금융 시장 데이터를 생성 모델로 합성할 수 있을까
원제 Can you use autoregressive diffusion to generate market data?
104 포인트댓글 36
Key Point
시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
- Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다.
- 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다.
- 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다.
- 초기 DDPM 기반 확산 모델은 88~95% 값이 평균으로부터 8 표준편차 이상 떨어진 발산 궤적을 보여 실패했다.
- Flow matching 방식으로 전환하니 안정성이 크게 개선됐는데, 이는 데이터와 노이즈 사이를 선형 보간하고 속도를 예측하는 방식으로 수렴성이 우수하다.
- 시장 데이터의 불연속성(타이밍 분포의 영점 질량, 가격 주변 클러스터링)을 처리하기 위해 처음엔 20개 분류로 세분화했으나 이는 변수 증가 시 확장 불가능하다.
- 대신 '원자 평활화'라는 기법을 개발해 스파이크 분포를 부드럽게 처리하면서도 확률 질량을 보존하는 방식을 적용했다.
- 한 스텝 앞 예측에서 총변이 거리로 측정한 한계 분포 일치도는 개선됐지만, 생성된 이벤트와 실제 이벤트를 구분하는 분류기 정확도로 평가하면 여전히 리얼하지 못했다.
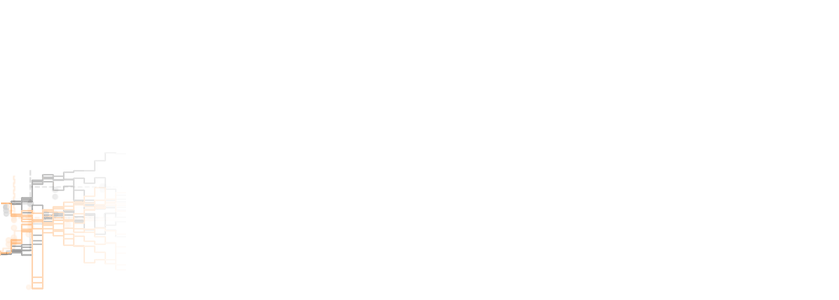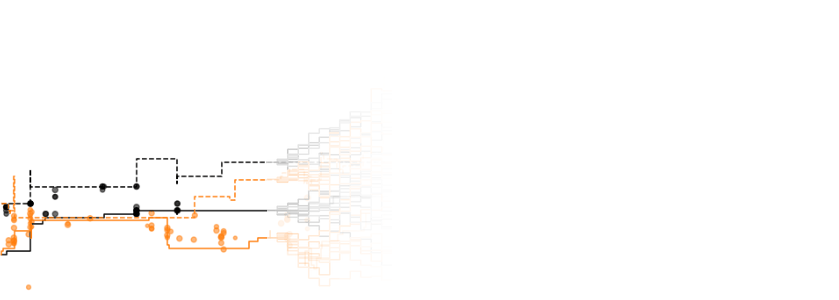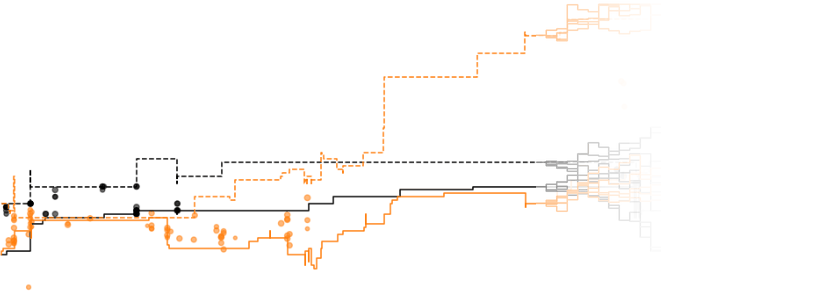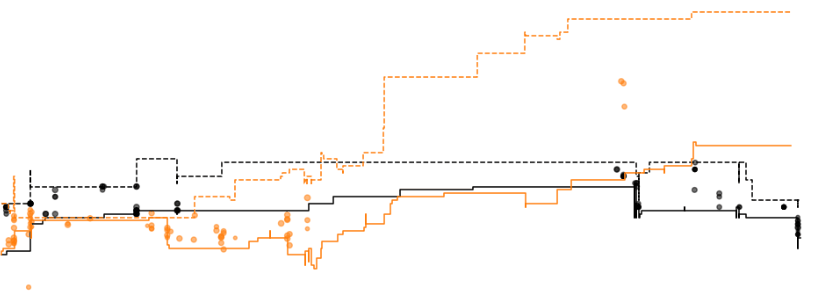
- 자동회귀 방식의 다단계 생성에서 모델의 예측 정확도가 시간 경과에 따라 악화되며, CME US 선물 데이터의 합성 롤아웃에서 스프레드 확산이 관찰된다.
- 현재 모델은 실용적 생성 수준에 도달하지 못했지만, 연구를 통해 이산성 수준 결정(분류 vs. 확산 예측), 특성 표현 최적화라는 핵심 설계 결정사항을 정리했다.