쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
6건 · "시간 정렬"조건 지우기 ×
001 18:11 ▲ 25 · 댓글 2 1인칭 영상 설명에 타이밍 추가한 'EgoCaptioner' 공개 기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. AI · 머신러닝 · EgoCaptioner: Towards Comprehensive and Fine-Grained Egocentric Video Captioning
Key Point 1인칭 영상 분석에서 정확한 시간 정보와 세밀한 행동 설명이 모두 필요한 실제 문제를 해결하는 새로운 데이터셋과 방법론이며, 기존 상용 모델을 능가하는 성능을 달성했기 때문이다.
핵심 요약
기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. EgoCaptioner는 영상의 환경·참여자·착용자의 전반 활동을 개요로 먼저 제시한 뒤, 각 단계마다 타임스탬프를 붙인 설명을 제공하며 세부사항의 정도를 조정해 주요 순간을 정확히 표시한다. 50,000개 학습 데이터셋을 위해 'coarse-to-fine' 주석 방식을 개발했으며, 먼저 사건 구조를 정의한 뒤 각 단계 설명을 확장하는 방식을 사용했다. 전체 요약 8문장 읽기 → 002 18:11 ▲ 10 · 댓글 2 양팔 조종 + 이동형 로봇을 위한 데이터 수집 시스템 HALO 양팔 동작과 로봇 이동을 함께 학습하는 모바일 조작 로봇의 학습 데이터를 효율적으로 수집하는 HALO 시스템을 소개했다. 하드웨어 · 시스템 · HALO: Human-Aligned Data Collection for WhoLe-body MObile Manipulation
Key Point 기존 데이터 수집의 속도와 품질 문제를 동시에 해결하면서 복잡한 양팔-이동 로봇 학습의 현실적 경로를 보여준다.
핵심 요약
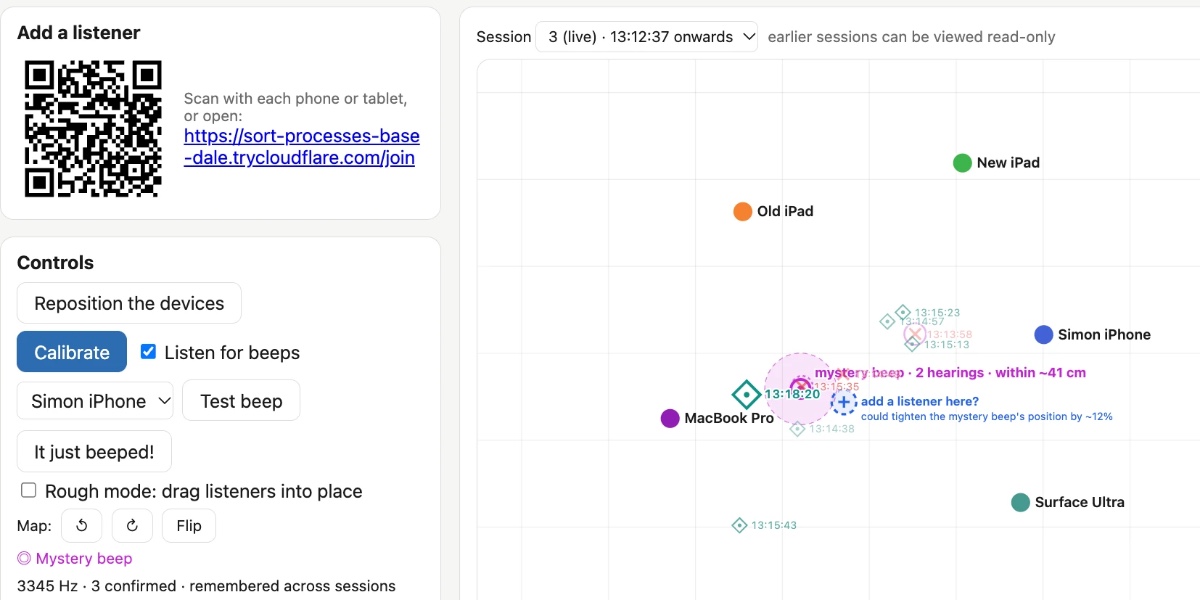
양팔 동작과 로봇 이동을 함께 학습하는 모바일 조작 로봇의 학습 데이터를 효율적으로 수집하는 HALO 시스템을 소개했다. 기존 인터페이스는 직접 제어, 인지-행동 정렬, 자연스러운 이동성 중 하나를 포기해야 하는 트레이드오프가 있었다. HALO는 저항 작은 플랫폼 위에서 키네스틱 티칭으로 로봇 팔을 조종하면서 자연스럽게 이동할 수 있게 설계했다. 전체 요약 6문장 읽기 → 003 18:12 ▲ 168 · 댓글 75 AI 음성으로 "정체 모를 소음" 위치 찾다 집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. AI · 머신러닝 · Locating the source of a mysterious beep
Key Point AI가 코드 작성을 넘어 실시간 센서 데이터를 처리하고 동적으로 자신의 능력을 확장하는 방식을 보여주는 사례로, 코딩 에이전트의 실질적 한계와 가능성을 다룬다.
핵심 요약
집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. 여러 기기(iPad, 휴대폰, MacBook Pro, Surface Ultra)를 방에 배치해 WebSocket과 웹 마이크를 통해 소리를 감지하고 위치를 계산하는 방식이다. 기기 간 음향 신호로 상대 위치를 자동 계산하되, 수동으로 드래그하는 '러프 모드'를 통해 대략적 위치를 입력하고 정확도를 높인다. 전체 요약 12문장 읽기 → 004 15:11 ▲ 103 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 005 00:11 ▲ 173 · 댓글 59 녹음음악, 기계의 완벽함에 잠식되다 1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 기타 · What Is Gridifcation
Key Point 음악 제작 방식이 지난 25년간 근본적으로 변했으며, 인간의 살아있는 시간과 개별성이 기계적 완벽함으로 지워지는 문제를 역사적 데이터로 처음 명확히 제시했다.
핵심 요약
1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 2025년 빌보드 1위곡 '다이 위드 어 스마일'은 평균 79 BPM에서 표준편차 0.00 BPM, 템포 변화 0회, 100% 정확도로 거의 완벽한 기계적 정밀도를 유지하고 있다. 이 현상을 '그리디피케이션'이라 하며, 인간의 공연을 사후 처리 과정에서 알고리즘 기반 양자화 도구로 보정하여 기계 같은 완벽함으로 변환하는 것을 의미한다. 전체 요약 9문장 읽기 → 006 21:12 ▲ 11 · 댓글 2 인간의 촉각 데이터 500시간, 로봇 조작 성공률 22.5%→57.5% TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. AI · 머신러닝 · TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
Key Point 로봇 조작에 필요한 촉각 정보를 포함한 대규모 균질 데이터셋이 실제 작업 성공률을 2.5배 향상시켜, 구현화된 AI 시스템 개발의 데이터 기초가 어떻게 바뀌는지 보여준다.
핵심 요약
TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. 각 기록은 정면 RGB-D 비디오, 손목 RGB 비디오, 양손 촉각 측정값이 시간 정렬되어 포함되며 약 2,000개의 사전 정의된 작업 설명을 아우른다. 기존 촉각 데이터와 달리 센서와 수집 절차가 고정되어 있어 데이터 규모의 영향을 명확히 분리할 수 있다. 전체 요약 8문장 읽기 →