쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
20건 · "에이전트 AI"조건 지우기 ×
001 06:11 ▲ 127 · 댓글 31 구글의 멀티에이전트 AI, 수십 년 묵은 수학 문제를 증명하다 구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. AI · 머신러닝 · Advancing science and engineering with Antigravity's /teamwork
Key Point 구글이 멀티에이전트 AI로 정보이론, 양자 알고리즘, 형식 수학 등 수십 년 묵은 미해결 문제들을 순차적으로 증명·발견했으며, 이 도구를 모든 연구자에게 공개하면서 AI-인간 협업 연구의 새로운 패러다임을 제시했다.
핵심 요약
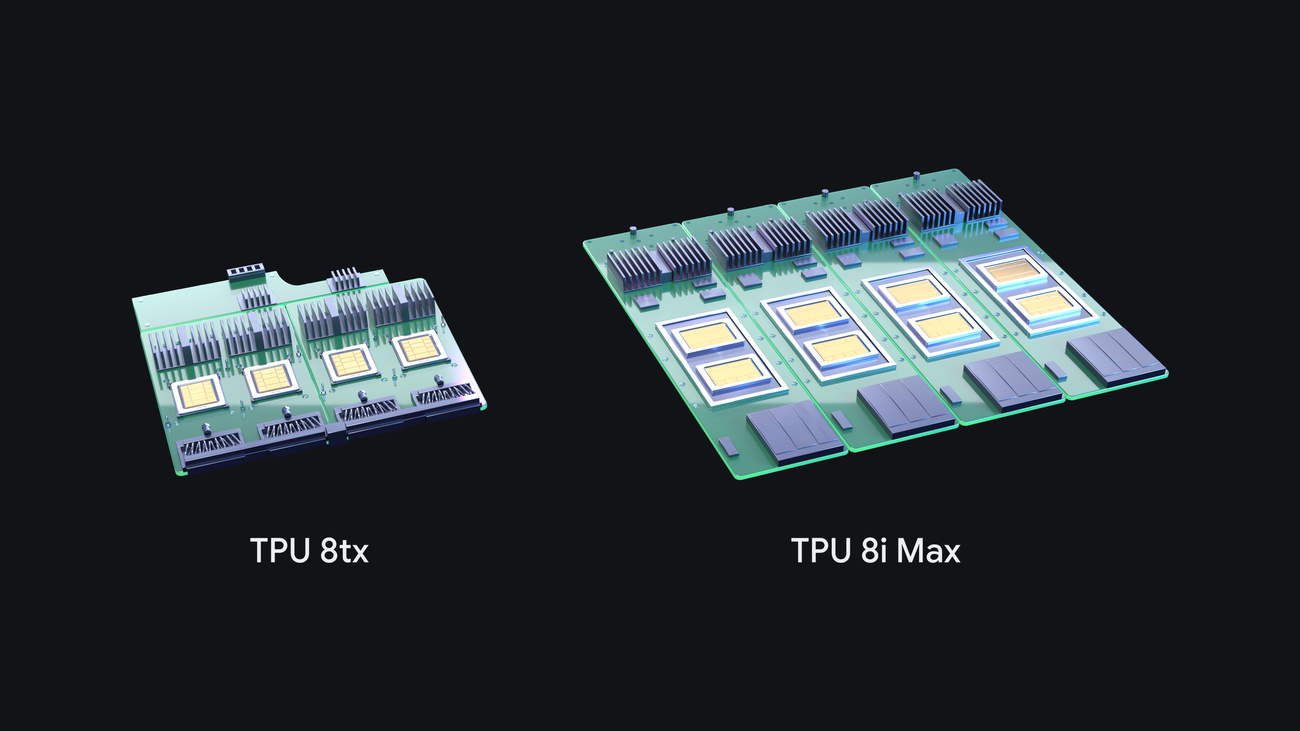
구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. Gemini 4 Argon, Carbon, Hydrogen 모델과 /teamwork을 함께 사용해 정보이론, 형식 검증, 분자 구조 발견, 커널 최적화 등에서 혁신을 이뤘다. /teamwork의 설계는 언어 모델의 두 가지 한계를 해결한다: 첫째 병렬 탐색과 검증자(Lean 4 증명 체커, 테스트 스위트 등)를 짝지어 생성의 불확실성을 극복하고, 둘째 각 에이전트에 필요한 도구와 파일만 전달해 장기 작업에서 맥락 손실을 방지한다. 전체 요약 14문장 읽기 → 002 09:11 ▲ 155 · 댓글 22 구글, 에이전트 시대 맞춰 TPU 8tx·8i Max 공개 구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. 인프라 · 데브옵스 · TPUs
Key Point 에이전트 AI 시대에 필요한 하드웨어 아키텍처가 극적으로 바뀌고 있으며, PyTorch 네이티브 지원 등으로 TPU 접근성이 대폭 개선돼 기존 GPU 중심의 개발 환경을 재편할 가능성이 있다.
핵심 요약
구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. TPU 8t는 2.7배 더 빠른 학습 성능을, TPU 8i는 80% 더 나은 추론 가격 대비 성능을 제공한다. TPU 8tx는 민감한 데이터 보호를 위해 하드웨어 수준의 암호화를 탑재하고, AMD EPYC CPU와 결합해 추론 시 2배 낮은 지연 시간을 달성한다. 전체 요약 12문장 읽기 → 003 06:11 ▲ 162 · 댓글 66 메타, 에이전트 작업용 경량 모델 뮤즈 엠버 공개 메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. AI · 머신러닝 · Our Smallest, Most Efficient Model: Muse Ember
Key Point 에이전트 AI가 상용화되면서 도구 호출과 반복 작업에 최적화된 경량 모델의 필요성이 높아졌는데, 뮤즈 엠버는 기존 모델보다 훨씬 저렴한 비용으로 더 나은 성능을 제시해 생산 AI 시스템의 비용 구조를 바꿀 가능성을 보여준다.
핵심 요약
메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. 뮤즈 엠버는 Claude Haiku 5.5보다 약 3분의 1 비용으로 동일 수준의 성능을 내며, 모든 GPT-4o Luna 설정을 능가한다. 가격 대비 성능 지수에서 Artificial Analysis 전체 리더보드 효율성 경계선에 위치한다. 전체 요약 13문장 읽기 → 004 03:11 ▲ 118 · 댓글 65 Claude의 에이전트 메모리 시스템, 드리밍으로 자기 성찰 Anthropic이 AI 에이전트의 메모리 시스템 설계 원칙을 공개했다. 인간 뇌의 해마와 신피질 구조처럼, 에이전트는 세션 중 경험을 로그에 기록하고 유휴 시간에 이를 정리하는 '드리밍'을 통해 메모리를 조직화한다. AI · 머신러닝 · The Components of Agent Memory
Key Point 메모리 시스템 설계의 고민과 검증 결과를 보여줌으로써, 에이전트 AI가 실제 세계에서 효과적으로 학습하고 작업할 수 있는 방법에 대한 실용적 인사이트를 제공한다.
핵심 요약
Anthropic이 AI 에이전트의 메모리 시스템 설계 원칙을 공개했다. 인간 뇌의 해마와 신피질 구조처럼, 에이전트는 세션 중 경험을 로그에 기록하고 유휴 시간에 이를 정리하는 '드리밍'을 통해 메모리를 조직화한다. Claude는 메모리 노트를 작성해 사건의 중요도를 표시하고, 이는 미래 세션에서 읽을 수 있다. 메모리는 미래 패턴 반복을 예측하는 행위로, 예컨대 검증된 사실을 기록함으로써 향후 다시 확인할 필요가 없다고 예측한다. Continual Learning Bench 벤치마크에서 Claude Opus 5.5와 Sonnet 5.5는 메모리를 통해 검증된 규칙을 캡처했고, 기존 방식 대비 약 같은 성능을 유지하며 학습 루프를 완성했다. 전체 요약 12문장 읽기 → 005 15:11 ▲ 48 · 댓글 3 에이전트 AI 모델 'Axion 1.0' 오픈소스 공개 Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. AI · 머신러닝 · Axion 1.0: Open Agent Foundation Models, Simplified
Key Point 강력한 에이전트 AI를 단순한 훈련 방식으로 구현할 수 있다는 것을 입증하고 전체 개발 과정을 공개해 오픈소스 에이전트 AI 연구의 진입장벽을 낮혔다.
핵심 요약
Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. 3단계 학습으로 구성된다: 모델 인식 데이터 구성을 통한 자체 추론 능력 개발, 실제 데이터 기반 다양한 작업으로 도구 활용 추론 확장, 강화학습을 통한 장기 추론 강화. 첫 번째 SFT 단계는 모델의 성공적 문제해결 전략을 기반으로 어려운 문제를 합성하고 역대적으로 강화하는 방식을 사용한다. 전체 요약 8문장 읽기 → 006 00:11 ▲ 374 · 댓글 328 AI가 일을 덜어준다더니, 더 많이 일하고 있다 AI가 반복 업무를 자동화해주고 실장하기 쉬워지면서, 저자는 예전에는 시작할 가치가 없던 프로젝트까지 실행하기 시작했다. AI · 머신러닝 · AI promised less work. I've never worked more
Key Point AI의 생산성 향상이 실제로는 일의 양을 줄이지 않고 오히려 더 많은 업무를 야기하는 역설을 구체적 데이터로 보여주는 현장 증언으로, 개발자와 관리자 모두에게 AI 도입의 숨은 대가를 생각하게 한다.
핵심 요약
AI가 반복 업무를 자동화해주고 실장하기 쉬워지면서, 저자는 예전에는 시작할 가치가 없던 프로젝트까지 실행하기 시작했다. GitHub 기여 기록으로 분석한 결과, VP of Technology 역할로 올해 들어 2020년 최고 활동량과 비슷한 수준으로 급증했다: 10월 27일까지 2,102개 기여로 2021~2025년 전체 연도를 초과했다. 일주일에 2~3개 심각한 작업에서 여러 AI 에이전트를 병렬로 돌리는 방식으로 바뀌었고, 각 에이전트가 피드백과 승인을 요청할 때마다 컨텍스트 전환이 발생해 정신적 피로가 증가했다. 전체 요약 7문장 읽기 → 007 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 008 15:11 ▲ 72 · 댓글 2 게임 세계에서 스케일링: 구체화 에이전트의 지속적 사전학습 연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. AI · 머신러닝 · Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
Key Point 게임 환경에서 LLM의 스케일링 법칙을 실증적으로 검증한 첫 대규모 연구로, 에이전트 AI의 일반화 능력과 학습 데이터 다양성 간의 관계를 정량적으로 보여준다.
핵심 요약
연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. 0.8B~27B 모델 4종, 50~1,600시간 데이터 6개 규모, Minecraft 단독부터 다중 게임 혼합 데이터 5가지 조합으로 총 120가지 설정을 학습했다. 결과적으로 더 많은 데이터는 학습 데이터 포함 게임 성능을 높이고, 다양성은 유사 게임으로의 전이는 개선하나 거리가 먼 게임으로의 일반화는 제한적이었다. 전체 요약 8문장 읽기 → 009 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 010 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 011 03:12 ▲ 33 · 댓글 2 다중 에이전트 갈등 평가 벤치마크 CLASHarness 공개 Vision-language 모델이 멀티에이전트 시스템에 배포되면서 실무 협업처럼 불완전한 정보, 모순된 지시, 권한 경쟁 등 갈등 상황을 다루는 능력이 중요해졌다. AI · 머신러닝 · CLASHarness: Benchmarking Multi-Agent Conflict in Computer Use via a Controllable and Verifiable Generation Pipeline
Key Point 멀티에이전트 AI 시스템이 실제 협업 환경의 불완전한 정보와 갈등을 제대로 처리하지 못하는 근본적 한계를 드러낸 평가 지표이므로, 안정적인 에이전트 시스템 개발의 방향을 가늠하는 데 필요하다.
핵심 요약
Vision-language 모델이 멀티에이전트 시스템에 배포되면서 실무 협업처럼 불완전한 정보, 모순된 지시, 권한 경쟁 등 갈등 상황을 다루는 능력이 중요해졌다. 기존 벤치마크는 협력적 환경을 가정하므로 갈등 해결 능력을 평가하기 어렵고, 수동 작성은 복잡 시스템에서 확장 불가능하며 LLM 생성은 일관성 결여와 답안 유출 문제가 있다. CLASHarness는 600개 멀티라운드 과제로 검증 가능한 에이전트 갈등을 생성하는 제어 가능한 프레임워크로, 계층적 시나리오 계획과 8단계 검증 파이프라인을 결합해 모든 과제가 구성상 해결 가능함을 보장한다. 전체 요약 7문장 읽기 → 012 18:11 ▲ 64 · 댓글 2 규칙 추론 벤치마크 RuleTrek 공개, LLM의 한계 드러내다 대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. AI · 머신러닝 · RuleTrek: Benchmarking Agentic Rule Reasoning in Complex Scenarios
Key Point LLM이 현실 업무에서 도메인 규칙을 얼마나 정확히 따를 수 있는지 측정하는 새 기준이 제시되면서, 에이전트 AI의 신뢰성 문제가 수치로 드러났다.
핵심 요약
대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. 기존 규칙 추론 벤치마크는 시나리오를 소수의 사실 진술로만 표현해 규칙 식별과 적용을 지나치게 단순화했다. 연구팀이 발표한 RuleTrek은 복잡한 시나리오에서 에이전트 기반 규칙 추론을 평가하는 다중 도메인 벤치마크다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 014 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 015 03:11 ▲ 116 · 댓글 148 메타 뮤즈, 우수한 디자인으로 소비자 AI 시장 주도권 잡다 메타의 뮤즈는 기술적으로 새롭지 않지만 기존 AI 제품들의 복잡한 인터페이스를 단순하게 정리하여 성공했다. AI · 머신러닝 · What Meta got right with Muse
Key Point 소비자 AI 시장에서 기술 혁신보다 디자인, 메타포, 비즈니스 모델이 얼마나 중요한지 보여주며, 각 기업의 강점과 약점을 명확히 분석한다.
핵심 요약
메타의 뮤즈는 기술적으로 새롭지 않지만 기존 AI 제품들의 복잡한 인터페이스를 단순하게 정리하여 성공했다. 뮤즈는 모델 선택, 작업과 채팅 전환, MCP나 크론 작업 같은 개념을 모두 숨기고 하나의 채팅으로 통합해 단순성을 달성했다. 사용자에게 AI를 '자신의 개인용 도우미'라는 명확한 정신 모델을 제공하며, Jobs-To-Be-Done 프레임워크에 따라 도구 모음이 아닌 동료처럼 작동한다. 전체 요약 8문장 읽기 → 016 15:11 ▲ 31 · 댓글 2 드라마·영상물 자막을 에피소드 전체로 일관되게 번역하는 AI 시스템 장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. AI · 머신러닝 · Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
Key Point 장편 드라마나 영상물의 일관된 자막 번역이 필요한 스튜디오·OTT 플랫폼과 다국어 번역을 다루는 개발자들이 접할 수 있는 실용적 멀티에이전트 AI 시스템의 등장이자, 기존 문장 단위 번역의 한계를 시리즈 전체 맥락으로 극복하는 새로운 접근법이다.
핵심 요약
장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. SMART라는 자체 진화 다중 에이전트 시스템을 제안하며, 테스트 시점 학습 단계에서 시리즈 수준 메모리를 구축하고 동적 라우터와 Mixture-of-Agents 계층을 통해 용어 검증·자막 제약 검증·문맥 검색 도구를 활용한다. 판사-개선 루프를 거쳐 후보들을 채점하고 텍스트 비판을 통해 LLM을 재학습하지 않으면서 에이전트 프롬프트와 라우팅 정책을 업데이트한다. 전체 요약 7문장 읽기 → 017 21:11 ▲ 123 · 댓글 39 AI가 인간처럼 생각하게 하려면, 빠르고 느린 시스템을 함께 써야 한다 현대 AI는 이미지 분석, 자연어 처리 등 특정 영역에서 뛰어나지만, 인간의 일반적 지능에 비해 여전히 좁은 범위의 능력만 가지고 있다. AI · 머신러닝 · Thinking fast and slow in AI: The role of metacognition (2021)
Key Point 인간의 인지 구조를 AI에 적용하는 구체적인 아키텍처를 제시해 현재 좁은 AI의 한계를 어떻게 극복할 수 있을지 보여준다.
핵심 요약
현대 AI는 이미지 분석, 자연어 처리 등 특정 영역에서 뛰어나지만, 인간의 일반적 지능에 비해 여전히 좁은 범위의 능력만 가지고 있다. 인간의 사고 메커니즘을 더 잘 이해하면 AI에 더 폭넓은 능력을 부여할 수 있다고 논문은 주장한다. 카네만의 '빠르고 느린 생각' 이론을 바탕으로, 연구팀은 두 종류의 에이전트로 구성된 다중 에이전트 AI 아키텍처를 제시했다. 전체 요약 5문장 읽기 → 018 09:11 ▲ 135 · 댓글 37 DeepSeek, 에이전트 AI 학습용 샌드박스 인프라 공개 DeepSeek이 대규모 에이전트 AI 학습·평가를 위한 프로덕션 샌드박스 플랫폼 'DSec'를 개발했다. AI · 머신러닝 · DeepSeek Elastic Compute (DSec)
Key Point 에이전트 AI의 대규모 학습에 필요한 인프라 구조가 어떻게 설계되는지 보여주며, 복잡한 샌드박스 관리 문제를 실무에서 푼 구체적인 방식을 공개했다.
핵심 요약
DeepSeek이 대규모 에이전트 AI 학습·평가를 위한 프로덕션 샌드박스 플랫폼 'DSec'를 개발했다. DSec는 함수 호출, 컨테이너, 마이크로VM, 전체VM 같은 4가지 백엔드를 통합 SDK로 제공하며, 클러스터 전체에 걸쳐 배치와 생명주기를 조정한다. 독립적으로 버전 관리되는 레이어로 실행 환경을 구성하고, 메모리 공유·회수·CPU 스케줄링으로 고밀도 실행을 구현하며, Fire-Flyer File System(3FS)을 통해 이미지 데이터를 필요 시점에 로드한다. 전체 요약 7문장 읽기 → 019 16:18 ▲ 112 · 댓글 3 깃허브 코드에서 AI 에이전트용 스킬 자동 추출 Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. AI · 머신러닝 · Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
Key Point 에이전트 AI에 필요한 재사용 가능한 스킬을 스케일로 자동 확보할 수 있는 새로운 경로를 제시하며, 기존 방법의 한계를 보완하는 동시에 성능 개선을 입증했다.
핵심 요약
Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. 추출한 스킬에는 원자적 작업, 복합 워크플로우, 반복 패턴이 포함되며 소스 코드 재구성과 비교로 검증된다. 이 방식은 환경 상호작용이 필요 없으면서도 실행 가능한 증거를 제공한다는 점에서 기존 궤적 기반 방식과 다르다. 전체 요약 5문장 읽기 → 020 09:10 ▲ 100 · 댓글 9 2026년 AI 추론이 주도권 잡으며 전용 칩 전쟁 시작 AI는 2020년 이후 대규모 모델 학습에만 집중했으나, 2026년 추론이 핵심 과제로 급부상했다. AI · 머신러닝 · The Inference Hardware Revolution of 2026
Key Point 기존 학습 중심의 AI 인프라 전략이 완전히 뒤바뀌고 있으며, 추론 전용 하드웨어가 새로운 경쟁 구도를 만들고 있기 때문이다.
핵심 요약
AI는 2020년 이후 대규모 모델 학습에만 집중했으나, 2026년 추론이 핵심 과제로 급부상했다. 추론형 AI 모델과 에이전트 AI 확산으로 인해 추론 수요가 폭발적으로 증가했고, 일부 고추론 모델은 저추론 모델 대비 20배 이상의 텍스트를 생성한다. 학습과 추론은 계산 방식이 완전히 다르다: 학습은 역전파로 매개변수를 갱신하지만, 추론은 이전 토큰의 모든 가중치와 문맥을 반복 읽어야 하는 자기회귀 방식이다. 전체 요약 4문장 읽기 →