쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
14건 · "3D 공간"조건 지우기 ×
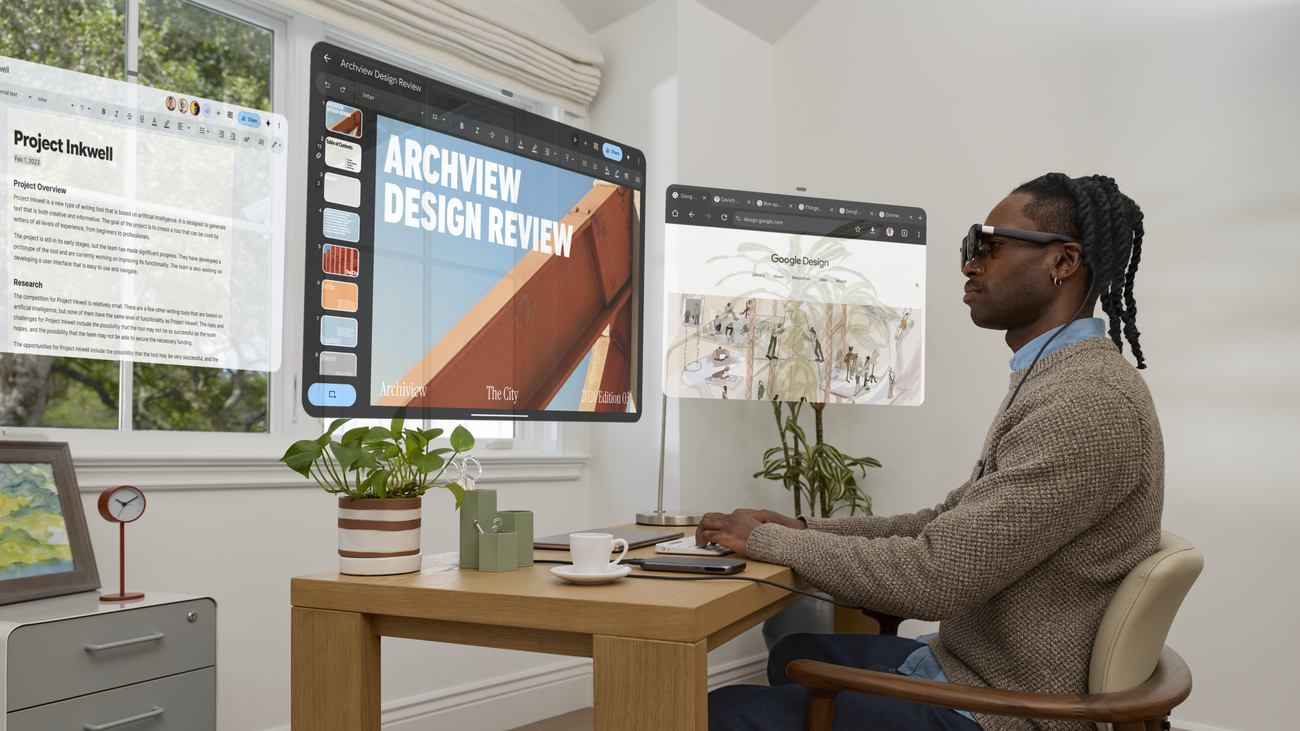
001 00:11 ▲ 103 · 댓글 101 구글, Android XR 기반 유선 XR 안경 'XREAL AURA' 출시 구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. AI · 머신러닝 · The first wired XR glasses powered by Android XR
Key Point Android XR을 탑재한 첫 유선 XR 안경으로, 가벼운 설계·강력한 AI 지원·다양한 앱과 게임·업무용 유선 미러링 기능을 갖춘 모바일 XR 기기 시장의 새로운 옵션이 출시된 것이다.
핵심 요약
구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. 투명 렌즈로 실제 세계를 보면서 70도 시야각으로 공간 콘텐츠를 투영하며, 95g 미만의 가벼운 무게는 케이블로 연결된 별도 컴퓨트 퍽에 Snapdragon Reality Elite 칩과 배터리를 실어 구현한다. Gemini가 사용자의 행동과 화면을 이해해 자연스러운 대화로 도움을 주며, Google Play의 150개 이상 XR 전용 앱을 포함한 수백만 개 앱을 실행할 수 있다. 전체 요약 13문장 읽기 → 002 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 005 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 006 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 007 21:11 ▲ 56 · 댓글 3 자연어로 3D 실내 공간 생성하는 AI 에이전트 개발 Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. AI · 머신러닝 · Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation
Key Point 자연어로 물리적으로 타당하고 기능적으로 올바른 3D 공간을 자동으로 설계하는 기술이 게임, 건축 시각화, 메타버스 등 여러 산업에서 필요한 핵심 과제를 해결한다.
핵심 요약
Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. Scene-OTA-35K 데이터셋은 관찰-사고-행동 지도를 제공해 장면 설계와 오류 수정을 학습하며, Scene-OTC-15K 데이터셋은 관찰-사고-평가자 지도로 물리적 타당성, 기능적 정확성, 레이아웃 일관성을 평가하는 능력을 갖춘다. Scene-GRPO는 평가자 기반 GRPO 프레임워크로, 설계 결정을 개선하고 불필요한 시행착오를 줄인다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 164 · 댓글 2 비전-언어 모델이 3D 공간을 직접 탐색하며 추론하는 방법 시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. AI · 머신러닝 · Learning to Think and Explore in 3D World
Key Point 3D 환경에서 능동적으로 탐색해야만 답할 수 있는 문제에서 기존 상용 모델을 능가하는 오픈소스 모델 사례를 제시하며, VLM의 추론 능력을 확장하는 새로운 학습 패러다임을 보여줍니다.
핵심 요약
시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. 초기 질문과 첫 번째 관점에서 시작한 뒤, 모델이 반복적으로 추론하고 이동·회전 같은 행동을 통해 시점을 변경하며 최종 답변을 제출하는 방식입니다. 궤적 감독 미세조정 후 강화학습(RL)을 적용했으며, 보상은 최종 답변 정확도로만 주어져서 모델이 어떤 시점을 방문할지는 스스로 학습합니다. 전체 요약 8문장 읽기 → 009 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 111 · 댓글 1 도시 전체 3D 장면에서 물체를 찾는 AI 에이전트 'Urbex' 공개 도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. AI · 머신러닝 · Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
Key Point 도시 규모 3D 장면 이해 문제를 에이전트 기반의 대화형 탐색으로 재설계해 기존 랭킹 방식의 비효율성을 타파한 새로운 접근법이기 때문입니다.
핵심 요약
도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. 기존 방식은 미리 계산한 후보 상자들을 순위매기는 방식이었는데, 대규모 실외 장면에서 비효율적이었다. Urbex는 비전-언어 모델 에이전트가 인터랙티브하게 탐색하도록 설계했다. 전체 요약 8문장 읽기 → 011 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 012 18:35 ▲ 43 · 댓글 2 손재주 많은 로봇 제어, 3D 점군으로 배운다 세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. AI · 머신러닝 · PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
Key Point 기존 손재주 로봇 조작 모델은 평면 이미지와 1차원 관절각만 다루며 3D 공간 기하를 놓쳤던 근본적 한계를 점군으로 해결한 접근법이 기존 방식을 11.7포인트 이상 추월했다.
핵심 요약
세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. Point World Action Model (PointWAM)은 환경과 손을 공유 시공간 좌표에서 3D 점 궤적으로 명시적, 분리적으로 표현하고 함께 예측한다. 작업별 물체 또는 키포인트 선택 없이 대규모 인간 시연 영상으로 사전학습할 수 있으며, 컬러 포인트 클라우드와 언어 지시로부터 장면과 손이 3D 공간에서 시간 경과에 따라 어떻게 공진화하는지 예측한 후 손 동작을 로봇 행동으로 재타겟팅한다. 전체 요약 4문장 읽기 → 013 15:11 ▲ 53 · 댓글 1 MLLM도 3D 상상력이 필요하다 - 다중뷰 이해의 새 방법 멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. AI · 머신러닝 · Imagine3D-LLM: Teaching MLLMs to Imagine 3D Scenes Before Answering
Key Point 다중뷰 3D 이해라는 MLLM의 핵심 약점을 인간의 추론 방식으로 해결하는 새로운 접근으로, 구조화된 3D 표현 학습이 모델 전체의 기하 인식을 높이는 메커니즘을 제시한다.
핵심 요약
멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. 본 연구는 인간의 공간 추론 방식에 영감을 받아, 세밀한 기하 단서보다는 뷰 간 공통 객체 인식 → 상대 기하 추론 → 장면의 대략적 3D 배치 조립 과정을 모방한다. Imagine3D-LLM은 이미지 토큰 뒤에 학습 가능한 요약 토큰 집합을 추가하고, 이를 3D 가우시안 스플래팅 표현으로 복원한다. 전체 요약 6문장 읽기 → 014 16:18 ▲ 84 · 댓글 3 로봇 기초모델, 3D 공간 이해로 조작 정확도 높이다 기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. AI · 머신러닝 · Grounded Action Model: 3D Grounding as a Foundation for Robotics
Key Point 로봇 조작 작업에서 객체 위치와 기하학 정보를 명시적으로 모델링함으로써 일반화 능력을 크게 개선한 새로운 아키텍처 패러다임으로, 실제 로봇 배포의 신뢰성을 높이는 핵심 진전입니다.
핵심 요약
기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. Grounded Action Models(GAM)은 3D 공간 정보를 명시적으로 포함한 새로운 로봇 기초모델로, 언어·포인트·박스 프롬프트 등으로 입력받은 후 공유 객체 표현으로 변환해 행동을 예측한다. 이 표현은 목표 대상의 시각 특징과 기하학적 정보를 담으며 로봇 상태 이력과 함께 멀티스트림 트랜스포머로 처리된다. 전체 요약 6문장 읽기 →