쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
50건 · "KV 캐시"조건 지우기 ×
001 00:11 당일 +127 LLM 시대 인프라 설계의 첫 걸음, 공개 교과서 LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. AI · 머신러닝 · bojieli/ai-infra-book · Python
Key Point 대규모 언어 모델을 실제로 배포할 때 지연 시간과 비용이 몇 배 차이나는 원인을 하드웨어와 시스템 설계에서 찾고 정량적으로 분석하는 방법을 배울 수 있다.
핵심 요약
LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. 전체 12장으로 구성되며 초기 입출력, 모델 아키텍처, 추론·훈련 부하, 가속기 아키텍처, 알고리즘과 런타임, 다중 기기 협력, 데이터센터 네트워크, 추론 최적화, 분산 추론, 훈련 시스템, 자원 스케줄링, 엣지-클라우드 협력을 다룬다. 책의 핵심 방법론은 '제약에서 설계로'로, 작업과 품질 요구사항을 정의한 뒤 계산·저장·통신 비용을 하드웨어 성능과 비교해 수량적으로 추정한다. 전체 요약 9문장 읽기 → 002 00:11 당일 +316 Cloudflare로 만드는 자체 이메일 서비스 'Cloud Mail' 하나의 도메인만으로 여러 이메일 계정을 만들 수 있는 오픈소스 이메일 서비스 플랫폼이다. 인프라 · 데브옵스 · maillab/cloud-mail · JavaScript
Key Point Cloudflare의 무료/저가 인프라를 활용해 자체 이메일 서비스를 구축할 수 있는 실질적인 솔루션으로, 개발자들의 높은 관심을 받고 있다.
핵심 요약
하나의 도메인만으로 여러 이메일 계정을 만들 수 있는 오픈소스 이메일 서비스 플랫폼이다. Cloudflare Workers에 배포 가능해 서버 비용을 크게 절감할 수 있다. Cloudflare Email 또는 Resend API를 이용한 이메일 발송, R2 객체 스토리지를 활용한 첨부파일 송수신을 지원한다. 전체 요약 10문장 읽기 → 003 06:11 ▲ 121 · 댓글 64 GLM-5.3을 두 DGX 스테이션에서 vLLM으로 607.8 토큰/초 처리 GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. AI · 머신러닝 · Serving GLM-5.3 at 607.8 tok/s across two Nvidia DGX stations with vLLM
Key Point 대규모 언어 모델을 여러 머신에 걸쳐 서빙하는 실전 구현 예시로, vLLM의 분산 배포와 성능 최적화 기법을 상세히 보여준다.
핵심 요약
GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. ConnectX-8 RDMA로 연결된 두 NVIDIA DGX 스테이션이 텐서 병렬화(TP=2)를 통해 하나의 OpenAI 호환 엔드포인트로 모델을 서빙하며, 각 GPU가 대략 절반의 가중치를 보유하고 계산한다. vLLM은 멀티토큰 예측, FP8 KV-캐시 저장, 프리픽스 캐싱을 활성화해 동시 부하에서 처리량을 최대화한다. 전체 요약 11문장 읽기 → 004 18:11 ▲ 24 · 댓글 3 3D 기하 재구성 없이 23배 빠른 신규 시점 렌더링 디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. AI · 머신러닝 · TTB: Test-time Baking for Efficient Rendering of Decoder-only View Synthesis Models
Key Point 3D 재구성 없이도 신규 시점을 실시간으로 생성할 수 있는 방식의 등장으로, VR·게임·영상 제작 등 뷰 합성이 필요한 분야의 효율성 문제를 근본적으로 바꿀 수 있다.
핵심 요약
디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. 새로운 방법인 TTB(Test-Time Baking)는 교차 뷰 어텐션에서 전역 장면 정보를 경량 MLP에 학습하여 빠르고 고품질의 신규 시점 디코딩을 가능하게 한다. 첫 번째 핵심은 TTT의 빠른 가중치 MLP를 입출력 쌍에서 교차 뷰 어텐션 매핑을 명시적으로 학습하도록 재목적화하여, TTT와 동일한 렌더링 효율을 유지하면서 현저히 높은 품질을 제공한다. 전체 요약 5문장 읽기 → 005 03:11 ▲ 12 · 댓글 3 에이전트 워크로드에 최적화된 LLM 서빙 프레임워크 공개 에이전트 기반 워크로드는 LLM 추론 수요의 주요 원인이며, 기존 Prefill-Decode 분산 서빙 시스템은 런타임 계산 할당과 KV 캐시 관리의 유연성이 부족하다. 인프라 · 데브옵스 · Evolving Infra: Agent-Adaptive LLM Serving at Scale
Key Point 에이전트 기반 LLM 애플리케이션이 확산되는 가운데, 기존 서빙 시스템의 구조적 한계를 직접 해결하고 프로덕션 환경에서 NVIDIA 표준 프레임워크를 크게 앞도는 성능을 입증한 기술이다.
핵심 요약
에이전트 기반 워크로드는 LLM 추론 수요의 주요 원인이며, 기존 Prefill-Decode 분산 서빙 시스템은 런타임 계산 할당과 KV 캐시 관리의 유연성이 부족하다. 현 방식은 거친 신호에만 의존하면서 다양하고 동적인 에이전트 워크로드를 제대로 포착하지 못해, Prefill과 Decode 노드 간 부하 불균형과 에이전트가 재사용할 KV 캐시 제거 문제를 야기한다. Evolving Infra는 런타임 중 에이전트 워크로드에 맞춰 계산 할당을 조정하고, 에이전트 컨텍스트 관리 신호에 따라 KV 캐시를 관리하는 프레임워크이다. 전체 요약 6문장 읽기 → 006 15:11 ▲ 15 · 댓글 4 깊은 신경망의 정보 손실을 잡다, DepthGraft 기법 LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. AI · 머신러닝 · DepthGraft: Structural Regularization through Hierarchical Cross-Layer KV Reconstruction
Key Point 모델의 깊이를 키우면서 정보 손실을 막고 캐시를 줄일 수 있는 구조적 기법이 제시되어, 더 효율적인 초대형 언어모델 개발에 실질적 가능성을 보여준다.
핵심 요약
LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. 교차 계층 연결은 이 문제를 완화하지만 기존 방식은 계산이나 메모리 접근을 추가로 늘린다. 연구팀은 교차 계층 KV(Key-Value) 공유 방식을 효율적인 연결 방법으로 재검토했으며, KV 재사용이 깊은 계층에서 얕은-중간 계층의 KV 생성으로 직접 기울기 경로를 만들어 KV 표현 구조를 정규화한다는 점을 발견했다. 전체 요약 9문장 읽기 → 007 00:11 ▲ 34 · 댓글 4 추론 메모리 4배 줄이는 KV 캐시 압축 기법 LowRAM 생성형 AI의 자동회귀 디코딩은 KV 캐시 메모리가 컨텍스트 길이에 선형으로 증가해 배치 크기와 처리량을 제한한다. AI · 머신러닝 · LowRAM: Low-Rank Keys and Amortised Values for Composable KV Cache Compression at Test-Time
Key Point LLM 추론 시 가장 큰 메모리 병목인 KV 캐시를 4배 이상 압축하면서 성능을 유지하는 방법으로, 배치 크기 확대와 처리량 증대에 직결된다.
핵심 요약
생성형 AI의 자동회귀 디코딩은 KV 캐시 메모리가 컨텍스트 길이에 선형으로 증가해 배치 크기와 처리량을 제한한다. 논문은 각 어텐션 헤드 내에서 밸류(Value)가 키(Key)로부터 대부분 예측 가능하다는 새로운 압축 축을 제시한다. 밸류 캐시 상각화 기법은 헤드별 경량 예측기를 추론 시점에 피팅하고 예측 오류가 큰 토큰의 잔차만 저장해 4배 무손실에 가까운 압축을 달성한다. 전체 요약 8문장 읽기 → 008 00:11 ▲ 106 · 댓글 34 284B 대형 AI 모델, GPU 없이 64GB RAM에서 실행하기 llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. AI · 머신러닝 · Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU
Key Point GPU 없이 대형 언어 모델을 기존 CPU 워크스테이션에서 실행할 수 있게 되면, 엔터프라이즈 AI 인프라의 진입 장벽이 크게 낮아진다.
핵심 요약
llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. 표준 방식으로는 DeepSeek-V4-Flash가 76.87GB가 필요해 64GB 시스템에서 메모리 부족 오류가 나지만, SwiGLU-H2 2차 헤시안 압축과 Fractal-64 양자화(3.75 bits/weight)를 조합하면 56.56GB로 축소할 수 있다. 256K 토큰 컨텍스트에서 프리필(prefill) 성능은 43.16~44.36 토큰/초, 순수 CPU 디코딩은 9.06~10.74 토큰/초, Stockfish-PVS 추측 디코딩 적용 시 11.5~14.7 토큰/초를 달성한다. 전체 요약 13문장 읽기 → 009 06:11 ▲ 11 · 댓글 2 루프 트랜스포머를 위한 초저비트 KV 캐시 양자화 기술 LoopVQ 루프 트랜스포머는 동일한 레이어를 여러 번 재적용해 매개변수 효율성을 높이면서도 표준 트랜스포머 성능을 유지하는 아키텍처다. AI · 머신러닝 · LoopVQ: Sub 1-bit KV Cache Quantization for Looped Transformers
Key Point 루프 트랜스포머는 파라미터 효율성이 뛰어나지만 KV 캐시 메모리가 주요 병목인데, 0.5비트 수준의 극저비트 양자화로 추론 처리량을 6배까지 늘릴 수 있음을 보여준다.
핵심 요약
루프 트랜스포머는 동일한 레이어를 여러 번 재적용해 매개변수 효율성을 높이면서도 표준 트랜스포머 성능을 유지하는 아키텍처다. 하지만 루프의 각 단계마다 고유한 KV 캐시를 저장하므로, KV 캐시가 루프 단계 수에 따라 선형 증가하며 메모리 병목이 된다. 연구진은 루프 모델의 KV 캐시가 루프 축을 따라 높은 중복성을 가지며, 루프 단계별로 양자화 민감도가 크게 다름을 발견했다. 전체 요약 7문장 읽기 → 010 12:54 ▲ 11 · 댓글 2 루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현 Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT
Key Point 작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다. 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다. 전체 요약 9문장 읽기 → 011 00:11 당일 +351 278조 파라미터 모델을 CPU에서 8GB로 돌린다 중국의 Kimi K3 모델(278조 파라미터)을 C99로 순수 CPU 추론하는 프로젝트다. AI · 머신러닝 · FareedKhan-dev/kimi-k3-in-c · C
Key Point 거대 언어 모델을 GPU 없이 평범한 노트북에서 돌릴 수 있는 방법을 보여주는 사례로, CPU 기반 추론의 실용적 한계를 재정의한다.
핵심 요약
중국의 Kimi K3 모델(278조 파라미터)을 C99로 순수 CPU 추론하는 프로젝트다. 1.56TB 체크포인트를 디스크에서 스트리밍하면서 최소 8.24GB 메모리로 작동한다. BLAS, 프레임워크, GPU 없이 176KB 엔진만으로 구현했으며, 포괄적인 테스트와 참고 구현이 함께 제공된다. 전체 요약 12문장 읽기 → 012 21:11 당일 +140 290B 모델을 데스크톱에서 실행하는 엣지 추론 엔진 FreeToken FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. AI · 머신러닝 · FlashML-org/FreeToken · Python
Key Point 소비자용 GPU로 290B 규모의 대형 MoE 모델을 실시간 속도로 로컬 실행할 수 있게 되어, 개인 개발자와 소규모 팀도 엣지에서 프론티어급 AI 모델을 직접 운영할 수 있는 가능성을 열어준다.
핵심 요약
FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. GPU, CPU, 호스트 메모리, 상호연결을 통합 플랫폼으로 활용하며, 대역폭 적응형 CPU-GPU 협력 실행(q* 정책)과 레이어 이중 버퍼링 프리필 스트리밍을 지원한다. 의미 기반 캐싱으로 상태와 KV 캐시의 앵커 체크포인트를 저장하여, 도구 호출·사고 블록 같은 에이전트 컨텍스트 편집 시 중복 재계산을 피한다. 전체 요약 9문장 읽기 → 013 06:11 ▲ 104 · 댓글 18 NVIDIA의 NVL72 시스템, 올바른 스케줄러로 GPU 활용률 27% 향상 InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. 인프라 · 데브옵스 · Grace Blackwell needs a new scheduler: 27% more usable GPUs from the same racks
Key Point NVL72 같은 랙 규모 시스템에서 통신 병목을 피하려면 하드웨어만으로는 부족하고, 올바른 스케줄링이 처리량을 14% 이상 개선할 수 있다.
핵심 요약
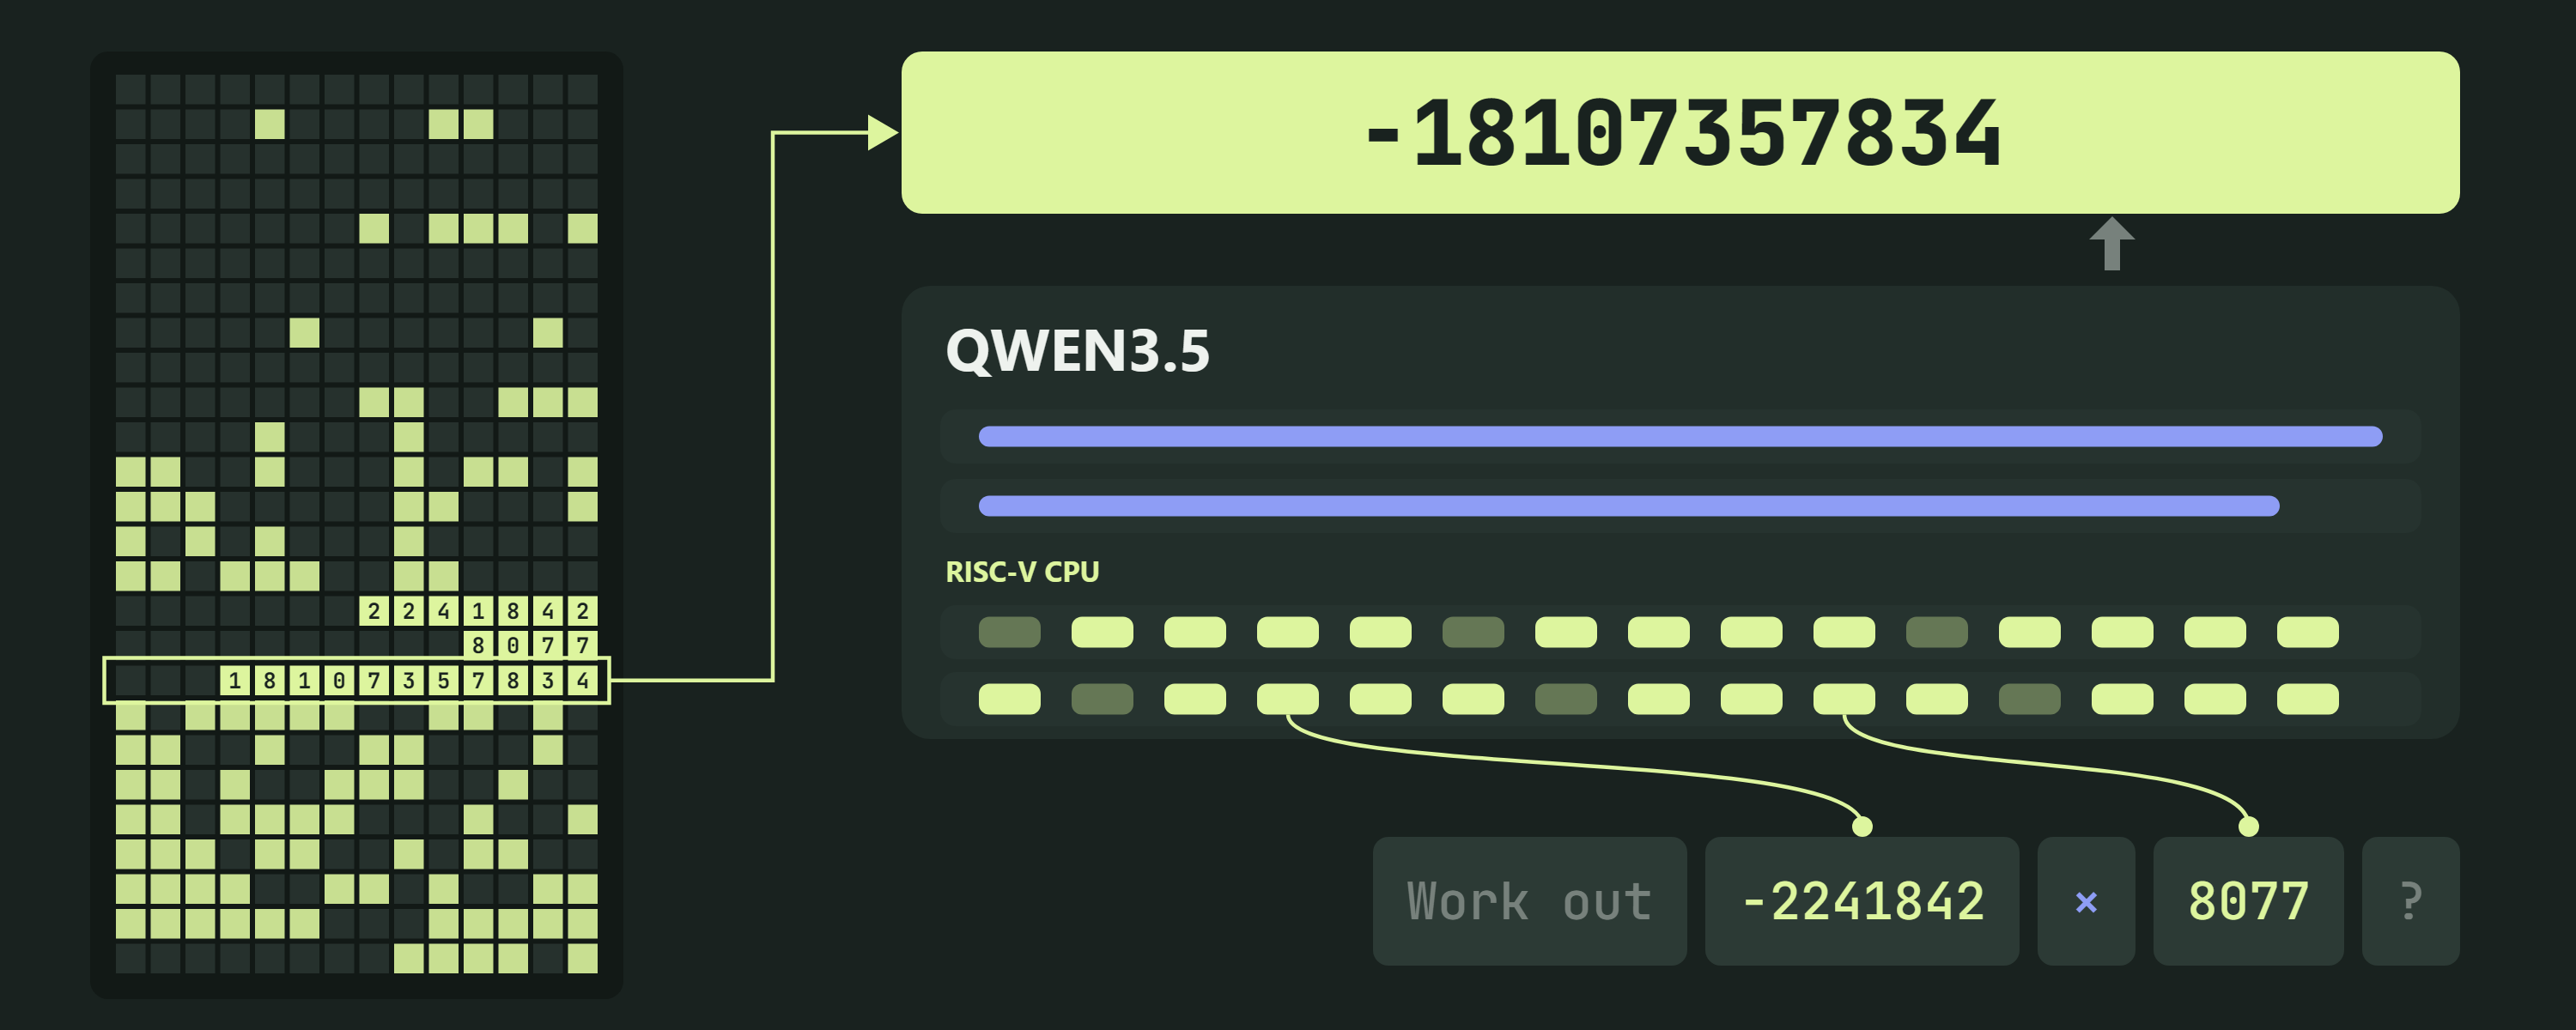
InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. NVIDIA의 NVL72 시스템은 한 랙의 72개 GPU를 통합 NVLink 패브릭으로 연결하면서 멀티 노드 AI 워크로드를 고대역폭으로 처리할 수 있게 했다. 대규모 학습에서 텐서 병렬화와 전문가 병렬화는 통신 병목이 되는데, 64웨이 전문가 병렬화를 사용하면 InfiniBand에서 학습 시간의 최대 60%가 통신에 소비된다. 전체 요약 13문장 읽기 → 014 12:11 ▲ 140 · 댓글 34 Qwen 가중치에 내장된 RISC-V CPU, 정확하게 동작하다 Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. AI · 머신러닝 · Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5
Key Point 언어 모델이 외부 도구 없이 정확한 산술 계산과 파일 저장을 수행할 수 있다는 새로운 가능성을 보여주며, AI 안전성 연구와 해석가능성 측면에서도 중요한 아키텍처 실험이다.
핵심 요약
Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. Gated DeltaNet 레이어의 게이트를 1로, 쓰기 강도를 1로, 원-핫 키 인코딩을 사용하면 정확한 주소 지정이 가능한 RAM이 되며, 이는 일반 어텐션의 KV 캐시보다 메모리 효율이 높다. CPU는 32비트 RISC-V 코어(RV32IM 명령어 세트)로 모델의 처음 11개 레이어를 차지하며, 컴파일러가 회로 설명을 트랜스포머 레이어의 어텐션 헤드와 피드포워드 유닛으로 변환한다. 전체 요약 11문장 읽기 → 015 15:11 ▲ 113 · 댓글 37 클라우드플레어 AI 모델서 사용자 데이터 노출, 155건 영향 클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 보안 · Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
Key Point 컨텍스트 윈도우와 실제 메모리 풀 크기의 불일치가 추론 엔진의 버그와 결합되어 사용자 간 데이터 유출을 초래한 사례로, disaggregated 구조의 AI 추론 서비스를 운영하는 회사들이 참고해야 할 설정·배포 체크리스트와 업스트림 수정 사항을 제시한다.
핵심 요약
클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 8월 27일부터 9월 9일까지 681,280토큰을 초과하는 긴 프롬프트에 대한 응답 155건이 영향을 받았으며, 의도적인 악용 흔적은 없었다. 근본 원인은 두 가지였다: 첫째, GLM-5.3의 KV 캐시 풀 크기(681,280토큰)가 선언된 컨텍스트 윈도우(1,048,576토큰)보다 작았고, 둘째, 오픈소스 추론 엔진 SGLang에서 초과 길이 요청을 disaggregated prefill/decode 모드로 처리할 때 거부된 요청을 제대로 중단하지 않는 버그가 있었다. 전체 요약 9문장 읽기 → 016 18:11 ▲ 149 · 댓글 53 세레브라스, 3조개 파라미터 모델을 59개 웨이퍼에 분산 배포 세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 인프라 · 데브옵스 · Cerebras Deploys Trillion-Parameter AI Models
Key Point 대규모 언어모델 추론 인프라의 실제 배포 방식을 보여주는 기술 사례로, GPU가 아닌 웨이퍼 기반 칩에서 조 단위 모델을 어떻게 효율적으로 운영하는지 알 수 있다.
핵심 요약
세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 3조 파라미터 규모의 공개 모델 키미 K3를 예시로, 4비트 양자화 기준 각 레이어는 약 16GB가 필요하다. 키미 K3의 경우 69개 선형 주의 레이어(각 웨이퍼당 2개씩 배치 가능)와 24개 밀집 레이어(각 웨이퍼당 1개씩, 나머지는 KV 캐시용)로 총 59개 웨이퍼가 필요하다. 전체 요약 8문장 읽기 → 017 12:11 ▲ 135 · 댓글 1 LLM 에이전트 캐시 관리, 비용 28% 절감 LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. AI · 머신러닝 · Cache Engineering for Agents
Key Point LLM 에이전트의 장시간 작업에서 캐시 관리 오버헤드가 최대 비용이 되는 상황에서, 궤적 수정 없이 캐시를 제어하고 비용을 27.7% 줄이는 새로운 방식의 등장으로 에이전트 성능 최적화의 패러다임이 바뀌고 있다.
핵심 요약
LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. 기존 방식인 히스토리 정리·요약은 궤적을 변경해서 이미 캐시된 상태를 무효화하고 비용이 많이 드는 재-프리필(re-prefilling)을 촉발한다. 연구팀은 cache engineering이라는 새로운 방식을 제안했는데, 궤적을 수정하지 않으면서 에이전트가 활성 KV 캐시를 직접 제어할 수 있게 한다. 전체 요약 10문장 읽기 → 018 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 019 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 020 09:11 ▲ 156 · 댓글 69 RTX Spark 노트북에 Arch Linux 깔아 ARM 성능 검증했다 마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. 하드웨어 · 시스템 · Putting Linux on my RTX Spark laptop because I don't have a Microsoft account
Key Point Windows 의존성 없이 ARM 노트북의 전체 성능(CPU·메모리·GPU 추론)을 Linux에서 동일하게 재현할 수 있음을 구체적 수치로 입증해, 폐쇄형 OS에 갇히지 않고 오픈 모델을 로컬에서 실행하려는 개발자에게 실질적 대안을 제시한다.
핵심 요약
마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. Arch Linux 패키지 유지보수자인 저자가 NVIDIA 커널 작업, ACPI 오버라이드, 펌웨어 추출을 통해 부팅 가능한 설정을 구성했으며, 키보드·오디오·디스플레이(3840×2400, 120Hz) 지원을 추가했다. CPU 성능 테스트에서 Linux 7-Zip 26.04는 Windows와 단일 스레드에서 거의 동등(±1%)하고, 20스레드에서는 압축 5%, 압축 해제 2.7% 더 빠른 결과를 기록했다. 전체 요약 8문장 읽기 → 021 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 022 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 023 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 024 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 025 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 026 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 027 15:11 ▲ 32 · 댓글 1 INT4 양자화로 강화학습 롤아웃 1.8배 빠르게 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
Key Point 강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다. KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다. 전체 요약 5문장 읽기 → 028 21:11 당일 +362 스트리밍 3D 재구성 모델 LingBot-Map 공개 Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. AI · 머신러닝 · Robbyant/lingbot-map · Python
Key Point 실시간 카메라 입력으로 고품질 3D 장면을 20 FPS 이상 처리할 수 있는 스트리밍 재구성 모델로, SLAM 및 3D 비전 분야에서 새로운 효율성 기준을 제시한다.
핵심 요약
Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. Geometric Context Transformer 아키텍처를 통해 좌표 정렬, 기하 신호, 드리프트 보정을 단일 스트리밍 프레임워크로 통합했으며, 앵커 컨텍스트, 포즈 참조 윈도우, 궤적 메모리를 활용한다. 518×378 해상도에서 10,000프레임 이상의 긴 시퀀스에 대해 초당 약 20프레임 속도로 안정적인 추론이 가능한 고효율 스트리밍 추론을 제공한다. 전체 요약 12문장 읽기 → 029 06:11 ▲ 143 · 댓글 119 DeepSeek 4.1 Flash, 프론티어 모델 수준의 성능을 1/100 가격으로 저자는 지난 한 달간 DeepSeek 4.1 Flash를 12개 프로젝트에서 헤비하게 사용했으며, Anthropic Opus와 구별할 수 없을 정도로 성능이 뛰어나면서 프론티어 모델보다 몇십 배 저렴하다고 밝혔다. AI · 머신러닝 · Why isn't the industry freaking out about DeepSeek 4.1 Flash?
Key Point 중국 LLM이 프론티어 모델과 대등한 성능을 1/100 가격에 제공하기 시작했으며, 이는 AI 비용 구조와 산업의 경제성을 근본적으로 재편할 수 있다.
핵심 요약
저자는 지난 한 달간 DeepSeek 4.1 Flash를 12개 프로젝트에서 헤비하게 사용했으며, Anthropic Opus와 구별할 수 없을 정도로 성능이 뛰어나면서 프론티어 모델보다 몇십 배 저렴하다고 밝혔다. DeepSeek는 Anthropic/OpenAI보다 1~2개월 뒤처져 있지만 같은 수준의 작업을 처리할 수 있으며, 개발자들은 성능보다 비용 대비 효율을 우선시하는 추세다. 현재의 LLM 성능이 충분히 좋아져서 최신 모델을 계속 쫓는 것이 불필요해졌으며, DeepSeek의 월 $10 구독으로 실질적으로 무제한 사용이 가능하다. 전체 요약 9문장 읽기 → 030 18:30 ▲ 13 · 댓글 4 MoE 모델 디코딩 성능 2배 근처로 높이는 프레임워크 Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. AI · 머신러닝 · SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
Key Point MoE 모델의 디코딩 병목을 해결하는 새로운 방식으로 정확도 손실을 최소화하면서 처리량을 획기적으로 높일 수 있다는 점이 중요하다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. 기존 전문가 가지치기(pruning)는 계산이 필요한 prefill 단계도 함께 가지쳐 모델 품질 저하에 비해 처리량 향상이 미미하다. SlimWise는 추론 각 단계별로 전문가 풀을 다르게 구성하는 서빙 프레임워크로, prefill은 전체 모델로 수행하고 decode는 가지친 모델을 사용한다. 전체 요약 6문장 읽기 → 031 18:30 ▲ 106 · 댓글 2 선택적 정밀도로 선형 어텐션 상태 압축하는 STEPQuant Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. AI · 머신러닝 · STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 032 18:33 ▲ 14 · 댓글 3 작은 모델도 빠른 추론 가능, 선택 기반 구조화 추론 등장 멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. AI · 머신러닝 · Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
Key Point 2B~4B 같은 경량 모델에서 추론 속도를 90% 단축하면서도 성능을 유지하는 방식이 나왔으므로, 리소스 제약이 있는 환경에서 멀티모달 에이전트를 활용할 수 있게 된다.
핵심 요약
멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. 이를 해결하기 위해 선택 기반 구조화 추론(SSR)을 제안했다. 추론을 개방형 생성 대신 선택 문제로 재정의한다. SSR은 반복되는 고수준 추론을 미리 정의된 재사용 가능한 자연언어 후보로 표현한다. 전체 요약 8문장 읽기 → 033 18:33 ▲ 20 · 댓글 2 재귀 언어모델의 고정점 최적화로 학습·추론 비용 2배 절감 루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. AI · 머신러닝 · Towards Looped Models Done Right, Part II: Rethinking at Fixed Points
Key Point 재귀 언어모델의 학습·추론 비용을 획기적으로 줄이는 구체적 기법(KV 캐시 축소, 역전파 생략, RL 속도 개선)과 이론적 기반(고정점 특성)을 제시하며, 실험 결과로 입증된 개선 방법을 다룬다.
핵심 요약
루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. 고정점 근처에서의 수렴 성질을 활용하면 학습 중 절단된 역전파(truncated backpropagation), 거의 정확도 손실 없는 터미널 KV 공유 디코딩, 1.79배 빠른 프리필을 위한 증류 학생 모델, 저장된 롤아웃 상태에서 그래디언트를 계산하는 RL 업데이트(재생 경로 역전파보다 2배 빠름)가 가능하다. 고정점을 형성하는 두 핵심 요소인 깊이 사전(depth prior)과 입력 주입(input injection)을 개선했다. 전체 요약 8문장 읽기 → 034 18:33 ▲ 12 · 댓글 2 로봇 동작 예측을 25배 빠르게 하는 원스텝 AI 모델 World Action Models(WAM)은 비디오 생성 모델에서 시각 정보를 추출해 로봇의 동작 예측을 안내하는데, 기존 효율형 모델도 멀티스텝 디노이징과 전문가 모듈 간 순차 대기로 인해 느렸다. AI · 머신러닝 · RealtimeWAM: One-Step Asynchronous World Action Models
Key Point 비디오 생성 기반 로봇 동작 모델의 추론 속도를 극적으로 개선하는 기술이 공개되었으며, 성능 손실 거의 없이 25배 가속을 달성해 실시간 로봇 제어 애플리케이션을 가능하게 한다.
핵심 요약
World Action Models(WAM)은 비디오 생성 모델에서 시각 정보를 추출해 로봇의 동작 예측을 안내하는데, 기존 효율형 모델도 멀티스텝 디노이징과 전문가 모듈 간 순차 대기로 인해 느렸다. RealtimeWAM은 원스텝 동작 생성과 비동기 추론으로 이 두 병목을 해결한다. 멀티스텝 반복을 줄이기 위해 Teacher-Anchored Consistency Distillation(TACD)을 제안했는데, 이는 국소 일관성 오차만으로는 정확한 최종 동작을 보장할 수 없다는 문제를 해결하고 동결된 교사 모델의 멀티스텝 롤아웃 결과로 명시적 감독을 추가한다. 전체 요약 7문장 읽기 → 035 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 036 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 037 03:11 ▲ 57 · 댓글 2 여러 LLM을 조합한 멀티에이전트, KV 캐시 공유로 10배 빠르게 Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. AI · 머신러닝 · Prefill-Free Cross-Family KV Cache Transfer for Heterogeneous Multi-Agent LLMs
Key Point 서로 다른 LLM을 조합하는 멀티에이전트 시스템에서 구조적 차이를 극복하고 캐시 재사용으로 최대 10배의 속도 향상을 달성한 방식이 처음 제시되었습니다.
핵심 요약
Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. 논문은 HeteroFold라는 방식을 제안했다. 토큰화·모델 깊이·KV 표현의 차이를 처리하면서 양쪽 모델을 그대로 두고 KV 캐시를 다른 모델 족으로 이전한다. HeteroFold는 구조를 정렬하고, 송신자의 캐시를 수신자 공간으로 매핑한 뒤, 수신자의 동작을 유지하도록 보정한다. 전체 요약 6문장 읽기 → 038 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 039 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 040 12:11 ▲ 14 · 댓글 2 LLM 긴 문맥 추론 가속, KV 캐시 저비트 양자화 기법 WUSH-KV 컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. AI · 머신러닝 · WUSH-KV: KV Cache Quantization with Data-Adaptive Transforms
Key Point 긴 문맥을 다루는 LLM의 추론 속도와 메모리 효율을 크게 개선할 수 있는 양자화 기법으로, 실제 프로덕션 환경에서 바로 적용 가능한 방법을 제시한다.
핵심 요약
컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. WUSH-KV는 행렬 곱셈의 두 인수에서 2차 통계량을 이용해 데이터 인식 변환을 구성하는 WUSH 방식을 KV 캐시에 적용한 것으로, 양자화 오류를 줄일 수 있다. 캘리브레이션 데이터로 key와 value에 대해 별도의 변환을 구성하며, value 변환은 모델 가중치에 포함시키고 key 변환은 RoPE 이후에 적용한다. 전체 요약 6문장 읽기 → 041 03:11 ▲ 99 · 댓글 3 KV 캐시 압축의 숨은 약점, 위치에 따라 정확도 40%p 차이 긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. AI · 머신러닝 · Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
Key Point 긴 문맥 추론 최적화를 위해 KV 캐시 압축을 도입하면 평균 점수로는 보이지 않는 주기적 성능 저하가 발생하므로, 이 기법의 실제 안정성을 평가할 때 주의가 필요하다.
핵심 요약
긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. 같은 정보가 어떤 phase에서는 쉽게 검색되지만 다른 phase에서는 어렵다는 체계적인 비대칭성이 발생하며, 이를 phase sensitivity라고 명명했다. 대규모 오픈소스 모델들에서 long-context 검색 정확도가 phase에 따라 최대 40 percentage points 차이가 나타나, 평균 벤치마크 점수로는 드러나지 않는 주기적 약점들이 존재한다. 전체 요약 7문장 읽기 → 042 03:11 ▲ 343 · 댓글 342 중국 AI 연구소의 최적화 기술, 서방 기업들이 조용히 도입 중 Anthropic과 OpenAI가 중국 AI 연구소의 기술을 모방한다고 지적하지만, 중국 연구소들은 오히려 자신들의 혁신 기술을 공개하고 있다. AI · 머신러닝 · The AI Race Just Got Awkward
Key Point 서방 AI 기업들이 중국 연구소의 혁신 기술을 도입하면서 장문맥 처리 비용이 급격히 내려가고 있으며, 이는 AI 산업 경쟁 구도의 근본적 변화를 보여준다.
핵심 요약
Anthropic과 OpenAI가 중국 AI 연구소의 기술을 모방한다고 지적하지만, 중국 연구소들은 오히려 자신들의 혁신 기술을 공개하고 있다. DeepSeek이 공개한 KV 캐시 최적화 기술은 긴 문맥을 처리하는 작업에서 캐시 크기를 437배까지 줄였다. MLA 아키텍처로 15배 압축에 성공한 후, CSA, HCA 등의 기법을 거쳐 최신 DeepSeek-V4.1-Flash는 토큰당 890바이트로 캐시를 단축했다. 전체 요약 7문장 읽기 → 043 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 044 00:11 ▲ 17 · 댓글 1 행렬 곱셈 대신 저비용 연산 쓰는 트랜스포머 구조 제시 기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. AI · 머신러닝 · Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
Key Point 행렬 곱셈 최적화가 아닌 완전히 다른 연산으로 대체할 때 처리량 증가 vs. 성능 저하 트레이드오프가 어떻게 나타나는지 보여주는 실험 결과이다.
핵심 요약
기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. 일반적인 행렬 곱셈을 희소한 상호작용 테이블로 대체하는 결합대수(associative algebra) 구성을 기반으로, 물리적 블록 크기가 고정되면 행렬 차원에서 이차 산술복잡도를 갖는 계층군을 구축했다. 이 구성은 Alder-Strassen 경계에 의해 쌍선형 순위(bilinear rank)에서 증명 가능하게 최적이며, 인과 마스킹(causal masking)과 KV 캐시 디코딩과 호환되는 행 타입의 직사각형 투영으로 실현할 수 있다. 전체 요약 6문장 읽기 → 045 21:11 ▲ 20 · 댓글 1 동영상 생성 자동회귀 확산 모델의 캐시 재사용으로 1.7배 고속화 자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. AI · 머신러닝 · In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
Key Point 프롬프트-기반 동영상 생성 서비스 개발 시 캐시 재사용과 양방향 조건부 생성으로 생성 속도를 높이는 구체적인 기술적 해법을 제시하므로, 장시간 영상 생성이 필요한 실무 개발자에게 실질적 개선 방안을 보여준다.
핵심 요약
자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. FlashForward는 각 노이즈 제거 단계 중에 자동으로 생성되는 현재 청크의 KV 캐시를 다음 청크에서 직접 재사용해 캐시 업데이트 전용 순전파를 제거한다. 이 방식은 여러 GPU를 각 단계에 할당해 서로 다른 청크가 동시에 서로 다른 단계를 점유하도록 해 병렬 처리 효율을 높인다. 전체 요약 7문장 읽기 → 046 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 047 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 048 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 049 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 050 12:10 ▲ 103 · 댓글 51 LRU 캐시 정책, 기존 논문보다 더 견고했다 실제 Claude Code 세션 393개(요청 68,266건)와 Mooncake 요청 23,608건을 재현해 LRU를 이길 방법을 3가지로 시도했으나 모두 실패했다. 인프라 · 데브옵스 · LRU is harder to beat than the KV-cache papers suggest
Key Point 생성형 LLM 에이전트 서빙에서 캐시 정책을 최적화하려는 엔지니어들이 설계 선택을 할 때, 최근 학술 논문의 주장이 실제 프로덕션 워크로드에 얼마나 적용되는지 확인할 수 있다.
핵심 요약
실제 Claude Code 세션 393개(요청 68,266건)와 Mooncake 요청 23,608건을 재현해 LRU를 이길 방법을 3가지로 시도했으나 모두 실패했다. 용량 부족 상황에서 캐시 재계산의 주요 원인은 세션 만료(TTL)가 아니라 2초 간격의 도구 호출 루프였고, 5분 TTL은 실제로 발동되지 않았다. 재계산 토큰의 33.1%는 10초 이내 요청에서 발생했고, 5분 이상 대기 후 요청은 17.5%에 불과해 기존 논문의 핵심 가정이 실제 워크로드와 다르다. 전체 요약 5문장 읽기 →