로봇 학습, 데이터 대량 수집 시대 열리다
원제 How to Train Your Robot
103 포인트댓글 32
Key Point
로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
- AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다.
- LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다.
- 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다.
- 시뮬레이션은 저렴하고 빠르지만 현실과의 '시뮬레이션-현실 갭'이 특히 물체 조작에서 심각하다.
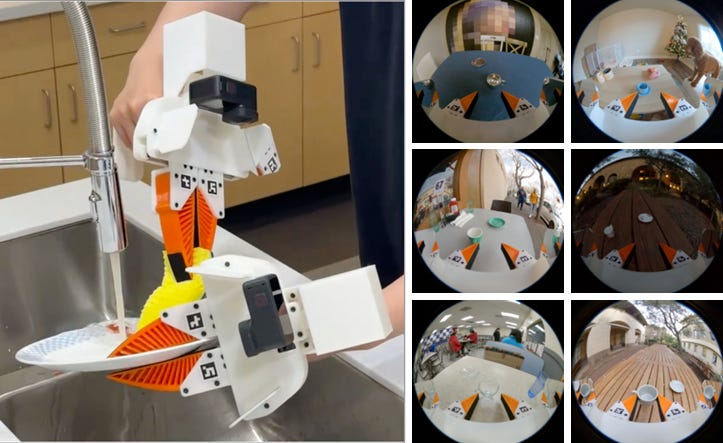
- 인간이 수행하는 작업을 카메라로 녹화하거나 UMI(범용 조작 인터페이스)로 데이터를 수집하는 방식이 확산 중이다.
- 구글 DeepMind의 OXE 데이터셋(400시간)에서 Figure AI의 일일 4만 3천시간 수집, Generalist AI의 50만시간 등으로 빠르게 증가하고 있다.
- 현재 로봇 모델은 GPT-3나 GPT-4보다 1천~5천배 적은 데이터로 학습되고 있어, '100만년 데이터 갭'이 존재한다고 평가된다.
- 필요한 데이터량이 10억 시간 수준이라면 총 비용은 100억~1천억 달러에 이를 것으로 추정된다.
- 데이터 수집 비용은 시간당 10달러에서 150달러까지 다양하며, 효율적인 파이프라인 개발로 비용 절감 중이다.
- 실제 필요 데이터량은 미확정 상태이며, 생성형 AI 모델의 능력이나 더 샘플 효율적인 로봇 모델 개발로 달라질 수 있다.
- 현실에서의 물체 조작은 텍스트 생성보다 훨씬 복잡하고 오류 허용도가 낮아, 더 많은 데이터가 필요할 수 있다.
- 로봇 공학자들은 현장 배치 로봇에서 나오는 데이터를 다시 학습에 쓰는 '데이터 플라이휠' 구축을 목표로 하고 있다.