PostgreSQL의 SELECT DISTINCT, 행 수에 비례해 느려진다
원제 Postgres SELECT DISTINCT Does Not Scale
102 포인트댓글 28
Key Point
쿼리 최적화나 데이터베이스 성능에 의존하는 개발자라면 Postgres의 이 근본적 한계를 알아야 대규모 시스템에서 SELECT DISTINCT를 피할 수 있다.
핵심 요약
- PostgreSQL의 SELECT DISTINCT는 직관과 달리 인덱스가 아무리 잘 짜여도 항상 조건을 만족하는 모든 행을 풀 스캔한다.
- 분할된 큐에서 '활성' 파티션을 찾는 쿼리에서 DISTINCT를 썼을 때, 파티션 수가 적어도 초 단위 지연이 발생했다.
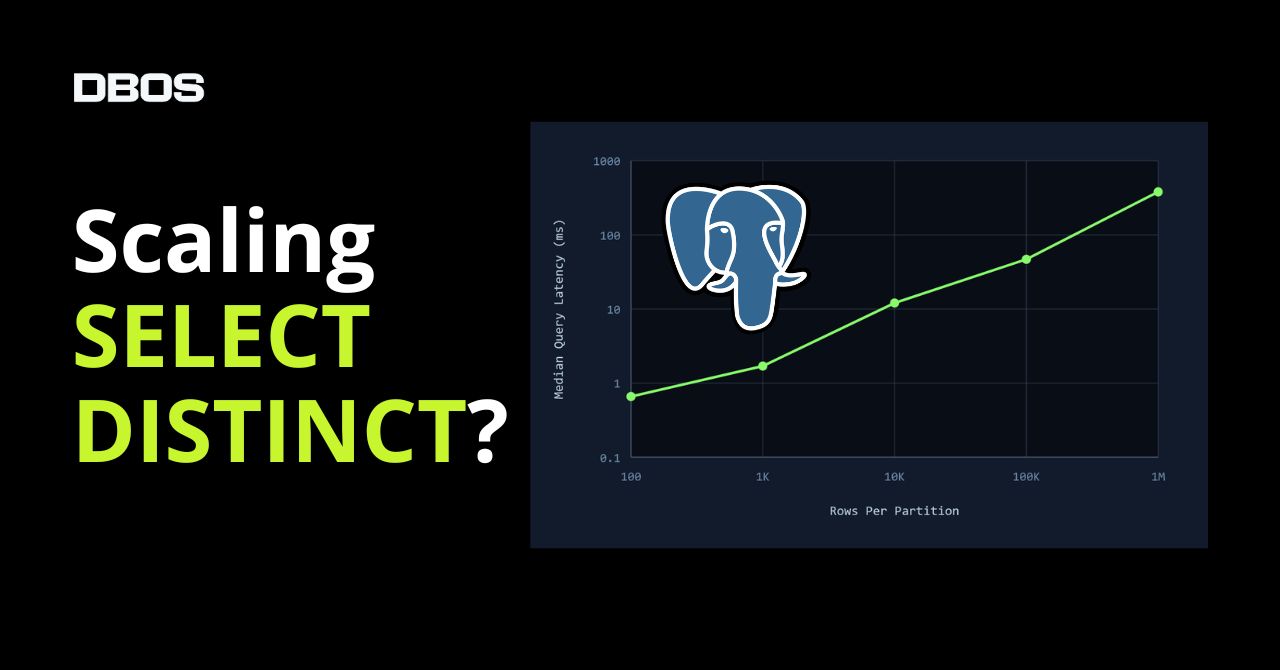
- 같은 파티션 수에서 행 개수만 100에서 1M으로 늘려도 쿼리 시간이 선형으로 증가하는 벤치마크 결과를 확인했다.
- Postgres는 파티션 수와 무관하게 조건을 만족하는 모든 워크플로우(1M 행)를 스캔해서 세 개의 파티션 키를 찾는 비효율을 보였다.
- MySQL 같은 다른 데이터베이스는 '느슨한 인덱스 스캔' 연산자로 고유값만 검색하지만, Postgres의 모든 인덱스 스캔 연산자는 전체 조건 행을 읽는다.
- Postgres 18의 스킵 스캔 최적화도 여전히 모든 조건 행을 스캔하므로 DISTINCT 속도 개선에 쓸 수 없다.
- 2018년 느슨한 인덱스 스캔 추가 시도는 4년 노력 끝에 폐기됐다.
- 효율적 해결책은 재귀 CTE를 이용해 각 반복에서 min()만 선택하도록 쿼리를 구성하는 것이다.
- CTE 방식 쿼리는 파티션 수에 비례한 O(파티션 수) 성능을 보여, 1K에서 1M 행까지 파티션 크기 변화에 지연이 없다.