EmbeddingGemma 2를 음성 인식 모델로 개조한 실험
원제 We turned EmbeddingGemma 2 into a speech-to-text model
238 포인트댓글 57
Key Point
다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
- Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다.
- 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다.
- 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다.
- 리더 모델은 H100 8개에서 2시간 미만의 학습으로 만들어졌으며 명시적 음성-텍스트 학습 없이 구현됐다.
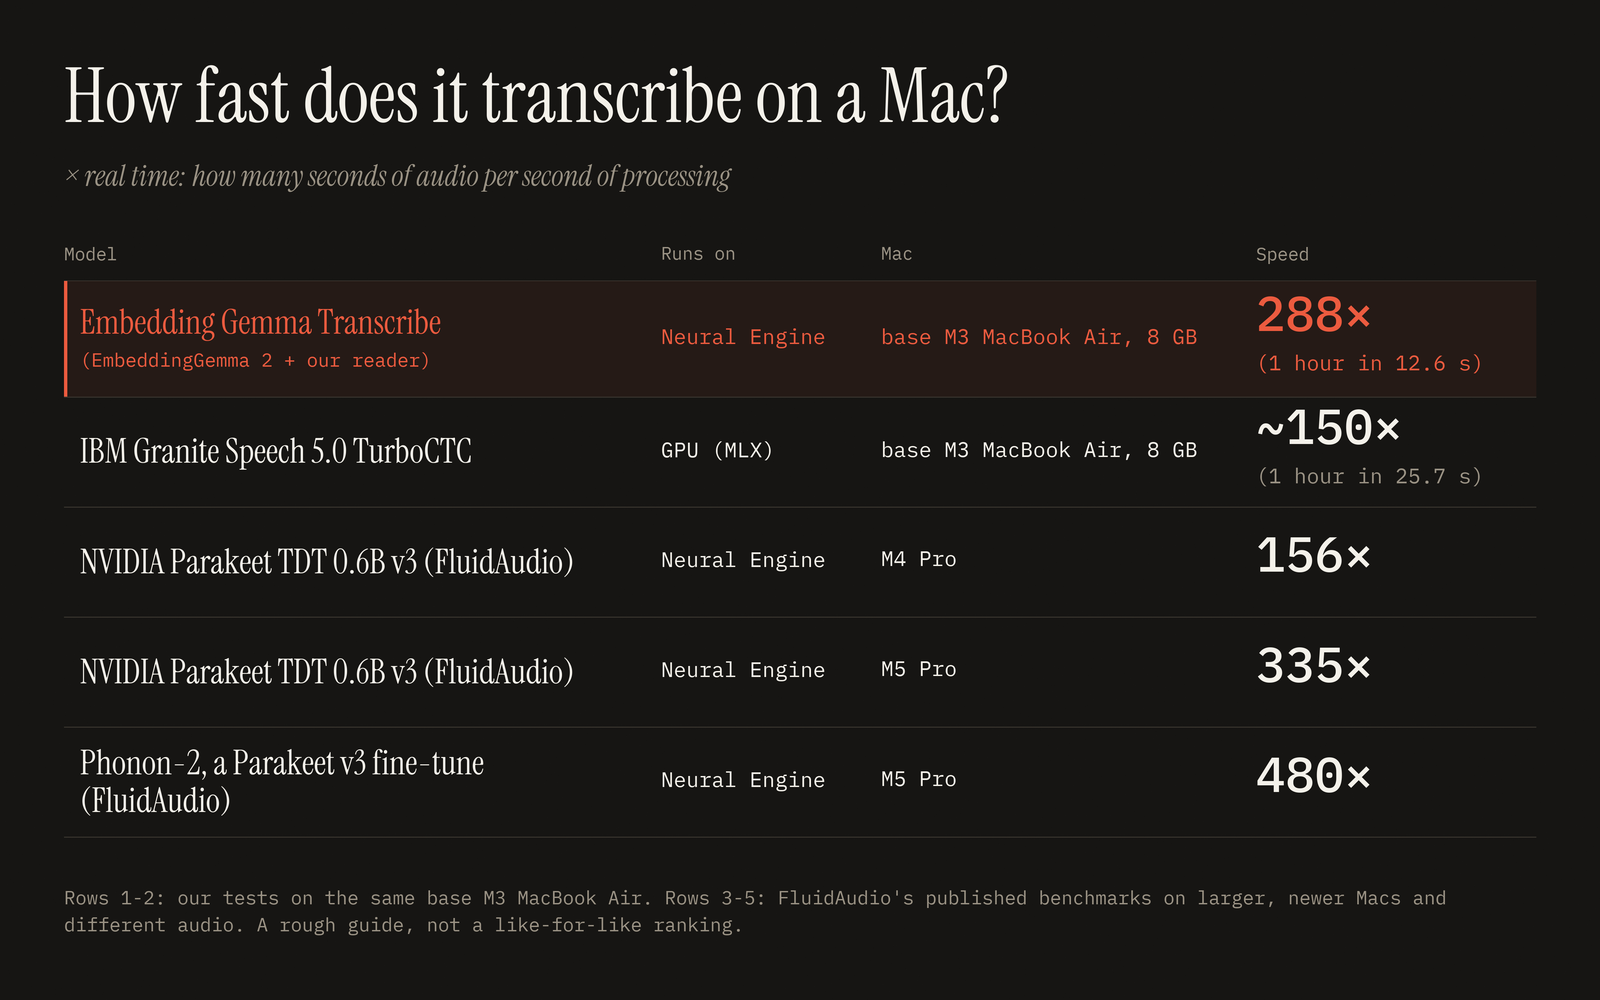
- Mac의 Neural Engine에서 1시간 오디오를 약 12.6초 만에 처리하며, 기존 IBM Granite(25.7초), NVIDIA Parakeet(더 느림)보다 빠르다.
- 현재 5% 수준의 단어 오류율을 기록하고 있으며 최고 수준 모델의 2~3%보다 높지만, 리더 모델 개선으로 격차를 줄일 수 있다고 본다.
- Mac 앱으로 무료로 제공되며 오디오가 기기를 벗어나지 않는다.