쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
75건 · "임베딩"조건 지우기 ×
001 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 002 06:11 ▲ 26 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 005 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 006 03:11 ▲ 16 · 댓글 4 Gemma 4 임베딩을 극도로 압축하는 OPTIC 기법 공개 Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. AI · 머신러닝 · Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
Key Point 대규모 언어 모델의 임베딩 매개변수가 점차 커지는 추세에서, 성능 손실을 최소화하면서 극도의 압축을 달성할 수 있는 새로운 방법을 제시한다.
핵심 요약
Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. OPTIC은 토큰마다 하나의 양자화된 코드를 저장하고, 각 층에서 층별 아핀 디코더로 디코딩하는 방식을 사용한다. 코드와 디코더는 저장된 벡터가 아닌 PLE 출력 경로에 맞춰 학습된다. 전체 요약 7문장 읽기 → 007 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 008 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 009 03:12 당일 +709 여러 AI를 한 곳에서 - OpenBot 데스크톱 앱 OpenBot은 로컬 우선 데스크톱 워크스페이스로, Codex, Claude, Grok, Cursor, Cline, Gemini, OpenCode 등 여러 AI 에이전트를 한곳에서 운영할 수 있다. AI · 머신러닝 · nightly-labs/openbot · TypeScript
Key Point 여러 AI 에이전트를 하나의 데스크톱 앱에서 관리·협업시킬 수 있는 새로운 워크플로우가 가능해진다.
핵심 요약
OpenBot은 로컬 우선 데스크톱 워크스페이스로, Codex, Claude, Grok, Cursor, Cline, Gemini, OpenCode 등 여러 AI 에이전트를 한곳에서 운영할 수 있다. 각 에이전트가 독립적인 워크스페이스와 대화 히스토리를 가지며, 로컬 메시지 큐, 파일 전송, 임베딩 브라우저, 에이전트 간 메시징을 제공한다. 개발 미리보기 단계이며 에이전트들이 기본적으로 무제한 접근 권한으로 실행되므로 신뢰할 수 있는 작업만 실행해야 한다. 전체 요약 10문장 읽기 → 010 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 011 15:10 ▲ 117 · 댓글 13 12년 된 분산 SQLite, 어떻게 진화했나 2014년 9월 저자가 Raft 합의 알고리즘과 SQLite를 결합한 rqlite를 발표했고, 이것이 이 둘을 합친 첫 오픈소스 시스템이었다. 인프라 · 데브옵스 · Twelve years of distributed SQLite
Key Point SQLite 분산 시스템의 아이디어가 12년에 걸쳐 어떻게 다양한 구현으로 진화했고, 오픈소스에서 유료 플랫폼으로 전환된 과정을 보여준다.
핵심 요약
2014년 9월 저자가 Raft 합의 알고리즘과 SQLite를 결합한 rqlite를 발표했고, 이것이 이 둘을 합친 첫 오픈소스 시스템이었다. rqlite는 CP 시스템으로 설계되어 쓰기는 리더를 통해서만, 다수결 승인이 필요하며 분할된 소수는 쓰기를 거부한다. 2016년 Bedrock(Paxos 기반)과 ActorDB(Erlang 기반)가 비슷한 시도를 했지만 널리 채택되지 않았으며, rqlite는 이를 독립적이고 범용적인 오픈소스로 만들었다. 전체 요약 12문장 읽기 → 012 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 013 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 014 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 015 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 016 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 017 12:11 ▲ 227 · 댓글 3 멀티모달 GUI 에이전트의 주의력 집중 방식 FocusGUI 스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. AI · 머신러닝 · Focused Omni-Modal GUI Agents
Key Point 멀티모달 정보를 처리하는 GUI 자동화 에이전트가 불필요한 정보로 인한 오류를 줄이고 성능을 대폭 향상시키는 새로운 방식을 제시하고 있다.
핵심 요약
스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. 각 단계마다 실제로 필요한 정보는 다르므로, 단계별로 적응적이고 행동 충분하며 비방해적인 '집중된 인식'을 요구한다. FocusGUI는 경량 어댑터로서 현재 의사 결정에 필요한 멀티모달 채널을 동적으로 우선순위화하고, 가장 관련성 높은 정보를 압축된 잠재 표현으로 변환한다. 전체 요약 7문장 읽기 → 018 03:11 ▲ 104 · 댓글 13 어두운 웹 위협 정보 수집 자동화하는 오픈소스 VoidAccess 공개 VoidAccess는 다크웹 조사 쿼리를 구조화된 위협 정보로 변환하는 자체 호스팅 가능한 오픈소스 OSINT 도구다. 보안 · Show HN: VoidAccess – open-source dark web OSINT, from query to a graph
Key Point 다크웹 위협 정보 수집을 자동화하는 엔터프라이즈급 오픈소스 도구로, 규모 있는 보안팀이 수작업으로 하던 조사를 체계화할 수 있기 때문이다.
핵심 요약
VoidAccess는 다크웹 조사 쿼리를 구조화된 위협 정보로 변환하는 자체 호스팅 가능한 오픈소스 OSINT 도구다. 16개 이상 Tor 검색 엔진, 붙여넣기 사이트, 코드 저장소, 보안 피드에서 병렬로 데이터를 수집한다. 정규식, 명명된 개체 인식(NER), 선택적 LLM을 이용해 IOC, 지갑, 자격증명, 취약점, 악성코드, 행위자 등을 추출한다. 전체 요약 12문장 읽기 → 019 21:11 당일 +190 에이전트를 위한 타입 안전 그래프 DB, Omnigraph 공개 Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 오픈소스 · 도구 · ModernRelay/omnigraph · Rust
Key Point AI 에이전트가 공유 상태를 안전하게 읽고 쓸 수 있는 데이터 계층이 필요할 때, Git 워크플로우와 정책 기반 접근 제어를 갖춘 오픈소스 솔루션이 나왔다.
핵심 요약
Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 타입 온톨로지(`.pg` 스키마로 노드·엣지 타입, 키, 제약 선언)를 통해 에이전트들이 통일된 도메인 모델을 강제할 수 있으며, 모든 쓰기에서 엔진이 검증한다. 그래프 순회, 벡터 검색(ANN), 전문 검색, 상호 순위 융합을 한 번의 쿼리로 처리하는 통합 검색 엔진으로 높은 정확도의 컨텍스트를 조립할 수 있다. 전체 요약 11문장 읽기 → 020 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 021 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 022 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 023 18:11 ▲ 15 · 댓글 2 이미지-텍스트 모델, 속성-객체 연결 약하다 비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. AI · 머신러닝 · Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Key Point CLIP, DINOv2 등 대중적인 비전-언어 모델이 기본적인 속성 구분을 못 하는 약점을 드러냈으며, 실제 멀티모달 검색 품질 개선에 직결된다.
핵심 요약
비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. 기존 벤치마크는 모달리티 쌍, 객체 개수, 속성 유형이 제한적이어서 모델의 바인딩 능력을 제대로 평가하지 못했다. 연구팀은 4가지 이미지-텍스트 모달리티 쌍, 다양한 속성 유형, 최대 10개 객체를 포함하는 SABER 벤치마크를 개발했다. 전체 요약 7문장 읽기 → 024 18:11 ▲ 47 · 댓글 2 언어모델의 숨은 의미 읽는 법: 렉시컬 참조틀 제안 언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. AI · 머신러닝 · Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
Key Point 기존 해석 기법과 달리 모델이 실제로 상태를 처리하는 방식을 따라 언어모델의 중간 계산을 읽을 수 있게 되어, 투명성·효율성·제어성이 모두 향상된다.
핵심 요약
언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. 연구팀은 각 은닉 상태가 다음 층들의 읽기 방식과 맥락에 맞춰진 '네이티브 참조틀'을 가진다고 주장한다. 렉시컬 참조틀은 모델의 남은 층들을 통해 상태를 읽되, 정해진 횟수의 위치 간 어텐션과 나머지는 전형적인 어텐션 출력으로 근사한다. 전체 요약 7문장 읽기 → 025 21:11 당일 +250 초등 교육 커리큘럼을 구조화한 오픈 데이터셋 공개 Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 오픈소스 · 도구 · withmarbleapp/os-taxonomy · JavaScript
Key Point 교육과정을 기계 판독 가능한 그래프 구조로 공개한 것은 EdTech 서비스, 학습 분석 도구, AI 튜터링 시스템 등을 만드는 개발자에게 기초 데이터로 쓸 수 있다는 점이 의미 있습니다.
핵심 요약
Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 1,590개의 '마이크로 토픽'(하나의 배울 수 있는 단위)으로 분해했으며, 각각 명확한 설명과 숙달 기준을 담았다. 3,221개의 선행 학습 의존도 간선으로 구성한 방향 무순환 그래프이며, 각 간선은 '강함/약함' 태그와 이유를 포함한다. 전체 요약 9문장 읽기 → 026 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 027 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 028 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 029 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 030 18:11 ▲ 19 · 댓글 1 초해상화, 올바른 잠재공간에서 해결하다 고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. AI · 머신러닝 · Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
Key Point DINOv3 비전 파운데이션 모델의 잠재공간이 기존 방식보다 초해상화 작업을 근본적으로 효과적으로 만드는 방법을 제시하여, 이미지 복원 파이프라인의 설계 원칙이 바뀔 수 있음을 보여준다.
핵심 요약
고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. 기존 초해상화 방법들은 재구성 지향 또는 픽셀 공간에서 작동하는데, 이 공간들에서 저화질 이미지가 다양체에서 멀리 떨어져 있어 매핑이 어렵고 비용이 크다. 의미 정보가 부족한 공간에서 작동하면 심각한 할루시네이션이 발생하며, 화질 저하가 심할수록 이 문제는 악화된다. 전체 요약 9문장 읽기 → 031 12:11 ▲ 46 · 댓글 2 멀티모달 에이전트의 메모리 진화 방식 분석 프레임워크 멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. AI · 머신러닝 · Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
Key Point 멀티모달 AI 에이전트가 실제 환경에서 장기간 지속적으로 학습하려면 시간이 지나면서 진화하는 메모리 관리 체계가 필수적이며, 이 논문이 제시하는 분석 프레임워크는 현재 에이전트 시스템의 메모리 설계 방향을 제시한다.
핵심 요약
멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. 논문은 멀티모달 에이전트 메모리를 두 축으로 분석하는 프레임워크를 제안한다: 축1(Formation과 Representation)은 정보가 어떻게 형성되고 표현되는지, 축2(Memory Management)는 축적된 경험으로 어떻게 적응하는지를 다룬다. 축1에서는 어떤 정보를 유지하고 양식별 임베딩·텍스트 및 구조화된 기록·잠재 및 매개변수 표현으로 어떻게 인코딩하는지를 규명해 이후 추론과 행동을 지원한다. 전체 요약 6문장 읽기 → 032 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 033 12:11 새 버전 Ollama 0.40.4, 터미널에서 의사결정 모델 직접 실행 Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. AI · 머신러닝 · ollama/ollama@v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
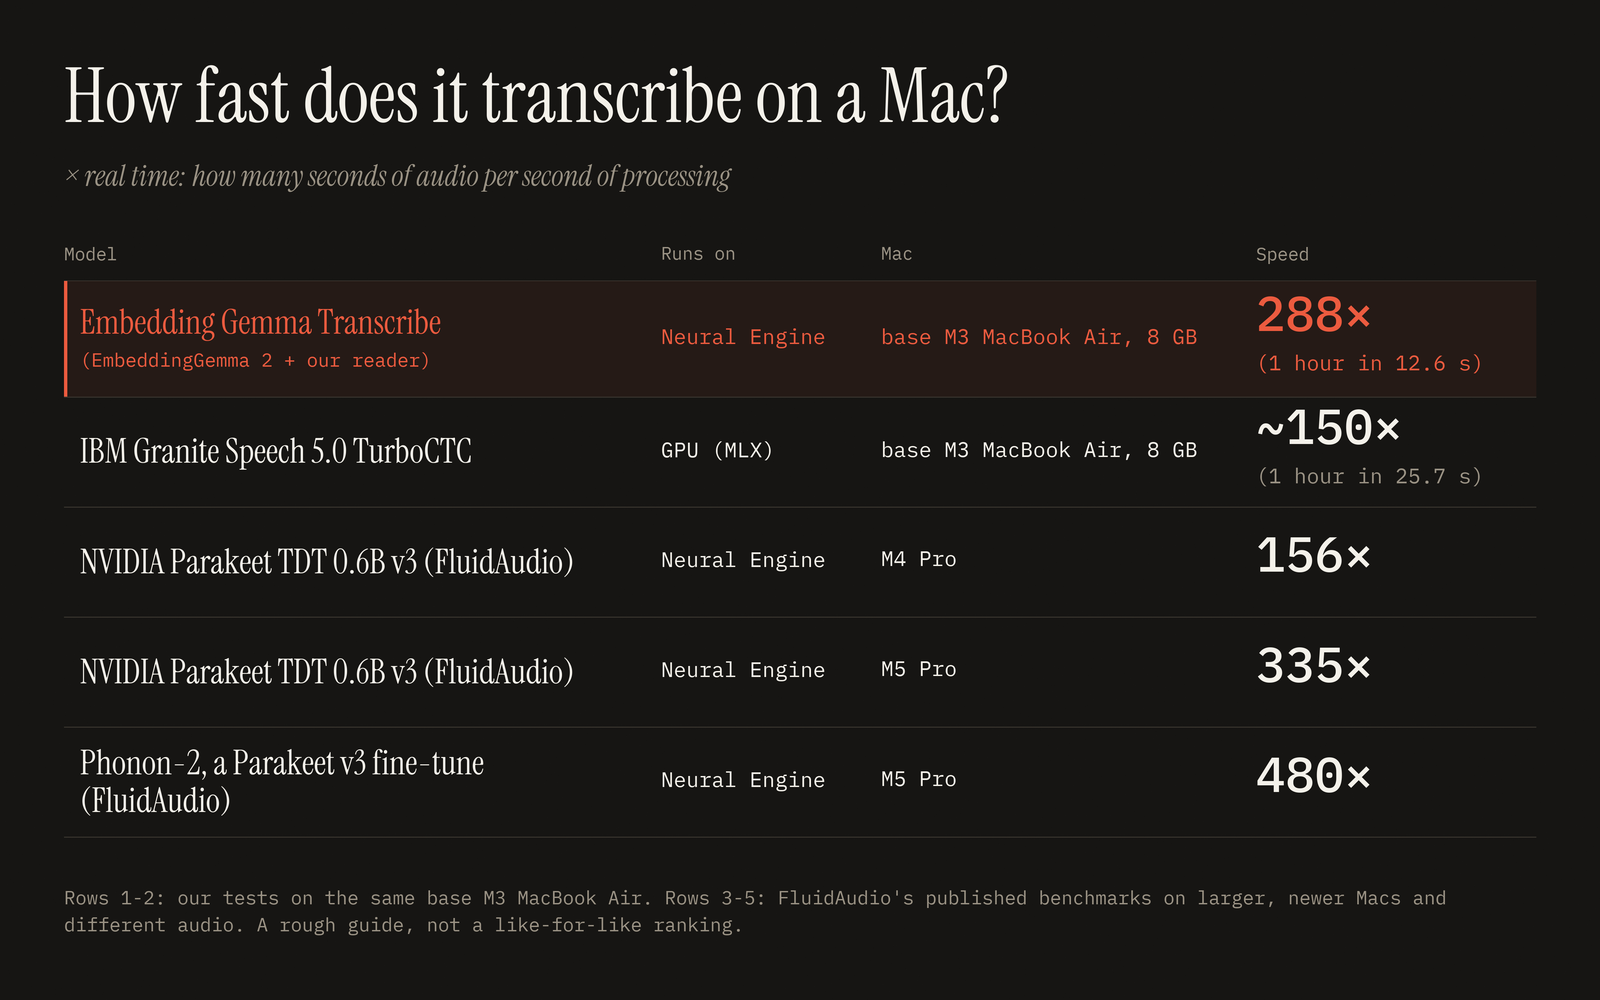
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → 034 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 035 21:12 당일 +131 Rust로 만든 고성능 AI 코딩 에이전트 jcode 공개 GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. AI · 머신러닝 · 1jehuang/jcode · Rust
Key Point 메모리 사용량을 1/10 이하로 줄이고 응답 속도를 200배 이상 개선한 오픈소스 AI 에이전트가 나왔으므로, 로컬 개발 환경에서 가볍게 AI 코딩 어시스턴트를 운영하거나 대규모 멀티에이전트 시스템을 구축하려는 개발팀에게 중요한 선택지가 될 수 있다.
핵심 요약
GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. 단일 세션 메모리 사용량은 27.8MB(임베딩 비활성화)부터 167.1MB(활성화)로, Claude Code 386.6MB 대비 약 2~14배 적으며, 10개 세션 병렬 실행 시에도 260.8MB로 경쟁 제품 대비 압도적이다. 부팅부터 첫 프레임까지 14.0ms, 첫 입력까지 48.7ms로 다른 도구(Claude Code 3436.9ms)의 1/200~1/70 수준의 극도로 빠른 응답성을 제공한다. 전체 요약 10문장 읽기 → 036 21:11 당일 +333 마이크로소프트, 1비트 LLM 추론 프레임워크 공개 마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. AI · 머신러닝 · microsoft/BitNet · C++
Key Point CPU만으로 초대형 언어 모델을 실용적 속도로 실행할 수 있게 되면서, 엣지 디바이스와 로컬 환경에서의 LLM 배포 방식이 근본적으로 바뀔 수 있다.
핵심 요약
마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. x86 CPU에서 2.37~6.17배 속도 향상, ARM CPU에서 1.37~5.07배 향상을 달성하며 에너지 소비는 x86에서 71.9~82.2%, ARM에서 55.4~70.0% 감소한다. 100B 파라미터의 BitNet b1.58 모델을 단일 CPU에서 초당 5~7 토큰 속도로 실행 가능하다. 전체 요약 11문장 읽기 → 037 15:11 새 버전 Ollama v0.40.3 릴리스, 배경 업그레이드 중단으로 성능 개선 Ollama v0.40.3에서 Claude 커넥터 관련 경고 메시지를 제거했다. 오픈소스 · 도구 · ollama/ollama@v0.40.3
Key Point 백그라운드 모델 업그레이드 중단으로 고부하 상황에서 요청 처리 성능이 개선되며, 불필요한 경고 메시지 제거로 사용자 경험이 간단해진다.
핵심 요약
Ollama v0.40.3에서 Claude 커넥터 관련 경고 메시지를 제거했다. Codex 실행 시 서비스 티어 경고도 함께 없앴다. 고정확 사용(임베딩 등)에서 모든 요청에 오버헤드를 발생시키던 백그라운드 모델 업그레이드 기능을 일시 중지했다. 038 21:11 ▲ 39 · 댓글 6 언어모델의 불확실성을 해석 가능하게 측정하는 'U-Space' 제안 대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. AI · 머신러닝 · U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Key Point 언어모델이 제시하는 답변의 신뢰도를 판단하고 잘못된 결론을 피해야 하는 상황에서, 해석 가능한 불확실성 측정 방법이 제시됨에 따라 모델 신뢰성 평가 방식이 달라질 수 있다.
핵심 요약
대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. 기존 불확실성 정량화 방법은 반복 생성이나 별도 학습이 필요하고, 불확실성이 어디서 발생하는지 보여주지 못한다. 생성 길이가 불확실성 추정과 정답률과 강하게 연관되어 있어서, 추정기가 불확실성 정보인지 단순히 길이 정보인지 구분하기 어렵다. 전체 요약 8문장 읽기 → 039 06:11 ▲ 341 · 댓글 79 16.9MB 경량 음성인식 모델 Whistle 공개 Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. AI · 머신러닝 · Whistle: Speech to Text in 16.9 MB
Key Point 극도로 경량화한 음성인식 모델로 온디바이스 처리가 가능해져, 엣지 환경에서 사용할 수 있는 선택지가 생겼다.
핵심 요약
Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. Whistle은 16.9MB 단일 파일로, CPU에서 의존성 없이 작동하며 기존 Needle 엔진과 같은 C++ 컨테이너에서 동작한다. 7개 언어(영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 네덜란드어, 폴란드어) 지원하며, 최대 30초 음성을 온디바이스에서 처리한다. 전체 요약 12문장 읽기 → 040 21:11 당일 +144 도커의 AI 에이전트 런타임 오픈소스 공개 Docker가 AI 에이전트 구축 및 실행 도구인 docker-agent를 오픈소스로 공개했다. AI · 머신러닝 · docker/docker-agent · Go
Key Point AI 에이전트를 YAML로 선언적으로 정의하고 실행하는 도구가 등장해, 복잡한 멀티에이전트 시스템을 코드 없이 구축할 수 있게 되었다.
핵심 요약
Docker가 AI 에이전트 구축 및 실행 도구인 docker-agent를 오픈소스로 공개했다. YAML 설정 파일만으로 코드 없이 AI 에이전트를 정의하고 실행할 수 있으며, docker CLI 플러그인으로 `docker agent` 명령으로 사용한다. 다중 에이전트 아키텍처를 지원해 여러 전문화된 에이전트가 자동으로 작업을 분배하고 협력하며 복잡한 문제를 해결할 수 있다. 전체 요약 10문장 읽기 → 041 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 042 18:30 ▲ 233 · 댓글 109 Docker, YAML로 AI 에이전트 만드는 도구 공개 Docker가 AI 에이전트를 선언형 YAML 설정으로 만들고 실행할 수 있는 Docker Agent를 공개했다. AI · 머신러닝 · Docker Agent
Key Point 멀티 에이전트 협업과 다양한 AI 모델을 YAML 하나로 관리하면서 패키징·배포할 수 있어, AI 에이전트 개발의 진입장벽을 크게 낮춘다.
핵심 요약
Docker가 AI 에이전트를 선언형 YAML 설정으로 만들고 실행할 수 있는 Docker Agent를 공개했다. Docker CLI 플러그인으로 제공되며 코드 작성 없이 에이전트 정의, 도구 할당, 실행이 가능하다. 여러 전문화된 에이전트가 작업을 자동으로 위임하는 멀티 에이전트 아키텍처를 지원한다. 전체 요약 11문장 읽기 → 043 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 044 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 045 18:35 ▲ 11 · 댓글 2 긴 영상 이해하는 비전-언어 모델, 메모리 효율을 10%로 줄이다 비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. AI · 머신러닝 · KeyRec: Bounded Visual Memory for Streaming and Long-Video Understanding
Key Point 비전-언어 모델의 장시간 영상 처리 비용을 10%로 줄이면서 성능을 유지하는 방식으로, 실시간 스트리밍과 긴 영상 분석 작업의 실용성을 크게 높인다.
핵심 요약
비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. 기존의 훈련 없는 토큰 선택 방식은 정보성 있는 토큰만 남기지만, 사건의 일관된 증거를 잃고 최근 세부 관찰과 장기 히스토리를 구분하지 못한다. KeyRec은 제한된 시각 메모리를 구성하는 훈련 없는 프레임워크로, 최근 관찰은 시각 캐시에 세밀하게 보존하고 과거 증거는 구조화된 사건 은행으로 조직한다. 전체 요약 8문장 읽기 → 046 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 047 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 048 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 049 03:11 ▲ 11 · 댓글 2 논문 검색 벤치마크 ScholarCatalyst 공개 Hugging Face에서 논문 검색 벤치마크 ScholarCatalyst를 발표했다. 과학자들이 새로운 연구를 할 때 어떤 선행 논문을 참고하는지 연구하기 위해 만들어졌다. AI · 머신러닝 · ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research
Key Point 현재의 LLM과 에이전트 기술도 논문 검색에서 전문가 수준의 성능을 내지 못하고 있으며, 이는 과학 AI 모델 개발의 새로운 과제를 드러낸다.
핵심 요약
Hugging Face에서 논문 검색 벤치마크 ScholarCatalyst를 발표했다. 과학자들이 새로운 연구를 할 때 어떤 선행 논문을 참고하는지 연구하기 위해 만들어졌다. 컴퓨터과학 분야 최근 논문 207편의 제1저자 184명이 자신의 프로젝트를 진행할 때 도움이 된 논문들을 직접 라벨링했으며, 각각 상세한 근거를 제공했다. 과제 시작 당시 공개된 논문만 사용해 주어진 연구 질문으로부터 도움이 될 만한 논문을 검색하는 태스크로 구성했다. 전체 요약 6문장 읽기 → 050 15:11 ▲ 120 · 댓글 66 에이전트가 필요한 건 기억력이 아니라 문서 기존 메모리 플러그인은 대화 내용을 스니펫으로 쪼개 벡터 데이터베이스에 저장했다가 프롬프트마다 유사도로 상위 5개를 주입하는 RAG 방식으로 동작하고 있다. AI · 머신러닝 · Agents don't need memory, they need documentation
Key Point 메모리 플러그인의 RAG 방식은 상사 검색의 한계·문맥 손실·코드 변화 추적 불능 등 근본적 결함을 안고 있으며, 문서 기반 메모리로 전환하면 에이전트의 맥락 이해도와 투명성을 동시에 높일 수 있다.
핵심 요약
기존 메모리 플러그인은 대화 내용을 스니펫으로 쪼개 벡터 데이터베이스에 저장했다가 프롬프트마다 유사도로 상위 5개를 주입하는 RAG 방식으로 동작하고 있다. 유사도 검색은 정확성·최신성·누락된 정보를 파악할 수 없고, 스니펫은 문맥을 잃으며, 매일 변하는 코드베이스에서 기록된 정보는 빠르게 구식이 되며, 에이전트는 무엇을 모르는지 알 수 없어 검색 도구를 제대로 사용하지 못한다. 또한 수천 개의 임베딩이 저장되면 어떤 기억이 활용되고 있는지, 어떤 기억이 오래되었거나 잘못되었는지 감시할 수 없는 감사 불가능의 문제가 있다. 전체 요약 8문장 읽기 → 051 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 052 09:11 ▲ 19 · 댓글 2 텍스트 손실 없이 멀티모달 임베딩 통합하는 경량 모델 기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. AI · 머신러닝 · Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
Key Point 기존 멀티모달 모델의 텍스트 성능 저하 문제를 해결하면서 매우 경량화한 기술로, 실제 프로덕션 배포에서 비용과 메모리 효율성이 크게 개선된다.
핵심 요약
기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. Omni-Embed-Mini는 0.9B 파라미터로 텍스트, 음성, 오디오, 이미지, 비디오, 문서를 단일 임베딩 공간에 매핑하면서 텍스트 파라미터는 고정해 손실을 방지한다. 핵심은 별도의 교사 모델 없이 각 미디어 샘플을 밀집 캐스케이딩 캡션과 쌍으로 만들고, 교사 신호는 고정된 백본의 캡션 임베딩을 그대로 사용한다는 것이다. 전체 요약 8문장 읽기 → 053 06:11 ▲ 10 · 댓글 2 쿼리의 의미를 먼저 파악해 최적 LLM 선택 기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. AI · 머신러닝 · SeLMRoute: Probabilistic Semantic Evidence for Large Language Model Routing
Key Point LLM 라우팅 결정에 의미론적 근거를 명확히 도입해 해석 가능성을 높이면서 성능을 기존 방식 대비 3% 이상 향상시킨 새로운 접근법이기 때문이다.
핵심 요약
기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. SeLMRoute는 의미론적 증거 추출, 모델 성능 학습, 배포 목표 적용을 분리하는 라우팅 프레임워크를 제시한다. 의사결정 모델이 쿼리의 추론 요구도, 외부 지식 사용 여부 등 해석 가능한 질문들을 먼저 확률 분포로 평가한다. 전체 요약 9문장 읽기 → 054 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 055 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 → 056 06:11 ▲ 13 · 댓글 2 밀집 검색, 공유 vs 독립 투영 선택 기준을 이론으로 증명 Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. AI · 머신러닝 · When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
Key Point Dense retrieval 시스템에서 쿼리-문서 인코딩을 공유할지 독립적으로 설계할지 선택하는 문제에 처음으로 엄밀한 이론적 기준을 제시해, 실무 설계 결정의 근거를 제공한다.
핵심 요약
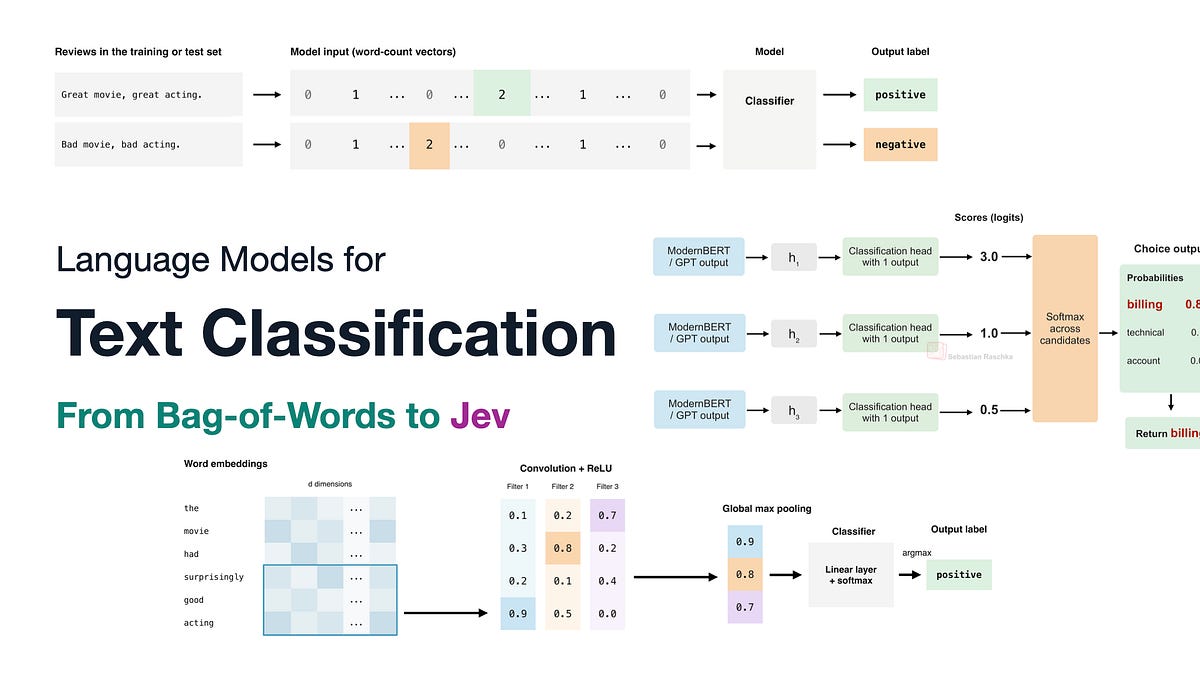
Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. 공유 투영(Shared)은 양의 준정치 연산자를 생성하고 독립 투영(Dual)은 임의의 저차원 연산자를 실현하는 구조적 차이가 있다. 정확한 근사 오차를 유도했으며, 제곱 방향신호가 추가 자유도의 추정 비용을 초과할 때만 독립 투영이 더 낮은 리스크를 갖는다는 국소 가우시안 경계를 증명했다. 전체 요약 8문장 읽기 → 057 18:11 ▲ 107 · 댓글 4 텍스트 분류의 진화, Bag-of-Words부터 Jev까지 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
Key Point 15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다. RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다. 전체 요약 11문장 읽기 → 058 03:11 ▲ 28 · 댓글 1 흉부 X선 분석을 위한 문장 중심 비전-언어 모델 SentZero 흉부 X선(CXR) 이미지와 방사선 리포트를 사용한 비전-언어 사전학습이 의료 영상 이해에 유망하지만, 기존 방법들은 긴 임상 리포트를 간단한 제로샷 프롬프트로 정렬하기 어려워 작업별 미세조정에 의존한다. AI · 머신러닝 · SentZero: An Enhanced Sentence-Centric Vision-Language Pretraining for Multi-Task Zero-Shot Chest X-Ray Analysis
Key Point 방사선학 텍스트의 특성을 고려한 새로운 문장 수준 설계와 거짓 음성 완화 기법이 흉부 X선의 미세조정 없는 분석 성능을 크게 향상시킨다.
핵심 요약
흉부 X선(CXR) 이미지와 방사선 리포트를 사용한 비전-언어 사전학습이 의료 영상 이해에 유망하지만, 기존 방법들은 긴 임상 리포트를 간단한 제로샷 프롬프트로 정렬하기 어려워 작업별 미세조정에 의존한다. 최근 문장 수준 접근법이 LLM으로 추출한 임상 구문을 사용해 이를 부분적으로 개선했으나, 방사선학 텍스트의 내재적 특성을 간과하고 양성 쌍의 다양성이 제한되어 있다. 임상적으로 동등한 문장이 환자 간에 반복되면서 대조 학습에서 거짓 음성이 발생하는 문제가 있다. 전체 요약 6문장 읽기 → 059 21:11 당일 +101 AI 에이전트용 메모리 인프라 Mem0, 토큰 효율성 47% 향상 Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. AI · 머신러닝 · mem0ai/mem0 · Python
Key Point AI 에이전트가 사용자 정보를 효과적으로 기억하고 활용하는 것이 LLM 기반 서비스의 핵심인데, 이 업데이트는 토큰 비용을 유지하면서 성능을 30% 이상 끌어올렸기 때문에 생산 환경 배포를 고민하는 팀이 참고할 만하다.
핵심 요약
Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. 2026년 4월 업데이트된 새로운 메모리 알고리즘은 LoCoMo에서 71.4점에서 92.5점으로, LongMemEval에서 67.8점에서 94.4점으로 성능을 향상시켰다. 단일 LLM 호출로 동작하는 ADD-only 추출 방식을 도입해 메모리를 누적시키면서도 6.7~6.9K 토큰으로 낮은 레이턴시(0.88~1.09초)를 유지한다. 전체 요약 11문장 읽기 → 060 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 061 00:11 ▲ 13 · 댓글 2 로봇 촉각센서, 자체학습으로 표현력 높인다 로봇의 접촉 기반 섬세한 조작에 쓰이는 촉각센서는 시각에 가려진 환경에서 필수적인데, 기존에는 사전학습된 이미지 인코더와 달리 촉각 인코더는 주로 원본 신호로부터 처음 학습되어 표현력이 제한된다. AI · 머신러닝 · Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Key Point 로봇이 손으로 물체를 조작할 때 촉각센서 데이터를 얼마나 잘 해석하느냐에 따라 정밀도가 크게 달라지는데, 기존에 없던 효율적인 사전학습 방법이 나왔다.
핵심 요약
로봇의 접촉 기반 섬세한 조작에 쓰이는 촉각센서는 시각에 가려진 환경에서 필수적인데, 기존에는 사전학습된 이미지 인코더와 달리 촉각 인코더는 주로 원본 신호로부터 처음 학습되어 표현력이 제한된다. 분산 전자피부처럼 불규칙하게 배치된 촉각센서는 시각 기반 센서와 다르게 희소하고 불규칙한 구조를 가져, 기존 시각학습 방식을 직접 적용하기 어렵다. Tactile-JEPA는 센서의 공간적 배치와 연결 관계를 활용해 토폴로지 인식형 표현을 학습하는 자체지도학습 사전학습 방법이다. 전체 요약 8문장 읽기 → 062 21:11 당일 +103 AI 에이전트를 위한 오픈소스 메모리 플랫폼, Cognee 공개 Cognee는 AI 에이전트에게 세션 간 지속적인 장기 메모리를 제공하는 오픈소스 플랫폼이며, 문서·코드·대화를 자체 호스팅 지식 그래프로 변환해 검색과 재사용이 가능하다. AI · 머신러닝 · topoteretes/cognee · Python
Key Point LLM 비용 없이 로컬 소형 모델만으로 에이전트에 장기 메모리를 주는 방식이 구현되었으며, 단일 PostgreSQL로 전체 메모리 스택을 대체할 수 있다는 점이 인프라 단순화의 새로운 접근을 보여준다.
핵심 요약
Cognee는 AI 에이전트에게 세션 간 지속적인 장기 메모리를 제공하는 오픈소스 플랫폼이며, 문서·코드·대화를 자체 호스팅 지식 그래프로 변환해 검색과 재사용이 가능하다. API 키 없이 로컬에서 무료 실행되며, CPU를 사용하는 소형 모델에 의존한다. 텍스트 입수·검색·세션 저장은 LLM 없이 작동하고, 로컬 GLiNER 추출 모델과 로컬 임베딩 모델을 사용하며 첫 실행 시 자동 다운로드된다. 전체 요약 10문장 읽기 → 063 22:29 ▲ 16 · 댓글 3 토큰화 효율 높이는 기능 분해 방식 제안 기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. AI · 머신러닝 · The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
Key Point 같은 단어의 다양한 표기를 효율적으로 처리해 모델의 어휘 크기를 줄이고 코드 생성 정확도를 높이는 실질적 개선 방법이기 때문입니다.
핵심 요약
기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. 논문은 직교 및 구조 변형을 함수형 분해로 처리하는 Functionalizer를 제안한다. 대문자화(CAPITALIZE), 발음 기호(13개 전용 옵코드), 문자 반복(REPEAT, MULTIREPEAT) 등의 가역 연산자를 사용해 유니코드 개인용 영역에 인코딩한 프리픽스 스트림으로 정규 기본 토큰 앞에 붙인다. 전체 요약 6문장 읽기 → 064 15:11 ▲ 46 · 댓글 2 텍스트·이미지·영상·음성을 하나로 이해하는 멀티모달 임베딩 모델 공개 Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. AI · 머신러닝 · Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
Key Point 단일 모달리티 검색의 한계를 극복하고 텍스트-영상, 음성-텍스트 등 크로스 모달 검색이 필요한 개발자와 연구자에게 새로운 기술 선택지를 제공한다.
핵심 요약
Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. 기존의 분리된 모달리티 타워 대신 공유 멀티모달 백본을 사용해 모든 데이터를 공통 표현 공간으로 인코딩한다. Qwen-omni 사전학습 모델을 기반으로 대조 학습과 저랭크 초기화를 통해 학습했다. 전체 요약 5문장 읽기 → 065 15:11 ▲ 12 · 댓글 2 대문자와 소문자를 구분해 읽는 메모리, 문맥에 따라 다른 의미 포착 LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. AI · 머신러닝 · MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
Key Point 토큰의 다중 의미를 문맥으로 구분해 메모리 효율성과 정확도를 동시에 높이는 기법으로, 소형 언어모델 최적화와 임베딩 기술 발전에 직결됩니다.
핵심 요약
LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. 예를 들어 'python'은 프로그래밍 언어와 동물이라는 서로 다른 의미를 같은 토큰이지만 별도의 메모리 슬롯으로 저장 및 구분합니다. Llama-3, Qwen3, MobileLLM 등 여러 모델 아키텍처에서 기존 Value Embedding, Bigram, STEM 방식보다 성능이 우수했습니다. 전체 요약 5문장 읽기 → 066 21:11 당일 +1,160 AI 에이전트를 한곳에서 관리하는 제어 플레인 Nasiko 공개 Nasiko는 여러 AI 에이전트의 배포, 라우팅, 보안, 관찰을 통합 관리하는 제어 플레인 프로젝트로, A2A 프로토콜을 따르는 모든 에이전트를 지원한다. AI · 머신러닝 · Nasiko-Labs/nasiko · Rust
Key Point 여러 AI 에이전트를 프로덕션에서 운영할 때 키 관리, 권한 제어, 비용 추적 같은 복잡한 운영 문제를 한 번에 해결하는 오픈소스 플랫폼이 나왔다.
핵심 요약
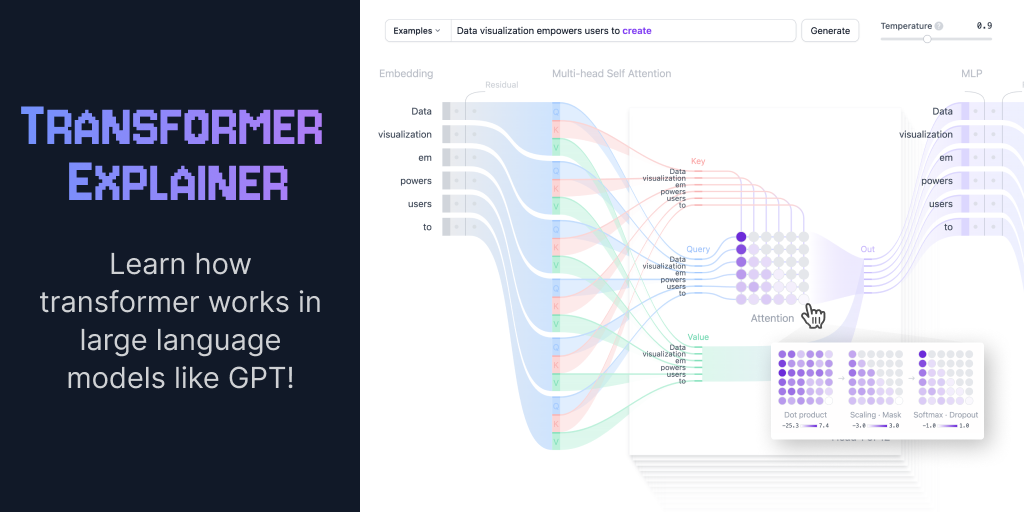
Nasiko는 여러 AI 에이전트의 배포, 라우팅, 보안, 관찰을 통합 관리하는 제어 플레인 프로젝트로, A2A 프로토콜을 따르는 모든 에이전트를 지원한다. Python, Rust, Go, TypeScript 등 어떤 언어로 만든 에이전트든 호환되며, 기존 에이전트는 공개 주소로 노출되지 않고 모든 트래픽이 중앙 프록시를 거친다. 임베딩 유사도와 대화 맥락으로 에이전트를 선택하는 3단계 라우팅, 레이트 제한·ACL·토큰 추적, Redis 기반 종료 안전 장치를 제공한다. 전체 요약 6문장 읽기 → 067 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 068 21:10 당일 +162 Go로 만든 멀티플랫폼 음악 다운로드 도구 공개 Go 기반 음악 검색·다운로드 도구로, 웹·TUI 터미널·데스크톱·모바일(Android/iOS) 앱 4가지 모드를 지원한다. 오픈소스 · 도구 · guohuiyuan/go-music-dl · Go
Key Point 음악 팬들은 여러 플랫폼에 흩어진 곡들을 한 곳에서 검색·관리할 수 있게 되며, 개발자라면 다양한 인터페이스(Web·CLI·Desktop·Mobile)로 자유롭게 활용할 수 있는 오픈소스 솔루션을 얻는다.
핵심 요약
Go 기반 음악 검색·다운로드 도구로, 웹·TUI 터미널·데스크톱·모바일(Android/iOS) 앱 4가지 모드를 지원한다. 네이버, QQ, 쿠거, 빌리빌리, 칭수이 등 10개 이상의 음악 스트리밍 플랫폼을 통합하며, 다중 출처 병렬 검색과 무손실(FLAC) 음질 다운로드가 가능하다. 단곡·플레이리스트·앨범 검색, 플레이리스트 분류 브라우징, 개인 플레이리스트 관리, 로컬 음악 파일 관리 등의 기능을 제공한다. 전체 요약 5문장 읽기 → 069 06:10 ▲ 122 · 댓글 63 캑터스 니들 3: 8~29MB 경량 모델이 DeepSeek V4 Flash 수준 성능 8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. AI · 머신러닝 · Show HN: Cactus Needle 3: 8-29MB automation models can match DeepSeek V4 Flash
Key Point 에지 기기 AI의 핵심 병목이던 모델 크기와 성능의 트레이드오프를 근본적으로 바꾸는 아키텍처로, 온디바이스 AI 구현이 현실화될 수 있음을 보여줍니다.
핵심 요약
8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. Laddered Simple Attention Networks 아키텍처로 같은 크기 트랜스포머 대비 토큰당 2배 적은 연산을 사용합니다. 4계층 모델을 파인튜닝하면 DeepSeek V4 Flash와 같은 성능을 내며, 라즈베리파이5에서 초당 400~4000토큰을 처리합니다. 전체 요약 6문장 읽기 → 070 21:11 당일 +1,173 코드베이스를 지식 그래프로 변환하는 Graphify 코드, 문서, PDF, 설정 파일 등을 쿼리 가능한 지식 그래프로 변환하는 도구로 Claude Code, Cursor 등 AI 코딩 어시스턴트에서 /graphify 명령으로 사용할 수 있다. AI · 머신러닝 · Graphify-Labs/graphify · Python
Key Point 벡터 검색 없이 실제 그래프 구조로 코드베이스를 매핑하고 추론 과정을 추적할 수 있다는 점이 기존 의미 검색 방식과 다르며, 개발자들이 AI 어시스턴트에서 직접 코드 전체 구조를 이해하는 방식을 바꿀 수 있다.
핵심 요약
코드, 문서, PDF, 설정 파일 등을 쿼리 가능한 지식 그래프로 변환하는 도구로 Claude Code, Cursor 등 AI 코딩 어시스턴트에서 /graphify 명령으로 사용할 수 있다. tree-sitter 기반 AST 파싱으로 코드는 로컬에서 결정론적으로 처리되며 LLM을 사용하지 않고 기계에서 벗어나지 않는다. 각 연결은 명시적 추출(EXTRACTED) 또는 추론(INFERRED)으로 태그되어 원본에서 직접 읽은 것과 도출된 것을 구분할 수 있다. 전체 요약 6문장 읽기 → 071 06:10 ▲ 322 · 댓글 109 로컬 개인 검색 엔진 Hister 공개 방문한 웹페이지와 보유한 파일의 전체 내용을 인덱싱해 검색할 수 있는 프라이빗 검색 엔진 Hister를 오픈소스로 공개했다. 오픈소스 · 도구 · Hister: A private search engine for the pages you visit and the files you keep
Key Point 개인이 소유한 데이터를 제3자 검색 엔진에 의존하지 않고 로컬에서 검색할 수 있는 프라이빗 대안이 필요한 사용자들에게 의미있는 선택지다.
핵심 요약
방문한 웹페이지와 보유한 파일의 전체 내용을 인덱싱해 검색할 수 있는 프라이빗 검색 엔진 Hister를 오픈소스로 공개했다. 로컬 서버에서만 동작하며 원격 클라우드 서비스나 원격 측정 기능이 없다. 브라우저 확장 프로그램으로 방문 페이지를 자동 인덱싱하고, 웹 인터페이스·터미널·AI 어시스턴트를 통해 검색할 수 있다. 전체 요약 6문장 읽기 → 072 15:10 ▲ 111 · 댓글 16 Jev처럼 작동하는 오픈소스 선택 모델 공개 TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 오픈소스 · 도구 · Reverse-engineered Jev-like model
Key Point 상용 모델의 폐쇄된 설계를 재현한 오픈소스 구현으로, 선택형 분류 작업에서 경량 모델의 새로운 가능성을 보여준다.
핵심 요약
TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 텍스트와 N개의 선택지를 입력받아 각 선택지별 확률을 한 번에 반환하는 방식으로, 단어 단위 생성이 아닌 원샷(one-pass) 추론을 수행한다. 바이트 임베딩 기본 인코더와 선택적 허깅페이스 사전학습 인코더를 지원하며, CPU·MPS·CUDA에서 학습 가능하다. 전체 요약 5문장 읽기 → 073 12:10 ▲ 104 · 댓글 39 LiteLLM의 핵심 기능만 추린 경량 라이브러리 litelm 공개 LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. AI · 머신러닝 · Litelm: LiteLLM Without the Bloat
Key Point 기존 LiteLLM의 100k+ 줄 코드 크기에 부담을 느끼거나 가벼운 LLM 통합을 원하는 개발자에게 핵심만 추린 대안을 제시한다.
핵심 요약
LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. 프록시 서버, 캐싱, 비용 추적 등 100k+ 줄의 복잡한 기능을 제거하고 모델 라우팅, 메시지 변환, 스트리밍, 도구 사용, 임베딩만 제공한다. OpenAI 호환 엔드포인트로 19개 제공자(OpenAI, Anthropic, Groq, Mistral, xAI, Azure, Bedrock 등)를 지원하며 api_base로 로컬 vLLM·Ollama·LM Studio도 연결 가능하다. 전체 요약 5문장 읽기 → 074 11:10 ▲ 120 · 댓글 43 임베딩 벡터를 쌍 데이터 없이 변환하는 방법 개발 텍스트 임베딩을 한 벡터 공간에서 다른 공간으로 옮기는 비지도 학습 방법을 제시했다. AI · 머신러닝 · Harnessing the Universal Geometry of Embeddings
Key Point 서로 다른 AI 모델의 임베딩을 통역할 수 있다는 것은 모델 간 상호운용성을 높이지만, 동시에 벡터 데이터베이스의 민감 정보 노출 위험을 직시하게 한다.
핵심 요약
텍스트 임베딩을 한 벡터 공간에서 다른 공간으로 옮기는 비지도 학습 방법을 제시했다. 쌍 데이터, 인코더, 미리 정의된 매치 없이 범용 잠재 표현(Platonic Representation Hypothesis)으로 변환한다. 서로 다른 아키텍처·파라미터 크기·학습 데이터를 가진 모델 간에도 높은 코사인 유사도를 달성한다. 전체 요약 4문장 읽기 → 075 20:31 당일 +132 Unsloth, 로컬에서 LLM과 확산 모델 학습할 수 있는 데스크톱 앱 공개 로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. AI · 머신러닝 · unslothai/unsloth · Python
Key Point 로컬 AI 모델 실행·학습을 간편하게 만드는 도구로서 개발자가 클라우드 비용 없이 자체 서버에서 LLM을 운영할 수 있게 해주는 점이 주목받고 있다.
핵심 요약
로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. 미세조정 시 학습 속도를 2배 빠르게 하면서 VRAM 사용량을 70% 줄일 수 있고 LoRA, QLoRA, GRPO, DPO 등 다양한 훈련 방식을 지원한다. Tauri 기반 데스크톱 앱으로 제공되며 Windows, macOS, Linux 등 여러 플랫폼을 지원하고 Cloudflare를 통한 원격 접근도 가능하다.