시뮬레이션으로 보는 강화학습, 4개 뉴런 생명체가 빛을 찾다
원제 A visual explanation of reinforcement learning
112 포인트댓글 6
Key Point
강화학습의 원리를 직관적으로 이해할 수 있는 인터랙티브 시각화로, 단순한 신경회로에서 출발해 복잡한 생물학적 뇌의 학습 방식까지 설명한다.
핵심 요약
- 뇌에 4개 뉴런을 가진 가상의 생물 '스파크'가 강화학습으로 빛을 따라가는 행동을 학습하는 과정을 시각화한 글이다.
- 스파크의 뇌는 눈 역할을 하는 2개 뉴런과 지느러미를 움직이는 2개 뉴런으로 구성되며, 동측 연결, 교차 연결, 구동력 등 3가지 파라미터로 신경회로가 결정된다.
- 사용자가 슬라이더를 조정해 스파크의 뇌를 직접 배선한 뒤, 이 과정을 알고리즘으로 자동화한다: 매 시행마다 뇌 배선을 무작위로 변화시키고, 성과가 좋으면 그 방향으로 조정하고 나쁘면 반대로 조정한다.
- 초기 스파크는 50회 시행 후 움직이기 시작하고, 500회 후 과감히 빛을 향해 달려가며, 2000회 후 전문가 수준으로 빛을 따라다니고 정밀하게 선회한다.
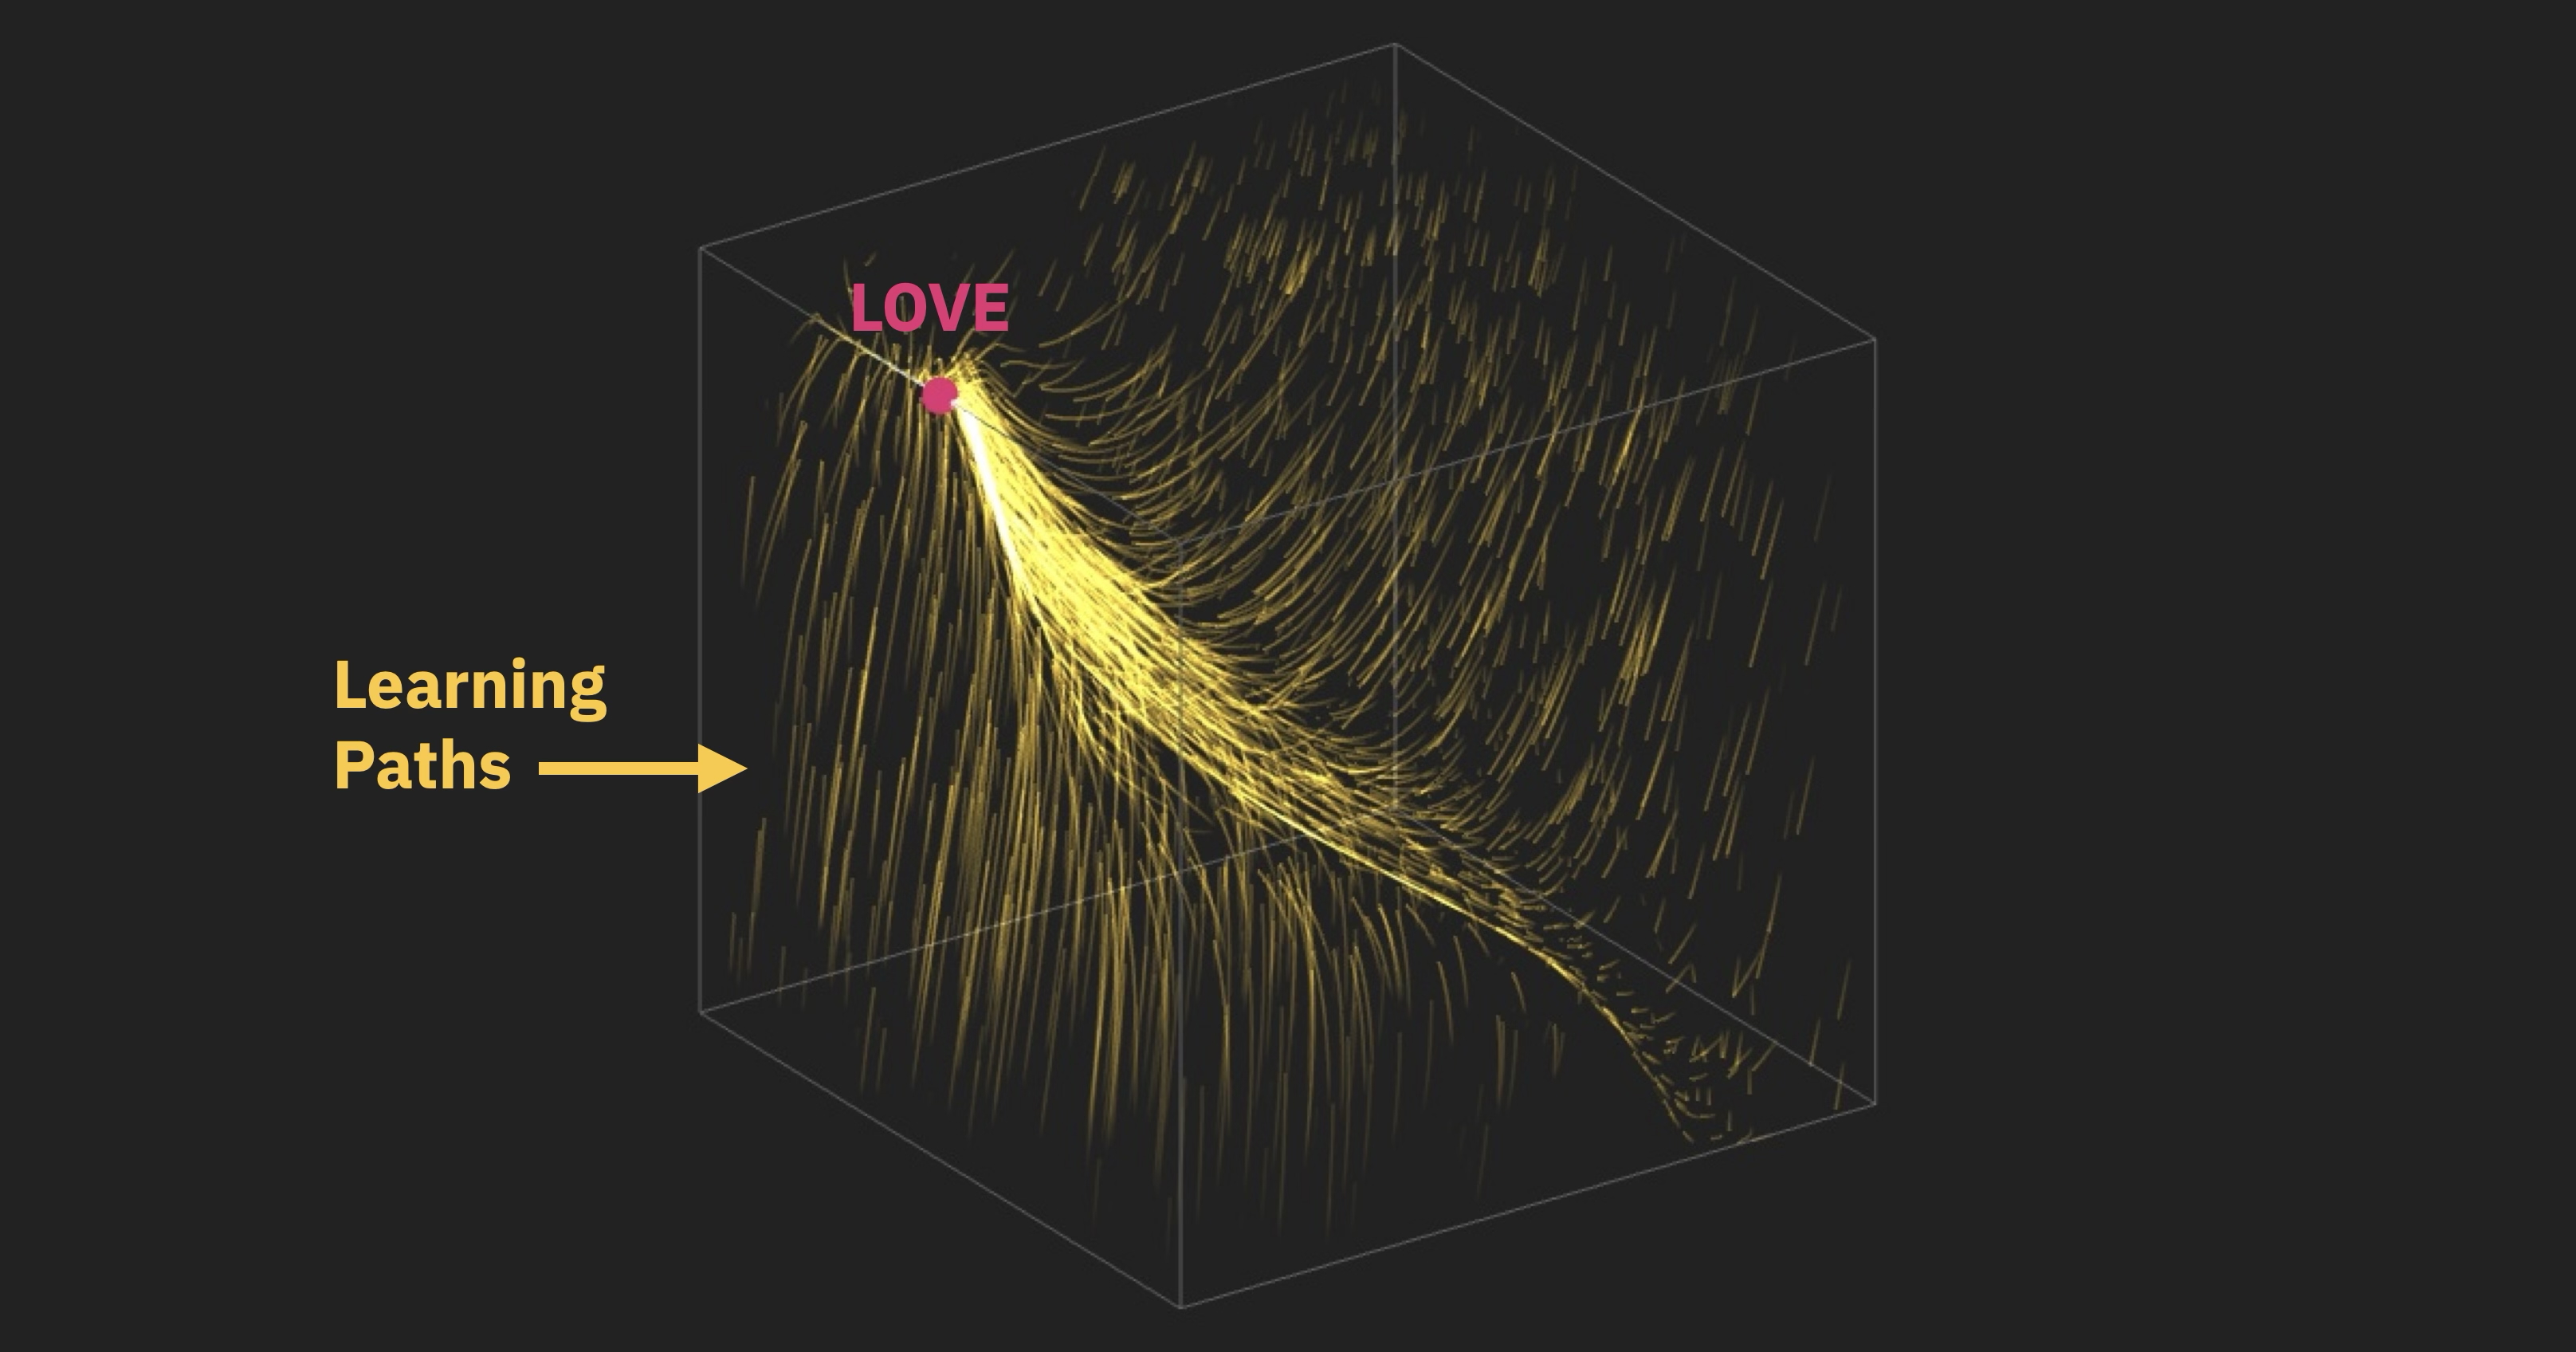
- 학습 과정을 3차원 공간의 경로로 시각화하면, 무수히 다른 초기 상태에서 시작한 스파크들의 학습 궤적이 모두 같은 목표점(♥︎)으로 수렴한다.
- 학습은 선형적이지 않으며 좌절과 실수를 거치고, 일부 개체는 목표 달성에 수천 번의 시행이 필요하다.
- 보상 시스템을 바꾸면 스파크는 새로운 행동을 학습한다: 빛이 해로우면 회피하거나 정지하고, 고속 접근이 보상이면 공격한다.
- 생물학적 뇌도 강화학습으로 학습한다: 새끼 새들은 울음을 시행착오로 배우며, 성인의 울음에 가까워지면 도파민이 증가하고 멀어지면 감소해 보상과 처벌이 학습을 안내한다.
- 인간의 뇌는 약 860억 개 뉴런과 100조 개 이상의 연결을 가지므로 복잡하지만, 근본 원리는 같다: 학습은 광대한 내부 공간을 네비게이션하는 과정이고 피드백이 나침반 역할을 한다.
- 스파크는 1992년 로널드 윌리엄스의 REINFORCE 알고리즘을 바탕으로 학습하며, 매 시행마다 파라미터를 무작위로 변화시키고 보상을 비교해 파라미터를 조정한다.
- 가중치 교란(weight perturbation) 방식을 사용하며, 유사한 아이디어인 진화 전략은 OpenAI가 2017년 에이터리 게임 학습에 활용했다.