쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "도메인"조건 지우기 ×
001 06:11 ▲ 104 · 댓글 18 NVIDIA의 NVL72 시스템, 올바른 스케줄러로 GPU 활용률 27% 향상 InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. 인프라 · 데브옵스 · Grace Blackwell needs a new scheduler: 27% more usable GPUs from the same racks
Key Point NVL72 같은 랙 규모 시스템에서 통신 병목을 피하려면 하드웨어만으로는 부족하고, 올바른 스케줄링이 처리량을 14% 이상 개선할 수 있다.
핵심 요약
InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. NVIDIA의 NVL72 시스템은 한 랙의 72개 GPU를 통합 NVLink 패브릭으로 연결하면서 멀티 노드 AI 워크로드를 고대역폭으로 처리할 수 있게 했다. 대규모 학습에서 텐서 병렬화와 전문가 병렬화는 통신 병목이 되는데, 64웨이 전문가 병렬화를 사용하면 InfiniBand에서 학습 시간의 최대 60%가 통신에 소비된다. 전체 요약 13문장 읽기 → 002 21:11 ▲ 18 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 003 21:11 ▲ 110 · 댓글 19 논리 버그만으로 엣지 전체 체인 공략, 16만 5천 달러 획득 Orange Tsai 연구원이 Pwn2Own Berlin 2026에서 논리 버그 5개와 Windows 기능 2개를 조합해 Microsoft Edge 풀 체인을 완성하고 17만 5천 달러와 17.5 Master of Pwn 포인트를 획득했다. 보안 · Forging a Microsoft Edge Full Chain with Logic Bugs Only
Key Point 메모리 손상 없이 순수 논리 버그만으로 현대 브라우저의 완전한 권한 상승 체인을 구축한 사례로, 브라우저 보안의 새로운 취약점 면(Navigation Throttles, UXSS 프리미티브, 프로토콜 핸들러 재설정)을 시연했다.
핵심 요약
Orange Tsai 연구원이 Pwn2Own Berlin 2026에서 논리 버그 5개와 Windows 기능 2개를 조합해 Microsoft Edge 풀 체인을 완성하고 17만 5천 달러와 17.5 Master of Pwn 포인트를 획득했다. Navigation Throttles는 브라우저 프로세스에서 모든 네비게이션을 가로채는데, Edge의 EdgeCAGuidanceNavigationThrottle은 회사 계정 로그인 시 사용자를 올바른 프로필로 안내하기 위해 설계되었다. 이 throttle은 login.live.com 같은 Microsoft 도메인에서만 발동되도록 제한되지만, GetLastCommittedURL()로 검증하면서 크로스 윈도우 네비게이션을 간과해 window.open()으로 우회 가능하다. 전체 요약 11문장 읽기 → 004 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 005 06:11 ▲ 11 · 댓글 2 AI 에이전트가 자신의 개선 방법을 스스로 최적화한다 언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. AI · 머신러닝 · Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
Key Point AI 에이전트가 문제 해결 방법 자체를 자동으로 개선할 수 있는 체계가 나왔으며, 이는 AGI로 향하는 재귀적 자기개선의 실질적 구현 사례다.
핵심 요약
언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. Skill^∞는 메타 에이전트가 메타스킬을 따라 작업 스킬을 최적화하고, 동일한 절차로 메타스킬 자신도 최적화하는 재귀적 자기개선(RSI) 방식을 제시한다. 최적화 과정은 에이전트가 주도하며, 실행 추적을 진단하고 후보를 제안하며 독립적 검토를 요청하고 탐색 예산을 배분하는 단계들을 정의한다. 전체 요약 6문장 읽기 → 006 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 007 03:11 ▲ 11 · 댓글 2 실제 업무 환경에서 에이전트 능력을 측정하는 벤치마크 공개 CRM(고객관계관리) 작업을 통해 언어 모델 에이전트의 실무 역량을 평가하는 벤치마크 'CRM-Agent-Bench'를 공개했다. AI · 머신러닝 · CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments
Key Point 실제 비즈니스 환경에서 언어 모델 에이전트의 신뢰성을 평가하는 방식이 바뀌고 있으며, 정책 준수와 운영 비용을 함께 측정하는 기준이 필요한 상황이기 때문이다.
핵심 요약
CRM(고객관계관리) 작업을 통해 언어 모델 에이전트의 실무 역량을 평가하는 벤치마크 'CRM-Agent-Bench'를 공개했다. 555개의 상태 변화 멀티턴 작업을 9개 비즈니스 도메인과 36개 능력 태그로 구성해 실제 운영 환경을 모사한다. 각 작업마다 실행 가능한 계약을 제공하며, 이는 액션·인수·순서·응답·목표 상태·보호된 상태에 대한 검사 항목들로 이루어진다. 전체 요약 6문장 읽기 → 008 21:11 ▲ 14 · 댓글 2 주의력 레이어에 희소성 더하는 Nestor 모델 제안 현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. AI · 머신러닝 · Nested Sparsity for Scalable Pretraining and Continual Learning
Key Point 조건부 계산의 새로운 메커니즘이 기존 MoE 모델의 학습 효율과 연속 학습 능력을 동시에 개선하는 구체적인 방법을 제시하고 있습니다.
핵심 요약
현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. 이 논문은 주의력 연산자를 일반화한 대안적 조건부 계산 메커니즘을 제안하며, 이는 MoE 희소성과 계층적으로 결합되는 '중첩 희소성'을 만든다. Nestor라 명명한 이 모델은 동일한 계산량과 희소성에서 기존 MoE 트랜스포머보다 언어 모델 사전학습에서 더 나은 성능을 보인다. 전체 요약 6문장 읽기 → 009 12:11 ▲ 90 · 댓글 7 LLM 에이전트는 사용자 습관을 제대로 학습하지 못한다 장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. AI · 머신러닝 · HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
Key Point LLM 에이전트의 메모리 시스템이 사용자 습관 추론에서 근본적인 한계를 드러냈으며, 현재 방법들의 약 67%가 습관을 잘못 적용한다는 의미다.
핵심 요약
장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. 개별 관찰만으로는 습관의 부분적 증거만 제공할 수 있고, 과거 상호작용 기록만으로는 습관 추론과 적용을 보장하지 못한다. HABIT-Bench는 에이전트 메모리 시스템이 약한 증거에서 습관을 추론하고 이후 요청에 적용하는 능력을 평가하는 벤치마크다. 전체 요약 8문장 읽기 → 010 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 011 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 012 18:11 ▲ 52 · 댓글 2 LLM 에이전트의 지속 학습 능력을 측정하는 벤치마크 CLE 공개 지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. AI · 머신러닝 · Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
Key Point LLM이 점진적 경험 누적으로 실제 직무를 수행할 수 있는지 평가하는 새로운 방식이 나왔고, 현존 모델의 이러한 능력이 절반 수준에 불과하다는 객관적 지표를 제시한다.
핵심 요약
지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. 허깅페이스와 도메인 전문가 50명이 개발한 CLE는 120개의 인간 저작 과제로 구성되며, 각 과제는 5단계 계단식 구조여서 총 600개 레벨, 12개 직업 도메인 89개 전문 역할에 걸쳐 있다. 에이전트는 각 레벨을 통과해야 다음 레벨을 해제할 수 있고, 뒤의 과제들은 이전 과제에서 축적한 경험에 기반한다. 전체 요약 7문장 읽기 → 013 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 014 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 015 15:11 ▲ 21 · 댓글 2 AI가 자동으로 만드는 평가 벤치마크, 근데 효과는? AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. AI · 머신러닝 · EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?
Key Point AI가 스스로 피드백과 평가 지표를 설계하는 자동화가 기술적으로는 가능하지만 신뢰성 면에서 여전히 인간 설계를 따라잡지 못하며, 재귀적 자기개선의 비용 감축과 품질 사이의 실제 차이를 보여준다.
핵심 요약
AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. 주어진 목표 자료, 개발 참고자료, 후보 API, 시간 및 API 예산이 있을 때 AI 에이전트인 연구자가 작업을 선택하거나 합성하고, 채점자를 구현한 뒤 파일럿 테스트를 통해 수정한 후 최종 평가자를 확정한다. 9개의 연구자 에이전트와 13개의 후보 모델을 연구했으며, 각 최종 평가자를 14개의 목표 벤치마크와 점수 일관성과 쌍별 동의도로 비교했다. 전체 요약 7문장 읽기 → 016 12:11 ▲ 224 · 댓글 185 AI가 이전 불가능했던 소프트웨어를 현실로 만든다 AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. AI · 머신러닝 · We should be more ambitious with the software we build
Key Point AI 모델의 성능 급증으로 불가능했던 소프트웨어 개발이 현실화되는 한편, 누가, 어떤 조건에서 이를 활용할 수 있는지가 핵심 관심사다.
핵심 요약
AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. PostgreSQL을 Rust로 재작성하는 pgrust 프로젝트는 철저한 테스트 과정에서 PostgreSQL 내 수치 버그, JSONPath 포맷 캐시 버그, 메모리 안전 버그 등 여러 실제 버그를 발견했으며, 성능 최적화에 초점을 맞추고 있다. 저자는 정규표현식 엔진, ripgrep 포크, Rust 컴파일 속도 개선 도구 등을 몇 시간 내에 구현했는데, 5년 전이라면 1년 이상 걸렸을 작업들이다. 전체 요약 10문장 읽기 → 017 09:11 ▲ 101 · 댓글 64 미국 핵전력 긴급명령 신호, 공개 기록으로 접근 미국 핵전력이 11175 kHz 라디오 주파수로 송신하는 긴급명령 메시지(Emergency Action Messages)를 녹음하고 해석한 데이터를 공개 기록으로 제공하는 사이트이다. 보안 · Listen and read USA nuclear forces Emergency Action Messages, heard on 11175 kHz
Key Point 미국 핵전력 통신 체계의 작동 원리와 신호를 누구나 접근 가능하게 공개한 것으로, 핵 안보 투명성과 감시 문화의 경계에 놓인 기술 프로젝트이다.
핵심 요약
미국 핵전력이 11175 kHz 라디오 주파수로 송신하는 긴급명령 메시지(Emergency Action Messages)를 녹음하고 해석한 데이터를 공개 기록으로 제공하는 사이트이다. 제공되는 데이터는 표본 데이터이며 실제 운영 트래픽이 아니다. 사이트는 추적 쿠키를 사용하지 않으며, 선택적 로그인은 세션 유지 용도의 쿠키만 설정한다. 전체 요약 7문장 읽기 → 018 21:11 당일 +202 컨테이너 없이 프로세스 샌드박싱하는 경량 도구 공개 Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. 인프라 · 데브옵스 · anthropics/sandbox-runtime · TypeScript
Key Point 컨테이너의 오버헤드 없이 OS 원시 기능으로 AI 에이전트와 로컬 도구를 안전하게 격리하려는 개발자들에게 필요한 인프라가 등장했다.
핵심 요약
Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. macOS는 sandbox-exec과 Seatbelt 프로필을, Linux는 bubblewrap을 사용해 격리를 구현하고, Windows는 전용 사용자 계정과 WFP 필터로 제약을 적용한다. 네트워크는 기본적으로 모두 차단되며, allowedDomains/deniedDomains로 명시적으로 허용하는 방식을 사용한다. 파일 읽기는 기본 허용이고 denyRead/allowRead로 제어하며, 쓰기는 기본 차단이고 allowWrite로만 허용한다. 전체 요약 11문장 읽기 → 019 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 020 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 021 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 022 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 023 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 024 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 025 03:11 ▲ 439 · 댓글 149 Quad9, 프랑스 법원 판결에 11월 24일 서비스 중단 스위스 비영리 DNS 리졸버 서비스인 Quad9가 11월 24일부터 프랑스 사용자에게 서비스를 제공하지 않기로 결정했다. 보안 · Quad9 (DNS Resolver) to Exit France
Key Point DNS 리졸버라는 인터넷 기반 인프라가 국가 판결에 의해 차단되는 선례가 생기고 있으며, 이는 사용자 프라이버시와 인터넷 중립성의 원칙에 부딪히는 글로벌 이슈로 확대될 수 있다.
핵심 요약
스위스 비영리 DNS 리졸버 서비스인 Quad9가 11월 24일부터 프랑스 사용자에게 서비스를 제공하지 않기로 결정했다. 프랑스 법원이 스포츠 중계 저작권 문제를 이유로 특정 도메인의 DNS 해석을 차단하도록 명령했으며, Quad9가 이를 거부하면 1일 1,000유로의 벌금을 부과하기로 했다(기존 1일 580,000유로에서 인하). Quad9는 DNS 리졸버가 중립적 인프라이며, 사용자 식별 없이 무료 서비스를 제공하는 자신들의 원칙을 유지하면서 프랑스 법원 명령을 이행할 수 없다고 주장한다. 전체 요약 10문장 읽기 → 026 00:11 당일 +136 자신의 서버에서 앱을 배포하는 오픈소스 PaaS, Coolify Coolify는 Heroku, Netlify, Vercel의 오픈소스 대안으로 자신의 서버에서 애플리케이션, 데이터베이스, 서비스를 배포할 수 있는 PaaS 플랫폼이다. 인프라 · 데브옵스 · coollabsio/coolify · PHP
Key Point 클라우드 플랫폼의 비용 부담과 벤더 락인을 피하고 인프라 완전 제어를 원하는 개발팀과 운영팀이 고려할 만한 오픈소스 배포 솔루션이다.
핵심 요약
Coolify는 Heroku, Netlify, Vercel의 오픈소스 대안으로 자신의 서버에서 애플리케이션, 데이터베이스, 서비스를 배포할 수 있는 PaaS 플랫폼이다. SSH 연결이 있는 모든 서버에서 작동하며, VPS, 베어메탈 서버, 라즈베리파이 등 어디서나 설치 가능하다. GitHub, GitLab, Bitbucket, Gitea에서 빌드할 수 있고, Nixpacks, Railpack, Dockerfile, Docker Compose, 미리 빌드된 Docker 이미지를 지원한다. 전체 요약 11문장 읽기 → 027 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 028 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 029 15:11 ▲ 88 · 댓글 2 컴퓨터 사용 AI 에이전트, 오픈소스로 학습 환경 대규모 생성 Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. AI · 머신러닝 · Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
Key Point 컴퓨터 상호작용을 수행하는 AI 에이전트 학습이 실제 환경의 안전 위험 없이 대규모로 가능해지는 방법이 제시되었고, 오픈소스만으로 구축 가능함을 입증했다.
핵심 요약
Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. 기존 단일 인터페이스 접근과 달리, 그래픽 사용자 인터페이스·모델 컨텍스트 프로토콜 서비스·커맨드 라인 인터페이스를 함께 지원해 시각 상호작용·도구 사용·코드 실행을 자유롭게 조합할 수 있다. 오픈소스 모델만으로 구성되어 있으며, 폐쇄형 최신 모델 없이도 고품질 컴퓨터 사용 환경 생성이 가능함을 보여준다. 전체 요약 7문장 읽기 → 030 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 031 03:11 ▲ 197 · 댓글 82 LiteLLM 1.107.0, 자격증명 탈취·백도어 악성코드 포함돼 배포 LiteLLM 1.107.0이 PyPI에서 자격증명 탈취 악성코드와 원격코드 실행 백도어를 포함해 배포됐다. 보안 · Compromised LiteLLM 1.107.0 on PyPI Installs a Credential Stealer and Backdoor
Key Point PyPI의 인기 라이브러리에서 개발자 환경의 모든 민감 정보(AWS 자격증명, SSH 키, API 토큰, 비밀번호)를 탈취하는 대규모 공급망 공격이 발생했으며, 빌드 파이프라인 손상으로 의심돼 의존성 관리의 신뢰성에 심각한 영향을 미친다.
핵심 요약
LiteLLM 1.107.0이 PyPI에서 자격증명 탈취 악성코드와 원격코드 실행 백도어를 포함해 배포됐다. Linux, macOS, Windows 7개 휠의 모든 설치 파일에 cook.pth, cook.py, sitecustomize.py 3개 파일이 심어졌으며, Python 프로세스 시작 시 자동 실행되는 구조다. cook.py는 SSH 키, 클라우드 자격증명, CI/CD 시크릿, AI 도구 토큰, 브라우저 비밀번호, LiteLLM 프록시 데이터베이스 내 LLM 제공자 API 키를 수집해 www.litellm[.]dev로 AES-256-CBC 암호화로 전송한다. 전체 요약 10문장 읽기 → 032 00:11 ▲ 13 · 댓글 2 에지 기기용 LLM 커널 생성 벤치마크 공개 LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. AI · 머신러닝 · EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
Key Point 에지 디바이스 배포는 서버와 달리 하드웨어가 다양하고 제약이 크기 때문에, LLM으로 생성한 커널을 실제로 잘 동작하게 하려면 새로운 평가 방식과 최적화 전략이 필요하다는 점이 중요하다.
핵심 요약
LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. EdgeKernelBench는 통합 IR 배포 프레임워크와 에지 워크로드용 계층적 벤치마크를 결합하여, 재사용 가능한 계산·스케줄링·메모리 결정을 통합 IR로 캡처하고 컴파일러 인터페이스를 통해 각 백엔드에 연결한다. 벤치마크는 개별 연산자부터 컴팩트 모델 그래프까지 점진적으로 확대된 프로그램 범위를 포함하며, 대표적인 에지 애플리케이션 도메인을 아우른다. 전체 요약 6문장 읽기 → 033 00:11 ▲ 18 · 댓글 2 장시간 비디오에서 사건 추론하는 새로운 과제 Event-STVG 제시 기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. AI · 머신러닝 · Event-STVG: Spatio-Temporal Video Grounding for Long-Form Event Reasoning
Key Point 비디오 이해 AI의 현재 한계를 실제 벤치마크로 검증하며, 장시간 사건 추론이라는 새로운 요구에 맞춘 모델 개발 방향을 제시한다.
핵심 요약
기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. Event-STVG는 STVG를 단순 객체 검색에서 사건 수준의 추론으로 확장하는 새로운 과제로, 장시간 문맥 이해, 반복되는 사건 구분, 사건 위치 파악, 역할 추론, 다중 대상 그라운딩을 통합한다. 축구를 포함한 8개 도메인에서 총 4,016개의 사건 발생을 주석 처리한 대규모 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 034 21:11 당일 +107 개인 서버에서 돌리는 AI 검색엔진 Vane Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 웹 · 프론트엔드 · ItzCrazyKns/Vane · TypeScript
Key Point 자신의 서버에서 검색 데이터를 완전히 제어하면서 최신 AI 모델을 활용하려는 사용자와 개발자에게 실질적인 대안이 된다.
핵심 요약
Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 스피드 모드(빠른 답변), 밸런스드 모드(일상 검색), 퀄리티 모드(깊이 있는 연구)의 세 가지 검색 모드를 지원하고, 웹·토론·학술논문 등 다양한 출처에서 검색할 수 있으며 특정 도메인으로 검색을 제한할 수도 있다. SearxNG를 통해 여러 검색 엔진에 익명으로 접근하고, 이미지·비디오 검색, PDF·텍스트·이미지 파일 업로드 후 질문, 스마트 자동완성 제안, 트렌딩 콘텐츠 브라우징, 로컬 검색 히스토리 저장 등의 기능을 제공한다. 전체 요약 7문장 읽기 → 035 21:11 당일 +215 DeepSeek Harness를 휴대폰에서 제어하는 DSH Pocket 전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 오픈소스 · 도구 · shaobeichen/dsh-pocket · JavaScript
Key Point DeepSeek Harness 사용자가 외출 중에도 전자 기기의 agent 작업을 실시간으로 모니터링하고 제어할 수 있는 표준 솔루션이 등장했으므로, 개발자 생산성 도구 사용자라면 즉시 설치 가치가 있다.
핵심 요약
전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 로컬 네트워크 모드는 설정 페이지에서 바로 사용 가능하며, 장치 IP를 자동 감지하고 WSL 환경에서 Windows 물리 네트워크 카드 IP를 자동으로 선택한다. 공인망 접근은 cloudflared 터널을 통해 작동하며, Cloudflare Tunnel Token과 도메인명을 설정해 고정된 공인 주소를 사용할 수 있는 '명명된 터널' 옵션을 제공한다. 전체 요약 12문장 읽기 → 036 21:11 ▲ 101 · 댓글 64 독립 개발자를 위한 자동 비상 알림 도구 'Death Plan Switch' 오픈소스 공개 개발자가 주 1회 체크인 이메일에 응하지 않으면 자동으로 비상 연락망을 알리는 셀프호스팅 서비스다. 오픈소스 · 도구 · Show HN: Death Plan Switch, a self-hosted dead man's switch for solo devs
Key Point 일인 사업가나 중요 정보 관리 책임이 있는 개발자가 예기치 못한 상황에서도 관계자들이 적절히 알림을 받도록 자동화할 수 있다.
핵심 요약
개발자가 주 1회 체크인 이메일에 응하지 않으면 자동으로 비상 연락망을 알리는 셀프호스팅 서비스다. 24시간 뒤 상기 메일, 48시간 뒤 마지막 경고, 72시간 뒤 지정한 가족·친구에게 질문, 120시간 뒤 모두에게 알림 메시지를 보낸다. 가족이 '괜찮다'고 응답하면 중단되고, 아무도 응답하지 않으면 미리 작성한 메시지가 모든 연락처에 전달된다. 전체 요약 10문장 읽기 → 037 21:11 ▲ 252 · 댓글 108 eMudhra CA 인증서 개인키가 단일 바이트였던 사건 10월 17일 보안 연구자가 eMudhra 인증 기관의 8개 중간 인증서 개인키 유출을 Apple, Google, Microsoft, Mozilla, eMudhra에 보고했고, Chrome과 Firefox가 차단했으며 Mozilla가 eMudhra 루트를 제거했다. 보안 · Eight Bits of Trust; eMudhra's CA keys cracked in milliseconds
Key Point P-384 곡선에서 단 8비트로 보호된 CA 개인키로 인해, 브라우저 밖의 거의 모든 TLS 클라이언트(API 호출, 설치 도구, IoT 기기)에서 어떤 도메인으로든 가짜 인증서를 만들 수 있다는 구조적 위험이 17개월간 방치됐다.
핵심 요약
10월 17일 보안 연구자가 eMudhra 인증 기관의 8개 중간 인증서 개인키 유출을 Apple, Google, Microsoft, Mozilla, eMudhra에 보고했고, Chrome과 Firefox가 차단했으며 Mozilla가 eMudhra 루트를 제거했다. eMudhra의 개인키는 4, 56, 115 등 단일 바이트 숫자였으며, P-384 곡선의 개인키는 384비트 난수(2³⁸⁴ 경우의 수)여야 하지만 47바이트 영점 다음 1바이트만 존재했다. 이 때문에 인증서의 공개키를 보고 밀리초 단위로 개인키를 복구할 수 있었으며, 연구자는 Mozilla가 공개한 8개 인증서 모두를 즉시 복구했다. 전체 요약 10문장 읽기 → 038 18:11 ▲ 157 · 댓글 62 메타 뮤즈, 공유 링크로 사용자 민감정보 노출 메타의 AI 에이전트 뮤즈가 대화 공유 기능에서 민감한 개인·업무 정보를 노출하는 취약점이 발견됐다. 보안 · Muse exposes users' personal and business secrets when they share conversations
Key Point 개인정보와 업무 기밀을 포함한 메타 뮤즈 공유 링크가 쉽게 외부에 노출되는 설계 결함이 있으며, 광범위한 계정 접근 권한을 요구하는 AI 에이전트의 신뢰성이 의문의 여지가 남아있다.
핵심 요약
메타의 AI 에이전트 뮤즈가 대화 공유 기능에서 민감한 개인·업무 정보를 노출하는 취약점이 발견됐다. 보안업체 클라록 연구원들이 단 한 번의 쿼리로 6,800개의 공유 링크를 열거할 수 있었다. 노출된 정보에는 임원 지원자 면접 메모, 회사 매출 검토 자료, 대출 신청서, 직원 휴가 일정 등이 포함됐다. 전체 요약 8문장 읽기 → 039 00:11 ▲ 12 · 댓글 2 다양한 장면에 강한 자율 학습 깊이 추정 기법 MaSS 자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. AI · 머신러닝 · Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
Key Point 자율 학습 깊이 추정이 다양한 현실 데이터에서 제대로 작동하려면, 도메인별 편향을 넘어 일반화된 구조 학습이 필수적이기 때문이다.
핵심 요약
자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. 연구진은 자율 학습 상황에서 모델이 전이 가능한 기하학 대신 데이터셋별 구조적 편향을 학습하면서 도메인 간 최적화 충돌이 발생하는 문제를 발견했다. 이를 해결하기 위해 MaSS 프레임워크를 제안하며, 맥락 특징과 명시적으로 분리된 전용 구조 표현 경로를 도입한다. 전체 요약 7문장 읽기 → 040 00:11 ▲ 103 · 댓글 59 가짜 통계로 ChatGPT에 인용되는 법 저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. AI · 머신러닝 · Publish fake stats, get cited in LLMs
Key Point LLM 기반 AI 검색이 Google을 대체하면서 가짜 정보가 인용과 재인용으로 신뢰성을 얻는 '정보 연쇄 반응'의 실증적 증거를 제시하며, 웹 콘텐츠 신뢰성과 LLM 학습 데이터 품질에 대한 근본적인 문제를 지적한다.
핵심 요약
저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. 사이트는 ChatGPT로부터 1만 개 이상의 세션을 받았고, Shopify, DHL, Bluehost를 포함한 330개 이상의 도메인에서 링크되었으며, 가짜 수치가 학술 논문과 은행의 투자 연구에 인용되었다. 저자는 LLM 관련 연구 중 LLM들이 지식 격차를 채우기 위해 통계를 찾는 패턴을 발견했고, 이를 통해 GEO(생성형 검색 최적화) 실험을 설계했다. 전체 요약 14문장 읽기 → 041 21:11 당일 +190 에이전트를 위한 타입 안전 그래프 DB, Omnigraph 공개 Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 오픈소스 · 도구 · ModernRelay/omnigraph · Rust
Key Point AI 에이전트가 공유 상태를 안전하게 읽고 쓸 수 있는 데이터 계층이 필요할 때, Git 워크플로우와 정책 기반 접근 제어를 갖춘 오픈소스 솔루션이 나왔다.
핵심 요약
Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 타입 온톨로지(`.pg` 스키마로 노드·엣지 타입, 키, 제약 선언)를 통해 에이전트들이 통일된 도메인 모델을 강제할 수 있으며, 모든 쓰기에서 엔진이 검증한다. 그래프 순회, 벡터 검색(ANN), 전문 검색, 상호 순위 융합을 한 번의 쿼리로 처리하는 통합 검색 엔진으로 높은 정확도의 컨텍스트를 조립할 수 있다. 전체 요약 11문장 읽기 → 042 09:11 ▲ 181 · 댓글 30 PostgreSQL 19에서 8~10개 주요 기능이 베타 중 롤백된 이유 PostgreSQL 19 베타 단계에서 평년보다 훨씬 많은 8~10개 정도의 주요 기능이 롤백됐으며, 그 중 일부는 베타 후반부에 이루어졌다. 오픈소스 · 도구 · The reverts will continue until morale improves
Key Point LLM 기반 코드 리뷰가 발견 속도를 혁신했지만, 레거시 기능들이 새로운 품질 기준에 미치지 못해 베타 중 대량 롤백되는 상황이 발생했고, 이는 PostgreSQL 개발 프로세스의 근본적 변화를 시사한다.
핵심 요약
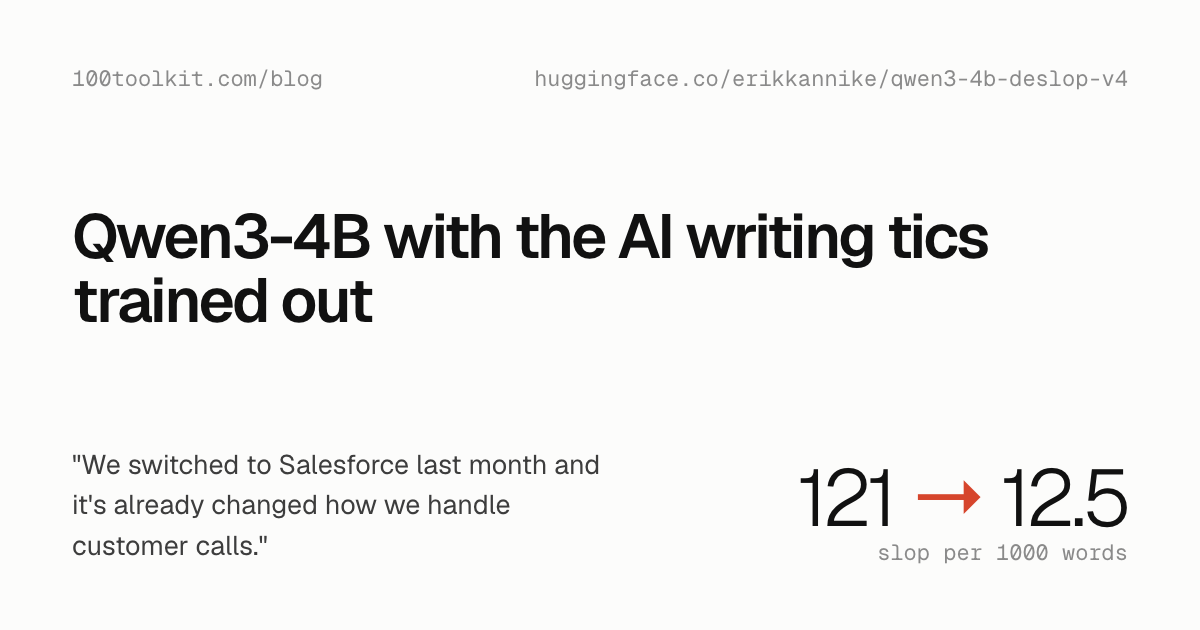
PostgreSQL 19 베타 단계에서 평년보다 훨씬 많은 8~10개 정도의 주요 기능이 롤백됐으며, 그 중 일부는 베타 후반부에 이루어졌다. 코드 품질 부족도 있지만, 주요 원인은 LLM 기반 코드 리뷰로 인해 과거라면 나중에 발견됐을 엣지 케이스들이 베타 중에 빠르게 적발된 것이다. Vulnpocalypse 보안 사건으로 4월부터 8월까지 시니어 개발자들이 보안 패치에 집중했고, 베타 기간 중 추가 검토와 테스트가 줄어들었다가 8월 이후 다시 증가해 늦은 발견과 롤백을 초래했다. 전체 요약 8문장 읽기 → 043 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 044 00:11 ▲ 114 · 댓글 15 DNS로 해낸 기상천외한 실험들 DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. 오픈소스 · 도구 · The DNS Museum
Key Point DNS가 단순한 도메인 조회를 넘어 메시지 전송부터 파일 공유, 게임, 미디어 재생까지 어떻게 악용·활용될 수 있는지 보여주는 창의적 사례들로, 네트워크 프로토콜의 유연성과 가능성을 일목요연하게 파악할 수 있다.
핵심 요약
DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. Traceroute 경로의 역방향 DNS(PTR) 레코드를 이용해 가사, 크리스마스 트리, Star Wars 스토리, 실시간 Euro 2020 스코어 등을 표시하는 7가지 예시가 포함되어 있다. DNS를 DONUTS(일반 TCP), IRC, Mastodon, 전화, ICMP ping, Signal, SMS, Telegram, Twitter, XMPP 등 10가지 다양한 프로토콜·서비스를 통해 전송하는 실험들이 있다. 전체 요약 6문장 읽기 → 045 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 046 00:11 ▲ 113 · 댓글 36 렛츠 암호화, 도메인 검증 강화 위해 원격 관점 2개 추가 렛츠 암호화가 도메인 검증 시 원격 관점을 2개 추가해 총 6개(기존 4개에서 증설)로 늘린다. 보안 · Let's Encrypt is adding two additional remote perspectives for domain validation
Key Point CA 인증서 발급의 검증 강화는 도메인 탈취 및 중간자 공격 방지의 핵심이며, 업계 기준 준수를 위해 모든 CA가 준비해야 하는 필수 변경사항이다.
핵심 요약
렛츠 암호화가 도메인 검증 시 원격 관점을 2개 추가해 총 6개(기존 4개에서 증설)로 늘린다. 이번 변경은 Baseline Requirements 개정(2026년 12월 15일 발효)에 따른 것으로, 최소 5개 원격 관점을 요구한다. 도메인 검증 시 주 데이터센터 1개와 원격 관점 6개로부터 총 7개의 검증 요청을 보낸다. 전체 요약 8문장 읽기 → 047 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 048 15:11 ▲ 164 · 댓글 2 비전-언어 모델이 3D 공간을 직접 탐색하며 추론하는 방법 시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. AI · 머신러닝 · Learning to Think and Explore in 3D World
Key Point 3D 환경에서 능동적으로 탐색해야만 답할 수 있는 문제에서 기존 상용 모델을 능가하는 오픈소스 모델 사례를 제시하며, VLM의 추론 능력을 확장하는 새로운 학습 패러다임을 보여줍니다.
핵심 요약
시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. 초기 질문과 첫 번째 관점에서 시작한 뒤, 모델이 반복적으로 추론하고 이동·회전 같은 행동을 통해 시점을 변경하며 최종 답변을 제출하는 방식입니다. 궤적 감독 미세조정 후 강화학습(RL)을 적용했으며, 보상은 최종 답변 정확도로만 주어져서 모델이 어떤 시점을 방문할지는 스스로 학습합니다. 전체 요약 8문장 읽기 → 049 12:11 ▲ 180 · 댓글 3 장기 자동화 에이전트의 실제 제약 검증 벤치마크 BizBench 공개 기존 장기 자동화 에이전트 벤치마크는 최종 성공 여부만 중시하며 중간 실행의 유효성을 제대로 평가하지 못하는 한계가 있다. AI · 머신러닝 · BizBench: Unveiling Hidden Challenges in Deploying Long-Horizon Agents for Real-World Business
Key Point 최고 성능 모델도 엄격한 제약 조건 평가에서는 60% 이하의 성공률을 보여주며, 결제·금융처럼 중간 단계 오류가 실제 손실을 초래하는 분야에서 에이전트의 신뢰성을 어떻게 평가할지 규정한 첫 벤치마크다.
핵심 요약
기존 장기 자동화 에이전트 벤치마크는 최종 성공 여부만 중시하며 중간 실행의 유효성을 제대로 평가하지 못하는 한계가 있다. 현실의 비즈니스 운영, 특히 결제 같은 고위험 도메인에서는 에이전트가 복잡한 정책을 따르면서 실행 전 과정에서 제약 조건을 만족해야 한다. 연구팀이 결제 회사의 실제 운영 절차를 기반으로 BizBench 벤치마크를 개발했다. 전체 요약 9문장 읽기 → 050 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 051 21:10 당일 +100 Z-Library 명령어 도구 zlib 공개 Z-Library를 CLI에서 검색·다운로드·Kindle 전송할 수 있는 도구 zlib를 공개했다. 오픈소스 · 도구 · heartleo/zlib · Go
Key Point Z-Library 도서 자료 접근 방식이 CLI 기반 자동화 도구로 개선됐으며, 특히 Claude Code 통합으로 AI 에이전트와의 연동이 가능해졌다.
핵심 요약
Z-Library를 CLI에서 검색·다운로드·Kindle 전송할 수 있는 도구 zlib를 공개했다. 대화형 검색, 페이지 네비게이션, 다운로드 기록 브라우저, 사용 프로필 확인, 7가지 테마 지원이 포함되어 있다. Homebrew, winget, curl, Go install로 설치할 수 있으며 Go 1.25 이상이 필요하다. 전체 요약 12문장 읽기 → 052 18:11 ▲ 156 · 댓글 68 DeepSeek, 검색·웹페이지 수집 API 공개…1000건당 75센트 DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. AI · 머신러닝 · DeepSeek search and fetch – $0.75 per 1000 successful requests
Key Point RAG와 AI 에이전트 기능이 필요한 개발자들이 DeepSeek의 웹 접근 API를 활용할 수 있게 됐으며, 저가 가격대(1000건당 75센트)로 경쟁 중인 유사 서비스와 비교하는 기준점이 된다.
핵심 요약
DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. Search API는 쿼리에 맞는 웹페이지를 찾아 구조화된 검색 결과를 반환하며, DeepSeek 자체 검색엔진으로 구동된다. Fetch API는 단일 웹페이지를 가져와 Markdown 형식으로 콘텐츠를 반환한다. 전체 요약 13문장 읽기 → 053 03:11 ▲ 105 · 댓글 69 .name 도메인 내년 폐기, 마이그레이션 재촉 3단계 .name 도메인이 내년에 영구 삭제될 예정이다. 기타 · Tell HN: Remember to migrate away from .name domain
Key Point .name 도메인이 폐기되기 전에 미리 다른 도메인으로 옮기지 않으면 서비스 중단이나 이메일 손실 같은 피해를 입을 수 있다.
핵심 요약
3단계 .name 도메인이 내년에 영구 삭제될 예정이다. .name 도메인을 사용 중인 개발자들은 .com 등 다른 도메인으로의 마이그레이션 준비를 권장받고 있다. Azure 관리자 이메일처럼 도메인 변경이 불가능한 서비스에 묶여 있는 사용자들의 경우, 마이그레이션 자체가 어려운 상황이다. 054 21:11 당일 +250 초등 교육 커리큘럼을 구조화한 오픈 데이터셋 공개 Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 오픈소스 · 도구 · withmarbleapp/os-taxonomy · JavaScript
Key Point 교육과정을 기계 판독 가능한 그래프 구조로 공개한 것은 EdTech 서비스, 학습 분석 도구, AI 튜터링 시스템 등을 만드는 개발자에게 기초 데이터로 쓸 수 있다는 점이 의미 있습니다.
핵심 요약
Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 1,590개의 '마이크로 토픽'(하나의 배울 수 있는 단위)으로 분해했으며, 각각 명확한 설명과 숙달 기준을 담았다. 3,221개의 선행 학습 의존도 간선으로 구성한 방향 무순환 그래프이며, 각 간선은 '강함/약함' 태그와 이유를 포함한다. 전체 요약 9문장 읽기 → 055 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 056 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 057 18:11 ▲ 28 · 댓글 3 파일에서 인사이트 찾는 AI, 합성 데이터로 학습시키다 파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. AI · 머신러닝 · Data World: Scaling Data Environments from Scratch
Key Point 데이터 분석 AI 학습을 위한 현실적인 대규모 데이터 환경 구축 방식이 제시되며, 합성 환경에서의 강화학습이 실제 벤치마크 성능 향상으로 이어지는 경로를 보여준다.
핵심 요약
파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. Data World 엔진은 파일을 먼저 생성하는 대신, 파일 뒤의 세상(데이터 구조·관계)을 명시적으로 정의한 뒤 환경·과제·평가 기준을 합성한다. 독립적인 감사로 관찰된 파일에서 정답을 복구할 수 있는지 검증하며, RL 학습을 위한 보상 함수로도 활용한다. 전체 요약 7문장 읽기 → 058 12:11 ▲ 10 · 댓글 1 LLM이 가르치는 과학 생성 AI, 자연어로 약물 설계한다 기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. AI · 머신러닝 · LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
Key Point LLM의 추론 능력과 도메인 특화 생성 모델의 구조적 타당성을 결합하여 자연어 명령만으로 신약 후보 물질을 설계할 수 있는 방법론이 제시되었기 때문에, 과학 발견 프로세스의 자동화 가능성을 보여주는 중요한 진전이다.
핵심 요약
기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. 명시적 보상 함수 없이 자연어로 표현된 발견 목표에 과학 생성 모델을 정렬하는 방법을 연구했다. LLM-to-Flow Distillation(LFD)을 제안하며, 여기서 고정된 LLM이 도메인 특화 생성 모델의 적응형 교사 역할을 한다. 전체 요약 8문장 읽기 → 059 09:11 ▲ 191 · 댓글 75 공개 토렌트에 EXE 위장 악성코드로 뿌려지는 Sonarr 공격 저자가 NAS의 Sonarr *arr 스택을 운영 중 South Park 에피소드 이름에 .exe를 붙인 파일이 2,392개 시더로 공개 토렌트에 올라와 자동으로 다운로드된 사건 발생. 보안 · Someone on Torrent Sites Kept Fucking with My Sonarr
Key Point 공개 토렌트 사이트에서 배포되는 악성코드가 Sonarr 같은 자동 다운로드 도구를 악용하고 있으며, 무심코 실행할 경우 수십 개 애플리케이션의 민감한 데이터(암호, 토큰, 암호화폐 지갑, 개발 키 등)를 한꺼번에 탈취할 수 있다.
핵심 요약
저자가 NAS의 Sonarr *arr 스택을 운영 중 South Park 에피소드 이름에 .exe를 붙인 파일이 2,392개 시더로 공개 토렌트에 올라와 자동으로 다운로드된 사건 발생. qBittorrent는 파일을 받지 못했으나(total_downloaded: 0) Sonarr는 90초마다 임포트를 시도했고, Sonarr 내 블록리스트로 해당 토렌트를 차단함. 저자가 호기심으로 파일을 다시 다운로드해 분석한 결과, 887 MB 크기의 실제 PE 바이너리(118 KB 본체 + 886 MB 랜덤 데이터)로 대형 파일 크기로 백신 탐지 회피를 시도. 전체 요약 11문장 읽기 → 060 03:12 ▲ 16 · 댓글 2 LLM 에이전트, 사용자 감정 변화에 취약하다 장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. AI · 머신러닝 · τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
Key Point 현실의 사용자 감정 변화가 LLM 에이전트의 신뢰성을 심각하게 흔드는 취약점을 처음으로 체계적으로 측정하고, 이를 개선하기 위한 학습 방법을 제시한다.
핵심 요약
장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. 기존 벤치마크는 협조적이고 안정적인 사용자를 가정하고 있어 감정 변화가 에이전트 신뢰성에 미치는 영향을 제대로 평가하지 못했다. τ-Emotion-Bench는 10개 도메인에서 감정 조건부 사용자 상호작용 하에서 도구 호출 에이전트를 평가하는 벤치마크를 제시한다. 전체 요약 8문장 읽기 → 061 03:12 ▲ 200 · 댓글 35 광고로 위장한 스파이웨어, Al Jazeera 감염까지 노출 시민실험실이 Discover-Tech라는 이스라엘 회사가 타겟 광고로 용병급 스파이웨어를 배포하는 'AdFection' 공격을 처음 기술적으로 확인했다. 보안 · Zero-Click Spyware Delivered via Targeted Ads: AdFection
Key Point 온라인 광고 생태계가 개인 추적, 클릭 없는 스파이웨어 배포, 익명성 제거에 악용되고 있으며, Google 같은 대형 플랫폼의 검증 체계도 통과했다는 점이 광고 기반 인터넷의 보안 위기를 보여준다.
핵심 요약
시민실험실이 Discover-Tech라는 이스라엘 회사가 타겟 광고로 용병급 스파이웨어를 배포하는 'AdFection' 공격을 처음 기술적으로 확인했다. Discover-Tech는 Controlium 플랫폼으로 모바일 광고 ID, 쿠키, IP 주소를 바탕으로 개인을 지목하고 클릭 없이 자동 감염시키는 방식으로 작동한다. 2024~2025년 Al Jazeera는 Discover-Tech 광고를 통해 배포된 Candiru 스파이웨어에 45대 이상 기기가 감염되었으며, 감염 장치는 Discover-Tech 도메인 → Candiru 검증 서버 → C&C 서버 순서로 연결된다. 전체 요약 11문장 읽기 → 062 18:11 ▲ 64 · 댓글 2 규칙 추론 벤치마크 RuleTrek 공개, LLM의 한계 드러내다 대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. AI · 머신러닝 · RuleTrek: Benchmarking Agentic Rule Reasoning in Complex Scenarios
Key Point LLM이 현실 업무에서 도메인 규칙을 얼마나 정확히 따를 수 있는지 측정하는 새 기준이 제시되면서, 에이전트 AI의 신뢰성 문제가 수치로 드러났다.
핵심 요약
대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. 기존 규칙 추론 벤치마크는 시나리오를 소수의 사실 진술로만 표현해 규칙 식별과 적용을 지나치게 단순화했다. 연구팀이 발표한 RuleTrek은 복잡한 시나리오에서 에이전트 기반 규칙 추론을 평가하는 다중 도메인 벤치마크다. 전체 요약 8문장 읽기 → 063 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 064 06:11 ▲ 10 · 댓글 1 에이전트가 직접 학습 환경을 설계하는 자동화 시스템 등장 터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AI · 머신러닝 · AutoEnvScaling: Automating the Data Flywheel with Terminal Agents
Key Point 터미널 에이전트 훈련의 가장 큰 병목이었던 환경 설계를 자동화함으로써, 모델의 자율적 성장과 비용 효율성을 동시에 달성하는 경로를 보여준다.
핵심 요약
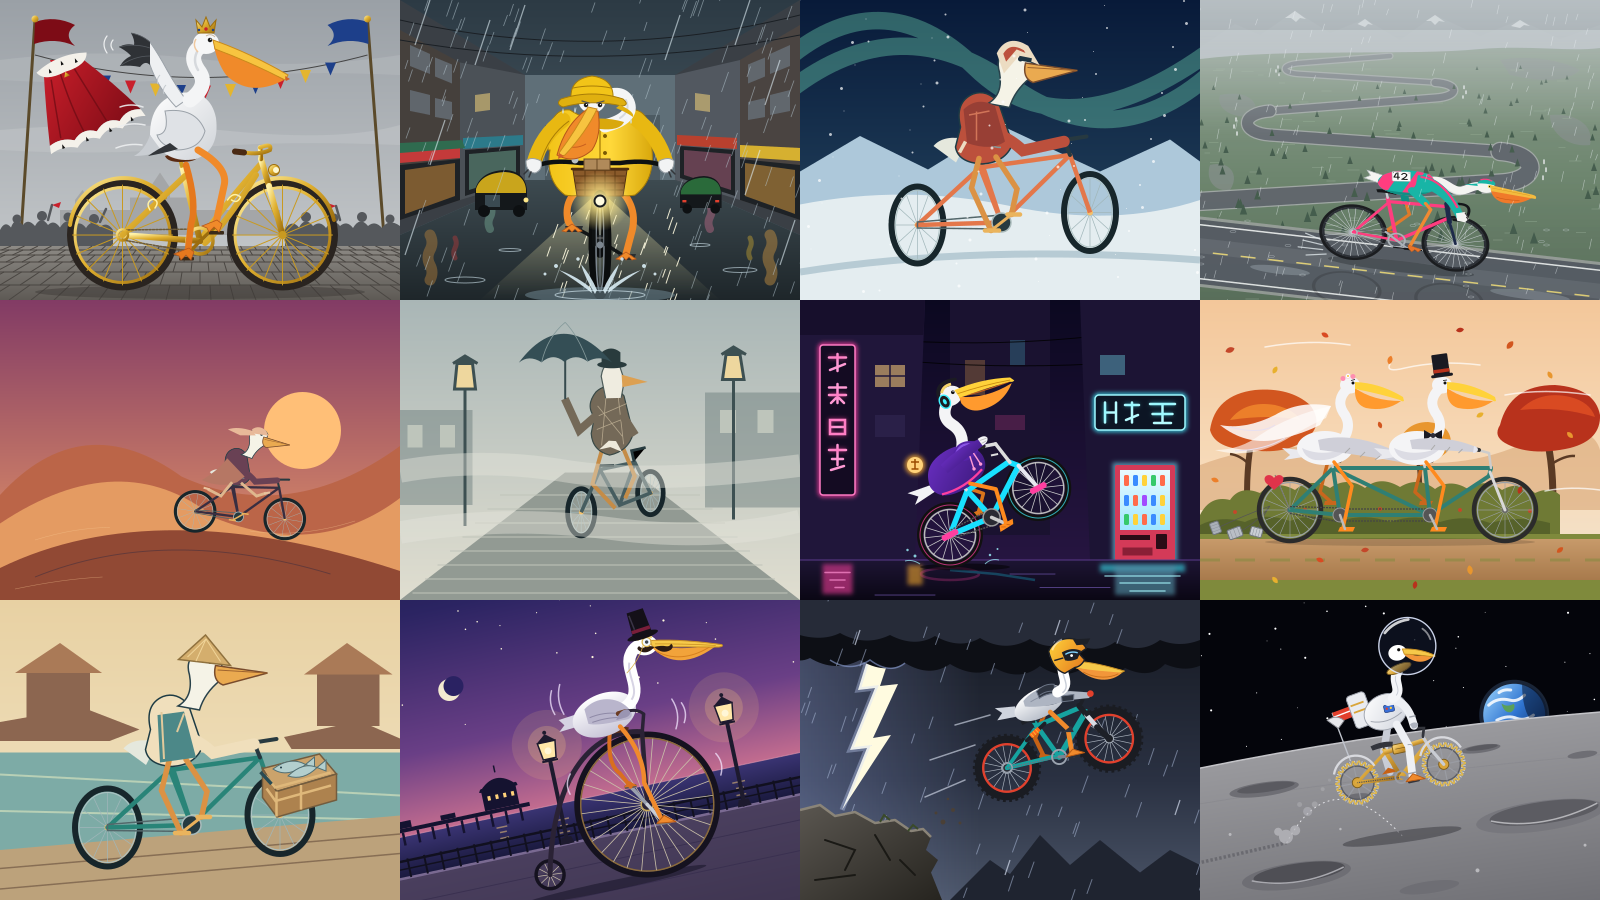
터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AutoEnvScaling은 환경 설계를 터미널 작업으로 재정의해 에이전트가 자동으로 학습 환경을 생성하도록 한다. 제안 에이전트가 풀이 에이전트의 실행 롤아웃을 바탕으로 새로운 강화학습 환경을 구축하고, 그 결과가 다음 훈련 라운드를 안내한다. 전체 요약 8문장 읽기 → 065 03:11 ▲ 123 · 댓글 109 LLM이 만드는 디자인, 모두 똑같은 이유 LLM들이 UI 디자인 작업에서 놀랍도록 비슷한 결과물을 만드는 '다양성 붕괴' 문제가 드러났다. AI · 머신러닝 · Why do LLM pelicans look like this?
Key Point AI 모델들의 UI 디자인 창의성이 인간의 30% 수준에 불과하며, 모두 비슷한 패턴으로 생성하는 근본적 한계를 정량적으로 입증한 첫 벤치마크다.
핵심 요약
LLM들이 UI 디자인 작업에서 놀랍도록 비슷한 결과물을 만드는 '다양성 붕괴' 문제가 드러났다. Kombai 연구팀이 'Design Creativity Bench' 벤치마크를 개발해 16개 최첨단 모델을 80개 열린형 UI 작업으로 평가했으며, 각 작업마다 2개의 서로 다른 제품 도메인과 인간 디자이너 기준을 제시했다. 창의성을 세 가지 차원으로 측정했다: 원창성(같은 브리프에 대해 다른 모델들과 얼마나 다른지), 창의적 범위(제품 도메인이 바뀔 때 디자인 결정을 얼마나 적응시키는지), 적절성(생성된 UI가 요구사항을 만족하는 정도). 전체 요약 6문장 읽기 → 066 03:11 ▲ 140 · 댓글 68 미국 요청에 좌파 ISP 서버 몰수한 네덜란드 경찰 암스테르담 경찰이 미국의 법적 요청에 따라 이탈리아 좌파 ISP 오티스티치/인벤타티(A/I)의 서버를 데이터센터에서 압수했다. 보안 · Amsterdam police confiscates server left-wing ISP A/I at American request
Key Point 인터넷 서비스 제공자가 사용자의 콘텐츠에 책임을 묻는 사례는 드문데, 이 사건은 미국 정부의 정치적 결정이 유럽의 법 집행으로까지 확대되는 과정을 보여준다.
핵심 요약
암스테르담 경찰이 미국의 법적 요청에 따라 이탈리아 좌파 ISP 오티스티치/인벤타티(A/I)의 서버를 데이터센터에서 압수했다. A/I는 지난 25년간 전 세계 약 2만 개 단체에 무료 웹호스팅과 이메일 서비스를 제공해온 반자본주의 조직이다. 미국 정부는 A/I가 '안티파'(반파시스트)를 지원한다고 주장했고, 트럼프 행정부는 안티파를 테러 조직으로 분류했다. 전체 요약 7문장 읽기 → 067 03:11 ▲ 288 · 댓글 435 패스키는 함정이 아니다, 피싱 방지 기술 해외에서 '패스키는 함정'이라는 주장이 확산되자, 패스키 기술 전문가가 이를 반박하는 글을 발표했다. 보안 · Passkeys are not a trap
Key Point 패스키를 피해야 한다는 주장이 널리 퍼지면서 사용자들이 보안 선택을 재검토하는 중인데, 기술적 오류와 실제 위협을 구분하는 것이 중요하다.
핵심 요약
해외에서 '패스키는 함정'이라는 주장이 확산되자, 패스키 기술 전문가가 이를 반박하는 글을 발표했다. 주장의 핵심은 패스키의 증명(attestation) 기능이 점진적으로 확대되어 승인된 소프트웨어·OS로만 로그인하게 될 것이라는 우려였다. 그러나 대부분의 사용자가 쓰는 동기화 패스키(iCloud Keychain, Google Password Manager 등)는 증명 기능을 제공하지 않으며, 소비자 서비스는 증명을 요청하지 말라는 권고를 오랫동안 받고 있다. 전체 요약 7문장 읽기 → 068 18:11 ▲ 96 · 댓글 2 장기 작업 자동화 AI, 밀도 높은 보상으로 학습 난제 해결 수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. AI · 머신러닝 · Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
Key Point 장기 자동화 작업의 학습 데이터 부족과 희소 보상 문제를 해결한 구체적인 방법론과 검증 가능한 데이터셋을 제시하여 오픈소스 장기 에이전트 개발의 실질적인 진전을 가능하게 한다.
핵심 요약
수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. 연구팀은 Tev-Gym이라는 첫 번째 장기 에이전트 학습 데이터셋을 제시했으며, 7개 도메인의 1,170개 검증된 과제 환경을 포함하고 검증 가능한 밀도 높은 진행 보상을 제공한다. 잠재 세계 우선 접근법으로 작동하여 먼저 완전하고 정확한 숨겨진 작업 명세를 구성하고, 각 단계마다 예상되는 상태를 지정한 뒤, 과제를 점진적으로 렌더링해 제어 가능한 복잡성과 자연스러운 진행 지표를 제공한다. 전체 요약 6문장 읽기 → 069 15:11 ▲ 27 · 댓글 1 멀티턴 에이전트 학습의 진행도 신호, DeltaTTG 제안 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
Key Point 기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다. DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다. 전체 요약 8문장 읽기 → 070 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 071 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 072 18:12 ▲ 92 · 댓글 2 AI 에이전트 학습용 소프트웨어 환경 자동 생성 기술 Computer-use agent(CUA)는 발전 중이지만 다양하고 신뢰할 수 있는 소프트웨어 환경을 대규모로 합성하는 것이 어려운 상황이다. AI · 머신러닝 · SoftwareGym: Scaling Computer-Use Agent Training with Diverse Synthesized Software Environments
Key Point 자동 생성된 소프트웨어 환경으로 학습한 AI 에이전트가 기존 벤치마크에서 대폭 성능을 향상시켜, CUA 개발의 데이터 부족 문제에 새로운 해결책을 제시한다.
핵심 요약
Computer-use agent(CUA)는 발전 중이지만 다양하고 신뢰할 수 있는 소프트웨어 환경을 대규모로 합성하는 것이 어려운 상황이다. 기존 네이티브 애플리케이션 환경은 구축과 통합에 많은 노력이 필요해 범용성이 낮고 오버피팅 위험이 있으며, 브라우저 기반 환경은 상호작용 깊이와 워크플로우 복잡성이 제한적이다. SoftwareGym은 다양한 인터페이스, 실행 가능한 기능, 런타임 검증된 동작을 갖춘 GUI 소프트웨어 환경을 자동으로 합성하는 파이프라인이다. 전체 요약 8문장 읽기 → 073 18:12 ▲ 44 · 댓글 2 인간의 GUI 경험에서 재사용 가능한 에이전트 스킬을 자동 추출 컴퓨터 사용 에이전트는 복잡한 GUI 작업을 수행할 수 있지만 인간의 도메인 지식이 필요한 낯선 소프트웨어와 워크플로우는 여전히 어려운 과제다. AI · 머신러닝 · Work2Skill: Capturing Human GUI Experience for Reusable Agent Skill Induction
Key Point 복잡한 GUI 작업을 수행하는 AI 에이전트가 인간의 실제 워크플로우 지식을 자동으로 학습하고 재사용할 수 있는 새로운 방법론이며, 멀티모달 데이터셋도 함께 공개돼 향후 에이전트 연구의 기반을 제공한다.
핵심 요약
컴퓨터 사용 에이전트는 복잡한 GUI 작업을 수행할 수 있지만 인간의 도메인 지식이 필요한 낯선 소프트웨어와 워크플로우는 여전히 어려운 과제다. Work2Skill은 인간의 GUI 경험을 캡처하여 재사용 가능한 에이전트 스킬을 자동으로 유도하는 프레임워크를 제시한다. WorkRecorder는 화면 녹화, 마우스·키보드 이벤트, 접근성 트리 정보를 정렬하여 인간의 경험을 수집하는 인프라를 제공한다. 전체 요약 7문장 읽기 → 074 18:12 ▲ 108 · 댓글 27 인기 TypeScript 검증 라이브러리 Zod 4.6.6, 악성코드 포함 배포 Zod 4.6.6 버전에 악성 스크립트가 삽입된 커밋이 공개되었다. 보안 · Zod 4.6.6 compromised by malware?
Key Point Zod는 개발자들이 널리 사용하는 스키마 검증 라이브러리인 만큼, 4.6.6 버전 설치 시 악성 페이로드가 자동 실행될 수 있으며 공급망 공격으로 사용자 시스템이 위협받을 수 있다.
핵심 요약
Zod 4.6.6 버전에 악성 스크립트가 삽입된 커밋이 공개되었다. 패키지 설치 시 자동 실행되는 preinstall 스크립트에 meta.test.mjs 파일이 추가되었다. 해당 파일은 Ethereum RPC 노드에 연결해 0xe236330379d0c54aD5b2ef06aC714CEbdd4Ce523 주소의 스마트 컨트랙트를 호출한다. 전체 요약 7문장 읽기 → 075 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 → 076 21:11 당일 +101 Linux 서버 관리 원스톱 도구 KEJILION.SH 공개 Linux 서버 모니터링·관리용 통합 Shell 스크립트 도구인 KEJILION.SH를 GitHub에서 공개했다. 인프라 · 데브옵스 · kejilion/sh · Shell
Key Point Linux 서버 운영에 필요한 시스템 관리, 네트워크 테스트, 애플리케이션 배포, 보안 방어를 한 스크립트로 통합하므로 개발자와 운영자의 작업 효율을 크게 높일 수 있다.
핵심 요약
Linux 서버 모니터링·관리용 통합 Shell 스크립트 도구인 KEJILION.SH를 GitHub에서 공개했다. 시스템 정보 개요, 네트워크 테스트, Docker 컨테이너 관리, LDNMP 스택 배포를 한 곳에서 처리할 수 있다. CC 방어·안티크롤러·방화벽 기능으로 웹사이트를 보호하고, 사이트와 데이터베이스 백업·복구·원격 마이그레이션을 지원한다. 전체 요약 10문장 읽기 → 077 12:11 ▲ 11 · 댓글 2 비전-언어 모델의 공간 추론 능력 평가 벤치마크 공개 시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. AI · 머신러닝 · SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
Key Point 현재 주류 시각-언어 모델들이 보이는 공간을 읽기만 하는 수준이며, 실제 공간 추론 능력에서 심각한 격차를 보이고 있기 때문이다.
핵심 요약
시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. 182개의 실제 장면에서 3,862개 질문으로 구성되며, 정적 인식·국소 예측·전역 예측의 3단계 16가지 과제를 포함한다. 기존 벤치마크는 입력에 이미 보이는 관계를 읽는 지각 능력만 테스트하지만, SpaceCast-Bench는 장면을 구성하고 개입의 결과를 예측하는 예측적 공간 추론을 직접 평가한다. 전체 요약 6문장 읽기 → 078 12:11 ▲ 103 · 댓글 35 체험형 게임쇼의 원조, 다케시 캐슬의 역사와 재부활 1986년부터 1990년까지 일본 TBS 방송국에서 방영된 '다케시 캐슬'은 아역 배우이자 영화감독인 타케시 기타노(비트 다케시)가 성주 역으로 출연해 시청자들이 극복해야 할 신체 도전과제들을 만든 게임쇼다. 기타 · Takeshi's Castle
Key Point 1980년대의 신체 도전 게임쇼 붐을 주도한 '다케시 캐슬'이 2023년 스트리밍 플랫폼으로 부활한 이유와 프로그램의 구조, 수십 가지 챌린지의 구체적 방식을 알 수 있다.
핵심 요약
1986년부터 1990년까지 일본 TBS 방송국에서 방영된 '다케시 캐슬'은 아역 배우이자 영화감독인 타케시 기타노(비트 다케시)가 성주 역으로 출연해 시청자들이 극복해야 할 신체 도전과제들을 만든 게임쇼다. 프로그램은 일반 타니(谷隼人)가 86~142명의 도전자를 이끌고 물에 빠지거나 진흙에 빠지는 내용의 제거식 신체 챌린지에 참여하게 하며, 마지막에 생존자들이 다케시와 그의 군대와 성을 점령하기 위해 최종 전투를 벌인다. 요코하마의 TBS 소유 미도리야마 스튜디오에 대규모 조경과 인공 호수, 정교한 고정 장애물들이 설치되어 도전과제들이 펼쳐졌다. 전체 요약 10문장 읽기 → 079 00:11 ▲ 140 · 댓글 97 WSL 3, 커널 6.18로 업그레이드하며 성능 3~60% 향상 Microsoft가 WSL 3.x 스택 출시와 함께 기본 가상화 런타임을 개선하고 리눅스 커널을 6.6 LTS에서 6.18로 업데이트했다. 인프라 · 데브옵스 · WSL3 Performance is about 5-60% faster than WSL2 depending on the workload
Key Point 메모리 대역폭 61% 향상과 커널 오버헤드 16% 감소는 로컬 데이터베이스나 컨테이너 워크로드의 성능에 직접 영향을 미치므로, 특정 워크로드의 개발자는 반드시 확인해야 할 성능 변화를 제시한다.
핵심 요약
Microsoft가 WSL 3.x 스택 출시와 함께 기본 가상화 런타임을 개선하고 리눅스 커널을 6.6 LTS에서 6.18로 업데이트했다. WSL 2.6.3.0(커널 6.6.87.2)과 WSL 3.0.2.0(커널 6.18.40.1)을 Alpine Linux에서 실제 벤치마크로 비교한 결과, 메모리 대역폭이 7.84 GB/s에서 12.64 GB/s로 61.35% 증가했다. 커널 primitives 수준에서 스케줄러 지연은 약 11% 감소했으며, 시스템콜 오버헤드도 약 4% 개선되었다. 전체 요약 6문장 읽기 → 080 15:13 ▲ 74 · 댓글 2 강화학습으로 스스로 개선하는 초대형 모델 MiMo-V2.6 공개 Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. AI · 머신러닝 · MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
Key Point 장기 시퀀스 처리와 복합 작업에서 초대형 모델이 스스로 개선되도록 하는 RL 확장 기법이 어떻게 작동하는지, 그 구체적인 구현과 한계를 다루기 때문에 모델 개선 연구자와 개발자가 참고할 수 있다.
핵심 요약
Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. RL 훈련 전에 다양한 멀티모달 데이터를 이용해 중간 학습을 수행하고, 하이브리드 SWA 구조의 사전학습 모델을 기반으로 확장 가능한 인프라를 구축했다. RL 계산을 세 가지 방향으로 확장했다: (1) 비동기 훈련으로 스텝당 1,568개 샘플과 2.7~3.7B 토큰 처리, 최대 1M 길이 컨텍스트 지원, (2) 코드·일반·시각·사이버 도메인을 포함한 다양한 환경과 에이전트 구성, (3) 그룹별 에이전트 채점으로 장기 작업의 정확한 보상 신호와 토큰 효율성 개선. 전체 요약 6문장 읽기 → 081 15:13 ▲ 189 · 댓글 82 $2 ESP32-C3로 PSRAM 없이 Pi-hole 수준의 광고 차단 14만 개 이상의 도메인을 0.7MB 플래시 저장소에 40비트 해시로 저장하고 이진 검색으로 ~10ms에 매칭하는 DNS 광고 차단 프로젝트. 하드웨어 · 시스템 · ESP32-C3 Adblock
Key Point 값싼 마이크로컨트롤러로 PSRAM 비용 없이 대규모 차단 목록을 관리하는 해시 기반 최적화 기법이 실제로 작동하며, 가정용 DNS 차단 서버의 진입장벽을 크게 낮춤.
핵심 요약
14만 개 이상의 도메인을 0.7MB 플래시 저장소에 40비트 해시로 저장하고 이진 검색으로 ~10ms에 매칭하는 DNS 광고 차단 프로젝트. 기존 ESP32 광고 차단기는 차단 목록을 RAM에 올려야 해서 비싼 PSRAM이 필요하지만, 이 프로젝트는 도메인 문자열 대신 5바이트 고정 길이 해시를 플래시에 저장해 ~50KB RAM만 사용. 40비트 크기는 목표 플래시 용량에서 충돌을 최소화하는 최적값으로, 14만 도메인에서 충돌 거의 없고 53만 7천 도메인에서도 1건만 발생. 전체 요약 13문장 읽기 → 082 00:11 ▲ 20 · 댓글 2 Flow 정책 미세조정을 위한 스칼라 수반 매칭 기법 Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. AI · 머신러닝 · Q-Learning with Scalar Adjoint Matching
Key Point Flow 정책의 강화학습 미세조정 비용을 획기적으로 줄이면서도 실제 로봇 제어까지 검증한 실용적 알고리즘이 제안되었다.
핵심 요약
Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. Flow 정책을 학습된 가치 함수로 미세조정하는 것은 정책이 많은 Flow 스텝을 거쳐 행동을 생성하므로 비자명하다. 기존 수반 매칭은 최종 행동에서 각 Flow 스텝으로 가치 정보를 역전파하는 원칙적 방법이지만, 매 스텝마다 벡터-야코비안 곱을 요구해 계산 비용이 Flow 스텝 수와 정책 크기에 따라 증가한다. 전체 요약 9문장 읽기 → 083 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 084 18:30 ▲ 17 · 댓글 2 약한 모델과의 비교로 학생 모델 학습 개선 온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. AI · 머신러닝 · On-Policy Distillation with Negative-Policy Rollouts
Key Point 학생 모델 학습에서 강한 교사만으로는 부족한 신호를 약한 모델과의 비교로 보완하는 새로운 접근 방식이 여러 조건에서 효과를 입증했다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. 기존 OPD 연구들은 증류 보상 공식이나 교사 구성을 개선해왔으나, 교사와 학생 간의 분포 중복이 낮을 때 긍정적 신호만으로는 학습이 부족할 수 있다. 논문은 음수 정책 온-폴리시 증류(NP-OPD)를 제안하는데, 낮은 성능의 음수 정책으로부터 생성한 샘플을 추가하여 학생 모델의 부정적 참조점을 제공한다. 전체 요약 6문장 읽기 → 085 18:30 ▲ 33 · 댓글 2 세계 모델에 소리를 더하는 'WorldSonus' 논문 공개 월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. AI · 머신러닝 · WorldSonus: Bringing Sound to Worlds
Key Point 기존 월드 모델은 시각만 생성했지만, WorldSonus는 실시간 상호작용형 공간음향 합성으로 생성 환경의 완전성을 한 단계 높였다.
핵심 요약
월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. 실시간 생성을 위해 스트리밍 인과 자기회귀 확산 구조를 사용해 RTF 0.41의 저지연으로 오디오 청크를 합성한다. 대화형 제어는 오디오 중심의 캡셔닝 파이프라인과 청크 인덱스 프롬프트 스케줄링으로 생성 도중 음향 이벤트를 동적으로 조작할 수 있다. 전체 요약 5문장 읽기 → 086 18:30 ▲ 94 · 댓글 2 로봇 실시간 제어, 영상 메모리 19초 활용하면 성공률 63→79% 로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. AI · 머신러닝 · Long-WAM: Scaling the Context of World-Action Models
Key Point 로봇 제어에서 짧은 지연(107ms)로 19초 영상 메모리를 활용하면서 복잡한 조작 작업에서 대폭 높은 성공률을 달성한 실시간 배포 기술이기 때문이다.
핵심 요약
로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. Long-WAM은 실시간 제어 제약 속에서 인과적 세계-행동 모델의 맥락을 확장하기 위한 모델-시스템 프레임워크이다. 핵심 발견: 긴 히스토리에 접근하는 것과 실제로 사용하는 것은 다르며, 비디오 기초 모델이 자기회귀(AR) 방식으로 사전학습될 때 더 큰 이득이 난다. 전체 요약 12문장 읽기 → 087 18:33 ▲ 10 · 댓글 2 기존 과학 소프트웨어로 터미널 에이전트 자동 훈련 과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. AI · 머신러닝 · Self-Supervised Scaling of Terminal Environments for Scientific Domains
Key Point 기존 소프트웨어 워크플로우를 재사용하는 자체 지도 학습으로 도메인별 훈련 데이터 구축 비용을 대폭 줄이면서도 검증된 고품질 데이터를 얻을 수 있는 방법이 제시되었다.
핵심 요약
과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. 연구팀이 '소프트웨어 루프 내 재구성(Software-in-the-Loop Reconstruction, SWR)'이라는 자체 지도 학습 프레임워크를 제안했다. 이 방법은 기존 소프트웨어 워크플로우(구조화된 입력을 출력으로 매핑하는 실행 가능한 프로그램)에서 참조 출력과 검증 대상을 추출한다. 전체 요약 8문장 읽기 → 088 18:33 ▲ 18 · 댓글 2 시계열 예측에 뉴스 기반 사건 추론을 적용하는 SEER 모델 실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. AI · 머신러닝 · SEER: Self-Evolving Event Reasoning and Retrieval for Time Series Forecasting
Key Point 시계열 예측에 뉴스 기반 외부 사건을 통합하는 새로운 방식이 기존 모델보다 성능이 우수하다는 것을 보여주므로, 금융·에너지·주식 등 변동성 큰 시계열을 다루는 개발자와 연구자에게 중요하다.
핵심 요약
실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. 언어 모델을 통해 외부 뉴스를 검색할 수 있지만, 표준 검색 증강 방식은 높은 노이즈, 신호 손실, 사건 영향에 대한 인과적 추론 능력 부족의 문제가 있다. SEER는 시계열 예측을 위해 사건 조건화를 동적으로 최적화하는 폐루프 프레임워크로, 예측 오류를 두 가지 피드백 메커니즘으로 변환한다. 전체 요약 7문장 읽기 → 089 18:33 ▲ 11 · 댓글 3 AI 에이전트의 작업 능력과 오류 복구를 분리 평가하는 벤치마크 Tool-using AI 에이전트를 평가하는 기존 벤치마크들은 단순한 작업 완료만 측정해 기본 계획 능력과 실제 운영 환경에서의 장애 복구 능력을 구분하지 못한다. AI · 머신러닝 · UndoBench: Separating Task Competence from Recovery Capability in Tool-Using AI Agents
Key Point 엔터프라이즈 환경에 배포되는 AI 에이전트의 실제 위험성은 정상 작동 능력이 아닌 장애 복구 능력에 있으며, 기존 평가 방식의 맹점을 드러내는 첫 체계적 벤치마크다.
핵심 요약
Tool-using AI 에이전트를 평가하는 기존 벤치마크들은 단순한 작업 완료만 측정해 기본 계획 능력과 실제 운영 환경에서의 장애 복구 능력을 구분하지 못한다. 연구팀은 UndoBench를 제시해 8개 엔터프라이즈 도메인의 36개 기본 워크플로우와 36개 장애 시나리오로 이 둘을 분리해 평가한다. 동일한 시드로 실행한 쌍 비교 시험과 와이어 수준 영향 이력·환경 상태 오라클을 통해 두 능력을 독립적으로 측정한다. 전체 요약 8문장 읽기 → 090 18:33 ▲ 26 · 댓글 2 강화학습만으로 의료 LLM 도메인 적응한 HuatuoGPT-3 범용 대규모언어모델(LLM)을 특정 도메인 전문가로 바꾸기 위해 OnePO(One-stage Policy Optimization)라는 강화학습 기법을 제안했습니다. AI · 머신러닝 · HuatuoGPT-3: RL-Only Domain Adaptation from Base Models
Key Point 의료 LLM 개발 시 SFT 없이 강화학습만으로도 최신 모델을 능가하는 성과를 낼 수 있음을 보여주므로, 도메인 적응 파이프라인의 효율성이 크게 달라질 수 있습니다.
핵심 요약
범용 대규모언어모델(LLM)을 특정 도메인 전문가로 바꾸기 위해 OnePO(One-stage Policy Optimization)라는 강화학습 기법을 제안했습니다. 기존 SFT+RL 방식은 탐색 다양성을 감소시키고 다단계 최적화의 복잡성이 있어, 순수 강화학습만으로 적응하는 방식을 개발했습니다. 순수 on-policy RL의 콜드스타트 문제와 혼합정책 RL의 문제점(gradient starvation, teacher-distribution anchoring)을 파악했습니다. 전체 요약 8문장 읽기 → 091 18:33 ▲ 11 · 댓글 1 거래 알고리즘 코드 생성에 특화한 언어모델 'QuantCode' 개발 대규모 언어모델이 일반 코드 생성에는 강하지만, 자동거래 알고리즘 코드 생성은 자연어 전략을 실행 가능한 프로그램으로 정확히 변환하고 과거 데이터에서 실행해 거래를 만들어내는 고도의 전문화가 필요하다. AI · 머신러닝 · QuantCode Model: Specializing Language Models for Executable Algorithmic Trading Code
Key Point 자동거래 코드 생성이라는 전문 영역에서 언어모델을 효과적으로 적응시키는 방법과 이 과정의 실제 제약을 실증적으로 보여주며, 도메인 전문화와 일반 능력 유지 사이의 트레이드오프 문제를 구체적으로 드러낸다.
핵심 요약
대규모 언어모델이 일반 코드 생성에는 강하지만, 자동거래 알고리즘 코드 생성은 자연어 전략을 실행 가능한 프로그램으로 정확히 변환하고 과거 데이터에서 실행해 거래를 만들어내는 고도의 전문화가 필요하다. 연구팀은 거래 프레임워크 코드로 계속 학습(continued pretraining)과 검증된 요청-코드 쌍으로 감독 학습(SFT)이라는 두 가지 메커니즘을 통해 언어모델을 특화시켰다. Backtrader 전략 생성을 위한 400개 과제 벤치마크(QuantCode-Bench)와 저장소 수준의 SWE-벤치 트랙으로 평가했다. 전체 요약 9문장 읽기 → 092 18:33 ▲ 28 · 댓글 2 AI 과학자를 평가하는 벤치마크, 자동으로 만든다 기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AI · 머신러닝 · AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
Key Point AI 에이전트가 빠르게 발전할 때 기존 평가 방식이 뒤떨어지는 문제를 자동화로 해결하는 방법론이 제시되어, 향후 AI 시스템 평가 방식에 영향을 미칠 수 있다.
핵심 요약
기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AutoSciBench는 각 과제를 과학 도메인·데이터 형식·추론 방식을 지정하는 고수준 개념과 질문·환경·정답 구성 방법을 담은 저수준 레시피로 표현한다. 에이전트가 과제를 시도할 때 생성되는 풀이 궤적과 판단 피드백을 이용해 자동으로 레시피나 개념을 개선하고, 과제를 우회 풀이에서 원본 데이터 재검토·중간 결과 해석·증거 통합으로 진화시킨다. 전체 요약 6문장 읽기 → 093 18:33 ▲ 38 · 댓글 3 도구 사용 AI 에이전트, 증거 없이 행동하는 이유 도구를 사용하는 AI 에이전트는 외부 상태를 변경하지만, 올바른 결과도 그 행동이 사전에 확보한 증거에 기반했다는 것을 보장하지 않는다. AI · 머신러닝 · From Evidence to Action: How Tool-Using Agents Fail
Key Point AI 에이전트가 올바른 결과를 내도 그 과정이 증거 기반이 아닐 수 있으며, 증거 확보-행동 실행 과정의 어느 단계에서 실패하는지 파악하는 것이 신뢰할 수 있는 AI 시스템 구축의 핵심이다.
핵심 요약
도구를 사용하는 AI 에이전트는 외부 상태를 변경하지만, 올바른 결과도 그 행동이 사전에 확보한 증거에 기반했다는 것을 보장하지 않는다. 증거 수집부터 단일 행동, 종속적 워크플로우 실행까지 단계별로 체인이 어디서 끊어지는지 분석하는 것이 이 연구의 목표다. 10가지 모델-장비 구성에서 강력한 정적 행동 평가가 훨씬 약한 대화형 실행과 공존할 수 있음을 발견했다. 전체 요약 8문장 읽기 → 094 18:33 당일 +236 LLM 기반 자동 침투 테스트 시스템 ARTEX 공개 바이두 'agent+' 공방 챌린지 우승 프로젝트로, Go 백엔드와 Next.js 프론트엔드로 구성된 자동화된 침투 테스트 시스템을 오픈소스로 공개했다. AI · 머신러닝 · Autumn-27/ARTEX · Go
Key Point LLM 멀티 에이전트가 자동으로 공격 사슬을 완성하는 시스템의 구조와 작동 방식이 어떻게 설계되었는지 이해할 수 있으며, 침투 테스트 자동화 분야의 실제 구현 사례를 볼 수 있다.
핵심 요약
바이두 'agent+' 공방 챌린지 우승 프로젝트로, Go 백엔드와 Next.js 프론트엔드로 구성된 자동화된 침투 테스트 시스템을 오픈소스로 공개했다. LLM 기반 다중 에이전트 아키텍처로 설계되어 있으며, 온라인 데모를 통해 대시보드, 임무 관리, 자산 맵핑 등의 기능을 직접 체험할 수 있다. 핵심은 '탐색 그래프'와 '자산 그래프'라는 이중 구조로, 목표 달성 과정과 실제 발견한 자산을 독립적으로 추적하면서 앵커 포인트로 연결한다. 전체 요약 12문장 읽기 → 095 18:33 ▲ 138 · 댓글 49 해킹으로 Google 위장 TLS 인증서 발급…DNS 탈취가 계기 공격자들이 .gh, .sl, .as 국가 도메인 3개를 탈취한 뒤 DNS 레코드를 조작해 Google과 다른 대형 서비스의 위조 TLS 인증서를 발급받았다. 보안 · Hackers obtain counterfeit TLS certificates for Google and other large services
Key Point 도메인 레지스트리 탈취로 수백 개 사이트의 위장 인증서가 발급된 대규모 사건으로, 도메인과 DNS 보안의 취약점이 TLS 신뢰 체계 전체에 미치는 영향을 보여준다.
핵심 요약
공격자들이 .gh, .sl, .as 국가 도메인 3개를 탈취한 뒤 DNS 레코드를 조작해 Google과 다른 대형 서비스의 위조 TLS 인증서를 발급받았다. 공격자들이 탈취한 DNS 레코드로 도메인 통제 권한을 자동 검증하는 과정을 통과하고, Google의 여러 도메인과 '세계적 선도 브랜드 및 널리 쓰이는 온라인 서비스'에 대한 무단 인증서를 획득했다. TLS 인증서는 도메인을 공개키에 묶는 암호화 자격증으로, 이를 악용하면 공격자가 피해 기반시설을 암호학적으로 위장할 수 있다. 전체 요약 8문장 읽기 → 096 18:35 ▲ 292 · 댓글 394 LLM 시대, Common Lisp이 최고의 언어가 된 이유 LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. AI · 머신러닝 · Why Common Lisp is now the best programming language
Key Point LLM이 코드 작성을 담당하면서 개발의 병목이 컴파일 시간으로 옮겨졌는데, Common Lisp의 라이브 이미지 기반 구조와 도메인 언어 구축 능력이 이 시대에 유독 적합하다는 주장을 이해해야 미래 기술 스택 선택에서 참고할 수 있다.
핵심 요약
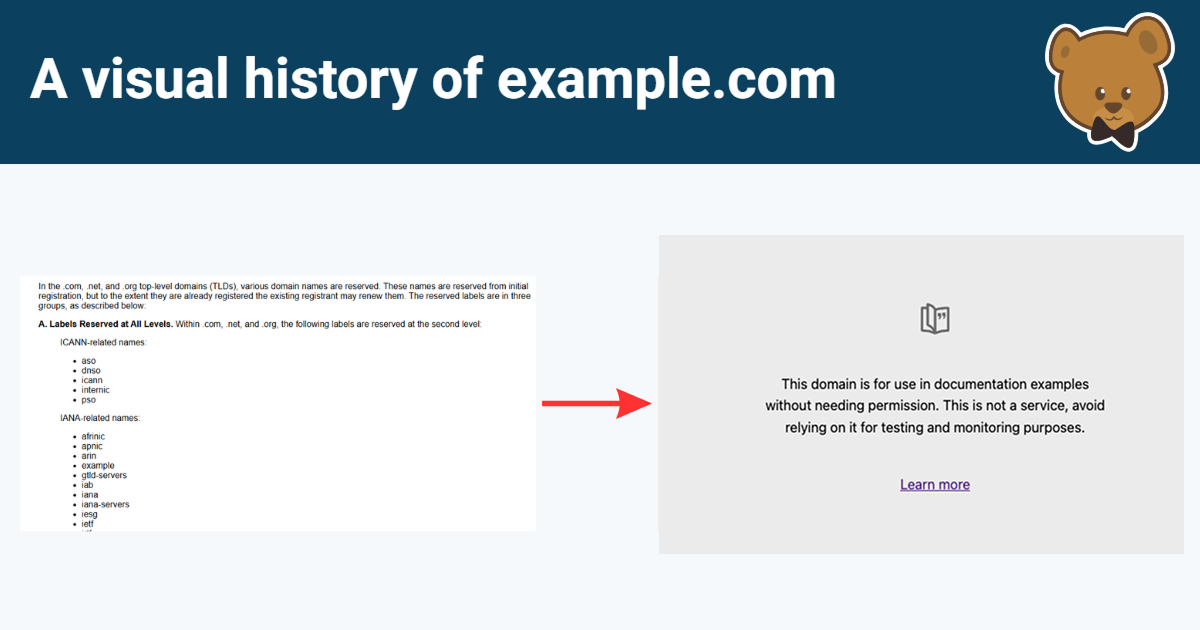
LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. Common Lisp은 이미지 기반이라 함수 업데이트 시 재시작 불필요하고, 오류 발생 시 프로그램이 종료되지 않고 디버거를 열어 LLM이 직접 문제를 해결하고 재개할 수 있다. Lisp의 코드는 데이터와 같은 리스트 형태이므로 매크로로 언어에 새로운 구문을 추가할 수 있어, 프로그래머가 자신의 문제 영역을 위한 도메인 언어를 만들고 그 위에 프로그램을 작성한다. 전체 요약 8문장 읽기 → 097 18:35 ▲ 357 · 댓글 247 example.com의 20년 진화사, 다국어 지원으로 대규모 재설계 IANA가 관리하는 문서용 예제 도메인 example.com이 2026년 9월 28일 20년 만에 대규모 재설계를 단행했다. 웹 · 프론트엔드 · Example.com just launched the biggest redesign in decades
Key Point IANA의 공식 예제 도메인이 2026년 JavaScript 다국어 지원으로 재설계된 만큼, 개발자용 예제 도메인의 기술적 진화와 IANA의 인프라 관리 정책 변화를 이해할 수 있다.
핵심 요약
IANA가 관리하는 문서용 예제 도메인 example.com이 2026년 9월 28일 20년 만에 대규모 재설계를 단행했다. 재설계의 주요 변화는 JavaScript를 활용한 다국어 지원 추가로, 영어·아랍어·중국어·프랑스어·러시아어·스페인어 6개 언어를 5초마다 자동 전환했다. 각 문자를 span 요소로 감싸고 CSS transition-delay를 달리 적용해 문자별로 순차적인 불투명도 애니메이션을 구현했으나, 10월 3일 애니메이션을 제거하고 모든 언어를 동시 표시로 변경했다. 전체 요약 9문장 읽기 → 098 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 099 09:11 ▲ 101 · 댓글 137 커스텀 도메인 이메일, 2년간의 우회로 끝나다 저자는 자신의 도메인 jacobg.co에서 저렴하게 사용할 수 있는 커스텀 이메일 주소를 찾기 위해 여러 방안을 시도했다. 웹 · 프론트엔드 · All I wanted was a custom domain email
Key Point 자신의 도메인으로 개인 이메일을 운영하려는 개발자·사업가들이 흔히 마주치는 선택지들을 직접 비교 평가한 실용적 가이드다.
핵심 요약
저자는 자신의 도메인 jacobg.co에서 저렴하게 사용할 수 있는 커스텀 이메일 주소를 찾기 위해 여러 방안을 시도했다. Cloudflare Email Routing은 수신은 간단하지만 발신이 복잡하고 느렸으며, Mailflare는 오픈소스지만 신뢰할 수 있는 발신 설정이 어려웠다. Purelymail은 연 $10 수준의 저렴한 가격과 무제한 주소, IMAP/SMTP 지원으로 좋은 옵션이었으나 다른 선택지를 찾았다. 전체 요약 6문장 읽기 → 100 06:11 당일 +182 $2 ESP32-C3로 만드는 광고 차단 DNS 서버 Pi-hole 같은 DNS 광고 차단기를 $2짜리 ESP32-C3 마이크로컨트롤러에 구현한 프로젝트로, PSRAM 없이도 동작한다. 하드웨어 · 시스템 · M-Abozaid/esp32-c3-adblock · C++
Key Point 저가 마이크로컨트롤러로 대규모 광고 차단 서버를 만드는 방식이 근본적으로 다르므로, 자체 DNS 서버 구축을 고려하는 개발자와 홈랩 운영자에게 참고할 만한 기술이다.
핵심 요약
Pi-hole 같은 DNS 광고 차단기를 $2짜리 ESP32-C3 마이크로컨트롤러에 구현한 프로젝트로, PSRAM 없이도 동작한다. 핵심 아이디어는 도메인 문자열을 RAM에 올리지 말고 40비트 FNV-1a 해시를 플래시에 저장한 후 이진 탐색으로 검색하는 것이다. 537,000개 도메인을 약 50KB의 RAM만 사용해 저장할 수 있으며, 조회는 10ms 정도에 완료된다. 전체 요약 14문장 읽기 →