쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
15건 · "로보틱스"조건 지우기 ×
001 06:11 ▲ 154 · 댓글 30 600번의 실험으로 발견한 JEPA 월드 모델의 최적 설계 JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. AI · 머신러닝 · After 600 experiments, here's what I discovered about JEPA world models
Key Point JEPA 월드 모델의 병목이 예측이 아니라 계획 방식임을 실험으로 증명했고, 재학습 없이 네 가지 방법으로 성공률을 3배 이상 향상시킨 구체적 기법들을 제시한다.
핵심 요약
JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. LeWM 모델을 600회 실험한 결과, 예측 정확도 개선보다 계획 방식 변경이 더 큰 효과를 발휘했다. LeWM의 예측기를 완벽한 물리 시뮬레이터로 바꿔도 성공률이 78%에서 77%로 거의 변하지 않아, 병목은 모델의 예측이 아닌 사용 방식임을 확인했다. 전체 요약 12문장 읽기 → 002 21:11 당일 +412 구글 딥마인드, 다중관절 물리 시뮬레이터 MuJoCo 오픈소스화 MuJoCo(Multi-Joint dynamics with Contact)는 로봇공학, 생역학, 그래픽스, 머신러닝 등 다양한 분야의 연구개발을 지원하는 범용 물리 엔진으로, Google DeepMind가 유지보수한다. 오픈소스 · 도구 · google-deepmind/mujoco · C++
Key Point Google DeepMind의 물리 시뮬레이션 엔진이 오픈소스로 공개되어, 로봇공학 및 AI 연구에 기여할 수 있는 강력한 도구가 누구나 접근 가능해졌다.
핵심 요약
MuJoCo(Multi-Joint dynamics with Contact)는 로봇공학, 생역학, 그래픽스, 머신러닝 등 다양한 분야의 연구개발을 지원하는 범용 물리 엔진으로, Google DeepMind가 유지보수한다. C API를 제공하며 저수준 데이터 구조에 최적화된 런타임 시뮬레이션 모듈로 높은 성능을 목표로 하고, 데스크톱 및 웹 브라우저에서 대화식 시각화를 지원한다. Python 바인딩, Unity 플러그인, JavaScript/WebAssembly 바인딩 등 다양한 언어 및 플랫폼 지원을 제공하며, 물리량 계산을 위한 다수의 유틸리티 함수를 포함한다. 전체 요약 10문장 읽기 → 003 18:11 ▲ 112 · 댓글 76 로봇 팩토리는 손으로 만들어진다 저자가 유니트리의 항저우 팩토리를 방문했을 때, 모터를 만드는 구간은 대부분 구리선을 감싸는 작업을 하는 인력으로 채워져 있었고 자동화 라인은 소수에 불과했다. 하드웨어 · 시스템 · I toured Unitree's factory. I'm more bullish on the West
Key Point 중국의 낮은 인건비가 로봇 제조를 손작업으로 유지하는 동안, 서방은 높은 임금으로 인해 자동화 기계에 투자할 동기가 크며, AI가 프로그래밍 비용을 급격히 줄이면서 제조 자동화의 핵심 장벽이 낮아지고 있다.
핵심 요약
저자가 유니트리의 항저우 팩토리를 방문했을 때, 모터를 만드는 구간은 대부분 구리선을 감싸는 작업을 하는 인력으로 채워져 있었고 자동화 라인은 소수에 불과했다. 유니트리는 2025년 약 32,000대의 로봇을 만들었지만 자동화 설비는 장부 가치 170만 달러 수준으로, 로봇 한 대당 약 50달러에 불과했다. 로봇 제조 원가에서 인건비는 8%에 불과하고 대부분이 부품비인 만큼, 인력 비용을 절반으로 줄어들어도 전체 원가는 2% 미만 감소한다. 전체 요약 13문장 읽기 → 004 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 005 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 006 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
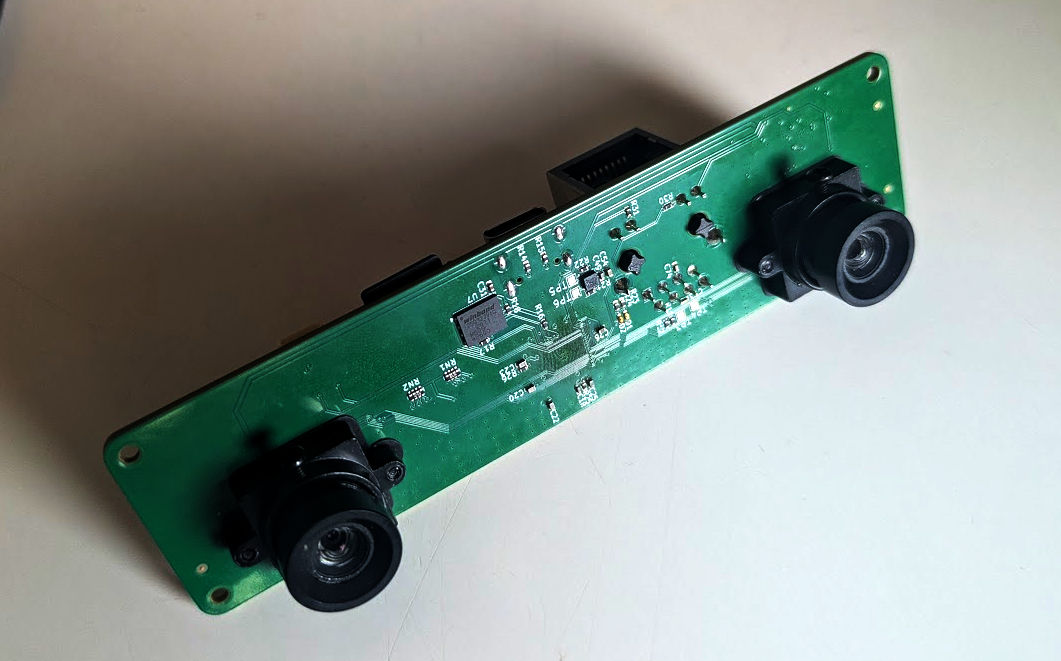
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 007 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 008 21:11 당일 +599 강화학습으로 움직이는 오리 로봇, 마이크로덕 공개 폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. 하드웨어 · 시스템 · pollen-robotics/microduck · Rust
Key Point 강화학습으로 훈련된 신경망 정책을 탑재한 로봇의 전체 소프트웨어 아키텍처와 개발 방식을 공개함으로써, 소형 이족 보행 로봇의 제어·배포·업그레이드 파이프라인을 어떻게 구현할 수 있는지 보여준다.
핵심 요약
폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. Rockchip RK3566 프로세서 위에서 15개 서보 모터를 제어하는 50Hz 제어 루프를 포함하며, 라디오·카메라·자동 업데이트 시스템 등 완전한 로봇 운영 체계를 담고 있다. 행동 정책은 MuJoCo 시뮬레이터와 PPO 강화학습, 시뮬레이션 투 리얼(sim2real) 기법으로 훈련한 후 ONNX 형식으로 변환되어 로봇에 로드된다. 전체 요약 8문장 읽기 → 009 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 010 03:11 당일 +1,172 AI 에이전트의 메모리를 영구 보존하는 claude-mem Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. AI · 머신러닝 · thedotmack/claude-mem · TypeScript
Key Point 세션이 끝나도 AI 에이전트가 이전 작업 맥락을 자동으로 기억하게 해주는 기술로, 장기 프로젝트에서 에이전트의 연속성을 유지하는 방식이 어떻게 구현되는지 보여준다.
핵심 요약
Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. 5개의 생명주기 훅(SessionStart, UserPromptSubmit, PostToolUse, Stop, SessionEnd)과 스마트 설치 기능으로 작동하며, Bun 기반 워커 서비스가 로컬 HTTP API와 웹 뷰어 UI를 제공한다. SQLite 데이터베이스에 세션과 관찰 내용을 저장하고, Chroma 벡터 데이터베이스를 통해 하이브리드 의미론적 검색과 키워드 검색을 지원하는 mem-search 기능으로 프로젝트 히스토리를 자연어로 쿼리할 수 있다. 전체 요약 10문장 읽기 → 011 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 012 21:11 ▲ 35 · 댓글 1 로봇이 실패를 스스로 극복하게 해주는 '수첩' 기법 로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. AI · 머신러닝 · Recursive Harness Distillation across Agents for Robot Manipulation
Key Point 로봇 조작의 실패 대응을 자동화하는 방법론이 제시되어, 다양한 환경의 로봇 작업 신뢰도를 크게 높일 수 있는 경로를 보여준다.
핵심 요약
로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. 연구팀은 강한 에이전트가 약한 에이전트를 위해 경험을 '플레이북'으로 정제하고, 약한 에이전트의 실행 피드백으로 이를 반복 개선하는 '재귀적 하네스 증류(Recursive Harness Distillation)' 기법을 제안했다. 이 플레이북은 모델 파라미터를 업데이트하지 않고도 새로운 작업에서 누적된 개입 지식을 재사용하게 해준다. 전체 요약 6문장 읽기 → 013 15:11 ▲ 18 · 댓글 1 로봇이 경험 쌓아 스스로 진화하는 기초모델 프레임워크 기초모델을 단일 정책으로 보지 않고, 전체 시스템 자체를 진화하는 정책으로 취급하는 RoboFoundry를 제시한다. 기타 · RoboFoundry: System-as-Policy Evolution for Self-Learning Embodied Agents
Key Point 기초모델이 단순히 에이전트로 동작하는 것을 넘어 실행 경험으로부터 시스템 자체를 자동으로 개선할 수 있는 구조를 제시하는 것이 중요하며, 서로 다른 로봇 간 기능 전이가 가능해 구현의 실용성이 크게 높아진다. ai
핵심 요약
기초모델을 단일 정책으로 보지 않고, 전체 시스템 자체를 진화하는 정책으로 취급하는 RoboFoundry를 제시한다. 메모리 관리·문맥 처리·기술 조직·행동 인터페이스 등 에이전트 스택의 개별 요소들을 최적화하는 기존 방식과 달리, 실행 경험을 검증된 시스템 변화로 변환해 지속적으로 개선하는 방식이다. 맥락 시스템(활성 내부 문맥·파일시스템 메모리 관리)과 계층적 기술 시스템(원자적 기술·재사용 가능한 조합·실패 조건부 복구)이라는 두 가지 진화 표면을 갖추고 있다. 전체 요약 7문장 읽기 → 014 22:26 ▲ 13 · 댓글 2 로봇 시각-언어 모델의 안전성 강화, HJ 도달가능성 기반 셰일드VLA 제안 로봇 조작·이동을 수행하는 VLA(Vision-Language-Action) 모델은 일반화 성능이 뛰어나지만 기존 미세조정 방식은 안전성 보장이 부족하다. AI · 머신러닝 · ShieldVLA: Feasibility-Aware Safety Alignment for Vision-Language-Action Models
Key Point 로봇 AI 모델의 안전성은 실제 배포 시 가장 중요한 과제이며, ShieldVLA는 기존 트레이드오프 방식을 근본적으로 개선하는 새로운 접근법을 제시한다.
핵심 요약
로봇 조작·이동을 수행하는 VLA(Vision-Language-Action) 모델은 일반화 성능이 뛰어나지만 기존 미세조정 방식은 안전성 보장이 부족하다. 현재 방식은 라그랑주 최적화로 누적 비용에 소프트 페널티를 부과하는데, 이는 제약 위반이나 과도하게 보수적 행동을 초래하고 시각 도메인에서 단계별 안전 레이블이 없어 학습이 어렵다. Hamilton-Jacobi(HJ) 도달가능성에 기반한 ShieldVLA를 제안하며, 시각 관찰로부터 HJ 도달가능성 가치함수를 모델-프리 방식으로 근사하여 안전 작동 영역을 추정한다. 전체 요약 6문장 읽기 → 015 22:26 ▲ 22 · 댓글 2 로봇의 귀를 열다, 공간음향 이해 벤치마크 OmniEcho 구체화된 에이전트(로봇 등)가 시각 정보와 함께 음성 신호를 이용해 추론하기는 여전히 어렵다. AI · 머신러닝 · OmniEcho: Spatial Audio Understanding for Embodied Agents
Key Point 음성 감지 능력이 로봇과 에이전트의 환경 이해 능력을 크게 확장할 수 있으며, 이를 평가하고 개선할 수 있는 첫 번째 대규모 벤치마크가 공개되었다.
핵심 요약
구체화된 에이전트(로봇 등)가 시각 정보와 함께 음성 신호를 이용해 추론하기는 여전히 어렵다. 음향-시각 인식과 음성-시각-언어 기반 네비게이션을 평가할 통일된 벤치마크가 필요했다. 연구팀이 OmniEchoBench를 제안했으며, 30개 실제 환경에서 수집한 197개 실제 공간음향-시각 장면, 2,972개 질문-답변 쌍, 900개 네비게이션 샘플(1차 앰비소닉스 오디오)을 포함한다. 전체 요약 7문장 읽기 →