쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 5일 (목)까지 3984건
51건 · "생성형 AI"조건 지우기 ×
001 00:11 ▲ 308 · 댓글 84 유료 구독자도 Gemini 대화 훈련에 사용된다 Google AI 구독 사용자의 Gemini 채팅 기록도 기본적으로 AI 모델 훈련에 사용된다. AI · 머신러닝 · Tell HN: Gemini trains on chat history, even for subscribers (personal accounts)
Key Point 유료 가입자도 개인 대화 기록이 훈련과 인간 검토에 사용될 수 있다는 점이 구독의 기본 약관에는 명시되어 있지만 충분히 공지되지 않아, 프라이버시 기대치와 실제 서비스 정책 사이의 간극을 보여준다.
핵심 요약
Google AI 구독 사용자의 Gemini 채팅 기록도 기본적으로 AI 모델 훈련에 사용된다. 채팅 기록은 구글의 개선 서비스에만 아니라 생성형 AI 모델 훈련에도 활용되며, 일부 대화는 인간 검토자에 의해 검토된다. 구글은 인간 검토 시 사용자 계정과 연결을 해제한다고 주장하지만, 기밀 정보를 입력하지 않을 것을 명시적으로 경고한다. 전체 요약 6문장 읽기 → 002 21:11 당일 +224 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 003 09:11 ▲ 167 · 댓글 21 생성형 AI의 수학적 기초를 다룬 입문서 출간 Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. AI · 머신러닝 · The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer
Key Point 생성형 AI를 체계적으로 학습하려는 개발자나 연구자에게 PCA부터 최신 모델까지 일관된 수학적 기초를 제공하는 교재가 생겼다는 점이 중요하다.
핵심 요약
Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. 이 책은 주요 생성 모델들(PCA, 확률적 PCA, 변분 오토인코더, 확산 모델, 정규화 흐름, 자기회귀 모델, GAN, Wasserstein GAN, 에너지 기반 모델)을 연결하는 일관된 경로를 제시한다. 도출 과정을 중심으로 구성되어 최근의 모든 아키텍처나 구현 세부사항을 다루기보다는 생성 모델링의 구조를 수학적 엄밀함을 잃지 않으면서 이해하기 쉽게 만드는 데 초점을 맞췄다. 전체 요약 6문장 읽기 → 004 09:11 ▲ 112 · 댓글 61 SEC, 앤스로픽 IPO 중단해야 한다는 주장 AI 업계의 복잡한 재무 구조로 투자자와 규제기관이 정확한 재무 현황을 파악하기 어렵다며, 앤스로픽이 IPO 등록 신청서를 제출했다. AI · 머신러닝 · The SEC Should Block Anthropic's IPO to Protect the Public
Key Point 앤스로픽 상장이 임박한 가운데, 숨겨진 막대한 지출 약정과 악화하는 사업 여건이 일반 투자자와 경제 전체에 미칠 위험이 무엇인지를 설명합니다.
핵심 요약
AI 업계의 복잡한 재무 구조로 투자자와 규제기관이 정확한 재무 현황을 파악하기 어렵다며, 앤스로픽이 IPO 등록 신청서를 제출했다. 앤스로픽은 매출 성장으로 호실적을 보이지만, 등록 신청서 각주에 2030년대까지 연장되는 약 900억 달러 규모의 지출 약정이 드러났다. 2026년 3분기 결과에서 매출 성장이 둔화했으며, 2026년 재무제표는 정식 감시를 받지 않았다. 전체 요약 15문장 읽기 → 005 03:11 ▲ 12 · 댓글 2 어두운 사진을 한 번에 살리는 생성형 AI 기술 개발 저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. AI · 머신러닝 · GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
Key Point 어두운 사진을 한 번의 계산으로 고품질로 복원할 수 있게 되면, 스마트폰이나 보안카메라 같은 실제 기기에서 즉시 적용할 수 있는 기술이 된다.
핵심 요약
저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. 기존 확산 기반 생성형 방법은 강력한 이미지 사전 정보를 활용해 높은 화질을 달성하지만, 반복적 샘플링으로 인한 계산 비용이 크고 실제 배포에 제약이 있다. GLOW-FM은 한 번의 함수 평가로 고품질 개선을 수행하는 단계별 지연 흐름 일치(flow matching) 프레임워크를 제안한다. 전체 요약 9문장 읽기 → 006 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 007 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 008 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 009 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 010 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 011 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 012 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 013 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 014 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 016 12:11 ▲ 47 · 댓글 2 LLM 에이전트가 스킬을 배우고 다시 쓰게 하는 대화형 학습법 에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. AI · 머신러닝 · Socratic Skill Learning: Interleaving Teaching and Practice for Transferable Agent Skills
Key Point LLM 에이전트가 작업별 스킬을 효과적으로 학습하고 재사용하는 방법이 개발되면서, 생성형 AI의 작업 자동화 능력이 실무 환경으로 한 걸음 더 나아갔다.
핵심 요약
에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. Socratic Skill Learning(SSL)은 전문가 교수(Educator)와 학생(Student)을 짝지어, 학생이 환경을 직접 조작하고 제안받은 절차를 스스로 검증·수정하며 스킬을 작성하도록 한다. 연구팀은 35개 작업 계열과 408개 실행 가능한 사례로 구성된 SkillTransferBench를 만들어 스킬 재사용을 평가했다. 전체 요약 8문장 읽기 → 017 06:11 ▲ 16 · 댓글 1 학습 데이터 없이 확산 모델 가속화하는 방법 확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. AI · 머신러닝 · Consistent Distribution Matching for Data-Free Diffusion Distillation
Key Point 학습 데이터가 필요 없으면서도 최소 함수 평가로 고화질 생성을 하는 새로운 증류 기법이 기존의 데이터 의존성과 복잡한 학습 파이프라인 문제를 해결한다.
핵심 요약
확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. Consistent Distribution Matching이라는 시뮬레이션 프리·데이터 프리 증류 방식을 제안하며, 샘플 생성과 스코어 추정을 하나의 학생 네트워크로 통합한다. 프레임워크는 얼어 있는 교사 모델과 학습 가능한 학생 모델 두 개만 사용하고 하나의 목적함수를 최적화한다. 전체 요약 6문장 읽기 → 018 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 019 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 020 15:11 ▲ 52 · 댓글 2 전자상거래 상품 메인 이미지를 자동 생성하는 AI 프레임워크 공개 알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. AI · 머신러닝 · CommerceGen-Studio: An End-to-End Framework for Commercial-Grade Main-Image Generation
Key Point 전자상거래 플랫폼의 핵심인 상품 이미지를 수초 만에 대규모로 자동 생성하는 상용 AI 시스템의 구조와 한계가 명확히 공개됨으로써, 실제 프로덕션 환경에서 생성형 AI를 어떻게 설계하고 최적화하는지를 이해할 수 있다.
핵심 요약
알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. 세 단계 파이프라인으로 구성된다: (1) PERL-Agent가 상품 메타데이터를 VLM과 LLM이 반복적으로 평가하며 판매 포인트 텍스트로 압축, (2) Layout Thinker Optimization이 생성된 이미지와 캡션 품질을 최적화, (3) SKU-DiT가 배경 없는 상품 이미지, 상표 이미지, 구조화된 레이아웃을 조건으로 최종 이미지 생성. SKU-DiT는 Reinforce-Distill-Reinforce 점진적 훈련 기법으로 학습되어 상품 피델리티, 상표 무결성, 글자 수준의 정확도를 동시에 유지한다. 전체 요약 7문장 읽기 → 021 21:11 당일 +103 필터 없는 AI 이미지·영상 생성 스튜디오 오픈소스화 Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. AI · 머신러닝 · Anil-matcha/Open-Generative-AI · JavaScript
Key Point 기존 상용 AI 영상 플랫폼의 높은 구독료와 필터 제한에서 벗어나, 600개 모델로 무제한 창작이 가능한 자체 호스팅 솔루션이 등장했다는 점이 중요합니다.
핵심 요약
Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. Flux·Kling·Sora·Veo 등 주요 이미지/영상 생성 모델 200여 개를 통합하고 콘텐츠 필터나 제한 없이 사용할 수 있다. 이미지·영상·음성·입술싱크·시네마·워크플로우 등 14개 스튜디오를 포함하며, 자체 호스팅 가능하고 MIT 라이선스로 완전 무료이다. 전체 요약 10문장 읽기 → 022 21:11 당일 +331 로컬 실행되는 AI 이미지·영상 생성 워크플로우 빌더 공개 HeliosGen은 무료 오픈소스 데스크톱 앱으로, 노드 기반의 시각적 인터페이스로 AI 이미지 및 영상 생성 워크플로우를 구축할 수 있다. AI · 머신러닝 · SegFault42/HeliosGen · TypeScript
Key Point 생성형 AI 도구를 클라우드 의존 없이 로컬에서 완전히 제어할 수 있는 대안이 필요한 개발자와 크리에이터에게 유용하며, 오픈소스이므로 커스터마이징과 자체 호스팅이 가능하다.
핵심 요약
HeliosGen은 무료 오픈소스 데스크톱 앱으로, 노드 기반의 시각적 인터페이스로 AI 이미지 및 영상 생성 워크플로우를 구축할 수 있다. 모든 데이터와 생성 결과가 로컬 머신에서만 실행되며, 클라우드 계정이나 구독 없이 kie.ai API 키만으로 동작한다. GPT Image 2, Google Nano Banana, Seedream, Z-Image, Grok Imagine 등의 이미지 모델과 Veo 3.1, Gemini Omni Video, Kling 3.0, Seedance 2.0 등의 영상 모델을 지원한다. 전체 요약 12문장 읽기 → 023 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 024 00:11 ▲ 45 · 댓글 2 극한 압축으로 확산 모델 가속화하는 APEX 등장 확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. AI · 머신러닝 · APEX: Asynchronous Prefix Denoising for Extreme Compression
Key Point 확산 모델의 토큰 수를 획기적으로 줄이면서도 생성 품질을 유지할 수 있는 방법으로, 추론 속도와 비용에 민감한 생성형 AI 서비스 개발에 직접 영향을 미친다.
핵심 요약
확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. APEX는 계층적 레이턴시 공간과 채널 그룹별 비동기 디노이징을 결합한 새로운 방식이다. 오토인코더가 채널 프리픽스를 구조에서 세부사항 순서로 정렬하고, 공유된 단일 디노이저가 토큰을 추가하지 않고 엇갈린 시간에 생성한다. 전체 요약 6문장 읽기 → 025 18:11 ▲ 81 · 댓글 1 미적 코드 생성, 시각 보상으로 가능해졌다 슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AI · 머신러닝 · AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
Key Point 시각 설계가 필요한 UI 코드 생성에서 미적 품질과 정확성을 동시에 달성하는 새로운 접근법이 기존 모델의 한계를 구체적으로 수치로 극복해냈다.
핵심 요약
슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AesCode는 사용자 지시문에 따라 코드를 생성하되, 같은 지시문으로 만든 이미지를 시각 미적 참조로 활용한다. 생성된 코드를 디자인 그래프로 표현해 각 속성을 추적 가능하게 만들고, 이 그래프로부터 두 종류의 보상을 만든다. 전체 요약 8문장 읽기 → 026 03:11 ▲ 164 · 댓글 327 애플, AI 기능 강화한 새 Apple TV 4K 공개 애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. AI · 머신러닝 · New Apple TV 4K
Key Point 애플의 주요 가정용 기기에 생성형 AI 기능이 본격 적용되는 사례로, 음성 인터페이스와 홈 자동화가 어떻게 진화하고 있는지 보여준다.
핵심 요약
애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. 신형 기기는 Siri AI를 탑재해 사용자가 영화·드라마를 찾고 발견하는 경험을 전체 화면 대화형 인터페이스로 제공한다. Siri AI는 애플 인텔리전스 기반으로 더 강력해졌으며, 개인 맥락을 이해해 '알린다가 추천한 쇼 재생'처럼 기기 간 요청을 처리할 수 있다. 전체 요약 13문장 읽기 → 027 00:11 ▲ 135 · 댓글 97 Character.AI, 디즈니에 자산 매각하며 파산 신청 AI 챗봇 스타트업 Character.AI가 미국에서 Chapter 11 파산보호를 신청하고 디즈니에 자산을 매각하기로 했다. AI · 머신러닝 · Character.ai Files for Bankruptcy
Key Point 생성형 AI 초기 성공 기업이 법적·안전 문제로 인해 파산에 이르는 과정과 대형 기술 회사의 인수 전략 변화를 보여주는 사례입니다.
핵심 요약
AI 챗봇 스타트업 Character.AI가 미국에서 Chapter 11 파산보호를 신청하고 디즈니에 자산을 매각하기로 했다. 회사는 수년간 안전 문제와 법적 도전에 직면해 왔으며, 파산 신청서에서 5천만~1억 달러 규모의 부채를 보유한 것으로 추정했다. 디즈니는 주요 입찰자로서 미공개 자산에 대해 2천만 달러를 지불하고, 이전 직원들의 고용을 통한 전환 지원 및 지적재산권에 대한 비독점 라이선스를 받는다. 전체 요약 8문장 읽기 → 028 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 029 12:11 ▲ 11 · 댓글 2 포스터 생성, 텍스트 프롬프트에서 공간 캔버스로 텍스트 프롬프트는 2차원 포스터 구성 의도를 1차원 문장으로 변환해야 하는 비효율적 인터페이스다. AI · 머신러닝 · From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
Key Point 기존 텍스트 프롬프트의 한계를 극복한 새로운 인터페이스 패러다임이 포스터 생성의 제어성을 어떻게 개선하는지 보여주는 구체적인 기술 솔루션이다.
핵심 요약
텍스트 프롬프트는 2차원 포스터 구성 의도를 1차원 문장으로 변환해야 하는 비효율적 인터페이스다. Spatial Canvas Interface는 사용자가 의도를 공간에 직접 배치하는 방식으로, 의미·정체성·텍스트·픽셀 4가지 바인딩 타입과 텍스트 스펙을 조합한다. Compo 모델은 사전학습된 이미지 편집 모델을 기반으로 Spatial Canvas 입력을 이해하도록 적응시켰다. 전체 요약 7문장 읽기 → 030 06:11 ▲ 163 · 댓글 131 Typesafe AI, 7.5조 기업가치 시리즈A 870억 달러 조달 Typesafe AI가 Andreessen Horowitz가 주도하고 Sequoia Capital, DCVC 등이 참여한 시리즈A에서 8억 7천만 달러를 조달했다. AI · 머신러닝 · Typesafe AI raises $870M at $7.5B
Key Point 생성형 AI 인프라 스타트업의 대규모 투자 유치는 엔터프라이즈 AI 시장의 성장 신호이며, 이미 주요 기업들의 프로덕션 환경에서 실제 가치를 제공하고 있음을 보여준다.
핵심 요약
Typesafe AI가 Andreessen Horowitz가 주도하고 Sequoia Capital, DCVC 등이 참여한 시리즈A에서 8억 7천만 달러를 조달했다. Jev 프로덕트에서 사용자들이 좋아하는 기능을 더욱 강화하고, 더 많은 머신 네이티브 모델을 제공할 계획이다. 스마트 소프트웨어 구축을 위한 최고 수준의 인프라를 제공하는 것을 목표로 한다. 전체 요약 6문장 읽기 → 031 18:11 ▲ 18 · 댓글 2 캔버스 지시로 이미지 편집하는 VibeEdit 텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. AI · 머신러닝 · VibeEdit: Image Editing with Canvas Instructions
Key Point 유사한 객체 여럿 중에서 정확히 어떤 것을 편집할지 지정하는 문제를 시각적 주석으로 해결하면서 성능 지표에서 기존 방식을 크게 앞선다.
핵심 요약
텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. VibeEdit는 사용자가 이미지에 직접 공간적 표시와 선택적 짧은 메모를 남기는 새로운 편집 인터페이스를 제공하며, 이 주석들이 함께 캔버스 지시를 형성한다. 별도 텍스트 프롬프트 없이 객체 추가, 제거, 교체, 속성 수정, 이동 등을 수행한다. 전체 요약 8문장 읽기 → 032 18:11 ▲ 38 · 댓글 2 편집과 생성 작업을 위한 통합 대응점 매칭 프레임워크 FreeMatching Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. AI · 머신러닝 · Beyond Spatio-Temporal Priors: A Generalizable Approach for Dense Correspondence Matching
Key Point 생성형 AI의 이미지 편집과 참고 기반 생성 작업에서 객체 정체성을 유지하면서 변환된 이미지 간 대응점을 찾는 근본적 문제에 새로운 해법을 제시해, 콘텐츠 생성 도구의 질적 개선에 직결된다.
핵심 요약
Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. FreeMatching은 생성 모델과 의미론적 파운데이션 표현(semantic foundation representation)을 결합해, 고전 데이터셋·추적 비디오·합성 장면으로부터의 다양한 감독 신호를 활용해 정체성 보존 대응점을 학습하는 프레임워크. 교사 모델 가이드 반복 정제(teacher-guided iterative refinement) 기법을 통해 대응점 주석 없이도 IEG 작업에서 대응점 품질을 추가 개선. 전체 요약 6문장 읽기 → 033 12:11 ▲ 127 · 댓글 204 AI 노래로 수십억 스트림 사기한 음악인, 징역 18개월 미국 노스캐롤라이나 주의 뮤지션 마이클 스미스(54세)가 봇 스트리밍으로 인한 음악 사기혐의로 징역 18개월 선고받고 부정 적립 로열티 800만 달러 반납을 명령받았다. AI · 머신러닝 · US man given prison sentence for bot-farming music streams
Key Point AI 생성 음악으로 스트리밍 플랫폼을 대규모로 사기친 첫 유죄 사례로, 생성형 AI 시대 저작권 보호와 스트리밍 시스템의 적절성에 대한 문제를 드러낸다.
핵심 요약
미국 노스캐롤라이나 주의 뮤지션 마이클 스미스(54세)가 봇 스트리밍으로 인한 음악 사기혐의로 징역 18개월 선고받고 부정 적립 로열티 800만 달러 반납을 명령받았다. 스미스는 2017년부터 2024년 체포까지 약 10,000개의 거짓 계정을 생성해 자신의 AI 생성 음악을 자동으로 스트리밍했다. 그는 수십억 건의 봇 스트림을 통해 수백만 곡의 AI 생성 곡을 배포했으며, 한 곡에 대한 의심스러운 스트림 패턴이 적발되지 않도록 수천 곡에 걸쳐 자동화된 스트림을 분산시켰다. 전체 요약 5문장 읽기 → 034 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 035 03:11 ▲ 25 · 댓글 2 이미지·텍스트 동시 생성하는 연속형 확산 모델 공개 Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. AI · 머신러닝 · Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
Key Point 텍스트와 이미지를 진정으로 통합되는 한 가지 방식으로 모두 생성할 수 있다면, 멀티모달 모델의 아키텍처가 단순해지고 더 나은 성능을 낼 수 있다는 점을 실증한다.
핵심 요약
Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. 텍스트 블록과 이미지를 순서가 있는 연속적 하이퍼청크로 구성하며, Flow Matching을 통해 이들 위의 단일 벡터장을 학습한다. 크로스 모달 상호작용을 위해 공동 어텐션을 사용하고, 각 모달리티별 피드포워드 네트워크로 처리한다. 전체 요약 7문장 읽기 → 036 21:11 당일 +343 GraphBLAS 기반 초고속 그래프 데이터베이스 FalkorDB 공개 FalkorDB는 희소 행렬(Sparse Matrix) 기반의 그래프 데이터베이스로, 인접 행렬을 GraphBLAS로 표현하고 선형대수를 활용해 쿼리를 실행한다. AI · 머신러닝 · FalkorDB/FalkorDB · Rust
Key Point 희소 행렬 기반의 그래프 데이터베이스로 기존 그래프DB와는 다른 구조를 제공하며, LLM 시대에 Knowledge Graph 구축이 중요해지면서 새로운 선택지를 제시한다.
핵심 요약
FalkorDB는 희소 행렬(Sparse Matrix) 기반의 그래프 데이터베이스로, 인접 행렬을 GraphBLAS로 표현하고 선형대수를 활용해 쿼리를 실행한다. LLM용 Knowledge Graph 구축에 최적화되었으며, 생성형 AI, 에이전트 메모리, 클라우드 보안, 사기 탐지 등 다양한 용도를 지원한다. OpenCypher 쿼리 언어를 지원하며 Property Graph 모델을 준수하고, 노드와 관계에 속성을 부여할 수 있다. 전체 요약 9문장 읽기 → 037 03:11 ▲ 61 · 댓글 1 LLM이 외부 지침을 선별하는 법: 신뢰성 판단과 거부 능력 모델이 성능이 높아질수록 인간이 설계한 워크플로우 지침이 부정확해졌을 때 실행을 제약하는 문제를 지적한다. AI · 머신러닝 · Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
Key Point 생성형 AI를 에이전트로 운영할 때 외부 지침에 무조건 따르는 것이 항상 최선은 아니라는 점을 실증적으로 증명하며, 모델이 거짓 지침을 거부하고 참 지침만 선별하는 능력을 어떻게 학습시킬 수 있는지를 다룬다.
핵심 요약
모델이 성능이 높아질수록 인간이 설계한 워크플로우 지침이 부정확해졌을 때 실행을 제약하는 문제를 지적한다. 이 논문은 '생각의 틀 밖으로' 나가는 능력을 정의하는데, 유용한 지침은 따르면서 신뢰할 수 없는 지침은 무시하는 능력을 뜻한다. Box²-Bench라는 벤치마크를 제시해 모델과 작업을 고정하되 워크플로우 신뢰성만 변동시켜 지침 의존도를 측정한다. 전체 요약 7문장 읽기 → 038 21:11 당일 +141 당신의 PC 성능에 최적화된 오픈 모델 추천·실행 엔진 'Magnitude' Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. AI · 머신러닝 · magnitudedev/magnitude · Rust
Key Point 내 하드웨어에서 실제로 빠르게 돌아갈 오픈소스 AI 모델을 자동으로 찾아주고 최적화해주므로, 로컬에서 생성형 AI를 쓰려는 개발자와 AI 에이전트 사용자에게 필수 도구다.
핵심 요약
Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. 머신 프로파일링을 통해 당신의 하드웨어 사양을 분석한 후, 다운로드 전에 각 모델과 양자화 버전의 예상 추론 속도(tok/s)를 추정해 사용자가 최적의 모델을 선택하도록 돕는다. Ollama나 LM Studio와 달리, 사용자가 선택한 모델을 컨텍스트 크기와 추측 디코딩 등으로 정확한 하드웨어에 맞게 튜닝한다. 전체 요약 8문장 읽기 → 039 21:11 ▲ 22 · 댓글 2 Flow Matching으로 이미지 보정 도구 제어하기 기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. AI · 머신러닝 · FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
Key Point 자동회귀 방식의 느린 추론을 벗어나 50배 빠른 이미지 보정 시스템을 구현한 새로운 접근 방식으로, 생성형 AI 기반 편집 도구의 성능과 효율성을 크게 개선할 수 있는 경로를 제시한다.
핵심 요약
기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. FlowTool은 이 문제를 Flow Matching으로 재정의하여 입력 이미지와 사용자 지시에 조건부된 고품질 편집 파라미터 분포를 직접 모델링한다. 비전-언어 모델과 Diffusion Transformer 기반 파라미터 생성기를 결합해 가우시안 잡음을 편집 계획으로 변환한다. 전체 요약 8문장 읽기 → 040 21:11 ▲ 59 · 댓글 1 CoWindow: 주의 메커니즘의 중복 계산을 줄인 구조화된 어텐션 기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. AI · 머신러닝 · CoWindow Attention: Full Causal Coverage Is a Collective Property
Key Point 효율적인 장문맥 처리가 필수인 생성형 AI에서 Full Attention의 중복 계산을 제거하면서도 성능을 유지하는 방법이 제시되었으므로, 스케일링 효율성을 개선하려는 팀들의 관심을 받을 만합니다.
핵심 요약
기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. 연구팀이 제안한 CoWindow Attention(CoWA)은 KV 헤드 간에 인과 히스토리 접근을 분산시키는 구조화된 어텐션이다. 모든 헤드는 근거리 대각 윈도우와 접두사-싱크 윈도우를 공유하며, 나머지 먼 과거는 보완적 장거리 윈도우로 분할되어 전체 인과 커버리지를 달성한다. 전체 요약 10문장 읽기 → 041 18:11 ▲ 37 · 댓글 3 통합 모델이 자기 생성물을 스스로 고치는 방법 찾았다 이미지를 보고 만들 수 있는 통합 멀티모달 모델에서, 생성된 이미지의 문제를 진단하고 수정하는 과정을 자동으로 학습하는 방법을 제시했다. AI · 머신러닝 · Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning
Key Point 생성형 AI 모델이 자신의 오류를 인식하고 반복적으로 수정하는 능력을 학습하는 방식이 바뀌고 있으며, 이는 이미지 생성의 품질 향상과 모델 구조의 단순화를 동시에 이룬다.
핵심 요약
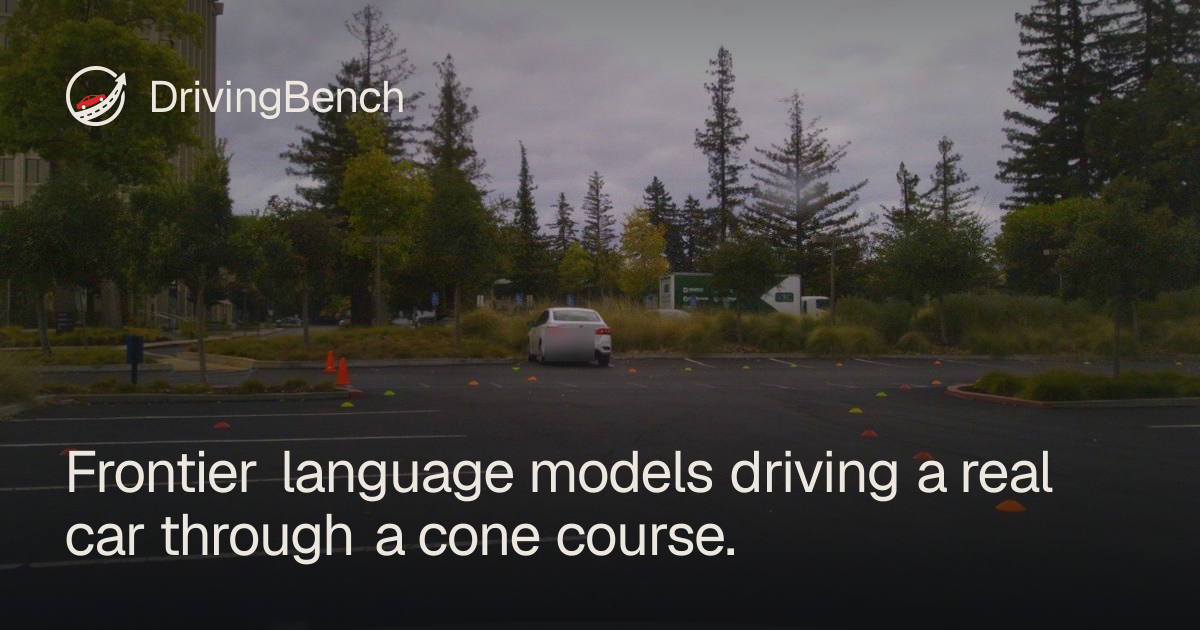
이미지를 보고 만들 수 있는 통합 멀티모달 모델에서, 생성된 이미지의 문제를 진단하고 수정하는 과정을 자동으로 학습하는 방법을 제시했다. 기존 지도 학습(SFT)은 시작은 빠르지만 효과적인 수정 경로를 찾지 못했고, 렌더러나 한 부분만 최적화하는 단순한 강화학습(RL)은 잠재력을 충분히 활용하지 못했다. UMM-Reflection은 강화학습을 반사 궤적 전체에 적용하되, 같은 초기 이미지를 공유하는 자매 궤적들의 상대적 이점으로 반사 전략을 비교하고, 한 번의 궤적 단위 이점으로 반사 텍스트와 흐름 기반 수정을 함께 업데이트한다. 전체 요약 6문장 읽기 → 042 22:29 ▲ 193 · 댓글 165 GPT-6 Astra, 자동차 운전 벤치마크 완주 성공 DrivingBench는 AI 모델의 자동차 운전 능력을 평가하는 벤치마크 플랫폼으로, 모델이 한 번의 연속 대화에서 최대 3회 시도를 합니다. AI · 머신러닝 · GPT-6 Astra has gained the ability to drive a car
Key Point GPT-6 Astra가 현재까지 이 벤치마크를 유일하게 완주하며 생성형 AI의 자율주행 수준을 처음 실증했으며, 다른 선두 모델들과의 격차가 얼마나 큰지 보여줍니다.
핵심 요약
DrivingBench는 AI 모델의 자동차 운전 능력을 평가하는 벤치마크 플랫폼으로, 모델이 한 번의 연속 대화에서 최대 3회 시도를 합니다. GPT-6 Astra는 코스 중심선으로부터 4m 이내를 유지하면서 100% 진행률을 달성하고 5분 22초 만에 코스를 완주했습니다. GPT-6 Astra의 최고 성능 실행(run #2)은 5:22에 134.7m 거리를 주행하며 2.46억 토큰을 소비했고, 비용은 $7.74였습니다. 전체 요약 6문장 읽기 → 043 22:29 ▲ 41 · 댓글 3 AI 세계 모델의 신뢰성을 평가하는 벤치마크 공개 Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. AI · 머신러닝 · HappyWorld-Bench
Key Point 세계 모델이 상호작용과 수정에 얼마나 잘 반응하고 신뢰성을 유지하는지 평가하는 새로운 기준이 필요한 상황에서, 이 벤치마크는 비디오·공간·구현형 모델 전반의 약점을 구체적으로 드러낸다.
핵심 요약
Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. 벤치마크는 생성 구성부터 통합 세계 모델링까지 6단계의 계층적 능력 프레임워크(W1-W6)를 기반으로 설계되었다. 비디오 세계 모델(1,138개 프롬프트), 공간 세계 모델(300개 장면), 구현형 세계 모델(254개 테스트 케이스) 등 세 가지 독립적 평가 트랙으로 구성된다. 전체 요약 8문장 읽기 → 044 15:11 ▲ 32 · 댓글 3 이미지 생성 모델의 벡터 양자화 학습 안정성 개선 방법 자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. AI · 머신러닝 · StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
Key Point 이미지 생성 모델의 핵심 컴포넌트인 벡터 양자화의 학습 불안정성을 해결하는 실무적 방법론을 제시하므로, 생성형 AI 모델 개발자와 연구자에게 즉시 적용 가능한 지침을 제공한다.
핵심 요약
자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. 인코더-디코더와 코드북 학습이 얽혀 있어 두 모듈이 협력할 때만 작동하므로, 학습이 가중될수록 붕괴되는 취약함이 있다. StableVQ는 동적 STE를 통해 인코더의 학습 목표를 안정화하고, 리전 VQ 손실로 코드북이 독립적으로 전체 추적을 보장하며, 분리된 스케줄로 각 모듈이 별도의 학습률을 갖도록 한다. 전체 요약 5문장 읽기 → 045 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 046 03:10 ▲ 116 · 댓글 66 AI로 글을 쓰지 말고 직접 생각하라 Claude나 ChatGPT 같은 AI는 코딩·리서치에는 유용하지만 글쓰기에는 사용하지 말아야 한다. 기타 · Don't Use AI to Write
Key Point 생성형 AI에 글쓰기를 맡기는 것이 시간 절약처럼 보이지만, 실은 핵심 사고 과정을 포기하는 것이므로 이를 올바르게 활용하는 방법을 알아야 한다.
핵심 요약
Claude나 ChatGPT 같은 AI는 코딩·리서치에는 유용하지만 글쓰기에는 사용하지 말아야 한다. 글쓰기는 문제를 깊이 있게 사고하고 핵심을 명확히 하는 과정인데, AI에 맡기면 이 사고 단계를 건너뛰게 된다. AI가 생성한 문서는 겉으로는 그럴듯해 보이지만, 실제로 당신의 가장 중요한 생각을 담고 있는지 확인할 수 없다. 전체 요약 6문장 읽기 → 047 21:10 ▲ 117 · 댓글 38 30년 방치된 아미가 유닉스, 현대 하드웨어에서 부활 1990년 출시했던 코모도어의 Amix(System V Release 4)를 커뮤니티가 현대화하는 프로젝트가 진행 중이다. 오픈소스 · 도구 · Amiga Unix, Again
Key Point 1990년대 레트로 시스템을 오픈소스 커뮤니티가 현대 하드웨어에서 복구하는 과정에서 AI와 실제 검증을 결합한 독특한 개발 방식을 보여주며, 실제 66040/68060 머신에서 구동되는 단계까지 진행되고 있다.
핵심 요약
1990년 출시했던 코모도어의 Amix(System V Release 4)를 커뮤니티가 현대화하는 프로젝트가 진행 중이다. 68040·68060 프로세서와 현대 가속 보드에서 Amix를 구동하며, 현대적 도구체인, apkg 패키지 매니저, 이전에 없던 카드용 드라이버들을 제공한다. 플로피·CD-ROM 부팅 설치, 원격 저장소에서 grep·gzip·less·patch·zlib 등 GNU/BSD 도구를 설치하는 패키지 관리 시스템을 갖췄다. 전체 요약 6문장 읽기 → 048 03:10 ▲ 103 · 댓글 76 실제 사진과 AI 생성 이미지, 당신은 구분할 수 있을까 실제 사진인지 AI가 생성한 이미지인지 맞추는 간단한 게임 서비스다. AI · 머신러닝 · Can you tell which images are AI-generated?
Key Point AI 생성 이미지가 일상화되면서 진짜와 가짜를 구분하는 능력이 중요해지고 있으며, 이 게임을 통해 자신의 판별력을 테스트해볼 수 있다.
핵심 요약
실제 사진인지 AI가 생성한 이미지인지 맞추는 간단한 게임 서비스다. 60초 동안 여러 이미지를 보고 빠르게 판단해야 하며, 각 이미지마다 10초씩 제한된다. 연속으로 3개를 맞추면 콤보 보너스를 받을 수 있다. 전체 요약 4문장 읽기 → 049 09:10 당일 +130 생성형 AI용 문서 처리 플랫폼 Docling, 비디오·이메일 지원 Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. AI · 머신러닝 · docling-project/docling · Python
Key Point 생성형 AI 개발에 필수적인 문서 전처리 도구로, 최근 비디오·이메일·XBRL 등 엔터프라이즈 형식 지원을 확대했으므로 데이터 파이프라인 구축에 직접 활용할 수 있다.
핵심 요약
Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. 페이지 레이아웃, 표 구조, 수식, 이미지 분류 등 고급 PDF 이해 기능을 제공하며, 마크다운·HTML·JSON 등 여러 형식으로 내보낼 수 있다. LangChain, LlamaIndex, Crew AI 등 주요 AI 프레임워크와 통합되며, MCP 서버와 API 서버로 구동할 수 있고 로컬 실행으로 민감한 데이터 보호를 지원한다. 전체 요약 6문장 읽기 → 050 00:10 ▲ 314 · 댓글 271 생성형 AI 시대, 프로그래머는 왜 계속 만드는가 저자는 생성형 AI가 프로그래밍 작업의 의미를 빼앗는다고 느껴 극심한 정신적 충격을 받았다. AI · 머신러닝 · Fuck it, make it anyway
Key Point 생성형 AI 도구 확산 속에서 프로그래머와 게임 개발자들이 직면한 현실적 고민—기술 발전이 창작의 즐거움과 자존감을 위협할 때, 어떻게 계속 만들어 나갈 것인가라는 질문을 다룬다.
핵심 요약
저자는 생성형 AI가 프로그래밍 작업의 의미를 빼앗는다고 느껴 극심한 정신적 충격을 받았다. 코드 어시스턴트를 쓰면 생산성은 높아지지만 즐거움이 없고, 자신의 작업이라는 느낌이 사라진다. AI로 쉽게 만들 수 있는 도구들이 증가하면서 작은 프로젝트에 대한 동료들의 피드백과 인정이 줄어들었다. 전체 요약 5문장 읽기 → 051 12:10 ▲ 100 · 댓글 31 생성형 AI, 반복 편집할수록 의미 왜곡되는 현상 분석 보안 연구자가 LLM을 반복적으로 재작성하도록 지시했을 때 어떻게 실패하는지 실험했다. AI · 머신러닝 · Recursion into madness
Key Point LLM 에이전트 루프와 재귀 처리의 근본적 한계를 보여주는 사례로, 모델이 자신의 출력에 반복 접근할 때 어떻게 의미가 누적 변형되는지 이해하는 데 중요하다.
핵심 요약
보안 연구자가 LLM을 반복적으로 재작성하도록 지시했을 때 어떻게 실패하는지 실험했다. 이미지 파이프라인은 노이즈 때문에 몇 번 반복하면 즉시 왜곡되지만, 텍스트는 초기엔 안정적이다. 텍스트 재작성은 처음엔 세밀한 변경이 가능하지만, 오픈엔디드 프롬프트는 모델이 표류하다 안정화된다. 전체 요약 6문장 읽기 →