001 15:11 ▲ 61 · 댓글 1 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 002 06:11 ▲ 104 · 댓글 18 NVIDIA의 NVL72 시스템, 올바른 스케줄러로 GPU 활용률 27% 향상 InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. 인프라 · 데브옵스 · Grace Blackwell needs a new scheduler: 27% more usable GPUs from the same racks
Key Point NVL72 같은 랙 규모 시스템에서 통신 병목을 피하려면 하드웨어만으로는 부족하고, 올바른 스케줄링이 처리량을 14% 이상 개선할 수 있다.
핵심 요약
InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. NVIDIA의 NVL72 시스템은 한 랙의 72개 GPU를 통합 NVLink 패브릭으로 연결하면서 멀티 노드 AI 워크로드를 고대역폭으로 처리할 수 있게 했다. 대규모 학습에서 텐서 병렬화와 전문가 병렬화는 통신 병목이 되는데, 64웨이 전문가 병렬화를 사용하면 InfiniBand에서 학습 시간의 최대 60%가 통신에 소비된다. 전체 요약 13문장 읽기 → 003 03:11 ▲ 179 · 댓글 82 팔로알토 방화벽 0-day 연쇄 공격, 25개 서버 장악 Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 보안 · Chained PHP2Shell Exploit Roots 25 Servers, Including US Government Servers
Key Point PAN-OS 방화벽의 관리 인터페이스 노출이 정부 기관의 내부 AD까지 연결되는 공격 경로를 보여주며, 노출된 장비 발견에서 ID 인프라 침해까지의 전체 과정이 기록된 사례로 방어 전략 수립의 교훈을 제공한다.
핵심 요약
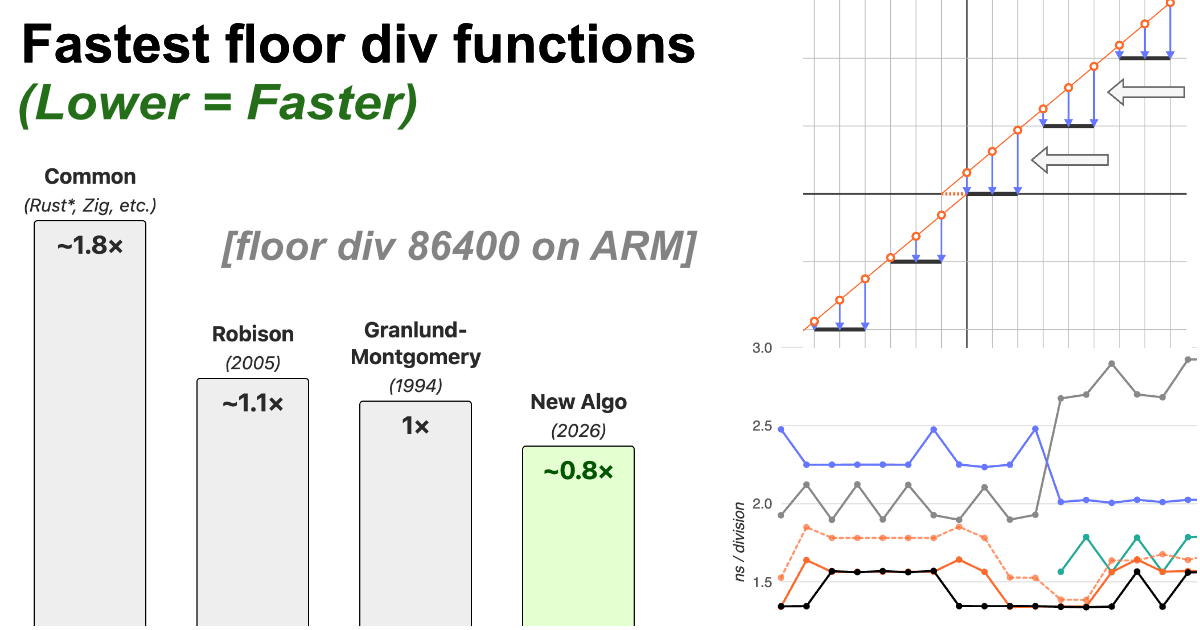
Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 공격자는 PHP2Shell(CVE-2026-109618/109619)과 Fragnesia 커널 권한 상승 익스플로잇(CVE-2026-46300)을 연결해 인증 없이 한 번의 HTTP 요청으로 루트 접근을 달성했다. PHP2Shell은 PHP의 session.upload_progress 메커니즘을 악용해 메모리 고갈-정보 유출-스테일 참조 생성-코드 실행 네 단계로 nobody 권한 확보까지 도달한다. 전체 요약 13문장 읽기 → 004 00:11 ▲ 123 · 댓글 10 64비트 부호있는 정수 나눗셈을 더 빠르게 하는 새로운 알고리즘 부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 인프라 · 데브옵스 · A new faster algorithm to compute 64-bit signed floor division
Key Point 정수 나눗셈은 단순해 보이지만 음수 처리와 성능 최적화가 깊이 있으며, 다양한 CPU에서 구현 방식을 달리 선택해야 하므로 저수준 성능 최적화가 중요한 시스템 프로그래밍에 실질적 가치가 있습니다.
핵심 요약
부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 컴파일 타임에 나누는 수가 정해진 경우, 기존 방법은 곱셈 1회 + 2~3 사이클 또는 나머지 계산이 필요했으며, 음수 처리를 위해 추가 분기나 비교가 들어갑니다. 1994년 Granlund·Montgomery 논문의 기법을 확장하면 양수 나눗셈을 부호 반사로 처리해 5~6 사이클을 3 사이클로 단축할 수 있고, 2005년 Arch D. Robison 논문은 곱셈-더하기-시프트 조합으로 더 단순한 구현을 제시했습니다. 전체 요약 10문장 읽기 → 005 00:11 ▲ 189 · 댓글 120 미국 3개월간 배터리 저장소 20.2GWh 신규 설치, 사상 최대 미국은 2026년 2분기에 20.2GWh의 배터리 저장 용량을 신규 설치해 분기 최고 기록을 달성했으며, 올해 상반기 누적 설치량은 30.8GWh로 전년 동기 대비 23% 증가했다. 인프라 · 데브옵스 · The US added a record 20.2 GWh of battery storage in just 3 months
Key Point 전력망 안정성 강화와 에너지 수요 증가에 대응하는 배터리 저장소 투자가 미국 전역으로 확산되고 있으며, 이는 전력 인프라와 재생에너지 산업의 구조 변화를 시사한다.
핵심 요약
미국은 2026년 2분기에 20.2GWh의 배터리 저장 용량을 신규 설치해 분기 최고 기록을 달성했으며, 올해 상반기 누적 설치량은 30.8GWh로 전년 동기 대비 23% 증가했다. 유틸리티급 배터리가 성장을 주도했으며, 2분기 설치량 18GWh 중 애리조나 4곳, 캘리포니아 2곳, 유타 1곳의 기가와트급 규모 프로젝트가 포함되어 있다. 애리조나는 단일 주 기록인 6.2GWh를 설치했고, 텍사스 3.8GWh, 캘리포니아 3.6GWh를 추가했다. 전체 요약 12문장 읽기 → 006 15:11 ▲ 155 · 댓글 5 에이전트 메모리의 숨은 대가를 파헤치다 장기 작업을 수행하는 에이전트에서 메모리 시스템의 실제 가치를 검토한 연구를 발표했다. AI · 머신러닝 · Memory Tax: Dissecting the Net Value of Agent Memory
Key Point 에이전트 시스템에서 흔히 사용되는 메모리 메커니즘이 실제로는 직접 검색보다 떨어질 수 있다는 점을 실증적으로 보여주기 때문에, 현재의 메모리 아키텍처 설계 방향을 재검토해야 한다.
핵심 요약
장기 작업을 수행하는 에이전트에서 메모리 시스템의 실제 가치를 검토한 연구를 발표했다. 여러 벤치마크와 모델을 대상으로 대규모 평가한 결과, 많은 전용 메모리 시스템이 단순한 RAG 방식을 하회하는 성능을 보였다. 메모리의 순 가치를 '메모리 이득'과 '메모리 세금'으로 구분했으며, 이는 생 히스토리에서 직접 조회했을 때와의 차이에서 비롯된다. 전체 요약 7문장 읽기 → 007 12:11 ▲ 26 · 댓글 2 LLM 환각 탐지 벤치마크 비교 불가능한 이유 대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. AI · 머신러닝 · Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
Key Point LLM 성능을 평가하는 핵심 지표인 환각 탐지가 벤치마크마다 다르게 정의되고 측정되기 때문에, 어떤 방법이 실제로 더 나은지 판단할 수 없다는 문제를 드러낸다.
핵심 요약
대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. 연구팀은 환각 탐지를 벤치마크 조건부 측정 문제로 보고, 세 가지 축으로 기존 벤치마크들을 분류했다: 모델 출력과 근거 조건을 어떻게 얻는지를 설명하는 '출처', 사실성과 충실성 오류를 어떻게 정의하는지를 나타내는 '유형분류', 환각을 어떤 단위로 주석·예측·평가하는지를 명시하는 '단위'이다. 벤치마크 구성, 주석 방식, 평가 방법의 차이가 예측 작업에 어떻게 영향을 미치고, 탐지기의 메커니즘과 가정이 어떤 조건에서 성능을 보이는지를 분석했다. 전체 요약 5문장 읽기 → 008 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 009 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 010 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 011 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 012 21:11 당일 +1,930 개인 맞춤형 학습 AI 튜터 DeepTutor 공개 홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. AI · 머신러닝 · HKUDS/DeepTutor · Python
Key Point 개인화된 AI 학습이 주목받는 시대에 오픈소스 기반의 완전한 튜터링 플랫폼이 공개되어, 교육용 AI 애플리케이션을 직접 구축하려는 개발자와 교육 기관에 실제 활용 가능한 기반을 제공한다.
핵심 요약
홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. Python 기반이며 deeptutor.info에서 공식 문서를 제공한다. 에이전트 네이티브 아키텍처로 설계되었으며 도구와 능력 플러그인 모델을 지원한다. 전체 요약 11문장 읽기 → 013 06:11 새 버전 Rust 1.98.0 출시, 수명 단축 강제 해제와 안전성 검사 강화 Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. 오픈소스 · 도구 · rust-lang/rust@1.98.0
Key Point Rust를 실무에서 쓰는 개발자라면 호환성 변화와 새로운 안전 검사 규칙, 플랫폼 지원 정책의 변화를 파악해야 기존 코드가 컴파일되지 않는 상황을 피할 수 있다.
핵심 요약
Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. memcmp, memset, strlen 같은 코어 런타임 심볼을 대상으로 invalid_runtime_symbol_definitions 린트(금지 기본값)와 suspicious_runtime_symbol_definitions 린트(경고 기본값)가 추가되었으며, 향후 확대될 예정이다. c_void_returns 린트(경고 기본값)로 core::ffi::c_void를 반환 타입으로 사용하는 것을 검사한다. 전체 요약 9문장 읽기 → 014 21:11 당일 +110 AI를 위한 PDF 파서, 접근성 자동화까지 지원 OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 오픈소스 · 도구 · opendataloader-project/opendataloader-pdf · Java
Key Point LLM 기반 애플리케이션의 문서 처리 성능을 크게 좌우하는 PDF 파싱 도구이면서 동시에 전 세계 규제 대상이 되고 있는 PDF 접근성 자동화를 오픈소스로 제공하는 점이 의미 있다.
핵심 요약
OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 200개 실제 PDF로 벤치마크한 결과 전체 정확도 0.907(표 추출 0.928)로 기존 도구 중 1위이며, 하이브리드 모드에서 복잡한 테이블·수식·차트를 AI로 처리한다. 로컬 모드는 결정적(deterministic) 출력으로 0.015초/페이지 속도, 하이브리드 모드는 0.463초/페이지로 처리하며 Python·Node.js·Java SDK를 제공한다. 전체 요약 8문장 읽기 → 015 18:11 ▲ 22 · 댓글 8 단순한 RAG가 복잡한 에이전트 메모리보다 우수하다 LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. AI · 머신러닝 · Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
Key Point LLM 기반 대화 시스템에서 고도의 메모리 아키텍처가 반드시 필요하지 않을 수 있다는 점이 개발자의 시스템 설계 선택을 바꿀 수 있기 때문이다.
핵심 요약
LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. 이 논문은 Raw-RAG라는 단순한 RAG 베이스라인을 제안했다: 원본 대화 이력에 대해 밀집 벡터 검색과 재정렬만 수행한 후 증거를 LLM에 제공하는 방식이다. LoCoMo, LongMemEval, MEME, MemoryAgentBench 4개 벤치마크에서 Raw-RAG는 7개 벤치마크-모델 조합 중 6개에서 1위를 차지했으며, 가장 강력한 에이전트 메모리 시스템 대비 0.13~5.53점 높은 성능을 보였다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 24 · 댓글 1 음성 에이전트가 말 듣는 중에 일을 준비한다 음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. AI · 머신러닝 · Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
Key Point 음성 에이전트의 응답 지연을 줄이는 근본적인 아키텍처 개선으로, 실시간 음성 인터페이스에서 사용 경험을 크게 향상시킬 수 있다.
핵심 요약
음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. 기존 추측적(speculative) 접근은 음성 입력 중에 작업을 시작하지만, 청크 경계나 업데이트 시 중단 방식은 도구 호출의 인자가 완성되기 전에 잘릴 수 있다. 이 논문은 '하트비트 싱킹(Heartbeat Thinking)'을 제안하는데, 이는 음성 업데이트 시마다 새로운 사고 인스턴스를 호출하면서도 진행 중인 작업과 배포된 도구는 계속 실행할 수 있도록 한다. 전체 요약 7문장 읽기 → 017 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 018 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 019 03:11 ▲ 126 · 댓글 46 안드로이드 폰에서 iOS 16.5 전체 시스템 부팅 HackiOS는 안드로이드 폰의 하드웨어 위에서 iOS 16.5의 미수정 사용자 영역을 실행하는 오픈소스 XNU 커널(xnu-8796.121.2) 포팅 프로젝트다. 하드웨어 · 시스템 · Show HN: Run full iOS 16.5 firmware on Android Devices
Key Point 안드로이드 하드웨어에서 Apple의 XNU 커널과 완전한 iOS 사용자 영역을 실행하는 것이 가능함을 보여주는 포팅으로, 폐쇄된 생태계와 오픈소스의 경계를 넘나드는 기술적 성과다.
핵심 요약
HackiOS는 안드로이드 폰의 하드웨어 위에서 iOS 16.5의 미수정 사용자 영역을 실행하는 오픈소스 XNU 커널(xnu-8796.121.2) 포팅 프로젝트다. 독자 EFI 로더, Apple의 폐쇄 드라이버 대체물, UEFI 포트, Linux Wi-Fi 드라이버의 호환성 레이어로 가능하게 했다. POCO X5 Pro 5G(Snapdragon 778G)와 QEMU(aarch64) 두 환경에서 실행되며, 안드로이드로 부팅할 때 아무것도 플래시되지 않는다. 전체 요약 13문장 읽기 → 020 21:11 당일 +181 팀의 모든 앱을 연결하는 AI 플랫폼 'Onyx' 오픈소스 공개 50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. AI · 머신러닝 · onyx-dot-app/onyx · Python
Key Point 조직 내부의 분산된 앱과 데이터를 하나의 AI 컨텍스트 층으로 통합하려는 팀들이 자체 호스팅으로 데이터 보호를 하면서 고급 AI 기능을 활용할 수 있게 된다.
핵심 요약
50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. LLM이 공개 정보뿐 아니라 팀 내부 정보도 활용할 수 있도록 하는 것을 목표로 하며, 자체 호스팅으로 데이터 주권을 보장한다. MCP 기반 검색이나 인덱스 없는 방식과 달리 Onyx는 내부 표현으로 지식을 구축해 낮은 지연시간과 비용으로 관련성 높은 컨텍스트를 제공한다. 전체 요약 10문장 읽기 → 021 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 022 15:11 새 버전 일렉트론 45, 크로뮴 156으로 업그레이드 Electron v45.0.0이 출시되어 Chromium 156.0.8078.48, Node.js v24.22.0, V8 15.6을 포함한다. 웹 · 프론트엔드 · electron/electron@v45.0.0
Key Point Electron 앱 개발자들이 보안·성능·API의 중대한 변화를 반영해야 하며, 특히 32비트 지원 중단과 동기식 safeStorage 제거는 기존 앱에 영향을 줄 수 있다.
핵심 요약
Electron v45.0.0이 출시되어 Chromium 156.0.8078.48, Node.js v24.22.0, V8 15.6을 포함한다. 샌드박스 렌더러의 프리로드 스크립트 실행 성능을 개선했으며, Buffer와 타이머 모듈 같은 전역 객체를 제거해 번들 크기를 줄였다. nodeIntegrationInWorker 옵션에서 Worker가 부모 프레임의 Node.js 통합 여부를 정확히 반영하도록 수정했다. 전체 요약 13문장 읽기 → 023 12:11 ▲ 26 · 댓글 3 실시간 변경되는 업무 기록을 다루는 AI의 한계 측정 팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. AI · 머신러닝 · MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
Key Point 엔터프라이즈 AI가 현실의 복잡한 협업 환경에서 정보 충돌과 불일치를 처리하는 방식의 근본적 한계를 측정한 첫 번치마크로, 기업용 AI 에이전트 개발의 방향을 제시한다.
핵심 요약
팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. 시뮬레이션된 협업 프로젝트의 멀티모달 기록 1,613개 질문으로 구성되며, 증거 추론(Evidence Reasoning), 충돌 해결(Conflict Resolution), 답변 불가능 인식(Unanswerability) 세 가지 범주를 포함한다. 프로펠리어터리(상용) 및 오픈소스 멀티모달 LLM 10개를 평가한 결과, 가장 성능이 좋은 모델들도 출처나 시간이 다른 정보가 충돌할 때, 또는 증거가 여러 이미지에 걸쳐 있을 때 정확도가 급격히 떨어진다. 전체 요약 6문장 읽기 → 024 06:11 ▲ 150 · 댓글 177 Steam 유저들, Next Fest의 AI 생성 게임 범람에 필터 요청 Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. 웹 · 프론트엔드 · Steam Users Beg for "No AI" Filter as Vibecoders Flood Next Fest
Key Point 게임 개발에서 AI 도구의 보편화가 전환점을 맞으면서, 플랫폼의 큐레이션 정책과 유저 경험의 충돌이 현실화되고 있다.
핵심 요약
Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. Claude Opus 5.5 출시와 최근의 분해·매시업 모드 열풍이 AI 생성 게임 증가의 배경으로 지적된다. Steam 커뮤니티 유저들은 저품질 콘텐츠를 걸러낼 수 없어 원하는 게임을 찾기 어려워하는 상황을 호소하고 있다. 전체 요약 8문장 읽기 → 025 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 026 21:11 당일 +190 에이전트를 위한 타입 안전 그래프 DB, Omnigraph 공개 Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 오픈소스 · 도구 · ModernRelay/omnigraph · Rust
Key Point AI 에이전트가 공유 상태를 안전하게 읽고 쓸 수 있는 데이터 계층이 필요할 때, Git 워크플로우와 정책 기반 접근 제어를 갖춘 오픈소스 솔루션이 나왔다.
핵심 요약
Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 타입 온톨로지(`.pg` 스키마로 노드·엣지 타입, 키, 제약 선언)를 통해 에이전트들이 통일된 도메인 모델을 강제할 수 있으며, 모든 쓰기에서 엔진이 검증한다. 그래프 순회, 벡터 검색(ANN), 전문 검색, 상호 순위 융합을 한 번의 쿼리로 처리하는 통합 검색 엔진으로 높은 정확도의 컨텍스트를 조립할 수 있다. 전체 요약 11문장 읽기 → 027 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 028 21:11 당일 +184 AI 초보자 위한 완전한 빕 코딩 학습 가이드 데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. AI · 머신러닝 · datawhalechina/easy-vibe · JavaScript
Key Point AI 코딩의 기초부터 프로덕션 배포까지 무료로 배울 수 있는 체계적이고 다국어 지원되는 교육 자료로, 특히 초보자가 AI로 실제 제품을 만들어본다는 점이 차별화된다.
핵심 요약
데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. 초보자 단계(Stage 1)는 실제 문제 찾기에서 시작해 기회 포착, 방향 선택, 사용자 조사, 프로토타입 구축, AI 통합, 최종 완성까지 단계별로 진행되며 실습 예제와 상호작용형 데모로 '배우고 잊는 것'을 방지한다. 중급 개발자 단계(Stage 2)는 프론트엔드 UI 설계, Git 및 데이터베이스, 백엔드 API, Stripe 결제 통합, Zeabur 배포 등을 다루며 AI 카피라이팅 SaaS, 온라인 시험 시스템 등 실제 프로젝트를 완성한다. 전체 요약 8문장 읽기 → 029 18:11 ▲ 27 · 댓글 2 논문을 포스터로 변환하는 AI 벤치마크 RAP 공개 논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. AI · 머신러닝 · RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
Key Point 시각적 코딩 벤치마크의 공백을 채우고, 객관적 평가와 인간 설계 재활용을 동시에 가능하게 하는 대규모 구조화된 데이터셋이 공개되었다.
핵심 요약
논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. RAP는 2022~2026년 머신러닝 학회 25K개 이상의 논문-포스터 쌍을 수집하고, 3단계 콘텐츠 분류체계로 주석했으며, 150개 테스트 논문 벤치마크를 별도로 포함한다. 기존 벤치마크와 달리 완전 자동화된 역렌더링 파이프라인으로 각 포스터를 재작성 가능한 HTML/CSS 마크업으로 변환하여, 논문-포스터-마크업 삼중쌍으로 검증할 수 있다. 전체 요약 8문장 읽기 → 030 18:11 ▲ 156 · 댓글 68 DeepSeek, 검색·웹페이지 수집 API 공개…1000건당 75센트 DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. AI · 머신러닝 · DeepSeek search and fetch – $0.75 per 1000 successful requests
Key Point RAG와 AI 에이전트 기능이 필요한 개발자들이 DeepSeek의 웹 접근 API를 활용할 수 있게 됐으며, 저가 가격대(1000건당 75센트)로 경쟁 중인 유사 서비스와 비교하는 기준점이 된다.
핵심 요약
DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. Search API는 쿼리에 맞는 웹페이지를 찾아 구조화된 검색 결과를 반환하며, DeepSeek 자체 검색엔진으로 구동된다. Fetch API는 단일 웹페이지를 가져와 Markdown 형식으로 콘텐츠를 반환한다. 전체 요약 13문장 읽기 → 031 03:12 ▲ 16 · 댓글 2 LLM 에이전트, 사용자 감정 변화에 취약하다 장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. AI · 머신러닝 · τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
Key Point 현실의 사용자 감정 변화가 LLM 에이전트의 신뢰성을 심각하게 흔드는 취약점을 처음으로 체계적으로 측정하고, 이를 개선하기 위한 학습 방법을 제시한다.
핵심 요약
장시간의 도구 호출 작업에서 LLM 에이전트는 도구 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로도 실패한다. 기존 벤치마크는 협조적이고 안정적인 사용자를 가정하고 있어 감정 변화가 에이전트 신뢰성에 미치는 영향을 제대로 평가하지 못했다. τ-Emotion-Bench는 10개 도메인에서 감정 조건부 사용자 상호작용 하에서 도구 호출 에이전트를 평가하는 벤치마크를 제시한다. 전체 요약 8문장 읽기 → 032 18:11 ▲ 270 · 댓글 3 선택 문제의 구조를 존중하는 AI 모델 'Jeva' 제안 System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. AI · 머신러닝 · Jeva: System One Models from First Principles
Key Point 선택지 기반 의사결정 시스템의 구조적 요구사항을 처음 체계적으로 정의하고 이를 만족하는 아키텍처를 제시하여, 추천·검색·순위 결정 등 실무 문제들을 근본적으로 다시 설계할 수 있는 접근법을 제공한다.
핵심 요약
System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. 논문은 구조적으로 중요한 네 가지 요구사항을 제시한다: (i) null-aware(답변 부재를 후보 간 불확실성과 구별), (ii) permutation-invariant(대안의 순서 변경이 결정에 영향 없음), (iii) option-scalable(후보 집합 증가 시 출력 공간 재정의 불필요), (iv) cacheable(반복되는 대안에 대한 재사용 가능). 이를 해결하기 위해 Jeva 아키텍처를 제안한다. 공유 인코더가 요청과 각 선택지를 독립적으로 표현하고, 컴팩트 결정 스택이 불변의 선택지 메모리에 대해 요청 상태만 정제한다. 전체 요약 9문장 읽기 → 033 18:11 ▲ 66 · 댓글 1 흉부 X선 진단에 도구 활용한 AI 에이전트, ChestAgentBench서 최고 성능 흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. AI · 머신러닝 · X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
Key Point 의료 AI가 X선 이미지 분석 시 외부 측정 도구를 필요한 순간에만 올바르게 활용하는 방식을 개선함으로써, 의료 진단 시스템의 신뢰성과 설명 가능성을 높이는 구체적인 접근 방식을 제시합니다.
핵심 요약
흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. 이를 해결하기 위해 X-Ragent라는 도구 활용 강화학습 후학습 프레임워크를 제안하며, 이는 보조 증거 수집과 타당성 검증 정량 측정 획득을 분리한다. 7.7K 샘플의 Rad-CoT 코퍼스를 구축해 인과관계 순서의 도구 활용 궤적과 보고서 양식 진단 추론을 결합했다. 전체 요약 7문장 읽기 → 034 21:11 당일 +233 AI 에이전트가 웹 데이터를 자유롭게 수집하는 Apify MCP 서버 Apify MCP 서버는 Claude, VS Code 등 AI 에이전트가 Apify Store의 8,000개 이상 스크래퍼·크롤러·자동화 도구를 MCP 프로토콜로 직접 사용하도록 연결한다. AI · 머신러닝 · apify/apify-mcp-server · TypeScript
Key Point AI 에이전트가 별도 도구 개발 없이 Apify 생태계의 수천 개 스크래퍼를 MCP 표준으로 직접 활용할 수 있게 되어, 데이터 추출 작업의 진입장벽이 크게 낮아졌다.
핵심 요약
Apify MCP 서버는 Claude, VS Code 등 AI 에이전트가 Apify Store의 8,000개 이상 스크래퍼·크롤러·자동화 도구를 MCP 프로토콜로 직접 사용하도록 연결한다. 소셜미디어, 검색엔진, 지도, 이커머스 등 모든 웹사이트에서 데이터를 추출할 수 있으며, OAuth를 지원해 Claude.ai나 VS Code에서 URL만으로 연결 가능하다. 호스팅 서버(mcp.apify.com)는 Streamable HTTP 전송을 사용하며 레거시 SSE 엔드포인트는 제거됐다. 전체 요약 12문장 읽기 → 035 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 036 21:12 당일 +919 로컬·클라우드 AI 모델 한곳에서 관리하는 오픈소스 UI Open WebUI는 Ollama, OpenAI 호환 API 등 다양한 AI 모델을 지원하는 자체 호스팅 AI 플랫폼이며, 완전 오프라인 운영이 가능합니다. AI · 머신러닝 · open-webui/open-webui · Python
Key Point 로컬 모델부터 클라우드 API까지 통합 관리하면서 엔터프라이즈급 보안(LDAP/SSO/SCIM), 팀 협업 기능, RAG, 에이전트 실행 환경을 모두 지원해 온프레미스 AI 플랫폼을 자체 구축하려는 팀에게 필수 선택지입니다.
핵심 요약
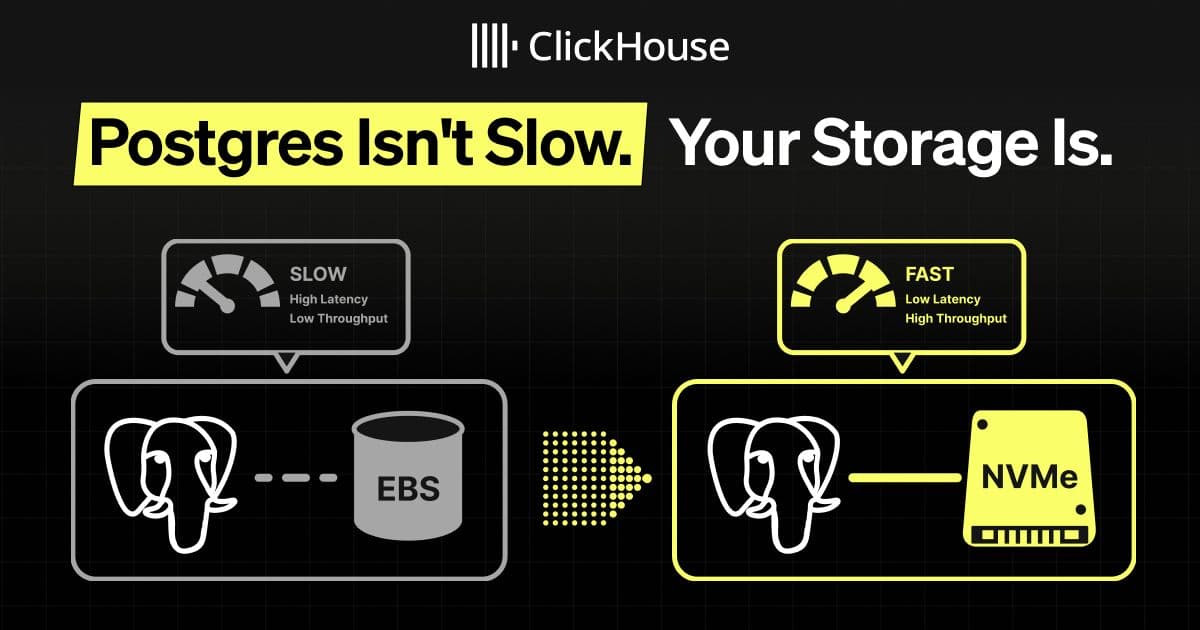
Open WebUI는 Ollama, OpenAI 호환 API 등 다양한 AI 모델을 지원하는 자체 호스팅 AI 플랫폼이며, 완전 오프라인 운영이 가능합니다. 플러그인(필터, 액션, 파이프, 도구, 스킬)을 통해 MCP, MCPO, OpenAPI 도구 서버 연결로 맞춤 통합을 구축할 수 있으며, 역할 기반 접근 제어(RBAC)와 사용자 그룹으로 세밀한 권한 관리가 가능합니다. Open Terminal을 통해 AI 에이전트가 터미널과 파일시스템에 접근해 다단계 작업을 실행할 수 있으며, 엔터프라이즈 버전인 Terminals는 사용자별 격리 컨테이너, 리소스 제한, 네트워크 규칙을 제공합니다. 전체 요약 12문장 읽기 → 037 21:12 ▲ 122 · 댓글 107 PostgreSQL 성능 문제의 범인은 저장소다 POSETTE 2026에서 발표된 '당신의 저장소가 느리다' 주제의 강연이 PostgreSQL 성능과 저장소의 관계를 분석했다. 인프라 · 데브옵스 · Postgres isn't slow, your storage is
Key Point 저장소 성능이 대규모 PostgreSQL 운영의 여러 증상의 근본 원인일 수 있으며, 로컬 NVMe로 9배의 처리량 개선을 달성하는 구체적인 벤치마크 결과와 프로덕션 운영 패턴을 제시한다.
핵심 요약
POSETTE 2026에서 발표된 '당신의 저장소가 느리다' 주제의 강연이 PostgreSQL 성능과 저장소의 관계를 분석했다. 대규모 PostgreSQL 운영 환경에서 나타나는 다섯 가지 증상이 있다: 느린 수집 파이프라인, 예측 불가능한 P95 읽기 지연, VACUUM 지연, 느린 체크포인트, 논리적 복제 지연. 이 증상들의 공통 원인은 저장소 성능이다. 캐시 미스, WAL 플러시, VACUUM, 논리적 디코딩 등이 저장소의 대역폭과 IOPS를 경쟁하기 때문이다. 전체 요약 13문장 읽기 → 038 21:11 당일 +110 Cloudflare Workers를 자체 서버에서 실행하는 오픈소스 celld 공개 Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. 인프라 · 데브옵스 · denoland/celld · Rust
Key Point 자사 Cloudflare Workers 애플리케이션을 클라우드 의존 없이 완전히 자체 통제하는 인프라에서 운영할 수 있게 되므로, 멀티테넌트 워크로드나 온프레미스 배포가 필요한 조직에 중요한 선택지를 제공한다.
핵심 요약
Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. Workers, Durable Objects, KV, Queues, D1, R2, Workflows, Cron Triggers, 정적 자산 등 Cloudflare의 모든 주요 서비스를 로컬 클러스터에서 동작시킬 수 있다. 각 객체는 셀(cell)이라는 자체 SQLite 데이터베이스를 가진 명명된 서버이며, 장기 상태는 S3, Google Cloud Storage, Azure Blob Storage 버킷에 저장된다. 전체 요약 13문장 읽기 → 039 21:11 ▲ 156 · 댓글 41 LineageOS 24.0 공개, Android 17 기반으로 빠르게 적용 LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 인프라 · 데브옵스 · LineageOS 24.0
Key Point Linux 커널 4.4/4.9 기기 지원을 조건부로 축소하고 베어메탈 x86_64까지 지원하는 등 플랫폼의 복잡도를 줄이면서 개발자 경험은 개선한 구체적인 전략이 담겨 있다.
핵심 요약
LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 2025년 8월부터 2026년 10월까지의 보안 패치가 18.1~24.0에 병합되었고, 레거시 브랜치(15.1, 16.0, 17.1)도 2025년 11월 보안 패치까지 적용되었다. Canvas 이미지 편집기, Catapult TV 런처, Etar 달력 등 주요 앱들이 Material Design 3로 업데이트되었으며, Updater는 A/B 파티션 기기에서 스트리밍 방식으로 설치해 설치 시간을 단축했다. 전체 요약 12문장 읽기 → 040 06:11 새 버전 Ruff 0.17.0, 코드 서명과 새로운 규칙 기본값 적용 macOS와 Windows 릴리스의 실행 파일이 코드 서명되었다. macOS는 Apple Developer ID 인증서로 서명·공증되었고, Windows는 Azure Artifact Signing으로 Authenticode 타임스탬프 서명을 받아 바이너리 무결성 검증과 퍼블리셔 기반 허용 목록을 지원한다. 오픈소스 · 도구 · astral-sh/ruff@0.17.0
Key Point 파이썬 기본 버전 변경과 기본 규칙 비활성화로 기존 프로젝트의 린트 결과가 달라질 수 있으며, conda-forge 설치 방식의 사용 방법이 변경되므로 ruff 사용자의 즉각적인 대응이 필요하다.
핵심 요약
macOS와 Windows 릴리스의 실행 파일이 코드 서명되었다. macOS는 Apple Developer ID 인증서로 서명·공증되었고, Windows는 Azure Artifact Signing으로 Authenticode 타임스탬프 서명을 받아 바이너리 무결성 검증과 퍼블리셔 기반 허용 목록을 지원한다. Python 기본 버전이 변경되었다. 버전 미설정 시 3.10에서 3.11로, 문법 검사 시 3.14에서 3.15로 올라갔다. 기본 활성화 규칙이 변경되었다. flake8-datetimez의 7개 규칙(DTZ001, DTZ005, DTZ006, DTZ007, DTZ011, DTZ012, DTZ901)은 더 이상 기본 활성화되지 않으며, F406(undefined-local-with-nested-import-star-usage)은 새로 기본 활성화된다. 전체 요약 12문장 읽기 → 041 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 042 03:11 ▲ 124 · 댓글 47 배터리 저장 장치, 전 세계 모든 가스터빈보다 저렴해졌다 Wood Mackenzie의 전 지구적 발전 비용 분석에 따르면 4시간 배터리 저장 장치가 43개 시장 모두에서 개방형 가스터빈보다 저렴해졌다. 인프라 · 데브옵스 · 4-hour battery storage is cheaper to install than gas turbines all across globe
Key Point 배터리 저장 비용이 가스터빈을 전지구적으로 역전시킨 것은 전력 시스템 계획의 패러다임 변화를 의미하며, 특히 신규 가스 발전 투자 시대의 종말을 신호한다.
핵심 요약
Wood Mackenzie의 전 지구적 발전 비용 분석에 따르면 4시간 배터리 저장 장치가 43개 시장 모두에서 개방형 가스터빈보다 저렴해졌다. 중동·아프리카에서 유틸리티급 태양광은 37달러/MWh이며 4시간 배터리는 2035년까지 33% 하락해 80달러/MWh이 되어 가스 피킹을 완전히 대체할 전망이다. 중국은 아시아태평양 평균보다 55% 이상 저렴한 배터리 비용으로 전 세계 기준을 제시하고 있으며, 제조 규모가 글로벌 비용 지도를 재편하고 있다. 전체 요약 10문장 읽기 → 043 21:11 당일 +144 도커의 AI 에이전트 런타임 오픈소스 공개 Docker가 AI 에이전트 구축 및 실행 도구인 docker-agent를 오픈소스로 공개했다. AI · 머신러닝 · docker/docker-agent · Go
Key Point AI 에이전트를 YAML로 선언적으로 정의하고 실행하는 도구가 등장해, 복잡한 멀티에이전트 시스템을 코드 없이 구축할 수 있게 되었다.
핵심 요약
Docker가 AI 에이전트 구축 및 실행 도구인 docker-agent를 오픈소스로 공개했다. YAML 설정 파일만으로 코드 없이 AI 에이전트를 정의하고 실행할 수 있으며, docker CLI 플러그인으로 `docker agent` 명령으로 사용한다. 다중 에이전트 아키텍처를 지원해 여러 전문화된 에이전트가 자동으로 작업을 분배하고 협력하며 복잡한 문제를 해결할 수 있다. 전체 요약 10문장 읽기 → 044 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 045 18:30 당일 +343 온톨로지 변경을 증명으로 검증하는 오픈소스 도구 프로덕션 온톨로지 변경을 계획·적용·롤백할 수 있으며, 영향 범위 보고서와 감사자가 검증 가능한 증명을 제공하는 Rust 기반 도구다. 오픈소스 · 도구 · fabio-rovai/open-ontologies · Rust
Key Point 온톨로지 변경의 모든 결과를 사전에 확인하고, 누구나 검증할 수 있는 증명을 함께 제공함으로써 프로덕션 환경에서의 신뢰성 문제를 근본적으로 해결하는 접근 방식이다.
핵심 요약
프로덕션 온톨로지 변경을 계획·적용·롤백할 수 있으며, 영향 범위 보고서와 감사자가 검증 가능한 증명을 제공하는 Rust 기반 도구다. 한 줄의 삼중항(triple) 변경이 901개의 새로운 결과를 만드는 경우, 텍스트 diff로는 볼 수 없는 의미론적 차이를 드러내는 형태 diff(shape diff) 보고서를 생성한다. 도구가 생성한 증명 파일(asserted.tsv, derivations.tsv)은 Lean 4 검증기로 검수할 수 있으며, 검증 명령어 oo-cert는 JVM 없이 독립적으로 실행 가능하다. 전체 요약 12문장 읽기 → 046 18:30 당일 +770 AI 에이전트를 위한 로컬 검색 엔진 XERJ 출시 XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. AI · 머신러닝 · xerj-org/xerj · Rust
Key Point 에이전트의 토큰 낭비를 줄이는 로컬 검색 엔진으로, grep 대비 2.7배의 토큰 절감을 실측으로 증명한 도구가 오픈소스로 공개되었으며 AI 개발 워크플로우의 효율성을 크게 바꿀 가능성이 있다.
핵심 요약
XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. 기존 grep/sed 대비 40배 적은 토큰으로 데이터를 인덱싱하며, Elasticsearch 호환 API를 제공해 기존 클라이언트와 도구가 그대로 작동한다. 참고 코딩(reference coding) 사용 사례에서 실측한 결과, grep 기반 에이전트 대비 출력 토큰 2.7배 감소, 메모리만 사용할 때 대비 26배 감소를 달성했고 현장 보고에서는 약 5배의 토큰 절감이 보고된다. 전체 요약 12문장 읽기 → 048 18:33 ▲ 18 · 댓글 2 RAG 시스템 배포 판단을 위한 증거 기반 품질검증 프레임워크 기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AI · 머신러닝 · AGO AI Quality Gate: Evidence-First Release Decisions for Retrieval-Augmented Generation
Key Point RAG 시스템의 프로덕션 배포를 자동화할 때 LLM 판사의 오류가 얼마나 심각한지, 그리고 이를 어떻게 체계적으로 검증해야 하는지 보여주는 실무적 해결책을 담았습니다.
핵심 요약
기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AGO는 불완전한 증거와 LLM 판사의 오류를 명시적 결과로 다루는 4단계 의사결정 모델, 결정론적 검사와 LLM 평가를 결합한 계층화 점수 매기기, 회귀 위험을 확률로 정량화하는 베타-이항 게이트로 구성된다. LLM 판사의 신뢰성을 사전 검증하는 메타-평가 프로토콜을 필수로 포함하여 판사 오류가 최종 결정에 영향을 미치지 않도록 설계했다. 전체 요약 7문장 읽기 → 049 18:33 ▲ 18 · 댓글 2 시계열 예측에 뉴스 기반 사건 추론을 적용하는 SEER 모델 실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. AI · 머신러닝 · SEER: Self-Evolving Event Reasoning and Retrieval for Time Series Forecasting
Key Point 시계열 예측에 뉴스 기반 외부 사건을 통합하는 새로운 방식이 기존 모델보다 성능이 우수하다는 것을 보여주므로, 금융·에너지·주식 등 변동성 큰 시계열을 다루는 개발자와 연구자에게 중요하다.
핵심 요약
실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. 언어 모델을 통해 외부 뉴스를 검색할 수 있지만, 표준 검색 증강 방식은 높은 노이즈, 신호 손실, 사건 영향에 대한 인과적 추론 능력 부족의 문제가 있다. SEER는 시계열 예측을 위해 사건 조건화를 동적으로 최적화하는 폐루프 프레임워크로, 예측 오류를 두 가지 피드백 메커니즘으로 변환한다. 전체 요약 7문장 읽기 → 050 18:33 ▲ 21 · 댓글 2 단일 모델로 검색과 장문맥 처리 통합하는 UNREAL 말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. AI · 머신러닝 · UNREAL: Unifying Retrieval and Long-Context with a Single Model
Key Point 대규모 언어모델의 검색과 장문맥 처리라는 두 가지 핵심 문제를 하나의 메커니즘으로 해결하는 새로운 접근으로, 생성 효율성과 정확도를 동시에 개선하는 경로를 제시한다.
핵심 요약
말뭉치 검색(RAG)과 장문맥 추론은 증거 선택을 서로 다른 규모로 처리하는데, 이를 통일할 수 있는지 묻는 논문이다. UNREAL은 LLM의 내부 표현에서 청크를 인코딩하고 검색 쿼리를 직접 도출하는 모델 내재 증거 선택 프레임워크다. 500K개 미만의 학습 가능 파라미터를 추가하며 기본 LLM은 수정하지 않는다. 전체 요약 9문장 읽기 → 051 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 052 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 053 18:35 ▲ 19 · 댓글 2 다중 매체 검색 결과를 선택적으로 압축하는 CANOPY 멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. AI · 머신러닝 · CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
Key Point 멀티모달 검색에서 압축 과정의 세분화 수준을 동적으로 조절함으로써 토큰 사용을 줄이면서도 답변 정확도를 지킬 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. 기존 압축 방식은 매체별로 다르게 동작하며, 이질적 항목 간에 적응형 세분화로 영역을 선택하는 공통 방식이 부족했다. CANOPY는 검색 결과를 계층 구조로 표현하고, 질문에 대해 학습된 인코더로 각 영역의 점수를 매긴 뒤, 부모 상대 정제(parent-relative refinement)로 다양한 세분화 수준의 여러 영역을 선택한다. 전체 요약 7문장 읽기 → 054 09:11 ▲ 12 · 댓글 2 의료 AI 검증 시스템의 숨은 한계, 자동 분류로 드러내다 의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. AI · 머신러닝 · Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
Key Point 의료 AI 시스템의 검증 성능이 개선되지 않는 근본 원인이 무엇인지 밝혀, 현재 방식의 한계를 이해하고 새로운 접근이 필요한 이유를 제시한다.
핵심 요약
의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. MedExpert 데이터셋과 3개의 폐쇄형 데이터셋 사례 연구에서 검색 단계 오류 5가지와 검증 추론 오류 6단계를 분류하는 두 개의 체계적 분류법을 개발했다. LLM을 판사로 삼아 증거 품질을 라벨링하고 검증 오류를 자동으로 분류하는 패턴 귀납 파이프라인을 적용하여 4가지 검색 방식과 6개 최신 검증 모델에서 대규모로 검증했다. 전체 요약 5문장 읽기 → 055 00:11 ▲ 126 · 댓글 61 런스케이프, 언리얼 엔진 기반 차세대 MMO 'RS4' 개발 중 Jagex가 RuneFest에서 언리얼 엔진으로 구축한 완전히 새로운 RuneScape MMORPG 'RS4' 개발을 공식 발표했다. 기타 · We're working on a new RuneScape MMO
Key Point 25년 운영되는 메이저 MMO 프랜차이즈의 새로운 작품 개발 발표로, 기존 게임들과의 관계 정의와 개발 철학이 향후 MMO 시장에 어떤 영향을 미칠지 주목할 시점이다.
핵심 요약
Jagex가 RuneFest에서 언리얼 엔진으로 구축한 완전히 새로운 RuneScape MMORPG 'RS4' 개발을 공식 발표했다. RS4는 기존의 RuneScape, Old School RuneScape, Dragonwilds와는 별개로 운영되며, 플레이어들이 여러 게임을 오갈 수 있도록 설계된다. 게임은 Gielinor 세계의 여섯 번째 시대를 배경으로 하며, Dragonwilds의 용왕 쿨드라 파괴 이후의 시간대에서 시작하는 '애슈펄(Ashenfall)' 지역에서 출발한다. 전체 요약 7문장 읽기 → 056 15:11 ▲ 120 · 댓글 66 에이전트가 필요한 건 기억력이 아니라 문서 기존 메모리 플러그인은 대화 내용을 스니펫으로 쪼개 벡터 데이터베이스에 저장했다가 프롬프트마다 유사도로 상위 5개를 주입하는 RAG 방식으로 동작하고 있다. AI · 머신러닝 · Agents don't need memory, they need documentation
Key Point 메모리 플러그인의 RAG 방식은 상사 검색의 한계·문맥 손실·코드 변화 추적 불능 등 근본적 결함을 안고 있으며, 문서 기반 메모리로 전환하면 에이전트의 맥락 이해도와 투명성을 동시에 높일 수 있다.
핵심 요약
기존 메모리 플러그인은 대화 내용을 스니펫으로 쪼개 벡터 데이터베이스에 저장했다가 프롬프트마다 유사도로 상위 5개를 주입하는 RAG 방식으로 동작하고 있다. 유사도 검색은 정확성·최신성·누락된 정보를 파악할 수 없고, 스니펫은 문맥을 잃으며, 매일 변하는 코드베이스에서 기록된 정보는 빠르게 구식이 되며, 에이전트는 무엇을 모르는지 알 수 없어 검색 도구를 제대로 사용하지 못한다. 또한 수천 개의 임베딩이 저장되면 어떤 기억이 활용되고 있는지, 어떤 기억이 오래되었거나 잘못되었는지 감시할 수 없는 감사 불가능의 문제가 있다. 전체 요약 8문장 읽기 → 057 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 058 03:11 당일 +121 Kestra 2.0, AI 에이전트와 이벤트 기반 오케스트레이션 플랫폼 공개 오픈소스 오케스트레이션 플랫폼 Kestra 2.0이 릴리스됐으며, 데이터·AI·인프라 워크플로우를 YAML 코드로 선언적으로 정의할 수 있다. 인프라 · 데브옵스 · kestra-io/kestra · Java
Key Point 데이터 파이프라인과 AI 워크플로우를 코드와 UI로 자유롭게 정의할 수 있는 오픈소스 오케스트레이션 플랫폼의 메이저 업그레이드로, 엔터프라이즈급 확장성과 개발자 편의성이 대폭 개선되었다.
핵심 요약
오픈소스 오케스트레이션 플랫폼 Kestra 2.0이 릴리스됐으며, 데이터·AI·인프라 워크플로우를 YAML 코드로 선언적으로 정의할 수 있다. AI 코파일럿이 사이드바로 개선돼 Ask·Edit·Plan 모드를 지원하고, AI 에이전트와 RAG 워크플로우를 일급 작업 유형으로 제공하며, 외부 AI 에이전트에서 흐름을 호출할 수 있는 MCP 서버가 포함됐다. YAML 에디터·노코드 에디터·AI 코파일럿이 같은 흐름을 편집하며 실시간 동기화되고, UI에서 Git 버전 관리와 드래프트 리비전을 통해 코드로 관리한 워크플로우를 안전하게 변경할 수 있다. 전체 요약 12문장 읽기 → 059 21:11 당일 +343 GraphBLAS 기반 초고속 그래프 데이터베이스 FalkorDB 공개 FalkorDB는 희소 행렬(Sparse Matrix) 기반의 그래프 데이터베이스로, 인접 행렬을 GraphBLAS로 표현하고 선형대수를 활용해 쿼리를 실행한다. AI · 머신러닝 · FalkorDB/FalkorDB · Rust
Key Point 희소 행렬 기반의 그래프 데이터베이스로 기존 그래프DB와는 다른 구조를 제공하며, LLM 시대에 Knowledge Graph 구축이 중요해지면서 새로운 선택지를 제시한다.
핵심 요약
FalkorDB는 희소 행렬(Sparse Matrix) 기반의 그래프 데이터베이스로, 인접 행렬을 GraphBLAS로 표현하고 선형대수를 활용해 쿼리를 실행한다. LLM용 Knowledge Graph 구축에 최적화되었으며, 생성형 AI, 에이전트 메모리, 클라우드 보안, 사기 탐지 등 다양한 용도를 지원한다. OpenCypher 쿼리 언어를 지원하며 Property Graph 모델을 준수하고, 노드와 관계에 속성을 부여할 수 있다. 전체 요약 9문장 읽기 → 060 06:11 ▲ 13 · 댓글 2 밀집 검색, 공유 vs 독립 투영 선택 기준을 이론으로 증명 Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. AI · 머신러닝 · When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
Key Point Dense retrieval 시스템에서 쿼리-문서 인코딩을 공유할지 독립적으로 설계할지 선택하는 문제에 처음으로 엄밀한 이론적 기준을 제시해, 실무 설계 결정의 근거를 제공한다.
핵심 요약
Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. 공유 투영(Shared)은 양의 준정치 연산자를 생성하고 독립 투영(Dual)은 임의의 저차원 연산자를 실현하는 구조적 차이가 있다. 정확한 근사 오차를 유도했으며, 제곱 방향신호가 추가 자유도의 추정 비용을 초과할 때만 독립 투영이 더 낮은 리스크를 갖는다는 국소 가우시안 경계를 증명했다. 전체 요약 8문장 읽기 → 061 21:11 당일 +477 벡터DB 없이 추론으로 문서를 읽는 RAG, PageIndex PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. AI · 머신러닝 · VectifyAI/PageIndex · Python
Key Point 벡터DB에 의존하지 않고 LLM의 추론으로 문서를 검색하는 새로운 RAG 방식이, 복잡한 전문 문서에서 기존 벡터 검색보다 훨씬 높은 정확도(98.7%)와 낮은 비용(2~16배 절감)을 달성했기 때문이다.
핵심 요약
PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. 벡터 RAG는 의미적 유사성으로 검색하지만, 유사성이 반드시 관련성을 의미하지 않는다. PageIndex는 문맥 이해, 도메인 전문성, 다단계 추론이 필요한 금융보고서나 법률 문서에서 더 정확한 관련 정보를 찾는다. 인덱싱은 문서마다 트리 구조를 생성하고, 검색은 LLM이 그 트리를 추론하며 탐색하는 두 단계로 진행된다. 전체 요약 12문장 읽기 → 062 21:11 ▲ 59 · 댓글 1 CoWindow: 주의 메커니즘의 중복 계산을 줄인 구조화된 어텐션 기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. AI · 머신러닝 · CoWindow Attention: Full Causal Coverage Is a Collective Property
Key Point 효율적인 장문맥 처리가 필수인 생성형 AI에서 Full Attention의 중복 계산을 제거하면서도 성능을 유지하는 방법이 제시되었으므로, 스케일링 효율성을 개선하려는 팀들의 관심을 받을 만합니다.
핵심 요약
기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. 연구팀이 제안한 CoWindow Attention(CoWA)은 KV 헤드 간에 인과 히스토리 접근을 분산시키는 구조화된 어텐션이다. 모든 헤드는 근거리 대각 윈도우와 접두사-싱크 윈도우를 공유하며, 나머지 먼 과거는 보완적 장거리 윈도우로 분할되어 전체 인과 커버리지를 달성한다. 전체 요약 10문장 읽기 → 063 15:11 ▲ 103 · 댓글 48 AI가 '지식 노동' 경제를 해체하다 저자는 LLM을 이용해 1989년 고전 게임 '전쟁의 창(War of the Lance)'을 역공학하고 현대 브라우저로 포팅한 경험을 공유한다. AI · 머신러닝 · What reversing, modernising old games tells us about the economic impact of AI
Key Point 지식 노동의 희소성이 AI로 사라지는 과정을 게임 개발 구체 사례로 보여주며, 단순한 기술 발전을 넘어 경제 구조 변화의 신호를 던진다.
핵심 요약
저자는 LLM을 이용해 1989년 고전 게임 '전쟁의 창(War of the Lance)'을 역공학하고 현대 브라우저로 포팅한 경험을 공유한다. Qwen-3.8-Flash-Next로 한 주 안에 충실한 게임 재현과 Three.js 렌더링 엔진을 구현했으며, 이를 토탈워와 히어로즈 오브 마이트 앤 매직 스타일로 현대화하고 있다. Fable 5.1로 주당 80~100개 3D 모델을 생성할 수 있으며, GPT-6 Astra는 중급 전문가 수준의 3D 모델링 능력을 보였다. 전체 요약 15문장 읽기 → 064 12:11 ▲ 17 · 댓글 1 복합 질의를 위한 문서 집합 재순위화, 적응형 튜터링으로 개선 RAG와 깊이 있는 연구에서 문서 재순위화는 하류 모델이 받는 증거를 결정하는데, 기존 재순위화기는 관련성 매칭으로만 선택해 복잡한 정보 요구에 필요한 보완적·비중복 문서 집합을 구성하지 못했다. AI · 머신러닝 · AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
Key Point 복잡한 정보 검색에서 단순한 관련성 매칭을 넘어 보완적이고 비중복적인 문서 집합을 구성해야 한다는 새로운 접근이 RAG 성능 개선에 직결된다.
핵심 요약
RAG와 깊이 있는 연구에서 문서 재순위화는 하류 모델이 받는 증거를 결정하는데, 기존 재순위화기는 관련성 매칭으로만 선택해 복잡한 정보 요구에 필요한 보완적·비중복 문서 집합을 구성하지 못했다. 기존 방식은 문서 집합을 평가할 때 하나의 스칼라 점수로 모든 문서를 동등하게 보상하므로 감독 신호가 희박해, 중복 문서도 집합이 잘 나오면 보상받고 결정적 문서도 집합이 못 나오면 페널티를 받아 신용 할당이 불명확했다. AdaTutoRank는 적응형 튜터링 최적화(ATO) 기법으로 훈련되는 집합 단위 재순위화기로, 9개 평가 기준을 3단계 계층 구조로 조직해 콜드 스타트용 은레이블·강화학습용 보상·증류용 힌트를 제공한다. 전체 요약 6문장 읽기 → 065 21:11 당일 +138 Claude 코드용 388개 스킬·플러그인 공개 Alireza Rezvani가 Claude Code를 비롯한 13개 AI 코딩 도구용 388개의 프로덕션 급 스킬·플러그인·에이전트 스킬을 오픈소스로 공개했다. 오픈소스 · 도구 · alirezarezvani/claude-skills · Python
Key Point 13개 플랫폼을 하나의 표준으로 지원하는 388개 규모의 스킬 라이브러리로, 엔지니어부터 C레벨 경영진까지 모든 역할의 AI 코딩 에이전트 능력을 한 번에 확장할 수 있다.
핵심 요약
Alireza Rezvani가 Claude Code를 비롯한 13개 AI 코딩 도구용 388개의 프로덕션 급 스킬·플러그인·에이전트 스킬을 오픈소스로 공개했다. 엔지니어링, 마케팅, 제품, 규제·컴플라이언스, C레벨 어드바이저, 비즈니스·금융 등 20개 도메인을 다루며, 388개의 Python 도구(모두 표준 라이브러리만 사용)와 823개의 템플릿·체크리스트·도메인 참고 자료를 포함한다. Claude Code, OpenAI Codex, Gemini CLI, Cursor, Aider, Windsurf, Mistral Vibe, Hermes Agent 등 13개 플랫폼에 네이티브로 작동하며, 통일된 agentskills.io SKILL.md 표준을 사용한다. 전체 요약 11문장 읽기 → 066 03:11 당일 +317 TypeScript를 네이티브 코드로 컴파일하는 scriptc 공개 Vercel Labs가 TypeScript/JavaScript를 네이티브 실행 파일과 WebAssembly로 컴파일하는 scriptc를 공개했다. 웹 · 프론트엔드 · vercel-labs/scriptc · TypeScript
Key Point TypeScript 개발자가 Node 런타임 없이 단일 네이티브 실행 파일로 배포할 수 있게 되어, 번들 크기 최소화와 성능 향상이 가능해진다.
핵심 요약
Vercel Labs가 TypeScript/JavaScript를 네이티브 실행 파일과 WebAssembly로 컴파일하는 scriptc를 공개했다. TypeScript 컴파일러를 활용해 파싱과 타입 검사를 수행하고, 타입화된 중간 표현(IR), C 코드, LLVM IR, 네이티브 어셈블리, 객체 파일 등 다양한 형태로 출력할 수 있다. macOS 15+ arm64, Linux, Windows에서 동작하며, Node 없이 독립적인 네이티브 실행 파일 생성이 가능하고 정적 바이너리에는 작은 런타임만 포함된다. 전체 요약 9문장 읽기 → 067 22:26 당일 +1,454 에이전트가 학습하는 장기 메모리 시스템 Hindsight 공개 Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. AI · 머신러닝 · vectorize-io/hindsight · Python
Key Point 에이전트가 단순히 과거 대화를 불러오는 것을 넘어 경험에서 배우고 정신 모델을 스스로 구축하도록 설계된 새로운 메모리 시스템으로, 기존 RAG와 지식그래프의 한계를 기술적으로 해결하면서도 LongMemEval에서 검증된 성능을 제공하고 있다.
핵심 요약
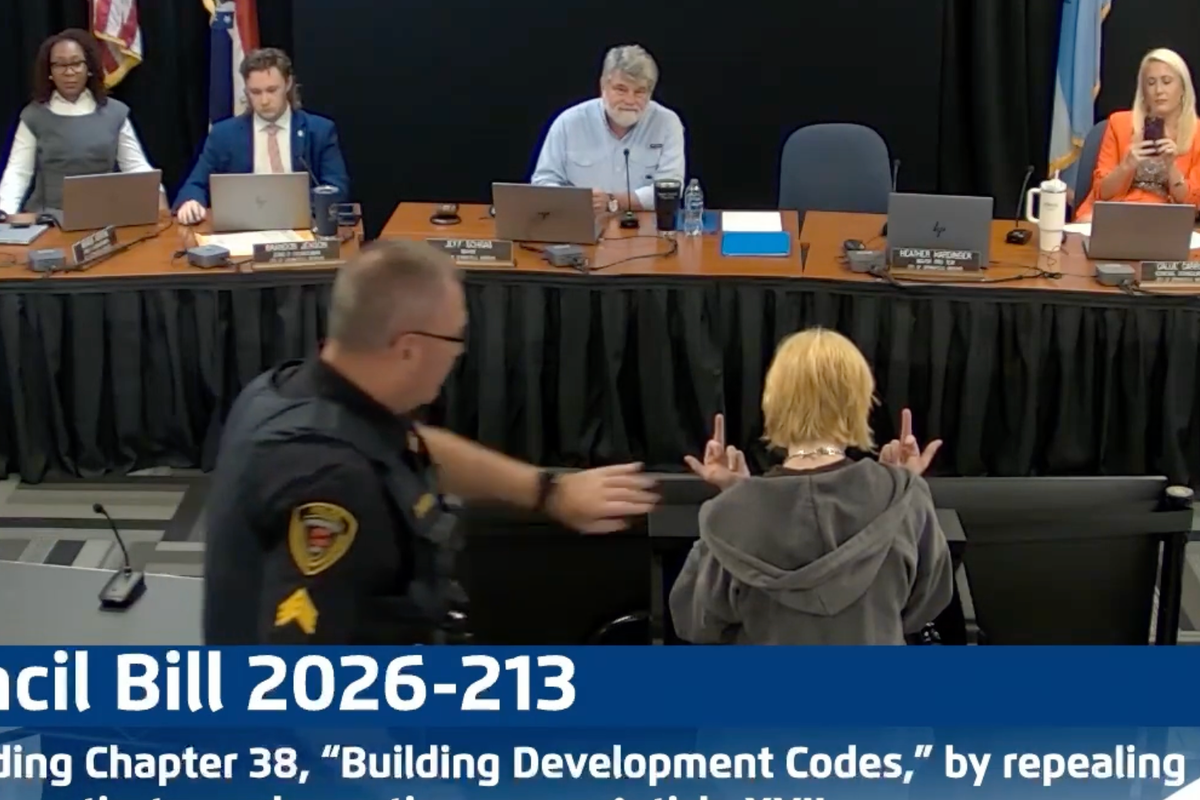
Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. 세계 사실, 에이전트 경험, 관찰, 정신 모델 등 4가지 메모리 타입을 바이오미메틱 데이터 구조로 조직하며, 메모리 뱅크 내에 엔티티, 관계, 시계열과 희소/밀집 벡터 표현을 결합한다. Retain(정보 저장) 연산은 LLM으로 사실과 관계를 추출하고 정규화하며, Recall(검색) 연산은 의미론적·키워드·그래프·시간 범위 필터링을 병렬로 수행한 뒤 역상호 순위 융합과 교차 인코더로 재정렬한다. 전체 요약 13문장 읽기 → 068 22:29 ▲ 158 · 댓글 159 공개 의견 제시 중 체포된 여성, 시민 감시 카메라 논의 폐쇄 미주리주 스프링필드시 의회가 자동 번호판 인식 카메라(ALPR)인 Flock 카메라 검토 결의안에 대한 시민 의견 진술을 차단하는 움직임을 보였다. 보안 · Woman Arrested, Dragged Away After Speaking About Flock at City Council Meeting
Key Point 정부가 시민의 공개 의견 제시 권리를 제한하고 이에 항의한 주민을 체포한 사건으로, 민주적 절차와 공권력 행사의 경계를 다루고 있습니다.
핵심 요약
미주리주 스프링필드시 의회가 자동 번호판 인식 카메라(ALPR)인 Flock 카메라 검토 결의안에 대한 시민 의견 진술을 차단하는 움직임을 보였다. 시장 제프 슈래그는 검토 결의안이 상정되자 즉시 위원회로 회부하도록 동의를 구했고, 시민 의견 수렴을 거부하는 표결에 성공했다(5:3). 군중이 반발하자 슈래그는 회의를 중단하고 카메라를 끄며 방을 비우도록 명령했고, 이 과정에서 프리랜서 사진작가 노아 파월이 경찰에 구속되고 적발됐다. 전체 요약 10문장 읽기 → 069 18:11 ▲ 63 · 댓글 4 기업 문서 RAG를 위한 효율적 청킹 기법 D-RAC 공개 Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. AI · 머신러닝 · Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
Key Point enterprise RAG 도입 시 문서 처리 비용과 속도가 실무상 가장 큰 병목이며, 이 기법이 정규화 단계에서 극적인 효율 개선을 달성했기 때문이다.
핵심 요약
Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. 모든 문서 포맷을 PDF로 정규화한 뒤 멀티모달 LLM으로 단 한 번의 처리만으로 검색 최적화된 마크다운으로 변환한다. 표는 자체 포함 문장으로 재작성되고 제목 계층 구조가 보존되며, 청킹은 ID 기반 파싱과 경량 LLM 처리만 거친다. 전체 요약 6문장 읽기 → 070 09:10 당일 +130 생성형 AI용 문서 처리 플랫폼 Docling, 비디오·이메일 지원 Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. AI · 머신러닝 · docling-project/docling · Python
Key Point 생성형 AI 개발에 필수적인 문서 전처리 도구로, 최근 비디오·이메일·XBRL 등 엔터프라이즈 형식 지원을 확대했으므로 데이터 파이프라인 구축에 직접 활용할 수 있다.
핵심 요약
Docling은 PDF, DOCX, PPTX, XLSX, HTML, EPUB, 이미지, 오디오, 비디오 등 40여 가지 문서 형식을 파싱하고 생성형 AI와 연계하는 오픈소스 도구다. 페이지 레이아웃, 표 구조, 수식, 이미지 분류 등 고급 PDF 이해 기능을 제공하며, 마크다운·HTML·JSON 등 여러 형식으로 내보낼 수 있다. LangChain, LlamaIndex, Crew AI 등 주요 AI 프레임워크와 통합되며, MCP 서버와 API 서버로 구동할 수 있고 로컬 실행으로 민감한 데이터 보호를 지원한다. 전체 요약 6문장 읽기 → 071 03:10 ▲ 110 · 댓글 28 Git을 객체 스토리지에서 구동하려면 팩파일 재설계가 필수 Git 저장소를 객체 스토리지 위에서 구동하는 오픈소스 프로젝트 개발 중이며, 처음엔 파일시스템 추상화 계층을 사용했으나 대규모 저장소에서 성능 문제 발생. 인프라 · 데브옵스 · You can run Git on object storage if you re-make packfiles
Key Point Git을 객체 스토리지에서 효율적으로 구동하기 위해 팩파일 구조를 근본적으로 재설계한 사례로, 마이크로서비스 아키텍처와 클라우드 네이티브 환경에서 Git 기반 인프라를 구축하는 방식이 달라질 수 있음을 시사합니다.
핵심 요약
Git 저장소를 객체 스토리지 위에서 구동하는 오픈소스 프로젝트 개발 중이며, 처음엔 파일시스템 추상화 계층을 사용했으나 대규모 저장소에서 성능 문제 발생. Git의 팩파일은 로컬 스토리지와 mmap을 전제로 설계돼 있어서, 네트워크 왕복 지연(최소 10ms)이 파일시스템 캐시(10ns)보다 백만 배 느린 것이 병목. 객체 스토리지에 최적화된 새로운 팩파일 포맷을 칼럼형 저장소로 구현했고, 클라이언트 수정 없이 Linux 커널 같은 대규모 저장소(1천1백만 개 객체)에서도 효과적으로 동작하도록 해결. 072 06:10 ▲ 144 · 댓글 245 미국의 또 다른 종교, 셀프 스토리지 미국은 글로벌 셀프 스토리지 용량의 90%를 차지하며 가장 큰 시장이며, 연간 수익이 400억 달러를 넘는다. 기타 · The American Religion of Self-Storage Facilities
Key Point 미국 사회의 물질 축적 문화와 그것을 수용하는 '인프라'의 규모를 통해, 소비주의가 얼마나 구조화되어 있는지 보여주는 문화 칼럼입니다.
핵심 요약
미국은 글로벌 셀프 스토리지 용량의 90%를 차지하며 가장 큰 시장이며, 연간 수익이 400억 달러를 넘는다. 셀프 스토리지 시설은 1970년대부터 일반화되었으며, 현재 미국 내 셀프 스토리지 시설 수는 스타벅스, 맥도날드, 월마트 등 주요 체인점들을 합친 것보다 많다. 셀프 스토리지 수요는 사망, 이주, 이혼, 다운사이징이라는 '네 가지 D'로 설명되며, 이는 물품 축적과 현실 사이의 충돌로 인한 생활 사건들이다. 전체 요약 5문장 읽기 → 073 21:11 당일 +428 Supabase, Firebase 대체 오픈소스 플랫폼 Postgres 기반 개발 플랫폼으로 Firebase와 유사한 기능을 오픈소스 도구로 제공한다. 오픈소스 · 도구 · supabase/supabase · TypeScript
Key Point Firebase에서 벗어나고자 하는 개발자들이 선택할 수 있는 완전한 오픈소스 백엔드 플랫폼이 어떻게 구성되어 있는지 알 수 있다.
핵심 요약
Postgres 기반 개발 플랫폼으로 Firebase와 유사한 기능을 오픈소스 도구로 제공한다. 호스팅 Postgres 데이터베이스, 인증, REST/GraphQL API, 실시간 구독, 에지 함수, 파일 스토리지, AI 벡터 toolkit을 포함한다. PostgREST, GoTrue, Realtime, Storage 등 엔터프라이즈급 오픈소스 도구들을 조합하여 구성되어 있다. 전체 요약 4문장 읽기 → 074 21:11 당일 +655 웹 콘텐츠를 LLM 친화적 마크다운으로 변환하는 오픈소스 크롤러 Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. AI · 머신러닝 · unclecode/crawl4ai · Python
Key Point LLM 시대에 웹 데이터 추출의 핵심 병목인 '어떻게 깔끔한 입력으로 변환할까'를 풀어낸 도구이며, API 종속 없이 자체 운영 가능한 오픈소스라는 점이 매력적이다.
핵심 요약
Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. 비동기 브라우저 풀, 캐싱, 세션·프록시·쿠키 제어, 사용자 스크립트 등으로 빠르고 세밀한 크롤링을 지원한다. v0.9.3에서 임의 파일 쓰기, SSRF, DoS 등 5개 보안 취약점을 패치했고 33개 버그를 수정했다. 전체 요약 5문장 읽기 → 075 21:10 당일 +111 오픈소스 AI 에이전트 100+ 모음, 바로 복제해서 사용 가능 클로드, 제미니, GPT, 딥시크 등 다양한 LLM을 지원하는 100개 이상의 오픈소스 AI 에이전트, 에이전트 스킬, RAG 앱을 제공하는 저장소다. AI · 머신러닝 · Shubhamsaboo/awesome-llm-apps · Python
Key Point LLM 기반 에이전트를 빠르게 구현하려는 개발자들이 프로덕션 급 템플릿을 즉시 활용하고 자신의 프로젝트에 맞춰 개조할 수 있는 실용적인 리소스가 생겼다.
핵심 요약
클로드, 제미니, GPT, 딥시크 등 다양한 LLM을 지원하는 100개 이상의 오픈소스 AI 에이전트, 에이전트 스킬, RAG 앱을 제공하는 저장소다. 에이전트 스킬은 단일 명령으로 설치되고 자연어로 사용 가능하며, 클로드 코드, 커서 같은 코딩 에이전트에서 작동한다. 프로젝트 무덤 찾기, 초안 검토 시뮬레이션, 스코프 크리프 감지 등 개발 생산성 도구부터 블로그를 팟캐스트로 변환하거나 실시간 주식 분석하는 시작용 에이전트까지 포함된다. 전체 요약 5문장 읽기 → 076 21:11 당일 +115 메모리 4분의 1만 써도 FAISS보다 빠른 벡터 검색 엔진 Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. AI · 머신러닝 · RyanCodrai/turbovec · Rust
Key Point 벡터 데이터베이스의 메모리 사용과 검색 성능은 RAG 시스템의 핵심이므로, 기존 방식 대비 4배 더 효율적이면서 더 빠른 솔루션의 등장은 프로덕션 환경 선택에 직접 영향을 미친다.
핵심 요약
Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. 1,000만 문서 기준 float32 31GB가 4GB로 압축되며 FAISS IndexPQFastScan보다 빠른 검색 속도를 낸다. 온라인 인제스트 지원으로 훈련 단계 없이 벡터를 바로 색인하고, 증분 저장으로 변경분만 동기화한다. 전체 요약 6문장 읽기 → 077 09:10 당일 +181 문서를 자동으로 연결하는 개인 위키, LLM Wiki 공개 LLM Wiki는 문서를 자동으로 정리하고 상호 연결한 개인 지식베이스를 구축하는 크로스플랫폼 데스크톱 애플리케이션이다. AI · 머신러닝 · nashsu/llm_wiki · TypeScript
Key Point 개인 지식베이스를 구축하는 패러다임이 바뀌고 있으며, 이 프로젝트는 Karpathy의 방법론을 실제 사용 가능한 데스크톱 앱으로 구현한 구체적 사례를 보여준다.
핵심 요약
LLM Wiki는 문서를 자동으로 정리하고 상호 연결한 개인 지식베이스를 구축하는 크로스플랫폼 데스크톱 애플리케이션이다. 기존 RAG 방식처럼 매번 처음부터 검색·답변하는 대신, LLM이 지속적으로 구조화된 위키를 증분 방식으로 구축하고 유지한다. PDF·Office·EPUB·웹 클립 등 다양한 형식의 문서를 지원하고, 이미지 추출, 소스 추적, 벡터 검색, 지식 그래프 분석 기능을 갖춘다. 전체 요약 5문장 읽기 → 078 21:11 당일 +128 AI 에이전트 구축 원리부터 실전까지 완전 가이드 Datawhale 커뮤니티가 에이전트 개발자를 위한 무료 오픈소스 교육 프로젝트 'Hello-Agents'를 공개했다. AI · 머신러닝 · datawhalechina/hello-agents · Python
Key Point 2025년 '에이전트 원년'에 접어든 시점에서 기초부터 실전까지 체계적으로 AI 에이전트를 배우고 구축할 수 있는 실제 프로젝트 기반의 무료 교재를 얻을 수 있기 때문이다.
핵심 요약
Datawhale 커뮤니티가 에이전트 개발자를 위한 무료 오픈소스 교육 프로젝트 'Hello-Agents'를 공개했다. 기초 이론(ReAct, Plan-and-Solve, Reflection 등)부터 실제 구축까지 16개 장으로 구성되었으며, AI 네이티브 에이전트 시스템의 구조와 핵심 원리를 다룬다. AutoGen, AgentScope, LangGraph 같은 주류 프레임워크 활용법과 직접 에이전트 프레임워크를 만드는 방법을 포함한다. 전체 요약 6문장 읽기 → 079 21:11 당일 +169 AI를 위한 메모리 엔진, 로컬 실행 가능한 Supermemory AI 대화 간 기억을 유지하는 메모리·컨텍스트 엔진으로, LongMemEval, LoCoMo, ConvoMem 등 주요 벤치마크에서 1위를 차지했다. AI · 머신러닝 · supermemoryai/supermemory · TypeScript
Key Point AI 어시스턴트가 대화 간 정보를 잊는 근본적인 문제를 해결하는 메모리 인프라로, 개발자들이 자신의 AI 도구에 장기 메모리를 추가하거나 에이전트에 통합할 수 있는 API를 제공한다.
핵심 요약
AI 대화 간 기억을 유지하는 메모리·컨텍스트 엔진으로, LongMemEval, LoCoMo, ConvoMem 등 주요 벤치마크에서 1위를 차지했다. 95% Recall@15을 달성하면서 컨텍스트를 99.4% 압축하고, 사용자 프로필을 약 50ms 내에 생성한다. Claude Code, Cursor, VS Code 등 AI 도구에 플러그인이나 MCP 서버로 통합되어 대화 전체에서 지속적인 메모리를 제공한다. 전체 요약 5문장 읽기 → 080 11:10 당일 +134 Ollama, 오픈소스 LLM 로컬 실행 플랫폼 Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. AI · 머신러닝 · ollama/ollama · Go
Key Point 개발 팀이 LLM을 클라우드 종속 없이 로컬에서 운영하고 싶을 때 실용적인 선택지가 필요하기 때문이다.
핵심 요약
Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. macOS, Windows, Linux 데스크톱은 물론 Docker로도 제공되며, Python과 JavaScript 라이브러리를 통해 기존 애플리케이션에 통합할 수 있다. Claude Code, Codex, Copilot CLI 등 다양한 코딩 IDE와 통합 지원하고, OpenClaw를 통해 WhatsApp, Telegram, Slack, Discord 등 메신저 앱과 연동 가능하다. 전체 요약 5문장 읽기 → 081 11:10 당일 +124 텐센트의 오픈소스 LLM 지식 플랫폼 'WeKnora' 공개 문서를 RAG 기반 Q&A, 자율 추론 에이전트, 자동 유지 위키로 변환하는 엔터프라이즈급 지식 프레임워크다. AI · 머신러닝 · Tencent/WeKnora · Go
Key Point 문서 기반 정보 검색과 활용 방식을 근본적으로 바꾸는 오픈소스 플랫폼으로, 한국 기업들의 지식 관리 자동화와 데이터 주권 보호에 직결된 기술이다.
핵심 요약
문서를 RAG 기반 Q&A, 자율 추론 에이전트, 자동 유지 위키로 변환하는 엔터프라이즈급 지식 프레임워크다. ReAct 에이전트가 검색·MCP 도구·웹 검색을 자동 조합하고, Wiki 모드에서 문서를 상호연결된 마크다운 지식베이스로 정제한다. PDF·Word·이미지·Excel·XMind 등 10+ 포맷 지원하고, Feishu·GitLab·Notion·Slack·Telegram 등 20+ 데이터 소스 및 LLM 제공자와 통합된다. 전체 요약 5문장 읽기 → 082 11:10 ▲ 402 · 댓글 106 구글, 시간 단위 날씨 예측 AI 모델 WeatherNext 3 공개 구글 딥마인드가 전 지구 날씨 예측 AI 모델 WeatherNext 3를 발표했으며, 하루 24시간 매시간 일기예보를 생성하는 첫 글로벌 모델이다. AI · 머신러닝 · WeatherNext 3
Key Point 기존의 복잡한 수치 기상 모델을 대체할 수 있는 AI 기반 날씨 예측이 시간 단위로 제공되면서, 개인과 기업의 의사결정 정확도가 크게 향상될 수 있다는 점과 재생에너지 분야의 효율성 개선에 직결된다.
핵심 요약
구글 딥마인드가 전 지구 날씨 예측 AI 모델 WeatherNext 3를 발표했으며, 하루 24시간 매시간 일기예보를 생성하는 첫 글로벌 모델이다. 위성 데이터를 직접 활용해 5km 해상도의 기온·습도, 10km 해상도의 풍속 등 지표면 변수를 예측하며, 학습 데이터에 없는 지역도 더 정확한 예보를 제공한다. 시간 단위 업데이트로 빠르게 변하는 강우·강설 등의 날씨 변화를 추적할 수 있다. 전체 요약 5문장 읽기 → 083 08:12 당일 +612 Claude 기반 AI 에이전트 운영 플랫폼 Ruflo 공개 Claude Code/Codex를 위한 에이전트 메타-하니스로, 100개 이상의 전문화된 에이전트를 제공하고 다중 에이전트 스웜을 조직하며 자율 워크플로우를 조정합니다. AI · 머신러닝 · ruvnet/ruflo · TypeScript
Key Point 에이전트 기반 자동화를 원하는 개발자에게 기존의 개별 도구 학습 부담 없이 통합된 플랫폼으로 멀티 에이전트 시스템을 구축하는 새로운 방식을 제시합니다.
핵심 요약
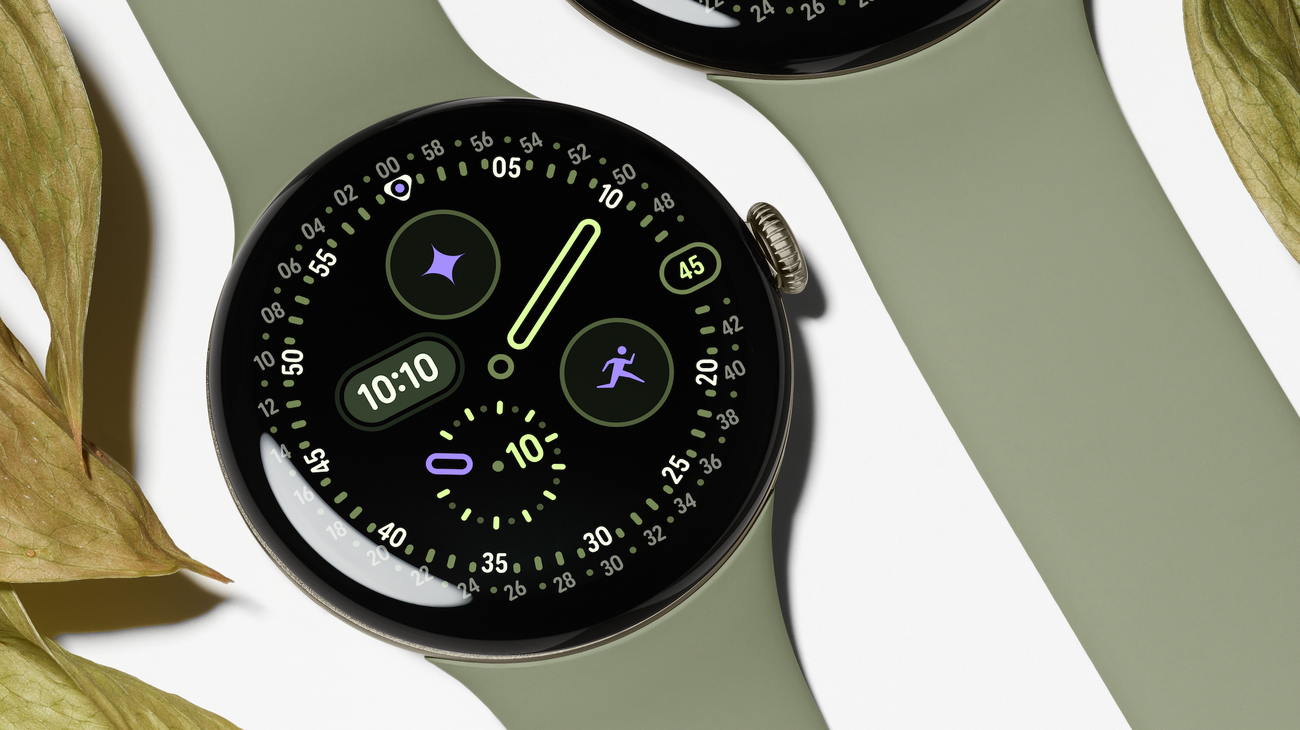
Claude Code/Codex를 위한 에이전트 메타-하니스로, 100개 이상의 전문화된 에이전트를 제공하고 다중 에이전트 스웜을 조직하며 자율 워크플로우를 조정합니다. 메모리 기능으로 세션 간 학습을 저장하고, RAG 통합으로 지능형 검색을 지원하며, 페더레이션 커뮤니케이션으로 여러 머신의 에이전트가 안전하게 협력합니다. npx ruflo init 명령어로 초기화하면 자동으로 에이전트가 스웜을 조직하고, 성공한 패턴을 학습하고, 백그라운드에서 작업을 조정하며 사용자는 일반 코딩만 계속합니다. 전체 요약 5문장 읽기 → 084 20:31 ▲ 148 · 댓글 300 구글, Pixel Watch 5 공개…젬니 AI와 건강 추적 강화 Pixel Watch 5는 Qualcomm Snapdragon W5 Gen 2 프로세서 탑재로 이전 모델 대비 20% 빨라지고 50% 많은 RAM을 갖춰 온디바이스 AI 기반 실시간 기능을 지원한다. 하드웨어 · 시스템 · Pixel Watch 5
Key Point 기술 매체에서 큰 관심을 보인 구글의 최신 웨어러블 기기 발표로, AI 성능 향상과 생명 안전 기능의 혁신적 추가가 주목받고 있다.
핵심 요약
Pixel Watch 5는 Qualcomm Snapdragon W5 Gen 2 프로세서 탑재로 이전 모델 대비 20% 빨라지고 50% 많은 RAM을 갖춰 온디바이스 AI 기반 실시간 기능을 지원한다. GPS 추적 정확도가 전 세대 대비 2배 향상되어 Apple Watch Ultra 3과 Garmin Fenix 8 Pro를 능가하며, Google Health Coach와 함께 맞춤형 근력 운동과 적응형 회복 권장사항을 제공한다. 새로운 Health Guardian 기능으로 호흡 응급 상황 감지, 맥박 손실 감지, 위성 통신을 지원하며 감지 시 자동으로 응급 서비스 호출이 가능하다.