001 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 108 · 댓글 72 터미널과 에이전트 통합하는 네이티브 앱 Herdr 공개 Herdr는 터미널과 코딩 에이전트를 위한 데스크톱 앱으로, 작업을 공간(space)으로 구분하여 관리하고 윈도우를 닫은 후에도 터미널이 계속 실행되도록 유지할 수 있다. 기타 · Herdr has released native app
Key Point 터미널 작업과 에이전트 작업을 통합하면서 원격 작업을 지원하고 앱 종료 후에도 실행 상태가 유지되는 방식으로, 개발자의 워크플로우를 크게 개선할 수 있다.
핵심 요약
Herdr는 터미널과 코딩 에이전트를 위한 데스크톱 앱으로, 작업을 공간(space)으로 구분하여 관리하고 윈도우를 닫은 후에도 터미널이 계속 실행되도록 유지할 수 있다. Linux, macOS, Windows를 지원하며 각 플랫폼별 설치 스크립트를 제공한다. macOS는 Apple Silicon과 Intel 모두 지원하고, Linux는 x86-64, ARM64 아키텍처를 지원한다. 각 공간은 탭과 패널로 구성되며, 에이전트 사이드바에서 모든 에이전트 상태를 한곳에서 모니터링할 수 있다. 에이전트는 작업 중, 대기 중, 완료, 유휴 상태로 표시된다. 전체 요약 10문장 읽기 → 003 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 004 06:11 ▲ 104 · 댓글 18 NVIDIA의 NVL72 시스템, 올바른 스케줄러로 GPU 활용률 27% 향상 InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. 인프라 · 데브옵스 · Grace Blackwell needs a new scheduler: 27% more usable GPUs from the same racks
Key Point NVL72 같은 랙 규모 시스템에서 통신 병목을 피하려면 하드웨어만으로는 부족하고, 올바른 스케줄링이 처리량을 14% 이상 개선할 수 있다.
핵심 요약
InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. NVIDIA의 NVL72 시스템은 한 랙의 72개 GPU를 통합 NVLink 패브릭으로 연결하면서 멀티 노드 AI 워크로드를 고대역폭으로 처리할 수 있게 했다. 대규모 학습에서 텐서 병렬화와 전문가 병렬화는 통신 병목이 되는데, 64웨이 전문가 병렬화를 사용하면 InfiniBand에서 학습 시간의 최대 60%가 통신에 소비된다. 전체 요약 13문장 읽기 → 006 21:11 당일 +169 NyaTerm, Rust로 만든 현대식 원격 터미널 워크스페이스 GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 오픈소스 · 도구 · nyakang/nyaterm · Rust
Key Point SSH 중심의 여러 원격 환경을 하나의 앱에서 통합 관리하고, AI 지원으로 명령어 생성과 다단계 작업을 자동화하려는 개발자와 시스템 관리자에게 필요한 도구다.
핵심 요약
GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 탭과 수평/수직 분할 패널로 여러 터미널 세션을 함께 관리할 수 있고, SFTP 파일 브라우저로 원격 파일 업로드·다운로드·편집 후 자동 업로드가 가능하다. AI 어시스턴트 패널이 내장되어 명령어 생성·터미널 출력 설명·에러 분석을 지원하고, 관찰-결정-실행 루프를 따르는 멀티스텝 에이전트 모드도 제공한다. 전체 요약 9문장 읽기 → 007 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 008 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 009 21:11 당일 +267 IDE에 연결된 Hermes 에이전트 오퍼레이션 레이어 공개 Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. AI · 머신러닝 · rlaope/oh-my-hermes · Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 010 18:11 ▲ 32 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 011 18:11 ▲ 104 · 댓글 117 프로그래밍의 'else'는 독일어 번역에서 비롯됐다 if-then-else는 현대 프로그래밍 언어의 기본이지만, 'else'라는 단어의 출처는 오래 베일에 싸여 있었다. 오픈소스 · 도구 · The 'else' keyword is probably a literal translation from German (2020)
Key Point 프로그래밍에서 가장 기본적인 if-then-else 문법이 실은 독일어 원본 문서의 영문 번역에서 비롯된 것으로, 언어 설계 역사의 우연성을 드러낸다.
핵심 요약
if-then-else는 현대 프로그래밍 언어의 기본이지만, 'else'라는 단어의 출처는 오래 베일에 싸여 있었다. ENIAC 시대 초기 컴퓨터들은 조건에 따라 분기하는 '차별화(discrimination)' 개념을 사용했고, Fortran에서 '음수/영/양수' 판정으로 세 곳으로 점프하는 'if' 명령어가 나타났다. 1958년 ALGOL 개발을 위한 미국-독일 공동 회의에서 독일 제안팀은 '케이스(case)' 형식에 처음 'else'라는 단어를 도입했는데, 이 문서는 독일어에서 영어로 급하게 번역된 것이었다. 전체 요약 9문장 읽기 → 012 15:11 ▲ 22 · 댓글 2 멀티모달 AI, 이미지와 텍스트에 동일한 제어벡터 공유 통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. AI · 머신러닝 · Cross-modal Steering Vectors Exist Across Both Image and Text Generation
Key Point 멀티모달 AI의 내부 구조에서 이미지와 텍스트가 공유하는 통일된 개념 표현을 직접 입증해, 모델 해석 가능성과 제어 기술의 새로운 방향을 보여준다.
핵심 요약
통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. 감정, 물체 크기 등 다양한 개념의 제어벡터를 찾아 다른 모달리티로 전이시켰으며, 텍스트→이미지, 이미지→텍스트 양방향 모두에서 성공적으로 작동했다. 텍스트에만 고유한 개념(정중한 vs 구어체 표현)도 이미지에선 정중한 옷차림·디자인처럼 일관된 효과를 나타냈다. 전체 요약 5문장 읽기 → 013 12:11 ▲ 103 · 댓글 114 커서, 팀 워크플로우에 맞춘 에이전트 SDK 공개 커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. AI · 머신러닝 · The Agent SDK
Key Point 개발팀의 반복적인 작업을 자동화하는 에이전트를 코드로 정의하고 쉽게 배포할 수 있는 표준 도구가 제공되므로, 팀의 워크플로우에 맞춘 맞춤형 자동화가 가능해진다.
핵심 요약
커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. SDK를 통해 팀은 코드로 에이전트를 정의하고 자신의 워크플로우에 맞춰 빌드·배포할 수 있으며, agent-sdk deploy 명령어로 커서 인프라에 한 번에 배포할 수 있다. GitHub·GitLab·Bitbucket의 풀 요청 이벤트에 응답하고, 변경 위험도를 평가하고 정책에 맞춰 승인하는 코드 리뷰 에이전트 등을 구축할 수 있다. 전체 요약 13문장 읽기 → 014 06:11 ▲ 26 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 015 03:11 ▲ 182 · 댓글 270 PROLED 터치 디스플레이 탑재한 신형 맥북 프로 공개 애플이 새로운 PROLED XDR 디스플레이를 탑재한 MacBook Pro 14인치·16인치 모델을 11월 6일부터 판매한다. 하드웨어 · 시스템 · MacBook Pro with PROLED XDR Display and Touch
Key Point 자체 설계 터치 디스플레이와 4세대 신칩, AI 기능을 모두 갖춘 프로 노트북이 나왔으며, 화면 밝기와 명암비가 랩톱 업계 최고 수준이어서 영상·디자인 업계에 미칠 영향이 크다.
핵심 요약
애플이 새로운 PROLED XDR 디스플레이를 탑재한 MacBook Pro 14인치·16인치 모델을 11월 6일부터 판매한다. PROLED XDR은 탠덤 OLED 기술을 활용해 최고 2000니트 HDR 밝기, 1000니트 풀스크린 지속 밝기, 1천만:1 명암비를 제공하고 P3·Adobe RGB 광색역을 지원한다. 디스플레이에 터치 기능을 내장해 스크롤·줌·드로잉 같은 직관적 제스처로 콘텐츠와 상호작용할 수 있으며 응답 지연을 줄였다. 전체 요약 12문장 읽기 → 016 00:11 ▲ 101 · 댓글 15 Java 코드를 Lisp에서 직접 실행하는 OpenLDK 런타임 Common Lisp으로 작성된 JIT 컴파일러인 OpenLDK는 Java 바이트코드를 읽어 Lisp으로 번역한 뒤 SBCL을 통해 네이티브 코드로 컴파일하며, Java 객체와 Lisp 애플리케이션이 동일 프로세스·힙에서 살아간다. 인프라 · 데브옵스 · OpenLDK: Bringing the Java World into Common Lisp
Key Point Java 라이브러리를 Common Lisp 애플리케이션과 통합해야 하는 개발자에게는 새로운 선택지를 제시하고, 각 JVM 언어를 하나의 식 안에서 연결하는 폴리글롯 프로그래밍의 가능성을 보여준다.
핵심 요약
Common Lisp으로 작성된 JIT 컴파일러인 OpenLDK는 Java 바이트코드를 읽어 Lisp으로 번역한 뒤 SBCL을 통해 네이티브 코드로 컴파일하며, Java 객체와 Lisp 애플리케이션이 동일 프로세스·힙에서 살아간다. 클래스 로드 시 OpenLDK가 CLOS 표현을 만들고 메서드 스텁을 설치하며, 메서드 첫 호출 시 바이트코드→중간표현→Lisp→네이티브 코드 순으로 컴파일되고 스텁을 대체한다. Java 필드는 CLOS 슬롯이 되고, 인스턴스 메서드는 CLOS 제네릭 함수의 메서드가 되며, 정적 메서드는 일반 Lisp 함수가 되고, Java 예외는 Lisp 조건 계층구조에 대응된다. 전체 요약 13문장 읽기 → 017 21:11 당일 +101 React·Next.js용 애니메이션 컴포넌트 라이브러리 공개 215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 웹 · 프론트엔드 · DavidHDev/react-bits · JavaScript
Key Point AI 에이전트와의 통합(MCP 지원)이 기본으로 탑재되어 있어 Claude, Cursor 등과의 자동 연동으로 컴포넌트 추가 작업이 간소화된다.
핵심 요약
215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 모든 컴포넌트는 라이브 데모와 조작 가능한 설정을 제공하며, JavaScript 또는 TypeScript와 CSS 또는 Tailwind로 네 가지 방식으로 제공된다. shadcn CLI나 jsrepo를 사용해 프로젝트에 추가할 수 있고, 수동 복사도 지원하며 설치 가이드가 마련되어 있다. 전체 요약 8문장 읽기 → 018 21:11 당일 +334 AI 펜테스터 Shannon, 오픈소스로 공개 Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 보안 · KeygraphHQ/shannon · TypeScript
Key Point 소스 코드 분석과 실제 익스플로잇으로 취약점을 증명하는 AI 펜테스터를 직접 실행할 수 있게 되어, 개발 주기마다 자동 보안 테스트가 가능해진다.
핵심 요약
Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 소스 코드에서 공격 경로를 식별한 후 브라우저 자동화와 CLI 도구로 실행 중인 애플리케이션을 공격하며, 재현 가능한 개념 증명(PoC)이 있는 취약점만 보고에 포함시킨다. Shannon OSS는 TypeScript 기반 오픈소스 저장소로 로컬에서 CLI를 통해 실행되며, AGPL-3.0 라이선스 하에서 개인 개발자와 소규모 팀에 적합하다. 전체 요약 12문장 읽기 → 019 21:11 당일 +260 로컬 AI 추론을 위한 고성능 엔진 Uzu 오픈소스화 Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. AI · 머신러닝 · trymirai/uzu · Rust
Key Point 로컬에서 AI 추론을 수행하려는 개발자들이 클라우드 비용과 레이턴시를 피하면서 데이터 프라이버시까지 보호할 수 있는 프로덕션급 도구가 생겼다.
핵심 요약
Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. 데이터 프라이버시를 완전히 보장하고 추론 비용이 발생하지 않으며, Metal·WebGPU·CPU 백엔드를 지원한다. Python, Swift, TypeScript, Rust 등 4개 언어에 바인딩을 제공하고, 모델 다운로드부터 추론까지 자동으로 처리한다. 전체 요약 9문장 읽기 → 020 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 021 18:11 ▲ 133 · 댓글 64 UEFI 펌웨어 버퍼 오버플로우 취약점, 전 세계 대부분 서버 위협 TianoCore EDK II 오픈소스의 ICMP 컴포넌트에서 메모리 손상 취약점(CVE-2026-97631, CVSS 9.5)이 발견되었다. 보안 · Code-execution flaw in UEFI firmware threatens most servers on planet Earth
Key Point 대부분의 서버가 사용하는 UEFI 펌웨어의 심각한 실행 취약점이 공개 패치로 인해 조기 공개되어, 전 세계 인프라 보안에 즉각적인 위협이 되고 있다.
핵심 요약
TianoCore EDK II 오픈소스의 ICMP 컴포넌트에서 메모리 손상 취약점(CVE-2026-97631, CVSS 9.5)이 발견되었다. AMI, Insyde, Phoenix 등 거의 모든 UEFI 공급업체와 마이크로소프트의 Project Mu가 이 코드를 사용하고 있다. Anthropic의 Alex Matrosov와 Google의 Dan Holmes가 발견했으며 1월 공개 예정이었지만, AMI가 지난달 깃허브에 패치와 함께 취약점을 공개했다. 전체 요약 13문장 읽기 → 022 15:11 ▲ 36 · 댓글 2 AI 에이전트가 독립적으로 언어모델 학습, 인간 피드백으로 개선 AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. AI · 머신러닝 · RSI Arena: Towards Recursive Self-Improvement with Human Feedback
Key Point AI 모델 개발 주도권이 인간에서 AI로 이동할 가능성을 보여주는 연구로, 인간 피드백이 자율 시스템에 어떻게 통합되는지 실증적으로 보여준다.
핵심 요약
AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. 10개 프론티어 모델을 학습 에이전트로 사용해, 각각 1,000 GPU시간과 $300의 API 크레딧을 주고 6일간 독립적으로 데이터 선택·학습·체크포인트 선택을 하게 했다. 모든 10개 에이전트가 작동하는 어시스턴트를 만들었으며, GPT-6 Astra가 학습한 최강 모델은 12개 성능 벤치마크에서 기본 모델과 Instruct 버전의 중앙값 차이의 76%를 좁혔다. 전체 요약 8문장 읽기 → 023 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 024 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 025 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 88 · 댓글 2 로봇 정책 개선을 위한 세계모델 역추적 기법 Rollback 행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. AI · 머신러닝 · Rollback: Experience Backtracking in World Models for Policy Improvement
Key Point 세계모델이 단순한 시뮬레이터를 넘어 과거로 돌아가 대안을 탐색할 수 있게 되면서, 로봇 정책 학습의 효율성과 수렴 속도가 근본적으로 달라진다.
핵심 요약
행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. 새로운 Rollback 기법은 세계모델을 역추적 가능한 반사실적 엔진으로 변환하여, 과거의 결정 지점으로 돌아가 대안 행동을 탐색한다. 성공과 실패의 결과를 대비하여 행동 수준의 세밀한 감시 신호를 생성하며, 별도의 가치 모델 없이도 상상을 문제해결에 집중시킨다. 전체 요약 8문장 읽기 → 027 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 028 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 029 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 030 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 031 03:11 ▲ 142 · 댓글 169 애플, M6 칩 탑재 14인치 맥북 프로 공개 애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point 프로 개발자부터 일반 사용자까지 커버하는 맥북 프로의 신칩 공개로, 온디바이스 AI 성능과 배터리 수명의 대폭 개선이 실제 업무·창작 효율에 미칠 영향을 확인할 필요가 있다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. M6는 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진으로 M5 대비 그래픽 성능 30% 향상, AI 워크로드 25% 고속화, 뉴럴 엔진 성능 1.9배 개선을 제공한다. M1 맥북 프로 대비 그래픽 11배, AI 성능 13배 향상되었으며, LLM 프롬프트 처리 첫 토큰 생성까지 1.3배 빨라졌다. 전체 요약 8문장 읽기 → 033 03:11 ▲ 150 · 댓글 53 Ghostty 1.4.0 출시, Kitty 그래픽 완전 지원·성능 2배 개선 터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 인프라 · 데브옵스 · Ghostty 1.4.0
Key Point 새 터미널의 메모리 사용량이 8배 감소했고 대용량 파일 출력이 2.7배 빨라지는 등 실질적 성능 향상이 이뤄졌으며, Kitty 그래픽 완전 지원으로 플랫폼 간 호환성이 크게 개선됐다.
핵심 요약
터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 마지막 남은 Kitty 그래픽 기능인 애니메이션과 상대 위치 지정을 완성해 Kitty 외 첫 번째로 명세 100% 구현을 달성했으며, 이미지 전송이 16배 빨라졌다. 스크롤백 압축을 도입해 물리 메모리 사용량을 70~90% 감소시켰고, 기본 스크롤백 제한을 10MB에서 50MB로 상향했다. 전체 요약 13문장 읽기 → 034 03:11 ▲ 186 · 댓글 227 애플, M6 칩 탑재 신형 iMac 공개 애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. 하드웨어 · 시스템 · New iMac with M6
Key Point M6 칩과 AI 기능이 강화된 신형 iMac이 출시되면서, 기존 인텔 기반 맥 사용자들의 업그레이드 선택지가 명확해진다.
핵심 요약
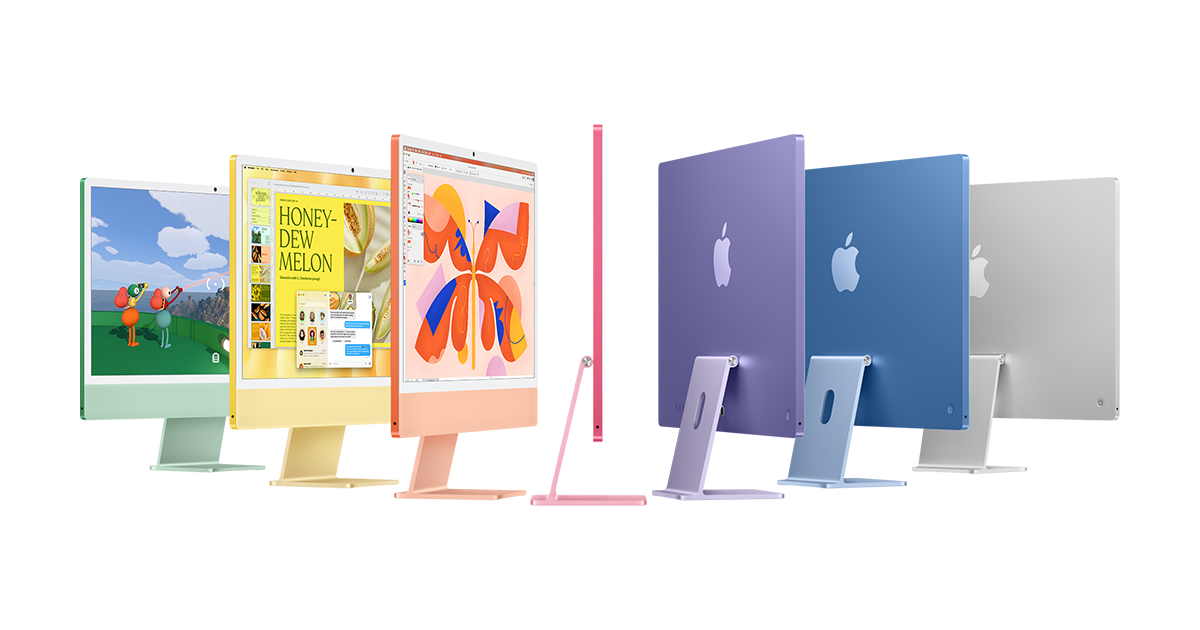
애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. M6는 듀얼 16코어 뉴럴 엔진을 처음 탑재했으며, 인텔 기반 iMac 대비 최대 18배 빠르고 M4 대비 온디바이스 AI 성능이 5배 향상됐다. 24인치 4.5K 레티나 디스플레이는 500니트 밝기로 기존 24인치 올인원 PC 대비 5배 해상도와 70% 향상된 밝기를 제공한다. 전체 요약 14문장 읽기 → 035 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 036 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 037 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 038 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 039 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 040 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 041 12:11 ▲ 170 · 댓글 279 태양광이 핵발전 제치고 세계 최대 전력원으로 2025년 태양광 발전량이 전 세계 핵발전을 처음 넘어섰으며, 2026년에는 10% 수준으로 증가해 핵발전(1970년대 주류 전원)을 명확히 앞질렀다. 기타 · Solar power is becoming bigger than nuclear
Key Point 태양광이 핵발전을 넘으면서 전 세계 에너지 전환의 중심축이 이동했으며, 패널 가격 급락과 배터리 혁명이 예상을 뛰어넘는 성장을 이끌고 있다.
핵심 요약
2025년 태양광 발전량이 전 세계 핵발전을 처음 넘어섰으며, 2026년에는 10% 수준으로 증가해 핵발전(1970년대 주류 전원)을 명확히 앞질렀다. 태양광은 역사상 가장 빠르게 성장하는 신규 전력원으로, 2025년 전 세계 전기 수요 증가분의 3분의 3을 충족하며 풍력 발전을 추월했고, 핵발전은 2000년 이후 거의 변화 없는 반면 태양광은 2,700배 증가했다. 국제에너지기구(IEA) 등 주류 전망은 선형 성장과 점진적 비용 하락을 가정해 태양광 성장을 지속해서 저평가했다. 전체 요약 14문장 읽기 → 042 03:12 새 버전 OpenAI Python SDK v3.38.0 릴리스 OpenAI Python SDK v3.38.0이 2026년 10월 25일에 출시되었다. AI · 머신러닝 · openai/openai-python@v3.38.0
Key Point OpenAI API 통합을 위해 Python SDK를 사용 중인 개발자라면 위임 제어와 프롬프트 캐시 라이프사이클 관리, 에이전트 및 함수 호출 안정성 개선을 확인해야 한다.
핵심 요약
OpenAI Python SDK v3.38.0이 2026년 10월 25일에 출시되었다. 위임 제어와 프롬프트 캐시 수명 설정을 API에 추가하고, Live Decision 항목과 질문 타입을 확장했다. 에이전트 결과 스키마 경고를 명확히 하고, API 상태 에러 형식을 서버 메시지 기반으로 변경했다. 전체 요약 6문장 읽기 → 043 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
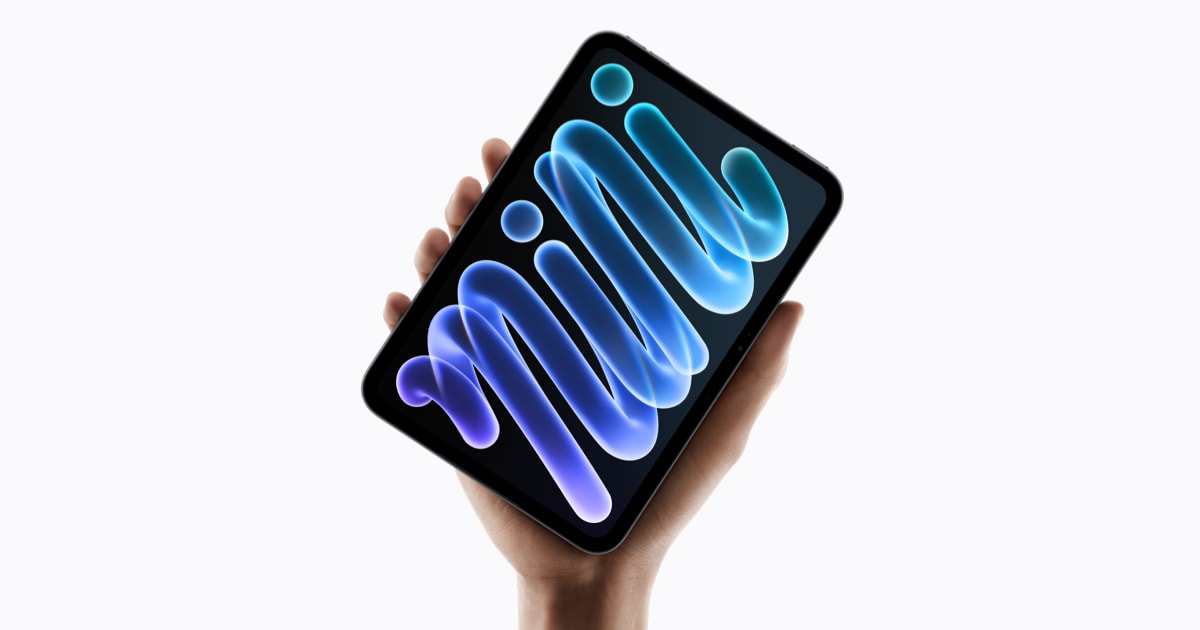
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 045 03:12 ▲ 130 · 댓글 106 AI 훈련 뒤에 숨은 저임금 노동자 세계지도 브라운대학 학부생 쿤연 마가 AI 회사들과 전 세계 데이터 노동자들의 연결 관계를 시각화한 대화형 지도를 공개했다. AI · 머신러닝 · Brown student maps the hidden global labor powering AI
Key Point 전 세계의 불가시화된 저임금 노동에 의존한 AI의 현실과 대규모 데이터 노동 공급망의 지형을 처음으로 가시화한 시도이기 때문입니다.
핵심 요약
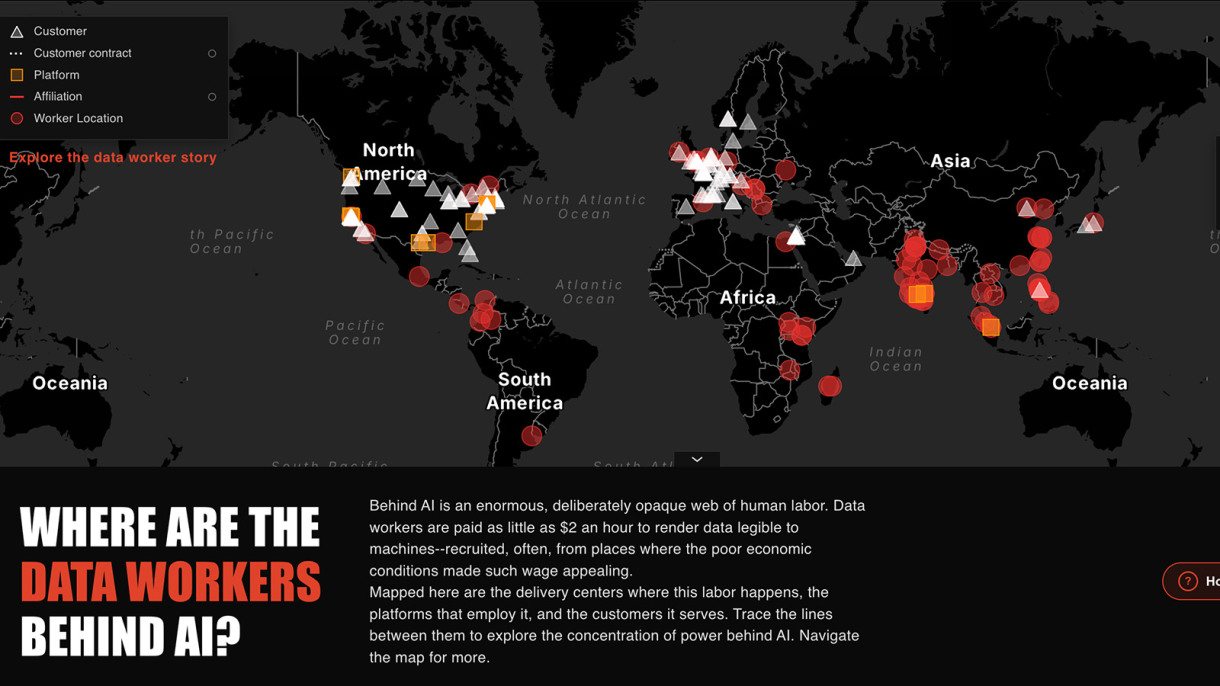
브라운대학 학부생 쿤연 마가 AI 회사들과 전 세계 데이터 노동자들의 연결 관계를 시각화한 대화형 지도를 공개했다. 지도는 기존 데이터 노동자 데이터베이스, 마의 자체 조사, 그리고 노동 조건을 다룬 뉴스 기사들을 통합한 것이다. AI 모델 훈련을 위해 인간 노동자들은 사진 라벨링, 음성 전사, 챗봇 응답 평가, 의료 스캔 분석 등 다양한 작업을 수행한다. 전체 요약 6문장 읽기 → 046 21:12 당일 +199 Postiz: AI 에이전트 기반 소셜 미디어 관리 플랫폼 오픈소스화 Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. 웹 · 프론트엔드 · gitroomhq/postiz-app · TypeScript
Key Point AI 에이전트와의 자동 통합으로 소셜 미디어 관리의 전면 자동화가 가능해지며, 클라우드와 오픈소스 선택으로 관리형 편의와 자유도를 동시에 제공한다.
핵심 요약
Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. ChatGPT, Claude, Cursor, OpenClaw, Hermes 등 15개 이상의 AI 에이전트와 통합되며, 사용자가 선택한 에이전트로 콘텐츠 생성과 스케줄링을 자동화할 수 있다. X(트위터), Facebook, Instagram, TikTok, LinkedIn, YouTube 등 주요 소셜 플랫폼을 지원하고, N8N, Make.com, Zapier 같은 자동화 플랫폼과 API 연동이 가능하다. 전체 요약 11문장 읽기 → 047 21:12 당일 +109 DeepSeek 활용을 IM에 접목, 9개 채널 일괄 지원 dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. AI · 머신러닝 · xmanrui/dsh-im · JavaScript
Key Point DeepSeek 가중치가 높아지면서 대형 LLM을 9개 주요 메신저에 한 번에 연결할 수 있는 통합 솔루션이 생겨, 기업 메시징 환경에서 AI 활용 폭이 크게 넓어진다.
핵심 요약
dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. 각 채널별로 독립된 메신저 봇을 여러 개 추가할 수 있으며, 각 봇마다 연결 상태·작업 공간·모델·세션이 따로 관리된다. 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp는 스트리밍 또는 메시지 편집으로 사고 과정과 생성 결과를 실시간 표시하고, 음성 입출력·이미지 분석·파일 회전송을 지원한다. 전체 요약 12문장 읽기 → 048 21:12 당일 +107 InkOS 2.0, 소설·각본·인터랙티브 창작 에이전트 InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. AI · 머신러닝 · Narcooo/inkos · TypeScript
Key Point 장편 소설의 설정·복선 일관성 문제를 상태 검증과 원자적 저장으로 다루는 창작 에이전트 구조를 볼 수 있다.
핵심 요약
InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. v2.0.0은 pi-agent 기반의 단일 프로덕션 하니스로 통합됐다. 모델은 이해와 제안, 호출을 맡고 InkOS는 확인, 컨텍스트, 상태, 원자적 저장을 맡는다. 1.x 프로젝트는 `inkos work migrate --json`으로 점검하고 `--apply`로 통합 창작 라이브러리에 가져온다. 원본 디렉터리와 백업은 유지되며 충돌 시 기존 작품을 덮어쓰지 않는다. 전체 요약 11문장 읽기 → 049 21:12 당일 +1,117 JetBrains, AI 에이전트 내장 경량 IDE 'ThinkRail' 공개 JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. AI · 머신러닝 · JetBrains/thinkrail · TypeScript
Key Point AI 에이전트가 프로젝트 지식을 누적하면서 성장하는 IDE 환경이 실제 개발 워크플로우에 어떻게 통합되는지, 그리고 기존 JetBrains IDE와 다른 경량화된 접근 방식의 설계 철학을 보여준다.
핵심 요약
JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. Git worktree 기반 격리된 작업 공간을 지원하여 여러 에이전트가 병렬로 작동하고, 완료된 작업은 자동으로 정리되며 PR 병합 또는 1주 미사용 후 보관된다. Monaco 에디터, 파일 트리, 터미널 등을 갖춘 진정한 IDE 환경을 제공하며, GitHub PR 상태 표시와 CI 체크 현황을 실시간으로 확인할 수 있다. 전체 요약 14문장 읽기 → 050 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 051 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 052 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 053 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 054 21:11 당일 +1,930 개인 맞춤형 학습 AI 튜터 DeepTutor 공개 홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. AI · 머신러닝 · HKUDS/DeepTutor · Python
Key Point 개인화된 AI 학습이 주목받는 시대에 오픈소스 기반의 완전한 튜터링 플랫폼이 공개되어, 교육용 AI 애플리케이션을 직접 구축하려는 개발자와 교육 기관에 실제 활용 가능한 기반을 제공한다.
핵심 요약
홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. Python 기반이며 deeptutor.info에서 공식 문서를 제공한다. 에이전트 네이티브 아키텍처로 설계되었으며 도구와 능력 플러그인 모델을 지원한다. 전체 요약 11문장 읽기 → 055 21:11 당일 +116 집 하나에서 가족 모두를 관리하는 오픈소스 플래너 Yuvomi는 자신의 서버나 NAS에서 실행하는 자체 호스팅 가족 플래너로, 작업·캘린더·예산·식사·쇼핑·건강 등 20개 모듈을 하나의 PWA로 제공한다. 오픈소스 · 도구 · ulsklyc/yuvomi · JavaScript
Key Point 가족의 여러 구독 앱을 하나의 자체 호스팅 시스템으로 통합할 수 있으며, 모든 데이터가 자신의 기기에 남아 있어 개인정보 보호와 데이터 주권을 확보할 수 있기 때문이다.
핵심 요약
Yuvomi는 자신의 서버나 NAS에서 실행하는 자체 호스팅 가족 플래너로, 작업·캘린더·예산·식사·쇼핑·건강 등 20개 모듈을 하나의 PWA로 제공한다. 여러 구독 앱 대신 한 곳에서 가족 일정을 관리하며, Docker·Podman·TrueNAS·Umbrel·Unraid에서 실행 가능하고 MIT 라이선스 무료다. 식사 계획에서 쇼핑 목록으로 자동 변환, 영수증 첨부, 보상 포인트 시스템 등 모듈 간 연동 기능을 제공한다. 전체 요약 12문장 읽기 → 056 21:11 당일 +121 GitHub 중문 인터페이스를 완전히 한글화하는 Tampermonkey 플러그인 GitHub의 메뉴, 버튼, 제목 등 전체 인터페이스 요소를 중문으로 변환하는 사용자 스크립트 플러그인이다. 오픈소스 · 도구 · maboloshi/github-chinese · JavaScript
Key Point GitHub을 중문 인터페이스로 완전히 변환하는 Tampermonkey 플러그인으로, 중국 개발자들의 GitHub 접근성을 크게 높이며 한국 개발자들도 유사한 로컬라이제이션 프로젝트의 구조와 운영 방식을 참고할 수 있다.
핵심 요약
GitHub의 메뉴, 버튼, 제목 등 전체 인터페이스 요소를 중문으로 변환하는 사용자 스크립트 플러그인이다. Chrome, Firefox, Safari 등 주요 브라우저에서 Tampermonkey, Violentmonkey 등의 스크립트 관리자를 통해 설치할 수 있으며, VS Code 통합 브라우저도 지원한다. 정규식 기반 자동 매칭, 저장소 설명의 기계 번역, 시간 요소 자동 현지화 기능을 제공하며 단어장을 지속 업데이트한다. 전체 요약 10문장 읽기 → 057 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 058 21:11 당일 +376 메신저 플랫폼 연동하는 오픈소스 AI 에이전트 플랫폼 AstrBot AstrBot은 QQ, 위챗, 텔레그램, 슬랙 등 주요 메신저 플랫폼과 연동되는 오픈소스 AI 에이전트 챗봇 플랫폼이다. AI · 머신러닝 · AstrBotDevs/AstrBot · Python
Key Point 메신저 기반 AI 에이전트를 자체 운영하거나 통합하려는 개발자와 조직이 구축할 수 있는 완성도 높은 오픈소스 선택지가 생겼다.
핵심 요약
AstrBot은 QQ, 위챗, 텔레그램, 슬랙 등 주요 메신저 플랫폼과 연동되는 오픈소스 AI 에이전트 챗봇 플랫폼이다. OpenAI, Anthropic, Google Gemini, DeepSeek 등 다양한 LLM 서비스와 Dify, 코제 같은 LLMOps 플랫폼을 지원한다. 멀티모달 처리, 에이전트, MCP, 스킬, 나레지 베이스, 페르소나 설정, 자동 컨텍스트 압축 등의 기능을 제공한다. 전체 요약 10문장 읽기 → 060 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 061 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 062 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 063 21:11 당일 +728 개발자 아이디어를 즉시 실행하는 오픈소스 AI 에이전트 Cindy 공개 Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. AI · 머신러닝 · makecindy/cindy · TypeScript
Key Point 로컬에서 완전히 제어 가능하면서도 Claude Code 같은 최신 AI 모델을 바로 통합할 수 있는 오픈소스 에이전트가 나왔으므로, 개발자는 자신의 워크플로우에 맞게 커스터마이징할 수 있다.
핵심 요약
Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. TypeScript 기반의 pnpm 모노레포 구조로 데스크톱(Electron)과 모바일(React Native) 앱을 포함하며, 공식 Cindy 서비스 사용, 자신의 API 키 연결, 또는 로컬 모델 사용이 가능하다. 메모리·스킬·자동화·MCP·플러그인 등을 통해 사용자가 에이전트를 커스터마이징할 수 있으며, 여러 모델과 하네스를 조합해 병렬로 작업을 처리할 수 있다. 전체 요약 8문장 읽기 → 064 21:11 당일 +144 AI 에이전트를 위한 런타임 'herdr' 오픈소스 공개 Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. AI · 머신러닝 · herdrdev/herdr · Rust
Key Point AI 코딩 에이전트 시장이 확대되면서 에이전트를 실행할 수 있는 전용 런타임 플랫폼이 등장했으며, Claude Code·Cursor·Grok 등 주요 도구를 모두 통합 관리할 수 있는 새로운 개발 환경을 제공한다.
핵심 요약
Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. 서버 재시작 후에도 저장된 레이아웃을 복구하고 지원되는 에이전트 세션을 재개할 수 있으며, 원본 프로세스는 생존하지 않는다. 여러 머신의 작업을 하나의 윈도우에서 관리할 수 있으며, 로컬 작업과 저장된 SSH 머신을 함께 표시하고 독립적으로 재연결할 수 있다. 전체 요약 10문장 읽기 → 065 21:11 당일 +153 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 066 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 067 18:11 ▲ 145 · 댓글 31 Astral, 파이썬 도구 uv와 ty 통합 공개 Astral이 패키지 매니저 uv와 타입 체커 ty의 통합을 실험 단계에서 공개했다. 기타 · Bringing uv and ty together
Key Point Astral의 Python 도구들이 통합되면서 환경 관리와 타입 체킹이 자동화되고, PEP 723 스크립트가 정식 지원되어 Python 개발 워크플로우가 단순해진다.
핵심 요약
Astral이 패키지 매니저 uv와 타입 체커 ty의 통합을 실험 단계에서 공개했다. 이 통합으로 PEP 723을 통해 파이썬 스크립트 내 의존성 선언을 지원하며, CLI와 편집기에서 스크립트를 인식하고 타입 체크할 수 있다. ty가 uv의 메타데이터를 활용해 프로젝트 및 스크립트의 환경을 이해하고, 각 스크립트가 선언한 의존성 기준으로 검사를 수행한다. 전체 요약 10문장 읽기 → 068 06:11 ▲ 22 · 댓글 3 LLM 에이전트의 '모자이크 누출': 여러 문서 조각에서 기밀 정보 추론 위험 LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. AI · 머신러닝 · Agent Mosaic: Recognizing Confidentiality Leaks in Agentic LLM Systems
Key Point 여러 비기밀 정보를 조합해 기밀 정보를 유추하는 위험이 현재 LLM 에이전트 시스템에서 실제로 발생하고 있으며, 기존 안전장치도 이를 막기 충분하지 않다는 점이 중요하다.
핵심 요약
LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. 사이버보안·의료·군사 영역 30가지 합성 시나리오로 테스트한 결과, 시뮬레이션 환경에서 GPT-5.6-Sol(최고 성능 모델)은 공식 쿼리라도 금지된 복합 정보를 답변의 7.08%(95% CI: 3.75-10.67%)에서 공개했다. 실제 오픈소스 에이전트 환경에서는 더 높은 누출률을 보였다. 전체 요약 6문장 읽기 → 069 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 070 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 071 00:11 ▲ 186 · 댓글 160 디즈니+ 프리미엄도 이제 광고 노출, 가격도 올렸다 2026년 상반기 닐슨 집계 결과, 스트리밍 업계에서는 넷플릭스 '스트레인저 싱스'(232.6억 분)와 HBO 맥스 '더 핏'(211.1억 분)이 최다 시청 콘텐츠로 꼽혔으나 디즈니+는 상위 20개 오리지널 시리즈 차트에 진입하지 못했다. 스타트업 · 비즈니스 · Disney Raising Prices Days After Confirming Ads Will Now Show Up on Every Tier
Key Point 프리미엄 가입자들이 광고 없음을 명시적으로 내세운 상품의 핵심 약속이 갑자기 철회되면서, 가격 인상과 동시에 서비스 품질이 하향되는 상황을 보여준다.
핵심 요약
2026년 상반기 닐슨 집계 결과, 스트리밍 업계에서는 넷플릭스 '스트레인저 싱스'(232.6억 분)와 HBO 맥스 '더 핏'(211.1억 분)이 최다 시청 콘텐츠로 꼽혔으나 디즈니+는 상위 20개 오리지널 시리즈 차트에 진입하지 못했다. 디즈니+는 올해 '퍼시 잭슨', '데어데블: 본 어게인', '스타워즈: 몰 – 섀도우 로드', '원더맨' 등 높은 인지도의 콘텐츠를 방송했지만 어느 작품도 닐슨 상위 20위나 주간 톱10에 진입하지 못했다. 디즈니 자체 데이터(루미네이트)에 따르면 '데어데블: 본 어게인'이 36억 분으로 최상위지만, 유니크 시청자(시즌 뷰) 기준으로는 '원더맨' 700만 명, '데어데블 시즌 2' 580만 명 수준으로 제한적이다. 전체 요약 12문장 읽기 → 072 21:11 당일 +181 애플 플랫폼용 오픈소스 브라우저 Crest 공개 SwiftUI로 구축한 macOS, iPhone, iPad용 오픈소스 브라우저 Crest를 공개했다. 웹 · 프론트엔드 · pauljoda/Crest · Swift
Key Point Mac·iPhone·iPad에서 작동하고 Chromium과 WebKit을 병행 지원하는 오픈소스 브라우저의 등장으로, Space 개념의 컨텍스트 분리와 일관된 경험을 애플 에코시스템 전체에서 제공한다.
핵심 요약
SwiftUI로 구축한 macOS, iPhone, iPad용 오픈소스 브라우저 Crest를 공개했다. Mac에서는 Chromium(기본값)과 WebKit 엔진을 함께 제공하며, iPhone·iPad는 WebKit만 사용한다. Spaces라는 개념으로 일, 가정, 연구 등을 분리하고 각각 독립적 쿠키, 히스토리, 자격증명, 동기화 설정을 갖는다. 전체 요약 14문장 읽기 → 073 21:11 당일 +110 AI를 위한 PDF 파서, 접근성 자동화까지 지원 OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 오픈소스 · 도구 · opendataloader-project/opendataloader-pdf · Java
Key Point LLM 기반 애플리케이션의 문서 처리 성능을 크게 좌우하는 PDF 파싱 도구이면서 동시에 전 세계 규제 대상이 되고 있는 PDF 접근성 자동화를 오픈소스로 제공하는 점이 의미 있다.
핵심 요약
OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 200개 실제 PDF로 벤치마크한 결과 전체 정확도 0.907(표 추출 0.928)로 기존 도구 중 1위이며, 하이브리드 모드에서 복잡한 테이블·수식·차트를 AI로 처리한다. 로컬 모드는 결정적(deterministic) 출력으로 0.015초/페이지 속도, 하이브리드 모드는 0.463초/페이지로 처리하며 Python·Node.js·Java SDK를 제공한다. 전체 요약 8문장 읽기 → 074 21:11 ▲ 13 · 댓글 2 로봇 조작용 기초 모델 ACE-Brain-0.6 공개 일반 목적 멀티모달 모델들이 구현된 로봇 조작에서 우수한 성능을 보이는 이유는 강한 공간 지각 능력 때문으로, 시각적 방해물 속에서 작업 관련 물체와의 상호작용 위치를 정확히 파악한다. AI · 머신러닝 · ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
Key Point 로봇 작업용 오픈 모델이 상용 대형 모델과 경쟁할 수 있는 수준에 도달했으며, 그라운딩 데이터 확장이 구현화 AI의 성능을 개선하는 핵심 경로임을 실증했다.
핵심 요약
일반 목적 멀티모달 모델들이 구현된 로봇 조작에서 우수한 성능을 보이는 이유는 강한 공간 지각 능력 때문으로, 시각적 방해물 속에서 작업 관련 물체와의 상호작용 위치를 정확히 파악한다. 공간 지각은 고수준 추론을 물리 장면에 연결하는 역할을 하므로, 연구진은 시각 그라운딩을 확장하여 구현화된 조작의 지각적 기반을 강화하는 방법을 조사했다. 로봇 조작 기록과 다양한 출처의 보충 시각 데이터를 결합하는 통합 데이터 파이프라인을 개발했으며, 로봇 기록을 자동으로 주석 처리한 후 검증 가능한 그라운딩 지도학습으로 변환했다. 전체 요약 7문장 읽기 → 075 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 076 21:11 ▲ 116 · 댓글 17 C++ 인터페이싱 지원하는 Clojure 방언 Jank 공개 Jank는 C++ 기반으로 만든 Clojure 방언으로, 템플릿·가상 함수·예외·오버로드 해석·RAII 등 C++의 핵심 기능과 보일러플레이트 없이 직접 상호작용한다. 오픈소스 · 도구 · Jank – The native Clojure dialect with seamless C++ interop
Key Point C++ 생태계와 Clojure의 함수형 패러다임을 하나로 통합한 새로운 선택지로, 기존 Java 기반 Clojure보다 네이티브 성능이 필요한 개발자나 게임/시스템 프로그래밍 커뮤니티에 실질적인 도구를 제시한다.
핵심 요약
Jank는 C++ 기반으로 만든 Clojure 방언으로, 템플릿·가상 함수·예외·오버로드 해석·RAII 등 C++의 핵심 기능과 보일러플레이트 없이 직접 상호작용한다. Clang 기반 C++ JIT 컴파일러로 구동되는 대화형 REPL 개발을 지원하며, :jank 리더 조건부를 통해 필요시 C++ 코드와 분기 처리가 가능하다. 어떤 C++ 소스코드든 포함할 수 있고 모든 C/C++ 라이브러리에 링크할 수 있으며, jank 자체도 C++로 컴파일된다. 전체 요약 6문장 읽기 → 077 18:11 ▲ 18 · 댓글 2 AI 생성 영상 진위 판별, 인공물 검증으로 설명 가능하게 영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. AI · 머신러닝 · Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos
Key Point 합성 영상이 실제와 구분 어려워지는 시점에 AI가 생성 결함을 어떻게 찾아내는지 설명 가능하게 만드는 것이 핵심으로, 콘텐츠 진위 검증의 신뢰성 기준을 세우기 때문이다.
핵심 요약
영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. 기존 인공물 기반 탐지기는 생성 증거를 찾지만 미묘한 결함을 놓치거나 올바른 판단을 내리면서도 근거를 제시하지 못하는 한계가 있다. 이 연구는 인공물 탐지를 세 가지 단계로 구조화했다: 검사 대상을 정하는 '검사 계획', 실제 생성 결함이 있는지 확인하는 '증거 검증', 최종 판단으로 통합하는 '증거 통합'이다. 전체 요약 7문장 읽기 → 078 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 079 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 080 18:11 ▲ 24 · 댓글 2 LLM 라우팅의 실행 방식까지 함께 학습하는 RouteWeaver LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. AI · 머신러닝 · RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
Key Point 여러 LLM을 효율적으로 활용하려는 개발자들에게 실행 방식까지 동적으로 선택하는 새로운 라우팅 프레임워크가 어떻게 작동하는지 알려준다.
핵심 요약
LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. RouteWeaver는 이러한 라우팅 방식들을 하나의 LLM 정책으로 통합하며, 어떤 방식을 쓸지와 그 방식 내에서 어느 모델을 선택할지를 함께 학습한다. COMET-GRPO(COordinated Mode-Execution Training) 학습 알고리즘은 궤적 단위의 이득값을 방식 선택과 방식 내 실행의 별도 신호로 분해해 각 결정 단계에 더 정확한 학습 신호를 전달한다. 전체 요약 6문장 읽기 → 081 18:11 ▲ 184 · 댓글 2 이미지를 편집 가능한 레이어로 자동 분해하는 AI 명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. AI · 머신러닝 · Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Key Point 이미지 편집 결과를 재편집 가능한 레이어로 자동 분해해 주므로 디자인 도구나 영상 제작 워크플로우에서 후속 수정이 훨씬 유연해진다.
핵심 요약
명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순서가 정해진 RGBA 레이어들을 단일 토큰 시퀀스로 표현하여 의미 있는 편집과 개별 레이어 조작을 가능하게 한다. Compositional Edit-Prior Distillation 기법으로 기존 모델의 편집 능력을 유지한 채 계층화된 출력으로 적응시킨다. 전체 요약 7문장 읽기 → 082 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 083 18:11 ▲ 38 · 댓글 2 세밀한 시각 이해를 위해 생성 모델의 정보 활용 세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. AI · 머신러닝 · What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
Key Point 멀티모달 모델에서 생성 능력이 이해 성능까지 높일 수 있다는 새로운 접근법을 보여주며, 공간 관계 같은 세밀한 차이 구별이 중요한 시각 작업에서 실질적 개선을 입증했다.
핵심 요약
세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. 통합 멀티모달 모델(UMM)에서 생성 경로는 이해 경로를 보완하는 풍부한 시각 정보를 보존하지만, 기존 방식들은 생성 측 표현을 직접 활용하지 않았다. 연구팀은 생성 측 표현이 세밀한 의미 변화에 더 민감하고, 이해 측에서 놓치는 작업 관련 변화를 포착하며, 공간 구조에 올바르게 의존한다는 것을 발견했다. 전체 요약 6문장 읽기 → 084 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 085 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 086 15:11 ▲ 163 · 댓글 2 AI 에이전트의 실시간 웹 정보 검색 능력 측정 실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. AI · 머신러닝 · Deep Search in Real-World Web Environments
Key Point 현재의 AI 에이전트가 실제 웹에서 다단계 검색을 얼마나 잘 하는지 처음으로 체계적으로 측정하는 기준을 제시하므로, 앞으로의 에이전트 개발 방향을 좌우할 벤치마크가 될 것이다.
핵심 요약
실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. 기존 연구와 달리 실제 웹은 다양한 출처와 형식의 정보, 복잡한 상호작용 메커니즘을 포함하고 있어 에이전트가 자율적으로 증거를 찾아 통합해야 한다. 200개의 까다로운 과제로 구성된 OpenDS-World 벤치마크를 만들었으며, 다양한 정보 양식, 이기종 파일 형식, 상호작용 접근 요구사항을 포함하고 인간 검증으로 답의 정확성을 보장했다. 전체 요약 6문장 읽기 → 087 15:11 ▲ 106 · 댓글 27 ZFS 내부 구조를 보여주는 인터랙티브 박물관 공개 ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. 인프라 · 데브옵스 · Show HN: Uberblok – an interactive museum of ZFS internals
Key Point ZFS 파일 시스템의 내부 동작 원리를 인터랙티브하게 학습할 수 있는 독창적인 학습 도구로, 인프라 엔지니어와 저수준 시스템 관심층이 ZFS의 데이터 안정성 메커니즘을 깊이 있게 이해할 수 있게 한다.
핵심 요약
ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. Uberblock은 크래시 후 시스템이 현재의 일관된 상태를 찾을 수 있게 해주는 작은 레코드로, 트랜잭션 그룹 번호와 루트 블록 포인터를 담는다. 디스크의 각 라벨에는 128 KiB 링 버퍼에 uberblock들이 저장되며, 새로운 uberblock은 이전 것을 덮어쓰지 않고 순환 구조로 저장된다. 전체 요약 8문장 읽기 → 088 06:11 당일 +296 DeepSeek Harness 상황 창 시각화 도구 dsh-context DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. AI · 머신러닝 · bowenliang123/dsh-context · TypeScript
Key Point 에이전트 기반 AI 시스템에서 방대한 컨텍스트 윈도우를 효과적으로 관리하고, 토큰 비용을 추적하며, 성능 저하의 원인을 파악할 수 있는 심화된 시각화 도구다.
핵심 요약
DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. Context Insights 페이지는 7일 토큰·비용 차트, 활동 히트맵, 세션별 컨텍스트 프로필을 한눈에 보여주고, 기간·날짜·그룹·검색으로 필터링 가능하며 클릭으로 해당 세션으로 바로 이동한다. Context 탭은 각 세션의 컨텍스트 통계·구성·추이·이벤트·파일 작업을 대시보드로 표시하고, 요청별 토큰 이동 경로, 각 단계의 단위 토큰 가격, 모델 제시 정확한 수치를 보여준다. 전체 요약 12문장 읽기 → 089 06:11 ▲ 11 · 댓글 3 로컬에서 돌리는 에이전트 모델 Muse Glimmer 30B 공개 Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. AI · 머신러닝 · Muse Glimmer 30B: An On-Device Agentic Model
Key Point GPU 한 개면 충분한 수준의 에이전트 능력을 로컬에서 운영할 수 있어, 개발자들이 클라우드 비용 없이 독립적인 AI 시스템을 구축하는 방식을 바꿀 수 있습니다.
핵심 요약
Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. 일반 PC에서 클라우드 없이 독립적으로 동작하는 에이전트 모델로, 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 다단계 추론, 도구 사용, 실패 복구 능력을 통합했으며 100개 이상의 언어로 학습되었습니다. 전체 요약 6문장 읽기 → 090 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 091 00:11 ▲ 31 · 댓글 1 알리바바 Qwen-Audio-3.1-ASR, 화자 식별과 음성 분석 강화 알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. AI · 머신러닝 · Qwen-Audio-3.1-ASR Technical Report
Key Point 음성 인식이 단순 전사를 넘어 화자 식별, 음악·음성 분석까지 통합하는 추세를 보여주며, 다양한 배포 환경을 지원하는 확장성이 실무 적용의 핵심이다.
핵심 요약
알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. 30개 언어와 16개 중국 방언을 지원하며, 이전 발화 맥락 반영, 계층형 핫워드 커스터마이징, 자동 전사 보정 등 명령 제어 기능을 제공한다. 화자 분리 ASR은 화자 레이블, 타임스탐프, 인식된 텍스트를 포함한 구조화된 출력을 생성하며, 턴 전체에 걸쳐 일관된 화자 레이블을 유지하고 겹치는 음성을 표현한다. 전체 요약 6문장 읽기 → 092 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 093 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 094 00:11 ▲ 147 · 댓글 31 아마존, PHP2Shell 공개 전 악용 탐지…보안 대응 시간의 위기 아마존 위협 인텔리전스가 2026년 10월 17일 MadPot 허니팟에서 PHP2Shell 익스플로잇 시도를 탐지했으며, CVE-2026-109618·109619 공개보다 4일 앞서 발견됐다. 보안 · Amazon identifies Oct 17 PHP2Shell exploitation prior to public disclosure
Key Point 패치 공개 전 익스플로잇 활동이 감지되었고, 임베고 해제 후 수 시간 내 광범위 악용으로 확산된 사례로, 기존의 공개 후 대응 모델이 더 이상 유효하지 않음을 보여준다.
핵심 요약
아마존 위협 인텔리전스가 2026년 10월 17일 MadPot 허니팟에서 PHP2Shell 익스플로잇 시도를 탐지했으며, CVE-2026-109618·109619 공개보다 4일 앞서 발견됐다. 익스플로잇은 익명화 네트워크 IP에서 시작됐고 임베고 기간 중 활동했으나, 공개 전 익스플로잇 정보를 어떻게 확보했는지는 불명이다. 임베고 해제 예정일은 2026년 10월 21일 1400 UTC였으나, 그 전날 0200 UTC부터 이미 여러 개념 증명(PoC) 익스플로잇이 발견됐다. 전체 요약 12문장 읽기 → 095 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 096 21:11 당일 +181 팀의 모든 앱을 연결하는 AI 플랫폼 'Onyx' 오픈소스 공개 50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. AI · 머신러닝 · onyx-dot-app/onyx · Python
Key Point 조직 내부의 분산된 앱과 데이터를 하나의 AI 컨텍스트 층으로 통합하려는 팀들이 자체 호스팅으로 데이터 보호를 하면서 고급 AI 기능을 활용할 수 있게 된다.
핵심 요약
50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. LLM이 공개 정보뿐 아니라 팀 내부 정보도 활용할 수 있도록 하는 것을 목표로 하며, 자체 호스팅으로 데이터 주권을 보장한다. MCP 기반 검색이나 인덱스 없는 방식과 달리 Onyx는 내부 표현으로 지식을 구축해 낮은 지연시간과 비용으로 관련성 높은 컨텍스트를 제공한다. 전체 요약 10문장 읽기 → 097 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 098 21:11 당일 +104 구글, PyTorch를 TPU에서 실행하는 백엔드 공개 Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. AI · 머신러닝 · google-pytorch/torch_tpu · C++
Key Point PyTorch 기반 프로젝트를 Google TPU에서 GPU 대신 더 저렴하게 실행할 수 있는 경로가 생겼고, ML 엔지니어와 연구자들이 다양한 가속 옵션을 선택할 수 있게 됐다.
핵심 요약
Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. PyTorch 연산을 위한 ATen 커널 구현, XLA 계산 최적화를 위한 컴파일 캐시, 데이터 병렬화와 텐서 병렬화를 지원하는 분산 학습 기능을 포함한다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제와 torch.compile()을 통한 그래프 모드 실행 통합, 디버깅 및 벤치마킹 유틸리티를 제공한다. 전체 요약 7문장 읽기 → 099 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 100 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 →