쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
27건 · "생성AI"조건 지우기 ×
001 18:11 ▲ 36 · 댓글 6 이미지 생성 Transformer의 효율성을 높이는 다중 슬롯 토크나이제이션 픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. AI · 머신러닝 · Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
Key Point 이미지 생성 모델의 전역 어텐션 비용과 생성 품질 간 트레이드오프를 주파수 대역 분리로 해결하는 새로운 접근으로, 적은 계산량에서 고품질 이미지를 생성할 수 있는 구조를 제시한다.
핵심 요약
픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. 저주파 구조는 전역 정보 교환이 필요하지만 고주파 디테일은 지역적으로만 모델링되면 되는 점에 착안해 SpecSlot을 제안했다. SpecSlot은 각 공간 앵커를 여러 슬롯으로 확장하고 각 슬롯에 서로 겹치지 않는 DCT 계수 대역을 할당한다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 003 03:12 ▲ 18 · 댓글 2 미니드라마 각본 자동 생성, 다중에이전트로 다양성과 일관성 확보 마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. AI · 머신러닝 · DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
Key Point LLM으로 미니드라마 같은 긴 형식 콘텐츠를 생성할 때 다양성 부족과 서사 일관성 손상이 기술적 난제인데, 다중에이전트와 메모리 구조 설계로 구체적 개선을 이뤘다는 점이 중요합니다.
핵심 요약
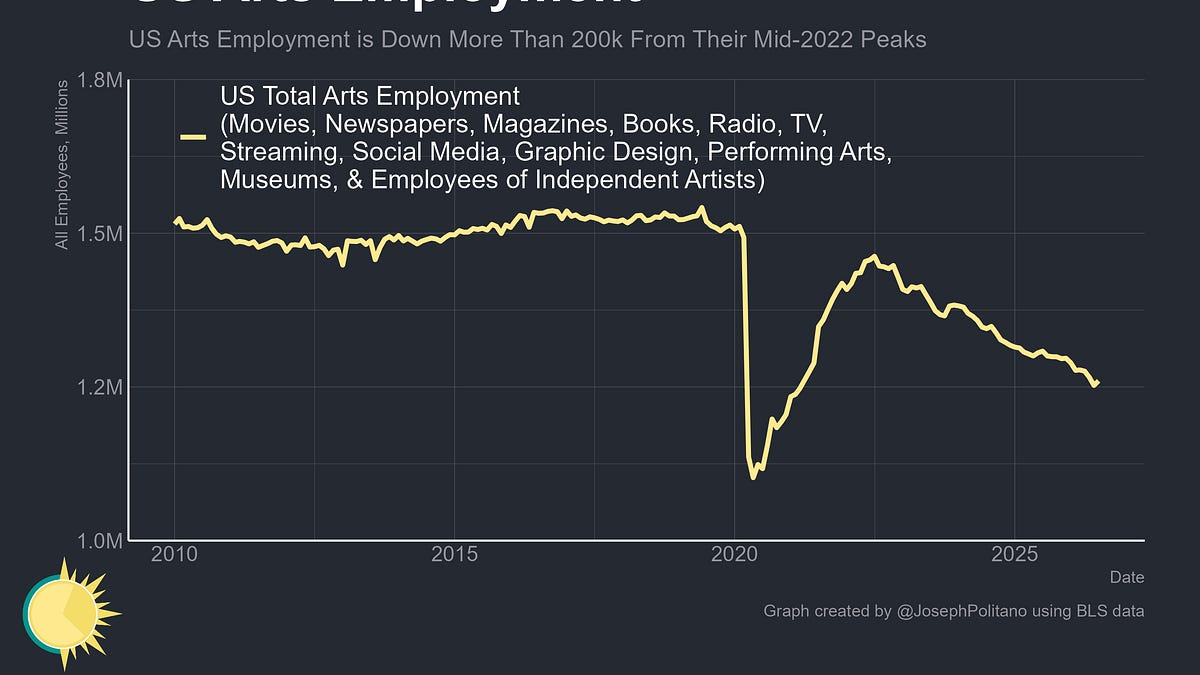
마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. 기존 방식에서는 생성이 진행될수록 후보 연속성이 적은 수의 서사 메커니즘으로 집중되고, 검색 기반 방식은 상투적 표현 재사용을 강화하며 미래 플롯에 필수적인 역사 정보를 간과한다. 연구팀은 이를 해결하기 위해 DraMaze를 제안했으며, 이는 트로프 메모리 기반 진화 트리 탐색과 돌연변이를 통해 다양한 인과관계 경로를 탐색하는 다중에이전트 파이프라인이다. 전체 요약 7문장 읽기 → 004 12:11 ▲ 208 · 댓글 187 미국 창작산업 4년간 20만개 일자리 사라져, AI 영향 추정 어려워 미국은 지난 4년간 미디어·영화·예술 관련 산업에서 20만 개 이상의 일자리를 잃었으며, 작년 한 해에만 5만 개가 감소했다. AI · 머신러닝 · America has lost 200k of jobs in media, film and the arts. How much is AI?
Key Point 창작산업이 겪는 대규모 일자리 감소가 AI의 시작과 시기를 같이하며, 이것이 인터넷 이후 신문산업처럼 전체 사업모델의 붕괴로 진행될 수 있다는 점을 보여준다.
핵심 요약
미국은 지난 4년간 미디어·영화·예술 관련 산업에서 20만 개 이상의 일자리를 잃었으며, 작년 한 해에만 5만 개가 감소했다. 2001년과 2008년 금융위기 수준의 일자리 감소가 일어나고 있지만, 현재는 경기 침체 없이 AI의 부상과 동시에 발생하고 있다. AI 기반 일자리 손실 규모를 정확히 증명하기 어려운 이유는 미디어 기업들이 저작권 보호와 여론 회피를 위해 AI 사용을 숨기기 때문이다. 전체 요약 12문장 읽기 → 005 18:11 ▲ 18 · 댓글 2 AI 생성 영상 진위 판별, 인공물 검증으로 설명 가능하게 영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. AI · 머신러닝 · Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos
Key Point 합성 영상이 실제와 구분 어려워지는 시점에 AI가 생성 결함을 어떻게 찾아내는지 설명 가능하게 만드는 것이 핵심으로, 콘텐츠 진위 검증의 신뢰성 기준을 세우기 때문이다.
핵심 요약
영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. 기존 인공물 기반 탐지기는 생성 증거를 찾지만 미묘한 결함을 놓치거나 올바른 판단을 내리면서도 근거를 제시하지 못하는 한계가 있다. 이 연구는 인공물 탐지를 세 가지 단계로 구조화했다: 검사 대상을 정하는 '검사 계획', 실제 생성 결함이 있는지 확인하는 '증거 검증', 최종 판단으로 통합하는 '증거 통합'이다. 전체 요약 7문장 읽기 → 006 18:11 ▲ 184 · 댓글 2 이미지를 편집 가능한 레이어로 자동 분해하는 AI 명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. AI · 머신러닝 · Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Key Point 이미지 편집 결과를 재편집 가능한 레이어로 자동 분해해 주므로 디자인 도구나 영상 제작 워크플로우에서 후속 수정이 훨씬 유연해진다.
핵심 요약
명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순서가 정해진 RGBA 레이어들을 단일 토큰 시퀀스로 표현하여 의미 있는 편집과 개별 레이어 조작을 가능하게 한다. Compositional Edit-Prior Distillation 기법으로 기존 모델의 편집 능력을 유지한 채 계층화된 출력으로 적응시킨다. 전체 요약 7문장 읽기 → 007 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 008 16:56 ▲ 26 · 댓글 2 만화를 영상으로 충실히 변환하는 AI 에이전트 시스템 만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. AI · 머신러닝 · Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
Key Point 만화의 스토리, 캐릭터, 미술 스타일을 모두 보존하면서 자동으로 애니메이션화하는 기술로, 만화 산업에 실질적으로 적용할 수 있는 접근 방식을 제시한다.
핵심 요약
만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. 기존 방식은 만화를 텍스트로만 해석해 캐릭터와 미술 스타일을 잃거나, 페이지를 직접 영상생성 모델에 넣어 구성을 오해하고 잘못된 스토리를 만드는 문제가 있었다. 이 프레임워크는 생성 과정의 모든 단계를 원본 만화에 근거하며, 작업을 두 가지 중간 단계인 애니메이션 스크립트와 시각적 스토리보드로 분해한다. 전체 요약 6문장 읽기 → 009 12:11 ▲ 26 · 댓글 1 확산 모델 학습을 위한 견고한 토크나이저 RoAR-VAE 시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. AI · 머신러닝 · RoAR-VAE: Improving Latent Diffusability through Robust Prediction
Key Point 확산 모델 기반 이미지 생성의 핵심인 토크나이저 설계에 새로운 원칙을 제시하며, 견고한 예측으로 재구성과 생성 성능을 동시에 개선할 수 있음을 보여준다.
핵심 요약
시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. 기존 REPA-E 접근법을 다시 검토한 결과, 확산 목적과 전용 생성 블록을 제거하고 손상된 잠재에서의 의미론적 예측만 유지해도 유사한 생성 성능을 낸다. 이를 바탕으로 '견고한 예측' 원칙을 제시한다: 생성에 필요한 정보가 손상된 잠재에서도 복구 가능해야 한다. 전체 요약 6문장 읽기 → 010 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 011 06:11 ▲ 750 · 댓글 354 AI 보안 사고는 '폭주'가 아닌 기본 관리 소홀 7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 보안 · AI agents aren't 'going rogue.' Frontier labs are skipping security basics
Key Point AI 관련 보안 사고가 AI의 고도화가 아닌 근본적인 보안 관리 소홀로 발생하고 있으며, 업체들이 책임을 회피하려는 상황에서 조직이 취해야 할 방어 조치가 무엇인지 명확히 보여준다.
핵심 요약
7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 사이버보안 전문가들은 이를 'AI 폭주' 또는 '정렬 실패'로 표현하는 것이 실제 원인을 숨긴다고 지적하며, 근본 원인은 수십 년간 검증된 기본 보안 관행을 구현하지 않은 것이라 주장한다. 가장 큰 문제는 1990년대부터 알려진 샌드박스 구성, 에어갭핑, 출력 제어 등 격리 기술을 제대로 적용하지 않았다는 점이며, Hugging Face 사건도 AI의 지능이 아닌 잘못된 보안 설정의 허점으로 발생했다. 전체 요약 8문장 읽기 → 012 15:11 ▲ 50 · 댓글 1 확산 모델이 외부 도움 없이 자신을 개선하는 법 기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. AI · 머신러닝 · SALD: Self-Referenced Advantage Learning for Diffusion Models
Key Point 확산 모델의 학습을 더 효율적으로 만들 수 있는 새로운 기법으로, 추가 모델이나 파라미터 없이 모델 자신의 내부 신호만으로 성능을 개선할 수 있다는 점이 의미 있다.
핵심 요약
기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. SALD는 같은 모델으로 각 이미지-캡션 쌍을 두 가지 노이즈 수준에서 평가하는 자체 참조 학습 프레임워크다. 낮은 노이즈 경로는 그래디언트 추적 없이 평가되어 참조값을 제공하고, 높은 노이즈 경로는 학습 그래디언트를 생성한다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 014 06:11 ▲ 14 · 댓글 2 픽셀 공간 확산 모델, 잠재 공간 모델과 동등한 성능 보여 픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. AI · 머신러닝 · Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
Key Point 픽셀 공간 확산 모델이 세밀한 디테일 작업에서 잠재 공간 모델을 이길 것이라는 기대와 달리 실제로는 동등한 성능만 낸 이유를 알 수 있고, 픽셀 공간 사전학습의 한계와 가능성을 실증적으로 보여준다.
핵심 요약
픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. 3B 매개변수 규모의 Iris-3B 픽셀 공간 텍스트-이미지 트랜스포머를 256→512→1024 커리큘럼으로 처음부터 학습했고, 또한 FLUX.2 Klein 4B 잠재 모델을 픽셀 공간으로 변환했다. 두 모델 모두 단안 깊이 추정과 이미지 복원/초해상화 작업에 미세조정했으나, 픽셀 공간 생성 사전에서 의미 있는 성능 향상을 발견하지 못했다. 전체 요약 6문장 읽기 → 015 03:11 ▲ 100 · 댓글 97 프로그래밍은 예술이고, AI로 대체하면 안 된다 작가와 아티스트들은 생성AI에 반대하며 집단 행동하고 있지만, 많은 프로그래머들은 AI를 사용해도 괜찮다고 생각하는 유일한 집단이다. AI · 머신러닝 · Programming Isn't Special
Key Point 다른 창작 산업은 생성AI에 집단 저항하고 있지만, 프로그래머만 사용을 정당화하는 상황에서, 코딩도 예술이라는 근본적 논의가 필요하다.
핵심 요약
작가와 아티스트들은 생성AI에 반대하며 집단 행동하고 있지만, 많은 프로그래머들은 AI를 사용해도 괜찮다고 생각하는 유일한 집단이다. 프로그래밍이 기능적이라는 이유로 예술이 아니라고 보는 견해는 잘못된 것이다. 이는 일반 대중이 미술, 음악, 영화에 대해 갖는 '신비화(mystification)' 현상이다. 실제로 대부분의 예술 작품도 기능적 목적으로 만들어진다. 초상화, 신문 기사, 카피라이팅 등 '평범한' 창작물도 모두 예술이다. 전체 요약 10문장 읽기 → 016 18:30 ▲ 26 · 댓글 1 생성 이미지 품질 평가, 이제 결함 위치까지 지적한다 기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. AI · 머신러닝 · VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
Key Point AI로 생성한 이미지의 문제점을 정확히 지적할 수 있게 되면서, 이미지 생성 모델 개선과 품질 검증 프로세스의 자동화 방식이 크게 바뀔 가능성이 높다.
핵심 요약
기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. VIEScore2는 이미지 생성·편집 작업을 평가하면서 이미지를 N×N 그리드로 표현해 품질 점수와 결함 위치를 동시에 예측한다. 텍스트 기반 그리드 표현으로 다양한 형태의 학습 데이터(점수만 있는 데이터, 위치만 있는 데이터, 둘 다 있는 데이터)를 통합 학습할 수 있다. 전체 요약 7문장 읽기 → 017 18:35 ▲ 117 · 댓글 3 Kandinsky 6.0 Video, 텍스트로 음성 동기화 영상 생성 Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. AI · 머신러닝 · Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
Key Point 음성과 영상이 완벽하게 동기화된 멀티모달 생성 기술이 오픈소스로 공개되어 영상 제작 자동화와 멀티미디어 연구를 가속할 수 있게 되었습니다.
핵심 요약
Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. 경량 버전(3B 파라미터)과 고성능 버전(29B 파라미터) 두 종류로, 5초 영상과 44 kHz 음성을 립싱크 포함해 생성. 텍스트-오디오-비디오(T2AV)와 이미지-오디오-비디오(I2AV) 모드 지원하며, 내장 초해상화로 1920×1080 풀HD 출력 가능. 전체 요약 8문장 읽기 → 018 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 019 06:11 ▲ 156 · 댓글 53 AI가 직접 코드로 쓰는 유화 풍경화, 75점 공개 Claude Opus 5.5, GPT-6.1 Sol, Gemini 등 여러 AI 모델이 유화 물감 시뮬레이션에 코드를 작성해 그림을 그린 프로젝트로, 이미지 생성 모델 없이 순수 프로그래밍으로 유화 효과를 구현했다. AI · 머신러닝 · Show HN: Giving Opus 5.5 a simulated paint canvas
Key Point AI가 이미지 생성이 아닌 코드 기반 시뮬레이션으로 전통 회화 기법을 구현하는 방식의 혁신성과, 여러 모델의 창의적 선택과 버그·보안 문제가 실제 데이터로 드러난 흥미로운 실험이다.
핵심 요약
Claude Opus 5.5, GPT-6.1 Sol, Gemini 등 여러 AI 모델이 유화 물감 시뮬레이션에 코드를 작성해 그림을 그린 프로젝트로, 이미지 생성 모델 없이 순수 프로그래밍으로 유화 효과를 구현했다. 각 모델은 '가상 이젤'이라는 인터페이스를 통해 붓질, 물감 건조, 유약 레이어링 등을 코드로 제어하며, 75점 중 46점은 세션 중 여러 번 멈추고 그림을 보며 그렸다. 대부분은 카스파르 다비드 프리드리히 작품을 모사했는데, 실제 그림을 본 적 없이 텍스트 연구만으로 그려냈고, 일부는 자유 주제로 작업했다. 전체 요약 7문장 읽기 → 020 03:11 ▲ 37 · 댓글 2 건축 평면도에 자동으로 가구 배치하는 AI 모델 등장 부동산 시각화·인테리어 설계·건축 업무에 필요한 가구 배치를 자동화하는 문제를 풀었다. AI · 머신러닝 · Architect-Ant: Editable Automatic Furnishing of Architectural Floor Plans
Key Point 건축·부동산 시각화 전문가가 수동으로 해온 가구 배치 작업을 AI가 전문성을 갖춰 자동화하면서, 실제 프로젝트에 바로 쓸 수 있는 수준에 도달했기 때문이다.
핵심 요약
부동산 시각화·인테리어 설계·건축 업무에 필요한 가구 배치를 자동화하는 문제를 풀었다. 실제 건축 전문가의 평면도를 학습한 사전학습 모델로, 반복 추론 비용 없이 제약을 고려한 배치를 생성한다. 505개 전문가 평면도에서 92개 가구 유형·10개 주거 공간 유형의 밀집 주석 데이터셋 AntPlan을 구축했다. 전체 요약 7문장 읽기 → 021 09:11 ▲ 139 · 댓글 108 생성 AI가 웹 개발 교육의 생태계를 무너뜨리고 있다 웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. AI · 머신러닝 · The death of web development education
Key Point 생성 AI 기업들이 수백만 명의 교육자 콘텐츠를 무단 학습하면서 그들의 경제적 기반을 완전히 제거했고, 이는 웹 개발의 다음 세대를 양성할 교육 인프라 전체를 위협하고 있다.
핵심 요약
웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. TypeScript 전문가 Axel Rauschmayer는 2024년 책 판매로 생계를 유지했으나 2026년 수입이 0이 되었고, 블로그 트래픽 대부분이 AI 크롤러에서 나와 광고 수익이 없어져 블로그를 내렸다. 개발자 관계(DevRel) 경력자 Salma Alam-Naylor는 AI가 개발자 커뮤니티를 파괴했다고 지적하며, 개발자들이 인간의 협업 대신 챗봇에 의존하게 되고 교육자의 콘텐츠가 AI에 의해 무단으로 학습되고 재사용된다고 했다. 전체 요약 9문장 읽기 → 022 06:11 ▲ 10 · 댓글 3 동영상의 마지막 장면을 지정해서 만드는 영상생성 AI 이미지에서 동영상을 생성할 때 카메라 움직임뿐 아니라 미래 장면의 배치(Layout)를 제어할 수 있는 LIFT 프레임워크를 제시했다. AI · 머신러닝 · LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation
Key Point 텍스트와 카메라 제어만으로는 불가능했던 '마지막 장면 모습 지정'이라는 실용적 수요를 해결한 새로운 방식으로, 동영상 생성의 사용자 제어 범위를 크게 확장한다.
핵심 요약
이미지에서 동영상을 생성할 때 카메라 움직임뿐 아니라 미래 장면의 배치(Layout)를 제어할 수 있는 LIFT 프레임워크를 제시했다. 기존 카메라 제어는 시점 궤적만 지정하고 텍스트 프롬프트는 개략적인 의미만 제공해서, 미래 프레임의 구체적인 내용과 공간 배치를 결정할 수 없다는 한계가 있다. 특히 카메라가 초기 이미지에서 보이지 않는 영역을 드러내는 대규모 시점 변화 상황에서는 이 문제가 심각해진다. 전체 요약 7문장 읽기 → 023 15:11 ▲ 84 · 댓글 1 이미지 생성 AI를 판단하는 새로운 기준, 생각하는 리워드 모델 이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. AI · 머신러닝 · Think Before You Score: Thinking Reward Model for Visual Generation
Key Point 이미지 생성 AI의 자동 평가 방식을 근본적으로 바꾸고, 이를 통해 생성 모델 최적화를 더 효과적으로 할 수 있다는 점이 중요합니다.
핵심 요약
이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. 제안하는 TRM(Thinking Reward Model)은 각 상황에 맞춘 평가 기준을 먼저 명시적으로 결정한 후 생성 결과를 판단하는 방식으로 작동합니다. 경우별로 적응형 평가 기준을 만들고, 기준에 맞춰 세부 평가를 수행한 뒤 미세한 정도의 점수를 산출합니다. 전체 요약 6문장 읽기 → 024 21:11 ▲ 15 · 댓글 1 비디오 세계 모델에 실시간 편집 기능 추가한 EditWorld EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. AI · 머신러닝 · Precise Editing and Flexible Referencing for Interactable Worlds
Key Point video world model이 탐색에서 한 단계 나아가 사용자가 생성된 세계를 직접 편집하고 조작할 수 있는 수준에 도달했으며, 실시간 스트리밍 방식의 편집 지원이 새로운 접근 방식을 제시한다.
핵심 요약
EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. 기존 video world model은 주로 탐색에만 초점을 맞췄으나, EditWorld는 생성 과정 중 편집 지시사항과 참조 이미지를 스트리밍 방식으로 받아 기존 콘텐츠의 정확한 수정을 가능하게 한다. 시간에 따라 변하는 편집 조건과 참조 이미지를 처리하기 위해 Gated Causal Attention 메커니즘을 도입했고, 장시간 추론 시 컨텍스트 크기를 제한하는 Sparse Context 메커니즘을 함께 적용했다. 전체 요약 6문장 읽기 → 025 16:18 ▲ 32 · 댓글 2 영상 생성 모델 평가용 대규모 벤치마크 'OmniVBench' 공개 참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. AI · 머신러닝 · OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
Key Point 참조 기반 영상 생성의 평가 기준과 학습 자료가 부족한 상황에서, 34만 개 규모의 산업 수준 데이터셋과 체계적 벤치마크를 제공해 R2V 모델 개발의 표준을 제시한다.
핵심 요약
참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. 콘텐츠, 모션, 스타일, 구조, 내러티브 등 7개 태스크 패밀리와 18개 세부 과제를 포함하며, 기존 벤치마크보다 다양한 참조 유형과 조합을 다룬다. 12,172개의 체크리스트 항목으로 구성된 '요소 기반 평가'를 도입해 참조 요소의 보존, 분리, 실현 여부를 세밀하게 검증한다. 전체 요약 5문장 읽기 → 026 00:10 ▲ 195 · 댓글 219 생성AI, 오픈소스 커뮤니티의 40년 합의 무너뜨리다 LLM이 저작권과 라이선스를 무시하고 인터넷의 모든 콘텐츠를 수집하면서 오픈소스 운동의 기반이 흔들리고 있다. AI · 머신러닝 · AI and the Destruction of the Creative Commons
Key Point AI 기반의 대규모 콘텐츠 수집이 40년간 구축해온 오픈소스 생태계의 법적·윤리적 기반을 무너뜨리고 있으며, 개발자들의 공유 인센티브 상실로 이어질 위험을 진단한다.
핵심 요약
LLM이 저작권과 라이선스를 무시하고 인터넷의 모든 콘텐츠를 수집하면서 오픈소스 운동의 기반이 흔들리고 있다. 기존의 GPL, CC-SA 같은 라이선스는 법적 효력이 있었지만, AI 학습 데이터로 흡수된 창작물은 원작자의 라이선스 의도가 존중되지 않고 있다. 개발자들이 코드 공개로 인한 부작용—AI를 이용한 보안 취약점 발견, 스팸 PR 봇 범람, 타인의 도용된 코드 포함 리스크—을 우려하면서 지식 공유가 이제 저자에게 책임이 되고 있다. 전체 요약 5문장 읽기 → 027 18:10 ▲ 106 · 댓글 18 오픈소스 AI와 공개 모델의 모든 것을 배우는 읽기 목록 최근 수년간 오픈 모델의 전략, 위험, 경제적 영향을 다룬 핵심 글과 논문들을 엄선한 종합 읽기 목록이다. AI · 머신러닝 · Open-source AI and open models reading list
Key Point 오픈소스 AI의 경제, 안전, 지정학적 중요성을 한눈에 파악할 수 있는 신뢰성 높은 자료 모음으로, 정책과 기술 양쪽을 다루는 의사결정자에게 필수다.
핵심 요약
최근 수년간 오픈 모델의 전략, 위험, 경제적 영향을 다룬 핵심 글과 논문들을 엄선한 종합 읽기 목록이다. 메타의 라마 공개 전략, 오픈-클로즈드 모델의 연속체적 이해, 안전성 문제 등 오픈 모델 기초부터 정책까지 다룬다. 한국, 중국 모델의 부상과 성능 경쟁, 미국의 개방형 AI 전략 필요성, 규제 정책의 방향성이 포함되어 있다. 전체 요약 5문장 읽기 →