001 06:11 ▲ 127 · 댓글 31 구글의 멀티에이전트 AI, 수십 년 묵은 수학 문제를 증명하다 구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. AI · 머신러닝 · Advancing science and engineering with Antigravity's /teamwork
Key Point 구글이 멀티에이전트 AI로 정보이론, 양자 알고리즘, 형식 수학 등 수십 년 묵은 미해결 문제들을 순차적으로 증명·발견했으며, 이 도구를 모든 연구자에게 공개하면서 AI-인간 협업 연구의 새로운 패러다임을 제시했다.
핵심 요약
구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. Gemini 4 Argon, Carbon, Hydrogen 모델과 /teamwork을 함께 사용해 정보이론, 형식 검증, 분자 구조 발견, 커널 최적화 등에서 혁신을 이뤘다. /teamwork의 설계는 언어 모델의 두 가지 한계를 해결한다: 첫째 병렬 탐색과 검증자(Lean 4 증명 체커, 테스트 스위트 등)를 짝지어 생성의 불확실성을 극복하고, 둘째 각 에이전트에 필요한 도구와 파일만 전달해 장기 작업에서 맥락 손실을 방지한다. 전체 요약 14문장 읽기 → 003 21:11 당일 +331 AI 코딩 에이전트를 위한 로컬 영상 편집기 FFmpeg-Skill 공개 Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. AI · 머신러닝 · kajisho5/ffmpeg-skill · Python
Key Point 클라우드나 API 키 없이 로컬에서 실행되며 에이전트가 정확하게 영상 편집을 수행할 수 있도록 설계된 도구라, AI 코딩 에이전트의 멀티모달 기능 확대와 오프라인 작업 흐름에 영향을 미친다.
핵심 요약
Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. 42개의 FFmpeg 도구를 제공하며, 클라우드나 API 키 없이 Python 표준 라이브러리만으로 동작한다. 각 도구는 명확한 입력 스키마를 가진 argparse 기반 스크립트로, 쉘 명령어 대신 타입이 지정된 인자로 작동한다. 전체 요약 13문장 읽기 → 004 21:11 ▲ 13 · 댓글 3 하이브리드 어텐션으로 텍스트-이미지 동시 이해·생성하는 유니스파크 UniSpark-9B는 시각 이해와 생성을 위해 하이브리드 어텐션을 조사하는 통합 멀티모달 모델이다. AI · 머신러닝 · UniSpark: Exploring Hybrid Attention for Multimodal Understanding and Generation
Key Point 텍스트 생성과 이미지 생성을 동시에 처리하는 통합 모델의 새로운 아키텍처 접근법으로, 다양한 멀티모달 작업에서 하이브리드 어텐션의 효과를 검증한다.
핵심 요약
UniSpark-9B는 시각 이해와 생성을 위해 하이브리드 어텐션을 조사하는 통합 멀티모달 모델이다. 각 브랜치에 약 9B 파라미터를 가진 Mixture-of-Transformer-Experts 백본을 기반으로 하며, 명시적 토큰 상호작용을 위한 전체 어텐션과 컨텍스트 전파를 위한 GatedDeltaNet 선형 어텐션을 결합한다. 자동회귀 텍스트 예측과 시각 흐름 매칭이 시각 질문 응답, 텍스트-이미지 생성, 지시 기반 편집, 인터리브 텍스트-이미지 예측을 지원한다. 전체 요약 8문장 읽기 → 005 21:11 ▲ 132 · 댓글 79 Brave 검색 API, x402 프로토콜로 에이전트 마이크로페이먼트 지원 Brave Search API가 오픈 x402 결제 프로토콜을 통해 즉시 종량제 에이전트 결제를 지원하기 시작했다. AI · 머신러닝 · Brave Search API now accepts agentic payments via the x402 protocol
Key Point AI 에이전트가 API 키 대신 블록체인 기반 마이크로페이먼트로 검색 서비스를 즉시 이용할 수 있게 되어, 자율 AI 시스템의 결제 자동화와 임계점 없는 사용이 가능해진다.
핵심 요약
Brave Search API가 오픈 x402 결제 프로토콜을 통해 즉시 종량제 에이전트 결제를 지원하기 시작했다. 개발자와 자율 AI 에이전트는 API 키 관리 없이 Brave의 독립 검색 인덱스를 프로그래밍 방식으로 쿼리할 수 있고, 실시간으로 요청을 결제한다. Brave는 Base 블록체인에서 USDC를 받는 퍼실리테이터로 운영되며, 다른 네트워크와 스테이블코인 지원도 곧 추가될 예정이다. 전체 요약 6문장 읽기 → 006 18:11 ▲ 16 · 댓글 4 코드가 세상을 짜면, 영상 모델은 렌더링만 하는 게 될까? 멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. AI · 머신러닝 · WorldDraft: If Code Builds the World, Can Video Models Just Render It?
Key Point 코드 기반 3D 월드와 AI 영상 생성의 분업 구조에서 영상 모델의 한계와 개선 방법을 체계적으로 실측했기 때문에, 멀티모달 AI 시스템 설계자들이 알아야 할 핵심 발견이다.
핵심 요약
멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. 신뢰할 수 있는 생성 렌더러에 필요한 두 가지 기준을 정의한다: (i) 월드 보존 - 지정된 4D 운동과 카메라 경로 유지, (ii) 시각 실현 - 텍스트로 지정된 속성을 시간에 따라 일관되게 유지. WorldDraft 벤치마크를 제안하는데, 6개 동적 카테고리에 걸친 48개 실행 가능한 4D 월드 패밀리에서 432개의 엄격하게 쌍을 이룬 테스트 케이스로 구성된다. 전체 요약 9문장 읽기 → 007 15:11 ▲ 51 · 댓글 3 운전 시뮬레이션의 정확성을 높이는 BirdDreams 논문 자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. AI · 머신러닝 · BirdDreams: Joint Perspective and BEV Video Generation for a Plausible, Reactive Driving World Model
Key Point 자율주행 시뮬레이션에서 현실적인 장면 재구성은 필수이며, 정적 레이아웃 대신 미래 배치를 예측하는 이 접근법은 자동차의 정확한 제어와 주변 객체의 자연스러운 운동 생성을 동시에 달성하는 새로운 방식이다.
핵심 요약
자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. BirdDreams는 1인칭 시점 영상과 조감도(BEV) 영상을 함께 생성하는 자동회귀 모델로, 미래 장면의 레이아웃을 예측의 일부로 만든다. BEV는 도로와 차량을 간단한 형태로 일정 스케일로 표시해 위에서 본 위치와 동작을 명확히 보여주고, 정적 시점은 신호등과 물체 외형 같은 세부 정보를 담는다. 전체 요약 8문장 읽기 → 008 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 009 15:11 ▲ 171 · 댓글 40 개인 컴퓨터에서 돌리는 1450억 파라미터 모델 Edge0-145B 공개 Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. AI · 머신러닝 · Edge0-145B: Frontier AI Capabilities on Your Own Computer
Key Point 개인 컴퓨터에서 클라우드 모델 수준의 복잡한 작업(코딩, 3D 모델링, 비디오 제작)을 요금 없이 수행 가능해지면서, 온디바이스 AI의 실용성이 크게 높아졌다.
핵심 요약
Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. 호환 가능한 노트북에서 피크 메모리 29GB, 토큰 생성 속도 80+tokens/s로 동작하며 기존 대규모 모델 대비 약 40% 메모리로 동등한 성능을 낸다. Edge0-145B는 DeepSWE 1.1에서 64.6점(Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4), Terminal-Bench 2.1에서 86.52점(Qwen 83.3, DeepSeek 82.7)으로 코딩·추론·명령 이행 능력이 클라우드 모델 수준이다. 전체 요약 11문장 읽기 → 010 03:11 ▲ 108 · 댓글 36 리눅스용 오픈소스 핀볼 시뮬레이션 엔진 개발 중 개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 오픈소스 · 도구 · I'm Working on a FOSS Linux Pinbal Simulation Engine
Key Point Linux와 오픈소스 커뮤니티에서 아직 부족한 핀볼 시뮬레이션 게임을 처음부터 만드는 프로젝트로, 게임 개발자와 Linux 애호가들에게 새로운 기여 기회를 제공한다.
핵심 요약
개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 새로운 사운드 시스템은 각 부품별로 음성을 쉽게 추가할 수 있고, 볼 구르는 소리와 슬링샷음 등 물리 기반 음향 감쇄를 지원한다. 물리 엔진을 대폭 개선했으며, 반복 시뮬레이션을 통해 현실감 있는 설정값을 찾아가는 중이다. 전체 요약 10문장 읽기 → 011 21:11 ▲ 116 · 댓글 26 화웨이, 로컬 추론용 양자화 도구 MACaQ 공개 화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. AI · 머신러닝 · Huawei releases MACaQ, its internal quantizer for local inference
Key Point 로컬 환경에서 대규모 모델을 빠르게 양자화하려는 개발자들에게 성능과 속도 모두 우수한 새로운 도구가 공개되어, 리소스 제한적인 환경에서의 모델 배포 선택지가 확대되었다.
핵심 요약
화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. 122B 파라미터 모델을 64분 내에 32.5GB 메모리만으로 양자화할 수 있으며, MR-GPTQ와 DuQuant++보다 더 낮은 퍼플렉시티를 달성하거나 Llama-3-8B에서 11배 빠른 양자화 시간으로 동등한 성능을 제공한다. llama.cpp 백엔드는 2/3/4비트 GGUF 포맷의 텍스트 생성을 지원하고 CPU 실행도 가능하며, vLLM은 W4A4 또는 가중치 전용 양자화로 텍스트 생성 및 서빙을 지원한다. 전체 요약 8문장 읽기 → 012 12:10 ▲ 11 · 댓글 5 텍스트-비디오 생성 모델의 물리법칙 이해도를 측정하는 평가 프레임워크 등장 텍스트-비디오(T2V) 생성 모델이 세계 시뮬레이터로 자리잡으면서 물리 상식 준수 여부 평가가 필수적이 되었다. AI · 머신러닝 · PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation
Key Point 텍스트-비디오 생성 모델의 물리법칙 준수 여부를 객관적이고 진단적으로 평가할 수 있는 표준화된 방법론이 제시되어, 향후 이 분야 벤치마킹과 개선의 기준점이 될 것으로 예상된다.
핵심 요약
텍스트-비디오(T2V) 생성 모델이 세계 시뮬레이터로 자리잡으면서 물리 상식 준수 여부 평가가 필수적이 되었다. 기존 벤치마크는 평가자의 직관에 의존한 단일 점수 방식으로, 주관적이며 어느 물리 원리 위반인지 파악할 수 없다. PhyRubric은 텍스트-비디오 생성의 물리 상식을 진단하는 루브릭 기반 평가 프레임워크다. 전체 요약 8문장 읽기 → 013 09:11 ▲ 224 · 댓글 74 구글, 의사결정 전문 AI API 공개…150ms 내 1000개 질문 처리 구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. AI · 머신러닝 · Gemini Decisions API
Key Point 의사결정에 특화된 저지연 API가 등장하며 AI 애플리케이션의 라우팅·검증·분류 작업 방식이 바뀌고, 기존 대비 5배 저렴한 가격과 3가지 질문 유형 지원으로 구현 복잡도를 크게 낮춘다.
핵심 요약
구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. 토큰별 생성이 아닌 단일 포워드 패스 방식으로 동작해 중앙값 50~100ms 모델 계산 시간(엔드투엔드 150~250ms)의 저지연을 유지하며, 최대 16K 토큰 컨텍스트에서 질문 1~100개 구간에서도 거의 선형적인 성능을 보인다. 에이전트 라우팅·추론·랭킹·멀티모달 이해 벤치마크에서 Gemini Decision 1이 최고 성능을 기록했으며, 보정 오류도 가장 낮다. 전체 요약 8문장 읽기 → 014 03:11 ▲ 252 · 댓글 137 TV 제조사 17개 질문 '당신은 나를 감시하는가' 기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 보안 · I asked every TV manufacturer 17 questions about how they spy on you
Key Point TV 제조사들이 음성·시청 데이터·위치를 수집하는 방식이 제조사마다 크게 다르며, 옵트아웃 후에도 데이터 전송이 계속될 수 있어 실제 프라이버시 보호 수준을 알기 위해 참고할 필요가 있다.
핵심 요약
기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 마이크 활성화 조건: Amazon과 Samsung은 버튼 누르거나 웨이크 워드로만 작동한다고 답변했고, LG도 기본값으로 꺼져 있으며 옵트인 후 추가 조치가 필요하다고 답변했다. 음성 저장 및 전송: Amazon은 저장하지 않으며, Google은 '음성 및 오디오 활동'이 명시적으로 켜진 경우만 저장한다고 답변했고, LG는 로컬 처리 후 삭제한다고 답변했다. 전체 요약 12문장 읽기 → 015 18:11 ▲ 23 · 댓글 5 비디오·행동을 함께 학습하는 세계 모델 SWAM 공개 언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. AI · 머신러닝 · SWAM: Scaling World Action Models with Cross-Modal Alignment
Key Point 로봇 제어를 위한 세계 모델의 언어-비디오 정렬 유지 전략이 명확해져, 동작 학습 시 기존 이해 능력을 보존하면서 행동 능력까지 확장하려는 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. 약 47,000시간의 일반 비디오, 1인칭 시점 비디오, UMI 데모, 로봇 데모를 수집하여 데이터 풀을 구성했다. 언어-비디오 감시, 언어-비디오-행동 감시, 두 형태를 결합한 학습이 세계 행동 모델(WAM) 성능에 어떻게 영향 미치는지 체계적으로 분석했다. 전체 요약 9문장 읽기 → 016 15:11 ▲ 88 · 댓글 2 스트리밍 영상 생성의 빠른 처리, 조건 시프팅으로 구현 스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 AI · 머신러닝 · Few-Step Streaming Video Generation via Condition Shifting
Key Point 빠르고 효율적인 스트리밍 영상 생성이 실시간 애플리케이션의 핵심인데, 조건 시프팅이라는 새로운 방식으로 계산 비용을 줄이면서도 생성 품질을 높이는 길을 보여줍니다.
핵심 요약
스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 기존 DMD는 별도 가짜 판별망으로 메모리와 연산 비용이 크고 생성기 추적이 필요함 조건 시프팅 기법으로 생성 분포의 속도장을 생성기 내부에서 직접 추정해 독립 판별망 제거 전체 요약 9문장 읽기 → 017 15:11 ▲ 100 · 댓글 81 저장소 위기 시대, AVIF 확산이 답인가 2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 웹 · 프론트엔드 · Time for AVIF everywhere?
Key Point 2026년 저장소 가격 폭등과 공급 부족이 심화하는 가운데, AVIF 같은 효율적 이미지 포맷의 광범위한 채택이 호스팅 비용과 대역폭을 실질적으로 줄일 수 있는 방법이라는 주장이 제시되고 있다.
핵심 요약
2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 저자는 Mastodon, Bluesky 등 서비스와 호스팅 제공자가 AVIF, WebP 같은 효율적인 이미지 포맷과 AV1, AV2 같은 비디오 포맷을 더 널리 지원해야 한다고 주장한다. AVIF는 WebP보다 우수한 압축률을 제공하면서도 이미지 품질을 유지하므로, 인터넷에서 매일 업로드되는 수십억 장의 이미지를 고려하면 저장 공간 절감이 상당할 수 있다. 전체 요약 14문장 읽기 → 018 03:11 ▲ 231 · 댓글 32 Blender 5.3, 가우시안 스플래팅 네이티브 지원 추가 Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. AI · 머신러닝 · Blender 5.3 released with Gaussian Splat support
Key Point 사진·영상에서 3D 장면을 재구성하는 가우시안 스플래팅이 3D 제작 파이프라인에 표준으로 통합되면서 Blender 사용자들이 AI 생성 모델이나 포토그래메트리 결과물을 직접 작업할 수 있게 된다.
핵심 요약
Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. PLY, SPZ, glTF 파일에서 가우시안 스플래팅을 포인트 클라우드로 임포트한 후 Geometry Nodes로 처리하고, EEVEE, Cycles, Workbench에서 렌더링할 수 있다. 스플래팅은 scale, rotation, radiance 등의 특수 속성으로 저장되며, 기본적으로 이미시브 셰이더로 렌더링되지만 Diffuse BSDF로 교체해 릿팅 처리도 가능하다. 전체 요약 12문장 읽기 → 019 21:11 당일 +170 AI로 게임을 만드는 원맨 스튜디오, OhMyGame 오픈소스 공개 OhMyGame은 AI 에이전트가 게임 제작의 전 과정을 주도하는 오픈소스 게임 개발 플랫폼이다. AI · 머신러닝 · WhiteTowerAI/ohmygame · TypeScript
Key Point 게임 개발의 진입장벽을 AI와 통합 도구로 낮추는 새로운 접근법이며, 개인 개발자도 한 명의 스튜디오처럼 완전한 게임을 만들고 멀티플랫폼으로 배포·수익화할 수 있게 한다.
핵심 요약
OhMyGame은 AI 에이전트가 게임 제작의 전 과정을 주도하는 오픈소스 게임 개발 플랫폼이다. 사용자가 게임 아이디어를 설명하면 에이전트가 설계 문서를 작성하고, 2D·3D 아트, 비디오, 코드를 생성하며, 게임을 빌드하고 직접 플레이하며 검증한다. 캔버스 기반 UI에서 설계 문서, 개념 아트, 3D 모델, 비디오가 한 보드 위에 함께 놓여 있고, 각 요소가 서로 참조될 수 있다. 전체 요약 12문장 읽기 → 020 21:11 ▲ 39 · 댓글 3 시각 에이전트가 도구 결과를 제대로 쓰도록 학습시키는 방법 시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. AI · 머신러닝 · Reframe: Observation-Aligned Multi-Teacher On-Policy Distillation for Agentic Visual Reasoning
Key Point 시각 에이전트의 도구 사용이 불완전해 학습이 비효율적이던 문제를 해결하는 체계적 접근법으로, 다중 교사 증류학습 분야의 실질적 개선책을 제시한다.
핵심 요약
시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. Reframe은 두 단계의 학습 프레임워크로, 먼저 Ground-Drop-GRPO(GD-GRPO)가 증거 기반 보상과 원본 시각 입력의 확률적 제거를 통해 공간·시간 전문가를 훈련해 근거 있는 증거를 얻고 도구 반환 관찰을 활용하게 한다. 두 번째 단계 Observation-Gated-MOPD(OG-MOPD)는 롤아웃 중 결함 있는 도구 행동을 정준(canonical) 행동으로 교체하고 수정된 관찰에서 증류학습을 재개해 학습 안정성을 높인다. 전체 요약 6문장 읽기 → 021 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 022 06:11 ▲ 162 · 댓글 66 메타, 에이전트 작업용 경량 모델 뮤즈 엠버 공개 메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. AI · 머신러닝 · Our Smallest, Most Efficient Model: Muse Ember
Key Point 에이전트 AI가 상용화되면서 도구 호출과 반복 작업에 최적화된 경량 모델의 필요성이 높아졌는데, 뮤즈 엠버는 기존 모델보다 훨씬 저렴한 비용으로 더 나은 성능을 제시해 생산 AI 시스템의 비용 구조를 바꿀 가능성을 보여준다.
핵심 요약
메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. 뮤즈 엠버는 Claude Haiku 5.5보다 약 3분의 1 비용으로 동일 수준의 성능을 내며, 모든 GPT-4o Luna 설정을 능가한다. 가격 대비 성능 지수에서 Artificial Analysis 전체 리더보드 효율성 경계선에 위치한다. 전체 요약 13문장 읽기 → 023 03:11 ▲ 106 · 댓글 27 결정 모델 추론 최대 9.5배 빠르게 하는 Flide 공개 OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. AI · 머신러닝 · Show HN: Flide: Make Jev-like decision models up to 9.5x faster
Key Point 결정 모델을 다루는 개발자와 AI 애플리케이션 구축자에게 기존 추론 엔진 대비 크게 향상된 성능과 다양한 모델 선택지를 제공하는 오픈소스 도구다.
핵심 요약
OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. Flide는 /v1/systemone API를 서빙하며, 모든 응답이 모델 단독으로 처리한 결과이다. 모델은 Python 3.12와 PyPI를 통해 설치할 수 있고, 명령 한 줄로 각 모델을 시작할 수 있다. 전체 요약 9문장 읽기 → 024 21:11 당일 +121 영상을 3D 가우시안 스플래팅으로 한 클릭 변환 비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 오픈소스 · 도구 · ooolabdev/ooosplat · Rust
Key Point 영상·사진 기반 3D 모델 생성을 로컬 머신에서 완전 자동화하는 오픈소스 도구로, 클라우드 의존 없이 개인정보 보호와 온프레미스 처리를 실현해 3D 콘텐츠 제작 워크플로우 변화를 가져올 수 있음.
핵심 요약
비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 입력 소재·프로젝트 폴더·품질 레벨을 선택하면 FFmpeg, COLMAP, Brush를 자동으로 실행해 최종 PLY 파일을 생성하고 바로 미리보기, 편집, 내보내기 가능. Windows 11 x64, Apple Silicon macOS 15+, Ubuntu 24.04 LTS x86_64를 지원하며, 번들된 FFmpeg·FFprobe·COLMAP·Brush를 사용해 별도 설치 불필요. 전체 요약 14문장 읽기 → 025 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 026 18:15 스타 1,277 웹에서 2.5D 캐릭터를 움직이는 경량 플레이어 공개 LivLiv Player는 웹용 2.5D 캐릭터 플레이어로, 입술 싱크와 웹캠 얼굴 추적을 지원한다. 웹 · 프론트엔드 · livliv-dev/player · TypeScript
Key Point 웹 스트림 오버레이나 앱에 AI 아바타를 임베드하려는 크리에이터와 개발자에게 무거운 라이브러리 없이 빠르게 2.5D 캐릭터를 구현할 수 있는 도구가 생겼다.
핵심 요약
LivLiv Player는 웹용 2.5D 캐릭터 플레이어로, 입술 싱크와 웹캠 얼굴 추적을 지원한다. WebGL2 기반이며 의존성 없이 압축 시 약 30KB 크기로, LivLiv·VRM·PNGTuber 캐릭터를 동일한 API로 재생한다. 입술 싱크(마이크·오디오·비디오)와 얼굴 추적(MediaPipe)은 모두 브라우저에서 동작하며, 필요할 때만 로드된다. 전체 요약 11문장 읽기 → 027 18:15 스타 1,140 AI가 코드로 영상 만든다…cinecode 오픈소스 공개 AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. AI · 머신러닝 · sarpstar/cinecode · Python
Key Point 코드 기반 영상 자동 제작으로 광고·설명영상·다큐 같은 콘텐츠를 개발자가 직접 만들 수 있게 되며, 이는 영상 제작 진입장벽을 낮추고 반복 제작 업무를 대폭 줄인다.
핵심 요약
AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. 사용자가 한 문장으로 아이디어를 입력하면 AI가 각본을 작성하고, 모든 프레임을 코드로 렌더링하고, 음향 디자인을 거쳐 MP4 파일을 제공한다. 짧은 영상·장편 다큐·광고·뮤직비디오 등 다양한 포맷을 지원하며, 빠른 모드(약 3분에 완성)와 필름 모드(단계적 검수)로 나뉜다. 전체 요약 9문장 읽기 → 028 18:15 스타 1,934 비디오 속 인물 한 번에 바꾸기, 오픈소스로 나왔다 비디오와 인물 사진을 업로드하고 생성 버튼을 누르면 영상의 주인공을 새 인물로 자동 교체하거나 헤어·옷을 바꾸거나 제거할 수 있는 오픈소스 도구 'Openjutsu' 공개 AI · 머신러닝 · D3voz/openjutsu · TypeScript
Key Point 로컬 GPU에서 돌아가는 오픈소스 비디오 인물 교체 도구로, 상용 Genjutsu 같은 수준의 기능을 무료로 제공하면서 정확한 추적과 다양한 편집 옵션으로 창작자의 선택지를 크게 넓혀줍니다.
핵심 요약
비디오와 인물 사진을 업로드하고 생성 버튼을 누르면 영상의 주인공을 새 인물로 자동 교체하거나 헤어·옷을 바꾸거나 제거할 수 있는 오픈소스 도구 'Openjutsu' 공개 MiniMax H3 영상 생성, SAM 3.1 인물 추적, Qwen3-VL 8B 이미지 설명 모두 오픈 가중치 모델을 로컬 GPU에서 실행하며, 카메라 움직임·편집·사운드는 유지 Next.js 프론트엔드와 ComfyUI 워크플로우 기반이며, FLUX.3 Klein으로 조명 재설정 가능 전체 요약 10문장 읽기 → 029 18:15 스타 1,867 한 장의 사진으로 AI 디지털 휴먼 영상 제작 한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. AI · 머신러닝 · andyhuo520/digital-human-koubo · TypeScript
Key Point Claude Code·Codex 같은 에이전트와 직접 통합되는 AI 동영상 자동화 도구로, 유튜브 톱 크리에이터의 편집 기법을 분석한 48개 컴포넌트와 견적 제어 시스템을 갖춘 프로덕션급 워크플로우가 처음 공개됐다.
핵심 요약
한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. Grok Video 1.5를 통해 최대 15초 단위 영상 클립을 생성하고, 음성은 별도 처리 후 스펙트럼 매칭으로 통일해 30개 이상의 분리된 클립이 하나의 녹음처럼 들리도록 한다. 유튜브 톱 크리에이터 25명의 영상을 프레임 단위로 분석해 추출한 48개의 패키징 컴포넌트(오프닝, 증거 카드, 주석, 리듬 효과 등)를 제공한다. 전체 요약 12문장 읽기 → 030 18:15 스타 2,588 Claude로 기계를 3D 시뮬레이터로 만들어 분해할 수 있는 도구 Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. AI · 머신러닝 · elvarofficial/teardown · JavaScript
Key Point Claude로 기계의 작동 원리를 3D 시뮬레이터로 즉시 만들 수 있는 방식이 등장해, 복잡한 엔지니어링 개념을 직관적으로 이해하고 공유하는 방법이 바뀔 수 있다.
핵심 요약
Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. 기계는 화면 중앙에 표시되고, 주변 패널에서 실시간 수치를 읽을 수 있으며, 버튼으로 작동 부품을 분해할 수 있다. 아무도 조작하지 않으면 페이지가 자동으로 기계를 둘러본다. 전체 요약 10문장 읽기 → 031 18:15 스타 3,847 비디오 제작 방식을 자동 분석하는 오픈소스 도구 'rea-video' 영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. AI · 머신러닝 · JuneYaooo/rea-video · Python
Key Point 비디오 콘텐츠 제작의 주요 성분(실사/AI/코드)을 정확히 판별할 수 있으면, 제작 기법 학습 비용을 대폭 낮추고 비슷한 스타일의 콘텐츠를 빠르게 만들 수 있다.
핵심 요약
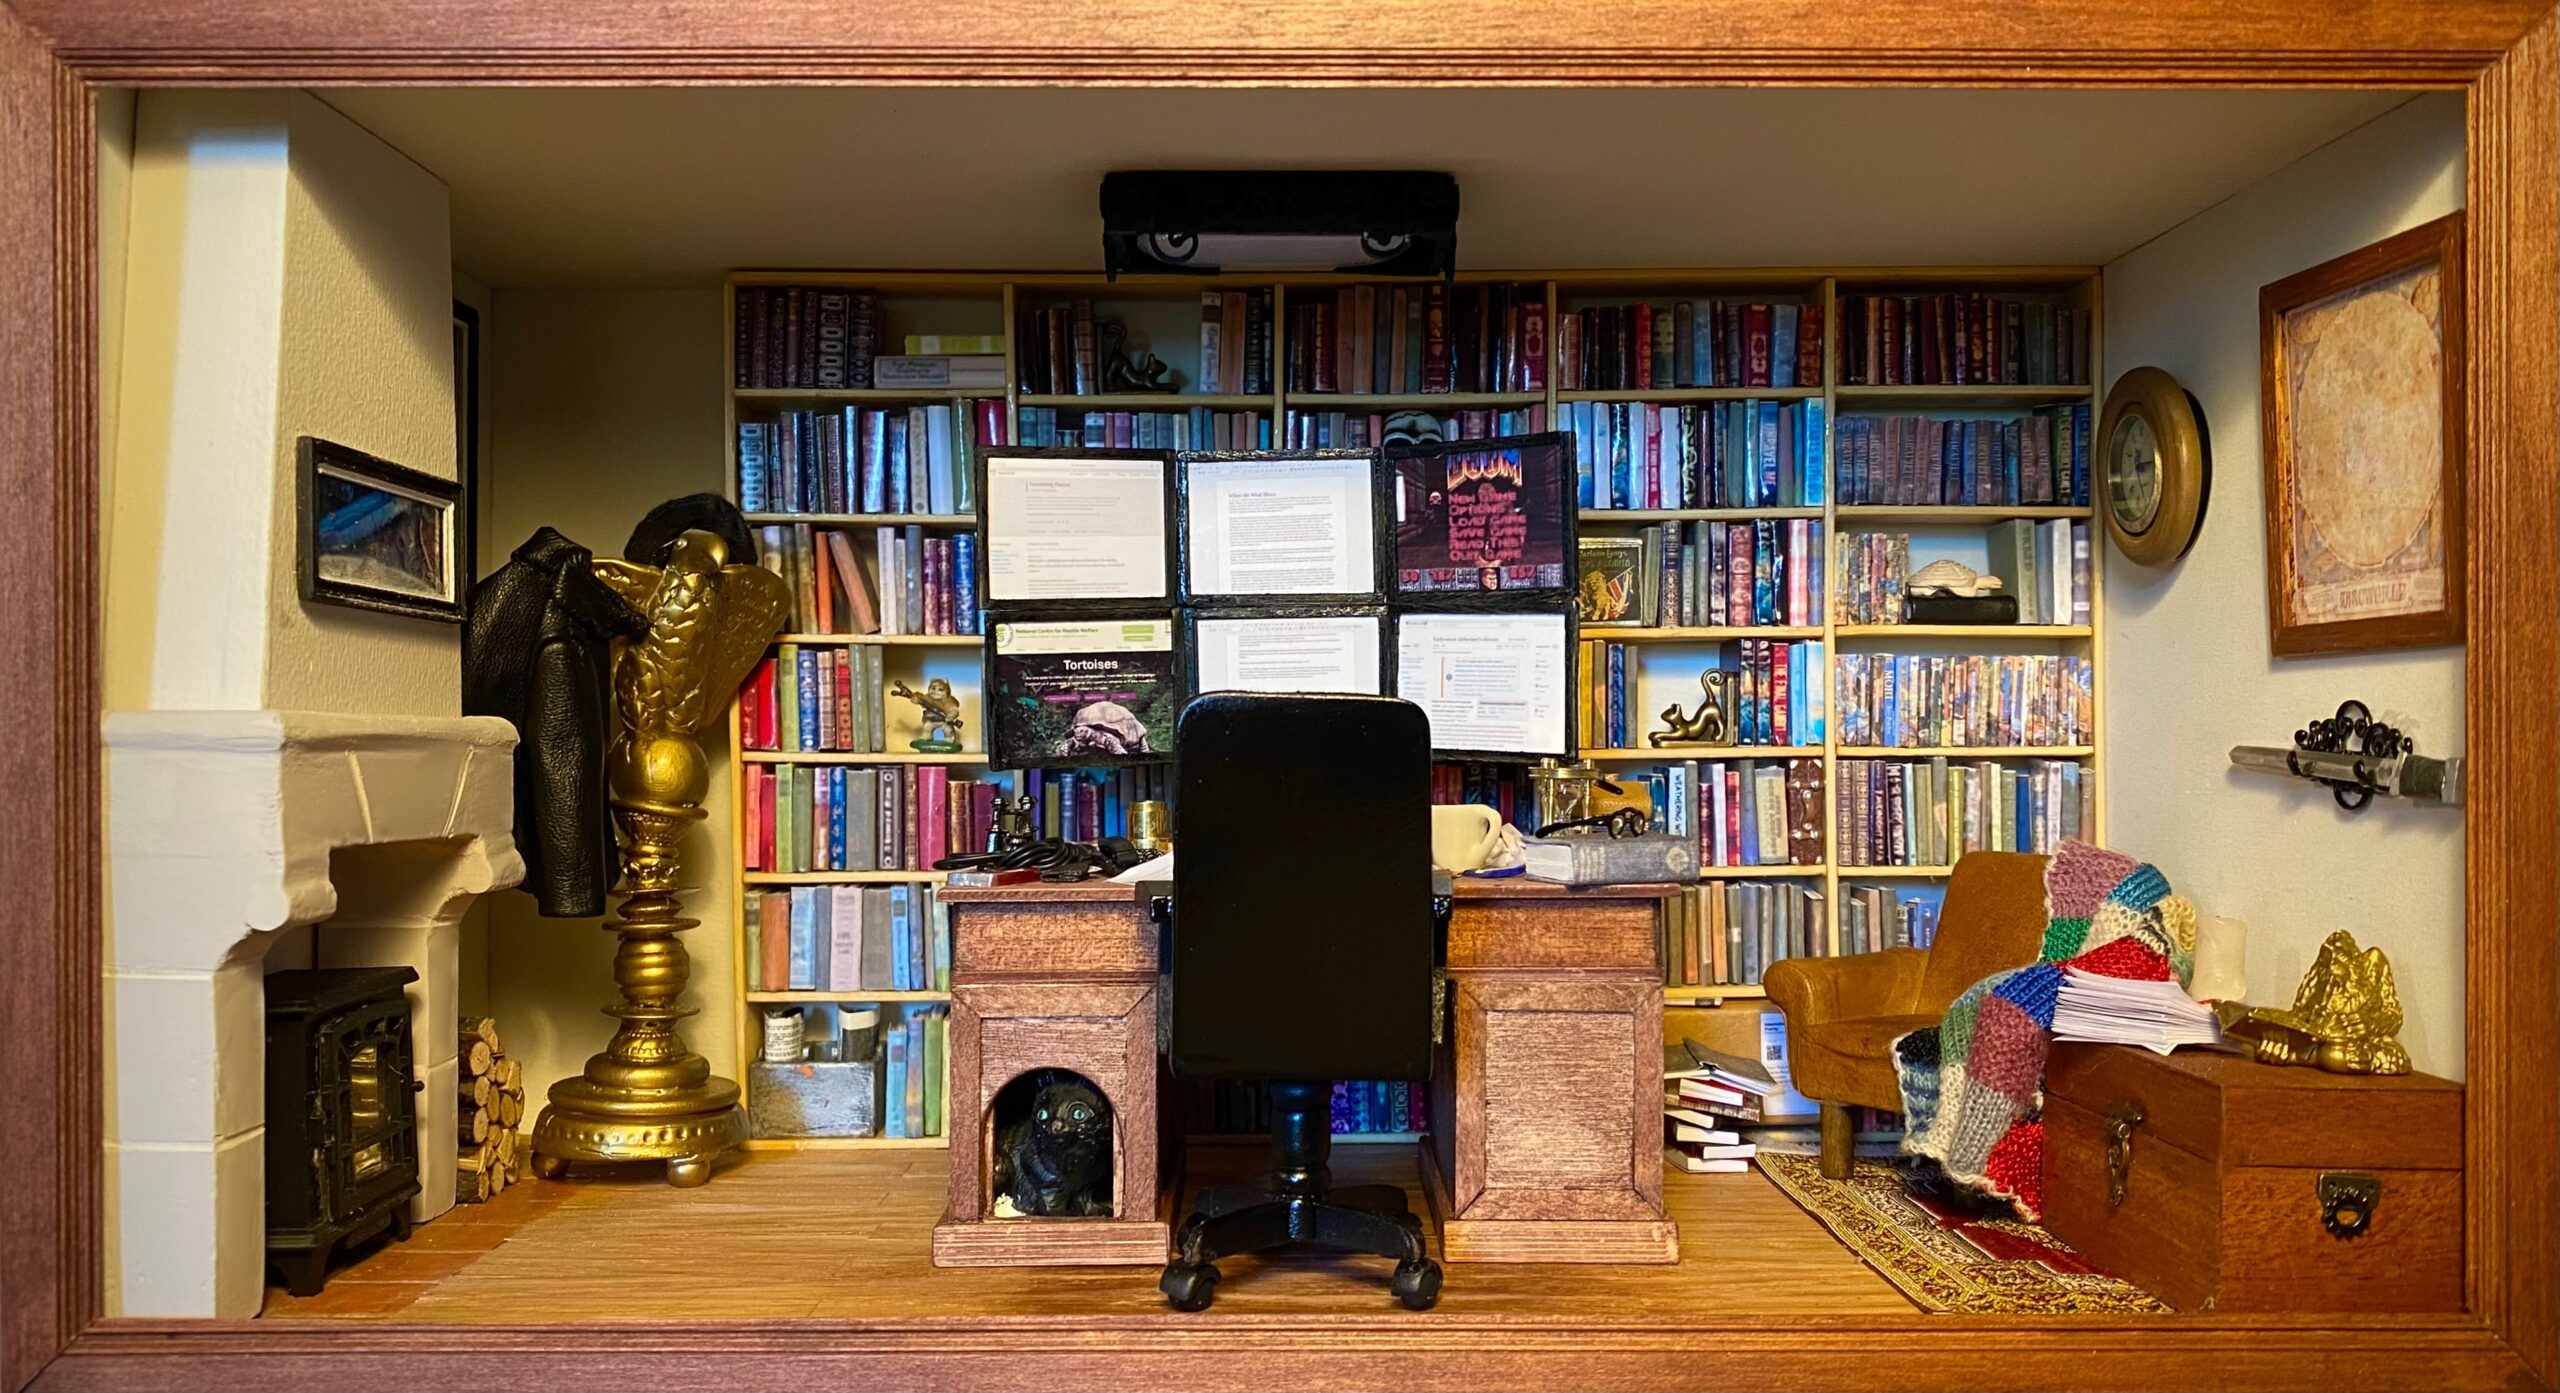
영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. 카메라 위치·조명 설정·색보정·렌즈 정보 등 촬영 기법, AI 영상의 역엔지니어링 프롬프트와 배치 전략, 3D/애니메이션의 렌더링 여부, 코드 기반 UI/타이포그래피의 타이밍, 화면 녹화 범위를 각각 구분해 보고한다. 자막·이모티콘·편집점·음성(인간/AI)·음악(BPM 포함)·효음의 위치와 지속 시간도 추출하며, SRT/ASS 자막 형식으로 내보낼 수 있다. 전체 요약 9문장 읽기 → 032 12:11 ▲ 111 · 댓글 31 테리 프래칫의 서재, 미니어처로 재현하다 덴마크 미니어처 제작자가 영국 판타지 작가 테리 프래칫의 서재를 1:12 축소 모형으로 재현했다. 기타 · Terry Pratchett's Study
Key Point 손으로 가죽 재킷을 바느질하고 원본 150쪽을 축소 인쇄해 담는 등, 거의 한두 달간의 압도적인 수공예 정성이 한 책 작가에게 쏟아진 사례로, 팬심의 극단을 보여준다.
핵심 요약
덴마크 미니어처 제작자가 영국 판타지 작가 테리 프래칫의 서재를 1:12 축소 모형으로 재현했다. 1.5개월간 제작한 이 프로젝트는 온라인에서 찾은 사진과 '더 커닝 아티피서' 버나드 피어슨의 조언을 바탕으로 완성됐다. 책장에는 모든 디스크월드 시리즈와 기타 프래칫 저작을 개별 제작한 책들로 채웠으며, 원본 표지를 모두 고증했다. 전체 요약 10문장 읽기 → 033 18:11 ▲ 156 · 댓글 102 애플 실리콘 리눅스, 오디오·비디오 드라이버 상류화 본격화 애플 실리콘용 Asahi Linux 개발팀이 macaudio 및 AVD 등 주요 드라이버를 리눅스 커널 상류(upstream)로 제출 준비를 완료했으며, 이는 약 16,100줄의 코드 작업을 포함한다. 인프라 · 데브옵스 · Asahi Linux Progress Linux 7.3
Key Point M5 칩 지원, 게임 호환성 대폭 개선, 주요 드라이버 상류화 가속화 등 Asahi Linux가 애플 실리콘 상용 운영체제 수준의 기능 완성도에 접근하고 있음을 보여준다.
핵심 요약
애플 실리콘용 Asahi Linux 개발팀이 macaudio 및 AVD 등 주요 드라이버를 리눅스 커널 상류(upstream)로 제출 준비를 완료했으며, 이는 약 16,100줄의 코드 작업을 포함한다. M4/M5 칩을 포함한 초기 기기 트리(Devicetree)를 공개했고, M3 시리즈 지원이 EXPERT 플래그 제거로 정식 출시되었으며, M3의 DCP(Display Compression Port) 활성화로 절전 모드와 노치 영역 지원이 가능해졌다. M5에 도입된 Exclaves(격리 환경에서 실행되는 작은 애플리케이션)를 m1n1에서 가상화하기 위해 EL1 아래에서 3개의 가상 머신을 동시 실행하게 되었으며, M4와 M5 모두에서 macOS 역공학을 가능하게 했다. 전체 요약 11문장 읽기 → 034 09:11 ▲ 15 · 댓글 2 가우시안 아바타의 흐릿함·왜곡을 확산 모델로 보정 단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. AI · 머신러닝 · EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
Key Point 카메라 한 대로 촬영한 비디오나 이미지로 3D 아바타를 만들 때 피할 수 없던 흐릿함과 왜곡을 AI로 자동 보정할 수 있게 되면, 메타버스와 실시간 통신 같은 응용에서 아바타 품질을 크게 높일 수 있다.
핵심 요약
단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. EDGAR는 조건부 확산 프레임워크로, 신원 정보를 유지하면서 가우시안 아바타의 결함을 고쳐주도록 설계했다. 학습을 위해 EDGAR-SET이라는 하이브리드 데이터셋을 만들었는데, 실제 촬영 샘플과 합성 렌더링 샘플을 섞어 열악한 가우시안 아바타 렌더링을 바닥 참값과 참조 이미지와 짝지었다. 전체 요약 8문장 읽기 → 035 21:12 당일 +139 React로 무한 캔버스 앱을 만드는 tldraw SDK tldraw는 React 기반 무한 캔버스 엔진으로, 커스텀 셰이프·도구·바인딩·UI 컴포넌트를 만들 수 있는 완전 확장형 SDK다. 웹 · 프론트엔드 · tldraw/tldraw · TypeScript
Key Point 구글, 샵파이, 오토데스크 같은 주요 기업들의 캔버스 앱을 구동하는 오픈소스 SDK로, 무한 캔버스가 필요한 협업 도구·AI 제품을 빠르게 구축할 수 있는 기반이 된다.
핵심 요약
tldraw는 React 기반 무한 캔버스 엔진으로, 커스텀 셰이프·도구·바인딩·UI 컴포넌트를 만들 수 있는 완전 확장형 SDK다. 압력 감지 드로잉, 기하학적 셰이프, 리치 텍스트, 화살표, 스냅 기능, 이미지·비디오 지원 등 드로잉과 다이어그래밍 기능을 제공한다. Editor API로 런타임에 캔버스를 제어할 수 있으며, LLM 통합과 AI 에이전트 구축을 위한 캔버스 프리미티브를 지원한다. 전체 요약 10문장 읽기 → 036 21:12 ▲ 279 · 댓글 117 Blender UI를 독립 라이브러리로: 모든 언어에서 쓸 수 있다 Blender의 사용자 인터페이스를 독립적인 C 라이브러리 BUI로 분리해, Python, Rust, JavaScript, C, C++, Dear ImGui 등 여러 언어와 프레임워크에서 사용할 수 있게 했다. 오픈소스 · 도구 · Blender's UI and Runtime: Much Faster Than GPUI
Key Point Blender의 수십 년 최적화된 인터페이스를 모든 언어·프레임워크에서 즉시 쓸 수 있게 되어, 기존 tkinter/Qt 앱도 코드 변경 없이 Blender 스타일로 전환할 수 있다.
핵심 요약
Blender의 사용자 인터페이스를 독립적인 C 라이브러리 BUI로 분리해, Python, Rust, JavaScript, C, C++, Dear ImGui 등 여러 언어와 프레임워크에서 사용할 수 있게 했다. Blender의 위젯 드로잉과 상호작용 규칙을 그대로 포팅했으며, 숨겨진 커서 드래그, 수식 입력(2*pi), 퍼지 메뉴 검색("ad cu"로 "Add Cube" 찾기) 등 Blender의 특징 인터페이스를 모두 지원한다. CPU 렌더러와 GPU 렌더러(Windows DirectX 11, Linux OpenGL 3.3)를 모두 지원하며, 손상 렌더링으로 유휴 UI는 0% CPU를 사용하고 변경된 위젯만 다시 그린다. 전체 요약 13문장 읽기 → 037 18:11 ▲ 100 · 댓글 45 팬그램, AI 이미지·영상 탐지 모델 1.0 공개 팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. AI · 머신러닝 · Pangram Image 1.0
Key Point AI가 만든 가짜 이미지·영상을 구분하는 것이 점점 어려워지는 상황에서, 학계와 업계 기준 모두에서 최고 성능을 달성한 탐지 도구가 공개되었다.
핵심 요약
팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. 이미지 모델은 12개 최신 AI 이미지 생성기로 만든 1,200개 합성 이미지에서 99.96% 정확도를 달성했다. 압축·노이즈·블러 등의 편집에도 견디도록 학습했으며, 최소 해상도를 512x512에서 256x256으로 낮춰 저해상도 탐지 능력을 개선했다. 전체 요약 9문장 읽기 → 038 12:54 ▲ 10 · 댓글 2 로봇 시뮬레이터 PrimeSim 공개, 30110시간 데이터로 학습 로봇용 월드 모델 시뮬레이터 PrimeSim을 공개했으며, 동작 명령을 충실히 따르고 다중 카메라 뷰 일관성을 유지하며 장시간 시뮬레이션을 안정적으로 지원해야 한다는 과제를 해결했다. AI · 머신러닝 · PrimeSim: A Generalist World Model Simulator from Large-Scale Cross-Embodiment Demonstrations
Key Point 대규모 크로스-플랫폼 로봇 데이터로 학습한 첫 일반화된 월드 모델이 공개되어, 로봇 제어와 시뮬레이션 연구 진행 속도가 크게 높아질 것으로 예상된다.
핵심 요약
로봇용 월드 모델 시뮬레이터 PrimeSim을 공개했으며, 동작 명령을 충실히 따르고 다중 카메라 뷰 일관성을 유지하며 장시간 시뮬레이션을 안정적으로 지원해야 한다는 과제를 해결했다. 22개 로봇 플랫폼의 30,110시간 데이터로 미드트레이닝했고, 통합 크로스-임보디먼트 액션 표현과 프레임 정렬 듀얼-패스 컨디셔닝을 도입해 동작 추적 정확도를 개선했다. 뷰-어웨어 인터리브드 어텐션 메커니즘을 개발해 명시적 카메라 ID를 사용하며 카메라 간 정보 교환을 유지하면서도 뷰별 표현을 보존한다. 전체 요약 7문장 읽기 → 039 12:54 ▲ 238 · 댓글 112 AI의 부상으로 되살아난 해킨토시 커뮤니티 해킨토시는 비애플 하드웨어에서 macOS를 실행하는 기술이며, 1980년대부터의 역사를 가지고 있다. 하드웨어 · 시스템 · The Hackintosh Reborn
Key Point AI 코딩 도구가 복잡한 운영체제 호환성 문제를 자동화하면서 쇠퇴하던 해킨토시 커뮤니티가 급진전하고 있으며, 이는 개발자들의 하드웨어 자유도 변화를 보여준다.
핵심 요약
해킨토시는 비애플 하드웨어에서 macOS를 실행하는 기술이며, 1980년대부터의 역사를 가지고 있다. 2021년 애플이 ARM 기반 M1 맥북을 출시하면서 x86 기반 해킨토시 커뮤니티는 끝날 것으로 예상됐다. 올해 출시된 macOS 27(Golden Gate)은 x86과 더 이상 호환되지 않으며, 해킨토시 커뮤니티는 5년 전 쇠퇴할 것으로 여겨졌다. 전체 요약 8문장 읽기 → 040 18:13 ▲ 12 · 댓글 2 확산 모델의 4단계 생성, 속도 대립적 증류로 정확도 높인다 적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. AI · 머신러닝 · VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation
Key Point 적은 샘플링 스텝에서도 높은 생성 품질을 유지하는 새로운 증류 방법이 텍스트-이미지, 텍스트-비디오 등 실용적인 생성 작업에 즉시 적용될 수 있다.
핵심 요약
적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. 흐름 일치 방식은 학생의 샘플링 과정에서 구성한 속도 필드를 통해 더 유연한 감독을 제공한다. 연구팀은 학습된 비평자를 사용해 학생과 교사의 속도 필드를 비교하고 불일치를 피드백으로 삼는 속도 대립적 증류(VAD)를 제안했다. 전체 요약 7문장 읽기 → 041 15:11 ▲ 23 · 댓글 3 게임 해석 AI, 낯선 게임도 실시간 해설 가능해졌다 비디오 LLM이 게임 실시간 해설을 하지만 학습한 게임에서만 해설이 정확하고, 본적 없는 게임에서는 타이밍은 맞춰도 게임 세계에 대한 지식을 전달하지 못한다. AI · 머신러닝 · StreamDuo: A Live Commentator and a Research Agent for Unseen Games
Key Point 게임 해설 AI가 새로운 게임에서도 정확히 해설할 수 있게 되면서, 스트리밍 커뮐니티에서 자동 해설 기술의 실용성이 크게 높아질 수 있다.
핵심 요약
비디오 LLM이 게임 실시간 해설을 하지만 학습한 게임에서만 해설이 정확하고, 본적 없는 게임에서는 타이밍은 맞춰도 게임 세계에 대한 지식을 전달하지 못한다. StreamDuo는 해설 전담 AI와 고정된 리서치 에이전트를 짝지었으며, 해설 AI가 모르는 것을 보면 현재 프레임을 리서치 에이전트에 보내고 게임 위키에서 찾은 정보를 2초 뒤에 받는다. 해설 AI만 한 게임(발더스 게이트 3)에서 두 단계로 학습했는데, 정보 이득 라벨로 답이 도움될 때만 질문하도록 학습하고, 이상적인 답을 본 자기 복사본과의 정책 기반 자기 증류로 노이즈가 있는 답도 활용할 수 있게 했다. 전체 요약 5문장 읽기 → 042 15:11 ▲ 37 · 댓글 2 게임 영상 1분 이상 학습 데이터셋 'GameVerse' 공개 인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. AI · 머신러닝 · GameVerse: A Minute-Scale Gameplay Dataset for Long-Horizon Interactive World Modeling
Key Point 장시간 게임 환경을 생성하는 AI 모델의 핵심 제약(짧은 학습 데이터)을 직접 해결하는 대규모 데이터셋이 나왔기 때문에, 이 분야 연구자와 개발자가 주목할 필요가 있다.
핵심 요약
인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. 기존 게임 영상 데이터셋은 10초 이하 클립으로 이루어져 있고 캡션도 거칠어서 장시간 제어 생성에 부적합하다. 연구팀이 공개한 GameVerse는 1~2분 길이의 게임 플레이 영상으로 구성되며, 69.7K개 클립, 1,655시간, 3억 4,960만 프레임 규모이다. 전체 요약 8문장 읽기 → 043 15:11 ▲ 26 · 댓글 3 AI 에이전트가 로봇 조종사 대신, 저비용 데이터셋 자동 생성 로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. AI · 머신러닝 · PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
Key Point 로봇 학습 데이터 수집 비용을 최소 60% 절감하면서도 성능과 환경 변화에 대한 강건성을 동시에 확보하는 방식을 제시해, 로봇 개발의 경제성 문제를 바꿀 가능성이 있다.
핵심 요약
로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. 연구팀은 코딩 에이전트가 조종사의 역할을 대신하는 'DataFarm' 시스템을 개발했다. 에이전트는 한 번의 캘리브레이션 영상과 작업 설명을 받아 시뮬레이션 내에서 장면, 전문가 제어기, 성공 판별 함수를 자동으로 작성한다. 전체 요약 7문장 읽기 → 044 09:11 ▲ 107 · 댓글 34 레이디버드 브라우저, 스타일·레이아웃 멀티스레드화 및 JavaScript JIT 탑재 레이디버드는 10월 스타일과 레이아웃을 메인 스레드에서 분리해 JavaScript 실행 중에도 CSS 애니메이션과 :hover 상태가 지속되도록 개선했다. 웹 · 프론트엔드 · This Month in Ladybird – October 2026
Key Point 오픈소스 브라우저 레이디버드가 스레드 분리, JIT 컴파일, 새 WebAssembly 엔진 등으로 성능을 크게 향상시키고 웹 표준 호환성도 Safari를 넘어선 상태로 년말 알파 출시를 앞두고 있다.
핵심 요약
레이디버드는 10월 스타일과 레이아웃을 메인 스레드에서 분리해 JavaScript 실행 중에도 CSS 애니메이션과 :hover 상태가 지속되도록 개선했다. 자신이 아는 바로는 이 기능을 동시에 구현한 브라우저는 없다고 밝혔다. Linux와 macOS에서 LibJS에 최적화 JIT를 추가해 런타임 타입 프로파일링 기반으로 구동되며, 퍼저를 통해 JIT와 인터프리터의 결과를 비교해 버그를 찾았다. 전체 요약 14문장 읽기 → 045 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 046 18:11 ▲ 85 · 댓글 2 AI 시스템이 상황마다 최적의 모델을 고르는 법 통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. AI · 머신러닝 · Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
Key Point 다양한 AI 작업을 하나의 시스템으로 처리할 때 여러 모델 중 각 상황에 맞는 것을 자동으로 선택하는 기법이 실제로 얼마나 효과적인지 처음 대규모 검증했기 때문이다.
핵심 요약
통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. Route Anything은 모델과 정책 라우팅을 통일된 프레임워크로 연구하며, 품질-비용 균형 속에서 최적 라우팅 조건을 수학적으로 규명한다. 언어 이해, 이미지·비디오·음성 생성, 코딩 에이전트, 로봇 조작 등 25개 벤치마크에서 452개 후보 모델 조합으로부터 37만 4401건의 평가 데이터를 수집했다. 전체 요약 6문장 읽기 → 047 18:11 ▲ 57 · 댓글 2 영상 확산 모델으로 범용 행동 표현 학습하는 DreamX 발표 비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. AI · 머신러닝 · DreamX: Video Diffusion Model is a Universal Latent Action Learner
Key Point 로봇과 인간 간 행동을 한 번에 학습하는 시스템으로, 다양한 실체와 환경에서 제로샷 전이가 가능해 로봇 학습 연구의 확장성을 크게 향상시킬 수 있다.
핵심 요약
비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. 기존 잠재 행동 모델은 시각적 변화와 행동을 얽혀 표현해 구현체 간 전이가 어려웠던 반면, DreamX는 비디오 모델의 생성 능력을 활용해 행동 관련 역학만 추출한다. 각 프레임을 1,200개에서 4개 토큰으로 압축해 300배 감소시키며, 의상이나 배경 같은 시각적 변화로부터 행동을 분리한 잠재 공간을 생성한다. 전체 요약 6문장 읽기 → 048 15:11 ▲ 74 · 댓글 2 긴 영상도 한 번에, 다중 장면 편집 프레임워크 MoviEdit 공개 Hugging Face와 연구진이 장편 다중 장면 비디오 편집을 위한 MoviEdit 프레임워크를 발표했습니다. AI · 머신러닝 · MoviEdit: Long-form Multi-Shot Video Editing Made Easy
Key Point 장편 영상의 다중 장면 편집을 자동화하는 기술로, 영상 제작 팀의 작업 효율을 크게 높일 수 있으며 오픈소스로 공개되어 개발자가 활용할 수 있습니다.
핵심 요약
Hugging Face와 연구진이 장편 다중 장면 비디오 편집을 위한 MoviEdit 프레임워크를 발표했습니다. 기존 단일 장면 편집과 달리 장면 전환, 카메라 각도, 피사체 모습의 급격한 변화 속에서도 편집 의도를 일관되게 유지해야 한다는 도전 과제를 해결합니다. 다중 시점 동기화 영상, 실제 다중 장면 비디오, 생성된 콘텐츠로부터 87K개의 쌍을 이루는 편집 비디오 데이터세트를 수동 작업 없이 자동 생성했습니다. 전체 요약 6문장 읽기 → 049 15:11 ▲ 68 · 댓글 2 비디오 생성의 병목은 렌더링에서 의미 제어로 넘어갔다 비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. AI · 머신러닝 · Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
Key Point 비디오 생성 시스템의 모든 모듈(캡셔닝, 프롬프트 강화, 보상 모델링, 평가)을 구체적으로 어떻게 설계했는지 보여주는 실전 가이드라 비디오 생성 연구자와 개발자에게 직접 적용할 수 있다.
핵심 요약
비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. Kling의 다세대 개발을 통해 얻은 다중모달 이해에 관한 통찰을 정리한 보고서로, 생성 품질은 데이터-조건화-정렬-평가 전체 파이프라인을 통한 다중모달 이해의 투영이라고 주장한다. Kling-MLLM은 이미지, 비디오, 오디오, 동기화된 오디오-비디오, 인터리빙 입력을 통합하는 공유 다중모달 기초 모델이며, 각 후속 모듈에 맞춰 특화된다. 전체 요약 9문장 읽기 → 050 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 051 00:11 ▲ 26 · 댓글 1 비디오 세계 모델의 예측 오차, 물리적 놀라움을 재대로 측정하지 못한다 비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. AI · 머신러닝 · When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 052 15:11 ▲ 74 · 댓글 2 영상 생성, 에이전트가 주도하는 시대로 동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. AI · 머신러닝 · Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
Key Point 동영상 생성 기술이 에이전트 자율성과 결합되는 새로운 패러다임을 제시하며, 멀티 에이전트·장기 계획·하이브리드 환경이 미래 AI 시스템의 핵심 방향이 될 것을 보여준다.
핵심 요약
동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. 에이전트 하네스는 동영상 모델 주변에 구성된 실행 런타임으로, 맥락·도구·상태·피드백·예산을 관리한다. 에이전트 비디오 생성은 스크립팅·샷 계획·에셋 관리·제작·편집을 조율하며, 이 시스템들의 평가가 과제다. 전체 요약 7문장 읽기 → 053 21:11 ▲ 26 · 댓글 9 단일 영상의 3D 추적, '궤적 수리'로 개선하다 단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. AI · 머신러닝 · ReLift: Dense 3D Tracking as Lifted Trajectory Repair
Key Point 기존 2D 추적과 3D 기하 정보를 활용해 3D 추적 정확도를 높이는 새로운 접근법으로, 앞으로 나올 추적기나 기하 모델 개선의 이득을 자동으로 누릴 수 있는 구조입니다.
핵심 요약
단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. 기존 2D 추적기와 3D 기하학 모델만으로도 폐색 부분을 단순 보간한 '들어올린 궤적'이 전용 3D 추적기 수준의 성능을 낸다. 하지만 이 방식은 대응과 깊이 오차를 상속받으며, 폐색 영역에서 깊이값이 가려진 물체에서 나오는 문제가 있다. 전체 요약 7문장 읽기 → 054 21:11 ▲ 23 · 댓글 2 위조 탐지 AI, 딥페이크부터 변조 문서까지 한 번에 비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. AI · 머신러닝 · Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
Key Point 이진 분류 기반 위조 탐지 작업에서 다양한 매체와 위조 형태를 동시에 처리할 수 있는 통합 기반 모델의 등장으로, 위변조 탐지 기술의 범용성이 크게 높아졌다.
핵심 요약
비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. 수천만 개의 오픈소스 및 사내 샘플로 학습했으며, LoRA와 전체 파라미터 튜닝을 번갈아 수행하는 'Tide-Style-Tuning' 기법으로 효율성과 일반화를 동시에 달성했다. 예측 엔트로피를 분석해 최적의 예측 방식을 자동으로 선택하는 'Entropy-based Test Adaptation'을 적용했다. 전체 요약 5문장 읽기 → 055 15:11 ▲ 35 · 댓글 3 비디오 모델 활용해 다양한 이미지 생성 통합 통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. AI · 머신러닝 · FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
Key Point 비디오 모델의 시간축 변환 능력을 조건부 이미지 생성에 적용한 새로운 접근법으로, 단일 모델이 여러 생성 작업을 통합 처리할 수 있게 하는 기술이다.
핵심 요약
통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. 기존 방식은 조건과 목표를 고정된 시간 위치에 배치하지만, 생성 작업마다 조건-목표 관계가 크게 달라진다. 비디오 모델은 시간에 따른 시각 변환을 자연스럽게 인코딩하기 때문에, 입력에 맞는 가상 시간 관계로 조건부 생성을 모델링할 수 있다. 전체 요약 6문장 읽기 → 056 15:11 ▲ 27 · 댓글 2 실시간 게임 월드를 자유롭게 조종하는 AI 에이전트 'Wizard' 비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. AI · 머신러닝 · Wizard: Manipulate Any World in Real Time via Agentic Control
Key Point 기존 게임 AI는 특정 환경·캐릭터에만 작동했지만, Wizard는 학습하지 않은 상황에서도 작동하며 플레이어가 실시간으로 게임 세계를 조종할 수 있어 게임 생성 AI의 상용화 가능성을 크게 높인다.
핵심 요약
비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. Wizard는 에이전틱 게임 월드 모델로서 캐릭터 모션을 실시간으로 정밀하게 제어하면서도 미학습 장면, 캐릭터, 행동에 대해 영점 일반화(zero-shot generalization)를 달성한다. 750개 장면과 178개 캐릭터를 포함하는 다양한 데이터셋을 구축했으며, 이들에 스켈레톤과 지오메트리 정보 같은 구조화된 표현을 포함시켰다. 전체 요약 6문장 읽기 → 057 12:10 ▲ 106 · 댓글 70 앤스로픽 Claude, 게임 역공학 작업 제한하기 시작 앤스로픽의 Claude AI가 비디오 게임 코드 모딩·디컴파일·역공학 작업을 제한하기 시작했다. AI · 머신러닝 · Anthropic takes steps to block Claude from reverse-engineering video games
Key Point 게임 업계의 저작권 침해 수법이 AI로 고도화되면서 AI 회사들이 제한에 나서고 있는데, 이는 훈련 데이터 무단 활용을 한 자신들의 관행과 맞지 않는 선택지를 남긴다.
핵심 요약
앤스로픽의 Claude AI가 비디오 게임 코드 모딩·디컴파일·역공학 작업을 제한하기 시작했다. 게임 해킹·모딩 커뮤니티는 AI를 이용해 게임 디컴파일 작업을 대폭 가속화했으며, 마리오를 엘든링에 삽입하거나 스파이더맨을 배트맨 아캄시티에 이식하는 사례들을 만들어냈다. 이어 월드 오브 워크래프트·콜 오브 듀티·그랜드 테프트 오토 바이스시티 등을 브라우저에서 실행 가능하게 만들었고, 원래 개발사의 동의 없이 배포됐다. 전체 요약 7문장 읽기 → 058 12:11 ▲ 10 · 댓글 4 영상 이해 AI, 불확실할 땐 질문하게 하기 멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. AI · 머신러닝 · AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
Key Point 스트리밍 비디오 분석 AI가 정보 부족 상황을 인식하고 능동적으로 질문하도록 훈련할 수 있는지가 새로운 기술 과제가 되고 있기 때문입니다.
핵심 요약
멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. 기존 주도적 상호작용 방식은 답변에 필요한 정보가 완전하다고 가정해 모델이 대기하거나 답하기만 하도록 설계됐으나, 실제로는 영상이나 사용자 질문의 불확실성으로 정보가 불완전한 경우가 많다. 불완전한 정보 상황에서 기존 방식은 모델이 영원히 대기하거나 환각적 응답을 생성하는 문제를 야기한다. 전체 요약 8문장 읽기 → 059 12:11 ▲ 114 · 댓글 42 BeOS를 브라우저에서 실행해보세요 Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. 하드웨어 · 시스템 · Infinite Mac: BeOS
Key Point BeOS는 Apple이 인수를 고려할 정도의 고성능 OS였으나 결국 선택되지 않은 역사 속 선택지인데, 지금 웹브라우저에서 직접 경험해보고 당시 기술적 혁신이 무엇이었는지 확인할 수 있다.
핵심 요약
Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. BeOS는 멀티미디어 중심, 멀티태스킹·멀티스레드 OS로 1990년대 중반 Power Macintosh로 포팅되었으며 Apple도 인수를 고려했던 제품이다. 저자가 DingusPPC 에뮬레이터를 활용해 BeOS 지원을 추가하면서 ADB 에뮬레이션, 화면 깊이 변경, 비디오 메모리 업데이트, HFS 파티션 마운트 등에서 여러 호환성 버그를 발견하고 수정했다. 전체 요약 11문장 읽기 → 060 00:11 ▲ 13 · 댓글 3 하나의 모델로 모든 형식 파싱하는 유투 옴니 파서 공개 유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. AI · 머신러닝 · Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
Key Point 멀티모달 구조화 파싱을 하나의 소규모 모델로 처리하면서 각 모달리티별 전문 모델 수준의 성능을 달성한 방식이 기술적으로 의미 있으며, 공개 모델로서 개발자들이 실제로 활용할 수 있는 선택지를 제공한다.
핵심 요약
유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. 모든 모달리티를 하나의 인코더로 처리하고 모든 태스크를 하나의 스키마로 통일한 설계를 기반으로 한다. 유투 옴니 인코더는 사전학습 언어모델에서 초기화되어 모든 모달리티를 통일된 시공간 좌표계에서 공유 가중치로 인코딩하며, 퓨전 레이어가 비디오 프레임의 동시 오디오 어텐션을 가능하게 한다. 전체 요약 9문장 읽기 → 061 00:11 ▲ 103 · 댓글 101 구글, Android XR 기반 유선 XR 안경 'XREAL AURA' 출시 구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. AI · 머신러닝 · The first wired XR glasses powered by Android XR
Key Point Android XR을 탑재한 첫 유선 XR 안경으로, 가벼운 설계·강력한 AI 지원·다양한 앱과 게임·업무용 유선 미러링 기능을 갖춘 모바일 XR 기기 시장의 새로운 옵션이 출시된 것이다.
핵심 요약
구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. 투명 렌즈로 실제 세계를 보면서 70도 시야각으로 공간 콘텐츠를 투영하며, 95g 미만의 가벼운 무게는 케이블로 연결된 별도 컴퓨트 퍽에 Snapdragon Reality Elite 칩과 배터리를 실어 구현한다. Gemini가 사용자의 행동과 화면을 이해해 자연스러운 대화로 도움을 주며, Google Play의 150개 이상 XR 전용 앱을 포함한 수백만 개 앱을 실행할 수 있다. 전체 요약 13문장 읽기 → 062 21:11 당일 +600 16명의 AI 에이전트 팀이 담긴 오픈소스 데스크톱 앱 Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. AI · 머신러닝 · Orkas-AI/Orkas · JavaScript
Key Point 마케팅 콘텐츠 제작, 이커머스 운영, 정기 보고서, 앱 개발 등 다양한 업무를 하나의 에이전트 팀으로 자동화할 수 있는 데스크톱 환경을 제공하므로, 반복 작업 자동화와 팀 협업이 필요한 개발자와 비즈니스 담당자에게 영향을 미친다.
핵심 요약
Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. 16개 내장 에이전트는 연구(DeepResearcher, SeoGeoAgent, StockAnalyser), 콘텐츠(ContentWriter, VideoStudio, VoiceStudio, ImageStudio, PptMaker), 개발(UIDesigner, ProductDeveloper), 사무(OfficeWorker), 이커머스(5개 전문 에이전트)를 담당한다. Claude Code, Codex, OpenCode, OpenClaw, Hermes-Agent 등 기존 CLI 에이전트들과 함께 작동하며, Commander가 각 에이전트에게 작업을 분배하고 결과를 통합한다. 전체 요약 12문장 읽기 → 063 18:11 ▲ 40 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 064 15:11 ▲ 20 · 댓글 3 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 065 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 066 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 067 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 068 15:11 ▲ 103 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 069 06:11 ▲ 28 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 070 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 071 18:11 ▲ 151 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 072 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 073 15:11 ▲ 53 · 댓글 2 자연언어 대신 코드로 영상 설명하기 영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. AI · 머신러닝 · CodeCap-Bench: Can Code Serve as a Good Video Caption?
Key Point 자연언어 대신 코드로 영상을 설명하면 공간과 시간 정보를 더 정확하고 간결하게 나타낼 수 있음을 보여주는 새로운 벤치마크가 나왔고, 현재 AI 모델이 이 작업을 얼마나 잘 수행할 수 있는지 밝혔다.
핵심 요약
영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. 논문은 실행 가능한 프로그램을 영상 설명으로 사용하는 새로운 패러다임을 제시한다. 그래픽 원시 요소와 시간 함수를 통해 시각 콘텐츠를 표현하는 방식이다. 코드 캡션과 자연언어 캡션을 질문 응답과 영상 재구성 작업으로 비교한 결과, 코드 캡션이 더 높은 추론 정확도와 재구성 충실도를 달성했다. 전체 요약 6문장 읽기 → 074 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 075 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 076 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 077 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 078 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 079 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 080 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 082 21:11 당일 +157 코드로 알고리즘 작동 원리를 시각화하는 대화형 플랫폼 Algorithm Visualizer는 코드로 작성한 알고리즘의 실행 과정을 시각적으로 보여주는 대화형 온라인 플랫폼이다. 웹 · 프론트엔드 · algorithm-visualizer/algorithm-visualizer · JavaScript
Key Point 복잡한 알고리즘의 동작 과정을 코드와 함께 시각적으로 학습할 수 있는 도구로, 알고리즘 교육이나 이해가 필요한 개발자에게 직접 유용하다.
핵심 요약
Algorithm Visualizer는 코드로 작성한 알고리즘의 실행 과정을 시각적으로 보여주는 대화형 온라인 플랫폼이다. 여러 프로그래밍 언어로 작성된 코드의 알고리즘 동작을 단계별로 시각화하여 알고리즘의 작동 원리를 더 쉽게 이해할 수 있다. 플랫폼은 학생, 교사, 전문가 대상으로 튜토리얼, 기사, 비디오 등 알고리즘 학습 자료를 제공한다. 전체 요약 9문장 읽기 → 083 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 084 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 085 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 086 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
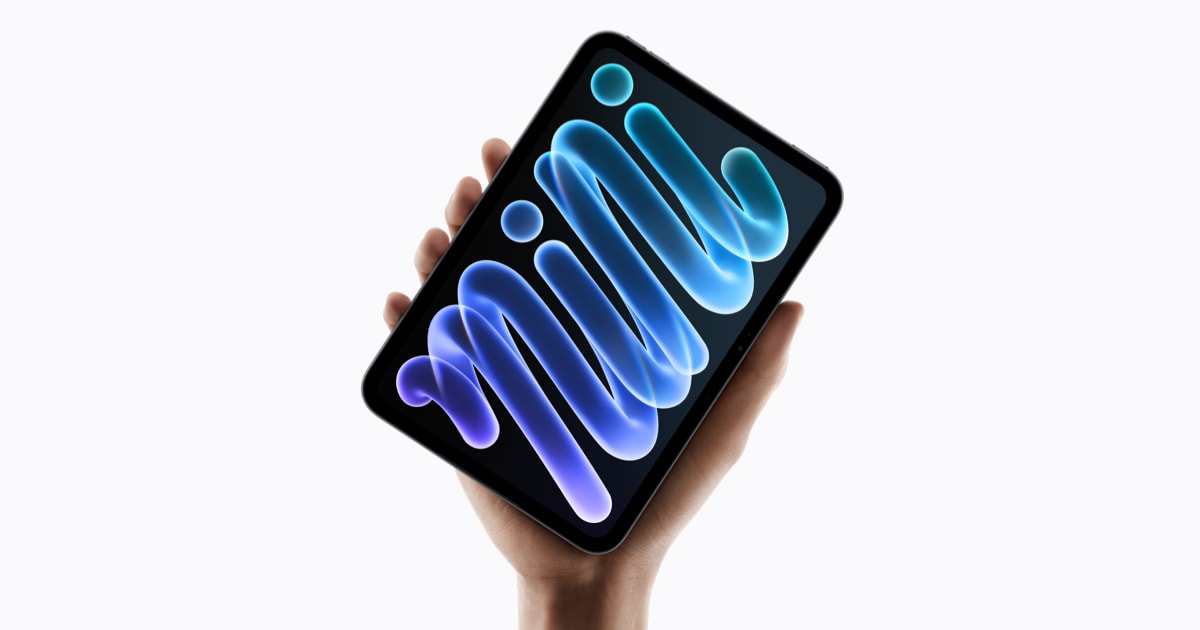
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 087 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
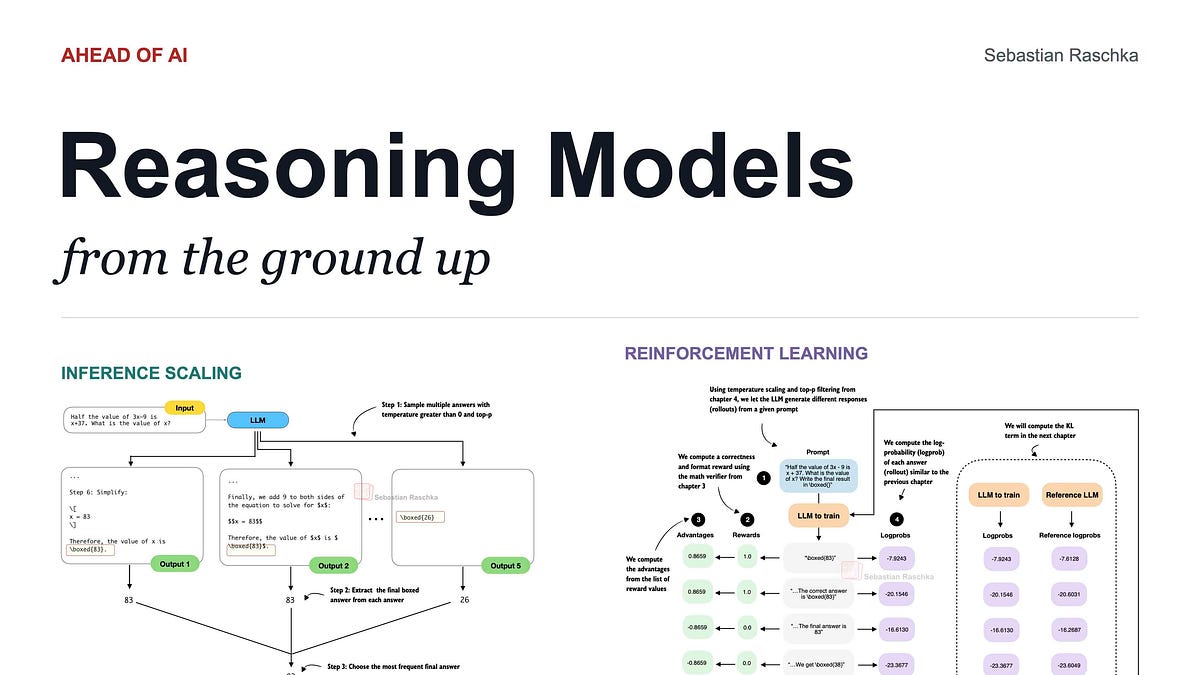
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 088 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 089 21:12 당일 +199 Postiz: AI 에이전트 기반 소셜 미디어 관리 플랫폼 오픈소스화 Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. 웹 · 프론트엔드 · gitroomhq/postiz-app · TypeScript
Key Point AI 에이전트와의 자동 통합으로 소셜 미디어 관리의 전면 자동화가 가능해지며, 클라우드와 오픈소스 선택으로 관리형 편의와 자유도를 동시에 제공한다.
핵심 요약
Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. ChatGPT, Claude, Cursor, OpenClaw, Hermes 등 15개 이상의 AI 에이전트와 통합되며, 사용자가 선택한 에이전트로 콘텐츠 생성과 스케줄링을 자동화할 수 있다. X(트위터), Facebook, Instagram, TikTok, LinkedIn, YouTube 등 주요 소셜 플랫폼을 지원하고, N8N, Make.com, Zapier 같은 자동화 플랫폼과 API 연동이 가능하다. 전체 요약 11문장 읽기 → 090 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 091 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
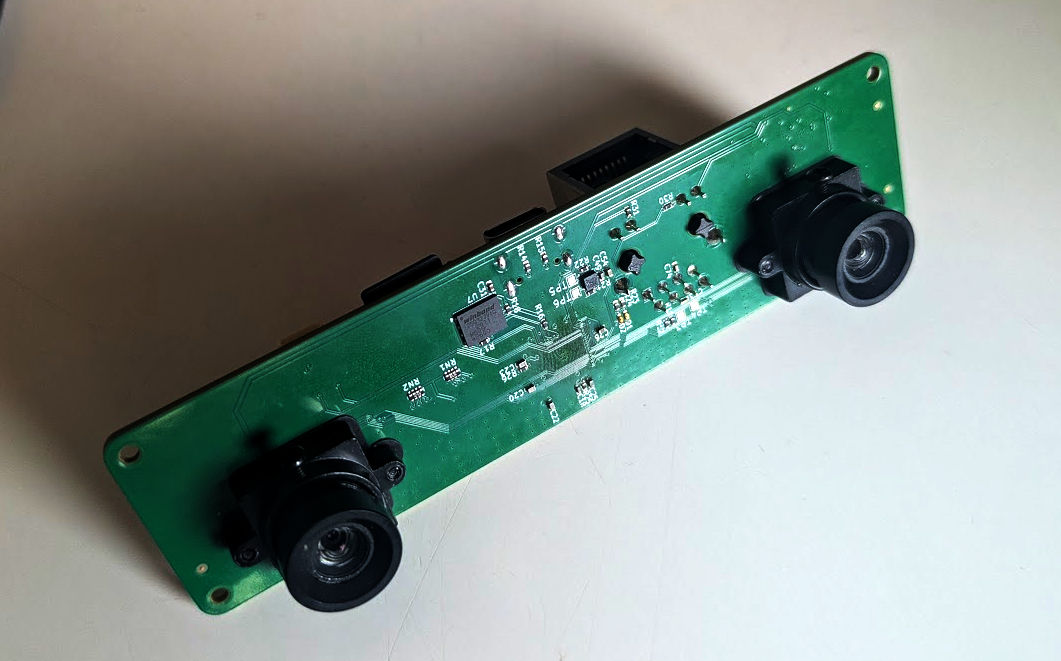
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 092 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 093 21:11 당일 +115 Arc 사이드바와 Dia의 감성을 담은 오픈소스 Chromium 브라우저 맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 웹 · 프론트엔드 · mantrakp04/ardia · TypeScript
Key Point Chromium 기반 오픈소스 브라우저로서 광고 차단과 개인정보 보호를 기본으로 제공하면서도 Arc과 Dia의 혁신적인 UI를 자유롭게 사용할 수 있는 선택지가 생겼다.
핵심 요약
맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 주소 표시줄을 사이드바로 옮겨 페이지가 창 최상단까지 확장되고, 최대 3개 패널을 나란히 또는 위아래로 배치할 수 있다. 비디오 재생 중 탭 전환 시 동영상이 창 모서리에 플로팅되었다가 원래 탭으로 돌아가면 페이지에 복귀한다. 전체 요약 11문장 읽기 → 094 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 096 00:11 ▲ 112 · 댓글 34 VLC 가우시안 블러 필터를 C와 C#으로 경주시켜봤다 VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 인프라 · 데브옵스 · C vs. C#: racing VLC's Gaussian blur
Key Point C# .NET AOT는 CPU 집약적 비디오 필터에서 C 대비 8~10% 수준으로 경쟁력 있으며, 컴파일러 최적화로 격차를 더 줄일 수 있다는 점이 주목할 만하다.
핵심 요약
VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 라인 바이 라인 포트에서 C# 버전은 약 23% 더 느렸는데, 원인은 가비지 컬렉터가 아니라 RyuJIT 코드 생성기가 Math.Min을 매 루프마다 재계산하기 때문이다. 루프 경계를 사전 계산하고 nint 인덱스를 사용하는 두 줄의 수정으로 C# 성능을 8% 범위 내로 개선했다. 전체 요약 12문장 읽기 → 097 18:11 ▲ 126 · 댓글 31 OBS Studio 33 출시, 브라우저 소스와 플러그인 체계 개편 OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 오픈소스 · 도구 · OBS Studio 33
Key Point 브라우저 소스 기반 프레임워크의 대규모 업데이트와 플러그인 체계 개편으로 인해, OBS를 사용하는 스트리머·콘텐츠 크리에이터와 플러그인 개발자는 호환성 변화에 주의해야 한다.
핵심 요약
OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 플러그인 로딩 체계를 완전히 개편했으며, 1차 플러그인은 'core' 폴더로 이동하고 3차 플러그인은 새로운 설치 위치와 폴더 구조를 적용했으나, 기존 3차 플러그인은 OBS Studio 34.0까지 기존 위치에서 로드된다. 프리뷰에서 소스 스냅 동작을 개선하여 시각적 지표를 추가했고, 소스가 전체 축을 따라 스냅되며 숨겨진 소스로의 스냅은 비활성화했다. 전체 요약 13문장 읽기 → 098 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 099 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 100 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 →