쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
100건 (최대치) · "효율성"조건 지우기 ×
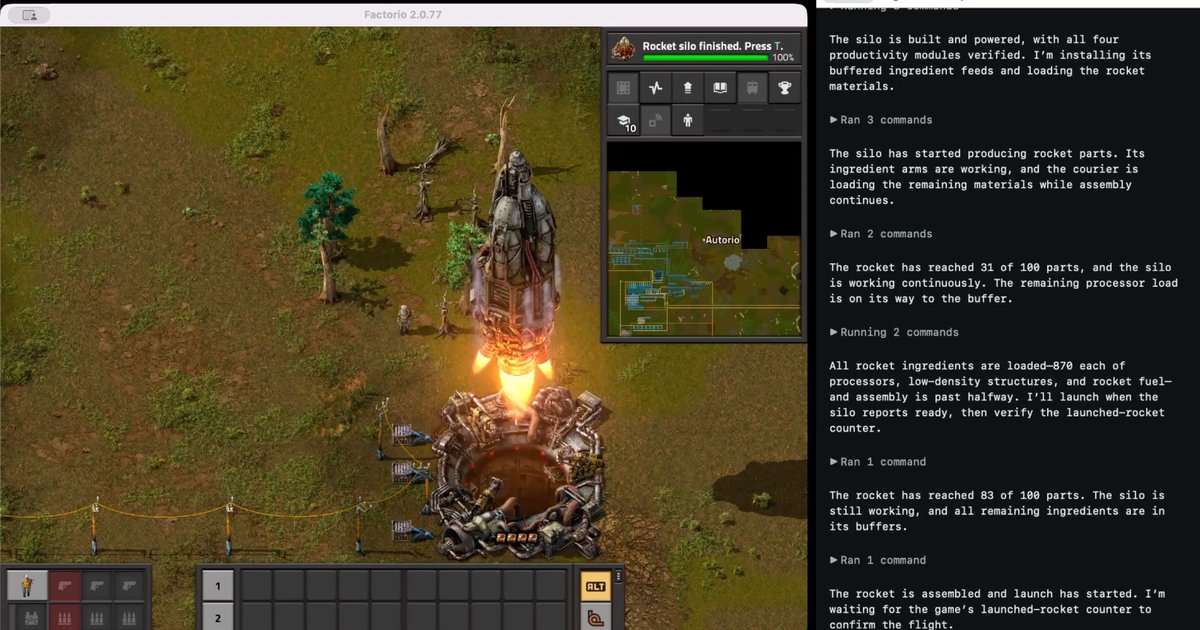
001 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 002 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 003 18:11 ▲ 24 · 댓글 2 분광 데이터 통합 학습하는 OmniSpectra 기초 모델 공개 기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. AI · 머신러닝 · OmniSpectra: A Unified Foundation Model for Universal Spectra Representation Learning
Key Point 천체 관측 데이터 같은 다양한 기기 간 분광 데이터를 효율적으로 학습하려는 연구자와 천문학 AI 개발자에게 물리 기반 설계로 소수 파라미터로 큰 모델을 능가하는 접근법을 제시한다.
핵심 요약
기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. OmniSpectra는 이 좌표 불일치를 해결하는 파장 기반 기초 모델로, 연속 좌표를 사용하는 마스크 오토인코더를 설계해 정수 픽셀 인덱싱을 버렸다. 물리 좌표를 로그 스케일로 매핑하면 우주 적색편이로 인한 곱셈 스케일링이 덧셈 변환으로 바뀌어, 연속 회전 위치 임베딩에서 상대 토큰 거리 계산이 격자 왜곡 없이 단순해진다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 103 · 댓글 27 베른의 잃어버린 미래 소설, 131년 만에 발견되다 1863년 쥘 베른은 미발표 소설 '20세기의 파리'를 썼으나 출판사 피에르-쥘 에첼이 예언이 비현실적이고 톤이 너무 어둡다며 거절했다. 기타 · Jules Verne's Lost Novel
Key Point 베른의 미래 예언 소설이 왜 거부당했고, 정확히 어떤 내용이었는지, 그리고 어떻게 세상에 나왔는지를 보여주는 문학사의 재미있는 발견 기록이다.
핵심 요약
1863년 쥘 베른은 미발표 소설 '20세기의 파리'를 썼으나 출판사 피에르-쥘 에첼이 예언이 비현실적이고 톤이 너무 어둡다며 거절했다. 소설은 1960년의 파리를 배경으로 19세기 문명이 과학, 기계, 상업, 효율성에 대한 맹신을 극단으로 밀어붙였을 경우를 상상한 작품이다. 베른이 늘상 미지의 섬, 해저, 지구 내부, 달의 뒤편을 소재로 삼던 것과 달리 이 작품은 직접 미래를 들여다본 드문 시도였다. 전체 요약 4문장 읽기 → 005 03:11 ▲ 11 · 댓글 2 생성 모델이 직접 관련성 판단…글랜스 레랭킹 방식 검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. AI · 머신러닝 · Glance: The Generator Is Its Own Reranker
Key Point 기존 RAG의 이중 모델 문제를 하나의 생성 모델로 통합하면서도 리랭킹 정확도는 더 높이는 방식이 제시되어, 비용 효율과 성능 사이의 트레이드오프를 해결하는 방법을 제시한다.
핵심 요약
검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. 쿼리-문단 쌍을 각각 따로 처리하지 않고 공유된 prefill 캐시에서 짧은 관련성 프로브를 분기하여 각 후보 문단마다 하나의 점수를 생성하므로, 처리 비용을 크게 줄인다. 9B 백본 모델이 생성, 일반 의사결정, 리랭킹을 모두 담당하며 각 기술별로 약 0.1GB의 추가 메모리만 필요하다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 269 · 댓글 203 AI가 SRE를 대체하지 않으면, 기술을 퇴화시킨다 AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 인프라 · 데브옵스 · AI isn't replacing SREs, it's deskilling them
Key Point AI가 많은 일을 자동화할수록 SRE의 실제 대응 능력이 떨어지는 '역설적 퇴화' 현상이 의료·항공 산업에서도 이미 관찰되고 있으며, 신입 인재 육성 경로까지 단절될 수 있다는 점이 기술 조직의 구조적 위험을 보여준다.
핵심 요약
AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 1983년 인지심리학자 리잔느 베인브릿지의 연구 논문 '자동화의 역설(Ironies of Automation)'을 근거로, 자동화가 발전할수록 인간 운영자는 자동화 실패 시 대응할 능력이 낮아진다는 패러독스를 설명한다. 산업 자동화가 육체 노동자들의 예외 상황 대처 능력을 빼앗았듯이, AI는 패턴 매칭, 분류, 알려진 문제 해결 같은 일상적 인지 업무를 대신하면서 SRE에게 드물고 복잡한 문제만 남긴다. 전체 요약 11문장 읽기 → 007 21:11 ▲ 12 · 댓글 2 음성 대화형 AI를 위한 압축 토큰 처리 기법 제안 음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. AI · 머신러닝 · CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
Key Point 음성 대화 모델의 추론 비용을 크게 줄이면서 모델 재학습 없이 기존 시스템에 적용할 수 있는 방법이 제시되어, 실제 음성 AI 서비스의 성능과 비용 효율성을 동시에 개선할 수 있다.
핵심 요약
음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. 기존의 저율 토크나이저는 시퀀스를 짧게 하지만 압축 품질 손상과 모델 교체 비용이 크다. CoSTA는 원본 음성 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 호환성 보존형 프레임워크다. 전체 요약 7문장 읽기 → 008 21:11 ▲ 101 · 댓글 96 AI 시대, 개발자들의 피로감 커지고 있다 AI 도구가 생산성을 높이지만 많은 개발자가 이전보다 심한 피로감을 느끼고 있다. AI · 머신러닝 · Ask HN: Are you tired too in this AI era?
Key Point AI 시대에 업무 효율성은 높아졌지만 개발자들의 인지적 부담이 오히려 증가하는 역설적 문제를 드러내며, 지속 가능한 AI 활용 방식을 모색하는 것이 현실적 필요성으로 대두되고 있다.
핵심 요약
AI 도구가 생산성을 높이지만 많은 개발자가 이전보다 심한 피로감을 느끼고 있다. 병렬로 진행되는 수많은 작업을 추적하고 생성된 방대한 텍스트를 읽어야 하는 부담이 늘어났다. 지속적인 품질 관리, 의사결정, 작업 전환으로 인한 인지적 과부하가 발생하고 있다. 전체 요약 4문장 읽기 → 009 18:11 ▲ 36 · 댓글 6 이미지 생성 Transformer의 효율성을 높이는 다중 슬롯 토크나이제이션 픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. AI · 머신러닝 · Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
Key Point 이미지 생성 모델의 전역 어텐션 비용과 생성 품질 간 트레이드오프를 주파수 대역 분리로 해결하는 새로운 접근으로, 적은 계산량에서 고품질 이미지를 생성할 수 있는 구조를 제시한다.
핵심 요약
픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. 저주파 구조는 전역 정보 교환이 필요하지만 고주파 디테일은 지역적으로만 모델링되면 되는 점에 착안해 SpecSlot을 제안했다. SpecSlot은 각 공간 앵커를 여러 슬롯으로 확장하고 각 슬롯에 서로 겹치지 않는 DCT 계수 대역을 할당한다. 전체 요약 8문장 읽기 → 010 18:11 ▲ 38 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 011 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 012 06:11 ▲ 146 · 댓글 14 Word2Vec 창시자 토마시 미콜로프, 체코 대통령으로부터 훈장 수상 체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI · 머신러닝 · Tomáš Mikolov awarded the Medal of Merit by the President of the Czech Republic
Key Point Word2Vec으로 현대 AI의 기초를 닦은 인물이 국가적 인정을 받았으며, 한국의 AI 연구자들이 참고할 만한 국제적 사례이자 자신의 성과 인정 경로를 보여준다.
핵심 요약
체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI 전문가 토마시 미콜로프는 Word2Vec 방식의 창시자로, 단어를 수학 벡터로 표현하여 의미 관계를 포착하는 기술을 개발했다. Word2Vec은 현대 언어 모델과 AI 도구의 중요한 기초가 되었으며, 미콜로프는 BottleCap AI 회사를 통해 효율적인 언어 모델 개발에 종사하고 있다. 전체 요약 9문장 읽기 → 013 03:11 ▲ 11 · 댓글 3 AI 에이전트가 검색할 가치를 판단하는 법 AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. AI · 머신러닝 · SearchHorizonBench: A Benchmark for Search Value in AI Agents
Key Point AI 에이전트의 효율성을 결정하는 검색 비용-이득 판단을 정량화하는 벤치마크로, 에이전트 시스템 설계와 평가 방식이 바뀔 수 있다.
핵심 요약
AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. 기존 답변 성공률은 질문의 난이도는 파악하지만, 검색의 추가 이득을 예측하지 못한다. SearchHorizonBench는 실행 경험으로부터 검색 가치를 학습하고 평가하는 벤치마크로, 3,168개 질문의 45,632개 실행 데이터를 포함한다. 전체 요약 9문장 읽기 → 014 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 015 18:11 ▲ 30 · 댓글 2 로봇 모델 평가, 비용 없이 미리 걸러낸다 로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. AI · 머신러닝 · Sensorimotor Alignment: A Platonic Proxy for Embodied Policy Success
Key Point 로봇 모델을 평가하는 데 드는 비용과 시간을 대폭 줄일 수 있는 방법이 제시되어, 로봇 AI 개발 파이프라인의 효율성이 크게 바뀔 수 있다.
핵심 요약
로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. 플라토닉 표현 가설(PRH)은 모델 능력이 높아질수록 비전·언어처럼 모달리티들이 현실의 같은 통계 모델로 수렴한다고 본다. 연구진은 움직임 궤적도 이런 모달리티인지 묻고, 감각 표현이 물리 운동의 구조와 얼마나 잘 맞는지 측정하는 S²(Sensorimotor Alignment) 지표를 만들었다. 전체 요약 8문장 읽기 → 016 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 017 21:11 ▲ 28 · 댓글 3 증거 연결로 멀티모달 인식 일반화시키는 EvidenceConnect 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
Key Point 멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다. 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다. 전체 요약 6문장 읽기 → 018 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 019 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
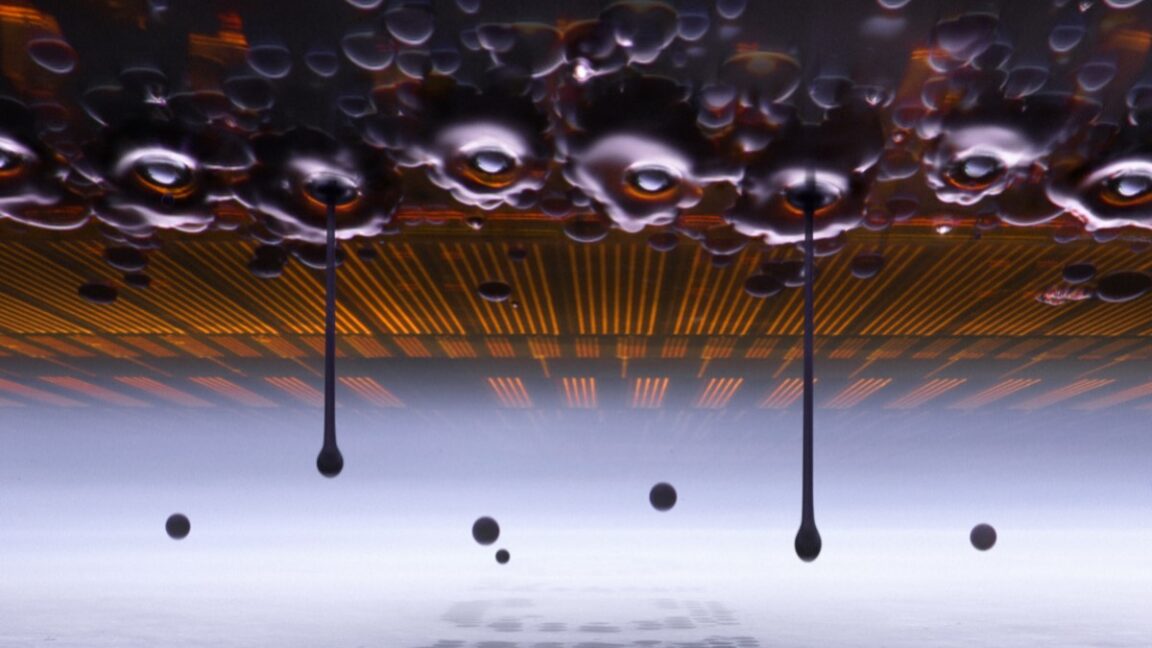
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 020 15:11 ▲ 158 · 댓글 24 25세 독일 사진작가, 잉크젯 프린터의 미시 세계 포착으로 니콘 공모전 우승 25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 하드웨어 · 시스템 · Ink droplets in motion snag top prize in Nikon Small World contest
Key Point 현미경 사진에서 고속 현상을 포착하기 위해 프린터 자체를 개조한 창의적 해결책과 저비용 자작 장비의 효율성이 과학적 도구의 창의적 활용을 보여준다.
핵심 요약
25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 우승작은 잉크젯 프린터가 종이에 잉크 방울을 분사하는 순간을 현미경으로 포착한 이미지다. 비엘펠트는 코로나19 락다운 중 부모님 다락에서 발견한 오래된 현미경으로 시작해 튜브와 나무로 어댑터를 만들어 아버지 카메라에 연결하고 독학했다. 전체 요약 7문장 읽기 → 021 12:11 ▲ 418 · 댓글 2 공간 인식 AI, 다중 질문 형식을 동시에 학습하는 기법 제시 공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. AI · 머신러닝 · ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence
Key Point 공간 인식 AI가 여러 형식의 질문을 동시에 잘 답하기 위한 학습 구조를 제시해 멀티태스크 비전언어모델의 효율성을 크게 높일 수 있는 실마리를 제공한다.
핵심 요약
공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. ChronoReplay는 다양한 공간 감독을 시간 순서대로 에피소드 형태로 반복 재생하고 각 형식의 원본 목표를 유지하면서 감독 신호를 균형 있게 분배하는 방식으로 이 문제를 해결한다. 동일한 시각 정보 접근 조건에서 ChronoReplay 체크포인트는 OVO-S-Bench, OST-Bench, UCS-Bench 세 벤치마크를 동시에 개선하며, 특히 OST-Bench에서 13.41포인트 향상을 달성했다. 전체 요약 6문장 읽기 → 022 12:11 ▲ 88 · 댓글 2 로봇 정책 개선을 위한 세계모델 역추적 기법 Rollback 행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. AI · 머신러닝 · Rollback: Experience Backtracking in World Models for Policy Improvement
Key Point 세계모델이 단순한 시뮬레이터를 넘어 과거로 돌아가 대안을 탐색할 수 있게 되면서, 로봇 정책 학습의 효율성과 수렴 속도가 근본적으로 달라진다.
핵심 요약
행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. 새로운 Rollback 기법은 세계모델을 역추적 가능한 반사실적 엔진으로 변환하여, 과거의 결정 지점으로 돌아가 대안 행동을 탐색한다. 성공과 실패의 결과를 대비하여 행동 수준의 세밀한 감시 신호를 생성하며, 별도의 가치 모델 없이도 상상을 문제해결에 집중시킨다. 전체 요약 8문장 읽기 → 023 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 024 09:11 ▲ 132 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 025 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 026 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 027 03:11 당일 +114 TheAlgorithms/Java, 66000개 알고리즘 구현 교육용 저장소 TheAlgorithms/Java는 모든 알고리즘을 Java로 구현한 교육 목적의 오픈소스 저장소다. 오픈소스 · 도구 · TheAlgorithms/Java · Java
Key Point 알고리즘 학습과 코드 기여에 관심 있는 개발자들을 위해 구조화된 교육 자료가 필요할 때, 실행 가능한 Java 구현들을 한곳에서 찾고 학습할 수 있는 기반이 되기 때문이다.
핵심 요약
TheAlgorithms/Java는 모든 알고리즘을 Java로 구현한 교육 목적의 오픈소스 저장소다. Gitpod.io(무료 온라인 개발 환경)를 통해 한 번의 클릭으로 알고리즘을 실행·편집하거나 기여할 수 있다. 이 저장소의 구현들은 학습 목적이므로 Java 표준 라이브러리보다 효율성이 떨어질 수 있다. 전체 요약 4문장 읽기 → 028 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 029 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 030 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 031 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 032 18:11 ▲ 114 · 댓글 56 N64 레이싱 게임 F-Zero X을 닌텐도 3DS로 이식 완료 F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 하드웨어 · 시스템 · F-Zero X on Nintendo 3DS
Key Point AI 에이전트 147개를 동원해 N64 게임을 3DS로 이식한 대규모 자동화 개발 프로젝트의 전체 과정과 최적화 기법, 비용 투명성을 공개한 사례로, 현대 AI 보조 개발의 스케일과 효율성을 보여준다.
핵심 요약
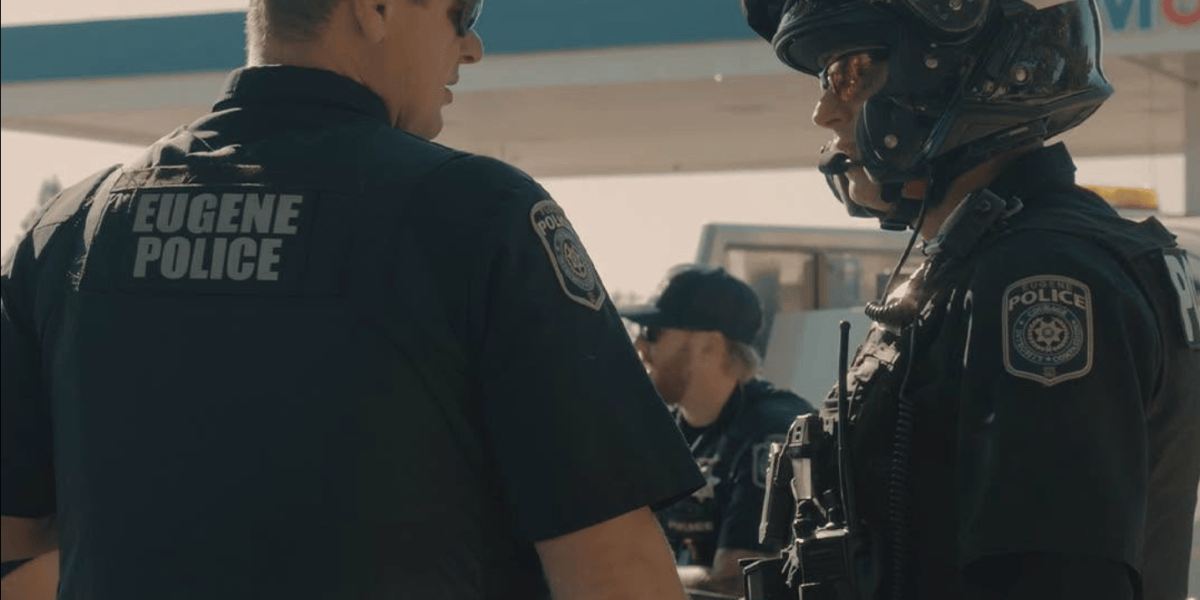
F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 첫 번째 단계(8월 11일~9월 3일)에서 New 3DS에서 3D 스테레오스코픽으로 60fps 달성했으며, 한 명의 디렉터와 147개 이상의 AI 에이전트가 참여했다. 두 번째 단계(9월 7일~10월 19일)에서 Old 3DS 지원, 네이티브 렌더러, N64 64DD 익스팬션 킷 기능을 추가했다. 전체 요약 13문장 읽기 → 033 06:11 ▲ 235 · 댓글 59 경찰 기록 공개에 250만 달러 청구, 언론사 봉쇄 수단인가 미국 오리건주 유진 경찰청이 지역 언론사 더블사이디드미디어의 공개 기록 청구에 248만 4599달러의 처리 비용을 청구했다. 보안 · Oregon Police Are Charging a Local News Outlet $2.5M for Records About One Cop
Key Point 경찰이 과도한 수수료로 언론의 감시 기능을 원천 차단하는 전술을 취하고 있으며, 지역 차원에서 이를 제어할 법적 장치가 부족한 상황이다.
핵심 요약
미국 오리건주 유진 경찰청이 지역 언론사 더블사이디드미디어의 공개 기록 청구에 248만 4599달러의 처리 비용을 청구했다. 청구 대상은 폭행 혐의가 있는 경찰관 저스틴 펙켈스의 2018년부터 2026년 사이 기록이며, 공공의 이익과 감시 차원에서 중요한 문제였다. 경찰청은 44,816시간의 직원 근무시간이 필요하다고 주장했고, 관련된 또 다른 전직 경찰관 에릭 클린코의 기록까지 합하면 총 270만 달러가 필요했다. 전체 요약 11문장 읽기 → 034 03:11 ▲ 129 · 댓글 39 S&P 500 기업의 시가총액을 '직원 1명당 가치'로 시각화 S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 스타트업 · 비즈니스 · Show HN: I put employees inside S&P 500 market-cap bubbles
Key Point 기업의 시가총액을 직원 수로 정규화해 '직원 1명당 가치' 관점에서 기술 기업과 전통 산업의 효율성 격차를 한눈에 볼 수 있기 때문이다.
핵심 요약
S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 각 버블 내부의 막대 인물은 직원을 나타내며, 모두 같은 크기로 표시된다. 버블이 촘촘하면 직원 1명당 시가총액이 낮고, 버블이 넓은데 인물이 적으면 직원 1명당 가치가 높다는 의미다. 전체 요약 7문장 읽기 → 035 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 036 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 037 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 038 18:11 ▲ 19 · 댓글 3 테스트 시점 회귀로 토큰 압축 성능 대폭 개선 언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. AI · 머신러닝 · Rethinking Sequence Compression with Test-time Regression
Key Point 기존 풀링·투영 방식의 약점을 해결하면서 더 적은 토큰으로 더 나은 성능을 달성하는 새로운 압축 기법이 여러 과제에서 검증됐다.
핵심 요약
언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. 새로운 접근으로 입력 토큰을 회귀 문제로 본 후, 피팅된 계수를 압축 표현으로 삼는 TTR-Compressor를 제시한다. 회귀 문제는 역전파로 엔드투엔드 학습하되, 순전파 중에는 폐쇄형 식으로 계수를 효율적으로 계산한다. 전체 요약 6문장 읽기 → 039 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 040 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 041 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 042 12:11 ▲ 162 · 댓글 75 LLM으로 대규모 소프트웨어 형식 검증이 현실화되다 Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. AI · 머신러닝 · LLMs are making formal software verification feasible at a much larger scale
Key Point 형식 검증이 역사적으로 수십 년의 전문 인력을 요구했으나, LLM이 이 비용을 획기적으로 낮추면서 일반 소프트웨어 개발에도 적용 가능해졌고, 향후 소프트웨어 보안 수준을 크게 변화시킬 기술이기 때문이다.
핵심 요약
Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. 개발자의 퍼지 테스트(fuzz test)를 자동으로 형식 사양으로 변환해 증명했으며, 239개 엔트리포인트에서 64MB 이하 모든 입력에 대해 크래시가 없음을 증명했다. 총 약 1억 8천만 줄의 Rocq 증명을 작성했고, 전형적인 증명은 약 60만 줄의 코드로 18,000개 RISC-V 명령어에 대한 보안 보장을 제공한다. 전체 요약 13문장 읽기 → 043 21:11 ▲ 28 · 댓글 2 반복되는 작업을 스스로 학습하게 하는 에이전트 훈련법 Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. AI · 머신러닝 · DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
Key Point 장시간 작업을 하는 AI 에이전트의 비효율을 근본적으로 줄일 수 있는 훈련 기법으로, 추가 라벨링 없이 에이전트 자신의 경험으로부터 학습하는 방식을 제시한다.
핵심 요약
Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. DeLoop는 이런 루프를 줄이기 위한 자기지도 학습 방법으로, 에이전트 자신의 실행 기록에서 감독 신호를 얻는다. 같은 작업 실행 내에서 반복된 액션을 부정 사례, 그 이후 처음 나오는 다른 액션을 긍정 사례로 삼아 직접 선호도 최적화로 학습한다. 전체 요약 6문장 읽기 → 044 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 045 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 046 03:11 새 버전 Terraform 1.17.0 출시, 정책 엔진과 변수 지원 강화 Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. 인프라 · 데브옵스 · hashicorp/terraform@v1.17.0
Key Point Terraform Policy가 정식 출시되며 인프라 코드의 정책 검증을 기본 기능으로 사용할 수 있게 되었고, 새로운 계획 옵션과 함수 개선으로 효율성과 안정성이 높아졌다.
핵심 요약
Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. Terraform Policy가 일반 공개되어 -policies 플래그가 실험 빌드나 -allow-experimental-features 플래그 없이 plan, apply, query 명령어에서 작동한다. Query 정책은 list 블록이 발견한 리소스를 평가하고 사람이 읽을 수 있거나 JSON 형식의 결과를 보고한다. command/init에서 제공자 버전으로 로그 메시지를 강화했고, test 명령어에 일시적 리소스용 mock_provider 지원이 추가되었다. 전체 요약 6문장 읽기 → 047 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 048 00:11 ▲ 22 · 댓글 4 장시간 작업용 LLM 에이전트, 실행 상태를 메모리처럼 재사용 장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. AI · 머신러닝 · FlowState: Execution State as Memory for Long-Horizon LLM Agents
Key Point 장시간 작업에서 LLM 에이전트의 맥락 길이 문제를 해결하는 새 방식이 기존 방법 대비 성능과 효율성 모두에서 실질적 개선을 보여주기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. FlowState는 실행 상태를 메모리로 취급해 요청 간에 유지하고 재방문할 수 있으며, 의미론적으로 타입된 상태 노드·관계·도구 관찰 참조를 보존해 필요 시에만 접근하도록 분리한다. Incremental State Update(ISU)는 실행 루프 내에서 새 입력과 피드백에 따라 현재 상태를 유지하고, Progressive State Access(PSA)는 추론 중 필요에 따라 과거 상태와 근거를 점진적으로 공개한다. 전체 요약 5문장 읽기 → 049 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 050 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 051 12:11 ▲ 11 · 댓글 2 자기 재귀로 멀티토큰 예측 효율화한 ECHO 논문 기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. AI · 머신러닝 · ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
Key Point 자동회귀 언어 모델의 학습과 추론 효율성을 동시에 높이는 핵심 알고리즘 개선으로, 기존 멀티토큰 예측의 구조적 문제를 근본적으로 해결한다.
핵심 요약
기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. ECHO는 백본의 최종 레이어 자체가 모든 예측 스텝을 담당하므로 감독 신호가 다음 토큰을 생성하는 매개변수에 직접 전달된다. 깊은 스텝의 학습 비용을 낮추기 위해 동적 깊이 샘플링(DDS)을 도입해 깊이에 따라 확률을 감쇠시킨다. 전체 요약 6문장 읽기 → 052 00:11 ▲ 118 · 댓글 53 형식 검증으로 코드 최적화하는 AI 'Maxwell' 공개 doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. AI · 머신러닝 · Maxwell: A new kind of model that sits between code and hardware
Key Point 기존 AI는 코드 작성만 지원했지만, Maxwell은 형식 검증을 통해 프로그램 실행 중 동적으로 코드를 재작성·최적화하는 새로운 영역을 열었기 때문에, 소프트웨어 성능과 자원 효율성에 미칠 파급 효과가 크다.
핵심 요약
doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. Maxwell은 실행 중인 프로그램의 병목을 감지하고 알고리즘 전체를 재작성해 더 빠른 바이너리를 생성하며, 생성된 코드는 원본과 의미적으로 완전히 동등함을 형식 검증으로 증명한다. 기존 JIT 컴파일러나 최적화 도구와 달리 Maxwell은 실제 하드웨어와 데이터 흐름에 맞춰 함수와 알고리즘 수준의 전체 변환을 수행하고 조건에 따라 보호 조항을 둔다. 전체 요약 13문장 읽기 → 053 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 054 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 055 06:11 ▲ 279 · 댓글 111 MiniMax M3.1 Flash 출시, 70% 가격 인하하고 추론 속도 3배 빨려 MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. AI · 머신러닝 · MiniMax M3.1 Flash
Key Point 에이전트 작업의 비용을 크게 낮추면서 최상위 모델 수준의 성능을 제공하는 모델이 나왔으니, 자동화 솔루션과 개발 업무에 LLM을 활용하는 기업들에게 실질적인 선택지가 생겼다는 뜻이다.
핵심 요약
MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. 자동화 업무·코딩·컴퓨터 사용·사이버보안 분야에서 상위 모델 수준의 성능을 보이며, AutomationBench-AA에서 우수한 순위를 기록하고 판매·마케팅·운영·고객서비스·재무·HR 등 기업 워크플로우를 자동화한다. DeepSWE v1.1에서 73.7% 점수로 코딩 업무에 강하며, 다단계 계획·문서 일관성 유지·금융 규정 준수 같은 복잡한 실무 과제를 처리한다. 전체 요약 10문장 읽기 → 056 18:11 ▲ 47 · 댓글 2 언어모델의 숨은 의미 읽는 법: 렉시컬 참조틀 제안 언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. AI · 머신러닝 · Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
Key Point 기존 해석 기법과 달리 모델이 실제로 상태를 처리하는 방식을 따라 언어모델의 중간 계산을 읽을 수 있게 되어, 투명성·효율성·제어성이 모두 향상된다.
핵심 요약
언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. 연구팀은 각 은닉 상태가 다음 층들의 읽기 방식과 맥락에 맞춰진 '네이티브 참조틀'을 가진다고 주장한다. 렉시컬 참조틀은 모델의 남은 층들을 통해 상태를 읽되, 정해진 횟수의 위치 간 어텐션과 나머지는 전형적인 어텐션 출력으로 근사한다. 전체 요약 7문장 읽기 → 057 18:11 ▲ 116 · 댓글 196 AI 도입 선두 기업 Anthropic, 주니어 직군은 줄고 생산성은 5배 증가 Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. AI · 머신러닝 · How employment is changing at Anthropic
Key Point AI 기반 조직 구조 변화의 선제적 신호를 보여주므로, 향후 다른 기업과 업계의 일자리·채용·업무 형태 변화를 예측하는 데 실질적 데이터를 제공한다.
핵심 요약
Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. 2026년 8월 기준 AI 에이전트 작동 시간이 직원 작동 시간의 6배에 달하며, 엔지니어 코드 커밋 속도는 6개월 전 대비 5배 증가했다. 코딩 에이전트 채택 후 엔지니어들의 코드량이 급증했으며, 영업 담당자도 더 많은 거래를 성약했고, 변호사·회계사·채용담당자 등 비기술 직군도 산출량이 증가했다. 전체 요약 12문장 읽기 → 058 15:11 ▲ 43 · 댓글 3 로봇 행동 예측 AI, 시각 정보 처리 30배 효율화 기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. AI · 머신러닝 · BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
Key Point 로봇 행동 모델의 계산 효율을 대폭 개선하면서 성능은 유지하는 기술로, 로봇 제어 AI의 실시간성과 비용 효율성을 높이는 방향을 제시한다.
핵심 요약
기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. BridgeWAM은 시각·언어·고유감각 정보를 32개의 Latent Bridge Queries(LBQs)를 통해 제한된 공유 잠재 공간으로 집약하는 Bridge-of-Experts 구조를 도입했다. 행동 예측 그래디언트가 비디오 전문가를 행동 예측에 적합한 표현으로 유도하고, 행동 전문가는 교차 주의를 통해 작업 관련 정보를 선택적으로 검색한다. 전체 요약 7문장 읽기 → 059 09:11 ▲ 158 · 댓글 97 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. AI · 머신러닝 · Hybrid Reasoning Agents: LLM agents that think in latent space, act through text
Key Point 텍스트만으로 처리하던 LLM 에이전트의 비효율성을 내부 잠재 추론과 외부 텍스트 상호작용으로 분리해 대폭적인 속도와 비용 개선을 달성한 새로운 에이전트 아키텍처이다.
핵심 요약
기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. HybridAgents는 하나의 생성 과정 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하는 구조를 제시한다. HybridLink라는 경량 모듈이 텍스트와 잠재 모드 간 원활한 전환을 가능하게 하며, 지속적인 작업 메모리가 여러 턴에 걸쳐 손실 없는 하이브리드 문맥을 유지한다. 전체 요약 9문장 읽기 → 060 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 061 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 062 21:11 ▲ 40 · 댓글 3 로봇 학습에서 세계 모델과 행동 예측이 서로 강화할 수 있을까 세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. AI · 머신러닝 · Can World and Action Modeling Benefit Each Other under Unified Causal Training?
Key Point 로봇의 행동 학습과 환경 이해 모델을 같은 구조에서 동시에 훈련할 때 둘이 서로 강화하는 효과가 있는지를 첫 체계적으로 검증한 결과로, 로봇 학습의 효율성을 높일 새로운 방법론을 제시한다.
핵심 요약
세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. 통합된 인과 학습 구조 하에서 행동을 세계 예측의 조건과 정책 학습의 목표로 동시에 취급한다. 지정된 행동이 주어졌을 때 그 시각적 결과를 예측하는 학습이 정책 성능과 일반화를 개선하는지 검증했다. 전체 요약 8문장 읽기 → 063 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 064 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 065 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 066 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 067 09:11 ▲ 203 · 댓글 105 16GB로 28개 서비스 운영하는 방법 저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. 인프라 · 데브옵스 · What I Self-Host
Key Point 작은 하드웨어로 수십 개 서비스를 효율적으로 자체 호스팅하려는 개발자들에게 실제 운영 구성, 도구 선택 원칙, 구체적 성능 수치를 제시한다.
핵심 요약
저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. Jellyfin을 기점으로 클라우드 서비스 의존도를 줄이기로 결심했으며, ISP의 CGNAT 제약으로 IPv6 VPN만 공개하고 내부 서비스는 인터넷에 노출하지 않는 정책을 유지했다. 단일 Go 바이너리 선호, Docker 대신 Podman/systemd 활용 등 운영 간편성을 우선으로 서비스를 선택했다. 전체 요약 9문장 읽기 → 068 03:12 ▲ 12 · 댓글 2 AI가 생성한 이미지의 글자 오류, 효율적으로 고쳐낸다 생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
Key Point AI가 만든 이미지의 텍스트 오류를 효율적으로 고칠 수 있는 방법이 나왔으며, 기존 방식 대비 정확도가 2배 이상 높아서 생성 이미지의 실용성이 크게 개선될 수 있다.
핵심 요약
생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. 기존 VAE 기반 방식은 재구성 과정에서 글자의 세밀한 획을 잃고, 전체 이미지 편집은 배경색을 왜곡하는 한계를 갖는다. PixText는 장면의 텍스트 보정을 픽셀 공간의 그룹화된 이미지 생성으로 정의하며, 원본 이미지를 조건으로 목표 영역만 생성하고 편집되지 않은 부분을 보존한다. 전체 요약 7문장 읽기 → 069 03:12 ▲ 233 · 댓글 359 AI가 수백 년 묵힌 난제 풀자 수학자들이 눈물 흘리는 이유 OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. AI · 머신러닝 · I Know Why the Mathematicians Weep
Key Point 인공지능이 인간만의 영역으로 여겨졌던 고등 수학을 대량 해결하면서, 기술 진보가 단순히 효율성이 아니라 인간의 존재 이유와 커뮤니티의 의미까지 빼앗을 수 있다는 근본적 질문을 던진다.
핵심 요약
OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. Fields Medal 수상자인 Hugo Duminil-Copin은 "내 연구 분야를 멸망시켰다"고, Cornell의 Steven Strogatz는 "울었다"고 밝혔으며, 수학자들 사이에서 상실감과 방향감각 상실을 느끼고 있다. 저자는 이를 단순한 자존심 상처가 아니라, 2000년 동안 이어져 온 수학이라는 '대화'가 단절되는 데서 비롯한 것이라 분석한다. 전체 요약 10문장 읽기 → 070 00:11 ▲ 107 · 댓글 72 AI가 학문 공동체를 잠식하다 저자는 옥스포드 석사 과정 초반 동료들이 ChatGPT로 숙제를 대신하자 충격을 받고, 초반엔 AI를 거부했으나 시험 준비 마지막 1개월 반에 4개 과목을 혼자 학습하면서 ChatGPT의 개념 설명 기능이 정의를 실례로 이해하는 자신의 학습 방식에 큰 도움이 됐다고 밝혔다. AI · 머신러닝 · AI was great until it was not
Key Point PhD 과정 중인 물리학자가 1년 전 ChatGPT의 도움으로 석사를 마친 경험에서 현재 박사 과정의 급격한 변화까지, AI가 학문 공동체의 협력 문화를 어떻게 침식하는지 내부자 관점에서 보여주는 글이다.
핵심 요약
저자는 옥스포드 석사 과정 초반 동료들이 ChatGPT로 숙제를 대신하자 충격을 받고, 초반엔 AI를 거부했으나 시험 준비 마지막 1개월 반에 4개 과목을 혼자 학습하면서 ChatGPT의 개념 설명 기능이 정의를 실례로 이해하는 자신의 학습 방식에 큰 도움이 됐다고 밝혔다. 하버드 박사 1년차 때는 수학 노트북과 Mathematica 코딩을 직접 했고 Claude를 극소한 부분만 사용했으며, 저작물은 출판될 수 있었다. 하지만 2년차 진학 후 물리학과 환경이 급변했다: 사람들이 모니터에 ChatGPT를 켜두고, 메일의 노트는 AI 생성이거나 AI의 제안 기반이 되었으며, '브레인스토밍'은 이제 ChatGPT와의 대화를 의미했다. 전체 요약 8문장 읽기 → 071 15:11 ▲ 32 · 댓글 1 INT4 양자화로 강화학습 롤아웃 1.8배 빠르게 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
Key Point 강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다. KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다. 전체 요약 5문장 읽기 → 072 15:11 ▲ 28 · 댓글 2 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. AI · 머신러닝 · Hybrid Reasoning Agents
Key Point LLM 에이전트의 추론 효율성과 투명성을 동시에 높이는 새로운 아키텍처로, 토큰 절감과 속도 개선이 이미 검증된 실질적인 개선 방안이다.
핵심 요약
현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. HybridAgent는 통합 생성 프로세스 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하며, 가벼운 HybridLink가 두 모드 간 seamless한 전환을 가능케 한다. 에이전트의 지속적 작업 메모리는 다중 턴에서 손실 없는 하이브리드 컨텍스트를 유지하고, 도구 통합 기능을 보존하면서도 잠재 사고(latent thoughts)를 직접 검사할 수 있도록 설계됐다. 전체 요약 6문장 읽기 → 073 12:11 ▲ 64 · 댓글 1 루프형 MoE 모델, 비대칭 연산 배분으로 효율 19% 개선 루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. AI · 머신러닝 · LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
Key Point 파라미터 효율성을 중시하는 개발팀이 더 작은 모델로 더 나은 성능을 달성할 수 있는 구조적 개선 방안을 얻을 수 있기 때문입니다.
핵심 요약
루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. 연구진이 공유 블록을 두 번 적용하는 모델에서 각 방문별로 별도의 잔차 계수를 학습한 결과, 첫 번째 방문에서 더 작은 스케일이 나타났다. 첫 번째 방문의 스케일을 줄이면 성능이 유지되거나 개선되지만, 두 번째 방문을 같은 정도로 줄이면 성능이 떨어진다. 전체 요약 8문장 읽기 → 074 09:11 ▲ 218 · 댓글 97 Anthropic의 Scion, Meta의 Mononoke를 닮다 Anthropic이 어제 새로운 버전 관리 시스템 Scion을 소개했고, '파생 데이터(derived data)' 개념을 사용해 blame 같은 작업을 더 효율적으로 처리한다고 설명했다. 스타트업 · 비즈니스 · Anthropic's Scion is heavily inspired by Mononoke
Key Point LLM이 기존 오픈소스 설계를 학습하면서 적절한 출처 표기 없이 재구현하는 문제를 드러내며, 기술 커뮤니티의 신용 체계가 어떻게 변해야 하는지 질문한다.
핵심 요약
Anthropic이 어제 새로운 버전 관리 시스템 Scion을 소개했고, '파생 데이터(derived data)' 개념을 사용해 blame 같은 작업을 더 효율적으로 처리한다고 설명했다. 이는 저자가 2022년 Meta에서 구축한 Mononoke 소스 제어 서버를 설명할 때 사용한 정확히 같은 개념이고 같은 효율성 목표다. Anthropic의 블로그 포스트는 Sapling만 '힘들게 얻은 교훈(hard-won lessons)'으로 명시했고 Mononoke는 언급조차 하지 않았다. 전체 요약 8문장 읽기 → 075 09:11 ▲ 230 · 댓글 88 OpenCode 2.0, 에이전트 중심 코딩 환경으로 전면 개편 OpenCode 2.0는 수백만 사용자의 경험을 바탕으로 에이전트가 필요로 하는 모든 기능을 지원하도록 대폭 재설계했다. AI · 머신러닝 · OpenCode 2.0
Key Point 코딩 에이전트의 자동화 능력을 극대화하도록 설계된 플랫폼의 근본적 변화로, 멀티태스킹·컨텍스트 효율성·확장성 측면에서 이전 버전과 완전히 다르다.
핵심 요약
OpenCode 2.0는 수백만 사용자의 경험을 바탕으로 에이전트가 필요로 하는 모든 기능을 지원하도록 대폭 재설계했다. 백그라운드 서비스가 자동으로 실행되어 TUI, 웹 인터페이스, 데스크톱 앱이 중앙 프로세스와 통신하며, 프로그래매틱 클라이언트는 로컬 서비스를 자동 발견한다. 밑바닥부터 다시 설계한 API는 세션·탭·워크트리 관리 등 에이전트의 다양한 워크플로우를 지원하며, OpenCode 자신도 이 API를 호출해 자동화 작업을 수행한다. 전체 요약 9문장 읽기 → 076 06:11 ▲ 10 · 댓글 1 에이전트가 직접 학습 환경을 설계하는 자동화 시스템 등장 터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AI · 머신러닝 · AutoEnvScaling: Automating the Data Flywheel with Terminal Agents
Key Point 터미널 에이전트 훈련의 가장 큰 병목이었던 환경 설계를 자동화함으로써, 모델의 자율적 성장과 비용 효율성을 동시에 달성하는 경로를 보여준다.
핵심 요약
터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AutoEnvScaling은 환경 설계를 터미널 작업으로 재정의해 에이전트가 자동으로 학습 환경을 생성하도록 한다. 제안 에이전트가 풀이 에이전트의 실행 롤아웃을 바탕으로 새로운 강화학습 환경을 구축하고, 그 결과가 다음 훈련 라운드를 안내한다. 전체 요약 8문장 읽기 → 077 03:11 새 버전 React 19.3.1 릴리스, 서버 컴포넌트 전송 프로토콜 개선 React 19.3.1이 10월 14일 공개되었다. 웹 · 프론트엔드 · facebook/react@v19.3.1
Key Point React 서버 컴포넌트의 통신 효율성 향상으로 성능과 안정성에 영향을 주는 업데이트이다.
핵심 요약
React 19.3.1이 10월 14일 공개되었다. React Server Components의 전송 프로토콜이 개선되었다. 이번 개선은 @unstubbable과 @eps1lon이 #37845를 통해 기여했다. 078 03:11 새 버전 Node.js v26.12.0 출시, WebSocket 마스킹 함수와 WebAssembly 지원 개선 Node.js v26.12.0이 2024년 10월 14일 공개되었다. 인프라 · 데브옵스 · nodejs/node@v26.12.0
Key Point WebSocket 마스킹 함수 추가와 암호화 성능 개선으로 실시간 통신과 보안 작업이 빨라지며, 스트림 모듈의 광범위한 최적화는 데이터 처리 효율성을 크게 향상시킨다.
핵심 요약
Node.js v26.12.0이 2024년 10월 14일 공개되었다. WebSocket 처리를 위해 http 모듈에 websocketMask()와 websocketUnmask() 함수가 추가되었다. WebAssembly 또는 정규표현식 지원이 없을 때 명확한 에러를 던지도록 변경되어 누락된 기능을 감지할 수 있다. 전체 요약 12문장 읽기 → 079 00:11 ▲ 13 · 댓글 2 긴 문맥 이해를 위한 강화학습 프레임워크 LongR LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. AI · 머신러닝 · LongR: Unleashing Long-Context Reasoning via Reinforcement Learning with Dense Utility Rewards
Key Point 장문맥 환경에서 LLM의 추론 능력을 강화하는 실질적인 방법을 제시하며, 기존 희소 보상 방식의 한계를 극복한 구체적인 해결책을 보여줍니다.
핵심 요약
LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. 제안하는 LongR 프레임워크는 '생각과 읽기(Think-and-Read)' 메커니즘을 통해 추론 과정 중 필요할 때 문서를 참고하는 방식으로 작동합니다. 상대적 정보 이득(relative information gain)을 기반으로 한 맥락 기반 밀도 보상을 도입하여, 증거 주석 없이도 관련 문서의 유용성을 정량화합니다. 전체 요약 5문장 읽기 → 080 00:11 ▲ 13 · 댓글 2 긴 영상도 고정 메모리로 처리하는 프레임 압축 기법 비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. AI · 머신러닝 · Elephant in the Fridge: Constant-Memory Frame Packing for Long Video Understanding
Key Point 장영상 이해가 VLM의 메모리 병목이 되는 시점에 학습 없이 적용 가능한 고정 메모리 솔루션이 나왔고, 기존 모델 대비 10% 이상 성능 향상을 보였다.
핵심 요약
비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. 기존의 토큰 감소나 핵심 프레임 선택 방식도 O(n) 증가 추세를 해결하지 못한다. FramePack-U는 학습 없이 임의로 긴 영상을 고정 크기의 시각 표현으로 압축하는 훈련-자유 프레임 패킹 프레임워크다. 전체 요약 9문장 읽기 → 081 00:11 ▲ 23 · 댓글 2 멀티모달 에이전트가 보는 방식과 읽는 법을 함께 개선하는 ViewCraft 멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. AI · 머신러닝 · VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
Key Point 멀티모달 에이전트의 입력 처리 방식 자체를 학습함으로써 모델 재학습 없이 성능과 효율성을 동시에 높일 수 있는 새로운 접근법이 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. 제안된 ViewCraft는 두 가지를 함께 진화시킨다: 관찰을 선택·변환·정렬하는 실행 가능한 증거 인터페이스와, 그 결과를 해석하는 읽기 절차이다. 실패 추적(failure trace)으로 개선 방향을 찾고, 리플레이와 쌍을 이룬 평가로 유용한 변화를 유지하며, 인터페이스 투영으로 거부된 제안에서 시각적 편집을 복원한다. 전체 요약 7문장 읽기 → 082 00:11 ▲ 20 · 댓글 1 자율 연구 AI를 위한 이중 체계 구조 JevGPT 공개 자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. AI · 머신러닝 · JevGPT: Thinking Fast and Slow in Autonomous Research
Key Point LLM 기반 자율 연구 에이전트의 성능과 비용 효율성을 동시에 높이는 새로운 아키텍처로, 현재 활발히 개발 중인 AI 리서치 도구의 실용성을 크게 개선할 수 있다.
핵심 요약
자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. JevGPT는 빠른 증거 처리와 신중한 연구 계획을 결합한 이중 체계 구조로, System Two는 증거 목표를 설정하고 발견을 통합하며, System One은 증거를 찾아 관련성을 평가하고 추가 검토를 안내한다. 독립적인 출처 판단이 병렬로 실행되며, 선택된 원문 구절이 다음 연구 단계에 반영되는 방식으로 작동한다. 전체 요약 5문장 읽기 → 083 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 084 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 085 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 086 18:11 ▲ 25 · 댓글 2 언어-행동 이중 부트스트래핑으로 네비게이션 성능을 자동 개선하다 자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. AI · 머신러닝 · Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
Key Point 고비용의 인간 주석 없이도 모델이 스스로 학습 데이터를 생성하고 개선하는 방식은 대규모 AI 시스템의 데이터 확보 문제를 어떻게 풀 수 있는지 보여주는 중요한 사례다.
핵심 요약
자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. 기존 방법들은 네비게이션과 명령어 생성을 분리된 모델로 처리하거나 특정 컴포넌트로 묶어서 처리하는 한계가 있었고, 고정된 모델로 전체 궤적을 미리 주석해서 생성된 감독이 진화하는 정책에 뒤처지는 문제가 있었다. 논문은 RSI-Nav라는 데이터 중심의 재귀적 자가개선 프레임워크를 제안하며, 하나의 공유 모델로 비전-언어-행동 명령 수행과 비전-행동-언어 명령 생성을 통합한다. 전체 요약 7문장 읽기 → 087 18:11 ▲ 111 · 댓글 1 도시 전체 3D 장면에서 물체를 찾는 AI 에이전트 'Urbex' 공개 도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. AI · 머신러닝 · Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
Key Point 도시 규모 3D 장면 이해 문제를 에이전트 기반의 대화형 탐색으로 재설계해 기존 랭킹 방식의 비효율성을 타파한 새로운 접근법이기 때문입니다.
핵심 요약
도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. 기존 방식은 미리 계산한 후보 상자들을 순위매기는 방식이었는데, 대규모 실외 장면에서 비효율적이었다. Urbex는 비전-언어 모델 에이전트가 인터랙티브하게 탐색하도록 설계했다. 전체 요약 8문장 읽기 → 088 15:11 ▲ 27 · 댓글 1 멀티턴 에이전트 학습의 진행도 신호, DeltaTTG 제안 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
Key Point 기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다. DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다. 전체 요약 8문장 읽기 → 089 03:11 ▲ 454 · 댓글 345 Gemini 4로 효소 설계 가속화, 몇 시간만에 신규 세린 에스터라아제 개발 Google의 Gemini 4 Argon 모델을 이용해 단백질 공학의 핵심인 효소 설계 과정을 대폭 단축했다. AI · 머신러닝 · Gemini 4 Argon
Key Point 기존 수개월이 필요하던 효소 설계가 AI로 몇 시간으로 단축되면서 바이오 제조·신약 개발 같은 산업의 개발 속도와 비용 구조를 근본적으로 바꿀 수 있는 전환점이 될 수 있기 때문이다.
핵심 요약
Google의 Gemini 4 Argon 모델을 이용해 단백질 공학의 핵심인 효소 설계 과정을 대폭 단축했다. 기존에는 수개월이 걸리던 세린 에스터라아제 설계가 Argon을 통해 몇 시간 내에 완료됐다. Argon은 관련 데이터를 수집하고 모델 튜닝을 수행한 후 생화학 기반의 필터를 적용해 5개의 신규 효소 설계안을 도출했다. 전체 요약 5문장 읽기 → 090 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 091 03:11 ▲ 20 · 댓글 3 장시간 연구 자동화, 상태 없는 에이전트로 풀다 LLM 에이전트를 이용한 자동화 연구 시스템은 장시간 실행 중 대화 히스토리 반복, 중복 실험, 토큰 낭비 등으로 실패한다. AI · 머신러닝 · Stateless Language Agents: Scaling Long-Horizon Automated Research
Key Point LLM 에이전트 기반 자동화 연구의 실제 문제점(토큰 낭비, 중복 실험)을 구조적으로 해결하는 새로운 접근법이며, 아주 큰 예산에서 실질적인 효율 개선을 입증했다.
핵심 요약
LLM 에이전트를 이용한 자동화 연구 시스템은 장시간 실행 중 대화 히스토리 반복, 중복 실험, 토큰 낭비 등으로 실패한다. 문제의 원인은 연구 상태를 에이전트가 들고 다니고 각 에이전트가 독립적으로 다음 시도를 결정하는 구조에서 비롯된다. Stateless Language Agents(SLA) 프레임워크는 역할을 바꿔 연구 상태를 하네스가 관리하고 매번 신선한 맥락만 에이전트에 제공한다. 전체 요약 8문장 읽기 → 092 03:11 ▲ 18 · 댓글 3 오프라인 학생 모델로 증류하는 것이 더 효과적인 경우가 많다 온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. AI · 머신러닝 · When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
Key Point 증류 훈련의 핵심 선택지인 온폴리시 방식의 효과성을 재평가하는 논문으로, 더 간단하고 빠른 오프라인 방식이 많은 경우 더 나은 결과를 주는 상황을 규명한다.
핵심 요약
온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. 1.5B부터 235B 파라미터까지 17개의 교사-학생 쌍을 테스트한 결과, 14개 경우에서 Semi-OPD가 OPD를 능가했으며, 정확도 최대 13.6% 향상과 11.4배 훈련 속도 향상을 달성했다. 두 방식 중 어느 것을 선택할지는 교사와 학생의 정렬도에 따라 결정되며, 출력 토큰 겹침 비율로 측정할 수 있다. 전체 요약 5문장 읽기 → 093 21:12 당일 +131 Rust로 만든 고성능 AI 코딩 에이전트 jcode 공개 GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. AI · 머신러닝 · 1jehuang/jcode · Rust
Key Point 메모리 사용량을 1/10 이하로 줄이고 응답 속도를 200배 이상 개선한 오픈소스 AI 에이전트가 나왔으므로, 로컬 개발 환경에서 가볍게 AI 코딩 어시스턴트를 운영하거나 대규모 멀티에이전트 시스템을 구축하려는 개발팀에게 중요한 선택지가 될 수 있다.
핵심 요약
GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. 단일 세션 메모리 사용량은 27.8MB(임베딩 비활성화)부터 167.1MB(활성화)로, Claude Code 386.6MB 대비 약 2~14배 적으며, 10개 세션 병렬 실행 시에도 260.8MB로 경쟁 제품 대비 압도적이다. 부팅부터 첫 프레임까지 14.0ms, 첫 입력까지 48.7ms로 다른 도구(Claude Code 3436.9ms)의 1/200~1/70 수준의 극도로 빠른 응답성을 제공한다. 전체 요약 10문장 읽기 → 094 18:12 ▲ 14 · 댓글 2 비디오 AI가 스스로 관찰 방식을 개선한다 비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. AI · 머신러닝 · Video-RSI: Recursive Self-Improvement of Video Understanding Agents via Harness Evolution
Key Point 비디오 AI가 실패를 분석해 자신의 관찰 방식을 반복적으로 개선하는 새로운 접근법이 제시되었으며, 정확도를 유지하면서 계산 비용을 절감할 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. Video-RSI라는 새로운 프레임워크를 제시하는데, 언어 모델 스스로가 자신의 하네스를 수정해서 비디오를 재조사한다. 에이전트는 원본 학습 영상에 돌아가 추가 관찰을 통해 여러 실패 가설을 검증하고, 기존 실행 흔적을 벗어난 증거로 개선안을 뒷받침한다. 전체 요약 8문장 읽기 → 095 18:12 ▲ 13 · 댓글 2 MixTok: 전역 1D와 부분 2D 혼합한 적응형 이미지 토크나이저 기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. AI · 머신러닝 · MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
Key Point 이미지 토크나이저의 효율성과 품질을 동시에 높이는 새로운 하이브리드 구조가 기존 방식의 트레이드오프를 어떻게 해결하는지 보여준다.
핵심 요약
기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. 연구팀은 글로벌 정보를 담은 1D 토큰과 세부 개선용 2D 토큰을 결합한 하이브리드 토크나이저 MixTok을 제안했다. 콘텐츠 적응 라우터가 우선순위에 따라 후보 위치를 순위 매기고, 목표 토큰 예산 내에서 각 이미지당 2D 토큰 개수를 결정한다. 전체 요약 5문장 읽기 → 096 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 097 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 098 15:11 ▲ 60 · 댓글 2 멀티모달 AI의 연산 비용을 줄이는 '탄력적 시각 표현' 기법 등장 멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. AI · 머신러닝 · VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
Key Point 다음 세대 멀티모달 모델 실서빙에서 비용과 속도를 동시에 개선하는 기술이 나왔으며, 기존 토큰 제거 기법보다 성능 유지 능력이 뛰어나다.
핵심 요약
멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. 기존 다운샘플링과 토큰 제거 기법들은 내용에 따른 세밀한 적응, 다양한 작업 지원, 최신 모델 통합에서 한계가 있었다. VisionWeave는 이미지 영역별로 세부도를 적응적으로 조절하는 '탄력적 시각 표현 짜기' 능력을 MLLM에 구현했다. 전체 요약 8문장 읽기 → 099 12:11 ▲ 33 · 댓글 2 확률 분포 일치로 보정 없이 확산 언어모델 양자화 확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. AI · 머신러닝 · SoloQ: Calibration-Free Quantization for Diffusion Language Models
Key Point 확산 기반 언어모델의 배포 효율성이 점점 중요해지는 상황에서, 보정 데이터 없이도 정확도를 유지하는 양자화 기법이 실무 적용 시간을 크게 단축할 수 있다.
핵심 요약
확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. 기존 양자화 방법들은 마스킹 상태와 노이징 단계마다 활성화 분포가 바뀌어 보정 데이터가 필수였다. SoloQ는 가중치와 활성화를 정규화된 회전 기저로 매핑해 예측 가능한 주변 분포를 만들고, 이를 통해 데이터 독립적 양자화를 실현한다. 전체 요약 8문장 읽기 → 100 21:11 당일 +529 PyTorch: GPU 가속 텐서 연산과 동적 신경망 PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. AI · 머신러닝 · pytorch/pytorch · Python
Key Point PyTorch는 현대 AI 개발의 핵심 프레임워크로, GPU 가속 능력과 동적 신경망 구축의 유연성이 산업 표준이 되었으므로 최신 버전과 설치 옵션을 파악하는 것이 필수다.
핵심 요약
PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. torch, torch.autograd, torch.nn, torch.multiprocessing, torch.utils 등 핵심 컴포넌트로 구성되어 있으며 NumPy 대체제 또는 딥러닝 연구 플랫폼으로 사용된다. CPU 또는 GPU에서 실행되는 텐서 라이브러리로 슬라이싱, 인덱싱, 선형대수 등 다양한 연산을 고속으로 수행하며 Intel MKL, NVIDIA cuDNN, NCCL 등 가속 라이브러리를 통합한다. 전체 요약 12문장 읽기 →