쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
40건 · "파인튜닝"조건 지우기 ×
001 03:11 ▲ 11 · 댓글 2 생성 모델이 직접 관련성 판단…글랜스 레랭킹 방식 검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. AI · 머신러닝 · Glance: The Generator Is Its Own Reranker
Key Point 기존 RAG의 이중 모델 문제를 하나의 생성 모델로 통합하면서도 리랭킹 정확도는 더 높이는 방식이 제시되어, 비용 효율과 성능 사이의 트레이드오프를 해결하는 방법을 제시한다.
핵심 요약
검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. 쿼리-문단 쌍을 각각 따로 처리하지 않고 공유된 prefill 캐시에서 짧은 관련성 프로브를 분기하여 각 후보 문단마다 하나의 점수를 생성하므로, 처리 비용을 크게 줄인다. 9B 백본 모델이 생성, 일반 의사결정, 리랭킹을 모두 담당하며 각 기술별로 약 0.1GB의 추가 메모리만 필요하다. 전체 요약 7문장 읽기 → 002 18:11 ▲ 12 · 댓글 2 웹 에이전트 학습용 자동 환경 생성 프레임워크 'WebAnything' 공개 웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. AI · 머신러닝 · WebAnything: From the Wild Web to Scalable Agent Environments
Key Point 웹 기반 AI 에이전트의 재현 가능한 학습 환경을 자동으로 구성하는 방법이 나왔으며, 기존 수동 방식보다 우수한 성능을 보여준다.
핵심 요약
웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. 기존 방식들은 수동 구현(사이트별 엔지니어링 필요), 생성형 구축(실제 웹과 괴리), 캡처 재생(상호작용 범위 제한) 등의 한계가 있다. WebAnything은 실제 URL에서 자동으로 웹 환경을 재구성하며, 사이트별 수동 작업이나 초기 설정 후 수리 불필요하다. 전체 요약 8문장 읽기 → 003 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 004 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 005 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 006 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 008 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 009 00:11 ▲ 34 · 댓글 3 장기 작업 완료 위한 'Interlock' 프레임워크 제시 LLM 에이전트가 장기 작업을 수행할 때 개별 요구사항은 충족하지만 이들 간의 관계를 유지하지 못해 부분적으로만 완성되는 문제가 있다. AI · 머신러닝 · Interlock: From Local Correctness to Task Completion in Long-Horizon Agents
Key Point 복잡한 장기 작업에서 부분적 완성이 아닌 전체 완성을 추구하는 새로운 에이전트 학습 방식이 제시되었으며, 여러 벤치마크에서 측정 가능한 성능 개선을 입증했다.
핵심 요약
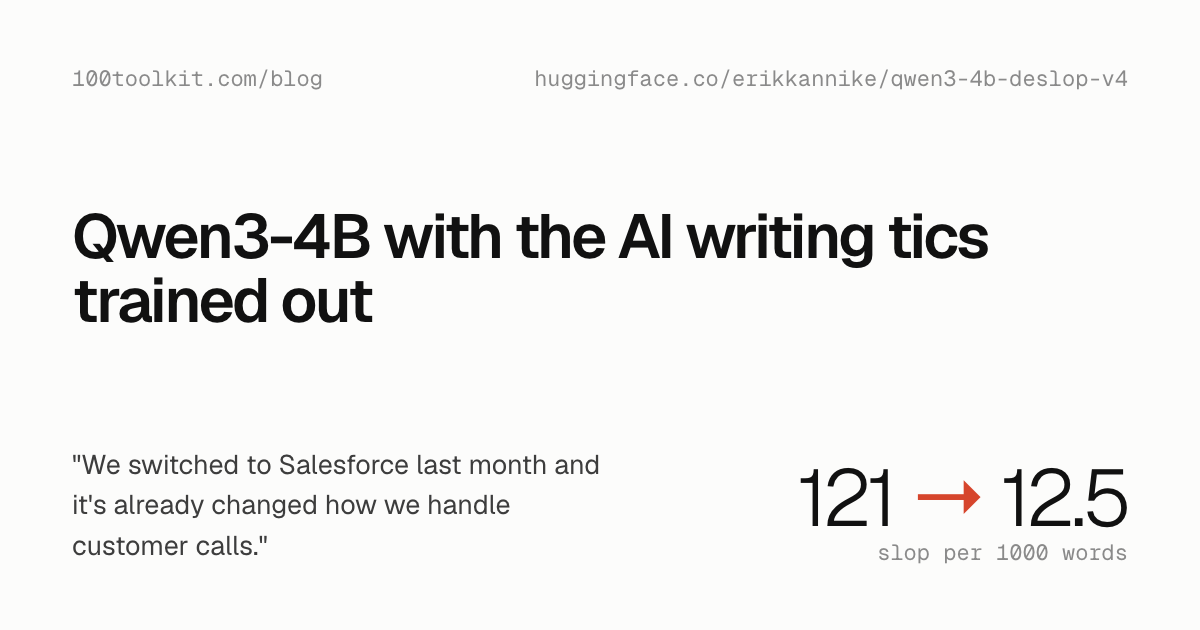
LLM 에이전트가 장기 작업을 수행할 때 개별 요구사항은 충족하지만 이들 간의 관계를 유지하지 못해 부분적으로만 완성되는 문제가 있다. Interlock은 작업을 타입 지정된 완성 그래프로 표현하는 프레임워크로, 그래프는 증거-결정 연결(grounding edge), 컴포넌트 간 결합 제약(coupling hyperedge), 결정-효과 연결(realization edge)로 구성된다. 이 그래프를 리셋 가능한 작업공간, 공개 요청서, 평가 기준으로 컴파일하며, 출처 검증과 공개 입력 검증을 통해 요구사항과 평가 기준의 정합성을 확인한다. 전체 요약 6문장 읽기 → 010 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 011 18:11 ▲ 15 · 댓글 2 이미지-텍스트 모델, 속성-객체 연결 약하다 비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. AI · 머신러닝 · Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Key Point CLIP, DINOv2 등 대중적인 비전-언어 모델이 기본적인 속성 구분을 못 하는 약점을 드러냈으며, 실제 멀티모달 검색 품질 개선에 직결된다.
핵심 요약
비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. 기존 벤치마크는 모달리티 쌍, 객체 개수, 속성 유형이 제한적이어서 모델의 바인딩 능력을 제대로 평가하지 못했다. 연구팀은 4가지 이미지-텍스트 모달리티 쌍, 다양한 속성 유형, 최대 10개 객체를 포함하는 SABER 벤치마크를 개발했다. 전체 요약 7문장 읽기 → 012 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 013 03:12 ▲ 12 · 댓글 1 GUI 인식 성능 대폭 개선한 GroundGUI 공개 GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. AI · 머신러닝 · GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
Key Point 자동화된 GUI 에이전트 개발의 핵심 과제인 화면 요소 인식 성능이 8B급 모델 범위에서 기존 오픈소스 접근법을 처음으로 능가했기 때문이다.
핵심 요약
GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. ScreenRef는 데스크톱, 웹, 모바일을 아우르는 586K개 GUI 스크린샷과 633K개 이상의 자연어 표현 인스턴스로 구성되며, 텍스트 인식·시각적 매칭·공간 이해·거부 시나리오 등을 포함한다. 감독학습 파인튜닝의 제한된 일반화와 강화학습의 희소 보상 문제를 해결하기 위해 Distillation-to-Reinforcement Learning(D2RL) 방법을 개발했다. 전체 요약 7문장 읽기 → 014 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 015 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 016 12:11 ▲ 11 · 댓글 2 비전-언어 모델의 공간 추론 능력 평가 벤치마크 공개 시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. AI · 머신러닝 · SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
Key Point 현재 주류 시각-언어 모델들이 보이는 공간을 읽기만 하는 수준이며, 실제 공간 추론 능력에서 심각한 격차를 보이고 있기 때문이다.
핵심 요약
시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. 182개의 실제 장면에서 3,862개 질문으로 구성되며, 정적 인식·국소 예측·전역 예측의 3단계 16가지 과제를 포함한다. 기존 벤치마크는 입력에 이미 보이는 관계를 읽는 지각 능력만 테스트하지만, SpaceCast-Bench는 장면을 구성하고 개입의 결과를 예측하는 예측적 공간 추론을 직접 평가한다. 전체 요약 6문장 읽기 → 017 12:11 ▲ 143 · 댓글 30 LLM으로 선택지 기반 의사결정 모델 만들기 기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. AI · 머신러닝 · Build your own decision model
Key Point 선택지 기반 의사결정 모델은 LLM의 효율성을 대폭 높이면서도 보정 없이는 신뢰도 점수가 실제 성능과 맞지 않는 근본 문제를 직면하게 되는데, 온도 스케일링으로 이를 해결하는 실제 구현 방법을 보여준다.
핵심 요약
기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. Decision model 방식은 A, B, C, D, E처럼 고정된 선택지만으로 출력을 제한해 단 한 번의 패스로 최고 확률 토큰을 선택한다. Qwen3-1.7B 모델을 이용해 선택지 토큰만 마스킹하는 방식으로 구현하면, CommonsenseQA 데이터셋에서 1.7B 모델 기준 정확도 59.38%를 얻는다. 전체 요약 8문장 읽기 → 018 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 019 18:30 ▲ 51 · 댓글 2 자동회귀 비디오 생성의 그래디언트 충돌 해결: SGF+ 자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. AI · 머신러닝 · SGF+: Decoupling Gradient Flows for Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 핵심 병목인 그래디언트 충돌을 단순한 파라미터 분리로 해결해 긴 비디오도 별도 학습 없이 생성할 수 있게 하는 방법론이 제시됐습니다.
핵심 요약
자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. 이러한 그래디언트 충돌이 시각적 품질과 시간적 일관성의 공동 최적화를 방해하고 있다. 연구팀은 Self Gradient Forcing Plus(SGF+)를 제안하여 컨텍스트 작성과 노이즈 제거에 별도의 파라미터를 할당하되, 인과적 어텐션을 통해 두 역할 간 상호작용을 유지한다. 전체 요약 7문장 읽기 → 020 18:33 ▲ 11 · 댓글 1 거래 알고리즘 코드 생성에 특화한 언어모델 'QuantCode' 개발 대규모 언어모델이 일반 코드 생성에는 강하지만, 자동거래 알고리즘 코드 생성은 자연어 전략을 실행 가능한 프로그램으로 정확히 변환하고 과거 데이터에서 실행해 거래를 만들어내는 고도의 전문화가 필요하다. AI · 머신러닝 · QuantCode Model: Specializing Language Models for Executable Algorithmic Trading Code
Key Point 자동거래 코드 생성이라는 전문 영역에서 언어모델을 효과적으로 적응시키는 방법과 이 과정의 실제 제약을 실증적으로 보여주며, 도메인 전문화와 일반 능력 유지 사이의 트레이드오프 문제를 구체적으로 드러낸다.
핵심 요약
대규모 언어모델이 일반 코드 생성에는 강하지만, 자동거래 알고리즘 코드 생성은 자연어 전략을 실행 가능한 프로그램으로 정확히 변환하고 과거 데이터에서 실행해 거래를 만들어내는 고도의 전문화가 필요하다. 연구팀은 거래 프레임워크 코드로 계속 학습(continued pretraining)과 검증된 요청-코드 쌍으로 감독 학습(SFT)이라는 두 가지 메커니즘을 통해 언어모델을 특화시켰다. Backtrader 전략 생성을 위한 400개 과제 벤치마크(QuantCode-Bench)와 저장소 수준의 SWE-벤치 트랙으로 평가했다. 전체 요약 9문장 읽기 → 021 18:33 ▲ 13 · 댓글 2 로봇 정책 호출 줄인 VLA 모델, 부드러운 동작 가능해졌다 Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. AI · 머신러닝 · When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
Key Point 로봇이 정책을 자주 호출할 때 발생하는 정지 구간을 없애면서도 신뢰도를 유지하는 방법이 실제 로봇에서 5배의 시간 절감을 이뤄 실용적 가치가 크다.
핵심 요약
Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. 액션 청크(action chunk)를 늘리면 정책 호출과 일시 정지를 줄일 수 있지만, 더 먼 미래를 예측하다 보니 장시간 청크 실행의 신뢰도가 떨어진다. 연구팀은 장시간 청크 내 액션 오류를 분석했고, 오류가 조작 서브스킬 간의 전환 지점에 집중되며 청크 길이에 따라 급격히 증가함을 발견했다. 전체 요약 6문장 읽기 → 022 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 023 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 024 15:11 ▲ 85 · 댓글 2 복잡한 작업도 자기 재작성으로 학습 데이터 확장 복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. AI · 머신러닝 · Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
Key Point 다양한 도구와 환경을 활용한 경험을 일반화된 학습 데이터로 변환하는 기법으로, 복잡한 작업에서 모델 성능을 대폭 끌어올릴 수 있음을 보여준다.
핵심 요약
복잡한 터미널 작업 해결을 위해 Recursive Self-Rewrite(RSR) 프레임워크를 제안했다. Qwen 3.8-27B 기반 모델이 다양한 도구와 환경에서 성공한 해법을 발견하고, 일반 환경에서 재실행 가능한 학습 데이터로 재구성한다. 플래너가 절차를 실행 가이드(runbook)로 추출하고, 비판자가 데이터 누수를 점검하며 반복 개선을 지도한다. 전체 요약 8문장 읽기 → 025 00:11 ▲ 13 · 댓글 2 종양 위원회 토론 기록으로 암 진료 AI 학습 데이터셋 공개 종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. AI · 머신러닝 · OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
Key Point 의료 AI가 단순 정보 제공을 넘어 복잡한 다학제 진료 의사결정에 얼마나 미흡한지 처음으로 실제 현장 데이터로 입증하는 벤치마크다.
핵심 요약
종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. YouTube에 공개된 종양 위원회 영상 12,534분을 전사해 611명의 환자 사례와 10개 전문 역할에 걸쳐 19,157개의 토론 턴을 수집했다. 벤치마크는 두 가지 평가 설정을 제공한다: 실제 토론 중 제기된 임상 질문에 LLM이 답하는 'SPECIALIST TURN'과, LLM이 전체 토론을 생성하고 치료 권장안·수술 계획·임상시험 매칭에 합의하는 'BOARD SIMULATION'이다. 전체 요약 7문장 읽기 → 026 03:11 ▲ 123 · 댓글 14 바운딩박스로 이미지를 픽셀 단위로 수정하는 FLUX 3 Black Forest Labs가 이미지 생성·편집 모델 FLUX 3 Image를 공개했다. AI · 머신러닝 · FLUX 3 Image
Key Point 이미지 생성 모델이 바운딩박스 기반 정밀 편집을 지원함으로써 레이아웃 제어와 픽셀 단위 수정이 가능해지며, 디자인·마케팅·콘텐츠 제작 워크플로우가 근본적으로 달라질 수 있다.
핵심 요약
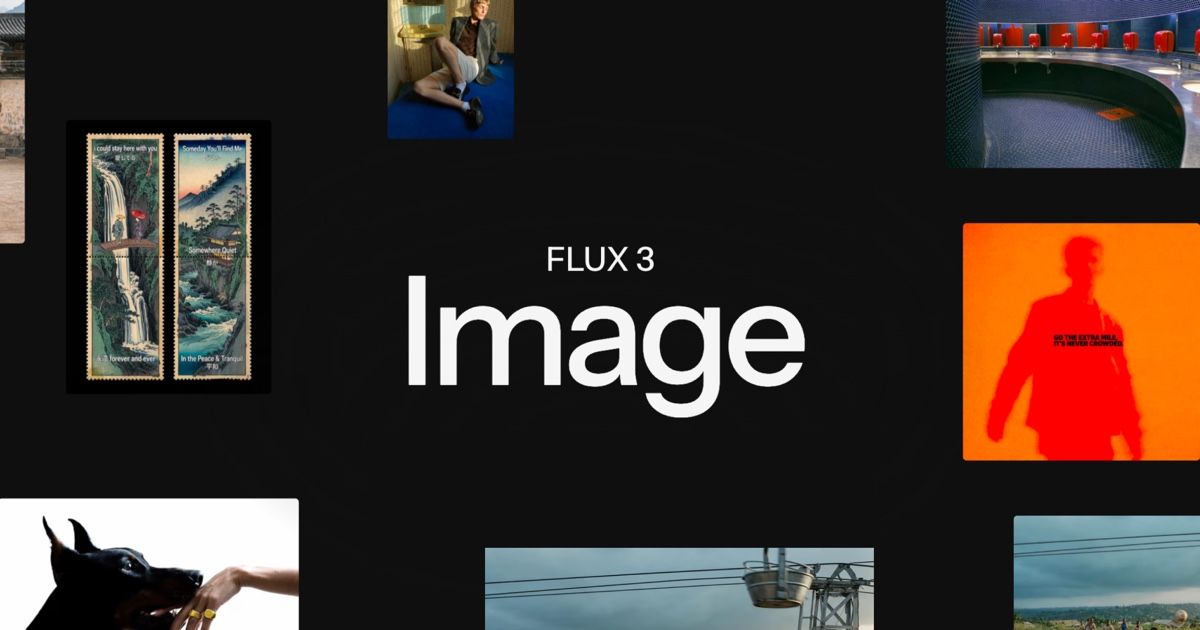
Black Forest Labs가 이미지 생성·편집 모델 FLUX 3 Image를 공개했다. 사용자가 캔버스에 바운딩박스를 그려 각 영역을 정확히 지정하고, 글로벌 캡션으로 전체 구도를 설명하면 모델이 박스 내부를 렌더링한다. 최대 4K 해상도의 네이티브 렌더링을 지원하며, 텍스처·얼굴·색상 같은 세부 사항을 보존한다. 전체 요약 9문장 읽기 → 027 15:11 ▲ 144 · 댓글 2 파일 기반 작업 에이전트 학습 데이터 자동 생성 프레임워크 GraphForge 현실적인 파일 기반 작업을 수행하는 에이전트를 학습시키려면 실제 파일을 포함한 검증 가능한 태스크가 필요하지만, 이런 데이터를 만드는 파이프라인은 거의 없다. AI · 머신러닝 · GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis
Key Point 실제 업무 시뮬레이션 기반 에이전트 학습 데이터를 자동으로 만드는 새로운 방법론으로, 에이전트 학습의 데이터 병목을 해소하는 실질적 솔루션을 제시한다.
핵심 요약
현실적인 파일 기반 작업을 수행하는 에이전트를 학습시키려면 실제 파일을 포함한 검증 가능한 태스크가 필요하지만, 이런 데이터를 만드는 파이프라인은 거의 없다. 기존 방식은 모델이 생성한 파일(현실성 부족) 또는 실제 파일 기반이지만 검증 방법이 없는 문제를 안고 있었다. GraphForge는 증거 그래프 기반 프레임워크로, 태스크와 검증을 모두 실제 파일에 고정시킨다. 전체 요약 9문장 읽기 → 028 12:11 ▲ 54 · 댓글 2 이미지 생성 AI로 GUI 상호작용 데이터 합성 GUI 에이전트 학습에는 소프트웨어 환경과의 상호작용 궤적이 필요하지만, 실제 앱을 설치·운영하면서 수집하는 방식은 비용이 많이 든다. AI · 머신러닝 · AutoGUIWorld: Image Generators as Visual World Models for GUI Agent
Key Point GUI 에이전트 학습 비용을 획기적으로 줄일 수 있는 데이터 합성 방법이 실제 환경에서 성능 향상을 입증했기 때문이다.
핵심 요약
GUI 에이전트 학습에는 소프트웨어 환경과의 상호작용 궤적이 필요하지만, 실제 앱을 설치·운영하면서 수집하는 방식은 비용이 많이 든다. AutoGUIWorld는 이미지 생성 모델과 작업 계획기를 결합해 실제 환경을 배포하지 않고도 GUI 상호작용 데이터를 자동으로 생성하는 프레임워크다. 초기 GUI 화면을 운영체제 컨텍스트·시각적 모양·인터페이스 상태로 정의한 후, 조건부 작업을 생성한다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 030 18:11 ▲ 33 · 댓글 2 LLM 학습 과정의 버려진 데이터를 재활용하는 기법 제안 대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. AI · 머신러닝 · ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
Key Point LLM 학습의 데이터 재활용 효율을 높이는 방법론으로, 기존에 버려지던 학습 경험에서 추가 성능을 뽑아낼 수 있다는 점이 실무적 가치가 크다.
핵심 요약
대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. 과거 경험은 현재 정책과 호환되면서도 더 이상 안정적으로 표현되지 않는 행동들을 보존할 수 있지만, 실수와 포기된 시도들도 함께 담고 있다. ROSS는 전체 과거 궤적을 맥락으로 유지하면서 모델이 선택적으로 생성한 부분만 손실을 적용하는 방식으로, 더 정밀한 감독 신호를 제공한다. 전체 요약 6문장 읽기 → 031 18:11 ▲ 107 · 댓글 4 텍스트 분류의 진화, Bag-of-Words부터 Jev까지 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
Key Point 15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
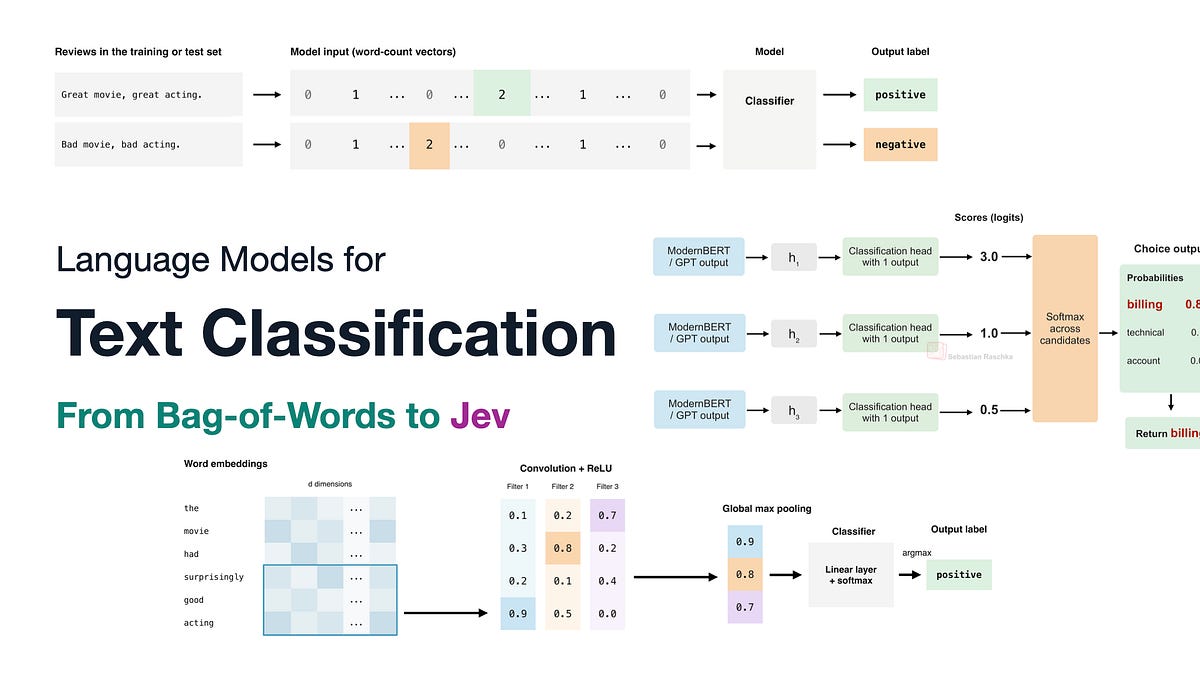
텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다. RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다. 전체 요약 11문장 읽기 → 032 15:11 ▲ 28 · 댓글 2 장시간 자율 작업 하는 AI 에이전트 '마라톤러' 공개 허깅페이스 연구팀이 수개월 이상 지속적으로 목표를 추구하는 초장기 자율 에이전트 '마라톤러'를 제시했다. AI · 머신러닝 · Marathoner: Ultra-Long-Horizon Autonomous Intelligence
Key Point AI 에이전트가 단기 작업을 넘어 수개월 규모의 복잡한 소프트웨어 개발 같은 초장기 미션을 독립적으로 수행할 수 있는 가능성을 보여주기 때문입니다.
핵심 요약
허깅페이스 연구팀이 수개월 이상 지속적으로 목표를 추구하는 초장기 자율 에이전트 '마라톤러'를 제시했다. GitHub 주요 PR에서 1000줄 이상의 새 코드를 포함한 데이터를 수집해 초장기 태스크를 합성했으며, 여러 작업을 연결한 멀티태스크 체이닝으로 최고난도 태스크를 생성했다. 강력한 교사 모델과 다양한 하니스(harness)를 조합해 거부 샘플링 파인튜닝을 수행하고, 모델이 독립 샌드박스 환경에서 실제 작업을 실행하며 1000+ 도구 호출을 처리하도록 강화학습했다. 전체 요약 6문장 읽기 → 033 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 25 · 댓글 1 문맥 학습의 약점을 공개 문서 합성으로 보완 LLM이 작업별 문맥을 이해하고 학습하는 능력이 약한데, 사람이 주석을 달아서 훈련 데이터를 만드는 것은 비용이 많이 들고 확장하기 어렵다. AI · 머신러닝 · Learning to Learn from Context: Synthetic Training from Perturbed Public Documents
Key Point 대규모 언어 모델의 문맥 학습 능력을 사람 개입 없이 개선하는 확장 가능한 방법이 제시되어, 고비용 데이터 레이블링에 의존하던 관행을 바꿀 수 있다.
핵심 요약
LLM이 작업별 문맥을 이해하고 학습하는 능력이 약한데, 사람이 주석을 달아서 훈련 데이터를 만드는 것은 비용이 많이 들고 확장하기 어렵다. 공개 문서는 풍부한 자원이지만 대부분 사전학습에 이미 포함돼 있어서, 그대로 학습하면 문맥 학습보다 암기를 유도할 수 있다. 연구팀은 공개 문서를 약간씩 수정한 뒤 3.5k개 문서에서 사람의 개입 없이 약 10k개 샘플을 자동 생성하는 파이프라인을 구축했다. 전체 요약 8문장 읽기 → 035 09:11 ▲ 205 · 댓글 66 Jeff: 0.8B 경량 분류 모델로 30ms 만에 선택지 판단 Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. AI · 머신러닝 · Jeff – Jev-compatible 0.8B decision models, trained at home, ~30 ms
Key Point 경량 모델로 30ms 안에 로컬에서 고속 분류를 수행할 수 있어, API 지연 없이 의사결정 시스템을 직접 구축해야 하는 개발자에게 즉시 활용 가능한 솔루션이다.
핵심 요약
Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. 한 번의 순전파로 각 선택지의 보정된 확률을 반환하며, RTX PRO 6000에서 22ms, Apple M4 Max에서 28ms가 소요된다. 제로샷 분류가 가능해 학습 데이터에 없는 옵션도 자연어 설명으로 판단할 수 있다. 전체 요약 14문장 읽기 → 036 00:11 ▲ 75 · 댓글 2 트랜스포머의 선형 중첩: 서로 다른 텍스트를 동시에 처리한다 LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. AI · 머신러닝 · Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
Key Point LLM이 내부적으로 여러 의미를 동시에 처리하는 선형적 구조를 가진다는 발견은 모델의 동작 방식에 대한 근본적인 이해를 바꾸며, 하나의 추론으로 여러 결과를 생성하는 효율성 개선까지 가능하게 한다.
핵심 요약
LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. 이 중첩 현상은 트랜스포머 아키텍처의 고유한 특성이며, 학습 과정 중에 오히려 감소하는 경향을 보였다. 경량 파인튜닝을 통해 선형성을 상당히 복원할 수 있으며, 예측된 다음 토큰 분포와 개별 분포의 평균 간 차이를 크게 줄일 수 있다. 전체 요약 4문장 읽기 → 037 16:18 ▲ 165 · 댓글 3 K-12 학습 전용 오픈 파운데이션 모델 'OmniEdu' 공개 100개 이상의 교육자료와 일반 명령어를 통합한 학습·교수용 오픈 파운데이션 모델 OmniEdu를 발표했다. AI · 머신러닝 · OmniEdu: Open Foundation Models for Learning and Teaching
Key Point 교육 분야 특화 오픈 파운데이션 모델이 문제풀이·교수·진단을 아우르며 실용적 성능을 달성해 K-12 학습 자동화 기반을 제시한다.
핵심 요약
100개 이상의 교육자료와 일반 명령어를 통합한 학습·교수용 오픈 파운데이션 모델 OmniEdu를 발표했다. 과목 역량, 교육과정 기반 이해, 진단 추론, 교육적 지원의 4가지 능력을 중심으로 69,999개의 학습 예제를 구성했다. 4B, 9B, 27B 규모 모델을 파인튜닝했으며, K12-Bench에서 63.12% EM·76.69% F1, MathFish 85.89%, EDUMATH 86.95%의 성능을 기록했다. 전체 요약 4문장 읽기 → 038 06:10 ▲ 122 · 댓글 63 캑터스 니들 3: 8~29MB 경량 모델이 DeepSeek V4 Flash 수준 성능 8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. AI · 머신러닝 · Show HN: Cactus Needle 3: 8-29MB automation models can match DeepSeek V4 Flash
Key Point 에지 기기 AI의 핵심 병목이던 모델 크기와 성능의 트레이드오프를 근본적으로 바꾸는 아키텍처로, 온디바이스 AI 구현이 현실화될 수 있음을 보여줍니다.
핵심 요약
8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. Laddered Simple Attention Networks 아키텍처로 같은 크기 트랜스포머 대비 토큰당 2배 적은 연산을 사용합니다. 4계층 모델을 파인튜닝하면 DeepSeek V4 Flash와 같은 성능을 내며, 라즈베리파이5에서 초당 400~4000토큰을 처리합니다. 전체 요약 6문장 읽기 → 039 21:11 당일 +247 YAML 한 줄로 LLM 학습하는 Soup, 4GB GPU에서 8B 모델 실행 Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. AI · 머신러닝 · MakazhanAlpamys/Soup · Python
Key Point 로컬 저사양 GPU에서도 대규모 언어모델을 효율적으로 학습할 수 있는 실용적인 도구로, 인프라 복잡성을 제거하고 싶은 개발자와 연구진이 참고해야 한다.
핵심 요약
Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. 레이어 스트리밍 기술로 8B 모델을 4GB 노트북 GPU에서 학습할 수 있으며, RTX 3050에서 119.6 tok/s, 3.32GB 피크 메모리로 동작한다. SSH 설정 없이 로컬 GPU에서 QLoRA로 훈련 가능하며, 배치 크기와 양자화 등을 자동으로 처리한다. 전체 요약 6문장 읽기 → 040 18:10 ▲ 101 · 댓글 76 System76, 192GB GPU 메모리 AI 워크스테이션 'Thelio Mira' 출시 System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 하드웨어 · 시스템 · Thelio Mira AI Linux Workstation: 192 GB GPU Memory
Key Point 로컬에서 대규모 AI 모델을 학습할 수 있는 고성능 GPU 워크스테이션이 등장했으며, 클라우드 비용 없이 자체 하드웨어에서 AI 개발을 완성할 수 있다는 점이 중요하다.
핵심 요약
System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 16코어 AMD Ryzen 9000 시리즈 CPU, 192GB DDR5 RAM, 듀얼 NVIDIA RTX Pro 6000 GPU로 총 192GB GPU 메모리를 지원한다. 액체 냉각, 빠른 내부 접근성, 미국 덴버에서 제조되는 오픈소스 하드웨어이다. 전체 요약 6문장 읽기 →