텍스트 분류의 진화, Bag-of-Words부터 Jev까지
원제 Language models for text classification: From bag-of-words to Jev
107 포인트댓글 4
Key Point
15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
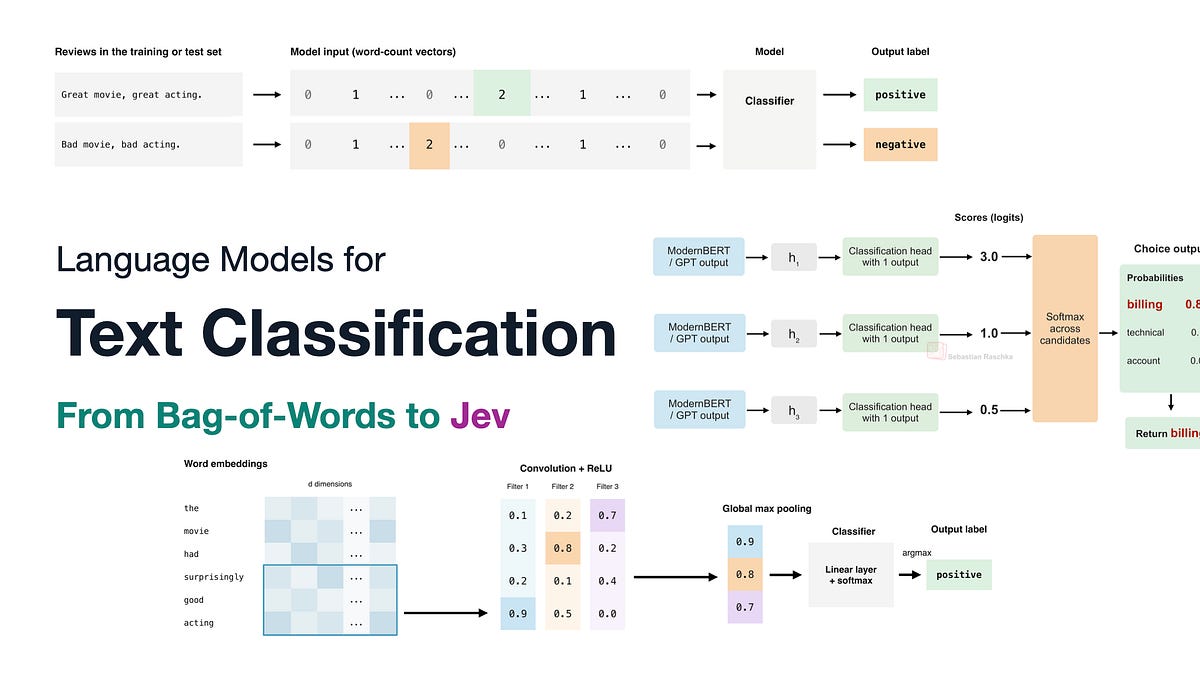
- 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다.
- Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다.
- RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다.
- CNN도 텍스트 분류에 사용 가능하며, 인접한 단어 임베딩에 필터를 적용해 병렬 처리 이점을 얻는다. IMDb 데이터셋에서 약 90% 정확도를 기록했다.
- Transformer 기반의 BERT 같은 인코더 모델은 분류 토큰을 활용해 자연스럽게 텍스트 분류에 적합하며, ModernBERT는 미미한 파인튜닝으로 95% 정확도를 달성한다.
- GPT 같은 디코더 스타일 LLM도 출력층을 분류 헤드로 교체하거나 텍스트-투-텍스트 방식으로 분류할 수 있다. GPT-2(124M 파라미터)는 IMDb에서 92% 정확도를 기록했다.
- T5 같은 인코더-디코더 모델도 분류 헤드나 텍스트-투-텍스트 방식으로 사용 가능하며, 두 방식 모두 작동한다.
- Jev는 TypeSafe AI가 최근 출시한 텍스트 분류 모델로, GPT-5.6 Luna와 동등한 성능을 제공하면서도 속도와 비용에서 우월하다.
- Jev의 강점은 맞춤 파인튜닝 없이도 다양한 텍스트 분류 작업을 저렴하게 처리할 수 있다는 점이며, 창립자들은 '보정된 결정을 위한 강화학습'으로 훈련했다고 밝혔다.
- Jev가 큰 관심을 받는 이유는 2022년 ChatGPT의 등장처럼 분류 작업의 범용 솔루션 역할을 하기 때문이며, 각 작업별 커스텀 분류기를 만들 필요가 없어진다.
- 최근 몇 주 동안 Jev의 오픈소스 클론들이 대량 출시되었으며, 현재 아키텍처와 정확한 훈련 알고리즘에 대해 공개된 정보는 많지 않다.