쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
79건 · "Transformer"조건 지우기 ×
001 00:11 새 버전 Hugging Face Transformers v5.23.0 출시, 멀티모달 모델과 모델 변환 기능 강화 Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. AI · 머신러닝 · huggingface/transformers@v5.23.0
Key Point 대규모 언어모델의 실제 배포와 추론 속도가 핵심인 만큼, 다양한 하드웨어 백엔드에서 일관된 방식으로 모델을 최적화·공유할 수 있는 Exporters 기능 통일과 OpenVINO 융합으로 최대 7.6배 성능 향상이 개발자 생산성과 프로덕션 배포 효율을 크게 바꾼다.
핵심 요약
Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. 모델 변환(Exporters) 기능 완전 개편: 모든 내보내기는 ExportedModel을 반환하여 원본 모델과 동일한 인터페이스로 호출하고, Dynamo·ONNX Runtime·OpenVINO·ExecuTorch 백엔드를 통합 관리한다. 성능 개선: OpenVINO 백엔드는 어텐션·RoPE·MoE 연산을 융합하여 디코딩 속도를 2.4~3.9배 가속하며, ONNX Runtime은 A100에서 eager PyTorch보다 7.6배, torch.compile보다 1.4배 빠르다. 전체 요약 9문장 읽기 → 002 21:11 ▲ 13 · 댓글 3 하이브리드 어텐션으로 텍스트-이미지 동시 이해·생성하는 유니스파크 UniSpark-9B는 시각 이해와 생성을 위해 하이브리드 어텐션을 조사하는 통합 멀티모달 모델이다. AI · 머신러닝 · UniSpark: Exploring Hybrid Attention for Multimodal Understanding and Generation
Key Point 텍스트 생성과 이미지 생성을 동시에 처리하는 통합 모델의 새로운 아키텍처 접근법으로, 다양한 멀티모달 작업에서 하이브리드 어텐션의 효과를 검증한다.
핵심 요약
UniSpark-9B는 시각 이해와 생성을 위해 하이브리드 어텐션을 조사하는 통합 멀티모달 모델이다. 각 브랜치에 약 9B 파라미터를 가진 Mixture-of-Transformer-Experts 백본을 기반으로 하며, 명시적 토큰 상호작용을 위한 전체 어텐션과 컨텍스트 전파를 위한 GatedDeltaNet 선형 어텐션을 결합한다. 자동회귀 텍스트 예측과 시각 흐름 매칭이 시각 질문 응답, 텍스트-이미지 생성, 지시 기반 편집, 인터리브 텍스트-이미지 예측을 지원한다. 전체 요약 8문장 읽기 → 003 21:11 당일 +113 오픈AI 음성 인식 모델 Whisper, 깃허브 트렌딩 OpenAI가 공개한 Whisper는 대규모 약지도 학습으로 학습된 범용 음성 인식 모델이다. 오픈소스 · 도구 · openai/whisper · Python
Key Point 음성 인식이 필요한 개발자라면 오픈소스로 무료 사용할 수 있는 Whisper의 다양한 모델과 다국어 지원, 구체적인 성능 지표를 파악하는 것이 중요하다.
핵심 요약
OpenAI가 공개한 Whisper는 대규모 약지도 학습으로 학습된 범용 음성 인식 모델이다. Transformer 시퀀스-투-시퀀스 구조를 사용하며 다국어 음성 인식, 음성 번역, 언어 식별, 음성 활동 감지 등 여러 음성 처리 작업을 동시에 수행할 수 있다. 특수 토큰을 사용한 멀티태스크 학습 방식으로 전통적인 음성 처리 파이프라인의 여러 단계를 하나의 모델로 통합한다. 전체 요약 10문장 읽기 → 004 18:12 ▲ 39 · 댓글 2 딥러닝 하나로 추천 순위 정렬부터 다채널 조합까지 산업용 추천 시스템에서 후보 점수 매기기 이후 최종 노출 목록을 조립하는 재정렬과 다채널 혼합(상품, 쇼츠, 라이브, 광고 카드)을 손수 작성한 규칙과 저용량 전문 모델로 처리했던 방식의 한계를 지적했다. AI · 머신러닝 · OneTrans-GSR: A Generative Slate Ranking Paradigm Unifying Reranking and Mix-Ranking with One Autoregressive Transformer
Key Point 추천 시스템의 최종 노출 목록을 생성하는 방식을 손수 작성한 규칙에서 통합 생성형 모델로 전환함으로써 거래액과 효율을 동시에 높이는 실제 성과를 보였기 때문이다.
핵심 요약
산업용 추천 시스템에서 후보 점수 매기기 이후 최종 노출 목록을 조립하는 재정렬과 다채널 혼합(상품, 쇼츠, 라이브, 광고 카드)을 손수 작성한 규칙과 저용량 전문 모델로 처리했던 방식의 한계를 지적했다. 기존 방식은 도메인 지식을 담고 있지만 추가 데이터와 연산 활용이 제한적이고, 후보 조합 공간을 제약하며, 목표 균형을 수동 조정으로 결정한다는 문제가 있다. OneTrans-GSR은 재정렬과 혼합 정렬을 통합한 학습 문제로 재정의한 단일 디코더 기반 정책으로, 전체 목록(slate)을 생성형 방식으로 끝까지 만든다. 전체 요약 7문장 읽기 → 005 21:11 ▲ 22 · 댓글 2 상대 위치 어텐션, 구조 인식 커널로 속도·메모리 대폭 개선 RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. AI · 머신러닝 · Fast and Exact Relative-Position Attention via Structure-Aware Kernels
Key Point 상대 위치 어텐션이 RoPE 대비 유리한 도메인에서 길이 확장성의 근본적 병목을 해결함으로써, 오디오·장문맥 처리에서 Transformer 적용 범위를 크게 확대할 수 있다.
핵심 요약
RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. 이 논문은 FlashAttention 스타일의 타일 기반 연산에 상대 위치 항을 정확히 통합하는 새로운 알고리즘을 제안한다. 오프셋 인식 타일링으로 중복 인덱싱을 제거하고, 키-쿼리 관계 연산을 필요한 만큼만 계산해 토큰 쌍 간에 재사용한다. 전체 요약 7문장 읽기 → 006 18:15 ▲ 12 · 댓글 8 선형 어텐션의 게이팅과 읽기 방식을 개선한 Muir 제안 선형 어텐션은 맥락을 고정 크기의 키-값 상태로 압축해 선형 시간 학습과 상수 메모리 추론을 가능하게 한다. AI · 머신러닝 · Muir: Linear Attention with Sensitivity-Allocated Gating and Matched-Filter Readout
Key Point 선형 어텐션의 상태 업데이트 민감도 비대칭을 처음 분석하고 이를 바탕으로 설계한 Muir가 Transformer와 최신 모델을 능가하는 성능을 달성했으며, 수백만 토큰 외삽까지 안정적으로 동작해 장문맥 모델의 새로운 방향을 제시한다.
핵심 요약
선형 어텐션은 맥락을 고정 크기의 키-값 상태로 압축해 선형 시간 학습과 상수 메모리 추론을 가능하게 한다. 기존 Gated DeltaNet-2(GDN-2)는 채널별 감쇠와 분리된 전체 계수 지우기·쓰기 게이트를 사용하는데, 저자들은 상태 업데이트가 쓰기보다 지우기에 훨씬 덜 민감함을 발견했다. 키 활성화와 단위 정규화가 키 에너지를 채널의 희소 부분집합에 집중시키는 반면, 값 쓰기는 모든 채널을 스케일링하므로 지우기 게이트는 더 낮은 계수로 매개변수화될 수 있다. 전체 요약 10문장 읽기 → 007 06:11 ▲ 221 · 댓글 122 마이크로소프트 AI 프론티어 그룹 해체, 연구자들 대거 이탈 2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI · 머신러닝 · The end of Microsoft Research's AI Frontiers group
Key Point 마이크로소프트 AI 조직 내 연구 철학의 근본적 충돌로 핵심 인재가 이탈하는 상황은 기업 AI 연구의 방향성, 기초 연구와 스케일링 사이의 우선순위 논쟁을 보여줍니다.
핵심 요약
2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI Frontiers는 MSR 전체가 사용하는 모노레포를 만들어 모델 개발 파이프라인을 공유하는 등 조직 전체와 협업했으나, 9월 초 마이크로소프트 AI(MAI)로 재편성되었다. MAI의 전직 인플렉션 리더십은 연구보다 스케일링(대규모 데이터와 모델 크기 증가)에만 집중하는 철학을 고수하고 있어, 기초 연구에 초점을 둔 AI Frontiers와 방향이 충돌했다. 전체 요약 6문장 읽기 → 008 06:11 ▲ 11 · 댓글 2 루프 트랜스포머를 위한 초저비트 KV 캐시 양자화 기술 LoopVQ 루프 트랜스포머는 동일한 레이어를 여러 번 재적용해 매개변수 효율성을 높이면서도 표준 트랜스포머 성능을 유지하는 아키텍처다. AI · 머신러닝 · LoopVQ: Sub 1-bit KV Cache Quantization for Looped Transformers
Key Point 루프 트랜스포머는 파라미터 효율성이 뛰어나지만 KV 캐시 메모리가 주요 병목인데, 0.5비트 수준의 극저비트 양자화로 추론 처리량을 6배까지 늘릴 수 있음을 보여준다.
핵심 요약
루프 트랜스포머는 동일한 레이어를 여러 번 재적용해 매개변수 효율성을 높이면서도 표준 트랜스포머 성능을 유지하는 아키텍처다. 하지만 루프의 각 단계마다 고유한 KV 캐시를 저장하므로, KV 캐시가 루프 단계 수에 따라 선형 증가하며 메모리 병목이 된다. 연구진은 루프 모델의 KV 캐시가 루프 축을 따라 높은 중복성을 가지며, 루프 단계별로 양자화 민감도가 크게 다름을 발견했다. 전체 요약 7문장 읽기 → 009 03:11 새 버전 Transformers v5.22.2 패치 공개 Hugging Face의 Transformers 라이브러리 v5.22.2 패치 버전이 공개됐다. AI · 머신러닝 · huggingface/transformers@v5.22.2
Key Point Transformers는 NLP 모델 개발의 필수 라이브러리로, 보안 취약점 개선과 분산 처리 버그 수정이 실제 모델 학습 환경에 영향을 미친다.
핵심 요약
Hugging Face의 Transformers 라이브러리 v5.22.2 패치 버전이 공개됐다. 보안과 분산 처리 관련 수정사항이 포함된 중간 패치 릴리스다. NCCL 분산 학습에서 device_id 설정을 개선했다. 전체 요약 4문장 읽기 → 010 18:11 ▲ 44 · 댓글 1 멀티태스크 이미지 생성 모델 'WeLM-Image' 공개, 단일 GPU 최적화 WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. AI · 머신러닝 · WeLM-Image: A Unified Image Generation Model towards Visual Intelligence
Key Point 단일 GPU에서 텍스트 생성·이미지 편집·참조 합성을 모두 수행하는 통합 모델이 나왔으며, 기존 오픈소스 경쟁 모델보다 벤치마크에서 앞선 성능을 보여준다.
핵심 요약
WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. 위챗 대규모 소비자 애플리케이션을 위해 단일 GPU 배포용으로 설계되었으며, 텍스트·참조 이미지·타겟 잠재변수를 하나의 인터리빙 시퀀스로 처리한다. Mixture-of-Transformers(MoT) 백본이 공유 어텐션과 독립적 이해·생성 파라미터를 결합하여 최적화 간섭을 제한한다. 전체 요약 9문장 읽기 → 011 12:54 ▲ 11 · 댓글 2 루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현 Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT
Key Point 작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다. 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다. 전체 요약 9문장 읽기 → 012 21:11 당일 +245 마이크로소프트, 음성 AI 모델 제품군 VibeVoice 공개 마이크로소프트가 오픈소스 음성 AI 모델 패밀리 VibeVoice를 공개했으며, 음성 인식(ASR)과 음성 합성(TTS) 모두 지원한다. AI · 머신러닝 · microsoft/VibeVoice · Python
Key Point 음성 인식·합성을 통합한 장시간 음성 처리의 새로운 기준을 제시하며, CPU 기반 엣지 배포부터 클라우드 추론까지 다양한 환경에서 실무 적용 가능성을 높인 기술이다.
핵심 요약
마이크로소프트가 오픈소스 음성 AI 모델 패밀리 VibeVoice를 공개했으며, 음성 인식(ASR)과 음성 합성(TTS) 모두 지원한다. 핵심 기술은 7.5Hz 초저속도의 연속 음성 토크나이저(Acoustic, Semantic)를 사용해 음질을 보존하면서도 긴 시퀀스 처리 효율을 높인다. VibeVoice-ASR은 60분 길이의 음성을 한 번에 처리하며, 화자 식별, 타임스탐프, 내용을 포함한 구조화된 전사를 생성한다. 전체 요약 11문장 읽기 → 013 15:11 ▲ 18 · 댓글 3 반복 최적화하는 3D 구조 재구성 모델 'Solv3R' 공개 기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. AI · 머신러닝 · Solv3R: 3D Looped Transformer as a Multi-view Solver
Key Point 카메라 포즈 추정과 3D 기하 재구성을 점진적으로 개선하는 방식을 학습 가능한 솔버로 통합해, 새로운 이미지 추가나 기존 결과 정제가 자유로워졌다.
핵심 요약
기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. Solv3R은 반복 루프 구조로 현재 상태에서부터 계속 3D 기하를 풀어나가는 루프 변환기(looped transformer)이며, 이미 정제된 뷰와 새로 추가된 뷰를 함께 업데이트할 수 있다. 업데이트 연산자가 반복 횟수와 독립적으로 작동하므로, 각 뷰가 얼마나 정확한지와 관계없이 동일하게 처리된다. 전체 요약 6문장 읽기 → 014 06:11 ▲ 113 · 댓글 41 Ripple-65B, 에이전트 코딩 성능 오픈웨이트 최강자로 미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. AI · 머신러닝 · Ripple-65B Preview: U.S. Open-Weight SOTA on Agentic Coding
Key Point 미국 오픈웨이트 최고 성능을 3,200만 달러라는 파격적 저비용으로 달성한 효율성 최적화 방법론이 향후 대규모 언어 모델 개발의 새로운 기준을 제시할 수 있기 때문이다.
핵심 요약
미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. Ripple-65B는 12조 개의 토큰으로 사전학습되었으며 최대 100만 토큰의 컨텍스트 길이를 지원한다. TerminalBench 2.1에서 80.52점으로 미국 오픈웨이트 SOTA를 달성했으며, Reflection Beam 501B(80.1), Meta Muse Spark Open 816B(76.4), Thinking Machines Inkling 975B(63.8) 등 훨씬 큰 모델들을 능가한다. 전체 요약 12문장 읽기 → 015 00:11 ▲ 10 · 댓글 1 트랜스포머 레이어 동적 순서 재구성으로 효율성·제어성 높인다 연구팀은 기존 언어 모델처럼 고정된 레이어 순서로 실행하는 대신, 추론 시 동적으로 레이어 순서를 재배열하는 Library of Layers(LoL) 아키텍처를 제안했다. AI · 머신러닝 · Library of Layers (LoL): Adaptively Ordering Transformer Layers at Runtime
Key Point 프로그래머가 같은 명령을 다른 순서로 조합하듯, 트랜스포머도 레이어 순서를 문제별로 동적 선택하면 파라미터와 연산량을 동시에 절약하면서 더 해석 가능한 모델을 만들 수 있다는 점이 중요하다.
핵심 요약
연구팀은 기존 언어 모델처럼 고정된 레이어 순서로 실행하는 대신, 추론 시 동적으로 레이어 순서를 재배열하는 Library of Layers(LoL) 아키텍처를 제안했다. LoL은 트랜스포머 블록의 글로벌 라이브러리 크기 하나의 하이퍼파라미터로 조절하면서 파라미터 재사용과 희소성 사이를 자유롭게 전환할 수 있다. 이를 통해 기존의 밀집 아키텍처, 깊이-순환 모델, 혼합 전문가(MoE) 아키텍처의 파라미터 효율성과 연산량 효율성 트레이드오프를 하나의 통합 체계 안에서 일반화한다. 전체 요약 8문장 읽기 → 016 00:11 ▲ 18 · 댓글 1 Blackwell GPU용 저정밀도 Attention 커널 FLAMIA 공개 NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. AI · 머신러닝 · FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
Key Point Transformer 학습의 가장 비용이 높은 부분인 Attention 연산을 최신 Blackwell GPU의 저정밀도 연산으로 1.1~1.4배 빠르게 만드는 기법이 개발되어, 대규모 모델 학습 효율에 직접적인 영향을 미칠 수 있다.
핵심 요약
NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. 양자화 오버헤드, 공유 스케일을 통한 인과 정보 누출, 정방향과 역방향 계산 간 수치 불일치 등 세 가지 주요 문제를 해결했다. MXFP8과 혼합 NVFP4/FP8 학습 경로를 지원하며, 토큰-블록 스케일링으로 양자화된 피연산자를 행렬 방향 간에 재사용한다. 전체 요약 8문장 읽기 → 017 15:11 ▲ 22 · 댓글 2 모달리티 넘나드는 임베딩 모델, 통합 프레임워크로 재정의 이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. AI · 머신러닝 · From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
Key Point 멀티모달 AI의 핵심 기술인 임베딩의 분산된 연구를 처음 통합 프레임워크로 정리해, 앞으로의 모달리티 간 통합 기술 발전 방향을 가늠할 수 있습니다.
핵심 요약
이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. 논문은 멀티모달 임베딩의 진화 경로를 세 가지 진행 단계로 정의한다: 커버리지 확대, 비교 가능성 확보, 구성성 달성이다. 각 단계를 위한 통합 방안으로 변환(transformation)은 모달리티 간 커버리지를 확대하고, 정렬(alignment)은 서로 다른 모달리티를 비교 가능하게 만든다. 전체 요약 6문장 읽기 → 018 00:11 ▲ 118 · 댓글 35 DOOM 게임 엔진으로 신경망 돌리기, 정확성 검증까지 DOOM 게임 엔진의 엔티티(voodoo dolls)와 맵 기하학을 이용해 신경망을 실제로 실행하는 프로젝트를 공개했다. 오픈소스 · 도구 · Show HN: I Turned DOOM into a Transformer
Key Point 게임 엔진 자체가 컴퓨팅 플랫폼이 될 수 있음을 보여주며, DOOM처럼 오래된 시스템에서도 복잡한 계산을 실행하고 검증할 수 있다는 점이 기술적 호기심을 자극한다.
핵심 요약
DOOM 게임 엔진의 엔티티(voodoo dolls)와 맵 기하학을 이용해 신경망을 실제로 실행하는 프로젝트를 공개했다. 신경망의 모든 값을 NumPy와 비교 검증하며 오차 허용도를 0으로 설정해 정확성을 보장한다. MNIST 손글씨 인식 네트워크는 10,000개 테스트 이미지 중 9,716개(97.16%)를 정확히 인식한다. 전체 요약 10문장 읽기 → 019 18:11 ▲ 24 · 댓글 6 이미지 생성 Transformer의 효율성을 높이는 다중 슬롯 토크나이제이션 픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. AI · 머신러닝 · Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
Key Point 이미지 생성 모델의 전역 어텐션 비용과 생성 품질 간 트레이드오프를 주파수 대역 분리로 해결하는 새로운 접근으로, 적은 계산량에서 고품질 이미지를 생성할 수 있는 구조를 제시한다.
핵심 요약
픽셀 공간 생성 Transformer는 이미지 패치마다 하나의 토큰을 사용하므로 세부 디테일을 캡처하려면 토큰 수가 증가해 전역 어텐션 비용이 커진다. 저주파 구조는 전역 정보 교환이 필요하지만 고주파 디테일은 지역적으로만 모델링되면 되는 점에 착안해 SpecSlot을 제안했다. SpecSlot은 각 공간 앵커를 여러 슬롯으로 확장하고 각 슬롯에 서로 겹치지 않는 DCT 계수 대역을 할당한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 021 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 022 18:11 새 버전 Transformers v5.21.1 릴리스, rope_scaling 버그 수정 Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. 오픈소스 · 도구 · huggingface/transformers@v5.21.1
Key Point vLLM 등 Transformers를 의존하는 라이브러리의 원격 코드 로딩이 v5.21.0에서 깨졌으므로, 이미 업그레이드한 사용자는 즉시 패치버전으로 업데이트해야 한다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. v5.21.0에서 rope_scaling setter 설정 과정에서 원격 코드 로딩이 손상되어 vLLM 호환성이 깨지는 이슈가 발생했다. 이번 패치에서 init 중에 rope_scaling을 할당하는 설정의 rope_scaling setter를 수정했다. 전체 요약 4문장 읽기 → 023 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 024 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 025 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 026 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 027 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 028 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 029 03:11 새 버전 Transformers 5.20.2 패치: 멀티모달 모델 입력 타입 버그 수정 Transformers 5.20.2 패치 버전이 릴리스됐다. AI · 머신러닝 · huggingface/transformers@v5.20.2
Key Point 멀티모달 모델과 대규모 분산학습 환경에서 발생하는 핵심 버그들이 수정되어 Transformers 라이브러리를 사용하는 개발자라면 즉시 업그레이드를 고려해야 한다.
핵심 요약
Transformers 5.20.2 패치 버전이 릴리스됐다. prepare_inputs_for_generation 함수에서 입력값이 원래 타입을 잃어 멀티모달 모델에 문제를 일으키던 버그를 수정했다. 또한 입력 딕셔너리 캐스팅 문제를 해결했으며, bfloat16과 전문가 병렬처리(expert parallelism)에서 ep_size < fsdp_size 조건일 때 제로 그래디언트 문제를 수정했다. 전체 요약 4문장 읽기 → 030 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 031 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 032 15:11 ▲ 43 · 댓글 3 로봇 행동 예측 AI, 시각 정보 처리 30배 효율화 기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. AI · 머신러닝 · BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
Key Point 로봇 행동 모델의 계산 효율을 대폭 개선하면서 성능은 유지하는 기술로, 로봇 제어 AI의 실시간성과 비용 효율성을 높이는 방향을 제시한다.
핵심 요약
기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. BridgeWAM은 시각·언어·고유감각 정보를 32개의 Latent Bridge Queries(LBQs)를 통해 제한된 공유 잠재 공간으로 집약하는 Bridge-of-Experts 구조를 도입했다. 행동 예측 그래디언트가 비디오 전문가를 행동 예측에 적합한 표현으로 유도하고, 행동 전문가는 교차 주의를 통해 작업 관련 정보를 선택적으로 검색한다. 전체 요약 7문장 읽기 → 033 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 034 00:11 새 버전 Transformers v5.20.1 출시, Beam 모델 추가 및 버그 수정 Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. AI · 머신러닝 · huggingface/transformers@v5.20.1
Key Point 새로운 고성능 모델 Beam이 추가되고 여러 모델 호환성 및 로딩 버그가 수정되어, 기존 Transformers 사용자와 새로운 모델을 시도하려는 개발자 모두에게 영향이 있다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. Beam은 토큰 효율적인 프론티어급 모델로 코딩과 에이전트 작업에 최적화되어 있다. 자체 하드웨어, 인프라, 클라우드에서 실행할 수 있으며 특정 요구사항에 맞게 커스터마이징 가능하다. 전체 요약 6문장 읽기 → 035 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 036 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 037 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 038 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 039 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 040 21:11 당일 +362 스트리밍 3D 재구성 모델 LingBot-Map 공개 Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. AI · 머신러닝 · Robbyant/lingbot-map · Python
Key Point 실시간 카메라 입력으로 고품질 3D 장면을 20 FPS 이상 처리할 수 있는 스트리밍 재구성 모델로, SLAM 및 3D 비전 분야에서 새로운 효율성 기준을 제시한다.
핵심 요약
Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. Geometric Context Transformer 아키텍처를 통해 좌표 정렬, 기하 신호, 드리프트 보정을 단일 스트리밍 프레임워크로 통합했으며, 앵커 컨텍스트, 포즈 참조 윈도우, 궤적 메모리를 활용한다. 518×378 해상도에서 10,000프레임 이상의 긴 시퀀스에 대해 초당 약 20프레임 속도로 안정적인 추론이 가능한 고효율 스트리밍 추론을 제공한다. 전체 요약 12문장 읽기 → 041 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 042 15:13 ▲ 38 · 댓글 2 확산 변환기의 희소 주의 문제, 훈련 없이 해결 확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. AI · 머신러닝 · MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
Key Point 긴 시퀀스 생성 작업의 병목인 희소 주의의 품질 저하 문제를 훈련 없이 근본적으로 해결해 실용적 가속을 달성했다.
핵심 요약
확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. 연구팀은 품질 저하 원인을 세 가지로 분석했다: 토큰 그룹화 제약, 부정확한 상호작용 선택, 폐기된 토큰의 주의 기여 손실이다. 이를 바탕으로 메타 캐시 희소 주의(MC-Sparse)를 제안했다. 훈련이 필요 없는 프레임워크로, 개별 키-값 토큰을 선택하면서 유사한 쿼리들을 타일 정렬 그룹으로 묶어 GPU 실행을 효율화한다. 전체 요약 6문장 읽기 → 043 18:30 ▲ 26 · 댓글 2 상태 추적을 위해 깊이를 동적으로 늘리는 변압기 Transformer는 시퀀스 길이와 무관하게 각 토큰에 고정된 깊이의 계산을 적용하지만, 상태 추적은 매 입력마다 업데이트가 필요하다. AI · 머신러닝 · Recurrent Looped Transformer
Key Point 상태 추적이 필요한 시퀀셜 태스크에서 기존 Transformer의 근본적인 약점을 지적하고, 계산 효율을 유지하면서도 장시간 시퀀스에서 정확도를 크게 높이는 아키텍처를 제시한다.
핵심 요약
Transformer는 시퀀스 길이와 무관하게 각 토큰에 고정된 깊이의 계산을 적용하지만, 상태 추적은 매 입력마다 업데이트가 필요하다. Recurrent Looped Transformer(RLT)는 병렬 인과 인코더와 반복 디코더로 레이어를 나누어 이 문제를 해결한다. 각 토큰에서 디코더가 인코더 출력과 이전 토큰의 최종 디코더 상태를 병합하므로 계산 경로가 시퀀스 길이와 함께 성장하되 토큰당 비용은 고정된다. 전체 요약 10문장 읽기 → 044 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 045 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 046 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 047 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 048 18:35 ▲ 277 · 댓글 82 역전파 없이 트랜스포머를 학습하는 'Dust' 알고리즘 등장 연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. AI · 머신러닝 · Dust: Pretraining Transformers Without Backpropagation
Key Point 역전파 없이도 대규모 언어 모델을 학습할 수 있는 첫 경쟁력 있는 방법이 등장했으며, 기존 진화 전략보다 수천 배 효율적이고 계산량이 충분하면 역전파를 능가할 가능성을 보여준다.
핵심 요약
연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. Dust는 모든 토큰에서 독립적으로 활성화를 교란하여 각 토큰을 가상 개체군 구성원으로 취급하고, 한 번의 순전파에서 수천 개의 개체군 구성원을 병렬로 평가한다. 가중치 공간 진화 전략(EGGROLL)보다 1000배~10000배 효율적이며, 100만 토큰 이상에서 이를 달성한다. 전체 요약 11문장 읽기 → 049 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 050 06:11 ▲ 25 · 댓글 3 로봇 제어를 위한 생성형 디노이징 방식 NowWAM 제안 사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. AI · 머신러닝 · Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
Key Point 기존의 영상 예측 기반 로봇 제어 방식에서 벗어나 더 효율적인 디노이징 방식이 비슷하거나 더 나은 성능을 내면서도 계산량은 절반, 추론 속도는 1.8배 빠르다는 점이 실제 로봇 응용에서 의미가 있습니다.
핵심 요약
사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. 본 논문은 사전학습된 생성형 모델이 행동 학습에 실제로 무엇을 기여하는지, 그리고 제어를 위해 어떻게 적응해야 하는지 묻는다. NowWAM은 현재 관찰을 디노이징하고 같은 시각 스트림에서 로봇 행동을 예측하는 미래-목표-자유 방식의 공동 학습 방식으로, 생성 목표를 디노이징 궤적 전체에서 행동 표현에 직접 연결한다. 전체 요약 7문장 읽기 → 051 06:11 ▲ 17 · 댓글 1 긴 동영상의 물체 추적 난제 해결한 LVMT 논문 발표 기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. AI · 머신러닝 · LVMT: Video Mask Transformer for Long-term Video Segmentation
Key Point 긴 동영상에서 물체 추적의 근본적인 한계를 해결한 새로운 구조와 학습 방법으로, 실제 응용에서 정확도와 속도의 트레이드오프를 동시에 개선했다.
핵심 요약
기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. 이 문제는 시간에 따라 어떤 물체 정보를 전파할지 선택하지 못하는 시간적 전파 메커니즘과 메모리·그래디언트 소실로 인해 긴 동영상 학습이 불가능한 탓이다. 연구팀은 경량 GRU 기반 시간적 전파 모듈을 제안해 메모리에 유지할 정보를 학습으로 선택할 수 있게 했다. 전체 요약 5문장 읽기 → 052 12:11 ▲ 67 · 댓글 2 사전학습 트랜스포머는 너무 일찍 멈춘다, 작은 LoRA로 해결 사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. AI · 머신러닝 · Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
Key Point 미세 조정 기법만으로 트랜스포머의 숨겨진 추론 능력을 200배까지 끌어낼 수 있다는 발견으로, 효율적인 모델 개선 방법을 제시한다.
핵심 요약
사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. 모든 모델 가중치를 고정한 상태에서 한 초기 계층에 rank-8 LoRA를 학습시키면 이 능력을 크게 확장할 수 있다. Qwen3-8B는 24줄 체인에서 정확도가 15.5%에서 99%로 개선되었고, 더 길게 학습된 LoRA는 50줄까지 도달했다. 전체 요약 7문장 읽기 → 053 03:11 ▲ 34 · 댓글 2 루프형 트랜스포머의 추론 효율 50% 끌어올리는 LoopCD 루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. AI · 머신러닝 · Decoding Looped Transformers Better for (Almost) Free
Key Point 루프형 트랜스포머는 추론 효율을 중시하는 모바일·엣지 환경에서 주목받는데, LoopCD로 추론 계산량을 절반 가까이 줄이면서 정확도도 높일 수 있다는 것이 중요하다.
핵심 요약
루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. 강한 예측과 약한 예측을 자동으로 쌍으로 제공하는 루프의 특성을 활용하면, 보조 모델이나 외부 학습 없이 디코딩을 개선할 수 있다. 연구진은 훈련 없는 대비학습 프레임워크 LoopCD를 제안했으며, 최종 예측을 이전 루프와 비교해 토큰 선택을 안내한다. 전체 요약 7문장 읽기 → 054 00:11 ▲ 14 · 댓글 1 이미지·영상 이해와 생성을 한 번에, 픽셀 기반 통합 모델 등장 기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. AI · 머신러닝 · PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
Key Point 인코더를 제거하고 픽셀 공간에서 직접 작동하는 통합 접근법은 시각-언어 파이프라인의 복잡도를 낮추면서도 이미지·영상 작업을 한 모델으로 처리하는 새로운 패러다임을 보여준다.
핵심 요약
기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. PixelUMM은 인코더 없이 픽셀 공간에서 이미지와 영상의 이해·생성을 통합하는 모델이다. 이미지를 공간 패치로, 영상을 시공간 튜블릿으로 표현해 원본 픽셀을 공유 백본에 단층 선형 투영으로 연결한다. 전체 요약 6문장 읽기 → 055 03:11 ▲ 40 · 댓글 2 반복 구조로 시각-언어 이해를 깊이있게 처리하는 LoopVL Loop Transformer를 시각-언어 모델로 확장한 LoopVL을 제시한다. AI · 머신러닝 · LoopVL: Recurrent Visual Intelligence
Key Point 반복 구조 기반 비전-언어 모델이 기존 방식보다 더 효율적으로 복잡한 멀티모달 추론을 처리할 수 있음을 실증적으로 보여주는 새로운 아키텍처 패러다임입니다.
핵심 요약
Loop Transformer를 시각-언어 모델로 확장한 LoopVL을 제시한다. Module-Loop와 Model-Loop 연산을 결합하여 공유 모듈을 통해 통합 시각-언어 상태를 반복적으로 업데이트한다. 언어 사전학습, 멀티모달 학습, 포스트 학습 단계를 거쳐 처음부터 훈련했다. 전체 요약 6문장 읽기 → 056 06:11 ▲ 11 · 댓글 1 루프형 트랜스포머의 단계 크기를 동적으로 조절하는 TAPS 알고리즘 순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. AI · 머신러닝 · Scheduling Recursive Reasoning in Looped Transformers
Key Point 반복적인 추론으로 정확도를 높이는 생성 모델의 효율성을 단계 크기 조절만으로 최대 56% 빠르게 만드는 실용적 기법이 핵심입니다.
핵심 요약
순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. 연구진은 터미널 손실에 대한 순환 업데이트 크기의 민감도를 분석하고, 시간 평균을 지속적 진전(persistent progress)과 중심화된 변동(centered fluctuation)의 정확한 분해식으로 도출함. 이를 바탕으로 TAPS(Trajectory Adaptive Progress-Fluctuation Scheduler)를 제안하며, 순환 업데이트 전반에서 두 요소의 균형을 추적하고 온라인으로 단계 크기를 동적 조정함. 전체 요약 6문장 읽기 → 057 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
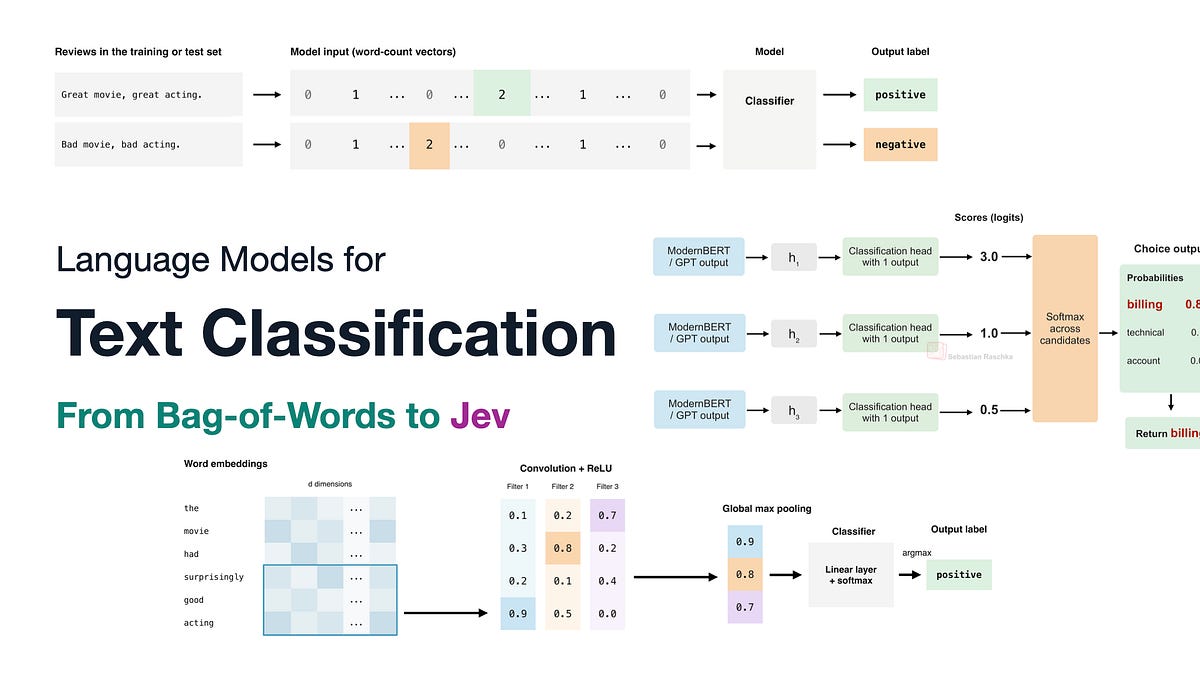
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 058 18:11 ▲ 107 · 댓글 4 텍스트 분류의 진화, Bag-of-Words부터 Jev까지 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
Key Point 15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다. RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다. 전체 요약 11문장 읽기 → 059 03:11 ▲ 118 · 댓글 2 VisionHOPE: 자기 적응 학습 비전 백본 VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. AI · 머신러닝 · VisionHOPE: Visual Backbones as Self-Modifying Learning Systems
Key Point CNN에서 Vision Transformer를 거쳐 Test-Time Training까지 진화해온 비전 백본을 자기 적응 학습 시스템으로 재구성하는 새로운 접근이 어떻게 안정성을 확보하고 실제 성능을 올렸는지 보여주는 논문이다.
핵심 요약
VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. Nested Learning의 자기참조 구조를 기반으로, 내용 저장, 키·값 표현 생성, 학습률 및 메모리 보유를 관장하는 5개의 연결된 메모리를 통해 진화를 구현한다. 직접 적용 시 불안정성이 발생하므로, 자기참조 주입에 소프트 캡을 씌우고 메모리 전환에 스펙트럼 클램프를 적용하는 단계 크기 제어 방식을 개발했으며, 이 메모리 동역학이 비확대(non-expansive)임을 증명했다. 전체 요약 6문장 읽기 → 060 00:11 ▲ 17 · 댓글 1 행렬 곱셈 대신 저비용 연산 쓰는 트랜스포머 구조 제시 기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. AI · 머신러닝 · Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
Key Point 행렬 곱셈 최적화가 아닌 완전히 다른 연산으로 대체할 때 처리량 증가 vs. 성능 저하 트레이드오프가 어떻게 나타나는지 보여주는 실험 결과이다.
핵심 요약
기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. 일반적인 행렬 곱셈을 희소한 상호작용 테이블로 대체하는 결합대수(associative algebra) 구성을 기반으로, 물리적 블록 크기가 고정되면 행렬 차원에서 이차 산술복잡도를 갖는 계층군을 구축했다. 이 구성은 Alder-Strassen 경계에 의해 쌍선형 순위(bilinear rank)에서 증명 가능하게 최적이며, 인과 마스킹(causal masking)과 KV 캐시 디코딩과 호환되는 행 타입의 직사각형 투영으로 실현할 수 있다. 전체 요약 6문장 읽기 → 061 21:11 ▲ 22 · 댓글 2 Flow Matching으로 이미지 보정 도구 제어하기 기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. AI · 머신러닝 · FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
Key Point 자동회귀 방식의 느린 추론을 벗어나 50배 빠른 이미지 보정 시스템을 구현한 새로운 접근 방식으로, 생성형 AI 기반 편집 도구의 성능과 효율성을 크게 개선할 수 있는 경로를 제시한다.
핵심 요약
기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. FlowTool은 이 문제를 Flow Matching으로 재정의하여 입력 이미지와 사용자 지시에 조건부된 고품질 편집 파라미터 분포를 직접 모델링한다. 비전-언어 모델과 Diffusion Transformer 기반 파라미터 생성기를 결합해 가우시안 잡음을 편집 계획으로 변환한다. 전체 요약 8문장 읽기 → 062 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 063 15:11 ▲ 16 · 댓글 1 멀티모달 LLM의 비전 토큰 처리를 MLP로 경량화 멀티모달 대형 언어 모델(MLLM)에서 긴 시각 토큰 시퀀스의 계산 비용을 줄이는 것이 핵심 과제이다. AI · 머신러닝 · Just MLPs: Efficient Visual State Reconstruction for Multimodal Language Models
Key Point 멀티모달 LLM의 추론 속도 병목인 시각 처리를 경량화하면서 정보 손실 없이 정확도를 유지하는 새로운 접근법이 기존 토큰 제거 방식의 한계를 극복한다.
핵심 요약
멀티모달 대형 언어 모델(MLLM)에서 긴 시각 토큰 시퀀스의 계산 비용을 줄이는 것이 핵심 과제이다. 기존 방법은 불필요한 시각 토큰을 제거하는 토큰 가지치기(pruning)를 사용하지만, 이후 층에서 유용할 수 있는 시각 정보를 영구적으로 버린다. 연구진은 저랭크 개입 분석을 통해 시각-텍스트 정보 흐름을 차단한 후 몇 가지 방향만 복구해도 대부분의 정확도가 회복됨을 발견했다. 전체 요약 8문장 읽기 → 064 15:11 ▲ 27 · 댓글 1 깊은 신경망에서 잔차 연결이 정말 효과적일까 Transformer의 깊이를 늘리면 계산 능력이 증가하지만, 깊어질수록 추가 레이어의 기여도가 감소하는 문제가 있다. AI · 머신러닝 · DepthBench: Measuring How Residual Connections Enable More Computational Depth
Key Point Transformer 모델 설계에서 깊이를 늘릴 때 어떤 구조 기법이 실제로 효과적인지를 과학적으로 증명하는 연구로, 향후 대규모 모델 개발 방향을 결정하는 기초가 될 수 있다.
핵심 요약
Transformer의 깊이를 늘리면 계산 능력이 증가하지만, 깊어질수록 추가 레이어의 기여도가 감소하는 문제가 있다. 최근 LayerNorm Scaling, mHC, AttnRes 같은 기법들이 정규화와 잔차 연결을 개선해 정보 흐름을 강화한다고 주장한다. 하지만 이런 기법들이 실제로 아키텍처 깊이를 계산상 깊이로 전환하는지, 다른 요인의 영향은 없는지 불명확하다. 전체 요약 9문장 읽기 → 065 15:11 ▲ 23 · 댓글 1 LLM 정렬을 위한 확산 기반 보상 모델 등장 기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. AI · 머신러닝 · Diffusion Reward Models
Key Point 인간의 다양한 판단 방식을 반영하는 새로운 보상 모델이 RLHF 학습에서 성능 개선을 직접 입증했기 때문에, LLM 정렬 연구에 실질적 영향을 미칠 수 있다.
핵심 요약
기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. 이를 해결하기 위해 Diffusion Reward Model(DRM)을 제안하며, 이는 보상 모델링을 조건부 밀도 추정 문제 p(r|x,y)로 재구성한다. DRM은 동결된 LLM 인코더를 기반으로 경량 Diffusion Transformer가 가우시안 노이즈를 보상 벡터로 제거(denoising)하며, 출력 분포에 대한 매개변수 가정 없이 자연스럽게 다중모달 구조를 표현한다. 전체 요약 8문장 읽기 → 066 15:11 ▲ 46 · 댓글 1 테스트 시점 스케일링 효율 높이는 적응형 루프 트랜스포머 루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. AI · 머신러닝 · Improving Test-Time Scaling with Adaptive Looped Transformers
Key Point 긴 시퀀스 생성 시 추론 효율을 크게 높일 수 있는 새로운 방법이 제시돼, 언어 모델의 테스트 시점 성능-계산량 트레이드오프를 개선하려는 연구자들에게 중요하다.
핵심 요약
루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. 기존 루프 트랜스포머는 비루프 모델 대비 정확도-계산 기울기(테스트 시 디코딩 FLOPs 두 배당 정확도 이득)가 가파르지만, 같은 계산량에서는 비루프 모델에 미치지 못한다. 고정 깊이 루핑은 모든 토큰에 추가 반복을 쓰는데, 실제로는 많은 토큰이 추가 반복의 이득을 받지 못한다는 것을 발견했다. 전체 요약 8문장 읽기 → 067 12:11 ▲ 198 · 댓글 3 음악 생성 AI의 상징과 음향 통합한 YuE2 등장 Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AI · 머신러닝 · YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
Key Point 악보라는 명시적 중간 단계를 통해 AI 음악 생성의 투명성과 편집 가능성을 확보하면서도 상용 서비스와 경쟁할 수 있는 품질을 달성했기 때문이다.
핵심 요약
Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AR-NAR Mixture-of-Transformers(MoT) 아키텍처를 사용하며, 악보로 멜로디와 화성을 지정한 뒤 의미론적 음악 토큰으로 확장해 전곡 오디오를 생성한다. 전문가 평가에서 악보 기반 계획이 49.3%의 선호도를 기록해 계획 없는 생성의 34.6%를 앞질렀으며, 음악성과 전체 품질에서 우수했다. 전체 요약 9문장 읽기 → 068 15:11 ▲ 18 · 댓글 1 로봇 조작을 위한 통합 세계 행동 모델 InternW0-Δ 공개 로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. AI · 머신러닝 · InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
Key Point 로봇 조작 분야에서 대규모 오픈 데이터와 통합 프레임워크를 통해 실용적인 성능을 달성한 방법론이 공개되는 만큼, 로봇 학습과 시뮬-투-리얼 연구에 직접 활용할 수 있는 자료다.
핵심 요약
로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. InternW0-Δ는 Mixture-of-Transformers 프레임워크로 설계되었고, 사전학습된 비디오 전문가와 행동 전문가가 고정된 VLM의 의미 지도 아래에서 상호작용한다. 사전학습된 4D 파운데이션 모델이 기하학적, 모션 사전 정보를 훈련 전용 증류로 주입하며, Causal Imprint 방식은 미래 감독 신호에서 미래 관련 장면 변화를 학습한다. 전체 요약 6문장 읽기 → 069 00:11 ▲ 75 · 댓글 2 트랜스포머의 선형 중첩: 서로 다른 텍스트를 동시에 처리한다 LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. AI · 머신러닝 · Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
Key Point LLM이 내부적으로 여러 의미를 동시에 처리하는 선형적 구조를 가진다는 발견은 모델의 동작 방식에 대한 근본적인 이해를 바꾸며, 하나의 추론으로 여러 결과를 생성하는 효율성 개선까지 가능하게 한다.
핵심 요약
LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. 이 중첩 현상은 트랜스포머 아키텍처의 고유한 특성이며, 학습 과정 중에 오히려 감소하는 경향을 보였다. 경량 파인튜닝을 통해 선형성을 상당히 복원할 수 있으며, 예측된 다음 토큰 분포와 개별 분포의 평균 간 차이를 크게 줄일 수 있다. 전체 요약 4문장 읽기 → 070 22:26 ▲ 13 · 댓글 2 기하학 구조 보존하는 Transformer 압축 기법 제시 Transformer 아키텍처의 계층 간 중복성을 활용하는 학습 없는 압축 프레임워크 GeoPair를 제안했다. AI · 머신러닝 · GeoPair: Geometry-Preserving Cross-Layer Factorization for Training-Free Transformer Compression
Key Point 계층 간 상호작용을 고려한 새로운 압축 패러다임으로, 학습 없이 추론만으로 모델 크기를 줄이는 실무적 가치가 있으며 다양한 모달리티에 적용 가능하다.
핵심 요약
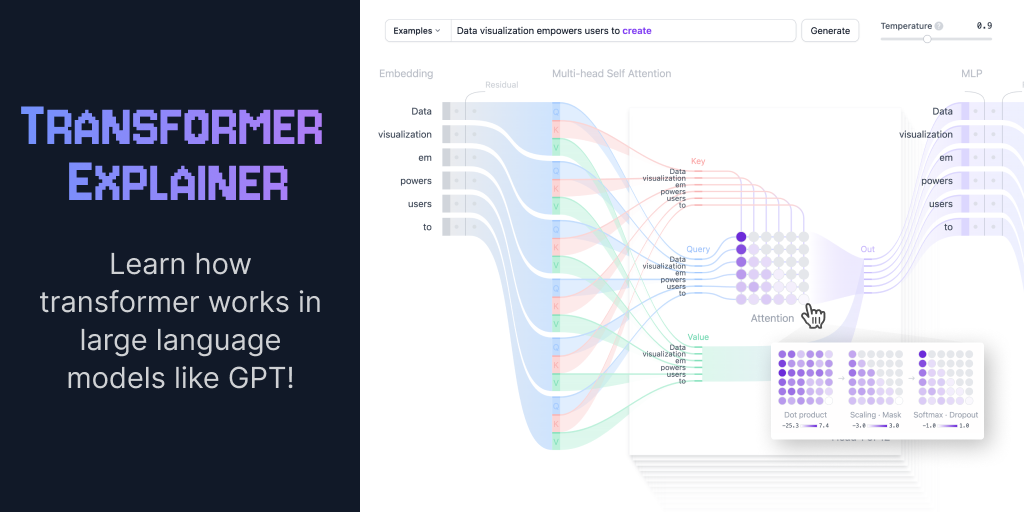
Transformer 아키텍처의 계층 간 중복성을 활용하는 학습 없는 압축 프레임워크 GeoPair를 제안했다. 기존 방식처럼 인접 계층의 가중치를 강제로 같은 기저에 공유시키거나 휴리스틱 기반 활성화 통계 병합 대신, 구조적으로 호환 가능한 사영(projection)을 찾아내는 방식을 사용한다. 각 계층의 고유한 보정 기하학(calibration geometry)을 더 잘 보존하는 공유 표현을 학습하며, 구조화된 희소성과 함께 적용하면 기능 정확도를 손상시키지 않으면서 효율적인 가중치 분해를 달성한다. 전체 요약 5문장 읽기 → 071 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 072 21:10 당일 +141 처음부터 LLM 훈련하기, 모든 코드를 PyTorch로 직접 작성 Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. AI · 머신러닝 · FareedKhan-dev/train-llm-from-scratch · Python
Key Point LLM 개발의 모든 단계를 직접 이해하고 구현하려는 개발자와 연구자에게 명확한 참고 자료가 되어준다.
핵심 요약
Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. 단일 GPU로 수백만~수십억 개 파라미터 규모의 LLM을 훈련할 수 있으며, 데이터 전처리부터 텍스트 생성까지 전체 과정을 다룬다. trl, peft, transformers 같은 외부 라이브러리 없이 모든 알고리즘을 순수 PyTorch로 구현했다. 전체 요약 5문장 읽기 → 073 08:25 당일 +195 컴퓨터 비전 개발을 빠르게, Supervision 라이브러리 Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. 오픈소스 · 도구 · roboflow/supervision · Python
Key Point 컴퓨터 비전 프로젝트의 반복적인 작업을 표준화된 도구로 통일할 수 있어, 모델 선택에 관계없이 동일한 코드로 여러 프레임워크를 활용할 수 있다.
핵심 요약
Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. Ultralytics, Transformers, MMDetection 등 인기 라이브러리와 기본 통합되며, 커스텀 모델도 손쉽게 연결할 수 있다. 데이터 로딩부터 실시간 구역 카운팅까지 컴퓨터 비전 작업의 전체 파이프라인을 지원한다. 전체 요약 5문장 읽기 → 074 00:10 ▲ 100 · 댓글 17 트랜스포머 회로 분석을 위한 수학적 프레임워크 GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. AI · 머신러닝 · A Mathematical Framework for Transformer Circuits (2021)
Key Point 대형 언어 모델의 예상 밖의 동작을 체계적으로 설명하고 안전 문제를 사전에 발견할 수 있는 기초 프레임워크를 제시하는 연구로, 모델 해석가능성 분야의 초기 이정표이다.
핵심 요약
GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. 이 논문은 트랜스포머를 역공학하기 위한 초기 단계로서, 가장 단순한 2층 이하의 어텐션 전용 모델부터 시작해 기본 알고리즘 패턴을 발견하는 것을 목표로 한다. 트랜스포머의 동작을 수학적으로 동등하면서도 새로운 관점으로 재구성함으로써, 특정 어텐션 헤드인 '귀납 헤드(induction heads)'가 인컨텍스트 학습을 설명할 수 있음을 발견했다. 전체 요약 5문장 읽기 → 075 21:11 당일 +501 트랜스포머 생태계의 중심 - Hugging Face Transformers 라이브러리 Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. AI · 머신러닝 · huggingface/transformers · Python
Key Point Transformers는 최신 AI 모델들의 표준 정의 기준이 되어 있으며, 기업과 개발자가 프로덕션 환경에서 모델을 활용할 때 필수 생태계입니다.
핵심 요약
Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. 라이브러리가 정의한 모델은 Axolotl, Unsloth, DeepSpeed 등 대부분의 학습 프레임워크와 vLLM, SGLang, TGI 같은 추론 엔진에서 호환됩니다. Hugging Face Hub에 100만 개 이상의 사전학습 모델 체크포인트가 공개되어 있어 즉시 활용 가능합니다. 전체 요약 5문장 읽기 → 076 03:10 ▲ 172 · 댓글 62 GPT-6 Astra, 루프 트랜스포머, 숨겨진 추론 메커니즘 OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. AI · 머신러닝 · GPT-6 Astra, looped transformers, and hidden reasoning
Key Point GPT-6 Astra의 구체적인 성능 향상(특히 추론과 컴퓨터 조작 능력)을 이해해야 차세대 모델의 방향을 파악할 수 있습니다.
핵심 요약
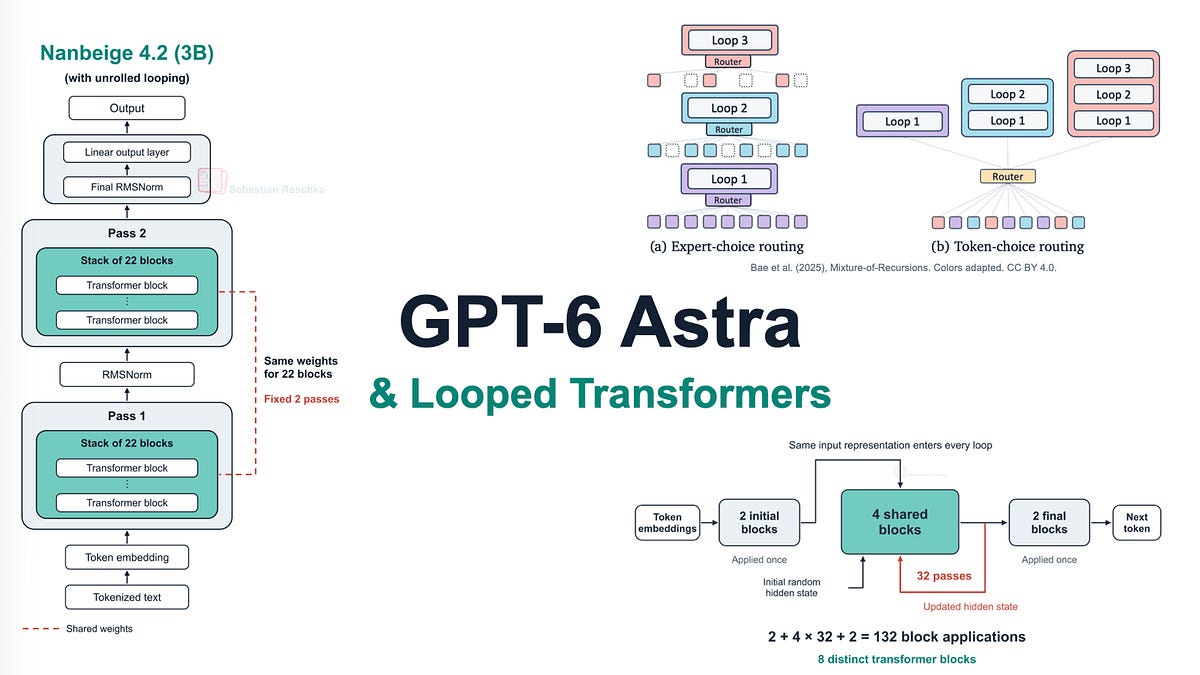
OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. 컴퓨터 사용 능력이 뛰어나 로컬 PC의 그래픽 소프트웨어(페인트, 블렌더 등)를 마우스와 UI로 직접 조작할 수 있으며, 이는 데모 영상의 시각적 임팩트로 주목받고 있다. 루프 트랜스포머(반복적 깊이) 및 숨겨진 추론 메커니즘에 대한 건축학적 루머가 있으며, 이 글은 이러한 기술 혁신과 최근 연구를 분석한다. 077 11:10 당일 +181 Open-Sora 2.0, 11B 모델로 고급 영상 생성 완전 공개 Open-Sora는 효율적인 고품질 영상 생성을 모두에게 개방하는 프로젝트이며, 3월 12일 2.0 버전(11B)을 공개했다. AI · 머신러닝 · hpcaitech/Open-Sora · Python
Key Point 고비용 영상 생성 모델 개발을 오픈소스로 완전 공개하고 학습 비용을 대폭 절감한 방법을 공개했으므로, 누구나 이 기술에 접근할 수 있게 되었다.
핵심 요약
Open-Sora는 효율적인 고품질 영상 생성을 모두에게 개방하는 프로젝트이며, 3월 12일 2.0 버전(11B)을 공개했다. 2.0의 11B 모델은 HunyuanVideo의 11B 모델, Step-Video의 30B 모델과 동등한 수준의 성능을 VBench와 사용자 선호도 평가에서 보여준다. 학습 코드와 체크포인트까지 완전 공개하며, 2억 달러 이상의 높은 학습 비용을 200만 달러 수준으로 절감했다. 전체 요약 5문장 읽기 → 078 08:12 ▲ 131 · 댓글 22 트랜스포머 모델의 어텐션 메커니즘을 시각화하다 트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. AI · 머신러닝 · Show HN: LLM Attention Visualization
Key Point LLM이 토큰을 생성할 때 어떤 과거 정보를 참고하는지 처음으로 직관적으로 볼 수 있어, 언어 모델의 동작 원리를 이해하는 데 도움이 된다.
핵심 요약
트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. 생성된 각 토큰을 클릭하면 영향을 미친 이전 토큰들이 투명도로 표시되며, 모든 어텐션 헤드와 레이어의 가중치를 집계하고 값 벡터 크기로 조정한 결과다. 예제에서 주소와 날짜처럼 그대로 복사되는 텍스트는 원본 데이터에서 높은 어텐션을 받으며, 작은 모델도 전체 함수 코드를 정확히 재현할 수 있는 이유를 보여준다. 전체 요약 5문장 읽기 → 079 00:10 ▲ 15 · 댓글 3 알리바바 Qwen 3.8 27B 공개, 로컬 모델 최고 성능 Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. AI · 머신러닝 · Qwen 3.8 27B is out: open weights, best local dense model yet
Key Point 로컬에서 구동 가능한 고성능 오픈소스 모델로, Hacker News 커뮤니티에서 배포 용이성과 벤치마크 성과에 주목받고 있다.
핵심 요약
Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. 27B 매개변수 모델로 코딩, 에이전트 작업, 멀티모달 이해 능력을 갖추고 262K 네이티브 컨텍스트를 지원한다. 터미널 코딩 벤치마크 73.0점, SWE-bench Pro 61.7점 등 기존 모델을 능가하는 성능을 보인다.