쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
12건 · "생성형AI"조건 지우기 ×
001 15:11 ▲ 29 · 댓글 2 슬라이드 생성·편집 통합 AI 모델 InfoVis 공개 Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. AI · 머신러닝 · InfoVis: Unified Slide Image Generation and Editing
Key Point 슬라이드 생성·편집에 특화된 대규모 데이터와 벤치마크 공개로, 프레젠테이션 자동화 분야에 새로운 평가 기준과 개방형 기준 모델을 제시한다.
핵심 요약
Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. 텍스트 렌더링, 명령 따르기, 시각적 접지, 미적 설계, 정밀한 편집을 한 캔버스 내에서 수행할 수 있도록 설계됐다. 연구팀은 1,300만 개의 지속 학습 기록과 190만 개의 감독 학습 기록으로 구성된 확장 가능한 데이터 엔진을 구축했다. 전체 요약 9문장 읽기 → 002 21:11 당일 +103 필터 없는 AI 이미지·영상 생성 스튜디오 오픈소스화 Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. AI · 머신러닝 · Anil-matcha/Open-Generative-AI · JavaScript
Key Point 기존 상용 AI 영상 플랫폼의 높은 구독료와 필터 제한에서 벗어나, 600개 모델로 무제한 창작이 가능한 자체 호스팅 솔루션이 등장했다는 점이 중요합니다.
핵심 요약
Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. Flux·Kling·Sora·Veo 등 주요 이미지/영상 생성 모델 200여 개를 통합하고 콘텐츠 필터나 제한 없이 사용할 수 있다. 이미지·영상·음성·입술싱크·시네마·워크플로우 등 14개 스튜디오를 포함하며, 자체 호스팅 가능하고 MIT 라이선스로 완전 무료이다. 전체 요약 10문장 읽기 → 003 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 004 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 → 005 18:11 ▲ 38 · 댓글 2 편집과 생성 작업을 위한 통합 대응점 매칭 프레임워크 FreeMatching Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. AI · 머신러닝 · Beyond Spatio-Temporal Priors: A Generalizable Approach for Dense Correspondence Matching
Key Point 생성형 AI의 이미지 편집과 참고 기반 생성 작업에서 객체 정체성을 유지하면서 변환된 이미지 간 대응점을 찾는 근본적 문제에 새로운 해법을 제시해, 콘텐츠 생성 도구의 질적 개선에 직결된다.
핵심 요약
Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. FreeMatching은 생성 모델과 의미론적 파운데이션 표현(semantic foundation representation)을 결합해, 고전 데이터셋·추적 비디오·합성 장면으로부터의 다양한 감독 신호를 활용해 정체성 보존 대응점을 학습하는 프레임워크. 교사 모델 가이드 반복 정제(teacher-guided iterative refinement) 기법을 통해 대응점 주석 없이도 IEG 작업에서 대응점 품질을 추가 개선. 전체 요약 6문장 읽기 → 006 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 007 21:11 ▲ 22 · 댓글 2 Flow Matching으로 이미지 보정 도구 제어하기 기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. AI · 머신러닝 · FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
Key Point 자동회귀 방식의 느린 추론을 벗어나 50배 빠른 이미지 보정 시스템을 구현한 새로운 접근 방식으로, 생성형 AI 기반 편집 도구의 성능과 효율성을 크게 개선할 수 있는 경로를 제시한다.
핵심 요약
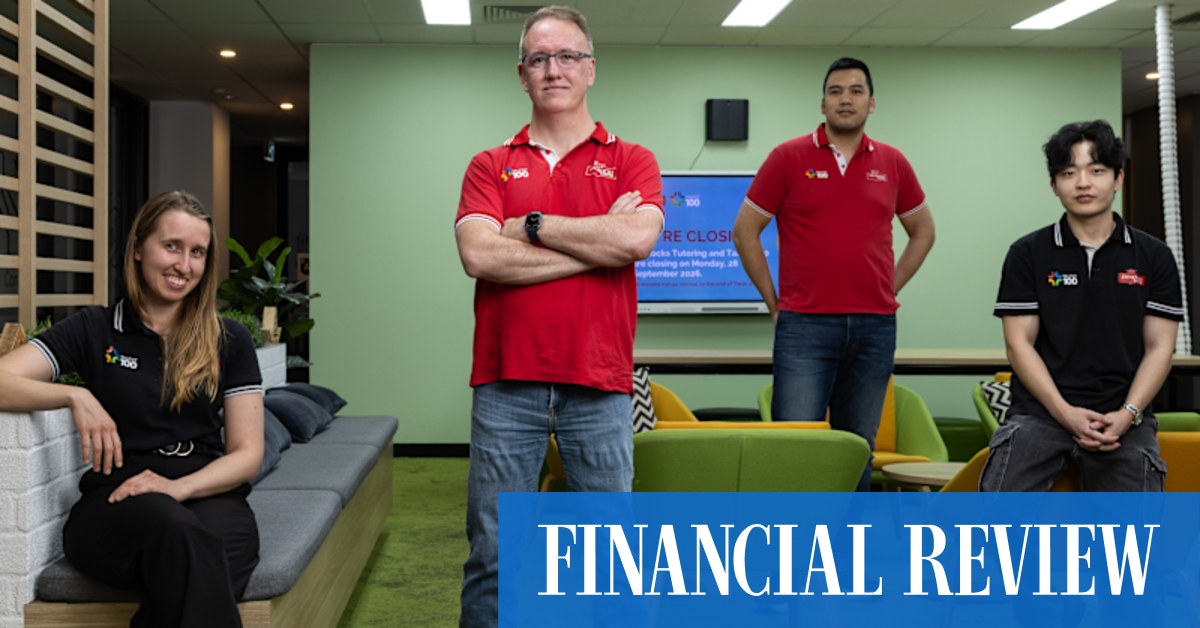
기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. FlowTool은 이 문제를 Flow Matching으로 재정의하여 입력 이미지와 사용자 지시에 조건부된 고품질 편집 파라미터 분포를 직접 모델링한다. 비전-언어 모델과 Diffusion Transformer 기반 파라미터 생성기를 결합해 가우시안 잡음을 편집 계획으로 변환한다. 전체 요약 8문장 읽기 → 008 22:26 ▲ 101 · 댓글 170 호주 과외회사 "AI 써라, 사람 과외는 돈 낭비" 호주의 Dymocks Tutoring과 Talent 100이 이번 주 말 폐업을 결정했다. AI · 머신러닝 · Tutoring company tells parents to save their money and 'use AI instead'
Key Point 교육 시장에서 AI가 인간 강사를 대체하기 시작했으며, 기업 스스로 이를 인정하고 사업을 종료하는 사례가 나타났다.
핵심 요약
호주의 Dymocks Tutoring과 Talent 100이 이번 주 말 폐업을 결정했다. 이 회사는 학부모들에게 Gemini나 ChatGPT에 투자하라며 비싼 인간 과외사를 이용할 필요가 없다고 조언했다. 학생들이 시험 준비와 즉각적인 학습 피드백을 위해 AI를 점점 더 활용하고 있다. 전체 요약 4문장 읽기 → 009 15:11 ▲ 32 · 댓글 3 이미지 생성 모델의 벡터 양자화 학습 안정성 개선 방법 자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. AI · 머신러닝 · StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
Key Point 이미지 생성 모델의 핵심 컴포넌트인 벡터 양자화의 학습 불안정성을 해결하는 실무적 방법론을 제시하므로, 생성형 AI 모델 개발자와 연구자에게 즉시 적용 가능한 지침을 제공한다.
핵심 요약
자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. 인코더-디코더와 코드북 학습이 얽혀 있어 두 모듈이 협력할 때만 작동하므로, 학습이 가중될수록 붕괴되는 취약함이 있다. StableVQ는 동적 STE를 통해 인코더의 학습 목표를 안정화하고, 리전 VQ 손실로 코드북이 독립적으로 전체 추적을 보장하며, 분리된 스케줄로 각 모듈이 별도의 학습률을 갖도록 한다. 전체 요약 5문장 읽기 → 010 08:25 ▲ 247 · 댓글 171 구글, 음성 AI 모델 제미니 3.8 라이브 공개 구글이 제미니 3.8 라이브와 3.8 라이브 익스텐디드 싱킹 두 음성 대화 모델을 발표했다. AI · 머신러닝 · Gemini 3.8 Live and 3.8 Live Extended Thinking
Key Point 음성 기반 AI 에이전트의 성능이 크게 향상되었으며, 개발자와 기업이 실시간 대화형 음성 인터페이스를 구축할 때 영향을 미친다.
핵심 요약
구글이 제미니 3.8 라이브와 3.8 라이브 익스텐디드 싱킹 두 음성 대화 모델을 발표했다. 3.8 라이브는 비용 효율성에 최적화했으며 시각 정보를 실시간으로 처리하고 97개 언어를 자동 전환한다. 3.8 라이브 익스텐디드 싱킹은 고복잡도 작업용으로, 음성 품질 지수에서 82.6점을 기록했다. 전체 요약 5문장 읽기 → 011 21:11 당일 +837 한 줄 프롬프트로 맞춤형 강의 제작…AI 에이전트 기반 교실 OpenMAIC v1.0.0은 프롬프트 하나로 강의안을 자동 생성하는 에이전트 워크벤치를 제공한다. AI · 머신러닝 · THU-MAIC/OpenMAIC · TypeScript
Key Point 교육 콘텐츠 제작 비용과 시간을 획기적으로 줄일 수 있는 방식으로, 에이전트 기반 대화형 AI가 소비 영역을 넘어 창작 도구로 확산되는 흐름을 보여준다.
핵심 요약
OpenMAIC v1.0.0은 프롬프트 하나로 강의안을 자동 생성하는 에이전트 워크벤치를 제공한다. 사용자는 채팅 방식으로 에이전트와 상호작용하며 강의안을 계획, 작성, 수정할 수 있다. 문서·음성·영상 업로드와 웹 검색을 통해 수집한 자료로부터 강의를 생성한다. 전체 요약 5문장 읽기 → 012 11:10 당일 +181 Open-Sora 2.0, 11B 모델로 고급 영상 생성 완전 공개 Open-Sora는 효율적인 고품질 영상 생성을 모두에게 개방하는 프로젝트이며, 3월 12일 2.0 버전(11B)을 공개했다. AI · 머신러닝 · hpcaitech/Open-Sora · Python
Key Point 고비용 영상 생성 모델 개발을 오픈소스로 완전 공개하고 학습 비용을 대폭 절감한 방법을 공개했으므로, 누구나 이 기술에 접근할 수 있게 되었다.
핵심 요약
Open-Sora는 효율적인 고품질 영상 생성을 모두에게 개방하는 프로젝트이며, 3월 12일 2.0 버전(11B)을 공개했다. 2.0의 11B 모델은 HunyuanVideo의 11B 모델, Step-Video의 30B 모델과 동등한 수준의 성능을 VBench와 사용자 선호도 평가에서 보여준다. 학습 코드와 체크포인트까지 완전 공개하며, 2억 달러 이상의 높은 학습 비용을 200만 달러 수준으로 절감했다. 전체 요약 5문장 읽기 →