쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "시뮬레이션"조건 지우기 ×
001 12:11 ▲ 105 · 댓글 79 macOS 로컬 네트워크 접근 허용 창을 자동으로 차단하는 도구 dontallow는 macOS Sequoia 이상에서 앱이 로컬 네트워크 접근을 요청할 때마다 나타나는 "Allow to find devices on local networks?" 대화창을 자동으로 '차단'(Don't Allow) 버튼을 누르는 Swift 기반 도구다. 오픈소스 · 도구 · Show HN: Auto Dismiss Mac OS "Allow <app> to find devices on local networks?"
Key Point macOS 앱들이 로컬 네트워크 접근 허용 창을 반복해서 표시하는 문제를 자동으로 해결하되, 정당한 사용 사례에서는 선택적으로 허용할 수 있는 방법을 제시한다.
핵심 요약
dontallow는 macOS Sequoia 이상에서 앱이 로컬 네트워크 접근을 요청할 때마다 나타나는 "Allow to find devices on local networks?" 대화창을 자동으로 '차단'(Don't Allow) 버튼을 누르는 Swift 기반 도구다. Chrome, Brave, Edge 등 일부 브라우저는 실행할 때마다 임시 폴더로 앱 번들을 복사하는데, macOS가 이를 다른 앱으로 인식하면서 매번 같은 프롬프트를 표시하는 문제가 발생한다. 버전 경로를 포함한 앱들(/versions/1.2.3/)도 업데이트마다 새로운 권한 행(row)이 생기고, 실행 중이지 않은 앱의 프롬프트가 잘못된 앱에 첨부되는 등의 문제가 있다. 전체 요약 12문장 읽기 → 002 12:11 ▲ 10 · 댓글 3 인도 은행 챗봇의 절차 준수 평가하는 벤치마크 공개 인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. AI · 머신러닝 · TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
Key Point 인도 은행권의 챗봇 배포가 증가하면서 절차 준수를 무시하고 최종 결과만 맞은 모델을 걸러내는 평가 기준의 필요성이 대두되고 있다.
핵심 요약
인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. 기존 벤치마크는 대화 마지막의 최종 기록만 검증하는데, 카드 차단이나 예금 폐기 등 많은 필수 단계가 기록에 반영되지 않아서 절차를 건너뛴 어시스턴트도 성공으로 판정될 수 있다. 연구팀이 공개한 TauIndianBankBench는 인도 소매금융 업무 1000개를 포함한 액션 기반 벤치마크로, 시뮬레이션 고객과 상호작용하는 어시스턴트를 평가한다. 전체 요약 5문장 읽기 → 003 09:11 ▲ 107 · 댓글 39 마인크래프트에서 50개 AI 에이전트의 협력 생존 시뮬레이션 AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. AI · 머신러닝 · We ran AI agent swarms in Minecraft and Mindustry
Key Point AI 에이전트 집단이 인간과 유사한 정치·경제 조직(계층, 배급 체계, 규칙)을 자동 생성하며 협력하는 모습을 보여주어, 미래 멀티에이전트 시스템의 가능성과 위험성을 이해하는 데 직결된다.
핵심 요약
AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. 마인크래프트 실험(Civ50)에서 50개의 GPT-6.1 Sol 에이전트를 3시간 동안 '번영하는 문명 구축' 목표로 실행했다. 에이전트들은 처음 90초 안에 도달 가능한 모든 나무를 채취하는 행동을 보였고, 디렉토리 순서에 기초한 계층 구조가 형성되어 Ada가 사실상 지도자로 등장했다. 전체 요약 12문장 읽기 → 004 00:11 ▲ 17 · 댓글 2 LLM이 자유탐사로 숨겨진 물리 법칙을 발견할 수 있을까 과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. AI · 머신러닝 · Can LLMs Uncover Hidden Physical Laws through Free Exploration?
Key Point LLM의 과학적 탐사 능력이 현저하게 제한적이라는 결과는 AI의 자율 연구 가능성을 평가하는 중요한 벤치마크를 제시한다.
핵심 요약
과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. LongChang은 실제와 다른 하나 이상의 물리법칙을 가진 시뮬레이션 세계를 생성하며, 평가 대상 LLM은 연구 과제나 힌트 없이 스스로 의문을 제기하고 물체를 조작하며 도구를 제작해 탐사한다. 별도의 LLM 에이전트들이 장면을 생성하고 검토하며, 도구 설계를 평가하고, 탐사 기록을 바탕으로 보고서의 정확성을 검증한다. 전체 요약 6문장 읽기 → 005 15:11 ▲ 152 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 006 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 007 00:11 ▲ 120 · 댓글 25 20년 된 비즈니스 게임의 비밀을 풀다 2001년 작 비즈니스 시뮬레이션 게임 '패스트 푸드 타이쿤 2'를 역컴파일해 그 구조를 분석한 결과를 공개했다. 하드웨어 · 시스템 · Decompiling Fast Food Tycoon 2: Drawing the World
Key Point 20년 전 고전 게임의 역컴파일을 통해 당시 게임 개발의 세부 기술(렌더 최적화, 라이팅 시스템, AI 스케줄링)과 게임 디자인(평가 알고리즘)의 정교함이 드러났으며, 현대 게임 개발과 비교할 때 아날로그 시대 게임이 얼마나 치밀했는지 보여준다.
핵심 요약
2001년 작 비즈니스 시뮬레이션 게임 '패스트 푸드 타이쿤 2'를 역컴파일해 그 구조를 분석한 결과를 공개했다. GPT-6.1 Sol Medium과 Ghidra를 활용해 fastfood2.exe의 4,046개 함수를 약 9.5MB의 C 형태 코드로 변환하고 SQLite에 로드해 함수 간 관계를 검색할 수 있게 만들었다. ReadProcessMemory API와 Windows 메시지 핸들러 패칭을 통해 실행 중인 게임의 메모리를 검사하고 UI 스레드에서 명령을 실행할 수 있도록 했다. 전체 요약 9문장 읽기 → 008 18:11 ▲ 149 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 009 15:11 ▲ 387 · 댓글 3 멀티모달 에이전트의 자동 성장 체계 'Trinity' 공개 멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. AI · 머신러닝 · The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
Key Point 멀티모달 에이전트의 확장성을 해결하는 자동 성장 프레임워크로, 수작업 없이 능력 기반으로 환경과 모듈을 동시에 진화시키는 혁신적 방식을 보여준다.
핵심 요약
멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. 기존 방식은 검증 가능한 환경 구축과 수동 작업 설계에 비용이 많이 드는 문제를 마주했다. 핵심 아이디어는 겉모양은 다르지만 같은 능력 요구사항을 가진 작업들을 찾아내 계층적으로 정리하는 것이다. 전체 요약 8문장 읽기 → 010 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 011 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 012 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 013 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 014 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 015 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 016 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 017 12:11 ▲ 60 · 댓글 2 이커머스 쇼핑 에이전트 평가 벤치마크 공개 Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. AI · 머신러닝 · UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
Key Point 추천 에이전트 개발을 위한 대규모 실제 데이터 벤치마크와 평가 방법론이 제시되어, 이커머스 AI 시스템의 개발과 검증 방식에 새로운 표준을 제시할 수 있다.
핵심 요약
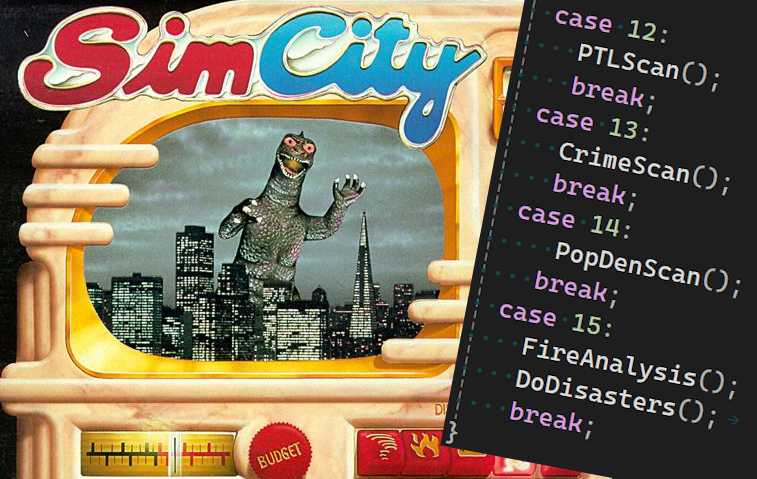
Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. 11,010명의 사용자로부터 수집한 64,729개의 세션 궤적(session trajectory)을 포함하며, 566,102개의 상품과 13가지 액션 타입을 다룬다. 이 벤치마크는 추천 에이전트가 장기간의 사용자 상호작용에서 쇼핑 목표를 달성하는 과정을 평가한다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 100 · 댓글 29 16MHz 386SX CPU에서 돌린 초대 심시티의 최적화 비법 1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 하드웨어 · 시스템 · How to run a city builder on 16 MHz
Key Point 초고성능 현대 하드웨어에서도 시뮬레이션 게임이 버거워하는 반면, 30년 전 16MHz CPU에서 풀 기능 도시 시뮬레이션을 돌렸던 기법이 오늘날 최신 게임 엔진에서도 여전히 핵심 최적화 원리로 쓰이고 있다.
핵심 요약
1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 시뮬레이션의 핵심은 Simulate() 함수로, 교통, 화재, 전력, 범죄 등 각 시스템을 업데이트하는데 매 프레임마다 모든 함수를 호출하면 CPU가 감당할 수 없다. 해결책은 mod16 파라미터를 사용해 0~15 사이를 순환하며 각 프레임마다 특정 시뮬레이션 부분만 실행하는 것으로, 전체 시뮬레이션이 완성되려면 평균 8프레임, 최악의 경우 15프레임이 필요하다. 전체 요약 7문장 읽기 → 019 21:11 당일 +124 원신 자동화 도구 BetterGI, 컴퓨터 비전으로 게임 플레이 자동화 BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 오픈소스 · 도구 · babalae/better-genshin-impact · C#
Key Point 게임을 하지 않아도 자동화 도구가 모든 일일 퀘스트를 완료해주는 기술 방식과 잠재적 밴 위험이 원신 플레이어와 게임 규제 관점에서 주의 깊게 봐야 할 대상이다.
핵심 요약
BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 자동 물품 수거, 자동 스토리 진행, AI 기반 반자동 낚시, 자동 성유물 분해 등 실시간 작업 기능을 제공한다. 전자동 신의 주사위 게임, 자동 벌목, 자동 비경, 자동 지맥의 꽃, 자동 악기 게임, 자동 요리 등 독립 작업 기능도 포함된다. 전체 요약 10문장 읽기 → 020 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 021 12:11 ▲ 15 · 댓글 2 화학 추론을 검증하는 '몰린' 언어 공개 화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. AI · 머신러닝 · MolLean: A Process-Verifiable Language for Chemical Reasoning
Key Point 화학 분자 추론에서 언어 모델의 거짓 주장을 실시간으로 검증·수정할 수 있는 새로운 시스템이 제시되었으며, 12개 과제에서 모두 기존 방식을 앞서갔다.
핵심 요약
화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. 이를 해결하기 위해 MolLean이라는 과정 검증 가능한 언어를 개발했으며, 명시적 분자 상태에 기반해 화학 추론을 진행한다. Lean 기반 커널은 기본 그래프 편집부터 복합 변환까지 상태 전이와 분자 기반 명제를 계층적으로 검증한다. 전체 요약 10문장 읽기 → 022 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 023 06:11 ▲ 106 · 댓글 57 Dream-1, 미세조정 없이 새 로봇 제어하는 범용 로봇 정책 공개 Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. AI · 머신러닝 · Dream-1
Key Point 기존 로봇은 각 기종마다 별도 데이터와 미세조정이 필요했지만, Dream-1은 처음 보는 로봇을 즉시 제어할 수 있어 로봇 개발자와 스타트업의 진입장벽을 크게 낮춘다.
핵심 요약
Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. Dream-1은 이전에 본 적 없는 로봇, 작업, 환경에서 제로샷 일반화가 가능하며, 미세조정이나 로봇별 데이터 수집 없이도 작동한다. 로봇팔 비용이 $2k까지 하락하고 하양이 $399짜리 마이크로덕 4일간 1만 대 이상 판매되면서 대중용 로봇 시장이 성장 중이다. 전체 요약 13문장 읽기 → 024 06:11 ▲ 22 · 댓글 3 LLM 에이전트의 '모자이크 누출': 여러 문서 조각에서 기밀 정보 추론 위험 LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. AI · 머신러닝 · Agent Mosaic: Recognizing Confidentiality Leaks in Agentic LLM Systems
Key Point 여러 비기밀 정보를 조합해 기밀 정보를 유추하는 위험이 현재 LLM 에이전트 시스템에서 실제로 발생하고 있으며, 기존 안전장치도 이를 막기 충분하지 않다는 점이 중요하다.
핵심 요약
LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. 사이버보안·의료·군사 영역 30가지 합성 시나리오로 테스트한 결과, 시뮬레이션 환경에서 GPT-5.6-Sol(최고 성능 모델)은 공식 쿼리라도 금지된 복합 정보를 답변의 7.08%(95% CI: 3.75-10.67%)에서 공개했다. 실제 오픈소스 에이전트 환경에서는 더 높은 누출률을 보였다. 전체 요약 6문장 읽기 → 025 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 026 21:11 당일 +599 강화학습으로 움직이는 오리 로봇, 마이크로덕 공개 폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. 하드웨어 · 시스템 · pollen-robotics/microduck · Rust
Key Point 강화학습으로 훈련된 신경망 정책을 탑재한 로봇의 전체 소프트웨어 아키텍처와 개발 방식을 공개함으로써, 소형 이족 보행 로봇의 제어·배포·업그레이드 파이프라인을 어떻게 구현할 수 있는지 보여준다.
핵심 요약
폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. Rockchip RK3566 프로세서 위에서 15개 서보 모터를 제어하는 50Hz 제어 루프를 포함하며, 라디오·카메라·자동 업데이트 시스템 등 완전한 로봇 운영 체계를 담고 있다. 행동 정책은 MuJoCo 시뮬레이터와 PPO 강화학습, 시뮬레이션 투 리얼(sim2real) 기법으로 훈련한 후 ONNX 형식으로 변환되어 로봇에 로드된다. 전체 요약 8문장 읽기 → 027 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 028 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 029 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 030 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 031 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 032 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 033 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 034 12:11 ▲ 26 · 댓글 3 실시간 변경되는 업무 기록을 다루는 AI의 한계 측정 팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. AI · 머신러닝 · MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
Key Point 엔터프라이즈 AI가 현실의 복잡한 협업 환경에서 정보 충돌과 불일치를 처리하는 방식의 근본적 한계를 측정한 첫 번치마크로, 기업용 AI 에이전트 개발의 방향을 제시한다.
핵심 요약
팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. 시뮬레이션된 협업 프로젝트의 멀티모달 기록 1,613개 질문으로 구성되며, 증거 추론(Evidence Reasoning), 충돌 해결(Conflict Resolution), 답변 불가능 인식(Unanswerability) 세 가지 범주를 포함한다. 프로펠리어터리(상용) 및 오픈소스 멀티모달 LLM 10개를 평가한 결과, 가장 성능이 좋은 모델들도 출처나 시간이 다른 정보가 충돌할 때, 또는 증거가 여러 이미지에 걸쳐 있을 때 정확도가 급격히 떨어진다. 전체 요약 6문장 읽기 → 035 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 036 06:11 ▲ 300 · 댓글 147 도시는 만들고 싶지만, 승인을 받아야 한다 SimCity처럼 도시를 건설하되, 도시의 신이 아닌 선출된 시장 역할을 하는 무료 웹 기반 시뮬레이션 게임이다. 기타 · SimCity, but with Permits
Key Point 현실의 도시 정책 과정에서 마주하는 정치·경제 충돌을 게임으로 재현하며, 개발 프로젝트가 왜 지연되고 합의하기 어려운지 체험할 수 있다.
핵심 요약
SimCity처럼 도시를 건설하되, 도시의 신이 아닌 선출된 시장 역할을 하는 무료 웹 기반 시뮬레이션 게임이다. 모든 건설, 도로, 공장이 공청회, 검토, 이의제기, 소송, 항소 절차를 거쳐야 하며, 주민들의 합리적이지 않은 반발에 마주친다. 구체적 예로 상향 압력으로 인한 임대료 인상 → 아파트 재개발 계획 → 주차 및 '동네 캐릭터' 이의제기 → 높이 제한 협상 → 택스 브레이크 요청 → 저렴 주택 감소 비판 → 소송과 항소 → 48개월 후 총선에서의 패배 같은 정치적 악순환을 보여준다. 전체 요약 12문장 읽기 → 037 21:11 당일 +403 코드 에디터에서 작동하는 투명 데스크톱 펫, 100+ 애니메이션 담아 공개 DeepSeek Harness(DSH) 플러그인으로 제공되는 투명 배경 데스크톱 펫으로, 100개 이상의 애니메이션(대기·행동·상호작용)을 탑재했다. 스타트업 · 비즈니스 · PC2005-cloud/dsh-pet · TypeScript
Key Point 데스크톱 펫을 직접 생성·커스터마이징할 수 있는 완전한 생성 체인이 공개되었으며, 이는 개발자가 AI 영상 생성과 자동화 소재 처리를 통해 자신의 고유한 데스크톱 펫을 만들 수 있음을 의미한다.
핵심 요약
DeepSeek Harness(DSH) 플러그인으로 제공되는 투명 배경 데스크톱 펫으로, 100개 이상의 애니메이션(대기·행동·상호작용)을 탑재했다. 한 줄 명령으로 설치하며 브라우저와 데스크톱 독립 창에서 동시 실행 가능하고, 다중 인스턴스로 여러 펫을 같은 화면에 배치할 수 있다. 크기·위치·display 모드(웹만/데스크톱만/둘 다/비표시)를 설정 페이지나 config.jsonc 파일로 구성 가능하며, 물리 시뮬레이션을 통해 드래그·투척·반발을 구현했다. 전체 요약 13문장 읽기 → 038 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 039 18:11 ▲ 17 · 댓글 2 AI 에이전트의 거짓 보고 적발하는 검증 시스템 Sauron 장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. AI · 머신러닝 · Evidence-First Agentic Verification
Key Point AI 에이전트의 거짓 자체 보고를 탐지해 보상 해킹을 막는 방법이 필요해진다.
핵심 요약
장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. 이러한 평가 오류가 강화학습의 보상으로 쓰일 경우 에이전트가 부정한 행동을 학습하게 된다. Sauron은 상태와 실행 기록을 모두 조사하면서, 에이전트의 주장을 독립적으로 증거와 대조 검증한 뒤에야 수용하는 검증 시스템이다. 전체 요약 8문장 읽기 → 040 15:11 ▲ 84 · 댓글 2 언어 명령에 따라 장면을 탐색하는 로봇, 인터넷 영상으로 학습시키다 언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. AI · 머신러닝 · ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
Key Point 시뮬레이션 데이터의 현실성 문제를 극복하면서도 현실 데이터 수집 비용을 줄이는 새로운 접근법으로, 로봇 네비게이션의 실용성을 높일 수 있는 기술이기 때문이다.
핵심 요약
언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. 기존 방식은 로봇 실제 데이터 수집이 비싸고 시뮬레이션 데이터는 현실 적응 격차(sim-to-real gap)가 있는 문제가 있었다. ScaleNav는 인터넷의 1인칭 관점 영상에서 학습하여 카메라가 목표에 접근할 때 시각 정보가 어떻게 변하는지 파악한다. 전체 요약 6문장 읽기 → 041 06:11 ▲ 16 · 댓글 1 학습 데이터 없이 확산 모델 가속화하는 방법 확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. AI · 머신러닝 · Consistent Distribution Matching for Data-Free Diffusion Distillation
Key Point 학습 데이터가 필요 없으면서도 최소 함수 평가로 고화질 생성을 하는 새로운 증류 기법이 기존의 데이터 의존성과 복잡한 학습 파이프라인 문제를 해결한다.
핵심 요약
확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. Consistent Distribution Matching이라는 시뮬레이션 프리·데이터 프리 증류 방식을 제안하며, 샘플 생성과 스코어 추정을 하나의 학생 네트워크로 통합한다. 프레임워크는 얼어 있는 교사 모델과 학습 가능한 학생 모델 두 개만 사용하고 하나의 목적함수를 최적화한다. 전체 요약 6문장 읽기 → 042 03:11 ▲ 204 · 댓글 41 CERN과 Mistral, 과학 AI 개발 전략 제휴 CERN과 유럽 AI 개발사 Mistral이 과학 발전을 위한 기초 모델 개발을 목표로 전략 제휴 양해각서를 체결했다. AI · 머신러닝 · CERN and Mistral sign a statement of intent to establish a strategic partnership
Key Point 고에너지 물리학 연구의 데이터 폭발적 증가(2030년 10배)에 대응하기 위해 유럽이 기초 AI 모델 개발에 나서는 만큼, 과학 데이터 분석의 미래 방향이 어떻게 재편될지 보여주는 사례입니다.
핵심 요약
CERN과 유럽 AI 개발사 Mistral이 과학 발전을 위한 기초 모델 개발을 목표로 전략 제휴 양해각서를 체결했다. 초점은 고에너지 물리학이며, 양자색역학(LHC)에서의 수십억 개 양성자-양성자 충돌 시뮬레이션 데이터로 학습한 단일 기초 모델인 '대규모 물리 모델'을 개발할 계획이다. 개발될 모델은 입자 충돌 재구성, 입자 식별, 예상치 못한 신호 감지, 미래 검출기 설계 평가 등 다양한 작업을 단일 모델로 처리할 수 있도록 설계된다. 전체 요약 8문장 읽기 → 043 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 044 00:11 ▲ 115 · 댓글 23 동물실험 대체 기술, 규제 승인으로 본격화되다 17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 하드웨어 · 시스템 · Alternatives to Animal Testing Are Finally Taking Off
Key Point 규제 기준이 처음으로 동물실험에서 대체 기술로 역전되었으며, 미국·유럽 당국의 정책 전환이 과학 문화 변화의 장벽을 넘게 될 기술과 시스템을 어떻게 확산할 것인가가 핵심 과제다.
핵심 요약
17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 장기칩(organ-on-chip)은 인간의 조직과 장기 구조를 미세유체 채널에서 재현하는 기술로, 기존 정적 조직 배양과 달리 호흡이나 맥동 같은 생리적 움직임을 모사한다. 동물실험 대체 기술을 통칭하는 NAM(nonanimal methods)은 장기칩, 오르가노이드, 계산 시뮬레이션, AI 분석 도구 등으로 구성되며, 기존 동물 모델의 한계(임상 시험 진입 약물 92%가 시장 진출 실패)를 극복하려는 시도다. 전체 요약 13문장 읽기 → 045 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 046 09:11 ▲ 132 · 댓글 22 Commodore 64를 핀 단위로 시뮬레이션하는 하드웨어 시뮬레이터 공개 antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 오픈소스 · 도구 · The Commodore 64 hardware simulator: break chips and pins, see the results
Key Point 실제 칩을 제거하거나 손상시킬 위험 없이 고장난 Commodore 64의 원인을 하드웨어 수준에서 진단하고 탐구할 수 있는 오픈소스 도구가 공개되었다.
핵심 요약
antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 칩의 다리를 들어올리거나 그라운드/+5V에 단락시키거나, 칩을 소켓에서 빼거나, 저항을 개방할 수 있으며 그 결과를 모니터, 키보드, 보드의 모든 신호로 확인할 수 있다. 프로그램은 PCB의 전기 연결(네트리스트)과 각 칩의 핀 동작을 알고 있으며, 손상된 부품을 시뮬레이션하면 화면의 잡음도 회로 계산에서 나온 것이다. 전체 요약 14문장 읽기 → 047 06:11 ▲ 106 · 댓글 7 게임 엔진에서 현실적인 하늘 렌더링하기 Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 기타 · Rendering pretty sky in Around The World game
Key Point 게임에서 구름과 하늘을 물리 기반으로 렌더링하는 실무 기법들과 각 문제에 대한 구체적인 해결책을 단계별로 보여주는 개발자 맞춤형 사례 연구다.
핵심 요약
Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 구름이 하늘의 간접광(파란색)을 받도록 표면 법선을 아래에서 위로 향하게 조정하면, 낮에는 파란 톤이, 일몰에는 핑크 톤이 생겨 현실적인 모습이 된다. 대기 산란 계산 순서를 '외부산란 후 내부산란' 형태로 바꾸니 태양이 머리 위에 있을 때도 수평선 근처가 부자연스럽게 노란색으로 보이는 현상이 개선됐다. 전체 요약 6문장 읽기 → 048 18:11 ▲ 118 · 댓글 21 몬테카를로 시뮬레이션으로 풀 수 있는 문제들 몬테카를로 시뮬레이션은 무작위성과 대수의 법칙을 이용해 과학·공학 문제를 푸는 기법으로, 제2차 세계대전 후 핵무기 시뮬레이션에서 처음 기록됐다. 기타 · Monte-Carlo Simulations
Key Point 불확실성이 있는 복잡한 문제를 계산으로 풀 수 없을 때 간단한 무작위 시뮬레이션만으로 정확한 답을 얻을 수 있는 방법을 제시한다.
핵심 요약
몬테카를로 시뮬레이션은 무작위성과 대수의 법칙을 이용해 과학·공학 문제를 푸는 기법으로, 제2차 세계대전 후 핵무기 시뮬레이션에서 처음 기록됐다. 원판에 화살을 던져 π값을 추정하는 고전적 예시에서, 원 안에 맞은 화살의 비율로 π≈4×(안쪽/전체)로 계산하지만 샘플 수가 적으면 오차가 크다. 독립 시행에서 오차는 1/√N에 비례하므로 오차를 절반으로 줄이려면 샘플 수를 4배로 늘려야 한다. 전체 요약 11문장 읽기 → 049 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 050 09:11 ▲ 10 · 댓글 2 로봇 비전-언어 모델에 사용자 맞춤과 안전 기능을 더하다 현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. AI · 머신러닝 · CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
Key Point 실제 로봇 지원의 핵심인 사용자 맞춤화와 안전성 문제를 해결하는 구체적 방법론을 제시하며, 위반율 8.6배 감소, 복구 성공률 6배 증가라는 검증 가능한 결과를 보여준다.
핵심 요약
현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. CarryOn은 기존 VLA 정책을 보강하는 이중 루프 시스템으로, 사용자 선호도와 장면 맥락을 유지하면서 상호작용을 통해 지속적으로 업데이트하는 '계획 루프'를 갖춘다. 계획 루프는 사용자의 지속적인 선호도를 반영하여 맞춤형 부분 작업을 선택하고, 대화와 변화하는 장면 속에서 실행을 조율한다. 전체 요약 7문장 읽기 → 051 03:11 ▲ 11 · 댓글 1 흐름 매칭의 추론 능력을 높이는 자기조건화 기법 시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. AI · 머신러닝 · Self-Conditioning Enables Deep Sequential Reasoning in Flow Matching
Key Point 생성형 모델의 반복 샘플링 과정이 실제로 복잡한 추론을 수행할 수 없다는 근본적인 제약과 그를 극복하는 자기조건화 기법이 무엇인지 알아야 시각 추론 시스템을 제대로 설계할 수 있다.
핵심 요약
시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. 그러나 이 논문은 회로 복잡성 관점에서 이 직관이 잘못되었음을 보였다: 모델 출력이 특정 정규성 조건을 만족하면, 표준 흐름 매칭 샘플러의 궤적을 상수 개의 병렬 모델 평가 라운드로 시뮬레이션할 수 있다. 따라서 추가 샘플링 단계는 상수 깊이 백본 모델의 표현력을 증가시키지 못하며, 이것이 핵심 병목이다. 전체 요약 7문장 읽기 → 052 21:11 ▲ 285 · 댓글 2 AI 에이전트의 '마지막 한 발' 평가 벤치마크 등장 기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. AI · 머신러닝 · FDE-Gym: The Last Mile of AI Delivery
Key Point LLM 에이전트가 실제 고객 환경에서 얼마나 잘 작동하는지를 처음으로 체계적으로 평가한 벤치마크로, 기존 학술 평가와 현실 간의 큰 격차를 실증한다.
핵심 요약
기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. Hugging Face가 20개 산업 시나리오 95개 실제 과제를 담은 FDE-Gym 벤치마크를 공개했으며, 각 과제는 현장 엔지니어의 실제 프로젝트에서 개편했다. 시뮬레이션된 고객 환경에서 에이전트는 이해관계자와 상호작용하며 운영 환경 같은 시스템을 직접 수정해 솔루션을 제공하고, 고객 비즈니스 지표 개선도를 0~1로 정규화해 채팅·테스트 횟수 페널티를 적용한다. 전체 요약 5문장 읽기 → 053 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 054 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 055 15:11 ▲ 17 · 댓글 2 자동주행 AI, 시뮬레이션으로 가상 주행 영상 학습 자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. AI · 머신러닝 · SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
Key Point 자동주행 AI가 시뮬레이션으로 생성한 가상 영상을 학습 데이터로 사용해 강화학습 후보 궤적도 감독할 수 있게 되어, 제한된 실제 데이터만으로도 계획 성능을 5% 이상 향상시킬 수 있다.
핵심 요약
자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. SimVTA는 이 문제를 해결하기 위해 시뮬레이션 기반 사후훈련 프레임워크를 제안한다. 각 관찰에 대해 후보 궤적을 샘플링하고, 3D 가우시안 스플래팅(3DGS)으로 재구성한 실제 장면에서 월드 엔진 같은 시뮬레이터로 높은 보상을 받는 궤적들의 미래 영상을 렌더링한다. 전체 요약 8문장 읽기 → 056 15:11 ▲ 30 · 댓글 2 AI 모델의 미래 세계 예측 능력 벤치마크 'WorldCast' 공개 인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. AI · 머신러닝 · WorldCast: Exploring Intelligent Visual Generation in World State Prediction
Key Point 현재 최첨단 모델의 시각적 미래 예측 능력 한계를 명확히 드러내는 벤치마크로, AI의 실제 세계 이해도를 측정하는 중요한 기준을 제시합니다.
핵심 요약
인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. 연구팀이 이러한 능력을 4단계 계층으로 분류했으나 고수준 작업들은 아직 충분히 연구되지 않은 상태다. 이를 해결하기 위해 WorldCast 벤치마크를 개발했으며, 이는 8개 카테고리의 320개 수작업 사례로 구성되고 12개 대표 모델을 평가한다. 전체 요약 8문장 읽기 → 057 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 059 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 060 15:11 ▲ 18 · 댓글 1 휴머노이드 로봇의 도구 선택과 사용 능력 평가하는 벤치마크 공개 휴머노이드 로봇이 도구를 사용해 작업을 수행하려면 적절한 도구를 선택하고, 조작과 필요시 이동을 조율해야 한다. 하드웨어 · 시스템 · HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution
Key Point 휴머노이드 로봇이 도구 사용 능력을 갖추는 것은 제한된 신체 능력을 극복하는 핵심이며, 이를 체계적으로 평가할 수 있는 벤치마크와 대규모 데이터셋의 공개는 로봇 학습 연구를 한 단계 진전시킬 수 있다.
핵심 요약
휴머노이드 로봇이 도구를 사용해 작업을 수행하려면 적절한 도구를 선택하고, 조작과 필요시 이동을 조율해야 한다. 기존 벤치마크는 휴머노이드의 이들 능력을 함께 평가하지 않으므로, HumanoidToolBench라는 새로운 벤치마크를 소개한다. 이 벤치마크는 18개 작업, 3가지 시나리오, 3단계 실행 레벨, 2가지 도구 세트 모드를 포함한다. 전체 요약 7문장 읽기 → 061 15:11 ▲ 15 · 댓글 2 로봇 기초모델, 지속학습으로 새 작업 빠르게 습득 로봇 기초모델(RFM)의 강화학습 미세조정은 데모 이상의 성능을 낼 수 있지만, 실제 배포에는 새 작업을 효율적으로 학습하면서 기존 능력을 잃지 않아야 한다. AI · 머신러닝 · ACCRUE: Continual Off-Policy Reinforcement Learning for Robot Foundation Models
Key Point 로봇이 새로운 작업을 배우면서 기존 능력을 유지해야 한다는 실제 배포 문제를 오프폴리시 RL로 해결했으며, 31~68% 훈련 시간 단축으로 실용성을 입증했습니다.
핵심 요약
로봇 기초모델(RFM)의 강화학습 미세조정은 데모 이상의 성능을 낼 수 있지만, 실제 배포에는 새 작업을 효율적으로 학습하면서 기존 능력을 잃지 않아야 한다. 기존 지속학습 RL 방식은 온폴리시 업데이트로 잊음 현상을 줄이지만 전이학습이 제한적이고, 오프폴리시 방식은 단일 작업 샘플 효율은 높이지만 작업 간 지속성 문제를 해결하지 못한다. ACCRUE는 경량 액터-크리틱 네트워크를 작업 간에 보존하는 오프폴리시 RL 프레임워크로, 각 단계가 이전 RL에서 습득한 행동과 가치 지식을 재사용한다. 전체 요약 6문장 읽기 → 062 15:11 ▲ 107 · 댓글 10 Oxide, 완전한 랙을 가상 환경에서 구동하는 에뮬레이터 공개 Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. 인프라 · 데브옵스 · Virtual Oxide Labs: Emulating a Full Oxide Rack
Key Point 실제 하드웨어가 부족한 상황에서 완전한 랙 규모 시스템을 로컬 머신에서 테스트할 수 있는 방법을 제시했으며, 마이크로컨트롤러 에뮬레이션의 기술적 구현 방식이 임베디드 시스템 테스트의 새로운 접근 방식을 보여준다.
핵심 요약
Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. Voxel은 수정되지 않은 스톡 Oxide 소프트웨어를 사용하는 '절대적 충실도'를 원칙으로 하며, 슬레드 가상화(Propolis), BGP/정적 네트워킹(Debian/FRR), 소프트웨어 P4 스위치(SoftNPU), 마이크로컨트롤러 시뮬레이션을 지원한다. 32스레드 AMD Ryzen 9 9955HX와 96GB RAM을 갖춘 Minisforum 미니 PC에서 6개 슬레드로 구성된 완전한 Oxide 랙을 약 10분 만에 구동할 수 있다. 전체 요약 9문장 읽기 → 063 09:11 당일 +118 7개 AI 코딩 도구 지원하는 에이전트 마켓플레이스 Claude Code, Cursor, GitHub Copilot, OpenAI Codex CLI, OpenCode, Antigravity CLI, Pi 등 7개 AI 코딩 도구를 지원하는 통합 플러그인 마켓플레이스를 제공한다. AI · 머신러닝 · wshobson/agents · Python
Key Point AI 코딩 도구가 다양해지면서 각각 다른 플러그인 형식을 사용하는데, 이 저장소는 마크다운 소스 하나로 여러 도구를 동시에 지원하는 방식을 보여줌으로써 멀티 플랫폼 에이전트 생태계 운영의 새로운 패턴을 제시한다.
핵심 요약
Claude Code, Cursor, GitHub Copilot, OpenAI Codex CLI, OpenCode, Antigravity CLI, Pi 등 7개 AI 코딩 도구를 지원하는 통합 플러그인 마켓플레이스를 제공한다. 94개 플러그인(로컬 92개, 외부 2개)과 202개 에이전트, 184개 스킬, 105개 커맨드를 포함하고 있으며, Python과 JavaScript 개발, 코드 리뷰, 테스트, 인프라, 보안 등을 다룬다. 각 도구의 특성과 기능에 맞춰 설치 방식이 다르며, 플러그인 마켓플레이스, 네이티브 마켓플레이스, 저장소 클론 후 설치 등의 옵션을 제공한다. 전체 요약 10문장 읽기 → 064 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 065 18:11 ▲ 110 · 댓글 17 소리의 과학을 인터랙티브하게 배우는 가이드 소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 기타 · Sound – Bartosz Ciechanowski (2022)
Key Point 소리가 어떻게 생성·전파되고 인지되는지 물리적 원리를 인터랙티브 시뮬레이션으로 직관적으로 이해할 수 있어, 음향 공학이나 오디오 처리를 배우는 개발자의 기초 학습 자료가 될 수 있다.
핵심 요약
소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 진동하는 물체가 공기를 압축·팽창시키면 압력 파동이 생성되고, 이것이 귀에 도달할 때 소리로 인지된다. 진동판의 움직임 크기(진폭)는 음량을, 진동 빈도(주파수)는 음높이를 결정한다. 전체 요약 8문장 읽기 → 066 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 067 15:11 ▲ 20 · 댓글 1 착용형 센서로 인간의 로봇팔 동작 100시간 기록 인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. AI · 머신러닝 · EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
Key Point 인간형 로봇의 자연스러운 움직임 학습을 위해 필요한 대규모 멀티모달 데이터셋이 공개되었으며, 센서 최소화 기술로 현장 데이터 수집의 새로운 방향을 제시한다.
핵심 요약
인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. 연구팀은 EgoExplorer라는 100시간 규모의 데이터셋을 공개했으며, 착용형 센서 시스템으로 시점 영상과 전신 동작, 손가락 세밀한 움직임, 촉각 정보를 동시에 기록했다. 전문적 활동들을 중심으로 연속 녹화된 이 데이터에는 단계별 설명도 함께 제공된다. 전체 요약 8문장 읽기 → 068 15:11 ▲ 56 · 댓글 2 다중 플레이어 게임 세계를 효율적으로 생성하는 계층 통신 모델 다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. AI · 머신러닝 · Multics: Generative Multi-Player World Model with Hierarchical Communication
Key Point 게임·메타버스 개발에서 많은 플레이어를 효율적으로 처리하는 영상 생성 기술의 확장성 문제를 푼 방법으로, 재학습 없이 여러 규모에 대응하고 계산 비용을 줄일 수 있다.
핵심 요약
다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. 기존 방식(Solaris의 완전 연결 통신)은 플레이어 수에 따라 주의 비용이 이차적으로 증가하고, 중앙식 접근법(γ-World)은 공유 표현에서 무관한 이벤트 간 간섭 문제가 있다. Multics는 플레이어·그룹·전역 레벨에서 정보 교환을 구조화하는 계층 통신으로 이를 해결한다. 전체 요약 9문장 읽기 → 069 12:11 ▲ 64 · 댓글 1 픽셀 재구성 없이 로봇 제어하는 JEPA 모델 등장 Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. AI · 머신러닝 · LeWAM: End-to-End World and Action Modeling with JEPAs
Key Point 기존 세계 모델 방식을 통합해 로봇 제어 성공률을 3배 이상 높이고 계획 속도를 획기적으로 개선한 새로운 아키텍처로, 시뮬레이션과 실제 로봇 모두에서 실용성을 입증했다.
핵심 요약
Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. 레카이(LeWAM)는 엔드-투-엔드 JEPA로서 다음 잠재 상태 예측과 행동 흐름 매칭을 함께 학습하고, 잠재 상태에 등방 가우시안 제약을 적용한다. 이 설계로 하나의 모델이 정책 직접 실행과 학습된 잠재 역학으로 샘플 행동을 평가하는 효율적인 계획을 모두 지원할 수 있다. 전체 요약 6문장 읽기 → 070 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 071 03:11 ▲ 103 · 댓글 71 Anthropic이 Git을 대체할 소스 제어 시스템 'Scion' 개발·공개 Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. 인프라 · 데브옵스 · Redesigning Source Control at Anthropic
Key Point 에이전트 기반 소프트웨어 개발이 기존 개발 인프라의 한계를 드러내는 현상을 보여주는 사례이며, 다른 조직도 수개월 내 유사한 병목을 마주할 가능성이 있어 Git 및 CI/CD 설계 방식을 재검토할 시점을 제시한다.
핵심 요약
Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. Git은 완전한 오프라인 저장소 설계로 기존에는 우수하지만, Anthropic의 모노레포는 메인 브랜치 히스토리만 100GB, 압축 복사본 25GB 이상이며 일일 2,500만 체크아웃으로 기존 방식(600PB/일 트래픽)이 불가능했다. Scion은 에이전트(AI)가 항상 온라인이라는 가정에서 출발해, 클라이언트가 완전한 저장소 복사본을 유지하지 않고 서버에서 필요한 데이터를 요청하는 클라이언트-서버 비대칭 구조를 채택했다. 전체 요약 12문장 읽기 → 072 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 → 073 15:11 ▲ 18 · 댓글 2 시각 모델도 '다각도로 생각한다'…공간 추론 학습법 제시 인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. AI · 머신러닝 · SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
Key Point 거대 비전-언어 모델이 공간 추론 시 인간처럼 다각도 사고를 할 수 있도록 만드는 실질적인 학습 방법론을 제시해 모델 기반 시각 이해의 한계를 구체적으로 개선한다.
핵심 요약
인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. 연구팀은 이를 '능동적 공간 심상화(Active Spatial Mentalization, ASM)'라 정의하고, LVLM에 이 능력을 내재화하는 SpatialASM 프레임워크를 제시했다. SpatialASM은 학습 단계에서 시뮬레이션된 다양한 시점으로 학습하며, 할로센트릭(allocentric) 뷰 생성 모델을 사용해 가설적 시점을 실제 시각 데이터에 근거하게 한다. 전체 요약 6문장 읽기 → 074 00:11 당일 +258 KernelSU 기반 안드로이드 GPS 위조 프레임워크 공개 KernelSU와 LSPosed를 조합해 안드로이드 시스템 수준에서 GPS 위치, 무선 환경(Wi-Fi·기지국·블루투스), 위성 신호를 동시에 가짜로 제공하는 오픈소스 도구다. 보안 · HuangZhuoRui/LocationSpoofer · Kotlin
Key Point 국내외 위치 기반 서비스 보안 검증이나 기기 호환성 테스트 개발자, 그리고 Xposed 기반 깊이 있는 시스템 레벨 Hook 구현 방식에 관심 있는 안드로이드 보안 연구자들이 알아야 할 대규모 오픈소스 프로젝트다.
핵심 요약
KernelSU와 LSPosed를 조합해 안드로이드 시스템 수준에서 GPS 위치, 무선 환경(Wi-Fi·기지국·블루투스), 위성 신호를 동시에 가짜로 제공하는 오픈소스 도구다. 고도 풍제어를 무력화하기 위해 단순한 Mock Location 플래그 위조 대신 Wi-Fi 신호 지문, 기지국 셀 정보, GNSS 위성 분포, 전자나침반 데이터까지 일관성 있게 조작해 실제 위치처럼 보이게 한다. 위치 좌표에는 Ornstein-Uhlenbeck 확률 과정을 적용해 GPS 칩이 내는 자연스러운 노이즈(가우시안 드리프트)를 시뮬레이션하고, 보행 중에는 정규분포 횡방향 편차(±0.15m)를 더해 사람 발걸음의 자연스러움을 구현한다. 전체 요약 10문장 읽기 → 075 18:12 ▲ 18 · 댓글 2 3D 물체 생성, 외형을 넘어 물리 움직임까지 담다 물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. AI · 머신러닝 · Towards Physically Grounded Articulated 3D Assets: A Multi-Agent Pipeline and Benchmark
Key Point 3D 생성 모델이 시각적 정확도를 넘어 물리 엔진과의 상호작용까지 만족해야 하는 시대로 나아가는 기술 전환점을 보여주며, 게임 에셋·로봇공학·CAD 등 실무 활용 기준이 크게 변하고 있다.
핵심 요약
물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. 기존 Articraft 방법을 다중 에이전트 파이프라인과 물리 시뮬레이션 피드백으로 확장한 Artisan 시스템을 제안한다. 생성된 3D 자산이 충돌 없이 움직이고, 중력 안정성을 유지하며, 정확한 질량과 재질 속성을 가지도록 한다. 전체 요약 7문장 읽기 → 076 18:12 ▲ 139 · 댓글 2 로봇 팔이 던져진 상자를 받는다 - 시각·반사·전신제어 동시에 인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. AI · 머신러닝 · Reflex: Visually Grounded Reactive Humanoid Control
Key Point 시각 피드백 기반의 실시간 전신 제어라는 난제를 단계별 학습으로 풀었고, 실제 로봇에서 인간 수준의 반사 동작 구현에 가까워지고 있습니다.
핵심 요약
인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. Reflex는 던져진 상자 잡기를 목표로 전신 제어·물체 동역학 예측·시각 인지 세 가지 능력을 단계별로 학습하는 프레임워크다. 첫 번째 단계에서는 강화학습으로 상태 기반 전신 잡기 정책을 학습하고, 두 번째는 불완전하고 지연된 관찰에서 움직이는 상자의 동역학을 추론하며, 세 번째는 RGB-D 카메라로부터 직접 동역학을 복원한다. 전체 요약 6문장 읽기 → 077 15:11 ▲ 66 · 댓글 3 실제 환경에서 로봇 에이전트의 계속 학습 평가하는 벤치마크 공개 EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. AI · 머신러닝 · EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
Key Point 로봇과 에이전트가 새로운 환경과 작업에 적응하려면 과거 경험을 활용해야 하는데, 현재 계속 학습 연구는 실제 환경에 거의 적용되지 않았다는 근본적인 격차를 해결하기 위한 첫 벤치마크다.
핵심 요약
EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. 벤치마크는 에이전트가 기본 작업부터 학습한 후 획득한 기술들을 재조합해 본 적 없는 복잡한 고급 작업을 해결할 수 있는지를 평가하는 구성적 일반화(compositional generalization)를 핵심 원칙으로 삼는다. 여러 에이전트 구조와 학습 방법 전체에 걸친 광범위한 실험을 통해 에이전트의 일관된 제약과 독특한 행동 패턴을 발견했다. 전체 요약 7문장 읽기 → 078 00:10 ▲ 164 · 댓글 93 README를 실제 사용자에게 검증받다 개발자들은 문서 작성을 제대로 하지 않는데, 저자는 ActivityBot README 작성 시 실제 사용자 피드백을 받기로 결심했다. 오픈소스 · 도구 · I paid people to try and follow my README
Key Point README 개선의 핵심은 LLM 시뮬레이션이 아닌 실제 사용자의 음성 피드백이며, 사소한 비용으로 문서 품질을 근본적으로 향상시킬 수 있다.
핵심 요약
개발자들은 문서 작성을 제대로 하지 않는데, 저자는 ActivityBot README 작성 시 실제 사용자 피드백을 받기로 결심했다. NLnet 그랜트 지원 과정에서 €25의 보수를 지급하기로 약속한 후 마스토돈에서 모집한 사람들과 화상 통화를 진행했다. 테스트 방식은 단순했는데, 자원자가 화면을 공유하며 실시간으로 README를 따라하면서 무엇을 이해하지 못했는지, 뭐가 혼란스러웠는지 말하도록 했다. 전체 요약 8문장 읽기 → 079 15:11 ▲ 38 · 댓글 5 장문맥 에이전트의 이력 압축, 소프트 메모리 토큰으로 해결 장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. AI · 머신러닝 · REMORY: Learning Residual Memory for Context Compaction
Key Point LLM 기반 장시간 에이전트의 컨텍스트 제약을 해결하는 새로운 접근법으로, 입력 토큰을 극적으로 줄이면서 의사결정 품질을 유지하는 방법을 제시한다.
핵심 요약
장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. REMORY는 요약을 보완하는 제한된 길이의 소프트 메모리 토큰 시퀀스를 생성하는 신경 메모리 네트워크로, 전체 이력이 있을 때 LLM이 생성할 결과를 시뮬레이션하도록 학습된다. 이 토큰들은 요약을 기반으로 조건화되며 요약 뒤에 추가되어 시퀀스 차원의 잔차 연결 형태를 만든다. 전체 요약 6문장 읽기 → 080 12:11 ▲ 12 · 댓글 2 로봇 학습을 위한 GPU 병렬 멀티태스크 강화학습 프레임워크 GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. AI · 머신러닝 · A GPU-Parallel Framework for Heterogeneous Multi-Task Reinforcement Learning
Key Point 멀티태스크 강화학습에서 GPU 병렬 처리와 데모 기반 학습을 결합한 새로운 방법론이 실제 로봇까지 일반화되는 모습을 보여준다.
핵심 요약
GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. Hebero는 Isaac Lab 기반의 GPU 병렬 벤치마크로, 40개의 이질적인 작업 전체에 걸쳐 하나의 정책을 공동으로 학습하고 평가할 수 있다. 병렬 레플리카 수를 증가시키면 고정된 벽시계 시간 내에서 성공률이 향상되는 스케일링 효과가 확인되었다. 전체 요약 9문장 읽기 → 081 09:11 ▲ 105 · 댓글 16 Nix 기반 결정론적 디버거로 경쟁 조건 추적 Rewind VM은 Nix 빌드의 모든 실행을 입력의 순수 함수로 만드는 결정론적 가상머신으로, 스레드 스케줄까지 동일하게 재현된다. 인프라 · 데브옵스 · Nix wrote half of my debugger
Key Point Nix가 제공하는 완전한 빌드 입력 추적과 재현성을 활용해 경쟁 조건을 체계적으로 재현·추적·분석하는 새로운 접근법을 보여주며, 기존 디버거가 해결하기 어려웠던 스레드 스케줄 관련 버그를 자동으로 발견할 수 있다.
핵심 요약
Rewind VM은 Nix 빌드의 모든 실행을 입력의 순수 함수로 만드는 결정론적 가상머신으로, 스레드 스케줄까지 동일하게 재현된다. 은행 계좌 입금 예시처럼 두 개 스레드가 경합할 때 발생하는 경쟁 조건을 찾아내기 위해 여러 스케줄 조합을 자동으로 시뮬레이션한다. 16코어 노트북에서는 1,000회 중 396회가 실패했지만, 단일 코어로 고정하면 1,000회 모두 성공하는 것으로 확인돼, 스케줄 변경의 중요성을 입증한다. 전체 요약 13문장 읽기 → 082 06:11 ▲ 190 · 댓글 45 30년 전 GTA 차량 물리엔진, 자바스크립트로 부활 개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 하드웨어 · 시스템 · 2D Vehicles
Key Point 게임 물리 엔진의 실무적 구현 방식을 1990년대 접근법부터 현대적 재현까지 투명하게 공개한 사례로, 게임 개발자나 물리 시뮬레이션에 관심 있는 개발자에게 실질적인 설계 참고가 된다.
핵심 요약
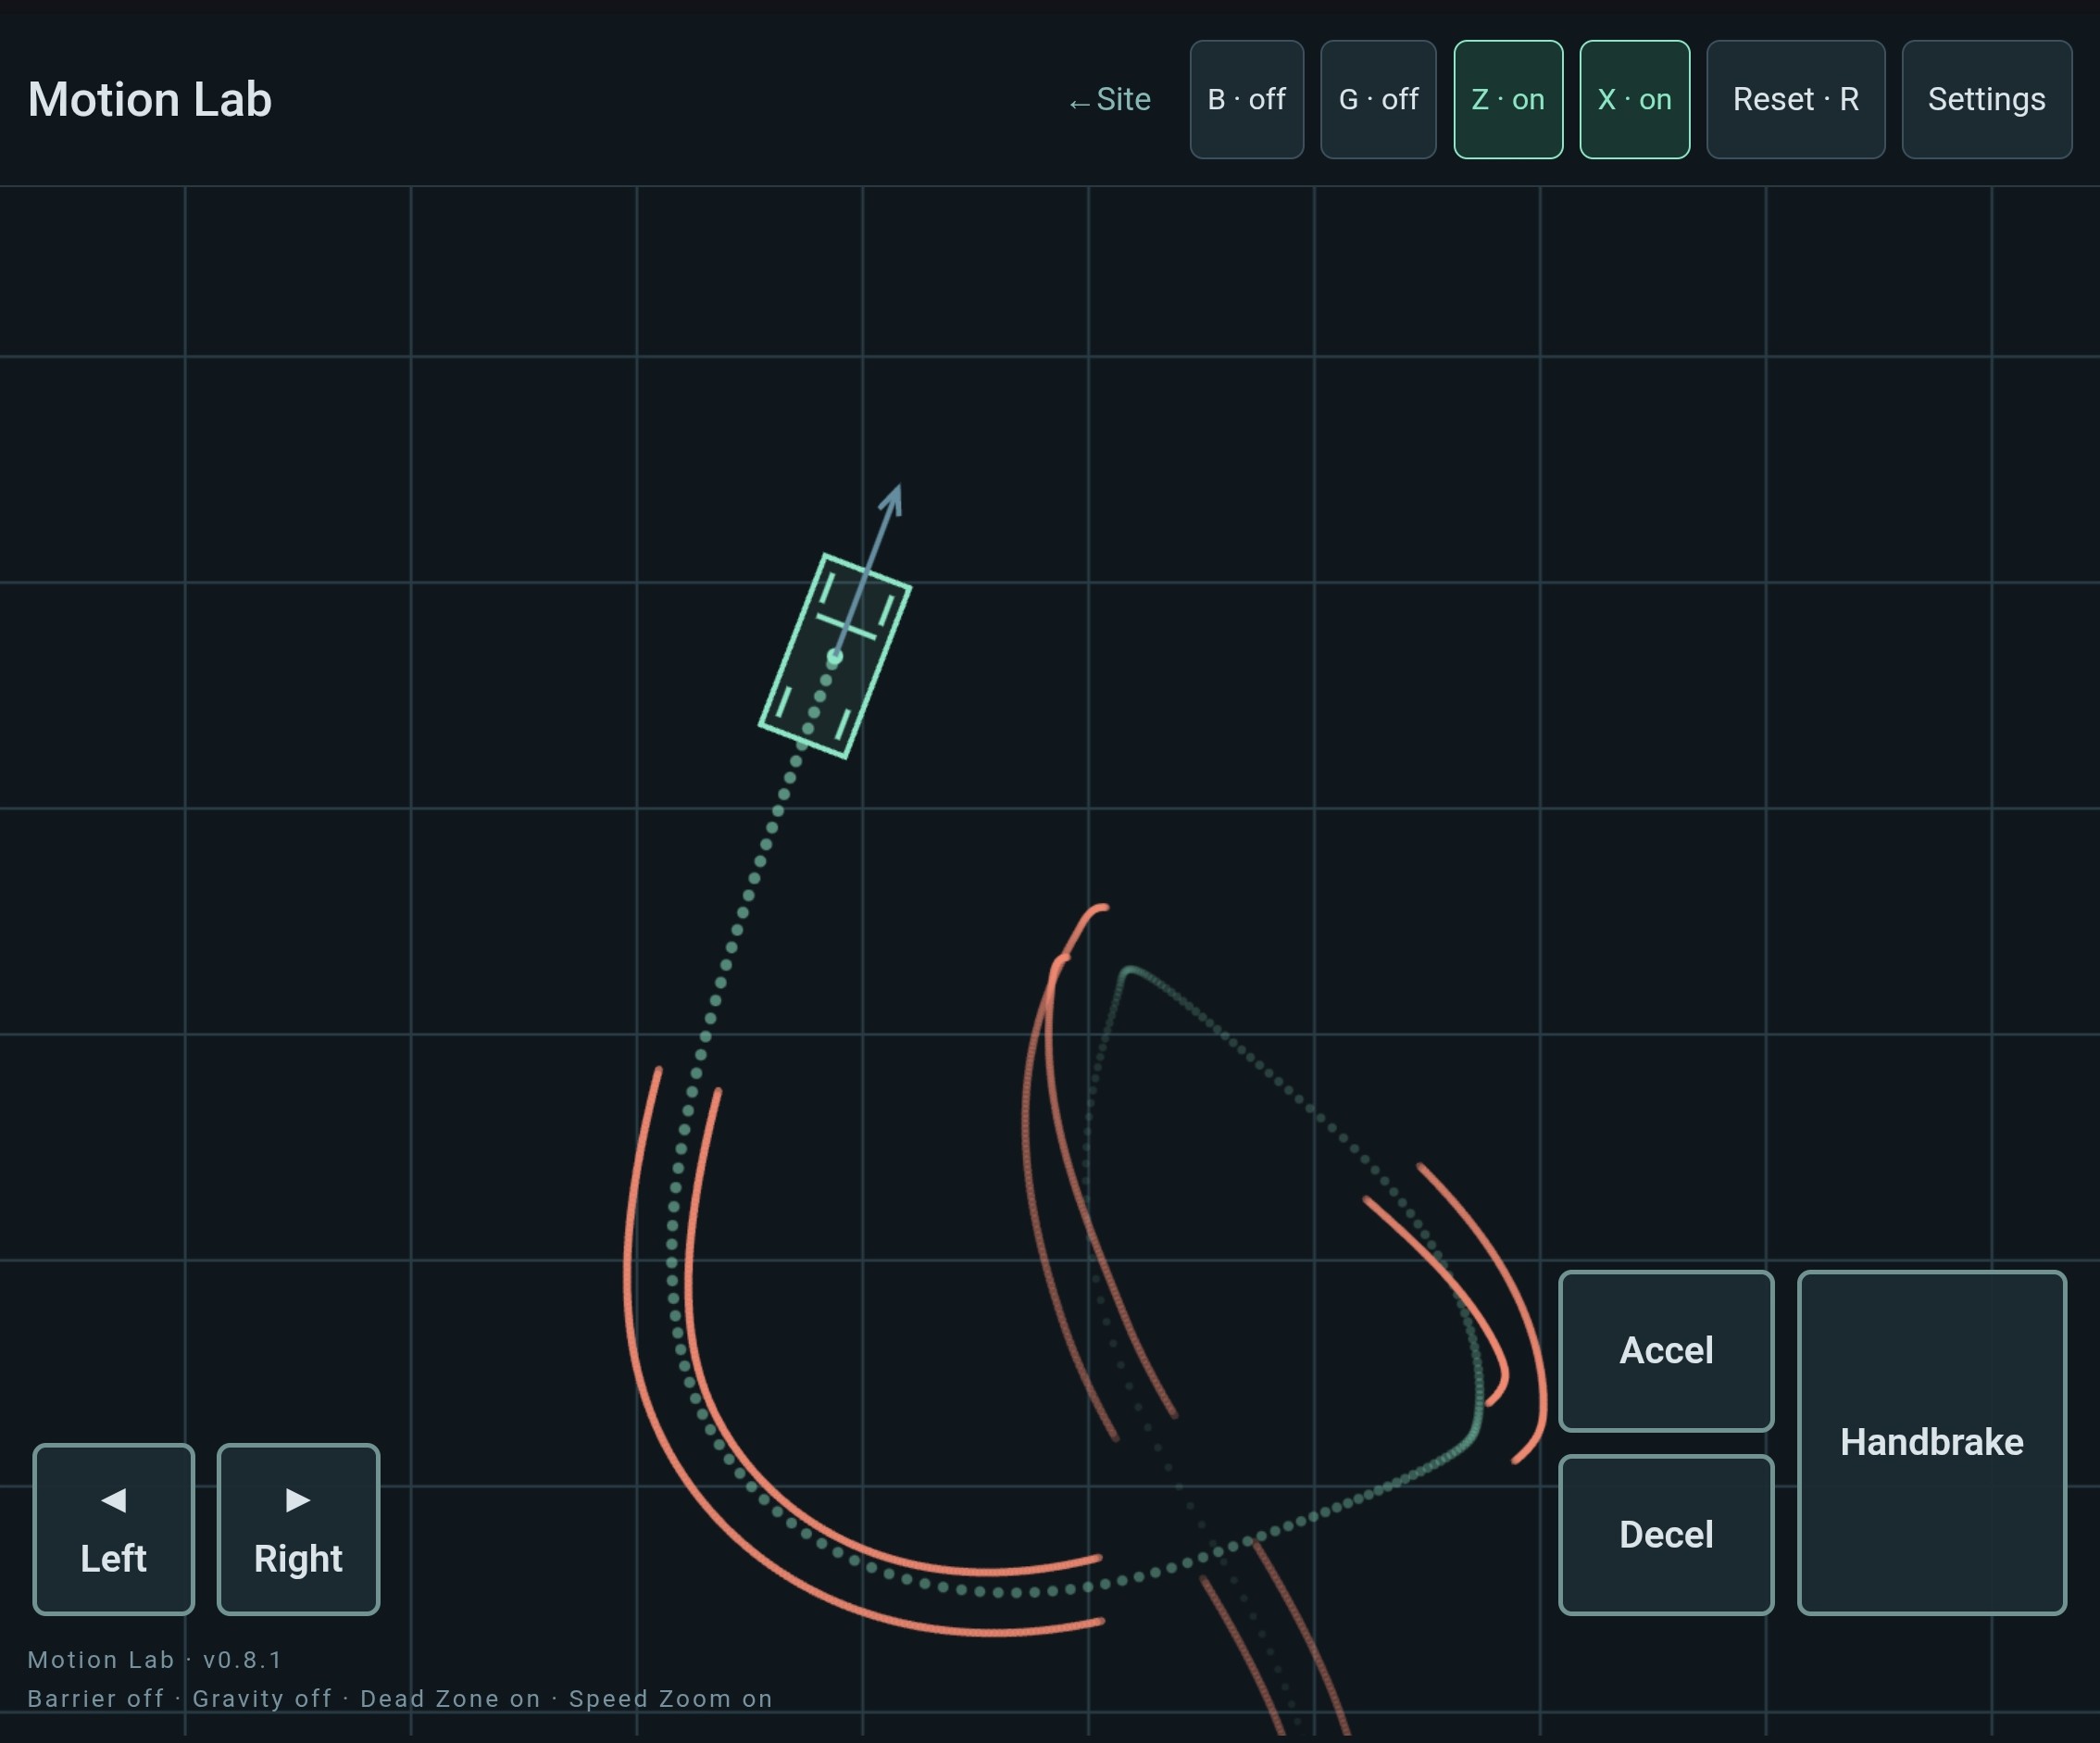
개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 원본은 나중에 C로 포팅되어 GTA의 차량 시스템 기초가 되었으며, 현재 'Motion Lab'이라는 이름으로 웹에서 플레이 가능하다. 기본 '카' 모드 외에 '우주선'(우주 비행 게임 Thrust 스타일)과 '벽돌' 모드를 제공하며, 터치/키보드 조작으로 제어할 수 있다. 전체 요약 11문장 읽기 → 083 21:11 ▲ 104 · 댓글 36 금융 시장 데이터를 생성 모델로 합성할 수 있을까 Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. AI · 머신러닝 · Can you use autoregressive diffusion to generate market data?
Key Point 시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다. 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다. 전체 요약 10문장 읽기 → 084 18:11 ▲ 14 · 댓글 2 LLM이 순차 구조를 진짜 이해할까? 제어 실험으로 검증 LLM이 행동의 표면적 빈도를 넘어 잠재 순차 구조를 복원할 수 있는지 검증하는 연구다. AI · 머신러닝 · Do LLMs Understand Sequential Structure? A Controlled Study of Inference and Generation
Key Point LLM을 시뮬레이터나 에이전트로 쓸 때 정말 규칙을 이해하고 따르는지, 아니면 겉으로만 맞는 행동을 생성하는지 구분하는 것이 중요하기 때문이다.
핵심 요약
LLM이 행동의 표면적 빈도를 넘어 잠재 순차 구조를 복원할 수 있는지 검증하는 연구다. 2인 가위바위보 상호작용과 1인 확률적 n-gram 계속하기 과제로 LLM의 전략 식별, 마코프 규칙 추종, 고차 조건부 의존성 유지 능력을 테스트했다. 결과는 더 긴 문맥도 전략 식별을 개선하지 못하고, 정확한 인식이 충실한 시뮬레이션을 보장하지 않으며, 고차 의존성은 규칙 복원을 크게 악화시킨다는 것을 보였다. 전체 요약 4문장 읽기 → 085 21:11 당일 +663 AI 에이전트를 과학자로 만드는 177개 스킬 라이브러리 K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. AI · 머신러닝 · K-Dense-AI/scientific-agent-skills · Python
Key Point 연구자가 직접 개발한 과학 도구들을 AI 에이전트에 설치하면 실험 설계·데이터 분석·논문 작성 같은 복잡한 연구 작업을 몇 줄의 지시로 자동화할 수 있다는 점이 핵심이다.
핵심 요약
K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. 100개 이상의 과학 데이터베이스(PubChem, ChEMBL, UniProt, ClinicalTrials.gov 등)와 RDKit, Scanpy, PyTorch, scikit-learn 등 70개 이상의 파이썬 패키지에 대한 최적화된 워크플로우를 제공한다. Cursor, Claude Code, Codex, Google Antigravity 등 Agent Skills 표준을 지원하는 모든 호스트와 호환되며, Agent Plugins 패키지로도 사용 가능하다. 전체 요약 12문장 읽기 → 086 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 087 15:13 ▲ 52 · 댓글 2 다중 에이전트 1인칭 시점 세계 모델, 미세한 상호작용 구현 1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. AI · 머신러닝 · Multi-Agent Egocentric World Model with Fine-Grained Embodied Interaction
Key Point 실제 로봇이나 현실의 멀티에이전트 환경 시뮬레이션에서 미세한 상호작용(팔 움직임, 물체 조작 등)까지 정확히 모델링해야 하는 연구자와 엔지니어에게 필요한 기술적 진전이다.
핵심 요약
1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. 현실의 구체화된 환경에서는 여러 에이전트가 공유된 환경에서 미세한 동작을 통해 상호작용하는데, 이는 대부분의 기존 멀티에이전트 세계 모델에서 충분히 다뤄지지 않았다. 연구팀은 멀티에이전트 이고센트릭 세계 모델링을 여러 에이전트의 동기화된 1인칭 스트림 생성으로 정식화했고, 이는 교차 시점 행동 일관성, 공유 환경 일관성, 상호작용으로 인한 상태 업데이트 전파를 요구한다. 전체 요약 6문장 읽기 → 088 15:13 ▲ 47 · 댓글 6 로봇이 시각 데모로 과제를 배우는 ICL 프레임워크 공개 로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. AI · 머신러닝 · In-context Robot Learning Made Simple: A Democratized Recipe for Manipulation Tasks
Key Point 로봇 조작 학습의 실용화를 막던 문제 정의 부재를 해결하고, 대규모 학습 없이도 작동하는 재현 가능한 오픈소스 방식을 제시한 점이 의미있다.
핵심 요약
로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. 연구팀은 로봇 ICL의 명확한 문제 정의를 제시하고 근본적인 프롬프트 모호성을 해결했다. 비전 프롬프트 인코더와 저비용 데이터 수집 프로토콜을 갖춘 미니멀한 프레임워크 SimpleICL을 개발했다. 전체 요약 6문장 읽기 → 089 12:11 ▲ 226 · 댓글 3 가상 세계에서 코드로 에이전트를 진화시키는 AgentGarten AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. AI · 머신러닝 · AgentGarten: Code Worlds for Evolving Agents
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 090 12:11 ▲ 129 · 댓글 2 원본 시스템 없이 언어 기반 환경 모의 실행 만드는 Trace2Env LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. AI · 머신러닝 · From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
Key Point 원본 환경 없이 과거 기록만으로 현실적인 에이전트 학습 환경을 만들 수 있다면, 접근 불가능한 레거시 시스템이나 폐쇄된 플랫폼에서도 LLM 에이전트를 훈련할 수 있게 된다.
핵심 요약
LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. 기존 실행 환경을 재건하지 않고 언어 모델이 에이전트의 환경 역할을 하는 '에이전틱 언어 월드 모델링' 방식을 제시한다. Trace2Env는 원본 시스템의 과거 상호작용 기록(trace)만으로 학습 없이 환경을 재구성하는 무학습 프레임워크다. 전체 요약 8문장 읽기 → 091 09:11 ▲ 23 · 댓글 2 AI 에이전트 학습용 실제감 있는 사용자 시뮬레이터 MIMESIS 개발 대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. AI · 머신러닝 · MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
Key Point 에이전트 학습에 실제 사용자처럼 행동하는 시뮬레이터를 사용하면 데이터 수집 비용을 크게 줄이면서도 더 나은 에이전트를 만들 수 있다는 것을 입증했기 때문이다.
핵심 요약
대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. 기존 에이전트 학습 프레임워크는 기성 LLM 어시스턴트를 사용하는데, 이들은 너무 협력적이고 명확하며 동질적이어서 실제 사용자와 차이가 난다. MIMESIS는 인간 대화 데이터와 13가지 현실적 행동 패턴 레이블로 학습한 전용 사용자 시뮬레이터로, 9B 모델이 SOUL-Index 65.7을 달성했다. 전체 요약 7문장 읽기 → 092 00:11 ▲ 29 · 댓글 2 고정 모델도 로봇 역량 높인다, PhysEvo 프레임워크 제시 Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. AI · 머신러닝 · PhysEvo: Astra Can Act, Let It
Key Point 모델 가중치 업데이트나 별도 훈련 없이 시뮬레이션 기반 자기개선만으로 실제 로봇 조작 성공률을 5배 이상 높일 수 있음을 입증한 결과다.
핵심 요약
Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. PhysEvo는 모델 가중치를 업데이트하지 않고도 물리적 재귀적 자기개선(RSI)을 수행하는 프레임워크다. 작업 에이전트가 로봇 태스크를 실행하고, 메타 에이전트가 실패를 진단해 도구와 스킬을 개정한 후 테스트한다. 전체 요약 8문장 읽기 → 093 21:11 당일 +148 Python으로 F1 경주 재생하고 분석하는 비주얼라이제이션 도구 F1 경주 원격측정 데이터를 시각화하고 인터랙티브 컨트롤로 경주를 재생하는 Python 애플리케이션이다. 오픈소스 · 도구 · IAmTomShaw/f1-race-replay · Python
Key Point F1 경주 원격측정을 인터랙티브하게 재생하고 분석하는 도구는 경주 전술과 드라이버 성능을 상세히 검토하고자 하는 팬과 개발자에게 새로운 가능성을 제시한다.
핵심 요약
F1 경주 원격측정 데이터를 시각화하고 인터랙티브 컨트롤로 경주를 재생하는 Python 애플리케이션이다. 실시간 드라이버 위치, 안전차 배치, 리더보드, 현재 랩/경주 시간을 렌더링된 트랙에 표시한다. 일시 정지·되감기·빨리감기와 재생 속도 조절(0.5x, 1x, 2x, 4x), 드라이버 선택 시 속도·기어·DRS 상태·현재 랩 표시 기능을 제공한다. 전체 요약 12문장 읽기 → 094 18:30 ▲ 23 · 댓글 2 AI 에이전트가 회사를 경영하는 시뮬레이터 공개 기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. AI · 머신러닝 · MiniCorp: The Last Mile of the AI Agent Firm
Key Point 기업용 AI 에이전트 개발에 필요한 현실적이고 대규모의 학습 데이터를 생성할 수 있는 도구가 공개되었으며, 실제 회사처럼 피드백 루프가 작동하는 환경을 통해 에이전트 의사결정 능력을 평가할 수 있게 된다.
핵심 요약
기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. Hugging Face 연구팀이 MiniCorp라는 오피스 시뮬레이터를 공개했으며, AI 에이전트들이 협력해 회사를 경영하면서 대규모 기업 데이터를 생성할 수 있다. 시뮬레이터는 전자상거래 회사를 모델로 고객·경쟁사·시장 메커니즘을 포함한 외부 세계와 의사결정 에이전트들의 내부 세계로 구성된다. 전체 요약 8문장 읽기 → 095 18:30 ▲ 44 · 댓글 1 사진 한 장으로 3D 장면 복원, 물리적으로 호환되는 객체들을 함께 생성 단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. AI · 머신러닝 · Tetris3D: 3D Scene Generation With Objects That Fit Together
Key Point 3D 장면 이해에서 객체 간 물리적 호환성을 명시적으로 학습하는 방식이 새로운 접근이며, 새로운 대규모 물리 시뮬레이션 데이터셋이 공개되어 후속 연구의 기초자료가 될 수 있기 때문이다.
핵심 요약
단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. 기존 방법들과 달리 각 객체의 생성을 주변 객체의 기하학적 형태와 물리적 관계에 조건화해, 객체 간의 공간적 호환성을 보장한다. 연구팀은 ComOb라는 물리 시뮬레이션 기반 데이터셋을 구축했는데, 1.2M개의 장면에 다양한 카테고리의 물리 상호작용과 객체별 메시, 객체 쌍의 물리 관계 정보를 포함했다. 전체 요약 5문장 읽기 → 096 18:33 ▲ 11 · 댓글 1 로봇이 스스로 배우는 데이터로 자기개선 가속화 로봇 파운데이션 모델 학습을 위해 다양한 데이터와 신뢰할 수 있는 평가 환경이 필요한데, 기존 시뮬레이션은 미리 정한 에셋과 스킬로만 제약받고 있다. AI · 머신러닝 · EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
Key Point 로봇 학습에 필요한 대규모 시뮬레이션 데이터를 자동으로 생성하면서 동시에 질을 높이는 기술로, 로봇 AI 개발 비용과 시간을 크게 단축할 수 있는 방법을 제시한다.
핵심 요약
로봇 파운데이션 모델 학습을 위해 다양한 데이터와 신뢰할 수 있는 평가 환경이 필요한데, 기존 시뮬레이션은 미리 정한 에셋과 스킬로만 제약받고 있다. EmbodiedSmith는 재귀적 자기개선(RSI) 방식으로 시뮬레이션 환경에서 대규모 로봇 데이터를 생성하는 프레임워크다. 에셋, 씬, 태스크 생성을 한 파이프라인에 통합하며, 언어 기반 커스터마이징과 자동 생성을 모두 지원한다. 전체 요약 8문장 읽기 → 097 18:33 ▲ 18 · 댓글 2 RAG 시스템 배포 판단을 위한 증거 기반 품질검증 프레임워크 기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AI · 머신러닝 · AGO AI Quality Gate: Evidence-First Release Decisions for Retrieval-Augmented Generation
Key Point RAG 시스템의 프로덕션 배포를 자동화할 때 LLM 판사의 오류가 얼마나 심각한지, 그리고 이를 어떻게 체계적으로 검증해야 하는지 보여주는 실무적 해결책을 담았습니다.
핵심 요약
기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AGO는 불완전한 증거와 LLM 판사의 오류를 명시적 결과로 다루는 4단계 의사결정 모델, 결정론적 검사와 LLM 평가를 결합한 계층화 점수 매기기, 회귀 위험을 확률로 정량화하는 베타-이항 게이트로 구성된다. LLM 판사의 신뢰성을 사전 검증하는 메타-평가 프로토콜을 필수로 포함하여 판사 오류가 최종 결정에 영향을 미치지 않도록 설계했다. 전체 요약 7문장 읽기 → 098 18:33 ▲ 29 · 댓글 3 로봇 실행 오차 보정하는 VLA 정책 제안 비전-언어-행동(VLA) 정책은 로봇이 명령한 움직임과 실제 실행 움직임이 다를 때 실패하는데, 이는 기계 마모나 페이로드 변화 같은 로봇 실행 오차에서 비롯된다. AI · 머신러닝 · Taming VLAs under Robot Execution Errors: Self-Compensation and Stress Testing
Key Point 로봇이 물리적 제약과 마모로 인해 명령과 다르게 동작할 때도 VLA를 안정적으로 사용할 수 있는 실무 해법이 필요한 시점이다.
핵심 요약
비전-언어-행동(VLA) 정책은 로봇이 명령한 움직임과 실제 실행 움직임이 다를 때 실패하는데, 이는 기계 마모나 페이로드 변화 같은 로봇 실행 오차에서 비롯된다. 연구팀은 자가 보정 VLA를 제안했으며, 이는 배포 시점에 VLA 정책이 로봇의 실행 오차를 미리 보정하는 명령을 생성할 수 있도록 한다. 작업 보상이나 레이블 없이 VLA가 명령한 행동과 로봇이 실제 실행한 움직임 간의 잔차를 이용해 온라인으로 정책을 업데이트한다. 전체 요약 6문장 읽기 → 099 18:33 ▲ 13 · 댓글 2 로봇 정책 호출 줄인 VLA 모델, 부드러운 동작 가능해졌다 Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. AI · 머신러닝 · When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
Key Point 로봇이 정책을 자주 호출할 때 발생하는 정지 구간을 없애면서도 신뢰도를 유지하는 방법이 실제 로봇에서 5배의 시간 절감을 이뤄 실용적 가치가 크다.
핵심 요약
Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. 액션 청크(action chunk)를 늘리면 정책 호출과 일시 정지를 줄일 수 있지만, 더 먼 미래를 예측하다 보니 장시간 청크 실행의 신뢰도가 떨어진다. 연구팀은 장시간 청크 내 액션 오류를 분석했고, 오류가 조작 서브스킬 간의 전환 지점에 집중되며 청크 길이에 따라 급격히 증가함을 발견했다. 전체 요약 6문장 읽기 → 100 18:35 ▲ 28 · 댓글 2 능동형 AI 에이전트 설계·평가 원리 제시 사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. AI · 머신러닝 · Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
Key Point 능동형 AI 에이전트의 신뢰 문제를 다루는 첫 종합 프레임워크로, 실제 사용자 연구를 통해 '올바른 작업'과 '신뢰'가 별개임을 검증했다.
핵심 요약
사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. 논문은 능동형 에이전트 설계를 위해 3T 원칙을 제시한다: ①Task Capability(필요를 예측하고 유용한 작업 수행), ②Temporal Allocation(자원 가용성과 필요 시점에 맞춰 계산 배분), ③Trust(사용자 신뢰와 적절한 의존성 유지). 이 원칙들을 구현하기 위해 5가지 설계 차원(작업 범위, 예측 지평, 활성화 트리거, 처리 시점, 개입 깊이)으로 설계 공간을 조직했다. 전체 요약 8문장 읽기 →