쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
38건 · "Transformers"조건 지우기 ×
001 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 002 18:11 새 버전 Transformers v5.21.1 릴리스, rope_scaling 버그 수정 Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. 오픈소스 · 도구 · huggingface/transformers@v5.21.1
Key Point vLLM 등 Transformers를 의존하는 라이브러리의 원격 코드 로딩이 v5.21.0에서 깨졌으므로, 이미 업그레이드한 사용자는 즉시 패치버전으로 업데이트해야 한다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. v5.21.0에서 rope_scaling setter 설정 과정에서 원격 코드 로딩이 손상되어 vLLM 호환성이 깨지는 이슈가 발생했다. 이번 패치에서 init 중에 rope_scaling을 할당하는 설정의 rope_scaling setter를 수정했다. 전체 요약 4문장 읽기 → 003 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 004 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 005 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 006 03:11 새 버전 Transformers 5.20.2 패치: 멀티모달 모델 입력 타입 버그 수정 Transformers 5.20.2 패치 버전이 릴리스됐다. AI · 머신러닝 · huggingface/transformers@v5.20.2
Key Point 멀티모달 모델과 대규모 분산학습 환경에서 발생하는 핵심 버그들이 수정되어 Transformers 라이브러리를 사용하는 개발자라면 즉시 업그레이드를 고려해야 한다.
핵심 요약
Transformers 5.20.2 패치 버전이 릴리스됐다. prepare_inputs_for_generation 함수에서 입력값이 원래 타입을 잃어 멀티모달 모델에 문제를 일으키던 버그를 수정했다. 또한 입력 딕셔너리 캐스팅 문제를 해결했으며, bfloat16과 전문가 병렬처리(expert parallelism)에서 ep_size < fsdp_size 조건일 때 제로 그래디언트 문제를 수정했다. 전체 요약 4문장 읽기 → 007 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 008 15:11 ▲ 43 · 댓글 3 로봇 행동 예측 AI, 시각 정보 처리 30배 효율화 기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. AI · 머신러닝 · BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
Key Point 로봇 행동 모델의 계산 효율을 대폭 개선하면서 성능은 유지하는 기술로, 로봇 제어 AI의 실시간성과 비용 효율성을 높이는 방향을 제시한다.
핵심 요약
기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. BridgeWAM은 시각·언어·고유감각 정보를 32개의 Latent Bridge Queries(LBQs)를 통해 제한된 공유 잠재 공간으로 집약하는 Bridge-of-Experts 구조를 도입했다. 행동 예측 그래디언트가 비디오 전문가를 행동 예측에 적합한 표현으로 유도하고, 행동 전문가는 교차 주의를 통해 작업 관련 정보를 선택적으로 검색한다. 전체 요약 7문장 읽기 → 009 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 010 00:11 새 버전 Transformers v5.20.1 출시, Beam 모델 추가 및 버그 수정 Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. AI · 머신러닝 · huggingface/transformers@v5.20.1
Key Point 새로운 고성능 모델 Beam이 추가되고 여러 모델 호환성 및 로딩 버그가 수정되어, 기존 Transformers 사용자와 새로운 모델을 시도하려는 개발자 모두에게 영향이 있다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. Beam은 토큰 효율적인 프론티어급 모델로 코딩과 에이전트 작업에 최적화되어 있다. 자체 하드웨어, 인프라, 클라우드에서 실행할 수 있으며 특정 요구사항에 맞게 커스터마이징 가능하다. 전체 요약 6문장 읽기 → 011 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 012 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 013 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 014 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 015 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 016 15:13 ▲ 38 · 댓글 2 확산 변환기의 희소 주의 문제, 훈련 없이 해결 확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. AI · 머신러닝 · MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
Key Point 긴 시퀀스 생성 작업의 병목인 희소 주의의 품질 저하 문제를 훈련 없이 근본적으로 해결해 실용적 가속을 달성했다.
핵심 요약
확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. 연구팀은 품질 저하 원인을 세 가지로 분석했다: 토큰 그룹화 제약, 부정확한 상호작용 선택, 폐기된 토큰의 주의 기여 손실이다. 이를 바탕으로 메타 캐시 희소 주의(MC-Sparse)를 제안했다. 훈련이 필요 없는 프레임워크로, 개별 키-값 토큰을 선택하면서 유사한 쿼리들을 타일 정렬 그룹으로 묶어 GPU 실행을 효율화한다. 전체 요약 6문장 읽기 → 017 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 018 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 019 18:35 ▲ 277 · 댓글 82 역전파 없이 트랜스포머를 학습하는 'Dust' 알고리즘 등장 연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. AI · 머신러닝 · Dust: Pretraining Transformers Without Backpropagation
Key Point 역전파 없이도 대규모 언어 모델을 학습할 수 있는 첫 경쟁력 있는 방법이 등장했으며, 기존 진화 전략보다 수천 배 효율적이고 계산량이 충분하면 역전파를 능가할 가능성을 보여준다.
핵심 요약
연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. Dust는 모든 토큰에서 독립적으로 활성화를 교란하여 각 토큰을 가상 개체군 구성원으로 취급하고, 한 번의 순전파에서 수천 개의 개체군 구성원을 병렬로 평가한다. 가중치 공간 진화 전략(EGGROLL)보다 1000배~10000배 효율적이며, 100만 토큰 이상에서 이를 달성한다. 전체 요약 11문장 읽기 → 020 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 021 06:11 ▲ 25 · 댓글 3 로봇 제어를 위한 생성형 디노이징 방식 NowWAM 제안 사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. AI · 머신러닝 · Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
Key Point 기존의 영상 예측 기반 로봇 제어 방식에서 벗어나 더 효율적인 디노이징 방식이 비슷하거나 더 나은 성능을 내면서도 계산량은 절반, 추론 속도는 1.8배 빠르다는 점이 실제 로봇 응용에서 의미가 있습니다.
핵심 요약
사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. 본 논문은 사전학습된 생성형 모델이 행동 학습에 실제로 무엇을 기여하는지, 그리고 제어를 위해 어떻게 적응해야 하는지 묻는다. NowWAM은 현재 관찰을 디노이징하고 같은 시각 스트림에서 로봇 행동을 예측하는 미래-목표-자유 방식의 공동 학습 방식으로, 생성 목표를 디노이징 궤적 전체에서 행동 표현에 직접 연결한다. 전체 요약 7문장 읽기 → 022 12:11 ▲ 67 · 댓글 2 사전학습 트랜스포머는 너무 일찍 멈춘다, 작은 LoRA로 해결 사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. AI · 머신러닝 · Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
Key Point 미세 조정 기법만으로 트랜스포머의 숨겨진 추론 능력을 200배까지 끌어낼 수 있다는 발견으로, 효율적인 모델 개선 방법을 제시한다.
핵심 요약
사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. 모든 모델 가중치를 고정한 상태에서 한 초기 계층에 rank-8 LoRA를 학습시키면 이 능력을 크게 확장할 수 있다. Qwen3-8B는 24줄 체인에서 정확도가 15.5%에서 99%로 개선되었고, 더 길게 학습된 LoRA는 50줄까지 도달했다. 전체 요약 7문장 읽기 → 023 03:11 ▲ 34 · 댓글 2 루프형 트랜스포머의 추론 효율 50% 끌어올리는 LoopCD 루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. AI · 머신러닝 · Decoding Looped Transformers Better for (Almost) Free
Key Point 루프형 트랜스포머는 추론 효율을 중시하는 모바일·엣지 환경에서 주목받는데, LoopCD로 추론 계산량을 절반 가까이 줄이면서 정확도도 높일 수 있다는 것이 중요하다.
핵심 요약
루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. 강한 예측과 약한 예측을 자동으로 쌍으로 제공하는 루프의 특성을 활용하면, 보조 모델이나 외부 학습 없이 디코딩을 개선할 수 있다. 연구진은 훈련 없는 대비학습 프레임워크 LoopCD를 제안했으며, 최종 예측을 이전 루프와 비교해 토큰 선택을 안내한다. 전체 요약 7문장 읽기 → 024 00:11 ▲ 14 · 댓글 1 이미지·영상 이해와 생성을 한 번에, 픽셀 기반 통합 모델 등장 기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. AI · 머신러닝 · PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
Key Point 인코더를 제거하고 픽셀 공간에서 직접 작동하는 통합 접근법은 시각-언어 파이프라인의 복잡도를 낮추면서도 이미지·영상 작업을 한 모델으로 처리하는 새로운 패러다임을 보여준다.
핵심 요약
기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. PixelUMM은 인코더 없이 픽셀 공간에서 이미지와 영상의 이해·생성을 통합하는 모델이다. 이미지를 공간 패치로, 영상을 시공간 튜블릿으로 표현해 원본 픽셀을 공유 백본에 단층 선형 투영으로 연결한다. 전체 요약 6문장 읽기 → 025 06:11 ▲ 11 · 댓글 1 루프형 트랜스포머의 단계 크기를 동적으로 조절하는 TAPS 알고리즘 순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. AI · 머신러닝 · Scheduling Recursive Reasoning in Looped Transformers
Key Point 반복적인 추론으로 정확도를 높이는 생성 모델의 효율성을 단계 크기 조절만으로 최대 56% 빠르게 만드는 실용적 기법이 핵심입니다.
핵심 요약
순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. 연구진은 터미널 손실에 대한 순환 업데이트 크기의 민감도를 분석하고, 시간 평균을 지속적 진전(persistent progress)과 중심화된 변동(centered fluctuation)의 정확한 분해식으로 도출함. 이를 바탕으로 TAPS(Trajectory Adaptive Progress-Fluctuation Scheduler)를 제안하며, 순환 업데이트 전반에서 두 요소의 균형을 추적하고 온라인으로 단계 크기를 동적 조정함. 전체 요약 6문장 읽기 → 026 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 027 00:11 ▲ 17 · 댓글 1 행렬 곱셈 대신 저비용 연산 쓰는 트랜스포머 구조 제시 기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. AI · 머신러닝 · Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
Key Point 행렬 곱셈 최적화가 아닌 완전히 다른 연산으로 대체할 때 처리량 증가 vs. 성능 저하 트레이드오프가 어떻게 나타나는지 보여주는 실험 결과이다.
핵심 요약
기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. 일반적인 행렬 곱셈을 희소한 상호작용 테이블로 대체하는 결합대수(associative algebra) 구성을 기반으로, 물리적 블록 크기가 고정되면 행렬 차원에서 이차 산술복잡도를 갖는 계층군을 구축했다. 이 구성은 Alder-Strassen 경계에 의해 쌍선형 순위(bilinear rank)에서 증명 가능하게 최적이며, 인과 마스킹(causal masking)과 KV 캐시 디코딩과 호환되는 행 타입의 직사각형 투영으로 실현할 수 있다. 전체 요약 6문장 읽기 → 028 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 46 · 댓글 1 테스트 시점 스케일링 효율 높이는 적응형 루프 트랜스포머 루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. AI · 머신러닝 · Improving Test-Time Scaling with Adaptive Looped Transformers
Key Point 긴 시퀀스 생성 시 추론 효율을 크게 높일 수 있는 새로운 방법이 제시돼, 언어 모델의 테스트 시점 성능-계산량 트레이드오프를 개선하려는 연구자들에게 중요하다.
핵심 요약
루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. 기존 루프 트랜스포머는 비루프 모델 대비 정확도-계산 기울기(테스트 시 디코딩 FLOPs 두 배당 정확도 이득)가 가파르지만, 같은 계산량에서는 비루프 모델에 미치지 못한다. 고정 깊이 루핑은 모든 토큰에 추가 반복을 쓰는데, 실제로는 많은 토큰이 추가 반복의 이득을 받지 못한다는 것을 발견했다. 전체 요약 8문장 읽기 → 030 12:11 ▲ 198 · 댓글 3 음악 생성 AI의 상징과 음향 통합한 YuE2 등장 Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AI · 머신러닝 · YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
Key Point 악보라는 명시적 중간 단계를 통해 AI 음악 생성의 투명성과 편집 가능성을 확보하면서도 상용 서비스와 경쟁할 수 있는 품질을 달성했기 때문이다.
핵심 요약
Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AR-NAR Mixture-of-Transformers(MoT) 아키텍처를 사용하며, 악보로 멜로디와 화성을 지정한 뒤 의미론적 음악 토큰으로 확장해 전곡 오디오를 생성한다. 전문가 평가에서 악보 기반 계획이 49.3%의 선호도를 기록해 계획 없는 생성의 34.6%를 앞질렀으며, 음악성과 전체 품질에서 우수했다. 전체 요약 9문장 읽기 → 031 15:11 ▲ 18 · 댓글 1 로봇 조작을 위한 통합 세계 행동 모델 InternW0-Δ 공개 로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. AI · 머신러닝 · InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
Key Point 로봇 조작 분야에서 대규모 오픈 데이터와 통합 프레임워크를 통해 실용적인 성능을 달성한 방법론이 공개되는 만큼, 로봇 학습과 시뮬-투-리얼 연구에 직접 활용할 수 있는 자료다.
핵심 요약
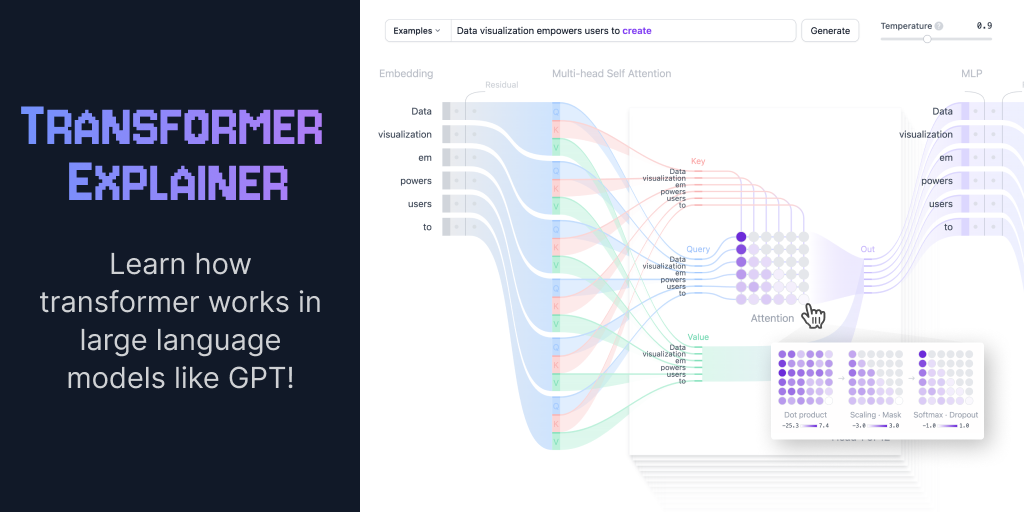
로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. InternW0-Δ는 Mixture-of-Transformers 프레임워크로 설계되었고, 사전학습된 비디오 전문가와 행동 전문가가 고정된 VLM의 의미 지도 아래에서 상호작용한다. 사전학습된 4D 파운데이션 모델이 기하학적, 모션 사전 정보를 훈련 전용 증류로 주입하며, Causal Imprint 방식은 미래 감독 신호에서 미래 관련 장면 변화를 학습한다. 전체 요약 6문장 읽기 → 032 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 → 033 21:10 당일 +141 처음부터 LLM 훈련하기, 모든 코드를 PyTorch로 직접 작성 Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. AI · 머신러닝 · FareedKhan-dev/train-llm-from-scratch · Python
Key Point LLM 개발의 모든 단계를 직접 이해하고 구현하려는 개발자와 연구자에게 명확한 참고 자료가 되어준다.
핵심 요약
Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. 단일 GPU로 수백만~수십억 개 파라미터 규모의 LLM을 훈련할 수 있으며, 데이터 전처리부터 텍스트 생성까지 전체 과정을 다룬다. trl, peft, transformers 같은 외부 라이브러리 없이 모든 알고리즘을 순수 PyTorch로 구현했다. 전체 요약 5문장 읽기 → 034 08:25 당일 +195 컴퓨터 비전 개발을 빠르게, Supervision 라이브러리 Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. 오픈소스 · 도구 · roboflow/supervision · Python
Key Point 컴퓨터 비전 프로젝트의 반복적인 작업을 표준화된 도구로 통일할 수 있어, 모델 선택에 관계없이 동일한 코드로 여러 프레임워크를 활용할 수 있다.
핵심 요약
Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. Ultralytics, Transformers, MMDetection 등 인기 라이브러리와 기본 통합되며, 커스텀 모델도 손쉽게 연결할 수 있다. 데이터 로딩부터 실시간 구역 카운팅까지 컴퓨터 비전 작업의 전체 파이프라인을 지원한다. 전체 요약 5문장 읽기 → 035 21:11 당일 +501 트랜스포머 생태계의 중심 - Hugging Face Transformers 라이브러리 Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. AI · 머신러닝 · huggingface/transformers · Python
Key Point Transformers는 최신 AI 모델들의 표준 정의 기준이 되어 있으며, 기업과 개발자가 프로덕션 환경에서 모델을 활용할 때 필수 생태계입니다.
핵심 요약
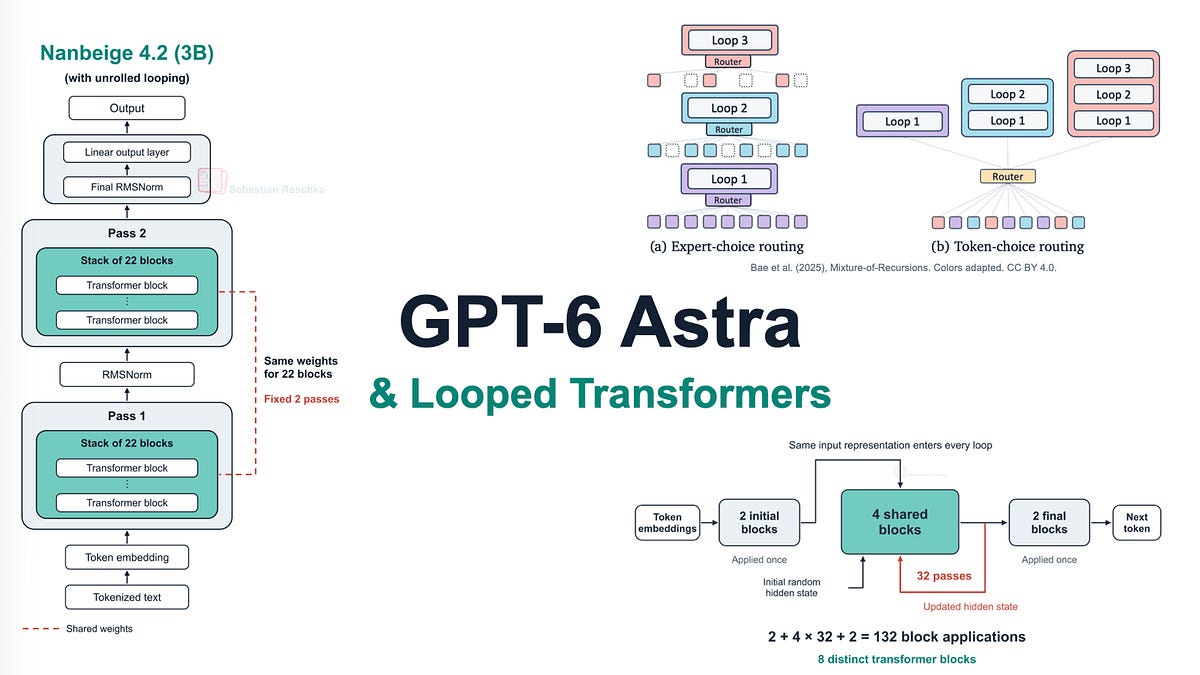
Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. 라이브러리가 정의한 모델은 Axolotl, Unsloth, DeepSpeed 등 대부분의 학습 프레임워크와 vLLM, SGLang, TGI 같은 추론 엔진에서 호환됩니다. Hugging Face Hub에 100만 개 이상의 사전학습 모델 체크포인트가 공개되어 있어 즉시 활용 가능합니다. 전체 요약 5문장 읽기 → 036 03:10 ▲ 172 · 댓글 62 GPT-6 Astra, 루프 트랜스포머, 숨겨진 추론 메커니즘 OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. AI · 머신러닝 · GPT-6 Astra, looped transformers, and hidden reasoning
Key Point GPT-6 Astra의 구체적인 성능 향상(특히 추론과 컴퓨터 조작 능력)을 이해해야 차세대 모델의 방향을 파악할 수 있습니다.
핵심 요약
OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. 컴퓨터 사용 능력이 뛰어나 로컬 PC의 그래픽 소프트웨어(페인트, 블렌더 등)를 마우스와 UI로 직접 조작할 수 있으며, 이는 데모 영상의 시각적 임팩트로 주목받고 있다. 루프 트랜스포머(반복적 깊이) 및 숨겨진 추론 메커니즘에 대한 건축학적 루머가 있으며, 이 글은 이러한 기술 혁신과 최근 연구를 분석한다. 037 08:12 ▲ 131 · 댓글 22 트랜스포머 모델의 어텐션 메커니즘을 시각화하다 트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. AI · 머신러닝 · Show HN: LLM Attention Visualization
Key Point LLM이 토큰을 생성할 때 어떤 과거 정보를 참고하는지 처음으로 직관적으로 볼 수 있어, 언어 모델의 동작 원리를 이해하는 데 도움이 된다.
핵심 요약
트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. 생성된 각 토큰을 클릭하면 영향을 미친 이전 토큰들이 투명도로 표시되며, 모든 어텐션 헤드와 레이어의 가중치를 집계하고 값 벡터 크기로 조정한 결과다. 예제에서 주소와 날짜처럼 그대로 복사되는 텍스트는 원본 데이터에서 높은 어텐션을 받으며, 작은 모델도 전체 함수 코드를 정확히 재현할 수 있는 이유를 보여준다. 전체 요약 5문장 읽기 → 038 00:10 ▲ 15 · 댓글 3 알리바바 Qwen 3.8 27B 공개, 로컬 모델 최고 성능 Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. AI · 머신러닝 · Qwen 3.8 27B is out: open weights, best local dense model yet
Key Point 로컬에서 구동 가능한 고성능 오픈소스 모델로, Hacker News 커뮤니티에서 배포 용이성과 벤치마크 성과에 주목받고 있다.
핵심 요약
Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. 27B 매개변수 모델로 코딩, 에이전트 작업, 멀티모달 이해 능력을 갖추고 262K 네이티브 컨텍스트를 지원한다. 터미널 코딩 벤치마크 73.0점, SWE-bench Pro 61.7점 등 기존 모델을 능가하는 성능을 보인다.