쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
51건 · "트랜스포머"조건 지우기 ×
001 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 002 12:11 ▲ 140 · 댓글 34 Qwen 가중치에 내장된 RISC-V CPU, 정확하게 동작하다 Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. AI · 머신러닝 · Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5
Key Point 언어 모델이 외부 도구 없이 정확한 산술 계산과 파일 저장을 수행할 수 있다는 새로운 가능성을 보여주며, AI 안전성 연구와 해석가능성 측면에서도 중요한 아키텍처 실험이다.
핵심 요약
Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. Gated DeltaNet 레이어의 게이트를 1로, 쓰기 강도를 1로, 원-핫 키 인코딩을 사용하면 정확한 주소 지정이 가능한 RAM이 되며, 이는 일반 어텐션의 KV 캐시보다 메모리 효율이 높다. CPU는 32비트 RISC-V 코어(RV32IM 명령어 세트)로 모델의 처음 11개 레이어를 차지하며, 컴파일러가 회로 설명을 트랜스포머 레이어의 어텐션 헤드와 피드포워드 유닛으로 변환한다. 전체 요약 11문장 읽기 → 003 21:11 ▲ 14 · 댓글 2 주의력 레이어에 희소성 더하는 Nestor 모델 제안 현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. AI · 머신러닝 · Nested Sparsity for Scalable Pretraining and Continual Learning
Key Point 조건부 계산의 새로운 메커니즘이 기존 MoE 모델의 학습 효율과 연속 학습 능력을 동시에 개선하는 구체적인 방법을 제시하고 있습니다.
핵심 요약
현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. 이 논문은 주의력 연산자를 일반화한 대안적 조건부 계산 메커니즘을 제안하며, 이는 MoE 희소성과 계층적으로 결합되는 '중첩 희소성'을 만든다. Nestor라 명명한 이 모델은 동일한 계산량과 희소성에서 기존 MoE 트랜스포머보다 언어 모델 사전학습에서 더 나은 성능을 보인다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 005 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 006 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 007 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 008 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 009 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 010 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 011 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 012 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 013 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 014 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 → 015 18:11 ▲ 65 · 댓글 3 텍스트와 레이아웃 제어가 강한 오픈소스 이미지 생성 모델 MOSS-Image 5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. AI · 머신러닝 · MOSS-Image Technical Report
Key Point 닫힌소스 모델만 가능하던 고품질 텍스트 렌더링과 복잡한 레이아웃 제어를 오픈소스로 구현한 첫 사례로, 텍스트 기반 이미지 생성의 새로운 기준을 제시한다.
핵심 요약
5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. 사용자의 다양한 요청을 상세한 콘텐츠와 레이아웃 명세로 변환하는 의도 인식 에이전트 프롬프트 향상 모듈을 개발했다. 장문 영어·중국어 텍스트 렌더링을 평가하는 LongLongTextBench(LLTB)와 엔드투엔드 레이아웃 생성을 평가하는 RealLayoutArena(RLA)를 새로 도입했다. 전체 요약 6문장 읽기 → 016 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 017 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 018 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 019 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 020 06:11 ▲ 14 · 댓글 2 픽셀 공간 확산 모델, 잠재 공간 모델과 동등한 성능 보여 픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. AI · 머신러닝 · Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
Key Point 픽셀 공간 확산 모델이 세밀한 디테일 작업에서 잠재 공간 모델을 이길 것이라는 기대와 달리 실제로는 동등한 성능만 낸 이유를 알 수 있고, 픽셀 공간 사전학습의 한계와 가능성을 실증적으로 보여준다.
핵심 요약
픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. 3B 매개변수 규모의 Iris-3B 픽셀 공간 텍스트-이미지 트랜스포머를 256→512→1024 커리큘럼으로 처음부터 학습했고, 또한 FLUX.2 Klein 4B 잠재 모델을 픽셀 공간으로 변환했다. 두 모델 모두 단안 깊이 추정과 이미지 복원/초해상화 작업에 미세조정했으나, 픽셀 공간 생성 사전에서 의미 있는 성능 향상을 발견하지 못했다. 전체 요약 6문장 읽기 → 021 15:13 ▲ 24 · 댓글 3 깊이 추정 없이 카메라 관점 변환 비디오 생성 외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. AI · 머신러닝 · LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
Key Point 깊이 추정 단계를 제거하면서도 비디오 생성 품질을 높이는 새로운 접근법으로, 구조 정렬과 세부 복원의 역할 분담 방식이 확산 모델의 특성과 어떻게 부합하는지 보여준다.
핵심 요약
외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. 기존 최첨단 방식은 깊이를 추정해 포인트 클라우드로 변환한 후 자아중심 카메라 관점에서 재렌더링하고, 이를 비디오 확산 모델의 조건으로 사용한다. 그러나 이 결정론적 매핑은 각 픽셀을 한 위치에만 할당하므로 깊이 오류가 콘텐츠 배치 오류로 전파되고, 텍스처는 보존되지만 정확도가 떨어진다. 전체 요약 9문장 읽기 → 022 18:35 ▲ 277 · 댓글 82 역전파 없이 트랜스포머를 학습하는 'Dust' 알고리즘 등장 연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. AI · 머신러닝 · Dust: Pretraining Transformers Without Backpropagation
Key Point 역전파 없이도 대규모 언어 모델을 학습할 수 있는 첫 경쟁력 있는 방법이 등장했으며, 기존 진화 전략보다 수천 배 효율적이고 계산량이 충분하면 역전파를 능가할 가능성을 보여준다.
핵심 요약
연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. Dust는 모든 토큰에서 독립적으로 활성화를 교란하여 각 토큰을 가상 개체군 구성원으로 취급하고, 한 번의 순전파에서 수천 개의 개체군 구성원을 병렬로 평가한다. 가중치 공간 진화 전략(EGGROLL)보다 1000배~10000배 효율적이며, 100만 토큰 이상에서 이를 달성한다. 전체 요약 11문장 읽기 → 023 06:11 ▲ 17 · 댓글 1 긴 동영상의 물체 추적 난제 해결한 LVMT 논문 발표 기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. AI · 머신러닝 · LVMT: Video Mask Transformer for Long-term Video Segmentation
Key Point 긴 동영상에서 물체 추적의 근본적인 한계를 해결한 새로운 구조와 학습 방법으로, 실제 응용에서 정확도와 속도의 트레이드오프를 동시에 개선했다.
핵심 요약
기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. 이 문제는 시간에 따라 어떤 물체 정보를 전파할지 선택하지 못하는 시간적 전파 메커니즘과 메모리·그래디언트 소실로 인해 긴 동영상 학습이 불가능한 탓이다. 연구팀은 경량 GRU 기반 시간적 전파 모듈을 제안해 메모리에 유지할 정보를 학습으로 선택할 수 있게 했다. 전체 요약 5문장 읽기 → 024 15:11 ▲ 91 · 댓글 4 장시간 영상 생성용 미래 예측 프레임 선택 기법 FrameMorrow 장시간 영상 생성에서 생성 이력이 길어질수록 모든 이전 콘텐츠를 유지하는 것이 비효율적이고 중복적이어서 효과적인 이력 선택이 필수적이다. AI · 머신러닝 · FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
Key Point 장시간 영상을 일관되게 생성하는 핵심 병목인 메모리 효율성을 미래 예측 기반 선택으로 해결하는 새로운 접근법이 실제 환경에서 효과를 입증했다.
핵심 요약
장시간 영상 생성에서 생성 이력이 길어질수록 모든 이전 콘텐츠를 유지하는 것이 비효율적이고 중복적이어서 효과적인 이력 선택이 필수적이다. 기존 방식들은 현재 콘텐츠 기반으로 과거 정보의 관련성을 판단하지만, 현재에 관련된 정보가 미래 생성에 반드시 유용한 것은 아니고 적어 보이는 과거가 나중에 중요할 수 있다. 핵심 통찰은 과거 정보를 미래 정보 수요에 대한 관련성에 따라 선택해야 한다는 것이다. 전체 요약 8문장 읽기 → 025 06:11 ▲ 110 · 댓글 18 버려진 영국 전기실, 아날로그 시대의 제어판 남겨 워킹의 버려진 전기 제어실을 탐사한 사진 시리즈다. 하드웨어 · 시스템 · Woking Electrical Control Room (2016)
Key Point 20세기 전기 인프라 운영의 아날로그 시대 모습을 보존한 역사적 기록이 담겨 있다.
핵심 요약
워킹의 버려진 전기 제어실을 탐사한 사진 시리즈다. 외부 도어부터 내부 제어판까지 건물 전체를 촬영했다. 제어벽에는 각 변전소나 트랜스포머를 나타내는 여러 위치 표시가 있다. 전체 요약 7문장 읽기 → 026 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 027 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 028 12:11 ▲ 67 · 댓글 2 사전학습 트랜스포머는 너무 일찍 멈춘다, 작은 LoRA로 해결 사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. AI · 머신러닝 · Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
Key Point 미세 조정 기법만으로 트랜스포머의 숨겨진 추론 능력을 200배까지 끌어낼 수 있다는 발견으로, 효율적인 모델 개선 방법을 제시한다.
핵심 요약
사전학습된 트랜스포머들은 맥락 참조를 따르기 위해 모델의 깊이를 거의 활용하지 않으며, 13개 기본 모델은 평균 1.4~3.6줄의 체인만 따를 수 있다. 모든 모델 가중치를 고정한 상태에서 한 초기 계층에 rank-8 LoRA를 학습시키면 이 능력을 크게 확장할 수 있다. Qwen3-8B는 24줄 체인에서 정확도가 15.5%에서 99%로 개선되었고, 더 길게 학습된 LoRA는 50줄까지 도달했다. 전체 요약 7문장 읽기 → 029 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 030 03:11 ▲ 34 · 댓글 2 루프형 트랜스포머의 추론 효율 50% 끌어올리는 LoopCD 루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. AI · 머신러닝 · Decoding Looped Transformers Better for (Almost) Free
Key Point 루프형 트랜스포머는 추론 효율을 중시하는 모바일·엣지 환경에서 주목받는데, LoopCD로 추론 계산량을 절반 가까이 줄이면서 정확도도 높일 수 있다는 것이 중요하다.
핵심 요약
루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. 강한 예측과 약한 예측을 자동으로 쌍으로 제공하는 루프의 특성을 활용하면, 보조 모델이나 외부 학습 없이 디코딩을 개선할 수 있다. 연구진은 훈련 없는 대비학습 프레임워크 LoopCD를 제안했으며, 최종 예측을 이전 루프와 비교해 토큰 선택을 안내한다. 전체 요약 7문장 읽기 → 031 06:11 ▲ 17 · 댓글 2 반복 구조와 희소 전문가 모델의 스케일링 법칙 제시 로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. AI · 머신러닝 · Scaling Laws for Looped Mixture of Experts
Key Point 반복 구조와 희소 전문가 모델을 함께 스케일링하는 첫 통합 법칙으로, 제한된 연산량에서 효율성 극대화를 원하는 대규모 모델 개발의 새로운 설계 기준을 제공한다.
핵심 요약
로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. 기존 스케일링 법칙은 반복 구조와 희소성을 따로 모델링했으나, 이 논문은 반복 구조와 희소성을 모델 크기·데이터와 함께 통합 모델링하는 'Loop Scaling Laws'를 제시했다. 핵심은 희소성-조건부 반복 매핑으로, 반복을 통한 유효 파라미터 이득을 특성화하고 희소성이 이 이득을 어떻게 높이는지를 나타낸다. 전체 요약 7문장 읽기 → 032 03:11 ▲ 40 · 댓글 2 반복 구조로 시각-언어 이해를 깊이있게 처리하는 LoopVL Loop Transformer를 시각-언어 모델로 확장한 LoopVL을 제시한다. AI · 머신러닝 · LoopVL: Recurrent Visual Intelligence
Key Point 반복 구조 기반 비전-언어 모델이 기존 방식보다 더 효율적으로 복잡한 멀티모달 추론을 처리할 수 있음을 실증적으로 보여주는 새로운 아키텍처 패러다임입니다.
핵심 요약
Loop Transformer를 시각-언어 모델로 확장한 LoopVL을 제시한다. Module-Loop와 Model-Loop 연산을 결합하여 공유 모듈을 통해 통합 시각-언어 상태를 반복적으로 업데이트한다. 언어 사전학습, 멀티모달 학습, 포스트 학습 단계를 거쳐 처음부터 훈련했다. 전체 요약 6문장 읽기 → 033 21:11 ▲ 125 · 댓글 69 NVIDIA DLSS 5를 Vulkan으로 완벽 복제한 오픈소스 프로젝트 NVIDIA DLSS 5 신경망 렌더링 네트워크를 Vulkan으로 재구현한 OpenDLSS-NR 공개했으며, 원본과 바이트 단위로 정확하게 일치한다. 오픈소스 · 도구 · OpenDLSS: A Vulkan Reimplementation of Nvidia's DLSS 5 Neural Rendering Network
Key Point GPU 가속 렌더링에서 NVIDIA의 독점 기술을 오픈소스로 복제한 것으로, 게임 엔진이나 그래픽 애플리케이션 개발자들이 DLSS 기술의 동작 원리를 이해하고 커스터마이징할 수 있는 길을 열었다.
핵심 요약
NVIDIA DLSS 5 신경망 렌더링 네트워크를 Vulkan으로 재구현한 OpenDLSS-NR 공개했으며, 원본과 바이트 단위로 정확하게 일치한다. 빌드 310.8.0의 71개 블록 Swin/ViT 신경망과 동일하며, 텐서 코어에서 FP8로 실행되고 75개 블록 경계의 중간 데이터까지 모두 일치한다. WebGPU 포트도 제공하는데 브라우저에서 동작하며 텐서 코어나 FP8 없이도 동일한 바이트를 생성한다. 전체 요약 10문장 읽기 → 034 06:11 ▲ 11 · 댓글 1 루프형 트랜스포머의 단계 크기를 동적으로 조절하는 TAPS 알고리즘 순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. AI · 머신러닝 · Scheduling Recursive Reasoning in Looped Transformers
Key Point 반복적인 추론으로 정확도를 높이는 생성 모델의 효율성을 단계 크기 조절만으로 최대 56% 빠르게 만드는 실용적 기법이 핵심입니다.
핵심 요약
순환 추론 모델은 공유 파라미터로 잠재 상태를 반복 개선하며 테스트 시간 계산을 확장하는데, 기존에는 고정된 단위 크기의 업데이트를 적용해 효율성이 제한됨. 연구진은 터미널 손실에 대한 순환 업데이트 크기의 민감도를 분석하고, 시간 평균을 지속적 진전(persistent progress)과 중심화된 변동(centered fluctuation)의 정확한 분해식으로 도출함. 이를 바탕으로 TAPS(Trajectory Adaptive Progress-Fluctuation Scheduler)를 제안하며, 순환 업데이트 전반에서 두 요소의 균형을 추적하고 온라인으로 단계 크기를 동적 조정함. 전체 요약 6문장 읽기 → 035 03:11 ▲ 99 · 댓글 3 KV 캐시 압축의 숨은 약점, 위치에 따라 정확도 40%p 차이 긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. AI · 머신러닝 · Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
Key Point 긴 문맥 추론 최적화를 위해 KV 캐시 압축을 도입하면 평균 점수로는 보이지 않는 주기적 성능 저하가 발생하므로, 이 기법의 실제 안정성을 평가할 때 주의가 필요하다.
핵심 요약
긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. 같은 정보가 어떤 phase에서는 쉽게 검색되지만 다른 phase에서는 어렵다는 체계적인 비대칭성이 발생하며, 이를 phase sensitivity라고 명명했다. 대규모 오픈소스 모델들에서 long-context 검색 정확도가 phase에 따라 최대 40 percentage points 차이가 나타나, 평균 벤치마크 점수로는 드러나지 않는 주기적 약점들이 존재한다. 전체 요약 7문장 읽기 → 036 00:11 ▲ 17 · 댓글 1 행렬 곱셈 대신 저비용 연산 쓰는 트랜스포머 구조 제시 기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. AI · 머신러닝 · Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
Key Point 행렬 곱셈 최적화가 아닌 완전히 다른 연산으로 대체할 때 처리량 증가 vs. 성능 저하 트레이드오프가 어떻게 나타나는지 보여주는 실험 결과이다.
핵심 요약
기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. 일반적인 행렬 곱셈을 희소한 상호작용 테이블로 대체하는 결합대수(associative algebra) 구성을 기반으로, 물리적 블록 크기가 고정되면 행렬 차원에서 이차 산술복잡도를 갖는 계층군을 구축했다. 이 구성은 Alder-Strassen 경계에 의해 쌍선형 순위(bilinear rank)에서 증명 가능하게 최적이며, 인과 마스킹(causal masking)과 KV 캐시 디코딩과 호환되는 행 타입의 직사각형 투영으로 실현할 수 있다. 전체 요약 6문장 읽기 → 037 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 038 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 039 15:11 ▲ 46 · 댓글 1 테스트 시점 스케일링 효율 높이는 적응형 루프 트랜스포머 루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. AI · 머신러닝 · Improving Test-Time Scaling with Adaptive Looped Transformers
Key Point 긴 시퀀스 생성 시 추론 효율을 크게 높일 수 있는 새로운 방법이 제시돼, 언어 모델의 테스트 시점 성능-계산량 트레이드오프를 개선하려는 연구자들에게 중요하다.
핵심 요약
루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. 기존 루프 트랜스포머는 비루프 모델 대비 정확도-계산 기울기(테스트 시 디코딩 FLOPs 두 배당 정확도 이득)가 가파르지만, 같은 계산량에서는 비루프 모델에 미치지 못한다. 고정 깊이 루핑은 모든 토큰에 추가 반복을 쓰는데, 실제로는 많은 토큰이 추가 반복의 이득을 받지 못한다는 것을 발견했다. 전체 요약 8문장 읽기 → 040 15:11 ▲ 103 · 댓글 48 AI가 '지식 노동' 경제를 해체하다 저자는 LLM을 이용해 1989년 고전 게임 '전쟁의 창(War of the Lance)'을 역공학하고 현대 브라우저로 포팅한 경험을 공유한다. AI · 머신러닝 · What reversing, modernising old games tells us about the economic impact of AI
Key Point 지식 노동의 희소성이 AI로 사라지는 과정을 게임 개발 구체 사례로 보여주며, 단순한 기술 발전을 넘어 경제 구조 변화의 신호를 던진다.
핵심 요약
저자는 LLM을 이용해 1989년 고전 게임 '전쟁의 창(War of the Lance)'을 역공학하고 현대 브라우저로 포팅한 경험을 공유한다. Qwen-3.8-Flash-Next로 한 주 안에 충실한 게임 재현과 Three.js 렌더링 엔진을 구현했으며, 이를 토탈워와 히어로즈 오브 마이트 앤 매직 스타일로 현대화하고 있다. Fable 5.1로 주당 80~100개 3D 모델을 생성할 수 있으며, GPT-6 Astra는 중급 전문가 수준의 3D 모델링 능력을 보였다. 전체 요약 15문장 읽기 → 041 00:11 ▲ 75 · 댓글 2 트랜스포머의 선형 중첩: 서로 다른 텍스트를 동시에 처리한다 LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. AI · 머신러닝 · Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
Key Point LLM이 내부적으로 여러 의미를 동시에 처리하는 선형적 구조를 가진다는 발견은 모델의 동작 방식에 대한 근본적인 이해를 바꾸며, 하나의 추론으로 여러 결과를 생성하는 효율성 개선까지 가능하게 한다.
핵심 요약
LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. 이 중첩 현상은 트랜스포머 아키텍처의 고유한 특성이며, 학습 과정 중에 오히려 감소하는 경향을 보였다. 경량 파인튜닝을 통해 선형성을 상당히 복원할 수 있으며, 예측된 다음 토큰 분포와 개별 분포의 평균 간 차이를 크게 줄일 수 있다. 전체 요약 4문장 읽기 → 042 15:11 ▲ 31 · 댓글 2 양자 회로로 언어모델 성능 끌어올린다 언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. AI · 머신러닝 · Circuit Hypernetworks for Quantum-Augmented Diffusion Language Models
Key Point 양자컴퓨팅의 이론적 우월성을 실제 언어모델 작업에 구현하면서 계산 효율성을 확보한 새로운 아키텍처로, 고비용 양자 회로를 대규모 신경망에 통합하는 방법론을 제시한다.
핵심 요약
언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. 토큰의 숨겨진 상태를 읽어 양자 회로의 좌표를 생성하고 실행한 후 결과를 잔차 연결로 더한다. 회로 하이퍼네트워크가 토큰별로 회전각과 결합력, 측정축을 생성하되 공유 희소 회로 구조를 사용한다. 전체 요약 5문장 읽기 → 043 16:18 ▲ 84 · 댓글 3 로봇 기초모델, 3D 공간 이해로 조작 정확도 높이다 기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. AI · 머신러닝 · Grounded Action Model: 3D Grounding as a Foundation for Robotics
Key Point 로봇 조작 작업에서 객체 위치와 기하학 정보를 명시적으로 모델링함으로써 일반화 능력을 크게 개선한 새로운 아키텍처 패러다임으로, 실제 로봇 배포의 신뢰성을 높이는 핵심 진전입니다.
핵심 요약
기존 로봇 기초모델은 언어-비전-행동 모델(VLA)이나 세계-행동 모델(WAM)을 기반하지만 3D 공간 정보를 직접 학습하지 않아 로봇 시연 데이터에만 의존했다. Grounded Action Models(GAM)은 3D 공간 정보를 명시적으로 포함한 새로운 로봇 기초모델로, 언어·포인트·박스 프롬프트 등으로 입력받은 후 공유 객체 표현으로 변환해 행동을 예측한다. 이 표현은 목표 대상의 시각 특징과 기하학적 정보를 담으며 로봇 상태 이력과 함께 멀티스트림 트랜스포머로 처리된다. 전체 요약 6문장 읽기 → 044 21:10 당일 +141 처음부터 LLM 훈련하기, 모든 코드를 PyTorch로 직접 작성 Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. AI · 머신러닝 · FareedKhan-dev/train-llm-from-scratch · Python
Key Point LLM 개발의 모든 단계를 직접 이해하고 구현하려는 개발자와 연구자에게 명확한 참고 자료가 되어준다.
핵심 요약
Attention is All You Need 논문을 기반으로 PyTorch에서 트랜스포머 모델을 처음부터 구현한 튜토리얼 저장소. 단일 GPU로 수백만~수십억 개 파라미터 규모의 LLM을 훈련할 수 있으며, 데이터 전처리부터 텍스트 생성까지 전체 과정을 다룬다. trl, peft, transformers 같은 외부 라이브러리 없이 모든 알고리즘을 순수 PyTorch로 구현했다. 전체 요약 5문장 읽기 → 045 06:10 ▲ 122 · 댓글 63 캑터스 니들 3: 8~29MB 경량 모델이 DeepSeek V4 Flash 수준 성능 8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. AI · 머신러닝 · Show HN: Cactus Needle 3: 8-29MB automation models can match DeepSeek V4 Flash
Key Point 에지 기기 AI의 핵심 병목이던 모델 크기와 성능의 트레이드오프를 근본적으로 바꾸는 아키텍처로, 온디바이스 AI 구현이 현실화될 수 있음을 보여줍니다.
핵심 요약
8~29MB 크기의 경량 자동화 모델 캑터스 니들 3을 공개했습니다. Laddered Simple Attention Networks 아키텍처로 같은 크기 트랜스포머 대비 토큰당 2배 적은 연산을 사용합니다. 4계층 모델을 파인튜닝하면 DeepSeek V4 Flash와 같은 성능을 내며, 라즈베리파이5에서 초당 400~4000토큰을 처리합니다. 전체 요약 6문장 읽기 → 046 21:11 당일 +500 금융 시장 전문 AI 모델 Kronos 오픈소스 공개 금융 캔들차트(K-line) 데이터 분석에 특화된 오픈소스 기초 모델 Kronos를 공개했습니다. 전 세계 45개 이상의 거래소 데이터로 사전 학습되었습니다. AI · 머신러닝 · shiyu-coder/Kronos · Python
Key Point 금융 시계열 분석에 특화된 첫 오픈소스 기초 모델로, 일반 시계열 모델과 달리 K-line 데이터의 독특한 특성을 처리하도록 설계되어 개인 트레이더와 정량 분석가들이 직접 활용할 수 있습니다.
핵심 요약
금융 캔들차트(K-line) 데이터 분석에 특화된 오픈소스 기초 모델 Kronos를 공개했습니다. 전 세계 45개 이상의 거래소 데이터로 사전 학습되었습니다. OHLCV 데이터를 계층적 이산 토큰으로 변환하는 전문화된 토크나이저와 자동회귀 트랜스포머로 구성되어 금융 데이터의 높은 노이즈 특성을 처리합니다. Kronos-mini(4.1M), Kronos-small(24.7M), Kronos-base(102.3M), Kronos-large(499.2M) 등 다양한 크기의 모델을 Hugging Face Hub에서 무료로 제공합니다. 전체 요약 5문장 읽기 → 047 00:10 ▲ 100 · 댓글 17 트랜스포머 회로 분석을 위한 수학적 프레임워크 GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. AI · 머신러닝 · A Mathematical Framework for Transformer Circuits (2021)
Key Point 대형 언어 모델의 예상 밖의 동작을 체계적으로 설명하고 안전 문제를 사전에 발견할 수 있는 기초 프레임워크를 제시하는 연구로, 모델 해석가능성 분야의 초기 이정표이다.
핵심 요약
GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. 이 논문은 트랜스포머를 역공학하기 위한 초기 단계로서, 가장 단순한 2층 이하의 어텐션 전용 모델부터 시작해 기본 알고리즘 패턴을 발견하는 것을 목표로 한다. 트랜스포머의 동작을 수학적으로 동등하면서도 새로운 관점으로 재구성함으로써, 특정 어텐션 헤드인 '귀납 헤드(induction heads)'가 인컨텍스트 학습을 설명할 수 있음을 발견했다. 전체 요약 5문장 읽기 → 048 21:11 당일 +501 트랜스포머 생태계의 중심 - Hugging Face Transformers 라이브러리 Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. AI · 머신러닝 · huggingface/transformers · Python
Key Point Transformers는 최신 AI 모델들의 표준 정의 기준이 되어 있으며, 기업과 개발자가 프로덕션 환경에서 모델을 활용할 때 필수 생태계입니다.
핵심 요약
Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. 라이브러리가 정의한 모델은 Axolotl, Unsloth, DeepSpeed 등 대부분의 학습 프레임워크와 vLLM, SGLang, TGI 같은 추론 엔진에서 호환됩니다. Hugging Face Hub에 100만 개 이상의 사전학습 모델 체크포인트가 공개되어 있어 즉시 활용 가능합니다. 전체 요약 5문장 읽기 → 049 18:10 ▲ 101 · 댓글 99 AI 연구자들, 재귀적 자기개선까지 가는 길 논쟁 OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. AI · 머신러닝 · AI researchers debate how close we are to recursive self-improvement
Key Point AI가 지수적으로 자기 자신을 개선할 수 있다는 시나리오가 과장된 것 아닌지, 실제 프론티어 연구자들이 어떤 장애물을 현실적으로 보고 있는지 알 수 있다.
핵심 요약
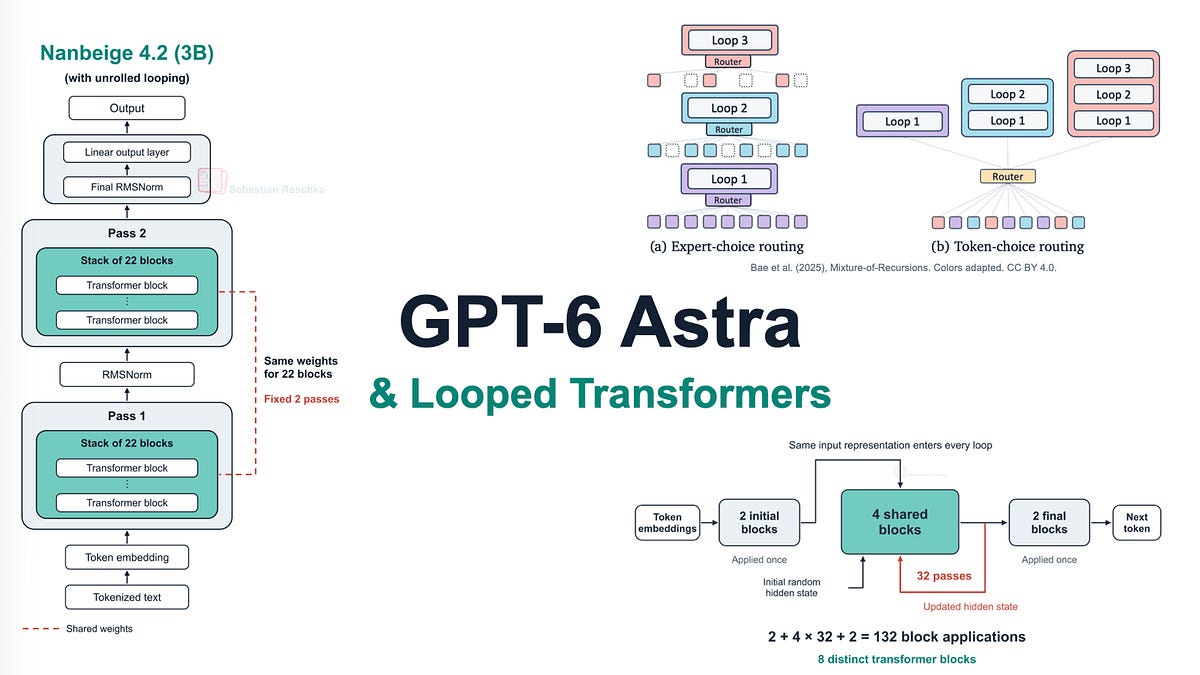
OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. 만약 2036년에 초지능이 세상을 근본적으로 바꾸지 못한다면, 가장 가능성 높은 기술적 이유는 메타러닝 일반화의 어려움과 연속학습(continual learning) 문제라고 논의했다. AI 모델이 벤치마크에서는 우수하지만 현실 환경으로의 적용(sim-to-real gap)에서 계속 막힐 수 있고, 이것이 성능 향상 사이클을 반복시킬 수 있다고 밀리지는 지적했다. 전체 요약 5문장 읽기 → 050 03:10 ▲ 172 · 댓글 62 GPT-6 Astra, 루프 트랜스포머, 숨겨진 추론 메커니즘 OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. AI · 머신러닝 · GPT-6 Astra, looped transformers, and hidden reasoning
Key Point GPT-6 Astra의 구체적인 성능 향상(특히 추론과 컴퓨터 조작 능력)을 이해해야 차세대 모델의 방향을 파악할 수 있습니다.
핵심 요약
OpenAI의 GPT-6 Astra는 코딩, 수학, 3D 렌더링 등 거의 모든 카테고리에서 GPT-5.6을 능가하며, 특히 ARC-AGI-3 벤치마크에서 99.9% 정확도를 기록했다. 컴퓨터 사용 능력이 뛰어나 로컬 PC의 그래픽 소프트웨어(페인트, 블렌더 등)를 마우스와 UI로 직접 조작할 수 있으며, 이는 데모 영상의 시각적 임팩트로 주목받고 있다. 루프 트랜스포머(반복적 깊이) 및 숨겨진 추론 메커니즘에 대한 건축학적 루머가 있으며, 이 글은 이러한 기술 혁신과 최근 연구를 분석한다. 051 08:12 ▲ 131 · 댓글 22 트랜스포머 모델의 어텐션 메커니즘을 시각화하다 트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. AI · 머신러닝 · Show HN: LLM Attention Visualization
Key Point LLM이 토큰을 생성할 때 어떤 과거 정보를 참고하는지 처음으로 직관적으로 볼 수 있어, 언어 모델의 동작 원리를 이해하는 데 도움이 된다.
핵심 요약
트랜스포머 기반 LLM이 다음 토큰을 생성할 때 과거 토큰들로부터 얼마나 정보를 가져오는지 보여주는 인터랙티브 시각화 도구를 만들었다. 생성된 각 토큰을 클릭하면 영향을 미친 이전 토큰들이 투명도로 표시되며, 모든 어텐션 헤드와 레이어의 가중치를 집계하고 값 벡터 크기로 조정한 결과다. 예제에서 주소와 날짜처럼 그대로 복사되는 텍스트는 원본 데이터에서 높은 어텐션을 받으며, 작은 모델도 전체 함수 코드를 정확히 재현할 수 있는 이유를 보여준다. 전체 요약 5문장 읽기 →