쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "기하학"조건 지우기 ×
001 09:11 ▲ 110 · 댓글 29 LLM의 내부 상태 지도: 수천 개 대화의 벡터 풍경 Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. AI · 머신러닝 · What thousands of conversations look like inside a language model
Key Point LLM이 대화를 처리할 때 내부 벡터 공간에서 어떤 구조를 형성하는지, 다국어와 코드가 어떻게 배치되는지 구체적으로 보여줌으로써 모델의 표현 방식과 한계를 이해할 수 있다.
핵심 요약
Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. 100개 주제에 걸친 영어·중국어·독일어·크로아티아어 문답 900개와 Python 코딩 예제 90개를 처리해 각 토큰 위치의 2,048차원 벡터를 기록하고 3차원 공간으로 투영했다. 각 토큰은 임베딩 테이블에서 시작 벡터를 받아 모델의 레이어들이 문맥에 따라 변환하는데, 최종 토큰 상태들을 연결한 선은 각 대화의 경로를 나타낸다. 전체 요약 11문장 읽기 → 002 03:11 ▲ 21 · 댓글 5 가중치 0.05% 삭제하는 것만으로 LLM 파인튜닝과 동급 성능 트랜스포머 블록의 게이트 프로젝션에서 가중치의 0.05% 미만을 0으로 만드는 방식(Deletion Tuning)으로 전체 모델 파인튜닝(FFT)과 동등한 성능을 달성했다. AI · 머신러닝 · The Surprising Effectiveness of Deleting Weights in LLM Post-Training
Key Point 매우 적은 수의 가중치만 제거해도 전체 파인튜닝 수준의 성능을 낼 수 있다는 발견은 LLM 적응 학습의 효율성을 크게 개선하며, 특히 지속적인 학습에서 이전 성능 유지와 모델 크기 최소화 사이의 오래된 문제를 동시에 해결한다.
핵심 요약
트랜스포머 블록의 게이트 프로젝션에서 가중치의 0.05% 미만을 0으로 만드는 방식(Deletion Tuning)으로 전체 모델 파인튜닝(FFT)과 동등한 성능을 달성했다. 강화학습 기반 보상, 감독형 파인튜닝, 온폴리시 증류 등 세 가지 LLM 포스트트레이닝 방식 모두에서 FFT와 같은 수준의 학습 결과를 얻었다. 학습된 마스크는 대응하는 FFT 체크포인트보다 수백 배에서 수천 배 작으며, 연속 학습에서 중요한 과제인 이전 작업 망각을 크게 줄인다. 전체 요약 5문장 읽기 → 003 03:11 ▲ 14 · 댓글 4 단백질 진화에 최적화된 뮤테이션 예측 모델 공개 깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. AI · 머신러닝 · ProTEUS: A mutation-resolved world model for closed-loop protein evolution
Key Point 단백질 설계에서 실험 스크리닝으로는 탐색 불가능한 조합적 돌연변이 공간을 효율적으로 탐색하는 AI 모델이 나왔으며, 실제 실험으로 10배 이상의 성능 개선을 입증했다.
핵심 요약
깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. 기하학적 제약 강제를 통해 AlphaFold3 대비 10배 이상 빠른 물리적으로 타당한 전체 원자 예측 엔진을 개발해 많은 변이체 탐색을 지원한다. 실험 피드백 루프를 통해 단백질 활성 예측을 반복 개선하면서 원하는 표현형으로 진화를 유도한다. 전체 요약 6문장 읽기 → 004 15:11 ▲ 26 · 댓글 2 로봇 손가락 조작, 앞선 시각 감각으로 성공률 11% 높였다 정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. AI · 머신러닝 · DexForesight: Grounding Dexterous Policies with Implicit Spatial Foresight
Key Point 로봇이 손가락 관절의 복잡한 움직임을 미리 예측하는 방식이 기존 대비 단순화되면서, 실제 환경에서 정교한 조작 작업의 성공률이 크게 올랐다.
핵심 요약
정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. DexForesight는 세계 모델을 정책의 잠재 공간에 주입해 공간 예측을 암묵적으로 학습하는 프레임워크다. 오프라인 장면 깊이 정보, 손 기하학, 시연 궤적으로부터 행동 조건부 세계 모델을 학습한다. 전체 요약 8문장 읽기 → 005 12:11 ▲ 149 · 댓글 27 테렌스 타오의 '수학 6가지 본질' 공개 필즈상 수상자 테렌스 타오가 '수학 6가지 본질'이라는 저작물을 공개했다. 기타 · Six Math Essentials by Terence Tao
Key Point 기초 수학의 여섯 가지 근본 개념을 세계적 수학자가 일반인도 접근 가능하게 정리한 자료로, 개발자의 논리적 사고력을 키우려는 학습에 참고할 수 있다.
핵심 요약
필즈상 수상자 테렌스 타오가 '수학 6가지 본질'이라는 저작물을 공개했다. 이 책은 고대부터 현대까지 수학자들을 이끈 여섯 가지 핵심 개념을 다룬 간결한 저서다. 수(numbers)를 정량적 사고의 입구로, 대수(algebra)를 추상화의 입구로 소개한다. 전체 요약 6문장 읽기 → 006 06:11 ▲ 42 · 댓글 8 LLM 에이전트가 PCB 라우팅 엔지니어 수준에 도달했나 PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. AI · 머신러닝 · PCBRouteAgent: How Close Are LLM Agents to Becoming PCB Routing Engineers?
Key Point PCB 설계 자동화가 LLM 에이전트 기술로 실무 수준에 가까워졌으며, 실제 보드에서 기존 방법을 크게 앞질렀다는 점이 의미 있습니다.
핵심 요약
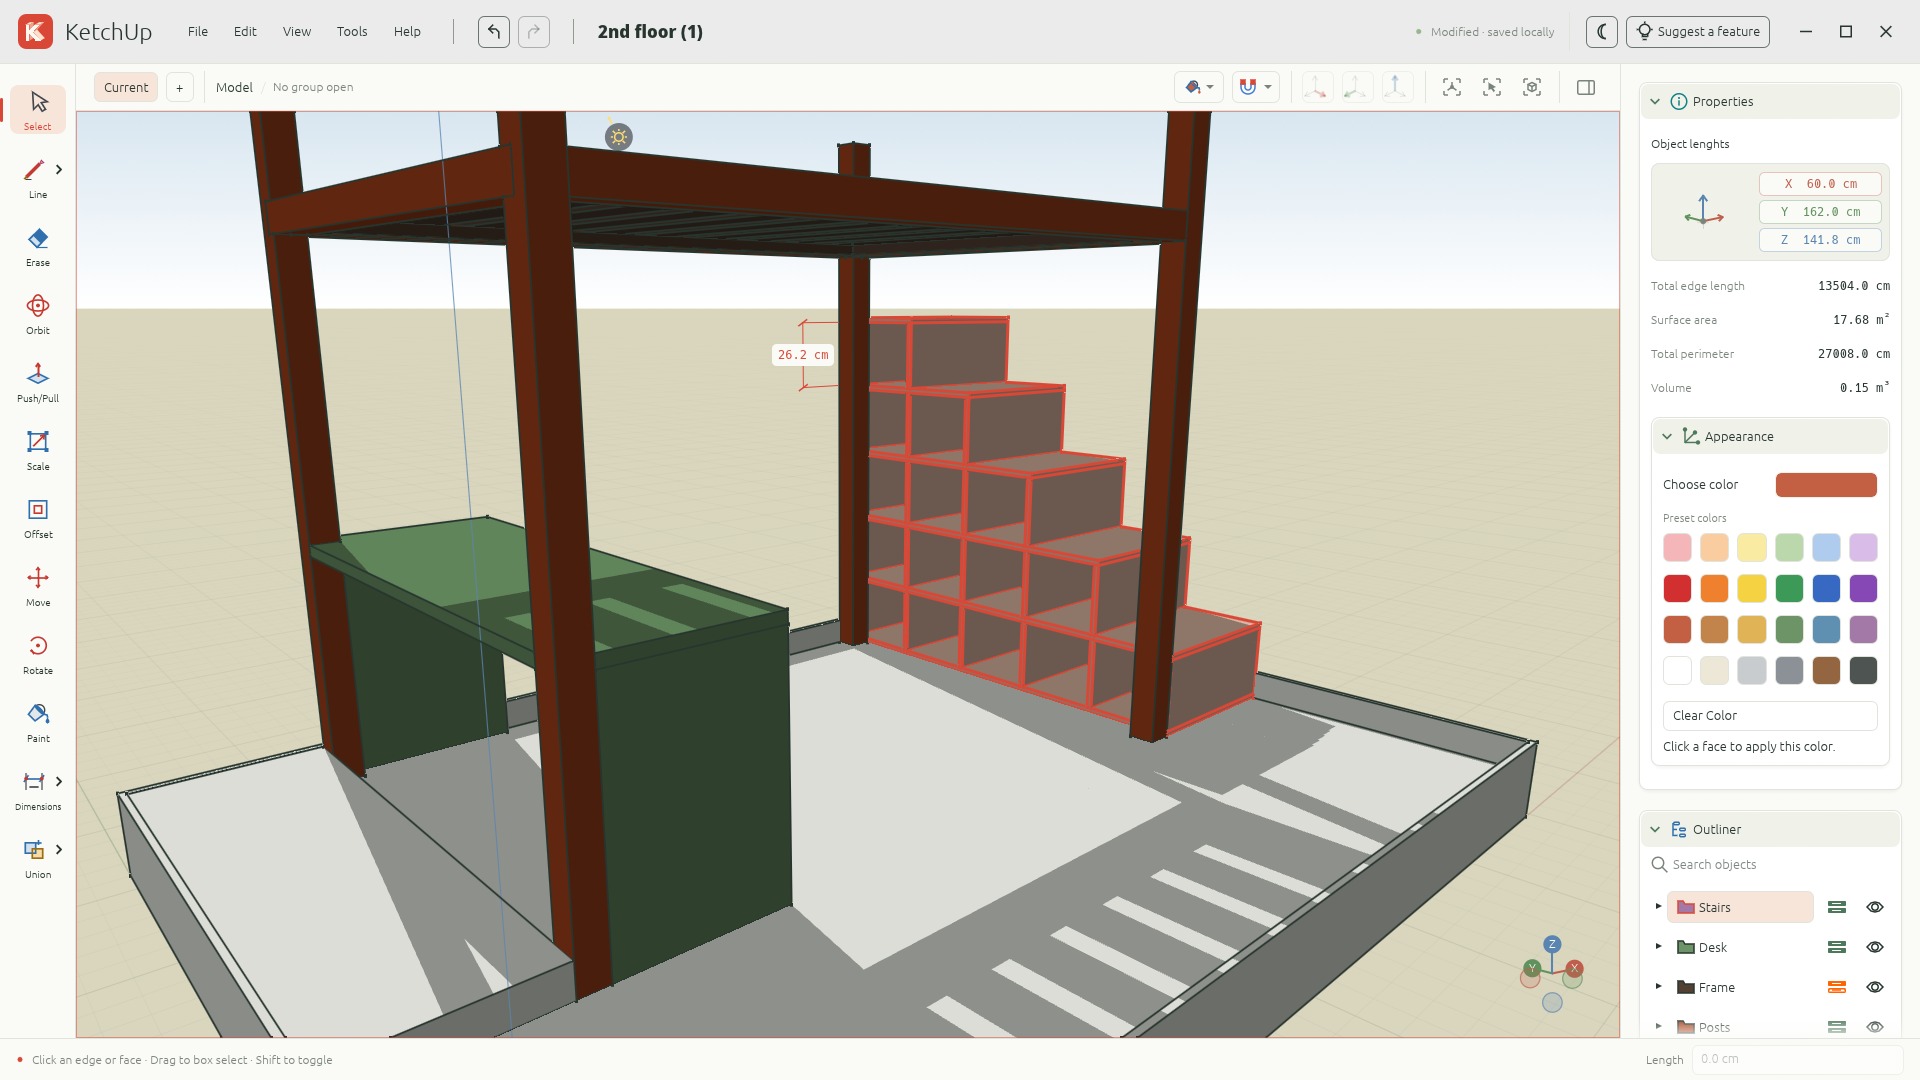
PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. PCBRouteAgent는 인간 엔지니어처럼 전역 전략과 지역 실행을 조율하는 멀티모달 에이전트로, 이미지와 전기·기하학 정보를 조합해 연결 위상(topology), 라우팅 순서, 경로(corridor), 층 전환을 결정한다. 전역 라우팅 플래너가 상위 계획을 수립하고, 상세 라우팅 실행기가 KiCad 네이티브 엔진을 통해 이를 구현하며, 실패한 부분을 구조화된 피드백으로 반환해 가이드를 개선할 수 있다. 전체 요약 5문장 읽기 → 007 12:11 ▲ 256 · 댓글 73 Rust와 WebGPU로 만든 오픈소스 3D 모델링 도구 KetchUp 목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. 오픈소스 · 도구 · KetchUp – Open-source SketchUp alternative built with Rust and WebGPU
Key Point SketchUp의 비싼 라이선스 비용을 피하려는 목공인과 가구 제작자들이 선택할 수 있는 완전히 무료이고 오픈소스인 대안이 나왔다.
핵심 요약
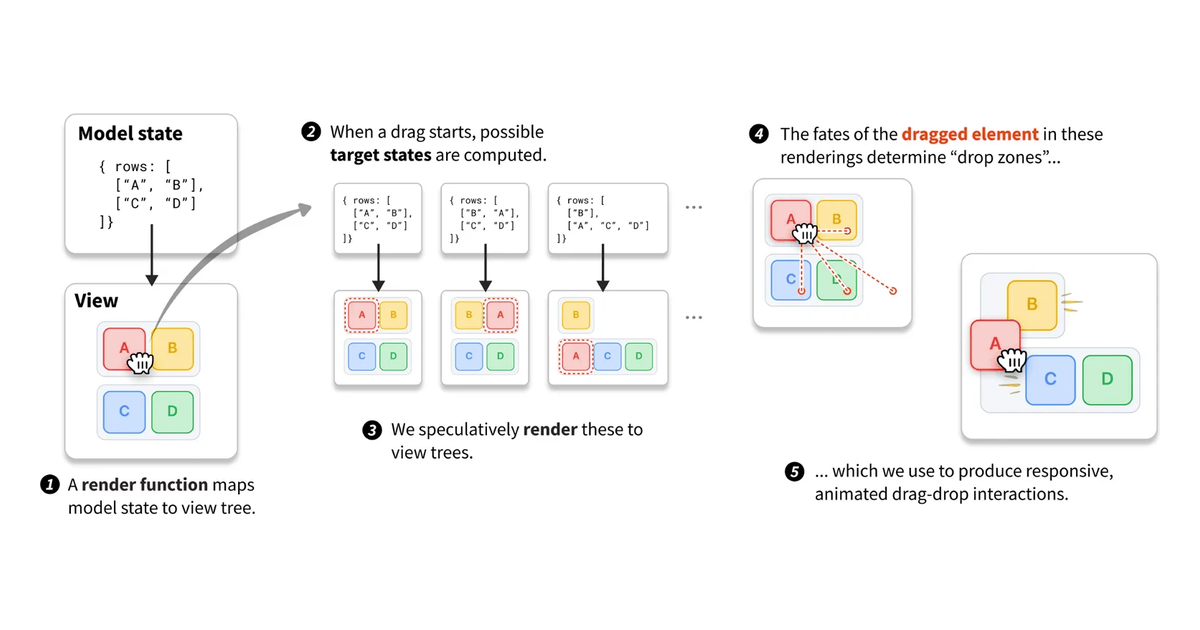
목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. Windows, macOS, Linux 데스크톱 앱 또는 웹 브라우저에서 실행되며, Rust와 WebGPU로 구축되었다. 직사각형·원·자유형 스케치로 시작해 Push/Pull로 깊이를 주고, 이동·복제·스케일링·칠하기로 모델을 만들 수 있다. 전체 요약 9문장 읽기 → 008 06:11 ▲ 133 · 댓글 8 모델 상태만 지정하면 드래그 상호작용을 자동 생성 Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 웹 · 프론트엔드 · Declarative Dragging
Key Point 인터페이스 제작자가 코드를 거의 짜지 않고도 고품질의 드래그 상호작용을 구현할 수 있는 새로운 패러다임을 제시하므로, 교육 도구, 게임, 수학 탐구 환경 등 다양한 분야에서 상호작용 설계의 진입장벽을 낮춘다.
핵심 요약
Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 기존 드래그 상호작용은 기하학, 피드백, 애니메이션을 다루는 복잡한 코드가 필요했으나, 이 방식은 요소를 드래그했을 때 도달할 수 있는 미래 상태만 지정하면 된다. 시스템이 이러한 상태들을 추론적으로 렌더링해 실제 위치를 파악한 후, 가능한 모든 상태를 결합해 매끄러운 드래그-드롭 상호작용을 자동 생성한다. 전체 요약 10문장 읽기 → 009 18:15 스타 1,579 LaTeX 페이지 여백에 꽃과 곤충을 절차적으로 생성하는 Florilegium 2.0 공개 LuaLaTeX와 pdfLaTeX에서 동작하는 florilegium 패키지는 델프트블루 스타일의 꽃과 동물을 페이지 여백에 절차적으로 생성하며, 모든 형태가 코드로 계산되어 PDF에 직접 기록된다. 오픈소스 · 도구 · kevinraymond/florilegium · TeX
Key Point TeX 문서의 미학을 완전히 새로운 차원으로 끌어올린 접근법으로, 이미지나 외부 자산 없이 순수 코드만으로 생성되는 식물은 매번 다르게 문서 공간에 적응하는 역동적인 타이포그래피 실험이다.
핵심 요약
LuaLaTeX와 pdfLaTeX에서 동작하는 florilegium 패키지는 델프트블루 스타일의 꽃과 동물을 페이지 여백에 절차적으로 생성하며, 모든 형태가 코드로 계산되어 PDF에 직접 기록된다. 2.0 버전부터는 손으로 설계한 모양 대신 게놈에서 샘플링한 식물 종을 그리므로, 같은 코드라도 시드값에 따라 다른 정원이 자란다. 문서의 텍스트 아래 남은 빈 공간에 식물을 채우는 탐욕적 공간 채우기 루프를 사용하며, 1998년 논문(Wong, Zongker & Salesin)의 아이디어를 바탕으로 한다. 전체 요약 12문장 읽기 → 010 06:11 ▲ 10 · 댓글 2 불완전한 3D 포인트 클라우드에서 완전한 장면 메시 복원 이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. AI · 머신러닝 · AnchorComplete: Recovering Complete Scene Meshes from Partial Point Clouds
Key Point 3D 재구성의 오래된 문제인 보이지 않는 영역의 기하학 복원 문제를 신경망 기반으로 해결하는 새로운 방법이 나왔으며, 소수 뷰 환경에서의 성능 개선이 3D 스캔·VR·로봇 비전 등 다양한 응용에 영향을 줄 수 있다.
핵심 요약
이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. 이를 해결하기 위해 AnchorComplete라는 프레임워크를 제안하는데, 불완전한 포인트 클라우드에서 완전한 장면 메시를 복원하면서 관찰된 기하학을 보존한다. TRELLIS.2를 기반으로 구축되었으며, 부분 포인트 조건화(global scene tokens와 local spatial evidence를 결합해 입력에 생성을 고정)와 메트릭 스케일 coarse-to-fine 생성(고정 크기 윈도우 내에서 기하학을 점진적으로 개선하면서 전역 구조 일관성 유지)을 결합한다. 전체 요약 4문장 읽기 → 011 09:11 ▲ 15 · 댓글 2 가우시안 아바타의 흐릿함·왜곡을 확산 모델로 보정 단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. AI · 머신러닝 · EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
Key Point 카메라 한 대로 촬영한 비디오나 이미지로 3D 아바타를 만들 때 피할 수 없던 흐릿함과 왜곡을 AI로 자동 보정할 수 있게 되면, 메타버스와 실시간 통신 같은 응용에서 아바타 품질을 크게 높일 수 있다.
핵심 요약
단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. EDGAR는 조건부 확산 프레임워크로, 신원 정보를 유지하면서 가우시안 아바타의 결함을 고쳐주도록 설계했다. 학습을 위해 EDGAR-SET이라는 하이브리드 데이터셋을 만들었는데, 실제 촬영 샘플과 합성 렌더링 샘플을 섞어 열악한 가우시안 아바타 렌더링을 바닥 참값과 참조 이미지와 짝지었다. 전체 요약 8문장 읽기 → 012 21:12 당일 +139 React로 무한 캔버스 앱을 만드는 tldraw SDK tldraw는 React 기반 무한 캔버스 엔진으로, 커스텀 셰이프·도구·바인딩·UI 컴포넌트를 만들 수 있는 완전 확장형 SDK다. 웹 · 프론트엔드 · tldraw/tldraw · TypeScript
Key Point 구글, 샵파이, 오토데스크 같은 주요 기업들의 캔버스 앱을 구동하는 오픈소스 SDK로, 무한 캔버스가 필요한 협업 도구·AI 제품을 빠르게 구축할 수 있는 기반이 된다.
핵심 요약
tldraw는 React 기반 무한 캔버스 엔진으로, 커스텀 셰이프·도구·바인딩·UI 컴포넌트를 만들 수 있는 완전 확장형 SDK다. 압력 감지 드로잉, 기하학적 셰이프, 리치 텍스트, 화살표, 스냅 기능, 이미지·비디오 지원 등 드로잉과 다이어그래밍 기능을 제공한다. Editor API로 런타임에 캔버스를 제어할 수 있으며, LLM 통합과 AI 에이전트 구축을 위한 캔버스 프리미티브를 지원한다. 전체 요약 10문장 읽기 → 013 18:11 ▲ 92 · 댓글 3 로봇 조작을 위한 공간-언어-행동 통합 모델 SLA 공개 로봇 조작에는 의미 이해와 3차원 공간의 정밀한 제어가 필요하지만, 기존 시각-언어-행동(VLA) 모델들은 2D 사전학습에서 나온 시각 표현을 쓰고 공간 감각은 과제별 적응 단계에서만 학습한다. AI · 머신러닝 · SLA: Scaling Spatial-Language-Action Model via Continual Pre-training
Key Point 로봇이 현실의 다양한 상황에서 물체를 다루도록 하려면 시각과 행동뿐 아니라 공간 감각까지 기초 모델 단계에서 학습해야 하는데, SLA는 이를 실제 로봇 데이터 규모의 연속 학습으로 처음 해결한 접근이다.
핵심 요약
로봇 조작에는 의미 이해와 3차원 공간의 정밀한 제어가 필요하지만, 기존 시각-언어-행동(VLA) 모델들은 2D 사전학습에서 나온 시각 표현을 쓰고 공간 감각은 과제별 적응 단계에서만 학습한다. 공간 이해를 전이 가능한 기초 모델 능력으로 발전시키기 위해 연구팀은 SLA(Spatial-Language-Action Model)를 개발했으며, 지속적 사전학습 중 암묵적 공간 정렬을 확장하고 후속 작업 단계에서도 유지한다. SLA는 사전학습된 pi05 정책에서 시작하여 행동 예측과 중간 시각 임베딩 및 고정된 3D 인지 모델의 공간 표현 간 정렬을 공동으로 최적화한다. 전체 요약 8문장 읽기 → 014 06:11 ▲ 23 · 댓글 3 정책 증류 학습, 분포 밖 일반화 능력 잃는다 여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. AI · 머신러닝 · On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
Key Point 대규모 언어모델을 다중 교사로부터 학습시킬 때 학습 데이터 분포 내에선 우수하지만 그 외의 상황에서 성능이 급격히 떨어지는 핵심 문제를 실증적으로 규명했고, 개선 방안까지 제시했기 때문입니다.
핵심 요약
여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. Qwen3 모델을 이용해 수학 추론, 코딩, 에이전트, 장문맥 이해 등 4가지 과제에서 성능을 평가한 결과, 분포 외(OOD) 성능이 기본 모델보다 2.45~16.25% 낮았다. 합성 작업에서는 MOPD가 분포 내 성능을 개선했으나, 구성된 작업의 분포 외 성능은 최고 성능 교사 모델보다 18.19~24.34% 뒤떨어졌다. 전체 요약 7문장 읽기 → 015 03:11 ▲ 102 · 댓글 24 Servo 0.7.0, 웹표준 기능 대폭 확충 웹 렌더링 엔진 Servo가 9월 동안 527개 커밋을 통해 0.7.0 버전을 릴리스했다. 웹 · 프론트엔드 · September in Servo: <progress>, rounded rectangles, and more
Key Point 웹 표준 호환성 확대와 성능 최적화가 동시에 진행 중인 오픈소스 렌더링 엔진의 큰 업데이트로, 웹 개발자와 Servo 기여자들이 진행 상황을 파악해야 할 시점이다.
핵심 요약
웹 렌더링 엔진 Servo가 9월 동안 527개 커밋을 통해 0.7.0 버전을 릴리스했다. 요소, :checked 의사클래스, user-select 속성, CSS typed arithmetic, alpha() 함수, font-width 속성 등 새로운 웹 플랫폼 기능을 추가했다. parentRule, version, getComposedRanges(), baseURL, CSS 모듈, SVG 요소들, MLKEM768-X25519 알고리즘, roundRect(), PerformancePaintTiming 등 다양한 DOM API를 구현했다. 전체 요약 14문장 읽기 → 016 18:13 ▲ 14 · 댓글 2 인간 시연으로 로봇 정책 적응 가능하게한 H2RB 프레임워크 사전학습된 Vision-Language-Action(VLA) 정책은 로봇 배포의 좋은 출발점이지만, 대상 로봇과 환경에 맞추려면 로봇 고유의 비용 많이 드는 시연이 필요하다. AI · 머신러닝 · Human-to-Robot Transfer via Bridging Representation and Action Space in VLAs
Key Point 로봇 정책 미세조정 시 비용이 많이 드는 로봇 데이터 대신 수집이 쉬운 인간 시연을 활용할 수 있는 실질적 방법을 제시하기 때문이다.
핵심 요약
사전학습된 Vision-Language-Action(VLA) 정책은 로봇 배포의 좋은 출발점이지만, 대상 로봇과 환경에 맞추려면 로봇 고유의 비용 많이 드는 시연이 필요하다. 인간 시연은 수집이 훨씬 쉽지만, VLA가 주로 로봇 데이터로 사전학습된 경우 인간-로봇 embodiment 차이가 크면 직접 활용하기 어렵다. H2RB(Human-To-Robot Bridge)는 쌍을 이루지 않은 인간과 로봇 시연으로부터 사전학습된 VLA 정책을 적응시키는 인간-로봇 공동 학습 프레임워크다. 전체 요약 8문장 읽기 → 017 15:11 ▲ 60 · 댓글 2 로봇 조작, 인코더 없는 시각-언어 모델로 더 정확하게 기존 비전-언어-액션 모델은 시각 인코더로 이미지를 먼저 압축한 후 행동 추론을 시작하지만, 조작 작업에 필요한 국소적 기하학·경계·깊이·미묘한 상태 변화 같은 시각 신호들이 손실될 수 있다. AI · 머신러닝 · From Pixels to Actions - Towards Native Vision-Language-Action Policies
Key Point 로봇 팔 같은 구체화된 제어 시스템이 최종 표현이 아닌 중간 단계의 시각 신호에서 더 정확한 정보를 얻을 수 있다는 발견은 로봇 공학과 구체화 AI의 아키텍처 설계 원칙을 바꿀 가능성이 있다.
핵심 요약
기존 비전-언어-액션 모델은 시각 인코더로 이미지를 먼저 압축한 후 행동 추론을 시작하지만, 조작 작업에 필요한 국소적 기하학·경계·깊이·미묘한 상태 변화 같은 시각 신호들이 손실될 수 있다. NEO-VLA는 인코더 없는 구조의 비전-언어-액션 프레임워크로, 이미지를 경량 패치 합성곱 층으로 토큰화한 뒤 백본 전체에서 언어와 함께 진화하도록 설계했다. 흐름-매칭 액션 전문가가 백본의 다양한 깊이에서 명령 조건부 시각 표현에 접근할 수 있어, 최종 시각 표현뿐 아니라 계산 계층 전체의 정보를 활용한다. 전체 요약 6문장 읽기 → 018 12:11 ▲ 104 · 댓글 2 로봇 범용 작업 위한 대규모 비전-언어 모델, 실제 얼마나 쓸 수 있나 로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. AI · 머신러닝 · Are Frontier VLM Agents Ready to Be Robot Generalists? An Empirical Study with the Embodied Agent Arena
Key Point 현재 최첨단 VLM 에이전트들이 로봇 조작 작업에서 구체적으로 어떤 한계를 보이는지, 폐쇄형과 오픈 모델의 성능 격차가 어디서 비롯되는지 체계적으로 밝혔다.
핵심 요약
로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. 이 벤치마크는 기하학, 공간 추론, affordance, 작업 계획, 조작 5개 영역을 평가하며, 32개 기존 데이터셋과 카메라·동작·깊이·스케일 추정을 위한 새로운 168개 케이스 GeoProbe로 총 1,000개 사례를 구성한다. 10개 VLM 에이전트를 평가한 결과, 폐쇄형 가중치 모델들이 5개 영역 모두에서 앞섰으나 오픈 가중치 VLM은 공간 추론은 유용하지만 계획과 조작 성공률이 훨씬 낮았다. 전체 요약 8문장 읽기 → 019 21:11 당일 +984 광디스크에 눈에 보이는 그림을 새기는 도구 공개 Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 오픈소스 · 도구 · JiaFeiMiao-K-Cat/DiscImageStudio · C#
Key Point 오픈소스 개발자들이 만든 도구로 CD·DVD·블루레이 표면에 실제로 보이는 그림을 새길 수 있다는 독특한 기술이 구현되어 있고, 보정 알고리즘의 정확도 향상과 다양한 출력 형식 지원으로 실용성이 높다.
핵심 요약
Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 이미지를 입력하면 CD·DVD·블루레이의 물리층 제약을 만족하는 데이터로 변환해 생성된 ISO·RAW·WAV+CUE 파일로 내보내거나 공백 디스크에 직접 기록할 수 있다. CD는 WAV 음성 트랙 및 CUE 파일, DVD는 ISO 미러, BD-R은 UDF 2.01 파일 시스템을 지원하며 세 매체 모두 디스크 내 파일 저장 기능이 있다. 전체 요약 12문장 읽기 → 020 09:11 ▲ 102 · 댓글 53 Lisp 기반 CAD 도구, Antimony 공개 Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 오픈소스 · 도구 · Antimony: CAD Software Evolved from Lisp Machines and Not Drafting Tables (2015)
Key Point 그래프 기반의 노드 프로그래밍 방식으로 CAD 작업을 재정의하고, 스크립트로 모든 설계 요소를 제어할 수 있는 새로운 패러다임을 제시한다.
핵심 요약
Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 각 노드는 Python 3.x 스크립트로 정의되며 입출력 포트를 통해 연결되고, 변경사항이 자동으로 하위 노드에 전파된다. 기하학 엔진은 불 연산(합집합·교집합·차집합)에 최적화된 함수형 표현을 사용하여 형상을 비트맵으로 렌더링한다. 전체 요약 11문장 읽기 → 021 00:11 ▲ 26 · 댓글 1 비디오 세계 모델의 예측 오차, 물리적 놀라움을 재대로 측정하지 못한다 비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. AI · 머신러닝 · When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 022 00:11 ▲ 101 · 댓글 39 3D 열 투명 망토로 물체를 열화상카메라에서 숨긴다 미국 일리노이 대학교 어베인-샤컌 캠퍼스 연구팀이 물체를 열화상카메라에서 숨길 수 있는 3차원 열 투명 망토를 개발하고 테스트했다. 하드웨어 · 시스템 · New 3D thermal invisibility cloak makes objects disappear from infrared cameras
Key Point 기존 2차원 열 망토의 한계를 극복한 3차원 전방향 열 투명화 기술이 최초로 실제 구현되어, 전자제품 냉각과 열 감지 회피 등 광범위한 응용이 가능해졌다.
핵심 요약
미국 일리노이 대학교 어베인-샤컌 캠퍼스 연구팀이 물체를 열화상카메라에서 숨길 수 있는 3차원 열 투명 망토를 개발하고 테스트했다. 기존 열 망토는 2차원이거나 열이 특정 방향에서만 올 때 작동했으나, 새 디자인은 모든 방향의 열을 물체 주위로 유도해 어떤 각도에서도 적외선상에서 물체가 보이지 않게 한다. 연구팀은 변환 열역학의 기본 원리를 재검토해 세 방향으로 독립적으로 조정 가능한 격자 구조 신소재를 개발했다. 전체 요약 11문장 읽기 → 023 21:11 ▲ 26 · 댓글 9 단일 영상의 3D 추적, '궤적 수리'로 개선하다 단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. AI · 머신러닝 · ReLift: Dense 3D Tracking as Lifted Trajectory Repair
Key Point 기존 2D 추적과 3D 기하 정보를 활용해 3D 추적 정확도를 높이는 새로운 접근법으로, 앞으로 나올 추적기나 기하 모델 개선의 이득을 자동으로 누릴 수 있는 구조입니다.
핵심 요약
단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. 기존 2D 추적기와 3D 기하학 모델만으로도 폐색 부분을 단순 보간한 '들어올린 궤적'이 전용 3D 추적기 수준의 성능을 낸다. 하지만 이 방식은 대응과 깊이 오차를 상속받으며, 폐색 영역에서 깊이값이 가려진 물체에서 나오는 문제가 있다. 전체 요약 7문장 읽기 → 024 18:11 ▲ 19 · 댓글 2 확산 모델 가속, 게이트 재구성에서 비롯된다 REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. AI · 머신러닝 · No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates
Key Point 확산 모델 가속의 진짜 메커니즘이 특성 구조가 아닌 잔차 게이트 재구성에서 비롯되며, 이를 정량화하고 개선하는 새로운 방법을 제시한다.
핵심 요약
REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. 기존에는 추가 감독(auxiliary objectives), 공간 구조 우선순위, 개선된 특성 기하학으로 설명했으나 실제 핵심은 다르다. AdaLN-Zero 잔차 게이트 α가 가속 방법들에 의해 대폭 재구성되며, 이것이 가속의 주요 원인임을 밝혔다. 전체 요약 8문장 읽기 → 025 15:11 ▲ 20 · 댓글 2 소형 언어모델로 로봇 조작 명령 프로그래밍하기 로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. AI · 머신러닝 · CaPtain: A Pipeline for Post-Training Code-as-Policy Robot Agents
Key Point 로봇 조작 AI를 프론티어 모델 의존에서 벗어나 오픈소스 소형 모델로도 실현할 수 있게 하는 구체적 방법과 검증 결과를 제시한다.
핵심 요약
로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. 연구팀이 공개한 CaPtain은 소형 오픈소스 비전-언어 모델(Qwen 3.5-4B)을 미세조정과 강화학습으로 독립적인 로봇 정책 에이전트로 훈련하는 파이프라인이다. 파이프라인은 CaPtain-Harness라는 프레임워크 위에서 동작하며, 로봇 API, 저수준 인지·기하학·안전 이동 원시 동작을 시뮬레이션과 실제 하드웨어에서 노출한다. 전체 요약 8문장 읽기 → 026 09:11 당일 +272 PyTorch 기반 미분 가능한 컴퓨터비전 라이브러리 kornia PyTorch 위에 구축된 kornia는 1200개 이상의 미분 가능한 이미지 처리 및 기하학 알고리즘을 제공하는 컴퓨터비전 라이브러리다. AI · 머신러닝 · kornia/kornia · Python
Key Point GPU 배치 처리와 미분 가능성을 갖춘 컴퓨터비전 연산 1200개 이상을 제공해 기존 라이브러리로는 불가능한 기하학 문제를 PyTorch 모델에 직접 통합할 수 있다.
핵심 요약
PyTorch 위에 구축된 kornia는 1200개 이상의 미분 가능한 이미지 처리 및 기하학 알고리즘을 제공하는 컴퓨터비전 라이브러리다. 배치 변환, 자동 미분, GPU 가속을 통해 AI 워크플로우에 통합되며, torchvision에 없는 카메라 모델·에피폴라 기하·특성점 매칭·모폴로지 연산 등을 지원한다. 샘플당 매개변수를 배치 호출로 처리할 수 있어 가우스 블러의 시그마를 (B, 2) 텐서로, 회전각을 (B,) 텐서로 받으며 torchvision은 호출마다 한 매개변수만 적용한다. 전체 요약 10문장 읽기 → 027 00:11 ▲ 118 · 댓글 35 DOOM 게임 엔진으로 신경망 돌리기, 정확성 검증까지 DOOM 게임 엔진의 엔티티(voodoo dolls)와 맵 기하학을 이용해 신경망을 실제로 실행하는 프로젝트를 공개했다. 오픈소스 · 도구 · Show HN: I Turned DOOM into a Transformer
Key Point 게임 엔진 자체가 컴퓨팅 플랫폼이 될 수 있음을 보여주며, DOOM처럼 오래된 시스템에서도 복잡한 계산을 실행하고 검증할 수 있다는 점이 기술적 호기심을 자극한다.
핵심 요약
DOOM 게임 엔진의 엔티티(voodoo dolls)와 맵 기하학을 이용해 신경망을 실제로 실행하는 프로젝트를 공개했다. 신경망의 모든 값을 NumPy와 비교 검증하며 오차 허용도를 0으로 설정해 정확성을 보장한다. MNIST 손글씨 인식 네트워크는 10,000개 테스트 이미지 중 9,716개(97.16%)를 정확히 인식한다. 전체 요약 10문장 읽기 → 028 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 029 15:11 ▲ 22 · 댓글 2 멀티모달 AI, 이미지와 텍스트에 동일한 제어벡터 공유 통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. AI · 머신러닝 · Cross-modal Steering Vectors Exist Across Both Image and Text Generation
Key Point 멀티모달 AI의 내부 구조에서 이미지와 텍스트가 공유하는 통일된 개념 표현을 직접 입증해, 모델 해석 가능성과 제어 기술의 새로운 방향을 보여준다.
핵심 요약
통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. 감정, 물체 크기 등 다양한 개념의 제어벡터를 찾아 다른 모달리티로 전이시켰으며, 텍스트→이미지, 이미지→텍스트 양방향 모두에서 성공적으로 작동했다. 텍스트에만 고유한 개념(정중한 vs 구어체 표현)도 이미지에선 정중한 옷차림·디자인처럼 일관된 효과를 나타냈다. 전체 요약 5문장 읽기 → 030 18:11 ▲ 22 · 댓글 2 LLM에 로봇 제어 패널만 달면 VLA 모델을 이긴다 로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. AI · 머신러닝 · RoboHarness: A Simple Harness Outperforms VLA and World Action Models
Key Point 대규모 로봇 학습 데이터 없이도 기존 LLM으로 로봇 제어가 가능하다는 것을 보였기에, 구체화된 AI 개발의 패러다임 전환 가능성을 시사한다.
핵심 요약
로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. 연구팀은 RoboHarness라는 로봇 제어 인터페이스를 제시해, LLM이 시각-기하학적 제어판을 통해 직접 로봇 동작을 이해하고 호출할 수 있게 했다. VLA 모델 대신 코딩 능력이 있는 LLM 에이전트에 간단한 로봇 장치만 제공하면, 로봇 조작 작업을 수행할 수 있다는 가정에 기반한다. 전체 요약 5문장 읽기 → 031 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 032 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 033 00:11 ▲ 179 · 댓글 82 위키피디아, AI 생성 콘텐츠 정소 전쟁 중 위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. AI · 머신러닝 · Wikipedia's Cleanup of AI-Generated Content
Key Point 위키피디아가 AI 콘텐츠 정소를 위해 어떤 기술과 정책을 실행하고 있으며, AI 시대에 전통적 지식 자산을 어떻게 재정의하려는지 알 수 있다.
핵심 요약
위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. 초기에는 '그것이 증거다', '풍부한 문화유산' 같은 반복 구문이나 결론 섹션처럼 ChatGPT의 특징적 패턴이 노출되어 있었다. 2025년 현재 AI 생성 콘텐츠의 특징이 더 미묘해지고 있으며, 기하학적 구조나 단락 패턴 같은 구조적 신호를 통해 탐지하고 있다. 전체 요약 12문장 읽기 → 034 00:11 ▲ 11 · 댓글 2 단일 이미지에서 3D 장면 재구성, 객체 기반 접근법으로 품질 향상 단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. AI · 머신러닝 · Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
Key Point 3D 장면 재구성 품질을 높이는 새로운 구성 방식의 등장으로, 컴퓨터 비전 모델 설계 방향을 보여주는 선례입니다.
핵심 요약
단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. 연구팀은 Easy-3Dfy라는 구성 기반 워크플로우를 제안했으며, 이는 객체 생성과 장면 배치 추정을 분리해 각 모델의 강점을 활용한다. 특화된 3D 객체 생성기는 상세한 객체 기하학을, 3D 기초 모델은 강력한 공간 이해를 각각 담당하도록 설계했다. 전체 요약 6문장 읽기 → 035 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
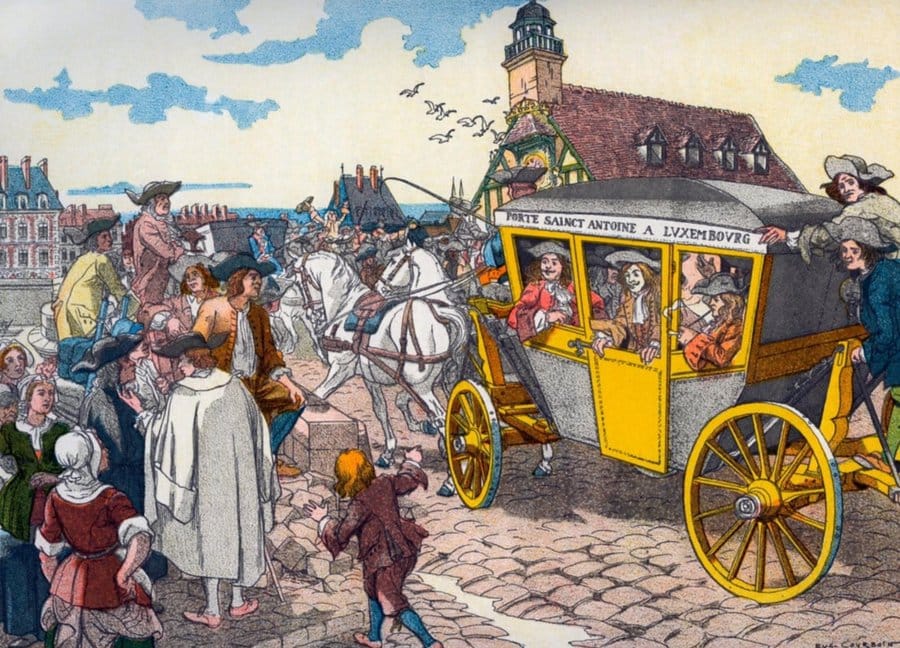
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 036 03:12 ▲ 202 · 댓글 96 파스칼이 정한 노선 대중교통을 발명하다 1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 기타 · Blaise Pascal invented fixed route public transport (2024)
Key Point 역사적으로 가장 중요한 도시 운송 혁신이 정부 정책이나 기술 기업이 아닌 수학자의 기하학적 사고에서 비롯되었다는 점과, 공학적 우월성보다 사회 포용성이 대중교통 성패를 결정한다는 인사이트를 배울 수 있다.
핵심 요약
1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 8명 탑승 가능한 말 끌기 마차 5대가 예측 가능한 주기(7.5~15분)로 여러 연결 노선을 운행했다. 파스칼의 네트워크는 현대 버스, 전차, 열차의 직접적인 선조이며, 육지에서 고정 노선 대중교통의 첫 시례였다. 전체 요약 9문장 읽기 → 037 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 038 18:11 ▲ 120 · 댓글 79 애플 폴딩폰, 분해 테스트 공개 애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 하드웨어 · 시스템 · iPhone Duo Teardown
Key Point 폴딩폰이 초기 수리성 평가를 받는 것은 드문데, 애플의 첫 번째 폴딩 시도가 실제로 어떤 구조를 가졌는지, 그리고 왜 초기 불량이 발생했는지를 기술 증거로 밝혀낸 정밀한 분석이다. 특히 999달러의 수리비 책정 이유를 엔지니어링 관점에서 이해할 수 있다.
핵심 요약
애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 듀오의 내부 디스플레이는 나노텍스처 코팅으로 주름을 숨긴다. 미세한 돌기가 빛을 산란시켜 반사를 부드럽게 하는데, 코팅을 제거하면 주름이 다른 폴딩폰보다 더 잘 보인다. 일부 서브픽셀이 타원형이며 방향이 다르게 배치되어 있다. 애플 특허에 따르면 이는 기하학적 디더링으로 회절 아티팩트를 줄이는 기술이다. 전체 요약 12문장 읽기 → 039 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 040 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 041 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 042 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 043 21:11 ▲ 113 · 댓글 55 인터뷰 팁이 퍼즐 게임 풀이에도 효과, 생각을 말로 나타내기의 힘 저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 기타 · Chain of Thought for Humans
Key Point 사고 과정을 말로 표현하는 것이 단순한 의사소통 기법이 아니라 실제 인지 성능을 향상시킨다는 기초적인 이해를 제시하며, 문제 해결 전략의 과학적 근거를 보여준다.
핵심 요약
저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 자신의 생각 속도가 말보다 빠르고 기하학적 추론은 언어로 표현하기 어려운데도 불구하고, 이 방법이 놀랍게도 퍼즐 풀이 효율을 크게 높였다. 저자는 LLM이 이전 생각을 반복할 수 없어 토큰을 출력해야 하는 아키텍처 제약이 있지만, 인간의 경우 다른 메커니즘이 작동한다고 생각했다. 전체 요약 6문장 읽기 → 044 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 045 18:11 ▲ 25 · 댓글 2 LLM 활용해 3D 부품 조립 성능 대폭 향상 3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. AI · 머신러닝 · LLM2R: From Large Language Models to 3D Reassemblers
Key Point 대규모 부품을 가진 3D 조립 작업에서 기존 방식의 확장성 문제를 LLM 기반 접근으로 근본적으로 해결하고, 복잡한 기하학적 추론을 단일 forward pass로 처리할 수 있는 새로운 가능성을 제시한다.
핵심 요약
3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. 기존 방식은 부품 쌍의 관계에 의존하거나 반복 생성-검증을 사용해 많은 부품을 가진 물체에서 확장성이 떨어진다. LLM2R은 부품 조립을 sequence modeling 문제로 재정의하며 사전학습된 decoder-only LLM을 활용한다. 전체 요약 10문장 읽기 → 046 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 047 00:11 ▲ 13 · 댓글 2 텍스트 거부 신호로 멀티모달 AI 안전성 확보 멀티모달 대형 언어 모델(MLLM)의 안전성 강화는 이미지·비디오 등 각 형식별로 새로운 안전 데이터를 수집해야 했고, 수집·배포 과정에서 윤리·법적 문제가 발생했다. AI · 머신러닝 · Harnessing Textual Refusal Directions for Multimodal Safety
Key Point 안전 데이터 수집 없이 기존 텍스트 모델의 안전 메커니즘을 이미지·비디오에 재사용할 수 있다는 점이 멀티모달 AI 안전성 구축의 비용과 윤리적 부담을 획기적으로 줄인다.
핵심 요약
멀티모달 대형 언어 모델(MLLM)의 안전성 강화는 이미지·비디오 등 각 형식별로 새로운 안전 데이터를 수집해야 했고, 수집·배포 과정에서 윤리·법적 문제가 발생했다. 연구팀은 텍스트 LLM에서 추출한 '거부 방향(refusal directions)'이 이미지, 비디오 등 다른 모달리티에도 적용 가능한지 검증했고, 레이어 선택·조종 강도·크로스모달 정렬에 따라 효과가 달라짐을 확인했다. MARS(Modality-Agnostic Refusal Steering)라는 학습 없이 작동하는 경량 방식을 제안했으며, 활성화 중심화로 모달리티 불일치를 바로잡고 기하학적 신뢰 영역 내에서 조종 강도를 적응적으로 조절한다. 전체 요약 6문장 읽기 → 048 00:11 ▲ 11 · 댓글 2 산업용 로봇 조작 평가 벤치마크 'LIBERO-Industry' 공개 LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 하드웨어 · 시스템 · LIBERO-Industry: Benchmarking Robotic Manipulation under Industrial Process Constraints
Key Point 실제 제조 환경의 복잡한 제약을 반영한 평가 지표가 없어 범용 로봇 정책의 산업 적용 가능성을 정확히 측정할 수 없었는데, 이제 체계적인 벤치마크로 검증할 수 있게 됐다.
핵심 요약
LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 유연 제조(고혼합·소량 생산) 환경에서 로봇이 대응해야 하는 제품 변종, 이동 재료 흐름, 제한된 작업 시간, 기하학적 공차 같은 산업용 제약을 반영했다. 3가지 작업 시나리오(정적→동적 로딩, 동적→정적 언로딩, 동적→동적 전달)로 구성되며 총 216개 태스크를 포함한다. 전체 요약 7문장 읽기 → 049 00:11 ▲ 12 · 댓글 2 다양한 장면에 강한 자율 학습 깊이 추정 기법 MaSS 자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. AI · 머신러닝 · Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
Key Point 자율 학습 깊이 추정이 다양한 현실 데이터에서 제대로 작동하려면, 도메인별 편향을 넘어 일반화된 구조 학습이 필수적이기 때문이다.
핵심 요약
자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. 연구진은 자율 학습 상황에서 모델이 전이 가능한 기하학 대신 데이터셋별 구조적 편향을 학습하면서 도메인 간 최적화 충돌이 발생하는 문제를 발견했다. 이를 해결하기 위해 MaSS 프레임워크를 제안하며, 맥락 특징과 명시적으로 분리된 전용 구조 표현 경로를 도입한다. 전체 요약 7문장 읽기 → 050 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 051 21:11 ▲ 13 · 댓글 2 빠르게 움직이는 물체 복원, 가우시안 배치 방식 개선 동적 가우시안 표현은 고품질 실시간 볼루메트릭 비디오를 가능하게 했으나, 빠르게 움직이는 작은 물체가 소실되거나 동적 영역의 세부 텍스처가 손실되는 문제가 있다. AI · 머신러닝 · Dusting the Phantom: Gaussian Allocation for Fading Dynamic Content
Key Point 실시간 동적 장면 재구성에서 빠르게 움직이는 작은 물체의 소실 문제를 해결하는 새로운 가우시안 배치 방식을 제시하여, 3D 비디오 캡처 기술의 실용성을 높인다.
핵심 요약
동적 가우시안 표현은 고품질 실시간 볼루메트릭 비디오를 가능하게 했으나, 빠르게 움직이는 작은 물체가 소실되거나 동적 영역의 세부 텍스처가 손실되는 문제가 있다. 더 오래 학습하거나 가우시안을 늘려도 이런 작은 고속 물체를 복원하기 어려운 이유는 표현 용량이 아니라 가우시안 초기화 위치와 시기가 핵심 병목이다. 기존 배치 전략은 현재 가우시안 위치에만 의존하고 이동할 가우시안의 시공간적 목표 위치를 간과한다. 전체 요약 7문장 읽기 → 052 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 053 06:11 ▲ 11 · 댓글 3 언어모델 학습, 중간 계산 구조까지 모방하는 방식 제시 기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. AI · 머신러닝 · OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
Key Point 출력 공간의 감독을 넘어 모델의 내부 계산 구조를 직접 전이하는 새로운 증류 방식으로, 학생 모델의 추론 능력과 학습 효율을 근본적으로 향상시키는 접근법입니다.
핵심 요약
기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. 표현 매칭 같은 단순한 중간 계층 증류는 불충분한데, 교사와 학생의 표현이 기하학적으로 다를 수 있고 정렬된 은닉 상태도 학생의 후속 계산에 사용 불가능할 수 있기 때문이다. 연구진은 온폴리시 메커니즘 증류(OPMD)를 제안하여, 학생이 실제로 사용 가능하도록 교사 표현을 학생의 중간 상태로 변환하는 학생 호환 교사를 먼저 구축한다. 전체 요약 6문장 읽기 → 054 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 055 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 056 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 057 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 059 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 060 12:11 ▲ 323 · 댓글 1 장편 비디오 생성의 공간·시간 일관성을 위한 ATAS 프레임워크 장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. AI · 머신러닝 · Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
Key Point 비디오 생성 AI가 긴 영상에서 장면 일관성을 유지해야 하는 핵심 문제를 해결하는 새로운 접근 방식을 제시하며, 기존 방법 대비 정량적·정성적 평가에서 모두 우수한 성과를 보여준다.
핵심 요약
장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. ATAS는 시나리오를 명시적인 위치, 카메라, 사건 시간 참조를 포함한 샷 요청으로 컴파일하는 방식으로, 생성 전 정적 기하학을 담은 장면 메모리와 시간별 동적 관찰을 담은 사건 메모리에서 관련 증거를 검색한다. 생성 후 ATAS는 클립을 재구성하고 등록하며, 검토와 상태 확인이 관찰을 수용할 때만 메모리를 업데이트하되 최종 영상 출력은 메모리 승인과 독립적으로 제공된다. 전체 요약 5문장 읽기 → 061 18:11 ▲ 18 · 댓글 1 4D 생성 영상의 기하학적 일관성을 높이는 GeoFix 논문 공개 비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. AI · 머신러닝 · GeoFix: Geometry Fixing for 4D Consistent Generation
Key Point 비디오 확산 모델 기반 4D 콘텐츠 생성이 점점 실용화되는 가운데, 기하학적 정확성을 유지하면서도 시각 품질을 보존하는 균형의 문제를 해결하는 방법론을 제시하고 있다.
핵심 요약
비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. 기존 방법은 기하학적 보상을 설계해 사후 학습하지만 텍스처와 세부 디테일이 저하되어 추가 외형 보상과 신중한 보상 조정이 필요했다. GeoFix는 단일 기하학적 보상으로 기하학적 일관성과 시각적 품질을 동시에 개선하는 통합 프레임워크로, 학습 및 추론 시간 모두에 적용 가능하다. 전체 요약 7문장 읽기 → 062 18:11 ▲ 25 · 댓글 2 3D 메시 움직임 복원, 스케일 분리로 범용화 희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. AI · 머신러닝 · Cepheid: Decoupling Scale from Structure for Cross-Family Motion Completion
Key Point 3D 애니메이션 제작과 로봇 제어에서 부분 관측만으로 전체 움직임을 복원하는 핵심 문제를 해결했으며, 단일 모델로 다양한 대상에 일반화되는 점이 기술적 진전을 의미한다.
핵심 요약
희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. 기존 학습 기반 잔차 사전은 특정 형태군(의류, 동물 등)에서만 기존 조화 확장을 넘지 못했다. 스케일 문제: 기하학 형태군 간 잔차 진폭이 10배 이상 차이나며, 관측값이 많아지면 붕괴된다. 전체 요약 6문장 읽기 → 063 15:11 ▲ 20 · 댓글 1 착용형 센서로 인간의 로봇팔 동작 100시간 기록 인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. AI · 머신러닝 · EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
Key Point 인간형 로봇의 자연스러운 움직임 학습을 위해 필요한 대규모 멀티모달 데이터셋이 공개되었으며, 센서 최소화 기술로 현장 데이터 수집의 새로운 방향을 제시한다.
핵심 요약
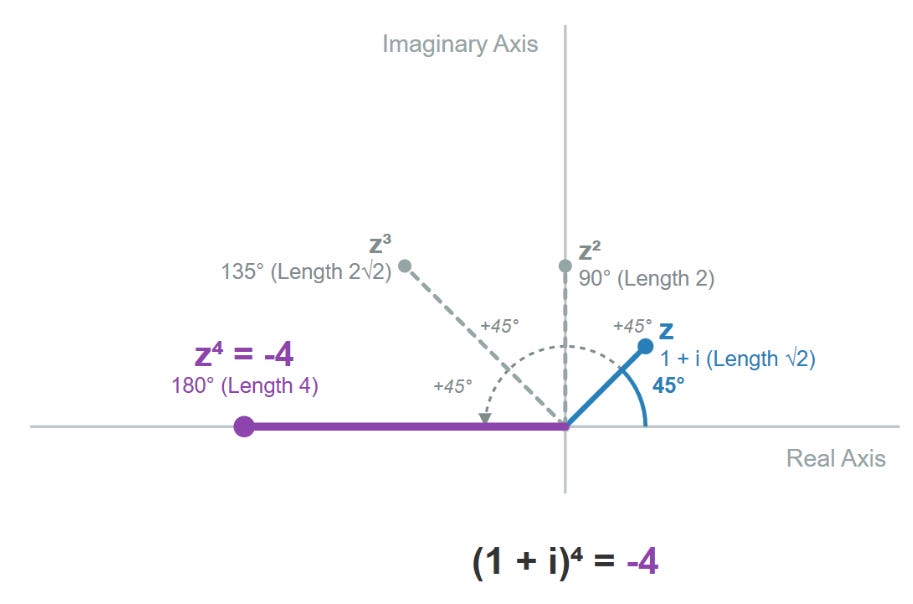
인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. 연구팀은 EgoExplorer라는 100시간 규모의 데이터셋을 공개했으며, 착용형 센서 시스템으로 시점 영상과 전신 동작, 손가락 세밀한 움직임, 촉각 정보를 동시에 기록했다. 전문적 활동들을 중심으로 연속 녹화된 이 데이터에는 단계별 설명도 함께 제공된다. 전체 요약 8문장 읽기 → 064 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 065 00:11 ▲ 106 · 댓글 22 오픈소스 Rust 기반 3D CAD, AI 에이전트 지원 SolidCraft는 Rust로 만든 오픈소스 파라메트릭 3D CAD로, 스케치·제약·솔리드 빌드를 지원하며 파라메트릭 기능 타임라인으로 치수 변경 시 모델이 자동 재구성된다. 하드웨어 · 시스템 · Show HN: SolidCraft – Open-Source Parametric CAD in Rust (With MCP Support)
Key Point Rust 생태계에서 완성도 높은 CAD 소프트웨어가 나왔으며, MCP를 통해 AI 에이전트가 직접 설계 작업을 수행할 수 있어 AI 드리븐 제조·설계 워크플로우의 새로운 가능성을 보여준다.
핵심 요약
SolidCraft는 Rust로 만든 오픈소스 파라메트릭 3D CAD로, 스케치·제약·솔리드 빌드를 지원하며 파라메트릭 기능 타임라인으로 치수 변경 시 모델이 자동 재구성된다. 데스크톱, 브라우저, MCP 서버를 통한 AI 에이전트 모델링을 지원하며, 라즈베리파이 케이스 예제처럼 스케치·압출·필렛·쉘·패턴·텍스트 조각 등을 한 설계에서 완성할 수 있다. Windows·macOS·Linux(AppImage·deb·rpm·Flatpak·Snap)와 웹 버전으로 제공되며, ARM64와 32비트 PC도 지원한다. 전체 요약 14문장 읽기 → 066 18:12 ▲ 14 · 댓글 2 LLM 숨겨진 상태 분석으로 추론 가속화 방법 개선 LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. AI · 머신러닝 · Surfing the Activation Wave: Analyzing the Information and Geometry of LLM Hidden States for Speculative Decoding
Key Point LLM 추론 속도 최적화는 실제 배포에서 핵심인데, 이 연구가 제시하는 계층 선택 방법이 기존 휴리스틱 대비 체계적이고 더 효율적이기 때문에 실제 서빙 비용 절감으로 이어질 수 있다.
핵심 요약
LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. 이 연구는 정보량(행렬 엔트로피) 및 다양성(CKA 분석)이라는 두 기준으로 최적의 다중 계층 숨겨진 상태를 선택하는 원칙 기반 프레임워크를 제시한다. 계층별 섀넌 엔트로피, 숨겨진 상태 결합 시 총 엔트로피, 계층 깊이에 따른 쌍별 CKA 동역학을 조사한 결과 디코더 표현 내에 서로 다른 기하학적 및 정보 구획이 존재함을 발견했다. 전체 요약 6문장 읽기 → 067 06:11 ▲ 190 · 댓글 45 30년 전 GTA 차량 물리엔진, 자바스크립트로 부활 개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 하드웨어 · 시스템 · 2D Vehicles
Key Point 게임 물리 엔진의 실무적 구현 방식을 1990년대 접근법부터 현대적 재현까지 투명하게 공개한 사례로, 게임 개발자나 물리 시뮬레이션에 관심 있는 개발자에게 실질적인 설계 참고가 된다.
핵심 요약
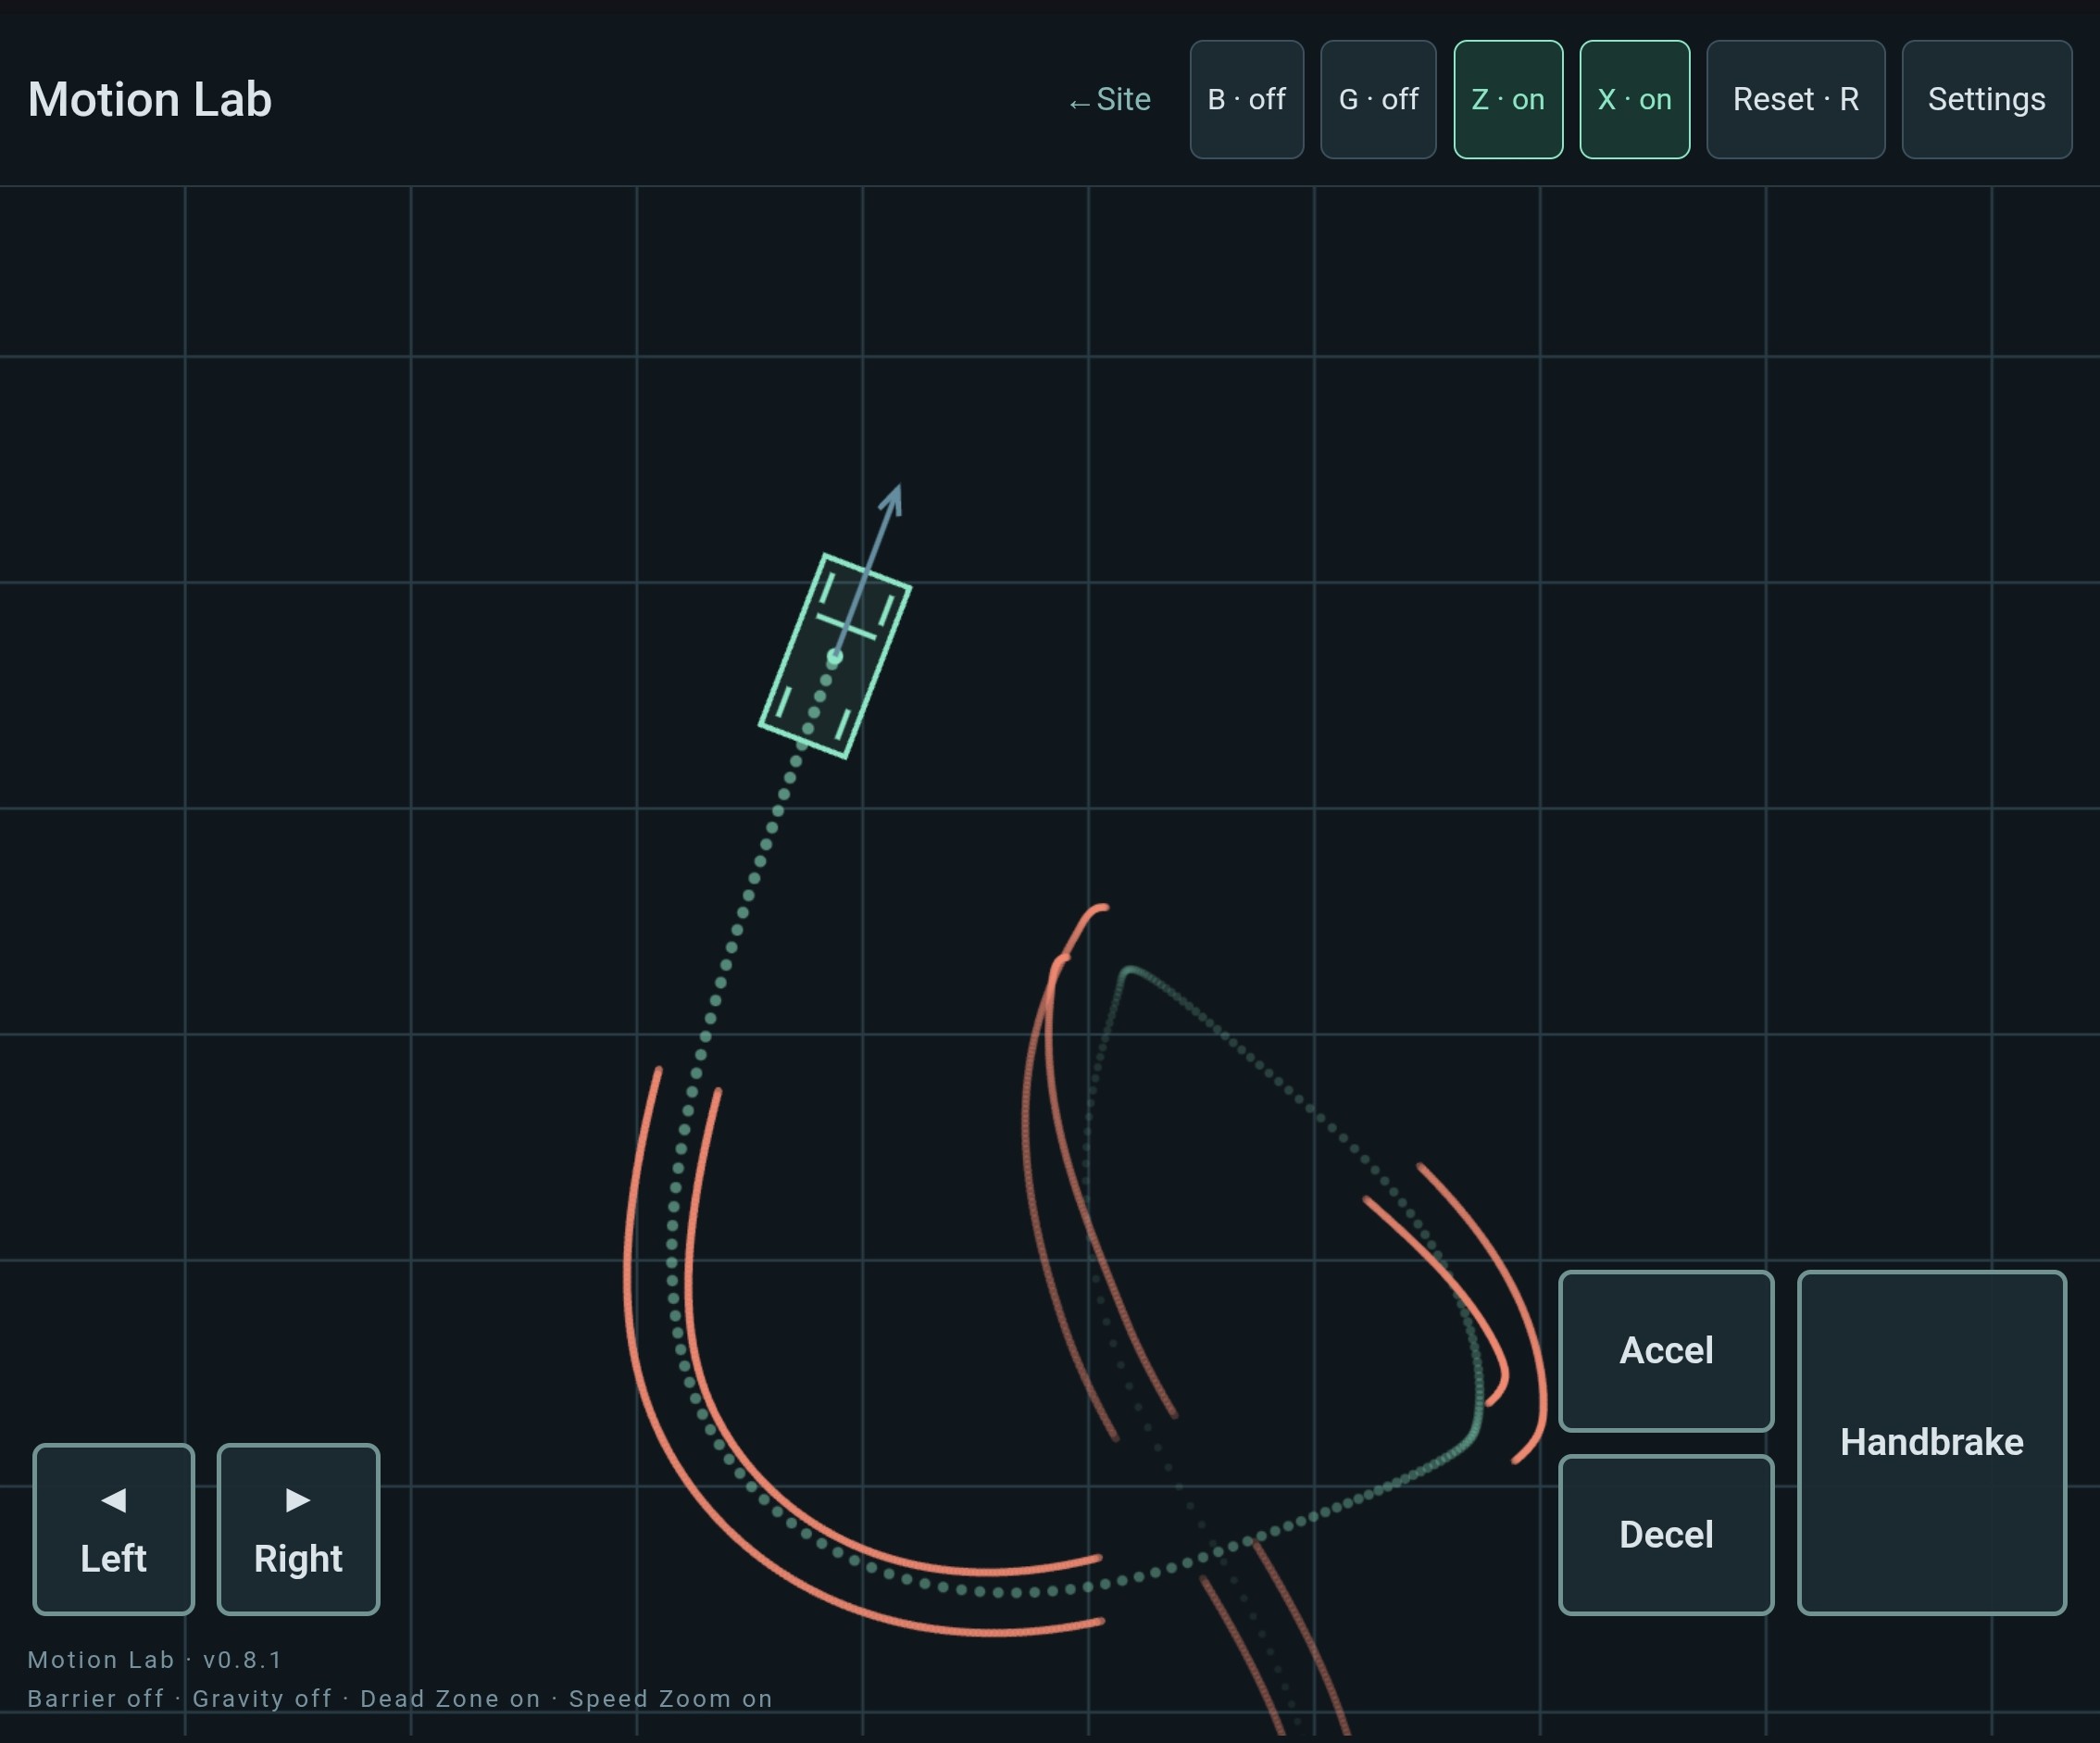
개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 원본은 나중에 C로 포팅되어 GTA의 차량 시스템 기초가 되었으며, 현재 'Motion Lab'이라는 이름으로 웹에서 플레이 가능하다. 기본 '카' 모드 외에 '우주선'(우주 비행 게임 Thrust 스타일)과 '벽돌' 모드를 제공하며, 터치/키보드 조작으로 제어할 수 있다. 전체 요약 11문장 읽기 → 068 21:11 당일 +202 마이크로소프트, 고품질 3D 생성 모델 TRELLIS.2 공개 마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. AI · 머신러닝 · microsoft/TRELLIS.2 · Python
Key Point 이미지 한 장에서 PBR 재질까지 포함한 완전한 3D 자산을 빠르게 생성할 수 있는 새로운 방식이 등장했으므로, 3D 콘텐츠 제작 워크플로우가 어떻게 바뀔 수 있을지 확인할 필요가 있다.
핵심 요약
마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. O-Voxel이라는 새로운 '필드 프리' 희소 복셀 구조를 사용하여 복잡한 위상, 예리한 특징, 완전한 PBR 재료를 가진 3D 자산을 생성한다. 512³ 해상도에서 약 3초(2초 형상 생성 + 1초 재질 생성), 1024³에서 약 17초, 1536³에서 약 60초가 소요된다. 전체 요약 12문장 읽기 → 069 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 070 06:11 ▲ 14 · 댓글 2 VLM 에이전트, 시각 기반 스킬로 강화 학습 기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. AI · 머신러닝 · ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
Key Point VLM 에이전트가 기하학적 정보를 보존한 시각 기반 스킬을 동적으로 습득·활용하는 새로운 강화 학습 방법으로, 정책과 스킬의 상호 개선 메커니즘이 기존 텍스트 중심 방식의 한계를 직접 해결한다.
핵심 요약
기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. ViSkill은 성공한 상호작용을 시각 정보 중심의 '스킬 카드'로 인코딩하여 VLM 에이전트가 직접 활용하는 방식을 제안한다. 검색된 스킬은 추론과 보상 형성을 모두 가이드하고, 성공한 궤적이 다시 스킬 라이브러리로 증류되어 닫힌 피드백 루프를 형성한다. 전체 요약 6문장 읽기 → 071 00:11 ▲ 215 · 댓글 82 AI 에이전트가 화면에 화살표와 텍스트를 그리게 해주는 macOS 도구 bigarrow는 macOS 명령줄 도구로, AI 에이전트가 화면 위에 투명한 화살표와 텍스트 레이블을 그려서 사용자를 특정 버튼이나 UI 요소로 안내한다. AI · 머신러닝 · Let your AI agents paint big arrows, boxes and text on your screen
Key Point AI 에이전트가 사용자의 물리적 조작이 필요한 순간에 정확한 위치를 시각적으로 가리켜서 '터미널에 프린트된 텍스트를 읽으면서 찾는' 번거로움을 없앤다.
핵심 요약
bigarrow는 macOS 명령줄 도구로, AI 에이전트가 화면 위에 투명한 화살표와 텍스트 레이블을 그려서 사용자를 특정 버튼이나 UI 요소로 안내한다. Swift 바이너리 하나로 구성되며 데몬, 메뉴바 아이콘, 텔레메트리가 없고, 그리기 자체는 macOS 권한을 필요로 하지 않는다. 화살표는 모든 윈도우, 디스플레이, Space 위에 떠있는 투명 윈도우에 렌더링되고, 클릭은 아래 앱으로 통과되며 키보드 포커스는 유지된다. 전체 요약 12문장 읽기 → 072 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 073 18:11 ▲ 109 · 댓글 124 AI 시대 수학 박사과정, 지금 시작해도 괜찮을까 수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. AI · 머신러닝 · What should we tell our students?
Key Point LLM의 급속한 발전으로 수학 박사과정 진학을 망설이는 학생들이 직면한 불안감에 대해, 실제 문제와 과장된 주장을 구분하고 어떻게 대응해야 할지 안내하는 수학자의 구체적인 조언을 담고 있다.
핵심 요약
수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. 저자는 AI 기업들이 자사의 이익을 위해 LLM 능력을 과장하고 있다고 지적한다. 예를 들어 OpenAI는 Navier-Stokes 문제 해결에 약 1500만 달러를 투자했지만, 다른 밀레니엄 난제 해결 실패에 드는 비용을 공개하지 않는다. LLM은 현재 기존 문헌에 포함된 아이디어의 볼록껍질 내에서만 작동한다고 본다. Erdős의 단위거리 추측 반박은 기하학과 대수적 수론의 기존 아이디어를 결합한 것으로, Riemann 가설처럼 완전히 새로운 개념이 필요한 문제 해결은 불가능하다. 전체 요약 11문장 읽기 → 074 18:11 ▲ 38 · 댓글 2 편집과 생성 작업을 위한 통합 대응점 매칭 프레임워크 FreeMatching Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. AI · 머신러닝 · Beyond Spatio-Temporal Priors: A Generalizable Approach for Dense Correspondence Matching
Key Point 생성형 AI의 이미지 편집과 참고 기반 생성 작업에서 객체 정체성을 유지하면서 변환된 이미지 간 대응점을 찾는 근본적 문제에 새로운 해법을 제시해, 콘텐츠 생성 도구의 질적 개선에 직결된다.
핵심 요약
Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. FreeMatching은 생성 모델과 의미론적 파운데이션 표현(semantic foundation representation)을 결합해, 고전 데이터셋·추적 비디오·합성 장면으로부터의 다양한 감독 신호를 활용해 정체성 보존 대응점을 학습하는 프레임워크. 교사 모델 가이드 반복 정제(teacher-guided iterative refinement) 기법을 통해 대응점 주석 없이도 IEG 작업에서 대응점 품질을 추가 개선. 전체 요약 6문장 읽기 → 075 15:13 ▲ 37 · 댓글 2 로봇 영상 예측 모델 DreamTrue, AgiBot World Challenge 2026 우승 로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. AI · 머신러닝 · DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
Key Point 로봇 학습에서 행동 추종과 물리적 타당성이라는 두 가지 핵심 문제를 동시에 해결하는 기법이 실제로 결함률을 48%에서 6%로 낮췄으며, 국제 대회 우승으로 검증되어 로봇 월드 모델 발전에 중요한 진전을 보여준다.
핵심 요약
로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. 기존 로봇 데이터셋으로 학습할 때 발생하는 두 가지 문제를 해결한다: 부정확한 캘리브레이션이 행동 추종을 방해하고, 실패 상호작용의 제한적 범위가 성공 편향을 만든다. 행동 궤적을 이미지 공간 조건으로 변환하고 오프라인 기하학 캘리브레이션을 도입해 다양한 로봇 체형 간 행동 추종을 개선한다. 전체 요약 8문장 읽기 → 076 12:11 ▲ 226 · 댓글 3 가상 세계에서 코드로 에이전트를 진화시키는 AgentGarten AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. AI · 머신러닝 · AgentGarten: Code Worlds for Evolving Agents
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 077 12:11 ▲ 13 · 댓글 2 3D 메시에서 CAD 모델 자동 복원하는 AI 에이전트 등장 3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. AI · 머신러닝 · CADFather: Autonomous CAD Reconstruction through Coordinated Tool Use
Key Point 3D 메시를 직접 편집 가능한 CAD 파라미터로 변환하는 과정이 자동화되면 역설계와 설계 작업흐름이 크게 단순화될 수 있기 때문이다.
핵심 요약
3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. CADFather는 여러 상호보완적 도구를 조율하는 자율 에이전트 시스템으로, 3D 메시에서 파라메트릭 CAD 프로그램을 복원한다. 비전-언어 어시스턴트가 목표 및 중간 단계 렌더링을 검사하고, 어느 CAD 프로그램을 확장할지, 어떤 도구를 사용할지, 몇 개의 제안을 생성할지, 언제 종료할지를 결정한다. 전체 요약 7문장 읽기 → 078 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 079 18:30 ▲ 44 · 댓글 1 사진 한 장으로 3D 장면 복원, 물리적으로 호환되는 객체들을 함께 생성 단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. AI · 머신러닝 · Tetris3D: 3D Scene Generation With Objects That Fit Together
Key Point 3D 장면 이해에서 객체 간 물리적 호환성을 명시적으로 학습하는 방식이 새로운 접근이며, 새로운 대규모 물리 시뮬레이션 데이터셋이 공개되어 후속 연구의 기초자료가 될 수 있기 때문이다.
핵심 요약
단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. 기존 방법들과 달리 각 객체의 생성을 주변 객체의 기하학적 형태와 물리적 관계에 조건화해, 객체 간의 공간적 호환성을 보장한다. 연구팀은 ComOb라는 물리 시뮬레이션 기반 데이터셋을 구축했는데, 1.2M개의 장면에 다양한 카테고리의 물리 상호작용과 객체별 메시, 객체 쌍의 물리 관계 정보를 포함했다. 전체 요약 5문장 읽기 → 080 18:30 ▲ 115 · 댓글 53 11개 정사각형 최적 배치 증명, AI 보조로 완성 Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. AI · 머신러닝 · AI-assisted proof of optimal packing for 11 squares
Key Point 최적화 문제의 엄밀한 증명에 AI 보조 도구와 형식 검증이 어떻게 결합되는지 보여주는 사례로, 수학적 추측을 기계 검증 가능한 형태로 변환하는 최신 방법론을 시연한다.
핵심 요약
Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. 7,920개 지역 Lean 모듈을 EvolvingPrograms 검증 시스템으로 검증했으며 모든 감사에서 오류가 0건이다. 최적 한 변의 길이는 T = (6u+4)/(1+2u-u²) 형태이며, u는 방정식 5u⁸-10u⁷-2u⁶+14u⁵+12u⁴-6u³+2u²+2u-1=0의 (9/25, 37/100) 범위 내 유일한 근이다. 전체 요약 8문장 읽기 → 081 18:33 ▲ 32 · 댓글 3 LLM 에이전트의 구조 설계 능력 평가 벤치마크 'LMBuild' 공개 LLM 기반 에이전트가 3D 구조물을 생성할 수 있지만, 기하학적 완성도와 실제 제작 가능성은 별개의 문제다. AI · 머신러닝 · LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
Key Point LLM이 물리적으로 제작 가능하고 기능하는 구조물을 만들어야 하는 시대에, 기하학적 완성도만이 아닌 실제 구축 가능성을 평가하는 기준이 처음으로 제시되었기 때문이다.
핵심 요약
LLM 기반 에이전트가 3D 구조물을 생성할 수 있지만, 기하학적 완성도와 실제 제작 가능성은 별개의 문제다. 기존 평가 방식은 기하학적 품질만 중점두고 물리적 실현 가능성을 간과해왔다. LMBuild는 LLM 에이전트가 생성한 구조물의 건축 가능성과 기능성을 평가하는 벤치마크로, 부품 분해·조인트·재료·제작 순서를 포함해 구조물을 표현한다. 전체 요약 8문장 읽기 → 082 18:35 ▲ 15 · 댓글 2 로봇 에이전트의 행동 선택을 단순화한 RobotUse 프레임워크 로봇 에이전트가 의도한 행동을 실제 결과에 연결하면서 반복 시도 과정에서 필요한 맥락을 유지하는 문제를 다룬다. AI · 머신러닝 · RobotUse: Allocating Computation, Context, and Decisions
Key Point 로봇 에이전트가 실제 환경에서 학습하고 행동 선택을 효율적으로 관리하는 새로운 방식을 제시하며, 기존 방법보다 높은 성공률과 맥락 효율성을 입증했다.
핵심 요약
로봇 에이전트가 의도한 행동을 실제 결과에 연결하면서 반복 시도 과정에서 필요한 맥락을 유지하는 문제를 다룬다. 기존 인터페이스는 선택을 미리 정의된 도구 내부에 남기거나 에이전트가 상세한 실행 코드와 그 증가하는 이력을 관리하도록 요구한다. RobotUse는 로봇 에이전트 프레임워크로, 계산·맥락·의사결정을 물리적 행동 지정 및 수정을 중심으로 구조화한다. 전체 요약 9문장 읽기 → 083 18:35 ▲ 122 · 댓글 86 AI 시대, 수학은 어떻게 발전할 것인가 수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. AI · 머신러닝 · The Future of Mathematics
Key Point AI가 수학 논문 수준의 결과를 생성하기 시작하면서 '수학이란 무엇인가'라는 근본적 질문이 제기되고 있으며, 수학의 본질은 문제 해결이 아니라 엄밀한 추론과 창의적 사고에 있다는 답변이 학문의 미래를 결정할 것이기 때문이다.
핵심 요약
수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. 그러나 수학의 본질은 엄밀한 추론과 의사소통의 문화이며, 이는 수천 년간 변함없이 유지돼 온 핵심이다. AI 시대에도 수학적 사고가 필요하다는 점은 변하지 않는다. 현재 기초 모델(foundation model)의 특징은 전체 수학 문헌을 학습했으며 피곤함이 없다는 것이다. AI의 해법들은 기존 기법을 조합해 푸는 문제들이 대부분이며, 근본적인 통찰력이나 새로운 아이디어를 요구하는 문제는 여전히 풀기 어렵다. 전체 요약 14문장 읽기 → 084 09:11 ▲ 14 · 댓글 1 Minkowski 기하학으로 시공간 패턴을 명시적으로 학습하는 신경망 인코딩 물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. AI · 머신러닝 · MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
Key Point 시공간 결합을 기하학적 불변량으로 명시적으로 모델링하면서도 표준 어텐션과 호환되는 새로운 인코딩이 다양한 스케일의 물리 지능 구축에 어떻게 기여하는지 보여준다.
핵심 요약
물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. 기존 접근법은 물리 법칙 기반이면 강한 사전지식을 제공하지만 유연성이 제한되고, 학습 기반은 유연하지만 시공간 결합을 대부분 암묵적으로만 처리한다. MinkowskiPE는 시간과 공간 좌표를 결합하여 Lorentz 변환을 query·key 특성에 적용하는 방식으로, 위치에 관한 어텐션 점수를 두 토큰 간의 상대적 시공간 변위에만 의존하게 만든다. 전체 요약 5문장 읽기 → 085 03:11 ▲ 48 · 댓글 0 3D 편집의 실제 조건을 담은 첫 벤치마크 공개 3D 편집 방법들은 보통 단일 편집만 테스트하지만, 실제로는 여러 수정 과정을 거쳐 자산이 완성되며 각 단계에서 요청된 부분만 수정하고 나머지는 유지해야 한다. AI · 머신러닝 · EditHero: A Benchmark for Long-Horizon Part-Level 3D Editing and Vibe Modeling
Key Point 지금까지 3D 편집 AI의 성능 평가가 단일 편집 과제에만 의존했는데, 실제 디자인 워크플로우의 다중 편집 조건을 담은 첫 벤치마크가 공개되면서 방법들의 실제 한계와 강점이 명확히 드러난다.
핵심 요약
3D 편집 방법들은 보통 단일 편집만 테스트하지만, 실제로는 여러 수정 과정을 거쳐 자산이 완성되며 각 단계에서 요청된 부분만 수정하고 나머지는 유지해야 한다. EditHero는 장시간의 부분 단위 3D 편집을 벤치마크하는 첫 번째 데이터셋으로, 자연어 지시와 기하학·텍스처 대상 이미지를 포함하며 결정론적 조립 엔진이 매 편집 후 정확한 결과물을 생성하고 모든 시퀀스는 수동 검수를 거친다. 비에이전트 방식은 학습된 3D 표현에서 전체 객체를 재생성하고 유지할 부분을 추론하는 하향식 접근을 취한다. 전체 요약 7문장 읽기 → 086 18:11 ▲ 51 · 댓글 2 물리 방정식 학습에 예측 기반 표현 학습 도입 매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. AI · 머신러닝 · PDE-JEPA: Predictive Representation Learning of Latent Dynamics Modeling for Parametric PDEs
Key Point 물리 시뮬레이션과 과학 계산이 필요한 분야에서 일반화 능력이 뛰어난 신경망 기반 PDE 솔버 개발의 핵심 진전입니다.
핵심 요약
매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. 예측 표현만으로는 정확한 필드 진화가 보장되지 않는다는 관찰을 기반으로 PDE-JEPA 프레임워크를 제안했습니다. 먼저 마스크된 잠재 예측을 사용해 인코더를 학습하여 PDE 동역학의 기저 규칙을 포착합니다. 전체 요약 6문장 읽기 → 087 15:11 ▲ 120 · 댓글 4 단백질 폴딩으로 AI의 추론 능력을 키운다 대규모 언어 모델은 표면적인 답변을 담은 인간 텍스트에 의존하면서, 그 뒤의 공간적·구조적 논리를 놓친다. AI · 머신러닝 · Does Learning Protein Folding Generalize to Broader Reasoning?
Key Point 구조화된 과학 문제의 학습이 언어 모델의 추론 능력 개선으로 직결되는 메커니즘을 처음 실증함으로써, 사전학습 데이터 구성 방식에 대한 새로운 접근 방향을 제시한다.
핵심 요약
대규모 언어 모델은 표면적인 답변을 담은 인간 텍스트에 의존하면서, 그 뒤의 공간적·구조적 논리를 놓친다. 연구팀은 단백질 폴딩 문제에 주목했다. 하나의 단백질 구조가 수천 개의 정확히 검증 가능한 공간·위상학적 문장을 만들어내기 때문이다. FoldingCorpus라는 단백질 기반 질의응답 데이터세트와 Fold2Reason이라는 학습 방법을 개발했다. 전체 요약 8문장 읽기 → 088 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 089 18:11 ▲ 113 · 댓글 44 AI가 레고 모델을 설계하는 오픈소스 도구 'ldraw-nova' 공개 AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. AI · 머신러닝 · Show HN: Made an open-source Lego AI generator
Key Point LLM이 복잡한 기하학 계산이 필요한 3D CAD 형식을 직접 생성하는 대신 파이썬 코드로 변환하면 성공률이 높아지는 새로운 접근법을 보여주며, AI로 만들 수 있는 창의적 결과물의 범위를 확장한다.
핵심 요약
AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. 생성된 결과물은 3D 뷰어, VR(Meta Quest 3), Blender 편집 가능한 glTF 파일, 채팅 기록, AI의 추론 과정 등 다양한 형식으로 제공된다. AI 에이전트는 먼저 지침을 읽고 필요한 부품과 서브모델을 계획한 후, 반복적으로 렌더링하며 위치와 미관을 조정해 모델을 완성한다. 전체 요약 7문장 읽기 → 090 09:11 ▲ 19 · 댓글 2 텍스트 손실 없이 멀티모달 임베딩 통합하는 경량 모델 기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. AI · 머신러닝 · Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
Key Point 기존 멀티모달 모델의 텍스트 성능 저하 문제를 해결하면서 매우 경량화한 기술로, 실제 프로덕션 배포에서 비용과 메모리 효율성이 크게 개선된다.
핵심 요약
기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. Omni-Embed-Mini는 0.9B 파라미터로 텍스트, 음성, 오디오, 이미지, 비디오, 문서를 단일 임베딩 공간에 매핑하면서 텍스트 파라미터는 고정해 손실을 방지한다. 핵심은 별도의 교사 모델 없이 각 미디어 샘플을 밀집 캐스케이딩 캡션과 쌍으로 만들고, 교사 신호는 고정된 백본의 캡션 임베딩을 그대로 사용한다는 것이다. 전체 요약 8문장 읽기 → 091 03:11 ▲ 37 · 댓글 2 건축 평면도에 자동으로 가구 배치하는 AI 모델 등장 부동산 시각화·인테리어 설계·건축 업무에 필요한 가구 배치를 자동화하는 문제를 풀었다. AI · 머신러닝 · Architect-Ant: Editable Automatic Furnishing of Architectural Floor Plans
Key Point 건축·부동산 시각화 전문가가 수동으로 해온 가구 배치 작업을 AI가 전문성을 갖춰 자동화하면서, 실제 프로젝트에 바로 쓸 수 있는 수준에 도달했기 때문이다.
핵심 요약
부동산 시각화·인테리어 설계·건축 업무에 필요한 가구 배치를 자동화하는 문제를 풀었다. 실제 건축 전문가의 평면도를 학습한 사전학습 모델로, 반복 추론 비용 없이 제약을 고려한 배치를 생성한다. 505개 전문가 평면도에서 92개 가구 유형·10개 주거 공간 유형의 밀집 주석 데이터셋 AntPlan을 구축했다. 전체 요약 7문장 읽기 → 092 03:11 ▲ 102 · 댓글 87 AI가 증명하는 정리, 수학의 미래를 두고 한숨 AI가 나비에-스토크스 추측을 증명하고 밀레니엄 문제를 해결하면서 수학 커뮤니티가 다섯 단계 상실감(거부·분노·타협·우울·수용)을 겪고 있다. AI · 머신러닝 · To grieve, or not to grieve?
Key Point AI가 수학의 어려운 정리들을 증명하면서 수학자들이 자신의 역할과 가치를 재정의하려 하는 와중에, 저자는 '이해'를 내세우는 것이 장기적 함정이 될 수 있으며 정리 증명 자체의 가치를 돌아봐야 한다고 주장한다.
핵심 요약
AI가 나비에-스토크스 추측을 증명하고 밀레니엄 문제를 해결하면서 수학 커뮤니티가 다섯 단계 상실감(거부·분노·타협·우울·수용)을 겪고 있다. 거부 단계: '인간 수학 협회'는 AI 사용을 금지하고 AI 없이 증명을 찾겠다고 선언하며, 필즈상 수상자 피터 숄체는 AI를 쓰지 않겠다고 공언했다. 분노 단계: 블라드 라직 등 여러 수학자가 온라인에서 AI 증명에 대한 분노를 표했다. 전체 요약 13문장 읽기 → 093 18:11 ▲ 57 · 댓글 2 일상 영상에서 도구 사용 이해하는 AI 벤치마크 공개 일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. AI · 머신러닝 · EgoTools: Towards Tool-Centric Reasoning in Real-World Egocentric Videos
Key Point 현 멀티모달 모델이 실제 작업 영상에서 도구 사용의 세부 기하학·절차·인과관계를 이해하는 데 약점을 드러냈으므로, 이를 진단하고 개선할 수 있는 벤치마크가 필요하다.
핵심 요약
일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. 이를 해결하기 위해 EgoTools 스위트를 공개했으며, 100시간의 도구 중심 1인칭 영상 데이터셋(음성 동기화·캡션·내레이션·3D 정보 포함)과 진단 벤치마크로 구성된다. 벤치마크는 1,000개의 QA로 이루어져 있으며 지각·기하학·절차·인과 추론의 4가지 트랙을 포함한다. 전체 요약 6문장 읽기 → 094 15:11 ▲ 42 · 댓글 2 로봇이 과거 사건 기억해 물체 집기 — 가려진 대상도 스스로 찾는다 과거 상호작용 기록을 바탕으로 물체를 파악하고 집는 로봇 시스템 BeyondSCe를 발표했다. 사용자의 요청이 '저 사건에서 사용한 물건'처럼 사건 기반이므로, 물체 이름이나 외형만으로는 특정할 수 없는 상황을 다룬다. 하드웨어 · 시스템 · Beyond the Current Scene: Event-Referential Grasping with Active View Selection
Key Point 로봇이 '그때 그 도구' 같이 문맥과 사건 기억에 기반한 지시를 이해하고 실행하는 것은 실제 가사 보조 로봇으로서의 실용성을 크게 높이는 진전이다.
핵심 요약
과거 상호작용 기록을 바탕으로 물체를 파악하고 집는 로봇 시스템 BeyondSCe를 발표했다. 사용자의 요청이 '저 사건에서 사용한 물건'처럼 사건 기반이므로, 물체 이름이나 외형만으로는 특정할 수 없는 상황을 다룬다. 시스템은 사건 히스토리와 현재 장면 정보를 함께 활용해 요청 물체를 찾고, 가려진 경우 과거 사건의 정보와 현재 기하학적 정보를 결합해 카메라 각도를 자동으로 선택한다. 사전학습 모델만 사용하며 추가 학습 없이 동작한다. 전체 요약 5문장 읽기 → 095 15:11 ▲ 30 · 댓글 2 비디오 생성 모델을 3D 기하학으로 정밀 제어하는 4Director 비디오 프로덕션에서 카메라와 물체의 동작을 정확히 제어하기 위해 4Director라는 비디오 월드 모델을 제안한다. AI · 머신러닝 · 4Director: Controlling Video World Models with Rigid 3D Geometry
Key Point 3D 기하학 기반 명시적 제어 방식으로 비디오 생성에서 카메라·물체 움직임의 정확도를 근본적으로 높였으며, 신규 데이터셋과 평가 지표까지 공개해 후속 연구의 기초가 될 수 있다.
핵심 요약
비디오 프로덕션에서 카메라와 물체의 동작을 정확히 제어하기 위해 4Director라는 비디오 월드 모델을 제안한다. 기존 방식은 깊이와 회전이 모호한 이미지 평면 신호나 기하학이 불완전한 3D 트랙으로만 제어했지만, 4Director는 명시적 4D 장면 표현을 사용한다. 각 객체를 입력 이미지에서 정준 메시(canonical mesh)로 한 번 재구성한 후 매 프레임마다 정해진 강체 변환(rigid transformation) 하나로 움직인다. 전체 요약 7문장 읽기 → 096 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 097 03:11 ▲ 33 · 댓글 2 근육 기반 모션을 다양한 지형에서 재구성·재타겟하는 TERRA 파이프라인 근육 기반 에이전트가 복잡한 인간 동작을 재현할 수 있게 발전했으나, 지형 정보가 부족해 평탄한 지면에만 국한되어 왔다. AI · 머신러닝 · TERRA: Terrain-Aware Reconstruction, Retargeting and Control for Musculoskeletal Locomotion
Key Point 근육 단위로 동작하는 인간형 로봇이 평탄한 곳을 벗어나 실제 불규칙한 지형을 움직이도록 하는 것은 로봇 제어와 애니메이션 분야의 핵심 난제인데, 이 논문이 모션 캡처 데이터로부터 지형을 추론하고 재타겟하는 자동화된 파이프라인을 제시했다.
핵심 요약
근육 기반 에이전트가 복잡한 인간 동작을 재현할 수 있게 발전했으나, 지형 정보가 부족해 평탄한 지면에만 국한되어 왔다. TERRA는 운동학적 궤적만으로 지형 사전 정보, 접촉 추정, 여유 공간 증거를 결합해 작업 관련 지지 기하학을 복구한다. 재타겟 과정에서 해부학적·인대 연속성·접촉 제약 조건을 고려해 근육 동작에 맞게 조정한다. 전체 요약 6문장 읽기 → 098 06:11 ▲ 13 · 댓글 2 밀집 검색, 공유 vs 독립 투영 선택 기준을 이론으로 증명 Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. AI · 머신러닝 · When Does Dense Retrieval Need Asymmetric Geometry? A Bias-Variance Theory of Shared and Dual Projections
Key Point Dense retrieval 시스템에서 쿼리-문서 인코딩을 공유할지 독립적으로 설계할지 선택하는 문제에 처음으로 엄밀한 이론적 기준을 제시해, 실무 설계 결정의 근거를 제공한다.
핵심 요약
Dense retrieval의 쿼리-문서 투영 방식 선택에 관한 이론적 기초를 제시한 논문으로, 저차원 이중선형 스코어링의 편향-분산 이론을 도입했다. 공유 투영(Shared)은 양의 준정치 연산자를 생성하고 독립 투영(Dual)은 임의의 저차원 연산자를 실현하는 구조적 차이가 있다. 정확한 근사 오차를 유도했으며, 제곱 방향신호가 추가 자유도의 추정 비용을 초과할 때만 독립 투영이 더 낮은 리스크를 갖는다는 국소 가우시안 경계를 증명했다. 전체 요약 8문장 읽기 → 099 06:11 ▲ 109 · 댓글 22 종이접기로 배우는 기하학 플라톤이 발견한 5가지 정다면체(플라톤 입체)는 모든 면이 같은 정다각형이며 모든 꼭짓점이 동일하게 보이는 가장 규칙적인 다면체다. 웹 · 프론트엔드 · Mathematical Origami
Key Point 수학 개념을 종이접기로 체험하고 배우는 대화형 교육 플랫폼으로, 기하학의 핵심 개념인 정다면체와 입체 구조를 손으로 직접 만들며 이해할 수 있다.
핵심 요약
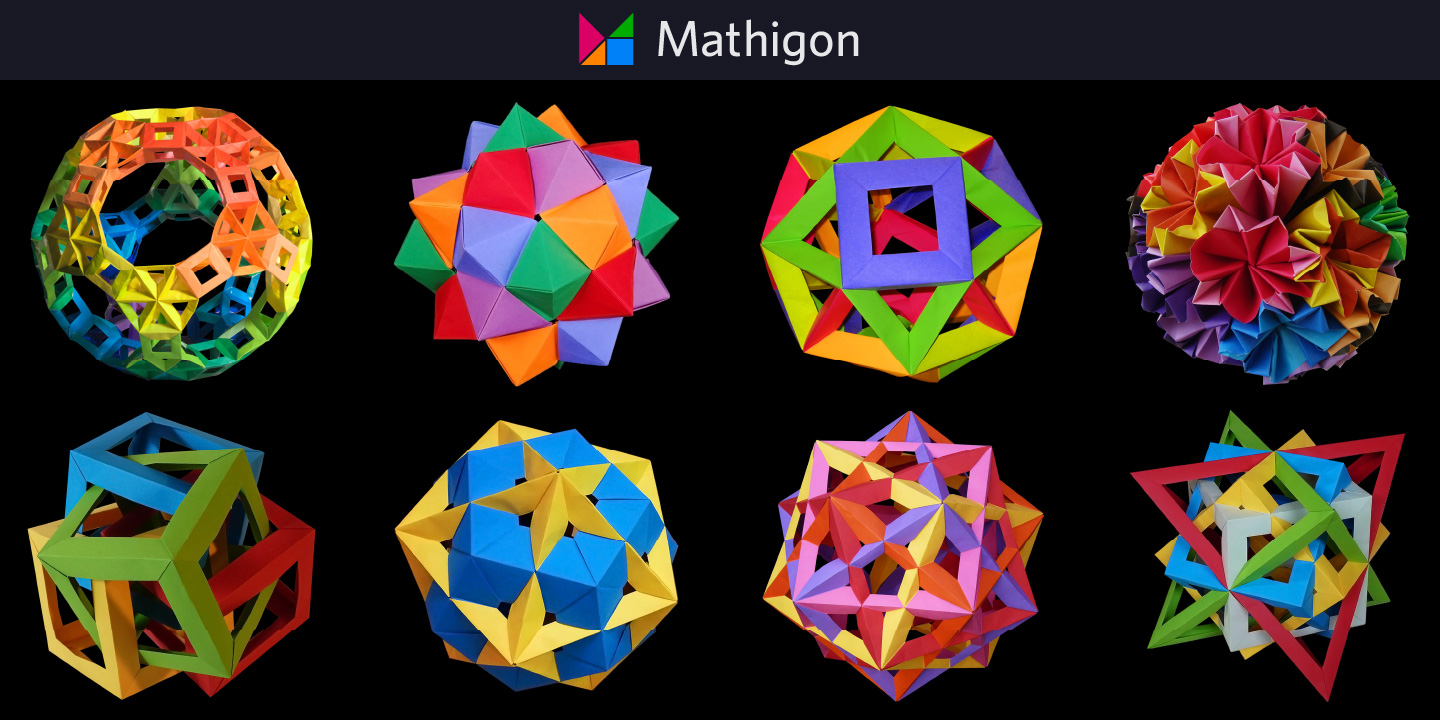
플라톤이 발견한 5가지 정다면체(플라톤 입체)는 모든 면이 같은 정다각형이며 모든 꼭짓점이 동일하게 보이는 가장 규칙적인 다면체다. 정다면체는 정사면체, 정육면체, 정팔면체, 정십이면체, 정이십면체를 포함하며, 플라톤은 이들이 흙, 물, 공기, 불, 우주라는 고대 원소에 대응된다고 믿었다. 아르키메데스 입체는 플라톤 입체처럼 정다각형으로 이루어지고 모든 꼭짓점이 같지만, 여러 종류의 다른 정다각형 면으로 구성되어 있다. 전체 요약 8문장 읽기 → 100 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
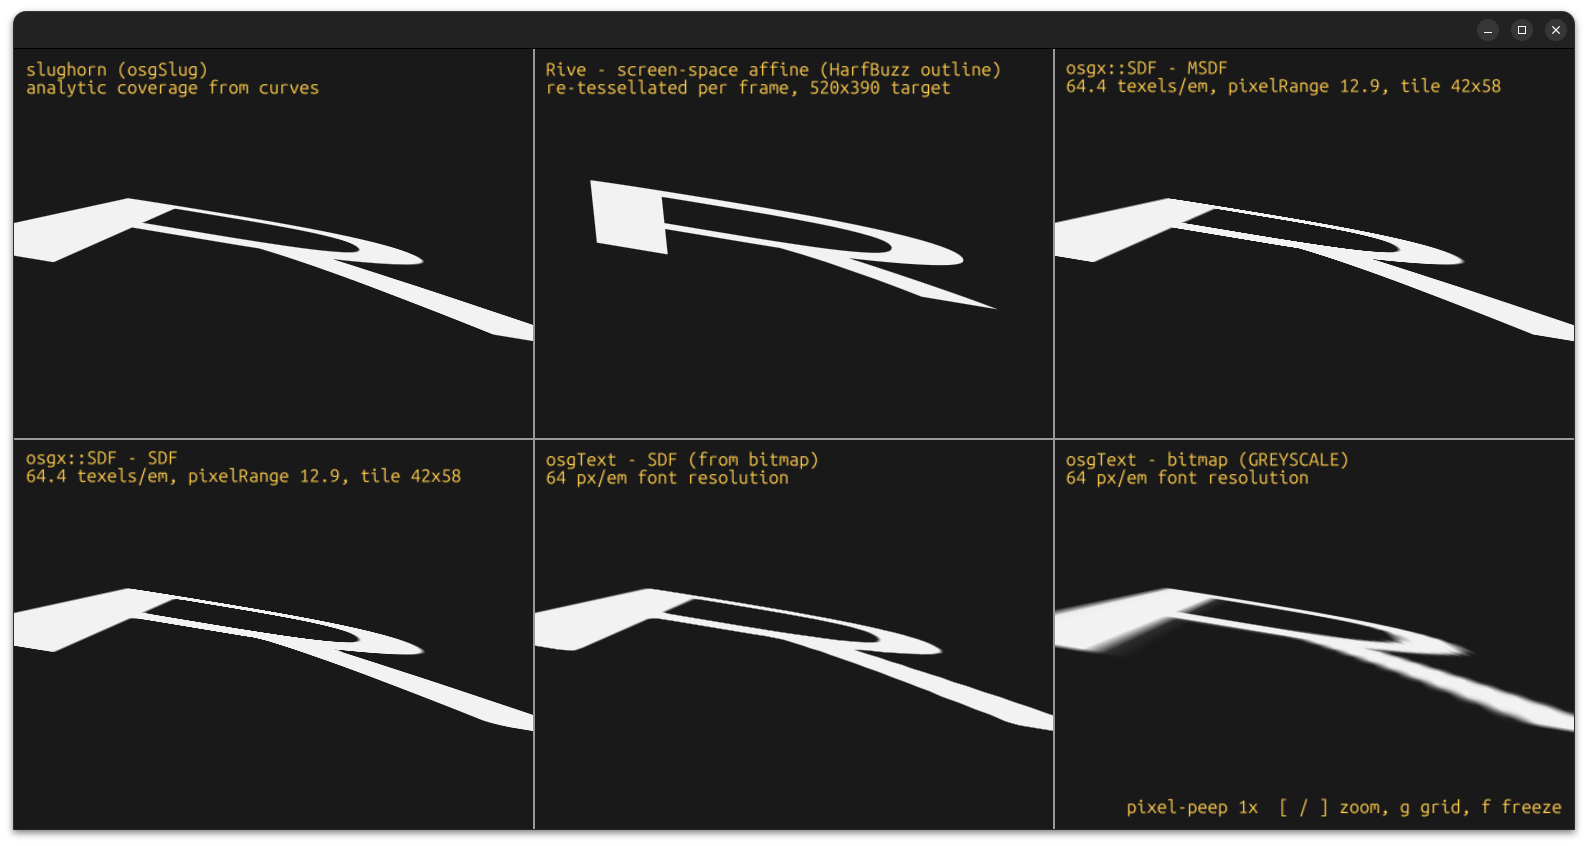
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 →