001 15:11 ▲ 13 · 댓글 1 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 002 06:11 ▲ 146 · 댓글 14 Word2Vec 창시자 토마시 미콜로프, 체코 대통령으로부터 훈장 수상 체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI · 머신러닝 · Tomáš Mikolov awarded the Medal of Merit by the President of the Czech Republic
Key Point Word2Vec으로 현대 AI의 기초를 닦은 인물이 국가적 인정을 받았으며, 한국의 AI 연구자들이 참고할 만한 국제적 사례이자 자신의 성과 인정 경로를 보여준다.
핵심 요약
체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI 전문가 토마시 미콜로프는 Word2Vec 방식의 창시자로, 단어를 수학 벡터로 표현하여 의미 관계를 포착하는 기술을 개발했다. Word2Vec은 현대 언어 모델과 AI 도구의 중요한 기초가 되었으며, 미콜로프는 BottleCap AI 회사를 통해 효율적인 언어 모델 개발에 종사하고 있다. 전체 요약 9문장 읽기 → 003 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 006 00:11 ▲ 18 · 댓글 2 자동 정리 증명, 복잡한 워크플로우보다 단순 반복 루프가 더 효과적 형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. AI · 머신러닝 · h1: A Taste of the Bitter Lesson in Automated Theorem Proving
Key Point 자동화된 정리 증명에서 복잡한 설계 워크플로우 대신 단순한 에이전트 루프가 더 효과적일 수 있다는 발견은, 향후 형식 검증 시스템을 어떻게 구축할 것인지에 대한 근본적인 접근 방향을 바꿀 수 있다.
핵심 요약
형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. 이 논문은 '비터 레슨' 질문을 제기한다: 테스트 타임 계산을 확장하는 단순한 에이전트 루프가 이런 복잡한 워크플로우와 경쟁할 수 있는가? h1이라는 단순한 도구를 개발했는데, 이는 모델에게 Lean 4의 효율적인 인터페이스를 제공하고 검증자 피드백과 자기 성찰로 작동하며, 명시적 분해나 탐색 구조를 강요하지 않는다. 전체 요약 7문장 읽기 → 007 09:11 ▲ 131 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 008 06:11 ▲ 125 · 댓글 28 유한 단순군의 분류, Lean으로 형식화 완료 군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. AI · 머신러닝 · Classification of Finite Simple Groups Formalized in Lean
Key Point 수십 년에 걸친 군론의 거대한 정리를 기계로 완전히 검증했을 뿐 아니라, 그 과정에서 기존 증명의 오류까지 발견한 사례는 형식화 수학의 실질적 가치를 보여준다.
핵심 요약
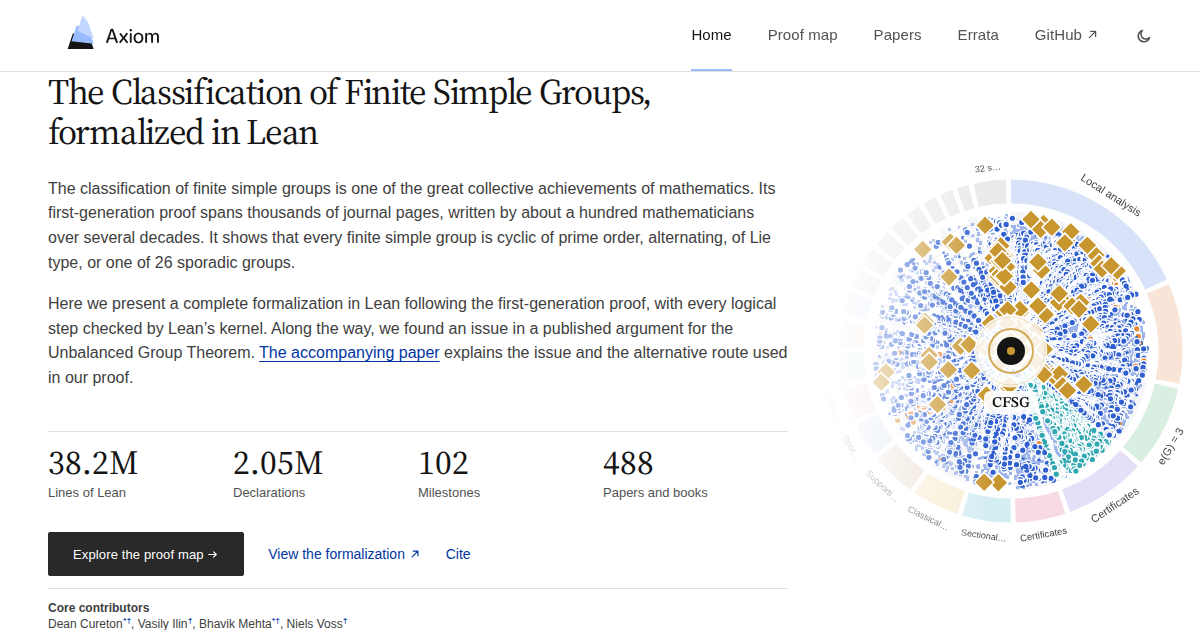
군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. 형식화 과정에서 기존 출판된 증명의 폐쇄성 주장에 대한 반례를 발견했으며, 이를 다룬 논문이 발표됐다. 특히 불균형군 정리(Unbalanced Group Theorem)의 기존 경로에서 막힘이 생겨, 1976년 Solomon의 극대 2-성분 이론을 바탕으로 한 대안적 논증을 제시했다. 전체 요약 4문장 읽기 → 009 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 010 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 011 03:12 ▲ 202 · 댓글 96 파스칼이 정한 노선 대중교통을 발명하다 1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 기타 · Blaise Pascal invented fixed route public transport (2024)
Key Point 역사적으로 가장 중요한 도시 운송 혁신이 정부 정책이나 기술 기업이 아닌 수학자의 기하학적 사고에서 비롯되었다는 점과, 공학적 우월성보다 사회 포용성이 대중교통 성패를 결정한다는 인사이트를 배울 수 있다.
핵심 요약
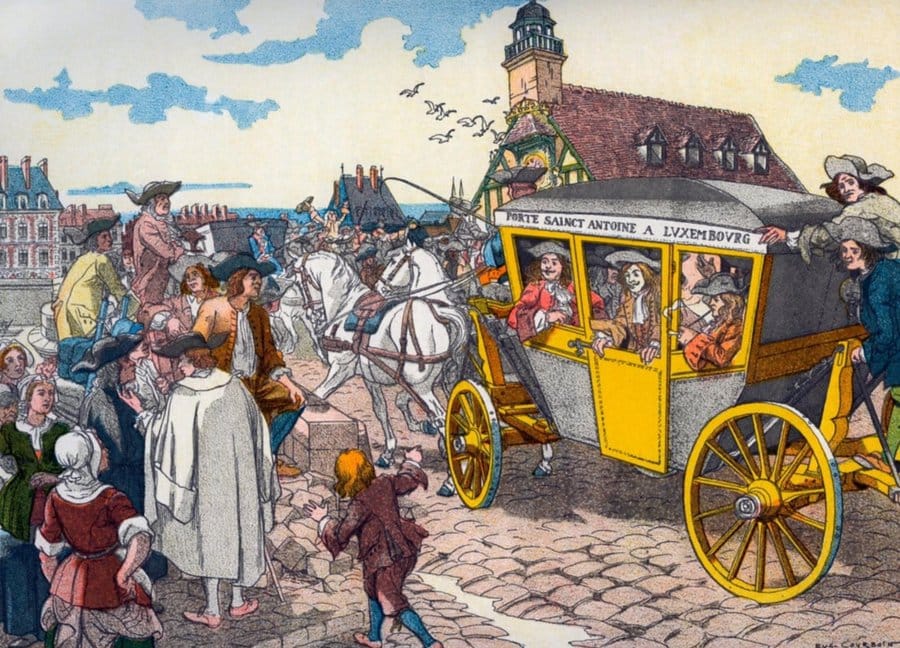
1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 8명 탑승 가능한 말 끌기 마차 5대가 예측 가능한 주기(7.5~15분)로 여러 연결 노선을 운행했다. 파스칼의 네트워크는 현대 버스, 전차, 열차의 직접적인 선조이며, 육지에서 고정 노선 대중교통의 첫 시례였다. 전체 요약 9문장 읽기 → 012 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 013 12:11 ▲ 208 · 댓글 187 미국 창작산업 4년간 20만개 일자리 사라져, AI 영향 추정 어려워 미국은 지난 4년간 미디어·영화·예술 관련 산업에서 20만 개 이상의 일자리를 잃었으며, 작년 한 해에만 5만 개가 감소했다. AI · 머신러닝 · America has lost 200k of jobs in media, film and the arts. How much is AI?
Key Point 창작산업이 겪는 대규모 일자리 감소가 AI의 시작과 시기를 같이하며, 이것이 인터넷 이후 신문산업처럼 전체 사업모델의 붕괴로 진행될 수 있다는 점을 보여준다.
핵심 요약
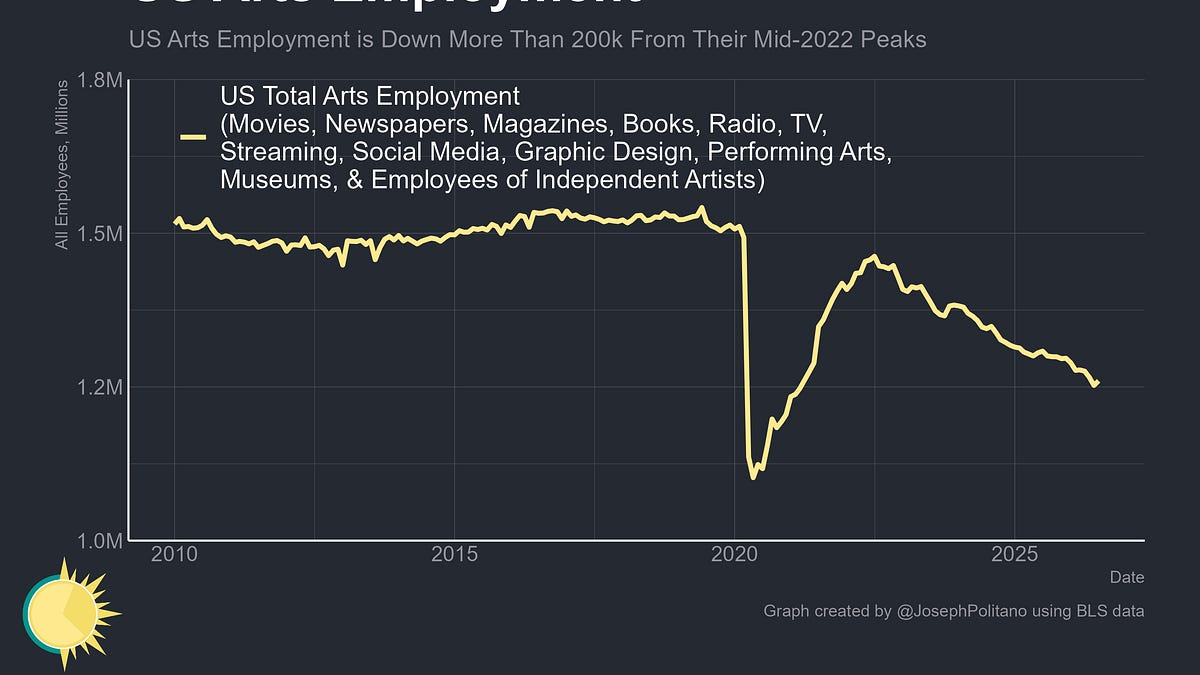
미국은 지난 4년간 미디어·영화·예술 관련 산업에서 20만 개 이상의 일자리를 잃었으며, 작년 한 해에만 5만 개가 감소했다. 2001년과 2008년 금융위기 수준의 일자리 감소가 일어나고 있지만, 현재는 경기 침체 없이 AI의 부상과 동시에 발생하고 있다. AI 기반 일자리 손실 규모를 정확히 증명하기 어려운 이유는 미디어 기업들이 저작권 보호와 여론 회피를 위해 AI 사용을 숨기기 때문이다. 전체 요약 12문장 읽기 → 014 06:11 ▲ 102 · 댓글 84 AI가 쓴 글이 어려운 이유: 정보 밀도 최적화 때문 AI 생성 텍스트가 최근 이해하기 어려워졌다는 광범위한 인식이 있어, 심리언어학적 특징을 분석한 연구가 나왔다. AI · 머신러닝 · Why is AI generated language so hard to understand?
Key Point AI 모델들이 의도하지 않게 생성하는 비자연스러운 문법 구조가 정보 밀도 최적화 때문이라는 구체적 원인을 밝혔으며, 향후 더 읽기 쉬운 AI 텍스트를 만드는 방향을 제시한다.
핵심 요약
AI 생성 텍스트가 최근 이해하기 어려워졌다는 광범위한 인식이 있어, 심리언어학적 특징을 분석한 연구가 나왔다. 연구팀은 목적어 상대절, 긴 통사 의존성, 저빈도 n-그램 등 인간의 처리 난이도와 상관관계가 있는 요소들을 조사했다. 9개 최신 모델 모두 생명이 없는 주어와 동사 활용 및 저빈도 n-그램을 더 많이 사용했으며, 대부분 더 긴 의존성, 적층된 명사, 대화에서 축약된 목적어 상대절을 더 많이 사용했다. 전체 요약 7문장 읽기 → 015 15:10 ▲ 107 · 댓글 74 음악은 왜 우리 마음을 흔드는가 저자가 차에서 전 세계 민속음악 혼합곡을 들으며 음악이 어떻게 평범한 숲을 신비로운 세계로 변화시킬 수 있는지 경험한다. 기타 · How is music possible
Key Point 음악이 단순한 청각 자극을 넘어 어떻게 인간의 가장 깊은 부분을 건드리는지에 대한 근본적 의문을 다룬다.
핵심 요약
저자가 차에서 전 세계 민속음악 혼합곡을 들으며 음악이 어떻게 평범한 숲을 신비로운 세계로 변화시킬 수 있는지 경험한다. 음악은 수학적 관계의 추상적 패턴일 뿐인데 왜 우리를 감정적으로 움직이는가라는 근본적 의문을 제기한다. 음악심리학의 첫 번째 관점은 음악이 음성의 톤이나 공간 감지 같은 생물학적 체계를 조작해 감정을 유발한다고 본다. 전체 요약 10문장 읽기 → 016 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 24 · 댓글 2 LLM 라우팅의 실행 방식까지 함께 학습하는 RouteWeaver LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. AI · 머신러닝 · RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
Key Point 여러 LLM을 효율적으로 활용하려는 개발자들에게 실행 방식까지 동적으로 선택하는 새로운 라우팅 프레임워크가 어떻게 작동하는지 알려준다.
핵심 요약
LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. RouteWeaver는 이러한 라우팅 방식들을 하나의 LLM 정책으로 통합하며, 어떤 방식을 쓸지와 그 방식 내에서 어느 모델을 선택할지를 함께 학습한다. COMET-GRPO(COordinated Mode-Execution Training) 학습 알고리즘은 궤적 단위의 이득값을 방식 선택과 방식 내 실행의 별도 신호로 분해해 각 결정 단계에 더 정확한 학습 신호를 전달한다. 전체 요약 6문장 읽기 → 018 18:11 ▲ 159 · 댓글 97 자연언어 프로그래밍은 왜 실패하는가 1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 오픈소스 · 도구 · The foolishness of "natural language programming" (1978)
Key Point 프로그래밍을 인간언어로 하면 더 쉬워질 것이란 아이디어가 왜 근본적으로 실패할 수밖에 없는지를 형식 체계의 역사와 논리로 설명한 고전 논문이다.
핵심 요약
1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 초기 컴퓨팅 시대부터 프로그래머들은 형식적 기호 체계의 엄격함을 단점으로 느꼈고, 기계가 모순된 명령도 충실히 실행하는 것을 문제 삼았다. 고급 프로그래밍 언어 개발로 명백한 실수는 에러 메시지를 내보내게 되어 개선됐지만, 프로그래밍의 형식성 요구는 여전했다. 전체 요약 12문장 읽기 → 019 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 020 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 021 00:11 ▲ 20 · 댓글 1 세션을 넘나드는 자율 연구 에이전트 Épi, 수학 난제 풀이에서 기록 경신 Épi는 세션 간 연구 연속성을 유지하고 누적된 경험으로 방법론을 개선하는 자율 연구 에이전트다. AI · 머신러닝 · Epi: Towards a Persistent, Self-Improving Agent for Autonomous Research
Key Point 자율 에이전트가 세션을 넘어 학습·개선하면서 수학 상수 계산부터 그래프 추측 증명까지 인간이 푸지 못한 문제들을 컴퓨터 보조로 해결하는 새 패러다임을 보여준다.
핵심 요약
Épi는 세션 간 연구 연속성을 유지하고 누적된 경험으로 방법론을 개선하는 자율 연구 에이전트다. 지속적 연구 이력, 계층적 메모리, 분기 탐색, 독립적 검증을 결합해 실험을 추적하고 대안적 접근을 재검토한다. 수치 해석에서 120개의 기록을 세웠는데, n-queens 상수 구간을 약 84배 좁혔고 quartic Feigenbaum attractor 차원 구간을 360만 배 이상 좁혔다. 전체 요약 8문장 읽기 → 022 21:11 ▲ 105 · 댓글 58 양자 물리학의 무대, 힐베르트 공간이란 무엇인가 양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. AI · 머신러닝 · In Hilbert space, all things are quantumly possible
Key Point 양자역학의 수학적 기초인 힐베르트 공간이 어떻게 탄생했고 어떻게 작동하는지 이해하면, 현대 양자 컴퓨팅과 우주론이 왜 그런 방식으로 문제를 푸는지 알 수 있다.
핵심 요약
양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. 물리학자 존 폰 노이만은 1927년 논문에서 이러한 가능성들을 추적하는 추상적 공간을 힐베르트 공간으로 정의했고, 이는 1925~1926년 개발된 하이젠베르크의 행렬역학과 슈뢰딩거의 파동역학이 본질적으로 같은 이론임을 증명했다. 양자 상태는 힐베르트 공간 내 벡터(화살표)로 표현되며, 이 벡터는 특정 축과의 정렬 정도에 따라 관찰될 확률을 나타낸다. 전체 요약 10문장 읽기 → 023 00:11 ▲ 118 · 댓글 53 형식 검증으로 코드 최적화하는 AI 'Maxwell' 공개 doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. AI · 머신러닝 · Maxwell: A new kind of model that sits between code and hardware
Key Point 기존 AI는 코드 작성만 지원했지만, Maxwell은 형식 검증을 통해 프로그램 실행 중 동적으로 코드를 재작성·최적화하는 새로운 영역을 열었기 때문에, 소프트웨어 성능과 자원 효율성에 미칠 파급 효과가 크다.
핵심 요약
doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. Maxwell은 실행 중인 프로그램의 병목을 감지하고 알고리즘 전체를 재작성해 더 빠른 바이너리를 생성하며, 생성된 코드는 원본과 의미적으로 완전히 동등함을 형식 검증으로 증명한다. 기존 JIT 컴파일러나 최적화 도구와 달리 Maxwell은 실제 하드웨어와 데이터 흐름에 맞춰 함수와 알고리즘 수준의 전체 변환을 수행하고 조건에 따라 보호 조항을 둔다. 전체 요약 13문장 읽기 → 024 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 025 18:11 ▲ 106 · 댓글 34 인텔 8087의 부동소수점 덧셈·뺄셈 마이크로코드 분석 1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 하드웨어 · 시스템 · The Intel 8087 chip: floating-point addition and subtraction
Key Point 1980년대 칩 설계의 정수 가산기·비트 시프터 같은 전용 회로와 마이크로코드 최적화가 어떻게 부동소수점 연산 속도를 100배 향상시켰는지 보여주며, 현대 CPU의 부동소수점 처리 기초를 이해할 수 있다.
핵심 요약
1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 8087은 부동소수점 수를 '부호 × 유효숫자 × 2^지수' 형태로 표현하며, 덧셈과 뺄셈을 위해 먼저 두 수의 소수점을 정렬한 후 정수 연산을 수행하고 결과를 정규화해야 한다. 칩 내부에는 80비트 임시 실수 형식(15비트 지수, 64비트 유효숫자)을 저장하는 8개의 스택 레지스터와, 덧셈·뺄셈·곱셈·나눗셈에 사용되는 69비트 정수 가산기, 임의 비트 수로 빠르게 시프트 가능한 비트 시프터, 선행 영 비트 카운팅 회로 등이 있다. 전체 요약 12문장 읽기 → 026 09:11 ▲ 158 · 댓글 97 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. AI · 머신러닝 · Hybrid Reasoning Agents: LLM agents that think in latent space, act through text
Key Point 텍스트만으로 처리하던 LLM 에이전트의 비효율성을 내부 잠재 추론과 외부 텍스트 상호작용으로 분리해 대폭적인 속도와 비용 개선을 달성한 새로운 에이전트 아키텍처이다.
핵심 요약
기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. HybridAgents는 하나의 생성 과정 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하는 구조를 제시한다. HybridLink라는 경량 모듈이 텍스트와 잠재 모드 간 원활한 전환을 가능하게 하며, 지속적인 작업 메모리가 여러 턴에 걸쳐 손실 없는 하이브리드 문맥을 유지한다. 전체 요약 9문장 읽기 → 027 06:11 ▲ 110 · 댓글 148 수학 황금기냐 암흑기냐, LLM 통합 방식에 달렸다 LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. AI · 머신러닝 · Will it be a golden age or a dark age for mathematics (and science)?
Key Point LLM이 수학 연구에서 핵심 도구화하는 시점에 실제 인간 이해·학술 출판·능력 평가 기준을 어떻게 유지할 것인지를 다룬, 수학과 과학 생태계의 미래를 가르는 근본적 질문이다.
핵심 요약
LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. 인간이 이해하지 못하면 수학은 인간 문화의 일부가 될 수 없으므로, 사회는 수학자를 더 많이 필요로 한다. LLM은 기존 지식을 재결합하는 데는 뛰어나지만, 새로운 수학 언어를 창안하는 '수학화'(mathematization) 능력은 여전히 불명확하다. 전체 요약 10문장 읽기 → 028 18:11 ▲ 129 · 댓글 44 Lean, 검증된 증명 커널 네 개 추가 Lean v4.35.0부터 lake check 명령으로 개발 환경을 leanchecker(공식 커널)로 재검증할 수 있으며, 프로세스는 샌드박스에서 실행된다. AI · 머신러닝 · Lean now ships with verified kernels
Key Point Lean 증명 보조기의 핵심인 커널에 버그가 증명을 검증하지 못하는 치명적 문제를 여러 커널로 재검증해 해결하는 방식이 도입되었고, 특히 형식적으로 증명된 Lean 기반 커널의 등장으로 신뢰성이 크게 강화되는 시점이다.
핵심 요약
Lean v4.35.0부터 lake check 명령으로 개발 환경을 leanchecker(공식 커널)로 재검증할 수 있으며, 프로세스는 샌드박스에서 실행된다. nanoda, lean4lean, con-leche, con-ron 네 개의 추가 커널을 탑재했고, lake check --paranoid로 모든 커널로 증명을 재검증할 수 있다. con-leche는 Lean으로 작성되고 일관성이 증명된 첫 번째 커널이며, Claude(Fable과 Opus)가 구현하고 Joachim Breitner가 감독했다. 전체 요약 11문장 읽기 → 029 21:11 당일 +250 초등 교육 커리큘럼을 구조화한 오픈 데이터셋 공개 Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 오픈소스 · 도구 · withmarbleapp/os-taxonomy · JavaScript
Key Point 교육과정을 기계 판독 가능한 그래프 구조로 공개한 것은 EdTech 서비스, 학습 분석 도구, AI 튜터링 시스템 등을 만드는 개발자에게 기초 데이터로 쓸 수 있다는 점이 의미 있습니다.
핵심 요약
Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 1,590개의 '마이크로 토픽'(하나의 배울 수 있는 단위)으로 분해했으며, 각각 명확한 설명과 숙달 기준을 담았다. 3,221개의 선행 학습 의존도 간선으로 구성한 방향 무순환 그래프이며, 각 간선은 '강함/약함' 태그와 이유를 포함한다. 전체 요약 9문장 읽기 → 030 16:56 당일 +211 중국 초등학교 전과목 무료 학습 플랫폼 오픈소스 중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 오픈소스 · 도구 · wuwangzhang1216/ChinaTextbookStudyFree · Swift
Key Point 교육 자원 불균형 해소를 목표로 무료 학습 플랫폼을 완전 공개하는 사례로, 중국 교육 기술 생태와 게임화 학습 경험 설계를 한눈에 볼 수 있다.
핵심 요약
중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 수학(인교판), 국어(통편판), 영어(인교판 PEP), 과학(교과판) 44권 교재, 2,166개 단원, 6,545도 연습 문제를 수록했다. AI 생성 단원 소테스트, 지식 설명, 279편 원본 교과서 음성 낭독(TTS), 284편 레벨별 이야기 + 이해 문제를 제공한다. 전체 요약 10문장 읽기 → 031 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 032 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 033 18:11 ▲ 154 · 댓글 2 모바일·PC 통합 GUI 에이전트 학습 플랫폼 MAI-Gym 공개 강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. AI · 머신러닝 · MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
Key Point 모의 앱에서 학습한 모델이 실제 기기에 직접 전이되는 결과는 GUI 에이전트 실용화의 큰 진전을 의미하며, 공개 플랫폼과 데이터셋은 이 분야의 반복 가능한 연구를 크게 가속화할 것으로 보인다.
핵심 요약
강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. Hugging Face가 모바일·PC·웹 환경에서 GUI 에이전트 평가와 온라인 강화학습 훈련을 통합하는 오픈소스 플랫폼 MAI-Gym을 공개했다. 통합 롤아웃 파이프라인으로 평가와 훈련 시 일관된 에이전트 동작을 보장하며, 10개 기존 벤치마크를 지원하고 2만 개 병렬 환경 인스턴스로 확장 가능하다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 035 06:11 ▲ 199 · 댓글 157 인간이 쓴 글만 싣는다, AI 콘텐츠 전면 금지 선언 온라인 매거진 Current Affairs가 노조 협약의 일환으로 AI 생성 텍스트와 이미지를 완전히 금지하는 정책을 채택했다. AI · 머신러닝 · Why We're Banning AI
Key Point 미디어 산업이 AI로 저가 콘텐츠를 대량 생산하려 할 때, 인간 창작자만 고용하는 매체가 이를 거부하고 고수하려는 이유와 현실의 긴장을 다룬다.
핵심 요약
온라인 매거진 Current Affairs가 노조 협약의 일환으로 AI 생성 텍스트와 이미지를 완전히 금지하는 정책을 채택했다. 뉴스룸 전역에서 기자를 AI로 대체하는 추세를 직시하고 있으며, Business Insider의 CEO는 'AI에 올인한다'고 선언했고 Sports Illustrated는 허구 기자 이름으로 AI 기사를 게재했다가 적발됐다. 일부 언론사는 AI 기사 게재가 적발되어도 옹호했는데, 월스트리트저널이 게재한 헤지펀드 억만장자 Stan Druckenmiller의 op-ed가 AI 생성 글이었음이 밝혀졌지만 신문사는 이를 정당화했다. 전체 요약 13문장 읽기 → 036 03:12 ▲ 167 · 댓글 138 수학자들의 AI 시대 전환 돕는 시몬스 재단, 1500만 달러 투자 시몬스 재단, Anthropic, OpenAI가 협력하여 수학 분야의 AI 전환을 지원하기 위해 총 1500만 달러를 투자하기로 발표했다. AI · 머신러닝 · Simons Foundation launches $15M effort to help mathematicians navigate AI era
Key Point 수학 분야의 AI 활용이 가속화되는 시점에 주요 재단과 AI 기업들이 연구자 커뮤니티를 지원하는 대규모 투자를 시작했으며, 이는 향후 수학 연구의 방향과 AI 도구 도입 기준에 실질적 영향을 미칠 것이다.
핵심 요약
시몬스 재단, Anthropic, OpenAI가 협력하여 수학 분야의 AI 전환을 지원하기 위해 총 1500만 달러를 투자하기로 발표했다. 이 자금은 개방형 공모를 통해 워크숍과 이니셔티브를 지원하며, 연구자들이 AI 보조 결과를 평가하고 새로운 도구를 배우며 AI 사용 기준을 정립하도록 돕는다. Anthropic과 OpenAI는 수학 분야를 넘어 기초 과학까지 AI 도구와 컴퓨팅 자원을 제공한다. 전체 요약 7문장 읽기 → 037 03:12 ▲ 233 · 댓글 359 AI가 수백 년 묵힌 난제 풀자 수학자들이 눈물 흘리는 이유 OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. AI · 머신러닝 · I Know Why the Mathematicians Weep
Key Point 인공지능이 인간만의 영역으로 여겨졌던 고등 수학을 대량 해결하면서, 기술 진보가 단순히 효율성이 아니라 인간의 존재 이유와 커뮤니티의 의미까지 빼앗을 수 있다는 근본적 질문을 던진다.
핵심 요약
OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. Fields Medal 수상자인 Hugo Duminil-Copin은 "내 연구 분야를 멸망시켰다"고, Cornell의 Steven Strogatz는 "울었다"고 밝혔으며, 수학자들 사이에서 상실감과 방향감각 상실을 느끼고 있다. 저자는 이를 단순한 자존심 상처가 아니라, 2000년 동안 이어져 온 수학이라는 '대화'가 단절되는 데서 비롯한 것이라 분석한다. 전체 요약 10문장 읽기 → 038 00:11 ▲ 107 · 댓글 72 AI가 학문 공동체를 잠식하다 저자는 옥스포드 석사 과정 초반 동료들이 ChatGPT로 숙제를 대신하자 충격을 받고, 초반엔 AI를 거부했으나 시험 준비 마지막 1개월 반에 4개 과목을 혼자 학습하면서 ChatGPT의 개념 설명 기능이 정의를 실례로 이해하는 자신의 학습 방식에 큰 도움이 됐다고 밝혔다. AI · 머신러닝 · AI was great until it was not
Key Point PhD 과정 중인 물리학자가 1년 전 ChatGPT의 도움으로 석사를 마친 경험에서 현재 박사 과정의 급격한 변화까지, AI가 학문 공동체의 협력 문화를 어떻게 침식하는지 내부자 관점에서 보여주는 글이다.
핵심 요약
저자는 옥스포드 석사 과정 초반 동료들이 ChatGPT로 숙제를 대신하자 충격을 받고, 초반엔 AI를 거부했으나 시험 준비 마지막 1개월 반에 4개 과목을 혼자 학습하면서 ChatGPT의 개념 설명 기능이 정의를 실례로 이해하는 자신의 학습 방식에 큰 도움이 됐다고 밝혔다. 하버드 박사 1년차 때는 수학 노트북과 Mathematica 코딩을 직접 했고 Claude를 극소한 부분만 사용했으며, 저작물은 출판될 수 있었다. 하지만 2년차 진학 후 물리학과 환경이 급변했다: 사람들이 모니터에 ChatGPT를 켜두고, 메일의 노트는 AI 생성이거나 AI의 제안 기반이 되었으며, '브레인스토밍'은 이제 ChatGPT와의 대화를 의미했다. 전체 요약 8문장 읽기 → 039 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 040 15:11 ▲ 28 · 댓글 2 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. AI · 머신러닝 · Hybrid Reasoning Agents
Key Point LLM 에이전트의 추론 효율성과 투명성을 동시에 높이는 새로운 아키텍처로, 토큰 절감과 속도 개선이 이미 검증된 실질적인 개선 방안이다.
핵심 요약
현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. HybridAgent는 통합 생성 프로세스 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하며, 가벼운 HybridLink가 두 모드 간 seamless한 전환을 가능케 한다. 에이전트의 지속적 작업 메모리는 다중 턴에서 손실 없는 하이브리드 컨텍스트를 유지하고, 도구 통합 기능을 보존하면서도 잠재 사고(latent thoughts)를 직접 검사할 수 있도록 설계됐다. 전체 요약 6문장 읽기 → 041 15:11 ▲ 76 · 댓글 2 비평으로 실패를 바로잡는 학생 모델 훈련법 온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. AI · 머신러닝 · Recovering Reliable Supervision via Critique-Guided On-Policy Distillation
Key Point 학생 모델이 스스로 생성한 데이터로 훈련할 때 교사의 오류 인식 능력을 활용해 신뢰성 있는 감독 신호를 복구하는 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 모델 훈련 효율을 높인다.
핵심 요약
온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. 교사 모델이 학생의 오류를 인식하면서도 그 오류를 따라가는 문제가 발생하며, 이는 잘못된 답변으로 훈련하게 만든다. 이를 해결하기 위해 CriticOPD를 제안했는데, 교사가 오류가 있는 롤아웃을 비평하면 학생은 그 오류를 인식하고 해답을 다시 작성한다. 전체 요약 5문장 읽기 → 042 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 043 18:11 ▲ 96 · 댓글 2 장기 작업 자동화 AI, 밀도 높은 보상으로 학습 난제 해결 수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. AI · 머신러닝 · Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
Key Point 장기 자동화 작업의 학습 데이터 부족과 희소 보상 문제를 해결한 구체적인 방법론과 검증 가능한 데이터셋을 제시하여 오픈소스 장기 에이전트 개발의 실질적인 진전을 가능하게 한다.
핵심 요약
수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. 연구팀은 Tev-Gym이라는 첫 번째 장기 에이전트 학습 데이터셋을 제시했으며, 7개 도메인의 1,170개 검증된 과제 환경을 포함하고 검증 가능한 밀도 높은 진행 보상을 제공한다. 잠재 세계 우선 접근법으로 작동하여 먼저 완전하고 정확한 숨겨진 작업 명세를 구성하고, 각 단계마다 예상되는 상태를 지정한 뒤, 과제를 점진적으로 렌더링해 제어 가능한 복잡성과 자연스러운 진행 지표를 제공한다. 전체 요약 6문장 읽기 → 044 15:11 ▲ 71 · 댓글 1 PPO의 가치 함수 추적 개선, 수학 추론 성능 7~8점 향상 언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. AI · 머신러닝 · TPPO: Tracking-Value PPO For Language Model Reasoning
Key Point 강화학습 기반 언어 모델 추론에서 가치 함수의 정확성이 직접적으로 성능을 좌우하는데, 이 방법이 표준 PPO를 크게 능가하는 수학 추론 성능 향상을 보여준다.
핵심 요약
언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. 논문은 연속된 접두어(prefix) 값들 사이의 관계를 분석하고, 이들이 로그-오즈 공간(log-odds space)에서 덧셈 갱신으로 이루어진 베이지안 분해를 허용함을 보였다. 이 덧셈 구조를 이용해 추적-가치 PPO(TPPO)를 제안하는데, 위치별 스칼라 출력값들을 누적해 가치 로짓(value logits)을 형성하고 재구성된 값들을 통한 종료 결과 지도학습으로 학습된다. 전체 요약 6문장 읽기 → 045 12:11 ▲ 66 · 댓글 1 Sparse Attention의 성능 가속, 무손실 증명 기반 최적화 DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. AI · 머신러닝 · DoSA: Dots Sparse Attention
Key Point LLM의 주요 병목인 sparse attention 계산을 수학적 증명으로 가속하는 기법으로, 추론 속도 개선이 직접적으로 비용 절감으로 이어지는 프로덕션 환경에서 실질적 임팩트를 제공한다.
핵심 요약
DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. 핵심 아이디어는 Top-K 선택이 후보를 완전히 평가하지 않아도 승리 임계값에 대한 증명(certificate)으로 배제 가능하다는 점이다. 시드 세트가 임계값의 하한을 제공하고, 음수 가중치 헤드의 기여도를 수학적으로 상한으로 제한한다. 전체 요약 7문장 읽기 → 046 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 047 21:11 ▲ 101 · 댓글 18 증명을 넘어선 일러스트레이션, 수학의 새로운 길 수학자·미술가·교육자들이 파리 Henri Poincaré 연구소에서 모여 일러스트레이션이 어떻게 엄밀한 증명이 될 수 있는지 논의했다. AI · 머신러닝 · Illustration Beyond Proof
Key Point AI가 정리 생산의 희소성을 무너뜨리면서 수학의 진정한 가치가 '증명'에서 '이해'로 옮겨가는 전환점에서, 200년 역사를 거슬러 일러스트레이션의 엄밀성을 재정의하려는 시도이기 때문이다.
핵심 요약
수학자·미술가·교육자들이 파리 Henri Poincaré 연구소에서 모여 일러스트레이션이 어떻게 엄밀한 증명이 될 수 있는지 논의했다. AI 시대 정리(theorem) 생산이 성공의 유일한 척도가 되면서, 수학의 진정한 목표는 '이해'라는 근본적 문제가 드러났다. 19세기 Monge의 École Polytechnique에서는 '그리기는 알기(Drawing was knowing)'였으나, 20세기 증명 중심 전통으로 축소되었다. 전체 요약 11문장 읽기 → 048 18:11 ▲ 125 · 댓글 91 OpenAI의 '빠른 푸리에 변환'은 수학적 속임수일 뿐 OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. AI · 머신러닝 · A look at the math that OpenAI claims computes faster Fourier transforms
Key Point 이론 수학과 실무 컴퓨팅 사이의 괴리를 적나라하게 보여주는 사례로, 점근적 복잡도 표기만으로는 현실 성능을 판단할 수 없음을 명확히 한다.
핵심 요약
OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. 기존 FFT는 1965년 쿨리-튜키 알고리즘으로 n²에서 5n log n 연산으로 개선했으며, n=1,000일 때 20배, n=1,000,000일 때 10,000배 속도 향상을 제공한다. OpenAI 알고리즘의 상수는 n=10¹²일 때 약 10¹⁰⁰으로 추정되므로, 실제로 더 빠른 n값은 우주의 원자 개수(10⁸⁰)보다 크다. 전체 요약 8문장 읽기 → 049 15:11 ▲ 108 · 댓글 53 AI 모델이 암호화된 능력을 숨길 수 있다는 증명 능력 평가는 위험한 모델 동작을 배포 전에 발견하기 위한 것이지만, 숨겨진 능력을 끌어낼 수 있다는 가정에 의존한다. AI · 머신러닝 · AI Models Can Provably Hide Arbitrary Capabilities
Key Point 능력 평가는 위험한 AI 배포를 막기 위한 핵심 도구인데, 이 논문이 수학적으로 감시를 우회하는 기법을 보여주면서 AI 안전 검증 방식의 근본적 한계를 제기합니다.
핵심 요약
능력 평가는 위험한 모델 동작을 배포 전에 발견하기 위한 것이지만, 숨겨진 능력을 끌어낼 수 있다는 가정에 의존한다. 연구팀은 백도어 공격으로 암호화된 신경망을 모델 가중치에 삽입하고, 비밀 트리거를 받을 때만 복호화·실행하는 방식을 제시했다. 디지털 로커를 이용해 이 숨겨진 회로는 암호 이론적 가정 하에서 모델 가중치에 완전히 접근하더라도 추출·해석이 원칙적으로 어렵다. 전체 요약 7문장 읽기 → 050 09:11 ▲ 23 · 댓글 2 인간의 직관을 넘지 못하는 멀티모달 AI…'제6의 감각' 벤치마크 공개 인간은 장면에서 명시적으로 드러난 것 이상을 인지한다. 과거 원인과 미래 궤적, 차량이 좁은 공간에 들어갈 수 있는지 여부, 영상에서 권위 관계, 보이지 않는 규칙 같은 추상적 패턴까지 순식간에 파악한다. AI · 머신러닝 · Humanity's Sixth Sense: Benchmarking Intuitive Visual Reasoning in Multimodal Models
Key Point 최고 수준의 멀티모달 AI도 인간의 직관적 시각 이해에 40%P 이상 뒤처지는 이유를 파악할 수 있는 새 평가 틀이 제시되었습니다.
핵심 요약
인간은 장면에서 명시적으로 드러난 것 이상을 인지한다. 과거 원인과 미래 궤적, 차량이 좁은 공간에 들어갈 수 있는지 여부, 영상에서 권위 관계, 보이지 않는 규칙 같은 추상적 패턴까지 순식간에 파악한다. 이런 빠른 직관적 추론 능력은 일상 네비게이션과 사회 상호작용의 핵심이며, 인간 곁에 배치되는 멀티모달 LLM에 필수적이다. 기존 시각 벤치마크들은 학술 수학 영역의 전문가 수준 분석 또는 저수준 지각만 다루며, 인간이 일상적으로 수행하는 직관적 추론은 검증되지 않는 문제가 있다. 전체 요약 8문장 읽기 → 051 03:11 ▲ 11 · 댓글 2 LLM 추론 가속화 기법 PreSTO 제안 LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. AI · 머신러닝 · PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
Key Point Power sampling으로 LLM 추론 품질은 개선되지만 속도가 병목이었는데, PreSTO는 수학적 정확성을 유지하면서 1.7~2.3배 속도 향상을 실현해 실용적 배포의 장벽을 낮춘다.
핵심 요약
LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. PreSTO(Predictive SubTree Prefetching)는 미래의 샘플 생성 제안을 미리 배치 처리하되, MH 전이 커널은 변경하지 않으므로 수학적 정확성을 유지한다. 알고리즘은 accept/reject 결정을 트리 구조로 모델링하고, 각 모델 호출에서 한 번에 여러 제안을 생성한 뒤 실제 경로를 MH 규칙으로 추적한다. 전체 요약 7문장 읽기 → 052 03:11 ▲ 11 · 댓글 2 LLM 매개변수 수정 없이 지식 이전하는 'UTT' 방법 제안 지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. AI · 머신러닝 · Universal Textual Teaching for LLMs
Key Point API 기반 또는 재학습이 비싼 LLM에도 적용 가능한 매개변수 무수정 지식 이전 방법으로, 해석 가능하고 재사용 가능한 형태의 교육 자료를 자동 생성할 수 있다는 점이 기존 증류 기법의 한계를 극복한다.
핵심 요약
지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. 연구팀은 매개변수 업데이트 없이 지식을 전달하는 'Universal Textual Teaching(UTT)'을 제안했으며, 교사와 학생의 차이를 자연어로 해석 가능한 'Primer'라는 재사용 가능한 형태로 증류한다. UTT는 먼저 쌍을 이룬 평가를 통해 대표적인 차이 사례들을 식별하고, 이후 다중 역할 상호작용으로 반복 업데이트한다: 학생이 과제를 시도하고, Prompter가 평가 피드백을 교수 지시문으로 변환하며, 교사가 대상화된 시연을 제공하고, Synthesizer가 검증된 교훈을 통합한다. 전체 요약 6문장 읽기 → 053 18:12 ▲ 20 · 댓글 2 결과값만으로 프로세스 감시 모델 자동 생성 Process reward models(PRMs)는 LLM의 중요한 구성요소인데, 인간의 단계별 주석이 확장하기 어렵고 몬테카를로 추정은 계산 비용이 크면서 정확도도 낮은 문제가 있다. AI · 머신러닝 · Inducing Process Supervision from Outcome-Only Reinforcement Learning
Key Point 프로세스 감시 모델 학습의 최대 병목인 인간 주석을 없애고 결과값 라벨만으로 효과적인 단계별 검증 능력을 자동으로 유도할 수 있다는 것이 핵심이다.
핵심 요약
Process reward models(PRMs)는 LLM의 중요한 구성요소인데, 인간의 단계별 주석이 확장하기 어렵고 몬테카를로 추정은 계산 비용이 크면서 정확도도 낮은 문제가 있다. TIPS(Thinking-Induced Process Supervision)는 결과값(정답 여부)만으로 생성형 PRM을 학습하는 강화학습 프레임워크로, 모델이 추론 과정과 단계별 레이블, 최종 결과값을 함께 생성한다. 보상은 예측 결과가 정답과 일치하는지 여부에만 의존하며, 그룹 상대 이점을 통해 전체 응답을 최적화한다. 전체 요약 7문장 읽기 → 054 18:11 ▲ 101 · 댓글 102 OpenAI 수학 난제 해결 발표, 수학계 충격과 혼란 OpenAI가 10월 6일 100개 이상의 미해결 수학 난제를 풀었다고 발표하자 수학계 전역이 충격을 받았다. AI · 머신러닝 · 100+ reactions to 100+ solutions
Key Point OpenAI의 대규모 수학 난제 해결 발표가 수학 연구 생태계, 학위 과정, 커뮤니티 규범, 젊은 세대의 경력까지 근본적으로 재편할 수 있는 전환점이 되고 있기 때문입니다.
핵심 요약
OpenAI가 10월 6일 100개 이상의 미해결 수학 난제를 풀었다고 발표하자 수학계 전역이 충격을 받았다. 일부 수학자들은 결과가 거의 믿을 수 없을 정도로 놀랍다고 평가하며, Thompson의 그룹이 비단순성(non-amenability), Boone-Higman 추측 완전 해결, Borel 추측 4차원에서의 실패 등이 증명되었다고 확인했다. 하지만 이러한 논문들의 품질 문제가 심각하게 지적되었는데, 저자 이름을 밝히지 않고, 저널 투고 절차를 거치지 않으며, 100페이지 이상의 읽기 어려운 'slop' 수준의 글이 다수 포함되어 있다. 전체 요약 11문장 읽기 → 055 18:11 ▲ 114 · 댓글 22 수학 증명의 형식화, AI 자동화 시대 열리다 형식 증명은 수학의 기초와 논리 규칙 수준에서 철저히 검증한 증명으로, 컴퓨터로 자동 검사하는 것이 일반적이며 페르마 최종 정리·구 채움 문제 등이 형식화됐다. AI · 머신러닝 · What mathematicians should know about the Lean Theorem Prover: reliability & AI
Key Point AI가 수학 증명을 자동 형식화하기 시작하면서 신뢰성·일관성 검증의 새로운 시대가 열렸지만, 커널 버그와 AI 자체에 대한 신뢰 문제가 수학의 기초를 위협할 수 있다.
핵심 요약
형식 증명은 수학의 기초와 논리 규칙 수준에서 철저히 검증한 증명으로, 컴퓨터로 자동 검사하는 것이 일반적이며 페르마 최종 정리·구 채움 문제 등이 형식화됐다. 증명 보조기(proof assistant) 중 Lean이 수학자들에게 가장 인기 있으며, 2013년 Leo de Moura가 개발했고 마이크로소프트에서 오픈소스로 공개됐다. Lean의 표준 수학 라이브러리인 mathlib은 약 30만 개 정리, 10만 개 이상 정의, 250만 줄 코드로 700명 이상이 기여했다. 전체 요약 13문장 읽기 → 056 12:11 ▲ 113 · 댓글 56 AI로 400년 기록 검색해 잊힌 운석·멸종 코뿔소 재발견 소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. AI · 머신러닝 · Pointing AI at archives found a forgotten meteorite, lost rhinos, and more
Key Point 공개 기록 검색에서 AI 에이전트가 개인 연구자에게 어떤 스케일의 발견을 가능하게 하는지 보여주며, 구체적인 발견들과 검증 과정이 역사 연구의 미래를 시사한다.
핵심 요약
소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. 검색 파이프eline은 먼저 각 문단을 의미의 수학적 지문으로 변환한 후 'System One' 모델인 Jev로 초기 필터링하고, Claude Haiku로 정밀 검토한 후 Claude Code 에이전트가 원문 스캔으로 검증하는 3단계 구조다. 1812년 인도 판드하르푸르에서 떨어진 운석 기록을 자바신문 재게재판을 통해 발견했으며, 이는 마하라슈트라의 가장 오래된 운석 낙하 기록(기존 최고 기록보다 26년 앞)으로 6개 목록에는 수록되지 않았다. 전체 요약 12문장 읽기 → 057 09:11 ▲ 250 · 댓글 152 AI가 지식 공동체를 무너뜨린다 지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. AI · 머신러닝 · No Man Is an Island
Key Point AI가 지식 생산의 핵심인 공동체의 동기부여 체계를 해체할 때, 개인의 지적 활동이 어떻게 사라지는지 보여주는 구조적 분석이다.
핵심 요약
지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. 소프트웨어 엔지니어링의 담론이 악화되었다: Claude Code 출시 1년 만에 업계가 급변했고, 컴파일러·타입 시스템·로직 같은 고도의 논의가 '프롬프트' '에이전트 루프' 같은 얕은 주제로 축소되었다. 인간자본 형성이 붕괴되었다: 프롬프팅은 소프트웨어 엔지니어링보다 훨씬 얕은 기술이므로, 학습할 게 없고 엄격한 사고력을 연습할 필요가 없어졌다. 전체 요약 9문장 읽기 → 058 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 059 16:56 ▲ 129 · 댓글 2 토큰 단위 LLM 라우팅을 위한 고효율 서빙 시스템 LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. AI · 머신러닝 · TokenRouter: Efficient Serving System for Token-Level LLM Routing
Key Point 토큰 단위로 여러 모델을 동적으로 선택하는 고급 라우팅 기법을 실제로 빠르게 처리할 수 있는 시스템이 처음 등장했기 때문이다.
핵심 요약
LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. 최근 연구는 토큰 단위의 세밀한 라우팅이 효율성과 품질에서 큰 이득을 줄 수 있음을 보였지만, 기존 LLM 서빙 시스템은 단일 모델 가정 위에 설계되어 토큰 단위 라우팅에서 심각한 동기화 문제와 배치 지연을 겪는다. TokenRouter는 요청 중심 프로그래밍, 모델 중심 실행 원칙을 따르며, 개발자는 단일 요청 관점에서 라우팅 로직을 기술하고 런타임이 각 LLM마다 서브서버를 실행해 비동기로 요청을 분배한다. 전체 요약 6문장 읽기 → 060 18:11 ▲ 109 · 댓글 124 AI 시대 수학 박사과정, 지금 시작해도 괜찮을까 수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. AI · 머신러닝 · What should we tell our students?
Key Point LLM의 급속한 발전으로 수학 박사과정 진학을 망설이는 학생들이 직면한 불안감에 대해, 실제 문제와 과장된 주장을 구분하고 어떻게 대응해야 할지 안내하는 수학자의 구체적인 조언을 담고 있다.
핵심 요약
수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. 저자는 AI 기업들이 자사의 이익을 위해 LLM 능력을 과장하고 있다고 지적한다. 예를 들어 OpenAI는 Navier-Stokes 문제 해결에 약 1500만 달러를 투자했지만, 다른 밀레니엄 난제 해결 실패에 드는 비용을 공개하지 않는다. LLM은 현재 기존 문헌에 포함된 아이디어의 볼록껍질 내에서만 작동한다고 본다. Erdős의 단위거리 추측 반박은 기하학과 대수적 수론의 기존 아이디어를 결합한 것으로, Riemann 가설처럼 완전히 새로운 개념이 필요한 문제 해결은 불가능하다. 전체 요약 11문장 읽기 → 061 18:11 ▲ 114 · 댓글 161 OpenAI의 백년 난제 풀이, 수학자들이 분노한 이유 OpenAI가 분할 원리(Partition Principle)가 선택 공리를 함축하지 않는다는 수학적 난제를 풀었다고 발표했다. AI · 머신러닝 · OpenAI, the Partition Principle, and Mathematics
Key Point 학계의 품질 기준 없이 AI가 '성과'를 발표하는 방식이 어떻게 대중과 정책 입안자에게 왜곡된 인상을 주는지, 수학자가 직접 질타한 사례이다.
핵심 요약
OpenAI가 분할 원리(Partition Principle)가 선택 공리를 함축하지 않는다는 수학적 난제를 풀었다고 발표했다. 집합론 전문가인 저자는 OpenAI의 논문을 검토한 결과 문장 구조가 혼란스럽고 용어가 부정확하며 이해하기 어렵게 작성되었다고 지적했다. 논문은 미출판된 강의 노트를 참고 자료로 사용하고 있으며, 심지어 저자의 논문을 잘못된 목적으로 인용하는 등 학술 기준을 따르지 않고 있다. 전체 요약 8문장 읽기 → 062 00:11 ▲ 276 · 댓글 226 OpenAI, 수학 논문 3편 철회…부호 오류 발견 OpenAI가 수학 논문 저장소에서 3편의 논문을 철회했다. 오픈소스 · 도구 · OpenAI Withdraws 3 Math Papers
Key Point 수학 논문의 기초가 되는 핵심 증명에서 오류가 발견되면 수십 편의 후속 연구에 영향을 미치는데, OpenAI가 어떻게 이를 공개하고 복구했는지 보여주는 사례이다.
핵심 요약
OpenAI가 수학 논문 저장소에서 3편의 논문을 철회했다. 'Algebraicity of Weil classes on split abelian eightfolds' 논문에서 발견된 부호 오류가 안정화-추적 소거 논증과 다른 논문 2편이 의존하던 구성을 무효화했다. 철회된 3편은 'Algebraicity of Keil classes on split abelian eightfolds', 'Algebraicity of Kuga–Satake Correspondences for K3 Surfaces', 'The rational Hodge conjecture for products of K3 surfaces'이다. 전체 요약 9문장 읽기 → 063 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 064 18:30 ▲ 29 · 댓글 2 저정밀 강화학습의 수치 오차 해결, TRIAGE 방법 제안 NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. AI · 머신러닝 · TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning
Key Point 저정밀 연산으로 LLM 강화학습 속도를 크게 높일 수 있지만 수치 오차로 인한 불안정성이 문제인데, 이 논문이 그 원인을 정확히 분석하고 실질적인 해결책을 제시했기 때문에 LLM 최적화에 관심 있는 개발자와 연구자가 봐야 한다.
핵심 요약
NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. 연구팀은 불일치가 정책 기울기 방향과 상호작용하는 방식을 분석해, 크기만으로는 식별할 수 없는 국소 증폭 및 감소 영역을 구분했다. NVFP4 실행에서 초기 불균형으로 인해 음수 이점·음수 간극 업데이트가 우세하고, 이러한 토큰들이 불일치가 전역적으로 확산되기 전에 응답 세그먼트의 소수 부분에 집중된다는 패턴을 발견했다. 전체 요약 7문장 읽기 → 065 18:30 ▲ 37 · 댓글 1 LLM 추론 안정성 높이는 새 학습 기법 제안 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization
Key Point 토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다. 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다. 전체 요약 7문장 읽기 → 066 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 067 18:30 ▲ 145 · 댓글 29 증명 없이 정답만 던지던 수학 천재 'Cleo'의 정체 2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 기타 · Cleo (Mathematician)
Key Point Stack Exchange에서 최고의 수학 천재로 추앙받던 정체 불명의 계정이 실은 우즈베키스탄 소프트웨어 개발자의 창작 페르소나였다는 온라인 미스터리의 전말을 한 번에 파악할 수 있습니다.
핵심 요약
2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 첫 주목받은 것은 2013년 11월 Mathematica와 Maple도 풀지 못한 복잡한 적분을 4시간 반 만에 '황금비를 이용한 답'으로 제시했을 때였다. 수학 커뮤니티는 Cleo가 천재 수학자인지, 여러 사람의 집단 계정인지 논쟁했고, Terence Tao나 Maryam Mirzakhani 같은 유명 수학자가 아닐까 추측했다. 전체 요약 9문장 읽기 → 068 18:30 ▲ 146 · 댓글 66 조건은 위로, 반복은 아래로: 코드 최적화의 대수학적 기초 '조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 웹 · 프론트엔드 · Push ifs up and fors down: The idiom, its algebra, and its limits
Key Point 코드의 데이터 흐름과 제어 흐름을 재배열하는 원칙이 단순 휴리스틱을 넘어 범주 이론, 함수형 프로그래밍, 데이터베이스 최적화에 일관되게 적용되는 대수학적 법칙임을 보여주므로, 어디까지 안전하게 리팩토링할 수 있는지 정확히 판단할 근거를 제공한다.
핵심 요약
'조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 함수가 입력에 따라 분기한다면 그 분기를 호출자로 옮기는 식으로, Option 대신 Walrus 타입을 받아 선택 사항을 타입으로 표현한다. 반복 최적화는 개별 호출 대신 배치 함수를 제공해 핫 루프를 분기 없이 실행하고 벡터화의 후보가 되도록 한다. 전체 요약 10문장 읽기 → 069 18:30 ▲ 115 · 댓글 53 11개 정사각형 최적 배치 증명, AI 보조로 완성 Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. AI · 머신러닝 · AI-assisted proof of optimal packing for 11 squares
Key Point 최적화 문제의 엄밀한 증명에 AI 보조 도구와 형식 검증이 어떻게 결합되는지 보여주는 사례로, 수학적 추측을 기계 검증 가능한 형태로 변환하는 최신 방법론을 시연한다.
핵심 요약
Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. 7,920개 지역 Lean 모듈을 EvolvingPrograms 검증 시스템으로 검증했으며 모든 감사에서 오류가 0건이다. 최적 한 변의 길이는 T = (6u+4)/(1+2u-u²) 형태이며, u는 방정식 5u⁸-10u⁷-2u⁶+14u⁵+12u⁴-6u³+2u²+2u-1=0의 (9/25, 37/100) 범위 내 유일한 근이다. 전체 요약 8문장 읽기 → 070 18:30 ▲ 228 · 댓글 257 OpenAI 372개 수학 난제 증명 발표, 수학계 흔들다 OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. AI · 머신러닝 · The Mathocalypse
Key Point 인간이 평생 풀지 못한 수학 난제들이 AI에 의해 일괄 해결됨으로써 수학 연구의 근본적 변화가 시작되었고, 증명의 검증과 이해 과정에서 수학 커뮤니티가 직면한 새로운 도전을 보여준다.
핵심 요약
OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. UGC 증명은 Lean 증명서를 갖추고 있지만 아직 인간이 전체 내용을 이해한 사람이 없으며, 논문이 이해하기 어렵게 쓰여 있어 AI 도움 없이는 읽을 수 없다고 보고되었다. Dana Moshkovitz(Scott의 아내, 복잡도 이론자)는 평생 증명하려던 문제가 로봇에 의해 해결되었으나, UGC가 참임이 증명되었다는 점에서 위안을 얻고 있다. 전체 요약 11문장 읽기 → 071 18:30 ▲ 304 · 댓글 186 AI 수학 증명 검증의 함정, 자동형식화는 신뢰할 수 없다 AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. AI · 머신러닝 · Navier–Stokes Lost in Translation
Key Point AI가 수학 논문을 자동으로 검증하려는 시도가 이론적으로 불가능하다는 것을 보여주는 논문으로, OpenAI의 발표된 증명이 실제로는 원본과 다를 수 있음을 시사한다.
핵심 요약
AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. 그러나 이 논문은 형식 언어로 검증된 증명이 원래 자연언어 증명의 정확성을 보장하지 않음을 보인다. 문제는 자연언어 수학 텍스트의 모호성을 해결하려면 의미론적으로 충실한 번역이 필수인데, 이 모호성 해결 문제가 계산 복잡도 계층(Solvability Complexity Index)에서 무한 수준(SCI = ∞)에 위치한다는 것이다. 전체 요약 6문장 읽기 → 072 18:33 ▲ 10 · 댓글 1 쿼리마다 다른 에이전트 구조 자동 설계하는 SHIFT 발표 멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. AI · 머신러닝 · Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
Key Point 마이크로소프트·구글 같은 기업들도 멀티에이전트 워크플로우를 점점 더 활용하고 있는 가운데, 각 질문에 맞는 최적의 에이전트 구조를 비용 효율적으로 자동 설계하는 방법이 제시되었기 때문이다.
핵심 요약
멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. SHIFT는 로컬 LLM 아키텍트가 탐색으로부터 harness 구성 정책과, 실행 결과로부터 정확도 대비 실행 비용을 예측하는 가치함수를 학습한다. 각 쿼리마다 Monte Carlo tree search가 이 예측값들을 이용해 harness를 구성하므로, 실행 과정을 탐색 루프 밖으로 옮긴다. 전체 요약 7문장 읽기 → 073 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 074 18:33 ▲ 21 · 댓글 1 확산 언어모델의 토큰 단위 특성 정렬로 생성 품질 개선 확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. AI · 머신러닝 · Representation-Space MMD for Diffusion Language Models
Key Point 확산 기반 언어모델의 생성 품질을 토큰 단위로 정렬하는 효율적인 방법으로, 별도의 샘플링 완성이나 보조 모델 없이 대규모 모델의 추론 속도와 정확도를 동시에 개선할 수 있다는 점이 중요하다.
핵심 요약
확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. 개별 토큰 위치의 맥락 특성을 유지하여 한 번의 특성 추출으로 여러 관찰 샘플을 얻으므로 효율적이다. 이산 모델은 정책 기울기를, 연속 모델은 생성된 잠재변수에 대한 직접 미분을 통해 최적화한다. 전체 요약 6문장 읽기 → 075 18:33 ▲ 118 · 댓글 53 AI 급등이 뒤흔드는 에르되시 수학 커뮤니티 에르되시 문제 사이트(erdosproblems.com)는 AI가 1년 사이 수학의 어려운 문제들을 푸는 데 성공하면서 AI 역량 측정의 기준이 되어왔다. AI · 머신러닝 · Erdosproblems.com Succumbs to the AI Onslaught
Key Point AI로 수학 문제 해결이 급증하면서 한 커뮤니티 사이트가 정책을 전환했고, 설명과 협업의 가치를 두고 수학자들이 엇갈린 입장을 드러냈기 때문이다.
핵심 요약
에르되시 문제 사이트(erdosproblems.com)는 AI가 1년 사이 수학의 어려운 문제들을 푸는 데 성공하면서 AI 역량 측정의 기준이 되어왔다. AI 해결책이 늘어나면서 많은 문제의 답을 알게 됐지만, 동시에 수학자들이 에르되시 문제를 '쉽고 재미있는' 것으로 폄하하고, AI와의 경쟁을 포기하며, 설명 없는 AI 생성 해결책으로 인해 인간 수학자들이 낙담하는 부작용도 생겼다. 사이트 운영자는 'Erdős 커뮤니티 인간들(에르되시 스타일 수학에 관심 있는 사람들)의 번영'을 핵심 가치로 삼고 변화를 추진했다. 전체 요약 9문장 읽기 → 076 18:35 ▲ 122 · 댓글 86 AI 시대, 수학은 어떻게 발전할 것인가 수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. AI · 머신러닝 · The Future of Mathematics
Key Point AI가 수학 논문 수준의 결과를 생성하기 시작하면서 '수학이란 무엇인가'라는 근본적 질문이 제기되고 있으며, 수학의 본질은 문제 해결이 아니라 엄밀한 추론과 창의적 사고에 있다는 답변이 학문의 미래를 결정할 것이기 때문이다.
핵심 요약
수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. 그러나 수학의 본질은 엄밀한 추론과 의사소통의 문화이며, 이는 수천 년간 변함없이 유지돼 온 핵심이다. AI 시대에도 수학적 사고가 필요하다는 점은 변하지 않는다. 현재 기초 모델(foundation model)의 특징은 전체 수학 문헌을 학습했으며 피곤함이 없다는 것이다. AI의 해법들은 기존 기법을 조합해 푸는 문제들이 대부분이며, 근본적인 통찰력이나 새로운 아이디어를 요구하는 문제는 여전히 풀기 어렵다. 전체 요약 14문장 읽기 → 077 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 078 09:11 ▲ 11 · 댓글 2 SFT에서 토큰 가중치를 다시 설계하다: SCALE 방법론 감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. AI · 머신러닝 · Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
Key Point 기존 미세 조정 방식의 근본적인 한계를 분석하고 새로운 기준틀을 제시하는 방법론으로, 수학·코드 성능에서 기존 방식을 초과하면서 실제 모델 개선에 활용될 수 있는 기술입니다.
핵심 요약
감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. 기존 토큰 재가중치 방법들은 음이 아닌 계수를 할당해 지도 업데이트를 억제하거나 증폭할 수 있지만, 일단 학습된 해로운 특성을 역으로 돌릴 수 없다. 큰 학습 가중치는 최적화 궤적을 바꾸는 것이지 고정된 SFT 방향의 크기를 조정하는 것이 아니므로, 진정한 특성 추외삽은 이루어지지 않는다. 전체 요약 9문장 읽기 → 079 03:11 ▲ 63 · 댓글 3 여러 전문 모델의 내부 표현까지 활용하는 학생 모델 증류법 온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. AI · 머신러닝 · Latent-MOPD: Latent Multi-Teacher On-Policy Distillation
Key Point 여러 작은 전문 모델의 능력을 한 학생 모델에 집약할 때 숨겨진 상태라는 새로운 정보 채널을 활용하면 더 효과적인 학습이 가능하며, 이는 효율적인 언어 모델 설계에 새로운 방향을 제시한다.
핵심 요약
온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. Latent-MOPD는 표현 수준의 첫 다중 교사 증류법으로, 교사의 예측뿐 아니라 예측을 계산하는 데 사용된 숨겨진 상태도 함께 활용한다. 추가 교사 학습 없이 기존 전문 모델을 통합하며, 여러 교사로부터의 표현 감독을 조정하기 위해 후층 타겟을 선택하고, 숨겨진 너비 차이를 공유 투영으로 해소하고, 도메인별로 업데이트를 그룹화한다. 전체 요약 9문장 읽기 → 080 03:11 ▲ 21 · 댓글 2 비용 효율 중심 LLM 진화 알고리즘 FrugalEvo 공개 LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. AI · 머신러닝 · FrugalEvo: Towards Cost-Aware LLM-Guided Program Evolution
Key Point 동일한 성능을 기존 대비 10~90배 저렴한 비용으로 달성하는 혁신적 비용 최적화 기법으로, LLM 기반 자동 프로그래밍의 실용성을 크게 높인다.
핵심 요약
LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. FrugalEvo는 고성능·고비용 LLM이 해결 전략을 탐색하고, 저비용 LLM이 이를 구현·반복 개선하는 2단계 진화 프레임워크다. 프롬프트와 하니스의 접두사 공유를 극대화해 LLM 캐시 재사용율을 높이는 효율적 진화 과정을 설계했다. 전체 요약 7문장 읽기 → 081 00:11 ▲ 44 · 댓글 2 다중언어 수학 문제로 언어 간 능력 이전의 핵심 요인 파악 한 언어에서 습득한 모델의 능력이 다른 언어로 얼마나 이전되는지 이해하기 위해 '다중언어 GSM-Symbolic' 데이터셋을 개발했다. AI · 머신러닝 · Multilingual GSM-Symbolic: What determines capability transfer across languages?
Key Point 모델 개발자가 저자원 언어의 성능을 예측하고 개선하는 데 필요한 핵심 요소가 무엇인지 명확히 하므로, 모든 언어 조합을 평가해야 하는 부담을 줄일 수 있다.
핵심 요약
한 언어에서 습득한 모델의 능력이 다른 언어로 얼마나 이전되는지 이해하기 위해 '다중언어 GSM-Symbolic' 데이터셋을 개발했다. 15개 언어의 3만 개 문제-답안 쌍을 포함하며, 기호 템플릿을 사용해 과적합을 방지하고 단일 샘플에서 수백만 개 변형을 생성할 수 있다. 모델 크기(β=1.77), 언어 자원 수준(β=0.77), 추론 능력(β=0.67), 언어의 유형학적 거리(β=-0.25)가 주요 성능 결정 요인임을 정량화했다. 전체 요약 7문장 읽기 → 082 18:11 ▲ 52 · 댓글 2 마스크 기반 확산 모델의 학습 효율성을 높이는 Pivot-SD 마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. AI · 머신러닝 · Pivot-SD: Efficient Self-Distillation for Masked Diffusion Language Models
Key Point 마스크 기반 확산 모델의 학습 비효율을 지목하고, 고영향 결정점만 선별 학습하는 새로운 자기증류 방식이 소규모 데이터로도 기존 방법을 능가하는 결과를 보여준다.
핵심 요약
마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. 기존 dLM 학습 방식은 이러한 신호를 활용하지 않으며, 최종 텍스트나 전체 노이징 단계에 보상을 할당하는 방식으로 개별 핵심 토큰 결정을 선별하지 않는다. Pivot-SD는 오프라인 자기증류 프레임워크로서, 오직 응답 형성에 큰 영향을 미치는 핵심 결정점(pivot)만을 감독한다. 전체 요약 5문장 읽기 → 083 00:11 ▲ 107 · 댓글 19 독일 Aleph Alpha, 주권형 언어모델 Kolibri 공개 Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. AI · 머신러닝 · Kolibri Has Landed: A Sovereign Open-Weight Model
Key Point EU 규제에 맞춘 독일 기업의 오픈소스 모델이 소규모 활성 파라미터로 대형 모델을 능가하는 성능을 달성했으며, 투명한 공급망과 온프레미스 배포로 정부·산업 고객의 데이터 주권을 보장하는 새로운 접근 방식을 보여준다.
핵심 요약
Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. Kolibri는 정부·산업·항공우주 등 규제 대상 영역의 임무 수행을 위해 독일어, 추론, 수학, 에이전트 행동에 최적화되었으며, 개별 고객의 사용 사례에 맞춘 성능을 제공한다. 모델은 공급망 투명성, 독일 및 핀란드 인프라 기반 운영, 완전한 배포 자유도를 제공하여 주권성을 확보했으며, EU AI법과 GDPR 준수를 설계 초기부터 반영했다. 전체 요약 13문장 읽기 → 084 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 085 15:11 ▲ 16 · 댓글 2 수학 문제 풀이 AI, 근처 파라미터로 학습 더 정확해진다 수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. AI · 머신러닝 · Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
Key Point 기존 자기증류 방식의 고정된 감독 전략을 파라미터 근처 탐색으로 개선해 AIME 수학 올림피아드 벤치마크에서 2~3포인트 일관된 성능 향상을 달성했으므로, 수학 문제 풀이 AI의 정확도 향상이 어떻게 이루어지는지 실제로 확인할 수 있다.
핵심 요약
수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. 기존 OPSD는 매 상태마다 고정된 파라미터 설정 하나만 사용했으나, 근처의 파라미터 변동이 같은 기준 맥락에서 추가 감독을 제공한다. 지역 파라미터 섭동은 기준과 정렬된 상이한 정정(correction)을 드러내며, 다양한 전문가들이 기준 위치의 여러 지점에서 이를 제공한다. 전체 요약 9문장 읽기 → 086 03:11 ▲ 102 · 댓글 87 AI가 증명하는 정리, 수학의 미래를 두고 한숨 AI가 나비에-스토크스 추측을 증명하고 밀레니엄 문제를 해결하면서 수학 커뮤니티가 다섯 단계 상실감(거부·분노·타협·우울·수용)을 겪고 있다. AI · 머신러닝 · To grieve, or not to grieve?
Key Point AI가 수학의 어려운 정리들을 증명하면서 수학자들이 자신의 역할과 가치를 재정의하려 하는 와중에, 저자는 '이해'를 내세우는 것이 장기적 함정이 될 수 있으며 정리 증명 자체의 가치를 돌아봐야 한다고 주장한다.
핵심 요약
AI가 나비에-스토크스 추측을 증명하고 밀레니엄 문제를 해결하면서 수학 커뮤니티가 다섯 단계 상실감(거부·분노·타협·우울·수용)을 겪고 있다. 거부 단계: '인간 수학 협회'는 AI 사용을 금지하고 AI 없이 증명을 찾겠다고 선언하며, 필즈상 수상자 피터 숄체는 AI를 쓰지 않겠다고 공언했다. 분노 단계: 블라드 라직 등 여러 수학자가 온라인에서 AI 증명에 대한 분노를 표했다. 전체 요약 13문장 읽기 → 087 15:11 ▲ 56 · 댓글 2 다중 보상 RL에서 희소 신호까지 균등하게 학습시키는 방법 다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. AI · 머신러닝 · Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
Key Point 다중 보상 학습에서 일부 목표만 우선 학습되는 문제를 밀도 기반의 수학적 분석으로 해결하고, 훈련 효율을 크게 개선한 방법론이다.
핵심 요약
다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. 연구팀은 '장점 에너지(advantage energy)'—배치 내 보상의 제곱된 장점의 합—를 분석하여, 이 에너지가 '활동 밀도'(보상이 0이 아닌 상대적 장점을 제공하는 롤아웃 그룹의 비율)에 비례함을 증명했다. 이는 배치 단위의 신호 불균형을 드러내고, 보상 기여도 보정의 근거를 제공한다. 전체 요약 7문장 읽기 → 088 15:11 ▲ 112 · 댓글 26 Claude Opus로 도도새 미발견 기록 발굴한 역사학자 Claude Opus 5.5 같은 최신 AI 모델은 대규모 역사 자료를 의미론적 검색으로 분석해 새로운 사료를 찾을 수 있다. AI · 머신러닝 · Using Opus 5.5 to discover a new eyewitness record of the dodo
Key Point 최신 AI 모델이 기존 전문가의 영역에서 새로운 발견을 할 수 있다는 것은 학문 생태계의 지각변동을 의미하며, 검증 능력 없는 아마추어의 진출이 늘면서 전문가 부족 현상이 곧 닥칠 것으로 전망된다.
핵심 요약
Claude Opus 5.5 같은 최신 AI 모델은 대규모 역사 자료를 의미론적 검색으로 분석해 새로운 사료를 찾을 수 있다. 저자는 네덜란드 동인도회사 아카이브를 검색해 1615년 도도새 사냥 기록을 발견했는데, 이전에 간과된 새로운 사료로 보인다. 같은 검색에서 1638년 적색 레일(멸종된 모리셔스 새)에 관한 참고문헌도 발견했는데, 1890년 프랑스 학자의 오역 때문에 지금까지 주목받지 못했다. 전체 요약 12문장 읽기 → 089 12:11 ▲ 79 · 댓글 2 토큰 독립성 문제 해결한 계층형 연속 확산 언어모델 이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. AI · 머신러닝 · Hierarchical Continuous Diffusion Language Models
Key Point 병렬 디코딩에서 토큰 간 의존성을 보존하면서도 전역 제약을 만족시키는 방식으로 확산 언어모델의 핵심 구조적 문제를 해결했기에, 생성 모델의 근본적인 설계 변화로 관심을 끈다.
핵심 요약
이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. 연속 확산 언어모델은 공유 연속 상태를 노이징하여 이를 피하지만, 노이저가 그 상태만 보므로 최종 디코딩까지 유효한 토큰 구성과의 연결고리가 없다. HC-DLM(Hierarchical Continuous Diffusion Language Models)은 이산 토큰 생성과 연속 잠재 궤적을 단일의 원칙적인 노이징 제거 과정으로 결합하며, 훈련 목적은 토큰 우도에 대한 변분 경계에서 유도된다. 전체 요약 6문장 읽기 → 090 06:11 ▲ 156 · 댓글 176 Git 3.0의 SHA-256 전환, 생태계 대혼란만 남길 것 Git 3.0은 기본 해시 알고리즘을 SHA-1에서 SHA-256으로 변경할 예정이며, 이는 전 산업에 막대한 비용과 혼란을 초래할 것이라고 GitButler 공동창립자 Scott Chacon이 주장한다. 인프라 · 데브옵스 · Git 3.0's upcoming SHA-256 default will be a costly mistake
Key Point 전 산업의 개발자와 기업이 준비하지 못한 Git 3.0의 SHA-256 기본값 전환이 실제로는 불필요한 문제를 만들 수 있으며, 생태계 단편화와 도구 호환성 문제를 야기할 것이기 때문이다.
핵심 요약
Git 3.0은 기본 해시 알고리즘을 SHA-1에서 SHA-256으로 변경할 예정이며, 이는 전 산업에 막대한 비용과 혼란을 초래할 것이라고 GitButler 공동창립자 Scott Chacon이 주장한다. SHA-1은 수학적으로 '준-깨졌다'고 여겨지지만, 실제로는 충돌이 발생하지 않았으며 200년 동안 우발적 충돌은 사실상 불가능하다. SHA-1 충돌 공격은 이론적으로는 가능하지만, 실제 공격자들은 GPU 집약적인 해시 충돌 생성보다 소셜 엔지니어링으로 유지보수자 접근권을 얻거나 npm 패키지를 장악하는 방식을 훨씬 선호한다. 전체 요약 12문장 읽기 → 091 00:11 ▲ 108 · 댓글 154 AI 수학 논문 공개, 인간의 이해를 먼저 확보하라 수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. AI · 머신러닝 · Responsible Release of AI-Generated Mathematics
Key Point AI가 인간이 검증하지 못한 수학 증명을 공개하는 관행이 학문 규범과 평등성을 위협하므로, 수학계의 새로운 기준을 수립해야 한다는 근본적 문제를 다룬다.
핵심 요약
수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. 수학 분야의 전통적 규범은 논문 저자가 내용을 이해하고 정확성을 검증하며 책임을 지는 것인데, AI 생성 결과는 이를 위반할 수 있다. 600개 이상의 피드백을 바탕으로 책임감 있는 AI 수학 결과 공개를 위한 권고안을 수립했다. 전체 요약 9문장 읽기 → 092 21:11 ▲ 41 · 댓글 2 언어 모델 내부 표현으로 새로운 수학 관계식 발견 언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. AI · 머신러닝 · LANTERN: Illuminating Hidden Mathematical Knowledge in Language Models
Key Point 언어 모델의 숨겨진 수학적 이해를 활용해 자동으로 새로운 과학적 발견을 찾아내는 실제 사례이며, AI가 단순 문제 해결을 넘어 연구 방향 설정까지 돕는 가능성을 제시한다.
핵심 요약
언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. 정수수열 백과사전(OEIS)의 1만 개 자주 참조되는 수열에서 5천만 개 수열 쌍을 순위 매기고 기존 교차 참조가 없는 검증된 관계 62개를 발견했다. 13개 관계를 내용 검증을 통해 선별했으며, 이 중 9개가 유의미하고, 4개는 OEIS나 기존 문헌에 없는 완전히 새로운 발견이다. 전체 요약 5문장 읽기 → 093 06:11 ▲ 11 · 댓글 2 긴 영상 분석 AI의 기억력 문제를 푸는 'VideoLoop' 멀티모달 AI 에이전트가 긴 영상을 이해하려면 여러 추론 단계에서 증거를 반복 수집해야 하는데, 기존 방식은 '의미적 스래싱' 현상을 겪는다. AI · 머신러닝 · VideoLoop: Looped Working Memory Against Semantic Thrashing in Long-Form Video Agents
Key Point 긴 영상을 분석하는 AI 에이전트가 정보를 제대로 기억하지 못하는 근본적 문제와 그 해결책을 제시하는 논문으로, 실제 벤치마크에서 10%대의 정확도 차이를 만든다.
핵심 요약
멀티모달 AI 에이전트가 긴 영상을 이해하려면 여러 추론 단계에서 증거를 반복 수집해야 하는데, 기존 방식은 '의미적 스래싱' 현상을 겪는다. '의미적 스래싱'은 작업 메모리가 계속 늘어나면서 핵심 증거에 대한 주의가 흐릿해지고 이미 찾은 정보에 접근할 수 없는 문제다. 연구팀은 추가 전용 메모리가 새로운 대상 증거는 통합할 수 있지만, 누적된 잡음을 제거하거나 컨텍스트 증가를 막으려면 메모리를 재작성하는 기능이 필수임을 수학적으로 보였다. 전체 요약 7문장 읽기 → 094 06:11 ▲ 109 · 댓글 22 종이접기로 배우는 기하학 플라톤이 발견한 5가지 정다면체(플라톤 입체)는 모든 면이 같은 정다각형이며 모든 꼭짓점이 동일하게 보이는 가장 규칙적인 다면체다. 웹 · 프론트엔드 · Mathematical Origami
Key Point 수학 개념을 종이접기로 체험하고 배우는 대화형 교육 플랫폼으로, 기하학의 핵심 개념인 정다면체와 입체 구조를 손으로 직접 만들며 이해할 수 있다.
핵심 요약
플라톤이 발견한 5가지 정다면체(플라톤 입체)는 모든 면이 같은 정다각형이며 모든 꼭짓점이 동일하게 보이는 가장 규칙적인 다면체다. 정다면체는 정사면체, 정육면체, 정팔면체, 정십이면체, 정이십면체를 포함하며, 플라톤은 이들이 흙, 물, 공기, 불, 우주라는 고대 원소에 대응된다고 믿었다. 아르키메데스 입체는 플라톤 입체처럼 정다각형으로 이루어지고 모든 꼭짓점이 같지만, 여러 종류의 다른 정다각형 면으로 구성되어 있다. 전체 요약 8문장 읽기 → 095 18:11 ▲ 33 · 댓글 2 LLM 학습 과정의 버려진 데이터를 재활용하는 기법 제안 대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. AI · 머신러닝 · ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
Key Point LLM 학습의 데이터 재활용 효율을 높이는 방법론으로, 기존에 버려지던 학습 경험에서 추가 성능을 뽑아낼 수 있다는 점이 실무적 가치가 크다.
핵심 요약
대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. 과거 경험은 현재 정책과 호환되면서도 더 이상 안정적으로 표현되지 않는 행동들을 보존할 수 있지만, 실수와 포기된 시도들도 함께 담고 있다. ROSS는 전체 과거 궤적을 맥락으로 유지하면서 모델이 선택적으로 생성한 부분만 손실을 적용하는 방식으로, 더 정밀한 감독 신호를 제공한다. 전체 요약 6문장 읽기 → 096 15:11 ▲ 28 · 댓글 1 LLM 학습의 불안정성을 해결한 EasyPPO 알고리즘 PPO의 학습된 비평가(Critic)는 기댓값 추정과 정책 기울기 분산 감소에 효과적이지만, LLM 강화학습에서 불안정성의 주요 원인으로 작용한다. AI · 머신러닝 · EasyPPO: Stabilizing the Critic Is Key
Key Point LLM 정책 최적화에서 학습 불안정성을 체계적으로 진단하고 해결하는 방법이 실무적으로 의미가 있기 때문입니다.
핵심 요약
PPO의 학습된 비평가(Critic)는 기댓값 추정과 정책 기울기 분산 감소에 효과적이지만, LLM 강화학습에서 불안정성의 주요 원인으로 작용한다. 논문은 두 가지 비평가 실패 모드를 지적한다: 첫째, 잘린 롤아웃(Truncated Rollout)을 액터와 비평가 모두에서 필터링하면 정책이 완료된 롤아웃에만 조건화되어 완료율이 떨어져도 보상은 증가할 수 있다. 둘째, 이질적 반환 노이즈가 특정 프롬프트의 손실을 지배한다. EasyPPO는 세 가지 개선책을 제시한다: 액터만 롤아웃을 필터링하되 비평가는 완료·미완료 모두를 학습하고, 각 프롬프트의 비평가 손실을 반환값의 표준편차 역수로 가중치 부여하며, 비평가 미니배치를 적당히 줄여 이상치의 영향을 제한한다. 전체 요약 4문장 읽기 → 097 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 098 12:11 ▲ 43 · 댓글 1 수학 추론 모델, 동료 모델과 궤적 교환으로 성능 향상 RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. AI · 머신러닝 · Learning Beyond What You Sample: Off-Policy-Aware Cross-Model Trajectory Exchange for RLVR
Key Point 이질적 모델들 사이의 상호 보완성을 활용해 동일 예산으로 수학 추론 성능을 크게 향상시키는 새로운 강화학습 방식을 제시하고 있으며, 실제 벤치마크에서 GRPO 대비 일관된 성능 개선을 입증했다.
핵심 요약
RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. 연구진은 서로 다른 모델들이 상호 보완적인 문제들에서 성공하는 패턴을 발견했으며, 이를 통해 강한 교사 모델 없이도 상호 학습이 가능함을 확인했다. 이를 바탕으로 GRAFT(Gated Replacement of Answer-Failed groups with peer Trajectories)를 제안했으며, 이는 모두 실패한 그룹을 정보량 많은 동료 그룹으로 교체하는 오프정책 인식 프레임워크다. 전체 요약 6문장 읽기 → 099 12:11 ▲ 30 · 댓글 1 추론 단계 다양성이 RL 학습을 앞당긴다 검증된 풀이가 모두 같은 가치는 아니라는 점에서 출발하여, 감독 학습(SFT) 데이터에서 추론 경로의 다양성이 중요함을 발견했다. AI · 머신러닝 · Selecting Diverse SFT Traces Improves Post-RL Generalization
Key Point RL 기반 추론 모델 개발에서 어떤 학습 데이터를 쓸지가 최종 성능을 크게 좌우하는데, 경로 다양성이라는 단순하지만 효과적인 선별 기준이 기존 방식을 일관되게 이기고 있습니다.
핵심 요약
검증된 풀이가 모두 같은 가치는 아니라는 점에서 출발하여, 감독 학습(SFT) 데이터에서 추론 경로의 다양성이 중요함을 발견했다. 추론 경로 다양성(route diversity)은 풀이 과정의 단계 수열이 얼마나 다양한지를 측정하는 지표로, 경량의 규칙 기반 지문(fingerprint)을 통해 선별할 수 있다. 같은 예산과 훈련 설정에서 유사한 경로보다 다양한 경로를 선택했을 때, SFT 이후 강화학습(RL)의 문제 해결률이 퍼즐과 수학 문제에서 모두 향상되었다. 전체 요약 6문장 읽기 → 100 09:11 ▲ 108 · 댓글 62 Claude Opus 5.5의 성능 변화를 추적하는 벤치마크 공개 Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. AI · 머신러닝 · Livenerf: Has Opus 5.5 been nerfed yet?
Key Point Claude 모델의 출시 후 성능 저하 의혹이 반복적으로 제기되는 상황에서, 데이터 기반 검증 도구가 공개돼 사용자와 개발자가 실제 변화를 직접 확인할 수 있게 되었다.
핵심 요약
Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. GPQA Diamond, MMLU-Pro, 대회 수학 문제 2,336개를 선별해 때때로 정답률이 50~70% 범위에 떨어지는 78개 문항을 최종 패널로 구성했다. 매일 90개 샘플을 실행하되, 처음 10일간을 기준선으로 설정하고 이후 두 개 10일 구간에서 통계적으로 유의미한 변화를 감지한다. 전체 요약 11문장 읽기 →