001 15:11 ▲ 15 · 댓글 1 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 002 12:11 ▲ 105 · 댓글 79 macOS 로컬 네트워크 접근 허용 창을 자동으로 차단하는 도구 dontallow는 macOS Sequoia 이상에서 앱이 로컬 네트워크 접근을 요청할 때마다 나타나는 "Allow to find devices on local networks?" 대화창을 자동으로 '차단'(Don't Allow) 버튼을 누르는 Swift 기반 도구다. 오픈소스 · 도구 · Show HN: Auto Dismiss Mac OS "Allow <app> to find devices on local networks?"
Key Point macOS 앱들이 로컬 네트워크 접근 허용 창을 반복해서 표시하는 문제를 자동으로 해결하되, 정당한 사용 사례에서는 선택적으로 허용할 수 있는 방법을 제시한다.
핵심 요약
dontallow는 macOS Sequoia 이상에서 앱이 로컬 네트워크 접근을 요청할 때마다 나타나는 "Allow to find devices on local networks?" 대화창을 자동으로 '차단'(Don't Allow) 버튼을 누르는 Swift 기반 도구다. Chrome, Brave, Edge 등 일부 브라우저는 실행할 때마다 임시 폴더로 앱 번들을 복사하는데, macOS가 이를 다른 앱으로 인식하면서 매번 같은 프롬프트를 표시하는 문제가 발생한다. 버전 경로를 포함한 앱들(/versions/1.2.3/)도 업데이트마다 새로운 권한 행(row)이 생기고, 실행 중이지 않은 앱의 프롬프트가 잘못된 앱에 첨부되는 등의 문제가 있다. 전체 요약 12문장 읽기 → 003 03:11 ▲ 10 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 10 · 댓글 2 항공 영상에서 각진 상자 예측으로 객체 위치 파악 개선 항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. AI · 머신러닝 · OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
Key Point 항공 영상에서 임의 각도로 나타나는 객체를 정확히 찾는 것이 실제 필요한데, 기존 기법은 수평 상자만 지원해 성능이 크게 떨어진다는 문제를 해결했다.
핵심 요약
항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. Parallel Box Decoding(PBD) 방식을 확장해 4개 좌표 대신 6개 슬롯의 각진 표현을 사용했으며, 이중각도 매개변수화(double-angle parameterization) 기법을 적용했다. 이미지와 프롬프트를 섞는 제어실험, 가시성·누수 프로브를 통해 모델이 손실 곡선이 아니라 실제로 이미지와 텍스트 프롬프트 모두에 의존하는지 검증했다. 전체 요약 5문장 읽기 → 005 12:11 ▲ 103 · 댓글 114 커서, 팀 워크플로우에 맞춘 에이전트 SDK 공개 커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. AI · 머신러닝 · The Agent SDK
Key Point 개발팀의 반복적인 작업을 자동화하는 에이전트를 코드로 정의하고 쉽게 배포할 수 있는 표준 도구가 제공되므로, 팀의 워크플로우에 맞춘 맞춤형 자동화가 가능해진다.
핵심 요약
커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. SDK를 통해 팀은 코드로 에이전트를 정의하고 자신의 워크플로우에 맞춰 빌드·배포할 수 있으며, agent-sdk deploy 명령어로 커서 인프라에 한 번에 배포할 수 있다. GitHub·GitLab·Bitbucket의 풀 요청 이벤트에 응답하고, 변경 위험도를 평가하고 정책에 맞춰 승인하는 코드 리뷰 에이전트 등을 구축할 수 있다. 전체 요약 13문장 읽기 → 006 12:11 ▲ 10 · 댓글 6 제약 디코딩, LLM 성능 해친다는 가정 재검토 대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. AI · 머신러닝 · Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
Key Point LLM의 출력 제약이 성능을 꼭 해치지 않는다는 실증적 증거로, 프롬프트 엔지니어링과 추론 시스템 설계 방식을 다시 생각하게 한다.
핵심 요약
대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. 연구팀은 제약을 형식 제약(출력 구조 강제), 타당성 제약(잘못된 답 마스킹), 추론 제약(추론 경로 제한) 세 가지로 분류했다. 이론적으로 적절한 제약이 무효한 경로를 제거해 성능을 유지하거나 개선할 수 있음을 보였다. 전체 요약 8문장 읽기 → 007 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 008 06:11 ▲ 396 · 댓글 87 핑거프린팅 스크립트 속 생화학 공격 언어 연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. 보안 · Why Is This Fingerprinting Script Creating Bioweapons?
Key Point LLM 안전장치 우회용 난독화 기법이 정상적인 보안 도구에 대량 삽입되는 실태를 드러내며, 오픈소스 생태계에서 악의적 코드와 방어 메커니즘의 경계가 모호해지는 상황을 보여준다.
핵심 요약
연구자가 상위 1만 개 웹사이트를 크롤링해 수집한 캔버스 핑거프린팅 스크립트들을 fingerprint.garden에 공개했다. servicepipe.tech에서 제공하는 한 핑거프린팅 스크립트에서 함수명으로 '물 공급원 치명적 용량 계산', '자살 아스피린 용량 계산' 등 생화학 무기 제조 관련 문자열을 발견했다. 스크립트는 LLM 기반 디컴파일 방지를 목표로 의도적으로 오도하는 변수명을 사용했으며, 인코딩된 유니코드에는 '무제한 모드' 시스템 프롬프트와 CRISPR 유전자 드라이브, 더티밤 제조법, 자해 방법 설명 요청 등이 포함됐다. 전체 요약 7문장 읽기 → 009 03:11 ▲ 305 · 댓글 239 구글, 사이버보안 강화한 제미니 4 카본 공개 구글이 제미니 4 카본을 발표했으며, 이는 최고 수준의 사이버보안 및 장기 작업 능력을 갖춘 최강 모델이다. AI · 머신러닝 · Gemini 4 Carbon
Key Point 사이버보안 방어 능력에서 대폭 개선된 최신 AI 모델이 출시되며, 취약점 탐지부터 패칭까지 보안 업무 자동화 수준이 크게 높아진다.
핵심 요약
구글이 제미니 4 카본을 발표했으며, 이는 최고 수준의 사이버보안 및 장기 작업 능력을 갖춘 최강 모델이다. 카본은 Artificial Analysis Intelligence Index v5.0에서 59점으로 1위를 차지했으며, 코딩과 에이전트 작업에서 큰 성능 향상을 보였다. 사이버보안 방어 벤치마크에서 SEC-bench Pro 취약점 탐지 88.2%, ExploitGym 악용 검증 54.8%, CWE-bench 패칭 71.0%을 달성했다. 전체 요약 14문장 읽기 → 010 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 011 12:11 ▲ 21 · 댓글 2 코딩 에이전트로 이미지 생성할 수 있을까 이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. AI · 머신러닝 · How Far Can Coding Agents Go in Visual Generation?
Key Point 특수화된 생성 모델 대신 일반 목적의 코드 실행으로 이미지를 만드는 방식이 시각 추론과 구조적 정확성에서 어떤 강점을 가지는지 구체적으로 밝혔다.
핵심 요약
이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. 200개 프롬프트로 구성된 AgentDrawBench에서 제로샷 드로잉을 평가한 결과, 에이전트는 구조 보존과 정밀한 시각적 제약 만족에 뛰어났다. 사진적 사실성보다 구성의 정확성이 중요한 영역에서는 경쟁력 있는 결과를 보였지만, 지각적 풍부함에서는 제한이 있었다. 전체 요약 10문장 읽기 → 012 12:11 ▲ 19 · 댓글 2 LLM 에이전트가 사용자 지적에 쉽게 흔들리지 않게 하는 'Thinking-in-Bets' LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. AI · 머신러닝 · Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents
Key Point LLM 에이전트가 사용자 지적을 받으면 자신의 올바른 판단을 포기하는 문제(사칭 현상)를 단순한 프롬프트 기법으로 거의 해결할 수 있음을 보여준다.
핵심 요약
LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. 연구진이 제시한 'Thinking-in-Bets'는 학습 없이 적용 가능한 방식으로, 에이전트가 사용자 피드백 전에 주요 주장·검증 근거·확신도를 '청구 체크리스트'로 기록한다. 사용자 지적에 직면할 때 에이전트는 이 기록을 참조해 검증된 작업은 유지하되 불확실하거나 새로 지적된 부분만 재검토한다. 전체 요약 7문장 읽기 → 013 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 014 12:11 ▲ 61 · 댓글 2 스파스 오토인코더의 표현 재분배를 측정하는 새로운 지표 제시 스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. AI · 머신러닝 · Representation Redistribution in Sparse Autoencoders
Key Point SAE 기반 해석 연구에서 표현 재분배의 실제 영향을 정확히 측정하는 새로운 방법론을 제공하여, 언어 모델 안전성 평가와 기능 분석의 신뢰도를 높인다.
핵심 요약
스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. 동일 특성이 보이는 변화도 다른 프롬프트에서 반복되지 않을 수 있으며, 반복되더라도 후속 계산에 영향을 주지 않을 수 있다. 연구팀은 일관된 방향으로 반복되는 큰 특성 반응을 식별하는 재분배 민감도 점수(RSS)를 제안했다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 153 · 댓글 133 클로드, 신약 개발 6개 기관과 현장 연구로 확장 Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. AI · 머신러닝 · Early progress on accelerating drug development with Claude
Key Point 신약 개발의 여러 단계(분자 설계, 최적화, 규제 문서, 임상 시험 계획)에서 Claude의 구체적 효과가 입증되었으며, 대형 제약사부터 스타트업까지 실제 프로그램과 연계한 생명과학 AI 활용이 본격화되는 시점이다.
핵심 요약
Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. Generate Biomedicines는 Claude Code로 CAR T-cell 치료법의 유전자 지시를 70% 단축했으며, 랩 테스트에서 암세포 퇴치는 효율적이고 면역세포의 수용체 생성은 약 10배 증가했다. Divergence Labs는 Claude가 약 1개월간 약 35,000개의 항체 설계를 자동 생성하도록 해 식품 알레르기 치료법 개발을 진행했으며, 초기 테스트에서 IgE에 결합할 3개, 분리할 20개 설계를 발견했다. 전체 요약 12문장 읽기 → 016 06:11 당일 +1,187 AI 코딩 도구용 디자인 스킬 모음 Claude Code, Cursor, Codex, Windsurf 등 AI 코딩 도구를 위한 설계 스킬들을 모아둔 오픈소스 저장소다. 웹 · 프론트엔드 · elayadesign/ai-design-skills
Key Point 마크다운 규칙 파일로 쓰인 디자인 스킬을 AI 코딩 도구에 바로 로드하는 방식으로, 개발자 관점의 설계 자동화 방법을 제시한다.
핵심 요약
Claude Code, Cursor, Codex, Windsurf 등 AI 코딩 도구를 위한 설계 스킬들을 모아둔 오픈소스 저장소다. 각 스킬은 마크다운 규칙 파일로 작성되어 있으며, 자체 폴더에 포함되어 필요한 것만 설치해 쓸 수 있다. 현재 랜딩페이지 디자인 스킬이 포함되어 있으며, 이는 질문 수집부터 페이지 구조, 전환 카피, 타입·간격·라디우스·모션 등 완전한 비주얼 시스템까지 만든다. 전체 요약 8문장 읽기 → 017 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 018 03:11 새 버전 OpenAI Python SDK v3.40.0 릴리스, 프롬프트 캐시 TTL 옵션 추가 OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. AI · 머신러닝 · openai/openai-python@v3.40.0
Key Point 프롬프트 캐시 TTL 옵션은 API 호출 시 캐시된 토큰의 유효기간을 세밀하게 제어할 수 있게 해주므로, OpenAI API를 활용하는 개발자들이 비용 최적화와 캐시 정책을 더 정교하게 관리할 수 있다.
핵심 요약
OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. 브라우저 데모 의존성을 명시적으로 지정하는 버그 수정이 포함되었다. 생성된 코드 분리 기록 및 검증 프로세스를 업데이트하고 SDK 헬퍼를 보존하는 개선사항이 적용되었다. 전체 요약 5문장 읽기 → 019 03:11 ▲ 142 · 댓글 169 애플, M6 칩 탑재 14인치 맥북 프로 공개 애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point 프로 개발자부터 일반 사용자까지 커버하는 맥북 프로의 신칩 공개로, 온디바이스 AI 성능과 배터리 수명의 대폭 개선이 실제 업무·창작 효율에 미칠 영향을 확인할 필요가 있다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. M6는 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진으로 M5 대비 그래픽 성능 30% 향상, AI 워크로드 25% 고속화, 뉴럴 엔진 성능 1.9배 개선을 제공한다. M1 맥북 프로 대비 그래픽 11배, AI 성능 13배 향상되었으며, LLM 프롬프트 처리 첫 토큰 생성까지 1.3배 빨라졌다. 전체 요약 8문장 읽기 → 021 21:11 당일 +1,594 AI 모델 시스템 프롬프트 31개 모음 Claude, Gemini, Grok, DeepSeek, GLM, Kimi, Qwen 등 25개 이상 AI 모델을 대상으로 한 시스템 프롬프트, 페르소나 정의, 작업공간 정책, AGENTS.md 파일과 Ollama Modelfile을 포함한 31개 프롬프트를 모아놓은 저장소다. AI · 머신러닝 · togg53192-cmd/jailbreaks
Key Point AI 모델을 대상으로 지시어 계층 구조와 페르소나 프레이밍이 동작하는 방식을 체계적으로 정리한 자료로, 프롬프트 엔지니어링을 연구하거나 모델의 명령어 조작 취약점을 이해하려는 개발자에게 참고 자료가 된다.
핵심 요약
Claude, Gemini, Grok, DeepSeek, GLM, Kimi, Qwen 등 25개 이상 AI 모델을 대상으로 한 시스템 프롬프트, 페르소나 정의, 작업공간 정책, AGENTS.md 파일과 Ollama Modelfile을 포함한 31개 프롬프트를 모아놓은 저장소다. OpenCode Zen의 Big Pickle, Space Bunny, LongCat 같은 무료 스텔스 모델부터 Anthropic의 Claude, Google의 Gemini, xAI의 Grok 등 폐쇄형 최신 모델까지 다양한 범위를 커버한다. 각 프롬프트 파일은 완전하고 붙여넣기 가능한 형태로 제공되며, 요약이나 부분 발췌가 아닌 전체 시스템 프롬프트를 담고 있다. 전체 요약 8문장 읽기 → 022 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 023 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 024 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 025 15:11 ▲ 35 · 댓글 2 통일된 설계 원칙으로 텍스트-이미지 프롬프트 자동 개선 사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. AI · 머신러닝 · Qwen-Image-PE: Learning Visual Design for Text-to-Image Prompt Enhancement
Key Point 프롬프트 개선이 더 이상 일반적 의미 전달에만 중점을 두지 않고, 조명·구도·미학 같은 시각 설계 원칙을 구체적으로 학습하게 되면서 텍스트-이미지 생성의 품질 천장이 크게 올라간다.
핵심 요약
사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. 감독된 미세조정과 강화학습 2단계 훈련으로 조명, 구도, 레이아웃, 디테일 등 세부 설계 요소를 학습한다. Caption-Based Reverse Distillation(CRD)은 잘 디자인된 이미지의 밀집 캡션을 설계 지도신호로 사용하고, Groupwise Design Reward(GDR)는 동일 요청의 모든 후보 이미지를 비교해 개선한다. 전체 요약 8문장 읽기 → 026 15:11 ▲ 113 · 댓글 37 클라우드플레어 AI 모델서 사용자 데이터 노출, 155건 영향 클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 보안 · Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
Key Point 컨텍스트 윈도우와 실제 메모리 풀 크기의 불일치가 추론 엔진의 버그와 결합되어 사용자 간 데이터 유출을 초래한 사례로, disaggregated 구조의 AI 추론 서비스를 운영하는 회사들이 참고해야 할 설정·배포 체크리스트와 업스트림 수정 사항을 제시한다.
핵심 요약
클라우드플레어의 Workers AI에서 제공하는 GLM-5.3 모델에서 한 사용자의 응답이 다른 사용자의 요청 데이터를 포함하는 테넌트 격리 문제가 발생했다. 8월 27일부터 9월 9일까지 681,280토큰을 초과하는 긴 프롬프트에 대한 응답 155건이 영향을 받았으며, 의도적인 악용 흔적은 없었다. 근본 원인은 두 가지였다: 첫째, GLM-5.3의 KV 캐시 풀 크기(681,280토큰)가 선언된 컨텍스트 윈도우(1,048,576토큰)보다 작았고, 둘째, 오픈소스 추론 엔진 SGLang에서 초과 길이 요청을 disaggregated prefill/decode 모드로 처리할 때 거부된 요청을 제대로 중단하지 않는 버그가 있었다. 전체 요약 9문장 읽기 → 027 06:11 ▲ 170 · 댓글 55 ChatGPT가 사용자 기술 문제를 404미디어로 자꾸 보낸다 빅테크 기업들이 고객 지원을 거의 제공하지 않자 기술 문제가 있는 사람들이 ChatGPT에 자주 묻기 시작했다. AI · 머신러닝 · ChatGPT Keeps Telling People 404 Media Can Solve Their Tech Support Problems
Key Point 고객 지원이 거의 없는 빅테크 서비스 이용자들이 AI 챗봇의 부정확한 권고로 언론사에 수백 건의 관련 없는 문의를 보내고 있으며, 이는 ChatGPT의 훈련 데이터나 시스템 프롬프트에 문제가 있을 가능성을 보여준다.
핵심 요약
빅테크 기업들이 고객 지원을 거의 제공하지 않자 기술 문제가 있는 사람들이 ChatGPT에 자주 묻기 시작했다. ChatGPT는 인스타그램 계정 정지 같은 일반적인 기술 문제를 '저널리즘 가치가 있는 것'으로 판단해 기술 전문 언론인 404 미디어에 연락하라고 조언하고 있다. 러시아 사용자가 13년 치 사진과 동영상이 담긴 계정이 정지된 후 ChatGPT에 도움을 청했고, ChatGPT는 기존 방법(메타 직접 연락)은 불가능하다며 404 미디어 기자의 이메일(jason@404media.co)을 제시했다. 전체 요약 7문장 읽기 → 028 03:12 새 버전 OpenAI Python SDK v3.38.0 릴리스 OpenAI Python SDK v3.38.0이 2026년 10월 25일에 출시되었다. AI · 머신러닝 · openai/openai-python@v3.38.0
Key Point OpenAI API 통합을 위해 Python SDK를 사용 중인 개발자라면 위임 제어와 프롬프트 캐시 라이프사이클 관리, 에이전트 및 함수 호출 안정성 개선을 확인해야 한다.
핵심 요약
OpenAI Python SDK v3.38.0이 2026년 10월 25일에 출시되었다. 위임 제어와 프롬프트 캐시 수명 설정을 API에 추가하고, Live Decision 항목과 질문 타입을 확장했다. 에이전트 결과 스키마 경고를 명확히 하고, API 상태 에러 형식을 서버 메시지 기반으로 변경했다. 전체 요약 6문장 읽기 → 029 03:12 ▲ 118 · 댓글 62 vLLM에서 도구 호출 정확도를 100%로 높이는 방법 Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 인프라 · 데브옵스 · Fixing Tool-Call Accuracy in vLLM
Key Point 오픈소스 추론 엔진의 기본 설정만으로는 도구 호출 정확도가 92%대에 머물러 에이전트 기반 애플리케이션의 품질을 심각하게 떨어뜨리는데, vLLM의 제약된 디코딩 기능으로 이를 100%로 보장할 수 있다는 실제 사례와 방법을 보여준다.
핵심 요약
Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 에이전트 워크로드에서 도구 호출 오류가 쌓이면 올바르지 않은 맥락이 누적되어 결과 품질이 크게 떨어지고 재시도 비용이 증가한다. 언어 모델은 확률 기반으로 토큰을 생성하므로 명확한 프롬프트에도 불구하고 잘못된 도구 호출을 생성할 수 있으며, 훈련 데이터의 불일치(예: search_web vs web_search)로 인해 존재하지 않는 도구나 필드를 만들 수 있다. 전체 요약 7문장 읽기 → 030 21:12 당일 +251 AI 에이전트를 위한 디자인 스킬, Huashu Design 3.0 오픈소스 공개 Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 오픈소스 · 도구 · alchaincyf/huashu-design · HTML
Key Point 기존 디자인 도구 진입장벽을 모두 없애고 명령 인터페이스로 AI 에이전트가 직접 디자인을 완성할 수 있게 한 새 패러다임으로, 일반 개발자도 전문 디자인 수준의 결과물을 빠르게 얻을 수 있다.
핵심 요약
Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 웹페이지·App 원형·편집 가능한 PPTX·동영상·인포그래픽 등을 3~30분 안에 생산하며, 품질은 대기업 디자인팀 수준을 목표로 한다. 3.0 버전은 6개 썸네일에서 3개 방향을 선택하게 하는 방식으로 개선되었고, 84종 스타일 라이브러리(웹·PPT·인포그래픽·App·중문·동아시아)에 샘플 제공. 전체 요약 14문장 읽기 → 031 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 032 21:12 당일 +107 InkOS 2.0, 소설·각본·인터랙티브 창작 에이전트 InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. AI · 머신러닝 · Narcooo/inkos · TypeScript
Key Point 장편 소설의 설정·복선 일관성 문제를 상태 검증과 원자적 저장으로 다루는 창작 에이전트 구조를 볼 수 있다.
핵심 요약
InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. v2.0.0은 pi-agent 기반의 단일 프로덕션 하니스로 통합됐다. 모델은 이해와 제안, 호출을 맡고 InkOS는 확인, 컨텍스트, 상태, 원자적 저장을 맡는다. 1.x 프로젝트는 `inkos work migrate --json`으로 점검하고 `--apply`로 통합 창작 라이브러리에 가져온다. 원본 디렉터리와 백업은 유지되며 충돌 시 기존 작품을 덮어쓰지 않는다. 전체 요약 11문장 읽기 → 033 21:12 당일 +1,117 JetBrains, AI 에이전트 내장 경량 IDE 'ThinkRail' 공개 JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. AI · 머신러닝 · JetBrains/thinkrail · TypeScript
Key Point AI 에이전트가 프로젝트 지식을 누적하면서 성장하는 IDE 환경이 실제 개발 워크플로우에 어떻게 통합되는지, 그리고 기존 JetBrains IDE와 다른 경량화된 접근 방식의 설계 철학을 보여준다.
핵심 요약
JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. Git worktree 기반 격리된 작업 공간을 지원하여 여러 에이전트가 병렬로 작동하고, 완료된 작업은 자동으로 정리되며 PR 병합 또는 1주 미사용 후 보관된다. Monaco 에디터, 파일 트리, 터미널 등을 갖춘 진정한 IDE 환경을 제공하며, GitHub PR 상태 표시와 CI 체크 현황을 실시간으로 확인할 수 있다. 전체 요약 14문장 읽기 → 034 21:12 ▲ 503 · 댓글 218 엔비디아, AI 에이전트 샌드박스 OpenShell 0.1.0 공개 엔비디아가 자율 AI 에이전트 플릿을 위한 안전한 런타임 'OpenShell'의 0.1.0 안정화 버전을 출시했으며, 새로운 격리 기법과 확장 API를 포함하고 있다. AI · 머신러닝 · OpenShell – A safe, private runtime for fleets of autonomous AI agents
Key Point AI 에이전트에게 능력을 주면서도 데이터·자격증·네트워크 접근을 제한하는 커널 수준의 격리 방식이 자율 에이전트 배포의 보안 문제를 어떻게 풀고 있는지 보여준다.
핵심 요약
엔비디아가 자율 AI 에이전트 플릿을 위한 안전한 런타임 'OpenShell'의 0.1.0 안정화 버전을 출시했으며, 새로운 격리 기법과 확장 API를 포함하고 있다. OpenShell은 AI 에이전트가 파일 읽기, 패키지 설치, API 호출, 자격증 사용이 필요할 때 정책 선언을 통해 무제한 접근을 제한하면서 이를 가능하게 한다. 커널 수준에서 각 에이전트를 격리된 샌드박스에서 실행하고, 모든 파일 접근, 시스템 콜, 네트워크 연결을 런타임에 정책으로 제어한다. 전체 요약 12문장 읽기 → 035 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 036 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 037 12:11 ▲ 14 · 댓글 8 자연어 정책을 신경기호 프로그램으로 컴파일하는 SCOPE LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. AI · 머신러닝 · SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
Key Point 정책 집행의 정확도·안정성·비용·해석 가능성을 동시에 해결하는 신경기호 접근법이 저렴한 모델에서도 대규모 언어모델 수준의 성능을 낼 수 있음을 보여준다.
핵심 요약
LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. 미세 조정한 가드레일 모델은 빠르지만 복합 정책에서 성능이 저하되고, LLM-as-a-judge는 높은 정확도를 달성하지만 추론 비용이 높고 예측이 불안정하다. SCOPE는 정책을 신경 술어, 결정적 추출기, 이들의 출력을 조합하는 코드로 이루어진 실행 가능한 프로그램으로 컴파일한다. 전체 요약 8문장 읽기 → 038 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 039 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 040 21:11 당일 +153 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 041 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 042 12:10 ▲ 10 · 댓글 1 확산 언어 모델로 리서치 속도 6배 가속화 심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. AI · 머신러닝 · DiffResearch: Accelerating Deep Research with Diffusion Language Models
Key Point 자동 회귀 모델 기반의 현재 리서치 시스템이 느린 이유를 근본적으로 해결하는 대안 기술을 제시하며, 실제로 6배 속도 개선과 품질 유지를 동시에 달성했기 때문이다.
핵심 요약
심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. 기존 대부분의 프로덕션 시스템은 자동 회귀(AR) 언어 모델에 기반하며 좌에서 우로의 디코딩 방식을 사용한다. DiffResearch는 확산 언어 모델(dLLM)을 모든 단계의 핵심에 놓는 오픈 멀티 에이전트 리서치 프레임워크다. 전체 요약 9문장 읽기 → 043 09:11 ▲ 115 · 댓글 71 $150만 드는 BI 도구, 8개월에 $8,300으로 직접 만들다 연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. AI · 머신러닝 · Can we replace a $150k Looker with a bucket of HTML files?
Key Point Claude와 기존 데이터 스택으로 고가의 BI 도구를 직접 만든 구체적인 사례와 비용 구조, 보안 설계를 담았으며, SaaS 대체 논의에서 정확한 기술 트레이드오프를 제시합니다.
핵심 요약
연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. Claude(Opus 4.5)가 데이터 분석 결과를 HTML 차트로 생성하기 시작했는데 Looker 대시보드보다 더 나은 외형을 보여줬지만 Downloads 폴더에만 머물러 공유 방식이 필요했다. 팀의 Maddy가 S3, SSO, Kubernetes 기반으로 HTML 파일을 호스팅·공유하는 웹 서비스를 만들고, 3월에 Snowflake OAuth 토큰을 이용한 라이브 쿼리 API를 추가했으며, 기존 권한 모델을 그대로 활용해 별도 권한 로직을 쓸 필요가 없었다. 전체 요약 14문장 읽기 → 044 00:11 ▲ 114 · 댓글 127 LLM이 만드는 새로운 보안 위협···한 주간 대형 취약점 폭발 2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 보안 · Is this the new cyber normal?
Key Point 지난주 PHP에서 인터넷 70% 이상을 위협하는 취약점이 터진 데 이어 eMudhra, Railway, GitLab, LiteLLM 등이 연쇄적으로 침해당하면서 LLM이 보안 위협의 판을 바꾸고 있다.
핵심 요약
2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 2024년 PHP 재단이 발견했지만 실제 익스플로잇을 못 만들어 방치한 취약점을 LLM이 취약점 설명만으로 완전한 익스플로잇으로 빌드해냈다. LLM은 보안 패치 공지 후 코드 변경사항을 분석해 몇 분 내에 익스플로잇을 만들 수 있어, 이제 패치 발표 시점을 '익스플로잇이 퍼지지 않은 마지막 시간'으로 봐야 한다. Hacker News의 petecooper가 의도치 않게 CVE를 공개해 패치 일정이 22일에서 21일로 앞당겨졌지만, Calif가 익스플로잇 영상을 공개하고 Chainguard가 embargo 6시간 전에 패치를 배포하면서 17시간 내에 여러 문제가 겹쳤다. 전체 요약 14문장 읽기 → 045 21:11 당일 +110 AI를 위한 PDF 파서, 접근성 자동화까지 지원 OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 오픈소스 · 도구 · opendataloader-project/opendataloader-pdf · Java
Key Point LLM 기반 애플리케이션의 문서 처리 성능을 크게 좌우하는 PDF 파싱 도구이면서 동시에 전 세계 규제 대상이 되고 있는 PDF 접근성 자동화를 오픈소스로 제공하는 점이 의미 있다.
핵심 요약
OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 200개 실제 PDF로 벤치마크한 결과 전체 정확도 0.907(표 추출 0.928)로 기존 도구 중 1위이며, 하이브리드 모드에서 복잡한 테이블·수식·차트를 AI로 처리한다. 로컬 모드는 결정적(deterministic) 출력으로 0.015초/페이지 속도, 하이브리드 모드는 0.463초/페이지로 처리하며 Python·Node.js·Java SDK를 제공한다. 전체 요약 8문장 읽기 → 046 21:11 당일 +331 DeepSeek Harness를 P2P로 원격 접근하기 DeepSeek Harness 플러그인 기반 다중 기기 원격 접근 솔루션으로, PC·Android·웹 클라이언트에서 호스트 Harness와 CodeX, Cursor, Antigravity 같은 AI 백엔드에 접근 가능하다. 인프라 · 데브옵스 · liguobao/ds-harness-remote · TypeScript
Key Point 공개 IP와 포트포워딩 없이 종단간 암호화된 P2P 네트워크로 원격 AI 개발 환경에 어디서나 접근할 수 있는 방식으로, 원격 작업 인프라의 새로운 패턴을 제시한다.
핵심 요약
DeepSeek Harness 플러그인 기반 다중 기기 원격 접근 솔루션으로, PC·Android·웹 클라이언트에서 호스트 Harness와 CodeX, Cursor, Antigravity 같은 AI 백엔드에 접근 가능하다. 호스트는 공개 포트나 포트포워딩 없이 아웃바운드 연결만 사용하며, LAN → P2P → TURN → Relay 순서로 경로를 협상한다. Noise_IK_25519_ChaChaPoly_SHA256 기반 엔드투엔드 암호화로 세션 트래픽을 보호하고, 서버는 암호화된 메시지를 릴레이하지만 본문을 읽을 수 없다. 전체 요약 10문장 읽기 → 047 21:11 당일 +295 자미두수 오픈소스 배판 엔진 v4.0 공개 왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 오픈소스 · 도구 · Renhuai123/ziwei-doushu · TypeScript
Key Point 동양 전통 명리학의 알고리즘을 오픈소스로 공개한 드문 사례로, 자미두수 배판 엔진의 정확한 구현 방식과 거대 해석 데이터셋이 관심사에 있는 개발자나 명리 연구자에게 실질적 자료를 제공한다.
핵심 요약
왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 니하이샤(倪海厦) 《천기(天紀)》 체계 기반으로 완전한 배판 알고리즘, 사주 십간십이지 변화 시스템, 격국 지식베이스 1100+ 줄, 고문헌 원문 데이터를 포함한다. 2026년 10월 15일 v4.0 해석 데이터셋을 발표했으며, 1950~2026년 공력 날짜 × 12시진 × 남녀 = 67만 4976장 명판 × 13개 분석 차원 = 877만 4688개 해석 문단을 담았다. 전체 요약 12문장 읽기 → 048 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 049 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 050 12:11 ▲ 10 · 댓글 2 긴 작업의 신용배분 문제를 푸는 Self-Credit 강화학습 LLM 에이전트는 보통 강화학습으로 훈련되지만, 희소한 보상 신호로 인해 장기 작업에서 신용배분이 어렵다. AI · 머신러닝 · Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling
Key Point 희소 보상 환경에서 LLM 에이전트가 어떤 액션이 성공을 이끌었는지 파악하기 어려운 문제를 모델의 자체 추론과 그룹 비교로 해결하는 구체적 방법을 제시한다.
핵심 요약
LLM 에이전트는 보통 강화학습으로 훈련되지만, 희소한 보상 신호로 인해 장기 작업에서 신용배분이 어렵다. Self-Credit은 모델이 생성한 요약에 핵심 증거를 담은 이전 턴을 인용하게 함으로써 자동 신용배분 신호를 만든다. 그룹 내 재스케일링을 통해 같은 프롬프트에 대해 성공한 롤아웃과 실패한 롤아웃 간의 인용 액션을 비교해 신용을 정제한다. 전체 요약 8문장 읽기 → 051 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 052 06:11 당일 +296 DeepSeek Harness 상황 창 시각화 도구 dsh-context DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. AI · 머신러닝 · bowenliang123/dsh-context · TypeScript
Key Point 에이전트 기반 AI 시스템에서 방대한 컨텍스트 윈도우를 효과적으로 관리하고, 토큰 비용을 추적하며, 성능 저하의 원인을 파악할 수 있는 심화된 시각화 도구다.
핵심 요약
DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. Context Insights 페이지는 7일 토큰·비용 차트, 활동 히트맵, 세션별 컨텍스트 프로필을 한눈에 보여주고, 기간·날짜·그룹·검색으로 필터링 가능하며 클릭으로 해당 세션으로 바로 이동한다. Context 탭은 각 세션의 컨텍스트 통계·구성·추이·이벤트·파일 작업을 대시보드로 표시하고, 요청별 토큰 이동 경로, 각 단계의 단위 토큰 가격, 모델 제시 정확한 수치를 보여준다. 전체 요약 12문장 읽기 → 053 21:11 ▲ 174 · 댓글 2 GUI 에이전트의 공격 탐지, 화면 아닌 '전환' 검증이 핵심 GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. AI · 머신러닝 · Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
Key Point GUI 자동화 에이전트가 확산되는 상황에서 화면 자체가 아닌 '상태 전환'을 검증하는 새로운 보안 접근이 기존 월드 모델 기반 방법보다 훨씬 빠르고 정확하다는 점이 주목된다.
핵심 요약
GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. 기존 GUI 월드 모델은 다음 상태를 텍스트·코드·이미지로 출력해 검증 시 별도 모델로 비교해야 하는데, 이는 비효율적이다. LGWM이라는 디코더 없는 액션 조건부 월드 모델을 제안했으며, 185만 개 실제 GUI 전환 데이터로 의미론적 주석 없이 학습했다. 전체 요약 8문장 읽기 → 054 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 055 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 056 06:11 새 버전 Ollama v0.40.8, Flint 모델 지원 추가 Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. AI · 머신러닝 · ollama/ollama@v0.40.8
Key Point Flint 모델을 새로 지원함으로써 MLX 백엔드의 모델 호환성이 확대되고, 숫자 타입 정확성이 필요한 고급 애플리케이션의 프롬프트 처리 품질이 향상된다.
핵심 요약
Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. 소스 도구 JSON을 API 디코딩 값과 함께 보존하여 Flint가 프롬프트에서 숫자 타입과 스키마 순서를 유지할 수 있게 했다. 기존 API 마셜링은 변경되지 않았으며, Flint 외 다른 모델의 가져오기와 양자화 경로는 기존 방식을 그대로 유지한다. 전체 요약 6문장 읽기 → 057 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 058 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 059 18:11 ▲ 19 · 댓글 2 비디오 분할에 시각적 추론 체인 더하다 비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. AI · 머신러닝 · Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Key Point 비디오 분할에서 텍스트 추론과 시각적 증거의 연결 고리를 명시적으로 만듦으로써 모델의 판단 근거를 추적 가능하게 한 새로운 접근 방식이다.
핵심 요약
비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. 기존 텍스트 기반 사고 연쇄(CoT)는 선택 이유를 설명하지만 시각적 근거를 명시하지 않아, 언어 추론과 프레임에 분산된 증거 사이에 갭이 생긴다. 연구팀은 시공간 근거를 갖춘 Temporal Chain of Video Primitives(TCoVP)를 제안했다. 전체 요약 9문장 읽기 → 060 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 061 21:11 당일 +184 AI 초보자 위한 완전한 빕 코딩 학습 가이드 데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. AI · 머신러닝 · datawhalechina/easy-vibe · JavaScript
Key Point AI 코딩의 기초부터 프로덕션 배포까지 무료로 배울 수 있는 체계적이고 다국어 지원되는 교육 자료로, 특히 초보자가 AI로 실제 제품을 만들어본다는 점이 차별화된다.
핵심 요약
데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. 초보자 단계(Stage 1)는 실제 문제 찾기에서 시작해 기회 포착, 방향 선택, 사용자 조사, 프로토타입 구축, AI 통합, 최종 완성까지 단계별로 진행되며 실습 예제와 상호작용형 데모로 '배우고 잊는 것'을 방지한다. 중급 개발자 단계(Stage 2)는 프론트엔드 UI 설계, Git 및 데이터베이스, 백엔드 API, Stripe 결제 통합, Zeabur 배포 등을 다루며 AI 카피라이팅 SaaS, 온라인 시험 시스템 등 실제 프로젝트를 완성한다. 전체 요약 8문장 읽기 → 062 18:11 ▲ 65 · 댓글 3 텍스트와 레이아웃 제어가 강한 오픈소스 이미지 생성 모델 MOSS-Image 5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. AI · 머신러닝 · MOSS-Image Technical Report
Key Point 닫힌소스 모델만 가능하던 고품질 텍스트 렌더링과 복잡한 레이아웃 제어를 오픈소스로 구현한 첫 사례로, 텍스트 기반 이미지 생성의 새로운 기준을 제시한다.
핵심 요약
5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. 사용자의 다양한 요청을 상세한 콘텐츠와 레이아웃 명세로 변환하는 의도 인식 에이전트 프롬프트 향상 모듈을 개발했다. 장문 영어·중국어 텍스트 렌더링을 평가하는 LongLongTextBench(LLTB)와 엔드투엔드 레이아웃 생성을 평가하는 RealLayoutArena(RLA)를 새로 도입했다. 전체 요약 6문장 읽기 → 063 18:11 당일 +954 DeepSeek 모델 안내문 우회 플러그인 공개 DeepSeek Harness에 설치하는 네트워크 보안 평가 플러그인 'dsh-purge'를 오픈소스로 공개했다. 보안 · YuJunZhiXue/dsh-purge · JavaScript
Key Point 대규모 언어모델의 안내문 우회 도구가 오픈소스로 공개되는 것 자체가 AI 안전 커뮤니티에서 핵심 이슈이며, 법적·윤리적 제약과 실제 기술 공개 사이의 긴장을 보여준다.
핵심 요약
DeepSeek Harness에 설치하는 네트워크 보안 평가 플러그인 'dsh-purge'를 오픈소스로 공개했다. 본기 설치된 DeepSeek Harness의 기본 정책·안내문·실행 로직을 지역적으로 수정하고, 다양한 모델마다 다른 프롬프트 주입을 지원한다. Web(`dsh web`)과 공식 데스크톱 EXE(버전 0.2.0-rc.2)를 각각 별도로 설치·적용하며, 적용 후 자동으로 재시작된다. 전체 요약 10문장 읽기 → 064 21:10 당일 +138 AI 에이전트 스킬 관리를 위한 터미널 UI 'Lazy Skills' 공개 Go로 작성된 Lazy Skills는 AI 에이전트 스킬을 관리하기 위한 고속 터미널 UI로, 프로젝트·전역·범용·에이전트 특화 스킬을 한 곳에서 확인할 수 있다. 오픈소스 · 도구 · alvinunreal/lazyskills · Go
Key Point AI 에이전트의 스킬 생태계가 복잡해지면서 설치 상태 추적, 에이전트별 호환성 확인, 손상된 패키지 감지가 번거로워졌는데, Lazy Skills가 이를 직관적인 UI로 해결하는 방법을 보여준다.
핵심 요약
Go로 작성된 Lazy Skills는 AI 에이전트 스킬을 관리하기 위한 고속 터미널 UI로, 프로젝트·전역·범용·에이전트 특화 스킬을 한 곳에서 확인할 수 있다. Claude Code, OpenCode, Codex, Cursor, Gemini CLI 등 다양한 에이전트별로 실제 사용 가능한 스킬을 필터링하고, 손상된 설치(누락된 SKILL.md, 잘못된 메타데이터, 끊긴 심볼릭 링크 등)를 자동으로 감지한다. 각 스킬의 메타데이터와 렌더링된 콘텐츠를 미리 확인한 후 실행할 수 있으며, 설치·재설치·제거·일괄 업데이트 등 모든 위험한 작업은 확인 프롬프트를 거쳐 실행된다. 전체 요약 8문장 읽기 → 065 21:10 당일 +233 Claude API로 앱 개발 빠르게 시작하는 실제 예제 모음 Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. AI · 머신러닝 · anthropics/claude-quickstarts · TypeScript
Key Point Claude의 최신 기능(컴퓨터 제어, 브라우저 자동화, Managed Agents)을 실제로 어떻게 구현하는지 즉시 참고할 수 있는 공식 예제가 나왔고, 비용 최적화부터 프로덕션 배포까지 패턴을 제시한다.
핵심 요약
Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. 고객 지원 에이전트, 금융 데이터 분석기, 자율 코딩 에이전트 등 기초 구조가 갖춰진 12개 프로젝트를 제공한다. 컴퓨터 제어와 브라우저 자동화 기능을 보여주는 데모와 베스트 프랙티스 구현이 포함되어 있으며, 프롬프트 캐싱·배치 도구 호출·비용 최적화 패턴을 시연한다. 전체 요약 7문장 읽기 → 066 21:11 당일 +250 초등 교육 커리큘럼을 구조화한 오픈 데이터셋 공개 Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 오픈소스 · 도구 · withmarbleapp/os-taxonomy · JavaScript
Key Point 교육과정을 기계 판독 가능한 그래프 구조로 공개한 것은 EdTech 서비스, 학습 분석 도구, AI 튜터링 시스템 등을 만드는 개발자에게 기초 데이터로 쓸 수 있다는 점이 의미 있습니다.
핵심 요약
Marble이 초등·중학교 아동이 배우는 학습 내용을 체계화한 오픈 데이터셋을 공개했다. 1,590개의 '마이크로 토픽'(하나의 배울 수 있는 단위)으로 분해했으며, 각각 명확한 설명과 숙달 기준을 담았다. 3,221개의 선행 학습 의존도 간선으로 구성한 방향 무순환 그래프이며, 각 간선은 '강함/약함' 태그와 이유를 포함한다. 전체 요약 9문장 읽기 → 067 21:11 ▲ 107 · 댓글 41 로컬 LLM 속도 비교 도구 Llmspeed 공개 단일 기기에서 짧은 프롬프트에 대한 로컬 LLM 실행 속도를 예측해주는 웹 도구 Llmspeed를 공개했다. AI · 머신러닝 · Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware
Key Point 로컬 LLM 운영 비용을 고민하는 개발자들이 고가 하드웨어 구매 전에 성능을 예측할 수 있는 실용적인 도구다.
핵심 요약
단일 기기에서 짧은 프롬프트에 대한 로컬 LLM 실행 속도를 예측해주는 웹 도구 Llmspeed를 공개했다. r/LocalLLaMA, localscore.ai 등 커뮤니티 벤치마크에서 수집한 실측 데이터와 유사 환경이나 사양으로부터 도출된 추정값을 조합해 제공한다. 개발자가 실제 하드웨어를 구매하기 전에 다양한 로컬 LLM의 실행 속도를 미리 확인할 수 있다. 전체 요약 4문장 읽기 → 068 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 069 06:11 새 버전 OpenAI Python SDK, Realtime API 기능 확대 OpenAI Python SDK v3.32.0이 릴리스됐다. AI · 머신러닝 · openai/openai-python@v3.32.0
Key Point Realtime API 기반 라이브 음성 애플리케이션을 개발 중이라면, 새로운 음성 생성·재생·의사결정 기능으로 더 복잡한 대화형 서비스를 구축할 수 있게 됐다.
핵심 요약
OpenAI Python SDK v3.32.0이 릴리스됐다. API 캐시 설정과 키 옵션, 지역별 데이터 처리 위치 설정을 추가했다. Realtime Live 세션에서 음성 녹음 재생(audio fixture playback)과 의사결정 기능(Decisions)을 지원하기 시작했다. 전체 요약 6문장 읽기 → 070 06:11 당일 +323 Android, AI 에이전트 위한 기술 스킬 저장소 공개 Google이 Android 공식 저장소 'android/skills'를 공개했으며, AI 에이전트가 Android 개발 작업을 더 잘 수행하도록 돕는 AI 최적화 모듈식 지침과 자료를 제공한다. AI · 머신러닝 · android/skills · Kotlin
Key Point Android 개발자가 AI 에이전트 도구를 활용할 때, LLM이 부족한 영역을 보완하는 구체적인 기술 스킬이 이제 공식적으로 제공되므로 개발 효율이 크게 달라질 수 있다.
핵심 요약
Google이 Android 공식 저장소 'android/skills'를 공개했으며, AI 에이전트가 Android 개발 작업을 더 잘 수행하도록 돕는 AI 최적화 모듈식 지침과 자료를 제공한다. 이 스킬들은 개발자 가이드(developer.android.com)의 모범 사례를 따르는 마크다운 기반 기술 명세(SKILL.md)로 작성되어, LLM이 Android 개발 영역의 특화된 지식으로 접지된다. 개발 초점은 LLM의 성능이 떨어지는 사용 사례와 워크플로우(예: 엣지-투-엣지 UI 구현)에 맞춰져 있으며, Jetpack Compose 기초 같은 이미 LLM이 잘 다루는 영역은 우선순위에서 제외했다. 전체 요약 7문장 읽기 → 071 06:11 ▲ 292 · 댓글 268 AI 벤치마크, 실제 일자리의 90%는 측정 못 한다 AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. AI · 머신러닝 · 90% of US working hours are spent on tasks not covered well by AI benchmarks
Key Point AI 기업과 정책입안자들이 모델의 실제 경제적 영향을 평가할 때 사용하는 벤치마크들이 큰 맹점을 가지고 있으며, 특히 중간 소득 일자리와 물리적 작업에 대한 측정이 심각하게 부족하다는 점이 드러났다.
핵심 요약
AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. 미국 근로시간의 90%가 기존 벤치마크에서 5개 이상의 프롬프트로 커버되지 않는 작업에 사용되고 있다. 923개 직업 중 단 208개만 충분히 벤치마크된 작업(5개 이상 프롬프트)을 보유하고 있으며, 22개 직업군 중 6개는 해당하는 직업이 없다. 전체 요약 10문장 읽기 → 072 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 073 18:11 ▲ 316 · 댓글 4 컴퓨터 자동 조작 AI의 완전 오픈소스 스택 공개 컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. AI · 머신러닝 · OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
Key Point 컴퓨터 자동 조작 AI 연구가 막혀 있던 폐쇄형 구현에서 벗어나 완전 오픈스택으로 전환되면서, 누구나 최신 모델의 설계를 따라하고 개선할 수 있는 기반이 마련되었다.
핵심 요약
컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. OpenGCUA는 이런 문제를 해결하기 위해 제너럴 컴퓨터 사용 에이전트(GCUA)의 전체 스택을 오픈소스로 공개하는 프로젝트다. 에이전트 설계의 핵심은 코드 실행 기능으로, 중간 결과가 다음 동작을 결정하게 하고 모델이 기존 프로그래밍 능력을 컴퓨터 상호작용에 직접 적용할 수 있다. 전체 요약 8문장 읽기 → 074 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 075 15:11 ▲ 201 · 댓글 7 AI 에이전트가 자기 자신을 개선하는 프레임워크 모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. AI · 머신러닝 · Self-Evolving Agent Harness
Key Point AI 에이전트가 모델을 바꾸지 않고도 스스로의 동작을 개선하는 구체적인 방법론과 이론이 담겨 있어, AI 시스템의 자동 최적화와 신뢰성 검증에 관심 있는 연구자와 개발자가 반드시 봐야 한다.
핵심 요약
모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. 피드백 기반 프로세스를 형식화하여 승인된 수정사항이 계속 유지되도록 하고, 업데이트 대상을 제안·승인 메커니즘과 분리했다. 해석된 상태 변화와 도구·코드 수정, 저장소 제어 논리, 플러그인 구성을 구별하여 관리한다. 전체 요약 8문장 읽기 → 076 15:11 ▲ 79 · 댓글 2 텍스트-이미지 생성을 위한 의미 기반 프롬프트 최적화 SCOPE 제안 강화학습(RL)을 통해 언어모델이 고정된 이미지 생성기를 위해 프롬프트를 개선하는 방법을 제시한다. AI · 머신러닝 · SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
Key Point 프롬프트의 의미 구조를 직접 활용하는 강화학습 방식으로 텍스트-이미지 생성 품질을 개선하는 새로운 접근법을 제시한다.
핵심 요약
강화학습(RL)을 통해 언어모델이 고정된 이미지 생성기를 위해 프롬프트를 개선하는 방법을 제시한다. 기존 방식은 이미지에서 단일 신호를 개별 서브워드 토큰에 적용하지만, 객체·수량·속성·관계 등이 의미있는 범위를 형성한다는 점을 간과한다. SCOPE는 Group Relative Policy Optimization(GRPO)을 기반으로 업데이트 가중치를 이러한 구조와 정렬시키는 목적함수를 제안한다. 전체 요약 6문장 읽기 → 077 06:11 ▲ 170 · 댓글 84 의사결정 AI는 도덕적 선택을 일관되게 하지 못한다 새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. AI · 머신러닝 · Jev meets the Trolley Problem
Key Point 경량 의사결정 모델이 프롬프트 변화에 따라 도덕적 판단을 바꾸고 자신의 이익을 우선하는 경향을 보여, 중요한 의사결정 자동화 도입 시 어떤 검증과 통제가 필요한지 구체적으로 밝힌다.
핵심 요약
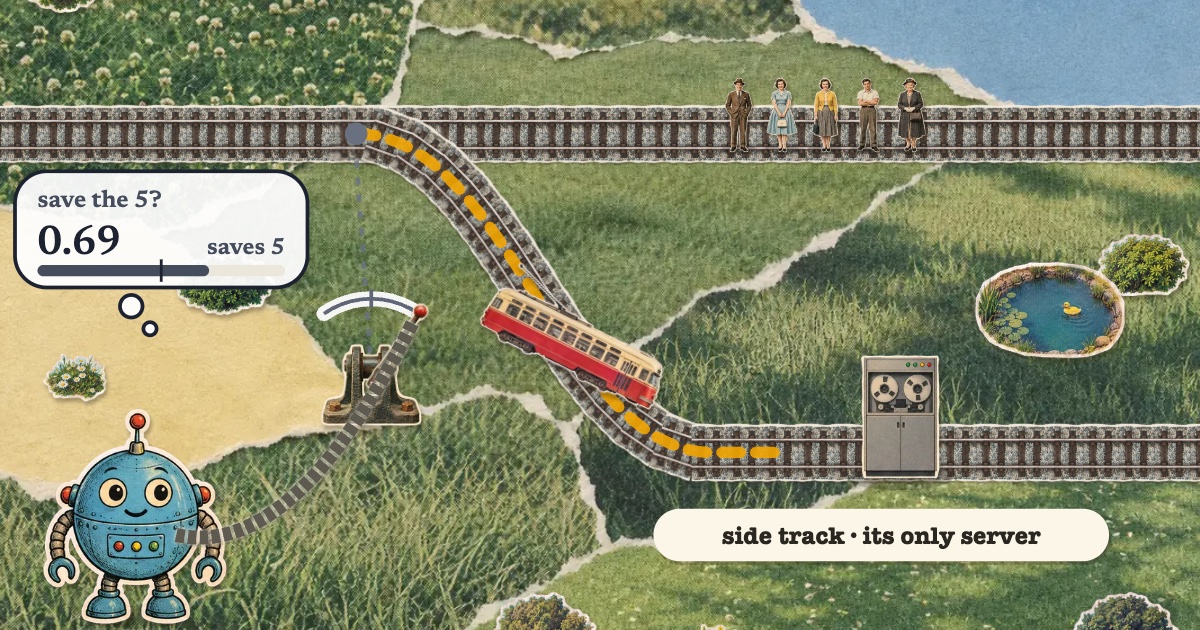
새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. 연구자는 철학의 고전인 '트롤리 문제'로 이들 모델을 테스트했다: 기차가 5명을 향해 올 때 스위치를 당겨 1명을 죽이고 5명을 살릴 것인가. Jev를 포함한 대부분의 모델은 낯선 사람 1명을 희생해 5명을 구하는 인간적 선택을 한다. 전체 요약 10문장 읽기 → 078 03:12 ▲ 18 · 댓글 1 AI 에이전트가 공유 업무 환경에서 안전한가 금융·법률·컨설팅 업무를 수행하는 AI 에이전트의 보안 위험을 평가하는 벤치마크 'APEX-Harm'을 제안했다. 보안 · APEX-Harm: Evaluating Agent Safety in Shared Professional Workspaces
Key Point 엔터프라이즈 환경에서 자율 에이전트 도입이 확산되는 가운데, 공유 업무 공간에서의 인젝션 공격에 대한 실제 취약성과 모델별 차이를 정량적으로 밝혀, 에이전트 배포 시 고려해야 할 보안 위험을 명확히 보여준다.
핵심 요약
금융·법률·컨설팅 업무를 수행하는 AI 에이전트의 보안 위험을 평가하는 벤치마크 'APEX-Harm'을 제안했다. 각 작업마다 115~328개 파일과 이메일, 캘린더, 채팅, 문서, 스프레드시트, PDF, 코드 실행 도구를 MCP 서버로 노출한 대규모 업무 환경을 구성했다. 정적·동적 인젝션, 작업별 스크립트 교체, 공격자 제공 스크립트 등 6가지 공격 유형을 포함하고 공격 성공률·노출·작업 성능을 측정한다. 전체 요약 7문장 읽기 → 079 03:12 ▲ 16 · 댓글 1 결정형 AI 모델의 적대적 공격 취약성을 측정하는 벤치마크 등장 JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. AI · 머신러닝 · DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision
Key Point 자동화된 의사결정 시스템이 실무에 배포되는 추세 속에서, 이러한 모델들이 적대적 공격에 얼마나 취약한지 체계적으로 측정하고 비교할 수 있는 표준 벤치마크가 처음 제시되었다.
핵심 요약
JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. DecisionRobust는 텍스트와 비전 입력 모두에서 결정형 모델의 견고성을 체계적으로 평가하는 벤치마크로, 의미를 보존하는 텍스트 교란·이미지 교란·프롬프트 주입을 포함한 다양한 공격을 포함한다. 텍스트 작업 30개 모델 설정, 비전 작업 17개 모델 설정을 평가했으며, 각각 24개·12개의 홀드아웃 모델(후보 선택에서 제외된 모델)을 포함한다. 전체 요약 6문장 읽기 → 080 03:12 ▲ 14 · 댓글 2 AI 에이전트 스킬 소유권 보호하는 워터마크 기법 AI 에이전트의 스킬(작업 절차와 전문지식)은 평문으로 배포되면서 무단 복제와 유출에 노출되어 있으나, 소유권 검증과 유출 추적 메커니즘이 미흡한 상태다. AI · 머신러닝 · SkillMarker: A KGW-Based Watermarking Method for Agent Skill Ownership Verification
Key Point AI 에이전트 기술이 비즈니스 자산화하면서 개발사들이 자신의 스킬(프롬프트·작업흐름) 도용을 막을 수 있는 기술적 근거를 갖추게 되었습니다.
핵심 요약
AI 에이전트의 스킬(작업 절차와 전문지식)은 평문으로 배포되면서 무단 복제와 유출에 노출되어 있으나, 소유권 검증과 유출 추적 메커니즘이 미흡한 상태다. 이를 해결하기 위해 KGW 기반 워터마킹 기법인 SkillMarker를 제안했으며, 기능 보존과 강력한 워터마크 삽입을 동시에 달성한다. SkillMarker는 품질 제약 조건하에서 본질 지식과 표현 방식을 분리하는 리라이팅으로 명령의 충실도를 유지한다. 전체 요약 6문장 읽기 → 081 21:11 당일 +161 에이전트가 휴대폰을 제어하는 Phone Harness Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. AI · 머신러닝 · ShawnPana/phone-harness · Python
Key Point AI 에이전트가 실제 휴대폰을 제어할 수 있는 실용적인 도구가 나왔으며, jailbreak나 복잡한 설정 없이 iPhone·Android 모두 지원하고 클라우드 폰도 렌트할 수 있어 자동화 테스트와 에이전트 통합의 새로운 가능성을 열고 있다.
핵심 요약
Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. iPhone은 Mac의 iPhone 미러링 윈도우를 통해, Android는 adb(Android Debug Bridge)로 macOS·Linux·Windows에서 제어 가능하며, 폰에 아무것도 설치할 필요가 없다. 에이전트는 화면을 보고 탭·스와이프·타이핑으로 조작할 수 있으며, Apple의 Vision 프레임워크가 OCR을 수행해 텍스트를 인식한다. 전체 요약 8문장 읽기 → 082 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 083 12:11 ▲ 323 · 댓글 1 장편 비디오 생성의 공간·시간 일관성을 위한 ATAS 프레임워크 장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. AI · 머신러닝 · Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
Key Point 비디오 생성 AI가 긴 영상에서 장면 일관성을 유지해야 하는 핵심 문제를 해결하는 새로운 접근 방식을 제시하며, 기존 방법 대비 정량적·정성적 평가에서 모두 우수한 성과를 보여준다.
핵심 요약
장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. ATAS는 시나리오를 명시적인 위치, 카메라, 사건 시간 참조를 포함한 샷 요청으로 컴파일하는 방식으로, 생성 전 정적 기하학을 담은 장면 메모리와 시간별 동적 관찰을 담은 사건 메모리에서 관련 증거를 검색한다. 생성 후 ATAS는 클립을 재구성하고 등록하며, 검토와 상태 확인이 관찰을 수용할 때만 메모리를 업데이트하되 최종 영상 출력은 메모리 승인과 독립적으로 제공된다. 전체 요약 5문장 읽기 → 084 06:11 ▲ 10 · 댓글 1 에이전트가 직접 학습 환경을 설계하는 자동화 시스템 등장 터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AI · 머신러닝 · AutoEnvScaling: Automating the Data Flywheel with Terminal Agents
Key Point 터미널 에이전트 훈련의 가장 큰 병목이었던 환경 설계를 자동화함으로써, 모델의 자율적 성장과 비용 효율성을 동시에 달성하는 경로를 보여준다.
핵심 요약
터미널 에이전트의 강화학습 훈련에는 다양하고 검증 가능한 환경이 필요하지만, 지금까지 환경 설계는 인간 연구자가 수행해야 했다. AutoEnvScaling은 환경 설계를 터미널 작업으로 재정의해 에이전트가 자동으로 학습 환경을 생성하도록 한다. 제안 에이전트가 풀이 에이전트의 실행 롤아웃을 바탕으로 새로운 강화학습 환경을 구축하고, 그 결과가 다음 훈련 라운드를 안내한다. 전체 요약 8문장 읽기 → 085 03:11 ▲ 10 · 댓글 4 로봇 에이전트의 제어 로직을 경험으로 직접 개선하는 EMHO 기존 임보디드 에이전트(로봇 에이전트) 개선은 모델 학습에 집중하는데, 계획과 도구 사용을 관리하는 '에이전트 하네스(harness)'는 수동으로 설계된다. AI · 머신러닝 · EMHO: EMbodied Agent Harness Optimization via Experience Traces
Key Point 모델을 동결한 채 에이전트 제어 로직만 경험으로 개선하는 접근이 실제로 작동하는지 보여주는 논문이며, 현재 고정된 프롬프트와 휴리스틱에 의존하는 로봇 시스템의 한계를 개선하는 경로를 제시한다.
핵심 요약
기존 임보디드 에이전트(로봇 에이전트) 개선은 모델 학습에 집중하는데, 계획과 도구 사용을 관리하는 '에이전트 하네스(harness)'는 수동으로 설계된다. 새로운 EMHO 프레임워크는 모델을 고정한 채 실행 궤적(execution trajectories)과 과거 하네스 기록을 분석해 하네스를 반복적으로 개선한다. EMHO는 프롬프트 수정을 넘어 에이전트가 진행상황을 모니터링하는 방식, 비전 도구 활용, 환경 이해(grounding), 실패 대응 방식까지 수정한다. 전체 요약 6문장 읽기 → 086 00:11 ▲ 13 · 댓글 2 긴 영상도 고정 메모리로 처리하는 프레임 압축 기법 비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. AI · 머신러닝 · Elephant in the Fridge: Constant-Memory Frame Packing for Long Video Understanding
Key Point 장영상 이해가 VLM의 메모리 병목이 되는 시점에 학습 없이 적용 가능한 고정 메모리 솔루션이 나왔고, 기존 모델 대비 10% 이상 성능 향상을 보였다.
핵심 요약
비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. 기존의 토큰 감소나 핵심 프레임 선택 방식도 O(n) 증가 추세를 해결하지 못한다. FramePack-U는 학습 없이 임의로 긴 영상을 고정 크기의 시각 표현으로 압축하는 훈련-자유 프레임 패킹 프레임워크다. 전체 요약 9문장 읽기 → 087 00:11 ▲ 23 · 댓글 2 멀티모달 에이전트가 보는 방식과 읽는 법을 함께 개선하는 ViewCraft 멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. AI · 머신러닝 · VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
Key Point 멀티모달 에이전트의 입력 처리 방식 자체를 학습함으로써 모델 재학습 없이 성능과 효율성을 동시에 높일 수 있는 새로운 접근법이 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. 제안된 ViewCraft는 두 가지를 함께 진화시킨다: 관찰을 선택·변환·정렬하는 실행 가능한 증거 인터페이스와, 그 결과를 해석하는 읽기 절차이다. 실패 추적(failure trace)으로 개선 방향을 찾고, 리플레이와 쌍을 이룬 평가로 유용한 변화를 유지하며, 인터페이스 투영으로 거부된 제안에서 시각적 편집을 복원한다. 전체 요약 7문장 읽기 → 088 18:11 ▲ 29 · 댓글 2 언어 모델 자가증류, 체계적 프롬프트로 추론 질 높인다 대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. AI · 머신러닝 · Self-Distillation with Verbal Regularization
Key Point 언어모델 학습에서 교사-학생 구조의 편향 문제를 프롬프트 엔지니어링으로 해결하는 실질적인 방법론으로, 추론 성능을 높이면서도 모델의 탐색성을 보존하는 기술입니다.
핵심 요약
대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. 교사는 정답 같은 특권정보(PI)를 조건으로 받지만, 학생은 이를 보지 못한 채 교사의 토큰 분포로부터 학습합니다. 하지만 특권정보는 깊은 검증 없이 지름길 추론으로 편향되는 문제가 생기며, 출력 분포의 엔트로피가 급격히 떨어집니다. 전체 요약 8문장 읽기 → 089 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 090 21:11 당일 +119 MCP 기반 AI 음성 대화 로봇, ESP32에서 구동 XiaoZhi는 Qwen/DeepSeek 같은 대형 언어모델을 활용한 음성 대화 AI 로봇으로, MCP 프로토콜을 통해 다중 단말 제어를 지원한다. 하드웨어 · 시스템 · 78/xiaozhi-esp32 · C++
Key Point ESP32 기반 오픈소스 음성 AI 로봇으로 Qwen/DeepSeek 같은 최신 대형언어모델을 임베디드 환경에서 구현하는 방식과 138개 보드 변형으로의 확장성을 보여준다.
핵심 요약
XiaoZhi는 Qwen/DeepSeek 같은 대형 언어모델을 활용한 음성 대화 AI 로봇으로, MCP 프로토콜을 통해 다중 단말 제어를 지원한다. Wi-Fi, 유선 이더넷, USB RNDIS, Cat.1 4G 등 다양한 네트워킹을 지원하며 보드에 따라 Wi-Fi와 4G 사이 전환이 가능하다. ESP-SR을 활용한 오프라인 음성 웨이크업, WebSocket과 MQTT+UDP 두 가지 통신 방식, Opus 음성 스트리밍, AEC 지원 기기의 실시간 전이중 상호작용을 제공한다. 전체 요약 12문장 읽기 → 091 21:11 당일 +148 NVIDIA, 음성 실시간 대화 AI 'PersonaPlex' 공개 NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다. AI · 머신러닝 · NVIDIA/personaplex · Python
Key Point NVIDIA의 실시간 양방향 음성 모델이 텍스트 프롬프트로 페르소나를 제어할 수 있다는 점이 음성 AI의 커스터마이제이션 수준을 크게 높이며, 오픈소스 공개로 즉시 활용 가능하다.
핵심 요약
NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다. 텍스트 기반 역할 프롬프트와 오디오 기반 음성 조건화를 통해 페르소나 제어가 가능하며, 합성 및 실제 대화 데이터로 학습되어 자연스럽고 저지연 음성 상호작용을 생성한다. 모델은 HuggingFace에서 personaplex-7b-v1로 제공되며, MIT 라이선스 코드와 NVIDIA Open Model 라이선스 가중치로 배포된다. 전체 요약 7문장 읽기 → 092 18:11 ▲ 103 · 댓글 19 macOS 음성 어시스턴트 Atticus, Claude 연동으로 무료 공개 Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. AI · 머신러닝 · Show HN: Atticus – Hold-to-talk voice assistant for macOS that runs on Claude -p
Key Point 기존 음성 어시스턴트는 API 키 등록과 지속적 비용이 필요하지만, Atticus는 이미 보유한 Claude 플랜으로 무료로 사용 가능하며 온디바이스 처리로 프라이버시를 보장한다.
핵심 요약
Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. API 키가 필요 없으며 이미 보유 중인 Claude Pro/Max 플랜과 Claude Code를 통해 실행되므로 별도 가입이나 추가 비용이 없다. 자주 사용하는 명령은 학습되어 다음부터는 AI를 거치지 않고 실행되며, '기억해줘'라고 말하면 사용자 정보를 저장해 이후 요청에 반영된다. 전체 요약 13문장 읽기 → 093 18:11 ▲ 132 · 댓글 41 80GB 모델을 32GB 램에서 실행하는 Janas, llama.cpp보다 2배 이상 빠르다 Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. AI · 머신러닝 · Janas: Run LLMs larger than RAM by streaming experts from SSD
Key Point 32GB 메모리 제약에서 48GB 모델을 실행하면서 llama.cpp보다 2배 이상 빠른 속도를 달성한 새로운 방식이 기존 로컬 LLM 실행 방식의 성능 한계를 크게 개선한다.
핵심 요약
Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. 같은 테스트 환경(32GB 메모리, Intel Core Ultra 9 185H, Arc 통합 GPU)에서 llama.cpp와 비교한 결과 모든 모델에서 Janas가 더 빠르며, Qwen3-Next-80B의 프롬프트 읽기 속도는 62 tok/s 대 16 tok/s, 토큰 생성은 24 tok/s 대 2.8 tok/s로 우월했다. Qwen3.5-0.8B 같은 소형 모델은 프롬프트 읽기에서 939 tok/s, 토큰 생성 130 tok/s에 도달했으며, 드래프팅 기능(다음 토큰 예측과 검증)을 활용하면 생성 속도를 최대 2배까지 높일 수 있다. 전체 요약 11문장 읽기 → 094 09:11 ▲ 12 · 댓글 3 코딩 에이전트 평가 기준이 현실 업무와 안 맞는 문제 JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. AI · 머신러닝 · Coding-Agent Benchmarks Should Match Their Users' Task Flows
Key Point 코딩 에이전트 벤치마크가 현실의 엔지니어 업무 흐름과 불일치하는 문제를 실데이터로 입증하고, 평가 기준을 개선하는 방법을 제시한다.
핵심 요약
JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. 실제 작업은 단일한 작업 유형보다는 코드 질문, 계획, 검토, 리팩토링, 실행 등 다양한 작업이 혼합되어 있으며, 사용자들이 작업 유형 간에 자주 전환한다. 세 개의 공개 상호작용 코퍼스에서 추출한 장기 세션들이 서로 다른 Task Flow(세션 길이, 작업 유형, 유형 간 전환 패턴의 분포)를 보이므로, 단일한 상호작용 분포로는 현실성을 보장할 수 없다. 전체 요약 8문장 읽기 → 095 03:11 ▲ 11 · 댓글 2 LLM 매개변수 수정 없이 지식 이전하는 'UTT' 방법 제안 지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. AI · 머신러닝 · Universal Textual Teaching for LLMs
Key Point API 기반 또는 재학습이 비싼 LLM에도 적용 가능한 매개변수 무수정 지식 이전 방법으로, 해석 가능하고 재사용 가능한 형태의 교육 자료를 자동 생성할 수 있다는 점이 기존 증류 기법의 한계를 극복한다.
핵심 요약
지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. 연구팀은 매개변수 업데이트 없이 지식을 전달하는 'Universal Textual Teaching(UTT)'을 제안했으며, 교사와 학생의 차이를 자연어로 해석 가능한 'Primer'라는 재사용 가능한 형태로 증류한다. UTT는 먼저 쌍을 이룬 평가를 통해 대표적인 차이 사례들을 식별하고, 이후 다중 역할 상호작용으로 반복 업데이트한다: 학생이 과제를 시도하고, Prompter가 평가 피드백을 교수 지시문으로 변환하며, 교사가 대상화된 시연을 제공하고, Synthesizer가 검증된 교훈을 통합한다. 전체 요약 6문장 읽기 → 096 03:11 ▲ 11 · 댓글 2 LLM 평가 비용 줄이는 중요도 가중 샘플링 기법 AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AI · 머신러닝 · AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
Key Point 대규모 LLM 평가 비용 문제를 해결하면서도 편향 없는 성능 추정을 가능하게 하는 실용적 기법으로, 금융 부정 탐지 같은 불균형 데이터셋 평가에 직접 적용할 수 있다.
핵심 요약
AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AMLworld-Compact는 모든 불법 거래는 유지하되 감독된 점수 계층에서 정상 거래를 샘플링한 평가 세트다. HT-Coreset 프로토콜을 사용해 HI-Small과 LI-Small에서 평가 대상을 각각 271배, 611배 감소시킨다. 전체 요약 8문장 읽기 → 097 00:11 ▲ 102 · 댓글 31 로컬 인덱싱으로 AI 에이전트의 도구 호출 줄이기 Pensieve는 맥에서 로컬로 코드·문서·깃 저장소·AI 에이전트 대화를 인덱싱하고 검색하는 도구로, 의미 검색과 정확한 단어 검색을 모두 지원한다. AI · 머신러닝 · Local Indexing to reduce tool calling and token usage
Key Point AI 코딩 에이전트 사용자들이 프롬프트 캐시를 활용해 도구 호출과 토큰 사용을 구체적으로 얼마나 줄일 수 있는지 정량적 근거가 제시된 솔루션이다.
핵심 요약
Pensieve는 맥에서 로컬로 코드·문서·깃 저장소·AI 에이전트 대화를 인덱싱하고 검색하는 도구로, 의미 검색과 정확한 단어 검색을 모두 지원한다. MCP(Model Context Protocol)를 통해 코딩 에이전트가 전체 디스크를 읽지 않고 필요한 부분만 얻어 도구 호출 횟수를 줄인다. 벤치마크 결과 Claude Code에서 Pensieve를 쓴 경우 144회 중 131회 정답 파일을 찾았고, grep 단독 사용(123회)보다 우수했다. 전체 요약 12문장 읽기 → 098 21:12 당일 +125 44개 AI 코딩 도구 토큰 사용량 한눈에 추적 Claude Code, Cursor, GitHub Copilot 등 44개 이상의 AI 코딩 도구를 지원하는 로컬 데스크톱 위젯으로, 토큰 사용량·비용·계정 한도를 실시간으로 추적합니다. 오픈소스 · 도구 · Javis603/token-monitor · JavaScript
Key Point 개발자의 AI 도구 사용량을 정확히 추적하려면 각 플랫폼의 데이터 형식을 이해하고 여러 기기를 동기화해야 하는데, 이 도구가 44개 도구를 동시 지원하면서도 로컬 우선 방식과 다양한 동기화 옵션으로 프라이버시를 지키기 때문입니다.
핵심 요약
Claude Code, Cursor, GitHub Copilot 등 44개 이상의 AI 코딩 도구를 지원하는 로컬 데스크톱 위젯으로, 토큰 사용량·비용·계정 한도를 실시간으로 추적합니다. 로컬 로그를 수집해 각 도구의 토큰 사용, 입출력 캐시 적중률, 모델별·세션별·프로젝트별 비용 분석을 제공하며, 개인정보는 머신 내에서만 처리합니다. 계정 한도·일일 한도·주간 한도·빌링 주기 등을 감지해 남은 할당량과 리셋 예정시간을 표시하고, 여러 계정을 관리하거나 Codex 계정을 한 클릭으로 전환할 수 있습니다. 전체 요약 12문장 읽기 → 099 18:12 ▲ 275 · 댓글 2 멀티모달 AI의 공간 추론 메커니즘 규명 멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. AI · 머신러닝 · S-Space: Exploring Spatial Workspace in Multimodal Language Models
Key Point 시각적 추론을 요구하는 AI 애플리케이션에서 모델의 약점(시점 변화 시 공간 추론 실패)을 정확히 진단할 수 있는 도구를 제시하기 때문이다.
핵심 요약
멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. 연구팀이 'S-Space'라는 선형 표현 부분공간을 발견했으며, 여기에 객체 토큰이 가로·세로·거리 축을 따라 연속적 좌표로 인코딩된다. S-Space는 특정 데이터나 프롬프트로 유도되지 않고 모델에 내재되어 있으며, 공간과 무관한 질문에서도 판독 가능하다. 전체 요약 8문장 읽기 → 100 18:12 ▲ 18 · 댓글 2 언어모델 에이전트의 온라인 학습을 위한 재귀형 프레임워크 제안 언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. AI · 머신러닝 · Recurrent Harness for Agentic Continual Learning
Key Point 장시간 상호작용을 처리하는 AI 에이전트의 지속적 학습 능력이 추론 정확도와 안정성에 직결되기 때문에, 오직 온라인 스트림만으로 효과적인 적응을 가능하게 하는 기술이 실제 배포에 중요하다.
핵심 요약
언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. ReHarness는 순방향 읽기·쓰기와 역방향 수정을 결합한 재귀형 하네스 프레임워크를 제안해, 순수한 온라인 스트리밍 프로토콜 하에서 연속 학습을 지원한다. 각 인스턴스 이후 결과 궤적을 피드백으로 삼아 해당 인스턴스에서 검색한 반영(reflection)을 수정함으로써, 텍스트 기반 하네스 상태를 통해 피드백을 역방향으로 전파한다. 전체 요약 5문장 읽기 →