쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
10건 · "성능최적화"조건 지우기 ×
001 18:11 ▲ 131 · 댓글 70 Next.js 걷어내니 라이트하우스 만점 블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 웹 · 프론트엔드 · Removing Next.js Got My Blog to 100 on Every Lighthouse Category
Key Point Next.js와 같은 현대 프레임워크가 정적 블로그처럼 상호작용이 거의 없는 사이트에서 성능을 해칠 수 있다는 구체적인 증거와, 만점을 위해 어떤 선택이 필요했는지 보여준다.
핵심 요약
블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 기존 선택지들(Medium, Blogger, Ghost, WordPress, Hugo)을 검토했으나 성능과 편의성 면에서 부족했고, Bear Blog를 영감 삼아 더 많은 기능을 갖춘 블로그를 직접 구축하기로 결심했다. 정적 웹사이트에 CDN 캐싱과 이미지 최적화만으로도 충분하다고 판단해 Cloudflare를 도입했으며, 특히 Cloudflare의 Image Transformations 무료 티어(5,000개)를 활용했다. 전체 요약 9문장 읽기 → 002 18:11 ▲ 102 · 댓글 11 단 하나의 해시로 블룸 필터 구현하기 블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 인프라 · 데브옵스 · One Hash Bloom Filters
Key Point Bluesky 같은 대규모 시스템에서 블룸 필터의 실제 병목(스레드 경합)을 단일 해시로 해결한 사례로, 고성능 인프라 개선 시 이론만이 아닌 구체적인 최적화 기법을 배울 수 있다.
핵심 요약
블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 전통적 블룸 필터는 k개의 독립적 해시 함수를 사용하지만, 2008년 Kirsch와 Mitzenmacher의 논문에 따르면 단 2개 해시로도 동일한 오류율을 달성할 수 있다. Bluesky는 bits-and-blooms 라이브러리를 사용했으나 스레드 안전성 부족으로 뮤텍스 경합이 병목이 되어 배포 시간이 90분에 달했고, atomic-bloom으로 개선해 15분대로 단축했다. 전체 요약 7문장 읽기 → 003 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 004 06:11 새 버전 uv 0.13.2, 복잡한 의존성 처리 성능 크게 개선 Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 오픈소스 · 도구 · astral-sh/uv@0.13.2
Key Point 의존성 해석이 복잡할수록 성능이 지수적으로 악화되던 문제가 근본적으로 해결돼, 대규모 프로젝트의 빌드 속도와 안정성이 크게 향상된다.
핵심 요약
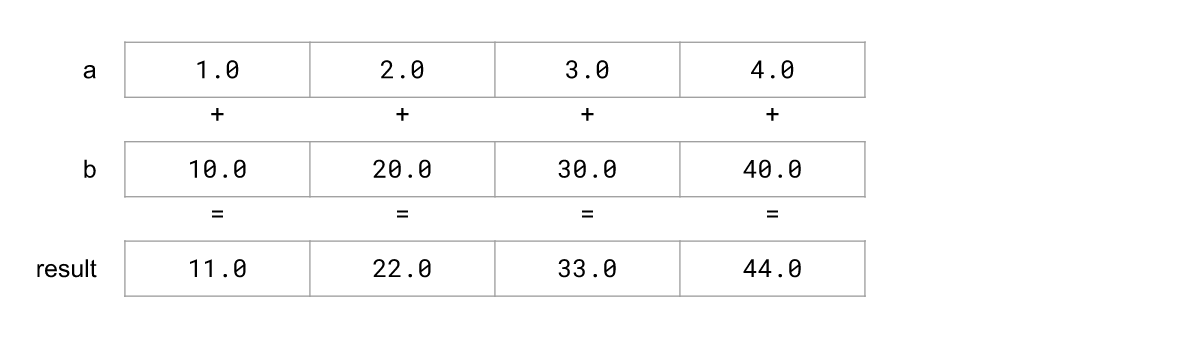
Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 워크스페이스 메타데이터에서 선택한 해석 범위 밖의 패키지도 포함해 모든 설치 패키지를 보고하고, pylock.toml 내보내기 시 환경 제약을 표시하도록 개선했다. 복잡한 의존성 마커 단순화·순회·내보내기 과정에서 지수 시간 복잡도 문제를 제거하고, 마커 파싱 속도와 메모리 사용량을 줄였으며, 대규모 의존성 그래프에서 리졸버 메모리 사용을 감소시켰다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 102 · 댓글 21 2026년 러스트 SIMD 생태계 완전 가이드 SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. 웹 · 프론트엔드 · The state of SIMD in Rust in 2026
Key Point x86/ARM/WebAssembly의 SIMD 확장 명령어가 다르고 호환성 문제가 크며, 러스트 생태계의 5가지 주요 SIMD 라이브러리(std::simd, fearless_simd, wide, pulp, macerator)가 각각 다른 장단점을 제공하므로 용도에 맞는 선택이 중요하다.
핵심 요약
SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. x86은 SSE2, SSE4.x, AVX, AVX2, AVX-512 등 여러 SIMD 확장명령어가 있어 CPU 호환성 문제가 발생하며, ARM은 NEON을 64비트에 필수화했고 WebAssembly는 128비트 확장을 제공한다. x86 바이너리 호환성을 위해 함수 멀티버전화(서로 다른 CPU 기능별로 같은 함수를 여러 번 컴파일)가 필요하며, ARM과 WebAssembly는 이 문제가 없다. 전체 요약 14문장 읽기 → 006 22:29 ▲ 134 · 댓글 48 Tailscale, 멀티큐와 메모리 최적화로 처리량 대폭 높인다 Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 인프라 · 데브옵스 · Making Tailscale Faster
Key Point Tailscale이 VPN 인프라의 핵심 성능 지표인 처리량과 지연시간을 대폭 개선하는 기술들을 순차 배포하고 있어, 개발자들이 VPN 기반 네트워크 구성을 더 효율적으로 활용할 수 있게 된다.
핵심 요약
Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 패킷 큐 길이를 단축해 메모리 절감 효과를 얻었고, 절약된 메모리를 서브넷 라우터와 앱 커넥터에 할당했다. 기존에는 여러 연결의 패킷 스트림을 단일 스레드 파이프라인에서 처리했지만, 새로운 멀티큐 시스템으로 패킷별 레인(lane)을 분리해 병렬 처리를 가능하게 했다. 전체 요약 8문장 읽기 → 007 09:10 ▲ 191 · 댓글 36 수학으로 100TB 메모리 절약한 Cloudflare의 최적화 기법 Cloudflare가 로드 밸런싱 서비스인 Pingora Backend Router의 메모리 사용량을 줄이는 과정을 소개했다. 인프라 · 데브옵스 · Saving another 100TB of RAM
Key Point 수십 테라바이트 규모의 메모리 최적화를 통해 확장 가능한 분산 시스템 설계에서 알고리즘 개선의 영향력을 직접 볼 수 있는 사례입니다.
핵심 요약
Cloudflare가 로드 밸런싱 서비스인 Pingora Backend Router의 메모리 사용량을 줄이는 과정을 소개했다. 내부적으로 사용 중인 일관성 해싱(consistent hashing) 알고리즘이 서버 간 작업을 골고루 분배하는 원리를 설명한다. 해시 함수의 출력을 32비트 정수 범위로 표현한 뒤 각 서버와 작업을 이 범위에 매핑해 작업을 할당한다. 전체 요약 6문장 읽기 → 008 00:10 ▲ 105 · 댓글 29 malloc() 알고리즘 비교 분석 멀티스레드 프로그램에서 메모리 할당/해제는 힙 경합으로 인해 병목이 되며, 스레드·프로세서 수 증가에 따라 오히려 성능이 저하된다. 인프라 · 데브옵스 · Comparison of Malloc() Algorithms
Key Point 멀티스레드 프로그램의 메모리 할당 성능을 크리티컬하게 좌우하는 malloc 알고리즘의 구조와 장단점을 체계적으로 비교하므로, 고성능 시스템 설계 시 올바른 할당자 선택이 필요하다.
핵심 요약
멀티스레드 프로그램에서 메모리 할당/해제는 힙 경합으로 인해 병목이 되며, 스레드·프로세서 수 증가에 따라 오히려 성능이 저하된다. malloc() 발전 과정은 단순 링크드리스트 방식에서 버킷힙, 크기별 분류, 아레나 풀(CPU·스레드별 메모리 풀)로 진화했다. 프론트엔드는 CLAB·TLAB·아레나 방식으로, 백엔드는 버디 알고리즘과 BIPOP 테이블로 메모리 조각화를 관리한다. 전체 요약 5문장 읽기 → 009 06:10 ▲ 148 · 댓글 24 Google의 범용 고속 정렬 알고리즘, C++ 표준 정렬보다 10배 빠름 Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 인프라 · 데브옵스 · Vectorized and performance-portable Quicksort (2022)
Key Point 단일 포터블 구현으로 모든 주요 CPU 아키텍처에서 기존 방식보다 10배 빠른 정렬을 가능하게 했으므로, 데이터베이스와 대규모 데이터 처리 애플리케이션의 성능 혁신을 기대할 수 있다.
핵심 요약
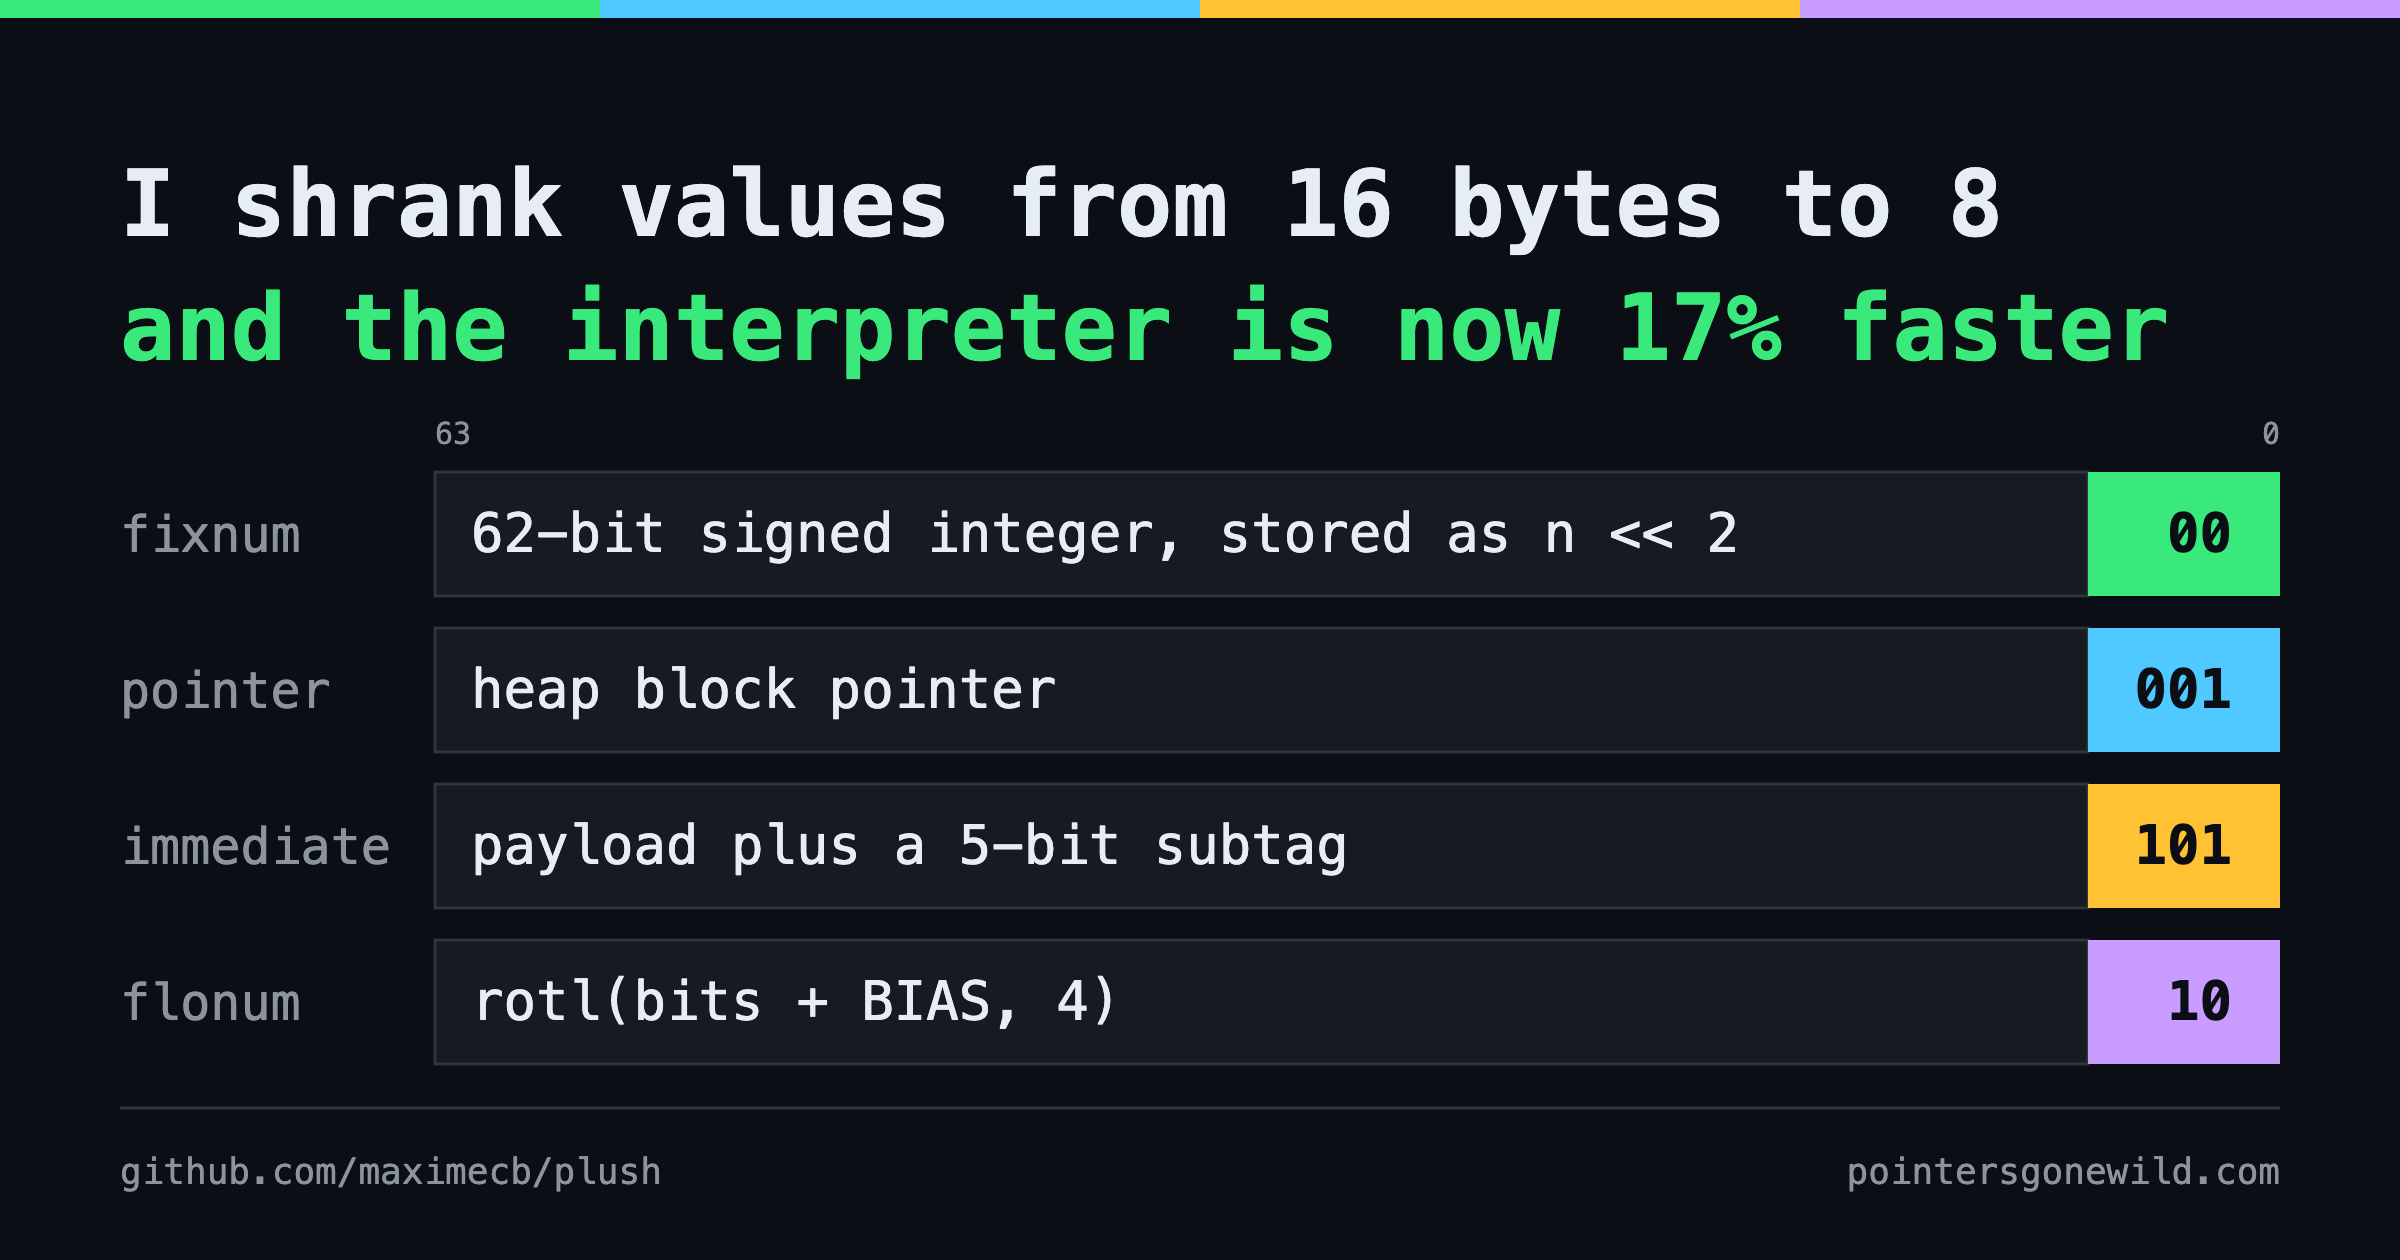
Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 단일 구현으로 AVX2, AVX-512, Arm NEON 등 6가지 명령어 세트를 지원하며, 플랫폼별 최적화 코드 재작성을 제거했다. 압축-저장(compress-store) 명령어를 활용한 파티셔닝으로 정렬 성능의 대부분을 차지하는 단계를 가속화했다. 전체 요약 5문장 읽기 → 010 15:10 ▲ 116 · 댓글 44 Rust 동적 언어 인터프리터, 64비트 값 표현으로 17% 성능 향상 Plush 언어 인터프리터의 Value 타입을 Rust 태그 열거형(16바이트)에서 64비트 단일 워드로 변경했다. 인프라 · 데브옵스 · Replacing a Rust Enum with a 64-Bit Word Made My Interpreter 17% Faster
Key Point 메모리 구조 최적화만으로 메모리 낭비를 50% 줄이면서 오히려 성능을 높인 저수준 인터프리터 튜닝 기법이 실제로 작동하는 방식을 보여준다.
핵심 요약
Plush 언어 인터프리터의 Value 타입을 Rust 태그 열거형(16바이트)에서 64비트 단일 워드로 변경했다. 메모리 정렬로 인한 낭비를 제거하고 저비트 태깅 기법을 사용해 각 값을 64비트 이내로 압축했다. 힙 객체 주소는 8바이트 정렬되어 최하위 3비트가 항상 0이고, 정수는 최하위 2비트를 차용해 태그를 내장했다. 전체 요약 6문장 읽기 →