쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
20건 · "SIMD"조건 지우기 ×
001 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 002 00:11 ▲ 112 · 댓글 34 VLC 가우시안 블러 필터를 C와 C#으로 경주시켜봤다 VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 인프라 · 데브옵스 · C vs. C#: racing VLC's Gaussian blur
Key Point C# .NET AOT는 CPU 집약적 비디오 필터에서 C 대비 8~10% 수준으로 경쟁력 있으며, 컴파일러 최적화로 격차를 더 줄일 수 있다는 점이 주목할 만하다.
핵심 요약
VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 라인 바이 라인 포트에서 C# 버전은 약 23% 더 느렸는데, 원인은 가비지 컬렉터가 아니라 RyuJIT 코드 생성기가 Math.Min을 매 루프마다 재계산하기 때문이다. 루프 경계를 사전 계산하고 nint 인덱스를 사용하는 두 줄의 수정으로 C# 성능을 8% 범위 내로 개선했다. 전체 요약 12문장 읽기 → 003 00:11 ▲ 118 · 댓글 53 형식 검증으로 코드 최적화하는 AI 'Maxwell' 공개 doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. AI · 머신러닝 · Maxwell: A new kind of model that sits between code and hardware
Key Point 기존 AI는 코드 작성만 지원했지만, Maxwell은 형식 검증을 통해 프로그램 실행 중 동적으로 코드를 재작성·최적화하는 새로운 영역을 열었기 때문에, 소프트웨어 성능과 자원 효율성에 미칠 파급 효과가 크다.
핵심 요약
doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. Maxwell은 실행 중인 프로그램의 병목을 감지하고 알고리즘 전체를 재작성해 더 빠른 바이너리를 생성하며, 생성된 코드는 원본과 의미적으로 완전히 동등함을 형식 검증으로 증명한다. 기존 JIT 컴파일러나 최적화 도구와 달리 Maxwell은 실제 하드웨어와 데이터 흐름에 맞춰 함수와 알고리즘 수준의 전체 변환을 수행하고 조건에 따라 보호 조항을 둔다. 전체 요약 13문장 읽기 → 004 03:11 새 버전 Node.js v26.12.0 출시, WebSocket 마스킹 함수와 WebAssembly 지원 개선 Node.js v26.12.0이 2024년 10월 14일 공개되었다. 인프라 · 데브옵스 · nodejs/node@v26.12.0
Key Point WebSocket 마스킹 함수 추가와 암호화 성능 개선으로 실시간 통신과 보안 작업이 빨라지며, 스트림 모듈의 광범위한 최적화는 데이터 처리 효율성을 크게 향상시킨다.
핵심 요약
Node.js v26.12.0이 2024년 10월 14일 공개되었다. WebSocket 처리를 위해 http 모듈에 websocketMask()와 websocketUnmask() 함수가 추가되었다. WebAssembly 또는 정규표현식 지원이 없을 때 명확한 에러를 던지도록 변경되어 누락된 기능을 감지할 수 있다. 전체 요약 12문장 읽기 → 005 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 006 00:11 ▲ 139 · 댓글 70 PS2 게임을 웹어셈블리로 정적 재컴파일해 브라우저에서 실행 PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 웹 · 프론트엔드 · Show HN: PS2 games statically recompiled to WebAssembly
Key Point 에뮬레이터 없이 PS2 게임을 웹브라우저에서 원본 해상도의 2~3배로, 정상적인 속도(50~60fps)로 실행하는 기술이 실현되었으며, 기계 코드 정적 재컴파일이라는 접근법이 성능과 정확도를 동시에 달성했다.
핵심 요약
PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 첫 타이틀인 Gran Turismo 4는 벡터 유닛과 정확한 부동소수점 처리, 팔레트 트릭 등 PS2의 까다로운 기능을 활용하며, 50fps로 풀속도로 재생되고 브라우저 메모리 카드에 저장된다. God of War II는 같은 스크립트로 포팅되었고, 재컴파일러와 벡터 유닛 타이밍의 버그, 입출력 프로세서의 누락된 기능들을 발견해 수정했으며, 60fps의 전투 성능을 낸다. 전체 요약 14문장 읽기 → 007 18:30 ▲ 548 · 댓글 362 Chrome 155부터 JPEG XL 지원, Rust로 안전성 강화 Chrome 155부터 JPEG XL(.jxl) 이미지 포맷의 디코딩을 지원한다. 웹 · 프론트엔드 · Shipping JPEG XL in Chrome
Key Point 메모리 안전성과 성능을 모두 확보한 새 이미지 포맷이 Chrome에 정식 탑재됨으로써, 웹 개발자는 JPEG 대비 더 나은 압축률로 고화질 이미지를 제공할 수 있게 되었다.
핵심 요약
Chrome 155부터 JPEG XL(.jxl) 이미지 포맷의 디코딩을 지원한다. JPEG XL은 차세대 이미지 포맷으로 JPEG 대비 30~50% 더 나은 압축률, 무손실 압축, 내장 HDR 지원, 무손실 JPEG 변환 등을 제공한다. 고화질·무손실 압축이나 사진 이미지, 세밀한 점진적 디코딩이 필요한 경우에 유용하며, 개발자는 최적의 결과를 위해 AVIF와 JPEG XL을 모두 시도해볼 것을 권장한다. 전체 요약 10문장 읽기 → 008 21:11 ▲ 117 · 댓글 25 Haskell 프로그램을 JVM에서 돌리는 새로운 JIT 컴파일러 THC 공개 Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. 인프라 · 데브옵스 · Turbo Haskell
Key Point GHC에서 컴파일한 Haskell 코드를 JVM 위에서 고성능으로 실행할 새로운 선택지이며, 다른 언어 라이브러리 직접 연동과 경량 스레드 같은 기능으로 Haskell의 실용성을 높이고 있다.
핵심 요약
Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. GHC가 파싱·타입체크·최적화까지 담당하고, THC가 Core를 받아 Truffle/GraalVM 위에서 JIT 컴파일해 실행한다. Template Haskell과 Linear Haskell 등 고급 기능을 완벽히 지원하며, JIT와 Native Image를 통한 AOT 컴파일 모두 가능하다. 전체 요약 13문장 읽기 → 009 06:11 ▲ 483 · 댓글 259 구글, 최신 AI 모델 '제미나이 4 아르곤' 발표 구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. AI · 머신러닝 · Gemini 4 Argon
Key Point 구글의 새로운 프론티어 모델이 기존 모델 대비 성능 향상, 크게 확대된 토큰 한도, 사이버보안 방어의 특화 능력을 갖춤으로써 개발자와 보안 담당자의 업무 방식을 바꿀 수 있기 때문이다.
핵심 요약
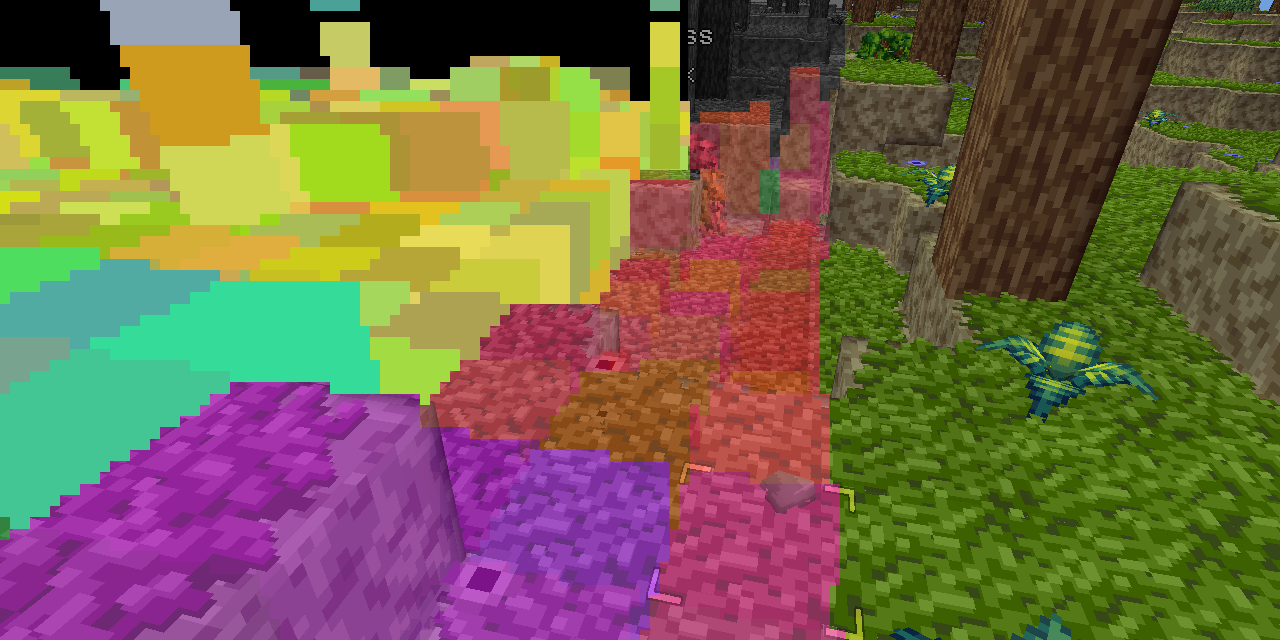
구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. 아르곤은 입력 토큰당 200만 개당 2달러, 출력 토큰당 1000만 개당 10달러의 도입 가격으로 책정되었으며, 캐시된 입력 토큰은 입력 가격의 95% 할인을 받는다. 출력 토큰 한도를 기존 64K에서 업계 최고 수준인 100만 토큰으로 대폭 확대해 더 깊이 있는 사고를 지원한다. 전체 요약 11문장 읽기 → 010 18:11 ▲ 102 · 댓글 9 블록 게임에 소프트웨어 오클루전 컬링 구현하기 약한 통합 GPU(Radeon Vega 8)에서도 성능을 내기 위해 깊이 기반 오클루전 컬링을 소프트웨어로 직접 구현했다. 인프라 · 데브옵스 · Software occlusion culling in Block Game
Key Point 약한 하드웨어에서도 블록 게임의 성능을 크게 개선할 수 있는 실용적인 소프트웨어 렌더링 기법의 구체적 구현 과정과 최적화 단계를 보여준다.
핵심 요약
약한 통합 GPU(Radeon Vega 8)에서도 성능을 내기 위해 깊이 기반 오클루전 컬링을 소프트웨어로 직접 구현했다. CPU에서 256x128 해상도의 깊이 버퍼에 큐브를 렌더링하고 후보 청크를 검사해 숨겨진 기하학을 제거하는 방식으로, 절반 프레임 이내에 완료되며 지하 동굴에서는 95% 이상의 청크를 컬링할 수 있다. 청크당 16x16x16 크기 내에서 5단계의 계층적 서브청크 레벨을 구축해 가까운 것은 작은 단위로, 먼 것은 큰 단위로 처리한다. 전체 요약 8문장 읽기 → 011 21:11 당일 +120 Apple Silicon과 NVIDIA에서 LLM을 OpenAI 호환 API로 서빙하는 TensorFold TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. AI · 머신러닝 · ashhart/TensorFold · Python
Key Point Apple Silicon 개발자가 로컬에서 고성능 LLM 추론을 OpenAI 호환 방식으로 실행할 수 있으며, NVIDIA GPU와 동일한 API로 통일된 배포가 가능해진다.
핵심 요약
TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. Nemotron 3.5 Lightning, Qwen3.8-27B, Qwen3.8 Flash Next, GLM-5.3-Flash, Gemma 4 등 여러 모델을 지원하며, 각 모델은 자체 커널과 드래프트 검증을 포함한다. MLX 백엔드는 M1~M5 칩에서 row-exact simd_qmm 디코더로 4비트/그룹64 가중치를 읽고, CUDA 백엔드는 단일 또는 2-rank 텐서 병렬 처리를 지원한다. 전체 요약 12문장 읽기 → 012 12:11 ▲ 102 · 댓글 21 2026년 러스트 SIMD 생태계 완전 가이드 SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. 웹 · 프론트엔드 · The state of SIMD in Rust in 2026
Key Point x86/ARM/WebAssembly의 SIMD 확장 명령어가 다르고 호환성 문제가 크며, 러스트 생태계의 5가지 주요 SIMD 라이브러리(std::simd, fearless_simd, wide, pulp, macerator)가 각각 다른 장단점을 제공하므로 용도에 맞는 선택이 중요하다.
핵심 요약
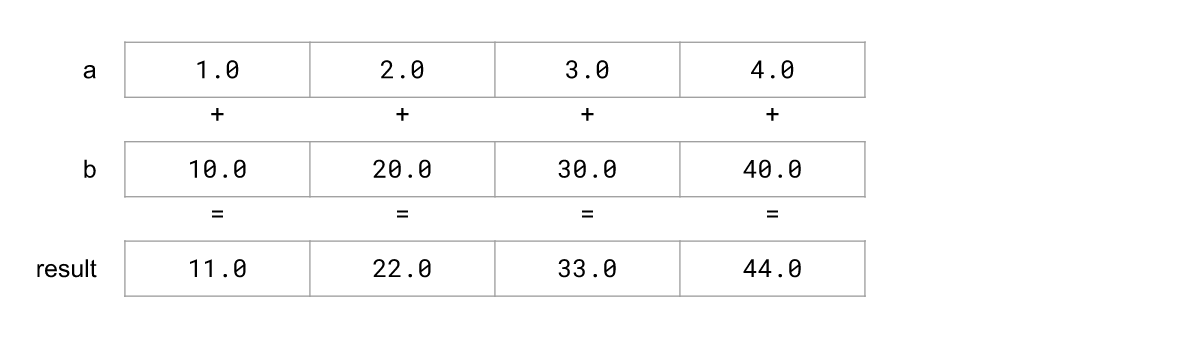
SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. x86은 SSE2, SSE4.x, AVX, AVX2, AVX-512 등 여러 SIMD 확장명령어가 있어 CPU 호환성 문제가 발생하며, ARM은 NEON을 64비트에 필수화했고 WebAssembly는 128비트 확장을 제공한다. x86 바이너리 호환성을 위해 함수 멀티버전화(서로 다른 CPU 기능별로 같은 함수를 여러 번 컴파일)가 필요하며, ARM과 WebAssembly는 이 문제가 없다. 전체 요약 14문장 읽기 → 013 00:11 ▲ 112 · 댓글 29 Go 1.27, 모든 플랫폼에서 쓰는 SIMD API 공개 Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. AI · 머신러닝 · Platform-Independent SIMD in Go
Key Point Go의 SIMD 에뮬레이션 기반 포터블 API 도입으로, 벡터 연산이 필요한 암호화·데이터 처리·AI 알고리즘을 플랫폼 의존성 없이 작성할 수 있게 됐으며, 어셈블리 대신 일반 Go 코드로 성능 최적화가 가능해짐.
핵심 요약
Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. 기존에는 Go 어셈블리로만 SIMD 접근 가능했으나, 새 API로 고성능 커널이 아닌 일반 소프트웨어도 벡터 연산 활용 가능. SIMD는 CPU마다 벡터 크기(128~512비트), 마스킹 방식, 지원 연산이 크게 달라 플랫폼별 구현이 복잡했음. 전체 요약 12문장 읽기 → 014 22:26 ▲ 115 · 댓글 18 Rust SIMD 라이브러리 'Fearless SIMD' v1.0 공개 Rust에서 SIMD 프로그래밍을 안전하게 만드는 라이브러리 Fearless SIMD v1.0이 출시됐으며, 8년의 개발 과정을 거쳤다. 오픈소스 · 도구 · Fearless SIMD v1.0
Key Point Rust의 SIMD 프로그래밍은 보안과 성능 사이의 균형이 중요한데, Fearless SIMD가 unsafe 코드 제거와 zero-cost 추상화를 동시에 달성한 것이 생태계에 미치는 실질적 영향을 알 수 있다.
핵심 요약
Rust에서 SIMD 프로그래밍을 안전하게 만드는 라이브러리 Fearless SIMD v1.0이 출시됐으며, 8년의 개발 과정을 거쳤다. 성능상 문제를 해결하기 위해 플랫폼 간 동일한 결과를 보장하는 precise 변형과 엣지 케이스를 무시하는 fast 변형을 모두 제공한다. 하드웨어 네이티브 벡터 크기로 코드를 표현할 수 있어 모든 플랫폼에서 하드웨어를 최대로 활용할 수 있다. 전체 요약 9문장 읽기 → 015 21:11 ▲ 101 · 댓글 52 LLM 에이전트가 Rust 코드를 2~20배 빠르게 최적화 Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. AI · 머신러닝 · Writing Rust code that's fast by asking agents to make the code faster
Key Point 에이전트형 LLM의 성능 최적화 능력이 구체적인 벤치마크 결과로 입증됨에 따라, 고성능 코드 작성의 새로운 워크플로우가 가능해졌다.
핵심 요약
Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. UMAP 차원 축소 알고리즘을 Rust로 구현해 벤치마킹하면서, 에이전트가 faer·simsimd 같은 최적화 라이브러리를 활용해 코드 속도를 2배~20배 향상시켰다. 에이전트에 명확한 성공 기준(pass/fail)과 긴 마크다운 프롬프트(대문자·강조 사용)를 제공하니 자동 반복 최적화가 효과적이었다. 전체 요약 5문장 읽기 → 016 06:11 ▲ 125 · 댓글 26 AMD 라이젠, 2년간 성능 50% 향상의 비결 2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 하드웨어 · 시스템 · How did AMD Ryzen get 50% faster in two years?
Key Point CPU 기술이 정체되었다는 통념을 깨고 실질적인 아키텍처 개선이 성능 향상을 어떻게 이뤄내는지 구체적 수치로 보여준다.
핵심 요약
2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 클록 속도 상승(4.5GHz에서 5.2GHz, 15% 증가)만으로는 이 정도 성능 향상을 설명할 수 없으며, 아키텍처 개선이 주요 원인이다. 트랜지스터 수가 약 50% 증가(110억에서 160억 개)했고, 대부분이 코어 성능 향상에 투입되었다. 전체 요약 6문장 읽기 → 017 09:10 ▲ 133 · 댓글 25 .NET 11의 성능 개선 공개, 작은 최적화들 누적 마이크로소프트가 .NET 11의 성능 개선 내용을 상세히 공개했다. 인프라 · 데브옵스 · Performance Improvements in .NET 11
Key Point 매년 누적되는 성능 개선을 구체적인 최적화 사례와 벤치마크로 확인할 수 있어, .NET 기반 애플리케이션 개발자들이 버전 업그레이드의 실질적 효과를 평가하고 최적화 기법을 학습하는 데 도움이 된다.
핵심 요약
마이크로소프트가 .NET 11의 성능 개선 내용을 상세히 공개했다. 바운드 체크 제거, 불필요한 할당 최적화, 잠금 제거, 루프 사이클 감소 등 수백 개의 개선이 이루어졌다. 각 개선은 JIT 컴파일러 최적화, 메모리 할당 감소, SIMD 활용 등 여러 영역에서 축적된 결과다. 전체 요약 5문장 읽기 → 018 06:10 ▲ 148 · 댓글 24 Google의 범용 고속 정렬 알고리즘, C++ 표준 정렬보다 10배 빠름 Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 인프라 · 데브옵스 · Vectorized and performance-portable Quicksort (2022)
Key Point 단일 포터블 구현으로 모든 주요 CPU 아키텍처에서 기존 방식보다 10배 빠른 정렬을 가능하게 했으므로, 데이터베이스와 대규모 데이터 처리 애플리케이션의 성능 혁신을 기대할 수 있다.
핵심 요약
Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 단일 구현으로 AVX2, AVX-512, Arm NEON 등 6가지 명령어 세트를 지원하며, 플랫폼별 최적화 코드 재작성을 제거했다. 압축-저장(compress-store) 명령어를 활용한 파티셔닝으로 정렬 성능의 대부분을 차지하는 단계를 가속화했다. 전체 요약 5문장 읽기 → 019 03:10 ▲ 100 · 댓글 25 WebAssembly 런타임 성능 비교: 2024~2026년 추이 2019년부터 추적해온 libsodium 암호화 벤치마크로 WebAssembly 런타임 성능 변화를 측정했다. 웹 · 프론트엔드 · Performance of WebAssembly Runtimes in 2026
Key Point WebAssembly는 클라우드와 엣지 환경에서 계속 확대되는데, 이 연구는 주요 런타임들의 실제 성능 추세를 정량화했으므로 배포 환경 선택 시 근거가 된다.
핵심 요약
2019년부터 추적해온 libsodium 암호화 벤치마크로 WebAssembly 런타임 성능 변화를 측정했다. 2024년, 2025년, 2026년 각 런타임 최신 버전을 비교한 결과, Wasmer가 최고 성능을 기록했으며 WAVM, WAMR, Wasmtime이 근접했다. Wasmtime은 연평균 성능 향상(2.67배 → 2.54배 → 2.41배 네이티브 대비)을 보였고, Bun은 2026년에 2025년 대비 3배 빨라져 가파른 개선 추세를 보였다. 전체 요약 6문장 읽기 → 020 21:11 당일 +115 메모리 4분의 1만 써도 FAISS보다 빠른 벡터 검색 엔진 Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. AI · 머신러닝 · RyanCodrai/turbovec · Rust
Key Point 벡터 데이터베이스의 메모리 사용과 검색 성능은 RAG 시스템의 핵심이므로, 기존 방식 대비 4배 더 효율적이면서 더 빠른 솔루션의 등장은 프로덕션 환경 선택에 직접 영향을 미친다.
핵심 요약
Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. 1,000만 문서 기준 float32 31GB가 4GB로 압축되며 FAISS IndexPQFastScan보다 빠른 검색 속도를 낸다. 온라인 인제스트 지원으로 훈련 단계 없이 벡터를 바로 색인하고, 증분 저장으로 변경분만 동기화한다. 전체 요약 6문장 읽기 →