쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
68건 · "양자화"조건 지우기 ×
001 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 002 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 003 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 004 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 005 06:11 ▲ 26 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 006 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 007 18:11 ▲ 60 · 댓글 2 이산 토큰, 연속 표현 수준의 시각 정보 담을 수 있을까 이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. AI · 머신러닝 · Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
Key Point 이산 토큰 기반 시각 표현이 그동안 한계로 간주해온 의미 손실 문제를 실질적으로 극복했으며, 멀티모달 기초 모델의 구조 선택에 영향을 미칠 가능성이 있다.
핵심 요약
이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. 기존 가정과 달리, 양자화 오류 크기와 의미 손실 사이에는 신뢰성 있는 상관관계가 없으며, 오류가 크더라도 더 나은 이해 성능을 낼 수 있다. 이산 토큰의 실질적인 비트 예산이 다운스트림 성능의 주요 결정 요소로 나타났으며, 기존 양자화기는 코드북이 증가할수록 의미 정보 기여도가 감소해 포화 현상이 발생한다. 전체 요약 8문장 읽기 → 008 03:11 ▲ 16 · 댓글 4 Gemma 4 임베딩을 극도로 압축하는 OPTIC 기법 공개 Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. AI · 머신러닝 · Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
Key Point 대규모 언어 모델의 임베딩 매개변수가 점차 커지는 추세에서, 성능 손실을 최소화하면서 극도의 압축을 달성할 수 있는 새로운 방법을 제시한다.
핵심 요약
Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. OPTIC은 토큰마다 하나의 양자화된 코드를 저장하고, 각 층에서 층별 아핀 디코더로 디코딩하는 방식을 사용한다. 코드와 디코더는 저장된 벡터가 아닌 PLE 출력 경로에 맞춰 학습된다. 전체 요약 7문장 읽기 → 009 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 010 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 011 18:11 ▲ 149 · 댓글 53 세레브라스, 3조개 파라미터 모델을 59개 웨이퍼에 분산 배포 세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 인프라 · 데브옵스 · Cerebras Deploys Trillion-Parameter AI Models
Key Point 대규모 언어모델 추론 인프라의 실제 배포 방식을 보여주는 기술 사례로, GPU가 아닌 웨이퍼 기반 칩에서 조 단위 모델을 어떻게 효율적으로 운영하는지 알 수 있다.
핵심 요약
세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 3조 파라미터 규모의 공개 모델 키미 K3를 예시로, 4비트 양자화 기준 각 레이어는 약 16GB가 필요하다. 키미 K3의 경우 69개 선형 주의 레이어(각 웨이퍼당 2개씩 배치 가능)와 24개 밀집 레이어(각 웨이퍼당 1개씩, 나머지는 KV 캐시용)로 총 59개 웨이퍼가 필요하다. 전체 요약 8문장 읽기 → 012 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 013 06:11 ▲ 11 · 댓글 3 로컬에서 돌리는 에이전트 모델 Muse Glimmer 30B 공개 Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. AI · 머신러닝 · Muse Glimmer 30B: An On-Device Agentic Model
Key Point GPU 한 개면 충분한 수준의 에이전트 능력을 로컬에서 운영할 수 있어, 개발자들이 클라우드 비용 없이 독립적인 AI 시스템을 구축하는 방식을 바꿀 수 있습니다.
핵심 요약
Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. 일반 PC에서 클라우드 없이 독립적으로 동작하는 에이전트 모델로, 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 다단계 추론, 도구 사용, 실패 복구 능력을 통합했으며 100개 이상의 언어로 학습되었습니다. 전체 요약 6문장 읽기 → 014 00:11 ▲ 173 · 댓글 59 녹음음악, 기계의 완벽함에 잠식되다 1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 기타 · What Is Gridifcation
Key Point 음악 제작 방식이 지난 25년간 근본적으로 변했으며, 인간의 살아있는 시간과 개별성이 기계적 완벽함으로 지워지는 문제를 역사적 데이터로 처음 명확히 제시했다.
핵심 요약
1975년 빌보드 1위곡 '러브 윌 킵 어스 투게더'는 킥과 베이스가 정확히 정렬되지 않고 비규칙적인 리듬 패턴, 템포 변화를 담고 있으며 평균 130.5 BPM에서 표준편차 2.79 BPM, ±1 BPM 범위 내 32.1%의 특성을 보인다. 2025년 빌보드 1위곡 '다이 위드 어 스마일'은 평균 79 BPM에서 표준편차 0.00 BPM, 템포 변화 0회, 100% 정확도로 거의 완벽한 기계적 정밀도를 유지하고 있다. 이 현상을 '그리디피케이션'이라 하며, 인간의 공연을 사후 처리 과정에서 알고리즘 기반 양자화 도구로 보정하여 기계 같은 완벽함으로 변환하는 것을 의미한다. 전체 요약 9문장 읽기 → 015 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 016 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 017 06:11 새 버전 Ollama v0.40.8, Flint 모델 지원 추가 Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. AI · 머신러닝 · ollama/ollama@v0.40.8
Key Point Flint 모델을 새로 지원함으로써 MLX 백엔드의 모델 호환성이 확대되고, 숫자 타입 정확성이 필요한 고급 애플리케이션의 프롬프트 처리 품질이 향상된다.
핵심 요약
Ollama가 v0.40.8을 릴리스하며 MLX 기반 Flint 모델 지원을 추가했다. 소스 도구 JSON을 API 디코딩 값과 함께 보존하여 Flint가 프롬프트에서 숫자 타입과 스키마 순서를 유지할 수 있게 했다. 기존 API 마셜링은 변경되지 않았으며, Flint 외 다른 모델의 가져오기와 양자화 경로는 기존 방식을 그대로 유지한다. 전체 요약 6문장 읽기 → 018 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 019 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 020 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 021 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 022 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 023 12:11 새 버전 Ollama v0.40.6 릴리스, 실행기 최적화와 GGUF 포맷 확장 Ollama v0.40.6이 릴리스되었으며, Windows 환경에서 고아 프로세스 실행기 문제를 해결했다. AI · 머신러닝 · ollama/ollama@v0.40.6
Key Point 로컬 LLM 서버인 Ollama의 안정성 개선과 양자화 포맷 확장으로 모델 호환성이 늘어나고, 클라우드 기능이 추가되어 사용자 편의성이 증가했다.
핵심 요약
Ollama v0.40.6이 릴리스되었으며, Windows 환경에서 고아 프로세스 실행기 문제를 해결했다. GGUF 포맷에 q2_0 텐서와 파일 타입을 추가하여 양자화 지원을 확장했다. Ollama의 클라우드 서비스에서 Clef를 런칭할 수 있도록 기능을 추가했다. 전체 요약 4문장 읽기 → 024 06:11 ▲ 102 · 댓글 28 PS5에서 언어모델 서버 구축, 집 전체 기기에서 사용 PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 하드웨어 · 시스템 · Llama.cpp on a jailbroken PS5: run any GGUF model natively on the console
Key Point 탈옥 PS5를 개인 서버로 변환하여 클라우드 없이 로컬에서 언어모델을 운영할 수 있으며, TV 기반 관리 인터페이스와 기존 AI 도구와의 호환성이 실용성을 높인다.
핵심 요약
PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 콘솔의 RDNA 2 GPU와 11.4GB 공유 메모리를 활용하며, llama.cpp가 지원하는 모든 아키텍처와 양자화 기법을 사용할 수 있다. OpenAI의 /v1/chat/completions와 Anthropic의 /v1/messages API를 구현하여 기존 클라이언트(Claude Code 포함)와 호환되며, 브라우저 채팅 인터페이스도 제공한다. 전체 요약 12문장 읽기 → 025 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 026 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 027 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 028 15:11 ▲ 32 · 댓글 1 INT4 양자화로 강화학습 롤아웃 1.8배 빠르게 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
Key Point 강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다. KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다. 전체 요약 5문장 읽기 → 029 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 030 12:11 ▲ 33 · 댓글 2 확률 분포 일치로 보정 없이 확산 언어모델 양자화 확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. AI · 머신러닝 · SoloQ: Calibration-Free Quantization for Diffusion Language Models
Key Point 확산 기반 언어모델의 배포 효율성이 점점 중요해지는 상황에서, 보정 데이터 없이도 정확도를 유지하는 양자화 기법이 실무 적용 시간을 크게 단축할 수 있다.
핵심 요약
확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. 기존 양자화 방법들은 마스킹 상태와 노이징 단계마다 활성화 분포가 바뀌어 보정 데이터가 필수였다. SoloQ는 가중치와 활성화를 정규화된 회전 기저로 매핑해 예측 가능한 주변 분포를 만들고, 이를 통해 데이터 독립적 양자화를 실현한다. 전체 요약 8문장 읽기 → 031 21:11 당일 +333 마이크로소프트, 1비트 LLM 추론 프레임워크 공개 마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. AI · 머신러닝 · microsoft/BitNet · C++
Key Point CPU만으로 초대형 언어 모델을 실용적 속도로 실행할 수 있게 되면서, 엣지 디바이스와 로컬 환경에서의 LLM 배포 방식이 근본적으로 바뀔 수 있다.
핵심 요약
마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. x86 CPU에서 2.37~6.17배 속도 향상, ARM CPU에서 1.37~5.07배 향상을 달성하며 에너지 소비는 x86에서 71.9~82.2%, ARM에서 55.4~70.0% 감소한다. 100B 파라미터의 BitNet b1.58 모델을 단일 CPU에서 초당 5~7 토큰 속도로 실행 가능하다. 전체 요약 11문장 읽기 → 032 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 033 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 034 18:30 ▲ 106 · 댓글 2 선택적 정밀도로 선형 어텐션 상태 압축하는 STEPQuant Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. AI · 머신러닝 · STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 035 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 036 18:33 ▲ 20 · 댓글 2 언어모델이 분자 최적화 알고리즘을 자동 설계 양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. AI · 머신러닝 · Optimizing the Optimizer: Language Models Discover Faster Molecular Relaxation
Key Point 언어모델이 과학 계산의 핵심 병목인 분자 최적화 알고리즘을 자동으로 개선해 계산 비용을 40% 이상 줄인 사례로, AI가 직접 과학 연구 방법론을 최적화할 수 있음을 보여준다.
핵심 요약
양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. 연구팀은 언어모델 에이전트를 이용해 최적화 알고리즘 자체를 개선할 수 있는지 시도했다. 에이전트가 기존 최고 성능의 오픈소스 옵티마이저 Sella를 기반으로 자동으로 재작성하면서 힘 계산 횟수를 최소화한다. 전체 요약 6문장 읽기 → 037 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 038 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 039 18:33 ▲ 339 · 댓글 396 AI가 설계한 오픈소스 AI 가속기, openTPU 공개 AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. AI · 머신러닝 · OpenTPU – An open-source AI accelerator, developed by AI
Key Point GPU나 TPU 없이 FPGA로 LLM 추론을 달성했을 뿐 아니라, 전체 설계 과정을 오픈소스로 공개해 누구나 AI 가속기의 구조를 디코딩부터 회로까지 깊이 있게 학습할 수 있다.
핵심 요약
AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. Xilinx Kintex-7 FPGA 카드(DDR3 2채널)에서 LFM2.5-230M int8 모델 기준 디코딩 52.3 tok/s, 프리필 335.4 tok/s 성능을 달성했고, 10개 현대 모델의 실제 가중치로 테스트해 시뮬레이터와 비트 정확도로 일치함을 확인했다. 4비트 양자화(FP4 블록 스케일) 지원으로 토큰당 바이트를 약 1/3 감소시키고 디코딩 속도를 40~45% 높였으며, int8 헤드는 정확도 유지를 위해 유지했다. 전체 요약 9문장 읽기 → 040 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 041 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 042 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 043 03:11 ▲ 25 · 댓글 2 이미지·텍스트 동시 생성하는 연속형 확산 모델 공개 Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. AI · 머신러닝 · Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
Key Point 텍스트와 이미지를 진정으로 통합되는 한 가지 방식으로 모두 생성할 수 있다면, 멀티모달 모델의 아키텍처가 단순해지고 더 나은 성능을 낼 수 있다는 점을 실증한다.
핵심 요약
Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. 텍스트 블록과 이미지를 순서가 있는 연속적 하이퍼청크로 구성하며, Flow Matching을 통해 이들 위의 단일 벡터장을 학습한다. 크로스 모달 상호작용을 위해 공동 어텐션을 사용하고, 각 모달리티별 피드포워드 네트워크로 처리한다. 전체 요약 7문장 읽기 → 044 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 045 12:11 ▲ 14 · 댓글 2 LLM 긴 문맥 추론 가속, KV 캐시 저비트 양자화 기법 WUSH-KV 컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. AI · 머신러닝 · WUSH-KV: KV Cache Quantization with Data-Adaptive Transforms
Key Point 긴 문맥을 다루는 LLM의 추론 속도와 메모리 효율을 크게 개선할 수 있는 양자화 기법으로, 실제 프로덕션 환경에서 바로 적용 가능한 방법을 제시한다.
핵심 요약
컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. WUSH-KV는 행렬 곱셈의 두 인수에서 2차 통계량을 이용해 데이터 인식 변환을 구성하는 WUSH 방식을 KV 캐시에 적용한 것으로, 양자화 오류를 줄일 수 있다. 캘리브레이션 데이터로 key와 value에 대해 별도의 변환을 구성하며, value 변환은 모델 가중치에 포함시키고 key 변환은 RoPE 이후에 적용한다. 전체 요약 6문장 읽기 → 046 09:11 ▲ 12 · 댓글 2 중국어 의사결정형 AI 모델 'Chinese-Jev' 공개 System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. AI · 머신러닝 · Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
Key Point 생성형 LLM 중심의 AI 개발 흐름에서 빠른 의사결정 작업에 특화된 System One 모델의 필요성이 증대되고 있으며, 중국어 처리 시 모바일 기기까지 효율적으로 배포할 수 있는 구체적 솔루션이 제시되었다.
핵심 요약
System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. 기존 Jev 모델이 중국어 의사결정 정확도에서 제한이 있었기에, 통합 데이터 처리 및 학습 파이프라인으로 이를 보완했다. 이질적인 중국어 주석을 후보 선택지별 확률로 변환하는 데이터 처리 프로토콜을 개발해 도메인과 질문 형식 간 학습을 통일했다. 전체 요약 8문장 읽기 → 047 09:11 ▲ 108 · 댓글 62 Claude Opus 5.5의 성능 변화를 추적하는 벤치마크 공개 Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. AI · 머신러닝 · Livenerf: Has Opus 5.5 been nerfed yet?
Key Point Claude 모델의 출시 후 성능 저하 의혹이 반복적으로 제기되는 상황에서, 데이터 기반 검증 도구가 공개돼 사용자와 개발자가 실제 변화를 직접 확인할 수 있게 되었다.
핵심 요약
Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. GPQA Diamond, MMLU-Pro, 대회 수학 문제 2,336개를 선별해 때때로 정답률이 50~70% 범위에 떨어지는 78개 문항을 최종 패널로 구성했다. 매일 90개 샘플을 실행하되, 처음 10일간을 기준선으로 설정하고 이후 두 개 10일 구간에서 통계적으로 유의미한 변화를 감지한다. 전체 요약 11문장 읽기 → 048 21:11 당일 +141 당신의 PC 성능에 최적화된 오픈 모델 추천·실행 엔진 'Magnitude' Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. AI · 머신러닝 · magnitudedev/magnitude · Rust
Key Point 내 하드웨어에서 실제로 빠르게 돌아갈 오픈소스 AI 모델을 자동으로 찾아주고 최적화해주므로, 로컬에서 생성형 AI를 쓰려는 개발자와 AI 에이전트 사용자에게 필수 도구다.
핵심 요약
Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. 머신 프로파일링을 통해 당신의 하드웨어 사양을 분석한 후, 다운로드 전에 각 모델과 양자화 버전의 예상 추론 속도(tok/s)를 추정해 사용자가 최적의 모델을 선택하도록 돕는다. Ollama나 LM Studio와 달리, 사용자가 선택한 모델을 컨텍스트 크기와 추측 디코딩 등으로 정확한 하드웨어에 맞게 튜닝한다. 전체 요약 8문장 읽기 → 049 21:11 ▲ 109 · 댓글 23 극한 압축 언어모델을 마이크로컨트롤러 클러스터에서 구동 7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 하드웨어 · 시스템 · ESP32S3 cluster running 1.58-bit (BitNet) Language model
Key Point 마이크로컨트롤러 클러스터에서 극저단계 양자화 모델을 실행하는 구체적인 분산 시스템 설계와 구현 사례를 보여줌으로써, 임베디드 환경에서 LLM 배포의 가능성을 확장한다.
핵심 요약
7개의 ESP32S3 마이크로컨트롤러를 클러스터로 연결해 0.5B 규모 1.58비트 BitNet 언어모델을 분산 실행하는 프로젝트다. 마스터 노드에서 BPE 토크나이저와 임베딩을 처리하고, 6개의 컴퓨트 노드에서 24개의 트랜스포머 블록을 4개씩 나눠 실행한다. SPI 데이지-체인 방식으로 노드 간 고속 통신하며, 마스터-노드 1-노드 2...노드 6-마스터 순환 파이프라인 구조로 동작한다. 전체 요약 7문장 읽기 → 050 06:11 ▲ 65 · 댓글 3 LLM 추론을 위한 '불일치 양자화', 프롬프트와 생성 단계별 최적화 프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. AI · 머신러닝 · Disaggregated Quantization: Specializing LLM Prefill and Decode
Key Point LLM 추론의 Prefill과 Decode 두 단계에 서로 다른 양자화 전략을 적용해 정확도 손실 없이 처리 속도(첫 토큰까지 1.78배 단축)와 메모리 효율을 동시에 개선하는 방법론이 공개됐다.
핵심 요약
프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. 연구진은 '불일치 양자화'(Disaggregated Quantization, DQ)를 제안했으며, 이는 두 단계별로 계산 형식·가중치·저장소 배치를 특화시킨다. Qwen 3과 Gemma 3에서 Decode 단계의 활성화 양자화를 제거하면 생성 작업의 정확성이 향상되고 추론 비용은 증가하지 않는다. 전체 요약 8문장 읽기 → 051 22:45 당일 +276 NVIDIA Model Optimizer, 양자화·가지치기·증류 등 최적화 기법 통합 라이브러리 오픈소스화 NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. AI · 머신러닝 · NVIDIA/Model-Optimizer · Python
Key Point DL 인퍼런스 배포 시 성능과 메모리 효율을 동시에 높이려는 개발자들에게 양자화, 가지치기, 증류 등을 통합 관리할 수 있는 공식 도구가 생겼고, 오픈소스로 누구나 기여 가능해졌다.
핵심 요약
NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. Hugging Face, PyTorch, ONNX 모델을 입력받아 Python API로 최적화 기법들을 조합해 적용하고, 최적화된 양자화 체크포인트를 생성한다. 생성된 체크포인트는 TensorRT-LLM, vLLM, SGLang 등 인퍼런스 프레임워크에 바로 배포 가능하며, Megatron-Bridge 및 Hugging Face Accelerate와 통합돼 있다. 전체 요약 12문장 읽기 → 052 22:26 ▲ 13 · 댓글 2 저정밀 연산으로 LLM 강화학습 안정화, FP8 파이프라인 전체 최적화 LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. AI · 머신러닝 · Towards Full Pipeline FP8 Reinforcement Learning for LLMs
Key Point 저정밀 연산(FP8)으로 LLM 강화학습 속도를 높이면서도 BF16 수준의 안정성을 유지할 수 있게 되어, 대규모 모델의 효율적인 학습이 실무에서 더 현실적으로 가능해진다.
핵심 요약
LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. 기존 연구는 TIS 같은 보정 기법으로 훈련-추론 불일치를 해결했지만, 전체 FP8 강화학습 파이프라인에서는 여전히 심각한 불안정성이 발생한다. 문제는 훈련 중 갑작스런 엔트로피 급상승과 출력 왜곡으로 나타나는데, 근본 원인은 누적된 FP8 양자화 잡음이 중요도 비율을 왜곡해 음수 이득 토큰을 신뢰 영역 밖으로 밀어내고 그래디언트를 잘못 영점화한다는 점이다. 전체 요약 6문장 읽기 → 053 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 → 054 15:11 ▲ 32 · 댓글 3 이미지 생성 모델의 벡터 양자화 학습 안정성 개선 방법 자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. AI · 머신러닝 · StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
Key Point 이미지 생성 모델의 핵심 컴포넌트인 벡터 양자화의 학습 불안정성을 해결하는 실무적 방법론을 제시하므로, 생성형 AI 모델 개발자와 연구자에게 즉시 적용 가능한 지침을 제공한다.
핵심 요약
자동회귀 및 마스킹 이미지 생성 모델의 기초가 되는 벡터 양자화(VQ) 토크나이저는 학습 과정이 불안정하다는 문제를 지적했다. 인코더-디코더와 코드북 학습이 얽혀 있어 두 모듈이 협력할 때만 작동하므로, 학습이 가중될수록 붕괴되는 취약함이 있다. StableVQ는 동적 STE를 통해 인코더의 학습 목표를 안정화하고, 리전 VQ 손실로 코드북이 독립적으로 전체 추적을 보장하며, 분리된 스케줄로 각 모듈이 별도의 학습률을 갖도록 한다. 전체 요약 5문장 읽기 → 055 18:11 ▲ 109 · 댓글 37 gzip으로 텍스트를 생성할 수 있다 정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. AI · 머신러닝 · Can gzip be a language model?
Key Point 기존의 대규모 학습된 신경망 없이 순수 표준 라이브러리만으로 언어 모델이 동작하는 방식을 보여주며, 압축과 예측의 수학적 동치성을 실제로 구현한 흥미로운 증명이다.
핵심 요약
정보 이론에서 압축은 예측과 동치이므로, 신경망 없이 OS의 gzip 압축기만으로 언어 모델처럼 동작할 수 있다. gzip은 최근 텍스트의 32KiB 슬라이딩 윈도우에서 매칭을 찾아 압축하는데, 이를 확률 점수로 변환할 수 있다. 코퍼스를 gzip의 윈도우에 포함시켜 프라임한 후, 후보 텍스트를 덧붙여 압축했을 때의 길이를 측정해 점수를 매긴다. 전체 요약 6문장 읽기 → 056 12:10 ▲ 112 · 댓글 57 개인 하드웨어에서 돌리는 프론티어급 AI, 학계가 주도한다 연구의 기본 단위가 논문에서 상호작용하는 오픈소스 생태계로 변했다. AI · 머신러닝 · Frontier AI on Your Own Hardware
Key Point 대형 모델을 개인 하드웨어에서 돌릴 수 있게 되면서 연구의 주도권이 GPU 자산이 많은 곳에서 혁신적 도구를 만드는 곳으로 이동하고 있기 때문이다.
핵심 요약
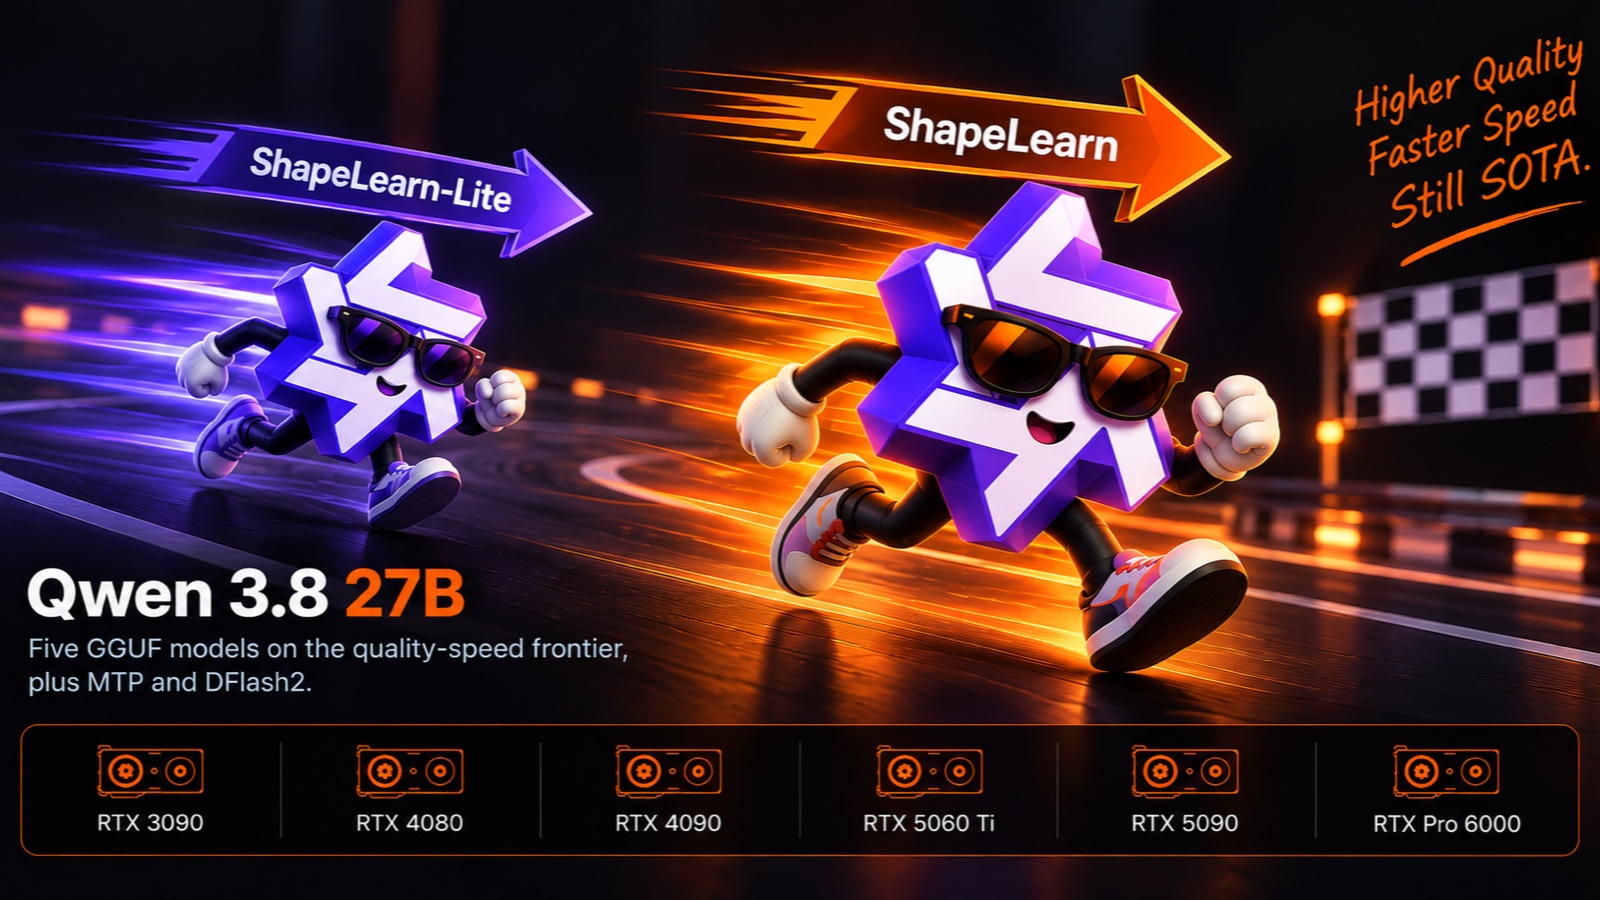
연구의 기본 단위가 논문에서 상호작용하는 오픈소스 생태계로 변했다. 에이전트로 인해 1년 걸리던 연구가 주 단위에 끝나면서 개별 논문 중심 연구는 더 이상 가치 있는 연구가 아니 된 것이다. 대학 연구팀이 24GB GPU 한 장에서 1250억 파라미터 모델을, MacBook에서 5500억 파라미터 모델을 실행할 수 있게 하는 프레임워크를 공개했다. 전체 요약 6문장 읽기 → 057 21:10 ▲ 100 · 댓글 38 Qwen 3.8 27B 최적화 모델, 13.1GB VRAM에서 99.63% 성능 ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. AI · 머신러닝 · Shapelearn Qwen 3.8 27B (13.1 GB VRAM)
Key Point 로컬에서 대규모 언어 모델을 최소 메모리로 효율적으로 운영하려는 개발자들에게 실질적인 선택지를 제시하는 벤치마크 기준을 제공한다.
핵심 요약
ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. GPU-5(IQ4_XS, 3.84bpw)는 13.1GB VRAM에서 BF16 기준 99.63% 정확도를 유지하며 90.4 토큰/초의 속도를 낸다. 메모리가 제한적이면 GPU-4(IQ3_S, 11.0GB)를 추천하며, 이는 98.72% 성능을 내면서 더 빠르다. 전체 요약 5문장 읽기 → 058 09:10 ▲ 150 · 댓글 49 27B 모델을 5.9GB로 압축, 98% 성능 유지 Qwen 3.8 27B 기반의 Ternary Bonsai 2 27B를 출시했으며, 삼진법 가중치와 FP16 그룹 스케일링으로 5.9GB 용량에 압축했다. AI · 머신러닝 · Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint
Key Point 로컬 기기에서 대형 모델을 실용적으로 실행할 수 있는 경계가 넓어지며, 에너지 효율과 배포 가능성의 균형이 어디까지 갈 수 있는지를 보여주기 때문입니다.
핵심 요약
Qwen 3.8 27B 기반의 Ternary Bonsai 2 27B를 출시했으며, 삼진법 가중치와 FP16 그룹 스케일링으로 5.9GB 용량에 압축했다. 전체 정밀도 모델 대비 9배 이상 작으면서 98.2% 성능을 유지하며, 262K 토큰 컨텍스트 윈도우와 멀티모달 기능을 지원한다. 추론, 코딩, 비전, 에이전트 도구 사용 등에서 성능 저하를 최소화해 장시간 작업이나 다단계 처리에 유리하다. 전체 요약 6문장 읽기 → 059 09:10 ▲ 117 · 댓글 11 3진 LLM 압축의 1.585비트 벽을 깬다 3진 LLM의 가중치는 {-1, 0, +1} 세 개 심볼로만 저장되며, 기존 5진-트릿 패킹 방식은 가중치당 1.625비트가 소요된다. AI · 머신러닝 · Breaking the 1.58-bit Barrier for Ternary LLMs
Key Point 3진 LLM의 저장 용량을 근본적으로 줄이는 압축 기법으로, 엣지 기기부터 서버까지 추론 성능을 즉시 개선할 수 있다.
핵심 요약
3진 LLM의 가중치는 {-1, 0, +1} 세 개 심볼로만 저장되며, 기존 5진-트릿 패킹 방식은 가중치당 1.625비트가 소요된다. 29개 3진 LLM 모델을 분석하면 영(0)이 최대 51.5%를 차지해 심볼이 균등하지 않게 분포한다. BITCOS 레이아웃은 영(0) 밀도에 따라 적응적으로 압축하며, 가중치당 (2 - z)비트를 사용한다. 전체 요약 5문장 읽기 → 060 21:11 당일 +247 YAML 한 줄로 LLM 학습하는 Soup, 4GB GPU에서 8B 모델 실행 Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. AI · 머신러닝 · MakazhanAlpamys/Soup · Python
Key Point 로컬 저사양 GPU에서도 대규모 언어모델을 효율적으로 학습할 수 있는 실용적인 도구로, 인프라 복잡성을 제거하고 싶은 개발자와 연구진이 참고해야 한다.
핵심 요약
Soup는 YAML 설정 파일 하나로 LLM 파인튜닝과 포스트트레이닝을 실행하는 CLI 도구다. 레이어 스트리밍 기술로 8B 모델을 4GB 노트북 GPU에서 학습할 수 있으며, RTX 3050에서 119.6 tok/s, 3.32GB 피크 메모리로 동작한다. SSH 설정 없이 로컬 GPU에서 QLoRA로 훈련 가능하며, 배치 크기와 양자화 등을 자동으로 처리한다. 전체 요약 6문장 읽기 → 061 08:25 당일 +113 RTX 5090 전용 고성능 추론 엔진 NInfer 공개 Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 인프라 · 데브옵스 · Neroued/ninfer · C++
Key Point 단일 고사양 GPU에서 대규모 언어모델의 최고 속도 추론이 필요한 개발자나 기업에게 선택지를 제공하며, 양자화된 모델로도 높은 처리량을 유지하는 최적화 기법이 무엇인지 보여줍니다.
핵심 요약
Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 텍스트, 이미지, 동영상 입력을 지원하며 로컬 CLI 또는 OpenAI/Anthropic 호환 HTTP API로 제공됩니다. RTX 5090에서 최대 8개 동시 요청을 처리할 수 있으며 1-8개 활성 요청의 고정 용량으로 특화되어 있습니다. 전체 요약 6문장 읽기 → 062 21:10 당일 +216 YuE2: 악보 편집으로 완성도 높은 음악 생성 가사와 스타일 설명만으로 멜로디-코드 악보를 자동 작성한 후 보컬과 반주가 포함된 완성 곡을 생성한다. AI · 머신러닝 · multimodal-art-projection/YuE · Python
Key Point 악보를 중간 단계로 하는 '화이트박스' 음악 생성 방식으로, 사용자가 생성 과정을 직접 검사·편집할 수 있는 새로운 제어 방식을 제시한다.
핵심 요약
가사와 스타일 설명만으로 멜로디-코드 악보를 자동 작성한 후 보컬과 반주가 포함된 완성 곡을 생성한다. 악보를 악곡 형식(ABC)으로 읽고 수정 가능해 사람이나 에이전트가 직접 편집할 수 있다. 기존 곡을 악보로 변환한 뒤 새로운 스타일로 재해석하는 제로샷 커버와, 대화 기반 에이전트 편집을 지원한다. 전체 요약 5문장 읽기 → 063 21:11 당일 +115 메모리 4분의 1만 써도 FAISS보다 빠른 벡터 검색 엔진 Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. AI · 머신러닝 · RyanCodrai/turbovec · Rust
Key Point 벡터 데이터베이스의 메모리 사용과 검색 성능은 RAG 시스템의 핵심이므로, 기존 방식 대비 4배 더 효율적이면서 더 빠른 솔루션의 등장은 프로덕션 환경 선택에 직접 영향을 미친다.
핵심 요약
Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. 1,000만 문서 기준 float32 31GB가 4GB로 압축되며 FAISS IndexPQFastScan보다 빠른 검색 속도를 낸다. 온라인 인제스트 지원으로 훈련 단계 없이 벡터를 바로 색인하고, 증분 저장으로 변경분만 동기화한다. 전체 요약 6문장 읽기 → 064 21:11 ▲ 218 · 댓글 31 OpenRouter 사용할 때 마주칠 9가지 함정 OpenRouter를 통해 같은 모델을 호스팅하는 20개 제공자들이 벤치마크에서 크게 달라지는데, 예를 들어 DeepSeek V4 Flash의 도구 호출 성능이 제공자별로 58~81%까지 20포인트 이상 차이난다. AI · 머신러닝 · So you want to use OpenRouter?
Key Point 같은 모델의 가중치를 사용해도 제공자별로 성능, 기능 호환성, 에러 처리가 크게 달라서 OpenRouter를 사용하는 개발자는 제공자 선택과 에러 대응 코드를 신중하게 고려해야 한다.
핵심 요약
OpenRouter를 통해 같은 모델을 호스팅하는 20개 제공자들이 벤치마크에서 크게 달라지는데, 예를 들어 DeepSeek V4 Flash의 도구 호출 성능이 제공자별로 58~81%까지 20포인트 이상 차이난다. 일부 비전 모델은 같은 모델 가중치를 쓰는데도 특정 제공자에서는 이미지를 인식하지 못하거나 오류를 반환하면서도 200 OK를 보내는 문제가 발생한다. reasoning.effort 파라미터가 모든 제공자에서 작동하지 않으며, 동일한 프롬프트에 대해 제공자별로 추론 토큰 생성이 일관되지 않다. 전체 요약 6문장 읽기 → 065 21:11 당일 +125 당신의 하드웨어에 맞는 LLM 찾아주는 도구 llmfit Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. AI · 머신러닝 · AlexsJones/llmfit · Rust
Key Point 로컬에서 LLM을 실행하려는 개발자들이 자신의 하드웨어 사양에 정확히 맞는 모델을 찾기 어려운 문제를 직접 해결해주는 도구이기 때문이다.
핵심 요약
Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. GGUF·AWQ·GPTQ·EXL2 등 다양한 양자화 포맷을 지원하며 메모리 사용량과 토큰 속도를 예측한다. 인터랙티브 TUI, 웹 대시보드, REST API 엔드포인트 중 선택해 사용할 수 있다. 전체 요약 5문장 읽기 → 066 11:10 당일 +849 WiFi 신호로 심박수·호흡 감지하는 오픈소스 센싱 플랫폼 WiFi 라우터의 신호 변화를 캡처해 카메라 없이 사람 감지, 호흡·심박수 측정, 움직임 추적을 수행하는 Rust 기반 오픈소스 플랫폼 RuView를 공개했다. 오픈소스 · 도구 · ruvnet/RuView · Rust
Key Point 프라이버시를 보장하면서 저비용 WiFi 센서로 생체신호를 측정할 수 있는 오픈소스 기술이 등장했으며, 기존 스마트홈 시스템과의 통합으로 실제 활용 가능성을 제시하고 있다.
핵심 요약
WiFi 라우터의 신호 변화를 캡처해 카메라 없이 사람 감지, 호흡·심박수 측정, 움직임 추적을 수행하는 Rust 기반 오픈소스 플랫폼 RuView를 공개했다. ESP32(9달러 수준) 센서와 Channel State Information(CSI)를 이용해 벽을 통과한 신호를 분석하며, 8KB 크기의 양자화 모델로 라즈베리파이에서 마이크로초 단위로 처리된다. 수면 단계 분류, 낙상 감지, 제스처 인식 등 21개 센서 항목을 제공하고, Home Assistant, Apple Home, Google Home, Alexa 등 주요 스마트홈 생태계에 통합된다. 전체 요약 5문장 읽기 → 067 11:10 당일 +125 로컬에서 빠르게 LLM 실행하는 llama.cpp, 고성능 추론 엔진 llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. AI · 머신러닝 · ggml-org/llama.cpp · C++
Key Point 하드웨어 요구사항이 낮으면서도 다양한 플랫폼을 지원해 개인 PC에서도 대형 언어모델을 효율적으로 운영할 수 있다는 점이 실무에서 중요해지고 있다.
핵심 요약
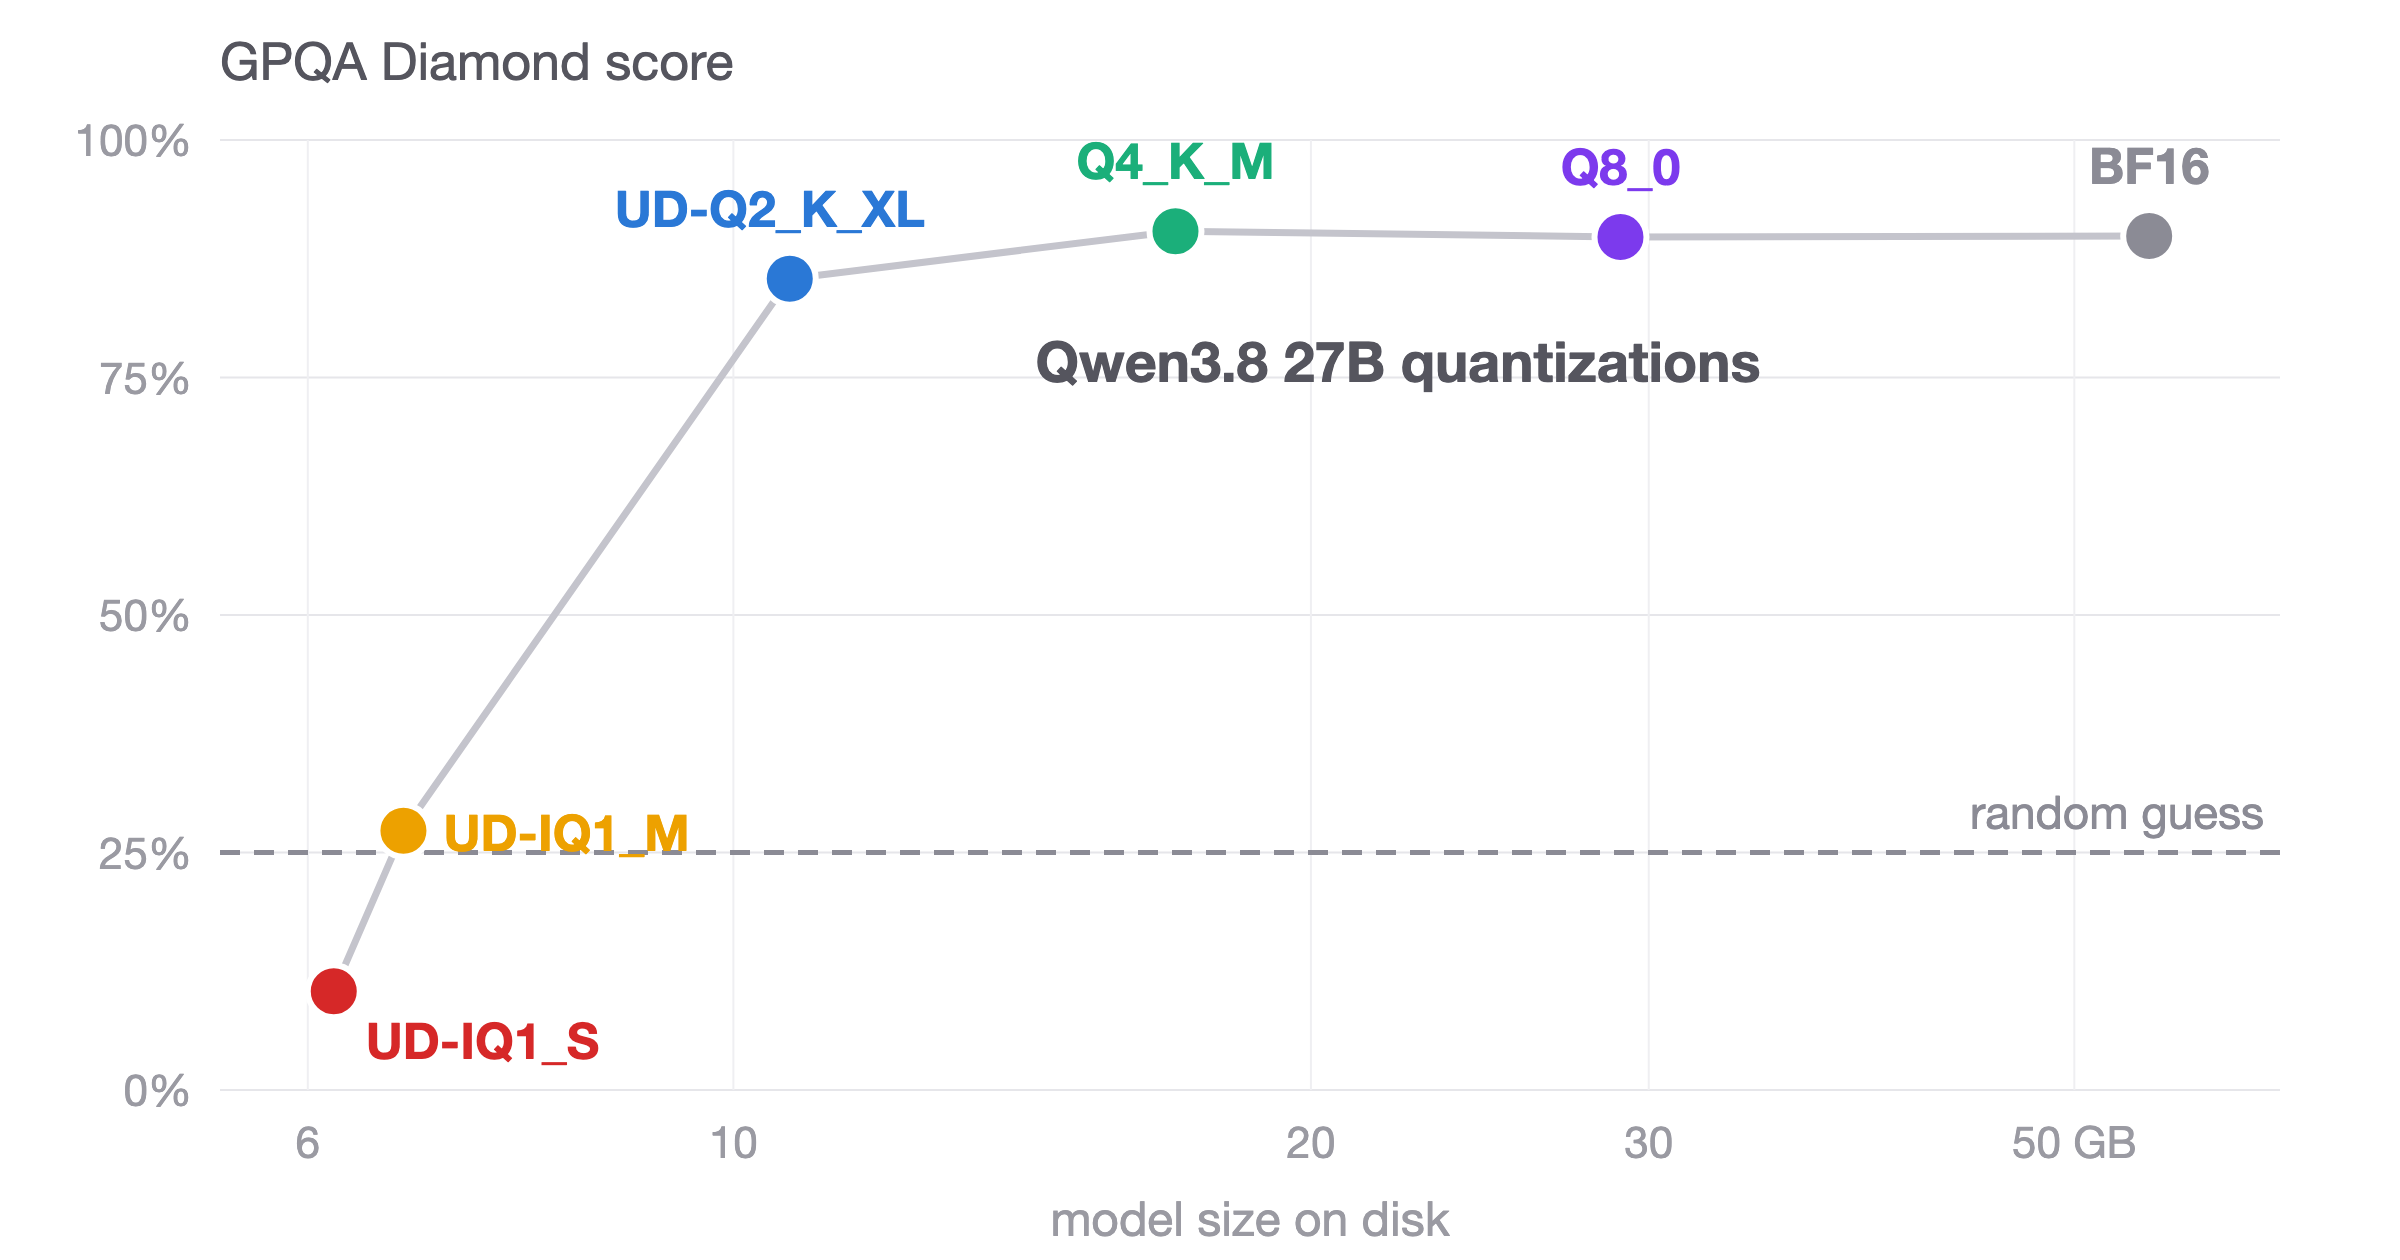
llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. Apple Silicon의 Metal, ARM NEON, x86의 AVX/AVX512, RISC-V의 RVV 등 각 플랫폼별 명령어세트를 지원해 효율성을 극대화했다. 1.5~8비트 정수 양자화를 통해 추론 속도를 높이고 메모리 사용량을 줄일 수 있으며, NVIDIA GPU(CUDA), AMD GPU(HIP), Intel NPU 등 14개 이상의 백엔드를 지원한다. 전체 요약 4문장 읽기 → 068 08:12 ▲ 218 · 댓글 107 Qwen 3.8 27B, 4비트 양자화까지는 성능 유지 원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. AI · 머신러닝 · Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses
Key Point 로컬에서 대형 언어 모델을 실행할 때 양자화 정도별로 실제 성능이 어떻게 달라지는지 벤치마크로 확인한 첫 실측 데이터라, 제한된 GPU 메모리 환경에서 모델 선택을 할 때 직접적인 참고 기준이 된다.
핵심 요약
원본 모델 55GB에 비해 4비트 Q4_K_M(17GB)은 Terminal-Bench 2.1 등 주요 벤치마크에서 동일한 성능을 유지한다. RTX 4090(24GB) 같은 소비자 GPU에서도 약 64k 토큰 컨텍스트를 남기며 실행 가능하다. 2비트 양자화는 조금 낮은 성능을 보이지만 10.7GB로 감소하고 실용적 수준을 유지한다. 전체 요약 6문장 읽기 →