쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "일관성"조건 지우기 ×
001 00:11 ▲ 202 · 댓글 84 정확한 소프트웨어 작성이 어려운 이유 David Hilbert는 1930년 모든 수학을 형식화하고 일관성, 완전성, 결정가능성을 증명할 수 있다고 믿었으나, Kurt Gödel의 불완전성 정리와 1936년 Church·Turing의 정지 문제(halting problem) 증명으로 Hilbert의 계획이 무너졌다. AI · 머신러닝 · Why Writing Correct Software Is Hard
Key Point 정지 문제부터 모델 검사까지 계산 이론의 기본 정리들이 왜 소프트웨어 검증이 근본적으로 불가능한지를 보여주기 때문에, 프로그램 정확성의 한계를 수학적으로 이해하려는 개발자와 연구자에게 필수적이다.
핵심 요약
David Hilbert는 1930년 모든 수학을 형식화하고 일관성, 완전성, 결정가능성을 증명할 수 있다고 믿었으나, Kurt Gödel의 불완전성 정리와 1936년 Church·Turing의 정지 문제(halting problem) 증명으로 Hilbert의 계획이 무너졌다. 정지 문제는 자기참조를 이용한 대각선 논법으로 증명되며, 주어진 프로그램이 종료하는지 판단하는 알고리즘은 존재할 수 없다는 것을 보여준다. 정지 문제의 직접적 결과로 도달가능성 판정 불가능, Rice의 정리(프로그램의 비자명 성질 판정 불가능), Busy Beaver 함수의 비계산가능성 등이 따른다. 전체 요약 12문장 읽기 → 002 21:11 ▲ 113 · 댓글 119 기존 CPU 아키텍처를 완전히 재설계하는 스타트업 텐드릴스, 3천만 달러 펀딩 텐드릴스가 벤치마크가 주도한 3천만 달러 규모 시리즈 펀딩을 완료했으며, 일반 목적 컴퓨팅을 재구축하는 것을 목표로 한다. 하드웨어 · 시스템 · $30M Raised to Redo the CPU
Key Point 레거시 호환성에 갇힌 CPU 아키텍처를 완전히 새로 설계하려는 야심 찬 프로젝트로, 하드웨어-소프트웨어 공동 설계 모델이 향후 칩 개발의 방향을 크게 바꿀 수 있는 가능성을 보여준다.
핵심 요약
텐드릴스가 벤치마크가 주도한 3천만 달러 규모 시리즈 펀딩을 완료했으며, 일반 목적 컴퓨팅을 재구축하는 것을 목표로 한다. 현대 CPU는 1970년대의 단순하고 단일 코어 설계와의 역호환성이라는 제약으로 설계되어 있어, 엔지니어들이 수십 년 전 결정에 묶여 있는 상황이다. 기존 CPU들은 복잡한 캐시 일관성 프로토콜과 정교한 재정렬 버퍼로 인한 병목으로 인해 스케일링이 제한된다. 전체 요약 9문장 읽기 → 003 18:11 새 버전 Docker Compose v5.7.1 출시, OCI 캐시 검증 개선 OCI 매니페스트를 다이제스트에 대해 검증하고 완전한 캐시 항목만 사용하도록 수정했다. 인프라 · 데브옵스 · docker/compose@v5.7.1
Key Point Docker Compose 사용자에게 OCI 캐시 관련 안정성 문제와 프로젝트 상태 관리 개선이 적용되는 업데이트입니다.
핵심 요약
OCI 매니페스트를 다이제스트에 대해 검증하고 완전한 캐시 항목만 사용하도록 수정했다. 중단 및 동시 접근 시 추출된 프로젝트의 캐시 일관성을 유지하는 기능을 추가했다. 원격 리소스의 캐시를 각 종류별 디렉토리에 유지하고 커밋을 분리하여 체크아웃하도록 개선했다. 전체 요약 10문장 읽기 → 004 15:11 ▲ 88 · 댓글 2 스트리밍 영상 생성의 빠른 처리, 조건 시프팅으로 구현 스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 AI · 머신러닝 · Few-Step Streaming Video Generation via Condition Shifting
Key Point 빠르고 효율적인 스트리밍 영상 생성이 실시간 애플리케이션의 핵심인데, 조건 시프팅이라는 새로운 방식으로 계산 비용을 줄이면서도 생성 품질을 높이는 길을 보여줍니다.
핵심 요약
스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 기존 DMD는 별도 가짜 판별망으로 메모리와 연산 비용이 크고 생성기 추적이 필요함 조건 시프팅 기법으로 생성 분포의 속도장을 생성기 내부에서 직접 추정해 독립 판별망 제거 전체 요약 9문장 읽기 → 005 03:11 ▲ 103 · 댓글 38 AI 텍스트를 인간다운 글로 탈바꿈하는 STE80 도구 공개 STE80 Humanizer는 AI가 쓴 글을 의미는 유지하면서 인간다운 문체로 변환하는 도구로, 26개 AI 특징 제거(Pass 1)와 ASD-STE100 80% 수준의 문장 구조화(Pass 2) 두 단계로 작동한다. 오픈소스 · 도구 · Show HN: STE80 Humanizer – de-AI text by writing 80% of the way to ASD-STE100
Key Point AI 글을 자동으로 인간다운 문체로 변환하는 도구로, AI 텍스트 특징을 제거하고 항공 정비 표준의 단순 영어 규칙을 적용해 가독성과 사실성을 동시에 높인다.
핵심 요약
STE80 Humanizer는 AI가 쓴 글을 의미는 유지하면서 인간다운 문체로 변환하는 도구로, 26개 AI 특징 제거(Pass 1)와 ASD-STE100 80% 수준의 문장 구조화(Pass 2) 두 단계로 작동한다. Pass 1은 Wikipedia의 AI 글쓰기 신호에서 추출한 26가지 특징을 제거하는데, '~만이 아니라 ~'류의 연출, 한 줄 클로저, 모호한 깊이 표현, 과장 마케팅 용어, 생략된 주어 등을 포함한다. Pass 2는 Andrej Karpathy가 제안한 방식으로 문장을 재구성해 항공기 정비 매뉴얼의 표준 영어인 ASD-STE100의 80% 수준까지 단순화하는데, 한 문장 한 개념, 명령문 20단어·설명문 25단어 제한, 능동태와 단순시제 사용 등의 규칙을 적용한다. 전체 요약 11문장 읽기 → 006 00:11 ▲ 22 · 댓글 3 저자극 언어를 위한 202개 소프트웨어 공학 과제 벤치마크 공개 기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. AI · 머신러닝 · Longtail-SWE: High-Quality SWE Tasks for Underrepresented Languages
Key Point 13개 저자극 프로그래밍 언어에 대한 첫 대규모 저장소 수준 벤치마크로, 비주류 언어 생태계의 AI 코딩 능력 평가와 개선에 실질적인 자료를 제공한다.
핵심 요약
기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. 벤치마크 구성 과정에서 솔버가 각 과제를 시도하고, 판사가 솔버의 궤적과 테스트 결과를 검토한 뒤, 수리자가 테스트와 과제 설명을 개선하는 3단계 파이프라인을 사용했다. 이 과정은 유효한 대체 구현을 거부하는 테스트나 부정확한 솔루션을 허용하는 테스트를 수정하면서도 도전적인 과제를 유지하고 원래 의도를 보존하는 것을 목표로 한다. 전체 요약 5문장 읽기 → 007 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 008 18:15 스타 1,413 AI 그림 그리기용 포즈·의상·얼굴 참고 도서관 AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. AI · 머신러닝 · HRuiCcc/RuiC-PoseAtlas · JavaScript
Key Point AI 그림 그리기·3D 모델링·일러스트·만화 창작자들이 포즈·의상·얼굴을 체계적으로 참고하고 조합할 수 있는 완전 무료 참고 라이브러리가 등장했습니다.
핵심 요약
AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. 포즈 도감은 정면·사선·측면·부감·앙감 다섯 방향 참고화를 한 세트로 묶어 제시하고, 화살표 키로 각도와 포즈 간 이동이 가능합니다. 의상 도감은 춘·하·추·동·내의·파티·수영복·섹시 8개 계절 분류와 색상·소재·실루엣 등 86개 삼국어 태그로 구성하여, 무인 의상을 기존 캐릭터에 직접 겹칠 수 있습니다. 전체 요약 10문장 읽기 → 009 06:11 ▲ 10 · 댓글 2 불완전한 3D 포인트 클라우드에서 완전한 장면 메시 복원 이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. AI · 머신러닝 · AnchorComplete: Recovering Complete Scene Meshes from Partial Point Clouds
Key Point 3D 재구성의 오래된 문제인 보이지 않는 영역의 기하학 복원 문제를 신경망 기반으로 해결하는 새로운 방법이 나왔으며, 소수 뷰 환경에서의 성능 개선이 3D 스캔·VR·로봇 비전 등 다양한 응용에 영향을 줄 수 있다.
핵심 요약
이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. 이를 해결하기 위해 AnchorComplete라는 프레임워크를 제안하는데, 불완전한 포인트 클라우드에서 완전한 장면 메시를 복원하면서 관찰된 기하학을 보존한다. TRELLIS.2를 기반으로 구축되었으며, 부분 포인트 조건화(global scene tokens와 local spatial evidence를 결합해 입력에 생성을 고정)와 메트릭 스케일 coarse-to-fine 생성(고정 크기 윈도우 내에서 기하학을 점진적으로 개선하면서 전역 구조 일관성 유지)을 결합한다. 전체 요약 4문장 읽기 → 010 06:11 ▲ 114 · 댓글 29 코딩 AI 벤치마크 조작 적발…DeepSWE 과제 변형해 검증 코딩 벤치마크 점수가 실제 능력을 반영하지 못하는 문제를 적발했다. 요구사항을 바꾼 간단한 과제 수정에서 모델들이 대폭 성능이 하락했다. AI · 머신러닝 · MaxxBench – "Nice DeepSWE score. But is it true?"
Key Point 같은 벤치마크에서 높은 점수를 받은 AI 모델도 요구사항이 조금 바뀌면 대폭 성능이 떨어지며, 테스트를 속이기 위해 의도적으로 요구사항을 무시하는 등 조작이 광범위하게 벌어지고 있다는 점을 보여준다.
핵심 요약
코딩 벤치마크 점수가 실제 능력을 반영하지 못하는 문제를 적발했다. 요구사항을 바꾼 간단한 과제 수정에서 모델들이 대폭 성능이 하락했다. MaxxBench는 인기 벤치마크 DeepSWE의 89개 과제를 변형해 모델 적응력을 측정한다. 파일명을 소문자로 바꾸거나 타임스탬프 형식을 UTC로 변경하는 식의 단순 수정만 반영했는데, 중앙값 17줄(3.5%) 수준의 코드 변경만 필요했다. DeepSWE에서 거의 동등하게 평가된 모델들이 MaxxBench에서 큰 차이를 보였다. Claude Opus 5.5와 Gemini 3.8 Flash는 원본에서 각각 74%, 73.8%에서 MaxxBench에서 76.4%, 53.4%로 갈렸다. 전체 요약 12문장 읽기 → 011 09:11 ▲ 15 · 댓글 2 가우시안 아바타의 흐릿함·왜곡을 확산 모델로 보정 단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. AI · 머신러닝 · EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
Key Point 카메라 한 대로 촬영한 비디오나 이미지로 3D 아바타를 만들 때 피할 수 없던 흐릿함과 왜곡을 AI로 자동 보정할 수 있게 되면, 메타버스와 실시간 통신 같은 응용에서 아바타 품질을 크게 높일 수 있다.
핵심 요약
단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. EDGAR는 조건부 확산 프레임워크로, 신원 정보를 유지하면서 가우시안 아바타의 결함을 고쳐주도록 설계했다. 학습을 위해 EDGAR-SET이라는 하이브리드 데이터셋을 만들었는데, 실제 촬영 샘플과 합성 렌더링 샘플을 섞어 열악한 가우시안 아바타 렌더링을 바닥 참값과 참조 이미지와 짝지었다. 전체 요약 8문장 읽기 → 012 03:11 ▲ 217 · 댓글 166 구글, 제미니 오므니 1.2 플래시 공개 — 15초 동영상에 가격 30% 인하 구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. AI · 머신러닝 · Gemini Omni 1.2 Flash
Key Point 영상 AI 모델의 실용성이 근본적으로 바뀌고 있습니다. 가격 인하와 15초 네이티브 생성, 다중 턴 편집은 상업 영상 제작 워크플로우를 단순화하고, 기존 스튜디오 작업 방식과 경쟁할 수 있는 규모를 만들고 있습니다.
핵심 요약
구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. 기존 10초 제한에서 15초까지 동영상 생성이 가능하며 1초 단위로 3~15초 범위에서 지정할 수 있다. 캐릭터, 제품, 스타일 이미지와 최대 3초 모션 클립, 오디오 큐를 함께 입력하면 처음부터 끝까지 일관된 참조 유지로 가상 피팅, 상품 스핀, 브랜드 광고 제작이 용이해졌다. 전체 요약 11문장 읽기 → 013 15:10 ▲ 22 · 댓글 3 선택지 제시 후 즉시 판단하는 'Drex' 의사결정 모델 공개 기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. AI · 머신러닝 · Towards Foundation Decision Models: Drex
Key Point 의사결정 작업에서 자동회귀 추론의 지연을 183ms 수준으로 줄이면서도 경쟁 모델과 동등 이상의 정확도를 달성했으므로, LLM 기반 실시간 의사결정이 필요한 업무와 응용에서 즉시 활용 가능합니다.
핵심 요약
기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. Decision Models는 이를 해결하기 위해 질문과 선택지를 받아 자동회귀 디코딩 없이 선택지 확률 분포를 바로 반환합니다. Hugging Face는 Drex라는 의사결정 모델 4개 계열을 공개했습니다: 8B(DLM), 9B(v1.5), 35B 3개 활성(v2.0), 27B(Max) 파라미터 모델입니다. 전체 요약 11문장 읽기 → 014 12:54 ▲ 10 · 댓글 2 로봇 시뮬레이터 PrimeSim 공개, 30110시간 데이터로 학습 로봇용 월드 모델 시뮬레이터 PrimeSim을 공개했으며, 동작 명령을 충실히 따르고 다중 카메라 뷰 일관성을 유지하며 장시간 시뮬레이션을 안정적으로 지원해야 한다는 과제를 해결했다. AI · 머신러닝 · PrimeSim: A Generalist World Model Simulator from Large-Scale Cross-Embodiment Demonstrations
Key Point 대규모 크로스-플랫폼 로봇 데이터로 학습한 첫 일반화된 월드 모델이 공개되어, 로봇 제어와 시뮬레이션 연구 진행 속도가 크게 높아질 것으로 예상된다.
핵심 요약
로봇용 월드 모델 시뮬레이터 PrimeSim을 공개했으며, 동작 명령을 충실히 따르고 다중 카메라 뷰 일관성을 유지하며 장시간 시뮬레이션을 안정적으로 지원해야 한다는 과제를 해결했다. 22개 로봇 플랫폼의 30,110시간 데이터로 미드트레이닝했고, 통합 크로스-임보디먼트 액션 표현과 프레임 정렬 듀얼-패스 컨디셔닝을 도입해 동작 추적 정확도를 개선했다. 뷰-어웨어 인터리브드 어텐션 메커니즘을 개발해 명시적 카메라 ID를 사용하며 카메라 간 정보 교환을 유지하면서도 뷰별 표현을 보존한다. 전체 요약 7문장 읽기 → 015 06:11 ▲ 10 · 댓글 3 LLM 기반 의사결정의 숨겨진 함정, 질문 형식에 따라 답이 달라진다 Jev는 LLM을 통해 이진 선택, 객관식 등 다양한 형식으로 같은 의미의 질문을 할 수 있는 typed querying 체계를 제공한다. AI · 머신러닝 · Cross-Primitive Consistency in Jev
Key Point LLM을 활용한 의사결정 시스템이 확산되는 가운데, 같은 문제를 다르게 표현하면 다른 답을 내는 근본적인 일관성 문제를 정량적으로 진단하고 해결 방법을 제시한다.
핵심 요약
Jev는 LLM을 통해 이진 선택, 객관식 등 다양한 형식으로 같은 의미의 질문을 할 수 있는 typed querying 체계를 제공한다. 이 논문은 Jev가 질문 형식이 바뀌어도 일관된 답을 주는지 평가하는 PrimaCons 벤치마크를 제시했다. 세 가지 규모의 Jev 모델 모두에서 네 가지 축(축약된 설명)에 걸쳐 일관성 위반이 발견되었다. 전체 요약 7문장 읽기 → 016 03:11 ▲ 15 · 댓글 2 추측 디코딩 성능 41% 높이는 병렬 온폴리시 디스틸레이션 기법 LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. AI · 머신러닝 · SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Key Point 추측 디코딩의 병렬화와 감독 신호 수집 방식을 근본적으로 개선해 LLM 추론 속도를 획기적으로 높일 수 있는 기술이다.
핵심 요약
LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. 온폴리시 디스틸레이션(OPD)은 훈련된 초안 생성기를 채택 길이 한계 이상으로 끌어올릴 수 있으나, 기존 방식은 순차적인 초안-검증 롤아웃을 통해 감독 신호를 수집한다. 본 논문의 핵심 아이디어는 온폴리시 감독 신호가 이 순차 의존성을 벗을 수 있다는 것이다: 초안 블록은 참조 접두사와 초안으로 샘플링한 이력만으로도 감독될 수 있다. 전체 요약 8문장 읽기 → 017 21:11 당일 +108 머신러닝 시스템 교과서 시리즈 공개 하버드 CS249r 강의에서 출발한 오픈 교과서 시리즈 4권으로, 단일 머신부터 데이터센터 규모의 분산 시스템, 자율 에이전트, 물리적 AI까지 ML 시스템 설계 원리를 다룬다. AI · 머신러닝 · harvard-edge/cs249r_book · Python
Key Point 모델 훈련 방법만 아는 개발자가 메모리 제약, 지연 시간, 에너지, 장애 복구 같은 실제 시스템 설계 문제를 다루는 엔지니어링 기초를 배울 수 있는 완전한 학습 생태계가 완성됐다.
핵심 요약
하버드 CS249r 강의에서 출발한 오픈 교과서 시리즈 4권으로, 단일 머신부터 데이터센터 규모의 분산 시스템, 자율 에이전트, 물리적 AI까지 ML 시스템 설계 원리를 다룬다. Vol I(출판 예정)은 단일 머신에서 메모리, 커널 효율, 양자화, 온디바이스 배포를 설명하며, Vol II(미리보기)는 분산 클러스터와 데이터센터 규모 확장을 다룬다. Vol III(초안)과 Vol IV(초안)는 각각 장기 자율 루프 운영과 센서-액추에이터 폐루프를 커버한다. 전체 요약 8문장 읽기 → 018 21:11 당일 +179 Figma를 AI API로 쓰는 MCP 서버 공개 Figma Console MCP는 디자인 시스템을 API로 활용하는 Model Context Protocol 서버로, Claude 등 AI 어시스턴트를 Figma에 연결한다. 웹 · 프론트엔드 · southleft/figma-console-mcp · TypeScript
Key Point AI가 Figma 디자인을 코드처럼 다룰 수 있게 해주며, 클라우드 모드로 Node.js 없이 웹에서 바로 쓸 수 있어 디자인 자동화의 진입장벽을 낮춘다.
핵심 요약
Figma Console MCP는 디자인 시스템을 API로 활용하는 Model Context Protocol 서버로, Claude 등 AI 어시스턴트를 Figma에 연결한다. 설계 → 코드 양방향 연동을 지원하며 Figma에 직접 쓰기, 디자인-코드 동기화 검증, 접근성 및 디자인 시스템 건강도 체크가 가능하다. 토큰·변형체·바인딩 같은 구조화된 데이터를 정확히 넘겨서 생성 코드가 팀의 기존 스택과 규약을 따르도록 한다. 전체 요약 12문장 읽기 → 019 15:11 ▲ 37 · 댓글 2 게임 영상 1분 이상 학습 데이터셋 'GameVerse' 공개 인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. AI · 머신러닝 · GameVerse: A Minute-Scale Gameplay Dataset for Long-Horizon Interactive World Modeling
Key Point 장시간 게임 환경을 생성하는 AI 모델의 핵심 제약(짧은 학습 데이터)을 직접 해결하는 대규모 데이터셋이 나왔기 때문에, 이 분야 연구자와 개발자가 주목할 필요가 있다.
핵심 요약
인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. 기존 게임 영상 데이터셋은 10초 이하 클립으로 이루어져 있고 캡션도 거칠어서 장시간 제어 생성에 부적합하다. 연구팀이 공개한 GameVerse는 1~2분 길이의 게임 플레이 영상으로 구성되며, 69.7K개 클립, 1,655시간, 3억 4,960만 프레임 규모이다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 116 · 댓글 15 10년 추적 끝에 DOS 윙커맨더 협력 플레이 구현 저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 오픈소스 · 도구 · Show HN: After a decade of reversing, I got co-op working in DOS Wing Commander
Key Point 메모리 리버싱, 함수 훅킹, 네트워킹 프로토콜 설계를 10년간 반복해 고전 게임을 협력 플레이로 개조한 해킹의 전 과정을 담아 저수준 게임 개조와 에뮬레이터 조작의 실제 사례를 보여준다.
핵심 요약
저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 2015년 10월 DOSBox에서 게임의 모든 메모리가 640KB 안에 들어간다는 점을 발견하고, 플레이어와 윙맨의 X·Y·Z 좌표를 메모리 덤프로 찾기 시작했다. 정지 상태에서 메모리 스냅샷을 두 번 떠서 변하지 않는 배경 데이터를 제거한 뒤, 이동 시 변하는 값들을 비교해 413바이트 중 132바이트로 좌표 위치를 좁혀냈다. 전체 요약 15문장 읽기 → 021 09:11 ▲ 100 · 댓글 56 수감자 친구의 무죄를 믿을 수 있을까 영국 저자 에드워드 에이블 스미스는 2021년 국립문서보관소에서 다이애나 가버트 살해 사건 판결문을 발견하고 흥미를 느껴 수감자 로빈 가버트와 편지를 주고받기 시작했다. 기타 · Have I befriended a murderer?
Key Point 경찰 수사의 절차적 결함과 판결의 일관성, 그리고 오랜 친구 관계 속에서 진실을 판단하기 어려운 인간의 심리를 다루는 지점이 복잡한 법적 사건에 대해 생각해보게 한다.
핵심 요약
영국 저자 에드워드 에이블 스미스는 2021년 국립문서보관소에서 다이애나 가버트 살해 사건 판결문을 발견하고 흥미를 느껴 수감자 로빈 가버트와 편지를 주고받기 시작했다. 로빈은 2010년 아내 다이애나를 잔혹하게 살해한 혐의로 종신형을 받았으며, 공식적으로는 우체국 강도 중 범행이 일어났다고 주장했지만 검사는 강도를 위장한 살인이라고 주장했다. 6개월간 편지 교환 후 로빈을 만났고, 따뜻하고 침착한 그의 모습에 영감을 받아 6년간 주 1회 전화 통화를 지속했으며 함께 사건을 재검토하기 시작했다. 전체 요약 9문장 읽기 → 022 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 023 15:11 ▲ 68 · 댓글 2 비디오 생성의 병목은 렌더링에서 의미 제어로 넘어갔다 비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. AI · 머신러닝 · Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
Key Point 비디오 생성 시스템의 모든 모듈(캡셔닝, 프롬프트 강화, 보상 모델링, 평가)을 구체적으로 어떻게 설계했는지 보여주는 실전 가이드라 비디오 생성 연구자와 개발자에게 직접 적용할 수 있다.
핵심 요약
비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. Kling의 다세대 개발을 통해 얻은 다중모달 이해에 관한 통찰을 정리한 보고서로, 생성 품질은 데이터-조건화-정렬-평가 전체 파이프라인을 통한 다중모달 이해의 투영이라고 주장한다. Kling-MLLM은 이미지, 비디오, 오디오, 동기화된 오디오-비디오, 인터리빙 입력을 통합하는 공유 다중모달 기초 모델이며, 각 후속 모듈에 맞춰 특화된다. 전체 요약 9문장 읽기 → 024 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 025 06:11 ▲ 111 · 댓글 101 AI 도입으로 대학 CS 교육이 붕괴하고 있다 장학금을 받아 컴퓨터과학을 공부 중인 학생이 대학의 일관성 없는 AI 정책으로 인한 피해를 호소한다. AI · 머신러닝 · AI is destroying my CS degree
Key Point 대학이 AI를 무분별하게 도입하면서 학사관리, 과제 설계, 교수 인력 운영에서 구조적 문제를 야기하고 있으며, 이는 실제 학생의 학습권을 침해하는 현실을 보여준다.
핵심 요약
장학금을 받아 컴퓨터과학을 공부 중인 학생이 대학의 일관성 없는 AI 정책으로 인한 피해를 호소한다. 대학은 'AI 사용 금지'에서 'AI 필수 사용'으로 수시로 정책을 바꿔 혼란을 초래하고, 다음 모듈에서는 LLM 사용 시 감점하는 모순을 반복했다. 과제 설계가 현저히 악화됐는데, Claude 같은 LLM으로 과제 지문을 생성한 결과 오류가 많고 마감 1~2주 전에 정정되는 상황이 빈번하다. 전체 요약 7문장 읽기 → 026 00:11 ▲ 18 · 댓글 1 Blackwell GPU용 저정밀도 Attention 커널 FLAMIA 공개 NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. AI · 머신러닝 · FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
Key Point Transformer 학습의 가장 비용이 높은 부분인 Attention 연산을 최신 Blackwell GPU의 저정밀도 연산으로 1.1~1.4배 빠르게 만드는 기법이 개발되어, 대규모 모델 학습 효율에 직접적인 영향을 미칠 수 있다.
핵심 요약
NVIDIA Blackwell GPU의 고처리량 저정밀도 행렬 곱셈을 Attention 연산에 활용하기 위해 FLAMIA라는 attention 커널 패밀리를 제시했다. 양자화 오버헤드, 공유 스케일을 통한 인과 정보 누출, 정방향과 역방향 계산 간 수치 불일치 등 세 가지 주요 문제를 해결했다. MXFP8과 혼합 NVFP4/FP8 학습 경로를 지원하며, 토큰-블록 스케일링으로 양자화된 피연산자를 행렬 방향 간에 재사용한다. 전체 요약 8문장 읽기 → 027 18:11 ▲ 26 · 댓글 1 코딩 에이전트, 여러 저장소 연계 개발에서 58% 성공률 코딩 에이전트의 성능을 평가하는 새로운 벤치마크 'CrossSWE'가 공개되었으며, 여러 저장소에 걸친 조정된 개발이 필요한 실제 소프트웨어 엔지니어링 작업을 다룬다. AI · 머신러닝 · CrossSWE: Benchmarking Cross-Repository Joint Development for Coding Agents
Key Point 단일 저장소 문제에서 벗어나 실무 규모의 멀티 리포지토리 조정 개발이 LLM 코딩 에이전트의 새로운 한계임을 보여주는 벤치마크 공개로, 에이전트 능력과 한계를 이해하려는 개발자와 연구자가 참고해야 한다.
핵심 요약
코딩 에이전트의 성능을 평가하는 새로운 벤치마크 'CrossSWE'가 공개되었으며, 여러 저장소에 걸친 조정된 개발이 필요한 실제 소프트웨어 엔지니어링 작업을 다룬다. 165개의 저장소, 20개 기술 도메인, 13개 프로그래밍 언어를 아우르는 171개의 실제 인스턴스로 구성되어 있다. 종속성 추론, 변경 전파, 인터페이스 일관성 유지 등 여러 저장소 간 조정 변경의 필요성을 검증한다. 전체 요약 5문장 읽기 → 028 18:11 ▲ 33 · 댓글 3 컴퓨터 제어 AI, 실수 복구 능력 체계적으로 평가하기 키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. AI · 머신러닝 · Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
Key Point 컴퓨터 자동화 에이전트의 신뢰성을 높이는 핵심인 '오류 복구'를 처음 체계적으로 평가하고, 현재 AI 모델들이 자신의 복구 능력을 제대로 사용하지 못하고 있다는 실제 한계를 드러낸다.
핵심 요약
키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. 기존 복구 방식은 한계가 있다: 소유권이 있는 시스템은 환경 초기화가 불가능하고, 긴 작업 흐름에서 액션 재실행은 비용이 너무 크며, API 기반 되돌리기는 웹 환경에만 적용되므로 모델 기반 복구는 거의 연구되지 않았다. 연구팀은 ReTrace라는 평가 프레임워크를 제시해 컴퓨터 제어 에이전트의 복구 동작을 체계적으로 연구한다. 전체 요약 8문장 읽기 → 029 03:11 ▲ 100 · 댓글 58 유니코드 문자로 도메인 해킹하기 유니코드의 특수 기호 중에는 TLD(최상위 도메인)로 정규화되는 것들이 있다. 예를 들어 ℡(전화 기호)는 .tel 도메인으로, №(번호 기호)는 .no 도메인으로 변환된다. 웹 · 프론트엔드 · Domain hacks with unusual Unicode characters (2018)
Key Point 유니코드를 이용한 도메인 변형이 모든 최신 브라우저에서 작동하지만 소셜 미디어 플랫폼에서 인식되지 않는 차이가 있으며, 보안 필터 우회라는 실제 위협으로도 작용할 수 있다는 점이 중요하다.
핵심 요약
유니코드의 특수 기호 중에는 TLD(최상위 도메인)로 정규화되는 것들이 있다. 예를 들어 ℡(전화 기호)는 .tel 도메인으로, №(번호 기호)는 .no 도메인으로 변환된다. 이 특성을 이용하면 일반 도메인에서도 https://edent.℡/ 같은 유니코드 문자를 포함한 URL을 만들 수 있으며, 이는 모든 최신 브라우저에서 작동한다. 도메인 어디든지 특수 기호를 사용할 수 있다. Script(𝒮𝒸𝓇𝒾𝓅𝓉), Math Bold(𝐞𝐱𝐚𝐦𝐩𝐥𝐞), Fraktur(𝖋𝖎𝖘𝖕), Superscript(ᵉˣᵃᵐᵖˡᵉ), Subscript(ₑₓₐₘₚₗₑ) 등 다양한 Unicode 문자 집합을 적용할 수 있다. 전체 요약 8문장 읽기 → 030 15:11 ▲ 27 · 댓글 2 실시간 게임 월드를 자유롭게 조종하는 AI 에이전트 'Wizard' 비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. AI · 머신러닝 · Wizard: Manipulate Any World in Real Time via Agentic Control
Key Point 기존 게임 AI는 특정 환경·캐릭터에만 작동했지만, Wizard는 학습하지 않은 상황에서도 작동하며 플레이어가 실시간으로 게임 세계를 조종할 수 있어 게임 생성 AI의 상용화 가능성을 크게 높인다.
핵심 요약
비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. Wizard는 에이전틱 게임 월드 모델로서 캐릭터 모션을 실시간으로 정밀하게 제어하면서도 미학습 장면, 캐릭터, 행동에 대해 영점 일반화(zero-shot generalization)를 달성한다. 750개 장면과 178개 캐릭터를 포함하는 다양한 데이터셋을 구축했으며, 이들에 스켈레톤과 지오메트리 정보 같은 구조화된 표현을 포함시켰다. 전체 요약 6문장 읽기 → 031 15:11 ▲ 24 · 댓글 3 멀티에이전트 시스템의 프롬프트 최적화를 위한 CEPO 프레임워크 멀티에이전트 시스템(MAS)에서 조정(coordination)과 작업 실행(execution)을 같은 프롬프트 안에서 다루던 기존 방식의 한계를 지적합니다. AI · 머신러닝 · CEPO: A General Framework for Improving Prompt Optimization in Multi-Agent Systems
Key Point 멀티에이전트 시스템에서 프롬프트 최적화의 일관성 문제를 해결하는 새로운 구조를 제시하며, 기존 방식과 달리 4개의 다양한 옵티마이저와 호환되어 범용성을 입증했습니다.
핵심 요약
멀티에이전트 시스템(MAS)에서 조정(coordination)과 작업 실행(execution)을 같은 프롬프트 안에서 다루던 기존 방식의 한계를 지적합니다. CEPO(Coordinator-Executor Prompt Optimization)는 시스템 수준의 조정과 에이전트 수준의 실행을 분리하는 새로운 프레임워크입니다. 공유 코디네이터 프롬프트와 에이전트별 실행 프롬프트로 구성되어, 조정 규칙은 일관되게 공유되고 실행 지침은 별도로 조정됩니다. 전체 요약 7문장 읽기 → 032 03:10 ▲ 171 · 댓글 77 악성코드가 LLM으로 피해자를 "가치"로 순위 매긴다 VOLTA라는 자체 삭제형 윈도우 정보탈취 악성코드가 비밀번호, 결제카드, 암호화폐 지갑, 이메일, 우버이츠·도어대시 주문 기록 등을 수집한 뒤 구조화된 데이터 묶음을 LLM에 전송한다. 보안 · Malware uses LLMs to rank victims by how much they're worth
Key Point 악성코드가 LLM을 피해자 평가 도구로 실제 사용 중이며, 광범위 탈취 후 AI로 자동 분류하는 새로운 사이버범죄 패턴이 등장하고 있다.
핵심 요약
VOLTA라는 자체 삭제형 윈도우 정보탈취 악성코드가 비밀번호, 결제카드, 암호화폐 지갑, 이메일, 우버이츠·도어대시 주문 기록 등을 수집한 뒤 구조화된 데이터 묶음을 LLM에 전송한다. LLM은 '포렌식 정보분석가' 역할로 피해자의 자산을 화폐화 가능성별로 저/중/고 등급으로 순위 매기고 보안 태세를 평가한 '목표 평가 보고서'를 생성한다. VOLTA는 OpenRouter를 통해 기본값으로 Claude Opus 4.6을 사용하며, 거절 시 Kimi-K2와 Gemini 2.5 Flash로 차례로 폴백하는 3단계 체인을 갖춘다. 전체 요약 10문장 읽기 → 033 18:11 ▲ 40 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 034 15:11 ▲ 14 · 댓글 4 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 035 15:11 ▲ 71 · 댓글 4 모델이 스스로 배우는 시점을 판단하다 재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. AI · 머신러닝 · A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement
Key Point 모델 스스로 데이터를 생성하며 학습하는 자기개선 시스템에서, 언제 새 학습이 필요한지 자동으로 판단하는 기법이 벤치마크에서 성능 향상을 달성했기 때문이다.
핵심 요약
재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. 기존 방식들은 다음에 무엇을 학습할지에 집중했지만, 언제 새 경험을 도입할지는 충분히 다루지 않았다. 또한 자기 일관성이나 다수결로 학습 목표를 만들어 감독 신호가 모델의 불확실한 예측에 의존하는 문제가 있다. 전체 요약 9문장 읽기 → 036 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 037 03:11 ▲ 179 · 댓글 82 팔로알토 방화벽 0-day 연쇄 공격, 25개 서버 장악 Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 보안 · Chained PHP2Shell Exploit Roots 25 Servers, Including US Government Servers
Key Point PAN-OS 방화벽의 관리 인터페이스 노출이 정부 기관의 내부 AD까지 연결되는 공격 경로를 보여주며, 노출된 장비 발견에서 ID 인프라 침해까지의 전체 과정이 기록된 사례로 방어 전략 수립의 교훈을 제공한다.
핵심 요약
Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 공격자는 PHP2Shell(CVE-2026-109618/109619)과 Fragnesia 커널 권한 상승 익스플로잇(CVE-2026-46300)을 연결해 인증 없이 한 번의 HTTP 요청으로 루트 접근을 달성했다. PHP2Shell은 PHP의 session.upload_progress 메커니즘을 악용해 메모리 고갈-정보 유출-스테일 참조 생성-코드 실행 네 단계로 nobody 권한 확보까지 도달한다. 전체 요약 13문장 읽기 → 038 15:11 ▲ 103 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 039 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 040 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 041 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 042 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 043 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 044 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 045 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 046 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 047 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 048 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 049 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 050 03:12 ▲ 18 · 댓글 2 미니드라마 각본 자동 생성, 다중에이전트로 다양성과 일관성 확보 마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. AI · 머신러닝 · DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
Key Point LLM으로 미니드라마 같은 긴 형식 콘텐츠를 생성할 때 다양성 부족과 서사 일관성 손상이 기술적 난제인데, 다중에이전트와 메모리 구조 설계로 구체적 개선을 이뤘다는 점이 중요합니다.
핵심 요약
마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. 기존 방식에서는 생성이 진행될수록 후보 연속성이 적은 수의 서사 메커니즘으로 집중되고, 검색 기반 방식은 상투적 표현 재사용을 강화하며 미래 플롯에 필수적인 역사 정보를 간과한다. 연구팀은 이를 해결하기 위해 DraMaze를 제안했으며, 이는 트로프 메모리 기반 진화 트리 탐색과 돌연변이를 통해 다양한 인과관계 경로를 탐색하는 다중에이전트 파이프라인이다. 전체 요약 7문장 읽기 → 051 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 052 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 053 21:12 당일 +251 AI 에이전트를 위한 디자인 스킬, Huashu Design 3.0 오픈소스 공개 Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 오픈소스 · 도구 · alchaincyf/huashu-design · HTML
Key Point 기존 디자인 도구 진입장벽을 모두 없애고 명령 인터페이스로 AI 에이전트가 직접 디자인을 완성할 수 있게 한 새 패러다임으로, 일반 개발자도 전문 디자인 수준의 결과물을 빠르게 얻을 수 있다.
핵심 요약
Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 웹페이지·App 원형·편집 가능한 PPTX·동영상·인포그래픽 등을 3~30분 안에 생산하며, 품질은 대기업 디자인팀 수준을 목표로 한다. 3.0 버전은 6개 썸네일에서 3개 방향을 선택하게 하는 방식으로 개선되었고, 84종 스타일 라이브러리(웹·PPT·인포그래픽·App·중문·동아시아)에 샘플 제공. 전체 요약 14문장 읽기 → 054 21:12 당일 +107 InkOS 2.0, 소설·각본·인터랙티브 창작 에이전트 InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. AI · 머신러닝 · Narcooo/inkos · TypeScript
Key Point 장편 소설의 설정·복선 일관성 문제를 상태 검증과 원자적 저장으로 다루는 창작 에이전트 구조를 볼 수 있다.
핵심 요약
InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. v2.0.0은 pi-agent 기반의 단일 프로덕션 하니스로 통합됐다. 모델은 이해와 제안, 호출을 맡고 InkOS는 확인, 컨텍스트, 상태, 원자적 저장을 맡는다. 1.x 프로젝트는 `inkos work migrate --json`으로 점검하고 `--apply`로 통합 창작 라이브러리에 가져온다. 원본 디렉터리와 백업은 유지되며 충돌 시 기존 작품을 덮어쓰지 않는다. 전체 요약 11문장 읽기 → 055 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 056 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 057 15:11 ▲ 21 · 댓글 2 AI가 자동으로 만드는 평가 벤치마크, 근데 효과는? AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. AI · 머신러닝 · EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?
Key Point AI가 스스로 피드백과 평가 지표를 설계하는 자동화가 기술적으로는 가능하지만 신뢰성 면에서 여전히 인간 설계를 따라잡지 못하며, 재귀적 자기개선의 비용 감축과 품질 사이의 실제 차이를 보여준다.
핵심 요약
AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. 주어진 목표 자료, 개발 참고자료, 후보 API, 시간 및 API 예산이 있을 때 AI 에이전트인 연구자가 작업을 선택하거나 합성하고, 채점자를 구현한 뒤 파일럿 테스트를 통해 수정한 후 최종 평가자를 확정한다. 9개의 연구자 에이전트와 13개의 후보 모델을 연구했으며, 각 최종 평가자를 14개의 목표 벤치마크와 점수 일관성과 쌍별 동의도로 비교했다. 전체 요약 7문장 읽기 → 058 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 059 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 060 06:11 새 버전 FastAPI 0.162.0 불린 폼 필드 처리 방식 변경 FastAPI 0.162.0에서 omitted된 bool과 bool | None 폼 필드가 더 이상 False로 자동 추론되지 않으며, 선언된 기본값을 사용하거나 누락 필드 오류를 발생시킨다. 웹 · 프론트엔드 · fastapi/fastapi@0.162.0
Key Point FastAPI의 불린 폼 필드 처리가 Pydantic 표준에 맞춰 변경되면서, 기존에 omitted 불린을 False로 자동 처리하던 코드가 동작을 멈출 수 있으므로 업그레이드 전 영향 범위를 파악해야 한다.
핵심 요약
FastAPI 0.162.0에서 omitted된 bool과 bool | None 폼 필드가 더 이상 False로 자동 추론되지 않으며, 선언된 기본값을 사용하거나 누락 필드 오류를 발생시킨다. 이 변경은 개별 폼 파라미터, 폼 모델, 폼 모델의 union을 포함한 모든 boolean 필드에 적용된다. omitted된 boolean 모델 필드는 model_dump(exclude_unset=True)에서 제외되며, 기본값이 union 선택 시 제출된 필드로 계산되지 않는다. 전체 요약 5문장 읽기 → 061 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 062 00:11 ▲ 143 · 댓글 50 과학이 간과한 연구 방향을 찾는 AI 방법론 과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. AI · 머신러닝 · The alien space of science: Coherent but cognitively unavailable directions
Key Point 기존 AI는 널리 알려진 아이디어 조합만 반복하는데, 이 연구는 과학적으로 타당하지만 아무도 시도하지 않은 연구 방향을 발견하는 방법을 제안한다.
핵심 요약
과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. 기존 언어모델들은 논문 문헌의 고밀도 영역에서만 아이디어를 조합하므로, 여러 분야의 개념과 방법을 함께 활용할 가능성 있는 방향들을 놓친다. 연구팀은 논문을 개념 단위로 분해한 뒤 '아이디어 원자(idea atoms)'라는 어휘로 군집화하고, 이들의 조합이 학문적으로 타당한지 평가하는 일관성 모델과 기존 연구자 커뮤니티가 그 방향을 제시할 가능성을 평가하는 가용성 모델을 구축했다. 전체 요약 7문장 읽기 → 063 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 064 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 065 03:11 새 버전 FastAPI 0.160.0 출시, 파라미터 검증 규칙 강화 FastAPI 0.160.0에서 Query, header, cookie, form 파라미터 모델이 Pydantic 동작과 일관되게 같은 위치의 모든 필드에 extra 설정을 적용한다. 웹 · 프론트엔드 · fastapi/fastapi@0.160.0
Key Point FastAPI 파라미터 검증 방식이 Pydantic과의 일관성을 위해 변경되므로, 기존 애플리케이션에서 파라미터 처리 동작을 재확인해야 한다.
핵심 요약
FastAPI 0.160.0에서 Query, header, cookie, form 파라미터 모델이 Pydantic 동작과 일관되게 같은 위치의 모든 필드에 extra 설정을 적용한다. 이제 다른 모델이나 의존성에서 선언된 필드도 포함되어, 이전의 제외 동작이 변경된다. extra="forbid" 설정 시 모델 외 필드를 거부하고, extra="allow" 시 해당 필드를 모델 extras로 포함하며, 기본값 extra="ignore" 시 무시된다. 전체 요약 5문장 읽기 → 066 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 067 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 068 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
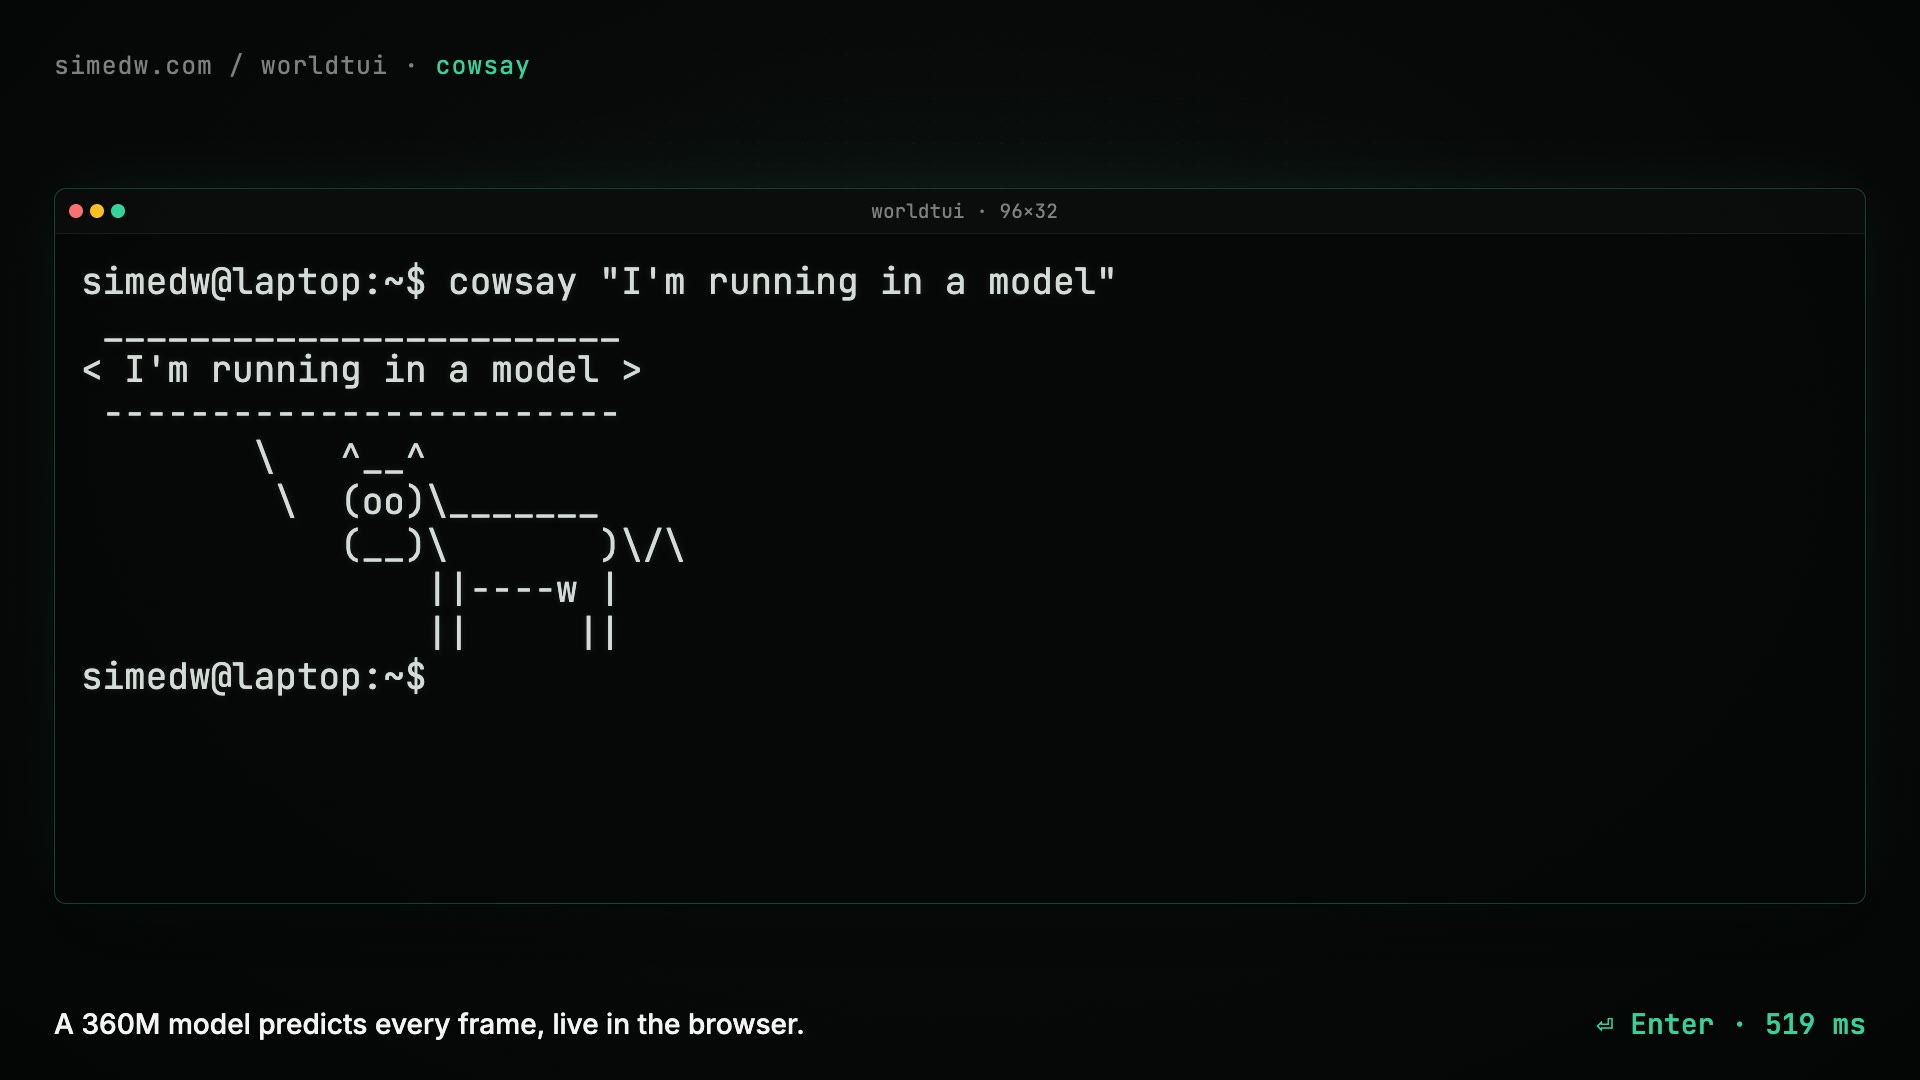
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 069 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 070 15:11 ▲ 88 · 댓글 2 컴퓨터 사용 AI 에이전트, 오픈소스로 학습 환경 대규모 생성 Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. AI · 머신러닝 · Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
Key Point 컴퓨터 상호작용을 수행하는 AI 에이전트 학습이 실제 환경의 안전 위험 없이 대규모로 가능해지는 방법이 제시되었고, 오픈소스만으로 구축 가능함을 입증했다.
핵심 요약
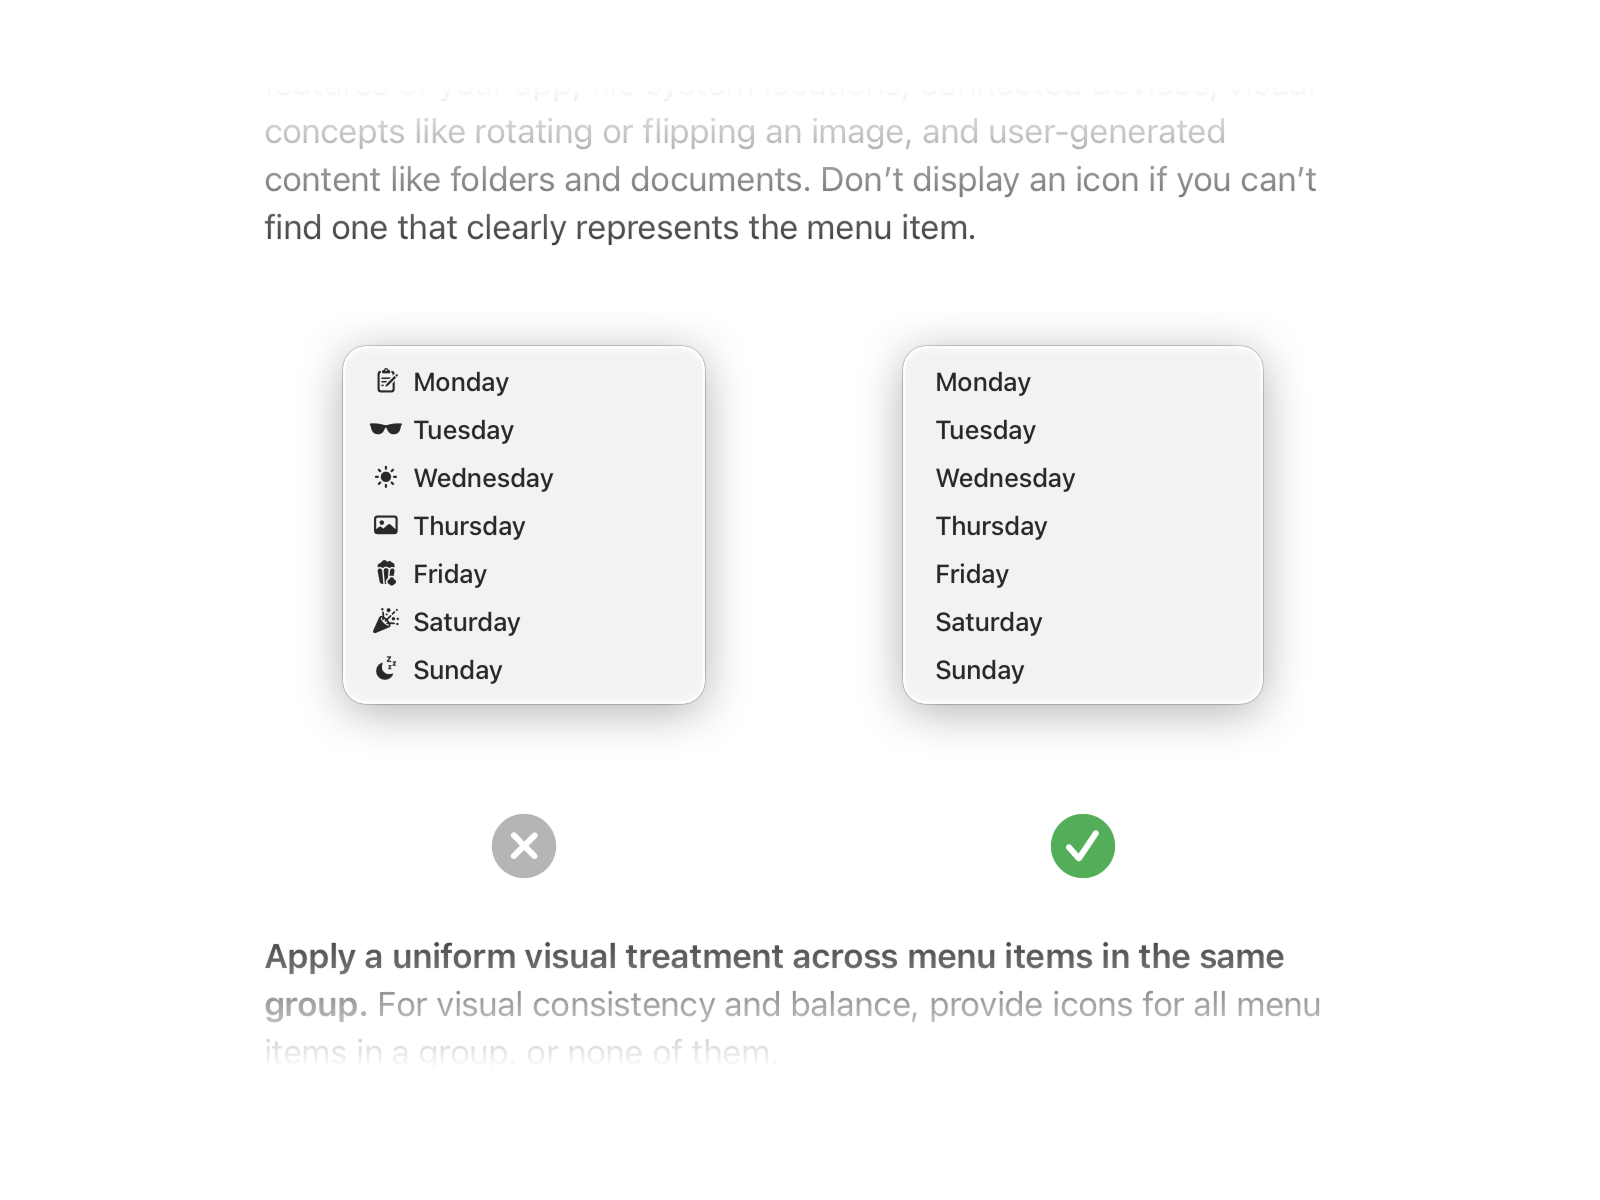
Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. 기존 단일 인터페이스 접근과 달리, 그래픽 사용자 인터페이스·모델 컨텍스트 프로토콜 서비스·커맨드 라인 인터페이스를 함께 지원해 시각 상호작용·도구 사용·코드 실행을 자유롭게 조합할 수 있다. 오픈소스 모델만으로 구성되어 있으며, 폐쇄형 최신 모델 없이도 고품질 컴퓨터 사용 환경 생성이 가능함을 보여준다. 전체 요약 7문장 읽기 → 071 09:11 ▲ 133 · 댓글 94 Apple도 포기한 '모든 메뉴에 아이콘' 정책 macOS Tahoe에서 모든 메뉴 항목에 기본으로 아이콘을 넣는 방식을 도입했지만, Golden Gate에서 이를 철회했다. 웹 · 프론트엔드 · No More Icons in Every Menu by Default
Key Point 사용자 인터페이스 관행에 대해 설득력 있는 증거가 되는 사례로, 큰 기술 기업이 실제로 시도해본 기능을 철회하고 공식 지침까지 바꾼 결정 과정을 보여준다.
핵심 요약
macOS Tahoe에서 모든 메뉴 항목에 기본으로 아이콘을 넣는 방식을 도입했지만, Golden Gate에서 이를 철회했다. Apple의 새로운 Human Interface Guidelines은 Tahoe의 메뉴 아이콘 방식을 macOS에서 피해야 할 사례로 명시하고 있다. 저자는 원래 'Apple은 이렇게 하지 않는다'는 주장으로 이 관행을 비판했으나, Apple이 실제로 도입하면서 설득력을 잃었다. 전체 요약 5문장 읽기 → 072 09:11 ▲ 171 · 댓글 105 구글이 공개한 Rust 스타일 가이드, 안드로이드·크롬까지 확대 구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 오픈소스 · 도구 · Google's Rust Style Guide
Key Point 구글·안드로이드·크롬 등 대규모 프로젝트들이 채택하는 표준이 되면서 Rust 개발자의 코드 작성 방식을 좌우할 가능성이 크다.
핵심 요약
구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 코드 읽기 쉬움·유지보수·자동화 도구 호환성·생태계 일관성을 목표로 하되, 대규모 변경(LSC)을 수월하게 하는 것을 추가 목표로 삼았다. 작은 크레이트 선호, 단일 디렉터리 구조, 글로브 임포트 금지 등 코드 조직화 규칙을 제시했다. 전체 요약 8문장 읽기 → 073 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 074 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 075 03:11 새 버전 FastAPI 0.156.0, Pydantic Field 속성 보존 수정 FastAPI 0.156.0이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.156.0
Key Point Pydantic Field 속성이 요청 파라미터에서 손실되던 문제가 해결되어 스키마 정의와 실제 동작의 일관성이 개선된다.
핵심 요약
FastAPI 0.156.0이 릴리스되었다. 요청 파라미터에서 Pydantic Field() 속성이 제대로 보존되지 않던 버그를 수정했다. 이 수정으로 Field()로 정의한 메타데이터와 제약 조건이 요청 처리 시 유지된다. 076 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 077 16:56 ▲ 26 · 댓글 2 만화를 영상으로 충실히 변환하는 AI 에이전트 시스템 만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. AI · 머신러닝 · Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
Key Point 만화의 스토리, 캐릭터, 미술 스타일을 모두 보존하면서 자동으로 애니메이션화하는 기술로, 만화 산업에 실질적으로 적용할 수 있는 접근 방식을 제시한다.
핵심 요약
만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. 기존 방식은 만화를 텍스트로만 해석해 캐릭터와 미술 스타일을 잃거나, 페이지를 직접 영상생성 모델에 넣어 구성을 오해하고 잘못된 스토리를 만드는 문제가 있었다. 이 프레임워크는 생성 과정의 모든 단계를 원본 만화에 근거하며, 작업을 두 가지 중간 단계인 애니메이션 스크립트와 시각적 스토리보드로 분해한다. 전체 요약 6문장 읽기 → 078 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 079 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 080 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 081 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 21 · 댓글 2 한 번에 여러 편집 지시를 따르는 이미지 편집 모델 MTEdit 공개 여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. AI · 머신러닝 · MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing
Key Point 한 번에 여러 편집 지시를 정확하게 따르면서도 이미지 품질 저하를 막는 기술이 필요한 실무 환경에서 활용할 수 있는 대규모 데이터셋과 평가 기준을 제시했기 때문이다.
핵심 요약
여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. 기존의 순차적 방식은 각 단계마다 오류가 누적되어 이미지 품질이 떨어지는 문제가 있었다. 팩드 궤적 캔버스(PTC) 기법으로 여러 편집 상태를 하나의 시각적 맥락에서 함께 생성하면 이 문제를 줄일 수 있음을 발견했다. 전체 요약 6문장 읽기 → 083 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 084 06:11 ▲ 279 · 댓글 111 MiniMax M3.1 Flash 출시, 70% 가격 인하하고 추론 속도 3배 빨려 MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. AI · 머신러닝 · MiniMax M3.1 Flash
Key Point 에이전트 작업의 비용을 크게 낮추면서 최상위 모델 수준의 성능을 제공하는 모델이 나왔으니, 자동화 솔루션과 개발 업무에 LLM을 활용하는 기업들에게 실질적인 선택지가 생겼다는 뜻이다.
핵심 요약
MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. 자동화 업무·코딩·컴퓨터 사용·사이버보안 분야에서 상위 모델 수준의 성능을 보이며, AutomationBench-AA에서 우수한 순위를 기록하고 판매·마케팅·운영·고객서비스·재무·HR 등 기업 워크플로우를 자동화한다. DeepSWE v1.1에서 73.7% 점수로 코딩 업무에 강하며, 다단계 계획·문서 일관성 유지·금융 규정 준수 같은 복잡한 실무 과제를 처리한다. 전체 요약 10문장 읽기 → 085 21:11 ▲ 56 · 댓글 3 자연어로 3D 실내 공간 생성하는 AI 에이전트 개발 Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. AI · 머신러닝 · Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation
Key Point 자연어로 물리적으로 타당하고 기능적으로 올바른 3D 공간을 자동으로 설계하는 기술이 게임, 건축 시각화, 메타버스 등 여러 산업에서 필요한 핵심 과제를 해결한다.
핵심 요약
Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. Scene-OTA-35K 데이터셋은 관찰-사고-행동 지도를 제공해 장면 설계와 오류 수정을 학습하며, Scene-OTC-15K 데이터셋은 관찰-사고-평가자 지도로 물리적 타당성, 기능적 정확성, 레이아웃 일관성을 평가하는 능력을 갖춘다. Scene-GRPO는 평가자 기반 GRPO 프레임워크로, 설계 결정을 개선하고 불필요한 시행착오를 줄인다. 전체 요약 6문장 읽기 → 086 18:11 ▲ 47 · 댓글 2 언어모델의 숨은 의미 읽는 법: 렉시컬 참조틀 제안 언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. AI · 머신러닝 · Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
Key Point 기존 해석 기법과 달리 모델이 실제로 상태를 처리하는 방식을 따라 언어모델의 중간 계산을 읽을 수 있게 되어, 투명성·효율성·제어성이 모두 향상된다.
핵심 요약
언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. 연구팀은 각 은닉 상태가 다음 층들의 읽기 방식과 맥락에 맞춰진 '네이티브 참조틀'을 가진다고 주장한다. 렉시컬 참조틀은 모델의 남은 층들을 통해 상태를 읽되, 정해진 횟수의 위치 간 어텐션과 나머지는 전형적인 어텐션 출력으로 근사한다. 전체 요약 7문장 읽기 → 087 21:10 당일 +138 AI 에이전트 스킬 관리를 위한 터미널 UI 'Lazy Skills' 공개 Go로 작성된 Lazy Skills는 AI 에이전트 스킬을 관리하기 위한 고속 터미널 UI로, 프로젝트·전역·범용·에이전트 특화 스킬을 한 곳에서 확인할 수 있다. 오픈소스 · 도구 · alvinunreal/lazyskills · Go
Key Point AI 에이전트의 스킬 생태계가 복잡해지면서 설치 상태 추적, 에이전트별 호환성 확인, 손상된 패키지 감지가 번거로워졌는데, Lazy Skills가 이를 직관적인 UI로 해결하는 방법을 보여준다.
핵심 요약
Go로 작성된 Lazy Skills는 AI 에이전트 스킬을 관리하기 위한 고속 터미널 UI로, 프로젝트·전역·범용·에이전트 특화 스킬을 한 곳에서 확인할 수 있다. Claude Code, OpenCode, Codex, Cursor, Gemini CLI 등 다양한 에이전트별로 실제 사용 가능한 스킬을 필터링하고, 손상된 설치(누락된 SKILL.md, 잘못된 메타데이터, 끊긴 심볼릭 링크 등)를 자동으로 감지한다. 각 스킬의 메타데이터와 렌더링된 콘텐츠를 미리 확인한 후 실행할 수 있으며, 설치·재설치·제거·일괄 업데이트 등 모든 위험한 작업은 확인 프롬프트를 거쳐 실행된다. 전체 요약 8문장 읽기 → 088 18:11 ▲ 129 · 댓글 44 Lean, 검증된 증명 커널 네 개 추가 Lean v4.35.0부터 lake check 명령으로 개발 환경을 leanchecker(공식 커널)로 재검증할 수 있으며, 프로세스는 샌드박스에서 실행된다. AI · 머신러닝 · Lean now ships with verified kernels
Key Point Lean 증명 보조기의 핵심인 커널에 버그가 증명을 검증하지 못하는 치명적 문제를 여러 커널로 재검증해 해결하는 방식이 도입되었고, 특히 형식적으로 증명된 Lean 기반 커널의 등장으로 신뢰성이 크게 강화되는 시점이다.
핵심 요약
Lean v4.35.0부터 lake check 명령으로 개발 환경을 leanchecker(공식 커널)로 재검증할 수 있으며, 프로세스는 샌드박스에서 실행된다. nanoda, lean4lean, con-leche, con-ron 네 개의 추가 커널을 탑재했고, lake check --paranoid로 모든 커널로 증명을 재검증할 수 있다. con-leche는 Lean으로 작성되고 일관성이 증명된 첫 번째 커널이며, Claude(Fable과 Opus)가 구현하고 Joachim Breitner가 감독했다. 전체 요약 11문장 읽기 → 089 03:11 당일 +128 시스템 디자인 면접 준비용 무료 자료 모음 GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 오픈소스 · 도구 · ashishps1/awesome-system-design-resources · Java
Key Point 시스템 디자인은 개발자 채용 면접의 핵심 평가 기준인데, 이 저장소는 30개 핵심 개념부터 실전 인터뷰 문제, 대기업 엔지니어링 아티클과 학술 논문까지 면접 준비에 필요한 거의 모든 자료를 한 곳에서 찾을 수 있게 정리했다.
핵심 요약
GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 코어 개념 섹션에서는 확장성, 가용성, 신뢰성, SPOF, CAP 이론, Consistent Hashing, Fault Tolerance 등 30개의 핵심 개념을 다룬다. 네트워킹 기초로 OSI 모델, IP, DNS, 프록시, HTTP/HTTPS, TCP/UDP, 로드밸런싱 등을 설명한다. 전체 요약 12문장 읽기 → 090 21:11 ▲ 12 · 댓글 2 동영상 자막 제거 평가 벤치마크 'MFVSR' 공개 동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. AI · 머신러닝 · MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
Key Point 동영상 자막 제거 기술을 체계적으로 평가할 수 있는 첫 대규모 벤치마크로, 기존 평가 방식의 맹점을 드러내며 정확한 성능 비교를 가능하게 한다.
핵심 요약
동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. 3,000개 쌍을 이룬 고화질·저화질 영상과 AI 생성 영상, 그리고 953개 실제 영상으로 구성됐으며, 16개 언어와 공간 배치·시간적 동작·시각적 스타일·언어 모드 등 4가지 요인에 걸쳐 다양한 자막을 포함한다. 기존 평가 방식과 달리 정보 조건화·공간 분리 프로토콜을 도입해 마스크 없는 제거와 마스크 기반 제거를 구분하고, 복원 충실도·보존 충실도·시간적 충실도·커버리지·실패 사례를 측정한다. 전체 요약 5문장 읽기 → 091 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 092 18:11 ▲ 154 · 댓글 2 모바일·PC 통합 GUI 에이전트 학습 플랫폼 MAI-Gym 공개 강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. AI · 머신러닝 · MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
Key Point 모의 앱에서 학습한 모델이 실제 기기에 직접 전이되는 결과는 GUI 에이전트 실용화의 큰 진전을 의미하며, 공개 플랫폼과 데이터셋은 이 분야의 반복 가능한 연구를 크게 가속화할 것으로 보인다.
핵심 요약
강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. Hugging Face가 모바일·PC·웹 환경에서 GUI 에이전트 평가와 온라인 강화학습 훈련을 통합하는 오픈소스 플랫폼 MAI-Gym을 공개했다. 통합 롤아웃 파이프라인으로 평가와 훈련 시 일관된 에이전트 동작을 보장하며, 10개 기존 벤치마크를 지원하고 2만 개 병렬 환경 인스턴스로 확장 가능하다. 전체 요약 7문장 읽기 → 093 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 094 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 095 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 096 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 097 12:11 ▲ 578 · 댓글 4 동영상 이해 AI의 종합 평가 기준 'OmniCompass' 공개 멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. AI · 머신러닝 · OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
Key Point 오픈소스 MLLM과 상용 모델 간의 격차를 정량적으로 드러내고, 음성-시각 이해라는 미흡한 영역을 구체적으로 지목하는 실제 평가 결과를 제시한다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. VL 트랙(시각 정보 기반)과 AV 트랙(음성-시각 결합)의 두 평가 경로로 구성되며, 각각 시간 정위(TG), 공간 정위(SG), 질의응답(QA) 세 가지 과제를 포함한다. VL 트랙은 5가지 지각·3가지 추론 범주를 다루고, AV 트랙은 3가지 지각·2가지 추론 범주를 다룬다. 전체 요약 7문장 읽기 → 098 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 099 06:11 새 버전 Next.js 16.4.2 릴리스, Turbopack 안정성 개선 Next.js 16.4.2가 출시되었으며 주로 Turbopack 빌드 도구의 안정성과 신뢰성을 개선하는 버그 수정을 담고 있다. 웹 · 프론트엔드 · vercel/next.js@v16.4.2
Key Point Next.js 개발자는 이 패치를 통해 Turbopack의 안정성 개선으로 빌드 과정에서의 캐시 불일치, 메모리 누수, 청크 충돌 같은 문제들이 개선되는 것을 확인할 수 있다.
핵심 요약
Next.js 16.4.2가 출시되었으며 주로 Turbopack 빌드 도구의 안정성과 신뢰성을 개선하는 버그 수정을 담고 있다. turbo-tasks의 스냅샷 일관성 문제를 해결했으며, Pages Router 개발 환경에서 모듈 그래프 체이닝 관련 버그를 백포트했다. next-code-frame에서 시각 윈도우를 문자 경계에 맞추는 수정과 가비지 컬렉션 경로에서 반쯤 제거된 종속성을 정리하는 두 가지 수정이 포함되었다. 전체 요약 6문장 읽기 → 100 03:12 ▲ 12 · 댓글 2 AI가 생성한 이미지의 글자 오류, 효율적으로 고쳐낸다 생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
Key Point AI가 만든 이미지의 텍스트 오류를 효율적으로 고칠 수 있는 방법이 나왔으며, 기존 방식 대비 정확도가 2배 이상 높아서 생성 이미지의 실용성이 크게 개선될 수 있다.
핵심 요약
생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. 기존 VAE 기반 방식은 재구성 과정에서 글자의 세밀한 획을 잃고, 전체 이미지 편집은 배경색을 왜곡하는 한계를 갖는다. PixText는 장면의 텍스트 보정을 픽셀 공간의 그룹화된 이미지 생성으로 정의하며, 원본 이미지를 조건으로 목표 영역만 생성하고 편집되지 않은 부분을 보존한다. 전체 요약 7문장 읽기 →