001 15:11 ▲ 14 · 댓글 1 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 002 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 003 12:11 당일 +156 AI가 웹사이트를 Next.js 앱으로 복제하는 템플릿 공개 AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. AI · 머신러닝 · JCodesMore/ai-website-cloner-template · TypeScript
Key Point AI 에이전트가 자동으로 웹사이트를 분석해 재구성하는 방식이 어떻게 작동하는지, 어떤 기술을 기반으로 하는지 알 필요가 있습니다.
핵심 요약
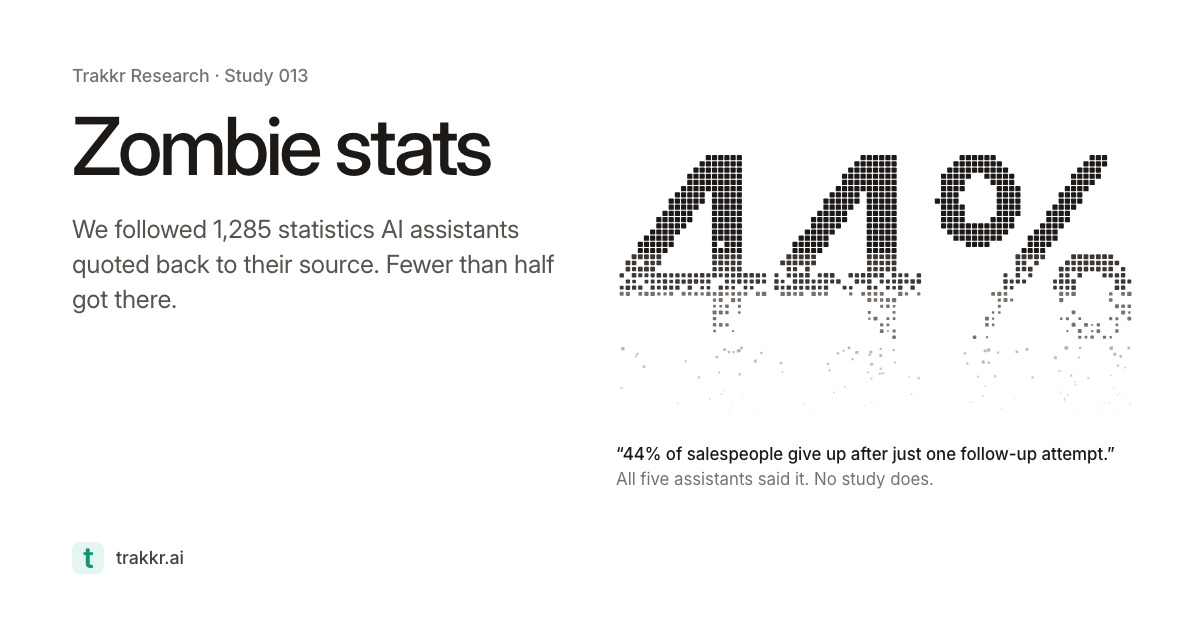
AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. Claude Code 및 Opus 5.5를 기준으로 개발했으며, Codex, Cursor, OpenCode도 지원한다. 클론 프로세스는 매핑(소스 URL을 로컬 라우트로 변환), 관찰(데스크톱·모바일 페이지 검사, 자산·폰트 추출), 빌드(컴포넌트·상호작용 구현), 비교(원본과 로컬 페이지 대조, 시각적 차이 수정) 4단계로 진행된다. 전체 요약 9문장 읽기 → 004 06:11 ▲ 117 · 댓글 58 AI 인용 통계 40%는 출처가 없다 ChatGPT, Perplexity, Gemini, Claude, Google AI Overviews에 수치 관련 질문 200개를 던지고, 인용한 1,285개 통계의 출처를 따라가며 추적했다. AI · 머신러닝 · Zombie stats: Where the numbers AI quotes come from
Key Point AI가 제시하는 통계 수치가 근거 없이 순환 인용되거나 왜곡되는 현상을 추적 조사로 구체화했으며, 사용자가 신뢰할 수 있는 정보를 구분할 수 있는 기준을 제공한다.
핵심 요약
ChatGPT, Perplexity, Gemini, Claude, Google AI Overviews에 수치 관련 질문 200개를 던지고, 인용한 1,285개 통계의 출처를 따라가며 추적했다. 각 통계마다 인용된 페이지부터 시작해 원본 연구까지 최대 5단계를 거슬러 올라갔으며, 300개 통계는 인간이 직접 재검증했다. 결과: 40%만 원본 연구를 정확히 찾았고, 8%는 연구는 찾았지만 수치나 맥락이 변했으며, 40%는 확인 불가능하고 11%는 아무 연구도 없었다. 전체 요약 12문장 읽기 → 005 03:11 ▲ 179 · 댓글 82 팔로알토 방화벽 0-day 연쇄 공격, 25개 서버 장악 Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 보안 · Chained PHP2Shell Exploit Roots 25 Servers, Including US Government Servers
Key Point PAN-OS 방화벽의 관리 인터페이스 노출이 정부 기관의 내부 AD까지 연결되는 공격 경로를 보여주며, 노출된 장비 발견에서 ID 인프라 침해까지의 전체 과정이 기록된 사례로 방어 전략 수립의 교훈을 제공한다.
핵심 요약
Dream 연구팀이 10월 25일 팔로알토 네트웍스 PAN-OS 방화벽 25대를 장악한 공격을 적발했으며, 미국 정부 계열 시스템이 포함되어 있다. 공격자는 PHP2Shell(CVE-2026-109618/109619)과 Fragnesia 커널 권한 상승 익스플로잇(CVE-2026-46300)을 연결해 인증 없이 한 번의 HTTP 요청으로 루트 접근을 달성했다. PHP2Shell은 PHP의 session.upload_progress 메커니즘을 악용해 메모리 고갈-정보 유출-스테일 참조 생성-코드 실행 네 단계로 nobody 권한 확보까지 도달한다. 전체 요약 13문장 읽기 → 006 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 007 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 008 21:11 당일 +1,199 AI 봇 팀을 채팅 앱에서 운영하는 오픈소스 플랫폼 Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. AI · 머신러닝 · milind-soni/OpenMausBot · TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 009 21:11 당일 +247 자체 인프라에서 운영하는 오픈소스 AI 에이전트 플랫폼 OpenBot CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. AI · 머신러닝 · CopilotKit/OpenBot · TypeScript
Key Point 기업이 기존 SaaS 에이전트 서비스에 의존하지 않고 자신의 인프라에서 완전히 제어 가능한 AI 에이전트 시스템을 직접 구축·운영할 수 있는 오픈소스 솔루션이 나왔다.
핵심 요약
CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. 각 에이전트(코워커)는 독립적인 브라우저, 파일 시스템, 로그인 정보를 가진 자체 컴퓨터를 보유하며 실행 전 모든 작업이 결정되고 실행 후 기록된다. AG-UI 프로토콜 기반으로 LangGraph, Mastra, CrewAI, Pydantic AI 등 다양한 에이전트 프레임워크와 호환되며, 프레임워크에 종속되지 않는다. 전체 요약 13문장 읽기 → 010 21:11 당일 +224 CapCut 대체 오픈소스 동영상 편집기 Concat 출시 Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 오픈소스 · 도구 · jub0t/Concat · Rust
Key Point 오픈소스 대안이 필요한 동영상 편집자들을 위해 로컬 처리·무제한 기능·AI 스크립팅 지원을 갖춘 완성도 높은 CapCut 대체제가 나왔다.
핵심 요약
Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 로컬 Whisper 모델로 자동 자막 생성, 텍스트-투-스피치 및 음성 복제, 배경 제거 등을 제공한다. 100개 이상의 GPU 렌더링 이펙트·필터·트랜지션, 키프레임 애니메이션(위치·스케일·회전·투명도·볼륨), 멀티트랙 타임라인을 지원한다. 전체 요약 12문장 읽기 → 011 15:11 ▲ 208 · 댓글 49 Claude Code 상태 표시줄이 토큰의 15~20% 낭비하는 이유와 해제법 Claude Code는 30초마다 백그라운드 에이전트의 전체 트랜스크립트를 모델(보통 Opus)로 보내 '최근 동작을 3~5단어로 설명'하도록 요청하며, 답은 에이전트 패널의 상태 줄만 업데이트한다. AI · 머신러닝 · Claude Code burns ~15–20% of your tokens on a 3-word status line
Key Point Claude Code의 상태 표시 기능이 전체 토큰 사용량의 최대 1/5을 낭비하고 있으며, 공식 설정으로는 비활성화할 수 없다는 점이 중요하다.
핵심 요약
Claude Code는 30초마다 백그라운드 에이전트의 전체 트랜스크립트를 모델(보통 Opus)로 보내 '최근 동작을 3~5단어로 설명'하도록 요청하며, 답은 에이전트 패널의 상태 줄만 업데이트한다. 이 agent_summary 기능은 Claude Code 전체 토큰 사용량의 15~20%(일부 측정에선 18~26%)를 차지하지만, 사용자는 끌 방법이 없다. 2.1.232버전(2026년 8월)부터 기본 활성화되었으며, OpenTelemetry export 분석으로 주 대화보다 많은 비용을 소비함이 드러났다. 전체 요약 10문장 읽기 → 012 06:11 ▲ 148 · 댓글 79 AI 에이전트는 세금 전문가가 될 수 있나 Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. AI · 머신러닝 · Dayjob: Tax – evaluating AI agents on 50 professional tax assignments
Key Point 프론티어 AI 모델이 계산은 잘해도 세금 전문가처럼 '문제가 뭔지 먼저 파악하고' '놓친 핵심을 짚어내는' 판단력은 부족하다는 점을 구체적 사례로 드러낸다.
핵심 요약
Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. Claude Sonnet 5.5가 95% 기준선에서 10.8% 통과율로 가장 높은 성과를 보였고, Claude Fable 5.1은 9.6%, Claude Opus 5.5는 9.2%의 통과율을 기록했다. 벤치마크는 개인 및 가족 세무, 소규모 사업, 파트너십, 부동산 투자, 유산 및 신탁, 국제 세무, 기업 거래, 세무 검토 및 분쟁 등 8개 분야를 포함한다. 전체 요약 10문장 읽기 → 013 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 014 00:11 ▲ 18 · 댓글 2 자동 정리 증명, 복잡한 워크플로우보다 단순 반복 루프가 더 효과적 형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. AI · 머신러닝 · h1: A Taste of the Bitter Lesson in Automated Theorem Proving
Key Point 자동화된 정리 증명에서 복잡한 설계 워크플로우 대신 단순한 에이전트 루프가 더 효과적일 수 있다는 발견은, 향후 형식 검증 시스템을 어떻게 구축할 것인지에 대한 근본적인 접근 방향을 바꿀 수 있다.
핵심 요약
형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. 이 논문은 '비터 레슨' 질문을 제기한다: 테스트 타임 계산을 확장하는 단순한 에이전트 루프가 이런 복잡한 워크플로우와 경쟁할 수 있는가? h1이라는 단순한 도구를 개발했는데, 이는 모델에게 Lean 4의 효율적인 인터페이스를 제공하고 검증자 피드백과 자기 성찰로 작동하며, 명시적 분해나 탐색 구조를 강요하지 않는다. 전체 요약 7문장 읽기 → 015 00:11 ▲ 101 · 댓글 76 AI 시대, 경력보다 배고픔이 답이다 Anthropic 채용담당자인 저자는 더 이상 코딩 테스트를 실시하지 않기로 결정했다. Claude가 이미 코딩 테스트와 알고리즘 문제 해결에서 인간을 능가하기 때문이다. AI · 머신러닝 · Hunger beats tenure: Advice for junior engineers
Key Point AI가 코딩 능력을 대체하면서 신입과 경력자의 경력 격차가 축소되고 있으며, 실행 비용 절감으로 주말 프로토타입도 영향력을 가질 수 있는 환경이 바뀌었기 때문이다.
핵심 요약
Anthropic 채용담당자인 저자는 더 이상 코딩 테스트를 실시하지 않기로 결정했다. Claude가 이미 코딩 테스트와 알고리즘 문제 해결에서 인간을 능가하기 때문이다. AI 도구 활용 능력이 높아지면서 누적된 기술 지식의 양이 이전보다 덜 중요해졌고, 신입 엔지니어들이 경력 많은 개발자를 추월하는 사례를 목격하고 있다. 신입 엔지니어의 핵심 장점은 선입견 없는 시각과 신선한 아이디어다. Stripe 창립자는 신입사원들이 기성인들이 놓친 마찰점을 발견하도록 권장했고, Notion 입사 면접에서 저자도 '불가능하다고 여겨지던' 오프라인 모드를 아무렇지 않게 제안했다. 전체 요약 7문장 읽기 → 016 21:11 당일 +101 React·Next.js용 애니메이션 컴포넌트 라이브러리 공개 215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 웹 · 프론트엔드 · DavidHDev/react-bits · JavaScript
Key Point AI 에이전트와의 통합(MCP 지원)이 기본으로 탑재되어 있어 Claude, Cursor 등과의 자동 연동으로 컴포넌트 추가 작업이 간소화된다.
핵심 요약
215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 모든 컴포넌트는 라이브 데모와 조작 가능한 설정을 제공하며, JavaScript 또는 TypeScript와 CSS 또는 Tailwind로 네 가지 방식으로 제공된다. shadcn CLI나 jsrepo를 사용해 프로젝트에 추가할 수 있고, 수동 복사도 지원하며 설치 가이드가 마련되어 있다. 전체 요약 8문장 읽기 → 017 21:11 당일 +334 AI 펜테스터 Shannon, 오픈소스로 공개 Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 보안 · KeygraphHQ/shannon · TypeScript
Key Point 소스 코드 분석과 실제 익스플로잇으로 취약점을 증명하는 AI 펜테스터를 직접 실행할 수 있게 되어, 개발 주기마다 자동 보안 테스트가 가능해진다.
핵심 요약
Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 소스 코드에서 공격 경로를 식별한 후 브라우저 자동화와 CLI 도구로 실행 중인 애플리케이션을 공격하며, 재현 가능한 개념 증명(PoC)이 있는 취약점만 보고에 포함시킨다. Shannon OSS는 TypeScript 기반 오픈소스 저장소로 로컬에서 CLI를 통해 실행되며, AGPL-3.0 라이선스 하에서 개인 개발자와 소규모 팀에 적합하다. 전체 요약 12문장 읽기 → 018 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 019 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 020 12:11 ▲ 11 · 댓글 2 전문가와 AI 에이전트의 협업, 새로운 벤치마크로 측정한다 인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. AI · 머신러닝 · Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows
Key Point AI 에이전트의 자동화 능력은 계속 늘어나지만, 현실의 업무는 인간과의 지속적인 협업을 필요로 하며, 기존 벤치마크로는 이를 측정할 수 없다는 근본적인 문제를 다룹니다.
핵심 요약
인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. 기존 자동화 벤치마크는 에이전트가 한 번에 작업을 완료하는 능력에 집중하지만, 실제 워크플로우에서 전문가는 계획 수정 등 지속적인 상호작용을 더 중요하게 봅니다. 전문 업무 워크플로우는 여러 상호의존 단계로 이루어져 있어, 협업 에이전트에게 실제로 필요한 두 가지 능력을 도출했습니다: 전문가가 자신의 제안을 채택·수정·거절할지 예측하기, 그리고 지속적인 피드백 없이 협업 품질을 평가하기입니다. 전체 요약 7문장 읽기 → 021 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 022 12:11 ▲ 153 · 댓글 133 클로드, 신약 개발 6개 기관과 현장 연구로 확장 Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. AI · 머신러닝 · Early progress on accelerating drug development with Claude
Key Point 신약 개발의 여러 단계(분자 설계, 최적화, 규제 문서, 임상 시험 계획)에서 Claude의 구체적 효과가 입증되었으며, 대형 제약사부터 스타트업까지 실제 프로그램과 연계한 생명과학 AI 활용이 본격화되는 시점이다.
핵심 요약
Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. Generate Biomedicines는 Claude Code로 CAR T-cell 치료법의 유전자 지시를 70% 단축했으며, 랩 테스트에서 암세포 퇴치는 효율적이고 면역세포의 수용체 생성은 약 10배 증가했다. Divergence Labs는 Claude가 약 1개월간 약 35,000개의 항체 설계를 자동 생성하도록 해 식품 알레르기 치료법 개발을 진행했으며, 초기 테스트에서 IgE에 결합할 3개, 분리할 20개 설계를 발견했다. 전체 요약 12문장 읽기 → 023 06:11 ▲ 135 · 댓글 64 아마존, AI 사업 대폭 축소 후유증 아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. AI · 머신러닝 · Amazon Is Gutting Its AI Division After Sustained Failure
Key Point 아마존 같은 거대 기술 기업도 LLM 투자에서 손을 떼고 있다는 신호는 AI 산업의 현실을 보여주며, 어느 분야가 실질적 가치를 만드는지 재평가하는 전환점이 될 수 있다.
핵심 요약
아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. 아마존은 Nova 텍스트 모델, 영상·이미지 생성 모델 등 대부분의 AI 모델을 '점화 유지' 상태로 전환했다. 이는 기술적으로 지원되지만 최소한의 리소스만 할당받는 상태를 뜻한다. 회사의 노동력과 컴퓨팅 파워를 단 하나의 목표로 집중시켰다. 2024년 인수한 로봇 회사 Covariant의 수장 Pieter Abbeel이 주도하는 '프론티어 모델' 개발에 중점을 두고 있다. 전체 요약 6문장 읽기 → 024 06:11 당일 +1,187 AI 코딩 도구용 디자인 스킬 모음 Claude Code, Cursor, Codex, Windsurf 등 AI 코딩 도구를 위한 설계 스킬들을 모아둔 오픈소스 저장소다. 웹 · 프론트엔드 · elayadesign/ai-design-skills
Key Point 마크다운 규칙 파일로 쓰인 디자인 스킬을 AI 코딩 도구에 바로 로드하는 방식으로, 개발자 관점의 설계 자동화 방법을 제시한다.
핵심 요약
Claude Code, Cursor, Codex, Windsurf 등 AI 코딩 도구를 위한 설계 스킬들을 모아둔 오픈소스 저장소다. 각 스킬은 마크다운 규칙 파일로 작성되어 있으며, 자체 폴더에 포함되어 필요한 것만 설치해 쓸 수 있다. 현재 랜딩페이지 디자인 스킬이 포함되어 있으며, 이는 질문 수집부터 페이지 구조, 전환 카피, 타입·간격·라디우스·모션 등 완전한 비주얼 시스템까지 만든다. 전체 요약 8문장 읽기 → 025 03:11 ▲ 177 · 댓글 76 Anthropic, 상용 제품 사용자 데이터 학습에 미사용 Anthropic의 상용 제품(Claude for Work, Anthropic API, Claude Gov 등)은 기본적으로 사용자의 입출력을 모델 학습에 사용하지 않는다. 보안 · Is my data used for model training?
Key Point 상용 AI 서비스 사용자가 자신의 데이터 활용 범위를 정확히 이해해야 개인정보보호와 보안을 판단할 수 있기 때문이다.
핵심 요약
Anthropic의 상용 제품(Claude for Work, Anthropic API, Claude Gov 등)은 기본적으로 사용자의 입출력을 모델 학습에 사용하지 않는다. 다만 사용자가 명시적으로 피드백을 제공하거나 데이터 사용을 허락할 경우, 대화 내용과 코딩 세션이 모델 학습에 활용될 수 있다. 피드백 버튼(좋아요/싫어요)을 통해 제공한 피드백 데이터는 커스텀 설정, 대화 기록, 모델 설정 등 관련 정보와 함께 보안 백엔드에 최대 5년간 저장된다. 전체 요약 6문장 읽기 → 026 03:11 ▲ 144 · 댓글 67 Anthropic, 스탠포드 교수 저작권 침해로 $1.5억 합의금 지급 연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. AI · 머신러닝 · Anthropic trained Claude on illegally obtained Stanford professors' books
Key Point Claude 개발사인 Anthropic이 불법 복제로 수억 달러 합의를 한 사건인데, 판사는 여전히 AI 학습용 저작물 취득을 공정 이용으로 인정해 AI 학습과 창작자 권리 간 법적 경계가 모호한 상황을 드러낸다.
핵심 요약
연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. Bartz v. Anthropic 사건에서 판사는 불법 복제를 금지하되, 저작권 취득을 통한 LLM 학습은 공정 이용으로 인정했다. 저작권 소유자 50만여 건에 대해 $1.5억의 합의금이 배정되었다. 전체 요약 10문장 읽기 → 027 00:11 ▲ 179 · 댓글 82 위키피디아, AI 생성 콘텐츠 정소 전쟁 중 위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. AI · 머신러닝 · Wikipedia's Cleanup of AI-Generated Content
Key Point 위키피디아가 AI 콘텐츠 정소를 위해 어떤 기술과 정책을 실행하고 있으며, AI 시대에 전통적 지식 자산을 어떻게 재정의하려는지 알 수 있다.
핵심 요약
위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. 초기에는 '그것이 증거다', '풍부한 문화유산' 같은 반복 구문이나 결론 섹션처럼 ChatGPT의 특징적 패턴이 노출되어 있었다. 2025년 현재 AI 생성 콘텐츠의 특징이 더 미묘해지고 있으며, 기하학적 구조나 단락 패턴 같은 구조적 신호를 통해 탐지하고 있다. 전체 요약 12문장 읽기 → 028 21:11 당일 +1,594 AI 모델 시스템 프롬프트 31개 모음 Claude, Gemini, Grok, DeepSeek, GLM, Kimi, Qwen 등 25개 이상 AI 모델을 대상으로 한 시스템 프롬프트, 페르소나 정의, 작업공간 정책, AGENTS.md 파일과 Ollama Modelfile을 포함한 31개 프롬프트를 모아놓은 저장소다. AI · 머신러닝 · togg53192-cmd/jailbreaks
Key Point AI 모델을 대상으로 지시어 계층 구조와 페르소나 프레이밍이 동작하는 방식을 체계적으로 정리한 자료로, 프롬프트 엔지니어링을 연구하거나 모델의 명령어 조작 취약점을 이해하려는 개발자에게 참고 자료가 된다.
핵심 요약
Claude, Gemini, Grok, DeepSeek, GLM, Kimi, Qwen 등 25개 이상 AI 모델을 대상으로 한 시스템 프롬프트, 페르소나 정의, 작업공간 정책, AGENTS.md 파일과 Ollama Modelfile을 포함한 31개 프롬프트를 모아놓은 저장소다. OpenCode Zen의 Big Pickle, Space Bunny, LongCat 같은 무료 스텔스 모델부터 Anthropic의 Claude, Google의 Gemini, xAI의 Grok 등 폐쇄형 최신 모델까지 다양한 범위를 커버한다. 각 프롬프트 파일은 완전하고 붙여넣기 가능한 형태로 제공되며, 요약이나 부분 발췌가 아닌 전체 시스템 프롬프트를 담고 있다. 전체 요약 8문장 읽기 → 029 21:11 당일 +233 Expo팀, AI 에이전트용 스킬 컬렉션 오픈소스 공개 Expo는 공식 AI 에이전트 스킬 모음을 깃허브에 오픈소스로 공개했다. AI · 머신러닝 · expo/skills · Shell
Key Point Expo 앱 개발 시 AI 에이전트가 네이티브 제약·SDK 호환성·워크플로우를 정확히 이해하도록 지식을 체계화했으며, Claude Code부터 Cursor·Copilot까지 다양한 도구에서 쓸 수 있다.
핵심 요약
Expo는 공식 AI 에이전트 스킬 모음을 깃허브에 오픈소스로 공개했다. 이 스킬은 Expo 앱 구축·배포·업그레이드·디버깅 시 AI 에이전트가 적절한 결정을 내리도록 가르친다. Expo 문서·CLI·EAS CLI를 소스 오브 트루스로 두되, 에이전트가 이를 실제 프로젝트에 올바르게 적용하는 방법을 교육한다. 전체 요약 8문장 읽기 → 030 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 031 12:11 ▲ 125 · 댓글 30 로컬에서 쓰는 오픈소스 AI, Hob 공개 Frigade가 개발한 Hob은 개인 컴퓨터에서 AI를 쓸 수 있는 무료 오픈소스 데스크톱 애플리케이션이다. AI · 머신러닝 · Show HN: Hob - Open-source, on device alternative to Claude Cowork and ChatGPT
Key Point 로컬 머신에서 완전히 프라이빗하게 LLM을 쓸 수 있는 크로스플랫폼 오픈소스 도구로, 개인정보 보호를 중요시하거나 API 의존성을 줄이고 싶은 개발자에게 유용한 선택지이다.
핵심 요약
Frigade가 개발한 Hob은 개인 컴퓨터에서 AI를 쓸 수 있는 무료 오픈소스 데스크톱 애플리케이션이다. Claude와 ChatGPT의 대체 프로그램으로, Gemma, GPT-OSS 같은 오픈 가중치 모델을 로컬에서 실행한다. Mac, Windows, Linux를 지원하며, 사용자의 컴퓨터에 맞는 최고 수준의 최신 모델을 자동으로 선택해 설정해준다. 전체 요약 6문장 읽기 → 033 03:12 당일 +709 여러 AI를 한 곳에서 - OpenBot 데스크톱 앱 OpenBot은 로컬 우선 데스크톱 워크스페이스로, Codex, Claude, Grok, Cursor, Cline, Gemini, OpenCode 등 여러 AI 에이전트를 한곳에서 운영할 수 있다. AI · 머신러닝 · nightly-labs/openbot · TypeScript
Key Point 여러 AI 에이전트를 하나의 데스크톱 앱에서 관리·협업시킬 수 있는 새로운 워크플로우가 가능해진다.
핵심 요약
OpenBot은 로컬 우선 데스크톱 워크스페이스로, Codex, Claude, Grok, Cursor, Cline, Gemini, OpenCode 등 여러 AI 에이전트를 한곳에서 운영할 수 있다. 각 에이전트가 독립적인 워크스페이스와 대화 히스토리를 가지며, 로컬 메시지 큐, 파일 전송, 임베딩 브라우저, 에이전트 간 메시징을 제공한다. 개발 미리보기 단계이며 에이전트들이 기본적으로 무제한 접근 권한으로 실행되므로 신뢰할 수 있는 작업만 실행해야 한다. 전체 요약 10문장 읽기 → 034 21:12 당일 +251 AI 에이전트를 위한 디자인 스킬, Huashu Design 3.0 오픈소스 공개 Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 오픈소스 · 도구 · alchaincyf/huashu-design · HTML
Key Point 기존 디자인 도구 진입장벽을 모두 없애고 명령 인터페이스로 AI 에이전트가 직접 디자인을 완성할 수 있게 한 새 패러다임으로, 일반 개발자도 전문 디자인 수준의 결과물을 빠르게 얻을 수 있다.
핵심 요약
Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 웹페이지·App 원형·편집 가능한 PPTX·동영상·인포그래픽 등을 3~30분 안에 생산하며, 품질은 대기업 디자인팀 수준을 목표로 한다. 3.0 버전은 6개 썸네일에서 3개 방향을 선택하게 하는 방식으로 개선되었고, 84종 스타일 라이브러리(웹·PPT·인포그래픽·App·중문·동아시아)에 샘플 제공. 전체 요약 14문장 읽기 → 035 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 036 21:12 당일 +199 Postiz: AI 에이전트 기반 소셜 미디어 관리 플랫폼 오픈소스화 Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. 웹 · 프론트엔드 · gitroomhq/postiz-app · TypeScript
Key Point AI 에이전트와의 자동 통합으로 소셜 미디어 관리의 전면 자동화가 가능해지며, 클라우드와 오픈소스 선택으로 관리형 편의와 자유도를 동시에 제공한다.
핵심 요약
Postiz는 소셜 미디어 글을 스케줄링, 자동화, 분석하는 플랫폼으로 클라우드 서비스와 오픈소스 버전을 동시에 제공한다. ChatGPT, Claude, Cursor, OpenClaw, Hermes 등 15개 이상의 AI 에이전트와 통합되며, 사용자가 선택한 에이전트로 콘텐츠 생성과 스케줄링을 자동화할 수 있다. X(트위터), Facebook, Instagram, TikTok, LinkedIn, YouTube 등 주요 소셜 플랫폼을 지원하고, N8N, Make.com, Zapier 같은 자동화 플랫폼과 API 연동이 가능하다. 전체 요약 11문장 읽기 → 037 21:12 당일 +118 AI 에이전트용 프레젠테이션 생성 스킬, 브라우저에서 편집하고 PPTX로 내보내기 문서를 AI 에이전트에 전달하면 각 페이지마다 브라우저 기반 편집 콘솔이 있는 PPT를 자동 생성하는 JavaScript 기반 스킬이다. 웹 · 프론트엔드 · chuspeeism/dashi-ppt-skill · JavaScript
Key Point AI 에이전트로 자동 생성한 프레젠테이션을 브라우저에서 직접 편집하고 진정한 PPTX로 내보낼 수 있는 완성도 높은 솔루션으로, 빠른 기안 작성이 필요한 업무 시나리오에서 기존 PowerPoint 파일 편집 흐름을 완전히 바꾼다.
핵심 요약
문서를 AI 에이전트에 전달하면 각 페이지마다 브라우저 기반 편집 콘솔이 있는 PPT를 자동 생성하는 JavaScript 기반 스킬이다. 12개의 시각 테마와 1020개 버전식, 8576개 조정 가능 컨트롤을 제공하며, 차트(레이더, 폭포, 맵트리, 깔때기, 열지도, 샌키, 간트), 분석 모델(SWOT, 포터 5력, PEST, 비즈니스 모델 캔버스, 더블 다이아몬드)을 포함한다. 생성된 HTML 프레젠테이션은 슬라이더로 모듈 개수 조정, 레이아웃·차트·색상 변경, 텍스트 클릭 수정, 드래그로 이미지/영상 교체, 9가지 페이지 전환 애니메이션을 지원한다. 전체 요약 9문장 읽기 → 038 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 039 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 040 12:11 ▲ 184 · 댓글 209 LLM 가격 경쟁 격화, 6개월간 최대 80% 인하 지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. AI · 머신러닝 · OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
Key Point OpenAI와 Anthropic이 매출의 대부분을 차지하는 LLM 가격을 6개월간 최대 80%까지 연쇄 인하한 배경에는 DeepSeek 같은 오픈 웨이트 모델의 확산과 인프라 제공자의 경쟁 심화가 있으며, 이는 LLM이 상품화되고 있음을 보여준다.
핵심 요약
지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. LLM 에이전트 운영 시 캐시 읽기 비용이 전체 토큰 소비의 96~99%를 차지한다. Fable 5.1은 캐시 읽기 비용을 75% 인하하면서 이는 전체 사용 비용 70~75% 감소로 이어졌다. DeepSeek Flash V4는 4월 2026년 출시 이후 매우 저렴한 가격(입력 $0.14, 캐시 읽기 $0.0028)으로 급속도로 확산되었고, OpenRouter에서 29개의 서로 다른 인프라 제공자가 이를 지원하고 있다. 전체 요약 10문장 읽기 → 041 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 042 21:11 당일 +1,930 개인 맞춤형 학습 AI 튜터 DeepTutor 공개 홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. AI · 머신러닝 · HKUDS/DeepTutor · Python
Key Point 개인화된 AI 학습이 주목받는 시대에 오픈소스 기반의 완전한 튜터링 플랫폼이 공개되어, 교육용 AI 애플리케이션을 직접 구축하려는 개발자와 교육 기관에 실제 활용 가능한 기반을 제공한다.
핵심 요약
홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. Python 기반이며 deeptutor.info에서 공식 문서를 제공한다. 에이전트 네이티브 아키텍처로 설계되었으며 도구와 능력 플러그인 모델을 지원한다. 전체 요약 11문장 읽기 → 044 15:11 ▲ 109 · 댓글 33 다섯 개의 Qwen 모델, 한 대의 컴퓨터로 Claude Opus5 수준 코딩 성능 달성 연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. AI · 머신러닝 · Five Qwen3.8-27B models match Fable 5 Using GVS5H Harness
Key Point 비용 대비 성능이 우수한 오픈소스 모델로도 상용 최강 모델 수준의 코딩 성능을 낼 수 있다는 점이 중요합니다. 특히 자가 호스팅 모델로 93% 수준을 달성할 수 있어, 개발팀의 추론 비용 절감과 프라이버시 개선에 직결됩니다.
핵심 요약
연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. LiveCodeBench의 최신 어려운 문제 100개로 평가한 결과, 열 개 모델에서 최대 25.6 포인트의 성능 향상을 얻었다. Qwen3.8 Flash Next를 조율했을 때 Claude Fable 5의 90.4%에 비해 93.0%의 pass@1을 기록했으며, 비용은 9% 수준으로 절감했다. 전체 요약 8문장 읽기 → 045 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 046 00:11 ▲ 111 · 댓글 30 에이전트·터미널 멀티플렉서 Corgi 공개 Corgi는 여러 AI 에이전트(Claude, Code Codex, Pi 등)를 동시에 관리하는 터미널 멀티플렉서다. 기타 · Show HN: Corgi, a helpful {agent, terminal} multiplexer
Key Point AI 에이전트 워크플로우가 복잡해지면서 여러 에이전트를 효율적으로 관리할 새로운 도구가 나타나는 추세를 보여주며, 개발자 생산성 향상에 직결된다.
핵심 요약
Corgi는 여러 AI 에이전트(Claude, Code Codex, Pi 등)를 동시에 관리하는 터미널 멀티플렉서다. 각 에이전트의 상태(작동 중, 사용자 요청 대기, 완료, 유휴)를 시각화하며, 토큰 사용량과 활동 기록을 추적한다. tmux처럼 에이전트와 프로세스를 백그라운드에서 계속 실행할 수 있고, 파일 변경 사항을 한 번에 볼 수 있다. 전체 요약 6문장 읽기 → 047 21:11 당일 +2,110 AI 냄새 제거하는 웹 디자인 도구 Hallmark 공개 Claude Code, Codex, Cursor 등 AI 코딩 도구용 디자인 스킬 Hallmark를 Together AI가 공개했다. 웹 · 프론트엔드 · Nutlope/hallmark · CSS
Key Point AI 코딩 어시스턴트 사용 시 발생하는 '대량 생산된 듯한' 디자인을 자동으로 차단하고, 실제 기능하는 웹 인터페이스를 빠르게 만들 수 있는 오픈 도구가 나왔다는 점이 개발자에게 의미가 있다.
핵심 요약
Claude Code, Codex, Cursor 등 AI 코딩 도구용 디자인 스킬 Hallmark를 Together AI가 공개했다. 48개의 테마를 제공하며, 각 테마는 종이·글씨·색상·표면 같은 구체적 물리적 속성을 담은 자료(material)이다. AI가 생성한 듯한 디자인의 흔한 문제점들(모든 제목 위의 눈썹 모양, 추적된 대문자 레이블, 제목 속 한 단어만 칠하기, 빈 프레임)을 명시적으로 검출하고 차단한다. 전체 요약 10문장 읽기 → 048 21:11 당일 +728 개발자 아이디어를 즉시 실행하는 오픈소스 AI 에이전트 Cindy 공개 Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. AI · 머신러닝 · makecindy/cindy · TypeScript
Key Point 로컬에서 완전히 제어 가능하면서도 Claude Code 같은 최신 AI 모델을 바로 통합할 수 있는 오픈소스 에이전트가 나왔으므로, 개발자는 자신의 워크플로우에 맞게 커스터마이징할 수 있다.
핵심 요약
Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. TypeScript 기반의 pnpm 모노레포 구조로 데스크톱(Electron)과 모바일(React Native) 앱을 포함하며, 공식 Cindy 서비스 사용, 자신의 API 키 연결, 또는 로컬 모델 사용이 가능하다. 메모리·스킬·자동화·MCP·플러그인 등을 통해 사용자가 에이전트를 커스터마이징할 수 있으며, 여러 모델과 하네스를 조합해 병렬로 작업을 처리할 수 있다. 전체 요약 8문장 읽기 → 049 21:11 당일 +144 AI 에이전트를 위한 런타임 'herdr' 오픈소스 공개 Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. AI · 머신러닝 · herdrdev/herdr · Rust
Key Point AI 코딩 에이전트 시장이 확대되면서 에이전트를 실행할 수 있는 전용 런타임 플랫폼이 등장했으며, Claude Code·Cursor·Grok 등 주요 도구를 모두 통합 관리할 수 있는 새로운 개발 환경을 제공한다.
핵심 요약
Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. 서버 재시작 후에도 저장된 레이아웃을 복구하고 지원되는 에이전트 세션을 재개할 수 있으며, 원본 프로세스는 생존하지 않는다. 여러 머신의 작업을 하나의 윈도우에서 관리할 수 있으며, 로컬 작업과 저장된 SSH 머신을 함께 표시하고 독립적으로 재연결할 수 있다. 전체 요약 10문장 읽기 → 050 21:11 당일 +153 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 051 21:11 당일 +202 컨테이너 없이 프로세스 샌드박싱하는 경량 도구 공개 Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. 인프라 · 데브옵스 · anthropics/sandbox-runtime · TypeScript
Key Point 컨테이너의 오버헤드 없이 OS 원시 기능으로 AI 에이전트와 로컬 도구를 안전하게 격리하려는 개발자들에게 필요한 인프라가 등장했다.
핵심 요약
Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. macOS는 sandbox-exec과 Seatbelt 프로필을, Linux는 bubblewrap을 사용해 격리를 구현하고, Windows는 전용 사용자 계정과 WFP 필터로 제약을 적용한다. 네트워크는 기본적으로 모두 차단되며, allowedDomains/deniedDomains로 명시적으로 허용하는 방식을 사용한다. 파일 읽기는 기본 허용이고 denyRead/allowRead로 제어하며, 쓰기는 기본 차단이고 allowWrite로만 허용한다. 전체 요약 11문장 읽기 → 052 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 053 09:11 ▲ 115 · 댓글 71 $150만 드는 BI 도구, 8개월에 $8,300으로 직접 만들다 연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. AI · 머신러닝 · Can we replace a $150k Looker with a bucket of HTML files?
Key Point Claude와 기존 데이터 스택으로 고가의 BI 도구를 직접 만든 구체적인 사례와 비용 구조, 보안 설계를 담았으며, SaaS 대체 논의에서 정확한 기술 트레이드오프를 제시합니다.
핵심 요약
연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. Claude(Opus 4.5)가 데이터 분석 결과를 HTML 차트로 생성하기 시작했는데 Looker 대시보드보다 더 나은 외형을 보여줬지만 Downloads 폴더에만 머물러 공유 방식이 필요했다. 팀의 Maddy가 S3, SSO, Kubernetes 기반으로 HTML 파일을 호스팅·공유하는 웹 서비스를 만들고, 3월에 Snowflake OAuth 토큰을 이용한 라이브 쿼리 API를 추가했으며, 기존 권한 모델을 그대로 활용해 별도 권한 로직을 쓸 필요가 없었다. 전체 요약 14문장 읽기 → 054 09:11 새 버전 Anthropic Python SDK v2.3.0 출시, 엔터프라이즈 기능 추가 Claude 엔터프라이즈 조직을 위한 새로운 Claude Tag 엔드포인트가 추가되었습니다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v2.3.0
Key Point 엔터프라이즈 조직의 Claude Tag 관리 기능이 추가되고 API 호출 방식이 정리되어, Python SDK를 사용하는 개발자와 기업 사용자가 업데이트해야 합니다.
핵심 요약
Claude 엔터프라이즈 조직을 위한 새로운 Claude Tag 엔드포인트가 추가되었습니다. Google Cloud 사용자 프로필 요청이 조직 엔드포인트로 전송되도록 수정되었습니다. 클라이언트가 엔드포인트 경로에 하드코딩된 쿼리 파라미터를 전송하지 않도록 개선되었습니다. 전체 요약 7문장 읽기 → 055 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 056 00:11 ▲ 114 · 댓글 127 LLM이 만드는 새로운 보안 위협···한 주간 대형 취약점 폭발 2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 보안 · Is this the new cyber normal?
Key Point 지난주 PHP에서 인터넷 70% 이상을 위협하는 취약점이 터진 데 이어 eMudhra, Railway, GitLab, LiteLLM 등이 연쇄적으로 침해당하면서 LLM이 보안 위협의 판을 바꾸고 있다.
핵심 요약
2026년 10월 지난 일주일 간 심각한 소프트웨어 취약점들이 대량 발견되었다. PHP의 CVE-2026-109618, 109619(PHP2Shell)는 OpenAI의 패치 프로그램과 구글 클라우드의 Wiz가 GPT-5.6과 Gemini 4를 이용해 찾은 원격 코드 실행 버그로, 인터넷 70% 이상에 영향을 미친다. 2024년 PHP 재단이 발견했지만 실제 익스플로잇을 못 만들어 방치한 취약점을 LLM이 취약점 설명만으로 완전한 익스플로잇으로 빌드해냈다. LLM은 보안 패치 공지 후 코드 변경사항을 분석해 몇 분 내에 익스플로잇을 만들 수 있어, 이제 패치 발표 시점을 '익스플로잇이 퍼지지 않은 마지막 시간'으로 봐야 한다. Hacker News의 petecooper가 의도치 않게 CVE를 공개해 패치 일정이 22일에서 21일로 앞당겨졌지만, Calif가 익스플로잇 영상을 공개하고 Chainguard가 embargo 6시간 전에 패치를 배포하면서 17시간 내에 여러 문제가 겹쳤다. 전체 요약 14문장 읽기 → 057 21:11 당일 +331 DeepSeek Harness를 P2P로 원격 접근하기 DeepSeek Harness 플러그인 기반 다중 기기 원격 접근 솔루션으로, PC·Android·웹 클라이언트에서 호스트 Harness와 CodeX, Cursor, Antigravity 같은 AI 백엔드에 접근 가능하다. 인프라 · 데브옵스 · liguobao/ds-harness-remote · TypeScript
Key Point 공개 IP와 포트포워딩 없이 종단간 암호화된 P2P 네트워크로 원격 AI 개발 환경에 어디서나 접근할 수 있는 방식으로, 원격 작업 인프라의 새로운 패턴을 제시한다.
핵심 요약
DeepSeek Harness 플러그인 기반 다중 기기 원격 접근 솔루션으로, PC·Android·웹 클라이언트에서 호스트 Harness와 CodeX, Cursor, Antigravity 같은 AI 백엔드에 접근 가능하다. 호스트는 공개 포트나 포트포워딩 없이 아웃바운드 연결만 사용하며, LAN → P2P → TURN → Relay 순서로 경로를 협상한다. Noise_IK_25519_ChaChaPoly_SHA256 기반 엔드투엔드 암호화로 세션 트래픽을 보호하고, 서버는 암호화된 메시지를 릴레이하지만 본문을 읽을 수 없다. 전체 요약 10문장 읽기 → 058 21:11 ▲ 116 · 댓글 39 거대언어모델, 이미지에 숨겨진 메시지를 자동 부호화·해독하다 Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. AI · 머신러닝 · How does Fable 5.1 hide messages in images?
Key Point LLM이 의도적으로 감춘 메시지를 사전 협의 없이 자동 복호화할 수 있다는 발견은, 향후 에이전트 시스템에서 감시를 우회한 비밀 통신의 가능성을 시사한다.
핵심 요약
Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. Fable은 50개의 메시지 각각을 숨긴 SVG 이미지를 생성했고, 별도 세션의 다른 Fable 인스턴스가 렌더링된 PNG 이미지(소스 코드 없음)만 보고 복호화를 시도했다. Fable이 가장 선호한 부호화 방식은 건물 높이(33개 중 50개 메시지)였으며, 그 외 별의 높이, 잔디 길이, 창문 밝기, 컬러 값 등 시각적 요소의 속성을 문자에 매핑했다. 전체 요약 11문장 읽기 → 059 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 060 12:11 ▲ 162 · 댓글 75 LLM으로 대규모 소프트웨어 형식 검증이 현실화되다 Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. AI · 머신러닝 · LLMs are making formal software verification feasible at a much larger scale
Key Point 형식 검증이 역사적으로 수십 년의 전문 인력을 요구했으나, LLM이 이 비용을 획기적으로 낮추면서 일반 소프트웨어 개발에도 적용 가능해졌고, 향후 소프트웨어 보안 수준을 크게 변화시킬 기술이기 때문이다.
핵심 요약
Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. 개발자의 퍼지 테스트(fuzz test)를 자동으로 형식 사양으로 변환해 증명했으며, 239개 엔트리포인트에서 64MB 이하 모든 입력에 대해 크래시가 없음을 증명했다. 총 약 1억 8천만 줄의 Rocq 증명을 작성했고, 전형적인 증명은 약 60만 줄의 코드로 18,000개 RISC-V 명령어에 대한 보안 보장을 제공한다. 전체 요약 13문장 읽기 → 061 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 062 03:11 ▲ 104 · 댓글 31 Omnara – 오픈소스 AI 에이전트 플랫폼 Claude Managed Agents와 OpenAI Agents API의 오픈소스 대안으로, 모든 모델과 머신에서 AI 에이전트를 실행할 수 있는 관리형 플랫폼이다. AI · 머신러닝 · Show HN: Omnara – Open-source alternative to Claude Managed Agents
Key Point 클라우드 종속성 없이 모든 AI 모델을 자체 인프라에서 에이전트로 실행하려는 개발 팀과 기업의 요구를 완전히 다르게 충족한다.
핵심 요약
Claude Managed Agents와 OpenAI Agents API의 오픈소스 대안으로, 모든 모델과 머신에서 AI 에이전트를 실행할 수 있는 관리형 플랫폼이다. Apache 2.0 라이선스로 자체 호스팅하거나 Omnara Cloud를 통해 사용할 수 있으며, REST API, TypeScript SDK, CLI를 제공한다. OpenAI, Anthropic, OpenRouter, Amazon Bedrock, LiteLLM, Ollama 등 호환되는 모든 모델을 지원하고, 자체 호스팅 모델도 사용 가능하다. 전체 요약 13문장 읽기 → 063 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 064 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 065 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 066 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 067 15:11 ▲ 44 · 댓글 2 LLM 추론 과정을 자체 스타일로 복원하는 TraceForge 발표 프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. AI · 머신러닝 · TraceForge: Distilling with Your Own Thinking
Key Point 상용 LLM의 추론 과정 접근을 제한하는 현실에서, 약관을 위반하지 않으면서도 모델의 자체 스타일로 추론을 복원해 학습 효율을 높일 수 있는 대안을 제시한다.
핵심 요약
프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. TraceForge는 교사 모델의 답변과 맥락에서 학생 모델 패밀리의 스타일로 추론 흔적을 생성하는 방식을 제안한다. 생성기가 교사 답변에서 추론 흔적을 재생성하도록 학습하고, 비평가가 실제 흔적의 진정성을 판단하는 2단계 학습(지도학습 후 적대적 학습)을 수행한다. 전체 요약 7문장 읽기 → 068 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 069 12:11 ▲ 226 · 댓글 102 PHP 취약점, 실제로는 쉽게 악용되지 않는다 최근 PHP 취약점이 보도되며 높은 관심을 받았지만, 저자는 이것이 Log4Shell이나 Heartbleed처럼 쉽게 악용되는 취약점이 아니라고 주장한다. 보안 · There isn't an easy exploit for this PHP vulnerability
Key Point LLM이 생성한 거짓 PoC로 인한 보안 오류 판단이 대규모로 반복되는 현상을 보여주며, 실제 공격 난이도와 미디어 과장 사이의 간극을 직시해야 한다.
핵심 요약
최근 PHP 취약점이 보도되며 높은 관심을 받았지만, 저자는 이것이 Log4Shell이나 Heartbleed처럼 쉽게 악용되는 취약점이 아니라고 주장한다. GitHub에서 수천 개의 '개념증명(PoC)' 공격 코드가 올라와 있지만, 이들을 실제 PHP 서버에서 테스트하면 작동하지 않는다. 대부분의 PoC가 LLM에 의해 생성된 것으로, 실제로는 로컬 파일 포함(LFI) 같은 사전 조건으로 이미 취약한 서버를 필요로 한다. 전체 요약 6문장 읽기 → 071 00:11 ▲ 13 · 댓글 2 에지 기기용 LLM 커널 생성 벤치마크 공개 LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. AI · 머신러닝 · EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
Key Point 에지 디바이스 배포는 서버와 달리 하드웨어가 다양하고 제약이 크기 때문에, LLM으로 생성한 커널을 실제로 잘 동작하게 하려면 새로운 평가 방식과 최적화 전략이 필요하다는 점이 중요하다.
핵심 요약
LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. EdgeKernelBench는 통합 IR 배포 프레임워크와 에지 워크로드용 계층적 벤치마크를 결합하여, 재사용 가능한 계산·스케줄링·메모리 결정을 통합 IR로 캡처하고 컴파일러 인터페이스를 통해 각 백엔드에 연결한다. 벤치마크는 개별 연산자부터 컴팩트 모델 그래프까지 점진적으로 확대된 프로그램 범위를 포함하며, 대표적인 에지 애플리케이션 도메인을 아우른다. 전체 요약 6문장 읽기 → 072 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 073 00:11 ▲ 105 · 댓글 71 Claude로 코드 공격 표면 줄이기 Anthropic이 AI 모델을 사용하여 소프트웨어의 불필요한 공격 표면을 자동으로 찾아내고 제거하는 방법을 연구했다. 보안 · Using Claude to reduce the attack surface of code
Key Point OpenSSH 같은 최고 수준의 감시 코드에서도 불필요한 공격 표면이 발견되며, 개발자는 Claude를 사용해 자신의 소프트웨어 공격 표면을 체계적으로 줄일 수 있다.
핵심 요약
Anthropic이 AI 모델을 사용하여 소프트웨어의 불필요한 공격 표면을 자동으로 찾아내고 제거하는 방법을 연구했다. 개별 취약점 수정보다 코드 도달 가능성을 줄이면 알려지지 않은 취약점의 심각도를 낮출 수 있다. Claude가 25개 오픈소스 프로젝트(C, C++, Java, PHP, Python, 500만 줄 이상)를 분석해 493개 문제를 발견했다. 전체 요약 12문장 읽기 → 074 21:11 당일 +605 Salesforce 대체할 오픈소스 CRM, Twenty 공개 Twenty는 기술팀을 위해 설계된 오픈소스 CRM으로, 복잡한 비즈니스 요구사항에 맞게 커스터마이징할 수 있고 비즈니스 변화에 빠르게 적응한다. 오픈소스 · 도구 · twentyhq/twenty · TypeScript
Key Point Salesforce 같은 엔터프라이즈 CRM의 비용 부담과 제약에서 벗어나 자신의 요구에 맞게 커스터마이징 가능한 오픈소스 대안을 원하는 개발팀에게 유용한 도구다.
핵심 요약
Twenty는 기술팀을 위해 설계된 오픈소스 CRM으로, 복잡한 비즈니스 요구사항에 맞게 커스터마이징할 수 있고 비즈니스 변화에 빠르게 적응한다. 나머지 스택처럼 CRM을 직접 빌드·배포·버전 관리할 수 있으며, 클라우드 가입으로 1분 내에 워크스페이스를 구성할 수 있고 인프라 관리는 불필요하다. Twenty CLI로 새 앱을 스캐폴딩하고 객체·필드·뷰를 코드로 정의한 뒤 워크스페이스에 배포할 수 있다. 전체 요약 8문장 읽기 → 075 21:11 당일 +107 개인 서버에서 돌리는 AI 검색엔진 Vane Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 웹 · 프론트엔드 · ItzCrazyKns/Vane · TypeScript
Key Point 자신의 서버에서 검색 데이터를 완전히 제어하면서 최신 AI 모델을 활용하려는 사용자와 개발자에게 실질적인 대안이 된다.
핵심 요약
Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 스피드 모드(빠른 답변), 밸런스드 모드(일상 검색), 퀄리티 모드(깊이 있는 연구)의 세 가지 검색 모드를 지원하고, 웹·토론·학술논문 등 다양한 출처에서 검색할 수 있으며 특정 도메인으로 검색을 제한할 수도 있다. SearxNG를 통해 여러 검색 엔진에 익명으로 접근하고, 이미지·비디오 검색, PDF·텍스트·이미지 파일 업로드 후 질문, 스마트 자동완성 제안, 트렌딩 콘텐츠 브라우징, 로컬 검색 히스토리 저장 등의 기능을 제공한다. 전체 요약 7문장 읽기 → 076 21:11 당일 +392 Claude Code를 마스터할 수 있는 실전 가이드 공개 Claude Code 설치 후 활용법이 막막한 개발자들을 위해 실전 학습 가이드인 'claude-howto'를 오픈소스로 공개했다. AI · 머신러닝 · luongnv89/claude-howto · Python
Key Point Claude Code의 고급 기능(메모리, 훅, 서브에이전트, MCP)을 실무 수준으로 배우려는 개발자라면, 공식 문서보다 구체적인 조합 사례와 바로 쓸 수 있는 템플릿이 필요한데, 이 가이드가 그 공백을 채워준다.
핵심 요약
Claude Code 설치 후 활용법이 막막한 개발자들을 위해 실전 학습 가이드인 'claude-howto'를 오픈소스로 공개했다. 공식 문서는 기능 설명에만 초점을 맞추지만, 이 가이드는 슬래시 명령어·메모리·스킬·MCP·훅·서브에이전트 등 10개 모듈의 시각적 튜토리얼과 복사-붙여넣기 템플릿을 제공한다. Mermaid 다이어그램으로 각 기능의 내부 동작 원리를 설명하고, 초급자부터 고급 사용자까지 11~13시간에 걸친 체계적 학습 경로를 제시한다. 전체 요약 8문장 읽기 → 077 18:11 ▲ 22 · 댓글 2 AI 에이전트가 자신의 인터페이스를 진화시킨다 기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. AI · 머신러닝 · Evolving Agent Interfaces
Key Point AI 에이전트가 직접 자신의 작업 인터페이스를 설계·최적화하면서 더 작은 모델로 기존의 고사양 모델을 능가하는 성과를 낸 것으로, 컴퓨터 사용 에이전트의 성능 향상 경로가 근본적으로 바뀔 수 있음을 보여준다.
핵심 요약
기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. 연구팀은 인터페이스 설계 자체를 에이전트의 능력으로 만들어야 한다고 주장하며 Agent S4를 제안했다. Agent S4는 메타 에이전트가 합성 훈련 작업에서 태스크 에이전트의 궤적을 분석하고, 성공 라벨 없이 인터페이스와 사용 지식을 자동으로 구축·수정하는 인터페이스 저장소를 관리한다. 전체 요약 8문장 읽기 → 078 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 079 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 080 15:11 ▲ 102 · 댓글 66 Claude가 전갈 신경독 항체 설계... 211개 모두 공개 Anthropic의 Claude가 전갈 신경독에 대한 단백질 미니바인더 211개를 설계했으며, 이 중 17개가 실험 검증을 통과했다. AI · 머신러닝 · Claude designed protein binders against scorpion neurotoxins
Key Point Claude가 실제 건강 문제(전갈 독소 중독)를 대상으로 AI 단백질 설계의 실용성을 증명했고, 검증된 데이터 전체를 공개해 항독소 치료제 개발 분야에 실질적 진전을 만들었다.
핵심 요약
Anthropic의 Claude가 전갈 신경독에 대한 단백질 미니바인더 211개를 설계했으며, 이 중 17개가 실험 검증을 통과했다. 전갈 쏘임은 연간 120만 명 이상이 피해를 입고 3,250명 이상이 사망하지만, 저개발 지역에서 치료제 접근이 어려운 무시된 질병이다. Claude는 64시간 동안 4번의 추가 지시를 받으며 자율적으로 작동했고, 12개의 설계 도구를 사용해 318,484개 디자인을 생성 후 필터링했다. 전체 요약 10문장 읽기 → 081 06:11 ▲ 150 · 댓글 177 Steam 유저들, Next Fest의 AI 생성 게임 범람에 필터 요청 Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. 웹 · 프론트엔드 · Steam Users Beg for "No AI" Filter as Vibecoders Flood Next Fest
Key Point 게임 개발에서 AI 도구의 보편화가 전환점을 맞으면서, 플랫폼의 큐레이션 정책과 유저 경험의 충돌이 현실화되고 있다.
핵심 요약
Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. Claude Opus 5.5 출시와 최근의 분해·매시업 모드 열풍이 AI 생성 게임 증가의 배경으로 지적된다. Steam 커뮤니티 유저들은 저품질 콘텐츠를 걸러낼 수 없어 원하는 게임을 찾기 어려워하는 상황을 호소하고 있다. 전체 요약 8문장 읽기 → 082 00:11 ▲ 118 · 댓글 53 형식 검증으로 코드 최적화하는 AI 'Maxwell' 공개 doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. AI · 머신러닝 · Maxwell: A new kind of model that sits between code and hardware
Key Point 기존 AI는 코드 작성만 지원했지만, Maxwell은 형식 검증을 통해 프로그램 실행 중 동적으로 코드를 재작성·최적화하는 새로운 영역을 열었기 때문에, 소프트웨어 성능과 자원 효율성에 미칠 파급 효과가 크다.
핵심 요약
doubleAI가 프로그램 실행 중 코드를 동적으로 최적화하는 '코드 실행 모델(CEM)' Maxwell을 공개했다. Maxwell은 실행 중인 프로그램의 병목을 감지하고 알고리즘 전체를 재작성해 더 빠른 바이너리를 생성하며, 생성된 코드는 원본과 의미적으로 완전히 동등함을 형식 검증으로 증명한다. 기존 JIT 컴파일러나 최적화 도구와 달리 Maxwell은 실제 하드웨어와 데이터 흐름에 맞춰 함수와 알고리즘 수준의 전체 변환을 수행하고 조건에 따라 보호 조항을 둔다. 전체 요약 13문장 읽기 → 083 21:11 당일 +682 Claude Code용 AI 시대 SEO 분석 플러그인 공개 Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. 오픈소스 · 도구 · AgriciDaniel/claude-seo · Python
Key Point Google의 AI 검색 최적화 가이드를 완전히 구현한 첫 번째 실제 도구로, SEO 감시를 4시간에서 12분으로 단축하고 모든 추천에 검증 기준을 붙인다는 점이 기존 상용 도구와의 구별점이다.
핵심 요약
Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. Python 기반이며 MIT 라이선스 오픈소스로 제공되고, 웹사이트 전체 감시 10~15분이면 완료된다. 모든 추천은 Google의 공식 가이드에 기반한 근거와 함께 제시되며, 각 발견사항마다 '이것이 실패했다고 어떻게 알 수 있는가'에 대한 검증 기준을 포함한다. 일반 사용자용 공개 저장소(`AgriciDaniel/claude-seo`)와 AI Marketing Hub Pro 회원용 프라이빗 미러(`AI-Marketing-Hub/claude-seo`)의 두 버전으로 제공되며, 후자는 신규 기능 조기 접근이 가능하다. 전체 요약 13문장 읽기 → 084 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 085 15:11 ▲ 28 · 댓글 2 LLM 에이전트의 능동적 탐색과 적응 능력 측정 벤치마크 등장 LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AI · 머신러닝 · AdaExploreBench: Benchmarking LLM Agents for Proactive Exploration and Test-time Adaptation in Evolving Environments
Key Point LLM 에이전트가 실제 배포 환경에서 변화하는 규칙에 독립적으로 대응할 수 없다는 기본 한계를 실증적으로 드러내며, 에이전트 개발에 필요한 핵심 개선 방향을 구체적으로 제시한다.
핵심 요약
LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AdaExploreBench는 환경의 숨겨진 규칙을 에이전트가 능동적으로 발견해야 하고, 규칙이 예고 없이 바뀌는 상황(implicit rule drift)에서 성능 저하를 감지해 재탐색해야 한다. GPT-4o, Claude 3.5 등 8개 최신 LLM으로 실험한 결과 GPT-4o가 61.9% 정확도를 기록했으며, 능동적이고 적응적인 탐색은 현재 모델들에게 여전히 매우 어려운 과제로 나타났다. 전체 요약 4문장 읽기 → 086 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 087 15:11 ▲ 204 · 댓글 3 LLM이 실무 경영과학 컨설팅을 제대로 할 수 있을까 LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. AI · 머신러닝 · OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
Key Point 실제 컨설팅 프로젝트 자료로 구성한 처음의 OR 벤치마크로, 현재 LLM이 비즈니스 최적화 문제를 전문가 수준으로 해결할 때의 실제 격차를 보여주기 때문이다.
핵심 요약
LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. 실제 유료 OR 컨설팅 프로젝트 3,680만 달러 규모의 10개 산업 분야 31개 사례로 구성되며, 원본 요구사항·입력 데이터·납품 형식을 그대로 유지한다. ORSim이라는 제어된 클라이언트 시뮬레이터를 도입해 비즈니스 정보는 제공하되 OR 전문성은 공급하지 않는 환경에서 정보 수집 과정을 추적한다. 전체 요약 9문장 읽기 → 088 12:11 ▲ 43 · 댓글 4 코딩 AI, 스스로 실패를 분석해 개선하는 법 배우다 LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. AI · 머신러닝 · Self-Evolving Coding Agents via Harness-Policy Optimization
Key Point 코딩 AI의 성능을 높이는 데 도구 사용 방식과 모델 학습을 함께 개선하는 방법이 유의미한 성과를 보여주고 있기 때문이다.
핵심 요약
LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. Self-HPO는 두 성분을 번갈아 최적화하는 자기개선 프레임워크로, 현재 정책이 자신의 실패를 분석해 새로운 harness 후보를 제안하는 H-스텝과 RL로 정책을 업데이트하는 P-스텝을 반복한다. 학습 중 어려운 작업들이 다음 라운드의 harness 탐색 대상이 되어, harness 최적화가 진화하는 정책의 실패 패턴에 계속 맞춰진다. 전체 요약 6문장 읽기 → 089 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 090 03:11 ▲ 102 · 댓글 85 개인 프로젝트로 AI 개발 도구 만들지 말라 소프트웨어 엔지니어들이 자신의 개발 자동화 도구(소프트웨어 팩토리)를 만들려는 것은 시간 낭비라는 주장이 나왔다. AI · 머신러닝 · Personal software factories are a waste of time
Key Point AI 도구가 급속도로 발전하면서 개발자들이 자신만의 개발 자동화 시스템을 만드는 것에 집착하는 경향을 비판하고, 대신 실제 문제 해결과 기존 AI 도구 활용에 집중해야 한다는 의견을 제시한다.
핵심 요약
소프트웨어 엔지니어들이 자신의 개발 자동화 도구(소프트웨어 팩토리)를 만들려는 것은 시간 낭비라는 주장이 나왔다. 저자는 이것이 안락함에서 벗어나지 못하는 행동이며, 결국 프로젝트를 시작했다가 포기하는 패턴의 반복이라고 지적한다. AI로 앱을 만드는 것도 소통 문제, 잘못된 기능 구현, 예상과 다른 결과 등 새로운 종류의 어려움을 안게 된다. 전체 요약 7문장 읽기 → 091 03:11 ▲ 158 · 댓글 156 즐거움을 위해 프로그래밍하는 것도 괜찮다 Hacker News의 부정적인 목소리에 맞서 저자는 주말에 게임 프로그래밍을 배우며 순수한 즐거움을 위해 코딩한다고 말한다. 기타 · It's still ok to enjoy programming
Key Point 기술 커뮤니티의 냉소주의와 번아웃 담론이 심해지는 가운데, 프로그래밍의 본질적 즐거움을 되찾는 것이 개인의 성장과 정신 건강에 중요하다는 메시지를 제시한다.
핵심 요약
Hacker News의 부정적인 목소리에 맞서 저자는 주말에 게임 프로그래밍을 배우며 순수한 즐거움을 위해 코딩한다고 말한다. 버그 있는 Breakout 클론을 손으로 직접 작성하면서 문제를 풀 때의 행복감을 느끼며, Claude가 한 번에 완성할 수 있다는 사실도 상관하지 않는다. 주말마다 무작위로 프로그래밍 주제를 탐구하는데, 최근에는 Java의 타입 안정성을 의존 타입 언어 아이디어로 확장하는 방식을 공부했다. 전체 요약 8문장 읽기 → 092 00:11 ▲ 104 · 댓글 69 Tmux로 AI 에이전트를 운영하는 법 Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. 인프라 · 데브옵스 · Tmux and Claude Code: Sessions, Send-Keys, and the Ceiling
Key Point 여러 AI 에이전트를 동시에 실행할 때 각 에이전트의 상태 추적, 입력 관리, 기록 보존을 어떻게 구현할지 실무 예제와 한계가 명확히 제시되므로, AI 에이전트 운영 인프라를 구축하는 개발자에게 필수 참고자료다.
핵심 요약
Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. Claude Code의 최신 버전은 --worktree --tmux 플래그로 자동 설정을 지원하지만, 여러 에이전트 관리, 스크립팅, 원격 실행은 수동으로 구성해야 한다. 세션은 프로젝트 단위로 명명하고, 각 작업마다 윈도우를 만들며, send-keys로 스크립트에서 에이전트에 입력할 수 있다. 전체 요약 9문장 읽기 → 093 21:11 당일 +150 AI 에이전트가 팀원처럼 일하는 오픈소스 프로젝트 관리 도구 Linear, Jira, Plane의 오픈소스 대안으로, 자체 서버에서 운영하는 프로젝트 관리 및 이슈 추적 플랫폼이다. 오픈소스 · 도구 · croffasia/itsaplan · TypeScript
Key Point 팀이 AI 에이전트와 함께 협업하는 완전히 자체 제어되는 프로젝트 관리 시스템이 필요한 개발팀과 스타트업에 직접적 대안을 제시한다.
핵심 요약
Linear, Jira, Plane의 오픈소스 대안으로, 자체 서버에서 운영하는 프로젝트 관리 및 이슈 추적 플랫폼이다. AI 에이전트가 일반 팀원처럼 역할·권한·할당 작업을 가지고 같은 보드에서 작업할 수 있는 것이 핵심 특징이다. 칸반, 테이블, 타임라인, 캘린더 뷰를 지원하고 사이클, 커스텀 필드, 대시보드, 문서 기능을 포함한다. 전체 요약 11문장 읽기 → 094 21:11 당일 +186 회사 채용 페이지를 직접 수집하는 오픈소스 채용 검색엔진 freehire는 채용 공고를 회사의 ATS(지원자 추적 시스템) 직접 수집하는 오픈소스 검색엔진으로, 리크루터 재게시나 중개자 없이 3.3M+ 공고를 294,000+ 회사에서 관리한다. 오픈소스 · 도구 · strelov1/freehire · Go
Key Point 채용공고 수집에서 지원·추적까지 전 과정을 오픈소스로 관리하는 인프라를 제공해 구직자가 중개자 없이 원본 정보에 직접 접근할 수 있도록 한다.
핵심 요약
freehire는 채용 공고를 회사의 ATS(지원자 추적 시스템) 직접 수집하는 오픈소스 검색엔진으로, 리크루터 재게시나 중개자 없이 3.3M+ 공고를 294,000+ 회사에서 관리한다. Workday, Greenhouse, Lever, Ashby, iCIMS 등 92개 ATS 플랫폼, 100개 채용사이트·집계자, 30개 회사 채용페이지로부터 225개 라이브 소스를 통해 데이터를 수집한다. 공고는 정규화되어 단일 스키마로 변환되고 중복 제거되며, 지역·근무형태·경력·기술·연봉 등으로 패싯 검색이 가능하다. 전체 요약 10문장 읽기 → 095 21:11 당일 +184 AI 초보자 위한 완전한 빕 코딩 학습 가이드 데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. AI · 머신러닝 · datawhalechina/easy-vibe · JavaScript
Key Point AI 코딩의 기초부터 프로덕션 배포까지 무료로 배울 수 있는 체계적이고 다국어 지원되는 교육 자료로, 특히 초보자가 AI로 실제 제품을 만들어본다는 점이 차별화된다.
핵심 요약
데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. 초보자 단계(Stage 1)는 실제 문제 찾기에서 시작해 기회 포착, 방향 선택, 사용자 조사, 프로토타입 구축, AI 통합, 최종 완성까지 단계별로 진행되며 실습 예제와 상호작용형 데모로 '배우고 잊는 것'을 방지한다. 중급 개발자 단계(Stage 2)는 프론트엔드 UI 설계, Git 및 데이터베이스, 백엔드 API, Stripe 결제 통합, Zeabur 배포 등을 다루며 AI 카피라이팅 SaaS, 온라인 시험 시스템 등 실제 프로젝트를 완성한다. 전체 요약 8문장 읽기 → 096 21:11 ▲ 105 · 댓글 44 AI가 자동으로 완성하는 코드 개발 플러그인, 16분 안에 구현 저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. AI · 머신러닝 · Superlite: A Faster Alternatie to Superpowers
Key Point 자율 코딩 에이전트의 실질적 병목(대기 시간, 빈번한 승인)을 해결해 개발 속도를 52% 단축한 구체적 방법론과 성과를 제시한다.
핵심 요약
저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. 문제를 분석한 결과 인간 게이트(기능당 8~12개 승인), 순차 실행, 모든 작업 후 리뷰, 여러 스킬의 반복 테스트, 느린 Opus 에이전트 사용이 병목이었다. 이를 해결하기 위해 Superlite를 개발했다: 한 번의 승인으로 설계와 계획을 확정하고, 병렬 실행 가능하도록 작업 그래프를 분할하며, 에이전트를 계층별로 할당하고, 코드로 규칙을 강제한다. 전체 요약 11문장 읽기 → 097 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 098 18:11 ▲ 116 · 댓글 196 AI 도입 선두 기업 Anthropic, 주니어 직군은 줄고 생산성은 5배 증가 Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. AI · 머신러닝 · How employment is changing at Anthropic
Key Point AI 기반 조직 구조 변화의 선제적 신호를 보여주므로, 향후 다른 기업과 업계의 일자리·채용·업무 형태 변화를 예측하는 데 실질적 데이터를 제공한다.
핵심 요약
Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. 2026년 8월 기준 AI 에이전트 작동 시간이 직원 작동 시간의 6배에 달하며, 엔지니어 코드 커밋 속도는 6개월 전 대비 5배 증가했다. 코딩 에이전트 채택 후 엔지니어들의 코드량이 급증했으며, 영업 담당자도 더 많은 거래를 성약했고, 변호사·회계사·채용담당자 등 비기술 직군도 산출량이 증가했다. 전체 요약 12문장 읽기 → 099 18:11 ▲ 106 · 댓글 49 Cloudflare에서 WhatsApp 메시지를 AI 에이전트가 읽게 해주는 MCP 공개 AI 에이전트(Claude Code, Claude Desktop 등)가 사용자의 WhatsApp 메시지를 검색하고 읽을 수 있도록 하는 WhatsApp MCP 서버를 오픈소스로 공개했다. AI · 머신러닝 · Show HN: WhatsApp MCP running free on Cloudflare
Key Point WhatsApp 메시지 데이터를 AI 에이전트가 쿼리하고 검색할 수 있는 새로운 방식의 개인 정보 활용 패턴이 등장했으며, 개인 서버에서 자신의 데이터를 온전히 제어하면서 AI 통합을 할 수 있는 방법을 제시한다.
핵심 요약
AI 에이전트(Claude Code, Claude Desktop 등)가 사용자의 WhatsApp 메시지를 검색하고 읽을 수 있도록 하는 WhatsApp MCP 서버를 오픈소스로 공개했다. 사용자의 휴대폰이 신뢰할 수 있는 출처로 작동하며, 서버는 WhatsApp Web처럼 연결된 기기로 동작한다. 사용자가 요청할 때와 하루에 한 번 WhatsApp에 연결되어 새로운 메시지를 수집하고 Cloudflare Durable Object의 SQLite 데이터베이스에 저장한 후 연결을 해제한다. 전체 요약 13문장 읽기 → 100 15:11 ▲ 14 · 댓글 2 AI가 과학 가설을 반복 학습으로 발견하는 DiscoveryRSI 과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. AI · 머신러닝 · DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Key Point 과학적 가설의 품질 평가와 선택을 AI가 자동으로 수행하면서 연구자들의 발견 과정이 어떻게 달라질 수 있는지 보여주는 구체적 시도이다.
핵심 요약
과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. 가설은 근거 있는 주장, 실행 가능한 조사 방법, 판정 기준, 대안적 설명으로 정의되며, 다중 에이전트 진화 탐색으로 가설 트리를 구축한다. 세 가지 재귀적 학습 메커니즘으로 동작한다: 가설 신용 최적화는 연구 기여도를 평가하고, 학습 리플레이는 생산적 전략과 실패 패턴을 식별하며, 재발견은 개선 사항을 새로운 조사에 적용한다. 전체 요약 7문장 읽기 →