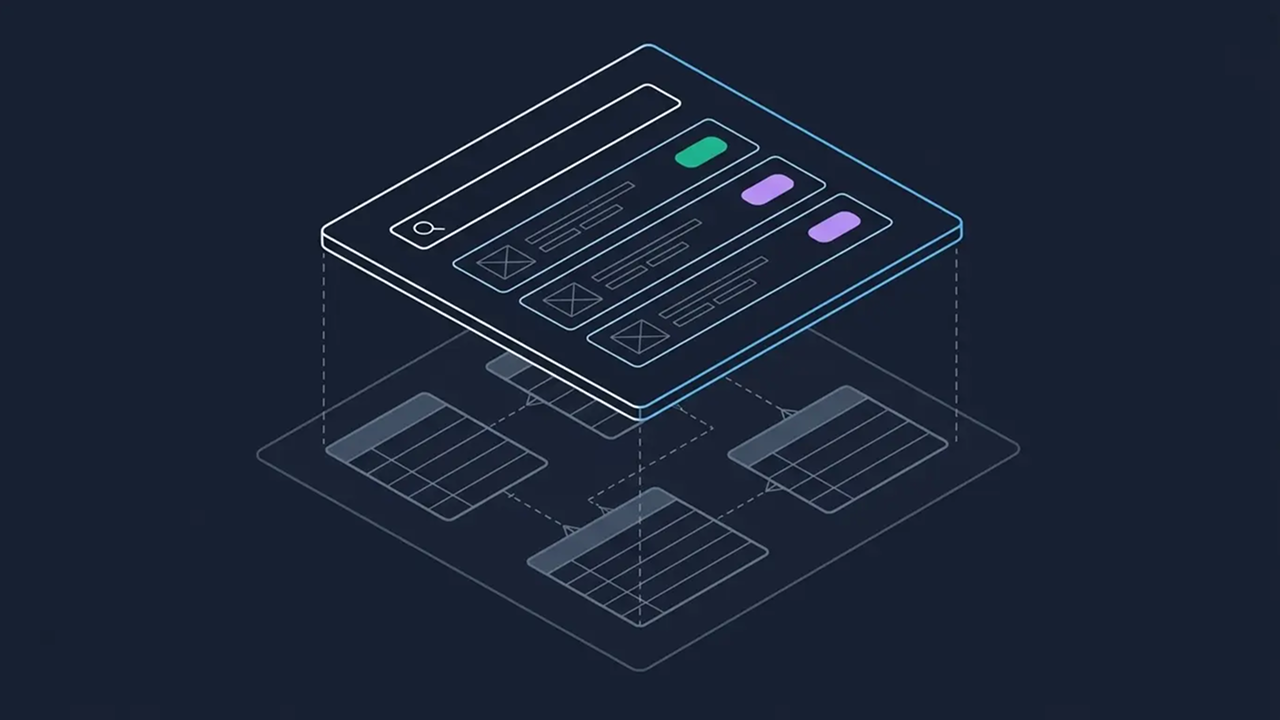
쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
25건 · "병렬화"조건 지우기 ×
001 03:11 ▲ 113 · 댓글 40 정규화된 스키마에서도 빠른 검색 가능, ParadeDB의 Rank Join ParadeDB가 검색 쿼리에서 정규화된 다중 테이블 조인을 지원하는 Rank Join 연산자를 추가했다. 인프라 · 데브옵스 · Do we still have to denormalize? Have your schema and search it too
Key Point 정규화된 스키마를 유지하면서도 검색 성능을 1000배 이상 개선할 수 있게 되어, 역정규화의 복잡성과 비용을 없앨 수 있는 기술적 돌파구가 나타났기 때문입니다.
핵심 요약
ParadeDB가 검색 쿼리에서 정규화된 다중 테이블 조인을 지원하는 Rank Join 연산자를 추가했다. 기존에는 검색 엔진을 쓰려면 데이터를 역정규화(denormalize)해야 했고, Postgres에서 정규화 상태로 조인 검색하면 매우 느렸다. StackOverflow 벤치마크에서 3개 테이블 OR 쿼리가 Vanilla Postgres 2분(118,000ms)에서 ParadeDB 100ms로 1000배 빨라졌고 추가 인프라 없이 실행된다. 전체 요약 11문장 읽기 → 002 06:11 ▲ 121 · 댓글 64 GLM-5.3을 두 DGX 스테이션에서 vLLM으로 607.8 토큰/초 처리 GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. AI · 머신러닝 · Serving GLM-5.3 at 607.8 tok/s across two Nvidia DGX stations with vLLM
Key Point 대규모 언어 모델을 여러 머신에 걸쳐 서빙하는 실전 구현 예시로, vLLM의 분산 배포와 성능 최적화 기법을 상세히 보여준다.
핵심 요약
GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. ConnectX-8 RDMA로 연결된 두 NVIDIA DGX 스테이션이 텐서 병렬화(TP=2)를 통해 하나의 OpenAI 호환 엔드포인트로 모델을 서빙하며, 각 GPU가 대략 절반의 가중치를 보유하고 계산한다. vLLM은 멀티토큰 예측, FP8 KV-캐시 저장, 프리픽스 캐싱을 활성화해 동시 부하에서 처리량을 최대화한다. 전체 요약 11문장 읽기 → 003 00:11 새 버전 Hugging Face Transformers v5.23.0 출시, 멀티모달 모델과 모델 변환 기능 강화 Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. AI · 머신러닝 · huggingface/transformers@v5.23.0
Key Point 대규모 언어모델의 실제 배포와 추론 속도가 핵심인 만큼, 다양한 하드웨어 백엔드에서 일관된 방식으로 모델을 최적화·공유할 수 있는 Exporters 기능 통일과 OpenVINO 융합으로 최대 7.6배 성능 향상이 개발자 생산성과 프로덕션 배포 효율을 크게 바꾼다.
핵심 요약
Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. 모델 변환(Exporters) 기능 완전 개편: 모든 내보내기는 ExportedModel을 반환하여 원본 모델과 동일한 인터페이스로 호출하고, Dynamo·ONNX Runtime·OpenVINO·ExecuTorch 백엔드를 통합 관리한다. 성능 개선: OpenVINO 백엔드는 어텐션·RoPE·MoE 연산을 융합하여 디코딩 속도를 2.4~3.9배 가속하며, ONNX Runtime은 A100에서 eager PyTorch보다 7.6배, torch.compile보다 1.4배 빠르다. 전체 요약 9문장 읽기 → 004 18:11 ▲ 62 · 댓글 8 매개변수 사전활용으로 멀티티처 증류 2배 빠르게 다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. AI · 머신러닝 · P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
Key Point 멀티티처 증류에서 훈련 단계를 50% 단축하고 최종 성능을 14% 향상시키는 방법이 제시되어, 대규모 모델 병렬화 연구에 실질적 가치가 있다.
핵심 요약
다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. 기존 태스크 산술(task arithmetic)은 학생과 전문가 매개변수를 선형결합하되 두 모델의 범위 내에만 머물게 되는 한계가 있다. P²-MOPD는 학생과 전문가 매개변수의 선형결합을 하나의 미분가능한 모델로 보고, 혼합 계수와 학생 가중치를 동일한 목적함수 아래 공동 최적화한다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 15 · 댓글 2 추측 디코딩 성능 41% 높이는 병렬 온폴리시 디스틸레이션 기법 LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. AI · 머신러닝 · SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Key Point 추측 디코딩의 병렬화와 감독 신호 수집 방식을 근본적으로 개선해 LLM 추론 속도를 획기적으로 높일 수 있는 기술이다.
핵심 요약
LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. 온폴리시 디스틸레이션(OPD)은 훈련된 초안 생성기를 채택 길이 한계 이상으로 끌어올릴 수 있으나, 기존 방식은 순차적인 초안-검증 롤아웃을 통해 감독 신호를 수집한다. 본 논문의 핵심 아이디어는 온폴리시 감독 신호가 이 순차 의존성을 벗을 수 있다는 것이다: 초안 블록은 참조 접두사와 초안으로 샘플링한 이력만으로도 감독될 수 있다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 122 · 댓글 6 실시간 장편 영상 생성 위해 '웨이브 포싱' 기법 제시 실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. AI · 머신러닝 · Wave Forcing: Towards Speed-of-Light Streaming Video Generation
Key Point 실시간 장편 영상 생성의 핵심 병목인 순차 처리 방식을 병렬화로 해결하는 구체적 기법이 제시되었고, 7배 이상의 성능 향상을 실현한 점이 주목된다.
핵심 요약
실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. WF는 청크별 인과 주의 메커니즘으로 노이즈 제거가 완료되기 전 더 깨끗한 과거 청크에 먼저 접근하고, 엇갈린 노이즈 제거와 캐시 갱신 단계를 모델 복제본들에 분산시켜 파이프라인 충전 후 한 번의 순전파 라운드마다 하나의 출력 청크를 생성한다(1F1C). 모델을 연속 생성 프로세스에 적응시키기 위해 혼합 노이즈 노이즈 제거, 움직임 감독, 자체 생성 히스토리를 이용한 인과 적응을 순차적으로 도입하는 3단계 훈련 절차를 개발했다. 전체 요약 7문장 읽기 → 007 06:11 ▲ 104 · 댓글 18 NVIDIA의 NVL72 시스템, 올바른 스케줄러로 GPU 활용률 27% 향상 InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. 인프라 · 데브옵스 · Grace Blackwell needs a new scheduler: 27% more usable GPUs from the same racks
Key Point NVL72 같은 랙 규모 시스템에서 통신 병목을 피하려면 하드웨어만으로는 부족하고, 올바른 스케줄링이 처리량을 14% 이상 개선할 수 있다.
핵심 요약
InfiniBand 대신 NVLink를 쓸 때 분산 학습 성능이 43% 향상되는데, 전통적으로 NVLink는 단일 노드 내 통신만 지원했다. NVIDIA의 NVL72 시스템은 한 랙의 72개 GPU를 통합 NVLink 패브릭으로 연결하면서 멀티 노드 AI 워크로드를 고대역폭으로 처리할 수 있게 했다. 대규모 학습에서 텐서 병렬화와 전문가 병렬화는 통신 병목이 되는데, 64웨이 전문가 병렬화를 사용하면 InfiniBand에서 학습 시간의 최대 60%가 통신에 소비된다. 전체 요약 13문장 읽기 → 008 18:11 ▲ 149 · 댓글 53 세레브라스, 3조개 파라미터 모델을 59개 웨이퍼에 분산 배포 세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 인프라 · 데브옵스 · Cerebras Deploys Trillion-Parameter AI Models
Key Point 대규모 언어모델 추론 인프라의 실제 배포 방식을 보여주는 기술 사례로, GPU가 아닌 웨이퍼 기반 칩에서 조 단위 모델을 어떻게 효율적으로 운영하는지 알 수 있다.
핵심 요약
세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 3조 파라미터 규모의 공개 모델 키미 K3를 예시로, 4비트 양자화 기준 각 레이어는 약 16GB가 필요하다. 키미 K3의 경우 69개 선형 주의 레이어(각 웨이퍼당 2개씩 배치 가능)와 24개 밀집 레이어(각 웨이퍼당 1개씩, 나머지는 KV 캐시용)로 총 59개 웨이퍼가 필요하다. 전체 요약 8문장 읽기 → 009 21:11 당일 +104 구글, PyTorch를 TPU에서 실행하는 백엔드 공개 Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. AI · 머신러닝 · google-pytorch/torch_tpu · C++
Key Point PyTorch 기반 프로젝트를 Google TPU에서 GPU 대신 더 저렴하게 실행할 수 있는 경로가 생겼고, ML 엔지니어와 연구자들이 다양한 가속 옵션을 선택할 수 있게 됐다.
핵심 요약
Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. PyTorch 연산을 위한 ATen 커널 구현, XLA 계산 최적화를 위한 컴파일 캐시, 데이터 병렬화와 텐서 병렬화를 지원하는 분산 학습 기능을 포함한다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제와 torch.compile()을 통한 그래프 모드 실행 통합, 디버깅 및 벤치마킹 유틸리티를 제공한다. 전체 요약 7문장 읽기 → 010 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 011 06:11 ▲ 195 · 댓글 47 구글이 PyTorch용 TPU 백엔드 오픈소스화 구글이 TorchTPU를 오픈소스로 공개했으며, 이는 PyTorch 모델과 연산을 구글 TPU 디바이스에서 직접 실행 가능하게 하는 네이티브 백엔드입니다. AI · 머신러닝 · Google open-sources TorchTPU, a native PyTorch back end for TPUs
Key Point PyTorch 사용자들이 NVIDIA GPU 대신 구글 TPU에서 직접 모델을 학습하고 추론할 수 있게 되어, 클라우드 인프라 선택지와 최적화 옵션이 확대됩니다.
핵심 요약
구글이 TorchTPU를 오픈소스로 공개했으며, 이는 PyTorch 모델과 연산을 구글 TPU 디바이스에서 직접 실행 가능하게 하는 네이티브 백엔드입니다. PyTorch ATen 커널 구현, XLA 컴파일 캐시 최적화, 데이터 병렬화와 텐서 병렬화를 포함한 분산 학습 지원, torch.compile() 통합 등의 기능을 제공합니다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제가 포함되어 있으며, 디버깅과 벤치마킹을 위한 유틸리티도 제공됩니다. 전체 요약 8문장 읽기 → 012 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 013 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 014 21:11 ▲ 105 · 댓글 44 AI가 자동으로 완성하는 코드 개발 플러그인, 16분 안에 구현 저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. AI · 머신러닝 · Superlite: A Faster Alternatie to Superpowers
Key Point 자율 코딩 에이전트의 실질적 병목(대기 시간, 빈번한 승인)을 해결해 개발 속도를 52% 단축한 구체적 방법론과 성과를 제시한다.
핵심 요약
저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. 문제를 분석한 결과 인간 게이트(기능당 8~12개 승인), 순차 실행, 모든 작업 후 리뷰, 여러 스킬의 반복 테스트, 느린 Opus 에이전트 사용이 병목이었다. 이를 해결하기 위해 Superlite를 개발했다: 한 번의 승인으로 설계와 계획을 확정하고, 병렬 실행 가능하도록 작업 그래프를 분할하며, 에이전트를 계층별로 할당하고, 코드로 규칙을 강제한다. 전체 요약 11문장 읽기 → 015 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 016 00:11 새 버전 Transformers v5.20.1 출시, Beam 모델 추가 및 버그 수정 Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. AI · 머신러닝 · huggingface/transformers@v5.20.1
Key Point 새로운 고성능 모델 Beam이 추가되고 여러 모델 호환성 및 로딩 버그가 수정되어, 기존 Transformers 사용자와 새로운 모델을 시도하려는 개발자 모두에게 영향이 있다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. Beam은 토큰 효율적인 프론티어급 모델로 코딩과 에이전트 작업에 최적화되어 있다. 자체 하드웨어, 인프라, 클라우드에서 실행할 수 있으며 특정 요구사항에 맞게 커스터마이징 가능하다. 전체 요약 6문장 읽기 → 017 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 018 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 019 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 020 18:11 ▲ 10 · 댓글 3 LLM 학습 중 병렬화 동적 최적화하는 Nereus 공개 LLM의 강화학습 후학습 단계에서 여러 모델을 GPU 클러스터에 배치할 때 자원 가용성, 시퀀스 길이, 메모리 압박, 단계별 병목 등이 변하면서 초기 실행 계획이 비효율적이 되는 문제를 해결한다. AI · 머신러닝 · Nereus: Adaptive Parallelism for LLM Post-Training
Key Point LLM 후학습에서 GPU 자원과 메모리 상황이 실시간으로 변할 때 자동으로 병렬화 전략을 재조정하므로, 대규모 모델 훈련 비용을 크게 절감하려는 조직이 검토할 필요가 있다.
핵심 요약
LLM의 강화학습 후학습 단계에서 여러 모델을 GPU 클러스터에 배치할 때 자원 가용성, 시퀀스 길이, 메모리 압박, 단계별 병목 등이 변하면서 초기 실행 계획이 비효율적이 되는 문제를 해결한다. Nereus는 비용 인식형 런타임으로서 RL 후학습 작업을 효율적인 실행 계획으로 자동 재조정하며, 저오버헤드 컨트롤러가 메모리 실행 가능한 전역 계획을 선택하고 실행 중인 작업을 기반으로 보정한 비용 모델로 전환을 승인한다. 분산 상태를 모델-단계 단위의 탄력형 모델 유닛으로 표현하고 전역 전환 그래프를 이용해 이들 유닛의 변환과 GPU 전송 순서를 조율한다. 전체 요약 5문장 읽기 → 021 21:11 ▲ 59 · 댓글 1 CoWindow: 주의 메커니즘의 중복 계산을 줄인 구조화된 어텐션 기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. AI · 머신러닝 · CoWindow Attention: Full Causal Coverage Is a Collective Property
Key Point 효율적인 장문맥 처리가 필수인 생성형 AI에서 Full Attention의 중복 계산을 제거하면서도 성능을 유지하는 방법이 제시되었으므로, 스케일링 효율성을 개선하려는 팀들의 관심을 받을 만합니다.
핵심 요약
기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. 연구팀이 제안한 CoWindow Attention(CoWA)은 KV 헤드 간에 인과 히스토리 접근을 분산시키는 구조화된 어텐션이다. 모든 헤드는 근거리 대각 윈도우와 접두사-싱크 윈도우를 공유하며, 나머지 먼 과거는 보완적 장거리 윈도우로 분할되어 전체 인과 커버리지를 달성한다. 전체 요약 10문장 읽기 → 022 18:11 ▲ 64 · 댓글 1 어텐션의 계산 효율을 높이는 MALA 메커니즘 제안 기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. AI · 머신러닝 · MassAlloc Attention: Let Attention Allocate Its Own Compute
Key Point Full Attention의 비효율적 계산 패턴을 식별하고 실제 기여도 기반 할당으로 2~3배 속도 향상을 달성하면서도 모델 성능을 유지하는 방법으로, 대규모 언어 모델의 추론·학습 효율을 개선하는 데 직결된다.
핵심 요약
기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. MALA(MassAlloc Attention)는 정규화된 기여도에 따라 후속 계산을 선택적으로 할당하는 퓨즈드 어텐션 프리미티브로, 순전파는 온라인 소프트맥스 정규화기를, 역전파는 최종 정규화기를 재사용한다. 하나의 공통 임계값으로 학습과 추론에서 적응적 유지(retention)가 가능하며, 8K 토큰 비교에서 생략된 질량은 0.0188%로 기준 오라클의 0.0182%에 근접한다. 전체 요약 7문장 읽기 → 023 21:11 ▲ 135 · 댓글 129 Claude Opus 5.5 프롬프팅 가이드 Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. AI · 머신러닝 · Prompting Claude Opus 5.5
Key Point Opus 5.5는 30% 빠른 토큰 생성과 새로운 사고 기능으로 기존 통합의 설정·프롬프트를 모두 재검토해야 하기 때문이다.
핵심 요약
Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. 기본값인 중간 노력도에서 Opus 5.5는 고노력도의 Opus 5보다 코딩과 지식 작업 평가에서 동등하거나 우수하다. 지금은 항상 사고(thinking) 기능이 켜져 있으므로, 노력도를 조정하는 것이 지능·지연·비용을 균형 맞추는 주요 방법이다. 전체 요약 13문장 읽기 → 024 06:11 ▲ 118 · 댓글 69 효율적인 C++ 코드 작성법, 메모리 계층과 캐시부터 C++는 고수준 기능(OOP, STL)과 저수준 제어(메모리 관리, 하드웨어 접근)를 모두 제공하는 유일한 언어로, 게임·실시간 처리처럼 성능이 중요한 분야에서 자주 선택된다. 인프라 · 데브옵스 · Writing Efficient C++ Code (2013)
Key Point 메모리 캐시와 데이터 구조 선택이 성능에 미치는 영향과 구체적 최적화 방법을 배워야 하는 개발자, 특히 게임·시스템 프로그래밍을 다루는 인원에게 실제 적용 가능한 가이드를 제공한다.
핵심 요약
C++는 고수준 기능(OOP, STL)과 저수준 제어(메모리 관리, 하드웨어 접근)를 모두 제공하는 유일한 언어로, 게임·실시간 처리처럼 성능이 중요한 분야에서 자주 선택된다. 많은 프로그래머가 OOP를 개념적으로만 생각하지만, 메모리 계층·캐시·포인터 앨리어싱 같은 저수준 이해 없으면 비효율적인 코드가 나온다. Data-Oriented Design(DOD)은 OOP와 다르지 않게, 데이터 레이아웃을 먼저 설계하고 그에 맞춘 알고리즘을 짜는 방식으로, 수많은 작은 객체의 포인터 호핑보다 배열의 순차 처리가 병렬화하기 쉽고 캐시 효율이 높다. 전체 요약 12문장 읽기 → 025 09:10 ▲ 227 · 댓글 123 AI 실수 원천 차단하는 프로그래밍 언어 'Bend' 공개 형식 증명(proof)으로 AI가 작성한 코드의 정확성을 검증하는 프로그래밍 언어 Bend를 발표했다. AI · 머신러닝 · Bend – A language that blocks AI mistakes via proof, on CPU and GPU
Key Point AI 에이전트가 코드를 자동 생성하는 시대에 형식 증명으로 보안 결함을 원천 차단할 수 있는 새로운 접근 방식을 제시하기 때문입니다.
핵심 요약
형식 증명(proof)으로 AI가 작성한 코드의 정확성을 검증하는 프로그래밍 언어 Bend를 발표했다. C 수준의 단일 코어 성능으로 컴파일되며, 동일 바이너리가 GPU에서 100배까지 빠르게 실행된다. 타입 체커가 증명 체커로 작동해 중간 규모 코드베이스에서 최대 1초 내에 검증을 완료한다. 전체 요약 5문장 읽기 →