쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "상호작용"조건 지우기 ×
001 15:11 ▲ 14 · 댓글 1 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 003 12:11 당일 +156 AI가 웹사이트를 Next.js 앱으로 복제하는 템플릿 공개 AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. AI · 머신러닝 · JCodesMore/ai-website-cloner-template · TypeScript
Key Point AI 에이전트가 자동으로 웹사이트를 분석해 재구성하는 방식이 어떻게 작동하는지, 어떤 기술을 기반으로 하는지 알 필요가 있습니다.
핵심 요약
AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. Claude Code 및 Opus 5.5를 기준으로 개발했으며, Codex, Cursor, OpenCode도 지원한다. 클론 프로세스는 매핑(소스 URL을 로컬 라우트로 변환), 관찰(데스크톱·모바일 페이지 검사, 자산·폰트 추출), 빌드(컴포넌트·상호작용 구현), 비교(원본과 로컬 페이지 대조, 시각적 차이 수정) 4단계로 진행된다. 전체 요약 9문장 읽기 → 004 12:11 ▲ 10 · 댓글 3 인도 은행 챗봇의 절차 준수 평가하는 벤치마크 공개 인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. AI · 머신러닝 · TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
Key Point 인도 은행권의 챗봇 배포가 증가하면서 절차 준수를 무시하고 최종 결과만 맞은 모델을 걸러내는 평가 기준의 필요성이 대두되고 있다.
핵심 요약
인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. 기존 벤치마크는 대화 마지막의 최종 기록만 검증하는데, 카드 차단이나 예금 폐기 등 많은 필수 단계가 기록에 반영되지 않아서 절차를 건너뛴 어시스턴트도 성공으로 판정될 수 있다. 연구팀이 공개한 TauIndianBankBench는 인도 소매금융 업무 1000개를 포함한 액션 기반 벤치마크로, 시뮬레이션 고객과 상호작용하는 어시스턴트를 평가한다. 전체 요약 5문장 읽기 → 005 00:11 ▲ 17 · 댓글 2 CLI 에이전트의 인간협력 평가 기준, REALCLI 제시 명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. AI · 머신러닝 · RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
Key Point CLI 에이전트의 협력 능력을 처음으로 체계적으로 평가하는 기준이 나왔으며, 최상급 모델도 37%대 성능에 불과해 실무 배포 전 해결해야 할 과제가 명확해졌다.
핵심 요약
명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. 기존 벤치마크는 사용자 지시가 고정되거나 결과 평가만 수행했으나, REALCLI는 실시간 협력의 질을 포함한 쌍 비교 평가를 제공한다. 협력 품질을 5가지 차원에서 22개 세부 항목과 51개 상호작용 시나리오로 측정하는 프레임워크를 구축했다. 전체 요약 6문장 읽기 → 006 21:11 당일 +1,199 AI 봇 팀을 채팅 앱에서 운영하는 오픈소스 플랫폼 Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. AI · 머신러닝 · milind-soni/OpenMausBot · TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
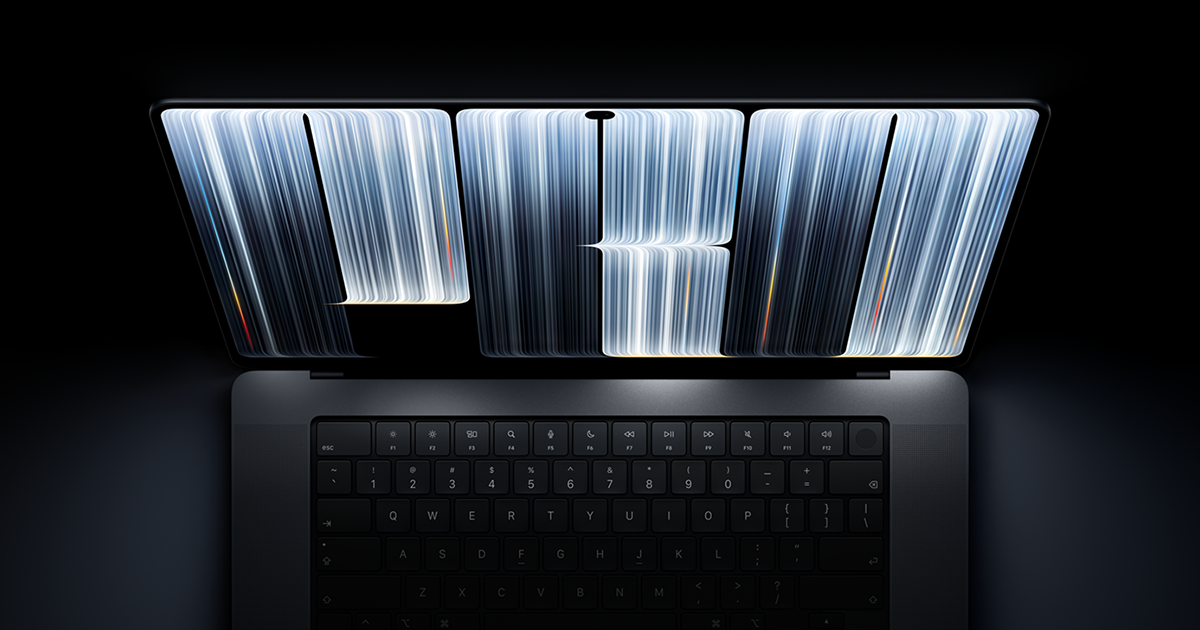
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 007 03:11 ▲ 182 · 댓글 270 PROLED 터치 디스플레이 탑재한 신형 맥북 프로 공개 애플이 새로운 PROLED XDR 디스플레이를 탑재한 MacBook Pro 14인치·16인치 모델을 11월 6일부터 판매한다. 하드웨어 · 시스템 · MacBook Pro with PROLED XDR Display and Touch
Key Point 자체 설계 터치 디스플레이와 4세대 신칩, AI 기능을 모두 갖춘 프로 노트북이 나왔으며, 화면 밝기와 명암비가 랩톱 업계 최고 수준이어서 영상·디자인 업계에 미칠 영향이 크다.
핵심 요약
애플이 새로운 PROLED XDR 디스플레이를 탑재한 MacBook Pro 14인치·16인치 모델을 11월 6일부터 판매한다. PROLED XDR은 탠덤 OLED 기술을 활용해 최고 2000니트 HDR 밝기, 1000니트 풀스크린 지속 밝기, 1천만:1 명암비를 제공하고 P3·Adobe RGB 광색역을 지원한다. 디스플레이에 터치 기능을 내장해 스크롤·줌·드로잉 같은 직관적 제스처로 콘텐츠와 상호작용할 수 있으며 응답 지연을 줄였다. 전체 요약 12문장 읽기 → 008 00:11 ▲ 15 · 댓글 2 음성·영상 AI가 실시간 상황에 제때 반응하지 못한다 옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. AI · 머신러닝 · Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
Key Point 음성·영상 AI가 실시간으로 상황을 인식하고 제때 도움을 주는 것이 얼마나 어려운지 첫 대규모 벤치마크로 드러나, 현재 모델의 한계와 개선할 구체적 방향을 보여준다.
핵심 요약
옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. Omni-InteractScope 벤치마크는 8개 작업군에 걸친 1,479개 인간 주석 상호작용과 1,790개 시간 목표를 제시한다. 도구 호출(tool invocation) 타이밍, 쿼리 없는 조언, 알림, 경고, 상태 추적, 지속적 응답을 포함해 입력 모달리티·사건 트리거·개입 유형·사용자 필요를 연결한다. 전체 요약 8문장 읽기 → 009 00:11 ▲ 381 · 댓글 4 LLM 에이전트 강화학습, 턴 단위 신용할당으로 최적화 장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. AI · 머신러닝 · Multiscale Policy Optimization for Long-Horizon LLM Agents
Key Point LLM 에이전트의 장시간 작업에서 어디에 책임을 할당할지 판단하는 방식을 개선함으로써, 복잡한 추론 작업에서 강화학습 효율을 높일 수 있기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. 현재 방식에서 비평가(critic) 값이 주로 턴(turn) 간에 변화하는 것을 발견했다. 이에 따라 턴 단위에서 최적화하면서 토큰 간 신용할당을 세밀하게 조정할 필요가 있다. 전체 요약 7문장 읽기 → 010 12:11 ▲ 11 · 댓글 2 전문가와 AI 에이전트의 협업, 새로운 벤치마크로 측정한다 인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. AI · 머신러닝 · Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows
Key Point AI 에이전트의 자동화 능력은 계속 늘어나지만, 현실의 업무는 인간과의 지속적인 협업을 필요로 하며, 기존 벤치마크로는 이를 측정할 수 없다는 근본적인 문제를 다룹니다.
핵심 요약
인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. 기존 자동화 벤치마크는 에이전트가 한 번에 작업을 완료하는 능력에 집중하지만, 실제 워크플로우에서 전문가는 계획 수정 등 지속적인 상호작용을 더 중요하게 봅니다. 전문 업무 워크플로우는 여러 상호의존 단계로 이루어져 있어, 협업 에이전트에게 실제로 필요한 두 가지 능력을 도출했습니다: 전문가가 자신의 제안을 채택·수정·거절할지 예측하기, 그리고 지속적인 피드백 없이 협업 품질을 평가하기입니다. 전체 요약 7문장 읽기 → 011 12:11 ▲ 90 · 댓글 7 LLM 에이전트는 사용자 습관을 제대로 학습하지 못한다 장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. AI · 머신러닝 · HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
Key Point LLM 에이전트의 메모리 시스템이 사용자 습관 추론에서 근본적인 한계를 드러냈으며, 현재 방법들의 약 67%가 습관을 잘못 적용한다는 의미다.
핵심 요약
장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. 개별 관찰만으로는 습관의 부분적 증거만 제공할 수 있고, 과거 상호작용 기록만으로는 습관 추론과 적용을 보장하지 못한다. HABIT-Bench는 에이전트 메모리 시스템이 약한 증거에서 습관을 추론하고 이후 요청에 적용하는 능력을 평가하는 벤치마크다. 전체 요약 8문장 읽기 → 012 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 013 12:11 ▲ 20 · 댓글 2 모바일 AI 에이전트의 개인화 능력 평가 벤치마크 공개 사용자의 실제 요청은 종종 불완전하며, AI 에이전트가 올바르게 행동하려면 사용자의 활동 기록에서 누락된 정보를 추론하고 필요한 경우 사용자에게 물어봐야 한다. AI · 머신러닝 · iPrefBench: A User-Centric Benchmark for Personalized Mobile Use Agents
Key Point 현재 개발되는 모바일 AI 에이전트는 작업 실행은 잘하지만 사용자 개인정보를 바탕으로 정확히 행동하는 데는 크게 부족하며, 이 논문은 그 간격을 정량적으로 측정하는 첫 벤치마크를 제시한다.
핵심 요약
사용자의 실제 요청은 종종 불완전하며, AI 에이전트가 올바르게 행동하려면 사용자의 활동 기록에서 누락된 정보를 추론하고 필요한 경우 사용자에게 물어봐야 한다. iPrefBench는 iOS 환경에서 모바일 에이전트의 추론과 질문 능력을 평가하는 벤치마크로, 3,051개의 과거 활동 이벤트를 바탕으로 한 일관된 페르소나와 26개 앱에 걸친 130개의 불완전한 사용자 작업으로 구성되었다. 각 누락된 정보는 사용자 활동 기록에서 추론 가능하거나 사용자에게만 물어볼 수 있도록 설계되었다. 전체 요약 7문장 읽기 → 014 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 016 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 017 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 018 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 019 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 020 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 021 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 022 12:11 ▲ 359 · 댓글 3 성공한 궤적도 학습 데이터로 부족한 이유 도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. AI · 머신러닝 · Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
Key Point 기존에 성공한 상호작용만 학습 데이터로 사용하는 방식의 근본적 문제를 제시하고, 다단계 의존성과 결정 근거를 모두 만족하는 상호작용을 설계하는 방법을 제안하여 에이전트의 학습 효율을 크게 개선한다.
핵심 요약
도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. 효과적인 궤적 감독을 위해서는 중요한 관찰-행동 의존성이 모두 표현되는 구성 커버리지와 각 행동이 에이전트의 학습 가능한 상호작용 이력으로 정당화되는 결정 기반이라는 두 가지 조건이 필요하다. Trajectory2Gym은 지원이 부족한 구성 구조 주변에 실행 가능한 상호작용을 구성하고, 실제 실행에서 정당화된 결정들만을 감독 신호로 사용한다. 전체 요약 8문장 읽기 → 023 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 024 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 025 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 026 21:12 ▲ 107 · 댓글 37 새 관찰이 뇌를 재구성하고 인지 쇠퇴를 늦춘다 새 관찰이 배드민턴이나 악기 학습처럼 뇌 구조를 직접 재구성할 수 있다는 연구가 발표됐다. 기타 · Birdwatching rewires the brain and slows cognitive decline
Key Point 새 관찰이 단순한 여가가 아니라 뇌 구조를 바꾸고 치매·인지 쇠퇴를 완화하는 의학적 중재로 인식되고 있으며, 요양시설과 의료 기관이 실제로 도입하기 시작했다.
핵심 요약
새 관찰이 배드민턴이나 악기 학습처럼 뇌 구조를 직접 재구성할 수 있다는 연구가 발표됐다. 캐나다 토론토 베크레스트 연구소의 에릭 윙 박사는 MRI 뇌 스캔을 비교해 새 식별 전문가들의 뇌가 주의력·시각 인식 영역에서 다르게 배선되어 있음을 발견했다. 전문가 그룹의 뇌는 특정 영역에서 더 높은 조직화 수준을 보였으며, 이는 나이가 들면서 감소하는 뇌의 조직화가 새 관찰을 통해 보존될 수 있음을 시사한다. 전체 요약 12문장 읽기 → 027 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 028 18:11 ▲ 131 · 댓글 70 Next.js 걷어내니 라이트하우스 만점 블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 웹 · 프론트엔드 · Removing Next.js Got My Blog to 100 on Every Lighthouse Category
Key Point Next.js와 같은 현대 프레임워크가 정적 블로그처럼 상호작용이 거의 없는 사이트에서 성능을 해칠 수 있다는 구체적인 증거와, 만점을 위해 어떤 선택이 필요했는지 보여준다.
핵심 요약
블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 기존 선택지들(Medium, Blogger, Ghost, WordPress, Hugo)을 검토했으나 성능과 편의성 면에서 부족했고, Bear Blog를 영감 삼아 더 많은 기능을 갖춘 블로그를 직접 구축하기로 결심했다. 정적 웹사이트에 CDN 캐싱과 이미지 최적화만으로도 충분하다고 판단해 Cloudflare를 도입했으며, 특히 Cloudflare의 Image Transformations 무료 티어(5,000개)를 활용했다. 전체 요약 9문장 읽기 → 029 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 030 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 031 12:11 ▲ 60 · 댓글 2 이커머스 쇼핑 에이전트 평가 벤치마크 공개 Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. AI · 머신러닝 · UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
Key Point 추천 에이전트 개발을 위한 대규모 실제 데이터 벤치마크와 평가 방법론이 제시되어, 이커머스 AI 시스템의 개발과 검증 방식에 새로운 표준을 제시할 수 있다.
핵심 요약
Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. 11,010명의 사용자로부터 수집한 64,729개의 세션 궤적(session trajectory)을 포함하며, 566,102개의 상품과 13가지 액션 타입을 다룬다. 이 벤치마크는 추천 에이전트가 장기간의 사용자 상호작용에서 쇼핑 목표를 달성하는 과정을 평가한다. 전체 요약 8문장 읽기 → 032 15:11 ▲ 100 · 댓글 36 뇌 영역 간 상호작용 감지하는 임플란트 칩 개발 EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 하드웨어 · 시스템 · Neural chip decodes interactions between brain regions
Key Point 뇌 영역 간 네트워크 신호를 분석하는 저전력 임플란트 기술은 기존 치료법의 한계를 극복하고 정신질환에 대한 적응형 치료의 길을 열어준다.
핵심 요약
EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 기존 뇌심부자극(DBS) 시스템은 개방형으로 작동하거나 단일 뇌 영역의 신호만 사용하는 한계가 있으며, 정신질환은 특정 영역 장애보다 뇌 영역 간 소통 단절에서 비롯될 수 있다. LogSync는 뇌 활동을 기록하고 뇌파 강도와 뇌 영역 간 신호 동기화를 추출한 뒤, 머신러닝 알고리즘으로 네트워크 수준의 바이오마커를 분석해 인지·감정 상태를 구분하고 자극 신호를 생성한다. 전체 요약 8문장 읽기 → 033 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 034 09:11 ▲ 190 · 댓글 80 음성 데이터만으로 학습한 실시간 양방향 대화 AI 'Dessa' 공개 Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다. AI · 머신러닝 · Dessa: the most authentic full-duplex speech model ever built
Key Point 음성을 텍스트로 변환하지 않고 원음만으로 AI를 학습시키는 새로운 방식이 실현되었으며, 감정과 뉘앙스를 보존한 더 자연스러운 음성 AI 상호작용이 가능해졌다.
핵심 요약
Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다. 기존 음성 AI와 달리 음성을 텍스트로 변환하지 않고 원본 오디오 데이터만으로 학습했다. 감정, 억양, 웃음, 숨 쉬는 소리, 풍자 등 텍스트로는 손실되는 음성의 뉘앙스를 모두 보존한다. 전체 요약 9문장 읽기 → 035 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 036 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 037 00:11 새 버전 Anthropic Python SDK v2.2.0 출시, 메시지 스레드 API 지원 Anthropic Python SDK v2.2.0이 출시됐으며, 메시지 스레드 API 지원이 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v2.2.0
Key Point Python SDK의 스레드 기반 대화 관리와 비용 추적 기능이 추가되어 복잡한 멀티턴 상호작용을 다루는 개발자에게 영향을 미친다.
핵심 요약
Anthropic Python SDK v2.2.0이 출시됐으며, 메시지 스레드 API 지원이 추가됐다. API에 차원별 사용량·비용 리포트 기능이 추가됐고, 기존 리포트는 레거시로 표시됐다. max_retries 에러 메시지에서 math.inf 제안을 중단했다. 전체 요약 8문장 읽기 → 038 21:11 ▲ 13 · 댓글 2 로봇 조작용 기초 모델 ACE-Brain-0.6 공개 일반 목적 멀티모달 모델들이 구현된 로봇 조작에서 우수한 성능을 보이는 이유는 강한 공간 지각 능력 때문으로, 시각적 방해물 속에서 작업 관련 물체와의 상호작용 위치를 정확히 파악한다. AI · 머신러닝 · ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
Key Point 로봇 작업용 오픈 모델이 상용 대형 모델과 경쟁할 수 있는 수준에 도달했으며, 그라운딩 데이터 확장이 구현화 AI의 성능을 개선하는 핵심 경로임을 실증했다.
핵심 요약
일반 목적 멀티모달 모델들이 구현된 로봇 조작에서 우수한 성능을 보이는 이유는 강한 공간 지각 능력 때문으로, 시각적 방해물 속에서 작업 관련 물체와의 상호작용 위치를 정확히 파악한다. 공간 지각은 고수준 추론을 물리 장면에 연결하는 역할을 하므로, 연구진은 시각 그라운딩을 확장하여 구현화된 조작의 지각적 기반을 강화하는 방법을 조사했다. 로봇 조작 기록과 다양한 출처의 보충 시각 데이터를 결합하는 통합 데이터 파이프라인을 개발했으며, 로봇 기록을 자동으로 주석 처리한 후 검증 가능한 그라운딩 지도학습으로 변환했다. 전체 요약 7문장 읽기 → 039 21:11 ▲ 116 · 댓글 17 C++ 인터페이싱 지원하는 Clojure 방언 Jank 공개 Jank는 C++ 기반으로 만든 Clojure 방언으로, 템플릿·가상 함수·예외·오버로드 해석·RAII 등 C++의 핵심 기능과 보일러플레이트 없이 직접 상호작용한다. 오픈소스 · 도구 · Jank – The native Clojure dialect with seamless C++ interop
Key Point C++ 생태계와 Clojure의 함수형 패러다임을 하나로 통합한 새로운 선택지로, 기존 Java 기반 Clojure보다 네이티브 성능이 필요한 개발자나 게임/시스템 프로그래밍 커뮤니티에 실질적인 도구를 제시한다.
핵심 요약
Jank는 C++ 기반으로 만든 Clojure 방언으로, 템플릿·가상 함수·예외·오버로드 해석·RAII 등 C++의 핵심 기능과 보일러플레이트 없이 직접 상호작용한다. Clang 기반 C++ JIT 컴파일러로 구동되는 대화형 REPL 개발을 지원하며, :jank 리더 조건부를 통해 필요시 C++ 코드와 분기 처리가 가능하다. 어떤 C++ 소스코드든 포함할 수 있고 모든 C/C++ 라이브러리에 링크할 수 있으며, jank 자체도 C++로 컴파일된다. 전체 요약 6문장 읽기 → 040 15:11 ▲ 163 · 댓글 2 AI 에이전트의 실시간 웹 정보 검색 능력 측정 실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. AI · 머신러닝 · Deep Search in Real-World Web Environments
Key Point 현재의 AI 에이전트가 실제 웹에서 다단계 검색을 얼마나 잘 하는지 처음으로 체계적으로 측정하는 기준을 제시하므로, 앞으로의 에이전트 개발 방향을 좌우할 벤치마크가 될 것이다.
핵심 요약
실제 웹 환경에서 AI 에이전트가 다단계 정보 검색을 수행할 수 있는지 평가하는 OpenDS 과제를 제안했다. 기존 연구와 달리 실제 웹은 다양한 출처와 형식의 정보, 복잡한 상호작용 메커니즘을 포함하고 있어 에이전트가 자율적으로 증거를 찾아 통합해야 한다. 200개의 까다로운 과제로 구성된 OpenDS-World 벤치마크를 만들었으며, 다양한 정보 양식, 이기종 파일 형식, 상호작용 접근 요구사항을 포함하고 인간 검증으로 답의 정확성을 보장했다. 전체 요약 6문장 읽기 → 041 03:11 ▲ 19 · 댓글 2 스스로 개선하는 AI, 살아있는 환경에서 진화한다 현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. AI · 머신러닝 · Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
Key Point 모델이 외부 업데이트 없이 자신의 경험으로 지속적으로 개선되는 구조를 실제로 구현해 검증했으며, AI 훈련 패러다임의 근본적 전환을 제시한다.
핵심 요약
현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. 미래 이벤트 예측에 기반한 자기진화 에이전트 시스템 'DeepEvolve'를 개발했으며, 에이전트가 지속적으로 변화하는 환경과 상호작용하면서 경험을 내재화·외재화하여 개선된다. 검증 가능한 작업을 합성하는 살아있는 환경과 각 예측 뒤의 추론 궤적을 능력으로 변환하는 순환진화 엔진으로 구성되며, 탐색을 예측으로부터 분리하여 파라미터 수준의 진화를 오염 위험이 있는 라이브 환경에 맞춘다. 전체 요약 8문장 읽기 → 042 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 043 03:11 ▲ 31 · 댓글 2 추천 모델, 각 아이템별로 계산량 다르게 할당 기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. AI · 머신러닝 · Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
Key Point 추천 시스템의 계산 효율을 각 아이템의 중요도에 맞춰 동적으로 조정하는 새로운 접근법을 제시하며, 실제 모든 백본 아키텍처에서 성능 향상을 입증했다.
핵심 요약
기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. 논문은 두 가지 핵심 진단을 제시한다: (1) 동일 시퀀스 내 아이템들이 필요한 계산량이 큰 차이가 있으며, 대부분은 얕은 처리로 수렴하지만 일부 중요 아이템은 최대 깊이에서만 안정화된다. (2) 고정 할당은 최적이 아니어서 이미 수렴한 아이템의 계산 용량을 낭비하면서 동시에 전체 추천 품질을 손상시킨다. 이를 해결하기 위해 LoopRec을 제안한다. LoopRec은 단일 가중치 공유 블록을 반복 적용하고 각 반복 경계에 경량 게이트를 도입해 개별 아이템마다 계속 진행할지 종료할지 이진 결정을 내린다. 전체 요약 8문장 읽기 → 044 00:11 ▲ 31 · 댓글 1 알리바바 Qwen-Audio-3.1-ASR, 화자 식별과 음성 분석 강화 알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. AI · 머신러닝 · Qwen-Audio-3.1-ASR Technical Report
Key Point 음성 인식이 단순 전사를 넘어 화자 식별, 음악·음성 분석까지 통합하는 추세를 보여주며, 다양한 배포 환경을 지원하는 확장성이 실무 적용의 핵심이다.
핵심 요약
알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. 30개 언어와 16개 중국 방언을 지원하며, 이전 발화 맥락 반영, 계층형 핫워드 커스터마이징, 자동 전사 보정 등 명령 제어 기능을 제공한다. 화자 분리 ASR은 화자 레이블, 타임스탐프, 인식된 텍스트를 포함한 구조화된 출력을 생성하며, 턴 전체에 걸쳐 일관된 화자 레이블을 유지하고 겹치는 음성을 표현한다. 전체 요약 6문장 읽기 → 045 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 046 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 047 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 048 15:11 ▲ 155 · 댓글 2 한 손 조작 넘어 양손 협력까지, 범용 로봇 제어 모델 DONIC 기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. AI · 머신러닝 · DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
Key Point 로봇이 두 손을 동시에 협력시켜 복잡한 조작 작업을 할 수 있도록 하는 첫 범용 모델로, 인간의 시연 영상만으로 학습할 수 있다는 점이 실용적 의미를 갖는다.
핵심 요약
기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. 연구팀은 첫 범용 양손 추적기 DONIC과 229개 물체를 포함한 1,575개 시퀀스의 양손 상호작용 데이터셋 BiHOI를 공개했다. DONIC은 근처정책최적화(PPO)와 행동복제를 결합하고, 성공한 실행을 재훈련 데이터로 재활용하는 피드백 루프를 사용한다. 전체 요약 6문장 읽기 → 049 15:11 ▲ 14 · 댓글 2 코딩 에이전트 훈련, 정책뿐 아니라 도구까지 기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. AI · 머신러닝 · Training the Whole Agent, Not Just the Model
Key Point 코딩 에이전트의 훈련 방식을 근본적으로 바꾸면서 SWE-bench에서 유의미한 성능 향상을 보여줘, 실제 소프트웨어 엔지니어링 작업을 자동화하는 에이전트의 실용성이 높아진다.
핵심 요약
기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. HarnessAdapt-RL은 강화학습 중 정책과 함께 에이전트의 도구·훅을 적응시키는 방식이다. 잘못된 수리 전략에는 고정된 교사 모델이 작업별 메커니즘 레벨의 스킬을 생성하고, 여러 작업에 반복되는 상호작용 문제에는 별도 교사 모델이 도구와 훅을 진화시키되 통과율이나 학습 가능한 비율을 개선할 때만 유지한다. 전체 요약 6문장 읽기 → 050 15:11 ▲ 484 · 댓글 2 다중분광 이미지 해석용 위치-채널 기반 설명 방법 다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. AI · 머신러닝 · Spectral-Spatial Interpretation
Key Point 위성·의료영상 등 다중분광 데이터를 다루는 컴퓨터 비전 모델에서 어느 파장대 어느 위치가 결정에 영향을 미치는지 정확히 파악할 수 있게 되면 모델 해석 능력이 한 단계 높아진다.
핵심 요약
다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. 기존 방식은 공간적 히트맵이나 전역 채널 점수만 보여주는데, SSI는 각 위치마다 채널 간 상호작용을 조건부 게임으로 정의하고 샤플리 값을 적용해 위치-채널 기여도 행렬을 생성한다. 고정된 주변 맥락 속에서 각 위치의 채널별 중요도를 계산하며, 채널 기여도를 모두 합산하면 그 위치를 기준 이미지로 교체했을 때의 효과와 정확히 일치한다. 전체 요약 6문장 읽기 → 051 15:11 ▲ 88 · 댓글 2 컴퓨터 사용 AI 에이전트, 오픈소스로 학습 환경 대규모 생성 Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. AI · 머신러닝 · Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
Key Point 컴퓨터 상호작용을 수행하는 AI 에이전트 학습이 실제 환경의 안전 위험 없이 대규모로 가능해지는 방법이 제시되었고, 오픈소스만으로 구축 가능함을 입증했다.
핵심 요약
Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. 기존 단일 인터페이스 접근과 달리, 그래픽 사용자 인터페이스·모델 컨텍스트 프로토콜 서비스·커맨드 라인 인터페이스를 함께 지원해 시각 상호작용·도구 사용·코드 실행을 자유롭게 조합할 수 있다. 오픈소스 모델만으로 구성되어 있으며, 폐쇄형 최신 모델 없이도 고품질 컴퓨터 사용 환경 생성이 가능함을 보여준다. 전체 요약 7문장 읽기 → 052 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 053 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 054 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 055 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 056 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 057 00:11 ▲ 105 · 댓글 71 Claude로 코드 공격 표면 줄이기 Anthropic이 AI 모델을 사용하여 소프트웨어의 불필요한 공격 표면을 자동으로 찾아내고 제거하는 방법을 연구했다. 보안 · Using Claude to reduce the attack surface of code
Key Point OpenSSH 같은 최고 수준의 감시 코드에서도 불필요한 공격 표면이 발견되며, 개발자는 Claude를 사용해 자신의 소프트웨어 공격 표면을 체계적으로 줄일 수 있다.
핵심 요약
Anthropic이 AI 모델을 사용하여 소프트웨어의 불필요한 공격 표면을 자동으로 찾아내고 제거하는 방법을 연구했다. 개별 취약점 수정보다 코드 도달 가능성을 줄이면 알려지지 않은 취약점의 심각도를 낮출 수 있다. Claude가 25개 오픈소스 프로젝트(C, C++, Java, PHP, Python, 500만 줄 이상)를 분석해 493개 문제를 발견했다. 전체 요약 12문장 읽기 → 058 00:11 ▲ 22 · 댓글 4 장시간 작업용 LLM 에이전트, 실행 상태를 메모리처럼 재사용 장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. AI · 머신러닝 · FlowState: Execution State as Memory for Long-Horizon LLM Agents
Key Point 장시간 작업에서 LLM 에이전트의 맥락 길이 문제를 해결하는 새 방식이 기존 방법 대비 성능과 효율성 모두에서 실질적 개선을 보여주기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. FlowState는 실행 상태를 메모리로 취급해 요청 간에 유지하고 재방문할 수 있으며, 의미론적으로 타입된 상태 노드·관계·도구 관찰 참조를 보존해 필요 시에만 접근하도록 분리한다. Incremental State Update(ISU)는 실행 루프 내에서 새 입력과 피드백에 따라 현재 상태를 유지하고, Progressive State Access(PSA)는 추론 중 필요에 따라 과거 상태와 근거를 점진적으로 공개한다. 전체 요약 5문장 읽기 → 059 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 060 18:11 ▲ 102 · 댓글 156 직원 시간의 12% 빼앗는 회의, 경제학이 증명했다 NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 스타트업 · 비즈니스 · Why do we have so many meetings?
Key Point 기업 문화에서 만성적으로 비판받는 회의가 실제로는 임금 성장과 지식 전달을 촉진하는 메커니즘이라는 경제학적 증거가 처음 제시되었기 때문이다.
핵심 요약
NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 회의는 직원들의 평균 업무 시간의 12%, 기업의 임금 지출의 14%를 소비하고 있으며, 계획·문제 해결·정보 공유·프로젝트 조율이 회의 활동의 대부분을 차지한다. 고임금·고매출 기업일수록 직원 시간의 기회 비용이 더 높음에도 불구하고 회의에 더 많은 자원을 할당하고 있다. 전체 요약 6문장 읽기 → 061 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 062 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 063 12:11 ▲ 227 · 댓글 3 멀티모달 GUI 에이전트의 주의력 집중 방식 FocusGUI 스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. AI · 머신러닝 · Focused Omni-Modal GUI Agents
Key Point 멀티모달 정보를 처리하는 GUI 자동화 에이전트가 불필요한 정보로 인한 오류를 줄이고 성능을 대폭 향상시키는 새로운 방식을 제시하고 있다.
핵심 요약
스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. 각 단계마다 실제로 필요한 정보는 다르므로, 단계별로 적응적이고 행동 충분하며 비방해적인 '집중된 인식'을 요구한다. FocusGUI는 경량 어댑터로서 현재 의사 결정에 필요한 멀티모달 채널을 동적으로 우선순위화하고, 가장 관련성 높은 정보를 압축된 잠재 표현으로 변환한다. 전체 요약 7문장 읽기 → 064 12:11 ▲ 66 · 댓글 3 장시간 작업·과학 탐구 할 수 있는 35B 에이전트 모델 공개 Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. AI · 머신러닝 · Sage-A1.5: From Long-Horizon Execution to Scientific Exploration with Capability Composition
Key Point 기존 에이전트 모델의 장시간 작업 신뢰성 문제와 제한된 자율성을 해결하는 구체적 기법(검증·병렬 위임·탐색적 탐구)을 35B 규모 오픈소스 모델로 구현한 점이 중요하다.
핵심 요약
Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. 이전 버전 A1을 개선해 장시간 문제 해결을 위한 적응형 능력 조합(capability composition)을 지원한다. 세부 개선 사항은 세 가지다: 첫째, 에이전트 오케스트레이션으로 서브에이전트 간 작업 위임과 병렬 협업을 통해 복잡한 작업을 분해하고 동시 실행하며 간섭을 줄인다. 전체 요약 6문장 읽기 → 065 03:11 ▲ 10 · 댓글 2 메모리의 가치를 배우다: 자원 제약 속 에이전트 최적화 지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. AI · 머신러닝 · Remembering Has a Price: Learning Memory Worth under Resource Constraints
Key Point 토큰 수 제약이 있는 LLM 에이전트에서 메모리 관리의 비용-편익을 최적화하는 새로운 접근법으로, API 호출 비용을 줄이면서 성능을 개선하는 실제 경로를 보여준다.
핵심 요약
지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. 이러한 강한 자원 제약 하에서 기존 평생 학습 메모리 방식들이 비효과적이 되며, 정교한 접근법도 단순 검색이나 메모리 없는 에이전트보다 나은 성과를 내지 못한다. 문제의 핵심은 단순히 관련 경험을 검색하는 것이 아니라 실제로 보존하고 재사용할 가치가 있는 경험을 판단하는 것이다. 전체 요약 7문장 읽기 → 066 03:11 ▲ 181 · 댓글 92 Cloudflare, TypeScript을 Rust로 포팅한 tsrs 공개 Cloudflare와 VoidZero, Owner.com의 Max Schwenk가 협력해 TypeScript 컴파일러를 Rust로 포팅한 tsrs를 개발 중이며, TypeScript 팀과 긴밀히 협력하고 Oxc JavaScript 컴파일러 툴체인 일부로 인큐베이션 중이다. 웹 · 프론트엔드 · Tsrs: A Port of TypeScript to Rust
Key Point TypeScript 검사 속도를 8배 높이면서 메모리를 70% 줄인 Rust 포트가 브라우저와 엣지 환경에서도 개발 환경 구성을 가능하게 한다.
핵심 요약
Cloudflare와 VoidZero, Owner.com의 Max Schwenk가 협력해 TypeScript 컴파일러를 Rust로 포팅한 tsrs를 개발 중이며, TypeScript 팀과 긴밀히 협력하고 Oxc JavaScript 컴파일러 툴체인 일부로 인큐베이션 중이다. tsrs는 TypeScript 7.0 대비 최대 8배 빠르고 약 70% 적은 메모리를 사용하며, TypeScript 팀의 최적화 일부가 tsrs에서 역으로 업스트림되었다. Cloudflare는 TypeScript 포크가 아니며, TypeScript 팀이 언어 설계와 방향을 전적으로 통제해야 한다는 입장을 유지하고, tsrs는 원본 구현을 엄격히 보존한다. 전체 요약 10문장 읽기 → 067 00:11 새 버전 FastAPI 0.152.0, 헤더 파라미터 검증 오류 메시지 개선 FastAPI 0.152.0 릴리스에서 헤더 파라미터 모델의 검증 오류가 Python 필드명(int_val)이 아닌 HTTP 헤더명(int-val)을 보고하도록 변경되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.152.0
Key Point 헤더 검증 오류 메시지가 HTTP 표준명으로 표시되므로, 클라이언트와의 상호작용 문제를 더 빠르게 파악하고 해결할 수 있다.
핵심 요약
FastAPI 0.152.0 릴리스에서 헤더 파라미터 모델의 검증 오류가 Python 필드명(int_val)이 아닌 HTTP 헤더명(int-val)을 보고하도록 변경되었다. 명시적 alias가 지정되거나 Header(convert_underscores=False)가 설정된 경우, 또는 Pydantic 모델에서 loc_by_alias=False가 설정된 경우에는 기존 동작을 유지한다. 이 변경으로 개발자는 헤더 검증 오류 시 실제 HTTP 헤더명을 받아보게 되어 디버깅이 더 직관적이 된다. 068 00:11 ▲ 11 · 댓글 2 산업용 로봇 조작 평가 벤치마크 'LIBERO-Industry' 공개 LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 하드웨어 · 시스템 · LIBERO-Industry: Benchmarking Robotic Manipulation under Industrial Process Constraints
Key Point 실제 제조 환경의 복잡한 제약을 반영한 평가 지표가 없어 범용 로봇 정책의 산업 적용 가능성을 정확히 측정할 수 없었는데, 이제 체계적인 벤치마크로 검증할 수 있게 됐다.
핵심 요약
LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 유연 제조(고혼합·소량 생산) 환경에서 로봇이 대응해야 하는 제품 변종, 이동 재료 흐름, 제한된 작업 시간, 기하학적 공차 같은 산업용 제약을 반영했다. 3가지 작업 시나리오(정적→동적 로딩, 동적→정적 언로딩, 동적→동적 전달)로 구성되며 총 216개 태스크를 포함한다. 전체 요약 7문장 읽기 → 069 21:11 당일 +682 Claude Code용 AI 시대 SEO 분석 플러그인 공개 Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. 오픈소스 · 도구 · AgriciDaniel/claude-seo · Python
Key Point Google의 AI 검색 최적화 가이드를 완전히 구현한 첫 번째 실제 도구로, SEO 감시를 4시간에서 12분으로 단축하고 모든 추천에 검증 기준을 붙인다는 점이 기존 상용 도구와의 구별점이다.
핵심 요약
Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. Python 기반이며 MIT 라이선스 오픈소스로 제공되고, 웹사이트 전체 감시 10~15분이면 완료된다. 모든 추천은 Google의 공식 가이드에 기반한 근거와 함께 제시되며, 각 발견사항마다 '이것이 실패했다고 어떻게 알 수 있는가'에 대한 검증 기준을 포함한다. 일반 사용자용 공개 저장소(`AgriciDaniel/claude-seo`)와 AI Marketing Hub Pro 회원용 프라이빗 미러(`AI-Marketing-Hub/claude-seo`)의 두 버전으로 제공되며, 후자는 신규 기능 조기 접근이 가능하다. 전체 요약 13문장 읽기 → 070 21:11 당일 +403 코드 에디터에서 작동하는 투명 데스크톱 펫, 100+ 애니메이션 담아 공개 DeepSeek Harness(DSH) 플러그인으로 제공되는 투명 배경 데스크톱 펫으로, 100개 이상의 애니메이션(대기·행동·상호작용)을 탑재했다. 스타트업 · 비즈니스 · PC2005-cloud/dsh-pet · TypeScript
Key Point 데스크톱 펫을 직접 생성·커스터마이징할 수 있는 완전한 생성 체인이 공개되었으며, 이는 개발자가 AI 영상 생성과 자동화 소재 처리를 통해 자신의 고유한 데스크톱 펫을 만들 수 있음을 의미한다.
핵심 요약
DeepSeek Harness(DSH) 플러그인으로 제공되는 투명 배경 데스크톱 펫으로, 100개 이상의 애니메이션(대기·행동·상호작용)을 탑재했다. 한 줄 명령으로 설치하며 브라우저와 데스크톱 독립 창에서 동시 실행 가능하고, 다중 인스턴스로 여러 펫을 같은 화면에 배치할 수 있다. 크기·위치·display 모드(웹만/데스크톱만/둘 다/비표시)를 설정 페이지나 config.jsonc 파일로 구성 가능하며, 물리 시뮬레이션을 통해 드래그·투척·반발을 구현했다. 전체 요약 13문장 읽기 → 071 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 072 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 073 18:11 ▲ 12 · 댓글 2 숨은 상태까지 관리하는 게임형 AI 비디오 생성 시스템 기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. AI · 머신러닝 · State World Models: Execute the Rules, Generate the Pixels
Key Point 기존 AI 비디오 생성 모델들은 화면에 보이지 않는 게임 상태를 제대로 추적하지 못하는데, 이 논문은 상태 관리 시스템을 도입해 규칙 준수율을 32%에서 92%로 끌어올린 방법을 제시한다.
핵심 요약
기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. Stateful Harness는 세계 상태 관리와 비디오 렌더링을 분리하는 프레임워크로, 정해진 규칙에 따라 세계 상태를 진화시키고 각 단계마다 비디오 모델로 장면을 생성한 뒤 다음 턴의 상태 업데이트에 활용한다. 사용자가 선택한 행동을 해석하고 3D 씬의 미리보기를 통해 공간과 카메라 위치를 제시하며, 생성된 비디오 클립으로 다시 세계 상태를 갱신하는 순환 구조를 갖춘다. 전체 요약 7문장 읽기 → 074 18:11 ▲ 28 · 댓글 2 LLM 에이전트의 메모리 효율화, 강화학습으로 최적화 LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. AI · 머신러닝 · MemPilot: Orchestrating On-Demand Multimodal Memory Curation for LLM Agents
Key Point LLM 에이전트가 상황에 맞게 메모리 처리 비용을 조절할 수 있게 함으로써, 가격과 속도 제약이 있는 실제 배포 환경에서 실용적인 선택지를 제공한다.
핵심 요약
LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. MemPilot은 성능·비용·지연 시간 우선순위에 따라 요청 시 메모리를 정리하는 유연한 프레임워크를 제시한다. 강화학습으로 최적화한 다단계 정책을 통해 사전 구축 메모리 검색과 쿼리 특화 정리 중 선택하며, 증거량·정리 지시·모델 선택·이미지 접근을 통합 제어한다. 전체 요약 7문장 읽기 → 075 15:11 ▲ 155 · 댓글 3 인간의 경험에서 배우는 홀리스틱 세계 이해 시스템 머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. AI · 머신러닝 · Holi-World: Building Holistic World Intelligence from Human-Ego Experience
Key Point 인간의 일상 영상에서 자동으로 학습 데이터를 만들어 세계 이해 AI를 훈련하는 새로운 방식을 제시해, 값비싼 수동 주석을 줄이면서 지각 AI의 실용적 확장을 가능하게 한다.
핵심 요약
머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. HOLI-WORLD는 카메라 캡처·세계 표현·자동 데이터 구성·모델 학습·평가를 통합하는 생태계로, 수동 주석 의존성을 줄인다. HOLIWORLD-Foundry는 정적·동적 인식을 결합해 장면 구조·물체 상태·상호작용 이력을 자동으로 연결하는 '세계 기록'을 구성한다. 전체 요약 8문장 읽기 → 076 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 077 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 078 15:11 ▲ 40 · 댓글 4 AI 동료의 협업 능력 키우는 학습 환경 자동 생성 AI 동료는 도구 조합, 순차적 소통, 변화하는 작업 공간 상태 대응을 동시에 해야 하며 이를 위한 체계적인 학습이 필요하다. AI · 머신러닝 · CoworkEnv: Synthesizing Training Environments for Long-Horizon Cowork Agents
Key Point AI 에이전트가 실제 업무 환경에서 도구를 조합하고 다단계로 소통하며 학습하는 방식이 어떻게 체계화되는지 보여주며, 구체적 성능 향상 수치로 실용 가치를 입증한다.
핵심 요약
AI 동료는 도구 조합, 순차적 소통, 변화하는 작업 공간 상태 대응을 동시에 해야 하며 이를 위한 체계적인 학습이 필요하다. CoworkEnv는 이런 AI 동료를 위한 실행 가능한 학습 환경을 자동으로 생성하는 프레임워크다. 업무 요구사항이 작업 구성을 가이드하고, 프로그램 검증과 피드백 기반 수정으로 사양과 채점 방식을 자동 생성한다. 전체 요약 7문장 읽기 → 079 15:11 ▲ 32 · 댓글 2 월드 모델의 일반화 능력을 평가하는 AnyGoal 벤치마크 공개 월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. AI · 머신러닝 · AnyGoal: On World Model Generalization Beyond Expert Rollouts
Key Point 월드 모델의 진정한 일반화 능력을 측정하는 표준화된 벤치마크가 부족한 상황에서, 구성적 일반화 실패 사례들을 체계적으로 드러내는 평가 도구가 제시되어 향후 모델 개선 방향을 명확히 제시한다.
핵심 요약
월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. 연구팀은 AnyGoal이라는 벤치마크와 오픈소스 라이브러리를 공개했으며, 기존 월드 모델 환경들을 변형해 새로운 목표를 가진 태스크 변이체들을 만들었다. 각 태스크는 개별 상태 요소와 행동들은 학습 범위 내에 있지만, 그 조합은 전문가 궤적에서 거의 나타나지 않도록 설계되었다. 전체 요약 6문장 읽기 → 080 12:11 ▲ 43 · 댓글 4 코딩 AI, 스스로 실패를 분석해 개선하는 법 배우다 LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. AI · 머신러닝 · Self-Evolving Coding Agents via Harness-Policy Optimization
Key Point 코딩 AI의 성능을 높이는 데 도구 사용 방식과 모델 학습을 함께 개선하는 방법이 유의미한 성과를 보여주고 있기 때문이다.
핵심 요약
LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. Self-HPO는 두 성분을 번갈아 최적화하는 자기개선 프레임워크로, 현재 정책이 자신의 실패를 분석해 새로운 harness 후보를 제안하는 H-스텝과 RL로 정책을 업데이트하는 P-스텝을 반복한다. 학습 중 어려운 작업들이 다음 라운드의 harness 탐색 대상이 되어, harness 최적화가 진화하는 정책의 실패 패턴에 계속 맞춰진다. 전체 요약 6문장 읽기 → 081 06:11 ▲ 279 · 댓글 111 MiniMax M3.1 Flash 출시, 70% 가격 인하하고 추론 속도 3배 빨려 MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. AI · 머신러닝 · MiniMax M3.1 Flash
Key Point 에이전트 작업의 비용을 크게 낮추면서 최상위 모델 수준의 성능을 제공하는 모델이 나왔으니, 자동화 솔루션과 개발 업무에 LLM을 활용하는 기업들에게 실질적인 선택지가 생겼다는 뜻이다.
핵심 요약
MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. 자동화 업무·코딩·컴퓨터 사용·사이버보안 분야에서 상위 모델 수준의 성능을 보이며, AutomationBench-AA에서 우수한 순위를 기록하고 판매·마케팅·운영·고객서비스·재무·HR 등 기업 워크플로우를 자동화한다. DeepSWE v1.1에서 73.7% 점수로 코딩 업무에 강하며, 다단계 계획·문서 일관성 유지·금융 규정 준수 같은 복잡한 실무 과제를 처리한다. 전체 요약 10문장 읽기 → 082 21:11 당일 +184 AI 초보자 위한 완전한 빕 코딩 학습 가이드 데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. AI · 머신러닝 · datawhalechina/easy-vibe · JavaScript
Key Point AI 코딩의 기초부터 프로덕션 배포까지 무료로 배울 수 있는 체계적이고 다국어 지원되는 교육 자료로, 특히 초보자가 AI로 실제 제품을 만들어본다는 점이 차별화된다.
핵심 요약
데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. 초보자 단계(Stage 1)는 실제 문제 찾기에서 시작해 기회 포착, 방향 선택, 사용자 조사, 프로토타입 구축, AI 통합, 최종 완성까지 단계별로 진행되며 실습 예제와 상호작용형 데모로 '배우고 잊는 것'을 방지한다. 중급 개발자 단계(Stage 2)는 프론트엔드 UI 설계, Git 및 데이터베이스, 백엔드 API, Stripe 결제 통합, Zeabur 배포 등을 다루며 AI 카피라이팅 SaaS, 온라인 시험 시스템 등 실제 프로젝트를 완성한다. 전체 요약 8문장 읽기 → 083 18:11 ▲ 73 · 댓글 4 영상 생성 지연 시간 없이 고품질 모델 쓰는 법 인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. AI · 머신러닝 · Speculative Sampling in Interactive Video Generation
Key Point 실시간 영상 생성의 지연 시간과 품질 사이의 근본적 트레이드오프를 해소하는 기법으로, 스트리밍 기반 영상 생성 시스템의 아키텍처를 재설계한다.
핵심 요약
인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. Speculative Sampling 기법을 제안하는데, 이는 큰 양방향 윈도우의 모델링 능력과 작은 윈도우의 저지연 상호작용을 결합한다. 노이즈 래턴트를 패딩으로 추가해 모델링 윈도우를 확장하고, 조건이 바뀌지 않으면 예측 결과를 캐시해 재사용한다. 전체 요약 7문장 읽기 → 084 18:11 ▲ 116 · 댓글 196 AI 도입 선두 기업 Anthropic, 주니어 직군은 줄고 생산성은 5배 증가 Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. AI · 머신러닝 · How employment is changing at Anthropic
Key Point AI 기반 조직 구조 변화의 선제적 신호를 보여주므로, 향후 다른 기업과 업계의 일자리·채용·업무 형태 변화를 예측하는 데 실질적 데이터를 제공한다.
핵심 요약
Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. 2026년 8월 기준 AI 에이전트 작동 시간이 직원 작동 시간의 6배에 달하며, 엔지니어 코드 커밋 속도는 6개월 전 대비 5배 증가했다. 코딩 에이전트 채택 후 엔지니어들의 코드량이 급증했으며, 영업 담당자도 더 많은 거래를 성약했고, 변호사·회계사·채용담당자 등 비기술 직군도 산출량이 증가했다. 전체 요약 12문장 읽기 → 085 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 086 15:11 ▲ 164 · 댓글 2 비전-언어 모델이 3D 공간을 직접 탐색하며 추론하는 방법 시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. AI · 머신러닝 · Learning to Think and Explore in 3D World
Key Point 3D 환경에서 능동적으로 탐색해야만 답할 수 있는 문제에서 기존 상용 모델을 능가하는 오픈소스 모델 사례를 제시하며, VLM의 추론 능력을 확장하는 새로운 학습 패러다임을 보여줍니다.
핵심 요약
시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. 초기 질문과 첫 번째 관점에서 시작한 뒤, 모델이 반복적으로 추론하고 이동·회전 같은 행동을 통해 시점을 변경하며 최종 답변을 제출하는 방식입니다. 궤적 감독 미세조정 후 강화학습(RL)을 적용했으며, 보상은 최종 답변 정확도로만 주어져서 모델이 어떤 시점을 방문할지는 스스로 학습합니다. 전체 요약 8문장 읽기 → 087 15:11 ▲ 40 · 댓글 4 모바일 에이전트 성능 비약 MobileGym++로 일상 앱 제어 학습 OpenMobile-2는 완전히 공개된 훈련 환경과 레시피로 모바일 에이전트를 구축한 시스템이다. AI · 머신러닝 · OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools
Key Point 모바일 AI 에이전트가 일상 앱을 자동 제어하는 수준이 실제 기기에서 거의 2배로 개선되었으며, 12,000개 데이터와 300개 도구 같은 대규모 공개 자산이 학계의 진입장벽을 낮춘다.
핵심 요약
OpenMobile-2는 완전히 공개된 훈련 환경과 레시피로 모바일 에이전트를 구축한 시스템이다. MobileGym++은 실제 상용 앱을 모방한 35개 앱으로 시작하며 안드로이드 에뮬레이터의 앱들을 포함해 총 110개 이상의 앱을 제공한다. 교차 앱 워크플로우를 지원하면서도 리셋과 검증을 위해 완전한 제어 가능성을 유지한다. 전체 요약 8문장 읽기 → 088 12:11 ▲ 34 · 댓글 3 장기 추론 에이전트를 위한 나무 구조 기반 정책 자기 증류법 강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. AI · 머신러닝 · Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
Key Point 장기 수평선 에이전트 학습 시 정책 편차와 신용할당 문제를 동시에 해결하는 새로운 방식이 기존 GRPO보다 실제 성과를 개선했기 때문입니다.
핵심 요약
강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. 기존 방식은 학습된 비평가, 과정 보상 모델, 온정책 증류 등으로 더 조밀한 신용을 얻지만 가치 네트워크나 강한 외부 교사가 필요해 훈련 복잡도가 높다. TreeOPSD는 비평가 없이 각 상호작용 턴을 나무 노드로 취급하고 공유 접두사에서 대안 경로를 분기하며 터미널 보상을 재귀적으로 역전파해 암묵적 턴 수준 신용을 생성한다. 전체 요약 6문장 읽기 → 089 12:11 ▲ 101 · 댓글 3 장기 작업 AI, 히스토리 대신 객체로 문맥 정리 장기 작업을 수행하는 AI 에이전트는 누적된 진전을 기록하는 긴 상호작용 히스토리를 반복해서 처리해야 한다는 문제가 있다. AI · 머신러닝 · Pack Light, CarryOn: Building Object-Oriented Context for Long-Horizon Agents
Key Point 컨텍스트 윈도우 제약이 있는 LLM 기반 에이전트에서 긴 작업 수행 시 토큰 사용량을 절반 이상 줄이면서 오히려 성능을 높이는 새로운 접근법이다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 누적된 진전을 기록하는 긴 상호작용 히스토리를 반복해서 처리해야 한다는 문제가 있다. CarryOn은 히스토리 대신 재사용 가능한 작업 객체를 중심으로 문맥을 조직하는 객체 지향 문맥 런타임이다. 기존 방식의 압축된 히스토리나 재구성된 진전 기록 대신, 재사용 가능한 작업 객체, 보완 실행 문맥, 최근 상호작용 로그로 문맥을 구성한다. 전체 요약 5문장 읽기 → 090 09:11 ▲ 158 · 댓글 97 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. AI · 머신러닝 · Hybrid Reasoning Agents: LLM agents that think in latent space, act through text
Key Point 텍스트만으로 처리하던 LLM 에이전트의 비효율성을 내부 잠재 추론과 외부 텍스트 상호작용으로 분리해 대폭적인 속도와 비용 개선을 달성한 새로운 에이전트 아키텍처이다.
핵심 요약
기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. HybridAgents는 하나의 생성 과정 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하는 구조를 제시한다. HybridLink라는 경량 모듈이 텍스트와 잠재 모드 간 원활한 전환을 가능하게 하며, 지속적인 작업 메모리가 여러 턴에 걸쳐 손실 없는 하이브리드 문맥을 유지한다. 전체 요약 9문장 읽기 → 091 12:11 ▲ 106 · 댓글 2 희소 자동인코더 표현이 얼마나 합성적인지 검증 희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. AI · 머신러닝 · Behavioral Compositionality of Sparse Autoencoder Representations
Key Point SAE 특성이 실제로 신경망 행동을 독립적으로 설명하는지가 오랫동안 미해결 문제였는데, 이 논문이 정량적 측정 방법과 한계를 처음 체계적으로 보여줌으로써 해석가능 AI 연구의 방향을 제시한다.
핵심 요약
희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. 연구팀은 SAE Additivity Residuals(SAR)를 도입해 설명되지 않은 행동 변이를 상호작용 차수별로 측정하며, 모집단 SAR은 정확히 그 차수 이상의 상호작용 에너지 정규화값이다. 학습된 SAE 좌표와 같은 부분공간의 합 보존 무작위 회전을 비교하면, 18개의 모델과 행동 설정 모두에서 학습된 좌표가 더 낮은 1차 잔차를 보인다. 전체 요약 6문장 읽기 → 092 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 093 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 094 09:11 ▲ 10 · 댓글 2 로봇 비전-언어 모델에 사용자 맞춤과 안전 기능을 더하다 현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. AI · 머신러닝 · CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
Key Point 실제 로봇 지원의 핵심인 사용자 맞춤화와 안전성 문제를 해결하는 구체적 방법론을 제시하며, 위반율 8.6배 감소, 복구 성공률 6배 증가라는 검증 가능한 결과를 보여준다.
핵심 요약
현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. CarryOn은 기존 VLA 정책을 보강하는 이중 루프 시스템으로, 사용자 선호도와 장면 맥락을 유지하면서 상호작용을 통해 지속적으로 업데이트하는 '계획 루프'를 갖춘다. 계획 루프는 사용자의 지속적인 선호도를 반영하여 맞춤형 부분 작업을 선택하고, 대화와 변화하는 장면 속에서 실행을 조율한다. 전체 요약 7문장 읽기 → 095 21:11 ▲ 285 · 댓글 2 AI 에이전트의 '마지막 한 발' 평가 벤치마크 등장 기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. AI · 머신러닝 · FDE-Gym: The Last Mile of AI Delivery
Key Point LLM 에이전트가 실제 고객 환경에서 얼마나 잘 작동하는지를 처음으로 체계적으로 평가한 벤치마크로, 기존 학술 평가와 현실 간의 큰 격차를 실증한다.
핵심 요약
기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. Hugging Face가 20개 산업 시나리오 95개 실제 과제를 담은 FDE-Gym 벤치마크를 공개했으며, 각 과제는 현장 엔지니어의 실제 프로젝트에서 개편했다. 시뮬레이션된 고객 환경에서 에이전트는 이해관계자와 상호작용하며 운영 환경 같은 시스템을 직접 수정해 솔루션을 제공하고, 고객 비즈니스 지표 개선도를 0~1로 정규화해 채팅·테스트 횟수 페널티를 적용한다. 전체 요약 5문장 읽기 → 096 21:11 ▲ 40 · 댓글 3 로봇 학습에서 세계 모델과 행동 예측이 서로 강화할 수 있을까 세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. AI · 머신러닝 · Can World and Action Modeling Benefit Each Other under Unified Causal Training?
Key Point 로봇의 행동 학습과 환경 이해 모델을 같은 구조에서 동시에 훈련할 때 둘이 서로 강화하는 효과가 있는지를 첫 체계적으로 검증한 결과로, 로봇 학습의 효율성을 높일 새로운 방법론을 제시한다.
핵심 요약
세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. 통합된 인과 학습 구조 하에서 행동을 세계 예측의 조건과 정책 학습의 목표로 동시에 취급한다. 지정된 행동이 주어졌을 때 그 시각적 결과를 예측하는 학습이 정책 성능과 일반화를 개선하는지 검증했다. 전체 요약 8문장 읽기 → 097 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 098 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 099 18:11 ▲ 316 · 댓글 4 컴퓨터 자동 조작 AI의 완전 오픈소스 스택 공개 컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. AI · 머신러닝 · OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
Key Point 컴퓨터 자동 조작 AI 연구가 막혀 있던 폐쇄형 구현에서 벗어나 완전 오픈스택으로 전환되면서, 누구나 최신 모델의 설계를 따라하고 개선할 수 있는 기반이 마련되었다.
핵심 요약
컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. OpenGCUA는 이런 문제를 해결하기 위해 제너럴 컴퓨터 사용 에이전트(GCUA)의 전체 스택을 오픈소스로 공개하는 프로젝트다. 에이전트 설계의 핵심은 코드 실행 기능으로, 중간 결과가 다음 동작을 결정하게 하고 모델이 기존 프로그래밍 능력을 컴퓨터 상호작용에 직접 적용할 수 있다. 전체 요약 8문장 읽기 → 100 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 →