쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
18건 · "세계모델"조건 지우기 ×
001 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 003 12:11 ▲ 88 · 댓글 2 로봇 정책 개선을 위한 세계모델 역추적 기법 Rollback 행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. AI · 머신러닝 · Rollback: Experience Backtracking in World Models for Policy Improvement
Key Point 세계모델이 단순한 시뮬레이터를 넘어 과거로 돌아가 대안을 탐색할 수 있게 되면서, 로봇 정책 학습의 효율성과 수렴 속도가 근본적으로 달라진다.
핵심 요약
행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. 새로운 Rollback 기법은 세계모델을 역추적 가능한 반사실적 엔진으로 변환하여, 과거의 결정 지점으로 돌아가 대안 행동을 탐색한다. 성공과 실패의 결과를 대비하여 행동 수준의 세밀한 감시 신호를 생성하며, 별도의 가치 모델 없이도 상상을 문제해결에 집중시킨다. 전체 요약 8문장 읽기 → 004 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
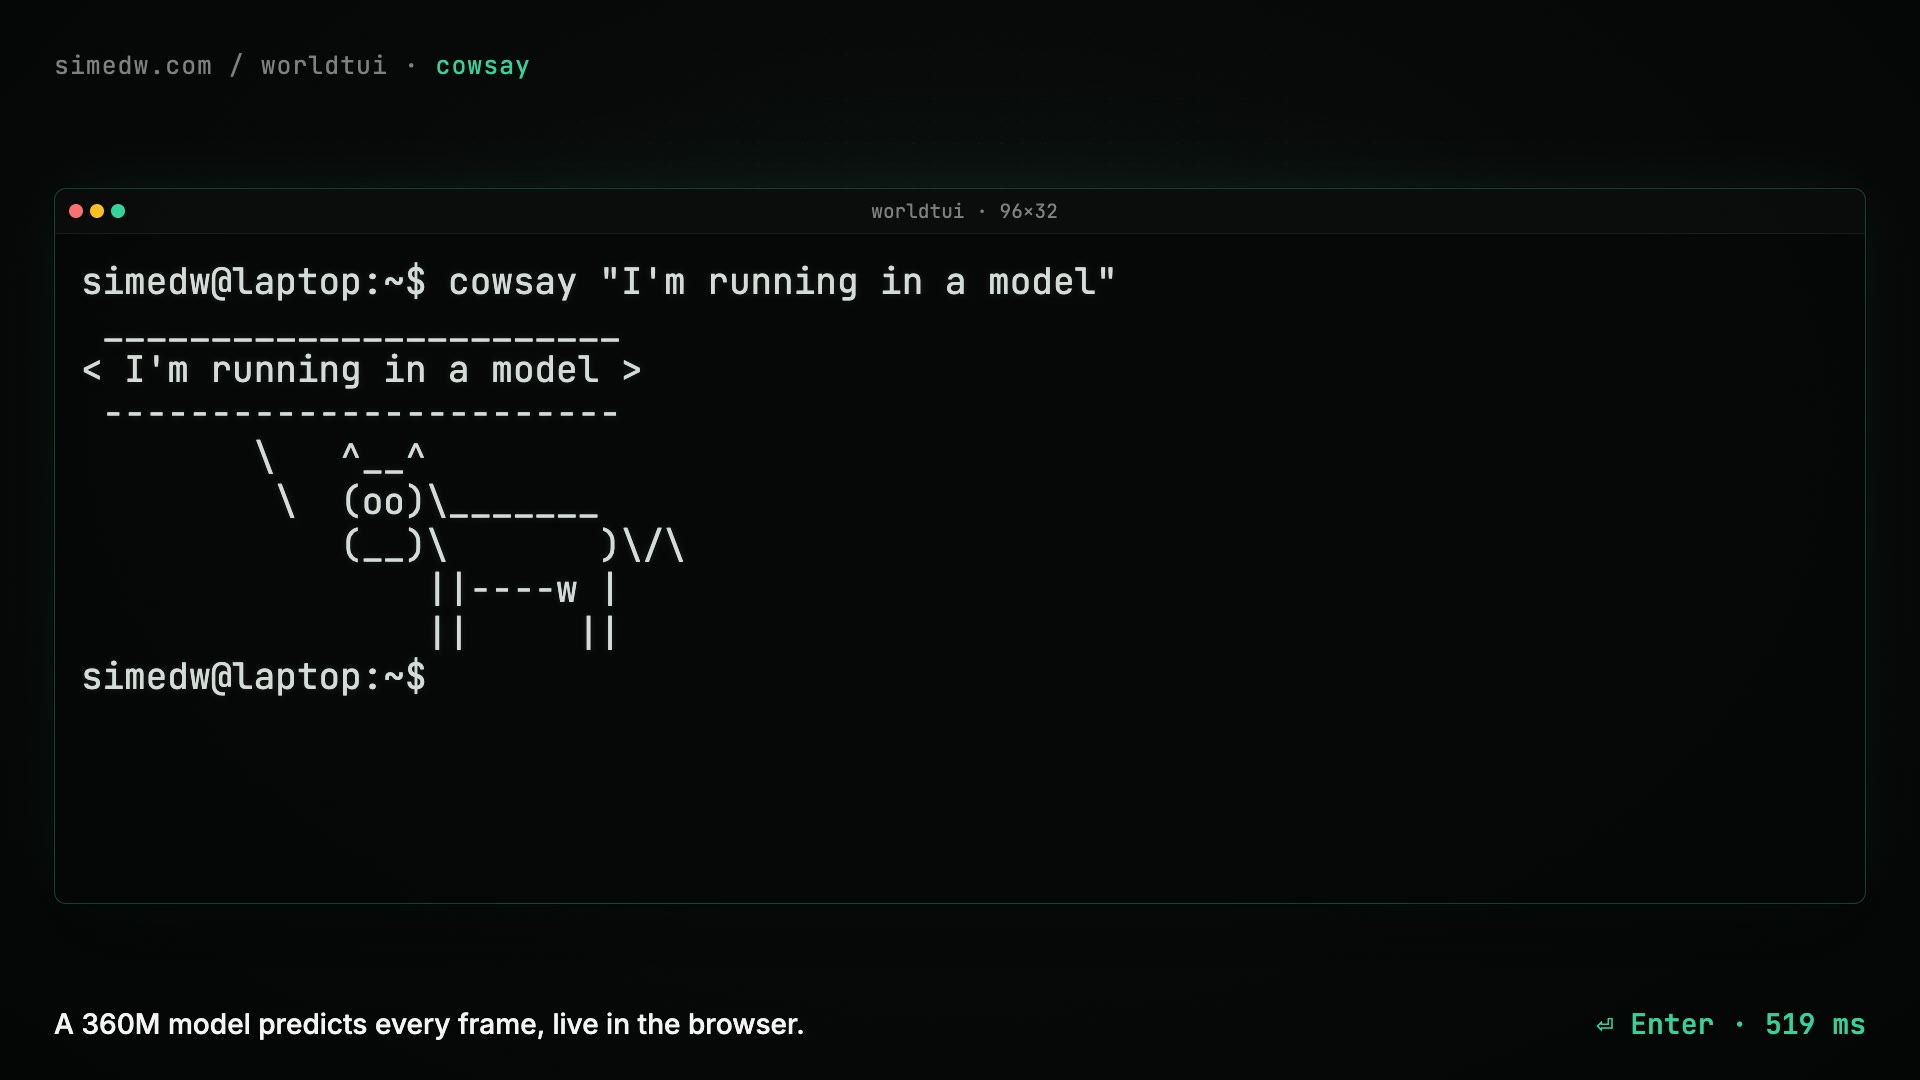
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 005 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 006 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 007 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 008 21:11 ▲ 84 · 댓글 2 로봇 기초 모델 'GreenWAM' 공개, 20개 로봇 계열에서 통용 로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. AI · 머신러닝 · GreenWAM: A World Foundation Model for Robotics
Key Point 다양한 로봇 종류에서 작동하는 통합 기초 모델이 세계 모델과 정책을 모두 수행할 수 있음을 처음으로 입증하며, 로봇 비전 분야의 일반화 문제에 실질적 해법을 제시한다.
핵심 요약
로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. 로봇마다 다른 행동 표기법을 통합하기 위해 20개 로봇 계열(양팔 로봇부터 손가락까지 제어하는 휴머노이드까지)을 공통 관절 좌표로 설명하는 '공유 해부학적 행동 공간'을 구축했다. 세계 모델 모드, 행동-조건부 모드, 세계-행동 모드의 세 가지 방식으로 이들 로봇 계열을 함께 학습했고, 행동 전문가를 분리하는 정책 구조를 적용했다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 010 12:11 ▲ 64 · 댓글 1 픽셀 재구성 없이 로봇 제어하는 JEPA 모델 등장 Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. AI · 머신러닝 · LeWAM: End-to-End World and Action Modeling with JEPAs
Key Point 기존 세계 모델 방식을 통합해 로봇 제어 성공률을 3배 이상 높이고 계획 속도를 획기적으로 개선한 새로운 아키텍처로, 시뮬레이션과 실제 로봇 모두에서 실용성을 입증했다.
핵심 요약
Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. 레카이(LeWAM)는 엔드-투-엔드 JEPA로서 다음 잠재 상태 예측과 행동 흐름 매칭을 함께 학습하고, 잠재 상태에 등방 가우시안 제약을 적용한다. 이 설계로 하나의 모델이 정책 직접 실행과 학습된 잠재 역학으로 샘플 행동을 평가하는 효율적인 계획을 모두 지원할 수 있다. 전체 요약 6문장 읽기 → 011 00:11 ▲ 35 · 댓글 5 고정된 LLM이 자기 개선하는 Memento 3, 환경 학습에 성공 Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. AI · 머신러닝 · Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks
Key Point 기존 LLM은 세계 모델을 외부 메모리 없이 학습할 수 없었는데, Memento 3의 규칙책 기반 접근은 동결된 모델도 자율적으로 환경을 학습하고 자기 개선할 수 있음을 보여준다.
핵심 요약
Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. 에이전트는 자연언어 규칙책을 의미 기억으로 유지하며, 환경 역학의 수정 가능한 가설을 기록하면서 미지의 측면은 불완전하게 남긴다. 규칙책을 실행 가능한 코드로 컴파일하여 예측과 계획에 활용한다. 전체 요약 9문장 읽기 → 012 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 013 18:35 ▲ 11 · 댓글 2 VLM에 세계 모델 통합, 공간 추론 성능 39% 향상 인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. AI · 머신러닝 · WM-VLM: Probing Internal World Models for Interleaved Visual-Textual Reasoning
Key Point 시각언어모델이 공간 추론을 하기 위해 중간 시각 상태 생성이 얼마나 효과적인지 보여주는 실증적 증거를 제시하며, VLM의 추론 메커니즘을 개선할 새로운 접근법을 제안한다.
핵심 요약
인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. 텍스트와 생성된 시각 상태를 모두 활용해 공간 문제를 해결할 수 있는 VLM을 만들기 위해 WM-VLM을 제안했다. WM-VLM은 사전학습된 VLM에 가벼운 세계 모델 브랜치를 추가해 중간 시각 상태를 생성한다. 전체 요약 8문장 읽기 → 014 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 015 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 016 06:11 ▲ 13 · 댓글 2 로봇 세계 모델로 복합 작업 학습을 자동화하다 로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. AI · 머신러닝 · RoboCoach: World Models as Active Coaches for Compositional Robot Skills
Key Point 세계 모델로 상상된 실패를 감지해 학습 데이터를 효율적으로 선택하는 방식으로, 로봇이 자동으로 어떤 기술부터 개선할지 결정할 수 있게 하는 방법을 보여준다.
핵심 요약
로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. 세계 모델 기반의 코칭 시스템으로, 상상된 실패를 감지해 어떤 기술을 학습할지, 어느 전문가 모델을 업데이트할지를 자동으로 결정한다. Route-Imagine-Diagnose-Improve(RIDI) 루프는 공유 액션-조건부 세계 모델인 COACHWORLD 내에서 재사용 가능한 기술 전문가들을 실행하고, 진행 판단자가 실패하는 첫 번째 부작업을 기록한다. 전체 요약 7문장 읽기 → 017 18:11 ▲ 68 · 댓글 3 LLM 에이전트의 숨은 세계 모델을 끌어내는 훈련법 LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
Key Point LLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다. 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다. 전체 요약 9문장 읽기 → 018 22:29 ▲ 41 · 댓글 3 AI 세계 모델의 신뢰성을 평가하는 벤치마크 공개 Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. AI · 머신러닝 · HappyWorld-Bench
Key Point 세계 모델이 상호작용과 수정에 얼마나 잘 반응하고 신뢰성을 유지하는지 평가하는 새로운 기준이 필요한 상황에서, 이 벤치마크는 비디오·공간·구현형 모델 전반의 약점을 구체적으로 드러낸다.
핵심 요약
Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. 벤치마크는 생성 구성부터 통합 세계 모델링까지 6단계의 계층적 능력 프레임워크(W1-W6)를 기반으로 설계되었다. 비디오 세계 모델(1,138개 프롬프트), 공간 세계 모델(300개 장면), 구현형 세계 모델(254개 테스트 케이스) 등 세 가지 독립적 평가 트랙으로 구성된다. 전체 요약 8문장 읽기 →