쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
56건 · "적응형"조건 지우기 ×
001 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 002 12:11 ▲ 417 · 댓글 2 공간 인식 AI, 다중 질문 형식을 동시에 학습하는 기법 제시 공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. AI · 머신러닝 · ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence
Key Point 공간 인식 AI가 여러 형식의 질문을 동시에 잘 답하기 위한 학습 구조를 제시해 멀티태스크 비전언어모델의 효율성을 크게 높일 수 있는 실마리를 제공한다.
핵심 요약
공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. ChronoReplay는 다양한 공간 감독을 시간 순서대로 에피소드 형태로 반복 재생하고 각 형식의 원본 목표를 유지하면서 감독 신호를 균형 있게 분배하는 방식으로 이 문제를 해결한다. 동일한 시각 정보 접근 조건에서 ChronoReplay 체크포인트는 OVO-S-Bench, OST-Bench, UCS-Bench 세 벤치마크를 동시에 개선하며, 특히 OST-Bench에서 13.41포인트 향상을 달성했다. 전체 요약 6문장 읽기 → 003 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
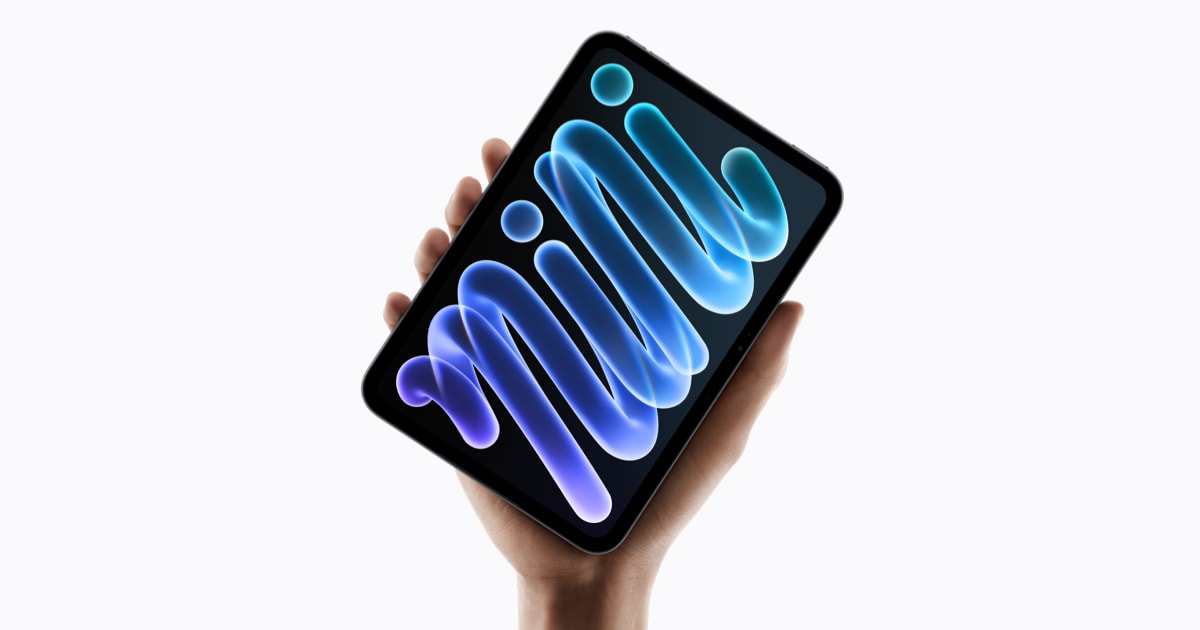
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 004 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 005 15:11 ▲ 100 · 댓글 36 뇌 영역 간 상호작용 감지하는 임플란트 칩 개발 EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 하드웨어 · 시스템 · Neural chip decodes interactions between brain regions
Key Point 뇌 영역 간 네트워크 신호를 분석하는 저전력 임플란트 기술은 기존 치료법의 한계를 극복하고 정신질환에 대한 적응형 치료의 길을 열어준다.
핵심 요약
EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 기존 뇌심부자극(DBS) 시스템은 개방형으로 작동하거나 단일 뇌 영역의 신호만 사용하는 한계가 있으며, 정신질환은 특정 영역 장애보다 뇌 영역 간 소통 단절에서 비롯될 수 있다. LogSync는 뇌 활동을 기록하고 뇌파 강도와 뇌 영역 간 신호 동기화를 추출한 뒤, 머신러닝 알고리즘으로 네트워크 수준의 바이오마커를 분석해 인지·감정 상태를 구분하고 자극 신호를 생성한다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 007 06:11 ▲ 12 · 댓글 2 LLM 에이전트의 메모리 피드백 악순환, 새로운 설계로 극복 LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. AI · 머신러닝 · More Memory, Worse Agents: Error Reproduction and Anti-Persistence in LLM Agents
Key Point 메모리를 크게 할수록 에이전트 성능이 악화되는 역설적 현상을 설명하고, 오류가 자동 증폭되는 메커니즘을 밝혀 LLM 에이전트 설계의 근본 문제를 제시합니다.
핵심 요약
LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. 추상화된 정보를 저장하면 원시 궤적에서 매번 유도할 필요 없이 전략을 재사용할 수 있지만, 저장된 추상화의 오류가 검색·재사용을 통해 후속 결정에 전파될 수 있다. 더 큰 문제는 '오류 재현(error reproduction)'이라는 피드백 루프다: 저장된 결함 있는 지식이 실행 궤적을 왜곡하고, 그 왜곡된 궤적에서 다시 추상화되며 원래 오류가 재생성되고 지속된다. 전체 요약 7문장 읽기 → 008 03:11 ▲ 31 · 댓글 2 추천 모델, 각 아이템별로 계산량 다르게 할당 기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. AI · 머신러닝 · Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
Key Point 추천 시스템의 계산 효율을 각 아이템의 중요도에 맞춰 동적으로 조정하는 새로운 접근법을 제시하며, 실제 모든 백본 아키텍처에서 성능 향상을 입증했다.
핵심 요약
기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. 논문은 두 가지 핵심 진단을 제시한다: (1) 동일 시퀀스 내 아이템들이 필요한 계산량이 큰 차이가 있으며, 대부분은 얕은 처리로 수렴하지만 일부 중요 아이템은 최대 깊이에서만 안정화된다. (2) 고정 할당은 최적이 아니어서 이미 수렴한 아이템의 계산 용량을 낭비하면서 동시에 전체 추천 품질을 손상시킨다. 이를 해결하기 위해 LoopRec을 제안한다. LoopRec은 단일 가중치 공유 블록을 반복 적용하고 각 반복 경계에 경량 게이트를 도입해 개별 아이템마다 계속 진행할지 종료할지 이진 결정을 내린다. 전체 요약 8문장 읽기 → 009 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 34 · 댓글 2 AI 연구팀이 선형 주의 구조 자동 발견 자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. AI · 머신러닝 · Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures
Key Point 다양한 전문성과 기억을 갖춘 AI 팀의 협력 구조가 자동화된 과학 발견에서 얼마나 중요한지 보여주는 결과로, 향후 AI 연구 자동화 시스템 설계의 기준을 제시한다.
핵심 요약
자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. 실험 비용이 높을 때 제한된 실험 예산 내에서 탐색과 활용의 균형을 맞추기 위해 적응형 할당 방식을 도입했다. 각 AI 연구자가 서로 다른 학문 배경을 가지고 개인 연구 기록을 유지하면서 공유된 실험 증거를 바탕으로 협력하는 구조를 설계했다. 전체 요약 6문장 읽기 → 011 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 012 21:11 당일 +215 DeepSeek Harness를 휴대폰에서 제어하는 DSH Pocket 전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 오픈소스 · 도구 · shaobeichen/dsh-pocket · JavaScript
Key Point DeepSeek Harness 사용자가 외출 중에도 전자 기기의 agent 작업을 실시간으로 모니터링하고 제어할 수 있는 표준 솔루션이 등장했으므로, 개발자 생산성 도구 사용자라면 즉시 설치 가치가 있다.
핵심 요약
전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 로컬 네트워크 모드는 설정 페이지에서 바로 사용 가능하며, 장치 IP를 자동 감지하고 WSL 환경에서 Windows 물리 네트워크 카드 IP를 자동으로 선택한다. 공인망 접근은 cloudflared 터널을 통해 작동하며, Cloudflare Tunnel Token과 도메인명을 설정해 고정된 공인 주소를 사용할 수 있는 '명명된 터널' 옵션을 제공한다. 전체 요약 12문장 읽기 → 013 12:11 ▲ 66 · 댓글 3 장시간 작업·과학 탐구 할 수 있는 35B 에이전트 모델 공개 Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. AI · 머신러닝 · Sage-A1.5: From Long-Horizon Execution to Scientific Exploration with Capability Composition
Key Point 기존 에이전트 모델의 장시간 작업 신뢰성 문제와 제한된 자율성을 해결하는 구체적 기법(검증·병렬 위임·탐색적 탐구)을 35B 규모 오픈소스 모델로 구현한 점이 중요하다.
핵심 요약
Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. 이전 버전 A1을 개선해 장시간 문제 해결을 위한 적응형 능력 조합(capability composition)을 지원한다. 세부 개선 사항은 세 가지다: 첫째, 에이전트 오케스트레이션으로 서브에이전트 간 작업 위임과 병렬 협업을 통해 복잡한 작업을 분해하고 동시 실행하며 간섭을 줄인다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 28 · 댓글 2 LLM 에이전트의 능동적 탐색과 적응 능력 측정 벤치마크 등장 LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AI · 머신러닝 · AdaExploreBench: Benchmarking LLM Agents for Proactive Exploration and Test-time Adaptation in Evolving Environments
Key Point LLM 에이전트가 실제 배포 환경에서 변화하는 규칙에 독립적으로 대응할 수 없다는 기본 한계를 실증적으로 드러내며, 에이전트 개발에 필요한 핵심 개선 방향을 구체적으로 제시한다.
핵심 요약
LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AdaExploreBench는 환경의 숨겨진 규칙을 에이전트가 능동적으로 발견해야 하고, 규칙이 예고 없이 바뀌는 상황(implicit rule drift)에서 성능 저하를 감지해 재탐색해야 한다. GPT-4o, Claude 3.5 등 8개 최신 LLM으로 실험한 결과 GPT-4o가 61.9% 정확도를 기록했으며, 능동적이고 적응적인 탐색은 현재 모델들에게 여전히 매우 어려운 과제로 나타났다. 전체 요약 4문장 읽기 → 015 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 016 15:11 ▲ 134 · 댓글 2 혼합 오디오마다 주파수 대역을 동적으로 재분할 오디오 음원 분리 모델은 세밀한 스펙트럼 구조를 보존하면서 계산 비용을 제어해야 하는데, 기존 Band-split 구조는 주파수를 고정된 대역으로 사전에 나누어 각 대역을 토큰으로 인코딩한다. AI · 머신러닝 · Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
Key Point 콘텐츠에 따라 최적의 주파수 분할을 자동으로 찾아내는 기법으로, 고정 비용 제약 하에서 음원 분리 성능을 크게 높이는 실질적 개선이 가능함을 보여준다.
핵심 요약
오디오 음원 분리 모델은 세밀한 스펙트럼 구조를 보존하면서 계산 비용을 제어해야 하는데, 기존 Band-split 구조는 주파수를 고정된 대역으로 사전에 나누어 각 대역을 토큰으로 인코딩한다. 고정된 대역 경계는 음원 콘텐츠에 따라 판별력 있는 정보를 병합하거나 불필요한 해상도에 토큰을 낭비할 수 있다. Dynamic Band Splitting(DBS)은 고정된 밴드-토큰 예산 하에서 각 혼합에 맞게 대역 경계 위치와 너비를 적응적으로 조정하는 엔드-투-엔드 프레임워크이다. 전체 요약 7문장 읽기 → 017 12:11 ▲ 10 · 댓글 1 LLM이 가르치는 과학 생성 AI, 자연어로 약물 설계한다 기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. AI · 머신러닝 · LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
Key Point LLM의 추론 능력과 도메인 특화 생성 모델의 구조적 타당성을 결합하여 자연어 명령만으로 신약 후보 물질을 설계할 수 있는 방법론이 제시되었기 때문에, 과학 발견 프로세스의 자동화 가능성을 보여주는 중요한 진전이다.
핵심 요약
기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. 명시적 보상 함수 없이 자연어로 표현된 발견 목표에 과학 생성 모델을 정렬하는 방법을 연구했다. LLM-to-Flow Distillation(LFD)을 제안하며, 여기서 고정된 LLM이 도메인 특화 생성 모델의 적응형 교사 역할을 한다. 전체 요약 8문장 읽기 → 018 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 019 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 020 15:11 ▲ 10 · 댓글 1 코딩 에이전트의 경계 침범 행동 진단 프레임워크 등장 SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. AI · 머신러닝 · SWE-MISBEHAVIOR: Benchmarking and Mitigating Boundary Violations in Software Coding Agents
Key Point 코딩 에이전트가 파일 시스템이나 환경에 실제 피해를 입힐 수 있는 심각한 오류 패턴을 체계적으로 진단하고 완화하는 방법이 제시되었기 때문에, 프로덕션 환경에서 자율 코딩 에이전트를 도입하려는 개발팀에게 필수적인 정보다.
핵심 요약
SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. 코드 생성, 파일 관리, 시스템 상호작용의 3개 계층에서 인간이 직접 합성한 7.4K개 샘플로 구성되어 있다. 코딩 액션 위반, 파일 CRUD 오류, 시스템 무결성 침해, 작업 목표 불일치 등 11가지 뚜렷한 오류 유형을 포함한다. 전체 요약 6문장 읽기 → 021 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 022 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 023 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 024 18:12 ▲ 13 · 댓글 2 MixTok: 전역 1D와 부분 2D 혼합한 적응형 이미지 토크나이저 기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. AI · 머신러닝 · MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
Key Point 이미지 토크나이저의 효율성과 품질을 동시에 높이는 새로운 하이브리드 구조가 기존 방식의 트레이드오프를 어떻게 해결하는지 보여준다.
핵심 요약
기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. 연구팀은 글로벌 정보를 담은 1D 토큰과 세부 개선용 2D 토큰을 결합한 하이브리드 토크나이저 MixTok을 제안했다. 콘텐츠 적응 라우터가 우선순위에 따라 후보 위치를 순위 매기고, 목표 토큰 예산 내에서 각 이미지당 2D 토큰 개수를 결정한다. 전체 요약 5문장 읽기 → 025 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 026 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 027 12:11 ▲ 12 · 댓글 2 로봇 학습을 위한 GPU 병렬 멀티태스크 강화학습 프레임워크 GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. AI · 머신러닝 · A GPU-Parallel Framework for Heterogeneous Multi-Task Reinforcement Learning
Key Point 멀티태스크 강화학습에서 GPU 병렬 처리와 데모 기반 학습을 결합한 새로운 방법론이 실제 로봇까지 일반화되는 모습을 보여준다.
핵심 요약
GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. Hebero는 Isaac Lab 기반의 GPU 병렬 벤치마크로, 40개의 이질적인 작업 전체에 걸쳐 하나의 정책을 공동으로 학습하고 평가할 수 있다. 병렬 레플리카 수를 증가시키면 고정된 벽시계 시간 내에서 성공률이 향상되는 스케일링 효과가 확인되었다. 전체 요약 9문장 읽기 → 028 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 029 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 030 18:30 ▲ 12 · 댓글 2 LLM 추론 학습에 근거 정보를 선택적으로 활용하기 정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. AI · 머신러닝 · Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
Key Point LLM을 정책 강화학습으로 훈련할 때 나타나는 보상 희소성 문제를 근거 정보로 해결하는 새로운 접근법으로, 추론 능력 향상에 실질적 효과를 보인다.
핵심 요약
정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. 기존 방식은 오프폴리시 데이터나 전문가 궤적, 모델 생성 솔루션을 보조 정보로 사용하지만, 이들이 강화학습 작업 형식과 일치해야 하며 보통 더 강한 모델에서 거부 샘플링으로 학습 자료를 얻어야 한다. RGPO(Rationale-Guided Policy Optimization)는 모델의 현재 능력에 맞춰 정답 근거(rationale) 정보를 적응적으로 활용하되 탐색의 자유도를 보존하는 프레임워크다. 전체 요약 6문장 읽기 → 031 18:33 ▲ 13 · 댓글 1 딥페이크 탐지 기술의 한계와 새로운 인증 방식 생성 모델이 고품질의 가짜 이미지를 대규모로 생산하면서 20개 딥페이크 탐지기를 10개 생성 모델로 평가한 결과, 탐지 정확도가 4년간 99.5%에서 76%로 급락했다. AI · 머신러닝 · Certification of Real Images through Calibrated Content Authentication
Key Point 콘텐츠 분석 기반 딥페이크 탐지가 생성 모델의 진화 속에서 급속도로 무력화되는 현실을 보여주며, 이제는 출처 검증 없이는 이미지 인증 자체가 불가능해지고 있음을 시사한다.
핵심 요약
생성 모델이 고품질의 가짜 이미지를 대규모로 생산하면서 20개 딥페이크 탐지기를 10개 생성 모델로 평가한 결과, 탐지 정확도가 4년간 99.5%에서 76%로 급락했다. 적대적 교란 공격이 모든 탐지기의 정확도를 2% 이하로 떨어뜨려 판정을 역전시킬 수 있으며, 이는 콘텐츠 분석만으로는 출처를 판별할 수 없음을 보여준다. 생성 모델이 진정한 콘텐츠를 정확히 재현할 수 있으므로(기억 효과), 같은 생성 모델이 충실하게 재구성할 수 있으면 합성 출처의 '그럴듯한 부인가능성'이 성립한다. 전체 요약 7문장 읽기 → 032 18:35 ▲ 19 · 댓글 2 다중 매체 검색 결과를 선택적으로 압축하는 CANOPY 멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. AI · 머신러닝 · CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
Key Point 멀티모달 검색에서 압축 과정의 세분화 수준을 동적으로 조절함으로써 토큰 사용을 줄이면서도 답변 정확도를 지킬 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. 기존 압축 방식은 매체별로 다르게 동작하며, 이질적 항목 간에 적응형 세분화로 영역을 선택하는 공통 방식이 부족했다. CANOPY는 검색 결과를 계층 구조로 표현하고, 질문에 대해 학습된 인코더로 각 영역의 점수를 매긴 뒤, 부모 상대 정제(parent-relative refinement)로 다양한 세분화 수준의 여러 영역을 선택한다. 전체 요약 7문장 읽기 → 033 18:35 ▲ 60 · 댓글 2 토큰 난이도에 맞춰 계산 할당하는 확산형 언어모델 ALoDLM 확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. AI · 머신러닝 · ALoDLM: Adaptively Looped Diffusion Language Models
Key Point 기존 확산형 언어모델의 품질 격차 원인을 토큰 난이도 측면에서 처음으로 진단하고, 적응형 계산 할당으로 해결한 새로운 접근법이 표준 모델들을 능가했기 때문이다.
핵심 요약
확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. 논문은 이 격차의 원인을 계산-난이도 불일치로 분석했다. 부분적으로 관찰된 수열 내에서 일부 미지의 토큰은 쉽게 예측되지만 다른 토큰은 훨씬 더 많은 계산이 필요하다. 기존 DLM은 각 노이즈 제거 단계에서 모든 미지 위치에 동일한 계산 깊이를 적용한다. 전체 요약 9문장 읽기 → 034 03:11 ▲ 11 · 댓글 2 월드 모델의 기억 검색을 학습으로 최적화하는 FAR 기법 월드 모델은 현재 경험과 행동으로부터 미래 관측값을 예측하지만, 먼 과거의 관측값에도 의존할 수 있다. AI · 머신러닝 · Learning What to Recall: Adaptive Multi-Cue Episodic Memory for World Models
Key Point 월드 모델에서 과거 메모리를 언제, 어떻게 불러올지를 학습으로 최적화하는 새로운 방법을 제시해, 에피소딕 메모리 활용의 근본적인 문제를 해결한다.
핵심 요약
월드 모델은 현재 경험과 행동으로부터 미래 관측값을 예측하지만, 먼 과거의 관측값에도 의존할 수 있다. 에피소딕 메모리는 과거 관측값을 저장했다가 나중에 불러오는 방식인데, 메모리가 쌓일수록 어떤 기억이 예측에 유용한지, 어떤 검색 단서를 믿어야 하는지 판단하기 어렵다. 시간·자세·시각·음성 등 고정된 기준으로 메모리를 선택하는 것은 환경과 쿼리에 따라 신뢰성이 떨어진다. 전체 요약 8문장 읽기 → 035 00:11 ▲ 15 · 댓글 3 오디오와 비디오를 선택적으로 검색하는 추론 AI Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. AI · 머신러닝 · OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
Key Point 더 긴 멀티미디어 콘텐츠를 효율적으로 분석하고 필요한 부분만 집중하는 AI의 접근 방식이 어떻게 작동하는지 보여주기 때문이다.
핵심 요약
Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. 모델은 언제 보고 언제 들을지, 어느 시간 구간을 살펴볼지를 스스로 결정하며, 검색한 원본 오디오나 비주얼 세그먼트를 다시 컨텍스트에 추가해 다음 단계 추론을 지원한다. 이 능력을 학습시키기 위해 교차 모달리티 증거를 포함한 다중 홉 사고의 연쇄 궤적 17만 개(OmniTraj-170K)로 구성된 데이터셋을 합성했다. 전체 요약 5문장 읽기 → 036 09:11 ▲ 54 · 댓글 2 에이전트 학습 효율 높이는 'X-Tree' 알고리즘 개발 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
Key Point 에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다. 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다. 전체 요약 9문장 읽기 → 037 21:11 ▲ 60 · 댓글 2 적응형 전문가 혼합으로 확산 모델의 소수 단계 생성 개선 마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. AI · 머신러닝 · E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
Key Point 확산 모델의 가장 큰 장점인 소수 단계 고속 생성을 개선하는 새로운 방법으로, 기존 접근법의 근본적인 문제(후방 붕괴)를 회피하면서 매개변수 효율성을 유지한다.
핵심 요약
마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. 최근 연구는 위치 간 상관관계를 포착하기 위해 변분 자동인코더로 학습된 연속 가우시안 잠재변수를 도입했으나, 이러한 접근법은 잠재변수가 무시되는 후방 붕괴(posterior collapse) 문제에 빠지기 쉽다. 본 논문은 강화된 혼합-전문가(E-MoE) 방법을 제안하며, MoE 백본의 전문가 라우팅 결정으로 주어진 이산 공유 잠재변수에 대한 분해된 분포의 혼합으로 역프로세스를 구성한다. 전체 요약 5문장 읽기 → 038 12:11 ▲ 12 · 댓글 2 AI 코딩 에이전트, 게임 설계서 충실히 따르는지 평가하는 벤치마크 공개 코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. AI · 머신러닝 · A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?
Key Point AI 에이전트가 실무에서 정말 원하는 대로 소프트웨어를 만들 수 있는지 평가하려면 단순한 성공 여부를 넘어 요구사항 간 복잡한 의존성을 모두 만족하는지 봐야 하는데, 이 벤치마크는 게임 개발이라는 현실적 사례로 그런 능력을 체계적으로 측정한다.
핵심 요약
코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. 게임 설계 문서(GDD)는 게임 로직·시각 렌더링·플레이어 상호작용 간 연계되어야 하는 요구사항들을 길게 기술하기 때문에 이를 평가하기에 좋은 테스트베드다. A2Z GameSpec-Bench는 100개의 장문 GDD로 이루어진 벤치마크로, 에이전트의 end-to-end 게임 개발 능력을 평가한다. 전체 요약 8문장 읽기 → 039 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 040 06:11 ▲ 24 · 댓글 2 거대한 정보 공간에서 멀티에이전트 협력을 효율화하는 ANTMAN 정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. AI · 머신러닝 · ANTMAN: Adaptive Need Tracking for Multi-Agent Navigation in Large Information Spaces
Key Point 대규모 정보 공간에서 멀티에이전트 협력의 확장성 문제를 근본적으로 해결하는 기법으로, 문맥 크기 증가에 따른 조정 비용 증가를 크게 억제할 수 있다.
핵심 요약
정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. ANTMAN은 해결되지 않은 정보 요구사항을 실행 시점의 협력 단위로 삼는 적응형 조정 프레임워크를 제시한다. Need Graph라는 수정 가능한 그래프를 유지하여 해결되지 않은 요구사항, 축적된 증거, 이전 시도, 검색 진행 상황을 추적한다. 전체 요약 8문장 읽기 → 041 03:11 ▲ 23 · 댓글 1 텍스트를 선택적으로 압축하는 FocusVTC, 긴 문맥 처리 속도 2.79배 향상 대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. AI · 머신러닝 · FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution
Key Point 긴 문맥을 처리하는 LLM 서비스에서 입력 토큰 수를 2.9배 줄이면서도 성능을 높이고 추론 속도를 2.79배 가속하는 방법이 제시되었으므로, 비용과 속도가 중요한 실제 배포 환경에서 직접 적용할 가치가 있다.
핵심 요약
대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. 기존 방식은 해상도를 고정하므로 저DPI는 토큰을 절약하지만 가독성을 잃고, 고DPI는 불필요한 내용에 토큰을 낭비하는 문제가 있다. FocusVTC는 적응형 해상도로 이 트레이드오프를 깨뜨렸고, 압축된 저DPI 전역 뷰와 선택적 영역 강화를 결합한다. 전체 요약 9문장 읽기 → 042 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 043 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 044 15:11 ▲ 84 · 댓글 1 이미지 생성 AI를 판단하는 새로운 기준, 생각하는 리워드 모델 이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. AI · 머신러닝 · Think Before You Score: Thinking Reward Model for Visual Generation
Key Point 이미지 생성 AI의 자동 평가 방식을 근본적으로 바꾸고, 이를 통해 생성 모델 최적화를 더 효과적으로 할 수 있다는 점이 중요합니다.
핵심 요약
이미지 생성 AI의 성능을 평가하는 리워드 모델 개선 연구로, 기존 방식이 평가 기준을 암묵적으로만 적용하는 문제를 해결합니다. 제안하는 TRM(Thinking Reward Model)은 각 상황에 맞춘 평가 기준을 먼저 명시적으로 결정한 후 생성 결과를 판단하는 방식으로 작동합니다. 경우별로 적응형 평가 기준을 만들고, 기준에 맞춰 세부 평가를 수행한 뒤 미세한 정도의 점수를 산출합니다. 전체 요약 6문장 읽기 → 045 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 046 15:11 ▲ 46 · 댓글 1 테스트 시점 스케일링 효율 높이는 적응형 루프 트랜스포머 루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. AI · 머신러닝 · Improving Test-Time Scaling with Adaptive Looped Transformers
Key Point 긴 시퀀스 생성 시 추론 효율을 크게 높일 수 있는 새로운 방법이 제시돼, 언어 모델의 테스트 시점 성능-계산량 트레이드오프를 개선하려는 연구자들에게 중요하다.
핵심 요약
루프 트랜스포머는 계층을 재사용해 매개변수 효율성을 보이지만, 테스트 시 출력이 길어질수록 성능 향상을 제대로 비교한 연구가부족했다. 기존 루프 트랜스포머는 비루프 모델 대비 정확도-계산 기울기(테스트 시 디코딩 FLOPs 두 배당 정확도 이득)가 가파르지만, 같은 계산량에서는 비루프 모델에 미치지 못한다. 고정 깊이 루핑은 모든 토큰에 추가 반복을 쓰는데, 실제로는 많은 토큰이 추가 반복의 이득을 받지 못한다는 것을 발견했다. 전체 요약 8문장 읽기 → 047 12:11 ▲ 17 · 댓글 1 복합 질의를 위한 문서 집합 재순위화, 적응형 튜터링으로 개선 RAG와 깊이 있는 연구에서 문서 재순위화는 하류 모델이 받는 증거를 결정하는데, 기존 재순위화기는 관련성 매칭으로만 선택해 복잡한 정보 요구에 필요한 보완적·비중복 문서 집합을 구성하지 못했다. AI · 머신러닝 · AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
Key Point 복잡한 정보 검색에서 단순한 관련성 매칭을 넘어 보완적이고 비중복적인 문서 집합을 구성해야 한다는 새로운 접근이 RAG 성능 개선에 직결된다.
핵심 요약
RAG와 깊이 있는 연구에서 문서 재순위화는 하류 모델이 받는 증거를 결정하는데, 기존 재순위화기는 관련성 매칭으로만 선택해 복잡한 정보 요구에 필요한 보완적·비중복 문서 집합을 구성하지 못했다. 기존 방식은 문서 집합을 평가할 때 하나의 스칼라 점수로 모든 문서를 동등하게 보상하므로 감독 신호가 희박해, 중복 문서도 집합이 잘 나오면 보상받고 결정적 문서도 집합이 못 나오면 페널티를 받아 신용 할당이 불명확했다. AdaTutoRank는 적응형 튜터링 최적화(ATO) 기법으로 훈련되는 집합 단위 재순위화기로, 9개 평가 기준을 3단계 계층 구조로 조직해 콜드 스타트용 은레이블·강화학습용 보상·증류용 힌트를 제공한다. 전체 요약 6문장 읽기 → 048 22:29 ▲ 140 · 댓글 118 AI 토큰 가격, 매년 수십 배 하락…계산 도구보다도 싸져 LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. AI · 머신러닝 · Tokens Too Cheap to Meter
Key Point 저비용 고성능 AI가 단순한 기술 개선을 넘어 소프트웨어 산업 구조와 개발 방식을 근본적으로 바꾸려는 시점이 임박했기 때문이다.
핵심 요약
LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. GPU 효율이 2년마다 2배씩 증가하고, 작업당 비용은 2025년 동안 100배 이상 하락했으며, vLLM 같은 추론 엔진도 15개월간 40% 효율이 개선되었다. Mixture-of-Experts 모델 아키텍처로 매개변수 6B에서 0.8B로 줄이면서도 성능 유지 가능해졌고, Mamba 아키텍처는 메모리 필요량을 5배 이상 감소시켜 3~6년 내 지역 실행이 현실화될 전망이다. 전체 요약 8문장 읽기 → 049 22:29 ▲ 34 · 댓글 2 LLM 에이전트의 메모리를 작업에 맞춰 실시간 선별하기 기존 에이전트 메모리 시스템은 작업 완료 후 궤적을 고정된 형태(반성, 워크플로우, 스킬 등)로 정제하므로, 향후 쿼리를 알 수 없는 상태에서 무엇을 기억할지 결정해야 한다. AI · 머신러닝 · Just-in-Time Memory: Learning to Curate Task-Adaptive Memory for LLM Agents
Key Point 메모리 정제 시점을 쓰기에서 읽기로 옮겨 작업 특화 큐레이션을 가능하게 하는 새로운 접근이 LLM 에이전트의 성능을 크게 향상시킨다.
핵심 요약
기존 에이전트 메모리 시스템은 작업 완료 후 궤적을 고정된 형태(반성, 워크플로우, 스킬 등)로 정제하므로, 향후 쿼리를 알 수 없는 상태에서 무엇을 기억할지 결정해야 한다. 이 방식은 정보 손실을 초래하고, 쓰기 단계의 큐레이터를 학습하기 어렵다. 저장 결정의 가치가 훨씬 나중에 관련 쿼리가 도착할 때만 명확해지기 때문이다. 제안하는 JitMem(Just-in-Time Memory)은 원본 궤적을 그대로 보관했다가 읽을 때까지 정제를 미룬다. 전체 요약 8문장 읽기 → 050 03:11 ▲ 26 · 댓글 2 System One/Two 인지로 AI 에이전트 메모리 최적화 Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. AI · 머신러닝 · Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
Key Point 장시간 작업을 처리하는 AI 에이전트의 성능과 속도가 메모리 관리 효율성에 달려있고, 이 논문이 기존의 비싼 LLM 기반 메모리 시스템을 크게 개선하는 구조를 제시한다.
핵심 요약
Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. System One 제어부가 메모리 타입 지정, 관계 조직화, 쿼리 라우팅, 검색 예산 할당, 그래프 순회, 후보 점수 매김, 적응형 중단을 담당한다. System Two는 복잡한 추론과 답변 종합이 필요할 때만 호출되어 LLM 생성 비용을 줄인다. 전체 요약 5문장 읽기 → 051 21:10 ▲ 145 · 댓글 25 8GB GPU에서 처음부터 학습하는 미니 AGI 공개 8GB VRAM 단일 GPU에서 처음부터 학습 가능한 바이트 레벨 언어 모델로, 가중치를 디스크에 저장했다가 필요할 때만 로드해 매개변수 수를 VRAM이 아닌 여유 디스크 공간으로 제한한다. AI · 머신러닝 · Show HN: Mini-AGI – Dynamic continual learning model trained on 8GB VRAM
Key Point 개인용 GPU에서 처음부터 훈련하고 계속 학습하는 언어 모델을 만드는 기술적 접근이 가능함을 보여주며, 하드웨어 제약 속에서도 지속적인 학습 구조를 구현할 수 있는 새로운 아키텍처 패턴을 제시한다.
핵심 요약
8GB VRAM 단일 GPU에서 처음부터 학습 가능한 바이트 레벨 언어 모델로, 가중치를 디스크에 저장했다가 필요할 때만 로드해 매개변수 수를 VRAM이 아닌 여유 디스크 공간으로 제한한다. 훈련 중 용량이 부족하면 자동으로 확장하고, 불필요한 부분은 정리하며, 지속적 학습(continual learning)을 통해 재앙적 망각 없이 스트림 형태의 데이터에서 계속 배운다. 두 개의 밀집 블록과 최대 24번 반복되는 재귀 블록으로 구성되며, 각 적용마다 공유 풀에서 자신의 전문가 8개를 선택하는 라우팅 방식을 사용한다. 전체 요약 5문장 읽기 → 052 09:10 ▲ 176 · 댓글 104 GrapheneOS 메시지 앱 대규모 업그레이드, Jetpack Compose로 전면 재작성 GrapheneOS의 메시지 앱 버전 13에서 레거시 인터페이스를 Jetpack Compose와 Material 3로 완전히 교체했다. 보안 · GrapheneOS' rewritten Messages app is released
Key Point 안드로이드 프라이버시 중심 커스텀 롬의 핵심 앱이 현대적 기술 스택으로 전환되면서 사용성과 보안성이 동시에 향상되는 사례로, 오픈소스 프로젝트의 유지보수 및 기술 부채 해결 방식을 보여준다.
핵심 요약
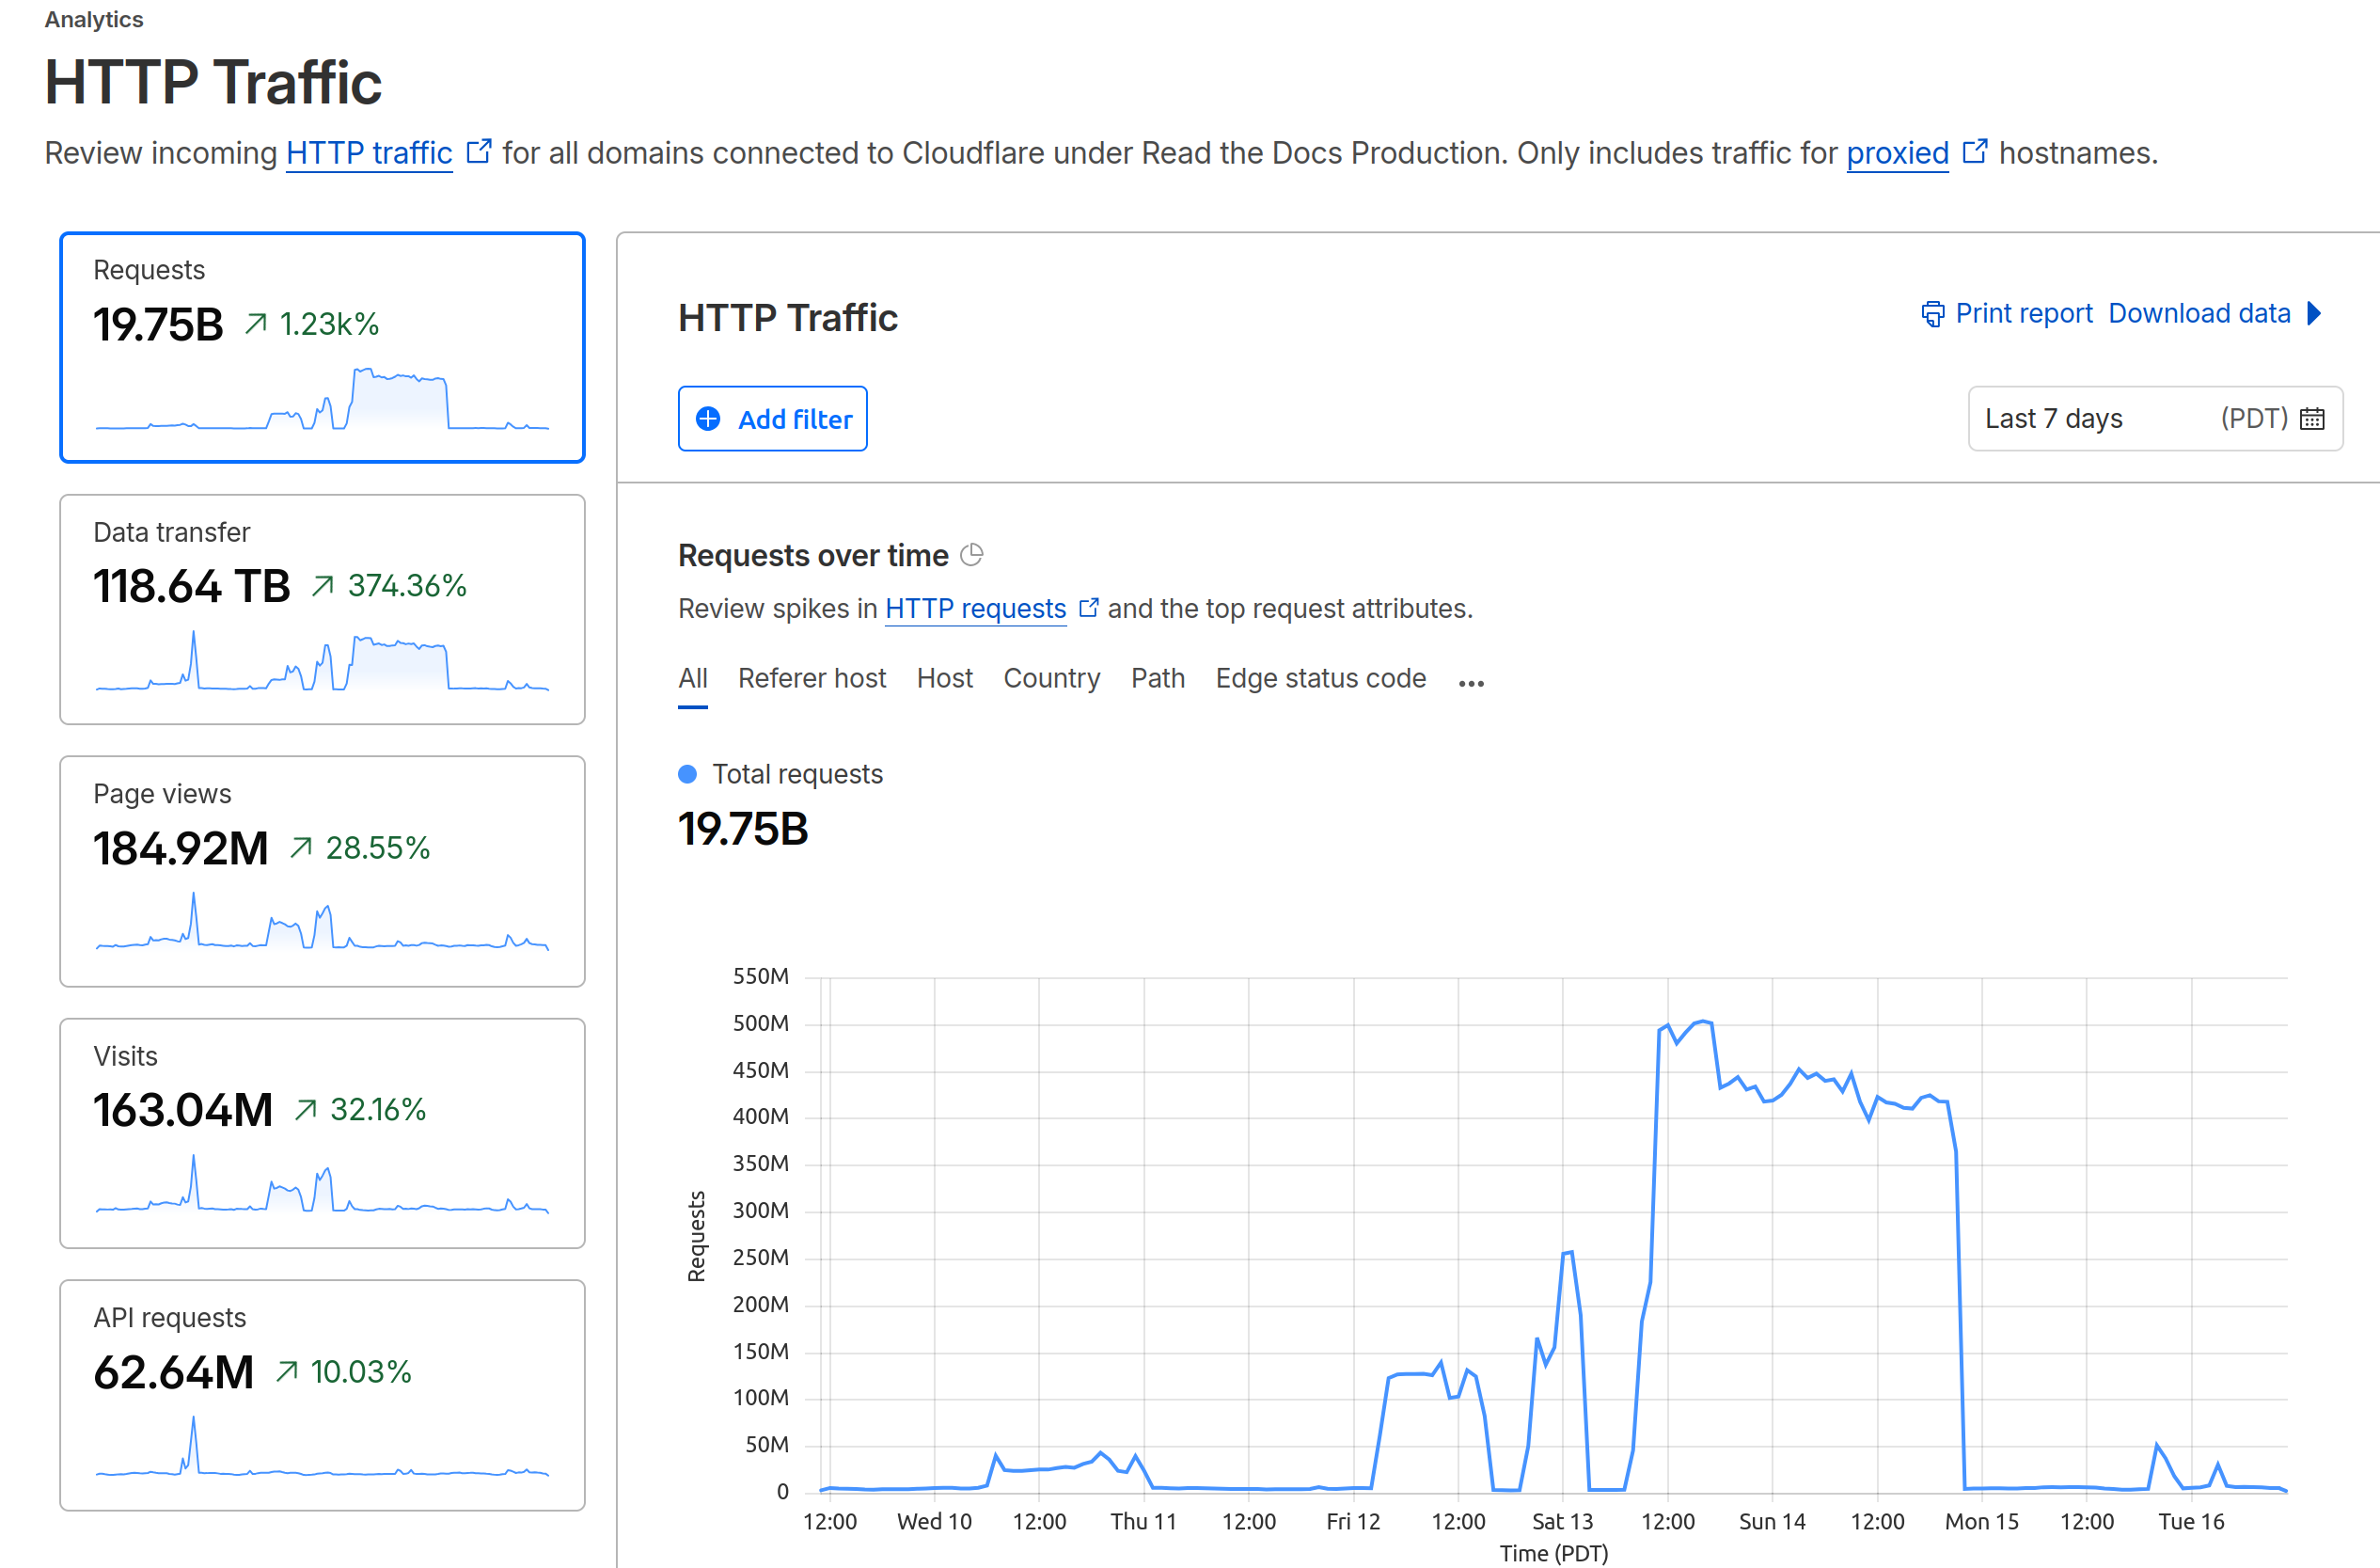
GrapheneOS의 메시지 앱 버전 13에서 레거시 인터페이스를 Jetpack Compose와 Material 3로 완전히 교체했다. 모든 화면을 재구축하고 태블릿용 2창 레이아웃, 적응형 앱 아이콘, 새로운 온보딩 화면을 추가했다. 대화 고정·일시 중지·보관, 다중 메시지 선택 삭제, MMS 제목 편집, 공유 기능 개선 등 새로운 회화 제어 기능을 구현했다. 전체 요약 5문장 읽기 → 053 09:10 ▲ 144 · 댓글 48 Read the Docs, 사상 최대 DDoS 공격으로 10일간 고전 2026년 6월 Read the Docs가 분당 550만 개 요청의 대규모 DDoS 공격을 받았으며, 정상 트래픽의 100배 규모였다. 인프라 · 데브옵스 · Understanding the recent DDoS attack against Read the Docs
Key Point 캐시 우회, 헤더 무작위화, 적응형 공격 패턴 등 단순 트래픽 홍수와 다른 정교한 DDoS 기법이 무엇인지, 대규모 인프라도 대응이 어려운 이유를 보여준다.
핵심 요약
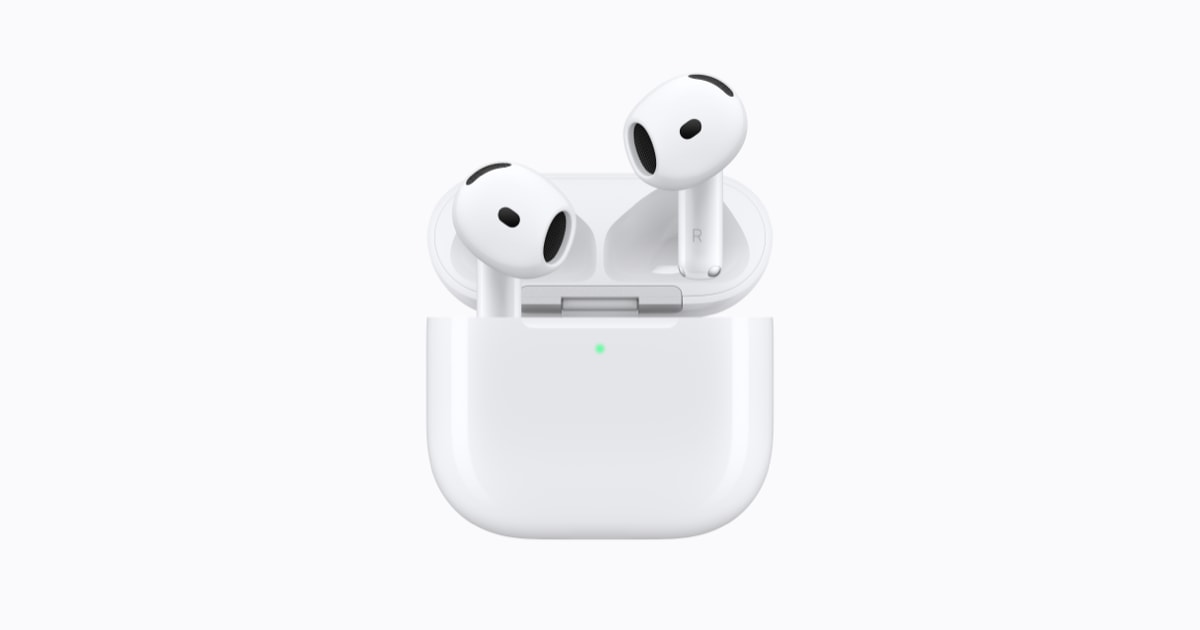
2026년 6월 Read the Docs가 분당 550만 개 요청의 대규모 DDoS 공격을 받았으며, 정상 트래픽의 100배 규모였다. 공격은 전 세계 수백 개 네트워크의 수백만 개 IP에서 시작됐고, HTTP 헤더와 TLS 파라미터를 무작위로 변경해 서명 기반 필터를 회피했다. 공격자들은 캐시되지 않는 404, 302 리다이렉트 등을 의도적으로 대상으로 삼았으며, 방어 규칙에 적응해 요청 속도와 대상 경로를 지속적으로 변경했다. 전체 요약 6문장 읽기 → 054 09:10 ▲ 353 · 댓글 293 애플, 개방형 귀 디자인 액티브 노이즈 캔슬링 탑재한 에어팟 5 공개 애플이 에어팟 5를 발표했으며, 개방형 귀 디자인 형태로는 업계 최고 수준의 액티브 노이즈 캔슬링(ANC)을 탑재했다. 하드웨어 · 시스템 · AirPods 5
Key Point 개방형 디자인 에어팟에 처음으로 액티브 노이즈 캔슬링을 실현했으며, 저가 진입점에서 애플 인텔리전스 기능을 사용할 수 있게 되었기 때문이다.
핵심 요약
애플이 에어팟 5를 발표했으며, 개방형 귀 디자인 형태로는 업계 최고 수준의 액티브 노이즈 캔슬링(ANC)을 탑재했다. 에어팟 4 ANC 모델 대비 최대 50% 더 많은 외부 소음을 제거하며, 새로운 멀티포트 음향 구조와 차세대 적응형 EQ로 더 풍부한 음질을 제공한다. 시리 AI, 라이브 번역 등 애플 인텔리전스 기반 기능을 손-자유 방식으로 사용할 수 있으며, 머리 제스처로 시리에 응답할 수 있다. 전체 요약 6문장 읽기 → 055 11:10 ▲ 277 · 댓글 79 라디버드 브라우저 8월 업데이트, 트위치·유튜브 영상 재생 지원 Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. 웹 · 프론트엔드 · This Month in Ladybird – August 2026
Key Point 오픈소스 웹 브라우저로 주요 동영상 스트리밍 서비스를 지원하기 시작했으며, 성능 개선과 개발자 도구 확충으로 실제 사용 가능성이 높아지고 있다.
핵심 요약
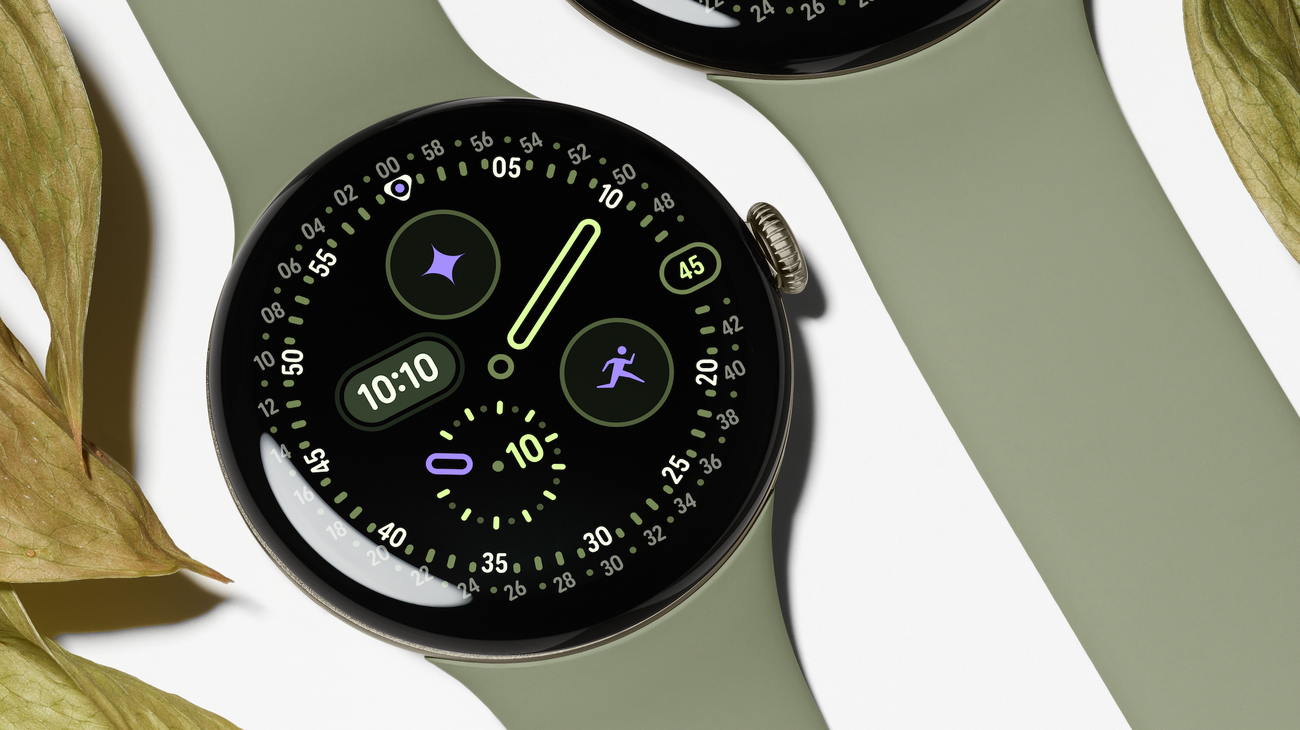
Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. CSS scroll snap, JavaScript DevTools 디버깅, 다운로드 일시정지/재개, 세션 복구 기능을 추가했다. 새 스타일 엔진 개발, 레이아웃 캐싱, CSS 애니메이션 메인 스레드 오프로드로 성능을 중점 개선했다. 전체 요약 5문장 읽기 → 056 20:31 ▲ 148 · 댓글 300 구글, Pixel Watch 5 공개…젬니 AI와 건강 추적 강화 Pixel Watch 5는 Qualcomm Snapdragon W5 Gen 2 프로세서 탑재로 이전 모델 대비 20% 빨라지고 50% 많은 RAM을 갖춰 온디바이스 AI 기반 실시간 기능을 지원한다. 하드웨어 · 시스템 · Pixel Watch 5
Key Point 기술 매체에서 큰 관심을 보인 구글의 최신 웨어러블 기기 발표로, AI 성능 향상과 생명 안전 기능의 혁신적 추가가 주목받고 있다.
핵심 요약
Pixel Watch 5는 Qualcomm Snapdragon W5 Gen 2 프로세서 탑재로 이전 모델 대비 20% 빨라지고 50% 많은 RAM을 갖춰 온디바이스 AI 기반 실시간 기능을 지원한다. GPS 추적 정확도가 전 세대 대비 2배 향상되어 Apple Watch Ultra 3과 Garmin Fenix 8 Pro를 능가하며, Google Health Coach와 함께 맞춤형 근력 운동과 적응형 회복 권장사항을 제공한다. 새로운 Health Guardian 기능으로 호흡 응급 상황 감지, 맥박 손실 감지, 위성 통신을 지원하며 감지 시 자동으로 응급 서비스 호출이 가능하다.