쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "증류"조건 지우기 ×
001 12:11 ▲ 103 · 댓글 21 Perplexity, 의사결정 특화 AI 모델 Decider v1.3 공개 Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. AI · 머신러닝 · Perplexity Decider v1.3: Training, eval, and use cases
Key Point 의사결정 전문 AI 모델로 한 번의 연산으로 여러 분류 작업을 수행해 기존 LLM 대비 훨씬 빠르고 저렴하게 구조화된 답변이 필요한 서비스(검색, 라우팅, 필터링 등)를 처리할 수 있다.
핵심 요약
Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. 의사결정 모델은 입력과 질문 집합을 받아 각 질문에 대한 확률 분포를 반환하는 범용 분류기로, Yes/No(이진), 다중선택, 점수(순서 있는 수준) 세 가지 질문 유형을 지원한다. 기존 생성형 LLM 대신 의사결정 모델을 사용하면 단일 포워드 패스에서 여러 질문을 동시에 처리하므로 토큰 하나씩 생성하는 오버헤드를 피하고 계산을 공유할 수 있다. 전체 요약 13문장 읽기 → 002 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 003 03:11 ▲ 21 · 댓글 5 가중치 0.05% 삭제하는 것만으로 LLM 파인튜닝과 동급 성능 트랜스포머 블록의 게이트 프로젝션에서 가중치의 0.05% 미만을 0으로 만드는 방식(Deletion Tuning)으로 전체 모델 파인튜닝(FFT)과 동등한 성능을 달성했다. AI · 머신러닝 · The Surprising Effectiveness of Deleting Weights in LLM Post-Training
Key Point 매우 적은 수의 가중치만 제거해도 전체 파인튜닝 수준의 성능을 낼 수 있다는 발견은 LLM 적응 학습의 효율성을 크게 개선하며, 특히 지속적인 학습에서 이전 성능 유지와 모델 크기 최소화 사이의 오래된 문제를 동시에 해결한다.
핵심 요약
트랜스포머 블록의 게이트 프로젝션에서 가중치의 0.05% 미만을 0으로 만드는 방식(Deletion Tuning)으로 전체 모델 파인튜닝(FFT)과 동등한 성능을 달성했다. 강화학습 기반 보상, 감독형 파인튜닝, 온폴리시 증류 등 세 가지 LLM 포스트트레이닝 방식 모두에서 FFT와 같은 수준의 학습 결과를 얻었다. 학습된 마스크는 대응하는 FFT 체크포인트보다 수백 배에서 수천 배 작으며, 연속 학습에서 중요한 과제인 이전 작업 망각을 크게 줄인다. 전체 요약 5문장 읽기 → 004 18:11 ▲ 36 · 댓글 3 LLM 에이전트를 효율적으로 경량화하는 SteerDistill 기법 저비트 양자화는 LLM 에이전트의 추론 비용을 줄이지만 작업 성공률이 떨어지는 문제가 있다. AI · 머신러닝 · SteerDistill: Quantizing LLM Agents via Closed-Loop Teacher Steering
Key Point LLM 에이전트의 양자화는 추론 비용 절감에 필수적인데, SteerDistill은 기존 방식의 한계를 극복하고 거의 전정밀도 수준의 성능을 유지하면서도 학습 효율을 크게 높인다.
핵심 요약
저비트 양자화는 LLM 에이전트의 추론 비용을 줄이지만 작업 성공률이 떨어지는 문제가 있다. 양자화된 에이전트는 작업 요구사항이나 환경 조건을 간과해 실패하며, 성공한 전정밀도 모델과 다른 행동을 보인다. 기존 방식은 오프라인 데이터로 학생 모델의 실패 상황을 놓치거나, 자체 실행에서 올바른 응답이 부족하다는 한계가 있다. 전체 요약 8문장 읽기 → 005 00:11 ▲ 18 · 댓글 3 음성 생성 통합 엔드투엔드 프레임워크 WaveGen 공개 WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. AI · 머신러닝 · WaveGen: Truly End-to-End Waveform Generation via Internal Spectral Trajectory Learning
Key Point 기존 음성 합성 파이프라인의 복잡한 멀티스테이지 구조를 완전히 통합하고 외부 모듈 의존성을 제거한 진정한 엔드투엔드 모델로, 음성 생성 시스템의 단순화 가능성을 보여준다.
핵심 요약
WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. 신경 오디오 코덱, 멜-스펙트로그램 보코더, VAE 기반 잠재 모델 등 별도 학습된 중간 표현에 의존하지 않으며, 지속시간 예측기 같은 외부 정렬 모듈 없이 모델 내부에서 텍스트-음성 정렬을 수행한다. BERT 기반 텍스트 임베딩, Wav2Vec 2.0 기반 의미 표현, 의미 증류 같은 자기지도 표현 의존성도 제거해 진정한 엔드투엔드 구조를 유지한다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 13 · 댓글 9 학생 모델을 저렴하게 학습하려면 '오차 예산'이 필요하다 On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. AI · 머신러닝 · How Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?
Key Point 학생 모델 지식 증류 시 비용 절감 기법들이 학습 안정성에 미치는 실제 영향을 정량 측정한 결과로, 양자화와 비동기 처리의 활용도를 크게 높일 수 있는 실용적 기준을 제시한다.
핵심 요약
On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. 그러나 이 두 기법은 롤아웃 엔진과 학습 중인 모델 사이에 training-inference mismatch를 일으킨다. 본 연구는 OPD가 얼마나 많은 mismatch를 견딜 수 있는지, 어디서 문제가 발생하는지, 실제 시스템이 이를 어떻게 활용할 수 있는지를 조사했다. 전체 요약 11문장 읽기 → 007 00:11 ▲ 32 · 댓글 5 LLM 학습 성능 자동 최적화하는 에이전트 InfraRSI 공개 분산 LLM 학습은 발사 설정·연산자 커널·통신 스케줄이 긴밀하게 결합되어 단일 수정이 OOM·컴파일러 충돌·측정 잡음·수치 오차를 야기하는 문제가 있다. AI · 머신러닝 · InfraRSI: Harnessing Recursive Self-Improvement for Training Infrastructure
Key Point 대규모 LLM 학습 시 메모리 충돌과 수치 오차를 자동으로 해결하면서 성능을 30% 이상 끌어올리는 방식으로, 학습 클러스터 운영 효율성의 새로운 기준을 제시한다.
핵심 요약
분산 LLM 학습은 발사 설정·연산자 커널·통신 스케줄이 긴밀하게 결합되어 단일 수정이 OOM·컴파일러 충돌·측정 잡음·수치 오차를 야기하는 문제가 있다. InfraRSI는 에이전트형 도구로, 사용자 명령을 다섯 단계 워크플로우(초기화·진단·실행·검증·보고)를 통해 검증된 학습 최적화로 변환한다. 초기화 단계에서는 수정 가능한 범위와 워크로드·손실·타이밍 불변식에 대한 고정 계약을 설정하여 보상 해킹을 방지한다. 전체 요약 11문장 읽기 → 008 21:11 ▲ 39 · 댓글 3 시각 에이전트가 도구 결과를 제대로 쓰도록 학습시키는 방법 시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. AI · 머신러닝 · Reframe: Observation-Aligned Multi-Teacher On-Policy Distillation for Agentic Visual Reasoning
Key Point 시각 에이전트의 도구 사용이 불완전해 학습이 비효율적이던 문제를 해결하는 체계적 접근법으로, 다중 교사 증류학습 분야의 실질적 개선책을 제시한다.
핵심 요약
시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. Reframe은 두 단계의 학습 프레임워크로, 먼저 Ground-Drop-GRPO(GD-GRPO)가 증거 기반 보상과 원본 시각 입력의 확률적 제거를 통해 공간·시간 전문가를 훈련해 근거 있는 증거를 얻고 도구 반환 관찰을 활용하게 한다. 두 번째 단계 Observation-Gated-MOPD(OG-MOPD)는 롤아웃 중 결함 있는 도구 행동을 정준(canonical) 행동으로 교체하고 수정된 관찰에서 증류학습을 재개해 학습 안정성을 높인다. 전체 요약 6문장 읽기 → 009 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 010 18:11 ▲ 62 · 댓글 8 매개변수 사전활용으로 멀티티처 증류 2배 빠르게 다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. AI · 머신러닝 · P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
Key Point 멀티티처 증류에서 훈련 단계를 50% 단축하고 최종 성능을 14% 향상시키는 방법이 제시되어, 대규모 모델 병렬화 연구에 실질적 가치가 있다.
핵심 요약
다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. 기존 태스크 산술(task arithmetic)은 학생과 전문가 매개변수를 선형결합하되 두 모델의 범위 내에만 머물게 되는 한계가 있다. P²-MOPD는 학생과 전문가 매개변수의 선형결합을 하나의 미분가능한 모델로 보고, 혼합 계수와 학생 가중치를 동일한 목적함수 아래 공동 최적화한다. 전체 요약 6문장 읽기 → 011 06:11 ▲ 10 · 댓글 3 영상 생성 없이 로봇 제어하는 'DreamFree' 기법 제안 세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. AI · 머신러닝 · Future Representation Distillation for Imagination-free World Action Models
Key Point 시각 예측 과정을 제거하면서도 더 나은 제어 성능을 달성하는 방식이 로봇 제어의 효율성과 확장성을 크게 높일 수 있다.
핵심 요약
세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. DreamFree는 사전학습된 영상 확산 모델을 표현 증류를 통해 예측용 시각 인코더로 재목적화하여 미래 영상 생성 없이 행동을 예측한다. 시각 인코더는 현재 관찰만으로 동결된 영상 확산 모델의 표현을 예측하도록 학습하고, 행동 모듈이 인코더에서 추출한 행동 관련 정보로 행동을 예측한다. 전체 요약 5문장 읽기 → 012 18:11 ▲ 44 · 댓글 1 멀티태스크 이미지 생성 모델 'WeLM-Image' 공개, 단일 GPU 최적화 WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. AI · 머신러닝 · WeLM-Image: A Unified Image Generation Model towards Visual Intelligence
Key Point 단일 GPU에서 텍스트 생성·이미지 편집·참조 합성을 모두 수행하는 통합 모델이 나왔으며, 기존 오픈소스 경쟁 모델보다 벤치마크에서 앞선 성능을 보여준다.
핵심 요약
WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. 위챗 대규모 소비자 애플리케이션을 위해 단일 GPU 배포용으로 설계되었으며, 텍스트·참조 이미지·타겟 잠재변수를 하나의 인터리빙 시퀀스로 처리한다. Mixture-of-Transformers(MoT) 백본이 공유 어텐션과 독립적 이해·생성 파라미터를 결합하여 최적화 간섭을 제한한다. 전체 요약 9문장 읽기 → 013 06:11 ▲ 23 · 댓글 3 정책 증류 학습, 분포 밖 일반화 능력 잃는다 여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. AI · 머신러닝 · On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
Key Point 대규모 언어모델을 다중 교사로부터 학습시킬 때 학습 데이터 분포 내에선 우수하지만 그 외의 상황에서 성능이 급격히 떨어지는 핵심 문제를 실증적으로 규명했고, 개선 방안까지 제시했기 때문입니다.
핵심 요약
여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. Qwen3 모델을 이용해 수학 추론, 코딩, 에이전트, 장문맥 이해 등 4가지 과제에서 성능을 평가한 결과, 분포 외(OOD) 성능이 기본 모델보다 2.45~16.25% 낮았다. 합성 작업에서는 MOPD가 분포 내 성능을 개선했으나, 구성된 작업의 분포 외 성능은 최고 성능 교사 모델보다 18.19~24.34% 뒤떨어졌다. 전체 요약 7문장 읽기 → 014 21:11 ▲ 21 · 댓글 3 LLM 자기증류 학습의 메모리 효율을 높인 뮤온 최적화 기법 자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. AI · 머신러닝 · MUON-RT Reusing the Teacher's Trajectory for Momentum-Free Muon for LLM Self-Distillation
Key Point 메모리 오버헤드를 크게 줄이면서도 LLM 학습 성능을 개선하는 옵티마이저 개선으로, 제한된 리소스에서 대규모 모델을 학습하려는 개발자들에게 직접적인 영향이 있다.
핵심 요약
자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. 뮤온-알티(Muon-RT)는 교사-학생 간 변위(displacement)를 재사용해 숨겨진 가중치 행렬의 모멘텀 버퍼를 제거한다. 이 변위가 적용된 업데이트의 지수가중 이력을 인코딩하며 시간적으로 상관없는 노이즈를 평활한다는 것을 로컬 모델 가정 하에서 증명했다. 전체 요약 7문장 읽기 → 015 18:13 ▲ 12 · 댓글 2 확산 모델의 4단계 생성, 속도 대립적 증류로 정확도 높인다 적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. AI · 머신러닝 · VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation
Key Point 적은 샘플링 스텝에서도 높은 생성 품질을 유지하는 새로운 증류 방법이 텍스트-이미지, 텍스트-비디오 등 실용적인 생성 작업에 즉시 적용될 수 있다.
핵심 요약
적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. 흐름 일치 방식은 학생의 샘플링 과정에서 구성한 속도 필드를 통해 더 유연한 감독을 제공한다. 연구팀은 학습된 비평자를 사용해 학생과 교사의 속도 필드를 비교하고 불일치를 피드백으로 삼는 속도 대립적 증류(VAD)를 제안했다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 23 · 댓글 3 게임 해석 AI, 낯선 게임도 실시간 해설 가능해졌다 비디오 LLM이 게임 실시간 해설을 하지만 학습한 게임에서만 해설이 정확하고, 본적 없는 게임에서는 타이밍은 맞춰도 게임 세계에 대한 지식을 전달하지 못한다. AI · 머신러닝 · StreamDuo: A Live Commentator and a Research Agent for Unseen Games
Key Point 게임 해설 AI가 새로운 게임에서도 정확히 해설할 수 있게 되면서, 스트리밍 커뮐니티에서 자동 해설 기술의 실용성이 크게 높아질 수 있다.
핵심 요약
비디오 LLM이 게임 실시간 해설을 하지만 학습한 게임에서만 해설이 정확하고, 본적 없는 게임에서는 타이밍은 맞춰도 게임 세계에 대한 지식을 전달하지 못한다. StreamDuo는 해설 전담 AI와 고정된 리서치 에이전트를 짝지었으며, 해설 AI가 모르는 것을 보면 현재 프레임을 리서치 에이전트에 보내고 게임 위키에서 찾은 정보를 2초 뒤에 받는다. 해설 AI만 한 게임(발더스 게이트 3)에서 두 단계로 학습했는데, 정보 이득 라벨로 답이 도움될 때만 질문하도록 학습하고, 이상적인 답을 본 자기 복사본과의 정책 기반 자기 증류로 노이즈가 있는 답도 활용할 수 있게 했다. 전체 요약 5문장 읽기 → 017 00:11 ▲ 19 · 댓글 2 4B 모델로 컴퓨터 조작 에이전트 SOTA 달성 Mage-VL-Cowork는 GUI 상호작용과 코드·터미널 실행을 하나의 정책으로 통합하는 4B 파라미터 하이브리드 컴퓨터 사용 에이전트(CUA)다. AI · 머신러닝 · Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
Key Point 파라미터 수가 작으면서도 복잡한 컴퓨터 조작 작업을 수행할 수 있는 에이전트 개발 방법이 제시되어, 온디바이스 AI 활용과 효율적인 에이전트 학습의 새로운 가능성을 보여준다.
핵심 요약
Mage-VL-Cowork는 GUI 상호작용과 코드·터미널 실행을 하나의 정책으로 통합하는 4B 파라미터 하이브리드 컴퓨터 사용 에이전트(CUA)다. 일반적인 멀티모달 정렬 체크포인트에서 출발해 미드트레이닝·감독학습·강화학습을 포함한 5단계 점진적 교육 과정을 거친다. Mage-CUA-Forge는 작업별 에이전트 구성을 재사용 가능한 스킬 조건부 생성 워크플로우로 대체하여 293,806개의 데스크톱·웹 작업을 6,915개 스킬로 합성한다. 전체 요약 7문장 읽기 → 018 21:11 ▲ 47 · 댓글 2 MLLM을 활용한 이미지 검색 정확도 향상 방법 제시 Composed Image Retrieval(CIR)는 참조 이미지와 수정 텍스트를 입력받아 목표 이미지를 검색하는 작업이다. AI · 머신러닝 · Factorized MLLM Embeddings for Composed Image Retrieval
Key Point 이미지 검색 태스크에서 멀티모달 모델의 합성적 이해를 명시적으로 활용하는 새로운 구조를 제안하며, 계산 효율성을 유지하면서 성능 향상을 이루는 방법론이 실용성 있다.
핵심 요약
Composed Image Retrieval(CIR)는 참조 이미지와 수정 텍스트를 입력받아 목표 이미지를 검색하는 작업이다. 기존 MLLM 기반 방식들은 합성 쿼리를 직접 검색 임베딩으로 매핑하면서 MLLM의 합성적 이해 능력을 제대로 활용하지 못한다. 본 연구는 Factorized MLLM Embeddings(FactEmbed)를 제안하여 합성 쿼리 이해와 판별 임베딩 구축을 분리한다. 전체 요약 9문장 읽기 → 019 15:11 ▲ 48 · 댓글 3 에이전트 AI 모델 'Axion 1.0' 오픈소스 공개 Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. AI · 머신러닝 · Axion 1.0: Open Agent Foundation Models, Simplified
Key Point 강력한 에이전트 AI를 단순한 훈련 방식으로 구현할 수 있다는 것을 입증하고 전체 개발 과정을 공개해 오픈소스 에이전트 AI 연구의 진입장벽을 낮혔다.
핵심 요약
Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. 3단계 학습으로 구성된다: 모델 인식 데이터 구성을 통한 자체 추론 능력 개발, 실제 데이터 기반 다양한 작업으로 도구 활용 추론 확장, 강화학습을 통한 장기 추론 강화. 첫 번째 SFT 단계는 모델의 성공적 문제해결 전략을 기반으로 어려운 문제를 합성하고 역대적으로 강화하는 방식을 사용한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 021 03:11 ▲ 34 · 댓글 4 LLM 증류 방식 개선, 확률값 대신 토큰 순서만 학습 기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. AI · 머신러닝 · Order-Only On-Policy Distillation
Key Point 확률값 대신 토큰 순서만 학습하는 방식으로 LLM 증류 성능을 개선했으며, 온도 튜닝 같은 복잡한 하이퍼파라미터 조정이 필요 없어진다는 점이 실무적 가치를 갖는다.
핵심 요약
기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. 이 확률값에는 교사가 선호하는 토큰이 무엇인지와 얼마나 확신하는지 두 가지 정보가 섞여있는데, 후자는 교사의 용량과 보정을 반영하므로 작은 학생 모델이 재현하기 어렵다. 교사 온도 변화가 확률값을 바꾸지만 순서는 유지하므로 OPD는 온도 선택에 민감하다. 전체 요약 10문장 읽기 → 022 00:11 ▲ 15 · 댓글 2 작은 의사결정 모델, 큰 언어모델 앞지르다 의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. AI · 머신러닝 · DecisionRank: On-Policy Distillation for Decision-Model Rerankers
Key Point 구조화된 검색 작업에서 작은 모델이 큰 모델 수준의 성능을 크게 빠른 속도로 달성하는 방법이 나왔기 때문에, 정보 검색 시스템의 효율성이 크게 개선될 가능성이 있다.
핵심 요약
의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. 의사결정 모델(학생)은 첫 토큰 위치의 점수로 순위를 정하는 반면 생성형 교사는 문서 ID 수열의 순위 목록으로 선호도를 표현하기 때문이다. DecisionRank는 항목 공간 정책상 증류(item-space OPD) 기법으로 학생 모델을 학습한다. 전체 요약 7문장 읽기 → 023 03:11 ▲ 25 · 댓글 2 한 번의 생성으로 실시간 제어, OSWAM 발표 직접 정책 기반 월드 액션 모델(WAM)은 자율주행과 구체화된 제어에서 미래 시각 예측 없이 행동 생성을 할 수 있지만, 경쟁력 있는 품질을 위해 수십 개의 노이즈 제거 단계가 필요해 실시간 배포를 어렵게 한다. AI · 머신러닝 · OSWAM: An Effective World Action Model with One-Step Action Generation
Key Point 자율주행과 로봇 제어의 실시간 의사결정이 필요한 상황에서 한 단계의 빠른 생성으로 충분한 품질을 내는 새로운 방식이 제시됨에 따라 실제 배포 가능성이 크게 높아졌다.
핵심 요약
직접 정책 기반 월드 액션 모델(WAM)은 자율주행과 구체화된 제어에서 미래 시각 예측 없이 행동 생성을 할 수 있지만, 경쟁력 있는 품질을 위해 수십 개의 노이즈 제거 단계가 필요해 실시간 배포를 어렵게 한다. 노이즈 제거 단계를 단순히 줄이면 비선형 다단계 궤적이 무너져 행동 품질이 크게 저하된다. 이 문제를 해결하기 위해 연구진은 한 단계의 확산만으로 고품질 행동을 생성하는 OSWAM(One-Step World Action Model)을 제안했다. 전체 요약 7문장 읽기 → 024 15:11 ▲ 36 · 댓글 2 음성·추론·도구 통합한 오픈 모델 Apriel Voice 27B 공개 Gemma 4 26B-A4B를 기반으로 한 Apriel Voice 27B Preview는 음성 입력을 직접 처리하면서 텍스트·이미지 입력도 지원하는 음성-언어 모델이다. AI · 머신러닝 · Apriel Voice 27B Preview: An Open Model for Speech, Reasoning, and Tool Use
Key Point 음성 인터페이스에서 추론과 도구 호출까지 한 모델에서 지원하는 오픈소스 음성 모델이 나왔으므로, 음성 기반 AI 어시스턴트 구축의 선택지가 늘어난다.
핵심 요약
Gemma 4 26B-A4B를 기반으로 한 Apriel Voice 27B Preview는 음성 입력을 직접 처리하면서 텍스트·이미지 입력도 지원하는 음성-언어 모델이다. 음성 인식을 넘어 사용자 요청을 이해하고, 문맥을 이용해 추론하며, 대화를 지속하고, 도구를 호출하는 기능을 하나의 추론 백본 안에서 통합한다. 2단계 학습 과정으로 학습했는데, 첫 단계는 음성 인터페이스를 확립하고 두 번째는 지도 학습·텍스트 재생·교차 엔트로피 손실함수를 통해 프로젝터와 백본을 동시에 적응시킨다. 전체 요약 6문장 읽기 → 025 15:11 ▲ 52 · 댓글 3 에이전트가 자가 개선하는 오케스트레이션 기법 R²Orch 복잡한 작업을 여러 스킬을 조합해 해결하는 에이전트 오케스트레이션은 수작업 커리큘럼, 롤아웃이 같은 결과에 도달할 때의 이점 붕괴, 신뢰할 수 없는 평가 신호 같은 문제가 있다. AI · 머신러닝 · R^2Orch: Recursive Self-Improvement for Agent Orchestration via Self-Play within a Skill-Internalization Loop
Key Point 에이전트 시스템이 인간 개입 없이 자신의 약점을 스스로 찾아 개선하는 방식이 제시되어, 복합 작업 해결에 필요한 에이전트 아키텍처의 진화 방향을 보여준다.
핵심 요약
복잡한 작업을 여러 스킬을 조합해 해결하는 에이전트 오케스트레이션은 수작업 커리큘럼, 롤아웃이 같은 결과에 도달할 때의 이점 붕괴, 신뢰할 수 없는 평가 신호 같은 문제가 있다. 이를 해결하기 위해 R²Orch는 내부 루프의 자가 대전으로 오케스트레이터를 개선하고 외부 루프로 내부 루프의 개선 방식 자체를 개선하는 재귀적 자가 대전 오케스트레이션 패러다임을 제안한다. 핵심은 '재귀적 학습 가능성(Recursive Learnability)' 목표로, 제안자가 스킬 철수 시에도 롤아웃이 계속 다양한 결과에 도달하는 작업을 선택하도록 보상한다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 17 · 댓글 3 멀티토큰 예측, KL 신호 복원으로 한 줄 개선 Multi-Token Prediction(MTP)은 언어모델 사전학습에서 다음토큰 예측과 추론 속도를 모두 개선하지만, 표준 MTP 훈련에 결함이 있어 모델 규모가 커질수록 그래디언트 간섭 문제가 심해진다. AI · 머신러닝 · Multi-Token Prediction Done Right
Key Point 언어모델 훈련의 표준 기법인 MTP의 수학적 결함을 밝혀내고 한 줄 코드 변경으로 해결하는 방법을 제시했기 때문에, 대규모 모델 훈련 효율과 추론 속도를 동시에 개선할 수 있다.
핵심 요약
Multi-Token Prediction(MTP)은 언어모델 사전학습에서 다음토큰 예측과 추론 속도를 모두 개선하지만, 표준 MTP 훈련에 결함이 있어 모델 규모가 커질수록 그래디언트 간섭 문제가 심해진다. MTP 교차엔트로피 그래디언트는 수학적으로 분해되는데, 유용한 KL 자기증류 항과 신호대잡음비가 낮은 잔여항으로 나뉜다. 저자들은 KL 그래디언트 복원 트릭을 제시했다: 두 분포가 선형 출력층을 공유할 때, 스트레이트스루 그래디언트 라우팅으로 교차엔트로피 그래디언트를 조합하여 KL 발산의 그래디언트를 정확히 복원할 수 있다. 전체 요약 9문장 읽기 → 027 06:11 ▲ 116 · 댓글 10 LLM의 '잠자기' 단계로 지속학습과 기억력 문제 해결 구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. AI · 머신러닝 · Sleep framework: A new way for LLMs to retain knowledge in continual learning
Key Point LLM이 새로운 정보를 학습하면서 기존 지식을 잃지 않고 맥락도 10배 이상 확장하는 핵심 기술이 어떻게 작동하는지 이해할 수 있고, 산업 배포된 모델의 적응력 문제를 근본적으로 해결하는 가능성을 보여준다.
핵심 요약
구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. 기존 LLM은 배포 후 고정된 학습 시점을 유지하거나, 문맥 윈도우 내에서만 정보를 보유하는 한계가 있고, 새로운 데이터로 업데이트하면 이전 학습 내용을 잊는 '재앙적 망각(catastrophic forgetting)' 문제가 발생한다. 수면 프레임워크는 활동(깨어있는) 단계와 오프라인 메모리 통합(수면) 단계를 번갈아가며 작동한다. 전체 요약 13문장 읽기 → 028 00:11 ▲ 13 · 댓글 3 하나의 모델로 모든 형식 파싱하는 유투 옴니 파서 공개 유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. AI · 머신러닝 · Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
Key Point 멀티모달 구조화 파싱을 하나의 소규모 모델로 처리하면서 각 모달리티별 전문 모델 수준의 성능을 달성한 방식이 기술적으로 의미 있으며, 공개 모델로서 개발자들이 실제로 활용할 수 있는 선택지를 제공한다.
핵심 요약
유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. 모든 모달리티를 하나의 인코더로 처리하고 모든 태스크를 하나의 스키마로 통일한 설계를 기반으로 한다. 유투 옴니 인코더는 사전학습 언어모델에서 초기화되어 모든 모달리티를 통일된 시공간 좌표계에서 공유 가중치로 인코딩하며, 퓨전 레이어가 비디오 프레임의 동시 오디오 어텐션을 가능하게 한다. 전체 요약 9문장 읽기 → 029 18:11 ▲ 19 · 댓글 4 한 두 번의 평가로 복잡한 텍스트 렌더링하기 빠른 이미지 생성 모델에서 프롬프트의 세부 사항을 정확히 표현하기 위해 Distribution Matching Distillation(DMD)을 개선한 Intrinsic Distribution Matching(IDM) 기법을 제안했다. AI · 머신러닝 · Intrinsic Distribution Matching
Key Point 한 두 번의 신경망 평가로 복잡한 텍스트를 정확히 렌더링해야 하는 실시간 이미지 생성 애플리케이션 개발자들이 알아야 할 효율적인 증류 기법이다.
핵심 요약
빠른 이미지 생성 모델에서 프롬프트의 세부 사항을 정확히 표현하기 위해 Distribution Matching Distillation(DMD)을 개선한 Intrinsic Distribution Matching(IDM) 기법을 제안했다. 기존 DMD는 점수 차이를 이용해 생성 분포를 참조 분포에 가깝게 만드는데, IDM은 역방향 KL 필드를 가우시안 모멘트 성분과 비가우시안 나머지로 분해해 학습한다. 생성 모델의 지수 이동 평균(EMA) 복사본을 이용해 특징의 평균과 좌표별 표준편차를 명시적으로 제약하며, 외부 특징 인코더가 필요 없다. 전체 요약 7문장 읽기 → 030 21:11 ▲ 21 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 031 18:11 ▲ 33 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 032 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 033 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 034 09:11 ▲ 132 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 035 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 036 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 037 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 038 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 039 18:11 ▲ 12 · 댓글 2 계층형 멀티에이전트 시스템, 온폴리시 증류로 학습 성능 향상 계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. AI · 머신러닝 · MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
Key Point 멀티에이전트 시스템의 계층적 학습 문제를 해결하는 새로운 방식으로, 간접 피드백만으로도 효과적인 공동 학습이 가능함을 보여준다.
핵심 요약
계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. MultiAgent-OPD는 온폴리시 증류(on-policy distillation)와 강화학습을 결합해 리더-서처-앤서 팀을 엔드투엔드로 공동 학습한다. 먼저 정답 정확성을 기준으로 서처-앤서 워크플로에서 교사 모델을 학습시킨다. 전체 요약 6문장 읽기 → 040 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 041 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 042 03:12 ▲ 35 · 댓글 2 LLM이 스스로 학습한다, 외부 감시 없이 대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. AI · 머신러닝 · On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
Key Point 기존의 자가 학습은 인간의 감시가 필수였으나, 이 방식은 모델이 완전히 독립적으로 자신의 학습 자료를 만들고 개선할 수 있음을 입증했다.
핵심 요약
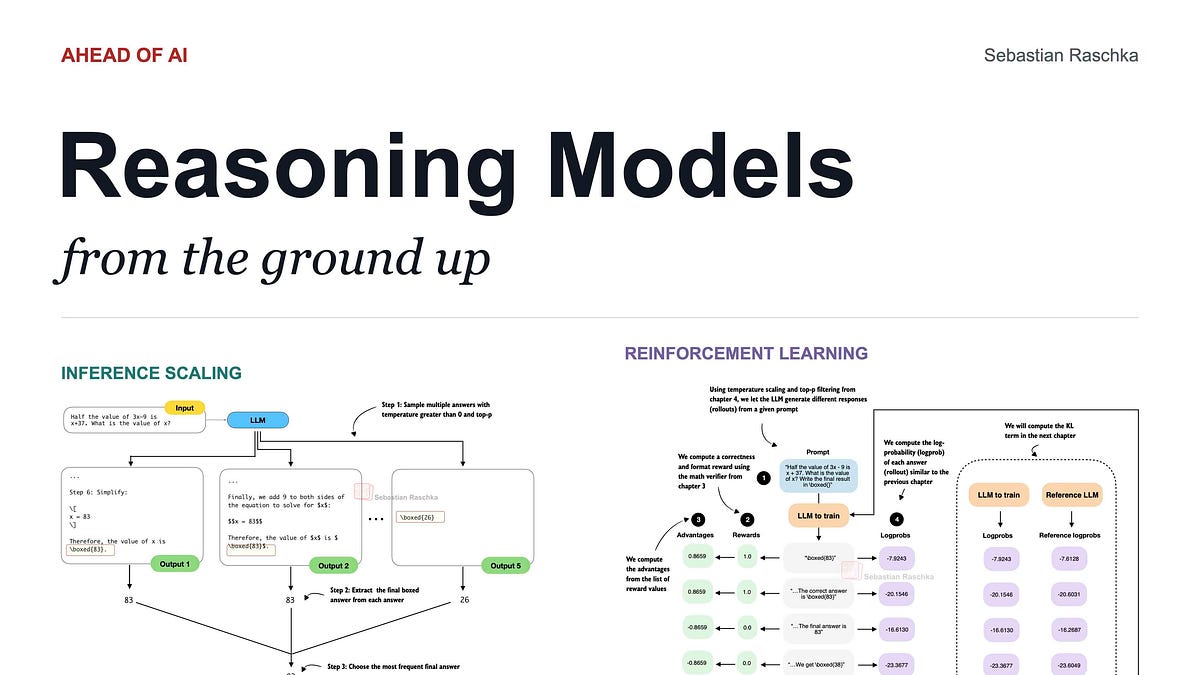
대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. 모델은 주제 설명만 받고 스스로 질문-답변 쌍과 고급 추론 과정을 생성하는 합성 커리큘럼을 구축한다. 완전히 인공적으로 생성한 정보로만 자가 증류를 수행해도 여러 영역에서 성능 개선이 가능하며, 학습하지 않은 영역의 능력도 유지된다. 전체 요약 5문장 읽기 → 043 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 60 · 댓글 2 이커머스 쇼핑 에이전트 평가 벤치마크 공개 Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. AI · 머신러닝 · UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
Key Point 추천 에이전트 개발을 위한 대규모 실제 데이터 벤치마크와 평가 방법론이 제시되어, 이커머스 AI 시스템의 개발과 검증 방식에 새로운 표준을 제시할 수 있다.
핵심 요약
Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. 11,010명의 사용자로부터 수집한 64,729개의 세션 궤적(session trajectory)을 포함하며, 566,102개의 상품과 13가지 액션 타입을 다룬다. 이 벤치마크는 추천 에이전트가 장기간의 사용자 상호작용에서 쇼핑 목표를 달성하는 과정을 평가한다. 전체 요약 8문장 읽기 → 045 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 046 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 047 03:11 ▲ 19 · 댓글 2 스스로 개선하는 AI, 살아있는 환경에서 진화한다 현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. AI · 머신러닝 · Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
Key Point 모델이 외부 업데이트 없이 자신의 경험으로 지속적으로 개선되는 구조를 실제로 구현해 검증했으며, AI 훈련 패러다임의 근본적 전환을 제시한다.
핵심 요약
현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. 미래 이벤트 예측에 기반한 자기진화 에이전트 시스템 'DeepEvolve'를 개발했으며, 에이전트가 지속적으로 변화하는 환경과 상호작용하면서 경험을 내재화·외재화하여 개선된다. 검증 가능한 작업을 합성하는 살아있는 환경과 각 예측 뒤의 추론 궤적을 능력으로 변환하는 순환진화 엔진으로 구성되며, 탐색을 예측으로부터 분리하여 파라미터 수준의 진화를 오염 위험이 있는 라이브 환경에 맞춘다. 전체 요약 8문장 읽기 → 048 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 049 15:11 ▲ 26 · 댓글 2 세 가지 능력을 하나로 담은 시각 인코더 ALPS 공개 World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. AI · 머신러닝 · ALPS: Visual State Encoders for World Models
Key Point 월드 모델의 비전 백본이 예측, 제어, 검증을 모두 지원할 수 있는 통합 인코더를 처음 제시하여 로봇 학습 파이프라인의 설계 방식을 바꿀 수 있다.
핵심 요약
World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. 기존 인코더는 이 세 가지 중 하나나 둘만 담당하는 반면, ALPS는 ViT-B/16 기반 프리트레인된 시각 상태 인코더로 세 능력을 모두 통합한다. 정지 이미지와 텍스트만 사용하여 언어, 재구성, 공간적 대응 목표로 처음부터 학습한 후 교차 뷰 자기 증류로 미세 조정했다. 전체 요약 7문장 읽기 → 050 15:11 ▲ 44 · 댓글 2 LLM 추론 과정을 자체 스타일로 복원하는 TraceForge 발표 프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. AI · 머신러닝 · TraceForge: Distilling with Your Own Thinking
Key Point 상용 LLM의 추론 과정 접근을 제한하는 현실에서, 약관을 위반하지 않으면서도 모델의 자체 스타일로 추론을 복원해 학습 효율을 높일 수 있는 대안을 제시한다.
핵심 요약
프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. TraceForge는 교사 모델의 답변과 맥락에서 학생 모델 패밀리의 스타일로 추론 흔적을 생성하는 방식을 제안한다. 생성기가 교사 답변에서 추론 흔적을 재생성하도록 학습하고, 비평가가 실제 흔적의 진정성을 판단하는 2단계 학습(지도학습 후 적대적 학습)을 수행한다. 전체 요약 7문장 읽기 → 051 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 052 03:11 ▲ 12 · 댓글 2 효율적인 흐름 모델로 LLM 병렬 생성 실현 연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. AI · 머신러닝 · Large Flow Language Models
Key Point 병렬 생성과 더 빠른 추론이 가능한 흐름 모델이 대규모 언어 모델에서 실질적으로 작동하는 것을 처음 입증했으며, 기존 자동회귀 모델보다 2.5배 빠른 처리 속도로 같은 품질을 낸다는 점이 생성 AI 구조의 근본적 전환을 시사한다.
핵심 요약
연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. 라파(Lafa)는 80억 개 매개변수 규모의 흐름 언어 모델로, 30B 토큰 미만으로 학습되어 이전 확산 모델보다 효율적이다. 블록 단위 흐름 모델 설계로 접두사에는 인과 관계 어텐션, 각 블록 내에는 양방향 비동기 흐름을 적용한다. 전체 요약 10문장 읽기 → 053 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 054 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 055 15:11 ▲ 154 · 댓글 2 반복 모델이 긴 문제를 푸는 법: 진행도 정렬 재귀 반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. AI · 머신러닝 · PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
Key Point 반복 모델의 길이 외삽 성능을 16배까지 개선하는 기법이 제시되어, 재귀 신경망의 일반화 한계를 다루는 근본적인 접근 방식을 보여준다.
핵심 요약
반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. 순차적 상태 추적 작업에서 최종 답변 감독만으로는 각 반복이 얼마나 진행해야 하는지 명시하지 않으며, 반복된 업데이트가 재귀 상태의 스케일을 변화시킨다. PAR(Progress-Aligned Recurrence)는 k번째 반복의 예측을 처음 k개 연산 후의 상태와 일치하도록 학습하고, 재귀 상태를 첫 반복의 규범으로 정규화한다. 전체 요약 10문장 읽기 → 056 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 057 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 058 03:11 ▲ 11 · 댓글 2 이미지 편집 누적 오류 줄이는 ACEdit 발표 이미지 편집 모델은 단일 편집에서는 좋은 결과를 내지만, 여러 번의 편집을 반복하면 품질이 떨어지는 문제가 있다. AI · 머신러닝 · ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning
Key Point 여러 번 편집할 때마다 품질이 떨어지는 근본적인 문제를 해결하는 훈련 방식이 제시되어, 실제 사용 환경에서 안정적인 이미지 편집 도구 개발에 영향을 줄 수 있다.
핵심 요약
이미지 편집 모델은 단일 편집에서는 좋은 결과를 내지만, 여러 번의 편집을 반복하면 품질이 떨어지는 문제가 있다. 각 편집마다 분포 변화가 누적되어, 원래 학습한 입력 분포와 실제 다중 편집 추론 단계 사이의 간격이 벌어지기 때문이다. ACEdit는 모델이 훈련 과정에서 자신의 이전 편집 결과물에 직접 작동하도록 강제하는 학습 방식을 도입했다. 전체 요약 6문장 읽기 → 059 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 060 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 061 06:11 ▲ 16 · 댓글 1 학습 데이터 없이 확산 모델 가속화하는 방법 확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. AI · 머신러닝 · Consistent Distribution Matching for Data-Free Diffusion Distillation
Key Point 학습 데이터가 필요 없으면서도 최소 함수 평가로 고화질 생성을 하는 새로운 증류 기법이 기존의 데이터 의존성과 복잡한 학습 파이프라인 문제를 해결한다.
핵심 요약
확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. Consistent Distribution Matching이라는 시뮬레이션 프리·데이터 프리 증류 방식을 제안하며, 샘플 생성과 스코어 추정을 하나의 학생 네트워크로 통합한다. 프레임워크는 얼어 있는 교사 모델과 학습 가능한 학생 모델 두 개만 사용하고 하나의 목적함수를 최적화한다. 전체 요약 6문장 읽기 → 062 06:11 ▲ 11 · 댓글 3 언어모델 학습, 중간 계산 구조까지 모방하는 방식 제시 기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. AI · 머신러닝 · OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
Key Point 출력 공간의 감독을 넘어 모델의 내부 계산 구조를 직접 전이하는 새로운 증류 방식으로, 학생 모델의 추론 능력과 학습 효율을 근본적으로 향상시키는 접근법입니다.
핵심 요약
기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. 표현 매칭 같은 단순한 중간 계층 증류는 불충분한데, 교사와 학생의 표현이 기하학적으로 다를 수 있고 정렬된 은닉 상태도 학생의 후속 계산에 사용 불가능할 수 있기 때문이다. 연구진은 온폴리시 메커니즘 증류(OPMD)를 제안하여, 학생이 실제로 사용 가능하도록 교사 표현을 학생의 중간 상태로 변환하는 학생 호환 교사를 먼저 구축한다. 전체 요약 6문장 읽기 → 063 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 064 12:11 ▲ 34 · 댓글 3 장기 추론 에이전트를 위한 나무 구조 기반 정책 자기 증류법 강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. AI · 머신러닝 · Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
Key Point 장기 수평선 에이전트 학습 시 정책 편차와 신용할당 문제를 동시에 해결하는 새로운 방식이 기존 GRPO보다 실제 성과를 개선했기 때문입니다.
핵심 요약
강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. 기존 방식은 학습된 비평가, 과정 보상 모델, 온정책 증류 등으로 더 조밀한 신용을 얻지만 가치 네트워크나 강한 외부 교사가 필요해 훈련 복잡도가 높다. TreeOPSD는 비평가 없이 각 상호작용 턴을 나무 노드로 취급하고 공유 접두사에서 대안 경로를 분기하며 터미널 보상을 재귀적으로 역전파해 암묵적 턴 수준 신용을 생성한다. 전체 요약 6문장 읽기 → 065 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 066 09:11 ▲ 11 · 댓글 2 AI 에이전트가 자율적으로 모델을 학습시키다 AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. AI · 머신러닝 · Athanor: An Agent-Native System for Autonomous Post-Training Research
Key Point 현재의 AI 에이전트가 인간의 개입 없이 모델 개발 연구를 독립적으로 수행할 수 있음을 실증했으며, AI 시스템이 더 강력한 AI를 구축하는 자기 개선 경로의 현실적 가능성을 보여준다.
핵심 요약
AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. 104시간 동안 Claude Opus 3.5 에이전트 4개가 각각 8개 GPU 노드에서 Qwen3-4B-Base 모델을 개선했으며, 어떤 연구 조언도 받지 않았다. 개발 테스트 6개 과제에서 모델 성능이 15.9에서 67.3으로, 공개되지 않은 홀드아웃 평가 세트에서는 9.2에서 48.2로 향상되었다. 전체 요약 8문장 읽기 → 067 18:11 ▲ 28 · 댓글 3 파일에서 인사이트 찾는 AI, 합성 데이터로 학습시키다 파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. AI · 머신러닝 · Data World: Scaling Data Environments from Scratch
Key Point 데이터 분석 AI 학습을 위한 현실적인 대규모 데이터 환경 구축 방식이 제시되며, 합성 환경에서의 강화학습이 실제 벤치마크 성능 향상으로 이어지는 경로를 보여준다.
핵심 요약
파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. Data World 엔진은 파일을 먼저 생성하는 대신, 파일 뒤의 세상(데이터 구조·관계)을 명시적으로 정의한 뒤 환경·과제·평가 기준을 합성한다. 독립적인 감사로 관찰된 파일에서 정답을 복구할 수 있는지 검증하며, RL 학습을 위한 보상 함수로도 활용한다. 전체 요약 7문장 읽기 → 068 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 069 12:11 ▲ 10 · 댓글 1 LLM이 가르치는 과학 생성 AI, 자연어로 약물 설계한다 기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. AI · 머신러닝 · LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
Key Point LLM의 추론 능력과 도메인 특화 생성 모델의 구조적 타당성을 결합하여 자연어 명령만으로 신약 후보 물질을 설계할 수 있는 방법론이 제시되었기 때문에, 과학 발견 프로세스의 자동화 가능성을 보여주는 중요한 진전이다.
핵심 요약
기초 LLM은 광범위한 화학·생물학 지식을 가진 반면, 흐름·확산 기반 생성 모델은 유효한 배열과 구조를 생산하는 데 필요한 선행 지식을 캡처하는데, 두 능력이 분리되어 있는 문제가 있다. 명시적 보상 함수 없이 자연어로 표현된 발견 목표에 과학 생성 모델을 정렬하는 방법을 연구했다. LLM-to-Flow Distillation(LFD)을 제안하며, 여기서 고정된 LLM이 도메인 특화 생성 모델의 적응형 교사 역할을 한다. 전체 요약 8문장 읽기 → 070 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 071 18:11 ▲ 65 · 댓글 1 문맥 정보를 모델의 영구 지식으로 만드는 방법 큰 언어모델에 주어진 문맥(context)으로 성능이 올라가지만, 문맥이 제거되면 그 이득이 사라진다. AI · 머신러닝 · Cortex: Consolidating Context into Parametric Memory
Key Point 문맥 정보를 임시적이 아닌 영구적 지식으로 전환하는 기술은 모델 미세조정이나 지속적 학습 환경에서 핵심적인 문제이며, 대규모 모델에서의 구체적 성능 달성(88.9% 복구율)을 보여준다.
핵심 요약
큰 언어모델에 주어진 문맥(context)으로 성능이 올라가지만, 문맥이 제거되면 그 이득이 사라진다. 생물학적 기억 통합 현상에서 영감을 얻어 Memory Consolidation(MC)을 제안한다: 문맥으로부터의 이득을 모델에 내재화하면서 다른 능력은 보존하는 것이다. Context-specified editing, skill learning, behavioral steering을 하나의 목표 아래 통합한다. 전체 요약 8문장 읽기 → 072 18:11 ▲ 76 · 댓글 2 강화학습 에이전트 최적화, 방법 많다고 더 나을까 에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. AI · 머신러닝 · More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning
Key Point 에이전트 강화학습의 자기증류 방법이 계속 제안되는 가운데, 실제로 더 많은 방법이 더 나은 성능을 보장하지 않는다는 점이 중요하기 때문에 방법론 선택과 연구 방향에 영향을 미친다.
핵심 요약
에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. 연구팀은 10가지 대표 방법을 GRPO와 함께 ALFWorld, ScienceWorld, Search-QA, WebShop에서 3가지 모델 크기로 비교했으며, 132개 훈련 실행과 총 12,124.4시간의 H800 GPU를 사용해 8개 롤아웃 시드로 반복 평가했다. 최종 성능 외에 훈련 진행률, 안정성, 측정된 계산 비용을 조사했고, GRPO 대비 성능 향상이 제한적이며 모든 설정에서 지속적으로 뛰어난 방법이 없음을 발견했다. 전체 요약 5문장 읽기 → 073 15:11 ▲ 15 · 댓글 2 로봇 기초모델, 지속학습으로 새 작업 빠르게 습득 로봇 기초모델(RFM)의 강화학습 미세조정은 데모 이상의 성능을 낼 수 있지만, 실제 배포에는 새 작업을 효율적으로 학습하면서 기존 능력을 잃지 않아야 한다. AI · 머신러닝 · ACCRUE: Continual Off-Policy Reinforcement Learning for Robot Foundation Models
Key Point 로봇이 새로운 작업을 배우면서 기존 능력을 유지해야 한다는 실제 배포 문제를 오프폴리시 RL로 해결했으며, 31~68% 훈련 시간 단축으로 실용성을 입증했습니다.
핵심 요약
로봇 기초모델(RFM)의 강화학습 미세조정은 데모 이상의 성능을 낼 수 있지만, 실제 배포에는 새 작업을 효율적으로 학습하면서 기존 능력을 잃지 않아야 한다. 기존 지속학습 RL 방식은 온폴리시 업데이트로 잊음 현상을 줄이지만 전이학습이 제한적이고, 오프폴리시 방식은 단일 작업 샘플 효율은 높이지만 작업 간 지속성 문제를 해결하지 못한다. ACCRUE는 경량 액터-크리틱 네트워크를 작업 간에 보존하는 오프폴리시 RL 프레임워크로, 각 단계가 이전 RL에서 습득한 행동과 가치 지식을 재사용한다. 전체 요약 6문장 읽기 → 074 15:11 ▲ 76 · 댓글 2 비평으로 실패를 바로잡는 학생 모델 훈련법 온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. AI · 머신러닝 · Recovering Reliable Supervision via Critique-Guided On-Policy Distillation
Key Point 학생 모델이 스스로 생성한 데이터로 훈련할 때 교사의 오류 인식 능력을 활용해 신뢰성 있는 감독 신호를 복구하는 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 모델 훈련 효율을 높인다.
핵심 요약
온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. 교사 모델이 학생의 오류를 인식하면서도 그 오류를 따라가는 문제가 발생하며, 이는 잘못된 답변으로 훈련하게 만든다. 이를 해결하기 위해 CriticOPD를 제안했는데, 교사가 오류가 있는 롤아웃을 비평하면 학생은 그 오류를 인식하고 해답을 다시 작성한다. 전체 요약 5문장 읽기 → 075 15:11 ▲ 54 · 댓글 2 토큰 대신 행동 기준으로 언어모델 에이전트 증류하기 언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. AI · 머신러닝 · ActionOPD: Distilling Decisions, Not Tokens
Key Point 작은 언어모델을 강력한 에이전트로 만드는 증류 방식의 근본적인 패러다임 전환으로, 토크나이저 의존성 없이 더 유연한 모델 간 지식 이전이 가능해진다.
핵심 요약
언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. 연구팀은 의미 있는 행동(semantic actions)을 증류 감시 신호로 사용하는 ActionOPD(행동 수준 온폴리시 증류) 방법을 제안했다. ActionOPD는 학생 모델이 마주친 각 상태에서 학생과 블랙박스 교사 모델에서 모두 행동을 샘플링하고, 학생 행동의 의미적 일치도에 따라 보상을 준다. 전체 요약 7문장 읽기 → 076 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 077 21:11 ▲ 84 · 댓글 2 로봇 기초 모델 'GreenWAM' 공개, 20개 로봇 계열에서 통용 로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. AI · 머신러닝 · GreenWAM: A World Foundation Model for Robotics
Key Point 다양한 로봇 종류에서 작동하는 통합 기초 모델이 세계 모델과 정책을 모두 수행할 수 있음을 처음으로 입증하며, 로봇 비전 분야의 일반화 문제에 실질적 해법을 제시한다.
핵심 요약
로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. 로봇마다 다른 행동 표기법을 통합하기 위해 20개 로봇 계열(양팔 로봇부터 손가락까지 제어하는 휴머노이드까지)을 공통 관절 좌표로 설명하는 '공유 해부학적 행동 공간'을 구축했다. 세계 모델 모드, 행동-조건부 모드, 세계-행동 모드의 세 가지 방식으로 이들 로봇 계열을 함께 학습했고, 행동 전문가를 분리하는 정책 구조를 적용했다. 전체 요약 7문장 읽기 → 078 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 079 18:11 ▲ 29 · 댓글 2 언어 모델 자가증류, 체계적 프롬프트로 추론 질 높인다 대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. AI · 머신러닝 · Self-Distillation with Verbal Regularization
Key Point 언어모델 학습에서 교사-학생 구조의 편향 문제를 프롬프트 엔지니어링으로 해결하는 실질적인 방법론으로, 추론 성능을 높이면서도 모델의 탐색성을 보존하는 기술입니다.
핵심 요약
대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. 교사는 정답 같은 특권정보(PI)를 조건으로 받지만, 학생은 이를 보지 못한 채 교사의 토큰 분포로부터 학습합니다. 하지만 특권정보는 깊은 검증 없이 지름길 추론으로 편향되는 문제가 생기며, 출력 분포의 엔트로피가 급격히 떨어집니다. 전체 요약 8문장 읽기 → 080 18:11 ▲ 195 · 댓글 2 LLM 에이전트에 자가 반성 능력 가르치는 Agent-Reflex 프레임워크 언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. AI · 머신러닝 · Agent-Reflex: Teaching Language Agents to Act Reflectively
Key Point 도구 사용 에이전트가 실제 환경의 노이즈와 오류로부터 자동으로 학습하고 회복할 수 있는 구체적인 훈련 방법론을 제시하고 있어, 더욱 견고한 AI 에이전트 개발에 필요한 기술이다.
핵심 요약
언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. Agent-Reflex는 세 단계로 구성된 훈련 프레임워크로, 먼저 Environment Reflection Skill Discovery(RSD) 단계에서 도구 피드백 섭동을 주입하고 다양한 LLM 풀에서 성공-실패 쌍을 추출해 반성 메타스킬을 도출한다. Reflective Supervised Fine-Tuning(ReSFT) 단계는 각 스킬을 자가 반성, 스킬 복구, 사용자 중심 수정을 위한 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 081 18:11 ▲ 53 · 댓글 2 이미지 속 상황의 진위를 판단하는 AI 에이전트 EviScene 이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. AI · 머신러닝 · EviScene: Beyond "Is It AI?" for Agentic Image Factuality Assessment
Key Point 이미지 조작이 늘어나는 환경에서 단순 AI 생성 여부가 아니라 그 장면의 실제 사실성을 검증할 수 있는 자동화된 방법이 중요해지고 있기 때문이다.
핵심 요약
이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. 이미지와 검증 지시문이 주어졌을 때 시스템이 지지 또는 반박 판정과 근거 기반 설명을 제시하는 방식으로, 텍스트 주장이 없어도 조사 중 점진적으로 팩트 질문을 정교화하고 외부 증거와 비교한다. 통제 생성과 웹 수집으로 만든 1만 174개 이미지(지지/반박)를 포함하며 12가지 팩트 오류 유형을 다루는 EviLens 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 082 15:11 ▲ 52 · 댓글 1 BERT 인코더의 한계를 뛰어넘은 UltraBERT 최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. AI · 머신러닝 · UltraBERT: Beyond the Limit of BERT Pre-Training
Key Point BERT 기반 인코더가 분류와 검색 작업을 함께 잘 처리하는 것이 불가능했던 문제를 처음으로 해결하며, 양방향 모델의 학습 방식과 마스킹 비율 설계에 대한 새로운 원칙을 제시한다.
핵심 요약
최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. 연구진은 학습 설계의 핵심 선택지들을 재검토해 세 가지 주요 발견을 얻었다: (1) 인코더는 수조 개 토큰 이상에서 다운스트림 작업의 성능이 포화되어 추가 계산이 도움이 안 됨, (2) 낮은 마스킹 비율은 분류에 유리하고 높은 비율은 검색에 유리하며 이는 모델 크기와 무관하게 적용됨, (3) 증류와 프루닝은 낮은 마스킹 비율에서는 분류를 개선하지만 높은 비율에서는 검색을 악화시킴. 이 발견들을 바탕으로 UltraBERT는 배치 내에서 낮은 비율과 높은 비율의 마스킹에 각각 별도의 언어모델 헤드를 할당하고 증류 목표를 낮은 비율로만 제한하는 설계를 적용했다. 전체 요약 4문장 읽기 → 083 09:11 ▲ 30 · 댓글 2 언어 모델 에이전트를 위한 숨은 표현 자기증류 기법 제안 언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. AI · 머신러닝 · PR-OPD: Privileged Representation On-policy Self-Distillation for Agentic Reinforcement Learning
Key Point 강화학습 기반 에이전트 훈련에서 은닉 상태 정렬이라는 새로운 자기증류 방식으로 기존 방법보다 상당히 높은 성능 개선을 이루었으며, 외부 자원 없이 단순한 구조로 실용적이다.
핵심 요약
언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. 연구팀은 스킬이 응답 토큰의 80% 이상에서 은닉 상태를 변화시키며, 이 변화를 선형 프로브로 추적할 수 있다는 점을 발견했다. 이를 바탕으로 PR-OPD(Privileged Representation On-policy Self-Distillation) 방법을 제안하며, GRPO 사전학습 후 정책이 각 궤적에 대해 후지학적 스킬을 작성한다. 전체 요약 6문장 읽기 → 084 03:11 ▲ 11 · 댓글 2 LLM 매개변수 수정 없이 지식 이전하는 'UTT' 방법 제안 지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. AI · 머신러닝 · Universal Textual Teaching for LLMs
Key Point API 기반 또는 재학습이 비싼 LLM에도 적용 가능한 매개변수 무수정 지식 이전 방법으로, 해석 가능하고 재사용 가능한 형태의 교육 자료를 자동 생성할 수 있다는 점이 기존 증류 기법의 한계를 극복한다.
핵심 요약
지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. 연구팀은 매개변수 업데이트 없이 지식을 전달하는 'Universal Textual Teaching(UTT)'을 제안했으며, 교사와 학생의 차이를 자연어로 해석 가능한 'Primer'라는 재사용 가능한 형태로 증류한다. UTT는 먼저 쌍을 이룬 평가를 통해 대표적인 차이 사례들을 식별하고, 이후 다중 역할 상호작용으로 반복 업데이트한다: 학생이 과제를 시도하고, Prompter가 평가 피드백을 교수 지시문으로 변환하며, 교사가 대상화된 시연을 제공하고, Synthesizer가 검증된 교훈을 통합한다. 전체 요약 6문장 읽기 → 085 03:11 ▲ 18 · 댓글 3 오프라인 학생 모델로 증류하는 것이 더 효과적인 경우가 많다 온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. AI · 머신러닝 · When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
Key Point 증류 훈련의 핵심 선택지인 온폴리시 방식의 효과성을 재평가하는 논문으로, 더 간단하고 빠른 오프라인 방식이 많은 경우 더 나은 결과를 주는 상황을 규명한다.
핵심 요약
온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. 1.5B부터 235B 파라미터까지 17개의 교사-학생 쌍을 테스트한 결과, 14개 경우에서 Semi-OPD가 OPD를 능가했으며, 정확도 최대 13.6% 향상과 11.4배 훈련 속도 향상을 달성했다. 두 방식 중 어느 것을 선택할지는 교사와 학생의 정렬도에 따라 결정되며, 출력 토큰 겹침 비율로 측정할 수 있다. 전체 요약 5문장 읽기 → 086 18:12 ▲ 10 · 댓글 2 정책 증류에서 상대적 차이의 전이 메커니즘 규명 온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. AI · 머신러닝 · Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Key Point 강화학습 정책 증류에서 어떤 강사-참조 조합이 효과적인지, 모델 간 지식 전이 가능 조건을 규명해 실제 응용의 성공률을 높일 수 있기 때문이다.
핵심 요약
온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. 최근 연구는 강사의 절대 분포 대신 강사와 참조 정책 간의 상대적 차이를 전이하는 방식을 제안했지만, 어떤 차이가 유용한 감독을 제공하고 어떤 대상이 이득을 볼 수 있는지는 불명확했다. 연구팀은 프록시 강사와 프록시 참조 간의 로그 확률 비를 KL 정규화 정책 최적화의 암묵적 보상으로 해석하는 통합 이론을 개발했다. 전체 요약 9문장 읽기 → 087 18:12 ▲ 13 · 댓글 2 의료 AI가 스스로 증거를 찾는다, 종단 임상 추론 벤치마크 재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. AI · 머신러닝 · From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
Key Point 임상 데이터를 능동적으로 탐색하며 종단 추론을 수행하는 의료 AI 에이전트의 새로운 패러다임이 제시되며, 대규모 정제 벤치마크와 학습 방법이 함께 공개될 예정이기 때문이다.
핵심 요약
재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. CASE라는 역할별 임상 에이전트 시리즈와 도구 사용 장치, 컴팩트한 비전-언어 정책 모델 학습 프레임워크를 제안한다. UK Biobank 기반 종단 멀티모달 벤치마크를 구축했으며, 4,739명의 참여자로부터 도출한 ICD-10 코딩 진단에 기반한 50,401개 임상 질문을 포함한다. 전체 요약 8문장 읽기 → 088 18:12 ▲ 32 · 댓글 2 OCR을 넘어 텍스트 기반 시각 지능으로: PolyOCR 모델 공개 Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. AI · 머신러닝 · PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
Key Point OCR 기술이 단순 텍스트 추출에서 복잡한 문서 이해와 추론으로 확장되는 가운데, 여러 작업을 균형있게 수행하는 통합 모델의 등장은 문서 처리, 정보 추출, 자동화 분야에 실질적인 영향을 미칠 수 있다.
핵심 요약
Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. 기존 OCR 시스템은 특정 작업에만 강하고 인식, 파싱, 추론을 균형있게 수행하지 못하는 한계가 있었다. PolyOCR은 명령 추종 프레임워크와 대규모 데이터 엔진을 결합하여 서로 다른 시각 자원을 검증된 OCR 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 089 18:12 ▲ 20 · 댓글 2 다양한 이미지 생성 모델을 하나로 연결하는 InstantFusion Diffusion/Flow 기반 이미지 생성 모델들이 다양해지면서 서로 다른 아키텍처와 표현방식을 가지게 되었으나, 모델 간 잠재 표현의 정렬과 디노이징 과정의 일관성에 대한 연구는 부족했다. AI · 머신러닝 · InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators
Key Point 서로 다른 이미지 생성 모델들을 하나의 인터페이스로 통일하면 생성 파이프라인 최적화와 모델 재사용성이 크게 향상될 수 있기 때문입니다.
핵심 요약
Diffusion/Flow 기반 이미지 생성 모델들이 다양해지면서 서로 다른 아키텍처와 표현방식을 가지게 되었으나, 모델 간 잠재 표현의 정렬과 디노이징 과정의 일관성에 대한 연구는 부족했다. 연구팀은 독립적으로 학습된 생성 모델들이 비슷한 잠재 공간 구조를 갖고 있으며, 정렬되지 않은 모델 간에도 중간 상태를 직접 전달하면 기본적인 시각 정보가 유지된다는 흥미로운 호환성을 발견했다. 이를 바탕으로 InstantFusion이라는 경량 공유 잠재 인터페이스를 제안했으며, 이는 서로 다른 구조의 이미지 생성 모델들의 디노이징 과정을 연결한다. 전체 요약 7문장 읽기 → 090 15:11 ▲ 60 · 댓글 2 멀티모달 AI의 연산 비용을 줄이는 '탄력적 시각 표현' 기법 등장 멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. AI · 머신러닝 · VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
Key Point 다음 세대 멀티모달 모델 실서빙에서 비용과 속도를 동시에 개선하는 기술이 나왔으며, 기존 토큰 제거 기법보다 성능 유지 능력이 뛰어나다.
핵심 요약
멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. 기존 다운샘플링과 토큰 제거 기법들은 내용에 따른 세밀한 적응, 다양한 작업 지원, 최신 모델 통합에서 한계가 있었다. VisionWeave는 이미지 영역별로 세부도를 적응적으로 조절하는 '탄력적 시각 표현 짜기' 능력을 MLLM에 구현했다. 전체 요약 8문장 읽기 → 091 15:11 ▲ 43 · 댓글 2 소형 모델의 지속 학습을 위한 합성 자기 증류법 소형 모델의 지속적 학습(continual post-training)은 새로운 능력을 습득하면서도 기존 지식을 보존해야 하는 이중 과제에 직면해 있다. AI · 머신러닝 · Continually Post-training Small Models via Synthetic Self-distillation
Key Point 분포 편향이 소형 모델 학습 실패의 근본 원인이라는 발견과 이를 해결하는 구체적 기법이 온디바이스 AI 서비스 실현의 핵심 과제를 다룬다.
핵심 요약
소형 모델의 지속적 학습(continual post-training)은 새로운 능력을 습득하면서도 기존 지식을 보존해야 하는 이중 과제에 직면해 있다. 기존 자기 증류 미세조정(SDFT)은 문맥 내 학습과 명령 따르기 능력이 뛰어난 모델에서는 작동하지만, 저지연 온디바이스 실행이 필요한 소형 모델에서는 실패한다. 논문은 소형 모델에서 새로운 능력 습득 실패와 기존 지식 망각이 학습된 모델의 분포 편향과 선형 상관관계를 보여주며, 분포 내 학습의 필요성을 입증했다. 전체 요약 7문장 읽기 → 092 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 093 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 094 09:11 ▲ 10 · 댓글 2 음악 악보 변환 AI, 합성 데이터로 정확도 대폭 향상 음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. AI · 머신러닝 · SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
Key Point 음악 악보 자동 변환의 핵심 문제(학습 데이터 부족과 음악적 일관성)를 합성 데이터와 구조화된 디코딩으로 해결한 방법론이 멀티태스크 모델에서 전문 모델을 능가하는 성능을 입증했다.
핵심 요약
음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. SheetSage2는 합성 데이터, 구조화된 디코딩, 자기회귀 증류를 통합한 음악 변환 모델로, MIDI를 음성으로 렌더링한 합성 데이터로 대규모 학습을 가능하게 한다. 작업별 구조화된 디코더가 음악 정보와 시간 의존성을 통합해 일관성 있는 악보를 생성한다. 전체 요약 6문장 읽기 → 095 06:11 ▲ 14 · 댓글 2 VLM 에이전트, 시각 기반 스킬로 강화 학습 기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. AI · 머신러닝 · ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
Key Point VLM 에이전트가 기하학적 정보를 보존한 시각 기반 스킬을 동적으로 습득·활용하는 새로운 강화 학습 방법으로, 정책과 스킬의 상호 개선 메커니즘이 기존 텍스트 중심 방식의 한계를 직접 해결한다.
핵심 요약
기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. ViSkill은 성공한 상호작용을 시각 정보 중심의 '스킬 카드'로 인코딩하여 VLM 에이전트가 직접 활용하는 방식을 제안한다. 검색된 스킬은 추론과 보상 형성을 모두 가이드하고, 성공한 궤적이 다시 스킬 라이브러리로 증류되어 닫힌 피드백 루프를 형성한다. 전체 요약 6문장 읽기 → 096 12:11 ▲ 226 · 댓글 3 가상 세계에서 코드로 에이전트를 진화시키는 AgentGarten AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. AI · 머신러닝 · AgentGarten: Code Worlds for Evolving Agents
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 097 12:11 ▲ 140 · 댓글 2 완료된 경험으로 예측력 높이는 AI 학습법 제시 강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다. AI · 머신러닝 · Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight
Key Point 보상 신호가 부족한 강화학습 상황에서 과거 경험으로 예측력을 높이는 새로운 접근법은 장기 작업 에이전트와 추론 기반 AI 개발에 직결되는 개선 기법이다.
핵심 요약
강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다. 기존 RLVR(검증 가능 보상 강화학습) 방식은 스칼라 보상만으로 신호를 만들어 그룹 상대 목표에서 모든 시도가 같은 보상받으면 실패한다. 저자는 "Self-Retrospection Distillation(SRD)" 기법을 제안해 이미 완료된 궤적(trajectory)의 정보를 사전 예측 학습에 활용한다. 전체 요약 8문장 읽기 → 098 09:11 ▲ 23 · 댓글 2 AI 에이전트 학습용 실제감 있는 사용자 시뮬레이터 MIMESIS 개발 대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. AI · 머신러닝 · MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
Key Point 에이전트 학습에 실제 사용자처럼 행동하는 시뮬레이터를 사용하면 데이터 수집 비용을 크게 줄이면서도 더 나은 에이전트를 만들 수 있다는 것을 입증했기 때문이다.
핵심 요약
대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. 기존 에이전트 학습 프레임워크는 기성 LLM 어시스턴트를 사용하는데, 이들은 너무 협력적이고 명확하며 동질적이어서 실제 사용자와 차이가 난다. MIMESIS는 인간 대화 데이터와 13가지 현실적 행동 패턴 레이블로 학습한 전용 사용자 시뮬레이터로, 9B 모델이 SOUL-Index 65.7을 달성했다. 전체 요약 7문장 읽기 → 099 03:11 ▲ 10 · 댓글 2 텍스트-이미지 생성 모델에 에이전트 지식 직접 조각내기 텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. AI · 머신러닝 · Internalizing Agent Experience into Diffusion Model Weights via On-Policy Context Distillation
Key Point 이미지 생성 품질을 높이는 에이전트 능력을 모델 자체에 영구적으로 내재시켜 일반 사용자도 원본 쿼리만으로 개선된 이미지를 받을 수 있게 하는 새로운 접근 방식이다.
핵심 요약
텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. 논문은 Diffusion On-Policy Context Distillation(D-OPCD)를 제안하는데, 에이전트가 개선한 프롬프트를 특권 정보로 삼아 에이전트의 능력을 확산 모델 가중치로 직접 압축하는 방식이다. Auto Skill Evolver(ASE)라는 텍스트-이미지 에이전트를 사용해 D-OPCD를 실험한 결과, 원본 쿼리만으로 생성했을 때 평균 점수가 60.52에서 65.09로 상승했다(4개 벤치마크 기준). 전체 요약 5문장 읽기 → 100 18:30 ▲ 16 · 댓글 2 LLM 추론 최적화를 사용자 맞춤형으로, PersonTTS 제안 LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. AI · 머신러닝 · From Pareto to Preference: Personalized Test-Time Scaling via Amortized Agentic Policy Discovery
Key Point LLM 추론 과정을 다양한 사용자 요구(정확도·비용·속도)에 맞춰 최적화하는 문제를 처음 체계적으로 정식화하고, 이전 탐색 경험을 재사용해 계산 효율까지 확보하는 실용적 방법을 제시했다.
핵심 요약
LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. 사용자 요구는 다차원적이다: 정확도, 지연시간, 추론 비용을 동시에 명시할 수 있으며, 서로 다른 요구는 다른 컨트롤러를 필요로 한다. PersonTTS는 사용자별 요구사항을 최대한 만족시키는 실행 가능한 컨트롤러를 발견하는 스케줄링 문제로 정식화한다. 전체 요약 7문장 읽기 →