쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
47건 · "OPD"조건 지우기 ×
001 03:11 ▲ 13 · 댓글 9 학생 모델을 저렴하게 학습하려면 '오차 예산'이 필요하다 On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. AI · 머신러닝 · How Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?
Key Point 학생 모델 지식 증류 시 비용 절감 기법들이 학습 안정성에 미치는 실제 영향을 정량 측정한 결과로, 양자화와 비동기 처리의 활용도를 크게 높일 수 있는 실용적 기준을 제시한다.
핵심 요약
On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. 그러나 이 두 기법은 롤아웃 엔진과 학습 중인 모델 사이에 training-inference mismatch를 일으킨다. 본 연구는 OPD가 얼마나 많은 mismatch를 견딜 수 있는지, 어디서 문제가 발생하는지, 실제 시스템이 이를 어떻게 활용할 수 있는지를 조사했다. 전체 요약 11문장 읽기 → 002 21:11 ▲ 39 · 댓글 3 시각 에이전트가 도구 결과를 제대로 쓰도록 학습시키는 방법 시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. AI · 머신러닝 · Reframe: Observation-Aligned Multi-Teacher On-Policy Distillation for Agentic Visual Reasoning
Key Point 시각 에이전트의 도구 사용이 불완전해 학습이 비효율적이던 문제를 해결하는 체계적 접근법으로, 다중 교사 증류학습 분야의 실질적 개선책을 제시한다.
핵심 요약
시각 기반 강화학습 에이전트는 도구가 반환한 관찰 정보를 무시하거나 부실한 행동으로 이후 증류학습에 필요한 증거를 잃는 문제를 겪는다. Reframe은 두 단계의 학습 프레임워크로, 먼저 Ground-Drop-GRPO(GD-GRPO)가 증거 기반 보상과 원본 시각 입력의 확률적 제거를 통해 공간·시간 전문가를 훈련해 근거 있는 증거를 얻고 도구 반환 관찰을 활용하게 한다. 두 번째 단계 Observation-Gated-MOPD(OG-MOPD)는 롤아웃 중 결함 있는 도구 행동을 정준(canonical) 행동으로 교체하고 수정된 관찰에서 증류학습을 재개해 학습 안정성을 높인다. 전체 요약 6문장 읽기 → 003 18:11 ▲ 62 · 댓글 8 매개변수 사전활용으로 멀티티처 증류 2배 빠르게 다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. AI · 머신러닝 · P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
Key Point 멀티티처 증류에서 훈련 단계를 50% 단축하고 최종 성능을 14% 향상시키는 방법이 제시되어, 대규모 모델 병렬화 연구에 실질적 가치가 있다.
핵심 요약
다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. 기존 태스크 산술(task arithmetic)은 학생과 전문가 매개변수를 선형결합하되 두 모델의 범위 내에만 머물게 되는 한계가 있다. P²-MOPD는 학생과 전문가 매개변수의 선형결합을 하나의 미분가능한 모델로 보고, 혼합 계수와 학생 가중치를 동일한 목적함수 아래 공동 최적화한다. 전체 요약 6문장 읽기 → 004 06:11 ▲ 23 · 댓글 3 정책 증류 학습, 분포 밖 일반화 능력 잃는다 여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. AI · 머신러닝 · On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
Key Point 대규모 언어모델을 다중 교사로부터 학습시킬 때 학습 데이터 분포 내에선 우수하지만 그 외의 상황에서 성능이 급격히 떨어지는 핵심 문제를 실증적으로 규명했고, 개선 방안까지 제시했기 때문입니다.
핵심 요약
여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. Qwen3 모델을 이용해 수학 추론, 코딩, 에이전트, 장문맥 이해 등 4가지 과제에서 성능을 평가한 결과, 분포 외(OOD) 성능이 기본 모델보다 2.45~16.25% 낮았다. 합성 작업에서는 MOPD가 분포 내 성능을 개선했으나, 구성된 작업의 분포 외 성능은 최고 성능 교사 모델보다 18.19~24.34% 뒤떨어졌다. 전체 요약 7문장 읽기 → 005 03:11 ▲ 15 · 댓글 2 추측 디코딩 성능 41% 높이는 병렬 온폴리시 디스틸레이션 기법 LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. AI · 머신러닝 · SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Key Point 추측 디코딩의 병렬화와 감독 신호 수집 방식을 근본적으로 개선해 LLM 추론 속도를 획기적으로 높일 수 있는 기술이다.
핵심 요약
LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. 온폴리시 디스틸레이션(OPD)은 훈련된 초안 생성기를 채택 길이 한계 이상으로 끌어올릴 수 있으나, 기존 방식은 순차적인 초안-검증 롤아웃을 통해 감독 신호를 수집한다. 본 논문의 핵심 아이디어는 온폴리시 감독 신호가 이 순차 의존성을 벗을 수 있다는 것이다: 초안 블록은 참조 접두사와 초안으로 샘플링한 이력만으로도 감독될 수 있다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 48 · 댓글 3 에이전트 AI 모델 'Axion 1.0' 오픈소스 공개 Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. AI · 머신러닝 · Axion 1.0: Open Agent Foundation Models, Simplified
Key Point 강력한 에이전트 AI를 단순한 훈련 방식으로 구현할 수 있다는 것을 입증하고 전체 개발 과정을 공개해 오픈소스 에이전트 AI 연구의 진입장벽을 낮혔다.
핵심 요약
Hugging Face가 완전 오픈소스 에이전트 기초 모델 Axion 1.0을 발표했다. 3단계 학습으로 구성된다: 모델 인식 데이터 구성을 통한 자체 추론 능력 개발, 실제 데이터 기반 다양한 작업으로 도구 활용 추론 확장, 강화학습을 통한 장기 추론 강화. 첫 번째 SFT 단계는 모델의 성공적 문제해결 전략을 기반으로 어려운 문제를 합성하고 역대적으로 강화하는 방식을 사용한다. 전체 요약 8문장 읽기 → 007 03:11 ▲ 34 · 댓글 4 LLM 증류 방식 개선, 확률값 대신 토큰 순서만 학습 기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. AI · 머신러닝 · Order-Only On-Policy Distillation
Key Point 확률값 대신 토큰 순서만 학습하는 방식으로 LLM 증류 성능을 개선했으며, 온도 튜닝 같은 복잡한 하이퍼파라미터 조정이 필요 없어진다는 점이 실무적 가치를 갖는다.
핵심 요약
기존 온폴리시 증류(OPD)는 학생 모델을 교사 모델의 토큰 확률값에 맞춰 학습시킨다. 이 확률값에는 교사가 선호하는 토큰이 무엇인지와 얼마나 확신하는지 두 가지 정보가 섞여있는데, 후자는 교사의 용량과 보정을 반영하므로 작은 학생 모델이 재현하기 어렵다. 교사 온도 변화가 확률값을 바꾸지만 순서는 유지하므로 OPD는 온도 선택에 민감하다. 전체 요약 10문장 읽기 → 008 00:11 ▲ 15 · 댓글 2 작은 의사결정 모델, 큰 언어모델 앞지르다 의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. AI · 머신러닝 · DecisionRank: On-Policy Distillation for Decision-Model Rerankers
Key Point 구조화된 검색 작업에서 작은 모델이 큰 모델 수준의 성능을 크게 빠른 속도로 달성하는 방법이 나왔기 때문에, 정보 검색 시스템의 효율성이 크게 개선될 가능성이 있다.
핵심 요약
의사결정 모델은 구조화된 작업에서 선택지나 점수를 직접 예측해 자동회귀 디코딩 지연을 피하지만, 생성형 LLM의 순위 매김 지식을 이전하기는 어렵다. 의사결정 모델(학생)은 첫 토큰 위치의 점수로 순위를 정하는 반면 생성형 교사는 문서 ID 수열의 순위 목록으로 선호도를 표현하기 때문이다. DecisionRank는 항목 공간 정책상 증류(item-space OPD) 기법으로 학생 모델을 학습한다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 33 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 010 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 011 18:11 ▲ 12 · 댓글 2 계층형 멀티에이전트 시스템, 온폴리시 증류로 학습 성능 향상 계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. AI · 머신러닝 · MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
Key Point 멀티에이전트 시스템의 계층적 학습 문제를 해결하는 새로운 방식으로, 간접 피드백만으로도 효과적인 공동 학습이 가능함을 보여준다.
핵심 요약
계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. MultiAgent-OPD는 온폴리시 증류(on-policy distillation)와 강화학습을 결합해 리더-서처-앤서 팀을 엔드투엔드로 공동 학습한다. 먼저 정답 정확성을 기준으로 서처-앤서 워크플로에서 교사 모델을 학습시킨다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 013 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
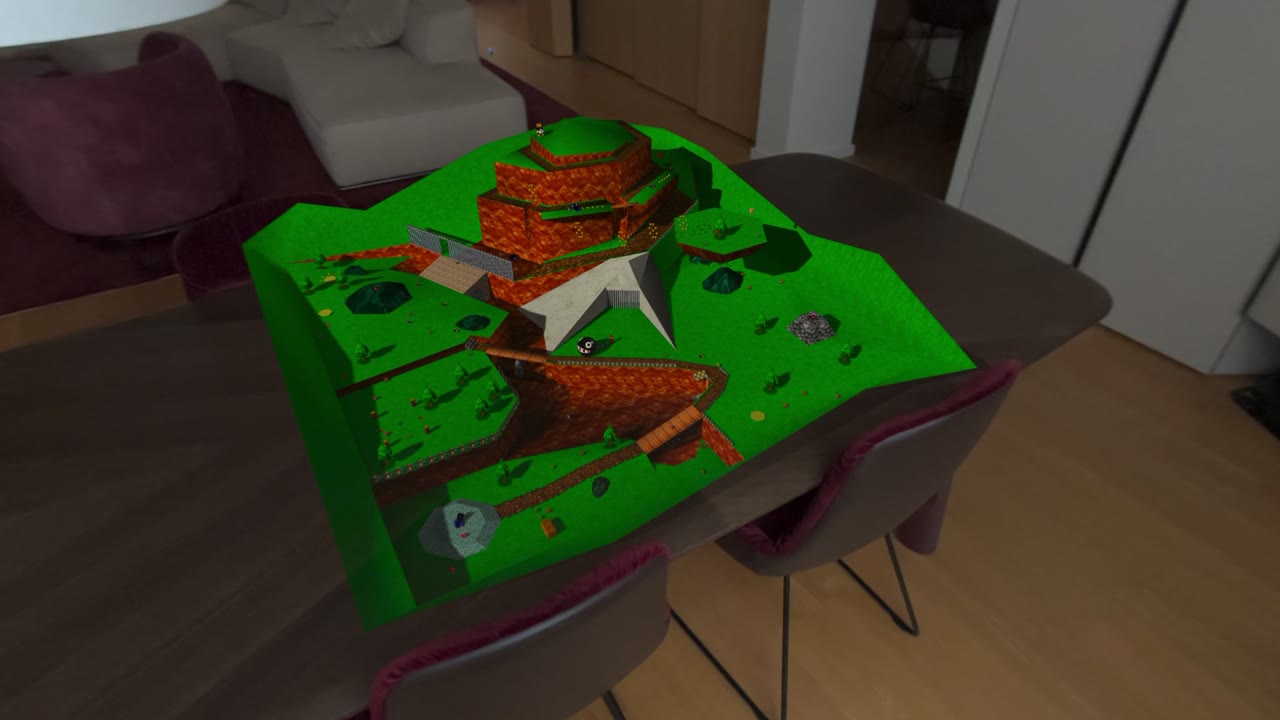
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 014 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 015 06:11 ▲ 11 · 댓글 3 언어모델 학습, 중간 계산 구조까지 모방하는 방식 제시 기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. AI · 머신러닝 · OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
Key Point 출력 공간의 감독을 넘어 모델의 내부 계산 구조를 직접 전이하는 새로운 증류 방식으로, 학생 모델의 추론 능력과 학습 효율을 근본적으로 향상시키는 접근법입니다.
핵심 요약
기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. 표현 매칭 같은 단순한 중간 계층 증류는 불충분한데, 교사와 학생의 표현이 기하학적으로 다를 수 있고 정렬된 은닉 상태도 학생의 후속 계산에 사용 불가능할 수 있기 때문이다. 연구진은 온폴리시 메커니즘 증류(OPMD)를 제안하여, 학생이 실제로 사용 가능하도록 교사 표현을 학생의 중간 상태로 변환하는 학생 호환 교사를 먼저 구축한다. 전체 요약 6문장 읽기 → 016 15:11 ▲ 668 · 댓글 4 RL 학습 과정의 중간 체크포인트로 정책 이동 검증하기 기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. AI · 머신러닝 · Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
Key Point 강화학습으로 개선된 모델의 지식을 효율적으로 전이할 때 단순히 최종 결과만 보는 게 아니라 학습 과정의 일관성을 검증해야 더 좋은 결과를 얻을 수 있다.
핵심 요약
기존 정책 이동 증류(policy-shift distillation)는 강화학습으로 학습한 교사 모델의 초기-최종 로짓 차이만 학생에게 전달하는데, 이는 학습 과정 중 행동 선호도가 일관되게 변했는지 알 수 없다. 같은 최종 변화라도 초기와 후기의 이동이 서로 상쇄될 수 있어 신뢰할 수 없다. Waypoint-OPD 방법은 교사 모델의 중간 체크포인트를 사용해 초기(시작→중간)와 후기(중간→최종) 정책 이동을 비교한다. 전체 요약 9문장 읽기 → 017 15:11 ▲ 76 · 댓글 2 비평으로 실패를 바로잡는 학생 모델 훈련법 온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. AI · 머신러닝 · Recovering Reliable Supervision via Critique-Guided On-Policy Distillation
Key Point 학생 모델이 스스로 생성한 데이터로 훈련할 때 교사의 오류 인식 능력을 활용해 신뢰성 있는 감독 신호를 복구하는 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 모델 훈련 효율을 높인다.
핵심 요약
온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. 교사 모델이 학생의 오류를 인식하면서도 그 오류를 따라가는 문제가 발생하며, 이는 잘못된 답변으로 훈련하게 만든다. 이를 해결하기 위해 CriticOPD를 제안했는데, 교사가 오류가 있는 롤아웃을 비평하면 학생은 그 오류를 인식하고 해답을 다시 작성한다. 전체 요약 5문장 읽기 → 018 15:11 ▲ 54 · 댓글 2 토큰 대신 행동 기준으로 언어모델 에이전트 증류하기 언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. AI · 머신러닝 · ActionOPD: Distilling Decisions, Not Tokens
Key Point 작은 언어모델을 강력한 에이전트로 만드는 증류 방식의 근본적인 패러다임 전환으로, 토크나이저 의존성 없이 더 유연한 모델 간 지식 이전이 가능해진다.
핵심 요약
언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. 연구팀은 의미 있는 행동(semantic actions)을 증류 감시 신호로 사용하는 ActionOPD(행동 수준 온폴리시 증류) 방법을 제안했다. ActionOPD는 학생 모델이 마주친 각 상태에서 학생과 블랙박스 교사 모델에서 모두 행동을 샘플링하고, 학생 행동의 의미적 일치도에 따라 보상을 준다. 전체 요약 7문장 읽기 → 019 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 020 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 021 09:11 ▲ 30 · 댓글 2 언어 모델 에이전트를 위한 숨은 표현 자기증류 기법 제안 언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. AI · 머신러닝 · PR-OPD: Privileged Representation On-policy Self-Distillation for Agentic Reinforcement Learning
Key Point 강화학습 기반 에이전트 훈련에서 은닉 상태 정렬이라는 새로운 자기증류 방식으로 기존 방법보다 상당히 높은 성능 개선을 이루었으며, 외부 자원 없이 단순한 구조로 실용적이다.
핵심 요약
언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. 연구팀은 스킬이 응답 토큰의 80% 이상에서 은닉 상태를 변화시키며, 이 변화를 선형 프로브로 추적할 수 있다는 점을 발견했다. 이를 바탕으로 PR-OPD(Privileged Representation On-policy Self-Distillation) 방법을 제안하며, GRPO 사전학습 후 정책이 각 궤적에 대해 후지학적 스킬을 작성한다. 전체 요약 6문장 읽기 → 022 03:11 ▲ 18 · 댓글 3 오프라인 학생 모델로 증류하는 것이 더 효과적인 경우가 많다 온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. AI · 머신러닝 · When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
Key Point 증류 훈련의 핵심 선택지인 온폴리시 방식의 효과성을 재평가하는 논문으로, 더 간단하고 빠른 오프라인 방식이 많은 경우 더 나은 결과를 주는 상황을 규명한다.
핵심 요약
온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. 1.5B부터 235B 파라미터까지 17개의 교사-학생 쌍을 테스트한 결과, 14개 경우에서 Semi-OPD가 OPD를 능가했으며, 정확도 최대 13.6% 향상과 11.4배 훈련 속도 향상을 달성했다. 두 방식 중 어느 것을 선택할지는 교사와 학생의 정렬도에 따라 결정되며, 출력 토큰 겹침 비율로 측정할 수 있다. 전체 요약 5문장 읽기 → 023 18:12 ▲ 10 · 댓글 2 정책 증류에서 상대적 차이의 전이 메커니즘 규명 온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. AI · 머신러닝 · Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Key Point 강화학습 정책 증류에서 어떤 강사-참조 조합이 효과적인지, 모델 간 지식 전이 가능 조건을 규명해 실제 응용의 성공률을 높일 수 있기 때문이다.
핵심 요약
온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. 최근 연구는 강사의 절대 분포 대신 강사와 참조 정책 간의 상대적 차이를 전이하는 방식을 제안했지만, 어떤 차이가 유용한 감독을 제공하고 어떤 대상이 이득을 볼 수 있는지는 불명확했다. 연구팀은 프록시 강사와 프록시 참조 간의 로그 확률 비를 KL 정규화 정책 최적화의 암묵적 보상으로 해석하는 통합 이론을 개발했다. 전체 요약 9문장 읽기 → 024 18:30 새 버전 Node.js 26.11.0 출시, 버퍼·HTTP·암호화 기능 강화 Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. 인프라 · 데브옵스 · nodejs/node@v26.11.0
Key Point Buffer 검증·HTTP 헤더 안전성·프로세스 타임아웃 등 개발 안정성을 높이는 새 기능들이 다수 안정화됨에 따라 프로덕션 환경 운영의 신뢰도가 올라간다.
핵심 요약
Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. HTTP 모듈에 헤더 검증 함수 isValidHeaderName()과 isValidHeaderValue()가 새로 제공된다. HTTP/2에 connectionWindowSize 옵션이 추가되어 연결 윈도우 크기를 제어할 수 있다. 전체 요약 11문장 읽기 → 025 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 026 18:30 ▲ 17 · 댓글 2 약한 모델과의 비교로 학생 모델 학습 개선 온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. AI · 머신러닝 · On-Policy Distillation with Negative-Policy Rollouts
Key Point 학생 모델 학습에서 강한 교사만으로는 부족한 신호를 약한 모델과의 비교로 보완하는 새로운 접근 방식이 여러 조건에서 효과를 입증했다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. 기존 OPD 연구들은 증류 보상 공식이나 교사 구성을 개선해왔으나, 교사와 학생 간의 분포 중복이 낮을 때 긍정적 신호만으로는 학습이 부족할 수 있다. 논문은 음수 정책 온-폴리시 증류(NP-OPD)를 제안하는데, 낮은 성능의 음수 정책으로부터 생성한 샘플을 추가하여 학생 모델의 부정적 참조점을 제공한다. 전체 요약 6문장 읽기 → 027 18:30 ▲ 29 · 댓글 2 정책 증류의 명암: 보상 모델 신뢰도가 붕괴 결정한다 온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. AI · 머신러닝 · Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
Key Point 온-정책 증류의 성능 향상과 붕괴가 동시에 일어나는 원인을 규명하고 실질적인 완화 방법을 제시해 언어 모델 학습의 숨은 위험을 드러낸다.
핵심 요약
온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. 연구팀은 강화학습 관점에서 이 현상을 설명한다: 교사 모델이 자신이 거의 생성하지 않는 학생 행동까지 암묵적으로 보상한다. 암묵적 보상 모델이 신뢰할 수 있을 때 OPD는 올바른 응답을 더 쉽게 샘플링하게 만든다. 전체 요약 6문장 읽기 → 028 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 029 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 030 06:11 ▲ 160 · 댓글 46 Reflection, 501B 파라미터 오픈소스 모델 'Beam' 공개 Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. AI · 머신러닝 · Beam: Reflection's 501B open-weight model
Key Point 고효율 오픈소스 에이전트 모델이 공개되며, 특히 추론 효율에서 훨씬 큰 모델과 경쟁할 수 있다는 점이 엔터프라이즈 코딩 워크로드에 미치는 영향이 크다.
핵심 요약
Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. Beam은 웹과 라이선스 데이터셋의 23.8조 개 토큰으로 사전학습되었으며, 10.5K NVIDIA GB300 GPU에서 4주간 RL을 실행해 1억 개 이상의 롤아웃을 생성했다. 코딩·에이전트 작업에서 GLM 5.2와 경쟁력 있는 성능을 보이며, Qwen 3.8-Max에 근접한다. 특히 추론 효율에서 우위가 있어 GLM 5.2 대비 3~4배 적은 계산량으로 유사한 추론 능력을 제공한다. 전체 요약 12문장 읽기 → 031 03:11 ▲ 63 · 댓글 3 여러 전문 모델의 내부 표현까지 활용하는 학생 모델 증류법 온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. AI · 머신러닝 · Latent-MOPD: Latent Multi-Teacher On-Policy Distillation
Key Point 여러 작은 전문 모델의 능력을 한 학생 모델에 집약할 때 숨겨진 상태라는 새로운 정보 채널을 활용하면 더 효과적인 학습이 가능하며, 이는 효율적인 언어 모델 설계에 새로운 방향을 제시한다.
핵심 요약
온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. Latent-MOPD는 표현 수준의 첫 다중 교사 증류법으로, 교사의 예측뿐 아니라 예측을 계산하는 데 사용된 숨겨진 상태도 함께 활용한다. 추가 교사 학습 없이 기존 전문 모델을 통합하며, 여러 교사로부터의 표현 감독을 조정하기 위해 후층 타겟을 선택하고, 숨겨진 너비 차이를 공유 투영으로 해소하고, 도메인별로 업데이트를 그룹화한다. 전체 요약 9문장 읽기 → 032 15:11 ▲ 17 · 댓글 2 합성 장면으로 시각 인식 키우는 멀티모달 AI 자체 학습법 멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. AI · 머신러닝 · Where-OPD: Spatially Guided On-Policy Self-Distillation of MLLMs with Synthetic Scenes
Key Point 합성 데이터로 학습한 시각 AI가 실제 데이터에서도 3포인트 이상 성능 향상을 보이는 방식은 대규모 모델 개선의 비용 효율성을 높이려는 기업과 연구자들에게 실질적인 선택지가 된다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. 기존 방식은 이미지 일부를 자르거나 외부 교사 모델에 의존했지만, 이 연구는 공간 정보를 담은 텍스트 가이드를 통해 교사 모델에 특권 정보를 제공한다. 절차적으로 생성한 합성 장면에서 객체 정체성과 공간 좌표를 자동으로 얻을 수 있어, 인간 주석 없이 대규모 포스트 학습이 가능하다. 전체 요약 7문장 읽기 → 033 06:11 ▲ 11 · 댓글 2 학생 모델의 정답 여부에 따라 선별한 교사 피드백으로 성능 향상 기존 온정책 증류(OPD)는 강력한 교사 모델의 토큰 수준 피드백으로 학생을 훈련하지만, 학생이 이미 정확히 푼 질문에 교사가 실패하거나 과제별로 성공률이 다른 점을 무시한다. AI · 머신러닝 · DuoOPD: Learning from Joint Teacher-Student Outcomes for Multi-Task On-Policy Distillation
Key Point 학생과 교사의 성공 여부 조합에 따라 피드백을 다르게 적용하는 간단한 규칙으로 다중 과제에서 일관되게 성능을 높이는 새로운 증류 방식이기 때문에, 모델 경량화 실무에 직접 도입할 수 있는 기법으로 주목할 만하다.
핵심 요약
기존 온정책 증류(OPD)는 강력한 교사 모델의 토큰 수준 피드백으로 학생을 훈련하지만, 학생이 이미 정확히 푼 질문에 교사가 실패하거나 과제별로 성공률이 다른 점을 무시한다. 이 논문은 DuoOPD를 제안하며, 학생의 정답 여부가 피드백 방향을 결정하고 교사-학생 결과 조합이 교사의 지원 방식을 정한다. 교사만 성공한 경우 교사의 검증된 답변이 학생의 실패 응답 평가 맥락이 되고, 학생만 성공한 경우 과제별 가중치가 전체 응답을 강화한다. 전체 요약 7문장 읽기 → 034 06:11 ▲ 20 · 댓글 2 다단계 작업에서 언어 모델이 실수를 예방하고 회복하는 법 다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. AI · 머신러닝 · PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
Key Point 초기 실수를 예방하면서 동시에 회복하는 훈련 방식으로, 다중 턴 작업 에이전트의 오류 누적 문제를 직접 해결하는 실용적 접근이다.
핵심 요약
다중 턴 에이전트 훈련에서 초기에 발생한 하나의 잘못된 행동이 이후 상태를 왜곡해 오류가 누적되는 문제를 발견했다. Qwen3 3개 모델(8B~235B) 실험에서 실패한 시도의 50% 이상이 '중추적 실수'(작업 완료를 더 멀게 하는 행동)를 포함하고 있으며, 이는 대부분 초기에 발생한다. 놀랍게도 이러한 중추적 실수 후 몇 턴의 지도만으로도 작업 성공을 복구할 수 있다. 전체 요약 7문장 읽기 → 035 15:11 ▲ 15 · 댓글 1 학생 정책 궤적에 맞춘 교사 모델 적응 방식 제안 온-폴리시 증류(OPD)는 학생이 자신의 정책으로 생성한 궤적에서 교사의 감독을 받으며 학습하는 사후 학습 패러다임으로, 학생이 생성한 궤적은 학생에게는 온-폴리시이지만 교사에게는 오프-폴리시라는 근본적 비대칭성을 가진다. AI · 머신러닝 · On the Off-Policy Teacher in On-Policy Distillation
Key Point 온-폴리시 증류는 모델 사후 학습의 새로운 방식으로 주목받는데, 학생과 교사의 정책 분포 불일치 문제를 체계적으로 분석하고 해결하는 구체적 방법을 제시합니다.
핵심 요약
온-폴리시 증류(OPD)는 학생이 자신의 정책으로 생성한 궤적에서 교사의 감독을 받으며 학습하는 사후 학습 패러다임으로, 학생이 생성한 궤적은 학생에게는 온-폴리시이지만 교사에게는 오프-폴리시라는 근본적 비대칭성을 가진다. 교사는 자신의 정책으로 생성한 접두사에서 연속 생성하도록 최적화되어 있으나, OPD 중에는 학생이 생성한 접두사에서 감독해야 하므로 접두사가 길어질수록 성능이 저하된다. 이를 해결하기 위해 연구팀은 SCOUT(Student-COnditioned Updates of the Teacher)라는 공동 학습 프레임워크를 제안했다. 전체 요약 6문장 읽기 → 036 12:11 ▲ 276 · 댓글 3 강화학습 모델을 학생 모델에 가르치는 새로운 방식, 표현층에서 직접 학습 기존 온-폴리시 디스틸레이션(OPD)은 학생 모델이 자신의 궤적 위에서 교사의 다음 토큰 분포를 모방하도록 훈련하며, 출력 공간에서 암묵적 보상을 외삽하여 교사를 능가하게 할 수 있다. AI · 머신러닝 · The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation
Key Point 모델 증류에서 강화학습의 효과를 더 효율적으로 전달하는 새로운 방법이 제시되어, 더 작은 모델로도 큰 모델 수준의 성능을 얻을 수 있는 경로를 열어준다.
핵심 요약
기존 온-폴리시 디스틸레이션(OPD)은 학생 모델이 자신의 궤적 위에서 교사의 다음 토큰 분포를 모방하도록 훈련하며, 출력 공간에서 암묵적 보상을 외삽하여 교사를 능가하게 할 수 있다. 그러나 언어모델 헤드는 이 변화를 비등방적으로 감쇠시키며, 교사 은닉층에 인코딩된 대부분의 변화가 로짓에는 작은 가중치로만 도달하고, 출력 공간 외삽이 의존하는 샘플 토큰 로그확률 비율은 훈련 불안정성을 초래하는 노이즈를 증폭시킨다. 연구진은 강화학습이 모델의 내부 표현을 기본 체크포인트에서 변화시키고, 이 변화의 방향을 모든 층에서 측정할 수 있음을 관찰했다. 전체 요약 7문장 읽기 → 037 06:11 ▲ 287 · 댓글 5 강화학습으로 큰 언어모델 키우기, 작은 선생도 가능하다 강화학습이 대규모언어모델에 추론 능력을 부여할 수 있지만, 모델 크기가 다를 때 이 능력이 얼마나 전이되는지는 미명확했다. AI · 머신러닝 · Scaling Properties of Same-Family On-Policy Distillation
Key Point 작은 모델의 강화학습 능력이 훨씬 큰 모델로 효과적으로 전이될 수 있음을 보여주므로, 효율적인 LLM 훈련 방식을 모색하는 개발자와 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
강화학습이 대규모언어모델에 추론 능력을 부여할 수 있지만, 모델 크기가 다를 때 이 능력이 얼마나 전이되는지는 미명확했다. 연구팀은 정책 증류(on-policy distillation, OPD)의 스케일링 특성을 약한 선생-강한 학생, 같은 기반-다른 크기, 강한 선생-약한 학생 구조에서 분석했다. 초기 OPD 훈련 과정에서 일관되게 '유용한 전이(useful-transfer)' 단계가 나타나며, 이 구간에서 성능(gold score)은 학생의 KL 발산의 제곱근에 거의 선형으로 증가한다. 전체 요약 7문장 읽기 → 038 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 039 12:11 ▲ 25 · 댓글 1 학생 모델이 만든 문장을 선생 모델이 계속쓰며 학습 OLIVE(온라인 인터벤션)라는 온라인 언어 모델 증류 방법을 제시한다. AI · 머신러닝 · Learning from Teacher Continuations at Student States
Key Point 온라인 학습과 오프라인 증류의 한계를 동시에 해결하는 새로운 증류 방식이 기존 방법 대비 더 나은 성능을 달성하는 방법론을 제시하기 때문이다.
핵심 요약
OLIVE(온라인 인터벤션)라는 온라인 언어 모델 증류 방법을 제시한다. 각 반복 단계에서 학생 모델이 프리픽스를 생성하고, 선생 모델이 자동회귀로 이를 이어쓰며, 선생이 생성한 토큰에 대해 교차 엔트로피로 학생을 업데이트한다. 기존 증류 방법의 세 가지 제약을 해결한다: 고정된 선생 궤적으로 학습할 때의 순차적 공변량 시프트, 프리픽스 실패 시 단편적 감독, 선생의 토큰 확률값 접근 필요성. 전체 요약 8문장 읽기 → 040 03:11 ▲ 10 · 댓글 3 강화학습으로 LLM 정책 증류 효율성 높이기 논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. AI · 머신러닝 · An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
Key Point LLM 정책 증류의 표본 효율성을 강화학습 이론으로 획기적으로 개선한 방법론으로, 수학 추론 등 복잡한 작업에서 필요한 롤아웃을 대폭 줄일 수 있다.
핵심 요약
논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. 이를 바탕으로 최소제곱 정책 증류(LSPD) 프레임워크를 제안했으며, 값 기반 RL의 낙관적 탐색과 오프정책 데이터 재사용을 결합했다. LSPD는 탐색 중 정책 다양성을 유지하면서도 이전에 수집한 궤적을 반복 학습해 롤아웃 효율성을 개선한다. 전체 요약 6문장 읽기 → 041 15:11 ▲ 16 · 댓글 1 온폴리시 증류 붕괴 문제, 마지막 레이어 신호로 해결 온폴리시 증류(OPD)는 학생 모델이 생성한 응답을 교사 모델의 다음 토큰 분포로만 보정하기 때문에, 교사가 어떻게 생각하는지(잠재 상태)는 학습하지 못한다. AI · 머신러닝 · LastOPD: Taming Collapse in Latent On-Policy Distillation
Key Point 온폴리시 증류의 근본적인 붕괴 문제를 진단하고 해결한 방법론으로, 작은 모델의 효율적 학습에 직접 적용할 수 있는 실용적 개선안을 제시한다.
핵심 요약
온폴리시 증류(OPD)는 학생 모델이 생성한 응답을 교사 모델의 다음 토큰 분포로만 보정하기 때문에, 교사가 어떻게 생각하는지(잠재 상태)는 학습하지 못한다. 최신 방법인 OPRD는 학생의 잠재 상태를 교사의 잠재 상태에 정렬하는 신호를 추가하지만, 실제 실험에서 심각한 문제가 발생한다. Qwen3 모델 증류 시 초기 성능은 높았지만(MATH-500에서 25에서 46으로 올라감) 이후 10단계 후 성능이 11까지 급락하며 회복되지 않는 '조기 이득, 후기 붕괴' 현상이 나타났다. 전체 요약 7문장 읽기 → 042 15:11 ▲ 140 · 댓글 2 다중 전문가 모델 통합, 피드백 균형이 결정한다 강화학습으로 한 언어모델을 수학, 코딩, 지시 따르기 등 단일 분야에 특화된 여러 전문가 모델로 나눌 수 있지만, 사용자는 모든 능력을 갖춘 하나의 모델이 필요하다. AI · 머신러닝 · Beyond Teacher Assignment: Domain-Normalized Multi-Teacher On-Policy Distillation
Key Point 여러 전문 분야의 언어모델을 하나로 통합할 때 단순 라우팅만으로는 부족하며, 도메인별 피드백의 강도를 정규화해야 모든 능력을 균형 있게 갖춘 학생 모델을 만들 수 있다는 실증적 발견을 제시한다.
핵심 요약
강화학습으로 한 언어모델을 수학, 코딩, 지시 따르기 등 단일 분야에 특화된 여러 전문가 모델로 나눌 수 있지만, 사용자는 모든 능력을 갖춘 하나의 모델이 필요하다. 기존 다중교사 정책 내 증류(MOPD) 방식은 학생 모델이 각 프롬프트에 답하면 해당 분야의 전문가가 모든 토큰에 대해 피드백을 주도록 라우팅하는 방식으로 통합한다. Qwen 3.5 세 가지 크기에서 실험한 결과, MOPD 학생 모델은 최고의 단일 전문가 모델을 이기지 못했으며 수학 전문가의 장점을 거의 얻지 못했다. 전체 요약 8문장 읽기 → 043 21:11 당일 +279 Shadcn과 Vite로 만든 관리자 대시보드 UI 템플릿 Shadcn UI와 Vite로 구축한 관리자 대시보드 UI 컬렉션으로, 반응형 디자인과 접근성을 고려해 제작되었다. 웹 · 프론트엔드 · satnaing/shadcn-admin · TypeScript
Key Point Shadcn UI와 최신 개발 도구로 완성된 프로덕션 수준의 관리자 대시보드를 즉시 참고하거나 커스터마이즈할 수 있는 실제 사례를 원하는 개발자에게 필수적입니다.
핵심 요약
Shadcn UI와 Vite로 구축한 관리자 대시보드 UI 컬렉션으로, 반응형 디자인과 접근성을 고려해 제작되었다. 라이트/다크 모드, 반응형 레이아웃, RTL(오른쪽에서 왼쪽) 언어 지원, 사이드바, 검색 명령, 10개 이상의 페이지와 커스텀 컴포넌트를 포함한다. Shadcn UI 컴포넌트를 기반으로 하되, 일부 컴포넌트를 RTL 지원과 기타 개선을 위해 수정했다. 전체 요약 8문장 읽기 → 044 22:29 ▲ 47 · 댓글 4 현실 상호작용으로 배우는 공간 추론, VLM의 약점을 잡다 시각-언어 모델(VLM)이 물리 세계에서 행동하려면 동적 환경에서 물체의 움직임과 시점 변화로 인한 국지적 상태 전이를 감지하고 이를 장기 궤적에 걸쳐 통합해 공간 상태를 유지해야 한다. AI · 머신러닝 · Spatial-Interactor: Learning Spatial Reasoning through Interaction with the Observable Physical World
Key Point VLM이 로봇·자율주행·구체화 AI 등 현실 세계 상호작용이 필요한 분야에서 공간 추론 능력을 크게 제약받고 있으며, 상호작용 궤적이라는 자연스러운 감독 신호를 활용해 이를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
시각-언어 모델(VLM)이 물리 세계에서 행동하려면 동적 환경에서 물체의 움직임과 시점 변화로 인한 국지적 상태 전이를 감지하고 이를 장기 궤적에 걸쳐 통합해 공간 상태를 유지해야 한다. 기존 VLM 훈련은 객체 속성과 공간 관계의 정적 질문에 집중해 상태 전이에 대한 직접적 감독이 부족하지만, 상호작용 궤적은 선행 관찰·행동·후속 관찰을 자연스럽게 연결해 국지적 상태 전이에 대한 직접 감독을 제공한다. 연구진은 VLM이 상호작용을 통해 물리 세계의 상태 전이를 모델링하도록 훈련하는 Spatial-Interactor 프레임워크를 제안했으며, L1 수동적 세계 상태 전이, L2 능동적 자기 상태 전이, L3 장기 상호작용 궤적으로 구성된 3단계 커리큘럼으로 학습 과정을 조직화했다. 전체 요약 6문장 읽기 → 045 22:29 ▲ 16 · 댓글 3 토큰 단위 신용할당 원리로 LLM 강화학습 개선 강화학습 기반 LLM 후처리 훈련에서 토큰 단위 신용할당(credit assignment)의 수학적 정의가 명확하지 않아, 기존 훈련 신호들과의 관계가 불분명했다. AI · 머신러닝 · PACT: From Credit Assignment to Critic Alignment
Key Point 토큰 단위 신용할당의 수학적 정의를 처음 엄밀하게 규정하고, 이를 바탕으로 LLM 강화학습의 핵심 알고리즘들을 통일된 틀에서 설명하며, 실제 수학·소프트웨어 문제에서 기존 방법들을 크게 능가하는 구체적 성과를 냈다.
핵심 요약
강화학습 기반 LLM 후처리 훈련에서 토큰 단위 신용할당(credit assignment)의 수학적 정의가 명확하지 않아, 기존 훈련 신호들과의 관계가 불분명했다. Completeness, Prefix Consistency, Neutrality 세 가지 정칙성 조건을 제시하면 토큰 단위 신용할당이 유일하게 결정됨을 증명했다. 이 특성화를 통해 On-Policy Distillation(OPD)의 이상적 교사가 암묵적 비평가 역할을 하며, Response-level REINFORCE Leave-One-Out(RLOO)이 토큰 단위 신용할당과 일치하는 정책 기울기를 낸다는 것을 확인했다. 전체 요약 7문장 읽기 → 046 18:11 ▲ 12 · 댓글 2 교사 모델의 편차를 걸러내는 증류 기법 제안 On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. AI · 머신러닝 · Calibrating Teacher--Student Discrepancy for On-Policy Distillation
Key Point 학생 모델의 추론 능력을 효율적으로 높이는 데 불필요한 학습 신호를 제거하는 방식이 기존 기법보다 더 효과적임을 보여주기 때문입니다.
핵심 요약
On-policy distillation은 강한 교사 모델과 학생 모델의 토큰 수준 차이를 학습해 추론 성능을 높이지만, 이 차이에는 교사 모델 자체의 편차가 섞여 있다. 교사 모델의 자체 편차까지 학습하면 학생 모델의 성능이 저하되는데, 특히 특권 정보를 활용하는 경우 이 문제가 더 심해진다. 연구팀은 Cal-OPD 기법을 제안해 긍정·부정 개입을 통해 교사의 편차 영역을 추정하고, 이를 제외한 진정한 역량 차이만 학습하도록 한다. 전체 요약 4문장 읽기 → 047 12:11 ▲ 15 · 댓글 2 1% 토큰으로 충분할 수도, 그래디언트 추정의 효율성 학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. AI · 머신러닝 · 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
Key Point 효율적인 모델 학습을 위해 어떤 토큰에 교사 감독을 할당할지 결정하는 문제에서, 단순한 유용성 평가뿐 아니라 그래디언트 추정 안정성도 고려해야 한다는 실질적 통찰을 제시한다.
핵심 요약
학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. 다음 토큰 샘플링으로부터 계산한 그래디언트가 노이즈를 많이 포함할 수 있으며, 신호 대 잡음 분해를 기반으로 정보 효율성 비율(IER)을 제안했다. IER은 토큰 선택 과정에서 유용성 점수와 결합되어 기존 방식보다 그래디언트 추정 신뢰성을 높인다. 전체 요약 4문장 읽기 →