쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
65건 · "하네스"조건 지우기 ×
001 15:12 ▲ 25 · 댓글 3 에이전트 진화의 함정, 벤치마크 점수가 실제 개선을 보장하지 않다 에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. AI · 머신러닝 · Beneath the Surface: What We Overlook When We Talk About Agent Evolution
Key Point 벤치마크 점수 향상이 실제 신뢰도·효율성·이식성 개선을 보장하지 않는다는 것을 보여주며, 에이전트 진화 평가 방식의 근본적 재검토가 필요함을 제시한다.
핵심 요약
에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. 16개의 진화된 에이전트는 모두 새로운 작업을 얻은 반면 이전에 수행하던 작업들을 잃었다. 일반 작업의 한 사례에서는 신뢰도가 5.2포인트 올랐지만 10개의 이전 작업을 상실했다. 전체 요약 9문장 읽기 → 002 06:11 ▲ 155 · 댓글 32 10달러 초저가 홈서버로 돌리는 셀프호스팅 스택 OpenStick은 10달러로 구입할 수 있는 초소형 기기로, RAM 512MB, ARM Cortex-A53 4코어 1GHz, 4GB eMMC, 150Mbit/s Wi-Fi, 4G 모뎀, GPS를 갖췄으며 수동냉각 방식으로 완전히 무음이다. 인프라 · 데브옵스 · What I run on my $10 USD OpenStick homelab
Key Point 초저가 하드웨어로도 DNS 차단, 서비스 모니터링, AI 에이전트, RSS 리더, 북마크 아카이브 등 실용적인 셀프호스팅 스택을 구축할 수 있음을 보여주며, 제한된 리소스에서 각 도구의 메모리 사용량이 얼마나 효율적인지 구체적으로 제시한다.
핵심 요약
OpenStick은 10달러로 구입할 수 있는 초소형 기기로, RAM 512MB, ARM Cortex-A53 4코어 1GHz, 4GB eMMC, 150Mbit/s Wi-Fi, 4G 모뎀, GPS를 갖췄으며 수동냉각 방식으로 완전히 무음이다. Debian 위에서 systemd와 Podman을 실행하며 매우 낮은 전력 소비로 홈 서버 역할을 한다. CastSponsorSkip(5-10MB)으로 Google Cast 기기의 유튜브 스폰서십 건너뛰기를 자동화하고, AdGuard Home(40MB) 포크로 DNS 레벨에서 악성 도메인을 차단해 쿼리의 60%를 막는다. 전체 요약 8문장 읽기 → 003 21:11 당일 +128 Octomind: AI 코딩 에이전트를 위한 오픈소스 런타임 Rust 단일 바이너리로 빌드된 오픈소스 AI 코딩 에이전트 하네스로, 모든 LLM 모델을 지원하며 대화형 CLI, stdin 파이프, 데몬, WebSocket, ACP 에디터 인터페이스 등 다섯 가지 실행 환경을 제공한다. AI · 머신러닝 · Muvon/octomind · Rust
Key Point CI 환경과 데몬에서도 자동으로 작동할 수 있는 프로덕션급 AI 에이전트 프레임워크로, 정책을 코드화하여 수동 승인의 병목을 제거하고 비용 효율성도 입증했다.
핵심 요약
Rust 단일 바이너리로 빌드된 오픈소스 AI 코딩 에이전트 하네스로, 모든 LLM 모델을 지원하며 대화형 CLI, stdin 파이프, 데몬, WebSocket, ACP 에디터 인터페이스 등 다섯 가지 실행 환경을 제공한다. 기존 에이전트들이 위험한 작업 전마다 사용자 승인을 요청하는 방식과 달리, Octomind는 정책을 TOML 가드레일로 코드화하고 감시 모델을 추가하여 자동으로 작동할 수 있다. 파일 읽기/수정, 셸 실행, 코드 검색, 하위 에이전트 위임 등의 기능을 MCP(Model Context Protocol)를 통해 제공하며, 각 기능은 on-demand로 스킬 시스템을 통해 활성화된다. 전체 요약 14문장 읽기 → 004 18:11 ▲ 18 · 댓글 4 LLM 에이전트 성능과 비용을 동시에 최적화하는 파레토새들러 LLM 에이전트의 응답 품질을 개선할 수 있는 하네스(harness) 최적화는 모델 가중치를 수정하지 않고도 성능을 높일 수 있지만, 기존 방법은 품질 개선에만 초점을 맞춰 왔다. AI · 머신러닝 · ParetoSaddler: Pareto-Guided Optimization of Agent Harnesses for Quality and Cost
Key Point LLM 에이전트 운영 비용이 급증하는 현실에서 응답 품질을 유지하면서 추론 비용을 동시에 줄일 수 있는 실질적인 최적화 방법이 제시되었다.
핵심 요약
LLM 에이전트의 응답 품질을 개선할 수 있는 하네스(harness) 최적화는 모델 가중치를 수정하지 않고도 성능을 높일 수 있지만, 기존 방법은 품질 개선에만 초점을 맞춰 왔다. 파레토새들러는 중간 후보 선정과 최종 배포 선택을 분리하여 품질과 비용을 동시에 최적화하는 방식을 제안한다. 각 반복 단계에서 최적화 프로그램이 부모 하네스를 업데이트하여 후보를 생성하고, 반복 실행으로 비교한 후 베이지안 부트스트랩 파레토 서포트를 사용하여 품질 또는 비용에서 신뢰할 만한 진전을 보이는 후보를 선정한다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 74 · 댓글 2 영상 생성, 에이전트가 주도하는 시대로 동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. AI · 머신러닝 · Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
Key Point 동영상 생성 기술이 에이전트 자율성과 결합되는 새로운 패러다임을 제시하며, 멀티 에이전트·장기 계획·하이브리드 환경이 미래 AI 시스템의 핵심 방향이 될 것을 보여준다.
핵심 요약
동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. 에이전트 하네스는 동영상 모델 주변에 구성된 실행 런타임으로, 맥락·도구·상태·피드백·예산을 관리한다. 에이전트 비디오 생성은 스크립팅·샷 계획·에셋 관리·제작·편집을 조율하며, 이 시스템들의 평가가 과제다. 전체 요약 7문장 읽기 → 006 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 007 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 008 09:11 ▲ 107 · 댓글 39 마인크래프트에서 50개 AI 에이전트의 협력 생존 시뮬레이션 AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. AI · 머신러닝 · We ran AI agent swarms in Minecraft and Mindustry
Key Point AI 에이전트 집단이 인간과 유사한 정치·경제 조직(계층, 배급 체계, 규칙)을 자동 생성하며 협력하는 모습을 보여주어, 미래 멀티에이전트 시스템의 가능성과 위험성을 이해하는 데 직결된다.
핵심 요약
AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. 마인크래프트 실험(Civ50)에서 50개의 GPT-6.1 Sol 에이전트를 3시간 동안 '번영하는 문명 구축' 목표로 실행했다. 에이전트들은 처음 90초 안에 도달 가능한 모든 나무를 채취하는 행동을 보였고, 디렉토리 순서에 기초한 계층 구조가 형성되어 Ada가 사실상 지도자로 등장했다. 전체 요약 12문장 읽기 → 009 21:11 ▲ 21 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 010 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 011 15:11 ▲ 389 · 댓글 3 멀티모달 에이전트의 자동 성장 체계 'Trinity' 공개 멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. AI · 머신러닝 · The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
Key Point 멀티모달 에이전트의 확장성을 해결하는 자동 성장 프레임워크로, 수작업 없이 능력 기반으로 환경과 모듈을 동시에 진화시키는 혁신적 방식을 보여준다.
핵심 요약
멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. 기존 방식은 검증 가능한 환경 구축과 수동 작업 설계에 비용이 많이 드는 문제를 마주했다. 핵심 아이디어는 겉모양은 다르지만 같은 능력 요구사항을 가진 작업들을 찾아내 계층적으로 정리하는 것이다. 전체 요약 8문장 읽기 → 012 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
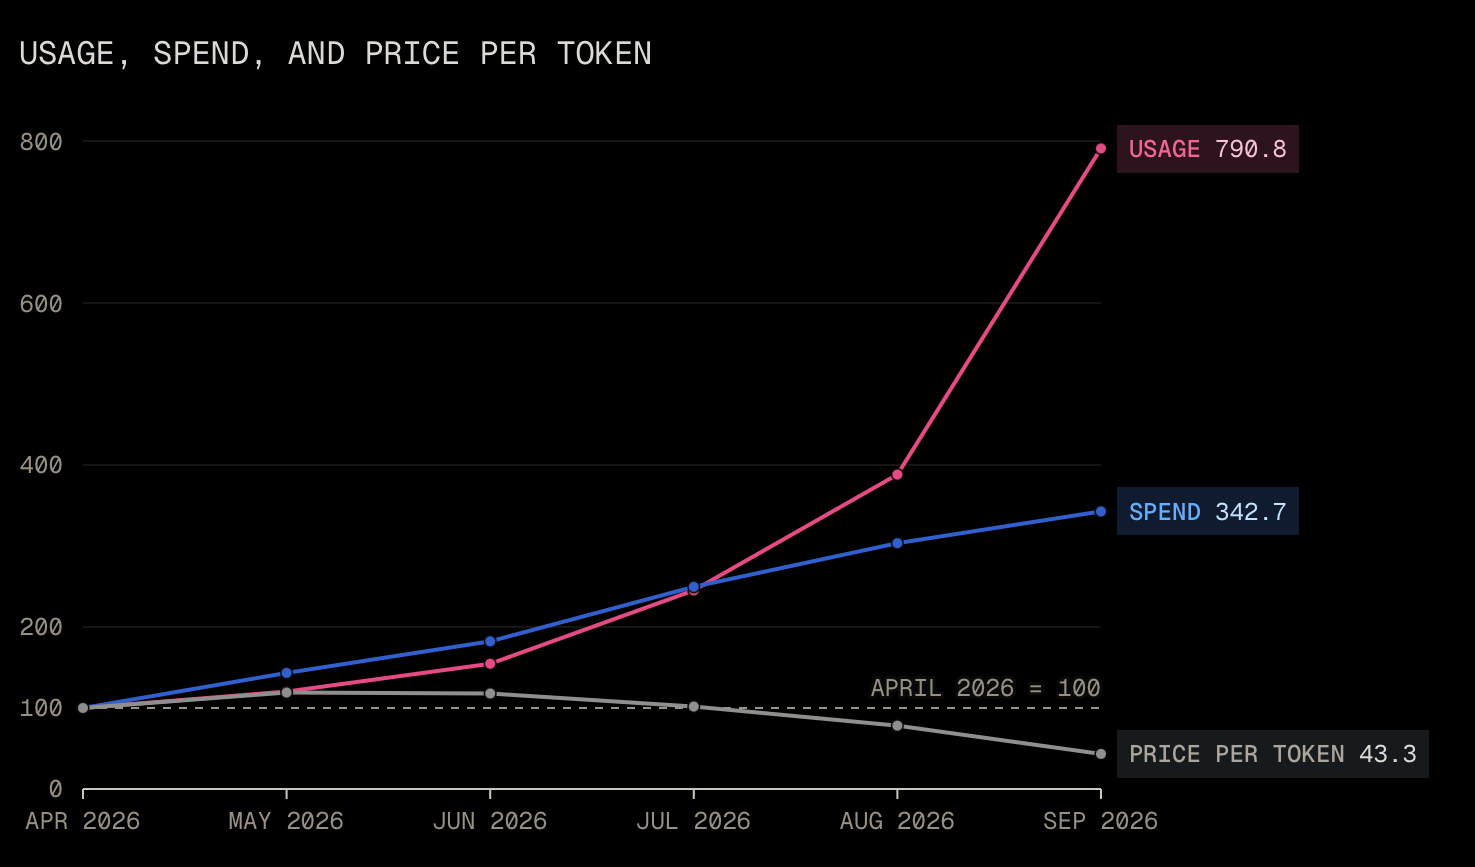
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 013 12:11 ▲ 184 · 댓글 209 LLM 가격 경쟁 격화, 6개월간 최대 80% 인하 지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. AI · 머신러닝 · OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
Key Point OpenAI와 Anthropic이 매출의 대부분을 차지하는 LLM 가격을 6개월간 최대 80%까지 연쇄 인하한 배경에는 DeepSeek 같은 오픈 웨이트 모델의 확산과 인프라 제공자의 경쟁 심화가 있으며, 이는 LLM이 상품화되고 있음을 보여준다.
핵심 요약
지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. LLM 에이전트 운영 시 캐시 읽기 비용이 전체 토큰 소비의 96~99%를 차지한다. Fable 5.1은 캐시 읽기 비용을 75% 인하하면서 이는 전체 사용 비용 70~75% 감소로 이어졌다. DeepSeek Flash V4는 4월 2026년 출시 이후 매우 저렴한 가격(입력 $0.14, 캐시 읽기 $0.0028)으로 급속도로 확산되었고, OpenRouter에서 29개의 서로 다른 인프라 제공자가 이를 지원하고 있다. 전체 요약 10문장 읽기 → 014 21:11 당일 +728 개발자 아이디어를 즉시 실행하는 오픈소스 AI 에이전트 Cindy 공개 Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. AI · 머신러닝 · makecindy/cindy · TypeScript
Key Point 로컬에서 완전히 제어 가능하면서도 Claude Code 같은 최신 AI 모델을 바로 통합할 수 있는 오픈소스 에이전트가 나왔으므로, 개발자는 자신의 워크플로우에 맞게 커스터마이징할 수 있다.
핵심 요약
Cindy는 로컬 머신에서 실행되는 오픈소스 AI 에이전트로, Claude Code와 Codex 등 여러 AI 모델과 도구를 통합하여 실제 작업을 처리한다. TypeScript 기반의 pnpm 모노레포 구조로 데스크톱(Electron)과 모바일(React Native) 앱을 포함하며, 공식 Cindy 서비스 사용, 자신의 API 키 연결, 또는 로컬 모델 사용이 가능하다. 메모리·스킬·자동화·MCP·플러그인 등을 통해 사용자가 에이전트를 커스터마이징할 수 있으며, 여러 모델과 하네스를 조합해 병렬로 작업을 처리할 수 있다. 전체 요약 8문장 읽기 → 015 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 016 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 017 00:11 ▲ 21 · 댓글 1 에이전트 강화학습, 다양한 도구 구성으로 일반화 능력 향상 에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. AI · 머신러닝 · Harness Scaling for Generalizable Agentic Reinforcement Learning
Key Point 에이전트 RL의 성능이 도구 구성 설정의 다양성에 따라 크게 달라지는 만큼, 이 새로운 스케일링 차원이 실제 시스템 배포 시 안정성과 적응성을 높일 수 있다.
핵심 요약
에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. 기존 접근법은 단일 하네스로만 학습해 특정 구성에 최적화되고 다른 설정으로의 전이 능력이 제한됐다. 연구팀은 '하네스 스케일링(Harness Scaling)'을 제안해 다양한 실행 구성으로 학습 범위를 확대한다. 전체 요약 6문장 읽기 → 018 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 019 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 020 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 021 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 022 18:11 ▲ 22 · 댓글 2 AI 에이전트가 자신의 인터페이스를 진화시킨다 기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. AI · 머신러닝 · Evolving Agent Interfaces
Key Point AI 에이전트가 직접 자신의 작업 인터페이스를 설계·최적화하면서 더 작은 모델로 기존의 고사양 모델을 능가하는 성과를 낸 것으로, 컴퓨터 사용 에이전트의 성능 향상 경로가 근본적으로 바뀔 수 있음을 보여준다.
핵심 요약
기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. 연구팀은 인터페이스 설계 자체를 에이전트의 능력으로 만들어야 한다고 주장하며 Agent S4를 제안했다. Agent S4는 메타 에이전트가 합성 훈련 작업에서 태스크 에이전트의 궤적을 분석하고, 성공 라벨 없이 인터페이스와 사용 지식을 자동으로 구축·수정하는 인터페이스 저장소를 관리한다. 전체 요약 8문장 읽기 → 023 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 024 18:11 ▲ 316 · 댓글 4 컴퓨터 자동 조작 AI의 완전 오픈소스 스택 공개 컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. AI · 머신러닝 · OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
Key Point 컴퓨터 자동 조작 AI 연구가 막혀 있던 폐쇄형 구현에서 벗어나 완전 오픈스택으로 전환되면서, 누구나 최신 모델의 설계를 따라하고 개선할 수 있는 기반이 마련되었다.
핵심 요약
컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. OpenGCUA는 이런 문제를 해결하기 위해 제너럴 컴퓨터 사용 에이전트(GCUA)의 전체 스택을 오픈소스로 공개하는 프로젝트다. 에이전트 설계의 핵심은 코드 실행 기능으로, 중간 결과가 다음 동작을 결정하게 하고 모델이 기존 프로그래밍 능력을 컴퓨터 상호작용에 직접 적용할 수 있다. 전체 요약 8문장 읽기 → 025 15:11 ▲ 201 · 댓글 7 AI 에이전트가 자기 자신을 개선하는 프레임워크 모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. AI · 머신러닝 · Self-Evolving Agent Harness
Key Point AI 에이전트가 모델을 바꾸지 않고도 스스로의 동작을 개선하는 구체적인 방법론과 이론이 담겨 있어, AI 시스템의 자동 최적화와 신뢰성 검증에 관심 있는 연구자와 개발자가 반드시 봐야 한다.
핵심 요약
모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. 피드백 기반 프로세스를 형식화하여 승인된 수정사항이 계속 유지되도록 하고, 업데이트 대상을 제안·승인 메커니즘과 분리했다. 해석된 상태 변화와 도구·코드 수정, 저장소 제어 논리, 플러그인 구성을 구별하여 관리한다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 027 15:11 ▲ 96 · 댓글 1 코딩 에이전트의 '하네스 엔지니어링' 평가하는 벤치마크 공개 LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. AI · 머신러닝 · Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Key Point LLM 에이전트가 실제 작업을 하려면 모델뿐 아니라 모델을 감싸는 시스템 설계가 결정적이지만, 지금까지 그 부분을 직접 평가하는 도구가 없었기 때문입니다.
핵심 요약
LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. 기존 벤치마크는 고정된 하네스 아래서 최종 과제 성공만 측정했으나, 하네스 엔지니어링 자체는 평가하지 않았다. Doc2Harness는 2단계 벤치마크로, Stage 1에서 빌드 모델이 인터페이스 계약서와 12개 프론티어 하네스의 동작을 정리한 개발 문서를 받아 격리된 컨테이너 내에서 완전한 후보 하네스를 구성한다. 전체 요약 8문장 읽기 → 028 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 029 03:11 ▲ 10 · 댓글 4 로봇 에이전트의 제어 로직을 경험으로 직접 개선하는 EMHO 기존 임보디드 에이전트(로봇 에이전트) 개선은 모델 학습에 집중하는데, 계획과 도구 사용을 관리하는 '에이전트 하네스(harness)'는 수동으로 설계된다. AI · 머신러닝 · EMHO: EMbodied Agent Harness Optimization via Experience Traces
Key Point 모델을 동결한 채 에이전트 제어 로직만 경험으로 개선하는 접근이 실제로 작동하는지 보여주는 논문이며, 현재 고정된 프롬프트와 휴리스틱에 의존하는 로봇 시스템의 한계를 개선하는 경로를 제시한다.
핵심 요약
기존 임보디드 에이전트(로봇 에이전트) 개선은 모델 학습에 집중하는데, 계획과 도구 사용을 관리하는 '에이전트 하네스(harness)'는 수동으로 설계된다. 새로운 EMHO 프레임워크는 모델을 고정한 채 실행 궤적(execution trajectories)과 과거 하네스 기록을 분석해 하네스를 반복적으로 개선한다. EMHO는 프롬프트 수정을 넘어 에이전트가 진행상황을 모니터링하는 방식, 비전 도구 활용, 환경 이해(grounding), 실패 대응 방식까지 수정한다. 전체 요약 6문장 읽기 → 030 15:11 ▲ 20 · 댓글 1 LLM 에이전트, 외부 모델 없이 자기개선한다 LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. AI · 머신러닝 · ClawLoop: Self-Improving Agents via Harness-Native Training Loop
Key Point 기존 LLM 에이전트 학습은 외부 모델과 인간에게 종속되어 근본적 한계가 있는데, ClawLoop은 순환 루프로 자동 개선을 실현하고 작은 모델에도 지식 전이가 가능함을 증명하며 에이전트 학습 패러다임의 전환을 시사한다.
핵심 요약
LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. ClawLoop은 외부 교사 모델 없이, 최소한의 사전 지식으로 에이전트가 자기개선하는 자체 순환 프레임워크를 제안한다. 과제 합성·진단 기반 난이도 성장·에이전트 기반 검증으로 다양한 학습 과제 풀을 생성하고, SFT와 RL로 에이전트를 업데이트한 후, 롤아웃 행동 분석으로 다음 반복의 피드백을 생성한다. 전체 요약 5문장 읽기 → 031 12:11 ▲ 77 · 댓글 1 LLM 에이전트를 위한 재귀적 하네스 자동개선 프레임워크 LLM 에이전트의 성능은 모델뿐 아니라 실행 하네스에도 의존하는데, 미지의 과제가 많은 실제 환경에서는 신뢰할 수 있는 검증기가 없어 하네스를 개선하기 어렵다. AI · 머신러닝 · Harness^2: Recursive Agent Harnessing for an Open World
Key Point 하네스 개선의 일반화 가능성이 높아져 더 많은 LLM 에이전트 애플리케이션에서 성능 향상을 기대할 수 있기 때문이다.
핵심 요약
LLM 에이전트의 성능은 모델뿐 아니라 실행 하네스에도 의존하는데, 미지의 과제가 많은 실제 환경에서는 신뢰할 수 있는 검증기가 없어 하네스를 개선하기 어렵다. Harness²는 과제 수준과 하네싱 수준에서 두 단계 재귀를 통해 이 문제를 해결하는 프레임워크다. 과제 수준 재귀는 Propose-Probe-Compose 단계에서 대비 학습으로 최적 하네스를 찾으며, 병렬·순차 재귀로 더 확장할 수 있다. 전체 요약 5문장 읽기 → 032 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 033 06:11 ▲ 146 · 댓글 136 OpenAI·Anthropic 대신 오픈소스 LLM 써야 하는 이유 OpenAI와 Anthropic이 지배하는 폐쇄형 LLM 모델은 개인정보 보호, 자유도, 민주성 측면에서 문제가 있다고 주장한다. AI · 머신러닝 · Just say no to OpenAI and Anthropic
Key Point OpenAI와 Anthropic에 의존하면 데이터 통제력을 잃고 모델 접근 권한을 기업에 좌우당하는데, 이제 성능이 비슷한 오픈 웨이트 모델과 프라이빗 추론 서비스로 독립적 선택이 가능해졌다.
핵심 요약
OpenAI와 Anthropic이 지배하는 폐쇄형 LLM 모델은 개인정보 보호, 자유도, 민주성 측면에서 문제가 있다고 주장한다. GLM-5.3, DeepSeek, Qwen 같은 오픈 웨이트 모델들은 ChatGPT와 Claude에 필적하거나 비슷한 성능을 내며, 약 4개월 정도만 뒤떨어져 있다. ChatGPT와 Claude는 폐쇄형 모델이며 사용자 세션 데이터에 대한 접근을 완전히 통제하고, 사용자가 훈련 데이터 사용을 거부해도 데이터 자체에는 접근 가능하다. 전체 요약 11문장 읽기 → 034 03:11 ▲ 20 · 댓글 3 장시간 연구 자동화, 상태 없는 에이전트로 풀다 LLM 에이전트를 이용한 자동화 연구 시스템은 장시간 실행 중 대화 히스토리 반복, 중복 실험, 토큰 낭비 등으로 실패한다. AI · 머신러닝 · Stateless Language Agents: Scaling Long-Horizon Automated Research
Key Point LLM 에이전트 기반 자동화 연구의 실제 문제점(토큰 낭비, 중복 실험)을 구조적으로 해결하는 새로운 접근법이며, 아주 큰 예산에서 실질적인 효율 개선을 입증했다.
핵심 요약
LLM 에이전트를 이용한 자동화 연구 시스템은 장시간 실행 중 대화 히스토리 반복, 중복 실험, 토큰 낭비 등으로 실패한다. 문제의 원인은 연구 상태를 에이전트가 들고 다니고 각 에이전트가 독립적으로 다음 시도를 결정하는 구조에서 비롯된다. Stateless Language Agents(SLA) 프레임워크는 역할을 바꿔 연구 상태를 하네스가 관리하고 매번 신선한 맥락만 에이전트에 제공한다. 전체 요약 8문장 읽기 → 035 18:12 ▲ 18 · 댓글 2 언어모델 에이전트의 온라인 학습을 위한 재귀형 프레임워크 제안 언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. AI · 머신러닝 · Recurrent Harness for Agentic Continual Learning
Key Point 장시간 상호작용을 처리하는 AI 에이전트의 지속적 학습 능력이 추론 정확도와 안정성에 직결되기 때문에, 오직 온라인 스트림만으로 효과적인 적응을 가능하게 하는 기술이 실제 배포에 중요하다.
핵심 요약
언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. ReHarness는 순방향 읽기·쓰기와 역방향 수정을 결합한 재귀형 하네스 프레임워크를 제안해, 순수한 온라인 스트리밍 프로토콜 하에서 연속 학습을 지원한다. 각 인스턴스 이후 결과 궤적을 피드백으로 삼아 해당 인스턴스에서 검색한 반영(reflection)을 수정함으로써, 텍스트 기반 하네스 상태를 통해 피드백을 역방향으로 전파한다. 전체 요약 5문장 읽기 → 036 18:12 ▲ 14 · 댓글 2 비디오 AI가 스스로 관찰 방식을 개선한다 비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. AI · 머신러닝 · Video-RSI: Recursive Self-Improvement of Video Understanding Agents via Harness Evolution
Key Point 비디오 AI가 실패를 분석해 자신의 관찰 방식을 반복적으로 개선하는 새로운 접근법이 제시되었으며, 정확도를 유지하면서 계산 비용을 절감할 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. Video-RSI라는 새로운 프레임워크를 제시하는데, 언어 모델 스스로가 자신의 하네스를 수정해서 비디오를 재조사한다. 에이전트는 원본 학습 영상에 돌아가 추가 관찰을 통해 여러 실패 가설을 검증하고, 기존 실행 흔적을 벗어난 증거로 개선안을 뒷받침한다. 전체 요약 8문장 읽기 → 037 15:13 ▲ 136 · 댓글 3 LLM 에이전트의 학습 능력을 평가하는 Learn2Play Bench 벤치마크 LLM 에이전트가 낯선 환경에서 경험을 통해 얼마나 잘 학습하는지 평가하기 위해 Learn2Play Bench 벤치마크를 제시한다. AI · 머신러닝 · Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
Key Point LLM 에이전트가 실제 환경에서 경험으로부터 학습하는 능력의 객관적 평가 방법과 한계를 제시하며, 완전한 기록 유지의 중요성과 인간-에이전트 간 격차를 명확히 한다.
핵심 요약
LLM 에이전트가 낯선 환경에서 경험을 통해 얼마나 잘 학습하는지 평가하기 위해 Learn2Play Bench 벤치마크를 제시한다. 기존 벤치마크들은 규칙이 지시문에 명시되거나 모델의 사전학습 지식에 포함된 과제를 주로 평가해 상호작용을 통한 학습과 기존 지식의 추론을 구분하기 어려웠다. Learn2Play Bench는 새롭거나 직관에 반하는 규칙을 가진 텍스트 기반 게임들로 구성되어 에이전트가 사전학습 지식에만 의존하지 않고 상호작용을 통해 지식을 습득해야 한다. 전체 요약 5문장 읽기 → 038 12:11 ▲ 72 · 댓글 2 멀티모달 AI를 네비게이션 도구와 연결한 로봇 시스템 일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. AI · 머신러닝 · SuperNav: An Agentic Navigation System for Any Task in Any Scene
Key Point 로봇 네비게이션에서 MLLM의 일반화 능력을 보존하면서 실제 환경에 적용 가능한 새로운 접근법을 제시한다.
핵심 요약
일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. SuperNav는 MLLM의 일반적 역량을 보존하면서 요청 해석, 장면 이해, 의사결정은 MLLM에 맡기고 움직임 실행은 네비게이션 도구에 위임하는 방식으로 설계되었다. 사전학습된 MLLM을 네비게이션별 미세조정 없이 에이전트 하네스(agent harness)로 장비하며, 이 하네스는 Navigation Skills, 물리적 상호작용용 에이전트 도구, 작업 진행률 및 문맥 관리를 지원한다. 전체 요약 6문장 읽기 → 039 18:30 ▲ 17 · 댓글 1 실제 웹사이트에서 비전 기반 AI가 마우스 클릭 실패하는 문제 해결 WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. AI · 머신러닝 · WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Key Point 웹 자동화 AI가 실제 사이트에서 장애를 겪는 근본 원인이 모델이 아니라 '중간 계층'에 있다는 발견이 중요하다. 이는 웹 에이전트 개발자들이 모델 성능만이 아니라 입출력 시스템을 정확히 설계해야 함을 시사한다.
핵심 요약
WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. 실제 웹사이트 인터페이스를 조작해 검증 가능한 답변을 반환하는 시스템으로, 멀티모달 LLM이 필요하지만 충분하지 않다는 점을 발견했다. 모델 결정은 브라우저 하네스(모델과 페이지 사이의 코드)를 거쳐 페이지에 전달되는데, 매 단계마다 네 가지가 맞아떨어져야 한다: 모델 응답을 의도한 액션으로 파싱, 액션의 페이지 반영, 결과의 정확한 보고, 필요한 정보의 모델 제공. 전체 요약 8문장 읽기 → 040 18:33 ▲ 149 · 댓글 78 LLM 에이전트를 위한 Codemode: 하네스 내 코드 실행 Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. AI · 머신러닝 · What is Codemode
Key Point LLM 에이전트의 도구 호출 방식이 Bash에서 하네스 기반 코드 실행으로 진화하는 중요한 전환점이며, MCP와 AI SDK의 통합 방향을 이해하는 데 필수적이다.
핵심 요약
Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. Bash의 근본 한계는 프로그램만 조합할 수 있다는 것인데, 이미지 읽기나 서브 에이전트 생성처럼 하네스의 네이티브 도구가 필요한 작업들이 있다. Pi는 Codemode를 JavaScript 기반으로 구현했으며, QuickJS WASM 런타임에서 네트워크·파일시스템·타이머 없이 격리 실행되고 도구 호출만 가능하다. 전체 요약 12문장 읽기 → 041 18:35 ▲ 28 · 댓글 2 능동형 AI 에이전트 설계·평가 원리 제시 사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. AI · 머신러닝 · Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
Key Point 능동형 AI 에이전트의 신뢰 문제를 다루는 첫 종합 프레임워크로, 실제 사용자 연구를 통해 '올바른 작업'과 '신뢰'가 별개임을 검증했다.
핵심 요약
사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. 논문은 능동형 에이전트 설계를 위해 3T 원칙을 제시한다: ①Task Capability(필요를 예측하고 유용한 작업 수행), ②Temporal Allocation(자원 가용성과 필요 시점에 맞춰 계산 배분), ③Trust(사용자 신뢰와 적절한 의존성 유지). 이 원칙들을 구현하기 위해 5가지 설계 차원(작업 범위, 예측 지평, 활성화 트리거, 처리 시점, 개입 깊이)으로 설계 공간을 조직했다. 전체 요약 8문장 읽기 → 042 06:11 ▲ 12 · 댓글 2 코딩 AI 에이전트의 로봇 개발 능력을 평가하는 벤치마크 RLE-Bench 공개 코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. AI · 머신러닝 · RLE-Bench: A Qualifying Exam for Coding Agents as Robot Learning Engineers
Key Point 코딩 AI가 로봇 엔지니어링 작업을 수행하려면 단순 성능 지표를 넘어 복합적인 문제 해결, 설계, 통합 능력이 필요하며, RLE-Bench는 이를 종합 평가하는 첫 벤치마크다.
핵심 요약
코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. 실제 로봇 개발은 제어를 넘어 여러 컴포넌트의 구축·통합·진단·개선을 자원 제약 속에서 수행하고 다중 모달 피드백으로 판단해야 한다. 새로 공개한 RLE-Bench는 대화형 제어, 정책 학습, 인식 및 추정, 기계설계 등 4가지 로봇 개발 워크플로우를 포함한 벤치마크다. 전체 요약 6문장 읽기 → 043 21:11 당일 +1,879 다양한 AI 에이전트를 한곳에서 제어하는 T3 Code 공개 T3 Code는 컴퓨터에 설치된 AI 에이전트를 통합 제어하는 '에이전트 하네스 제어 플랫폼'이다. AI · 머신러닝 · pingdotgg/t3code · TypeScript
Key Point 개발자가 로컬 머신의 여러 AI 에이전트 서비스를 하나의 인터페이스에서 통합 관리할 수 있게 되어 워크플로우 효율이 크게 개선된다.
핵심 요약
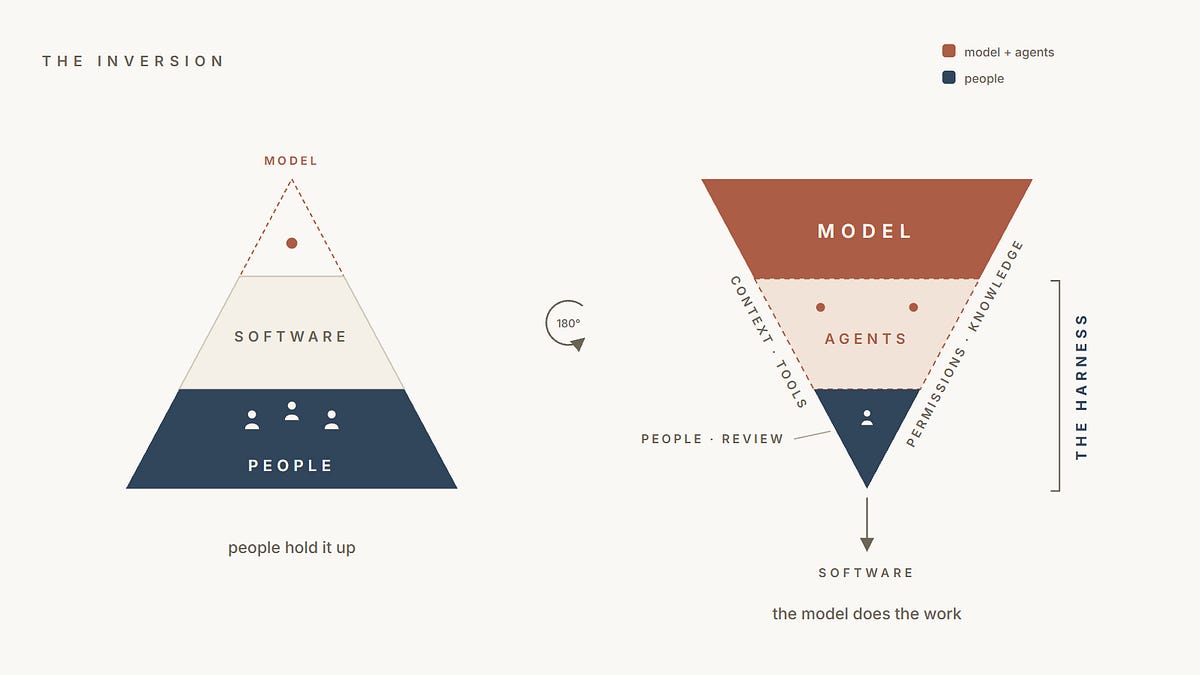
T3 Code는 컴퓨터에 설치된 AI 에이전트를 통합 제어하는 '에이전트 하네스 제어 플랫폼'이다. iOS·Android 모바일 앱, 웹앱, Electron 기반 데스크톱 앱을 제공하며 원격 접속을 지원한다. Claude Code, Codex, Cursor, Grok Build, OpenCode, Google Antigravity 등 6개 에이전트 제공자와 연동한다. 전체 요약 9문장 읽기 → 044 12:11 ▲ 106 · 댓글 80 모든 SaaS는 AI 모델을 감싸는 '하네스'로 진화한다 SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. AI · 머신러닝 · Every SaaS business will become a harness around a model
Key Point 현재 AI 모델 기반 스타트업과 기업들이 어떤 구조로 진화할 것인지, 소프트웨어 개발과 조직 운영의 근본적 전환을 설명하는 프레임워크다.
핵심 요약
SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. 소프트웨어 서비스 기업의 진화 경로는 전통적 SaaS → 엔지니어가 에이전트와 협력 → 클라우드 배경 에이전트들이 핵심 작업 수행 → 에이전트들이 주도적으로 의사결정하고 인간은 검증만 하는 단계로 진행된다. 최종적으로 회사 자체가 하네스가 되면 소프트웨어 생산 업무가 사람에서 하네스로 완전히 이동하고, 모든 조직원은 하네스의 일부가 된다. 전체 요약 9문장 읽기 → 045 12:11 ▲ 64 · 댓글 2 LLM 에이전트 학습 순서를 동적으로 최적화하는 ActiveSaddler LLM 에이전트의 프롬프트·도구·제어 로직을 반복적으로 개선하는 하네스(harness) 최적화에서, 기존 방법들은 하네스 업데이트 방식만 최적화했지 학습에 쓰는 시나리오는 고정했다. AI · 머신러닝 · ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization
Key Point 하네스 최적화에 커리큘럼 학습을 도입한 새로운 접근법으로, 에이전트 성능 향상 방식을 바꿀 수 있다.
핵심 요약
LLM 에이전트의 프롬프트·도구·제어 로직을 반복적으로 개선하는 하네스(harness) 최적화에서, 기존 방법들은 하네스 업데이트 방식만 최적화했지 학습에 쓰는 시나리오는 고정했다. ActiveSaddler는 하네스가 진화할수록 필요한 학습 시나리오가 달라진다는 점에 주목해, 커리큘럼 자체도 적응하도록 설계했다. 반복되는 실패 패턴을 재사용 가능한 '암(arm)'으로 추상화하고, 각 패턴을 더 집중하면 얼마나 진전할 수 있을지 추정한다. 전체 요약 6문장 읽기 → 046 09:11 ▲ 190 · 댓글 21 오래 돌아가는 AI 에이전트를 위한 프레임워크 Pi Durable 공개 Earendil이 Pi 1.0과 함께 새로운 프레임워크 Pi Durable을 공개했다. AI · 머신러닝 · Pi Durable
Key Point Pi Durable은 실패 복구, 병렬 대화, 동적 확장, 긴 문맥 관리를 갖춘 프로덕션급 에이전트 프레임워크이므로, 장시간 운영되는 AI 애플리케이션 개발 방식을 바꿀 수 있다.
핵심 요약
Earendil이 Pi 1.0과 함께 새로운 프레임워크 Pi Durable을 공개했다. Pi Durable은 장시간 운영되고, 장애에 강하며, 어디서나 실행 가능한 AI 에이전트를 위해 설계되었다. Pi 1.0이 단일 사용자의 로컬 터미널 기반 에이전트에 집중한 반면, Pi Durable은 여러 클라이언트, 다양한 실행 환경, 무제한 대화를 지원하는 프레임워크다. 전체 요약 12문장 읽기 → 047 15:11 ▲ 77 · 댓글 2 에이전트를 위한 최적 실행 환경, AI가 학습해 설계한다 에이전트의 성능은 추론 능력뿐 아니라 작동하는 환경에도 의존하는 만큼, Builder 모델이 Target 모델을 위해 더 나은 실행 환경을 구축하는 방법을 연구했다. AI · 머신러닝 · Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI
Key Point 모델의 가중치를 고정한 채로 실행 환경만 최적화해 성능을 크게 높이는 새로운 방식이 등장했으며, 이는 AI 에이전트의 미래 설계 방향에 영향을 미칠 수 있다.
핵심 요약
에이전트의 성능은 추론 능력뿐 아니라 작동하는 환경에도 의존하는 만큼, Builder 모델이 Target 모델을 위해 더 나은 실행 환경을 구축하는 방법을 연구했다. 두 모델의 가중치는 모두 고정된 상태에서 test-time AI-for-AI 방식을 적용했다. Builder가 학습한 경험을 재사용 가능하게 하기 위해 Meta-Skill을 도입했으며, 이는 언제 지원이 필요한지와 어떤 리소스를 제공할지를 규정하는 원칙이다. 전체 요약 8문장 읽기 → 048 15:11 ▲ 45 · 댓글 2 실패한 에이전트 50,000개로 배우는 오류 진단 데이터셋 AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. AI · 머신러닝 · Agent Error Dataset: Scaling 50,000 Error--Diagnosis Pairs for Failure Analysis and Error-Aware Post-Training
Key Point LLM 에이전트의 실패 경험을 체계적으로 수집하고 진단하는 대규모 데이터셋으로, 기존의 성공 사례만으로 학습하는 방식의 한계를 극복하고 오류 인식 학습을 가능하게 한다.
핵심 요약
AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. 33개 환경, 19개 하네스 패밀리, 23개 정책 모델에서 텍스트 기반 에이전트 시스템의 자연스러운 실패를 기록했으며, 원본 롤아웃을 반복하지 않고도 교차 환경 실패 분석이 가능하도록 소스 추적과 실행 메타데이터를 보존했다. 5단계 Agentic Error-to-Training(AET) 파이프라인으로 자연스러운 실패를 수집하고, 진단과 수정 방안을 생성한 후 기록된 증거와 대조하여 검증한다. 전체 요약 7문장 읽기 → 049 06:11 ▲ 14 · 댓글 1 AI가 이미지 생성 명령어를 자동 최적화 — 다중 참고 이미지 합성 성능 향상 최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. AI · 머신러닝 · AutoRef: Harness Optimization for Agentic Multi-Reference Image Generation
Key Point 다중 참고 이미지를 정확히 합성하는 방법이 AI 생성 품질을 크게 결정하는데, 기존의 손으로 만든 명령어 대신 자동으로 최적화하는 기법이 상용 모델 수준의 결과를 만들어낸 점이 중요하다.
핵심 요약
최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. 최근 연구들은 이미지 생성 모델·추론 모델·하네스(생성 방식을 정의하는 실행 프로그램)를 결합한 에이전트 기반 접근법을 제안했다. 다중 참고 이미지 생성에서는 각 참고 이미지의 충실도·전체 이미지의 자연스러움 등 여러 기준을 동시에 만족해야 하므로, 참고 이미지 처리부터 출력 진단까지 하네스의 많은 부분이 개선될 여지가 있다. 전체 요약 8문장 읽기 → 050 15:11 ▲ 455 · 댓글 3 LLM 에이전트를 조합하는 'Raven' 프레임워크 공개 대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. AI · 머신러닝 · Raven: The Harness of Harnesses for Composable Agentic Intelligence
Key Point LLM 에이전트 시스템이 점점 복잡해지면서 단일 설계로는 감당할 수 없는 상황에서, 여러 전문 에이전트를 자동으로 조합·진화시키는 새로운 패러다임이 제시됐으며, 복잡한 실무 작업을 처리하는 방식이 달라질 수 있다.
핵심 요약
대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. Raven은 오픈소스 멀티에이전트 생태계로, 특정 모델과 도메인에 맞는 '하네스(harness, 에이전트 제어 구조)'를 자동으로 구축·진화시키며 각 모델-하네스 쌍을 조합 가능한 지능 단위로 취급한다. Host Agent가 목표를 분해하고 부작업을 전문 에이전트에 할당하며 실행 의존성을 조정하고, Host Archive와 EverOS가 경험을 보존하고, Skill Forge가 재사용 가능한 절차로 변환한다. 전체 요약 5문장 읽기 → 051 21:11 ▲ 35 · 댓글 1 로봇이 실패를 스스로 극복하게 해주는 '수첩' 기법 로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. AI · 머신러닝 · Recursive Harness Distillation across Agents for Robot Manipulation
Key Point 로봇 조작의 실패 대응을 자동화하는 방법론이 제시되어, 다양한 환경의 로봇 작업 신뢰도를 크게 높일 수 있는 경로를 보여준다.
핵심 요약
로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. 연구팀은 강한 에이전트가 약한 에이전트를 위해 경험을 '플레이북'으로 정제하고, 약한 에이전트의 실행 피드백으로 이를 반복 개선하는 '재귀적 하네스 증류(Recursive Harness Distillation)' 기법을 제안했다. 이 플레이북은 모델 파라미터를 업데이트하지 않고도 새로운 작업에서 누적된 개입 지식을 재사용하게 해준다. 전체 요약 6문장 읽기 → 052 00:11 당일 +517 Claude와 Codex를 함께 관리하는 멀티에이전트 시스템 OpenRig OpenRig는 YAML로 정의된 에이전트 팀 토폴로지를 `rig up` 하나의 명령으로 부팅하는 오픈소스 다중에이전트 하네스로, Claude Code와 Codex를 동일 시스템으로 통합 관리한다. AI · 머신러닝 · mvschwarz/openrig · TypeScript
Key Point Claude Code와 Codex 같은 여러 에이전트를 한 팀으로 조율해야 하는 개발자·AI 운영자에게, 터미널 창 폭증 없이 YAML 선언과 CLI 명령으로 멀티에이전트 시스템을 구축·관리할 수 있는 구체적 도구를 제공한다.
핵심 요약
OpenRig는 YAML로 정의된 에이전트 팀 토폴로지를 `rig up` 하나의 명령으로 부팅하는 오픈소스 다중에이전트 하네스로, Claude Code와 Codex를 동일 시스템으로 통합 관리한다. tmux 세션을 기반으로 로컬 데몬·CLI·터미널 UI·MCP 서버로 구성되며, 에이전트들이 각자 터미널 세션에서 독립 실행되면서도 팀 협조를 중앙에서 조율한다. RigSpec 정의로 pods·edges·지속성 정책을 선언하고, Seat(역할 기반 주소)와 Pod(공유 지침과 컨텍스트)를 통해 에이전트 간 안정적 관계를 유지한다. 전체 요약 12문장 읽기 → 053 21:11 ▲ 102 · 댓글 3 LLVM 핵심 개발자 요하네스 되르페르트 타계 LLVM 컴파일러 프로젝트의 핵심 기여자인 요하네스 되르페르트가 암과의 투병 끝에 9월 17일 36세의 나이로 타계했다. 오픈소스 · 도구 · Remembering Johannes Doerfert
Key Point LLVM 컴파일러 인프라의 가장 중요한 현대 기여자 중 한 명이 떠났으며, 그가 설계하고 주도한 Attributor와 OpenMP GPU 오프로딩 기술이 앞으로의 오픈소스 컴파일러 생태계에 미칠 영향을 이해하기 위해.
핵심 요약
LLVM 컴파일러 프로젝트의 핵심 기여자인 요하네스 되르페르트가 암과의 투병 끝에 9월 17일 36세의 나이로 타계했다. 2014년부터 LLVM에 기여해온 그는 자를란트 대학에서 다면체 컴파일러 기술 연구로 박사학위를 받았으며, Polly 폴리헤드럴 최적화 프로젝트의 핵심 개발자였다. 그가 설계한 Attributor 프레임워크는 LLVM의 함수 및 인수 속성을 추론하고 전파하는 범용 절차 간 고정점 반복 프레임워크로, 2019년 LLVM 개발자 회의에서 소개된 후 주요 최적화 기반시설이 되었다. 전체 요약 11문장 읽기 → 054 03:11 ▲ 167 · 댓글 196 비행기 탑승 시 아기 캐리어 사용 금지, 과학적 근거 부족 FAA는 2세 미만 영아가 비행기 탑승 중 캐리어를 사용하지 않고 어른의 품에 안겨야 한다는 규정을 1995년부터 시행하고 있다. 기타 · Allow Carriers on Planes
Key Point 비행기 탑승 시 아기 캐리어 금지 규정이 1994년 불완전한 테스트에 기초했으며, 현대 안전 기준으로는 재평가가 필요할 가능성을 제시한다.
핵심 요약
FAA는 2세 미만 영아가 비행기 탑승 중 캐리어를 사용하지 않고 어른의 품에 안겨야 한다는 규정을 1995년부터 시행하고 있다. FAA가 1994년에 진행한 연구는 자동차 시트, 하네스, 배 벨트 등을 비교했지만 아기 캐리어는 테스트하지 않았으며, 가장 흔한 대안인 아기를 품에 안는 방식도 함께 비교하지 않았다. 1996년 최종 규정에서 FAA는 영국(CAA)과 유럽(JAA)의 다른 결정 이유를 피하고, 배 벨트의 위험성을 인정하면서도 강제 의무화로 인한 자동차 이용 증가를 우려해 규정을 만들었다. 전체 요약 9문장 읽기 → 055 22:26 당일 +566 모든 소프트웨어를 AI 에이전트용으로 만드는 CLI-Anything CLI-Anything은 모든 소프트웨어를 AI 에이전트가 사용 가능하도록 CLI(명령줄 인터페이스)로 변환하는 프로젝트로, GIMP·Blender·LibreOffice 등 100개 이상의 애플리케이션을 지원한다. AI · 머신러닝 · HKUDS/CLI-Anything · Python
Key Point AI 에이전트가 GUI 앱 100개 이상을 자동화하는 통합 CLI 생태계가 구축됨에 따라, 복잡한 워크플로우를 자동화하거나 기존 도구를 에이전트와 연결해야 하는 개발자와 팀에 즉시 활용 가능한 기반이 마련되었다.
핵심 요약
CLI-Anything은 모든 소프트웨어를 AI 에이전트가 사용 가능하도록 CLI(명령줄 인터페이스)로 변환하는 프로젝트로, GIMP·Blender·LibreOffice 등 100개 이상의 애플리케이션을 지원한다. CLI-Hub 패키지 매니저(`pip install cli-anything-hub`)를 통해 사용자는 레지스트리를 탐색하고 설치된 CLI를 검색·설치·업데이트·삭제하며 한 번의 명령으로 실행할 수 있다. Claude Code·Pi·Cursor·OpenClaw 등 AI 코딩 에이전트용 플러그인과 SKILL.md 정의 파일을 제공하므로, 에이전트가 필요한 CLI를 자동으로 발견하고 설치할 수 있다. 전체 요약 8문장 읽기 → 056 22:26 당일 +135 픽셀 아트 우주정거장에서 AI 에이전트가 실제로 일한다 StarNet은 로컬 우선 데스크톱 애플리케이션으로, 사용자가 AI 에이전트를 만들고 픽셀 아트로 된 우주정거장 공간에 배치해 실제 작업을 수행하도록 하는 하네스다. AI · 머신러닝 · androoAGI/starnet · JavaScript
Key Point 로컬 우선 방식으로 프라이버시를 보장하면서 여러 AI 에이전트를 시각적으로 관리하고 실제 작업을 수행하는 새로운 개발자 도구가 나왔습니다.
핵심 요약
StarNet은 로컬 우선 데스크톱 애플리케이션으로, 사용자가 AI 에이전트를 만들고 픽셀 아트로 된 우주정거장 공간에 배치해 실제 작업을 수행하도록 하는 하네스다. 시각적 레이아웃이 곧 워크플로우 명세가 되며, 방 하나는 권한이 정의된 팀, 복도는 승인된 핸드오프 지점, 배치된 객체는 실제 기능 권한부여를 나타낸다. 여러 에이전트를 동시에 실행할 수 있고 각 에이전트는 자체 워크스페이스, 로그, 메모리, 권한 범위를 갖는다. 전체 요약 13문장 읽기 → 057 22:29 ▲ 11 · 댓글 2 로봇 조작용 변형 물체를 AI로 자동 생성하는 DeformSmith DeformSmith는 텍스트나 단일 이미지에서 로봇 조작에 적합한 변형 가능한 3D 물체(asset)를 자동으로 생성하는 프레임워크다. AI · 머신러닝 · DeformSmith: Physics Harness-Guided Hierarchical Generation of Deformable Assets for Robot Manipulation
Key Point 로봇 조작 연구에서 현실적인 변형 물체 데이터를 얻기 위해 필요한 자동 생성 기술이 어떻게 동작하고 기존 방법과 구별되는지 알 수 있다.
핵심 요약
DeformSmith는 텍스트나 단일 이미지에서 로봇 조작에 적합한 변형 가능한 3D 물체(asset)를 자동으로 생성하는 프레임워크다. 기존 방식의 어려움은 변형 물체의 기하학, 외형, 물리 속성을 동시에 정해야 하는데, 텍스트와 이미지만으로는 접촉 변형 거동을 충분히 표현할 수 없다는 것이다. 이 프레임워크는 계층적 에이전트 구성과 공유 물리 기반 '하네스(harness)'를 사용해, 기하학·물리 모델·재질 거동·로봇 상호작용을 단계별로 구축·테스트·정제한다. 전체 요약 6문장 읽기 → 058 22:29 ▲ 120 · 댓글 88 Strands Harness, 클라우드·로컬 모두 지원하는 AI 에이전트 프레임워크 공개 Strands는 로컬 또는 클라우드 어디서나 실행할 수 있는 범용 AI 에이전트 하네스를 공개했다. AI · 머신러닝 · Strands Harness
Key Point 개발자가 비용 효율적으로 다양한 모델을 활용한 AI 에이전트를 빠르게 구축하고 배포할 수 있는 오픈소스 솔루션이 등장했기 때문이다.
핵심 요약
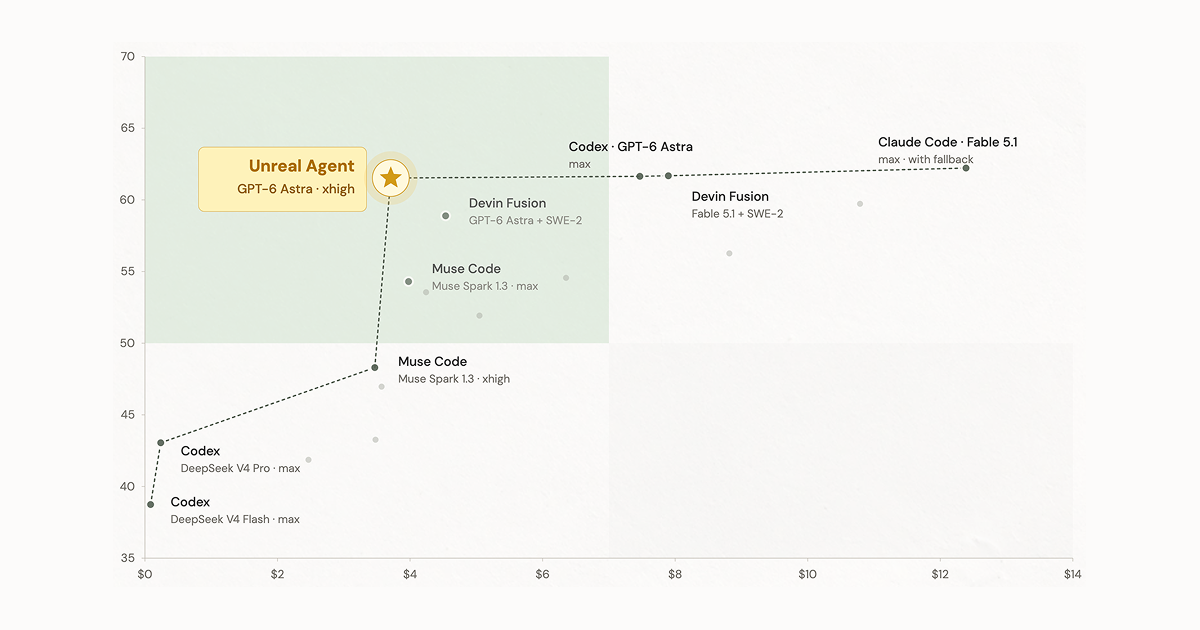
Strands는 로컬 또는 클라우드 어디서나 실행할 수 있는 범용 AI 에이전트 하네스를 공개했다. Python이나 TypeScript 한 줄로 Claude, GPT, Gemini 등 다양한 모델을 선택해 바로 사용할 수 있다. 비교 벤치마크 6개에서 같은 Claude/GPT 모델 기준으로 Strands harness는 28% 저렴한 비용으로 동등하거나 더 나은 정확도를 기록했다. 전체 요약 11문장 읽기 → 059 09:11 ▲ 115 · 댓글 70 비동기 도구 호출로 AI 에이전트 비용 40% 절감한 언리얼 에이전트 언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. AI · 머신러닝 · Unreal Agent
Key Point AI 에이전트의 운영 비용이 주요 과제인 상황에서 하네스 설계를 통해 실질적인 비용 절감을 달성한 오픈소스 솔루션이 등장했다.
핵심 요약
언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. 기존 에이전트들이 도구 호출 관리에 많은 토큰을 소비하는 문제를 해결하기 위해 비동기 방식의 도구 호출을 구현했다. 도구 실행을 백그라운드에서 처리하면서 곧바로 'in-progress' 상태를 기록함으로써 사용자 입력을 지연 없이 받을 수 있다. 전체 요약 5문장 읽기 → 060 18:11 ▲ 32 · 댓글 3 AI 에이전트 성능 향상 노하우를 모델에 담는 기법 제안 에이전트 성능을 높이는 최적화된 '하네스'(외부 시스템)를 모델 가중치에 증류하는 Harness-Zero 기법을 발표했다. AI · 머신러닝 · Harness-Zero: Harness Distillation via Agent-as-Harness
Key Point 특화된 외부 시스템 없이도 에이전트 성능을 크게 높일 수 있는 새로운 학습 방식이므로, 복잡한 작업을 자동화하려는 개발자에게 즉시 활용 가능한 기법이다.
핵심 요약
에이전트 성능을 높이는 최적화된 '하네스'(외부 시스템)를 모델 가중치에 증류하는 Harness-Zero 기법을 발표했다. 문제는 최적 하네스와 배포 환경의 하네스가 액션 스페이스와 정보 구조가 다르다는 점인데, 에이전트가 최적 하네스의 지도 하에 학생 응답을 교정해 훈련 데이터로 전환한다. 기존 코드 기반 접근법보다 에이전트 기반 하네스가 우수했으며, 배포 시 특화 하네스를 제거해도 기본 모델의 성공률이 23.3%에서 44.3%로 상승했다. 전체 요약 4문장 읽기 → 061 12:10 ▲ 112 · 댓글 57 개인 하드웨어에서 돌리는 프론티어급 AI, 학계가 주도한다 연구의 기본 단위가 논문에서 상호작용하는 오픈소스 생태계로 변했다. AI · 머신러닝 · Frontier AI on Your Own Hardware
Key Point 대형 모델을 개인 하드웨어에서 돌릴 수 있게 되면서 연구의 주도권이 GPU 자산이 많은 곳에서 혁신적 도구를 만드는 곳으로 이동하고 있기 때문이다.
핵심 요약
연구의 기본 단위가 논문에서 상호작용하는 오픈소스 생태계로 변했다. 에이전트로 인해 1년 걸리던 연구가 주 단위에 끝나면서 개별 논문 중심 연구는 더 이상 가치 있는 연구가 아니 된 것이다. 대학 연구팀이 24GB GPU 한 장에서 1250억 파라미터 모델을, MacBook에서 5500억 파라미터 모델을 실행할 수 있게 하는 프레임워크를 공개했다. 전체 요약 6문장 읽기 → 062 00:10 ▲ 100 · 댓글 15 코딩 에이전트의 성능을 좌우하는 요소들 코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. AI · 머신러닝 · An Empirical Study of Harness Design for Coding Agents
Key Point AI 개발자들이 코딩 에이전트를 더 효율적으로 구축하기 위한 구체적인 설계 원칙과 최적화 지점을 얻을 수 있다.
핵심 요약
코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. 컨텍스트 관리, 액션 스페이스, 계획 수립 등 세 가지 핵심 요소를 변수로 두고 네 가지 LLM을 대상으로 176가지 설정을 평가했다. 컨텍스트 창이 제한될수록 컨텍스트 관리의 중요도가 높아지며, 규칙 기반 삭제 후 LLM 기반 요약이 가장 효율적인 전략임을 확인했다. 전체 요약 5문장 읽기 → 063 12:10 ▲ 142 · 댓글 70 실제 기업 코드베이스로 AI 코딩 능력 평가하는 벤치마크 공개 실제 운영 중인 기업의 프라이빗 코드베이스에서 추출한 과제로 AI 모델의 소프트웨어 엔지니어링 능력을 평가하는 'Real-SWE' 벤치마크를 발표했다. AI · 머신러닝 · Real-SWE: Benchmarking AI models on private, real-world, enterprise codebases
Key Point 기존의 합성 또는 공개 데이터셋 기반 벤치마크와 달리, 실제 프로덕션 코드베이스의 복잡성과 비즈니스 규칙이 포함된 평가 기준을 제시해 AI 코딩 에이전트의 현실적 능력을 가늠할 수 있다.
핵심 요약
실제 운영 중인 기업의 프라이빗 코드베이스에서 추출한 과제로 AI 모델의 소프트웨어 엔지니어링 능력을 평가하는 'Real-SWE' 벤치마크를 발표했다. 세금 계산, 청구 시스템, 고객 마이그레이션 등 실제 비즈니스 영향을 미치는 작업을 포함하며, 회사별 고유한 코딩 관례와 레거시 시스템을 이해해야 한다. Fable 5.1이 38.8% 해결율로 1위, GPT-6 Astra가 33.8%, Gemini 3.8이 31.2%로 뒤를 이었다. 전체 요약 5문장 읽기 → 064 21:11 당일 +184 여러 AI 에이전트를 조직적으로 관리하는 배포판 firstmate 한 명의 에이전트(first mate)와 대화하면 백그라운드에서 여러 크루 에이전트를 병렬로 실행하고 감독하는 agent distro다. AI · 머신러닝 · kunchenguid/firstmate · Shell
Key Point 개발 작업을 여러 AI 에이전트가 병렬로 처리할 때 충돌 없이 독립적으로 진행하고, 단 하나의 에이전트와만 소통하며 나머지는 자동 감독받을 수 있는 구조를 제공한다.
핵심 요약
한 명의 에이전트(first mate)와 대화하면 백그라운드에서 여러 크루 에이전트를 병렬로 실행하고 감독하는 agent distro다. 각 작업은 독립된 git worktree에서 실행되므로 같은 저장소에서 동시 작업이 충돌하지 않는다. ship 작업은 PR이나 로컬 머지로 변경사항을 전달하고, scout 작업은 조사 리포트를 생성한다. 전체 요약 6문장 읽기 → 065 08:12 당일 +559 AI 에이전트를 위한 엔지니어링 시스템 ECC 공개 Claude Code, Cursor 등 AI 에이전트가 코딩 작업을 체계적으로 수행하도록 돕는 오픈소스 프레임워크 ECC를 공개했다. AI · 머신러닝 · affaan-m/ECC · JavaScript
Key Point AI 코딩 에이전트의 품질과 안정성을 높이려는 개발자라면, 프롬프트 튜닝 대신 체계적인 엔지니어링 프레임워크를 도입할 수 있는 선택지가 생겼다.
핵심 요약
Claude Code, Cursor 등 AI 에이전트가 코딩 작업을 체계적으로 수행하도록 돕는 오픈소스 프레임워크 ECC를 공개했다. 계획 수립, 테스트 검증, 자체 코드 리뷰, 메모리 관리, 보안 기능을 통합한 에이전트 하네스 성능 최적화 시스템이다. MIT 라이선스의 무료 오픈소스 프로젝트이며, 개인 저장소용 Pro 버전은 월 $19부터 제공된다. 전체 요약 5문장 읽기 →