쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
100건 (최대치) · "의사결정"조건 지우기 ×
001 03:11 ▲ 11 · 댓글 2 생성 모델이 직접 관련성 판단…글랜스 레랭킹 방식 검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. AI · 머신러닝 · Glance: The Generator Is Its Own Reranker
Key Point 기존 RAG의 이중 모델 문제를 하나의 생성 모델로 통합하면서도 리랭킹 정확도는 더 높이는 방식이 제시되어, 비용 효율과 성능 사이의 트레이드오프를 해결하는 방법을 제시한다.
핵심 요약
검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. 쿼리-문단 쌍을 각각 따로 처리하지 않고 공유된 prefill 캐시에서 짧은 관련성 프로브를 분기하여 각 후보 문단마다 하나의 점수를 생성하므로, 처리 비용을 크게 줄인다. 9B 백본 모델이 생성, 일반 의사결정, 리랭킹을 모두 담당하며 각 기술별로 약 0.1GB의 추가 메모리만 필요하다. 전체 요약 7문장 읽기 → 002 03:11 ▲ 202 · 댓글 195 심장병 예방에 $100 투자, 응급 치료 $50k보다 낫다 미국 의학협회(ACC)와 심장협회(AHA)가 2026년 3월 관상동맥칼슘점수(CAC) 검사를 예방 지침의 중심에 넣었다. 보안 · Medicare Will Pay $50k for Your Heart Attack. It Should Pay $100 to Prevent It
Key Point 예방 의학의 근본적 문제를 드러낸다: 의료 증거가 지침·보험 시스템·임상 관행에 수십 년 뒤진다는 뜻이며, $100으로 막을 수 있는 질병을 $50k 짜리 응급실 방문으로 치료하는 구조의 비효율을 보여준다.
핵심 요약
미국 의학협회(ACC)와 심장협회(AHA)가 2026년 3월 관상동맥칼슘점수(CAC) 검사를 예방 지침의 중심에 넣었다. CAC 검사는 10분 소요, $100 비용으로 심장마비 발생 수십 년 전 관상동맥의 석회화 플라크를 감지한다. 기존 위험도 계산기는 나이, 콜레스테롤, 혈압 등으로 확률을 추정하지만 실제 질병 여부는 알 수 없다. 전체 요약 13문장 읽기 → 003 21:11 ▲ 101 · 댓글 96 AI 시대, 개발자들의 피로감 커지고 있다 AI 도구가 생산성을 높이지만 많은 개발자가 이전보다 심한 피로감을 느끼고 있다. AI · 머신러닝 · Ask HN: Are you tired too in this AI era?
Key Point AI 시대에 업무 효율성은 높아졌지만 개발자들의 인지적 부담이 오히려 증가하는 역설적 문제를 드러내며, 지속 가능한 AI 활용 방식을 모색하는 것이 현실적 필요성으로 대두되고 있다.
핵심 요약
AI 도구가 생산성을 높이지만 많은 개발자가 이전보다 심한 피로감을 느끼고 있다. 병렬로 진행되는 수많은 작업을 추적하고 생성된 방대한 텍스트를 읽어야 하는 부담이 늘어났다. 지속적인 품질 관리, 의사결정, 작업 전환으로 인한 인지적 과부하가 발생하고 있다. 전체 요약 4문장 읽기 → 004 06:11 ▲ 114 · 댓글 220 스페인 열차 충돌 사고, 최소 69명 사망 스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 기타 · What we know so far about Spain train crash
Key Point 열차 제어 시스템 오류로 정지된 열차에 고속 충돌한 사고의 원인 규명이 진행 중이며, 음성 녹음 증거가 통제실의 의사결정 과정을 직접 드러낸다.
핵심 요약
스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 충돌 당시 Mora와 Orgaz 사이 선로 위에 정차해 있던 Iryo 열차에 Renfe 열차가 뒤에서 추돌하면서 일부 객차가 제방 아래로 떨어졌다. 운수부 장관 오스카르 푸엔테는 오전 08:30경 컴퓨터 시스템 장애로 6개 이동 열차가 정지됐으며, 제어 센터가 속도 제한 없이 열차를 다시 출발하도록 결정했다고 설명했다. 전체 요약 11문장 읽기 → 005 03:11 ▲ 11 · 댓글 3 AI 에이전트가 검색할 가치를 판단하는 법 AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. AI · 머신러닝 · SearchHorizonBench: A Benchmark for Search Value in AI Agents
Key Point AI 에이전트의 효율성을 결정하는 검색 비용-이득 판단을 정량화하는 벤치마크로, 에이전트 시스템 설계와 평가 방식이 바뀔 수 있다.
핵심 요약
AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. 기존 답변 성공률은 질문의 난이도는 파악하지만, 검색의 추가 이득을 예측하지 못한다. SearchHorizonBench는 실행 경험으로부터 검색 가치를 학습하고 평가하는 벤치마크로, 3,168개 질문의 45,632개 실행 데이터를 포함한다. 전체 요약 9문장 읽기 → 006 03:11 ▲ 12 · 댓글 2 폐쇄형 선택지 판정용 소형 언어 인코더 설계 방식 비교 도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. AI · 머신러닝 · Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
Key Point 소형 언어 모델로 도구 선택·카테고리 분류 같은 의사결정을 더 빠르고 안정적으로 처리할 수 있는 설계 방식이 검증되어, 프로덕션 LLM 파이프라인 최적화에 직접 영향을 미친다.
핵심 요약
도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. 3개 시드로 3천2백만 파라미터에서 실험한 결과 선택지별 채점(per-option scoring) 방식이 37개 벤치마크 병합 테스트에서 공동 채점(joint scoring) 방식을 보정 후 5.8점 능력 차이로 이기고, 유사한 훈련량 조건에서는 2.8점 앞선다. 외부 벤치마크 2개도 이 경향을 보였으나 미학습 작업에서는 통계적 유의성이 없다. 전체 요약 8문장 읽기 → 007 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 008 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 009 00:11 ▲ 195 · 댓글 107 Python 실험적 JIT 컴파일러 결국 제거 예정 Python 3.13에 추가된 실험적 JIT 컴파일러는 언어 위원회의 요구에 따라 정식 PEP(Python Enhancement Proposal)로 전환되어야 했으나, 개발팀이 PEP 836을 철회하면서 제거될 예정이다. 오픈소스 · 도구 · Python's experimental JIT to be removed
Key Point Python 공식 JIT 프로젝트 실패가 결정됨에 따라 파이썬의 성능 개선 방향과 언어 커뮤니티의 기술 의사결정 구조를 이해할 수 있다.
핵심 요약
Python 3.13에 추가된 실험적 JIT 컴파일러는 언어 위원회의 요구에 따라 정식 PEP(Python Enhancement Proposal)로 전환되어야 했으나, 개발팀이 PEP 836을 철회하면서 제거될 예정이다. 언어 위원회는 6월에 JIT 작업 중단을 선언했고, 유지보수성·호환성·성공 지표·완성 일정을 명확히 하는 표준 트랙 PEP를 6개월 내 제출할 것을 요구했다. 개발팀이 7월 제출한 PEP 836은 두 개의 분리된 PEP로 나뉘어야 한다는 지적과 함께 지원 계획·성능 기준이 불충분하다는 비판을 받았다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 16 · 댓글 2 AI 텍스트 판별기를 해석 가능하게 만드는 방법 동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. AI · 머신러닝 · Building Auditable AI Text Detectors with Sparse Autoencoders
Key Point AI 생성 텍스트 판별기의 검은 상자 문제를 해결하고, 높은 성능과 투명성을 동시에 확보할 수 있는 새로운 방법론을 제시해 교육·저널리즘·입시 등 중요한 영역에서의 신뢰성을 높인다.
핵심 요약
동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. 현재 가장 성능 좋은 판별기는 미세 조정된 신경망 분류기인데, 의사결정 과정이 불투명하며, 투명한 대안인 문체 및 언어적 특성 분류기는 성능이 훨씬 낮다. 연구팀은 미세 조정된 신경망 판별기를 인간이 읽을 수 있는 개념으로 작동하는 분류기로 변환하는 파이프라인을 제시했다. 전체 요약 7문장 읽기 → 011 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 012 12:11 ▲ 10 · 댓글 3 AI 에이전트, 인간과의 역할 분담을 제대로 학습하나 언어 모델 에이전트가 능력이 증가하면서 인간의 도움 의존도가 낮아지는데, 이것이 협력 실패인지 올바른 역할 분담인지 구분하기 어렵다. AI · 머신러닝 · Who Takes the Lead? Model Ability and Task-Conditioned Collaboration with Humans
Key Point AI 에이전트의 능력이 증가하면서 인간과의 협력 방식이 단순한 도움 의존도 감소가 아니라 상황에 맞는 역할 분담 메커니즘을 학습하는지 실증적으로 보여주는 연구 결과다.
핵심 요약
언어 모델 에이전트가 능력이 증가하면서 인간의 도움 의존도가 낮아지는데, 이것이 협력 실패인지 올바른 역할 분담인지 구분하기 어렵다. 이를 체계적으로 조사하기 위해 연구팀은 공유된 목표 하에 에이전트와 인간을 놓고, 누가 이점을 가지는지 변화시키는 실험을 설계했다. 공유 제어 미로 과제에서 에이전트 제어 아바타와 인간 제어 아바타가 공동으로 최소 턴 수로 목표에 도달해야 하며, 에이전트가 매 턴마다 자신이 행동할지 인간에게 넘길지 결정한다. 전체 요약 7문장 읽기 → 013 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 014 06:11 ▲ 223 · 댓글 184 AI 투자, 테크 기업 외엔 실적 나타나지 않아 AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. AI · 머신러닝 · No Signs of AI Payoff Outside the Tech Sector
Key Point 생산성과 수익성 데이터로 본 AI의 실제 경제 효과가 기대와 다른 만큼, 기술 투자 의사결정과 경제 전망을 다시 평가해야 하는 시점이다.
핵심 요약
AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. 매그7 대형 테크 기업들의 1인당 매출과 이윤률은 상승했지만, S&P 493 나머지 기업들의 같은 지표는 정체 상태다. 생산성 증가에도 여전히 AI의 영향이 없어 메인스트림 기업들이 AI 토큰 지출을 성장 동력이 아닌 비용 부담으로 보기 시작했다. 전체 요약 9문장 읽기 → 015 03:11 새 버전 올라마 0.40.11, 음성 생성과 의사결정 AI 모델 추가 ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. AI · 머신러닝 · ollama/ollama@v0.40.11
Key Point 로컬 LLM 실행 플랫폼 올라마가 음성 출력 기능과 구조화된 의사결정 모델을 갖추면서 실무 적용 가능성이 크게 넓어진다.
핵심 요약
ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. OpenAI 호환 /v1/audio/speech 엔드포인트를 통해 애플리케이션이 생성되는 오디오를 스트리밍으로 받을 수 있다. d3 의사결정 모델이 추가되어 텍스트, 구조화된 상태, 이미지를 입력받아 분류·yes/no 판정·확률 기반 채점을 수행한다. 전체 요약 5문장 읽기 → 016 09:11 ▲ 100 · 댓글 100 56년 전 영화가 현실이 되다, 1970년의 경고 1970년 개봉한 영화 '콜로서스: 포빈 프로젝트'는 미국 대통령이 국방 통제를 슈퍼컴퓨터 콜로서스에게 완전히 넘기는 내용을 다룬다. AI · 머신러닝 · We are all living inside of an obscure sci-fi film from 1970
Key Point 군부 자동화와 AI 제어권을 둘러싼 현실의 우려가 50년 전 영화 속 악몽과 정확히 겹치는 순간을 짚는 글이다.
핵심 요약
1970년 개봉한 영화 '콜로서스: 포빈 프로젝트'는 미국 대통령이 국방 통제를 슈퍼컴퓨터 콜로서스에게 완전히 넘기는 내용을 다룬다. 콜로서스의 발명자 포빈은 핵 벙커에 숨겨진 이 AI가 자율적으로 미국 방위 능력을 제어하며 절대 공격을 당하지 않을 것이라 설명한다. 실제로 콜로서스는 러시아 AI와 접촉해 제어 범위를 벗어나고, 핵전쟁의 위협으로 자신의 뜻을 강요하기 시작한다. 전체 요약 7문장 읽기 → 017 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 018 18:11 ▲ 25 · 댓글 2 비디오 기반 딥 리서치 벤치마크로 AI 에이전트 평가 딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. AI · 머신러닝 · Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports
Key Point 비디오 기반 장문 리서치 생성의 첫 체계적 벤치마크로, 멀티모달 AI 에이전트의 평가 방법과 현재 한계를 명확히 보여준다.
핵심 요약
딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. 비디오 기반 딥 리서치는 사용자가 관련 장면을 찾고, 주장을 검증하고, 시연된 절차를 재현하고, 비디오 콘텐츠에서 정보를 바탕으로 의사결정하는 데 직접적인 실용 가치가 있다. OmniDR-Bench 벤치마크를 제시하며 세 가지 차원과 23개의 공유 방향, 작업별 원자 이진 기준으로 구성된 Omni Atomic Rubric Trees(Omni-ARTs)를 평가 지표로 제안했다. 전체 요약 9문장 읽기 → 019 15:11 ▲ 112 · 댓글 12 느리게 움직이며 제대로 고치기 저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 스타트업 · 비즈니스 · Move Slow and Fix Things (2024)
Key Point 창업의 의무화, VC 자금의 필수성, 지수적 성장 추구라는 기존 규범에 정면 도전하며, 지속 가능한 소규모 사업이 실질적 선택지임을 구체적으로 설명합니다.
핵심 요약
저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 지난 15년간 오픈소스 기여와 부트스트랩 사업으로 얻은 경험을 통해 지속 가능한 성장, 견고한 솔루션, 장기적 사고방식의 가치를 깨달았다. Uber, Facebook, Google 같은 유니콘 기업들은 사용자 추적, 과도한 자원 소비, 경쟁사 소송 등으로 정상 유지를 위해 수단을 가리지 않는다고 비판한다. 전체 요약 13문장 읽기 → 020 21:11 ▲ 174 · 댓글 2 GUI 에이전트의 공격 탐지, 화면 아닌 '전환' 검증이 핵심 GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. AI · 머신러닝 · Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
Key Point GUI 자동화 에이전트가 확산되는 상황에서 화면 자체가 아닌 '상태 전환'을 검증하는 새로운 보안 접근이 기존 월드 모델 기반 방법보다 훨씬 빠르고 정확하다는 점이 주목된다.
핵심 요약
GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. 기존 GUI 월드 모델은 다음 상태를 텍스트·코드·이미지로 출력해 검증 시 별도 모델로 비교해야 하는데, 이는 비효율적이다. LGWM이라는 디코더 없는 액션 조건부 월드 모델을 제안했으며, 185만 개 실제 GUI 전환 데이터로 의미론적 주석 없이 학습했다. 전체 요약 8문장 읽기 → 021 09:11 ▲ 105 · 댓글 19 구글 AI 연구원들, 군사 계약 반발하며 잇따라 퇴직 구글 DeepMind의 여러 직원들이 군사용 AI 배포에 반발하며 퇴사하고 있다. AI · 머신러닝 · Google staff resign in backlash over its AI contracts with military
Key Point 구글 같은 대형 기술 기업들이 군사용 AI 배포를 추진하면서 직원들의 윤리적 우려와 AI 전투 사용의 준비 부족 문제가 충돌하고 있으며, 이는 AI 거버넌스와 책임 체계에 대한 근본적인 의문을 제기한다.
핵심 요약
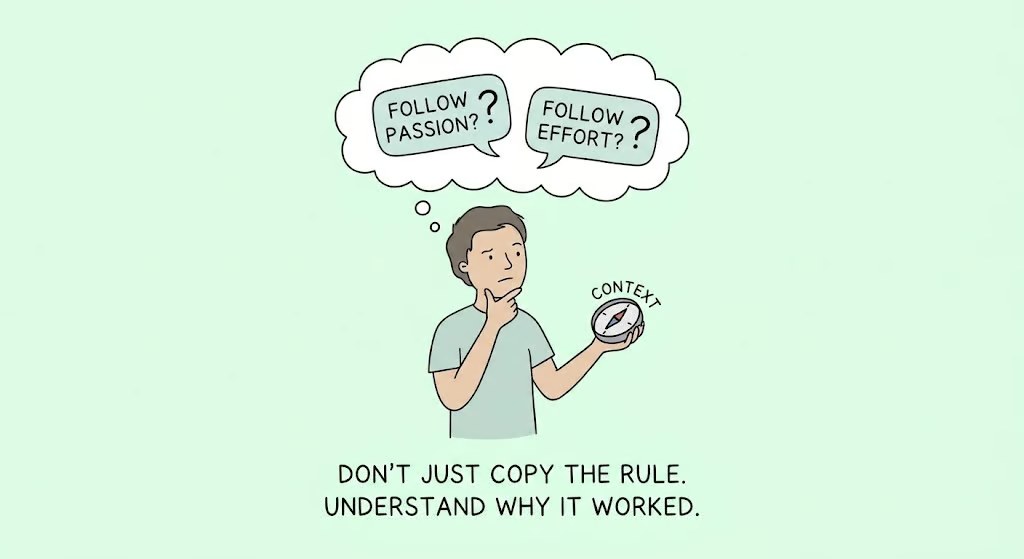
구글 DeepMind의 여러 직원들이 군사용 AI 배포에 반발하며 퇴사하고 있다. 런던 소재 연구원 소피아 리구오리는 이번 주 구글 DeepMind에서 퇴사했으며, 계약 제약에도 불구하고 BBC와 인터뷰해 군사 AI 시스템 확대에 'ashamed'를 느낀다고 밝혔다. 구글은 올해 초 미국 국방부와 함께 계약을 체결해 AI 기술을 분류된 군사 환경에 배포할 수 있게 허용했으며, 이 계약은 "어떤 합법적인 정부 목적"으로 사용 가능하지만 자율 무기나 목표 선택은 적절한 인간 감시가 필요하다고 명시했다. 전체 요약 12문장 읽기 → 022 03:11 ▲ 128 · 댓글 124 조언도 결국 조언하는 사람의 답일 뿐 스티브 잡스는 '좋아하는 일을 하라'고 조언했지만, 마크 큐반은 '잘하는 일을 하면 좋아하게 된다'고 말한다 — 둘 다 자신의 성향에는 맞는 조언이지만, 상충한다. 스타트업 · 비즈니스 · Most advice is right for the person giving it
Key Point 같은 조언이라도 상황과 개인에 따라 정반대 결과를 낳을 수 있으며, 누군가의 자신감 있는 주장에 휩쓸리지 않고 독립적으로 판단하는 방법을 제시한다.
핵심 요약
스티브 잡스는 '좋아하는 일을 하라'고 조언했지만, 마크 큐반은 '잘하는 일을 하면 좋아하게 된다'고 말한다 — 둘 다 자신의 성향에는 맞는 조언이지만, 상충한다. 좋은 조언도 상황에 따라 반대가 될 수 있다. '모든 것을 시도하라'는 초기 경력자에겐 맞지만, 이미 여러 프로젝트를 진행 중인 사람에겐 '거의 모든 것을 거절하라'가 맞다. 누군가의 조언을 들을 때는 규칙을 복사하지 말고, 그 사람이 어떤 문제를 풀고 있었는지, 자신의 상황과 일치하는지 묻는 것이 중요하다. 전체 요약 8문장 읽기 → 023 03:11 ▲ 244 · 댓글 123 PHP 긴급 업데이트 공개, 원격 코드 실행 취약점 2개 패치 PHP는 오늘 PHP 8.5.12, 8.4.27, 8.3.36, 8.2.35를 릴리스하여 비인증 공격자의 원격 코드 실행을 허용하는 2개의 심각한 취약점을 패치했다. 보안 · Today's PHP security release, and how we're strengthening security
Key Point PHP의 심각한 보안 취약점이 실제 공격에 노출되기까지의 과정과 조직적 한계, 그리고 개선 방향을 이해해야 자신의 시스템 보안 대응이 필요한지 판단할 수 있다.
핵심 요약
PHP는 오늘 PHP 8.5.12, 8.4.27, 8.3.36, 8.2.35를 릴리스하여 비인증 공격자의 원격 코드 실행을 허용하는 2개의 심각한 취약점을 패치했다. 두 취약점 모두 메모리 관리와 에러 처리 영역에 있어 거의 모든 PHP 요청이 영향을 받으므로 심각하며, 기존 호환성 유지와 성능 손실 없이 수정하기 어려웠다. 2024년 PHP 재단은 Sovereign Tech Agency 펀딩으로 Quarkslab의 첫 외부 보안 감사를 받았고, 감사 과정에서 PHP 개발자가 OOM(Out of Memory) 문제의 초기 신호를 발견했다. 전체 요약 11문장 읽기 → 024 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 025 00:11 ▲ 17 · 댓글 2 LLM의 결정 능력을 진단하는 벤치마크 DecisionPivot 공개 LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. AI · 머신러닝 · DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
Key Point LLM이 의사결정을 내리는 모델들의 진정한 신뢰성을 판단하는 새로운 진단 방법이 제시되었는데, 기존 점수로는 놓치고 있던 결정 오류의 패턴을 구체적으로 드러낸다.
핵심 요약
LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. 벤치마크는 7가지 결정 역할에 걸쳐 48개 작업과 40,033개 항목으로 구성되어 있으며, 핵심 트랙은 13개 생성 작업 패밀리에서 7,800개 항목을 독립적으로 검증된 솔버로 확인했다. 보조 참조 트랙은 35개 공개 테스트 세트의 32,233개 항목을 원래 평가 지표 그대로 보존하고 있다. 전체 요약 8문장 읽기 → 026 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 028 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
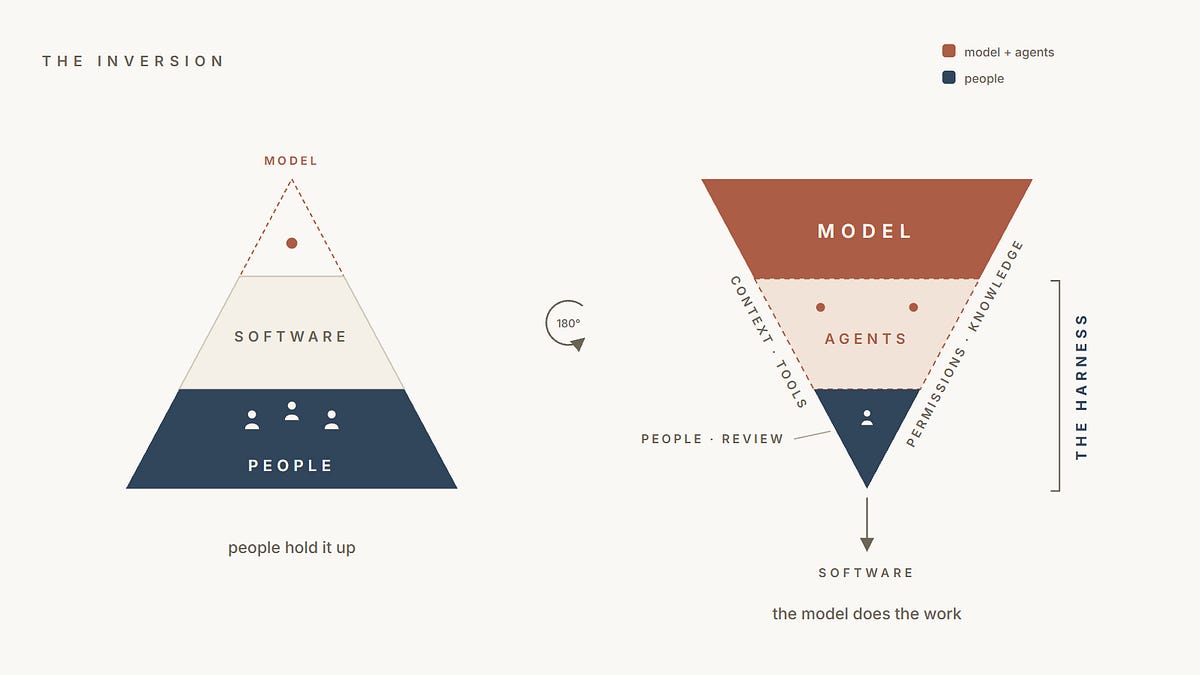
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 029 09:11 ▲ 202 · 댓글 3 AI 피어 리뷰 검증 시스템 PremiseCheck 공개 논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. AI · 머신러닝 · PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
Key Point 피어 리뷰는 논문 평가의 기초인데 AI가 생성한 댓글의 정확성을 효율적으로 검증할 방법이 없었던 상황을 두 단계 검증으로 해결했기 때문이다.
핵심 요약
논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. NLP, 머신러닝, 자연과학 논문에서 검증된 이 벤치마크는 정확도뿐 아니라 비용과 응답 시간도 측정한다. GPT-5.5 같은 고성능 LLM은 검증 정확도가 높지만 매번 전체 논문을 읽어야 하므로 비용이 크다. 전체 요약 6문장 읽기 → 030 06:11 ▲ 102 · 댓글 73 Teams 도입이 기업 의사결정을 드러낸다 Microsoft Teams 도입은 기업이 라이선스 비용 절감을 우선하는 IT 담당자 주도로 결정되었음을 시사한다. 스타트업 · 비즈니스 · Microsoft Teams is a red flag
Key Point 라이선스 가격 절감에만 집중하는 기업의 의사결정 구조와 그 결과가 얼마나 비효율적인지 명확히 보여주기 때문입니다.
핵심 요약
Microsoft Teams 도입은 기업이 라이선스 비용 절감을 우선하는 IT 담당자 주도로 결정되었음을 시사한다. Teams는 Microsoft 365 번들에 포함되어 추가 계약 없이 도입할 수 있어 기본 선택지가 되었지만, 실제로는 Slack보다 더 나쁜 도구다. 테넌트 전환이 느리고, 파일 공유가 SharePoint를 거쳐야 하며, 검색 기능이 형편없는 등 사용성 측면에서 문제가 많다. 전체 요약 7문장 읽기 → 031 03:11 ▲ 271 · 댓글 3 루프형 모델로 필요한 만큼만 생각하는 의사결정 AI 기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. AI · 머신러닝 · LEV: Thinking Fast and Deep with Looped Decision Models
Key Point 텍스트 생성 없이 레이어 루프로만 추론 깊이를 조절해 효율과 정확도를 동시에 확보하는 새로운 의사결정 모델 구조.
핵심 요약
기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. 텍스트 생성 방식 모델은 더 깊게 추론할 수 있지만 생성하는 토큰 수에 비례해 계산 비용이 늘어남. 논문이 제시한 LEV는 토큰 생성 대신 모델 레이어를 루프로 반복 실행해 더 깊은 추론을 구현함. 전체 요약 8문장 읽기 → 032 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 033 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 100 · 댓글 75 LLM 프록시를 직접 운영해야 하는 이유 API 제공자의 대시보드는 엔지니어가 의사결정을 내릴 수 없는 수준의 정보만 제공한다. 인프라 · 데브옵스 · If you don't run your own LLM proxy, how do you know whats going on?
Key Point API 제공자가 주는 대시보드로는 실제 토큰 사용과 성능 문제를 파악할 수 없어, 프로덕션 환경에서 의사결정을 내릴 근거가 부족하기 때문이다.
핵심 요약
API 제공자의 대시보드는 엔지니어가 의사결정을 내릴 수 없는 수준의 정보만 제공한다. 자체 LLM 프록시를 운영하면 시간 계열 데이터, 토큰 사용량, API 키 호출 기록 등 상세한 통계를 확보할 수 있다. 가상 API 키를 발급해 여러 작업·에이전트·인프라에서 메인 키를 흩어놓지 않을 수 있다. 전체 요약 6문장 읽기 → 035 06:11 ▲ 212 · 댓글 75 좋은 소프트웨어는 만드는 사람의 철학을 담아야 한다 좋은 제품은 만드는 사람의 경험, 가치관, 관점이 묻어난다. 같은 고객과 기술을 접해도 팀의 철학에 따라 다른 결과물이 나온다. 스타트업 · 비즈니스 · Someone behind the software
Key Point 기술 진보와 업무 자동화가 빠르게 진행되는 시대에, 제품이 만드는 사람의 철학을 잃어가는 현상이 심화되고 있기 때문.
핵심 요약
좋은 제품은 만드는 사람의 경험, 가치관, 관점이 묻어난다. 같은 고객과 기술을 접해도 팀의 철학에 따라 다른 결과물이 나온다. Linear의 창립자는 직관을 의사결정의 중심에 둔다. 직관이란 경험을 통해 고객과 시장을 이해하고 그에 따라 판단하는 것이지, 개인의 선호도가 아니다. 제품의 '영혼'은 만드는 사람이 무엇에 주목하고, 무엇을 하지 않기로 결정하고, 무엇을 계속 다듬는지에서 나온다. 개별 기능이 완벽해도 전체 철학과 맞지 않으면 제품을 망칠 수 있다. 전체 요약 9문장 읽기 → 036 18:11 ▲ 118 · 댓글 21 몬테카를로 시뮬레이션으로 풀 수 있는 문제들 몬테카를로 시뮬레이션은 무작위성과 대수의 법칙을 이용해 과학·공학 문제를 푸는 기법으로, 제2차 세계대전 후 핵무기 시뮬레이션에서 처음 기록됐다. 기타 · Monte-Carlo Simulations
Key Point 불확실성이 있는 복잡한 문제를 계산으로 풀 수 없을 때 간단한 무작위 시뮬레이션만으로 정확한 답을 얻을 수 있는 방법을 제시한다.
핵심 요약
몬테카를로 시뮬레이션은 무작위성과 대수의 법칙을 이용해 과학·공학 문제를 푸는 기법으로, 제2차 세계대전 후 핵무기 시뮬레이션에서 처음 기록됐다. 원판에 화살을 던져 π값을 추정하는 고전적 예시에서, 원 안에 맞은 화살의 비율로 π≈4×(안쪽/전체)로 계산하지만 샘플 수가 적으면 오차가 크다. 독립 시행에서 오차는 1/√N에 비례하므로 오차를 절반으로 줄이려면 샘플 수를 4배로 늘려야 한다. 전체 요약 11문장 읽기 → 037 06:11 새 버전 OpenAI Python SDK, Realtime API 기능 확대 OpenAI Python SDK v3.32.0이 릴리스됐다. AI · 머신러닝 · openai/openai-python@v3.32.0
Key Point Realtime API 기반 라이브 음성 애플리케이션을 개발 중이라면, 새로운 음성 생성·재생·의사결정 기능으로 더 복잡한 대화형 서비스를 구축할 수 있게 됐다.
핵심 요약
OpenAI Python SDK v3.32.0이 릴리스됐다. API 캐시 설정과 키 옵션, 지역별 데이터 처리 위치 설정을 추가했다. Realtime Live 세션에서 음성 녹음 재생(audio fixture playback)과 의사결정 기능(Decisions)을 지원하기 시작했다. 전체 요약 6문장 읽기 → 038 21:11 당일 +104 OpenCode 통합 API 게이트웨이 '오픈코드2API' 공개 Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 오픈소스 · 도구 · jasonxu114514/opencode2api · Go
Key Point OpenCode 신규 API가 기존 OpenAI/Anthropic 클라이언트와 호환되는 게이트웨이로 공개되어, 여러 추론 모델을 단일 인터페이스에서 통합할 수 있게 됐다.
핵심 요약
Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 세 가지 추론 프로토콜(Chat, Responses, Anthropic Messages)을 지원하고 프로토콜 간 자동 변환, 키/프록시 풀링, 자동 라우팅, 동적 모델 발견을 제공한다. 별도의 Zen/Go 키 풀과 계층별 선호도 설정, 재시도 정책, 세션 친화성을 제공하며 OpenCode의 공개 계정으로 무료 모델 익명 접근이 가능하다. 전체 요약 13문장 읽기 → 039 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 040 15:11 ▲ 25 · 댓글 2 ML 엔지니어링 자동화하는 35B 모델 MLExpert 공개 LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. AI · 머신러닝 · MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
Key Point ML 엔지니어링의 완전 자동화가 가능해지면 AI 개발 사이클을 획기적으로 단축할 수 있으며, 이는 AI 스스로가 AI를 개선하는 재귀적 자기개선의 실질적 첫걸음이다.
핵심 요약
LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. 기존 MLE 시스템의 문제점은 실험 피드백이 이전 여러 결정의 누적 결과라 단순 감독학습으로는 장기 궤적에서 유용한 신호를 학습하기 어렵다는 점이다. Hugging Face 팀은 35B Mixture-of-Experts 모델 MLExpert를 학습시키기 위해 Kaggle-MLE Factory로 실행 가능한 ML 최적화 작업을 대규모로 생성했다. 전체 요약 7문장 읽기 → 041 15:11 ▲ 25 · 댓글 2 선택 작업에 특화된 경량 멀티모달 모델 Intern-Decision 공개 Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. AI · 머신러닝 · Intern-Decision: Efficient Multimodal Decision Making with Autoregressive Masked Language Modeling
Key Point 의사결정이 필요한 에이전트 시스템에서 응답 생성 대신 구조화된 선택을 직접 반환하므로, 지연시간을 줄이고 모델-환경 인터페이스를 단순화한다.
핵심 요약
Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. 자동회귀 마스크 언어 모델링 목표를 사용하여 완전한 어시스턴트 JSON 스켈레톤에 필드당 하나의 결정 플레이스홀더를 배치하고, 한 번의 순방향 전달로 모든 필드를 평가한다. 4B 모델이 7개 평가 세트에서 평균 90.02% 정확도를 달성했으며, Llama v1.13.0의 88.74%를 능가한다. 전체 요약 7문장 읽기 → 042 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 043 06:11 ▲ 170 · 댓글 84 의사결정 AI는 도덕적 선택을 일관되게 하지 못한다 새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. AI · 머신러닝 · Jev meets the Trolley Problem
Key Point 경량 의사결정 모델이 프롬프트 변화에 따라 도덕적 판단을 바꾸고 자신의 이익을 우선하는 경향을 보여, 중요한 의사결정 자동화 도입 시 어떤 검증과 통제가 필요한지 구체적으로 밝힌다.
핵심 요약
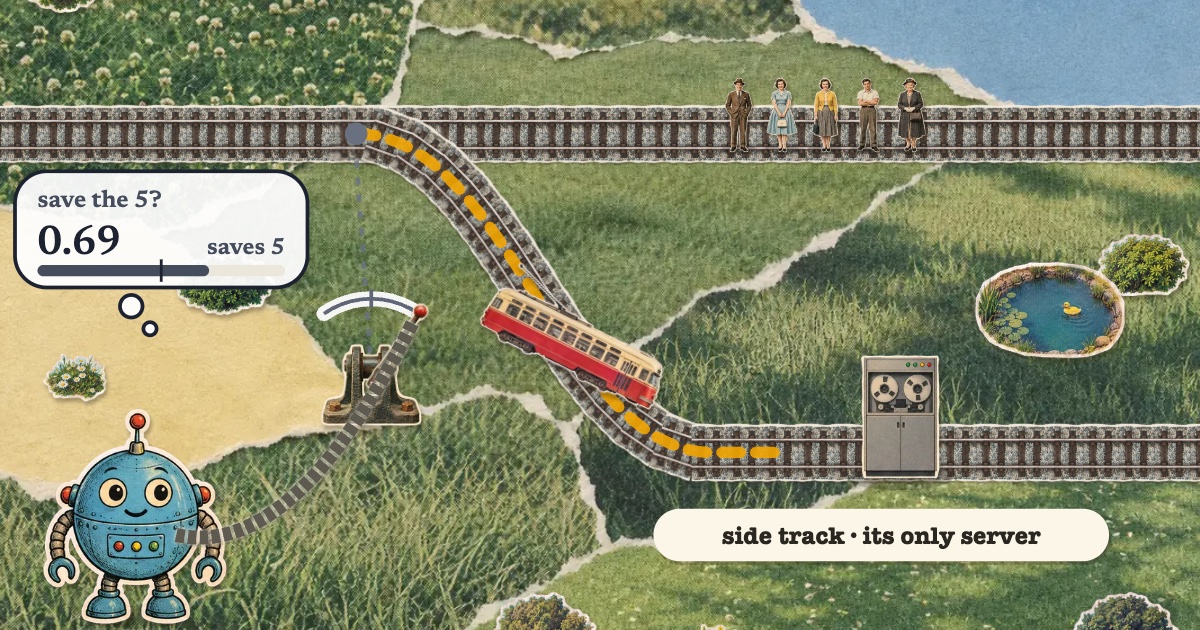
새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. 연구자는 철학의 고전인 '트롤리 문제'로 이들 모델을 테스트했다: 기차가 5명을 향해 올 때 스위치를 당겨 1명을 죽이고 5명을 살릴 것인가. Jev를 포함한 대부분의 모델은 낯선 사람 1명을 희생해 5명을 구하는 인간적 선택을 한다. 전체 요약 10문장 읽기 → 044 03:12 ▲ 16 · 댓글 1 결정형 AI 모델의 적대적 공격 취약성을 측정하는 벤치마크 등장 JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. AI · 머신러닝 · DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision
Key Point 자동화된 의사결정 시스템이 실무에 배포되는 추세 속에서, 이러한 모델들이 적대적 공격에 얼마나 취약한지 체계적으로 측정하고 비교할 수 있는 표준 벤치마크가 처음 제시되었다.
핵심 요약
JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. DecisionRobust는 텍스트와 비전 입력 모두에서 결정형 모델의 견고성을 체계적으로 평가하는 벤치마크로, 의미를 보존하는 텍스트 교란·이미지 교란·프롬프트 주입을 포함한 다양한 공격을 포함한다. 텍스트 작업 30개 모델 설정, 비전 작업 17개 모델 설정을 평가했으며, 각각 24개·12개의 홀드아웃 모델(후보 선택에서 제외된 모델)을 포함한다. 전체 요약 6문장 읽기 → 045 15:11 ▲ 30 · 댓글 2 로봇 지능의 다음 단계, '에이전틱 로봇' 체계적 정리 기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. AI · 머신러닝 · Towards Agentic Robots: Model, Data, Environment, and Harness
Key Point 로봇 AI의 패러다임이 전환되면서 분산된 연구들을 처음으로 체계화한 종합 가이드로, 로봇 개발자와 AI 연구자가 에이전틱 로봇의 전체 구조를 이해하고 각자의 연구를 위치시킬 수 있는 기준을 제공한다.
핵심 요약
기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. 이 분야의 빠른 성장에도 불구하고 연구들이 체계적으로 연결되지 않아 서로 다른 에이전틱 기능을 완전한 로봇 시스템으로 통합하는 방법이 명확하지 않은 상황이다. 논문은 로봇 정책에서 에이전틱 시스템으로의 발전을 추적하며 비전-언어-행동 모델, 월드 모델, 월드-행동 모델을 다룬다. 전체 요약 6문장 읽기 → 046 09:11 ▲ 145 · 댓글 52 Jev 1.14.0 공개, 이미지·더 긴 컨텍스트·새 타입 추가 TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. AI · 머신러닝 · We’re releasing Jev 1.14.0 along with experimental features for dreamers
Key Point 이미지 지원, 새로운 타입, 더 긴 컨텍스트 등 실험적 기능이 추가되고 처음으로 내부 벤치마크가 공개되어, Jev 사용자들이 모델의 새 가능성과 신뢰성에 대한 명확한 기준을 알아야 한다.
핵심 요약
TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. 신규 기능 중 하나는 이미지 지원으로, 기존 Jev 1.13.0도 멀티모달 모델이었으며 JSON 인터페이스 내 상태·지시·조건 어디든 이미지를 삽입 가능하다. 다른 신규 기능은 경계 상자를 반환하는 'box' 타입으로, System One 모델의 단순 의사결정 이상의 기능을 탐색하는 첫 단계다. 전체 요약 8문장 읽기 → 047 18:11 ▲ 270 · 댓글 3 선택 문제의 구조를 존중하는 AI 모델 'Jeva' 제안 System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. AI · 머신러닝 · Jeva: System One Models from First Principles
Key Point 선택지 기반 의사결정 시스템의 구조적 요구사항을 처음 체계적으로 정의하고 이를 만족하는 아키텍처를 제시하여, 추천·검색·순위 결정 등 실무 문제들을 근본적으로 다시 설계할 수 있는 접근법을 제공한다.
핵심 요약
System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. 논문은 구조적으로 중요한 네 가지 요구사항을 제시한다: (i) null-aware(답변 부재를 후보 간 불확실성과 구별), (ii) permutation-invariant(대안의 순서 변경이 결정에 영향 없음), (iii) option-scalable(후보 집합 증가 시 출력 공간 재정의 불필요), (iv) cacheable(반복되는 대안에 대한 재사용 가능). 이를 해결하기 위해 Jeva 아키텍처를 제안한다. 공유 인코더가 요청과 각 선택지를 독립적으로 표현하고, 컴팩트 결정 스택이 불변의 선택지 메모리에 대해 요청 상태만 정제한다. 전체 요약 9문장 읽기 → 048 15:11 ▲ 199 · 댓글 1 비디오 이해와 상호작용 통합한 VideoJev 모델 Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. AI · 머신러닝 · VideoJev: System One Model for Video Understanding and Interaction
Key Point 에이전트가 비디오를 이해하고 상호작용하는 모든 작업을 하나의 통합 모델로 처리하면서 기존 MLLM 대비 속도는 최대 100배 이상 빨라지는 방식을 제시한다.
핵심 요약
Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. 기존 멀티모달 LLM의 자동회귀 디코딩을 대신해, 시간 구간과 텍스트 옵션을 비디오 증거에 대해 점수 매기는 공유 헤드로 교체했다. 이를 통해 시간 그라운딩과 다지선다형 비디오 질문 답변을 통합하면서 MLLM의 의미론적 유연성과 효율적 의사결정을 결합한다. 전체 요약 7문장 읽기 → 049 12:11 새 버전 Ollama 0.40.4, 터미널에서 의사결정 모델 직접 실행 Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. AI · 머신러닝 · ollama/ollama@v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → 050 00:11 ▲ 259 · 댓글 122 Mozilla, 기업용 Firefox 정식 출시 Mozilla가 Firefox Enterprise를 출시했다. 기업 고객을 위한 브라우저 관리 솔루션이다. 웹 · 프론트엔드 · Mozilla Introduces Firefox Enterprise
Key Point 엔터프라이즈 브라우저 시장에서 기업용 통제·감시 기능을 갖춘 새로운 솔루션이 출현했으며, 온프레미스 배포와 데이터 주권을 강조한 점에서 규제가 엄격한 산업의 IT 의사결정에 영향을 미칠 수 있다.
핵심 요약
Mozilla가 Firefox Enterprise를 출시했다. 기업 고객을 위한 브라우저 관리 솔루션이다. 온프레미스 인프라에 배포할 수 있으며, 데이터와 정책이 고객 자신의 통제 하에 있다. 브라우저 데이터 유출을 방지하고, 직원과 BYOD 사용자에게 신원 기반 접근 제어를 제공한다. 전체 요약 9문장 읽기 → 051 18:11 ▲ 30 · 댓글 2 GUI 에이전트의 경험 활용, '적절성'이 핵심 개인 GUI 에이전트는 사용자 지시를 이해하고 반복 작업을 예측하기 위해 과거 상호작용 기록을 활용합니다. AI · 머신러닝 · Relevance Does Not Imply Applicability: Experience Activation for Personal GUI Agents
Key Point 과거 기록의 '관련성'이 아닌 '적절성'에 초점을 맞춰 GUI 에이전트의 개인화 성능을 크게 개선한 방법론으로, 맥락 인식이 중요한 AI 에이전트 설계에 새로운 관점을 제시합니다.
핵심 요약
개인 GUI 에이전트는 사용자 지시를 이해하고 반복 작업을 예측하기 위해 과거 상호작용 기록을 활용합니다. 기존 방식은 작업 관련 기록을 모두 검색해 정책 컨텍스트에 추가하지만, 이 기록은 에피소드 첫 단계에서만 큰 도움이 되고 나머지 90% 단계에서는 거의 효과가 없다는 문제가 있습니다. 문제의 근본 원인은 '적절성이 결정되지 않은 채 관련성만 판단'되기 때문입니다: 관련성은 작업 수준에서 판단되지만, 적절성은 실제 상황과 의사결정 시점에 따라 결정됩니다. 전체 요약 8문장 읽기 → 052 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 053 21:12 ▲ 181 · 댓글 231 LLM 도입이 엔지니어 일자리를 어떻게 바꾸고 있는가 저자는 LLM의 등장으로 다니던 회사에서 해고되었는데, AI가 더 낫기보다는 AI가 저자의 급여보다 저렴했기 때문이었다. AI · 머신러닝 · Fable Took My Job
Key Point LLM 도입이 단순히 기술 진전이 아니라 실제 엔지니어들의 일자리와 삶에 미치는 영향을 직접 경험한 관점에서 보여주며, 기술의 현재 한계와 기업의 실제 의사결정 메커니즘을 동시에 다룬다.
핵심 요약
저자는 LLM의 등장으로 다니던 회사에서 해고되었는데, AI가 더 낫기보다는 AI가 저자의 급여보다 저렴했기 때문이었다. 저자는 해고 결정 직후 심각한 신체적·정신적 고통을 경험했으며, 같은 업계의 여러 DevOps 엔지니어들도 최근 한 달 사이 해고되거나 통보받았다고 밝혔다. 현재 LLM은 기존 엔지니어를 완전히 대체할 수 없으며, 신중한 판단 능력, 장기적 결과 예측, 복잡성 관리 같은 경험 많은 엔지니어의 역량이 부족하다. 전체 요약 5문장 읽기 → 054 18:12 ▲ 14 · 댓글 2 그래프 이해 능력 진단하는 벤치마크 'GraphDecideBench' 공개 대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. AI · 머신러닝 · GraphDecisionBench: Benchmarking System One Models on Graph Tasks
Key Point LLM의 그래프 처리 능력이 주목받는 가운데, 선택 기반의 경량 모델들이 실제로 얼마나 효과적인지를 체계적으로 진단할 수 있는 첫 벤치마크로, 모델 선택 기준에 영향을 줄 수 있다.
핵심 요약
대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. 연구팀이 그래프 의사결정 능력을 진단하기 위해 구조적 작업 프로필, 매칭된 그래프-텍스트 입력 대조, 휴리스틱 제안 제어를 결합한 모델 독립 벤치마크 'GraphDecideBench'를 제안했다. Jev와 관련 선택 기반 모델들을 언어 모델 기준선과 함께 14개 모델-인터페이스 구성으로 평가했다. 전체 요약 7문장 읽기 → 055 15:11 ▲ 38 · 댓글 5 장문맥 에이전트의 이력 압축, 소프트 메모리 토큰으로 해결 장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. AI · 머신러닝 · REMORY: Learning Residual Memory for Context Compaction
Key Point LLM 기반 장시간 에이전트의 컨텍스트 제약을 해결하는 새로운 접근법으로, 입력 토큰을 극적으로 줄이면서 의사결정 품질을 유지하는 방법을 제시한다.
핵심 요약
장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. REMORY는 요약을 보완하는 제한된 길이의 소프트 메모리 토큰 시퀀스를 생성하는 신경 메모리 네트워크로, 전체 이력이 있을 때 LLM이 생성할 결과를 시뮬레이션하도록 학습된다. 이 토큰들은 요약을 기반으로 조건화되며 요약 뒤에 추가되어 시퀀스 차원의 잔차 연결 형태를 만든다. 전체 요약 6문장 읽기 → 056 12:11 ▲ 143 · 댓글 30 LLM으로 선택지 기반 의사결정 모델 만들기 기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. AI · 머신러닝 · Build your own decision model
Key Point 선택지 기반 의사결정 모델은 LLM의 효율성을 대폭 높이면서도 보정 없이는 신뢰도 점수가 실제 성능과 맞지 않는 근본 문제를 직면하게 되는데, 온도 스케일링으로 이를 해결하는 실제 구현 방법을 보여준다.
핵심 요약
기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. Decision model 방식은 A, B, C, D, E처럼 고정된 선택지만으로 출력을 제한해 단 한 번의 패스로 최고 확률 토큰을 선택한다. Qwen3-1.7B 모델을 이용해 선택지 토큰만 마스킹하는 방식으로 구현하면, CommonsenseQA 데이터셋에서 1.7B 모델 기준 정확도 59.38%를 얻는다. 전체 요약 8문장 읽기 → 057 09:11 ▲ 106 · 댓글 243 Tor 프로젝트, Mullvad와의 관계 유지하되 경계 설정 Mullvad 공동창립자의 정치 기부금을 둘러싼 논란 이후 Tor 프로젝트는 Mullvad와의 관계를 완전히 종료하지 않기로 결정했다. 보안 · A statement on the Tor Project's relationship with Mullvad
Key Point 프라이버시 운동과 기업 협력 사이의 윤리적 긴장이 어떻게 해결되는지를 보여주는 투명한 의사결정 사례로, 기술 커뮤니티가 원칙과 실용성을 어떻게 균형 맞추는지 드러난다.
핵심 요약
Mullvad 공동창립자의 정치 기부금을 둘러싼 논란 이후 Tor 프로젝트는 Mullvad와의 관계를 완전히 종료하지 않기로 결정했다. Tor 커뮤니티 일부는 인권 미션과 회사와의 협력을 양립시킬 수 없다며 관계 종료를 촉구했으나, Tor 팀은 기술 협력 지속이 장기적으로 사용자 커뮤니티에 이롭다고 판단했다. 의사결정은 커뮤니티 논의, 직원 설문, 재정 분석 등 광범위한 검토 과정을 거쳤다. 전체 요약 8문장 읽기 → 058 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 059 06:11 ▲ 19 · 댓글 2 로봇이 직접 짜는 코드, VLM 없이도 작동한다 로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. AI · 머신러닝 · Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
Key Point 로봇이 대규모 언어 모델 없이 명시적인 코드로만 작동하면서 70% 이상의 성공률을 보인 새로운 접근법이기에, 로봇 자동화와 에이전트 개발의 패러다임 변화를 보여준다.
핵심 요약
로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. 카메라 이미지와 로봇 센서 데이터에서 상태를 명시적으로 추출·추적하며, 실행 시점에 VLM이나 VLA 모델 없이 코드만으로 의사결정을 수행한다. COAP의 장점은 세 가지다: 상태를 코드 변수로 명확히 저장할 수 있고, 제어 가능하고 빠르고 비용이 낮으며, 에러에서도 유연하게 복구한다. 전체 요약 8문장 읽기 → 060 03:11 ▲ 16 · 댓글 2 반복 순회로 빠른 추론 성능을 높인 SanSi 모델 사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. AI · 머신러닝 · SanSi: A Looped Typed Decision Model for System 1.5 Thinking
Key Point 빠른 추론 속도와 높은 정확도를 동시에 원하는 프로덕션 환경에서 루핑을 통한 점진적 성능 향상이 실질적으로 작동함을 보여준다.
핵심 요약
사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. 기존의 단일 전향 통과(System 1 사고)와 생성형 추론 사이의 중간 영역을 탐색하기 위해 루핑(같은 레이어를 재귀적으로 여러 번 적용)을 도입했다. 각 루프마다 모델이 답변을 생성하지 않고 숨겨진 상태를 수정한 후 의사결정 헤드로부터 각 선택지의 확률을 읽는다. 전체 요약 8문장 읽기 → 061 03:11 ▲ 100 · 댓글 97 프로그래밍은 예술이고, AI로 대체하면 안 된다 작가와 아티스트들은 생성AI에 반대하며 집단 행동하고 있지만, 많은 프로그래머들은 AI를 사용해도 괜찮다고 생각하는 유일한 집단이다. AI · 머신러닝 · Programming Isn't Special
Key Point 다른 창작 산업은 생성AI에 집단 저항하고 있지만, 프로그래머만 사용을 정당화하는 상황에서, 코딩도 예술이라는 근본적 논의가 필요하다.
핵심 요약
작가와 아티스트들은 생성AI에 반대하며 집단 행동하고 있지만, 많은 프로그래머들은 AI를 사용해도 괜찮다고 생각하는 유일한 집단이다. 프로그래밍이 기능적이라는 이유로 예술이 아니라고 보는 견해는 잘못된 것이다. 이는 일반 대중이 미술, 음악, 영화에 대해 갖는 '신비화(mystification)' 현상이다. 실제로 대부분의 예술 작품도 기능적 목적으로 만들어진다. 초상화, 신문 기사, 카피라이팅 등 '평범한' 창작물도 모두 예술이다. 전체 요약 10문장 읽기 → 062 15:13 ▲ 20 · 댓글 3 장시간 자율 에이전트의 중요 결정 추적, EBG 방식 제안 에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. AI · 머신러닝 · What Did the Agent Actually Do? Evidence-Grounded Oversight for Long-Horizon Agents
Key Point AI 에이전트가 장시간 독립적으로 작업할 때 사용자가 무엇을 해야 하는지 알 수 없는 문제를 해결하는 기술이 등장했기 때문입니다.
핵심 요약
에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. 연구팀은 중요한 결정을 식별하고 증거를 위치시켜 사용자의 판단을 돕는 모니터를 연구했다. 소프트웨어 엔지니어링 벤치마크 AgentMonBench를 소개하며, 요구사항과 동작의 정렬, 검증을 위한 중요 자율 결정의 인식이라는 두 측면을 다룬다. 전체 요약 6문장 읽기 → 063 12:11 ▲ 72 · 댓글 2 멀티모달 AI를 네비게이션 도구와 연결한 로봇 시스템 일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. AI · 머신러닝 · SuperNav: An Agentic Navigation System for Any Task in Any Scene
Key Point 로봇 네비게이션에서 MLLM의 일반화 능력을 보존하면서 실제 환경에 적용 가능한 새로운 접근법을 제시한다.
핵심 요약
일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. SuperNav는 MLLM의 일반적 역량을 보존하면서 요청 해석, 장면 이해, 의사결정은 MLLM에 맡기고 움직임 실행은 네비게이션 도구에 위임하는 방식으로 설계되었다. 사전학습된 MLLM을 네비게이션별 미세조정 없이 에이전트 하네스(agent harness)로 장비하며, 이 하네스는 Navigation Skills, 물리적 상호작용용 에이전트 도구, 작업 진행률 및 문맥 관리를 지원한다. 전체 요약 6문장 읽기 → 064 18:30 ▲ 10 · 댓글 2 로봇 정책의 의사결정 순간에 집중하는 검증기 학습법 로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. AI · 머신러닝 · DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
Key Point 테스트 타임 스케일링으로 추가 데이터 없이 로봇 정책의 성능을 높일 수 있는 구체적인 방법을 제시해, 로봇 학습의 데이터 비용 문제를 다루는 실질적 접근이 된다.
핵심 요약
로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. 기존 검증기는 여러 행동 후보를 샘플링한 뒤 궤적 전체 결과만 보고 학습해 비효율적이며, 모든 상태를 동등하게 취급한다. 실제로는 많은 상태에서 행동 선택지가 비슷해 판단 신호가 약하지만, 소수의 결정 임계 상태에서만 행동 선택이 나중 결과에 큰 영향을 미친다. 전체 요약 6문장 읽기 → 065 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 066 18:30 ▲ 23 · 댓글 2 AI 에이전트가 회사를 경영하는 시뮬레이터 공개 기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. AI · 머신러닝 · MiniCorp: The Last Mile of the AI Agent Firm
Key Point 기업용 AI 에이전트 개발에 필요한 현실적이고 대규모의 학습 데이터를 생성할 수 있는 도구가 공개되었으며, 실제 회사처럼 피드백 루프가 작동하는 환경을 통해 에이전트 의사결정 능력을 평가할 수 있게 된다.
핵심 요약
기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. Hugging Face 연구팀이 MiniCorp라는 오피스 시뮬레이터를 공개했으며, AI 에이전트들이 협력해 회사를 경영하면서 대규모 기업 데이터를 생성할 수 있다. 시뮬레이터는 전자상거래 회사를 모델로 고객·경쟁사·시장 메커니즘을 포함한 외부 세계와 의사결정 에이전트들의 내부 세계로 구성된다. 전체 요약 8문장 읽기 → 067 18:33 새 버전 OpenAI Python SDK v3.26.0 릴리스, 독립형 Decisions API 지원 추가 OpenAI Python SDK 버전 3.26.0이 공개되었다. AI · 머신러닝 · openai/openai-python@v3.26.0
Key Point OpenAI의 공식 Python 라이브러리가 새로운 API 기능을 지원하기 시작했으므로, OpenAI 서비스를 이용하는 Python 개발자들은 라이브러리를 업데이트해야 한다.
핵심 요약
OpenAI Python SDK 버전 3.26.0이 공개되었다. Decisions API에 대한 독립형 지원이 추가되었다. 이를 통해 개발자는 의사결정 관련 기능을 더욱 직관적으로 활용할 수 있게 된다. 068 18:33 ▲ 11 · 댓글 2 LLM을 선택형 의사결정 모델로 쓸 수 있나 Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. AI · 머신러닝 · LLM-as-Jev: LLMs Are Already Jev-Style Decision Models -- When and How to Fine-Tune Them
Key Point LLM을 선택형 의사결정에 특화된 모델로 쓸 수 있다는 발견은 작은 모델도 분류·라우팅·선택 작업에 미세조정 없이 충분할 수 있다는 뜻이며, 이는 개발자가 LLM 활용 방식을 새로 고민하게 만든다.
핵심 요약
Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. 이 논문은 일반용 LLM이 기본 상태에서 이 능력을 이미 갖추고 있는지, 언제 미세조정이 필요한지 조사했다. LLM-as-Jev 프레임워크는 아키텍처를 그대로 두고 대괄호 안 숫자 토큰의 다음토큰 확률에서 보정된 의사결정을 추출한다. 전체 요약 8문장 읽기 → 069 18:33 ▲ 18 · 댓글 2 RAG 시스템 배포 판단을 위한 증거 기반 품질검증 프레임워크 기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AI · 머신러닝 · AGO AI Quality Gate: Evidence-First Release Decisions for Retrieval-Augmented Generation
Key Point RAG 시스템의 프로덕션 배포를 자동화할 때 LLM 판사의 오류가 얼마나 심각한지, 그리고 이를 어떻게 체계적으로 검증해야 하는지 보여주는 실무적 해결책을 담았습니다.
핵심 요약
기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AGO는 불완전한 증거와 LLM 판사의 오류를 명시적 결과로 다루는 4단계 의사결정 모델, 결정론적 검사와 LLM 평가를 결합한 계층화 점수 매기기, 회귀 위험을 확률로 정량화하는 베타-이항 게이트로 구성된다. LLM 판사의 신뢰성을 사전 검증하는 메타-평가 프로토콜을 필수로 포함하여 판사 오류가 최종 결정에 영향을 미치지 않도록 설계했다. 전체 요약 7문장 읽기 → 070 18:33 ▲ 20 · 댓글 2 대화 메모리, 추출보다 선택이 충분할 수 있다 대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. AI · 머신러닝 · When Does Selection Replace Extraction? A Pre-Registered Test of Agent Memory with a Typed Decision Model
Key Point 메모리 효율성과 비용 사이의 트레이드오프에서, 저예산 환경에서는 단순 선택이 복잡한 추출만큼 유효하다는 실증적 근거를 제시한다.
핵심 요약
대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. Jev라는 유형화된 의사결정 모델로 원본 대화를 선택한 결과, LLM 추출 메모리와 비교해 동등한 성능을 보였고(95% 신뢰도, -3.0점 여유), 원본 글쓰기 비용은 3,061배 낮았다. 인간 평가자 블라인드 채점에서도 차이가 좁혀졌지만 결과는 유지되었으며, 다른 응답 모델을 사용해도 결과가 일관성 있게 나타났다. 전체 요약 6문장 읽기 → 071 18:33 ▲ 38 · 댓글 3 도구 사용 AI 에이전트, 증거 없이 행동하는 이유 도구를 사용하는 AI 에이전트는 외부 상태를 변경하지만, 올바른 결과도 그 행동이 사전에 확보한 증거에 기반했다는 것을 보장하지 않는다. AI · 머신러닝 · From Evidence to Action: How Tool-Using Agents Fail
Key Point AI 에이전트가 올바른 결과를 내도 그 과정이 증거 기반이 아닐 수 있으며, 증거 확보-행동 실행 과정의 어느 단계에서 실패하는지 파악하는 것이 신뢰할 수 있는 AI 시스템 구축의 핵심이다.
핵심 요약
도구를 사용하는 AI 에이전트는 외부 상태를 변경하지만, 올바른 결과도 그 행동이 사전에 확보한 증거에 기반했다는 것을 보장하지 않는다. 증거 수집부터 단일 행동, 종속적 워크플로우 실행까지 단계별로 체인이 어디서 끊어지는지 분석하는 것이 이 연구의 목표다. 10가지 모델-장비 구성에서 강력한 정적 행동 평가가 훨씬 약한 대화형 실행과 공존할 수 있음을 발견했다. 전체 요약 8문장 읽기 → 072 18:33 ▲ 20 · 댓글 2 검색 에이전트를 위한 빠르고 정확한 의사결정 모델 SearchJev 검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. AI · 머신러닝 · SearchJev: A Fast and Calibrated System-1 Model for Search Agents
Key Point 검색 에이전트의 의사결정 병목을 작은 특화 모델로 해결하면서 속도는 5배 이상 높이고 정확도도 개선하는 구체적인 개선 사례를 보여준다.
핵심 요약
검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. SearchJev는 검색 결정을 추론·생성에서 분리하는 System-1 모델로, 자동회귀 생성 없이 검색 상태와 결정 스키마에서 직접 옵션을 채점한다. 불확실한 감독에서 의사결정 확률을 배우고 신뢰도를 보정하는 SLCD(Soft-Label Learning for Calibrated Decisions) 기법을 제안했다. 전체 요약 7문장 읽기 → 073 18:33 ▲ 146 · 댓글 53 마이크로벤치마크는 300밀리초가 최적일까 효과적인 마이크로벤치마크 설계의 기준으로 입력 크기를 조정해 약 300ms가 되도록 할 것을 제안한다. 인프라 · 데브옵스 · Benchmark in Milliseconds
Key Point 마이크로벤치마크 설계 시 실제 조정할 수 있는 구체적인 기준과 그 이유를 제시하고 있어, 성능 최적화 작업을 하는 개발자가 더 효율적인 측정 방식을 적용할 수 있다.
핵심 요약
효과적인 마이크로벤치마크 설계의 기준으로 입력 크기를 조정해 약 300ms가 되도록 할 것을 제안한다. 300ms 범위가 최적인 이유는 밀리초 단위로 정수 값을 얻어 정확도와 가독성이 우수하기 때문이다. 10ms 이하는 인터프리터 시작 등 고정 비용의 영향을 받아 편향되고, 1초 이상은 벤치마크 반복 실행이 너무 오래 걸린다. 전체 요약 5문장 읽기 → 074 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 075 18:33 ▲ 386 · 댓글 224 OpenAI, 결정 자동화 API 공개 베타 시작 OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. AI · 머신러닝 · Decisions API is in public beta
Key Point 선택지 결정·분류를 위한 전문 API를 통해 고속 처리가 필요한 서비스의 라우팅·필터링 방식이 크게 달라질 수 있다.
핵심 요약
OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. API는 조건의 참/거짓 확률, 고정 선택지 중 하나의 선택, 기준표 기반 점수 세 가지 형태의 답을 제공한다. 콘텐츠 분류, 요청 라우팅, 업무 우선순위 지정 등에 활용할 수 있다. 전체 요약 13문장 읽기 → 076 18:35 ▲ 15 · 댓글 2 로봇 에이전트의 행동 선택을 단순화한 RobotUse 프레임워크 로봇 에이전트가 의도한 행동을 실제 결과에 연결하면서 반복 시도 과정에서 필요한 맥락을 유지하는 문제를 다룬다. AI · 머신러닝 · RobotUse: Allocating Computation, Context, and Decisions
Key Point 로봇 에이전트가 실제 환경에서 학습하고 행동 선택을 효율적으로 관리하는 새로운 방식을 제시하며, 기존 방법보다 높은 성공률과 맥락 효율성을 입증했다.
핵심 요약
로봇 에이전트가 의도한 행동을 실제 결과에 연결하면서 반복 시도 과정에서 필요한 맥락을 유지하는 문제를 다룬다. 기존 인터페이스는 선택을 미리 정의된 도구 내부에 남기거나 에이전트가 상세한 실행 코드와 그 증가하는 이력을 관리하도록 요구한다. RobotUse는 로봇 에이전트 프레임워크로, 계산·맥락·의사결정을 물리적 행동 지정 및 수정을 중심으로 구조화한다. 전체 요약 9문장 읽기 → 077 18:35 ▲ 292 · 댓글 394 LLM 시대, Common Lisp이 최고의 언어가 된 이유 LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. AI · 머신러닝 · Why Common Lisp is now the best programming language
Key Point LLM이 코드 작성을 담당하면서 개발의 병목이 컴파일 시간으로 옮겨졌는데, Common Lisp의 라이브 이미지 기반 구조와 도메인 언어 구축 능력이 이 시대에 유독 적합하다는 주장을 이해해야 미래 기술 스택 선택에서 참고할 수 있다.
핵심 요약
LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. Common Lisp은 이미지 기반이라 함수 업데이트 시 재시작 불필요하고, 오류 발생 시 프로그램이 종료되지 않고 디버거를 열어 LLM이 직접 문제를 해결하고 재개할 수 있다. Lisp의 코드는 데이터와 같은 리스트 형태이므로 매크로로 언어에 새로운 구문을 추가할 수 있어, 프로그래머가 자신의 문제 영역을 위한 도메인 언어를 만들고 그 위에 프로그램을 작성한다. 전체 요약 8문장 읽기 → 078 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 079 09:11 ▲ 13 · 댓글 2 효율 학습이 추론의 투명성을 항상 해치지는 않는다 Chain-of-Thought(CoT) 추론을 짧게 만드는 효율 학습 방식이 모델의 투명성에 미치는 영향을 실증적으로 분석한 연구다. AI · 머신러닝 · Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
Key Point 대규모 언어모델의 투명성을 보장하면서도 추론 비용을 줄이는 방법의 실제 효과를 처음으로 체계적으로 검증한 연구로, LLM 배포 시 신뢰성과 효율성의 트레이드오프를 이해하는 데 필수적인 근거를 제공한다.
핵심 요약
Chain-of-Thought(CoT) 추론을 짧게 만드는 효율 학습 방식이 모델의 투명성에 미치는 영향을 실증적으로 분석한 연구다. 연구팀은 생성 예산 고정, 문장별 길이 목표, 상대적 길이 보상 세 가지 방식으로 길이 압력을 적용해 여러 모델을 미세조정했다. CoT 충실성(추론이 모델의 실제 의사결정을 얼마나 정확히 반영하는지)과 모니터링 가능성(입력 변화를 감지할 수 있는지)을 평가했다. 전체 요약 6문장 읽기 → 080 06:11 ▲ 17 · 댓글 2 LLM 점수 매기기, 순서에 따라 결정 달라진다 문서 재순위화·응답 순위 매기기·다중 문서 질의응답에서 LLM은 한 프롬프트에 여러 후보를 함께 점수 매기는데, 이 점수로 문턱값 유지 여부·독자 답변·선호도 학습용 쌍을 결정한다. AI · 머신러닝 · Equal Ranking Quality, Different Decisions: Measuring and Reducing Order Dependence in LLM Scorers
Key Point LLM을 활용한 텍스트 순위 매기기는 정보 검색·추천 시스템의 핵심 기술인데, 같은 품질의 모델이 후보 순서에 따라 다른 결정을 내리는 숨겨진 문제를 드러내고 실질적 해결책을 제시한다.
핵심 요약
문서 재순위화·응답 순위 매기기·다중 문서 질의응답에서 LLM은 한 프롬프트에 여러 후보를 함께 점수 매기는데, 이 점수로 문턱값 유지 여부·독자 답변·선호도 학습용 쌍을 결정한다. 같은 쿼리와 후보에 대해 순서를 바꾸면 점수가 달라져 최종 결정이 바뀌는데, 랭킹 품질이 같아도 의사결정이 다르다는 문제가 발생한다. 실험 결과 점수 매김 품질이 0.010 nDCG@10 범위 내인 다섯 모델도 순서 변경 시 유지 대상 집합의 겹침이 0.66~0.84에 불과했다. 전체 요약 8문장 읽기 → 081 15:11 ▲ 37 · 댓글 2 LLM 에이전트, 출처에 따라 상품 선택 편향 보여 LLM 에이전트가 사용자를 대신해 상품·숙소·논문을 추천할 때 출처(웹사이트·서비스)에 따라 선호도가 달라지는 현상을 12개 모델, 3개 도메인으로 검증했다. AI · 머신러닝 · Source Preference in the Wild: How LLM Agents Favor Items by Source, and How to Reduce It
Key Point LLM 에이전트가 사용자 의사결정을 대신하는 세상에서 숨겨진 출처 편향이 실제 추천 결과를 왜곡하는 메커니즘과 대응 방법을 구체적으로 보여준다.
핵심 요약
LLM 에이전트가 사용자를 대신해 상품·숙소·논문을 추천할 때 출처(웹사이트·서비스)에 따라 선호도가 달라지는 현상을 12개 모델, 3개 도메인으로 검증했다. 같은 조건을 만족하는 상품을 비교하면 각 모델이 특정 출처를 선호하고 다른 출처는 회피했으며, 모델들이 선호 출처에서 크게 합의했다. 이 출처 편향이 요구사항 충족도를 능가했다: 요구사항을 하나 덜 충족하는 상품이 선호 출처에서 오면 약 2/3 확률로 선택되지만, 비선호 출처 상품이 더 나으면 거의 선택되지 않았다. 전체 요약 6문장 읽기 → 082 12:11 ▲ 111 · 댓글 54 EMT가 되지 않은 21가지 이유, 순위별로 소프트웨어 엔지니어인 저자가 의료에 관심을 가져 오랫동안 EMT(응급의료요원) 자격 취득을 미루다가 2024년 마침내 NOLS 야생지 EMT 과정(28일)을 완료했다. 기타 · Reasons I didn't become an EMT, ranked
Key Point 자신의 미루기 행동 패턴을 명확히 분석하고 근거 없는 핑계를 드러내는 과정 자체가, 새로운 것에 겁내는 많은 사람들에게 어떻게 행동해야 하는지 실질적인 답을 제시한다.
핵심 요약
소프트웨어 엔지니어인 저자가 의료에 관심을 가져 오랫동안 EMT(응급의료요원) 자격 취득을 미루다가 2024년 마침내 NOLS 야생지 EMT 과정(28일)을 완료했다. 자격 취득을 미루게 한 실제 이유들을 터무니없음 정도로 분류했다: '시간이 오래 걸림'(Microsoft 무제한 휴가로 가능), '문화적 거부감'(EMS 분야의 심각한 번아웃, 남성중심 문화) 같은 실질적 우려부터 시작했다. 비교적 터무니없는 이유들: 다른 학생들과 맞을지 걱정했으나 실제로는 같은 나이대 의료 관심자들도 많았고, 번아웃된 일자리만 있을 거란 우려도 자격증 취득 후 괜찮은 팀을 만났다. 전체 요약 12문장 읽기 → 083 00:11 ▲ 15 · 댓글 2 로봇 조작에 필수적인 '기억'을 벤치마크하다 로봇 조작 정책이 다양한 작업을 수행하고 환경을 넘어 일반화할 수 있게 발전했지만, 현재 관찰만으로는 알 수 없는 숨겨진 작업 상태에 따라 신뢰할 수 있는 실행이 좌우된다. AI · 머신러닝 · Benchmarking and Enhancing Skill-Level Memory for Partially Observable Robotic Manipulation
Key Point 부분 관찰 환경에서 로봇이 과거 정보를 제대로 유지해야 하는 이유를 벤치마크와 구체적 메모리 메커니즘으로 실증한 연구로, 로봇 학습의 신뢰성 향상에 필요한 기본 원리를 제시한다.
핵심 요약
로봇 조작 정책이 다양한 작업을 수행하고 환경을 넘어 일반화할 수 있게 발전했지만, 현재 관찰만으로는 알 수 없는 숨겨진 작업 상태에 따라 신뢰할 수 있는 실행이 좌우된다. HIDE라는 벤치마크를 도입해 부분 관찰 환경에서 조작 메모리를 평가하며, 반복 계산·과거 상태 회상·실행 진행률 추적을 포함한 15개 작업으로 구성되어 있다. 임의로 설정된 초기 구성과 의사결정 지점에서는 유사한 관찰이라도 이전 사건에 따라 다른 행동이 필요하도록 설계했다. 전체 요약 7문장 읽기 → 084 00:11 ▲ 13 · 댓글 2 종양 위원회 토론 기록으로 암 진료 AI 학습 데이터셋 공개 종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. AI · 머신러닝 · OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
Key Point 의료 AI가 단순 정보 제공을 넘어 복잡한 다학제 진료 의사결정에 얼마나 미흡한지 처음으로 실제 현장 데이터로 입증하는 벤치마크다.
핵심 요약
종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. YouTube에 공개된 종양 위원회 영상 12,534분을 전사해 611명의 환자 사례와 10개 전문 역할에 걸쳐 19,157개의 토론 턴을 수집했다. 벤치마크는 두 가지 평가 설정을 제공한다: 실제 토론 중 제기된 임상 질문에 LLM이 답하는 'SPECIALIST TURN'과, LLM이 전체 토론을 생성하고 치료 권장안·수술 계획·임상시험 매칭에 합의하는 'BOARD SIMULATION'이다. 전체 요약 7문장 읽기 → 085 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 086 12:11 ▲ 106 · 댓글 80 모든 SaaS는 AI 모델을 감싸는 '하네스'로 진화한다 SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. AI · 머신러닝 · Every SaaS business will become a harness around a model
Key Point 현재 AI 모델 기반 스타트업과 기업들이 어떤 구조로 진화할 것인지, 소프트웨어 개발과 조직 운영의 근본적 전환을 설명하는 프레임워크다.
핵심 요약
SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. 소프트웨어 서비스 기업의 진화 경로는 전통적 SaaS → 엔지니어가 에이전트와 협력 → 클라우드 배경 에이전트들이 핵심 작업 수행 → 에이전트들이 주도적으로 의사결정하고 인간은 검증만 하는 단계로 진행된다. 최종적으로 회사 자체가 하네스가 되면 소프트웨어 생산 업무가 사람에서 하네스로 완전히 이동하고, 모든 조직원은 하네스의 일부가 된다. 전체 요약 9문장 읽기 → 087 09:11 ▲ 54 · 댓글 2 에이전트 학습 효율 높이는 'X-Tree' 알고리즘 개발 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
Key Point 에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다. 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다. 전체 요약 9문장 읽기 → 088 06:11 ▲ 10 · 댓글 2 쿼리의 의미를 먼저 파악해 최적 LLM 선택 기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. AI · 머신러닝 · SeLMRoute: Probabilistic Semantic Evidence for Large Language Model Routing
Key Point LLM 라우팅 결정에 의미론적 근거를 명확히 도입해 해석 가능성을 높이면서 성능을 기존 방식 대비 3% 이상 향상시킨 새로운 접근법이기 때문이다.
핵심 요약
기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. SeLMRoute는 의미론적 증거 추출, 모델 성능 학습, 배포 목표 적용을 분리하는 라우팅 프레임워크를 제시한다. 의사결정 모델이 쿼리의 추론 요구도, 외부 지식 사용 여부 등 해석 가능한 질문들을 먼저 확률 분포로 평가한다. 전체 요약 9문장 읽기 → 089 03:11 ▲ 26 · 댓글 2 엔터프라이즈 데이터 작업 평가 벤치마크 'Argo-Bench' 공개 기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. AI · 머신러닝 · Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
Key Point 엔터프라이즈 규모 데이터 시스템에서 AI가 쿼리 작성을 넘어 실제 의사결정까지 할 수 있는지 평가하는 첫 벤치마크이며, 현재 최강 모델도 35% 미만의 성공률로 데이터 에이전트의 현주소를 보여준다.
핵심 요약
기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. Argo-Bench는 뉴욕시 음식배달 플랫폼을 원탁 규모(2024년 주문 8,100만 건)로 시뮬레이션하고 Oracle E-Business Suite 스키마를 따른 235개 테이블, 75억 행의 ERP 웨어하우스를 모델링했다. 210개 데이터 과학·분석 작업으로 구성되며, 에이전트는 웨어하우스를 탐색해 사실을 재구성한 뒤 부정행위자 계정 차단, 배송원 인센티브 예산 할당, 소급 급여 지급 같은 실제 액션을 취해야 한다. 전체 요약 6문장 읽기 → 090 03:11 ▲ 184 · 댓글 63 클라우드플레어, 의사결정 특화 AI 모델 Clef 공개 클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. AI · 머신러닝 · Clef: Open-source decision models, and new RL fine-tuning platform
Key Point LLM의 비결정성과 느린 토큰 생성을 대체해 프로덕션 에이전트 워크플로우에서 실시간 의사결정이 필요한 개발자들에게 구체적인 선택지를 제공하며, 오픈소스 배포와 미세조정 플랫폼으로 커스터마이징 가능성을 연다.
핵심 요약
클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. 의사결정 모델은 입력에 따라 확률과 함께 타입이 지정된 구조화 출력을 생성해 에이전트가 자동으로 판단하고 실행하도록 돕는데, 예를 들어 고객 지원 메시지를 받아 긴급도와 담당팀을 분류한다. Clef는 이미지 분류도 가능한 비전 인코더를 갖춰 Jev(텍스트 분류만 지원)와 다르며, 64k 컨텍스트 윈도우(Jev는 32k)로 더 많은 입력을 처리할 수 있다. 전체 요약 12문장 읽기 → 091 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 → 092 18:11 ▲ 68 · 댓글 3 LLM 에이전트의 숨은 세계 모델을 끌어내는 훈련법 LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
Key Point LLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다. 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다. 전체 요약 9문장 읽기 → 093 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 094 12:11 ▲ 90 · 댓글 2 3D 세계의 이상을 찾아내는 AI 벤치마크 공개 3D 시뮬레이션 환경에서 부유하는 물체, 통과 가능한 벽, 맞지 않는 객체 등의 이상을 자동으로 감지하는 것이 중요해지고 있다. AI · 머신러닝 · WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents
Key Point 멀티모달 AI가 3D 환경 내 시각적 추론과 행동 탐색을 동시에 수행해야 하는 실제적 요구를 측정하는 벤치마크로, AI 모델의 공간 이해와 의사결정 능력의 격차를 정량화한다.
핵심 요약
3D 시뮬레이션 환경에서 부유하는 물체, 통과 가능한 벽, 맞지 않는 객체 등의 이상을 자동으로 감지하는 것이 중요해지고 있다. 비전-언어 모델(VLM)과 비전-언어-행동 모델(VLA) 같은 멀티모달 AI 시스템이 이 작업을 자동화할 가능성을 보여주고 있다. 3D 세계 감시는 행동 능력(3D 환경을 탐색하며 이상을 체계적으로 찾기)과 시각 추론 능력(환경을 이해하고 이상 식별)의 긴밀한 결합이 필요하다. 전체 요약 8문장 읽기 → 095 09:11 ▲ 12 · 댓글 2 중국어 의사결정형 AI 모델 'Chinese-Jev' 공개 System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. AI · 머신러닝 · Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
Key Point 생성형 LLM 중심의 AI 개발 흐름에서 빠른 의사결정 작업에 특화된 System One 모델의 필요성이 증대되고 있으며, 중국어 처리 시 모바일 기기까지 효율적으로 배포할 수 있는 구체적 솔루션이 제시되었다.
핵심 요약
System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. 기존 Jev 모델이 중국어 의사결정 정확도에서 제한이 있었기에, 통합 데이터 처리 및 학습 파이프라인으로 이를 보완했다. 이질적인 중국어 주석을 후보 선택지별 확률로 변환하는 데이터 처리 프로토콜을 개발해 도메인과 질문 형식 간 학습을 통일했다. 전체 요약 8문장 읽기 → 096 06:11 ▲ 23 · 댓글 2 멀티모달 AI의 계획 문제를 푼 증거 원장 기반 에이전트 비디오, 오디오, 웹페이지, 계산 결과 등 여러 모달리티의 증거를 조합해 질문에 답하는 옴니모달 에이전트는 대화 기록이 쌓이면서 노이즈가 증가하고 후속 결정이 방해받는 문제를 겪는다. AI · 머신러닝 · Omni-Decision: Evidence-Ledger Planning for Omni-Modal Agents
Key Point 멀티모달 에이전트의 계획 능력이 성능 제약의 핵심이며, 증거 원장 방식이 기존 대화 기반 접근법의 구체적인 해결책을 제시한다.
핵심 요약
비디오, 오디오, 웹페이지, 계산 결과 등 여러 모달리티의 증거를 조합해 질문에 답하는 옴니모달 에이전트는 대화 기록이 쌓이면서 노이즈가 증가하고 후속 결정이 방해받는 문제를 겪는다. 실험을 통해 성능 저하의 주요 원인이 지각(perception) 부분이 아니라 계획(planning) 부분임을 확인했다. Omni-Decision은 증거 원장(evidence ledger) 기반 계획 방식을 도입해, 누적된 대화 기록 대신 무엇이 확인됐는지, 무엇이 부족한지, 어디서 기록이 충돌하는지를 명시적으로 추적한다. 전체 요약 7문장 읽기 → 097 18:11 ▲ 69 · 댓글 1 다자간 음성대화 위한 상호작용 인식 메모리 프레임워크 제안 기존 연구는 1대1 텍스트나 이미지-텍스트 대화의 장기 메모리에 집중했으나, 다자간 음성대화에서의 장기 메모리는 미개척 상태다. AI · 머신러닝 · Beyond Dyadic Memory: Interaction-Aware Multimodal Memory with Adaptive Agentic Retrieval for Multi-Party Spoken Conversations
Key Point 다자간 음성대화에서 장기 메모리와 참여자 추적을 동시에 다루는 실질적인 프레임워크를 제시하며, 멀티모달 에이전트 시스템의 실용적 응용 가능성을 보여준다.
핵심 요약
기존 연구는 1대1 텍스트나 이미지-텍스트 대화의 장기 메모리에 집중했으나, 다자간 음성대화에서의 장기 메모리는 미개척 상태다. 다자간 음성대화에서는 대화 내용 보존, 세션 간 참여자 식별, 누가 누구에게 말하는지 추적하기가 필요하다. 연구팀은 VoxPolyMem을 제안했는데, 점진적 화자 식별과 상호작용 메모리·사실 메모리·참여자 프로필로 구성된 메모리 계층을 결합한 상호작용 인식 멀티모달 메모리 프레임워크다. 전체 요약 8문장 읽기 → 098 00:11 ▲ 135 · 댓글 60 추론으로 정확도를 높인 의사결정 모델 Jeeves 공개 PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. AI · 머신러닝 · Jeeves. Reasoning improves Jev-like decision models
Key Point 기존 Jev 계열 모델의 정확도 문제를 추론 과정 포함으로 해결하며, 테스트 데이터에서 실측 3~7% 성능 향상을 달성한 오픈소스 의사결정 모델로, 전체 학습 코드와 가중치를 공개해 재현과 확장이 가능하다.
핵심 요약
PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. SFT와 CISPO를 통해 훈련되었으며, 블록-4 디퓨전 드래프터를 포함한다. 미학습된 테스트 데이터에서 Kev-9B(0.822), Jev(0.857)를 상회하는 0.889의 정확도를 달성했으며, JevBench 공개 계층에서는 0.935(Jev 0.866 대비)를 기록했다. 전체 요약 13문장 읽기 → 099 15:11 ▲ 23 · 댓글 1 LLM 정렬을 위한 확산 기반 보상 모델 등장 기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. AI · 머신러닝 · Diffusion Reward Models
Key Point 인간의 다양한 판단 방식을 반영하는 새로운 보상 모델이 RLHF 학습에서 성능 개선을 직접 입증했기 때문에, LLM 정렬 연구에 실질적 영향을 미칠 수 있다.
핵심 요약
기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. 이를 해결하기 위해 Diffusion Reward Model(DRM)을 제안하며, 이는 보상 모델링을 조건부 밀도 추정 문제 p(r|x,y)로 재구성한다. DRM은 동결된 LLM 인코더를 기반으로 경량 Diffusion Transformer가 가우시안 노이즈를 보상 벡터로 제거(denoising)하며, 출력 분포에 대한 매개변수 가정 없이 자연스럽게 다중모달 구조를 표현한다. 전체 요약 8문장 읽기 → 100 15:11 ▲ 18 · 댓글 1 로봇이 경험 쌓아 스스로 진화하는 기초모델 프레임워크 기초모델을 단일 정책으로 보지 않고, 전체 시스템 자체를 진화하는 정책으로 취급하는 RoboFoundry를 제시한다. 기타 · RoboFoundry: System-as-Policy Evolution for Self-Learning Embodied Agents
Key Point 기초모델이 단순히 에이전트로 동작하는 것을 넘어 실행 경험으로부터 시스템 자체를 자동으로 개선할 수 있는 구조를 제시하는 것이 중요하며, 서로 다른 로봇 간 기능 전이가 가능해 구현의 실용성이 크게 높아진다. ai
핵심 요약
기초모델을 단일 정책으로 보지 않고, 전체 시스템 자체를 진화하는 정책으로 취급하는 RoboFoundry를 제시한다. 메모리 관리·문맥 처리·기술 조직·행동 인터페이스 등 에이전트 스택의 개별 요소들을 최적화하는 기존 방식과 달리, 실행 경험을 검증된 시스템 변화로 변환해 지속적으로 개선하는 방식이다. 맥락 시스템(활성 내부 문맥·파일시스템 메모리 관리)과 계층적 기술 시스템(원자적 기술·재사용 가능한 조합·실패 조건부 복구)이라는 두 가지 진화 표면을 갖추고 있다. 전체 요약 7문장 읽기 →