쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "예측"조건 지우기 ×
001 15:11 ▲ 23 · 댓글 1 모델이 스스로 배우는 시점을 판단하다 재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. AI · 머신러닝 · A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement
Key Point 모델 스스로 데이터를 생성하며 학습하는 자기개선 시스템에서, 언제 새 학습이 필요한지 자동으로 판단하는 기법이 벤치마크에서 성능 향상을 달성했기 때문이다.
핵심 요약
재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. 기존 방식들은 다음에 무엇을 학습할지에 집중했지만, 언제 새 경험을 도입할지는 충분히 다루지 않았다. 또한 자기 일관성이나 다수결로 학습 목표를 만들어 감독 신호가 모델의 불확실한 예측에 의존하는 문제가 있다. 전체 요약 9문장 읽기 → 002 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
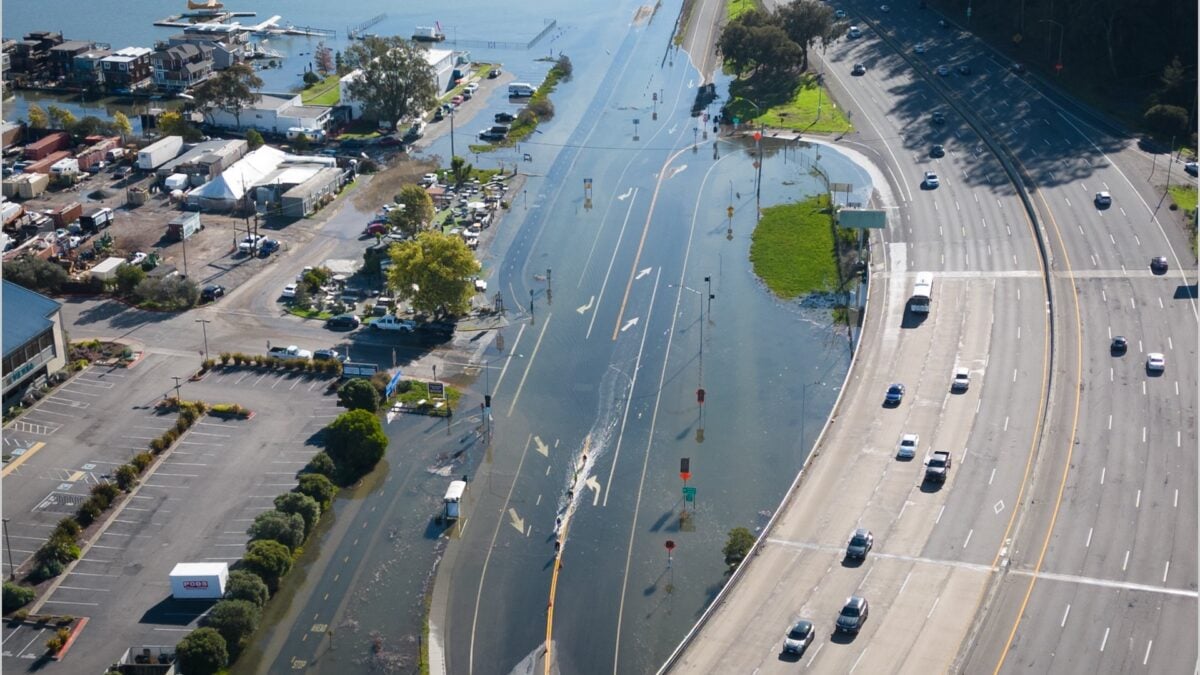
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 003 12:11 ▲ 108 · 댓글 38 엘니뇨·고조로 캘리포니아 해안 범람, 최고 조석은 아직 캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 하드웨어 · 시스템 · El Niño is flooding California's coasts with the highest tides to come
Key Point 캘리포니아 해안이 직면한 조수 범람 위기가 현재 이미 진행 중이며, 아직 올해 최고 조석이 오기 전이라는 점에서 이번 겨울의 재난 규모를 예측할 수 있는 시사점을 제공한다.
핵심 요약
캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 엘니뇨의 켈빈파로 인한 따뜻한 바닷물이 감사절·크리스마스 시즌에 심각한 피해를 줄 것으로 예측되며, 현재 샌프란시스코 베이에서 몬터레이까지 조수 범람이 발생하고 있다. 베이 에어리어의 월요일 고조는 10월 기록을 경신했고, 저지대 주민들이 고립되었으며, 소금물에 의한 배터리 합선으로 인한 전기차 화재 위험이 경고되고 있다. 전체 요약 10문장 읽기 → 004 06:11 ▲ 11 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 11 · 댓글 3 AI 에이전트가 검색할 가치를 판단하는 법 AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. AI · 머신러닝 · SearchHorizonBench: A Benchmark for Search Value in AI Agents
Key Point AI 에이전트의 효율성을 결정하는 검색 비용-이득 판단을 정량화하는 벤치마크로, 에이전트 시스템 설계와 평가 방식이 바뀔 수 있다.
핵심 요약
AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. 기존 답변 성공률은 질문의 난이도는 파악하지만, 검색의 추가 이득을 예측하지 못한다. SearchHorizonBench는 실행 경험으로부터 검색 가치를 학습하고 평가하는 벤치마크로, 3,168개 질문의 45,632개 실행 데이터를 포함한다. 전체 요약 9문장 읽기 → 006 03:11 ▲ 10 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 007 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
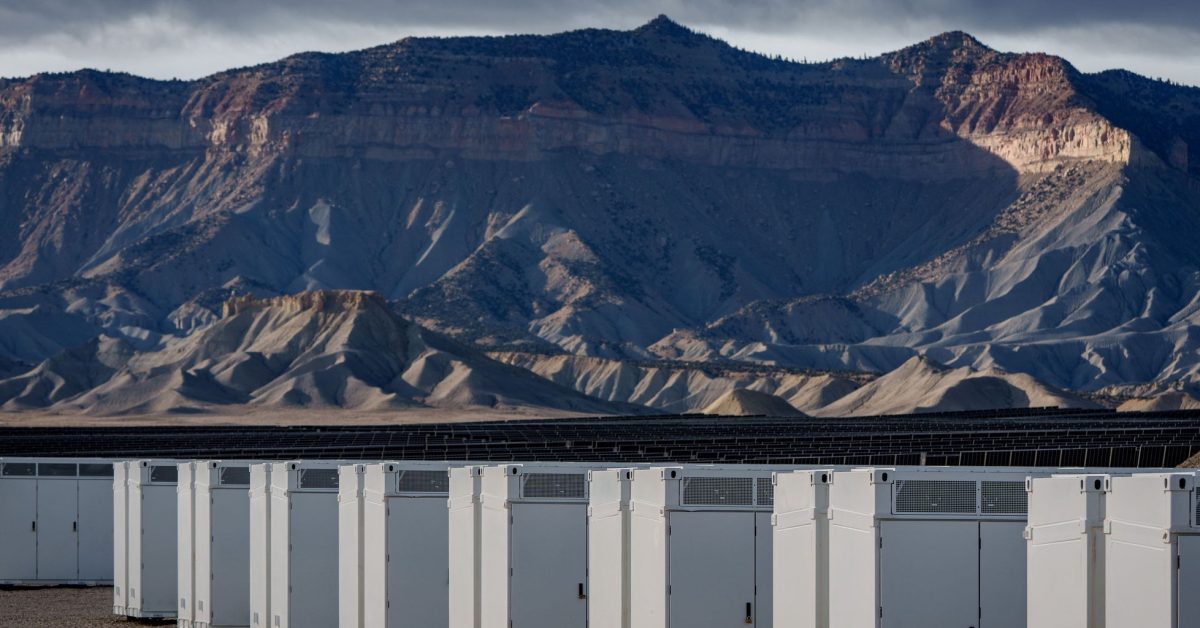
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 008 00:11 ▲ 189 · 댓글 120 미국 3개월간 배터리 저장소 20.2GWh 신규 설치, 사상 최대 미국은 2026년 2분기에 20.2GWh의 배터리 저장 용량을 신규 설치해 분기 최고 기록을 달성했으며, 올해 상반기 누적 설치량은 30.8GWh로 전년 동기 대비 23% 증가했다. 인프라 · 데브옵스 · The US added a record 20.2 GWh of battery storage in just 3 months
Key Point 전력망 안정성 강화와 에너지 수요 증가에 대응하는 배터리 저장소 투자가 미국 전역으로 확산되고 있으며, 이는 전력 인프라와 재생에너지 산업의 구조 변화를 시사한다.
핵심 요약
미국은 2026년 2분기에 20.2GWh의 배터리 저장 용량을 신규 설치해 분기 최고 기록을 달성했으며, 올해 상반기 누적 설치량은 30.8GWh로 전년 동기 대비 23% 증가했다. 유틸리티급 배터리가 성장을 주도했으며, 2분기 설치량 18GWh 중 애리조나 4곳, 캘리포니아 2곳, 유타 1곳의 기가와트급 규모 프로젝트가 포함되어 있다. 애리조나는 단일 주 기록인 6.2GWh를 설치했고, 텍사스 3.8GWh, 캘리포니아 3.6GWh를 추가했다. 전체 요약 12문장 읽기 → 009 18:11 ▲ 21 · 댓글 2 로봇 모델 평가, 비용 없이 미리 걸러낸다 로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. AI · 머신러닝 · Sensorimotor Alignment: A Platonic Proxy for Embodied Policy Success
Key Point 로봇 모델을 평가하는 데 드는 비용과 시간을 대폭 줄일 수 있는 방법이 제시되어, 로봇 AI 개발 파이프라인의 효율성이 크게 바뀔 수 있다.
핵심 요약
로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. 플라토닉 표현 가설(PRH)은 모델 능력이 높아질수록 비전·언어처럼 모달리티들이 현실의 같은 통계 모델로 수렴한다고 본다. 연구진은 움직임 궤적도 이런 모달리티인지 묻고, 감각 표현이 물리 운동의 구조와 얼마나 잘 맞는지 측정하는 S²(Sensorimotor Alignment) 지표를 만들었다. 전체 요약 8문장 읽기 → 010 12:11 ▲ 10 · 댓글 2 항공 영상에서 각진 상자 예측으로 객체 위치 파악 개선 항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. AI · 머신러닝 · OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
Key Point 항공 영상에서 임의 각도로 나타나는 객체를 정확히 찾는 것이 실제 필요한데, 기존 기법은 수평 상자만 지원해 성능이 크게 떨어진다는 문제를 해결했다.
핵심 요약
항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. Parallel Box Decoding(PBD) 방식을 확장해 4개 좌표 대신 6개 슬롯의 각진 표현을 사용했으며, 이중각도 매개변수화(double-angle parameterization) 기법을 적용했다. 이미지와 프롬프트를 섞는 제어실험, 가시성·누수 프로브를 통해 모델이 손실 곡선이 아니라 실제로 이미지와 텍스트 프롬프트 모두에 의존하는지 검증했다. 전체 요약 5문장 읽기 → 011 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 012 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 013 18:11 ▲ 149 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 014 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 015 18:11 ▲ 60 · 댓글 2 이산 토큰, 연속 표현 수준의 시각 정보 담을 수 있을까 이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. AI · 머신러닝 · Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
Key Point 이산 토큰 기반 시각 표현이 그동안 한계로 간주해온 의미 손실 문제를 실질적으로 극복했으며, 멀티모달 기초 모델의 구조 선택에 영향을 미칠 가능성이 있다.
핵심 요약
이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. 기존 가정과 달리, 양자화 오류 크기와 의미 손실 사이에는 신뢰성 있는 상관관계가 없으며, 오류가 크더라도 더 나은 이해 성능을 낼 수 있다. 이산 토큰의 실질적인 비트 예산이 다운스트림 성능의 주요 결정 요소로 나타났으며, 기존 양자화기는 코드북이 증가할수록 의미 정보 기여도가 감소해 포화 현상이 발생한다. 전체 요약 8문장 읽기 → 016 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 017 12:11 ▲ 11 · 댓글 2 전문가와 AI 에이전트의 협업, 새로운 벤치마크로 측정한다 인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. AI · 머신러닝 · Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows
Key Point AI 에이전트의 자동화 능력은 계속 늘어나지만, 현실의 업무는 인간과의 지속적인 협업을 필요로 하며, 기존 벤치마크로는 이를 측정할 수 없다는 근본적인 문제를 다룹니다.
핵심 요약
인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. 기존 자동화 벤치마크는 에이전트가 한 번에 작업을 완료하는 능력에 집중하지만, 실제 워크플로우에서 전문가는 계획 수정 등 지속적인 상호작용을 더 중요하게 봅니다. 전문 업무 워크플로우는 여러 상호의존 단계로 이루어져 있어, 협업 에이전트에게 실제로 필요한 두 가지 능력을 도출했습니다: 전문가가 자신의 제안을 채택·수정·거절할지 예측하기, 그리고 지속적인 피드백 없이 협업 품질을 평가하기입니다. 전체 요약 7문장 읽기 → 018 12:11 ▲ 26 · 댓글 2 LLM 환각 탐지 벤치마크 비교 불가능한 이유 대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. AI · 머신러닝 · Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
Key Point LLM 성능을 평가하는 핵심 지표인 환각 탐지가 벤치마크마다 다르게 정의되고 측정되기 때문에, 어떤 방법이 실제로 더 나은지 판단할 수 없다는 문제를 드러낸다.
핵심 요약
대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. 연구팀은 환각 탐지를 벤치마크 조건부 측정 문제로 보고, 세 가지 축으로 기존 벤치마크들을 분류했다: 모델 출력과 근거 조건을 어떻게 얻는지를 설명하는 '출처', 사실성과 충실성 오류를 어떻게 정의하는지를 나타내는 '유형분류', 환각을 어떤 단위로 주석·예측·평가하는지를 명시하는 '단위'이다. 벤치마크 구성, 주석 방식, 평가 방법의 차이가 예측 작업에 어떻게 영향을 미치고, 탐지기의 메커니즘과 가정이 어떤 조건에서 성능을 보이는지를 분석했다. 전체 요약 5문장 읽기 → 019 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 46 · 댓글 2 확산 언어 모델의 추측 디코딩 가속화 기법 SPOT 제안 확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. AI · 머신러닝 · On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
Key Point 확산 언어 모델의 속도 문제를 해결하는 새로운 추측 디코딩 기법으로, 토큰 위치 순서 예측이라는 핵심 인사이트를 통해 정확성을 유지하면서 6배 이상의 가속화를 달성했으며, 학습된 드래프터가 여러 모델에 전이 가능해 실용성이 높다.
핵심 요약
확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. 정확한 디코딩은 모델 패스당 하나의 마스킹된 위치만 채우고, 빠른 멀티토큰 디코딩은 품질 손실이 발생한다. 추측 디코딩은 자동회귀 모델의 표준 가속 기법이지만 DLM에 직접 적용되지 않는데, DLM은 무엇을 생성할지뿐 아니라 어디에 생성할지를 선택해야 하기 때문이다. 전체 요약 11문장 읽기 → 021 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 022 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
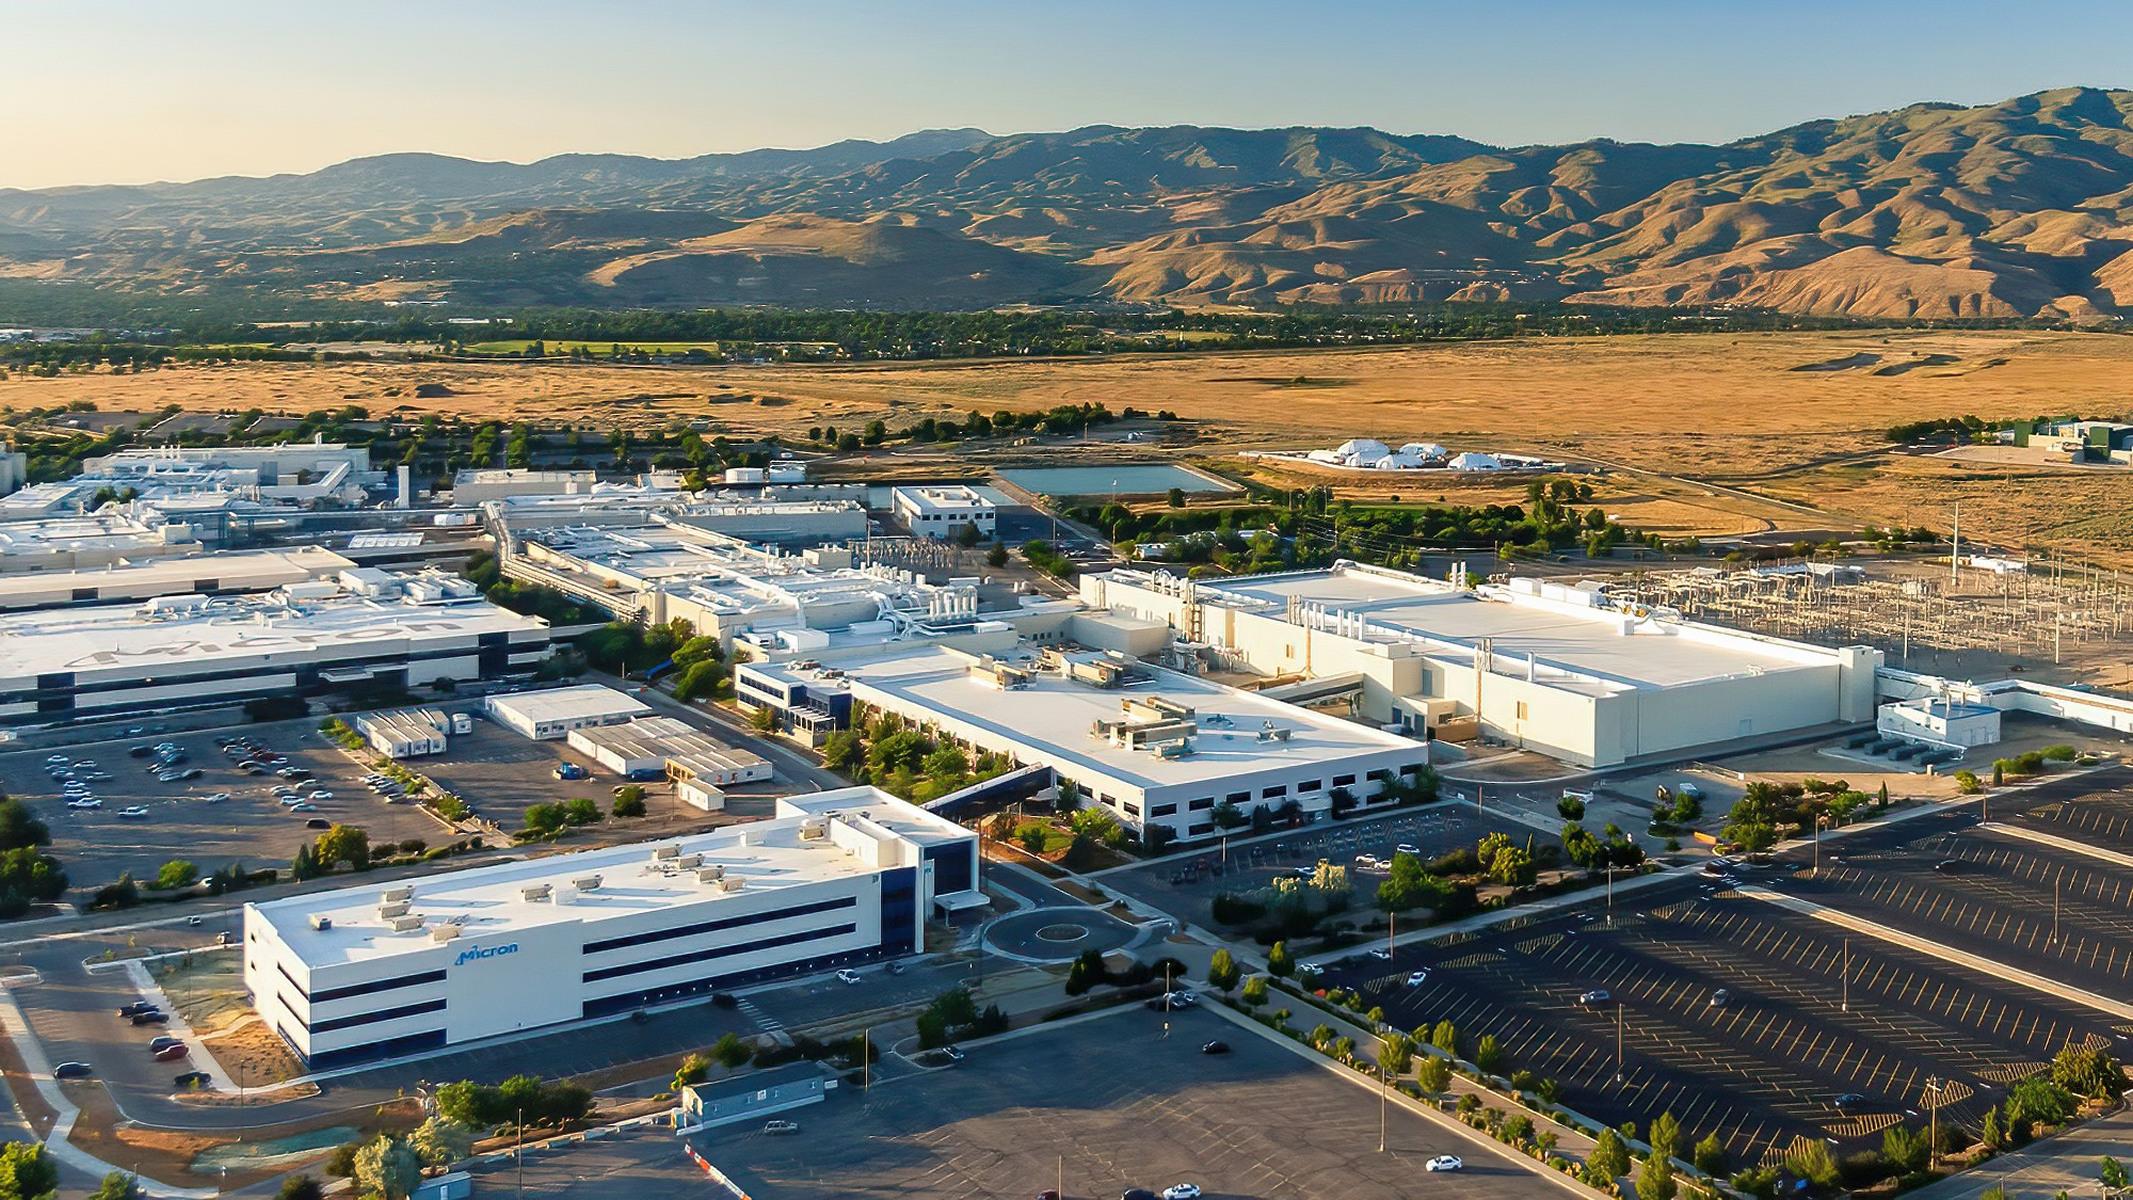
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 023 06:11 ▲ 114 · 댓글 17 마이크론이 4F² DRAM 포기, 3D 메모리로 방향 선회 마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. 하드웨어 · 시스템 · Why Micron Is Suddenly Ditching 4F² DRAM as Rivals Double Down
Key Point 경쟁업체들이 4F² DRAM에 투자할 때 마이크론만 반대 방향으로 가는 이유와, DRAM 미세화의 물리적 한계가 어디까지인지 이해할 수 있다.
핵심 요약
마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. DRAM 밀도는 셀 면적보다 커패시터 간격에 의해 결정되는데, 6F²에서 4F²로 축소해도 밀도 개선 효과가 미미하면서 비용과 복잡도만 급증한다. 마이크론은 1δ(델타) 고밀도 메모리 양산에 박차를 가하고 있으며, 1ε(엡실론)에서는 첨단 웨이퍼 본딩 기술을 적용한다. 전체 요약 8문장 읽기 → 024 03:11 ▲ 16 · 댓글 2 슬라이더로 이미지 편집 강도 미세 조종하기 이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. AI · 머신러닝 · SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
Key Point 이미지 편집에서 사용자가 원하는 강도를 정밀하게 조절할 수 있는 방법이 개선돼, 생성형 이미지 편집 도구가 더 직관적이고 빠르게 동작하게 된다.
핵심 요약
이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. 논문은 이 문제를 체계적으로 연구하기 위해 다양한 편집 카테고리를 포함한 종합 벤치마크 SlideBench를 제시했으며, 단조성·지각적 연속성·슬라이더 간 독립성을 측정하는 통일된 평가 지표를 제공한다. SliderEdit++는 편집 궤적의 양 끝점만 지도하는 기존 방식 대신 중간 과정의 궤적을 명시적으로 정규화한다. 전체 요약 6문장 읽기 → 025 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 026 03:11 ▲ 433 · 댓글 141 트럼프 행정부, 미국인 감시 방식 담은 비밀 법원 판결 공개 거부 민주당 상원의원 2명이 트럼프 행정부가 적법 절차 없이 미국인 통신을 감청할 수 있게 하는 프로그램(FISA 702조) 재승인 압박용으로 법원 판결을 의도적으로 숨기고 있다고 주장했다. 보안 · The US government is hiding secret court ruling about how it spies on Americans
Key Point 미국 정부가 국내 감시 권한의 법적 문제점을 담은 판결을 숨기면서, 의회 투표 앞에 필수 정보 공개를 거부하고 있는 상황이다.
핵심 요약
민주당 상원의원 2명이 트럼프 행정부가 적법 절차 없이 미국인 통신을 감청할 수 있게 하는 프로그램(FISA 702조) 재승인 압박용으로 법원 판결을 의도적으로 숨기고 있다고 주장했다. 외국정보감시법원(FISA Court)은 7개월 전 정보 분석가들이 승인·기록 없이 미국인 메시지를 추출하는 검색 필터를 문제 삼았고, 법원 판결은 공개되지 않고 있다. 행정부 자체 정책에 따르면 이런 판결은 발행 후 180일 내에 공개해야 하는데, 9월 13일 기한이 지났다. 전체 요약 12문장 읽기 → 027 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 028 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 029 18:11 ▲ 16 · 댓글 2 AI 텍스트 판별기를 해석 가능하게 만드는 방법 동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. AI · 머신러닝 · Building Auditable AI Text Detectors with Sparse Autoencoders
Key Point AI 생성 텍스트 판별기의 검은 상자 문제를 해결하고, 높은 성능과 투명성을 동시에 확보할 수 있는 새로운 방법론을 제시해 교육·저널리즘·입시 등 중요한 영역에서의 신뢰성을 높인다.
핵심 요약
동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. 현재 가장 성능 좋은 판별기는 미세 조정된 신경망 분류기인데, 의사결정 과정이 불투명하며, 투명한 대안인 문체 및 언어적 특성 분류기는 성능이 훨씬 낮다. 연구팀은 미세 조정된 신경망 판별기를 인간이 읽을 수 있는 개념으로 작동하는 분류기로 변환하는 파이프라인을 제시했다. 전체 요약 7문장 읽기 → 030 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 031 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 032 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 033 09:11 ▲ 170 · 댓글 52 크로스 플랫폼 AI 키잉 플러그인 CorridorKey 2.0 출시 Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. 오픈소스 · 도구 · CorridorKey 2.0
Key Point VFX 제작자들이 값비싼 소프트웨어 구독을 벗고 한 번의 구매로 주요 편집 도구 전역에서 프로급 자동 키잉을 쓸 수 있게 되는 만큼 워크플로우를 재편할 수 있다.
핵심 요약
Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. AI 기반 자동 키잉으로 초록색·파란색 배경 제거가 한 클릭으로 가능하며, 크로스페이드나 반투명 객체의 색상까지 예측해 처리한다. 기존 도구와 달리 영상의 전체 프레임을 분석하는 시간 인식 기능으로 프레임 간 깜박임(flicker)과 떨림을 제거한다. 전체 요약 8문장 읽기 → 034 03:12 ▲ 16 · 댓글 3 흐름 매칭으로 음악 분리하는 생성형 모델 FLOMSS 음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. AI · 머신러닝 · FLOMSS: Generative Music Source Separation by Flow Matching
Key Point 음악 분리라는 오디오 처리의 핵심 작업에 생성형 AI 패러다임(flow matching)을 적용한 사례로, 판별적 방식 중심의 기존 접근을 재검토하고 성능을 검증한 결과물이다.
핵심 요약
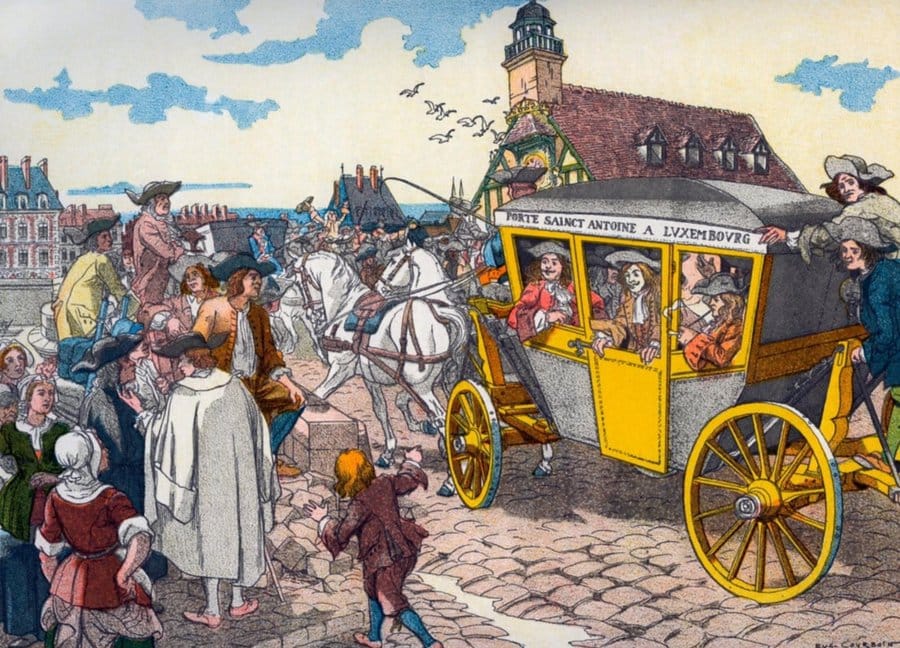
음악 소스 분리(MSS)는 보컬, 베이스, 드럼, 기타 등 네 가지 신호원을 분리하는 작업이며, 전통적으로 판별적 방식으로 처리되어 왔다. flow matching은 복잡한 데이터 분포를 모델링하는 생성형 패러다임으로 여러 분야에서 성공 사례가 나오고 있어 음악 분리에 적용할 가치가 있다. 연구팀은 flow matching을 음악 분리에 적용하면서 예측 대상(prediction targets), 흐름 경로(flow paths), 단일 소스 대 다중 소스 모델링, 혼합 일관성 제약 등을 체계적으로 조사했다. 전체 요약 5문장 읽기 → 035 03:12 ▲ 202 · 댓글 96 파스칼이 정한 노선 대중교통을 발명하다 1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 기타 · Blaise Pascal invented fixed route public transport (2024)
Key Point 역사적으로 가장 중요한 도시 운송 혁신이 정부 정책이나 기술 기업이 아닌 수학자의 기하학적 사고에서 비롯되었다는 점과, 공학적 우월성보다 사회 포용성이 대중교통 성패를 결정한다는 인사이트를 배울 수 있다.
핵심 요약
1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 8명 탑승 가능한 말 끌기 마차 5대가 예측 가능한 주기(7.5~15분)로 여러 연결 노선을 운행했다. 파스칼의 네트워크는 현대 버스, 전차, 열차의 직접적인 선조이며, 육지에서 고정 노선 대중교통의 첫 시례였다. 전체 요약 9문장 읽기 → 036 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 037 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 038 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 039 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
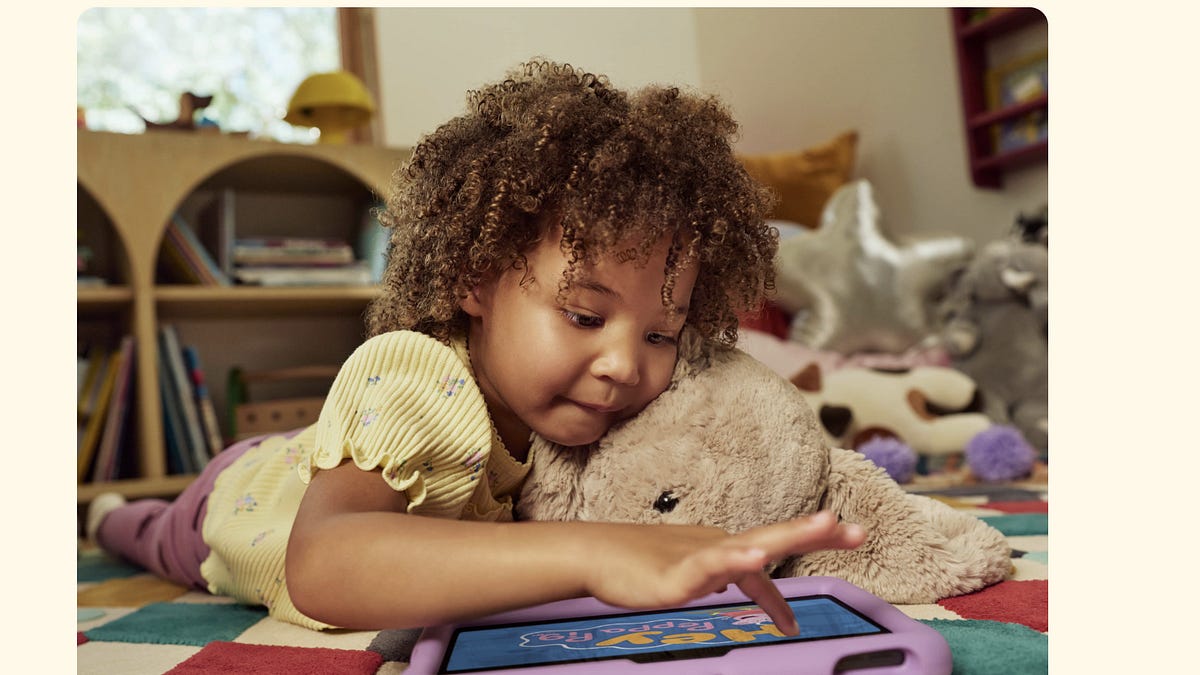
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 040 12:11 ▲ 109 · 댓글 163 아마존의 영유아용 태블릿, 발달 문제 우려 속 출시 아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 스타트업 · 비즈니스 · Amazon's "digital pacifier" for toddlers
Key Point 영유아 발달을 위해 의도적으로 피해야 할 활동을 상품으로 만들어 마케팅하는 기업의 실태와 그 영향을 보여주며, 부모들이 선택할 때 고려해야 할 과학적 근거들을 제시합니다.
핵심 요약
아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 미시간 대학 소아과 의사 제니 래드스키 교수는 태블릿이 아이의 "항상 곁의 친구" 역할을 해 행동 관리와 진정 용으로 활용되는 것이 문제라며, 동봉된 손잡이가 일상적 휴대를 의도한 설계라고 지적했다. 제너레이티브 AI 기능(이미지 생성, 이야기 만들기)을 포함한 아마존의 '창의적' 마케팅은 아이들의 독립적 사고력을 해칠 수 있다고 우려했다. 전체 요약 12문장 읽기 → 041 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 042 12:11 ▲ 14 · 댓글 8 자연어 정책을 신경기호 프로그램으로 컴파일하는 SCOPE LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. AI · 머신러닝 · SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
Key Point 정책 집행의 정확도·안정성·비용·해석 가능성을 동시에 해결하는 신경기호 접근법이 저렴한 모델에서도 대규모 언어모델 수준의 성능을 낼 수 있음을 보여준다.
핵심 요약
LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. 미세 조정한 가드레일 모델은 빠르지만 복합 정책에서 성능이 저하되고, LLM-as-a-judge는 높은 정확도를 달성하지만 추론 비용이 높고 예측이 불안정하다. SCOPE는 정책을 신경 술어, 결정적 추출기, 이들의 출력을 조합하는 코드로 이루어진 실행 가능한 프로그램으로 컴파일한다. 전체 요약 8문장 읽기 → 043 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 045 06:11 ▲ 106 · 댓글 57 Dream-1, 미세조정 없이 새 로봇 제어하는 범용 로봇 정책 공개 Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. AI · 머신러닝 · Dream-1
Key Point 기존 로봇은 각 기종마다 별도 데이터와 미세조정이 필요했지만, Dream-1은 처음 보는 로봇을 즉시 제어할 수 있어 로봇 개발자와 스타트업의 진입장벽을 크게 낮춘다.
핵심 요약
Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. Dream-1은 이전에 본 적 없는 로봇, 작업, 환경에서 제로샷 일반화가 가능하며, 미세조정이나 로봇별 데이터 수집 없이도 작동한다. 로봇팔 비용이 $2k까지 하락하고 하양이 $399짜리 마이크로덕 4일간 1만 대 이상 판매되면서 대중용 로봇 시장이 성장 중이다. 전체 요약 13문장 읽기 → 046 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 047 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 048 09:11 ▲ 102 · 댓글 88 UUIDv7, 생각보다 신뢰할 수 없다 UUIDv7은 단조증가 ID, 정확한 타임스탬프, 예측 불가능성을 제공한다고 알려져 있지만 RFC 호환 구현 중 많은 것이 이 속성들을 위반한다. 인프라 · 데브옵스 · UUIDv7 doesn't have the properties you think it does
Key Point 구현 선택에 따라 단조성, 정확한 타임스탐프, 보안성이 보장되지 않을 수 있으므로 UUIDv7 사용 시 각 구현의 실제 동작과 제약을 파악해야 한다.
핵심 요약
UUIDv7은 단조증가 ID, 정확한 타임스탬프, 예측 불가능성을 제공한다고 알려져 있지만 RFC 호환 구현 중 많은 것이 이 속성들을 위반한다. RFC 9562는 타임스탬프를 시스템 시계에서 직접 유도하지 않고 임의로 변경하도록 허용하기 때문에, UUID에 내장된 타임스탐프가 객체 생성 시간과 맞지 않을 수 있다. Python 표준 라이브러리의 uuid7()은 카운터 오버플로우 시 타임스탬프를 미리 증가시키는데, 시스템 클록이 역행하면 타임스탬프가 시스템 시간보다 임의로 크게 앞서갈 수 있다. 전체 요약 12문장 읽기 → 049 00:11 ▲ 106 · 댓글 78 AI 연구자들, 은퇴 계획 포기하는 유토피아 믿음 저자는 핵무기 역사 관련 서적 《Doomsday Machine》을 읽으며 1950년대 RAND 연구소의 분위기를 발견한다. AI · 머신러닝 · No Need for Retirement When Utopia Is Around the Corner
Key Point 냉전 시대 핵무기 개발 진영의 신념 체계가 현재 AI 산업의 구조적 문제와 어떻게 반복되는지 보여주는 사례 연구로, AI 업계의 열정과 확신이 고용 관행과 직원 대우에까지 미치는 영향을 비판한다.
핵심 요약
저자는 핵무기 역사 관련 서적 《Doomsday Machine》을 읽으며 1950년대 RAND 연구소의 분위기를 발견한다. 당시 과학자들은 소련의 핵 능력 우위라는 위기감 속에서 종말론적 예측을 했고, 세계 구원이라는 초월적 사명감으로 공동체를 형성했다. RAND 연구소의 젊은 연구원들, 특히 Alain Enthoven과 저자는 핵전쟁이 임박했다고 믿고 은퇴 연금 계획에 가입하지 않았다. 전체 요약 7문장 읽기 → 050 21:11 ▲ 12 · 댓글 2 합창 오디오를 성부별로 자동 기록하는 AI 모델 등장 기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. AI · 머신러닝 · Toward Part-Aware Choral Transcription with singing voice assignment
Key Point 합창 악보를 성부별로 정확히 기록할 수 있게 되면 학생 악단 연습, 악보 출판, 원곡 복원 등이 더 효율적으로 가능해진다.
핵심 요약
기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. 새로운 'PawCT' 모델은 합창 오디오를 입력받아 활성화된 SATB 성부를 먼저 식별한 뒤, 각 성부를 별도의 음표 레벨 트랙으로 자동 기록한다. 성부별 음의 시작·종료·유지 시점 예측과 성부 포함 여부 추정을 함께 진행하며, SATB 음역대 사전 정보(RP)와 성부 내 선율 연속성·성부 간 음정 순서를 반영하는 확장 기법(OC)을 적용한다. 전체 요약 6문장 읽기 → 051 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 052 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 053 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 054 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 055 18:11 ▲ 184 · 댓글 2 이미지를 편집 가능한 레이어로 자동 분해하는 AI 명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. AI · 머신러닝 · Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Key Point 이미지 편집 결과를 재편집 가능한 레이어로 자동 분해해 주므로 디자인 도구나 영상 제작 워크플로우에서 후속 수정이 훨씬 유연해진다.
핵심 요약
명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순서가 정해진 RGBA 레이어들을 단일 토큰 시퀀스로 표현하여 의미 있는 편집과 개별 레이어 조작을 가능하게 한다. Compositional Edit-Prior Distillation 기법으로 기존 모델의 편집 능력을 유지한 채 계층화된 출력으로 적응시킨다. 전체 요약 7문장 읽기 → 056 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 057 18:11 ▲ 113 · 댓글 115 같은 AI 요청, 텍사스가 스웨덴의 8.5배 CO₂ 배출 스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. AI · 머신러닝 · The same AI request emits 8.5 times more CO2 in Texas than in Sweden
Key Point 데이터센터의 위치에 따라 같은 AI 모델도 배출량이 8배 이상 차이나는 현실을 처음 투명하게 계산·공개한 방법론이 나왔으므로, AI 서비스 구매자와 제공업체들이 실제 수치로 비교하고 선택할 수 있는 기준이 생겼다.
핵심 요약
스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. 동일한 하드웨어에서 Kimi K3 모델에 대한 일반적인 요청은 스웨덴에서 약 0.4g CO₂, 아일랜드 1.6g, 독일 2.5g, 텍사스 3.2g를 배출하며, 전력망 구성과 시간대, 캐싱 여부에 따라 각 요청마다 개별 계산된다. Berget AI는 위치 기반 수치를 보고하며 서버 운영 지역의 평균 전력망 구성을 사용하고 하드웨어 제조 배출량을 포함한다. 전체 요약 11문장 읽기 → 058 18:11 ▲ 159 · 댓글 97 자연언어 프로그래밍은 왜 실패하는가 1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 오픈소스 · 도구 · The foolishness of "natural language programming" (1978)
Key Point 프로그래밍을 인간언어로 하면 더 쉬워질 것이란 아이디어가 왜 근본적으로 실패할 수밖에 없는지를 형식 체계의 역사와 논리로 설명한 고전 논문이다.
핵심 요약
1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 초기 컴퓨팅 시대부터 프로그래머들은 형식적 기호 체계의 엄격함을 단점으로 느꼈고, 기계가 모순된 명령도 충실히 실행하는 것을 문제 삼았다. 고급 프로그래밍 언어 개발로 명백한 실수는 에러 메시지를 내보내게 되어 개선됐지만, 프로그래밍의 형식성 요구는 여전했다. 전체 요약 12문장 읽기 → 059 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 060 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 061 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 062 06:11 ▲ 114 · 댓글 47 심해 화산으로 전력을 만들다, 스타트업의 첫 성공 시애틀 스타트업 엔듀어런스 에너지가 태평양 액시얼 해산 부근 5천 피트 심해에서 해저 지열발전소 프로토타입을 3주간 시험했다. 스타트업 · 비즈니스 · Startup taps underwater volcano as energy source in “proof point” test
Key Point 해저 지열발전이 기술적으로 작동 가능함을 처음 입증했으며, 섬나라와 외딴 지역의 에너지 독립성을 바꿀 수 있는 신재생에너지 옵션이 나타났기 때문이다.
핵심 요약
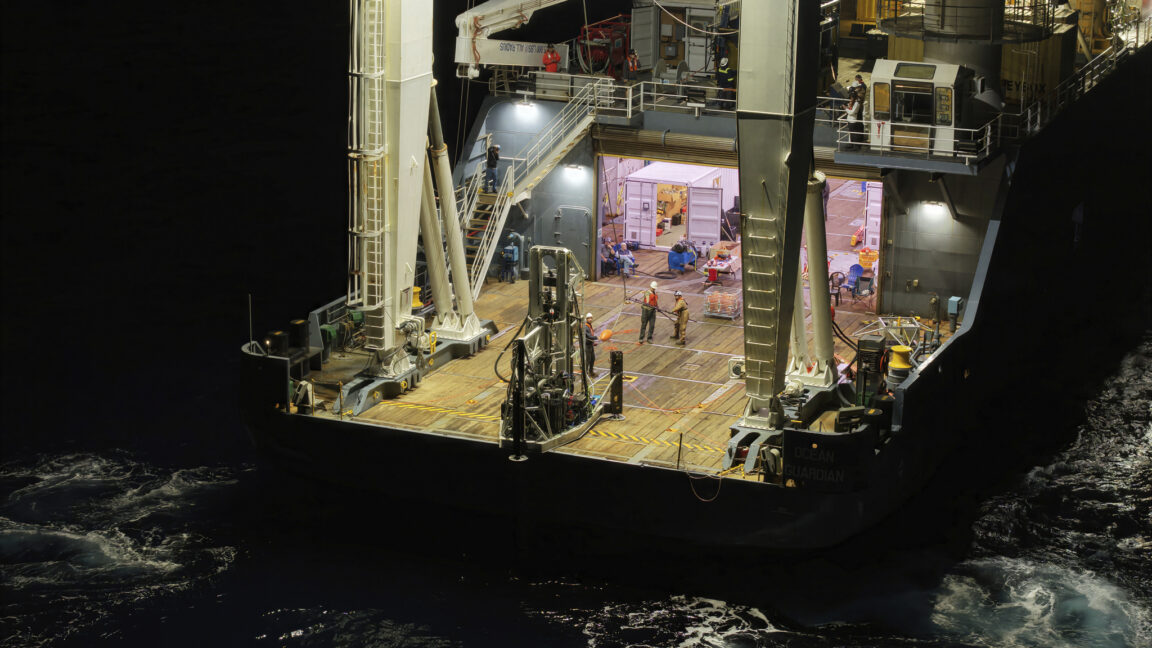
시애틀 스타트업 엔듀어런스 에너지가 태평양 액시얼 해산 부근 5천 피트 심해에서 해저 지열발전소 프로토타입을 3주간 시험했다. 100킬로와트 규모의 '애들리' 발전소는 500°F(260°C)의 열수 유체를 기화시켜 터빈을 돌리고 전기를 생성하도록 설계됐다. 9월 27일 시험에서 터빈이 26,000rpm에 도달했고, 약 8.7초 동안 발전소가 자체 운영에 필요한 전력보다 더 많은 전력을 생성(최대 16.5킬로와트)하는 순증가 상태에 도달했다. 전체 요약 9문장 읽기 → 063 03:11 ▲ 19 · 댓글 2 스스로 개선하는 AI, 살아있는 환경에서 진화한다 현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. AI · 머신러닝 · Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
Key Point 모델이 외부 업데이트 없이 자신의 경험으로 지속적으로 개선되는 구조를 실제로 구현해 검증했으며, AI 훈련 패러다임의 근본적 전환을 제시한다.
핵심 요약
현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. 미래 이벤트 예측에 기반한 자기진화 에이전트 시스템 'DeepEvolve'를 개발했으며, 에이전트가 지속적으로 변화하는 환경과 상호작용하면서 경험을 내재화·외재화하여 개선된다. 검증 가능한 작업을 합성하는 살아있는 환경과 각 예측 뒤의 추론 궤적을 능력으로 변환하는 순환진화 엔진으로 구성되며, 탐색을 예측으로부터 분리하여 파라미터 수준의 진화를 오염 위험이 있는 라이브 환경에 맞춘다. 전체 요약 8문장 읽기 → 064 03:11 ▲ 31 · 댓글 2 추천 모델, 각 아이템별로 계산량 다르게 할당 기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. AI · 머신러닝 · Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
Key Point 추천 시스템의 계산 효율을 각 아이템의 중요도에 맞춰 동적으로 조정하는 새로운 접근법을 제시하며, 실제 모든 백본 아키텍처에서 성능 향상을 입증했다.
핵심 요약
기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. 논문은 두 가지 핵심 진단을 제시한다: (1) 동일 시퀀스 내 아이템들이 필요한 계산량이 큰 차이가 있으며, 대부분은 얕은 처리로 수렴하지만 일부 중요 아이템은 최대 깊이에서만 안정화된다. (2) 고정 할당은 최적이 아니어서 이미 수렴한 아이템의 계산 용량을 낭비하면서 동시에 전체 추천 품질을 손상시킨다. 이를 해결하기 위해 LoopRec을 제안한다. LoopRec은 단일 가중치 공유 블록을 반복 적용하고 각 반복 경계에 경량 게이트를 도입해 개별 아이템마다 계속 진행할지 종료할지 이진 결정을 내린다. 전체 요약 8문장 읽기 → 065 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 066 21:11 ▲ 174 · 댓글 2 GUI 에이전트의 공격 탐지, 화면 아닌 '전환' 검증이 핵심 GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. AI · 머신러닝 · Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
Key Point GUI 자동화 에이전트가 확산되는 상황에서 화면 자체가 아닌 '상태 전환'을 검증하는 새로운 보안 접근이 기존 월드 모델 기반 방법보다 훨씬 빠르고 정확하다는 점이 주목된다.
핵심 요약
GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. 기존 GUI 월드 모델은 다음 상태를 텍스트·코드·이미지로 출력해 검증 시 별도 모델로 비교해야 하는데, 이는 비효율적이다. LGWM이라는 디코더 없는 액션 조건부 월드 모델을 제안했으며, 185만 개 실제 GUI 전환 데이터로 의미론적 주석 없이 학습했다. 전체 요약 8문장 읽기 → 067 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 068 21:11 ▲ 116 · 댓글 61 LLM의 신뢰도 점수는 신뢰할 수 없다 LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. AI · 머신러닝 · Using LLM for confidence scoring is a bad idea
Key Point LLM이 생성한 신뢰도 점수는 단순 텍스트 생성일 뿐 실제 확률을 반영하지 않으므로, AI 에이전트의 신뢰성을 검증해야 하는 개발자들이 알아야 할 근본적인 한계다.
핵심 요약
LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. 신뢰도란 예측이 얼마나 정확한지를 나타내는데, 이는 과거 정보와 현재 증거를 바탕으로 한 계산이어야 한다. 신뢰도 점수의 정확성은 같은 조건의 많은 사례에서 예측 확률과 실제 발생률이 일치하는지(보정도)로만 측정할 수 있다. 전체 요약 9문장 읽기 → 069 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 070 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 071 15:11 ▲ 26 · 댓글 2 세 가지 능력을 하나로 담은 시각 인코더 ALPS 공개 World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. AI · 머신러닝 · ALPS: Visual State Encoders for World Models
Key Point 월드 모델의 비전 백본이 예측, 제어, 검증을 모두 지원할 수 있는 통합 인코더를 처음 제시하여 로봇 학습 파이프라인의 설계 방식을 바꿀 수 있다.
핵심 요약
World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. 기존 인코더는 이 세 가지 중 하나나 둘만 담당하는 반면, ALPS는 ViT-B/16 기반 프리트레인된 시각 상태 인코더로 세 능력을 모두 통합한다. 정지 이미지와 텍스트만 사용하여 언어, 재구성, 공간적 대응 목표로 처음부터 학습한 후 교차 뷰 자기 증류로 미세 조정했다. 전체 요약 7문장 읽기 → 072 15:11 ▲ 22 · 댓글 2 멀티모달 에이전트, 로봇 제어로 확장할 때 뭐가 달라지나 멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. AI · 머신러닝 · Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
Key Point 컴퓨터 조작 AI와 로봇 제어의 근본적 차이를 정의하고, 로봇 에이전트 개발 시 현재 벤치마크가 놓친 부분을 지적해 향후 평가 방식 개선의 방향을 제시한다.
핵심 요약
멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. 멀티모달 임보디드 에이전트(MMEA)를 정의하면, 멀티모달 작업 추론을 물리 동작과 결합하고 그 결과 피드백으로 결정을 수정하는 목표 지향 시스템이다. 논문은 PAPAV라는 통합 프레임워크를 제시하며, 인식(Perceive)·예측(Anticipate)·계획(Plan)·행동(Act)·검증(Verify)의 5가지 반복 기능으로 세 시스템을 비교한다. 전체 요약 6문장 읽기 → 073 15:11 ▲ 158 · 댓글 2 자동회귀 동영상 생성에 미래 청크 예측 더하기 자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. AI · 머신러닝 · Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 시간적 진화를 제대로 모델링하는 훈련 기법이 기존 방식보다 적은 계산량으로 물리적 타당성을 높이는 방법을 제시했다.
핵심 요약
자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. 교사 강제(teacher forcing) 훈련에서 강한 시간적 중복성이 로컬 시각 연속성을 지름길 삼아 실제 시각 진화 모델링 압력을 감소시킨다. 연구팀은 Future Chunk Prediction(FCP)라는 보조 목표함수를 제시했으며, 이는 교사 강제 디노이징과 함께 학습된다. 전체 요약 7문장 읽기 → 074 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 075 03:11 ▲ 12 · 댓글 2 효율적인 흐름 모델로 LLM 병렬 생성 실현 연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. AI · 머신러닝 · Large Flow Language Models
Key Point 병렬 생성과 더 빠른 추론이 가능한 흐름 모델이 대규모 언어 모델에서 실질적으로 작동하는 것을 처음 입증했으며, 기존 자동회귀 모델보다 2.5배 빠른 처리 속도로 같은 품질을 낸다는 점이 생성 AI 구조의 근본적 전환을 시사한다.
핵심 요약
연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. 라파(Lafa)는 80억 개 매개변수 규모의 흐름 언어 모델로, 30B 토큰 미만으로 학습되어 이전 확산 모델보다 효율적이다. 블록 단위 흐름 모델 설계로 접두사에는 인과 관계 어텐션, 각 블록 내에는 양방향 비동기 흐름을 적용한다. 전체 요약 10문장 읽기 → 076 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 077 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 078 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 079 18:11 ▲ 25 · 댓글 2 LLM 활용해 3D 부품 조립 성능 대폭 향상 3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. AI · 머신러닝 · LLM2R: From Large Language Models to 3D Reassemblers
Key Point 대규모 부품을 가진 3D 조립 작업에서 기존 방식의 확장성 문제를 LLM 기반 접근으로 근본적으로 해결하고, 복잡한 기하학적 추론을 단일 forward pass로 처리할 수 있는 새로운 가능성을 제시한다.
핵심 요약
3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. 기존 방식은 부품 쌍의 관계에 의존하거나 반복 생성-검증을 사용해 많은 부품을 가진 물체에서 확장성이 떨어진다. LLM2R은 부품 조립을 sequence modeling 문제로 재정의하며 사전학습된 decoder-only LLM을 활용한다. 전체 요약 10문장 읽기 → 080 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 081 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 082 16:56 ▲ 146 · 댓글 81 영국 통신청, 4chan 제재 포기 선언 영국의 방송통신청(Ofcom)이 의회 청문회에서 외국 법원의 관할권 앞에선 한계를 인정했다. 보안 · Ofcom Concedes Defeat in the 4chan Case
Key Point 미국 법원의 판례가 영국 규제 기관의 검열 권력을 실질적으로 좌절시킨 사건으로, 외국 정부의 온라인 검열 시도에 저항하려는 미국과 기타 국가 기업·단체들에게 법적 선례를 제공한다.
핵심 요약
영국의 방송통신청(Ofcom)이 의회 청문회에서 외국 법원의 관할권 앞에선 한계를 인정했다. 온라인안전법(Online Safety Act) 위반으로 부과한 벌금을 미국에서 회수할 수 없다고 Ofcom 최고경영자 데임 멜라니 도스가 공식 진술했다. 미국 콜럼비아특별구 연방지방법원은 2025년 4chan v. Ofcom 판례에서 '4chan에 미국 내 인프라가 없으므로 미국 법원을 통해서만 집행 가능하며, 미국 법원은 헌법 위반 외국 판결을 집행하지 않는다'고 명시했다. 전체 요약 10문장 읽기 → 083 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 084 15:11 ▲ 154 · 댓글 2 반복 모델이 긴 문제를 푸는 법: 진행도 정렬 재귀 반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. AI · 머신러닝 · PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
Key Point 반복 모델의 길이 외삽 성능을 16배까지 개선하는 기법이 제시되어, 재귀 신경망의 일반화 한계를 다루는 근본적인 접근 방식을 보여준다.
핵심 요약
반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. 순차적 상태 추적 작업에서 최종 답변 감독만으로는 각 반복이 얼마나 진행해야 하는지 명시하지 않으며, 반복된 업데이트가 재귀 상태의 스케일을 변화시킨다. PAR(Progress-Aligned Recurrence)는 k번째 반복의 예측을 처음 k개 연산 후의 상태와 일치하도록 학습하고, 재귀 상태를 첫 반복의 규범으로 정규화한다. 전체 요약 10문장 읽기 → 085 15:11 ▲ 60 · 댓글 2 로봇 AI의 행동 생성, 재활용으로 3배 빠르게 Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. AI · 머신러닝 · VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse
Key Point 로봇 행동 생성 모델의 추론 속도를 대폭 개선하면서 정확도도 높이는 기법으로, 실시간 제어가 필요한 로봇 시스템의 실용성을 크게 향상시킬 수 있다.
핵심 요약
Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. 연구팀은 버려진 행동 꼬리가 제거 과정의 진행 상황을 담고 있어 재활용 가능함을 발견했고, 10단계 가우시안 기준선과 동등하거나 더 나은 성능을 더 적은 제거 단계로 달성할 수 있음을 보였다. 최적 제거 예산(denoising budget)이 샘플마다 크게 달라지므로, 행동 꼬리 재활용은 업데이트된 환경에 맞게 적응해야 한다는 관찰에 따라 VLA-Rolling을 제안한다. 전체 요약 6문장 읽기 → 086 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 087 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 088 15:11 ▲ 102 · 댓글 66 Claude가 전갈 신경독 항체 설계... 211개 모두 공개 Anthropic의 Claude가 전갈 신경독에 대한 단백질 미니바인더 211개를 설계했으며, 이 중 17개가 실험 검증을 통과했다. AI · 머신러닝 · Claude designed protein binders against scorpion neurotoxins
Key Point Claude가 실제 건강 문제(전갈 독소 중독)를 대상으로 AI 단백질 설계의 실용성을 증명했고, 검증된 데이터 전체를 공개해 항독소 치료제 개발 분야에 실질적 진전을 만들었다.
핵심 요약
Anthropic의 Claude가 전갈 신경독에 대한 단백질 미니바인더 211개를 설계했으며, 이 중 17개가 실험 검증을 통과했다. 전갈 쏘임은 연간 120만 명 이상이 피해를 입고 3,250명 이상이 사망하지만, 저개발 지역에서 치료제 접근이 어려운 무시된 질병이다. Claude는 64시간 동안 4번의 추가 지시를 받으며 자율적으로 작동했고, 12개의 설계 도구를 사용해 318,484개 디자인을 생성 후 필터링했다. 전체 요약 10문장 읽기 → 089 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 090 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 091 12:11 ▲ 11 · 댓글 2 자기 재귀로 멀티토큰 예측 효율화한 ECHO 논문 기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. AI · 머신러닝 · ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
Key Point 자동회귀 언어 모델의 학습과 추론 효율성을 동시에 높이는 핵심 알고리즘 개선으로, 기존 멀티토큰 예측의 구조적 문제를 근본적으로 해결한다.
핵심 요약
기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. ECHO는 백본의 최종 레이어 자체가 모든 예측 스텝을 담당하므로 감독 신호가 다음 토큰을 생성하는 매개변수에 직접 전달된다. 깊은 스텝의 학습 비용을 낮추기 위해 동적 깊이 샘플링(DDS)을 도입해 깊이에 따라 확률을 감쇠시킨다. 전체 요약 6문장 읽기 → 092 06:11 ▲ 119 · 댓글 209 AGI 시대, 아이에게 무엇을 가르칠 것인가 프로그래머인 저자는 첫 자녀가 생기면서 프로그래밍이라는 기술 중심의 교육이 여전히 의미가 있을지 의문을 품게 됐다. 기타 · What shall I teach my son?
Key Point 프로그래밍 같은 기술 중심 교육의 가치가 AI에 의해 훼손되는 상황에서, 교육의 근본적 목적을 다시 묻는 성찰이 필요한 시점이다.
핵심 요약
프로그래머인 저자는 첫 자녀가 생기면서 프로그래밍이라는 기술 중심의 교육이 여전히 의미가 있을지 의문을 품게 됐다. 닐 포스트만의 『교육의 종말』을 읽으며 토마스 에디슨이 1913년에 라디오와 영화가 교육을 대체할 것이라 예측했지만, 실제로는 그러지 않았음을 돌아본다. 저자는 2013년에 MOOC가 교육을 뒤흔들 것이라고 예측했던 자신의 착각을 인정하며, 린디 효과(Lindy Effect)로 기존 교육 체제의 지속력을 설명한다. 전체 요약 10문장 읽기 → 093 03:11 ▲ 103 · 댓글 33 밥 크링글리와의 30년, 실리콘밸리의 천재 이야기꾼 저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 기타 · My Friend Bob Cringely
Key Point 크링글리의 부음을 추도하며 그와 30년을 함께한 인생의 순간들을 담은 개인적 기록으로, 기술 칼럼니스트로서의 통찰력보다는 카리스마로 사람들을 매료시킨 인물상을 그려낸다.
핵심 요약
저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 크링글리는 저자가 외로운 프로그래머이면서 컴퓨터 관련 성취에 갈증을 느낄 거라는 심리를 정확히 읽고 있었고, 자바 프로그래밍 경험이 있냐고 묻자 저자는 거짓으로 '있다'고 답했다. 크링글리는 이들을 고용해 '프론토'라는 시스템을 개발하게 했는데, 이는 인터넷 연결이 유휴 상태일 때 잡지를 자동으로 다운로드한 뒤 새벽 2시에 프린터로 출력하는 출판 유통 시스템이었다. 전체 요약 11문장 읽기 → 094 00:11 새 버전 FastAPI 0.153.0, 폼 모델 합 타입의 브라우저 처리 개선 FastAPI 0.153.0은 여러 모델을 합한 Union 타입의 폼 데이터 처리를 개선했다. 웹 · 프론트엔드 · fastapi/fastapi@0.153.0
Key Point Pydantic 모델 Union을 쓰는 경우 폼 제출 시 데이터 처리 방식이 일관되지 않던 문제가 해결되어, 폼 기반 API의 입력 처리가 예측 가능해진다.
핵심 요약
FastAPI 0.153.0은 여러 모델을 합한 Union 타입의 폼 데이터 처리를 개선했다. Union 폼 모델에 이제 개별 모델과 동일한 브라우저 폼 핸들링이 적용된다. 빈 스칼라 필드는 기본값을 사용하거나 누락 오류를 발생시키며, 빈 리스트 항목은 유지된다. 전체 요약 6문장 읽기 → 095 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 096 18:11 ▲ 19 · 댓글 2 비디오 분할에 시각적 추론 체인 더하다 비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. AI · 머신러닝 · Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Key Point 비디오 분할에서 텍스트 추론과 시각적 증거의 연결 고리를 명시적으로 만듦으로써 모델의 판단 근거를 추적 가능하게 한 새로운 접근 방식이다.
핵심 요약
비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. 기존 텍스트 기반 사고 연쇄(CoT)는 선택 이유를 설명하지만 시각적 근거를 명시하지 않아, 언어 추론과 프레임에 분산된 증거 사이에 갭이 생긴다. 연구팀은 시공간 근거를 갖춘 Temporal Chain of Video Primitives(TCoVP)를 제안했다. 전체 요약 9문장 읽기 → 097 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 098 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 099 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 100 15:11 ▲ 84 · 댓글 2 언어 명령에 따라 장면을 탐색하는 로봇, 인터넷 영상으로 학습시키다 언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. AI · 머신러닝 · ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
Key Point 시뮬레이션 데이터의 현실성 문제를 극복하면서도 현실 데이터 수집 비용을 줄이는 새로운 접근법으로, 로봇 네비게이션의 실용성을 높일 수 있는 기술이기 때문이다.
핵심 요약
언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. 기존 방식은 로봇 실제 데이터 수집이 비싸고 시뮬레이션 데이터는 현실 적응 격차(sim-to-real gap)가 있는 문제가 있었다. ScaleNav는 인터넷의 1인칭 관점 영상에서 학습하여 카메라가 목표에 접근할 때 시각 정보가 어떻게 변하는지 파악한다. 전체 요약 6문장 읽기 →