쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
15건 · "다중모달"조건 지우기 ×
001 18:11 ▲ 32 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 002 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 003 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 30 · 댓글 2 AI 모델의 미래 세계 예측 능력 벤치마크 'WorldCast' 공개 인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. AI · 머신러닝 · WorldCast: Exploring Intelligent Visual Generation in World State Prediction
Key Point 현재 최첨단 모델의 시각적 미래 예측 능력 한계를 명확히 드러내는 벤치마크로, AI의 실제 세계 이해도를 측정하는 중요한 기준을 제시합니다.
핵심 요약
인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. 연구팀이 이러한 능력을 4단계 계층으로 분류했으나 고수준 작업들은 아직 충분히 연구되지 않은 상태다. 이를 해결하기 위해 WorldCast 벤치마크를 개발했으며, 이는 8개 카테고리의 320개 수작업 사례로 구성되고 12개 대표 모델을 평가한다. 전체 요약 8문장 읽기 → 006 18:11 ▲ 81 · 댓글 1 미적 코드 생성, 시각 보상으로 가능해졌다 슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AI · 머신러닝 · AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
Key Point 시각 설계가 필요한 UI 코드 생성에서 미적 품질과 정확성을 동시에 달성하는 새로운 접근법이 기존 모델의 한계를 구체적으로 수치로 극복해냈다.
핵심 요약
슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AesCode는 사용자 지시문에 따라 코드를 생성하되, 같은 지시문으로 만든 이미지를 시각 미적 참조로 활용한다. 생성된 코드를 디자인 그래프로 표현해 각 속성을 추적 가능하게 만들고, 이 그래프로부터 두 종류의 보상을 만든다. 전체 요약 8문장 읽기 → 007 15:11 ▲ 20 · 댓글 1 착용형 센서로 인간의 로봇팔 동작 100시간 기록 인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. AI · 머신러닝 · EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
Key Point 인간형 로봇의 자연스러운 움직임 학습을 위해 필요한 대규모 멀티모달 데이터셋이 공개되었으며, 센서 최소화 기술로 현장 데이터 수집의 새로운 방향을 제시한다.
핵심 요약
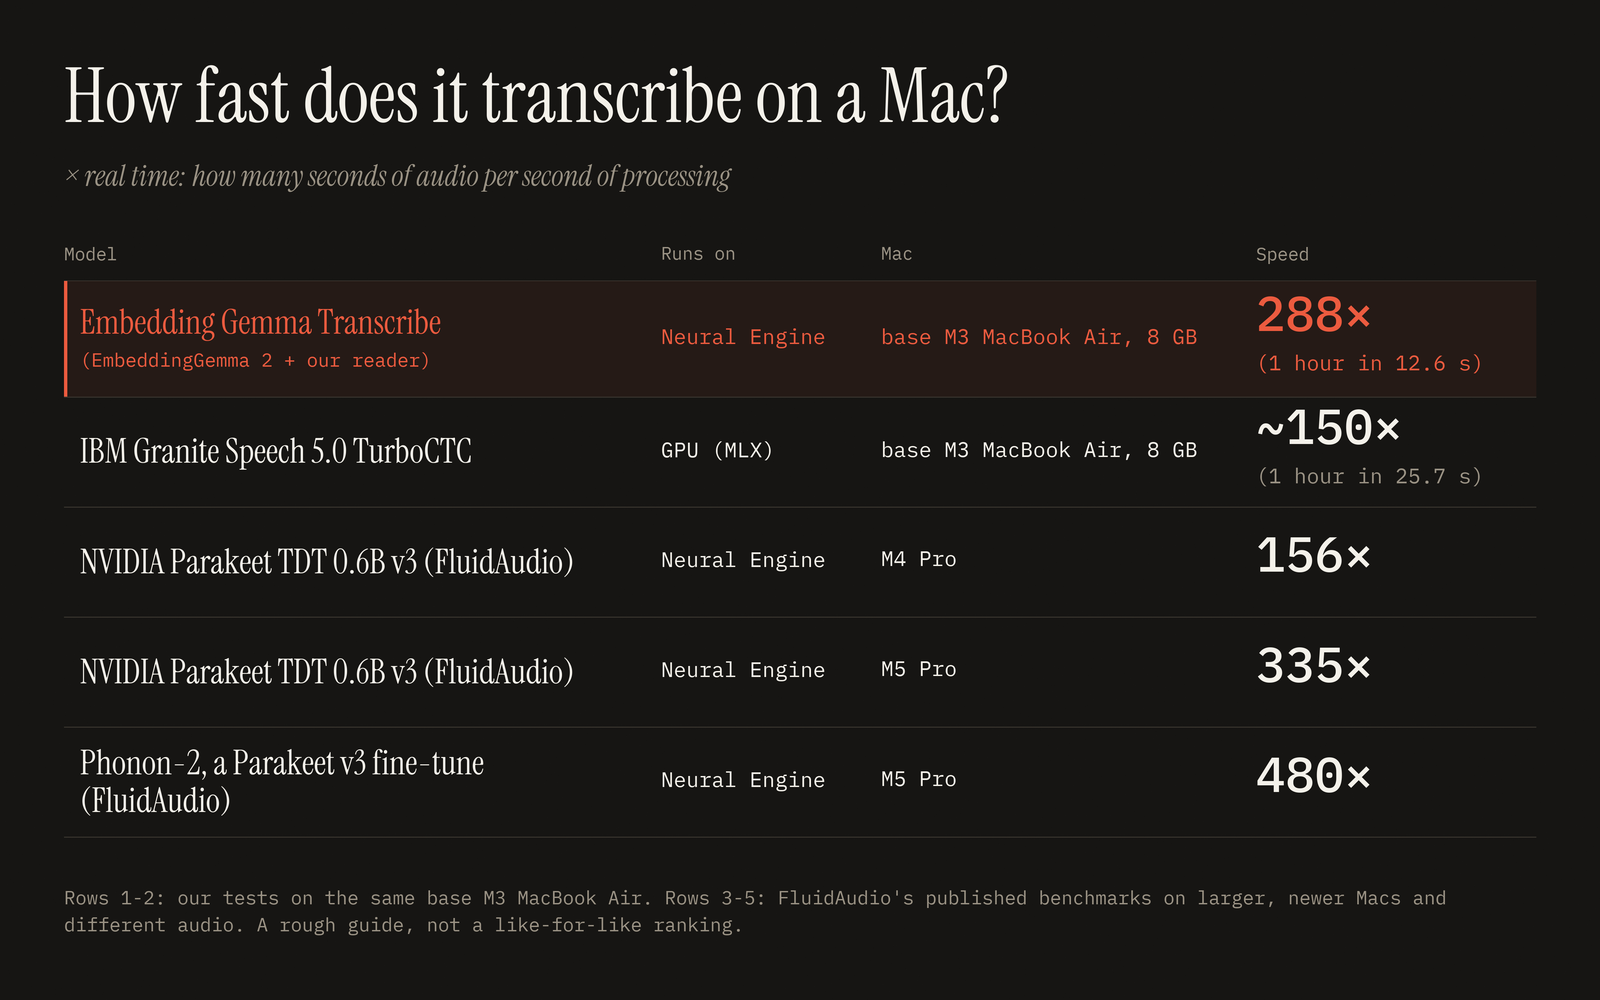
인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. 연구팀은 EgoExplorer라는 100시간 규모의 데이터셋을 공개했으며, 착용형 센서 시스템으로 시점 영상과 전신 동작, 손가락 세밀한 움직임, 촉각 정보를 동시에 기록했다. 전문적 활동들을 중심으로 연속 녹화된 이 데이터에는 단계별 설명도 함께 제공된다. 전체 요약 8문장 읽기 → 008 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 009 15:11 ▲ 261 · 댓글 2 로봇·자율주행용 '공간 인지' 기초 모델 GroundingPI 공개 Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. AI · 머신러닝 · GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Key Point 로봇 팔과 자율주행 자동차가 정확하고 빠르게 물체를 인식해야 하는데, 기존 범용 시각 모델 대신 공간 좌표 인식에 특화한 기초 모델을 쓰면 성능이 크게 오른다는 실증적 결과를 제시한다.
핵심 요약
Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. 이 모델은 점과 박스 형태의 정량화된 좌표를 공유 어휘로 생성해, 혼잡한 환경과 작은 물체의 위치 파악을 빠르게 수행한다. 다중모달·공간 사전학습, 지도학습, GRPO 강화학습을 결합해 학습하며, 공개 데이터셋과 자체 데이터 엔진의 감시 신호를 활용했다. 전체 요약 8문장 읽기 → 010 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 011 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 012 21:11 ▲ 60 · 댓글 2 적응형 전문가 혼합으로 확산 모델의 소수 단계 생성 개선 마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. AI · 머신러닝 · E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
Key Point 확산 모델의 가장 큰 장점인 소수 단계 고속 생성을 개선하는 새로운 방법으로, 기존 접근법의 근본적인 문제(후방 붕괴)를 회피하면서 매개변수 효율성을 유지한다.
핵심 요약
마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. 최근 연구는 위치 간 상관관계를 포착하기 위해 변분 자동인코더로 학습된 연속 가우시안 잠재변수를 도입했으나, 이러한 접근법은 잠재변수가 무시되는 후방 붕괴(posterior collapse) 문제에 빠지기 쉽다. 본 논문은 강화된 혼합-전문가(E-MoE) 방법을 제안하며, MoE 백본의 전문가 라우팅 결정으로 주어진 이산 공유 잠재변수에 대한 분해된 분포의 혼합으로 역프로세스를 구성한다. 전체 요약 5문장 읽기 → 013 03:11 ▲ 23 · 댓글 1 텍스트를 선택적으로 압축하는 FocusVTC, 긴 문맥 처리 속도 2.79배 향상 대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. AI · 머신러닝 · FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution
Key Point 긴 문맥을 처리하는 LLM 서비스에서 입력 토큰 수를 2.9배 줄이면서도 성능을 높이고 추론 속도를 2.79배 가속하는 방법이 제시되었으므로, 비용과 속도가 중요한 실제 배포 환경에서 직접 적용할 가치가 있다.
핵심 요약
대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. 기존 방식은 해상도를 고정하므로 저DPI는 토큰을 절약하지만 가독성을 잃고, 고DPI는 불필요한 내용에 토큰을 낭비하는 문제가 있다. FocusVTC는 적응형 해상도로 이 트레이드오프를 깨뜨렸고, 압축된 저DPI 전역 뷰와 선택적 영역 강화를 결합한다. 전체 요약 9문장 읽기 → 014 15:11 ▲ 23 · 댓글 1 LLM 정렬을 위한 확산 기반 보상 모델 등장 기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. AI · 머신러닝 · Diffusion Reward Models
Key Point 인간의 다양한 판단 방식을 반영하는 새로운 보상 모델이 RLHF 학습에서 성능 개선을 직접 입증했기 때문에, LLM 정렬 연구에 실질적 영향을 미칠 수 있다.
핵심 요약
기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. 이를 해결하기 위해 Diffusion Reward Model(DRM)을 제안하며, 이는 보상 모델링을 조건부 밀도 추정 문제 p(r|x,y)로 재구성한다. DRM은 동결된 LLM 인코더를 기반으로 경량 Diffusion Transformer가 가우시안 노이즈를 보상 벡터로 제거(denoising)하며, 출력 분포에 대한 매개변수 가정 없이 자연스럽게 다중모달 구조를 표현한다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 30 · 댓글 1 장시간 로봇 작업에서 기억력을 평가하는 새 벤치마크 공개 로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. AI · 머신러닝 · EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
Key Point 로봇이 복잡한 장시간 작업을 수행할 때 필요한 기억 능력의 핵심 문제를 체계적으로 분석하고 평가할 구체적 벤치마크와 솔루션을 제시해 구체화 합니다.
핵심 요약
로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. 문제의 원인은 네 가지입니다: 세부 시각 정보 기억 부족, 동적 세계 상태 추적 불안정, 상호작용 결과로 드러난 정보 미기록, 과거 경험 활용 제한. 이를 평가할 벤치마크가 없어 EmbodiedMemory-Bench(EMem-Bench)를 개발했습니다. 전체 요약 8문장 읽기 →