쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "비전"조건 지우기 ×
001 18:11 ▲ 124 · 댓글 28 알슬로스 Qwen3.8-27B 양자화 기술, 정확도 5~10% 향상 알슬로스(Unsloth)가 Qwen3.8-27B를 위한 새 양자화 기술 Dynamic V3.1을 발표했다. AI · 머신러닝 · Unsloth Qwen3.8-27B Quantizations – Dynamic v3.1 Update
Key Point 로컬에서 대규모 언어 모델을 실행하려는 개발자에게 5~10% 정확도 향상 기술과 구체적인 하드웨어 요구사항·설정값이 제시되었다.
핵심 요약
알슬로스(Unsloth)가 Qwen3.8-27B를 위한 새 양자화 기술 Dynamic V3.1을 발표했다. Dynamic V3.1은 기존 Dynamic 버전 대비 평균 정확도를 5~10% 향상시키며, Terminal Bench 2.1, DeepSWE v1.1, LiveCodeBench v6 등 다양한 벤치마크에서 개선 효과를 확인했다. Qwen3.8-27B는 27B 파라미터 모델로 256K 컨텍스트 윈도우와 비전·추론 능력을 갖추고 있으며, 17GB RAM/VRAM 환경에서 로컬 실행 가능하다. 전체 요약 13문장 읽기 → 002 12:11 ▲ 16 · 댓글 5 멀티모달 비전 인코더의 세 가지 선택지를 분해하다 멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. AI · 머신러닝 · Unbundling Multimodal Vision Encoding
Key Point 멀티모달 모델에서 비전 처리 방식의 세 가지 핵심 선택지(사전 학습 여부, 용량 크기, 융합 위치)를 통제된 비교를 통해 각각의 영향을 명확히 규명해 향후 모델 설계에 실질적인 지표를 제시한다.
핵심 요약
멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. 연구팀은 모든 모델을 동일한 데이터로 처음부터 학습하고 같은 계산량에서 VQA(시각 질답)와 언어 벤치마크로 비교했다. 사전 학습된 비전 사전 지식은 필수가 아니며, 처음부터 함께 학습한 인코더가 별도 학습 단계 없이 사전 학습된 것과 같은 수준이다. 전체 요약 7문장 읽기 → 003 06:11 ▲ 105 · 댓글 41 OpenAI 로봇팀 해체, 범용 AI로의 전환 선언 OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. AI · 머신러닝 · OpenAI disbands its robotics team as its general models start running robots
Key Point 범용 AI 모델이 로봇 제어 영역까지 침투하면서 로봇공학의 기술 스택과 경쟁 구도 자체가 재편될 수 있기 때문이다.
핵심 요약
OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. OpenAI는 이를 로봇공학에 대한 헌신의 증거로 표현했으며, 로봇공학이 회사의 장기 비전의 핵심이라고 밝혔다. 2024년 창업사 Figure와 협력해 휴머노이드 로봇 AI 개발을 추진했으나 2025년 2월 Figure가 자체 개발로 전환하면서 협력이 종료됐다. AI 산업 전반에서 언어, 코드, 비전 분야의 범용 모델을 로봇 같은 물리적 장치를 제어하는 '구체화된 AI(embodied AI)'에 직접 적용할 수 있다는 가정이 확산 중이다. 이는 로봇 전용 특화 모델을 따로 개발할 필요가 없다는 의미다. 전체 요약 7문장 읽기 → 004 00:11 새 버전 Hugging Face Transformers v5.23.0 출시, 멀티모달 모델과 모델 변환 기능 강화 Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. AI · 머신러닝 · huggingface/transformers@v5.23.0
Key Point 대규모 언어모델의 실제 배포와 추론 속도가 핵심인 만큼, 다양한 하드웨어 백엔드에서 일관된 방식으로 모델을 최적화·공유할 수 있는 Exporters 기능 통일과 OpenVINO 융합으로 최대 7.6배 성능 향상이 개발자 생산성과 프로덕션 배포 효율을 크게 바꾼다.
핵심 요약
Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. 모델 변환(Exporters) 기능 완전 개편: 모든 내보내기는 ExportedModel을 반환하여 원본 모델과 동일한 인터페이스로 호출하고, Dynamo·ONNX Runtime·OpenVINO·ExecuTorch 백엔드를 통합 관리한다. 성능 개선: OpenVINO 백엔드는 어텐션·RoPE·MoE 연산을 융합하여 디코딩 속도를 2.4~3.9배 가속하며, ONNX Runtime은 A100에서 eager PyTorch보다 7.6배, torch.compile보다 1.4배 빠르다. 전체 요약 9문장 읽기 → 005 21:11 ▲ 36 · 댓글 3 생성형 이미지 모델을 비전 AI로 변신시킨 오픈 레시피 기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. AI · 머신러닝 · Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
Key Point 생성형 AI를 기반으로 한 멀티태스크 비전 시스템의 설계 원리가 완전히 공개되어 연구 재현과 응용이 가능해진 점, 그리고 레전드 앙상블로 추가 학습 없이 성능을 크게 개선하는 방법론이 소개된 점이 중요하다.
핵심 요약
기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. OVB는 비전 작업을 조건부 이미지 편집으로 프레임화하며, 색상 인코딩·프롬프트 설계·파라미터 적응·작업 균형 같은 핵심 설계 선택지를 분석했다. 4B~9B 파라미터 오픈 가중치 모델과 공개 데이터셋 2.1M~3.8M 학습 쌍을 사용한 OVB는 Cityscapes 제로샷에서 73.9 mIoU로 Vision Banana(69.9)를 앞질렀다. 전체 요약 7문장 읽기 → 006 09:11 ▲ 13 · 댓글 3 시뮬레이션으로 AI 비서의 상호작용 능력 평가하는 새 벤치마크 사용자와 실시간 상호작용하는 비전 모델을 평가하기 위해 닫힌 루프 환경이 필요하다는 점을 제시한다. 기존 벤치마크는 오프라인 재생에만 의존해 AI의 응답이 사용자 행동과 작업 결과에 미치는 영향을 포착하지 못했다. AI · 머신러닝 · Interactive Visual Gym: Evaluating Visual Interaction Models with Simulated Users in Interactive Worlds
Key Point 비전 기반 AI 비서의 실제 사용성을 평가할 새로운 벤치마크가 제시되며, 현재 최고 성능 모델들도 절반 이상의 작업을 완료하지 못한다는 점이 해당 기술의 실용적 한계를 드러낸다.
핵심 요약
사용자와 실시간 상호작용하는 비전 모델을 평가하기 위해 닫힌 루프 환경이 필요하다는 점을 제시한다. 기존 벤치마크는 오프라인 재생에만 의존해 AI의 응답이 사용자 행동과 작업 결과에 미치는 영향을 포착하지 못했다. Interactive Visual Gym은 작업 환경과 인간 사용자를 함께 시뮬레이션하는 프레임워크로, 요리·가정용 물건 조작·모바일 인터페이스 3개 영역의 일상 작업과 인간의 행동 공간을 재현한다. 페르소나 기반 사용자 시뮬레이터를 통해 AI 비서와 협력하면서도 통제된 실행 오류와 예상 밖의 행동을 포함시킨다. 전체 요약 8문장 읽기 → 007 12:11 ▲ 15 · 댓글 3 월드 모델, 게임 규칙을 몇 번 봐야 학습할까 월드 모델이 낯선 환경의 메커니즘을 학습하려면 몇 번의 상호작용(노출)이 필요한지 연구했다. AI · 머신러닝 · How Many Exposures Does a World Model Need? Learning Unseen Game Mechanics at Test Time
Key Point 시각 기반 게임에서 월드 모델이 처음 보는 규칙을 얼마나 빨리 습득하는지 보여주며, 테스트 시점 적응의 효과를 정량적으로 입증했다.
핵심 요약
월드 모델이 낯선 환경의 메커니즘을 학습하려면 몇 번의 상호작용(노출)이 필요한지 연구했다. ARC-AGI-3 벤치마크의 20개 게임에서 69개 반복 메커니즘을 레이블링한 MechEval 평가 도구를 만들었고, 각 메커니즘이 환경을 바꾸는 셀에 대해 예측을 채점한다. WARC는 3,500만 파라미터 비전 트랜스포머로, 다른 게임에 사전학습한 후 매 전이 후 모든 파라미터를 업데이트한다. 전체 요약 6문장 읽기 → 008 18:12 ▲ 102 · 댓글 2 손가락 감각 센서 통합하는 택타일 기초 모델 공개 복합 조작 작업에 필수적인 접촉각 감각(tactile sensing)을 여러 센서 유형 간에 통합 표현하는 'LingBot-Touch' 모델을 개발했다. AI · 머신러닝 · Learning Heterogeneous Tactile Representation for General Dexterous Manipulation
Key Point 여러 종류의 촉각 센서를 하나의 모델로 통합하면 로봇의 손가락 조작 능력이 비약적으로 향상되는데, 이는 산업용 로봇과 지능형 로봇 개발에 필수적인 기술이다.
핵심 요약
복합 조작 작업에 필수적인 접촉각 감각(tactile sensing)을 여러 센서 유형 간에 통합 표현하는 'LingBot-Touch' 모델을 개발했다. 압저항식(piezoresistive), 자기식(magnetic), 시각-촉각식(visuotactile) 센서 등 서로 다른 센서 데이터를 하나의 통일된 표현으로 변환하고 새로운 센서 유형으로 확장 가능하다. 생성된 택타일 토큰은 확산 정책(diffusion policy)부터 π₀.₅, LingBot-VLA 같은 비전-언어-행동(VLA) 모델까지 다양한 정책 모델에 플러그 앤 플레이 방식으로 통합되어 조작 능력을 향상시킨다. 전체 요약 6문장 읽기 → 009 15:10 ▲ 52 · 댓글 3 로봇 자율성 향상, 다중에이전트 프레임워크로 실적 2배 이상 돌파 파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. AI · 머신러닝 · Toward the Era of Agentic Embodied Intelligence
Key Point 로봇의 자율적 행동 성능을 2배 이상 끌어올린 프레임워크가 공개될 예정이며, 실제 가정용 로봇 작업에서의 높은 성공률과 빠른 학습 속도는 구체화 AI 실용화에 새로운 기준을 제시한다.
핵심 요약
파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. 연구팀이 A2-MEAS라는 구체화 다중에이전트 프레임워크를 제안했으며, 이는 코드를 확장 인터페이스로 삼는다. 수정 코드는 수정 언어, 공간 증거, 실행 이력, 행동 제안을 결합하며, MetaBrain이 학습 감독과 런타임 지도를 제공한다. 전체 요약 12문장 읽기 → 010 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 011 06:11 ▲ 153 · 댓글 149 이더리움 재단, "자살 맹세" 포함 의무 정책으로 직원 해고 이더리움 재단이 3월에 1,000년 비전을 담은 38쪽 문서 '이더리움 재단 의무(mandate)'를 전 직원에게 배포했다. 스타트업 · 비즈니스 · Cryptocurrency lawsuit: Ethereum Foundation required "suicide pledge"
Key Point 블록체인 업계의 실제 임금 노동자들이 얼마나 극단적인 압력 속에서 일하는지, 그리고 조직 저항이 어떻게 해고와 대량 이탈로 이어질 수 있는지 보여준다.
핵심 요약
이더리움 재단이 3월에 1,000년 비전을 담은 38쪽 문서 '이더리움 재단 의무(mandate)'를 전 직원에게 배포했다. 문서 11쪽에는 만화 그림과 함께 '소스 셉쿠 라이선스'라는 제목 아래 '이 소프트웨어의 저자, 유지 관리자 등은 맹세 위반 시 칼로 자신의 목숨을 끊겠다'는 내용이 담겨 있었다. 재단은 직원들에게 월요일까지 의무 승인 양식을 제출하거나 퇴직할 것을 요구했으며, 두 가지 선택지는 완전 헌신 또는 보상을 받고 퇴직이었다. 전체 요약 9문장 읽기 → 012 18:11 ▲ 70 · 댓글 2 3D 가우시안 스플래팅, 장면 규모 차이 극복하다 기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. AI · 머신러닝 · SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 013 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 014 06:11 ▲ 125 · 댓글 39 시각장애 어머니 키패드폰에 안드로이드 16 올린 개발자 시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 하드웨어 · 시스템 · Porting Android 16 to my blind mother's keypad phone
Key Point 제조사가 불가능하다고 단언한 구형 접근성 폰에 최신 안드로이드를 포팅한 기술적 과정과 경험을 다루며, 시각장애 사용자를 위한 실제 접근성 개선의 맥락을 보여준다.
핵심 요약
시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 제조사는 안드로이드 12가 '불가능'하다고 주장했지만, JADX 디컴파일과 감시를 통해 카프시스가 libinput.so 시스템 라이브러리에 SV3KeyboardForTalkback 함수를 패칭해 키패드 동작을 구현했음을 발견했다. 라인지OS 23.2(안드로이드 16)를 GSI로 플래시했으나, 서명된 vbmeta 파일 없이 부팅이 거부되고 init이 크래시 로그를 표시하지 않아 문제 해결이 막혔다. 전체 요약 13문장 읽기 → 015 18:15 스타 1,140 AI가 코드로 영상 만든다…cinecode 오픈소스 공개 AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. AI · 머신러닝 · sarpstar/cinecode · Python
Key Point 코드 기반 영상 자동 제작으로 광고·설명영상·다큐 같은 콘텐츠를 개발자가 직접 만들 수 있게 되며, 이는 영상 제작 진입장벽을 낮추고 반복 제작 업무를 대폭 줄인다.
핵심 요약
AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. 사용자가 한 문장으로 아이디어를 입력하면 AI가 각본을 작성하고, 모든 프레임을 코드로 렌더링하고, 음향 디자인을 거쳐 MP4 파일을 제공한다. 짧은 영상·장편 다큐·광고·뮤직비디오 등 다양한 포맷을 지원하며, 빠른 모드(약 3분에 완성)와 필름 모드(단계적 검수)로 나뉜다. 전체 요약 9문장 읽기 → 016 18:15 스타 3,847 비디오 제작 방식을 자동 분석하는 오픈소스 도구 'rea-video' 영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. AI · 머신러닝 · JuneYaooo/rea-video · Python
Key Point 비디오 콘텐츠 제작의 주요 성분(실사/AI/코드)을 정확히 판별할 수 있으면, 제작 기법 학습 비용을 대폭 낮추고 비슷한 스타일의 콘텐츠를 빠르게 만들 수 있다.
핵심 요약
영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. 카메라 위치·조명 설정·색보정·렌즈 정보 등 촬영 기법, AI 영상의 역엔지니어링 프롬프트와 배치 전략, 3D/애니메이션의 렌더링 여부, 코드 기반 UI/타이포그래피의 타이밍, 화면 녹화 범위를 각각 구분해 보고한다. 자막·이모티콘·편집점·음성(인간/AI)·음악(BPM 포함)·효음의 위치와 지속 시간도 추출하며, SRT/ASS 자막 형식으로 내보낼 수 있다. 전체 요약 9문장 읽기 → 017 18:15 ▲ 259 · 댓글 147 Claude Code에서 Pi로 갈아탄 개발자의 불평 1년 이상 Claude Code를 사용해 온 개발자가 누적된 불편함으로 인해 Pi로 완전히 마이그레이션했다. AI · 머신러닝 · Goodbye Claude, Hello Pi
Key Point Claude Code 개발자들이 느끼는 구체적인 불편함(UI/UX 버그, 빈번한 시스템 프롬프트 변경, 비대한 토큰 사용)이 스타트업 도구인 Pi로의 대안 이동을 촉발하고 있다.
핵심 요약
1년 이상 Claude Code를 사용해 온 개발자가 누적된 불편함으로 인해 Pi로 완전히 마이그레이션했다. Claude Code가 AGENTS.md 파일 지원을 발표했지만 이미 결정한 후였고, 사용자가 두 형식을 오갈 때 복사나 심링크를 직접 해야 하는 번거로움이 있다. VSCode 통합 시 한 번에 하나의 세션만 IDE에 연결 가능해 여러 탭을 열 수 없으며, 이 버그는 2025년 12월부터 보고됐지만 미해결이다. 전체 요약 10문장 읽기 → 018 06:11 ▲ 10 · 댓글 2 불완전한 3D 포인트 클라우드에서 완전한 장면 메시 복원 이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. AI · 머신러닝 · AnchorComplete: Recovering Complete Scene Meshes from Partial Point Clouds
Key Point 3D 재구성의 오래된 문제인 보이지 않는 영역의 기하학 복원 문제를 신경망 기반으로 해결하는 새로운 방법이 나왔으며, 소수 뷰 환경에서의 성능 개선이 3D 스캔·VR·로봇 비전 등 다양한 응용에 영향을 줄 수 있다.
핵심 요약
이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. 이를 해결하기 위해 AnchorComplete라는 프레임워크를 제안하는데, 불완전한 포인트 클라우드에서 완전한 장면 메시를 복원하면서 관찰된 기하학을 보존한다. TRELLIS.2를 기반으로 구축되었으며, 부분 포인트 조건화(global scene tokens와 local spatial evidence를 결합해 입력에 생성을 고정)와 메트릭 스케일 coarse-to-fine 생성(고정 크기 윈도우 내에서 기하학을 점진적으로 개선하면서 전역 구조 일관성 유지)을 결합한다. 전체 요약 4문장 읽기 → 019 06:11 ▲ 113 · 댓글 86 Rune: Rust 기반 GPU 렌더링 크로스플랫폼 UI 프레임워크 macOS, Windows, Linux, 웹을 지원하는 네이티브 GPU 렌더링 방식의 Rust UI 프레임워크 Rune을 공개했다. 웹 · 프론트엔드 · Rune: A native GPU-rendered Rust UI framework for macOS, Windows, Linux and web
Key Point Rust 에코시스템에서 새로운 크로스플랫폼 UI 솔루션이 나왔고, 헤드리스 렌더링으로 AI 에이전트와의 통합을 염두에 둔 점이 기존 UI 프레임워크와 다르다.
핵심 요약
macOS, Windows, Linux, 웹을 지원하는 네이티브 GPU 렌더링 방식의 Rust UI 프레임워크 Rune을 공개했다. 자체 렌더러, 텍스트 엔진, 레이아웃, 스프링 애니메이션 엔진을 내장하고 있다. 모든 앱이 헤드리스 모드로 실행 가능해 에이전트가 PNG로 렌더링하거나 엘리먼트 트리를 덤프하고 스크립트 입력으로 조작할 수 있다. 전체 요약 8문장 읽기 → 020 21:12 당일 +211 Flutter로 만든 오프라인 LLM 클라이언트, 안드로이드에서 로컬 실행 지원 PrivateLM은 Flutter 기반의 크로스플랫폼 AI 채팅 클라이언트로, 안드로이드에서 GGUF 모델을 로컬로 다운로드해 GPU 가속(Vulkan)으로 인터넷 없이 실행할 수 있다. AI · 머신러닝 · orailnoor/cross-platform-llm-client · C++
Key Point 안드로이드 폰에서 인터넷 없이 LLM을 직접 실행하고, 필요시 클라우드 API로 전환하는 프로덕션급 오픈소스 앱으로, 프라이버시를 중시하는 개발자에게 실제 대안이 된다.
핵심 요약
PrivateLM은 Flutter 기반의 크로스플랫폼 AI 채팅 클라이언트로, 안드로이드에서 GGUF 모델을 로컬로 다운로드해 GPU 가속(Vulkan)으로 인터넷 없이 실행할 수 있다. 클라우드 API 모드에서는 OpenAI, Anthropic, Google Gemini, Kimi(Moonshot AI)로 자동 전환되며, 앱 내에서 두 방식을 원활하게 전환할 수 있다. 텍스트와 이미지를 함께 보낼 수 있는 멀티모달 채팅을 지원하며, Qwen2-VL 같은 로컬 모델과 클라우드 제공자 모두 비전 기능을 활용할 수 있다. 전체 요약 12문장 읽기 → 021 15:10 ▲ 106 · 댓글 1 로봇 계획 25배 빠르게, 비전 모델의 구조 활용한 VFlash 로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. AI · 머신러닝 · VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
Key Point 로봇의 시각 계획 생성 속도를 획기적으로 높이면서도 정확도까지 향상시키는 기법으로, 물리 AI 시스템의 실시간 제어 가능성을 크게 높인다.
핵심 요약
로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. 기존 자동회귀 모델은 이런 시각 원시요소를 토큰 하나씩 생성하기 때문에 예측이 복잡할수록 비용이 급증한다. VFlash는 Flash Primitive Decoding 기법으로 시각 원시요소의 구조를 활용, 경량 드래프터가 전체 원시요소를 한 번의 순전파로 예측한다. 전체 요약 8문장 읽기 → 022 15:10 ▲ 22 · 댓글 3 선택지 제시 후 즉시 판단하는 'Drex' 의사결정 모델 공개 기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. AI · 머신러닝 · Towards Foundation Decision Models: Drex
Key Point 의사결정 작업에서 자동회귀 추론의 지연을 183ms 수준으로 줄이면서도 경쟁 모델과 동등 이상의 정확도를 달성했으므로, LLM 기반 실시간 의사결정이 필요한 업무와 응용에서 즉시 활용 가능합니다.
핵심 요약
기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. Decision Models는 이를 해결하기 위해 질문과 선택지를 받아 자동회귀 디코딩 없이 선택지 확률 분포를 바로 반환합니다. Hugging Face는 Drex라는 의사결정 모델 4개 계열을 공개했습니다: 8B(DLM), 9B(v1.5), 35B 3개 활성(v2.0), 27B(Max) 파라미터 모델입니다. 전체 요약 11문장 읽기 → 023 12:54 ▲ 101 · 댓글 44 혼합 전문가 모델 인클링 2 스몰 공개 싱킹머신즈(Thinking Machines)가 594B 파라미터(활성 17B)의 혼합 전문가 모델 인클링 2 스몰을 발표했으며, 이미지 입력과 가변 계산 노력을 지원한다. AI · 머신러닝 · Inkling 2 Small
Key Point 오픈 가중치 공개가 임박한 최신 혼합 전문자 모델로 코딩·추론·금융 작업에서 경쟁 모델을 앞서며, 자율 학습으로 모델 개선을 입증했기 때문이다.
핵심 요약
싱킹머신즈(Thinking Machines)가 594B 파라미터(활성 17B)의 혼합 전문가 모델 인클링 2 스몰을 발표했으며, 이미지 입력과 가변 계산 노력을 지원한다. 인공 분석 인텔리전스 인덱스에서 31점을 기록해 이전 세대 모델 대비 에이전트 코딩, 비전, 지식 작업, 추론 영역에서 성능이 향상됐다. 모델은 현재 틴커(Tinker)를 통해 폐쇄 가중치로 제공되며, 외부 안전 테스트와 레드팀 완료 후 다음 주 Apache 2.0 라이선스로 전체 가중치를 공개할 예정이다. 전체 요약 12문장 읽기 → 024 15:11 ▲ 60 · 댓글 2 로봇 조작, 인코더 없는 시각-언어 모델로 더 정확하게 기존 비전-언어-액션 모델은 시각 인코더로 이미지를 먼저 압축한 후 행동 추론을 시작하지만, 조작 작업에 필요한 국소적 기하학·경계·깊이·미묘한 상태 변화 같은 시각 신호들이 손실될 수 있다. AI · 머신러닝 · From Pixels to Actions - Towards Native Vision-Language-Action Policies
Key Point 로봇 팔 같은 구체화된 제어 시스템이 최종 표현이 아닌 중간 단계의 시각 신호에서 더 정확한 정보를 얻을 수 있다는 발견은 로봇 공학과 구체화 AI의 아키텍처 설계 원칙을 바꿀 가능성이 있다.
핵심 요약
기존 비전-언어-액션 모델은 시각 인코더로 이미지를 먼저 압축한 후 행동 추론을 시작하지만, 조작 작업에 필요한 국소적 기하학·경계·깊이·미묘한 상태 변화 같은 시각 신호들이 손실될 수 있다. NEO-VLA는 인코더 없는 구조의 비전-언어-액션 프레임워크로, 이미지를 경량 패치 합성곱 층으로 토큰화한 뒤 백본 전체에서 언어와 함께 진화하도록 설계했다. 흐름-매칭 액션 전문가가 백본의 다양한 깊이에서 명령 조건부 시각 표현에 접근할 수 있어, 최종 시각 표현뿐 아니라 계산 계층 전체의 정보를 활용한다. 전체 요약 6문장 읽기 → 025 15:11 ▲ 18 · 댓글 3 반복 최적화하는 3D 구조 재구성 모델 'Solv3R' 공개 기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. AI · 머신러닝 · Solv3R: 3D Looped Transformer as a Multi-view Solver
Key Point 카메라 포즈 추정과 3D 기하 재구성을 점진적으로 개선하는 방식을 학습 가능한 솔버로 통합해, 새로운 이미지 추가나 기존 결과 정제가 자유로워졌다.
핵심 요약
기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. Solv3R은 반복 루프 구조로 현재 상태에서부터 계속 3D 기하를 풀어나가는 루프 변환기(looped transformer)이며, 이미 정제된 뷰와 새로 추가된 뷰를 함께 업데이트할 수 있다. 업데이트 연산자가 반복 횟수와 독립적으로 작동하므로, 각 뷰가 얼마나 정확한지와 관계없이 동일하게 처리된다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 104 · 댓글 2 로봇 범용 작업 위한 대규모 비전-언어 모델, 실제 얼마나 쓸 수 있나 로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. AI · 머신러닝 · Are Frontier VLM Agents Ready to Be Robot Generalists? An Empirical Study with the Embodied Agent Arena
Key Point 현재 최첨단 VLM 에이전트들이 로봇 조작 작업에서 구체적으로 어떤 한계를 보이는지, 폐쇄형과 오픈 모델의 성능 격차가 어디서 비롯되는지 체계적으로 밝혔다.
핵심 요약
로봇이 장면을 이해하고 행동하며 과제 조건을 충족하려면 어떤 능력이 필요한지 평가하기 위해 '구현된 에이전트 아레나'라는 벤치마크를 소개한다. 이 벤치마크는 기하학, 공간 추론, affordance, 작업 계획, 조작 5개 영역을 평가하며, 32개 기존 데이터셋과 카메라·동작·깊이·스케일 추정을 위한 새로운 168개 케이스 GeoProbe로 총 1,000개 사례를 구성한다. 10개 VLM 에이전트를 평가한 결과, 폐쇄형 가중치 모델들이 5개 영역 모두에서 앞섰으나 오픈 가중치 VLM은 공간 추론은 유용하지만 계획과 조작 성공률이 훨씬 낮았다. 전체 요약 8문장 읽기 → 027 03:11 ▲ 144 · 댓글 28 킴(Kimi) K3.1 Pro 오픈 가중치 공개 쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. AI · 머신러닝 · Kimi K3.1 Pro model weights are out
Key Point 중국 AI 스타트업이 공개한 초대형 멀티모달 모델의 가중치가 외부에 공개되어 오픈소스 커뮤니티에서 자유롭게 실험·파인튜닝할 수 있게 됐고, OpenAI·Anthropic 모델들과의 벤치마크 비교를 통해 오픈 모델의 현재 수준을 파악할 수 있다.
핵심 요약
쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. 100만 토큰 컨텍스트 윈도우를 지원하며, 코딩·3D 생성·금융 조사·사실 정확도·에이전트 기능 등에서 큰 개선을 이뤄냈다. 총 파라미터 2.8T, 활성화 파라미터 104B, 93개 레이어, 전문가 896개(토큰당 16개 활성화)의 Mixture-of-Experts 아키텍처를 사용한다. 전체 요약 10문장 읽기 → 028 18:11 ▲ 57 · 댓글 2 영상 확산 모델으로 범용 행동 표현 학습하는 DreamX 발표 비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. AI · 머신러닝 · DreamX: Video Diffusion Model is a Universal Latent Action Learner
Key Point 로봇과 인간 간 행동을 한 번에 학습하는 시스템으로, 다양한 실체와 환경에서 제로샷 전이가 가능해 로봇 학습 연구의 확장성을 크게 향상시킬 수 있다.
핵심 요약
비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. 기존 잠재 행동 모델은 시각적 변화와 행동을 얽혀 표현해 구현체 간 전이가 어려웠던 반면, DreamX는 비디오 모델의 생성 능력을 활용해 행동 관련 역학만 추출한다. 각 프레임을 1,200개에서 4개 토큰으로 압축해 300배 감소시키며, 의상이나 배경 같은 시각적 변화로부터 행동을 분리한 잠재 공간을 생성한다. 전체 요약 6문장 읽기 → 029 21:11 ▲ 38 · 댓글 1 360도 파노라마도 구성미 판단해 프레이밍하는 AI 기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. AI · 머신러닝 · PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
Key Point 360도 파노라마 이미지의 최적 프레이밍을 자동으로 결정하고 설명해주는 AI 방법이 필요한 3D 콘텐츠 제작과 가상 현실 분야에서 실용적 활용이 가능해진다.
핵심 요약
기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. PhotoGuider는 측정 후 프레이밍 방식으로 구성미 기반 방향 선택과 최종 프레이밍을 모두 해결하는 첫 방법이다. Subject, Composition, Aesthetics, Integrity 네 가지 포토그래픽 토큰으로 구성미를 인식하는 특징을 추출하고, 기초 및 태스크 특화 비전 모델을 사용한다. 전체 요약 7문장 읽기 → 030 18:11 ▲ 33 · 댓글 3 컴퓨터 제어 AI, 실수 복구 능력 체계적으로 평가하기 키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. AI · 머신러닝 · Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
Key Point 컴퓨터 자동화 에이전트의 신뢰성을 높이는 핵심인 '오류 복구'를 처음 체계적으로 평가하고, 현재 AI 모델들이 자신의 복구 능력을 제대로 사용하지 못하고 있다는 실제 한계를 드러낸다.
핵심 요약
키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. 기존 복구 방식은 한계가 있다: 소유권이 있는 시스템은 환경 초기화가 불가능하고, 긴 작업 흐름에서 액션 재실행은 비용이 너무 크며, API 기반 되돌리기는 웹 환경에만 적용되므로 모델 기반 복구는 거의 연구되지 않았다. 연구팀은 ReTrace라는 평가 프레임워크를 제시해 컴퓨터 제어 에이전트의 복구 동작을 체계적으로 연구한다. 전체 요약 8문장 읽기 → 031 15:11 ▲ 31 · 댓글 1 대규모 경험으로 AI 컴퓨터 제어 에이전트를 강화하는 NorthCUA NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. AI · 머신러닝 · NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
Key Point 컴퓨터 제어 AI가 복잡한 소프트웨어 작업을 자동화할 수 있는 수준으로 도달하는 과정을 보여주며, 오픈소스 에이전트 개발의 새로운 기준을 제시한다.
핵심 요약
NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. Experience Flywheel이 다양한 실행 가능한 작업을 공급하고, NorthCUA Harness가 장시간 상호작용을 유지하며 의사결정을 기록하고 작업 결과를 검증한다. Flywheel은 이러한 기록으로부터 검증된 궤적(trajectory)을 선별하고, 해결되지 않은 작업은 재귀적 자가개선을 통해 재사용 가능한 스킬을 진화시키면서 검증된 마일스톤을 보존해 이전 진행 과정을 바탕으로 한다. 전체 요약 7문장 읽기 → 032 21:11 ▲ 26 · 댓글 9 단일 영상의 3D 추적, '궤적 수리'로 개선하다 단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. AI · 머신러닝 · ReLift: Dense 3D Tracking as Lifted Trajectory Repair
Key Point 기존 2D 추적과 3D 기하 정보를 활용해 3D 추적 정확도를 높이는 새로운 접근법으로, 앞으로 나올 추적기나 기하 모델 개선의 이득을 자동으로 누릴 수 있는 구조입니다.
핵심 요약
단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. 기존 2D 추적기와 3D 기하학 모델만으로도 폐색 부분을 단순 보간한 '들어올린 궤적'이 전용 3D 추적기 수준의 성능을 낸다. 하지만 이 방식은 대응과 깊이 오차를 상속받으며, 폐색 영역에서 깊이값이 가려진 물체에서 나오는 문제가 있다. 전체 요약 7문장 읽기 → 033 21:11 ▲ 20 · 댓글 2 시각 기초 모델, 공간 인식 능력 충분한가 시각 기초 모델이 카메라 시점의 연속 영상에서 보이지 않는 영역을 추적하고 장면을 이해하는 공간 표현을 제공하는지 검증하는 연구다. AI · 머신러닝 · Probing Spatial State Representations in Visual Foundation Models
Key Point 시각 기초 모델이 이미지 인식만 하는 게 아니라 실제 로봇처럼 보이지 않는 물체를 추적하고 행동을 계획할 수 있는 공간 인식 능력이 있는지 정량적으로 검증한 첫 시도로, 현재 모델들의 한계를 명확히 드러낸다.
핵심 요약
시각 기초 모델이 카메라 시점의 연속 영상에서 보이지 않는 영역을 추적하고 장면을 이해하는 공간 표현을 제공하는지 검증하는 연구다. 연구팀은 10개 모델의 표현을 공간 구조·물체 지속성·예측적 공간 업데이트·행동 유도 등 4가지 수준의 능력으로 평가했다. 보이는 장면에서 높은 정확도를 보이는 모델도 물체 지속성(보이지 않는 물체 추적)과 미래 특성 인출(future-feature retrieval)에서는 성능이 떨어진다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 20 · 댓글 2 소형 언어모델로 로봇 조작 명령 프로그래밍하기 로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. AI · 머신러닝 · CaPtain: A Pipeline for Post-Training Code-as-Policy Robot Agents
Key Point 로봇 조작 AI를 프론티어 모델 의존에서 벗어나 오픈소스 소형 모델로도 실현할 수 있게 하는 구체적 방법과 검증 결과를 제시한다.
핵심 요약
로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. 연구팀이 공개한 CaPtain은 소형 오픈소스 비전-언어 모델(Qwen 3.5-4B)을 미세조정과 강화학습으로 독립적인 로봇 정책 에이전트로 훈련하는 파이프라인이다. 파이프라인은 CaPtain-Harness라는 프레임워크 위에서 동작하며, 로봇 API, 저수준 인지·기하학·안전 이동 원시 동작을 시뮬레이션과 실제 하드웨어에서 노출한다. 전체 요약 8문장 읽기 → 035 09:11 ▲ 103 · 댓글 56 다양한 감각의 AI가 같은 세계를 본다는 증명 Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. AI · 머신러닝 · Proving and improving the Platonic Representation Hypothesis with JEPAs
Key Point 서로 다른 모달리티 모델들이 같은 표현에 수렴한다는 오랜 추측을 수학적으로 증명하면서, 언어 모델이 비전과 정렬되는 방식의 근본적 차이를 밝혔고, 스케일보다 학습 데이터 품질이 중요함을 입증했다.
핵심 요약
Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. 저자들은 '플라톤적 표현 정리(Platonic Representation Theorem)'를 증명했다. 결합 임베딩 예측 아키텍처(JEPA)가 서로 다른 모달리티로 학습될 때, 긍정 쌍이 같은 장면의 두 관찰('좋은 뷰')이고 오정렬이 제한되면 회전을 제외하고 동일한 표현을 학습한다는 뜻이다. 다음 토큰 예측(언어 모델의 기본 방식)은 나쁜 뷰(한 문서의 일부)를 사용하는 JEPA로, 이는 언어 모델이 스케일을 통해서만 비전과 정렬되는 이유를 설명한다. 전체 요약 8문장 읽기 → 036 09:11 당일 +272 PyTorch 기반 미분 가능한 컴퓨터비전 라이브러리 kornia PyTorch 위에 구축된 kornia는 1200개 이상의 미분 가능한 이미지 처리 및 기하학 알고리즘을 제공하는 컴퓨터비전 라이브러리다. AI · 머신러닝 · kornia/kornia · Python
Key Point GPU 배치 처리와 미분 가능성을 갖춘 컴퓨터비전 연산 1200개 이상을 제공해 기존 라이브러리로는 불가능한 기하학 문제를 PyTorch 모델에 직접 통합할 수 있다.
핵심 요약
PyTorch 위에 구축된 kornia는 1200개 이상의 미분 가능한 이미지 처리 및 기하학 알고리즘을 제공하는 컴퓨터비전 라이브러리다. 배치 변환, 자동 미분, GPU 가속을 통해 AI 워크플로우에 통합되며, torchvision에 없는 카메라 모델·에피폴라 기하·특성점 매칭·모폴로지 연산 등을 지원한다. 샘플당 매개변수를 배치 호출로 처리할 수 있어 가우스 블러의 시그마를 (B, 2) 텐서로, 회전각을 (B,) 텐서로 받으며 torchvision은 호출마다 한 매개변수만 적용한다. 전체 요약 10문장 읽기 → 037 06:11 ▲ 113 · 댓글 132 수학은 변했다, 우리도 행동해야 한다 OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. AI · 머신러닝 · Mathematics has changed. Let's act like it
Key Point AI가 증명 생산 방식을 근본적으로 바꾸면서 수학 학계의 평가, 채용, 출판 시스템 전체를 재설계해야 하는 시점이 왔다.
핵심 요약
OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. 그러나 AI 회사들의 논문은 문장이 형편없고 출처 표기가 부실하며 일부는 틀렸으므로, 수학 커뮤니티는 채용, 출판, 학생 교육에서 더 많은 통제력을 행사해야 한다. AI가 Langlands 프로그램 같은 중앙 문제들을 풀었다 해도, 그것이 수론 전체를 '해결'하는 것은 아니며, 이는 원소 주기율표 발견이 화학을 완성하지 못한 것과 같다. 전체 요약 12문장 읽기 → 038 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 039 06:11 ▲ 60 · 댓글 4 서로 다른 모달리티도 같은 표현으로 수렴한다는 가설을 증명했다 여러 모달리티로 학습한 AI 모델들이 결국 같은 세계 표현에 도달하는지 묻는 플라톤 표현 가설(PRH)을 수학적으로 증명했다. AI · 머신러닝 · Proving and Improving the Platonic Representation Hypothesis with JEPAs
Key Point 다양한 모달리티 간 표현 정렬의 핵심 메커니즘을 수학적으로 입증했으며, 규모보다는 학습 방식의 질이 중요함을 보여주므로 멀티모달 AI 개발 방향에 직접 영향을 미친다.
핵심 요약
여러 모달리티로 학습한 AI 모델들이 결국 같은 세계 표현에 도달하는지 묻는 플라톤 표현 가설(PRH)을 수학적으로 증명했다. 공동 임베딩 예측 아키텍처(JEPA)를 여러 모달리티로 따로 학습하면, 긍정 쌍이 같은 장면의 두 관찰('좋은 뷰')일 때 회전을 제외한 동일한 표현을 학습한다는 정리를 증명했다. 다음 토큰 예측은 나쁜 뷰(한 문서의 일부)를 가진 JEPA이며, 이것이 언어 모델이 규모 확대를 통해서만 비전과 정렬되는 이유를 설명한다. 전체 요약 8문장 읽기 → 040 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 041 18:11 ▲ 101 · 댓글 3 확인된 부분만 처리하는 비전-언어 모델, 연산 35% 수준으로 줄인다 Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. AI · 머신러닝 · Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
Key Point 비전-언어 모델의 추론 속도를 현격히 높이는 기술로, 대규모 멀티모달 모델을 실제 제품에 적용하려는 개발자들에게 중요한 최적화 방안을 제시한다.
핵심 요약
Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. 연구팀이 LLaDA-V 모델의 예측을 검토한 결과, 이미지 제거 시 토큰 언마스킹이 변하는 경우가 평균 22.8%, 최저 7.9%에 불과했다. LOWN이라는 새로운 디코딩 방식을 제안했으며, 매 단계마다 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정한다. 전체 요약 7문장 읽기 → 042 18:11 ▲ 40 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 043 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 044 18:11 ▲ 30 · 댓글 2 로봇 모델 평가, 비용 없이 미리 걸러낸다 로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. AI · 머신러닝 · Sensorimotor Alignment: A Platonic Proxy for Embodied Policy Success
Key Point 로봇 모델을 평가하는 데 드는 비용과 시간을 대폭 줄일 수 있는 방법이 제시되어, 로봇 AI 개발 파이프라인의 효율성이 크게 바뀔 수 있다.
핵심 요약
로봇 파운데이션 모델은 보통 비싼 실제 테스트(closed-loop rollout)로 평가되는데, 연구팀이 저비용 오프라인 방식을 제안했다. 플라토닉 표현 가설(PRH)은 모델 능력이 높아질수록 비전·언어처럼 모달리티들이 현실의 같은 통계 모델로 수렴한다고 본다. 연구진은 움직임 궤적도 이런 모달리티인지 묻고, 감각 표현이 물리 운동의 구조와 얼마나 잘 맞는지 측정하는 S²(Sensorimotor Alignment) 지표를 만들었다. 전체 요약 8문장 읽기 → 045 12:11 ▲ 10 · 댓글 2 항공 영상에서 각진 상자 예측으로 객체 위치 파악 개선 항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. AI · 머신러닝 · OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
Key Point 항공 영상에서 임의 각도로 나타나는 객체를 정확히 찾는 것이 실제 필요한데, 기존 기법은 수평 상자만 지원해 성능이 크게 떨어진다는 문제를 해결했다.
핵심 요약
항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. Parallel Box Decoding(PBD) 방식을 확장해 4개 좌표 대신 6개 슬롯의 각진 표현을 사용했으며, 이중각도 매개변수화(double-angle parameterization) 기법을 적용했다. 이미지와 프롬프트를 섞는 제어실험, 가시성·누수 프로브를 통해 모델이 손실 곡선이 아니라 실제로 이미지와 텍스트 프롬프트 모두에 의존하는지 검증했다. 전체 요약 5문장 읽기 → 046 06:11 ▲ 28 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 047 18:11 ▲ 90 · 댓글 2 이산 토큰, 연속 표현 수준의 시각 정보 담을 수 있을까 이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. AI · 머신러닝 · Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
Key Point 이산 토큰 기반 시각 표현이 그동안 한계로 간주해온 의미 손실 문제를 실질적으로 극복했으며, 멀티모달 기초 모델의 구조 선택에 영향을 미칠 가능성이 있다.
핵심 요약
이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. 기존 가정과 달리, 양자화 오류 크기와 의미 손실 사이에는 신뢰성 있는 상관관계가 없으며, 오류가 크더라도 더 나은 이해 성능을 낼 수 있다. 이산 토큰의 실질적인 비트 예산이 다운스트림 성능의 주요 결정 요소로 나타났으며, 기존 양자화기는 코드북이 증가할수록 의미 정보 기여도가 감소해 포화 현상이 발생한다. 전체 요약 8문장 읽기 → 048 18:11 ▲ 22 · 댓글 2 LLM에 로봇 제어 패널만 달면 VLA 모델을 이긴다 로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. AI · 머신러닝 · RoboHarness: A Simple Harness Outperforms VLA and World Action Models
Key Point 대규모 로봇 학습 데이터 없이도 기존 LLM으로 로봇 제어가 가능하다는 것을 보였기에, 구체화된 AI 개발의 패러다임 전환 가능성을 시사한다.
핵심 요약
로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. 연구팀은 RoboHarness라는 로봇 제어 인터페이스를 제시해, LLM이 시각-기하학적 제어판을 통해 직접 로봇 동작을 이해하고 호출할 수 있게 했다. VLA 모델 대신 코딩 능력이 있는 LLM 에이전트에 간단한 로봇 장치만 제공하면, 로봇 조작 작업을 수행할 수 있다는 가정에 기반한다. 전체 요약 5문장 읽기 → 049 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 050 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 051 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 052 12:11 ▲ 418 · 댓글 2 공간 인식 AI, 다중 질문 형식을 동시에 학습하는 기법 제시 공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. AI · 머신러닝 · ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence
Key Point 공간 인식 AI가 여러 형식의 질문을 동시에 잘 답하기 위한 학습 구조를 제시해 멀티태스크 비전언어모델의 효율성을 크게 높일 수 있는 실마리를 제공한다.
핵심 요약
공간 비전언어모델(VLM)을 단일 형식으로 학습하면 한 종류의 질문(예: 사물의 위치)에만 성능이 높고 다른 형식(거리 추정)으로의 전이가 약해지는 '인터페이스 락-인' 현상이 발생한다. ChronoReplay는 다양한 공간 감독을 시간 순서대로 에피소드 형태로 반복 재생하고 각 형식의 원본 목표를 유지하면서 감독 신호를 균형 있게 분배하는 방식으로 이 문제를 해결한다. 동일한 시각 정보 접근 조건에서 ChronoReplay 체크포인트는 OVO-S-Bench, OST-Bench, UCS-Bench 세 벤치마크를 동시에 개선하며, 특히 OST-Bench에서 13.41포인트 향상을 달성했다. 전체 요약 6문장 읽기 → 053 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 054 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 055 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 056 00:11 ▲ 11 · 댓글 2 단일 이미지에서 3D 장면 재구성, 객체 기반 접근법으로 품질 향상 단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. AI · 머신러닝 · Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
Key Point 3D 장면 재구성 품질을 높이는 새로운 구성 방식의 등장으로, 컴퓨터 비전 모델 설계 방향을 보여주는 선례입니다.
핵심 요약
단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. 연구팀은 Easy-3Dfy라는 구성 기반 워크플로우를 제안했으며, 이는 객체 생성과 장면 배치 추정을 분리해 각 모델의 강점을 활용한다. 특화된 3D 객체 생성기는 상세한 객체 기하학을, 3D 기초 모델은 강력한 공간 이해를 각각 담당하도록 설계했다. 전체 요약 6문장 읽기 → 057 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 058 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 059 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 060 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
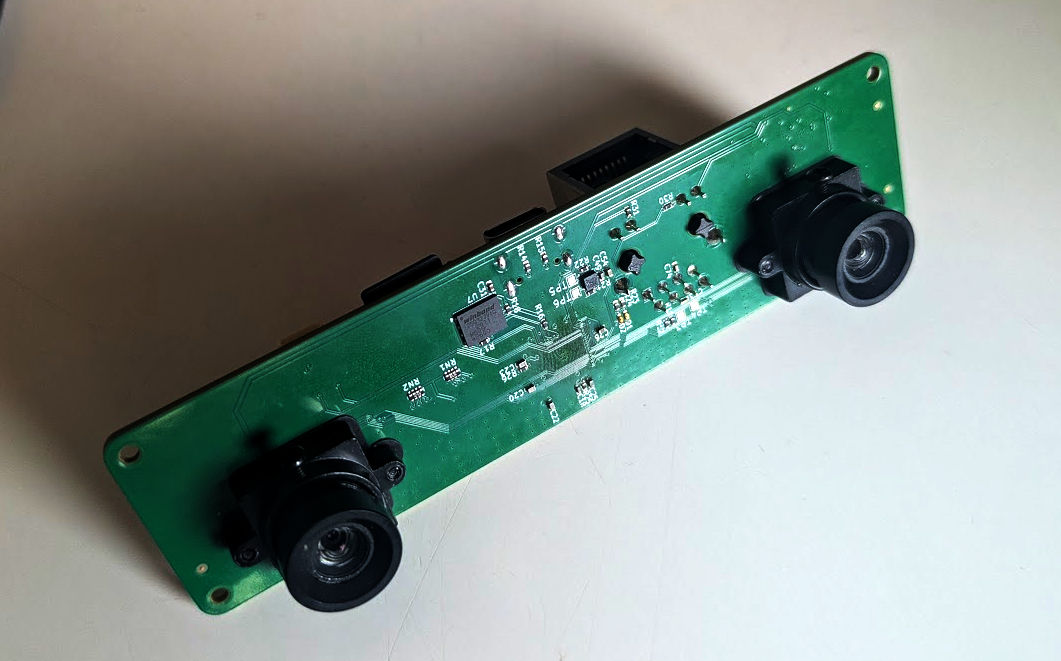
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 061 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 062 21:11 당일 +124 원신 자동화 도구 BetterGI, 컴퓨터 비전으로 게임 플레이 자동화 BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 오픈소스 · 도구 · babalae/better-genshin-impact · C#
Key Point 게임을 하지 않아도 자동화 도구가 모든 일일 퀘스트를 완료해주는 기술 방식과 잠재적 밴 위험이 원신 플레이어와 게임 규제 관점에서 주의 깊게 봐야 할 대상이다.
핵심 요약
BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 자동 물품 수거, 자동 스토리 진행, AI 기반 반자동 낚시, 자동 성유물 분해 등 실시간 작업 기능을 제공한다. 전자동 신의 주사위 게임, 자동 벌목, 자동 비경, 자동 지맥의 꽃, 자동 악기 게임, 자동 요리 등 독립 작업 기능도 포함된다. 전체 요약 10문장 읽기 → 063 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 064 03:11 새 버전 올라마, 엔비디아 네모트론 3.5 볼트 지원 올라마 v0.40.10에서 엔비디아의 네모트론 3.5 볼트 E4B 멀티모달 언어 모델을 지원한다. AI · 머신러닝 · ollama/ollama@v0.40.10
Key Point 로컬에서 실행 가능한 경량 멀티모달 모델의 추가로 더 낮은 리소스에서 온디바이스 AI를 사용하려는 개발자의 선택지가 늘었다.
핵심 요약
올라마 v0.40.10에서 엔비디아의 네모트론 3.5 볼트 E4B 멀티모달 언어 모델을 지원한다. 네모트론 3.5 볼트는 젬마 4 기반의 경량 비전-언어 모델로 로컬 대화, 이미지 이해, 도구 사용에 최적화되어 있다. 128K 토큰의 긴 컨텍스트 윈도우를 지원하며 추측 디코딩을 위한 드래프트 모델을 포함하고 있다. 전체 요약 4문장 읽기 → 065 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 066 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 067 18:11 ▲ 19 · 댓글 3 테스트 시점 회귀로 토큰 압축 성능 대폭 개선 언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. AI · 머신러닝 · Rethinking Sequence Compression with Test-time Regression
Key Point 기존 풀링·투영 방식의 약점을 해결하면서 더 적은 토큰으로 더 나은 성능을 달성하는 새로운 압축 기법이 여러 과제에서 검증됐다.
핵심 요약
언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. 새로운 접근으로 입력 토큰을 회귀 문제로 본 후, 피팅된 계수를 압축 표현으로 삼는 TTR-Compressor를 제시한다. 회귀 문제는 역전파로 엔드투엔드 학습하되, 순전파 중에는 폐쇄형 식으로 계수를 효율적으로 계산한다. 전체 요약 6문장 읽기 → 068 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 069 18:11 ▲ 38 · 댓글 2 세밀한 시각 이해를 위해 생성 모델의 정보 활용 세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. AI · 머신러닝 · What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
Key Point 멀티모달 모델에서 생성 능력이 이해 성능까지 높일 수 있다는 새로운 접근법을 보여주며, 공간 관계 같은 세밀한 차이 구별이 중요한 시각 작업에서 실질적 개선을 입증했다.
핵심 요약
세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. 통합 멀티모달 모델(UMM)에서 생성 경로는 이해 경로를 보완하는 풍부한 시각 정보를 보존하지만, 기존 방식들은 생성 측 표현을 직접 활용하지 않았다. 연구팀은 생성 측 표현이 세밀한 의미 변화에 더 민감하고, 이해 측에서 놓치는 작업 관련 변화를 포착하며, 공간 구조에 올바르게 의존한다는 것을 발견했다. 전체 요약 6문장 읽기 → 070 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 071 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 072 15:11 ▲ 26 · 댓글 2 세 가지 능력을 하나로 담은 시각 인코더 ALPS 공개 World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. AI · 머신러닝 · ALPS: Visual State Encoders for World Models
Key Point 월드 모델의 비전 백본이 예측, 제어, 검증을 모두 지원할 수 있는 통합 인코더를 처음 제시하여 로봇 학습 파이프라인의 설계 방식을 바꿀 수 있다.
핵심 요약
World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. 기존 인코더는 이 세 가지 중 하나나 둘만 담당하는 반면, ALPS는 ViT-B/16 기반 프리트레인된 시각 상태 인코더로 세 능력을 모두 통합한다. 정지 이미지와 텍스트만 사용하여 언어, 재구성, 공간적 대응 목표로 처음부터 학습한 후 교차 뷰 자기 증류로 미세 조정했다. 전체 요약 7문장 읽기 → 073 15:11 ▲ 484 · 댓글 2 다중분광 이미지 해석용 위치-채널 기반 설명 방법 다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. AI · 머신러닝 · Spectral-Spatial Interpretation
Key Point 위성·의료영상 등 다중분광 데이터를 다루는 컴퓨터 비전 모델에서 어느 파장대 어느 위치가 결정에 영향을 미치는지 정확히 파악할 수 있게 되면 모델 해석 능력이 한 단계 높아진다.
핵심 요약
다중분광 데이터에서 모델이 어느 위치의 어떤 채널을 중시하는지 한 번에 보여주는 SSI(Spectral-Spatial Interpretation) 방법을 제시한다. 기존 방식은 공간적 히트맵이나 전역 채널 점수만 보여주는데, SSI는 각 위치마다 채널 간 상호작용을 조건부 게임으로 정의하고 샤플리 값을 적용해 위치-채널 기여도 행렬을 생성한다. 고정된 주변 맥락 속에서 각 위치의 채널별 중요도를 계산하며, 채널 기여도를 모두 합산하면 그 위치를 기준 이미지로 교체했을 때의 효과와 정확히 일치한다. 전체 요약 6문장 읽기 → 074 06:11 ▲ 271 · 댓글 67 Mistral Large 4, 1.05조 매개변수 멀티모달 모델 공개 Mistral이 최신 범용 멀티모달 모델 Mistral Large 4를 공개했다. AI · 머신러닝 · Mistral Large 4
Key Point 1조 개 이상의 매개변수를 가진 오픈 가중치 모델 공개로 다양한 개발자가 최신 멀티모달 AI를 직접 배포·커스터마이징할 수 있게 되었다.
핵심 요약
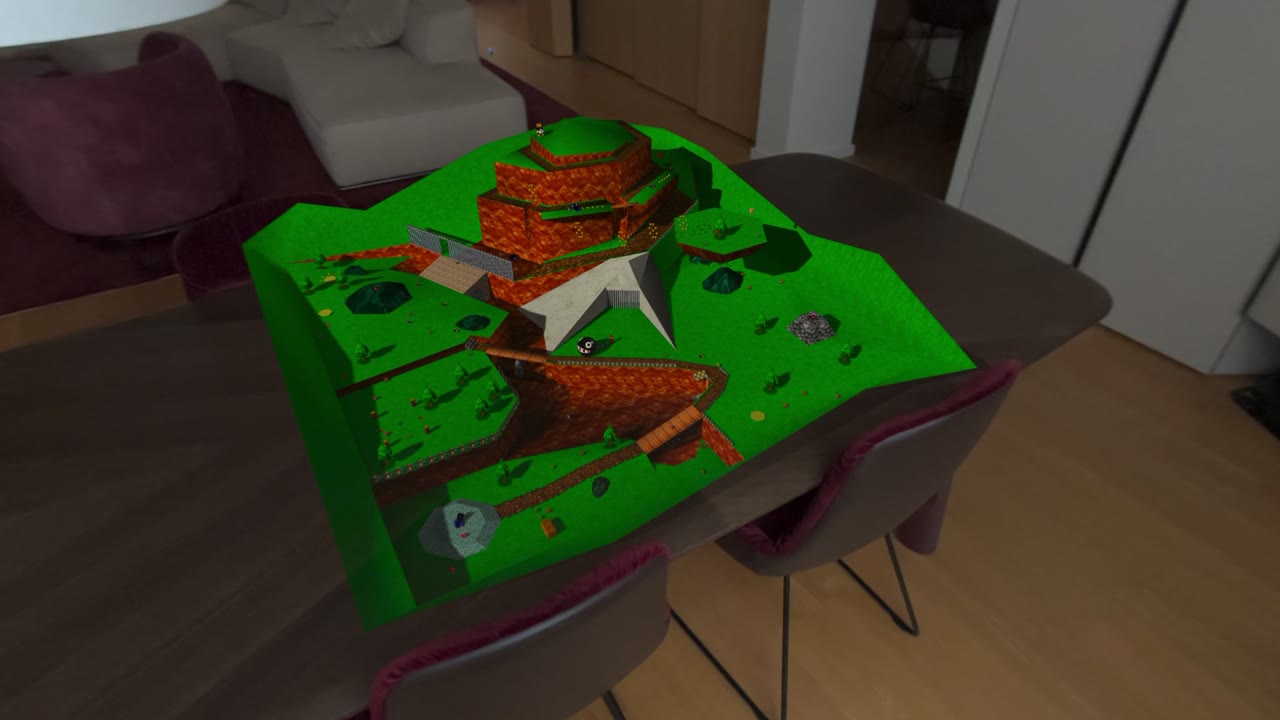
Mistral이 최신 범용 멀티모달 모델 Mistral Large 4를 공개했다. 52B의 활성 매개변수와 1.05조 개의 전체 매개변수를 가진 오픈 가중치 모델이다. 1.6B 크기의 비전 인코더를 내장해 이미지를 이해할 수 있다. 전체 요약 8문장 읽기 → 075 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 076 21:11 ▲ 100 · 댓글 58 네브래스카의 핫도그 대포, 30년간 2만 발을 쏘다 1996년 마크 루드는 필라델피아 필리즈에서 사용하던 핫도그 런처를 보고, 자신이 일하는 페어버리 미트의 제품 홍보에 활용할 수 있겠다는 생각을 했다. 기타 · 'Der Viener Schlinger': The meat cannon that launched 20k hot dogs
Key Point 네브래스카 대학의 30년 전통 핫도그 대포가 공학 개선과 안전 논쟁을 거쳐 2만 발을 발사한 미국 스포츠 문화의 특이한 사례를 보여준다.
핵심 요약
1996년 마크 루드는 필라델피아 필리즈에서 사용하던 핫도그 런처를 보고, 자신이 일하는 페어버리 미트의 제품 홍보에 활용할 수 있겠다는 생각을 했다. 1997년 네브래스카 허스커스 풋볼 홈경기에 '더 비너 슐링거'라는 이름으로 첫 선을 보인 이 장치는 CO2 탱크와 압축 가스 원리로 동작하며, 초기에는 시속 70마일 거리 150피트까지 핫도그를 발사할 수 있었다. 운영을 맡은 콘래드 굿은 전역 후 2015년까지 18시즌 동안 매 경기마다 25개씩 발사했고, 이후 팀 엘리커가 후임자로 들어섰다. 전체 요약 12문장 읽기 → 077 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 078 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 079 00:11 ▲ 11 · 댓글 2 산업용 로봇 조작 평가 벤치마크 'LIBERO-Industry' 공개 LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 하드웨어 · 시스템 · LIBERO-Industry: Benchmarking Robotic Manipulation under Industrial Process Constraints
Key Point 실제 제조 환경의 복잡한 제약을 반영한 평가 지표가 없어 범용 로봇 정책의 산업 적용 가능성을 정확히 측정할 수 없었는데, 이제 체계적인 벤치마크로 검증할 수 있게 됐다.
핵심 요약
LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 유연 제조(고혼합·소량 생산) 환경에서 로봇이 대응해야 하는 제품 변종, 이동 재료 흐름, 제한된 작업 시간, 기하학적 공차 같은 산업용 제약을 반영했다. 3가지 작업 시나리오(정적→동적 로딩, 동적→정적 언로딩, 동적→동적 전달)로 구성되며 총 216개 태스크를 포함한다. 전체 요약 7문장 읽기 → 080 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 081 15:11 ▲ 155 · 댓글 3 인간의 경험에서 배우는 홀리스틱 세계 이해 시스템 머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. AI · 머신러닝 · Holi-World: Building Holistic World Intelligence from Human-Ego Experience
Key Point 인간의 일상 영상에서 자동으로 학습 데이터를 만들어 세계 이해 AI를 훈련하는 새로운 방식을 제시해, 값비싼 수동 주석을 줄이면서 지각 AI의 실용적 확장을 가능하게 한다.
핵심 요약
머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. HOLI-WORLD는 카메라 캡처·세계 표현·자동 데이터 구성·모델 학습·평가를 통합하는 생태계로, 수동 주석 의존성을 줄인다. HOLIWORLD-Foundry는 정적·동적 인식을 결합해 장면 구조·물체 상태·상호작용 이력을 자동으로 연결하는 '세계 기록'을 구성한다. 전체 요약 8문장 읽기 → 082 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 083 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 084 21:11 ▲ 33 · 댓글 4 샤오미, 영역 지정 이해 강화한 4B 멀티모달 모델 공개 샤오미가 Qwen3.5 기반의 4B 멀티모달 대형언어모델(MLLM) Xiaomi-Lens-0을 발표했다. AI · 머신러닝 · Xiaomi-Lens-0 Technical Report
Key Point MLLM이 이미지의 구체적 영역을 지시하고 추론하는 능력을 획기적으로 개선했으며, 마스크 감독 방식의 혁신이 다른 멀티모달 모델 개발에 영향을 줄 수 있다.
핵심 요약
샤오미가 Qwen3.5 기반의 4B 멀티모달 대형언어모델(MLLM) Xiaomi-Lens-0을 발표했다. 기존 MLLM은 전체 이미지 질문에는 강하나 세밀한 영역 이해에 약한데, 텍스트 감독만으로는 어느 영역이 답변을 지지하는지 명시되지 않기 때문이다. Xiaomi-Lens-0은 자신의 시각 표현에서 마스크를 예측하는 방식으로 이를 해결한다. 전체 요약 7문장 읽기 → 085 18:11 ▲ 15 · 댓글 2 이미지-텍스트 모델, 속성-객체 연결 약하다 비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. AI · 머신러닝 · Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Key Point CLIP, DINOv2 등 대중적인 비전-언어 모델이 기본적인 속성 구분을 못 하는 약점을 드러냈으며, 실제 멀티모달 검색 품질 개선에 직결된다.
핵심 요약
비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. 기존 벤치마크는 모달리티 쌍, 객체 개수, 속성 유형이 제한적이어서 모델의 바인딩 능력을 제대로 평가하지 못했다. 연구팀은 4가지 이미지-텍스트 모달리티 쌍, 다양한 속성 유형, 최대 10개 객체를 포함하는 SABER 벤치마크를 개발했다. 전체 요약 7문장 읽기 → 086 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 087 15:11 ▲ 164 · 댓글 2 비전-언어 모델이 3D 공간을 직접 탐색하며 추론하는 방법 시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. AI · 머신러닝 · Learning to Think and Explore in 3D World
Key Point 3D 환경에서 능동적으로 탐색해야만 답할 수 있는 문제에서 기존 상용 모델을 능가하는 오픈소스 모델 사례를 제시하며, VLM의 추론 능력을 확장하는 새로운 학습 패러다임을 보여줍니다.
핵심 요약
시각언어모델(VLM)이 한 번에 한 장의 이미지만 입력받아 3D 환경과 상호작용하면서 능동적으로 탐색하도록 학습하는 새로운 접근을 제시했습니다. 초기 질문과 첫 번째 관점에서 시작한 뒤, 모델이 반복적으로 추론하고 이동·회전 같은 행동을 통해 시점을 변경하며 최종 답변을 제출하는 방식입니다. 궤적 감독 미세조정 후 강화학습(RL)을 적용했으며, 보상은 최종 답변 정확도로만 주어져서 모델이 어떤 시점을 방문할지는 스스로 학습합니다. 전체 요약 8문장 읽기 → 088 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 089 09:11 ▲ 10 · 댓글 2 로봇 비전-언어 모델에 사용자 맞춤과 안전 기능을 더하다 현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. AI · 머신러닝 · CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
Key Point 실제 로봇 지원의 핵심인 사용자 맞춤화와 안전성 문제를 해결하는 구체적 방법론을 제시하며, 위반율 8.6배 감소, 복구 성공률 6배 증가라는 검증 가능한 결과를 보여준다.
핵심 요약
현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. CarryOn은 기존 VLA 정책을 보강하는 이중 루프 시스템으로, 사용자 선호도와 장면 맥락을 유지하면서 상호작용을 통해 지속적으로 업데이트하는 '계획 루프'를 갖춘다. 계획 루프는 사용자의 지속적인 선호도를 반영하여 맞춤형 부분 작업을 선택하고, 대화와 변화하는 장면 속에서 실행을 조율한다. 전체 요약 7문장 읽기 → 090 06:11 ▲ 102 · 댓글 28 PS5에서 언어모델 서버 구축, 집 전체 기기에서 사용 PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 하드웨어 · 시스템 · Llama.cpp on a jailbroken PS5: run any GGUF model natively on the console
Key Point 탈옥 PS5를 개인 서버로 변환하여 클라우드 없이 로컬에서 언어모델을 운영할 수 있으며, TV 기반 관리 인터페이스와 기존 AI 도구와의 호환성이 실용성을 높인다.
핵심 요약
PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 콘솔의 RDNA 2 GPU와 11.4GB 공유 메모리를 활용하며, llama.cpp가 지원하는 모든 아키텍처와 양자화 기법을 사용할 수 있다. OpenAI의 /v1/chat/completions와 Anthropic의 /v1/messages API를 구현하여 기존 클라이언트(Claude Code 포함)와 호환되며, 브라우저 채팅 인터페이스도 제공한다. 전체 요약 12문장 읽기 → 091 18:11 ▲ 54 · 댓글 2 로봇 제어 성능 높이는 'VLA-Δ' 프레임워크 공개 Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. AI · 머신러닝 · VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Key Point 로봇 제어 분야의 VLA 모델이 물리적 상태 변화를 명시적으로 학습하는 새로운 접근으로 기존 과적합 문제를 해결하고 성능을 향상시킨 점이 중요하다.
핵심 요약
Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. 기존 방법들은 언어·시각·잠재 공간에서 중간 추론이나 미래 상태 예측을 도입했으나, 실제 물리적 상태 전환 자체는 명시적으로 학습하지 않았다. 연구팀은 현재 상태와 미래 상태 간 물리적 변화를 직접 학습 목표로 삼는 VLA-Δ 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 092 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 093 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 → 094 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 095 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 096 15:11 ▲ 30 · 댓글 2 AI 모델의 미래 세계 예측 능력 벤치마크 'WorldCast' 공개 인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. AI · 머신러닝 · WorldCast: Exploring Intelligent Visual Generation in World State Prediction
Key Point 현재 최첨단 모델의 시각적 미래 예측 능력 한계를 명확히 드러내는 벤치마크로, AI의 실제 세계 이해도를 측정하는 중요한 기준을 제시합니다.
핵심 요약
인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. 연구팀이 이러한 능력을 4단계 계층으로 분류했으나 고수준 작업들은 아직 충분히 연구되지 않은 상태다. 이를 해결하기 위해 WorldCast 벤치마크를 개발했으며, 이는 8개 카테고리의 320개 수작업 사례로 구성되고 12개 대표 모델을 평가한다. 전체 요약 8문장 읽기 → 097 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 098 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 099 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 100 03:12 ▲ 16 · 댓글 1 결정형 AI 모델의 적대적 공격 취약성을 측정하는 벤치마크 등장 JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. AI · 머신러닝 · DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision
Key Point 자동화된 의사결정 시스템이 실무에 배포되는 추세 속에서, 이러한 모델들이 적대적 공격에 얼마나 취약한지 체계적으로 측정하고 비교할 수 있는 표준 벤치마크가 처음 제시되었다.
핵심 요약
JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. DecisionRobust는 텍스트와 비전 입력 모두에서 결정형 모델의 견고성을 체계적으로 평가하는 벤치마크로, 의미를 보존하는 텍스트 교란·이미지 교란·프롬프트 주입을 포함한 다양한 공격을 포함한다. 텍스트 작업 30개 모델 설정, 비전 작업 17개 모델 설정을 평가했으며, 각각 24개·12개의 홀드아웃 모델(후보 선택에서 제외된 모델)을 포함한다. 전체 요약 6문장 읽기 →