쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 6일 (금)까지 4095건
11건 · "로봇공학"조건 지우기 ×
001 06:11 ▲ 166 · 댓글 82 천장에 매달린 4개 모터 로봇팔, 800달러 오픈소스로 케이블 구동 방식의 룸스케일 그리퍼 로봇 Stringman이 공개됐다. 4개의 DM-H6215 모터로 천장 모서리에서 케이블을 이용해 실내 전체 영역에 접근할 수 있다. 하드웨어 · 시스템 · Stringman, an $800 open-source room scale gripper robot
Key Point 케이블 드라이브 방식으로 실내 전체를 탐색할 수 있으면서도 800달러라는 저가 오픈소스 로봇이 나왔고, 에이전트 기반 자동화와 교육용으로도 활용 가능한 새로운 로봇 아키텍처를 제시한다.
핵심 요약
케이블 구동 방식의 룸스케일 그리퍼 로봇 Stringman이 공개됐다. 4개의 DM-H6215 모터로 천장 모서리에서 케이블을 이용해 실내 전체 영역에 접근할 수 있다. 7×7×3m 규모의 실내에서 28N의 선 장력 한계 내에 약 2kg의 탑재량을 제공하며, 데스크톱 암 대비 달러당 작업 영역이 약 500배 넓다. 기계 CAD, PCB, 제어 소프트웨어가 모두 오픈소스로 공개되었으며 OSHWA 인증을 받았다. 전체 요약 11문장 읽기 → 002 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 003 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
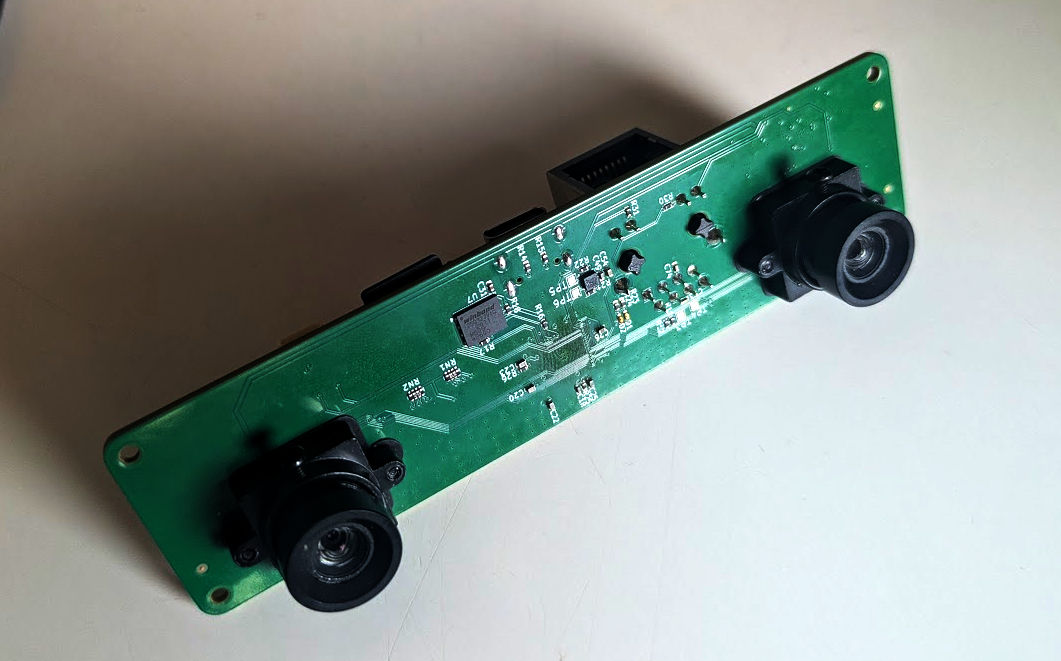
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 004 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 005 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 006 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 007 18:12 ▲ 18 · 댓글 2 3D 물체 생성, 외형을 넘어 물리 움직임까지 담다 물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. AI · 머신러닝 · Towards Physically Grounded Articulated 3D Assets: A Multi-Agent Pipeline and Benchmark
Key Point 3D 생성 모델이 시각적 정확도를 넘어 물리 엔진과의 상호작용까지 만족해야 하는 시대로 나아가는 기술 전환점을 보여주며, 게임 에셋·로봇공학·CAD 등 실무 활용 기준이 크게 변하고 있다.
핵심 요약
물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. 기존 Articraft 방법을 다중 에이전트 파이프라인과 물리 시뮬레이션 피드백으로 확장한 Artisan 시스템을 제안한다. 생성된 3D 자산이 충돌 없이 움직이고, 중력 안정성을 유지하며, 정확한 질량과 재질 속성을 가지도록 한다. 전체 요약 7문장 읽기 → 008 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 009 03:11 ▲ 31 · 댓글 2 체스를 두면서 수를 설명하는 언어모델 'Queen' 공개 기존 체스 엔진은 초인적 수준으로 두지만 수의 이유를 설명하지 못하고, 언어모델은 설명은 가능하지만 두는 실력이 약하다는 문제를 해결한 4B 파라미터 크기의 Queen 모델을 소개했다. AI · 머신러닝 · Language Models that Play Chess and Explain Their Moves
Key Point 전문 모델의 강력한 성능과 언어모델의 설명 능력을 결합하는 새로운 아키텍처로, 체스를 넘어 로봇, 게임 AI 등 여러 도메인에 적용할 수 있는 일반적 프레임워크를 제시한다.
핵심 요약
기존 체스 엔진은 초인적 수준으로 두지만 수의 이유를 설명하지 못하고, 언어모델은 설명은 가능하지만 두는 실력이 약하다는 문제를 해결한 4B 파라미터 크기의 Queen 모델을 소개했다. Queen은 인코더-디코더 아키텍처와 반복적 증류 알고리즘을 결합한 프레임워크를 사용하며, 침묵하는 체스 엔코더를 크로스-어텐션으로 명령어 튜닝된 언어모델과 통합한다. Q&A 커리큘럼을 통해 엔코더의 표현에서 체스 개념을 추출하도록 학습했으며, 벨만 업데이트의 자연어 유사형식으로 설명을 반복 개선한다. 전체 요약 7문장 읽기 → 010 15:11 ▲ 25 · 댓글 2 동영상 생성 모델의 '일괄 증류' 기술 공개 동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. AI · 머신러닝 · LongLive-Plug: Once-for-All Distillation for Video Generation
Key Point 동영상 생성 모델 특화로 인한 반복 학습 비용을 획기적으로 줄이는 기술로, 실제 배포된 54개 모델에서 검증되었기 때문에 현실성 있는 효율화 방안을 제시한다.
핵심 요약
동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. LongLive-Plug는 한 번의 학습으로 여러 모델에 재사용 가능한 기능을 LoRA로 학습하는 일괄 증류 프레임워크다. 단일 패스 분류기 없는 가이던스, 소수 단계 샘플링, 자동회귀 생성의 장기 맥락 오류 보정 기능을 제공한다. 전체 요약 8문장 읽기 → 011 16:18 ▲ 116 · 댓글 3 비전-언어모델의 지능을 로봇 제어로 옮기다 VLM을 로봇 제어에 활용하는 RoboDawn 인터페이스를 제시했다. 로봇이 자신의 시각 상태를 관찰하고 다음 행동을 추론하며 이를 실행하고 결과에 따라 의사결정을 적응시키는 폐루프 방식으로 동작한다. 하드웨어 · 시스템 · Transferring the Intelligence of VLMs to Robotic Control
Key Point 로봇 제어에 사전학습된 대규모 언어-시각 모델을 직접 활용하는 방식이 과제별 학습 없이도 작동하며, 현실 로봇까지 확대되는 경로를 제시해 로봇공학의 실용화 가능성을 높인다.
핵심 요약
VLM을 로봇 제어에 활용하는 RoboDawn 인터페이스를 제시했다. 로봇이 자신의 시각 상태를 관찰하고 다음 행동을 추론하며 이를 실행하고 결과에 따라 의사결정을 적응시키는 폐루프 방식으로 동작한다. 소수의 데모로 VLM을 인터페이스 사용법과 작업 전략에 적응시키는 인-컨텍스트 러닝 기법을 도입했다. 작업별 로봇 학습 없이도 강한 성능을 달성하며, 제로샷 설정에서 기존 정책보다 우수하다. 전체 요약 5문장 읽기 →