쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
58건 · "AMD"조건 지우기 ×
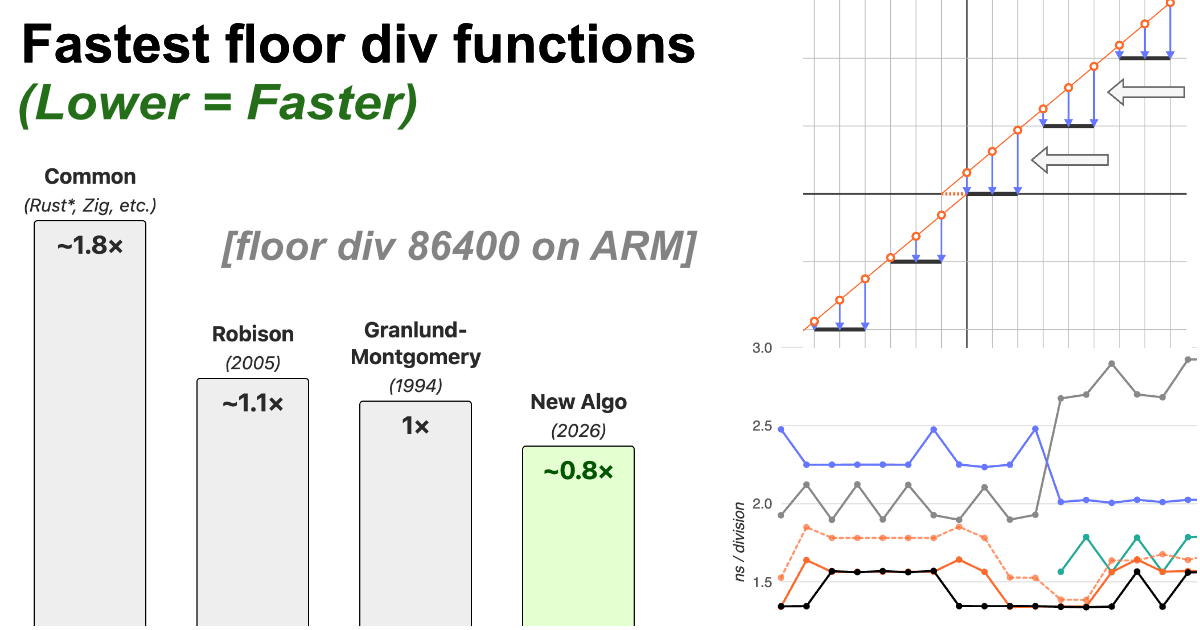
001 00:11 ▲ 123 · 댓글 10 64비트 부호있는 정수 나눗셈을 더 빠르게 하는 새로운 알고리즘 부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 인프라 · 데브옵스 · A new faster algorithm to compute 64-bit signed floor division
Key Point 정수 나눗셈은 단순해 보이지만 음수 처리와 성능 최적화가 깊이 있으며, 다양한 CPU에서 구현 방식을 달리 선택해야 하므로 저수준 성능 최적화가 중요한 시스템 프로그래밍에 실질적 가치가 있습니다.
핵심 요약
부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 컴파일 타임에 나누는 수가 정해진 경우, 기존 방법은 곱셈 1회 + 2~3 사이클 또는 나머지 계산이 필요했으며, 음수 처리를 위해 추가 분기나 비교가 들어갑니다. 1994년 Granlund·Montgomery 논문의 기법을 확장하면 양수 나눗셈을 부호 반사로 처리해 5~6 사이클을 3 사이클로 단축할 수 있고, 2005년 Arch D. Robison 논문은 곱셈-더하기-시프트 조합으로 더 단순한 구현을 제시했습니다. 전체 요약 10문장 읽기 → 002 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 003 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 004 12:11 새 버전 uv 0.13.6 출시, 대규모 프로젝트 메모리 사용량 대폭 감축 uv 0.13.6이 2026년 10월 26일 출시되었다. 오픈소스 · 도구 · astral-sh/uv@0.13.6
Key Point Python 패키지 관리자 uv의 주요 성능 개선판으로, 메모리 효율을 크게 높였고 여러 버그를 수정하여 대규모 프로젝트 작업 시 안정성이 향상되었다.
핵심 요약
uv 0.13.6이 2026년 10월 26일 출시되었다. CPython 3.11.18, 3.12.16, 3.13.18, 3.14.10, 3.15.2 버전을 추가 지원한다. 대규모 워크스페이스 의존성 해결 시 메모리 사용량을 여러 최적화를 통해 감축했고, 대규모 프로젝트 락·업그레이드 시에도 메모리 사용량을 줄였다. 전체 요약 9문장 읽기 → 005 09:11 ▲ 170 · 댓글 52 크로스 플랫폼 AI 키잉 플러그인 CorridorKey 2.0 출시 Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. 오픈소스 · 도구 · CorridorKey 2.0
Key Point VFX 제작자들이 값비싼 소프트웨어 구독을 벗고 한 번의 구매로 주요 편집 도구 전역에서 프로급 자동 키잉을 쓸 수 있게 되는 만큼 워크플로우를 재편할 수 있다.
핵심 요약
Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. AI 기반 자동 키잉으로 초록색·파란색 배경 제거가 한 클릭으로 가능하며, 크로스페이드나 반투명 객체의 색상까지 예측해 처리한다. 기존 도구와 달리 영상의 전체 프레임을 분석하는 시간 인식 기능으로 프레임 간 깜박임(flicker)과 떨림을 제거한다. 전체 요약 8문장 읽기 → 006 18:11 ▲ 106 · 댓글 7 작은 프로그램과 언어가 지닌 매력 작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 오픈소스 · 도구 · Small Programs and Languages
Key Point 작은 프로그램과 언어의 구현이 단순한 취미를 넘어 프로그래밍의 본질적 복잡도를 증명하는 의미 있는 작업이며, 개발자의 이해와 통제 욕구를 충족하는 설계 원칙을 제시한다.
핵심 요약
작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 역사적 사례들이 작은 구현의 가능성을 보여준다. philippe Brochard의 46바이트 Forth, Arthur Whitney가 한 오후에 작성한 122줄 J 언어 인터프리터, 90KB 부팅 가능 이미지의 kOS 운영체제 등이 그 예다. 코드 골프와 최소화는 재미만이 아니라 의미 있는 작업이다. 콜모고로프 복잡도 관점에서, 작은 구현들은 프로그램의 최소 복잡도를 드러낸다. 전체 요약 13문장 읽기 → 007 00:11 ▲ 103 · 댓글 58 자유로운 트위터 클라이언트, Nitter 포크 'Shitter' 공개 프라이버시와 성능을 중시하는 트위터 대체 프론트엔드 'Shitter'는 zedeus/nitter의 포크로, Codeberg에서 공개되었다. 웹 · 프론트엔드 · Shitter – A Nitter Fork
Key Point 트위터의 자바스크립트 강제와 추적 기술을 피하고 싶은 사용자와 프라이버시 중심의 개발자들이 자유롭게 설치·운영할 수 있는 경량의 오픈소스 대안이 등장했다.
핵심 요약
프라이버시와 성능을 중시하는 트위터 대체 프론트엔드 'Shitter'는 zedeus/nitter의 포크로, Codeberg에서 공개되었다. 자바스크립트나 광고 없이 모든 요청이 백엔드를 통해 처리되므로 트위터가 사용자의 IP나 자바스크립트 지문을 추적할 수 없다. 트위터의 비공식 API를 사용해 개발자 계정 없이도 동작하며, Nim 언어로 개발되어 60KB 수준의 가벼운 크기다. 전체 요약 10문장 읽기 → 008 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 009 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 010 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 011 15:11 ▲ 158 · 댓글 40 OpenBSD 8.0 공식 릴리스 OpenBSD 8.0이 공식 릴리스되었으며, 각 아키텍처별로 사전 빌드된 패키지를 제공한다. 오픈소스 · 도구 · OpenBSD 8.0
Key Point OpenBSD 사용자가 8.0 버전의 설치 방법, 지원 플랫폼, 소스 아카이브 구성을 한눈에 파악할 수 있다.
핵심 요약
OpenBSD 8.0이 공식 릴리스되었으며, 각 아키텍처별로 사전 빌드된 패키지를 제공한다. CD, USB, 플로피 디스크, 네트워크(PXE) 등 다양한 부팅 매체를 통한 설치를 지원한다. amd64, i386, armv64, armv7, hppa, alpha, luna88k, macppc, octeon, powerpc64, riscv64, sparc64 등 12개 아키텍처별로 설치 방법이 상이하다. 전체 요약 7문장 읽기 → 012 21:10 당일 +441 비디오의 모자이크를 자동으로 복원하는 Jasna 비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 오픈소스 · 도구 · Kruk2/jasna · Python
Key Point 모자이크 처리된 콘텐츠를 자동 복원하는 도구로, GPU 가속을 활용한 빠른 처리와 선택적 복원 기능이 기술적으로 흥미로운 구현을 보여준다.
핵심 요약
비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 무료 모델인 BasicVSR++와 유료 지원자 모델인 LTX 두 가지 복원 모델을 제공한다. 선택한 부분만 복원할 수 있는 Segment Editor와 복원된 영상을 실시간으로 볼 수 있는 Video Player를 갖춘 간단한 앱과 커맨드라인 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 013 09:11 ▲ 132 · 댓글 22 Commodore 64를 핀 단위로 시뮬레이션하는 하드웨어 시뮬레이터 공개 antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 오픈소스 · 도구 · The Commodore 64 hardware simulator: break chips and pins, see the results
Key Point 실제 칩을 제거하거나 손상시킬 위험 없이 고장난 Commodore 64의 원인을 하드웨어 수준에서 진단하고 탐구할 수 있는 오픈소스 도구가 공개되었다.
핵심 요약
antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 칩의 다리를 들어올리거나 그라운드/+5V에 단락시키거나, 칩을 소켓에서 빼거나, 저항을 개방할 수 있으며 그 결과를 모니터, 키보드, 보드의 모든 신호로 확인할 수 있다. 프로그램은 PCB의 전기 연결(네트리스트)과 각 칩의 핀 동작을 알고 있으며, 손상된 부품을 시뮬레이션하면 화면의 잡음도 회로 계산에서 나온 것이다. 전체 요약 14문장 읽기 → 014 06:11 ▲ 107 · 댓글 85 리눅스 7.2 커널, 역사상 2번째로 바쁜 개발 사이클 리눅스 토발즈가 8월 17일 7.2 커널을 릴리스했으며, 거의 60만 줄의 코드가 추가되어 역사상 2번째로 바쁜 개발 사이클이 되었다. 오픈소스 · 도구 · Development statistics for the 7.2 kernel
Key Point LLM 지원 커밋이 급증하면서 커널 개발의 구조와 품질이 어떻게 변하고 있는지를 수량 데이터로 추적하는 중요한 기록이자, 이해 없이 패치가 통합되는 위험성을 드러낸다.
핵심 요약
리눅스 토발즈가 8월 17일 7.2 커널을 릴리스했으며, 거의 60만 줄의 코드가 추가되어 역사상 2번째로 바쁜 개발 사이클이 되었다. 7.2에는 2,652명의 개발자가 기여한 16,418개의 비병합 커밋이 포함되었으며, 이는 이전 기록인 7.1의 2,479명을 크게 초과했다. 상위 기여자는 우베 클라이네-쾨니히(1,510개 커밋), 로센 페네프(1,460개), 이안 로저스(1,380개)였고, 코드 라인 수로는 매튜 스튜어트(83만 5,878줄)와 호킹 장(62만 8,936줄)이 선두였다. 전체 요약 9문장 읽기 → 015 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 016 16:56 당일 +900 Docker 한 줄로 띄우는 무료 영상 통합 검색 플랫폼 Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 오픈소스 · 도구 · LibreSpark/LibreTV · TypeScript
Key Point Docker 한 줄로 자체 영상 스트리밍 플랫폼을 구축할 수 있으며, 기존의 불안정한 공개 서비스에 의존하지 않고 여러 소스의 콘텐츠를 통합 관리할 수 있게 해준다.
핵심 요약
Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 다양한 영상 소스를 병렬 검색하고, 같은 제목의 영상은 하나로 합쳐서 여러 출처의 소스를 비교하며 선택할 수 있다. ArtPlayer와 hls.js 기반 플레이어는 광고 제거, 자동 연속재생, 배속, 모바일 3배속 등을 지원한다. 전체 요약 14문장 읽기 → 017 18:11 ▲ 101 · 댓글 28 Rust로 만든 고성능 웹 프레임워크 Proa 공개 Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 웹 · 프론트엔드 · Show HN: Proa – A Rust web framework with fast SSR and multi-target rendering
Key Point 한 번의 Rust 코드로 여러 렌더 타겟을 생성하고 React보다 237배 빠른 서버 렌더링을 제공하는 새로운 웹 프레임워크의 등장으로, SSR 기반 웹 개발의 패러다임이 어떻게 변할 수 있는지 보여줍니다.
핵심 요약
Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 하나의 타입된 컴포넌트로 HTML, Markdown 등 여러 렌더 타겟을 동시에 생성할 수 있습니다. 벤치마크 결과에 따르면 Proa의 서버 렌더링 속도는 React의 renderToString보다 237배 빠릅니다(8vCPU AMD EPYC-Milan VPS 기준). 전체 요약 12문장 읽기 → 018 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 019 03:12 ▲ 107 · 댓글 49 포트란 70주년 기념 행사 영국서 12월 개최 포트란의 첫 번째 설명서 발행 70주년을 맞아 10월 15일이 기념일이다. 기타 · Celebrating 70 Years of Fortran
Key Point 과학 계산 분야의 핵심 언어로 자리 잡은 포트란의 70년 역사를 돌아보고, 향후 발전 방향을 논의하는 공식 기념 행사의 세부 정보를 알 수 있다.
핵심 요약
포트란의 첫 번째 설명서 발행 70주년을 맞아 10월 15일이 기념일이다. 포트란은 원자핵 공학, 날씨·기후 예측, 재료과학 등 과학 기술 분야에서 핵심 인프라를 지탱해온 과학 계산용 프로그래밍 언어다. 영국 맨체스터 과학산업박물관에서 12월 1일 70주년 기념 행사를 개최한다. 전체 요약 9문장 읽기 → 020 00:11 ▲ 122 · 댓글 47 Libreboot 26.10 공개, UEFI·크롬북 지원 추가 오픈소스 부팅 펌웨어 Libreboot 26.10 '오미너스 올리브' 버전이 공개되었으며, EDK2 기반 UEFI 지원과 MrChromebox로부터 233개 크롬북 모델이 추가되었다. 오픈소스 · 도구 · Libreboot 26.10 "Ominous Olive" released with UEFI, Chromebook support
Key Point 오픈소스 펌웨어의 역사적 전환점으로, 완전한 UEFI 지원 추가와 AI 폐지 정책 수립이 프로젝트의 철학적·기술적 방향을 명확히 보여준다.
핵심 요약
오픈소스 부팅 펌웨어 Libreboot 26.10 '오미너스 올리브' 버전이 공개되었으며, EDK2 기반 UEFI 지원과 MrChromebox로부터 233개 크롬북 모델이 추가되었다. 기존 GRUB·SeaBIOS 페이로드를 EFI 버전으로 대체하고 EDK2를 기본값으로 설정했으며, 이전 세팅과의 하위 호환성을 위해 두 페이로드를 부트 메뉴에서 접근 가능하도록 제공한다. 거의 모든 64비트 대응 하드웨어(ThinkPad X200, T480 등)에서 EDK2를 사용하며, 32비트 전용 메인보드는 기존 방식을 유지한다. 전체 요약 15문장 읽기 → 021 21:11 당일 +103 필터 없는 AI 이미지·영상 생성 스튜디오 오픈소스화 Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. AI · 머신러닝 · Anil-matcha/Open-Generative-AI · JavaScript
Key Point 기존 상용 AI 영상 플랫폼의 높은 구독료와 필터 제한에서 벗어나, 600개 모델로 무제한 창작이 가능한 자체 호스팅 솔루션이 등장했다는 점이 중요합니다.
핵심 요약
Midjourney·Runway 같은 상용 AI 영상 플랫폼의 대안으로, 600개 이상 모델을 지원하는 오픈소스 생성형 AI 스튜디오를 공개했다. Flux·Kling·Sora·Veo 등 주요 이미지/영상 생성 모델 200여 개를 통합하고 콘텐츠 필터나 제한 없이 사용할 수 있다. 이미지·영상·음성·입술싱크·시네마·워크플로우 등 14개 스튜디오를 포함하며, 자체 호스팅 가능하고 MIT 라이선스로 완전 무료이다. 전체 요약 10문장 읽기 → 022 15:11 ▲ 107 · 댓글 10 Oxide, 완전한 랙을 가상 환경에서 구동하는 에뮬레이터 공개 Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. 인프라 · 데브옵스 · Virtual Oxide Labs: Emulating a Full Oxide Rack
Key Point 실제 하드웨어가 부족한 상황에서 완전한 랙 규모 시스템을 로컬 머신에서 테스트할 수 있는 방법을 제시했으며, 마이크로컨트롤러 에뮬레이션의 기술적 구현 방식이 임베디드 시스템 테스트의 새로운 접근 방식을 보여준다.
핵심 요약
Oxide는 Virtual Oxide Labs(Voxel)라는 소프트웨어 에뮬레이션 스택을 공개했으며, illumos와 Rust로 구축되어 실제 Oxide 랙을 가상 환경에서 재현할 수 있다. Voxel은 수정되지 않은 스톡 Oxide 소프트웨어를 사용하는 '절대적 충실도'를 원칙으로 하며, 슬레드 가상화(Propolis), BGP/정적 네트워킹(Debian/FRR), 소프트웨어 P4 스위치(SoftNPU), 마이크로컨트롤러 시뮬레이션을 지원한다. 32스레드 AMD Ryzen 9 9955HX와 96GB RAM을 갖춘 Minisforum 미니 PC에서 6개 슬레드로 구성된 완전한 Oxide 랙을 약 10분 만에 구동할 수 있다. 전체 요약 9문장 읽기 → 023 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 024 12:11 ▲ 101 · 댓글 19 iPad에서 Linux AMD GPU 드라이버를 직접 구동 LemonSeed Studio는 iPad에서 온디바이스 LLM 추론을 실행하는 에디터 및 IDE 애플리케이션이다. 하드웨어 · 시스템 · Running the unmodified Linux amdgpu driver on an iPad
Key Point iPad 같은 비전통적 플랫폼에서 Linux GPU 드라이버를 직접 구동하는 기술적 접근법이 어떻게 가능했는지 확인할 수 있다.
핵심 요약
LemonSeed Studio는 iPad에서 온디바이스 LLM 추론을 실행하는 에디터 및 IDE 애플리케이션이다. 수정되지 않은 업스트림 Linux amdgpu + amdkfd 드라이버를 PCIDriverKit 확장으로 앱에 내장했다. Thunderbolt 인클로저의 AMD GPU를 구동하며, HSA 런타임과 HRX/Loom을 통해 추론 엔진이 GPU에서 실행된다. 전체 요약 6문장 읽기 → 025 00:10 ▲ 127 · 댓글 115 RAM 부족 심화, 10년 전 DDR4 메모리 부활 RAM 가격 급등으로 PC 업그레이드 비용이 부담되자 Intel과 AMD가 구세대 DDR4 메모리를 지원하는 새 CPU를 출시하기로 나섰다. 하드웨어 · 시스템 · The RAM shortage is bringing back DDR4
Key Point DDR4 메모리 부활은 게이머와 일반 사용자의 CPU 업그레이드 선택지를 크게 바꾸는데, 기존에 DDR5 강제로 가는 것보다 최신 CPU를 더 저렴하게 쓸 수 있는 경로가 열렸기 때문입니다.
핵심 요약
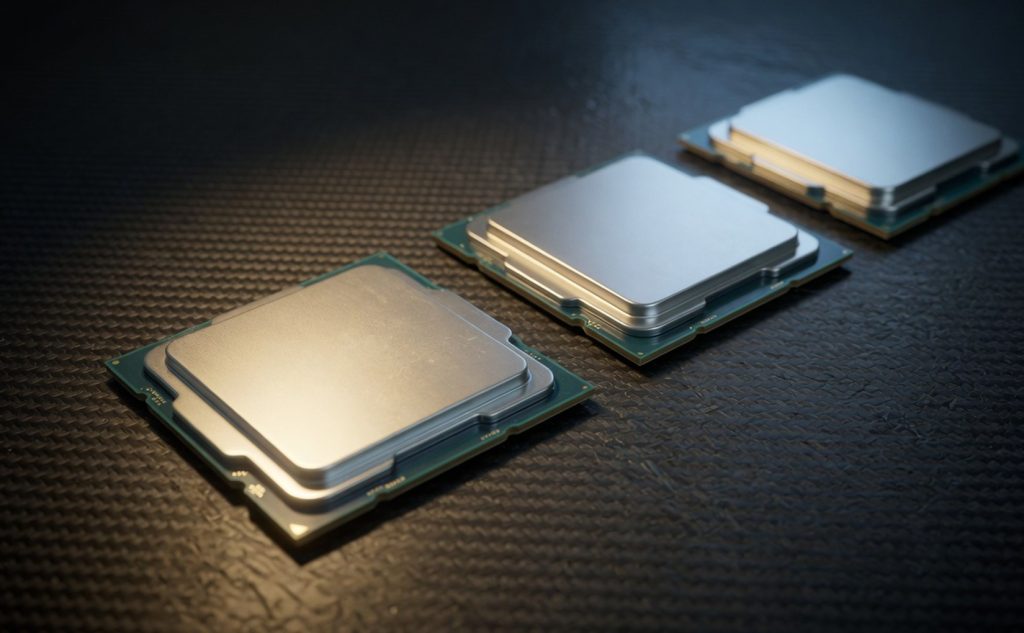
RAM 가격 급등으로 PC 업그레이드 비용이 부담되자 Intel과 AMD가 구세대 DDR4 메모리를 지원하는 새 CPU를 출시하기로 나섰다. Gigabyte가 2021년 출시한 Intel LGA 1700 소켓을 지원하는 새 마더보드를 발표했으며, Intel은 2027년 초 DDR4와 DDR5를 모두 지원하는 신규 LGA 1700 칩을 출시할 예정이다. Intel은 2024년 LGA 1700을 DDR5 전용으로 전환했으나 가격 부담으로 인해 DDR4 지원을 부활시키는 방향으로 전략을 바꿨다. 전체 요약 7문장 읽기 → 026 21:11 당일 +529 PyTorch: GPU 가속 텐서 연산과 동적 신경망 PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. AI · 머신러닝 · pytorch/pytorch · Python
Key Point PyTorch는 현대 AI 개발의 핵심 프레임워크로, GPU 가속 능력과 동적 신경망 구축의 유연성이 산업 표준이 되었으므로 최신 버전과 설치 옵션을 파악하는 것이 필수다.
핵심 요약
PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. torch, torch.autograd, torch.nn, torch.multiprocessing, torch.utils 등 핵심 컴포넌트로 구성되어 있으며 NumPy 대체제 또는 딥러닝 연구 플랫폼으로 사용된다. CPU 또는 GPU에서 실행되는 텐서 라이브러리로 슬라이싱, 인덱싱, 선형대수 등 다양한 연산을 고속으로 수행하며 Intel MKL, NVIDIA cuDNN, NCCL 등 가속 라이브러리를 통합한다. 전체 요약 12문장 읽기 → 027 21:11 당일 +143 Docker로 운영 가능한 완전한 메일 서버 구축 SMTP, IMAP, LDAP, 스팸 방지, 바이러스 방지 등을 갖춘 프로덕션 레벨의 풀스택 메일 서버를 Docker 컨테이너로 실행할 수 있는 오픈소스 프로젝트입니다. 인프라 · 데브옵스 · docker-mailserver/docker-mailserver · Shell
Key Point 자신의 메일 서버를 소유하고자 하는 사용자나 조직이 Docker 한 줄로 프로덕션 메일 환경을 구축할 수 있으며, SQL 없는 간단한 설정으로 유지보수 부담을 줄일 수 있습니다.
핵심 요약
SMTP, IMAP, LDAP, 스팸 방지, 바이러스 방지 등을 갖춘 프로덕션 레벨의 풀스택 메일 서버를 Docker 컨테이너로 실행할 수 있는 오픈소스 프로젝트입니다. SQL 데이터베이스 없이 설정 파일만으로 운영되어 간단하게 배포하고 업그레이드할 수 있습니다. Postfix(SMTP), Dovecot(IMAP/POP3), Rspamd, SpamAssassin, ClamAV, OpenDKIM, OpenDMARC, Fail2ban 등 메일 서버에 필요한 주요 서비스들을 포함하고 있습니다. 전체 요약 6문장 읽기 → 028 00:11 ▲ 220 · 댓글 57 오크사이드, 4억 4500만 달러 시리즈 D 펀딩 완료 오크사이드(Oxide)가 4억 4500만 달러 규모의 시리즈 D 펀딩을 완료했다. 하드웨어 · 시스템 · Our $445M Series D
Key Point 스타트업으로서 이미 수익성을 달성하고 공격적인 성장 자금을 조달한 사례는 극히 드물며, 특히 하드웨어 기업이 이를 성취한 것은 제품-시장 적합성의 강력한 증거다.
핵심 요약
오크사이드(Oxide)가 4억 4500만 달러 규모의 시리즈 D 펀딩을 완료했다. 회사는 봄에 통상적인 컴퓨터 판매 사업으로 순이익을 낸 후 법인 소득세를 납부하는 이정표를 달성했다. 스타트업 대부분이 수익성을 갖추지 못한 상태에서 투자를 받는 것과 달리, 오크사이드는 이미 제품-시장 적합성을 입증한 드문 경우다. 전체 요약 9문장 읽기 → 029 18:33 당일 +168 Rust 기반 고성능 링커 mold, lld보다 4.9배 빠르다 mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 인프라 · 데브옵스 · rui314/mold · Rust
Key Point 대규모 프로젝트 빌드 시간을 획기적으로 단축할 수 있는 성숙한 도구로, 특히 C++·Rust 개발자의 개발 생산성을 크게 높일 수 있다.
핵심 요약
mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 2026년 8월 벤치마크에서 wild 링커보다는 1.9배 빠르며, AMD Threadripper와 Apple M1 Ultra 양쪽 플랫폼에서 일관되게 우수한 성능을 보인다. LLVM lld 원개발자가 아키텍처 한계를 극복하기 위해 Rust로 새로 작성했으며, 2021년부터 프로덕션 환경에서 운영 중이다. 전체 요약 10문장 읽기 → 030 00:11 ▲ 166 · 댓글 69 125억 개 파라미터 모델을 RTX 4090으로 초당 100토큰 속도로 실행 Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. AI · 머신러닝 · Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
Key Point 소비자용 그래픽카드만으로 클라우드 서버 수준의 대규모 언어모델을 로컬에서 무료로 실행 가능해졌기 때문에, 개인 개발자와 중소 회사의 AI 접근 장벽이 크게 낮아진다.
핵심 요약
Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. RTX 5070(12GB)과 Ryzen 5 7600 조합에서 Q2_0 압축 모델 기준으로 초당 94토큰의 답변 생성 속도(32KB 문서 읽기 초당 2,650토큰)를 달성한다. RTX 3090(24GB) 같은 더 많은 VRAM을 가진 카드는 초당 100~140토큰 속도까지 낼 수 있다. 전체 요약 12문장 읽기 → 031 12:11 ▲ 163 · 댓글 21 Valve 개발자, 10년 된 AMD GPU 리눅스 지원 대폭 개선 Valve의 Timur Kristóf가 10년 전 GCN 1.0/1.1 세대 구형 AMD 그래픽카드의 리눅스 지원을 개선하는 작업을 진행했다. 인프라 · 데브옵스 · The work by Valve's Timur Kristóf on improving old AMD GPUs on Linux
Key Point AMD가 지원을 중단한 구형 GPU를 여전히 사용하는 리눅스 게이머들의 성능과 호환성이 크게 개선되고 있기 때문이다.
핵심 요약
Valve의 Timur Kristóf가 10년 전 GCN 1.0/1.1 세대 구형 AMD 그래픽카드의 리눅스 지원을 개선하는 작업을 진행했다. 기존 Radeon 레거시 드라이버에서 최신 AMDGPU 커널 드라이버로 전환하도록 주도했으며, 이를 통해 RADV Vulkan 드라이버 사용과 성능 향상을 가능하게 했다. AMDGPU 디스플레이 코드의 결함과 전력 관리 문제 등을 해결했다. 전체 요약 7문장 읽기 → 032 03:11 ▲ 101 · 댓글 19 Go 바이너리 하나로 로컬 LLM 구동하는 Janus 공개 Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. AI · 머신러닝 · Show HN: Janus – Go binary that runs GGUF models via Vulkan on AMD/Intel/Nvidia
Key Point 로컬 LLM 추론 환경에서 복잡한 의존성 없이 한 번에 실행 가능한 도구로, Ollama나 llama.cpp 대비 간단한 설정과 Go의 빌드 편의성을 제공한다.
핵심 요약
Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. Vulkan을 통해 AMD·Intel·NVIDIA GPU에서 추론을 수행하거나 CPU 폴백을 지원하며, OpenAI 호환 API(/v1/chat/completions, /v1/models)를 제공한다. 재시작 없이 GGUF 모델을 바꿀 수 있고, Cursor·Cline 같은 OpenAI 클라이언트와 연동되며, GGUF 메타데이터에서 자동으로 채팅 템플릿을 감지한다. 전체 요약 9문장 읽기 → 033 03:11 새 버전 uv 0.12.23 출시, 워크스페이스 없이 lock 파일 다루기 지원 Python 3.15.0rc3 지원을 추가했다. 오픈소스 · 도구 · astral-sh/uv@0.12.23
Key Point 워크스페이스 매니페스트 없이 lock 파일만으로 환경 관리가 가능해지면서 uv의 사용성이 확대되고, 특히 Python 3.15rc 지원으로 최신 버전 준비가 가능하다.
핵심 요약
Python 3.15.0rc3 지원을 추가했다. uv sync, export, tree, workspace metadata 명령을 --frozen 플래그로 워크스페이스 매니페스트 없이 uv.lock 파일에서 직접 동작할 수 있도록 했다. 워크스페이스 멤버들의 충돌하는 소스 선택을 거부해 설치 불가능한 lockfile 생성을 방지한다. 전체 요약 6문장 읽기 → 034 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 035 00:11 새 버전 Rust 1.99.0 공개, C-가변함수 안정화 Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 오픈소스 · 도구 · rust-lang/rust@1.99.0
Key Point C-가변함수 안정화로 FFI 작업이 더 안전해지고, 다수의 라이브러리 API 안정화로 표준 라이브러리 사용성이 개선되며, Rustdoc 성능 최적화가 대규모 프로젝트의 빌드 속도에 영향을 줍니다.
핵심 요약
Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 언어 차원에서 raw_borrows_via_references 린트 추가, unconditional_panic 린트 확장, #[my_macro] mod foo; 구문 안정화 등이 진행되었다. 컴파일러는 AVR/AMDGCN/NVPTX에서 -Ctarget-cpu를 target-modifier로 변환하고, doc alias 속성이 메서드 제안 시 유사성 검색보다 우선하도록 개선했다. 전체 요약 9문장 읽기 → 036 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 037 09:11 ▲ 120 · 댓글 54 하드웨어별 자동 최적화하는 오픈소스 추론 엔진 Magnitude 출시 YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. AI · 머신러닝 · Launch HN: Magnitude (YC S25) – Self-optimizing inference engine for agents
Key Point 로컬 추론 성능을 llama.cpp 대비 최대 2배 개선하면서 기존 에이전트와의 호환성을 유지한다는 점에서 에이전트 개발자와 프라이빗 AI 추론 사용자에게 실질적인 성능 이득이 생긴다.
핵심 요약
YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. 기기별로 커널을 컴파일·튜닝해 오픈 모델을 llama.cpp보다 최대 2배 빠르게 실행한다(Metal에서 92% 더 빠름, CUDA에서 19% 더 빠름). macOS, Windows, Linux에서 Apple Silicon, NVIDIA, AMD GPU 또는 CPU만으로 작동한다. 전체 요약 11문장 읽기 → 038 21:11 당일 +141 당신의 PC 성능에 최적화된 오픈 모델 추천·실행 엔진 'Magnitude' Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. AI · 머신러닝 · magnitudedev/magnitude · Rust
Key Point 내 하드웨어에서 실제로 빠르게 돌아갈 오픈소스 AI 모델을 자동으로 찾아주고 최적화해주므로, 로컬에서 생성형 AI를 쓰려는 개발자와 AI 에이전트 사용자에게 필수 도구다.
핵심 요약
Rust로 개발된 오픈소스 추론 엔진으로, 소유한 하드웨어에서 최적으로 동작하는 오픈 모델을 찾고 튜닝하는 데스크톱 애플리케이션이다. 머신 프로파일링을 통해 당신의 하드웨어 사양을 분석한 후, 다운로드 전에 각 모델과 양자화 버전의 예상 추론 속도(tok/s)를 추정해 사용자가 최적의 모델을 선택하도록 돕는다. Ollama나 LM Studio와 달리, 사용자가 선택한 모델을 컨텍스트 크기와 추측 디코딩 등으로 정확한 하드웨어에 맞게 튜닝한다. 전체 요약 8문장 읽기 → 039 09:11 ▲ 153 · 댓글 51 AMD, AI 스타트업 World Labs 인수 World Labs가 AMD 인수에 합의했다. 2024년 창립 이후 공간 및 물리 세계의 문제를 푸는 AI 잠재력에 대한 비전을 확립했으며, 확장과 하드웨어 접근성 강화를 위해 인수를 결정했다. AI · 머신러닝 · World Labs Is Joining AMD
Key Point AI 스타트업의 빅테크 대규모 인수로 하드웨어-소프트웨어 통합 경향이 확실해졌고, 오픈 AI 생태계 구축 선언이 주목할 만하다.
핵심 요약
World Labs가 AMD 인수에 합의했다. 2024년 창립 이후 공간 및 물리 세계의 문제를 푸는 AI 잠재력에 대한 비전을 확립했으며, 확장과 하드웨어 접근성 강화를 위해 인수를 결정했다. 두 회사는 지난해부터 AMD GPU에서의 모델 학습 및 추론 최적화를 중심으로 기술 파트너십을 진행해왔다. 협력 과정에서 AI 소프트웨어·하드웨어 생태계, 파운데이션 모델, 애플리케이션을 통합하는 것이 자연스러운 방향임을 인식했다. 전체 요약 7문장 읽기 → 040 09:11 ▲ 105 · 댓글 6 롱선 CPU의 원자 연산 버그 발견과 해결 2026년 2월 Debian의 normaliz 패킹 중 원자 연산이 일부 값을 누적하지 못해 무한 루프에 빠지는 현상 발생. 하드웨어 · 시스템 · The Lost Atomic Update on Loongson CPU
Key Point LoongArch 시스템에서 프로그램이 무한 루프에 빠지거나 메모리 보호 위반이 발생한다면, CPU 하드웨어 에러가 원인일 수 있으며 펌웨어 업데이트로 해결 가능합니다.
핵심 요약
2026년 2월 Debian의 normaliz 패킹 중 원자 연산이 일부 값을 누적하지 못해 무한 루프에 빠지는 현상 발생. 6개월 간 원인을 파악하지 못하다 8월 AI의 도움으로 glibc의 memcpy 벡터화 구현 호출 시 문제 발생 확인. LA664 코어의 원자 명령어(amadd, amcas, ammax 등)가 특정 조건에서 원자성을 잃는 하드웨어 에러라 판명. 전체 요약 13문장 읽기 → 041 21:11 ▲ 102 · 댓글 3 LLVM 핵심 개발자 요하네스 되르페르트 타계 LLVM 컴파일러 프로젝트의 핵심 기여자인 요하네스 되르페르트가 암과의 투병 끝에 9월 17일 36세의 나이로 타계했다. 오픈소스 · 도구 · Remembering Johannes Doerfert
Key Point LLVM 컴파일러 인프라의 가장 중요한 현대 기여자 중 한 명이 떠났으며, 그가 설계하고 주도한 Attributor와 OpenMP GPU 오프로딩 기술이 앞으로의 오픈소스 컴파일러 생태계에 미칠 영향을 이해하기 위해.
핵심 요약
LLVM 컴파일러 프로젝트의 핵심 기여자인 요하네스 되르페르트가 암과의 투병 끝에 9월 17일 36세의 나이로 타계했다. 2014년부터 LLVM에 기여해온 그는 자를란트 대학에서 다면체 컴파일러 기술 연구로 박사학위를 받았으며, Polly 폴리헤드럴 최적화 프로젝트의 핵심 개발자였다. 그가 설계한 Attributor 프레임워크는 LLVM의 함수 및 인수 속성을 추론하고 전파하는 범용 절차 간 고정점 반복 프레임워크로, 2019년 LLVM 개발자 회의에서 소개된 후 주요 최적화 기반시설이 되었다. 전체 요약 11문장 읽기 → 042 00:11 ▲ 112 · 댓글 29 Go 1.27, 모든 플랫폼에서 쓰는 SIMD API 공개 Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. AI · 머신러닝 · Platform-Independent SIMD in Go
Key Point Go의 SIMD 에뮬레이션 기반 포터블 API 도입으로, 벡터 연산이 필요한 암호화·데이터 처리·AI 알고리즘을 플랫폼 의존성 없이 작성할 수 있게 됐으며, 어셈블리 대신 일반 Go 코드로 성능 최적화가 가능해짐.
핵심 요약
Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. 기존에는 Go 어셈블리로만 SIMD 접근 가능했으나, 새 API로 고성능 커널이 아닌 일반 소프트웨어도 벡터 연산 활용 가능. SIMD는 CPU마다 벡터 크기(128~512비트), 마스킹 방식, 지원 연산이 크게 달라 플랫폼별 구현이 복잡했음. 전체 요약 12문장 읽기 → 043 22:29 당일 +119 Kubernetes를 스크립트 없이 직접 구축하기 Kelsey Hightower의 '쿠버네티스 어려운 방식(Kubernetes The Hard Way)' 저장소는 자동화 도구 없이 수동으로 쿠버네티스 클러스터를 구축하는 튜토리얼을 제공한다. 인프라 · 데브옵스 · kelseyhightower/kubernetes-the-hard-way
Key Point 자동 배포 도구에만 의존하던 개발자라면 쿠버네티스의 내부 동작 원리를 직접 손으로 구축하며 깊이 있게 학습할 수 있다.
핵심 요약
Kelsey Hightower의 '쿠버네티스 어려운 방식(Kubernetes The Hard Way)' 저장소는 자동화 도구 없이 수동으로 쿠버네티스 클러스터를 구축하는 튜토리얼을 제공한다. 이 가이드는 쿠버네티스의 핵심 개념과 각 컴포넌트가 어떻게 연결되는지 이해하려는 학습자를 대상으로 한다. 단일 제어 평면 노드와 두 개의 워커 노드로 구성된 기본 클러스터를 직접 구축하면서 각 단계를 깊이 있게 학습하도록 설계됐다. 전체 요약 7문장 읽기 → 044 22:26 당일 +257 Python 없이 비디오에서 3D 가우시안 스플래팅 모델을 만드는 올인원 도구 Spirula Studio는 비디오나 사진에서 3D 가우시안 스플래팅 모델을 훈련한 후 텍스처 메시로 변환하는 자체 포함 바이너리 도구로, Python/PyTorch나 별도 COLMAP 설치가 불필요하다. 하드웨어 · 시스템 · harry7557558/spirula-studio · C++
Key Point Python 설치 없이 영상에서 바로 3D 모델을 생성할 수 있으며, 크로스벤더 GPU 지원으로 고급 3D 재구성이 접근성 높아진다는 점이 중요하다.
핵심 요약
Spirula Studio는 비디오나 사진에서 3D 가우시안 스플래팅 모델을 훈련한 후 텍스처 메시로 변환하는 자체 포함 바이너리 도구로, Python/PyTorch나 별도 COLMAP 설치가 불필요하다. NVIDIA, AMD, Intel, Apple GPU를 Vulkan 또는 CUDA를 통해 지원하며, 8GB VRAM에서 1천만 개의 SH3 가우시안을 훈련할 수 있는 극도의 VRAM 효율성을 제공한다. 어안렌즈와 360° 카메라를 기본 지원하고, MCMC/IGS+/MRNF의 장점을 결합한 훈련 전략으로 선명한 결과와 적은 플로팅 아티팩트를 생성한다. 전체 요약 10문장 읽기 → 045 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 → 046 22:29 당일 +190 Linux 커널을 3분에 인덱싱하는 AI 코드 분석 엔진 codebase-memory-mcp는 코드베이스를 지속형 지식 그래프로 변환하는 MCP 서버로, 평균 저장소는 밀리초 단위로, Linux 커널(28M LOC, 75K 파일)은 3분에 인덱싱한다. 기타 · DeusData/codebase-memory-mcp · C
Key Point AI 에이전트가 대규모 코드베이스를 밀리초 단위로 이해할 수 있게 하는 기술로, 토큰 비용을 99% 줄이면서도 코드 구조를 정확히 분석하는 실용적인 솔루션이다.
핵심 요약
codebase-memory-mcp는 코드베이스를 지속형 지식 그래프로 변환하는 MCP 서버로, 평균 저장소는 밀리초 단위로, Linux 커널(28M LOC, 75K 파일)은 3분에 인덱싱한다. 158개 언어를 지원하며 tree-sitter AST 분석과 Python, TypeScript, Go, Java, Rust 등 12개 언어에 대한 하이브리드 LSP 의미론 분석으로 함수, 클래스, HTTP 경로, 서비스 간 연결을 매핑한다. 구조적 쿼리에 1ms 이하로 응답하며, 파일 단위 탐색 대비 99.2% 토큰 절감(5개 쿼리당 3,400 vs 412,000 토큰)을 달성한다. 전체 요약 12문장 읽기 → 047 22:29 ▲ 163 · 댓글 56 도어대시의 1.4억원 시장개입, 결국 노동자 합의금 1.5조원으로 돌아왔다 도어대시가 2025년 뉴욕 시장 선거에서 조란 마므다니 후보를 낙선시키기 위해 약 140만 달러를 지출했으나, 당선된 마므다니 행정부에 의해 최근 1억 3150만 달러(약 1.5조원) 규모의 노동자 합의금을 지급하게 됐다. 스타트업 · 비즈니스 · DoorDash Spent $1.4M Trying to Stop Mamdani from Becoming Mayor. Now We Know Why
Key Point 배달앱 기업의 노골적인 정치 개입 시도가 선거로는 실패했지만, 당선된 지도자의 노동자 보호 정책으로 수십억 달러 규모의 비용으로 돌아온 사례로, 기업 정치 자금과 노동 규제 정책의 충돌을 직접 보여준다.
핵심 요약
도어대시가 2025년 뉴욕 시장 선거에서 조란 마므다니 후보를 낙선시키기 위해 약 140만 달러를 지출했으나, 당선된 마므다니 행정부에 의해 최근 1억 3150만 달러(약 1.5조원) 규모의 노동자 합의금을 지급하게 됐다. 도어대시는 2025년 5월 '시티 개혁' 슈퍼팩에 100만 달러를 기부했으며, 이 단체는 마므다니를 '급진적으로 위험한' 정치인으로 낙인찍는 광고를 3100만 달러 규모로 집행했다. 슈퍼팩은 마므다니의 수염을 인종차별적으로 변조한 우편물을 배포했고, 마므다니는 이를 '노골적 이슬람혐오'로 비판했다. 전체 요약 11문장 읽기 → 048 06:11 ▲ 125 · 댓글 26 AMD 라이젠, 2년간 성능 50% 향상의 비결 2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 하드웨어 · 시스템 · How did AMD Ryzen get 50% faster in two years?
Key Point CPU 기술이 정체되었다는 통념을 깨고 실질적인 아키텍처 개선이 성능 향상을 어떻게 이뤄내는지 구체적 수치로 보여준다.
핵심 요약
2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 클록 속도 상승(4.5GHz에서 5.2GHz, 15% 증가)만으로는 이 정도 성능 향상을 설명할 수 없으며, 아키텍처 개선이 주요 원인이다. 트랜지스터 수가 약 50% 증가(110억에서 160억 개)했고, 대부분이 코어 성능 향상에 투입되었다. 전체 요약 6문장 읽기 → 049 00:10 ▲ 107 · 댓글 22 임베디드 C 컴파일러 SDCC 4.6.0 RC 2 공개 STM8, MCS-51, Z80, Rabbit, Padauk 등 다양한 마이크로컨트롤러를 지원하는 오픈소스 C 컴파일러 SDCC 4.6.0 Release Candidate 2가 공개되었다. 오픈소스 · 도구 · SDCC – Small Device C Compiler
Key Point 오픈소스 임베디드 컴파일러가 공식 펀딩을 받으며 보안·최적화 분야 기능 강화에 나서는 것은 IoT·펌웨어 개발자에게 영향을 미칠 수 있다.
핵심 요약
STM8, MCS-51, Z80, Rabbit, Padauk 등 다양한 마이크로컨트롤러를 지원하는 오픈소스 C 컴파일러 SDCC 4.6.0 Release Candidate 2가 공개되었다. NGI0 Commons Fund와 Sovereign Tech Fund의 지원으로 두 개의 주요 펀딩 프로젝트가 확정되어 개발 가속화가 예정되어 있다. NGI0 프로젝트는 Padauk·Rabbit 마이크로컨트롤러 지원 개선, ISO C 표준 강화, 링크타임 최적화(미사용 함수 제거) 등을 목표로 하며 5명의 개발자가 참여한다. 전체 요약 5문장 읽기 → 050 06:10 ▲ 111 · 댓글 60 AMD GPU에서 CUDA 애플리케이션 실행하는 도구 공개 ZLUDA와 AMD HIP/ROCm을 조합해 Windows의 AMD GPU에서 CUDA 기반 애플리케이션을 실행할 수 있는 스택을 구현했다. 하드웨어 · 시스템 · CUDA for AMD on Windows
Key Point AMD GPU 사용자들이 CUDA 기반 머신러닝 프레임워크(PyTorch 등)와 모델을 자신의 하드웨어에서 직접 돌릴 수 있게 되는 경로가 제시됐기 때문이다.
핵심 요약
ZLUDA와 AMD HIP/ROCm을 조합해 Windows의 AMD GPU에서 CUDA 기반 애플리케이션을 실행할 수 있는 스택을 구현했다. 현재 AMD Radeon RX 9060 XT(gfx1200)만 검증되었으며, 다른 AMD GPU는 호환성 보장이 없는 후보 상태다. nvcuda, cuBLAS, cuBLASLt, cuSPARSE, cuFFT 등의 CUDA API는 통과했고, 2,216,347개 파라미터의 PPO 신경망 학습도 동작 확인했다. 전체 요약 5문장 읽기 → 051 00:10 ▲ 100 · 댓글 17 트랜스포머 회로 분석을 위한 수학적 프레임워크 GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. AI · 머신러닝 · A Mathematical Framework for Transformer Circuits (2021)
Key Point 대형 언어 모델의 예상 밖의 동작을 체계적으로 설명하고 안전 문제를 사전에 발견할 수 있는 기초 프레임워크를 제시하는 연구로, 모델 해석가능성 분야의 초기 이정표이다.
핵심 요약
GPT-3, LaMDA 같은 대형 언어 모델은 학습 후에도 예상치 못한 해로운 행동이 드러나곤 하며, 이를 해결하려면 모델의 내부 계산을 역공학하는 기계적 해석가능성(mechanistic interpretability)이 필요하다. 이 논문은 트랜스포머를 역공학하기 위한 초기 단계로서, 가장 단순한 2층 이하의 어텐션 전용 모델부터 시작해 기본 알고리즘 패턴을 발견하는 것을 목표로 한다. 트랜스포머의 동작을 수학적으로 동등하면서도 새로운 관점으로 재구성함으로써, 특정 어텐션 헤드인 '귀납 헤드(induction heads)'가 인컨텍스트 학습을 설명할 수 있음을 발견했다. 전체 요약 5문장 읽기 → 052 18:10 ▲ 101 · 댓글 76 System76, 192GB GPU 메모리 AI 워크스테이션 'Thelio Mira' 출시 System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 하드웨어 · 시스템 · Thelio Mira AI Linux Workstation: 192 GB GPU Memory
Key Point 로컬에서 대규모 AI 모델을 학습할 수 있는 고성능 GPU 워크스테이션이 등장했으며, 클라우드 비용 없이 자체 하드웨어에서 AI 개발을 완성할 수 있다는 점이 중요하다.
핵심 요약
System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 16코어 AMD Ryzen 9000 시리즈 CPU, 192GB DDR5 RAM, 듀얼 NVIDIA RTX Pro 6000 GPU로 총 192GB GPU 메모리를 지원한다. 액체 냉각, 빠른 내부 접근성, 미국 덴버에서 제조되는 오픈소스 하드웨어이다. 전체 요약 6문장 읽기 → 053 03:10 ▲ 225 · 댓글 102 앤스로픽, AI 반대 운동가 감시 시스템 구축 중 앤스로픽이 회사 임원진과 시설을 겨냥한 시위를 모니터링하는 광범위한 감시 시스템을 구축 중이며, 범죄 발생 전 용의자를 경찰에 신고하는 '선제적 범죄 예방' 방식을 추진하고 있다. 보안 · Anthropic Is Building a Predictive Surveillance System to Monitor Activists
Key Point 언론의 자유와 집회의 자유를 침해할 수 있는 AI 기업의 감시 활동이 국가 안보라는 명목으로 정당화되고 있으며, 정보 기관 및 경찰과의 협력 구조가 어떻게 작동하는지 구체적으로 드러나는 사례이기 때문이다.
핵심 요약
앤스로픽이 회사 임원진과 시설을 겨냥한 시위를 모니터링하는 광범위한 감시 시스템을 구축 중이며, 범죄 발생 전 용의자를 경찰에 신고하는 '선제적 범죄 예방' 방식을 추진하고 있다. Samdesk와 계약해 사용자 인텔리전스를 수집하며, 한 사례에서 Claude 사용자가 CEO를 향한 폭력적 언급을 했다는 이유로 경찰에 신고했지만 경찰에 실제 증거를 제시하지 않았다. 최근 채용공고에서 글로벌 위협 추적 업무에 '활동주의'를 명시적으로 포함시켰고, 직원급 감시를 넘어 국가 규모의 위협 평가로 확대하고 있다. 전체 요약 4문장 읽기 → 054 11:10 당일 +125 로컬에서 빠르게 LLM 실행하는 llama.cpp, 고성능 추론 엔진 llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. AI · 머신러닝 · ggml-org/llama.cpp · C++
Key Point 하드웨어 요구사항이 낮으면서도 다양한 플랫폼을 지원해 개인 PC에서도 대형 언어모델을 효율적으로 운영할 수 있다는 점이 실무에서 중요해지고 있다.
핵심 요약
llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. Apple Silicon의 Metal, ARM NEON, x86의 AVX/AVX512, RISC-V의 RVV 등 각 플랫폼별 명령어세트를 지원해 효율성을 극대화했다. 1.5~8비트 정수 양자화를 통해 추론 속도를 높이고 메모리 사용량을 줄일 수 있으며, NVIDIA GPU(CUDA), AMD GPU(HIP), Intel NPU 등 14개 이상의 백엔드를 지원한다. 전체 요약 4문장 읽기 → 055 11:10 ▲ 128 · 댓글 29 FreeBSD 미니PC 재구성기, GPU 개조까지 이전 AMD 기반 FreeBSD 데스크톱을 업그레이드하면서 Silverstone SG13 미니 케이스를 선택했고, 부피는 5% 증가했으나 성능은 CPU 25%, GPU 40~60% 향상했다. 하드웨어 · 시스템 · AMD Based FreeBSD Desktop Reloaded
Key Point FreeBSD 사용자들이 실제 미니 PC 구성 시 직면하는 하드웨어 호환성과 공간 최적화 과제, 그리고 드라이버 및 펌웨어 설정 방법을 구체적으로 확인할 수 있습니다.
핵심 요약
이전 AMD 기반 FreeBSD 데스크톱을 업그레이드하면서 Silverstone SG13 미니 케이스를 선택했고, 부피는 5% 증가했으나 성능은 CPU 25%, GPU 40~60% 향상했다. 이전의 Ryzen 7 1700과 5700XT에서 Ryzen 7 PRO 4750GE와 7700XT 12GB로 교체했으며, DDR4와 AM4 플랫폼으로 가격 대비 성능을 중시했다. GPU가 케이스에 맞지 않아서 팬 커버와 확장 슬롯 브래킷을 절단해 장착했으며, 1~2mm 단위의 조정이 필요했다. 전체 요약 5문장 읽기 → 056 11:10 ▲ 143 · 댓글 53 vLLM이 AMD GPU에서 추측 디코딩 지원 vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. AI · 머신러닝 · Speculative Decoding in vLLM on AMD GPUs
Key Point LLM 추론 성능 최적화를 위한 주요 기법이 AMD GPU에서 실제 구현되어, 장기 생성 작업의 처리량 개선 가능성을 보여준다.
핵심 요약
vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. 추측 디코딩은 경량 드래프트 모듈이 여러 토큰을 먼저 제안하고 타겟 모델이 한 번에 검증하는 방식으로, 기존 자동회귀 디코딩보다 모델 통과 횟수를 줄인다. 표준 방식은 토큰 하나당 모델 실행 1회가 필요하지만, 추측 디코딩은 여러 드래프트 토큰이 검증을 통과하면 단일 모델 실행으로 여러 토큰을 커밋할 수 있다. 전체 요약 5문장 읽기 → 057 08:12 ▲ 117 · 댓글 23 FreeBSD 14.5 출시, 주요 기능보다 안정성 강화 FreeBSD 14.5-RELEASE가 2026년 9월 8일 발표되었으며, stable/14 브랜치의 여섯 번째 릴리스입니다. 인프라 · 데브옵스 · FreeBSD 14.5-Release
Key Point 레거시 브랜치의 유지보수 릴리스이므로 기존 FreeBSD 사용자의 안정적인 업그레이드 경로를 제공하며, 다양한 아키텍처와 설치 방식 지원으로 운영 환경에 맞게 선택할 수 있습니다.
핵심 요약
FreeBSD 14.5-RELEASE가 2026년 9월 8일 발표되었으며, stable/14 브랜치의 여섯 번째 릴리스입니다. 레거시 브랜치 말기 릴리스로 새로운 기능보다는 버그 수정, 드라이버 업데이트, 외부 소프트웨어 최신 버전에 집중합니다. amd64, i386, aarch64, armv7, powerpc, powerpc64, powerpc64le, riscv64 등 9개 아키텍처를 지원합니다. 전체 요약 5문장 읽기 → 058 00:10 ▲ 679 · 댓글 170 DRAM 주소 변환 조작으로 CPU 보안 우회 메모리 컨트롤러의 DRAM 주소 변환 레지스터를 수정해 물리 메모리 주소를 재배선한다. 보안 · Spaghettifying DRAM
Key Point DRAM 계층의 보안 우회 기법을 실증한 구체적인 PoC로, CPU 보안 경계를 넘어서는 저수준 공격 방식을 보여줘 주목받고 있다.
핵심 요약
메모리 컨트롤러의 DRAM 주소 변환 레지스터를 수정해 물리 메모리 주소를 재배선한다. PSP, SMM, C6, 마이크로코드 등 커널도 접근 불가능한 보호된 DRAM 영역을 노출시킨다. AMD Family 16h CPU에서 테스트됐으며, 메모리 컨트롤러 계층의 주소 리맵을 조작하는 단일 비트 플립으로 실행된다.