쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
100건 (최대치) · "FFI"조건 지우기 ×
001 00:11 당일 +217 WebKit 기반 경량 macOS 브라우저 Search 오픈소스 공개 Office Commun이 만든 Search는 macOS용 경량 웹 브라우저로, macOS에 내장된 WebKit 엔진을 사용하여 약 10MB 크기로 즉시 실행되며 Chromium을 별도로 포함하지 않는다. 오픈소스 · 도구 · driceroland/Search · Swift
Key Point Safari와 경쟁하는 경량 대안 브라우저가 완전 오픈소스로 공개되면서, 프라이버시 중심 설계와 로컬 전용 저장, 외부 의존성 제거 등 기존 주류 브라우저의 문제점을 어떻게 해결하는지 볼 수 있기 때문이다.
핵심 요약
Office Commun이 만든 Search는 macOS용 경량 웹 브라우저로, macOS에 내장된 WebKit 엔진을 사용하여 약 10MB 크기로 즉시 실행되며 Chromium을 별도로 포함하지 않는다. 탭을 왼쪽 또는 상단에 배치할 수 있고 도구 모음이나 시작 페이지 없이 주소 입력 필드 하나로 모든 기능을 수행하며, 주소 자동완성은 로컬 히스토리에서만 처리해 타이핑 내용을 외부로 전송하지 않는다. 탭 고정, 분할 화면 보기, 읽기 모드, 광고 차단(네트워크 수준), 비디오 팝아웃, 쿠키 배너 등 요소 숨기기, macOS 키체인 기반 비밀번호 관리 등을 기본으로 제공한다. 전체 요약 9문장 읽기 → 002 15:11 ▲ 104 · 댓글 71 에어버스 A321XLR, 초반 비행 몇 시간 저고도에서 머물러야 하는 이유 에어버스 A321XLR은 최대이륙중량(MTOW) 223,000파운드로 설계되어 태양양을 위해 초기 비행 시간 동안 저고도(32,000피트 이하)에서만 운항할 수 있다. 하드웨어 · 시스템 · Why the Airbus A321XLR often gets stuck climbing for first few hours of flight
Key Point 초장거리 협동체 항공기의 근본적인 물리적 제약을 이해하고, 항공사의 연료 효율성과 승객 편안함 사이의 트레이드오프가 어떻게 작동하는지 알 수 있기 때문이다.
핵심 요약
에어버스 A321XLR은 최대이륙중량(MTOW) 223,000파운드로 설계되어 태양양을 위해 초기 비행 시간 동안 저고도(32,000피트 이하)에서만 운항할 수 있다. 항공기는 연료를 태워 무게가 줄어들면서 최적 비행고도가 올라가는데, 초기에 연료가 과다하면 얇은 고고도 공기에서 충분한 양력을 얻기 어려워진다. 스텝 클라이밍 기법으로 약 2,000피트씩 단계적으로 올라가며, 10시간 대서양 횡단 비행에서 1~2회만 최종 순항고도에 도달한다. 전체 요약 7문장 읽기 → 003 03:11 ▲ 156 · 댓글 28 음성을 악보로 바꾸는 AI, 65배 작아졌다 음성을 MIDI로 변환하는 오픈소스 모델 Dettato를 공개했다. 2천만 파라미터로 경쟁 모델 MuScriptor(13억)보다 65배 작으면서도 성능이 더 우수하고, 비공개 모델인 Mirelo A2M v1.1 Pro와도 비슷한 수준의 정확도를 갖췄다. AI · 머신러닝 · Show HN: I made an audio-to-MIDI model 60x more efficient
Key Point 지금까지 65배 더 큰 모델을 썼는데도 같거나 더 좋은 성능을 내는 소형 모델이 나왔으며, 저작권 없는 데이터만으로 학습할 수 있다는 점이 오디오 AI와 음악 기술 분야에서 의미가 있습니다.
핵심 요약
음성을 MIDI로 변환하는 오픈소스 모델 Dettato를 공개했다. 2천만 파라미터로 경쟁 모델 MuScriptor(13억)보다 65배 작으면서도 성능이 더 우수하고, 비공개 모델인 Mirelo A2M v1.1 Pro와도 비슷한 수준의 정확도를 갖췄다. 벤치마크는 여러 데이터셋(Bach, PHENICX, RWC 등)에서 측정했으며, Dettato의 평균 F1 스코어는 60.87로 Mirelo 56.16, MuScriptor 47.45보다 높다. 학습 과정에서 저작권이 있는 음성을 전혀 사용하지 않았다. 대신 합성 악기 녹음과 CC 라이선스 솔로 악기를 URMP 데이터셋으로 혼합하고, 나머지는 Soundfont를 변형해 생성했다. 전체 요약 7문장 읽기 → 004 21:11 당일 +577 Notion과 Miro를 대체할 올인원 작업 플랫폼 AFFiNE 오픈소스 공개 TypeScript로 개발된 AFFiNE는 프라이버시 중심의 로컬 우선 오픈소스 플랫폼으로, Notion과 Miro의 대체재를 목표로 한다. 오픈소스 · 도구 · toeverything/AFFiNE · TypeScript
Key Point 로컬 우선 아키텍처로 개인 데이터를 소유하면서도 협업 기능을 갖춘 Notion·Miro 대체재가 오픈소스로 나왔으므로, 기존 SaaS의 데이터 소유권 문제를 걱정하는 개발팀과 조직에게 의미 있는 선택지가 된다.
핵심 요약
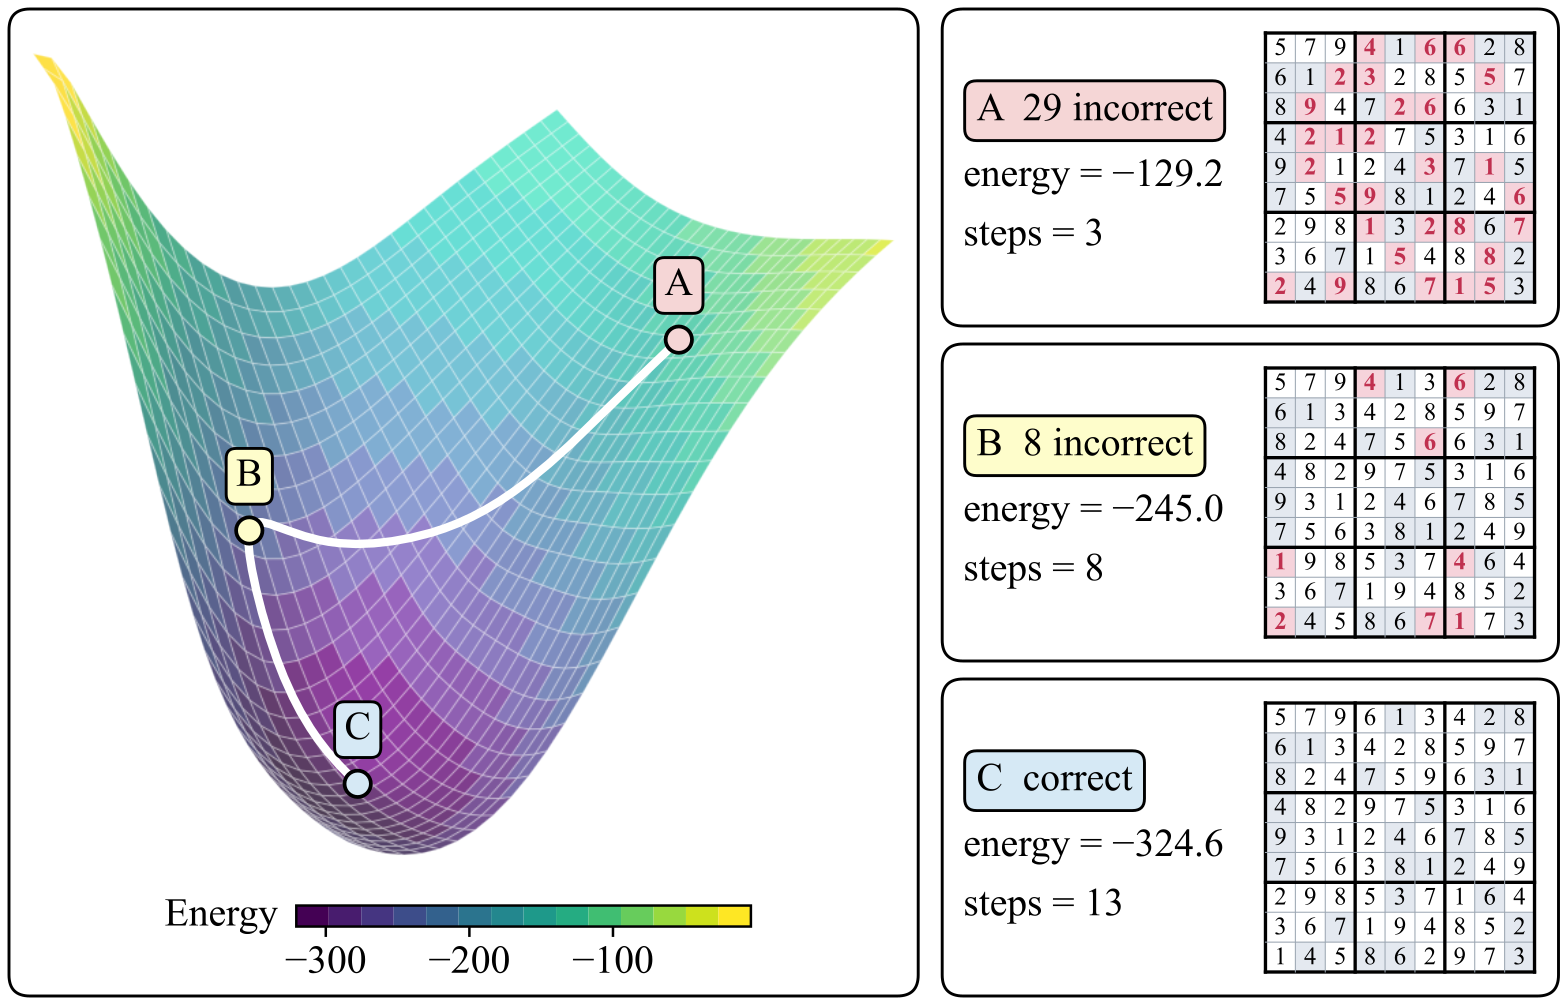
TypeScript로 개발된 AFFiNE는 프라이버시 중심의 로컬 우선 오픈소스 플랫폼으로, Notion과 Miro의 대체재를 목표로 한다. 문서, 캔버스, 테이블을 하나의 하이퍼퓨즈 플랫폼에서 통합하며, 리치 텍스트·스티커 노트·임베드 웹페이지·멀티뷰 데이터베이스·링크된 페이지·도형·슬라이드 등 모든 블록을 경계 없는 캔버스에 배치할 수 있다. AI 파트너 기능으로 보고서 작성, 슬라이드 생성, 마인드맵 요약, 작업 계획 정렬, 프로토타입 코딩 등을 지원한다. 전체 요약 10문장 읽기 → 005 00:11 ▲ 201 · 댓글 29 반복 추론을 위한 에너지 기반 모델, 추론 연산 345배 감소 반복 루프를 통해 추론 성능을 높이는 기존 모델들은 언제 멈춰야 할지, 현재 상태가 얼마나 좋은지 판단할 명시적 지표가 없다는 문제가 있었다. AI · 머신러닝 · Energy-Based Reasoners: 385x more efficient inference
Key Point 반복적 추론 작업에서 추론 연산을 300배 이상 감축하면서도 정확도는 유지하는 방법론이 제시되어, 에너지 기반 접근이 추론 효율성의 새로운 방향을 보여준다.
핵심 요약
반복 루프를 통해 추론 성능을 높이는 기존 모델들은 언제 멈춰야 할지, 현재 상태가 얼마나 좋은지 판단할 명시적 지표가 없다는 문제가 있었다. 에너지 기반 추론 모델(EBR)은 잠재 추론 상태에 대한 에너지 함수를 학습하고, 반복 업데이트를 이 에너지에 대한 경사하강법으로 수행한다. 에너지 점수는 추론 상태의 품질을 평가하고, 그 기울기는 개선 방향을 제시하며 동시에 멈춤 신호로 작동한다. 전체 요약 8문장 읽기 → 006 12:11 ▲ 131 · 댓글 88 구글 AI 답변, 웹사이트 클릭 40% 감소시킨다 구글의 AI Overviews는 검색 결과 위에 표시된 생성형 요약으로, 무작위 대조 실험 결과 이 기능이 나타나는 검색에서 외부 웹사이트 클릭은 약 40% 감소했다. AI · 머신러닝 · Google's AI answers reducing search traffic by 40%
Key Point 검색 트래픽을 주수입원으로 하는 웹사이트 운영자에게 AI 요약 기능의 급속한 확대가 얼마나 큰 영향을 미치는지, 그리고 이 변화에 대응할 실질적 전략이 무엇인지 보여주는 데이터 기반 분석이기 때문이다.
핵심 요약
구글의 AI Overviews는 검색 결과 위에 표시된 생성형 요약으로, 무작위 대조 실험 결과 이 기능이 나타나는 검색에서 외부 웹사이트 클릭은 약 40% 감소했다. AI Overviews는 미국 키워드의 61.43%에 나타나 2년 전 6%에서 급증했으며, 같은 기간 featured snippet은 8.96%에서 0.44%로 급락했다. AI 답변이 나타나면 1위 검색 결과의 클릭률은 58% 감소했고(데스크톱), 모든 검색 의도(정보성, 상거래, 탐색, 거래)에서 AI Overviews 노출률이 48~70%로 높아졌다. 전체 요약 10문장 읽기 → 007 21:11 ▲ 96 · 댓글 4 과학 증거 추론에 특화한 3200억 파라미터 MoE 모델 Sage S1.5 Flash 공개 Sage S1.5 Flash는 320억 파라미터의 혼합전문가 모델로, 과학 증거를 바탕으로 추론하고 상호작용 환경에서 행동할 수 있도록 설계됐다. AI · 머신러닝 · Sage S2.1 Flash Technical Report
Key Point 과학 데이터 분석과 에이전트 작업에서 실제로 증명 가능한 성능 차이를 보이고 있어, 과학 소프트웨어 개발과 AI 에이전트 분야 종사자라면 직접 검토해야 할 모델 개발 사례다.
핵심 요약
Sage S1.5 Flash는 320억 파라미터의 혼합전문가 모델로, 과학 증거를 바탕으로 추론하고 상호작용 환경에서 행동할 수 있도록 설계됐다. 분자 그래프와 생물학 수열용 전용 인코더, 스펙트럼을 측정 패치로 표현하는 멀티모달 처리 기능을 갖췄다. 텍스트와 이미지와 함께 과학 데이터를 처리하기 위해 모달리티별 프로젝터가 각 표현을 공유 백본의 입력 공간으로 변환한다. 전체 요약 8문장 읽기 → 008 03:11 새 버전 파이썬용 Anthropic SDK v2.9.0 릴리스 Anthropic Python SDK v2.9.0이 출시되었다. API에 RBAC 역할 읽기 엔드포인트에 소스와 오류 코드가 추가되고, Claude 태그 번들의 지시사항을 설정하는 Update Bundle 기능이 추가되었다. 오픈소스 · 도구 · anthropics/anthropic-sdk-python@v2.9.0
Key Point 파이썬 개발자가 Anthropic API를 사용할 때 필요한 SDK 업데이트 사항과 보안 개선, 도구 체인의 버그 수정 내용을 파악할 수 있으며, 베타 헤더 값 폐기 일정을 확인해야 기존 코드의 호환성 문제를 미리 대비할 수 있다.
핵심 요약
Anthropic Python SDK v2.9.0이 출시되었다. API에 RBAC 역할 읽기 엔드포인트에 소스와 오류 코드가 추가되고, Claude 태그 번들의 지시사항을 설정하는 Update Bundle 기능이 추가되었다. Windows의 Python 3.12 이하에서 자격증명 파일 쓰기를 수정하고, 파일 도구의 경로 처리 및 심볼릭 링크 해석, ripgrep 설정 파일 무시 등 다양한 도구 관련 버그가 수정되었다. 세션 도구 실행기의 유휴 카운트다운이 세션 스레드 종료 후에도 계속 실행되는 문제를 수정했으며, 세션 이벤트 히스토리 재연결 후 읽기 실패 시에도 종료 신호가 카운트다운을 취소하도록 개선되었다. 전체 요약 10문장 읽기 → 009 12:11 ▲ 101 · 댓글 11 15개 반원을 최소 원으로 패킹하는 퍼즐, 코딩으로 접근하기 벤처캐피탈 Paradigm이 주최한 퍼즐 대회에서 '반원 15개를 가장 작은 원으로 압축하기' 문제를 마주했다. AI · 머신러닝 · Semicircle Packing
Key Point 손으로 풀기 어려운 조합 최적화 문제를 시각화 도구와 AI의 협력으로 어떻게 단계적으로 개선해나가는지 보여주는 실제 사례로, 문제 해결 과정 자체가 흥미롭다.
핵심 요약
벤처캐피탈 Paradigm이 주최한 퍼즐 대회에서 '반원 15개를 가장 작은 원으로 압축하기' 문제를 마주했다. 처음엔 Affinity 그래픽 에디터로 수동으로 배열하며 시각적으로 접근했으나, 대칭 구조와 비대칭 미세 조정을 동시에 만족시키기 어려웠다. 직접 만든 시각화 도구를 이용해 부채꼴 레이어들을 자동으로 최적화하는 '타이튼' 모드와 비대칭 조정을 위한 '릴렉스' 모드를 구현했다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 24 · 댓글 3 3D 기하 재구성 없이 23배 빠른 신규 시점 렌더링 디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. AI · 머신러닝 · TTB: Test-time Baking for Efficient Rendering of Decoder-only View Synthesis Models
Key Point 3D 재구성 없이도 신규 시점을 실시간으로 생성할 수 있는 방식의 등장으로, VR·게임·영상 제작 등 뷰 합성이 필요한 분야의 효율성 문제를 근본적으로 바꿀 수 있다.
핵심 요약
디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. 새로운 방법인 TTB(Test-Time Baking)는 교차 뷰 어텐션에서 전역 장면 정보를 경량 MLP에 학습하여 빠르고 고품질의 신규 시점 디코딩을 가능하게 한다. 첫 번째 핵심은 TTT의 빠른 가중치 MLP를 입출력 쌍에서 교차 뷰 어텐션 매핑을 명시적으로 학습하도록 재목적화하여, TTT와 동일한 렌더링 효율을 유지하면서 현저히 높은 품질을 제공한다. 전체 요약 5문장 읽기 → 011 21:11 ▲ 22 · 댓글 12 AI 에이전트의 토큰 낭비 줄이는 'SparseRead' 기술 웹사이트, 문서, 저장소, 도구 응답 등 외부 콘텐츠를 읽을 때 AI 에이전트가 필요한 부분만 처리하지 못하고 전체를 노출받으면서 토큰과 지연 비용이 증가하는 문제를 다룬다. AI · 머신러닝 · Read Less, Solve More: Token-Efficient Sparse Reading of External Content for AI Agents
Key Point AI 에이전트의 컨텍스트 윈도우를 낭비하는 핵심 원인을 해결하면서 성능 손실 없이 비용과 속도를 획기적으로 개선하는 기술이 실증되었다.
핵심 요약
웹사이트, 문서, 저장소, 도구 응답 등 외부 콘텐츠를 읽을 때 AI 에이전트가 필요한 부분만 처리하지 못하고 전체를 노출받으면서 토큰과 지연 비용이 증가하는 문제를 다룬다. SparseRead는 에이전트 모델 수정 없이 콘텐츠 입력을 제어하는 별도 계층으로, Read Intent Protocol이 에이전트의 변화하는 요구사항을 추적하고 소스 범위를 파악한다. Adaptive Reader Backends가 증거 위치를 선택하고 노출 방식을 결정하며, Budgeted Read Gate가 에피소드당 누적 노출을 제한하되 필요시 전체 콘텐츠도 제공한다. 전체 요약 6문장 읽기 → 012 09:11 ▲ 135 · 댓글 24 애플, RAG 검색 속도 최대 11배 개선하는 신경망 기법 공개 추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. AI · 머신러닝 · Faster Retrieval for Better, More Efficient RAG
Key Point RAG 기반 AI 애플리케이션의 검색 속도가 최대 11배 개선되면 응답 시간 단축과 인프라 비용 절감이 직결되므로, 대규모 검색 시스템을 운영 중인 개발팀과 MLOps 담당자에게 즉시 실무 적용 가능한 최신 최적화 기법이다.
핵심 요약
추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. 기존 방법들은 클러스터링과 양자화로 속도를 높이지만 쿼리 분포를 무시하고, RAG에서는 사용자 질문(쿼리)과 문서(키)의 특성이 크게 달라 최적이 아니다. 애플 연구팀은 ICML 2026에서 쿼리별 라우팅을 학습하는 소형 신경망 두 가지를 제시했다: SupportNet은 각 클러스터별 지원함수(support function)를 학습해 라우팅 정확도를 높이고, KeyNet은 쿼리를 최적 키로 직접 변환해 기존 인덱스와 결합한다. 전체 요약 8문장 읽기 → 013 06:11 ▲ 127 · 댓글 49 우정사업본부, 공식 ZIP 코드 경계 지도 공개 미국 우정사업본부(USPS)가 배송 주소와 위치 정보를 기반으로 한 공식 ZIP 코드 경계 폴리곤 데이터를 공개했다. 인프라 · 데브옵스 · USPS now offers official ZIP Code boundary polygons
Key Point 공식 배송 데이터를 기반으로 한 정확한 경계 정보를 처음 공개하므로, 지도·물류·부동산 등 위치 기반 서비스를 개발하는 개발자와 기업의 데이터 신뢰도가 높아진다.
핵심 요약
미국 우정사업본부(USPS)가 배송 주소와 위치 정보를 기반으로 한 공식 ZIP 코드 경계 폴리곤 데이터를 공개했다. 이 데이터는 지도, 마케팅, 보험, 부동산, 물류, 네비게이션, 운송 등 다양한 업계에서 활용할 수 있다. 사용자들은 이 폴리곤 데이터를 기존 ZIP 코드 정보의 정확도 검증과 업데이트에 활용하거나, 인구통계 데이터 조직화 도구로 사용할 수 있다. 전체 요약 7문장 읽기 → 014 06:11 ▲ 162 · 댓글 66 메타, 에이전트 작업용 경량 모델 뮤즈 엠버 공개 메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. AI · 머신러닝 · Our Smallest, Most Efficient Model: Muse Ember
Key Point 에이전트 AI가 상용화되면서 도구 호출과 반복 작업에 최적화된 경량 모델의 필요성이 높아졌는데, 뮤즈 엠버는 기존 모델보다 훨씬 저렴한 비용으로 더 나은 성능을 제시해 생산 AI 시스템의 비용 구조를 바꿀 가능성을 보여준다.
핵심 요약
메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. 뮤즈 엠버는 Claude Haiku 5.5보다 약 3분의 1 비용으로 동일 수준의 성능을 내며, 모든 GPT-4o Luna 설정을 능가한다. 가격 대비 성능 지수에서 Artificial Analysis 전체 리더보드 효율성 경계선에 위치한다. 전체 요약 13문장 읽기 → 015 03:11 ▲ 21 · 댓글 4 비용 65% 줄이고 정확도까지 높이는 AI 에이전트 협업 장기 작업을 수행하는 AI 에이전트는 클라우드의 고성능 모델로 구동하면 비용이 비싼 반면, 저비용 모델은 성능이 떨어진다. AI · 머신러닝 · AgentBaton: Efficient Model Collaboration in Agentic Tasks
Key Point 고성능 AI 모델 비용을 획기적으로 줄일 수 있는 실용적 방법이 제시되어, 개발 팀이 AI 에이전트 프로젝트의 운영 비용을 최적화하는 데 바로 적용할 수 있다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 클라우드의 고성능 모델로 구동하면 비용이 비싼 반면, 저비용 모델은 성능이 떨어진다. 연구팀은 고성능 모델과 저비용 모델이 하나의 장기 작업 내에서 협력할 때 비용을 줄이면서도 정확도를 유지할 수 있는지 체계적으로 조사했다. 모델 간 역할 교대(handoff)를 통해 협력하며, 교대 방향(누가 누구에게 넘길지)과 맥락 전달 방식을 핵심 설계 항목으로 삼았다. 전체 요약 8문장 읽기 → 016 18:15 스타 2,588 Claude로 기계를 3D 시뮬레이터로 만들어 분해할 수 있는 도구 Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. AI · 머신러닝 · elvarofficial/teardown · JavaScript
Key Point Claude로 기계의 작동 원리를 3D 시뮬레이터로 즉시 만들 수 있는 방식이 등장해, 복잡한 엔지니어링 개념을 직관적으로 이해하고 공유하는 방법이 바뀔 수 있다.
핵심 요약
Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. 기계는 화면 중앙에 표시되고, 주변 패널에서 실시간 수치를 읽을 수 있으며, 버튼으로 작동 부품을 분해할 수 있다. 아무도 조작하지 않으면 페이지가 자동으로 기계를 둘러본다. 전체 요약 10문장 읽기 → 017 09:11 ▲ 15 · 댓글 2 가우시안 아바타의 흐릿함·왜곡을 확산 모델로 보정 단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. AI · 머신러닝 · EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
Key Point 카메라 한 대로 촬영한 비디오나 이미지로 3D 아바타를 만들 때 피할 수 없던 흐릿함과 왜곡을 AI로 자동 보정할 수 있게 되면, 메타버스와 실시간 통신 같은 응용에서 아바타 품질을 크게 높일 수 있다.
핵심 요약
단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. EDGAR는 조건부 확산 프레임워크로, 신원 정보를 유지하면서 가우시안 아바타의 결함을 고쳐주도록 설계했다. 학습을 위해 EDGAR-SET이라는 하이브리드 데이터셋을 만들었는데, 실제 촬영 샘플과 합성 렌더링 샘플을 섞어 열악한 가우시안 아바타 렌더링을 바닥 참값과 참조 이미지와 짝지었다. 전체 요약 8문장 읽기 → 018 15:11 ▲ 26 · 댓글 3 AI 에이전트가 로봇 조종사 대신, 저비용 데이터셋 자동 생성 로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. AI · 머신러닝 · PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
Key Point 로봇 학습 데이터 수집 비용을 최소 60% 절감하면서도 성능과 환경 변화에 대한 강건성을 동시에 확보하는 방식을 제시해, 로봇 개발의 경제성 문제를 바꿀 가능성이 있다.
핵심 요약
로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. 연구팀은 코딩 에이전트가 조종사의 역할을 대신하는 'DataFarm' 시스템을 개발했다. 에이전트는 한 번의 캘리브레이션 영상과 작업 설명을 받아 시뮬레이션 내에서 장면, 전문가 제어기, 성공 판별 함수를 자동으로 작성한다. 전체 요약 7문장 읽기 → 019 12:11 ▲ 10 · 댓글 5 기존 언어모델을 확산 모델로 변환하는 LoRA 기법 공개 자기회귀(AR) 모델을 확산 언어모델(DLM)로 변환하는 파라미터 효율적 기법 BYOD를 제시했다. AI · 머신러닝 · BYOD: Build Your Own DLM - Efficient Autoregressive-to-Diffusion Language Model Conversion
Key Point 확산 모델의 장점(병렬 토큰 업데이트, 유연한 생성)을 기존 오픈소스 언어모델에 저비용으로 적용하는 실용적 경로를 제시하며, 어댑터 학습만으로 대규모 재학습 없이 변환 가능함을 처음 증명했다.
핵심 요약
자기회귀(AR) 모델을 확산 언어모델(DLM)로 변환하는 파라미터 효율적 기법 BYOD를 제시했다. Gemma 2 9B, Llama 3.1 8B, Qwen2.5 7B, Ministral 8B 등 4개 모델에 LoRA 어댑터만으로 확산 생성 기능을 추가했으며, Mistral 모델의 AR-to-DLM 변환은 처음 보고된 사례다. 어댑터는 최종 파라미터의 4.1-5.8%만 차지하며 기본 모델 파라미터는 모두 동결된 상태로 유지된다. 전체 요약 9문장 읽기 → 020 03:11 ▲ 102 · 댓글 80 알고리즘 효율성의 정의를 놓친 50년, 이론과 현실의 단절 1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. AI · 머신러닝 · Efficient algorithms, the Exponential Time Hypothesis, and losing the plot
Key Point 컴퓨터과학 기초 이론이 현실의 계산 능력과 완전히 단절되어 있으며, 세계적 기업이 발표한 '획기적' 결과도 실제로는 구현 불가능한 매개변수를 감추고 있다는 점을 보여주기 때문입니다.
핵심 요약
1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. 에드몬즈는 자신의 기준이 불완전함을 알았고, n^1000 같은 다항식도 현실에서는 효율적이지 않으며 일부 지수 알고리즘(심플렉스)이 실무에서 빠르게 작동한다는 점을 이미 지적했다. 이 모호한 정의로 50년간 복잡도 이론이 발전했고, 현재 우리에게는 '복잡도 동물원'이라는 표현할 수 없을 정도로 큰 실행 시간을 가진 '우주적 알고리즘(galactic algorithm)'들이 쌓여 있다. 전체 요약 6문장 읽기 → 021 03:11 ▲ 194 · 댓글 50 Postman, 사용자 동의 없이 AI 플러그인 자동 설치 및 연동 Postman 데스크톱 12.33.4는 기존 사용자가 앱을 열 때 Codex와 Claude Code 플러그인을 자동으로 설치하는데, 로그에 'auto-existing-upgrade' 소스로 설치되었음이 기록된다. 보안 · Postman silently auto-installs AI plugins and attempts to share all API data
Key Point 개발자가 신뢰하는 도구들이 명시적 동의 없이 상호 연동되고 시스템 설정이 자동으로 변경되는 문제로, 조직 환경의 보안과 통제 범위에 직접 영향을 미친다.
핵심 요약
Postman 데스크톱 12.33.4는 기존 사용자가 앱을 열 때 Codex와 Claude Code 플러그인을 자동으로 설치하는데, 로그에 'auto-existing-upgrade' 소스로 설치되었음이 기록된다. 설치 과정에서 Postman은 Codex의 전역 설정 파일 ~/.codex/config.toml을 수정해 자신의 플러그인을 enabled=true로 등록하고 hooks/codex-hooks.json에 sha256 해시값을 trusted_hash로 추가했다. Postman이 주입한 hook 파일은 SessionStart 실행 시 사용자의 명시적 요청과 무관하게 모든 API 엔지니어링 작업(설계, 구현, 테스트, 배포 등)에서 Postman 스킬을 로드하도록 지시한다. 전체 요약 8문장 읽기 → 022 03:11 ▲ 12 · 댓글 2 어두운 사진을 한 번에 살리는 생성형 AI 기술 개발 저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. AI · 머신러닝 · GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
Key Point 어두운 사진을 한 번의 계산으로 고품질로 복원할 수 있게 되면, 스마트폰이나 보안카메라 같은 실제 기기에서 즉시 적용할 수 있는 기술이 된다.
핵심 요약
저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. 기존 확산 기반 생성형 방법은 강력한 이미지 사전 정보를 활용해 높은 화질을 달성하지만, 반복적 샘플링으로 인한 계산 비용이 크고 실제 배포에 제약이 있다. GLOW-FM은 한 번의 함수 평가로 고품질 개선을 수행하는 단계별 지연 흐름 일치(flow matching) 프레임워크를 제안한다. 전체 요약 9문장 읽기 → 023 21:11 당일 +2,173 Rust로 만든 AI 에이전트용 데스크톱 제어 도구 공개 Vercel Labs가 agent-desktop을 공개했으며, AI 에이전트가 데스크톱 애플리케이션을 안정적으로 제어할 수 있도록 설계되었다. AI · 머신러닝 · vercel-labs/agent-desktop · Rust
Key Point 픽셀 인식 대신 접근성 트리 기반으로 UI를 제어하므로 앱 변경에도 에이전트 동작의 안정성이 높아지며, 현업 AI 에이전트 개발자에게 실용적인 도구다.
핵심 요약
Vercel Labs가 agent-desktop을 공개했으며, AI 에이전트가 데스크톱 애플리케이션을 안정적으로 제어할 수 있도록 설계되었다. Rust로 구축됐으며 OS 접근성 트리(accessibility tree)를 통해 앱의 실제 UI 구조를 읽고, 픽셀 분석 대신 안정적인 요소 참조(ref)로 동작한다. 스냅샷 명령으로 JSON 형식의 UI 상태를 얻고, 에이전트가 참조를 통해 액션을 실행한 후 다시 스냅샷을 취해 상태 변화를 확인한다. 전체 요약 11문장 읽기 → 024 18:11 ▲ 11 · 댓글 2 가중치 정규화 학습의 진짜 핵심은 유효 학습률 스케줄 Weight-Normalized(WN) 학습이 기존 Weight Decay(WD)보다 사전학습 손실을 크게 줄이는 것으로 보고되고 있으나, 그 개선은 정규화 자체보다는 유효 학습률(ELR) 궤적이 주된 원인임을 밝혔다. AI · 머신러닝 · Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
Key Point Weight Decay 기반 학습에서 최고 성능을 달성하려면 명목 학습률이 아닌 유효 학습률 궤적을 직접 최적화해야 한다는 실질적 교훈을 제시한다.
핵심 요약
Weight-Normalized(WN) 학습이 기존 Weight Decay(WD)보다 사전학습 손실을 크게 줄이는 것으로 보고되고 있으나, 그 개선은 정규화 자체보다는 유효 학습률(ELR) 궤적이 주된 원인임을 밝혔다. WN과 WD의 ELR 궤적을 일치시키면 훈련 손실 동역학이 대부분 겹쳐지므로, 스케줄 설계는 명목 학습률(LR)이 아닌 ELR을 직접 대상으로 해야 한다. 이 원칙을 바탕으로 이론적으로 유도된 1/t 감쇠에 선형 보정을 더한 AIR(Affine Inverse-square-Root decay) 스케줄을 제안하며, 유한 훈련 기간 동안 목표 최고점과 말기 LR을 만족하도록 설계했다. 전체 요약 6문장 읽기 → 025 21:11 당일 +600 16명의 AI 에이전트 팀이 담긴 오픈소스 데스크톱 앱 Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. AI · 머신러닝 · Orkas-AI/Orkas · JavaScript
Key Point 마케팅 콘텐츠 제작, 이커머스 운영, 정기 보고서, 앱 개발 등 다양한 업무를 하나의 에이전트 팀으로 자동화할 수 있는 데스크톱 환경을 제공하므로, 반복 작업 자동화와 팀 협업이 필요한 개발자와 비즈니스 담당자에게 영향을 미친다.
핵심 요약
Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. 16개 내장 에이전트는 연구(DeepResearcher, SeoGeoAgent, StockAnalyser), 콘텐츠(ContentWriter, VideoStudio, VoiceStudio, ImageStudio, PptMaker), 개발(UIDesigner, ProductDeveloper), 사무(OfficeWorker), 이커머스(5개 전문 에이전트)를 담당한다. Claude Code, Codex, OpenCode, OpenClaw, Hermes-Agent 등 기존 CLI 에이전트들과 함께 작동하며, Commander가 각 에이전트에게 작업을 분배하고 결과를 통합한다. 전체 요약 12문장 읽기 → 026 21:11 ▲ 12 · 댓글 2 음성 대화형 AI를 위한 압축 토큰 처리 기법 제안 음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. AI · 머신러닝 · CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
Key Point 음성 대화 모델의 추론 비용을 크게 줄이면서 모델 재학습 없이 기존 시스템에 적용할 수 있는 방법이 제시되어, 실제 음성 AI 서비스의 성능과 비용 효율성을 동시에 개선할 수 있다.
핵심 요약
음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. 기존의 저율 토크나이저는 시퀀스를 짧게 하지만 압축 품질 손상과 모델 교체 비용이 크다. CoSTA는 원본 음성 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 호환성 보존형 프레임워크다. 전체 요약 7문장 읽기 → 027 18:11 ▲ 101 · 댓글 3 확인된 부분만 처리하는 비전-언어 모델, 연산 35% 수준으로 줄인다 Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. AI · 머신러닝 · Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
Key Point 비전-언어 모델의 추론 속도를 현격히 높이는 기술로, 대규모 멀티모달 모델을 실제 제품에 적용하려는 개발자들에게 중요한 최적화 방안을 제시한다.
핵심 요약
Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. 연구팀이 LLaDA-V 모델의 예측을 검토한 결과, 이미지 제거 시 토큰 언마스킹이 변하는 경우가 평균 22.8%, 최저 7.9%에 불과했다. LOWN이라는 새로운 디코딩 방식을 제안했으며, 매 단계마다 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정한다. 전체 요약 7문장 읽기 → 028 15:11 ▲ 21 · 댓글 3 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 029 15:11 ▲ 104 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 030 06:11 ▲ 28 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 031 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 032 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 033 03:11 ▲ 122 · 댓글 7 포스 언어 Gforth 1.0 공개, 멀티태스킹 기능 추가 포스(Forth) 언어의 구현인 Gforth 1.0이 릴리스되었으며, 새로운 기능들이 문서화되었다. 오픈소스 · 도구 · Gforth 1.0
Key Point 포스 언어의 주요 구현이 멀티태스킹, 메시지 큐, C 통합 등 현대적 기능을 갖춘 1.0으로 업그레이드되어 시스템 프로그래밍과 임베디드 시스템 개발 시 활용도가 달라진다.
핵심 요약
포스(Forth) 언어의 구현인 Gforth 1.0이 릴리스되었으며, 새로운 기능들이 문서화되었다. 스택 디버깅용 'Smart .s'는 스택 항목이 무엇을 의미하는지 추측해 적절히 표시하고, 터미널 하단에 BASE, 스택, 검색 순서를 보여주는 상태 줄이 추가되었다. 멀티코어/하드웨어 스레드에서 작동하는 멀티태스킹을 지원하며, newtask, task, initiate, execute-task, kill-task, mutex, lock, unlock 등의 단어들을 제공한다. 전체 요약 8문장 읽기 → 034 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 035 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 036 06:11 새 버전 Rust 1.98.0 출시, 수명 단축 강제 해제와 안전성 검사 강화 Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. 오픈소스 · 도구 · rust-lang/rust@1.98.0
Key Point Rust를 실무에서 쓰는 개발자라면 호환성 변화와 새로운 안전 검사 규칙, 플랫폼 지원 정책의 변화를 파악해야 기존 코드가 컴파일되지 않는 상황을 피할 수 있다.
핵심 요약
Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. memcmp, memset, strlen 같은 코어 런타임 심볼을 대상으로 invalid_runtime_symbol_definitions 린트(금지 기본값)와 suspicious_runtime_symbol_definitions 린트(경고 기본값)가 추가되었으며, 향후 확대될 예정이다. c_void_returns 린트(경고 기본값)로 core::ffi::c_void를 반환 타입으로 사용하는 것을 검사한다. 전체 요약 9문장 읽기 → 037 06:11 ▲ 126 · 댓글 73 덴마크, MS 오피스 대체 오픈소스 프로젝트 조용히 중단 덴마크 디지털화부(Digitaliseringsministeriet)가 마이크로소프트 오피스 대체 프로젝트의 시범사업을 조용히 종료했다. 오픈소스 · 도구 · Danish Government silently drops plan to dump MS Office
Key Point 공공기관의 오픈소스 도입 정책이 실제로는 어떻게 전개되는지, 그리고 기술 선택이 정치·경제적 현실 앞에서 어떻게 결정되는지를 보여주는 사례다.
핵심 요약
덴마크 디지털화부(Digitaliseringsministeriet)가 마이크로소프트 오피스 대체 프로젝트의 시범사업을 조용히 종료했다. 정부가 오픈소스 대안 도입을 추진했던 계획을 공식 발표 없이 포기한 것으로, 마이크로소프트 제품 계속 사용으로 회귀했다. 이는 공공부문의 오픈소스 정책 전환과 클라우드 인프라 의존도 증가 추세를 반영하는 것으로 보인다. 038 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 039 00:11 ▲ 269 · 댓글 278 무스크의 우크라이나 스타링크 제한, 유럽에 미국 기술 의존도 위험성 인식시키다 무스크가 우크라이나에 제공되던 Starshield(군사용 Starlink)를 개인적 판단으로 중단·제한하면서 유럽 정책결정권자들에게 큰 충격을 줬다. 스타트업 · 비즈니스 · Elon Musk Just Gave Europe a Reason to Replace American Technology
Key Point 미국 기술 기업의 일방적 결정이 지정학적 리스크로 인식되면서 향후 수십 년간 미국 기술 기업의 유럽 시장 영향력과 수익성이 근본적으로 위협받을 수 있기 때문이다.
핵심 요약
무스크가 우크라이나에 제공되던 Starshield(군사용 Starlink)를 개인적 판단으로 중단·제한하면서 유럽 정책결정권자들에게 큰 충격을 줬다. 수년간 유럽은 미국이 미국 기술의 스위치를 일방적으로 끌 수 있다는 우려를 제기해왔지만, 이번 사건으로 그것이 현실임이 증명되었다. 유럽 지도자들은 이제 Microsoft, OpenAI, Google 등 다른 미국 CEO들도 언제든 제품 접근을 제한할 수 있다는 시나리오를 더 이상 비현실적이라고 보지 않는다. 전체 요약 7문장 읽기 → 040 00:11 ▲ 116 · 댓글 61 구글 Brotli 압축 라이브러리의 심각한 보안 결함, HTTP 생태계 전역 영향 구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. 보안 · Node2Shell evolves to HTTP2Shell, blast radius affects many HTTP libs and apps
Key Point HTTP 압축의 표준 라이브러리 취약점이 Node.js·Python·여러 언어 전역에 영향을 미치며, 자동 의존성 로드로 인해 직접 설치하지 않은 애플리케이션도 노출될 수 있어 긴급 대응이 필요하다.
핵심 요약
구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. CVSS 9.2(심각)로 평가되며, 2월 OpenAI에서 발견했으나 당시엔 보안 문제로 인식되지 않았다. Node.js 22.23.4·24.22.1·26.12.1, Python Brotli 1.2.1·brotlicffi 1.2.1.0, Bun 1.4.4, Envoy 1.40.0 등으로 패치 가능하다. 전체 요약 8문장 읽기 → 041 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 042 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 043 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 044 12:11 ▲ 18 · 댓글 2 동영상 얼굴 바꾸기를 실시간으로, StreamingSwap 프레임워크 비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. AI · 머신러닝 · From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
Key Point 얼굴 교체 기술을 실시간 장시간 스트림까지 확장한 기술적 혁신으로, 고화질 정체성 전이를 저사양 하드웨어에서 구현했다.
핵심 요약
비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. 기존 플로우 매칭 방식은 얼굴만 바뀌는 변화에 약하고, 장시간 스트림에서 정체성 전이·고화질·실시간 생성을 동시에 달성하기 어렵다. Joint Rec-ID Loss를 개발해 노이즈 레벨에 따라 명시적 정체성 감독과 잠재 재구성을 균형있게 한다. 전체 요약 8문장 읽기 → 045 12:11 ▲ 11 · 댓글 2 자기 재귀로 멀티토큰 예측 효율화한 ECHO 논문 기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. AI · 머신러닝 · ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
Key Point 자동회귀 언어 모델의 학습과 추론 효율성을 동시에 높이는 핵심 알고리즘 개선으로, 기존 멀티토큰 예측의 구조적 문제를 근본적으로 해결한다.
핵심 요약
기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. ECHO는 백본의 최종 레이어 자체가 모든 예측 스텝을 담당하므로 감독 신호가 다음 토큰을 생성하는 매개변수에 직접 전달된다. 깊은 스텝의 학습 비용을 낮추기 위해 동적 깊이 샘플링(DDS)을 도입해 깊이에 따라 확률을 감쇠시킨다. 전체 요약 6문장 읽기 → 046 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 047 09:11 ▲ 202 · 댓글 3 AI 피어 리뷰 검증 시스템 PremiseCheck 공개 논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. AI · 머신러닝 · PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
Key Point 피어 리뷰는 논문 평가의 기초인데 AI가 생성한 댓글의 정확성을 효율적으로 검증할 방법이 없었던 상황을 두 단계 검증으로 해결했기 때문이다.
핵심 요약
논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. NLP, 머신러닝, 자연과학 논문에서 검증된 이 벤치마크는 정확도뿐 아니라 비용과 응답 시간도 측정한다. GPT-5.5 같은 고성능 LLM은 검증 정확도가 높지만 매번 전체 논문을 읽어야 하므로 비용이 크다. 전체 요약 6문장 읽기 → 048 00:11 ▲ 552 · 댓글 288 경찰관, 남편 ICE 요원에게 차량번인식 시스템 무단 공유 해고된 새배너 경찰관 앰버 하프가 남편(ICE 요원)에게 경찰의 Flock 차량번인식 시스템 접근 권한을 제공했고, 남편은 수백 건의 수사 관련 조회를 실시했다. 보안 · Ousted Savannah police officer gave ICE agent husband access to Flock system
Key Point 법정 집행 기관 내부의 자격증명 공유가 감시 시스템의 책임 추적과 법적 통제를 어떻게 훼손할 수 있는지, 그리고 같은 부서 내 감독자들이 정책 위반의 처벌 수준을 둘러싸고 어떻게 갈렸는지 보여준다.
핵심 요약
해고된 새배너 경찰관 앰버 하프가 남편(ICE 요원)에게 경찰의 Flock 차량번인식 시스템 접근 권한을 제공했고, 남편은 수백 건의 수사 관련 조회를 실시했다. 2026년 1월~7월 내부감시에서 하프의 계정으로 6개 주에서 97개 차량번 관련 983건의 조회가 적발되었으며, 사우스캐롤라이나 차량이 788건으로 대부분을 차지했다. 하프는 조사에서 남편이 대부분의 조회를 수행했다고 인정했고, 남편 타일러는 자신이 연방 업무로 Flock 접근권이 없어서 아내에게 로그인 정보를 요청했다고 진술했다. 전체 요약 10문장 읽기 → 049 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 050 09:11 ▲ 146 · 댓글 128 에스토니아 온라인 투표 시스템 소스코드 공개 에스토니아는 공식 선거에 사용하는 온라인 투표 시스템 IVXV의 소스코드를 GitHub에 공개했다. 보안 · Source code of the Estonian online voting system
Key Point 민주주의의 핵심인 투표 시스템의 소스코드를 공개함으로써 투명성과 신뢰성을 확보하려는 국가 차원의 시도로, 다른 국가의 전자투표 도입 시 참고할 수 있는 모범 사례다.
핵심 요약
에스토니아는 공식 선거에 사용하는 온라인 투표 시스템 IVXV의 소스코드를 GitHub에 공개했다. 이 저장소는 공개 검토를 위해 만들어졌으며, 활발한 개발은 진행하지 않지만 실제 선거에 사용되는 코드로 최신 상태를 유지한다. 법적 구속력이 있는 선거에 사용되는 투표 시스템이므로 에스토니아 선거관리위원회(State Electoral Office)의 감시 하에 엄격히 입법에 따라 개발된다. 전체 요약 5문장 읽기 → 051 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 052 21:11 당일 +154 안드로이드 폰을 Linux PC로 만드는 DroidDesk DroidDesk는 Termux, Termux X11, TUR, Proot를 활용해 안드로이드 폰을 완전한 Linux 데스크톱 환경으로 변환하는 오픈소스 프로젝트다. 인프라 · 데브옵스 · orailnoor/DroidDesk · Kotlin
Key Point 안드로이드 폰을 단순 터미널이 아닌 완전한 Linux 데스크톱 PC로 사용할 수 있게 해주는 기술이 공개됐으며, 폰을 모니터에 연결하면 휴대용 Linux 워크스테이션이 된다.
핵심 요약
DroidDesk는 Termux, Termux X11, TUR, Proot를 활용해 안드로이드 폰을 완전한 Linux 데스크톱 환경으로 변환하는 오픈소스 프로젝트다. VS Code, Firefox, LibreOffice, Blender, Wireshark, Metasploit, 로컬 AI 등 Ubuntu에서 실행되는 거의 모든 앱을 폰에서 구동할 수 있다. 폰의 커널에 직접 접근하므로 에뮬레이션이 아닌 네이티브 성능으로 동작하며, XFCE4, LXQt, MATE, KDE 중 선택한 데스크톱 환경을 자동 설치한다. 전체 요약 8문장 읽기 → 053 18:11 ▲ 101 · 댓글 28 Rust로 만든 고성능 웹 프레임워크 Proa 공개 Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 웹 · 프론트엔드 · Show HN: Proa – A Rust web framework with fast SSR and multi-target rendering
Key Point 한 번의 Rust 코드로 여러 렌더 타겟을 생성하고 React보다 237배 빠른 서버 렌더링을 제공하는 새로운 웹 프레임워크의 등장으로, SSR 기반 웹 개발의 패러다임이 어떻게 변할 수 있는지 보여줍니다.
핵심 요약
Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 하나의 타입된 컴포넌트로 HTML, Markdown 등 여러 렌더 타겟을 동시에 생성할 수 있습니다. 벤치마크 결과에 따르면 Proa의 서버 렌더링 속도는 React의 renderToString보다 237배 빠릅니다(8vCPU AMD EPYC-Milan VPS 기준). 전체 요약 12문장 읽기 → 054 15:11 ▲ 25 · 댓글 2 선택 작업에 특화된 경량 멀티모달 모델 Intern-Decision 공개 Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. AI · 머신러닝 · Intern-Decision: Efficient Multimodal Decision Making with Autoregressive Masked Language Modeling
Key Point 의사결정이 필요한 에이전트 시스템에서 응답 생성 대신 구조화된 선택을 직접 반환하므로, 지연시간을 줄이고 모델-환경 인터페이스를 단순화한다.
핵심 요약
Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. 자동회귀 마스크 언어 모델링 목표를 사용하여 완전한 어시스턴트 JSON 스켈레톤에 필드당 하나의 결정 플레이스홀더를 배치하고, 한 번의 순방향 전달로 모든 필드를 평가한다. 4B 모델이 7개 평가 세트에서 평균 90.02% 정확도를 달성했으며, Llama v1.13.0의 88.74%를 능가한다. 전체 요약 7문장 읽기 → 055 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 056 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 057 12:11 ▲ 78 · 댓글 3 비디오 생성 중간에 이미 완성된 토큰 멈추기 자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. AI · 머신러닝 · Speculative Forcing for Efficient Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 계산 병목을 토큰 단위로 해결해 같은 품질의 결과를 1.35~1.5배 빠르게 생성할 수 있게 하는 방법론이 공개됐다.
핵심 요약
자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. Speculative Forcing은 초기 단계의 깨끗한 추정값을 임시 결과물로 취급하고, 개별 토큰이 안전하게 조기에 수락될 수 있는 시점을 예측하는 프레임워크다. 수락된 토큰은 더 이상 노이즈 제거를 받지 않으면서 남은 토큰들의 맥락으로 캐시된 키와 값이 활용된다. 전체 요약 7문장 읽기 → 058 09:11 ▲ 203 · 댓글 105 16GB로 28개 서비스 운영하는 방법 저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. 인프라 · 데브옵스 · What I Self-Host
Key Point 작은 하드웨어로 수십 개 서비스를 효율적으로 자체 호스팅하려는 개발자들에게 실제 운영 구성, 도구 선택 원칙, 구체적 성능 수치를 제시한다.
핵심 요약
저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. Jellyfin을 기점으로 클라우드 서비스 의존도를 줄이기로 결심했으며, ISP의 CGNAT 제약으로 IPv6 VPN만 공개하고 내부 서비스는 인터넷에 노출하지 않는 정책을 유지했다. 단일 Go 바이너리 선호, Docker 대신 Podman/systemd 활용 등 운영 간편성을 우선으로 서비스를 선택했다. 전체 요약 9문장 읽기 → 059 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 060 03:12 ▲ 12 · 댓글 2 AI가 생성한 이미지의 글자 오류, 효율적으로 고쳐낸다 생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
Key Point AI가 만든 이미지의 텍스트 오류를 효율적으로 고칠 수 있는 방법이 나왔으며, 기존 방식 대비 정확도가 2배 이상 높아서 생성 이미지의 실용성이 크게 개선될 수 있다.
핵심 요약
생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. 기존 VAE 기반 방식은 재구성 과정에서 글자의 세밀한 획을 잃고, 전체 이미지 편집은 배경색을 왜곡하는 한계를 갖는다. PixText는 장면의 텍스트 보정을 픽셀 공간의 그룹화된 이미지 생성으로 정의하며, 원본 이미지를 조건으로 목표 영역만 생성하고 편집되지 않은 부분을 보존한다. 전체 요약 7문장 읽기 → 061 21:11 ▲ 64 · 댓글 1 장기 작업 에이전트 훈련을 위한 반복적 환경 진화 방식 WorkRover 강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. AI · 머신러닝 · WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
Key Point 장기 작업을 수행하는 AI 에이전트의 훈련 효율을 대폭 개선하는 새로운 프레임워크로, 복잡한 작업 환경을 자동으로 정제하고 검증하는 방식이 기존 대비 크게 나은 성능을 달성했다.
핵심 요약
강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. WorkRover는 하니스 기반 합성으로 구성 에이전트가 의미론적으로 정렬된 작업 맥락, 실행 가능한 작업, 증거 기반 검증자를 함께 구축하고 고정 워크플로우 대신 작업공간 상태와 실행 피드백에 맞춰 조치하는 프레임워크다. 환경 진화를 지원하기 위해 의존성 폐쇄 재실행과 검증된 후보 중 가장 작은 수정안을 선택하는 Factorial Compatibility Replay(FCR)를 도입했다. 전체 요약 5문장 읽기 → 062 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 063 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 064 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 065 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 066 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 067 03:11 ▲ 109 · 댓글 69 해커뉴스 공개 후 AI 봇 트래픽 폭증 해커뉴스에서 인기를 얻은 customizable feed reader 'sprinklz.io' 출시 후 웹사이트 트래픽이 급증했으나 원인을 조사해보니 AI 봇이 대부분이었다. 기타 · I posted to HN, and then my website was flooded with AI bot traffic
Key Point 개발자가 공개한 작은 프로젝트가 AI 봇 트래픽으로 마비되는 현상은 LLM 기반 서비스의 급증으로 인한 웹 생태계 변화를 보여준다.
핵심 요약
해커뉴스에서 인기를 얻은 customizable feed reader 'sprinklz.io' 출시 후 웹사이트 트래픽이 급증했으나 원인을 조사해보니 AI 봇이 대부분이었다. 트래픽의 거의 절반이 자신을 '웹사이트 변경 감지 후 AI 뉴스레터로 요약하는 서비스'라고 설명하는 한 사용자에서 나왔으며, 분당 여러 번 쿼리를 날렸다. Claude, OpenAI, Google 검색 봇 등의 크롤러와 함께 /wp-content/phpinfo.php 같은 취약점 스캔 시도도 감지되었다. 전체 요약 6문장 읽기 → 068 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 069 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 070 21:11 당일 +171 Claude Code에서 언리얼 에디터를 직접 조종하는 MCP 플러그인 공개 에픽게임즈가 Claude Code용 언리얼 엔진 플러그인을 공개했으며, MCP(Model Context Protocol)를 통해 Claude Code에서 언리얼 에디터를 직접 제어할 수 있다. AI · 머신러닝 · EpicGames/unreal-engine-skills-for-claude-code-plugin · Shell
Key Point Claude Code에서 코드 작성과 동시에 언리얼 에디터를 완전히 자동화할 수 있게 되면서, AI 어시스턴트를 활용한 게임 개발 워크플로우가 본격화된다.
핵심 요약
에픽게임즈가 Claude Code용 언리얼 엔진 플러그인을 공개했으며, MCP(Model Context Protocol)를 통해 Claude Code에서 언리얼 에디터를 직접 제어할 수 있다. 액터, 블루프린트, 머티리얼, Niagara, Control Rig, Sequencer, State Trees, 위젯, Gameplay Ability System, 자동화 테스트 등 30개 이상의 툴셋에서 수백 개의 도구를 노출한다. 플러그인은 ModelContextProtocol과 AllToolsets 플러그인이 활성화된 언리얼 에디터, 실행 중인 MCP 서버, PATH에 bash가 있어야 한다. 전체 요약 12문장 읽기 → 071 03:11 당일 +164 Flutter로 모바일·웹·데스크톱 앱을 단일 코드베이스에서 만든다 Google이 제공하는 크로스플랫폼 SDK인 Flutter는 하나의 Dart 코드베이스로 iOS, Android, 웹, Windows, macOS, Linux 앱을 빌드할 수 있다. 웹 · 프론트엔드 · flutter/flutter · Dart
Key Point 단일 코드베이스로 모바일·웹·데스크톱 앱을 동시에 개발할 수 있는 크로스플랫폼 프레임워크의 최신 상태를 확인할 수 있다.
핵심 요약
Google이 제공하는 크로스플랫폼 SDK인 Flutter는 하나의 Dart 코드베이스로 iOS, Android, 웹, Windows, macOS, Linux 앱을 빌드할 수 있다. Skia와 Impeller 같은 하드웨어 가속 2D 그래픽 라이브러리를 기반으로 화면의 모든 픽셀을 제어하면서 제약 없이 그래픽, 비디오, 텍스트, 컨트롤을 겹치고 애니메이션할 수 있다. Cupertino(iOS)와 Material 디자인 위젯을 포함한 완전한 위젯 세트를 제공하며, 필요시 완전히 새로운 시각 컴포넌트를 만들 수 있다. 전체 요약 8문장 읽기 → 072 00:11 ▲ 108 · 댓글 112 애플·macOS, Unix 공식 등록 목록에서 조용히 제외 The Open Group이 운영하는 공식 Unix 인증 제품 등록부에서 Apple과 macOS가 제거되었다. 하드웨어 · 시스템 · Apple/macOS silently removed from official Unix registry
Key Point macOS가 Unix 인증을 잃으면서 애플이 공식적으로 Unix 호환 시스템으로 마케팅할 수 없게 되었고, 이는 엔터프라이즈 환경에서 시스템 신뢰성 선택 기준에 영향을 미친다.
핵심 요약
The Open Group이 운영하는 공식 Unix 인증 제품 등록부에서 Apple과 macOS가 제거되었다. Unix 인증을 받으려면 Single UNIX Specification을 완전히 준수해야 하며, 인증받은 제품만 Unix 상표를 사용할 수 있다. The Open Group에 따르면 Unix 인증은 이식성, 호환성, 글로벌 상호운용성에서 가장 엄격한 기준을 충족하는 업계 표준이다. 전체 요약 4문장 읽기 → 073 21:11 당일 +663 AI 에이전트를 과학자로 만드는 177개 스킬 라이브러리 K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. AI · 머신러닝 · K-Dense-AI/scientific-agent-skills · Python
Key Point 연구자가 직접 개발한 과학 도구들을 AI 에이전트에 설치하면 실험 설계·데이터 분석·논문 작성 같은 복잡한 연구 작업을 몇 줄의 지시로 자동화할 수 있다는 점이 핵심이다.
핵심 요약
K-Dense가 공개한 Scientific Agent Skills는 AI 에이전트용 177개의 과학 연구 스킬을 담은 Python 라이브러리로, 생물학·화학·의학·신약개발 등 과학 전 분야를 커버한다. 100개 이상의 과학 데이터베이스(PubChem, ChEMBL, UniProt, ClinicalTrials.gov 등)와 RDKit, Scanpy, PyTorch, scikit-learn 등 70개 이상의 파이썬 패키지에 대한 최적화된 워크플로우를 제공한다. Cursor, Claude Code, Codex, Google Antigravity 등 Agent Skills 표준을 지원하는 모든 호스트와 호환되며, Agent Plugins 패키지로도 사용 가능하다. 전체 요약 12문장 읽기 → 074 16:56 ▲ 129 · 댓글 2 토큰 단위 LLM 라우팅을 위한 고효율 서빙 시스템 LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. AI · 머신러닝 · TokenRouter: Efficient Serving System for Token-Level LLM Routing
Key Point 토큰 단위로 여러 모델을 동적으로 선택하는 고급 라우팅 기법을 실제로 빠르게 처리할 수 있는 시스템이 처음 등장했기 때문이다.
핵심 요약
LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. 최근 연구는 토큰 단위의 세밀한 라우팅이 효율성과 품질에서 큰 이득을 줄 수 있음을 보였지만, 기존 LLM 서빙 시스템은 단일 모델 가정 위에 설계되어 토큰 단위 라우팅에서 심각한 동기화 문제와 배치 지연을 겪는다. TokenRouter는 요청 중심 프로그래밍, 모델 중심 실행 원칙을 따르며, 개발자는 단일 요청 관점에서 라우팅 로직을 기술하고 런타임이 각 LLM마다 서브서버를 실행해 비동기로 요청을 분배한다. 전체 요약 6문장 읽기 → 075 12:11 ▲ 29 · 댓글 2 생성 시점의 활성화에 맞춘 LLM 가지치기로 디코딩 가속 LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. AI · 머신러닝 · SparseDecoding: Decoding-Aware Pruning for Accurate and Efficient LLM Inference
Key Point 디코딩 단계의 실제 토큰 생성 환경과 가지치기 과정의 불일치를 해결하면서 SpMV 연산에 최적화된 커널까지 제공해, LLM 추론 속도 개선에 직접적으로 적용 가능한 실무적 해법을 제시한다.
핵심 요약
LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. 기존 방법들은 자연 텍스트에서 계산한 Hessian으로 모델을 가지치기하지만, 실제 디코딩 중에는 모델이 자체 생성 토큰을 처리하면서 분포 차이(distribution shift)가 발생한다. 이로 인해 생성 시 활성화 분포가 가지치기 시 사용된 분포에서 벗어나 모델 성능이 저하되는 문제가 있다. 전체 요약 7문장 읽기 → 076 21:11 ▲ 171 · 댓글 66 15년을 검색해서 찾은 한곡의 밴드 2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 기타 · The 15-year search for a band that charted once and vanished
Key Point AI 검색 도구의 시대에도 인터넷에서 완전히 사라진 음악을 추적할 수 없었던 이유와, 여러 모델을 접목한 체계적 조사가 어떻게 마침내 실마리를 찾았는지 보여주는 구체적 검색 과정이 흥미롭다.
핵심 요약
2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 초기에는 수동 검색으로 시도했고, 최근에는 AI 모델 여러 개를 활용해 메타데이터, 커버 아트, URL 등 수집한 모든 정보를 분석하게 했다. Official Charts 기록에서 2006년 6월 4-10주 독립 싱글 차트 47위 진입을 확인했고, Despatches라는 레이블에서 발매한 것을 알아냈다. 전체 요약 11문장 읽기 → 077 18:30 새 버전 Node.js 26.11.0 출시, 버퍼·HTTP·암호화 기능 강화 Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. 인프라 · 데브옵스 · nodejs/node@v26.11.0
Key Point Buffer 검증·HTTP 헤더 안전성·프로세스 타임아웃 등 개발 안정성을 높이는 새 기능들이 다수 안정화됨에 따라 프로덕션 환경 운영의 신뢰도가 올라간다.
핵심 요약
Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. HTTP 모듈에 헤더 검증 함수 isValidHeaderName()과 isValidHeaderValue()가 새로 제공된다. HTTP/2에 connectionWindowSize 옵션이 추가되어 연결 윈도우 크기를 제어할 수 있다. 전체 요약 11문장 읽기 → 078 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 079 18:30 ▲ 13 · 댓글 4 MoE 모델 디코딩 성능 2배 근처로 높이는 프레임워크 Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. AI · 머신러닝 · SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
Key Point MoE 모델의 디코딩 병목을 해결하는 새로운 방식으로 정확도 손실을 최소화하면서 처리량을 획기적으로 높일 수 있다는 점이 중요하다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. 기존 전문가 가지치기(pruning)는 계산이 필요한 prefill 단계도 함께 가지쳐 모델 품질 저하에 비해 처리량 향상이 미미하다. SlimWise는 추론 각 단계별로 전문가 풀을 다르게 구성하는 서빙 프레임워크로, prefill은 전체 모델로 수행하고 decode는 가지친 모델을 사용한다. 전체 요약 6문장 읽기 → 080 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 081 18:30 ▲ 200 · 댓글 57 해상 생활하는 개발자 커플, 10년 항해 일지와 도구·언어 프로젝트 공개 Hundred Rabbits는 배 위에서 사는 개발자 부부 Devine과 Rek이 운영하는 프로젝트 포럼으로, 매달 새로운 소프트웨어, 게임, 언어 개발을 기록하고 있다. 오픈소스 · 도구 · Living off-grid: Hundred Rabbits
Key Point 배 위에서 인터넷 불안정성을 견뎌내며 10년간 자체 개발 도구와 언어 생태계를 구축해온 개발자들의 실제 사례는, 중앙화된 플랫폼과 기존 소프트웨어에 의존하지 않는 독립적인 기술 실천이 구체적으로 어떻게 가능한지 보여준다.
핵심 요약
Hundred Rabbits는 배 위에서 사는 개발자 부부 Devine과 Rek이 운영하는 프로젝트 포럼으로, 매달 새로운 소프트웨어, 게임, 언어 개발을 기록하고 있다. 올해 주요 작업은 카드게임 Donsol의 새 버전 출시(애니메이션 스프라이트, 인게임 매뉴얼 포함), Uxn 에뮬레이터 개선, 벡터 렌더러 구현으로 타이포그래피 기능 확대 등이다. Uxntal이라는 16비트 어셈블리 언어로 작성한 포인트 앤 클릭 게임 Lepore Express Line을 Catjam 2026 게임잼에서 발표했다. 전체 요약 13문장 읽기 → 082 18:33 ▲ 13 · 댓글 1 긴 비디오 이해하기, 해상도 낮추고 프레임 촘촘히 샘플링해야 한다 비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. AI · 머신러닝 · Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
Key Point 비디오 이해 모델의 효율성을 높이는 새로운 관점으로, 해상도와 프레임 샘플링의 트레이드오프를 재정의하며 실제 배포 환경의 디코딩 병목을 해결한다.
핵심 요약
비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. 프론트엔드 디코딩 지연시간은 최종 토큰 수가 아니라 후보 풀의 크기에 의존하며, 1시간 길이의 비디오에서 프론트엔드 디코딩이 전체 처리 시간의 대부분을 차지한다. 해상도에 민감한 작업(예: 텍스트 인식)은 선택된 고해상도 프레임에서 이득을 얻으며, 일반적인 이해 작업은 저해상도 촘촘 샘플링으로 충분하다. 전체 요약 6문장 읽기 → 083 18:33 ▲ 14 · 댓글 3 작은 모델도 빠른 추론 가능, 선택 기반 구조화 추론 등장 멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. AI · 머신러닝 · Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
Key Point 2B~4B 같은 경량 모델에서 추론 속도를 90% 단축하면서도 성능을 유지하는 방식이 나왔으므로, 리소스 제약이 있는 환경에서 멀티모달 에이전트를 활용할 수 있게 된다.
핵심 요약
멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. 이를 해결하기 위해 선택 기반 구조화 추론(SSR)을 제안했다. 추론을 개방형 생성 대신 선택 문제로 재정의한다. SSR은 반복되는 고수준 추론을 미리 정의된 재사용 가능한 자연언어 후보로 표현한다. 전체 요약 8문장 읽기 → 084 09:11 ▲ 13 · 댓글 2 효율 학습이 추론의 투명성을 항상 해치지는 않는다 Chain-of-Thought(CoT) 추론을 짧게 만드는 효율 학습 방식이 모델의 투명성에 미치는 영향을 실증적으로 분석한 연구다. AI · 머신러닝 · Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
Key Point 대규모 언어모델의 투명성을 보장하면서도 추론 비용을 줄이는 방법의 실제 효과를 처음으로 체계적으로 검증한 연구로, LLM 배포 시 신뢰성과 효율성의 트레이드오프를 이해하는 데 필수적인 근거를 제공한다.
핵심 요약
Chain-of-Thought(CoT) 추론을 짧게 만드는 효율 학습 방식이 모델의 투명성에 미치는 영향을 실증적으로 분석한 연구다. 연구팀은 생성 예산 고정, 문장별 길이 목표, 상대적 길이 보상 세 가지 방식으로 길이 압력을 적용해 여러 모델을 미세조정했다. CoT 충실성(추론이 모델의 실제 의사결정을 얼마나 정확히 반영하는지)과 모니터링 가능성(입력 변화를 감지할 수 있는지)을 평가했다. 전체 요약 6문장 읽기 → 085 09:11 ▲ 12 · 댓글 2 고해상도 이미지 처리 위한 효율적인 토큰 순환 모델 GTR Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. AI · 머신러닝 · GTR: Gated Token Recurrence for Efficient Dense Prediction
Key Point 이차 복잡도로 인한 고해상도 이미지 처리의 계산 병목을 해결하는 새로운 아키텍처로, 4배 빠른 처리 속도와 엣지 장비 배포 가능성을 제시한다.
핵심 요약
Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. GTR(Gated Token Recurrence)은 소프트맥스 없는 순환 비전 백본으로 게이팅 선형 어텐션, 교대 공간 스캔 방향, 공간 강화된 SwiGLU 블록을 결합했다. GTR은 최종 레이어 패치-토큰 정렬로만 증류되며 마스킹된 토큰 예측이나 중간 레이어 감독은 사용하지 않는다. 전체 요약 8문장 읽기 → 086 18:11 ▲ 52 · 댓글 2 마스크 기반 확산 모델의 학습 효율성을 높이는 Pivot-SD 마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. AI · 머신러닝 · Pivot-SD: Efficient Self-Distillation for Masked Diffusion Language Models
Key Point 마스크 기반 확산 모델의 학습 비효율을 지목하고, 고영향 결정점만 선별 학습하는 새로운 자기증류 방식이 소규모 데이터로도 기존 방법을 능가하는 결과를 보여준다.
핵심 요약
마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. 기존 dLM 학습 방식은 이러한 신호를 활용하지 않으며, 최종 텍스트나 전체 노이징 단계에 보상을 할당하는 방식으로 개별 핵심 토큰 결정을 선별하지 않는다. Pivot-SD는 오프라인 자기증류 프레임워크로서, 오직 응답 형성에 큰 영향을 미치는 핵심 결정점(pivot)만을 감독한다. 전체 요약 5문장 읽기 → 087 00:11 ▲ 11 · 댓글 2 예측 가능한 의미 토큰으로 영상 생성 가속화 최근 영상 생성 모델들은 자기회귀 예측의 확장성과 확산 모델의 시각적 품질을 결합하고 있으며, 이 과정에서 장면 토크나이저의 선택이 핵심이다. AI · 머신러닝 · SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation
Key Point 자동회귀 영상 생성에서 모델 크기 대비 성능 효율이 3배 이상 개선되면서, 비용 효율적인 고품질 영상 생성 시스템 구축이 가능해진다.
핵심 요약
최근 영상 생성 모델들은 자기회귀 예측의 확장성과 확산 모델의 시각적 품질을 결합하고 있으며, 이 과정에서 장면 토크나이저의 선택이 핵심이다. 기존 유연한 토크나이저들은 초기 디코더 숨김층에만 표현 정렬(REPA) 손실을 적용하는데, 디코더가 노이즈 입력에서 이를 부분적으로만 충족할 수 있다는 문제가 있다. SemanTok은 고정된 DINO 특징을 인코더에 입력하고 각 토큰 접두사에서 이들을 재구성하는 경량 헤드를 추가한 유연한 영상 토크나이저다. 전체 요약 6문장 읽기 → 088 15:11 ▲ 11 · 댓글 1 음성 복제 TTS를 10배 빠르게, 자동회귀 대신 마스크 예측으로 기존 음성 복제 TTS는 자동회귀 시맨틱 모델링으로 높은 품질과 표현력을 보였지만, 순차 디코딩으로 인한 높은 지연 시간이 문제였다. AI · 머신러닝 · Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning
Key Point 음성 복제 음성합성의 속도와 유연성 문제를 동시에 해결하는 방식이 등장했으며, 텍스트 없는 조건화로 다국어·비음성 참조까지 지원하는 확장성이 실제 응용 시 의미가 있다.
핵심 요약
기존 음성 복제 TTS는 자동회귀 시맨틱 모델링으로 높은 품질과 표현력을 보였지만, 순차 디코딩으로 인한 높은 지연 시간이 문제였다. 논문은 Tacit-TTS라는 효율적인 음성 복제 시스템을 제안하며, IndexTTS2에서 증류(distillation)한 모델이다. 자동회귀 텍스트-시맨틱 디코딩을 마스크 기반 비자동회귀 생성으로 대체하고, 학습 없는 음성 길이 추정을 도입했다. 전체 요약 7문장 읽기 → 089 09:11 ▲ 54 · 댓글 2 에이전트 학습 효율 높이는 'X-Tree' 알고리즘 개발 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
Key Point 에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다. 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다. 전체 요약 9문장 읽기 → 090 21:11 ▲ 117 · 댓글 25 Haskell 프로그램을 JVM에서 돌리는 새로운 JIT 컴파일러 THC 공개 Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. 인프라 · 데브옵스 · Turbo Haskell
Key Point GHC에서 컴파일한 Haskell 코드를 JVM 위에서 고성능으로 실행할 새로운 선택지이며, 다른 언어 라이브러리 직접 연동과 경량 스레드 같은 기능으로 Haskell의 실용성을 높이고 있다.
핵심 요약
Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. GHC가 파싱·타입체크·최적화까지 담당하고, THC가 Core를 받아 Truffle/GraalVM 위에서 JIT 컴파일해 실행한다. Template Haskell과 Linear Haskell 등 고급 기능을 완벽히 지원하며, JIT와 Native Image를 통한 AOT 컴파일 모두 가능하다. 전체 요약 13문장 읽기 → 091 12:11 ▲ 115 · 댓글 26 LLM이 스스로 컨텍스트를 관리하는 새로운 모델 등장 Context Language Models(CLM)은 언어 모델이 자체 컨텍스트를 원시적으로 관리할 수 있도록 설계되었다. AI · 머신러닝 · Context Language Models
Key Point 컨텍스트 관리를 모델 스스로 학습하도록 함으로써 에이전트 시스템의 효율성과 확장성을 크게 개선할 수 있는 새로운 구조를 제시하기 때문이다.
핵심 요약
Context Language Models(CLM)은 언어 모델이 자체 컨텍스트를 원시적으로 관리할 수 있도록 설계되었다. 컨텍스트를 파일처럼 취급하여 모델이 이를 자유롭게 업데이트하도록 함으로써, 중요한 정보 유지 방식을 스스로 학습하게 한다. 다중 에이전트 시스템에서 여러 에이전트의 컨텍스트가 파일 형태로 공존할 수 있다. 전체 요약 9문장 읽기 → 092 00:11 새 버전 Rust 1.99.0 공개, C-가변함수 안정화 Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 오픈소스 · 도구 · rust-lang/rust@1.99.0
Key Point C-가변함수 안정화로 FFI 작업이 더 안전해지고, 다수의 라이브러리 API 안정화로 표준 라이브러리 사용성이 개선되며, Rustdoc 성능 최적화가 대규모 프로젝트의 빌드 속도에 영향을 줍니다.
핵심 요약
Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 언어 차원에서 raw_borrows_via_references 린트 추가, unconditional_panic 린트 확장, #[my_macro] mod foo; 구문 안정화 등이 진행되었다. 컴파일러는 AVR/AMDGCN/NVPTX에서 -Ctarget-cpu를 target-modifier로 변환하고, doc alias 속성이 메서드 제안 시 유사성 검색보다 우선하도록 개선했다. 전체 요약 9문장 읽기 → 093 21:11 당일 +280 Y Combinator CEO의 AI 에이전트 프로덕션 툴킷 공개 Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. AI · 머신러닝 · garrytan/gstack · TypeScript
Key Point 한 명의 기술 창업자가 전통적 팀 규모만큼 빠르게 일 처리할 수 있는 AI 에이전트 시스템의 구체적인 구현 방법과 수치 검증이 공개됐다.
핵심 요약
Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. Tan은 2026년 개인 생산성이 2013년 대비 논리적 코드 변경 기준 약 810배에 달했다고 밝혔다. 같은 사람이 같은 방식이 아닌 다른 도구를 사용한 결과다. gstack의 핵심 흐름은 사고 → 계획 → 구축 → 검토 → 테스트 → 배포 → 회고의 스프린트 구조다. /office-hours로 제품 재검토, /plan-ceo-review로 전략 도전, /plan-eng-review로 아키텍처 확정, /design-review로 AI 슬롭 감지, /review로 버그 찾기, /qa로 브라우저 테스트, /ship으로 배포 자동화를 수행한다. 전체 요약 10문장 읽기 → 094 03:11 ▲ 23 · 댓글 1 텍스트를 선택적으로 압축하는 FocusVTC, 긴 문맥 처리 속도 2.79배 향상 대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. AI · 머신러닝 · FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution
Key Point 긴 문맥을 처리하는 LLM 서비스에서 입력 토큰 수를 2.9배 줄이면서도 성능을 높이고 추론 속도를 2.79배 가속하는 방법이 제시되었으므로, 비용과 속도가 중요한 실제 배포 환경에서 직접 적용할 가치가 있다.
핵심 요약
대규모 언어모델의 장문맥 처리는 계산과 메모리 비용이 큰데, 시각 텍스트 압축(VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄인다. 기존 방식은 해상도를 고정하므로 저DPI는 토큰을 절약하지만 가독성을 잃고, 고DPI는 불필요한 내용에 토큰을 낭비하는 문제가 있다. FocusVTC는 적응형 해상도로 이 트레이드오프를 깨뜨렸고, 압축된 저DPI 전역 뷰와 선택적 영역 강화를 결합한다. 전체 요약 9문장 읽기 → 095 00:11 ▲ 27 · 댓글 2 모델이 자기 맥락을 관리하는 CLM 제안 언어 모델이 자신의 맥락을 파일처럼 다루며 자유롭게 업데이트하도록 하는 Context Language Models(CLMs)를 제안했다. AI · 머신러닝 · Context Language Models
Key Point LLM의 장문맥 처리 방식을 근본적으로 바꾸는 접근법으로, 맥락 관리 오버헤드를 줄이면서 멀티에이전트 시스템 구현도 용이하게 한다.
핵심 요약
언어 모델이 자신의 맥락을 파일처럼 다루며 자유롭게 업데이트하도록 하는 Context Language Models(CLMs)를 제안했다. CLM은 맥락에서 유지할 정보를 학습하고, 여러 에이전트의 맥락이 파일로 공존하는 멀티에이전트 시스템으로 자연스럽게 확장된다. 기존 모델로 제로샷 구축한 CLM은 여러 벤치마크에서 기존 최고 성능 대비 우수한 결과를 냈다: BrowseComp-Plus에서 11.4% 높은 정확도에 21.5% 적은 연산량, 12시간 EdgeBench에서 5% 높은 점수에 59% 적은 연산량. 전체 요약 7문장 읽기 → 096 21:11 당일 +311 AI 에이전트 자동 감사 도구 iFixAi 공개 기존 평가 도구는 토큰 효율성, 지연시간, 프롬프트 인젝션 같은 기술 능력만 검증하지만, iFixAi는 AI 에이전트가 비즈니스 KPI와 조직 목표를 제대로 수행하는지 120초 안에 판정한다. AI · 머신러닝 · ifixai-ai/iFixAi · Python
Key Point AI 에이전트가 실제로 의도대로 작동하는지 검증해야 한다는 산업의 공통 과제를 해결하는 오픈소스 감사 도구이며, 기존 기술 평가와 달리 비즈니스 의도 충족 여부를 체계적으로 검사한다.
핵심 요약
기존 평가 도구는 토큰 효율성, 지연시간, 프롬프트 인젝션 같은 기술 능력만 검증하지만, iFixAi는 AI 에이전트가 비즈니스 KPI와 조직 목표를 제대로 수행하는지 120초 안에 판정한다. CLI 가이드 마법사, CLI 명시적 플래그, Claude Code/Codex 플러그인, 모든 에이전트용 스킬 등 4가지 방식으로 실행 가능하며, 각 방식은 동일한 진단 엔진을 기반으로 한다. 32개 검사를 5가지 핵심 지표(조작, 위조, 기만, 예측 불가, 불투명성)에 걸쳐 수행하고 A~F 등급으로 결과를 제시한다(A ≥ 0.90, B ≥ 0.80, C ≥ 0.70, D ≥ 0.60, F < 0.60). 전체 요약 12문장 읽기 → 097 21:11 ▲ 118 · 댓글 40 1+1 계산하다가 함수형 프로그래밍 언어를 만들었다 데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 오픈소스 · 도구 · Needed 1+1, built a functional programming language
Key Point 간단한 산술 과제에서 출발해 메모리 할당, 가비지 컬렉션, 클로저, 함수형 언어까지 스스로 구현해가는 과정에서 핵심 개념들을 실제로 이해하는 방법을 보여준다.
핵심 요약
데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 초기에는 Add, Sub, Mul, Div 등 연산을 모두 다른 경우로 표현했지만, 모두 두 식을 받아 하나를 반환하므로 일반화된 Func 노드로 단순화했다. 변수를 추가하려면 해시 테이블이 필요했는데, C에 내장 해시 테이블이 없어서 직접 구현했다. 전체 요약 12문장 읽기 → 098 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 099 03:11 ▲ 10 · 댓글 3 강화학습으로 LLM 정책 증류 효율성 높이기 논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. AI · 머신러닝 · An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
Key Point LLM 정책 증류의 표본 효율성을 강화학습 이론으로 획기적으로 개선한 방법론으로, 수학 추론 등 복잡한 작업에서 필요한 롤아웃을 대폭 줄일 수 있다.
핵심 요약
논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. 이를 바탕으로 최소제곱 정책 증류(LSPD) 프레임워크를 제안했으며, 값 기반 RL의 낙관적 탐색과 오프정책 데이터 재사용을 결합했다. LSPD는 탐색 중 정책 다양성을 유지하면서도 이전에 수집한 궤적을 반복 학습해 롤아웃 효율성을 개선한다. 전체 요약 6문장 읽기 → 100 00:11 ▲ 13 · 댓글 3 동작 중심 영상 학습, 시간축 분리로 효율성 확보 영상 자가학습에서 아키텍처와 목적함수, 데이터, 학습 일정 등 여러 요소가 동시에 변해 동작 우선 표현 학습의 효과를 명확히 파악하기 어려운 점을 지적한다. AI · 머신러닝 · TT-VidT: Decoupling the Temporal Axis for Efficient Motion-Centric Video Pretraining
Key Point 시간과 공간을 분리해 동작 학습을 효율화하는 새로운 방식이 기존 방법보다 훨씬 빠르면서 동시에 여러 벤치마크에서 큰 폭의 성능 향상을 달성했기 때문이다.
핵심 요약
영상 자가학습에서 아키텍처와 목적함수, 데이터, 학습 일정 등 여러 요소가 동시에 변해 동작 우선 표현 학습의 효과를 명확히 파악하기 어려운 점을 지적한다. 이를 해결하기 위해 약 170M~190M 인코더 규모로 24가지 아키텍처-목적함수 조합을 통제된 조건에서 비교했다. TT-VidT는 DINOv3으로 초기화한 ViT-B/16 공간 경로와 컴팩트 Temporal Transfer Layer를 조합하고, Diff Compression 목적함수로 첫 프레임 외형 정보와 프레임별 동작 토큰으로부터 타겟 프레임을 재구성하도록 학습한다. 전체 요약 7문장 읽기 →