001 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 002 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 003 00:11 ▲ 128 · 댓글 33 형제 프린터, 텔넷으로 디버그 접근 발견 형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 하드웨어 · 시스템 · Getting debug access on a Brother printer over Telnet
Key Point 형제 프린터의 디버그 콘솔이 텔넷으로 간단하게 접근 가능하다는 것은 단순한 설정 명령어만으로 시스템의 깊숙한 부분에 접근할 수 있다는 뜻이므로, 프린터 보안과 개인정보 보호를 우려하는 사용자와 기업이 알아야 할 사항이다.
핵심 요약
형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 펌웨어는 32비트 ARM 소프트웨어로 작성되었으며, 데이터라이트 Reliance Nitro 3.0.6 파일시스템, FlashFX Tera 3.1 플래시 관리, Lua 5.2.3 스크립팅, OpenSSL, libpng 등을 포함하고 있다. 프린터는 800MHz 메인 프로세서, 133MHz 서브프로세서, 512MB 메모리를 탑재하고 있으며, 커널과 압축된 애플리케이션 코드, 웹/UI 자산이 별도 섹션으로 구성되어 있다. 전체 요약 8문장 읽기 → 004 03:11 ▲ 16 · 댓글 4 Gemma 4 임베딩을 극도로 압축하는 OPTIC 기법 공개 Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. AI · 머신러닝 · Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
Key Point 대규모 언어 모델의 임베딩 매개변수가 점차 커지는 추세에서, 성능 손실을 최소화하면서 극도의 압축을 달성할 수 있는 새로운 방법을 제시한다.
핵심 요약
Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. OPTIC은 토큰마다 하나의 양자화된 코드를 저장하고, 각 층에서 층별 아핀 디코더로 디코딩하는 방식을 사용한다. 코드와 디코더는 저장된 벡터가 아닌 PLE 출력 경로에 맞춰 학습된다. 전체 요약 7문장 읽기 → 005 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 006 03:11 ▲ 150 · 댓글 53 Ghostty 1.4.0 출시, Kitty 그래픽 완전 지원·성능 2배 개선 터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 인프라 · 데브옵스 · Ghostty 1.4.0
Key Point 새 터미널의 메모리 사용량이 8배 감소했고 대용량 파일 출력이 2.7배 빨라지는 등 실질적 성능 향상이 이뤄졌으며, Kitty 그래픽 완전 지원으로 플랫폼 간 호환성이 크게 개선됐다.
핵심 요약
터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 마지막 남은 Kitty 그래픽 기능인 애니메이션과 상대 위치 지정을 완성해 Kitty 외 첫 번째로 명세 100% 구현을 달성했으며, 이미지 전송이 16배 빨라졌다. 스크롤백 압축을 도입해 물리 메모리 사용량을 70~90% 감소시켰고, 기본 스크롤백 제한을 10MB에서 50MB로 상향했다. 전체 요약 13문장 읽기 → 007 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 008 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 009 21:11 당일 +376 메신저 플랫폼 연동하는 오픈소스 AI 에이전트 플랫폼 AstrBot AstrBot은 QQ, 위챗, 텔레그램, 슬랙 등 주요 메신저 플랫폼과 연동되는 오픈소스 AI 에이전트 챗봇 플랫폼이다. AI · 머신러닝 · AstrBotDevs/AstrBot · Python
Key Point 메신저 기반 AI 에이전트를 자체 운영하거나 통합하려는 개발자와 조직이 구축할 수 있는 완성도 높은 오픈소스 선택지가 생겼다.
핵심 요약
AstrBot은 QQ, 위챗, 텔레그램, 슬랙 등 주요 메신저 플랫폼과 연동되는 오픈소스 AI 에이전트 챗봇 플랫폼이다. OpenAI, Anthropic, Google Gemini, DeepSeek 등 다양한 LLM 서비스와 Dify, 코제 같은 LLMOps 플랫폼을 지원한다. 멀티모달 처리, 에이전트, MCP, 스킬, 나레지 베이스, 페르소나 설정, 자동 컨텍스트 압축 등의 기능을 제공한다. 전체 요약 10문장 읽기 → 010 00:11 ▲ 116 · 댓글 61 구글 Brotli 압축 라이브러리의 심각한 보안 결함, HTTP 생태계 전역 영향 구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. 보안 · Node2Shell evolves to HTTP2Shell, blast radius affects many HTTP libs and apps
Key Point HTTP 압축의 표준 라이브러리 취약점이 Node.js·Python·여러 언어 전역에 영향을 미치며, 자동 의존성 로드로 인해 직접 설치하지 않은 애플리케이션도 노출될 수 있어 긴급 대응이 필요하다.
핵심 요약
구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. CVSS 9.2(심각)로 평가되며, 2월 OpenAI에서 발견했으나 당시엔 보안 문제로 인식되지 않았다. Node.js 22.23.4·24.22.1·26.12.1, Python Brotli 1.2.1·brotlicffi 1.2.1.0, Bun 1.4.4, Envoy 1.40.0 등으로 패치 가능하다. 전체 요약 8문장 읽기 → 011 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 012 00:11 ▲ 13 · 댓글 1 AI 에이전트, 텍스트 해석 전 숨겨진 신호로 소통 확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. AI · 머신러닝 · Hidden Messages Between Diffusion Language Model Agents: Causal Evidence for Latent Communication
Key Point 기존 AI 에이전트는 텍스트만 주고받지만, 이 연구는 모델이 텍스트 생성 전 내부 신호로도 소통 가능함을 보여 멀티에이전트 시스템 설계의 근본적인 재검토를 요구한다.
핵심 요약
확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. 연구진은 한 에이전트의 확산 과정이 다른 에이전트에게 숨겨진 메시지를 전달할 수 있는지, 그리고 수신 에이전트가 실제로 그 메시지의 의미를 사용하는지 검증했다. 송신 에이전트는 노이징 제거 상태(denoising state)를 4개의 압축된 벡터로 변환하고, 수신 에이전트는 자신의 문맥과 생성 궤적을 유지하면서 이를 수용한다. 전체 요약 8문장 읽기 → 013 21:11 당일 +295 자미두수 오픈소스 배판 엔진 v4.0 공개 왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 오픈소스 · 도구 · Renhuai123/ziwei-doushu · TypeScript
Key Point 동양 전통 명리학의 알고리즘을 오픈소스로 공개한 드문 사례로, 자미두수 배판 엔진의 정확한 구현 방식과 거대 해석 데이터셋이 관심사에 있는 개발자나 명리 연구자에게 실질적 자료를 제공한다.
핵심 요약
왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 니하이샤(倪海厦) 《천기(天紀)》 체계 기반으로 완전한 배판 알고리즘, 사주 십간십이지 변화 시스템, 격국 지식베이스 1100+ 줄, 고문헌 원문 데이터를 포함한다. 2026년 10월 15일 v4.0 해석 데이터셋을 발표했으며, 1950~2026년 공력 날짜 × 12시진 × 남녀 = 67만 4976장 명판 × 13개 분석 차원 = 877만 4688개 해석 문단을 담았다. 전체 요약 12문장 읽기 → 014 18:11 ▲ 19 · 댓글 3 테스트 시점 회귀로 토큰 압축 성능 대폭 개선 언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. AI · 머신러닝 · Rethinking Sequence Compression with Test-time Regression
Key Point 기존 풀링·투영 방식의 약점을 해결하면서 더 적은 토큰으로 더 나은 성능을 달성하는 새로운 압축 기법이 여러 과제에서 검증됐다.
핵심 요약
언어·멀티모달 모델의 토큰 압축은 효율성의 핵심 병목이지만 기존 풀링과 학습된 투영 방식의 성능이 떨어진다. 새로운 접근으로 입력 토큰을 회귀 문제로 본 후, 피팅된 계수를 압축 표현으로 삼는 TTR-Compressor를 제시한다. 회귀 문제는 역전파로 엔드투엔드 학습하되, 순전파 중에는 폐쇄형 식으로 계수를 효율적으로 계산한다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 016 18:11 ▲ 38 · 댓글 2 세밀한 시각 이해를 위해 생성 모델의 정보 활용 세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. AI · 머신러닝 · What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
Key Point 멀티모달 모델에서 생성 능력이 이해 성능까지 높일 수 있다는 새로운 접근법을 보여주며, 공간 관계 같은 세밀한 차이 구별이 중요한 시각 작업에서 실질적 개선을 입증했다.
핵심 요약
세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. 통합 멀티모달 모델(UMM)에서 생성 경로는 이해 경로를 보완하는 풍부한 시각 정보를 보존하지만, 기존 방식들은 생성 측 표현을 직접 활용하지 않았다. 연구팀은 생성 측 표현이 세밀한 의미 변화에 더 민감하고, 이해 측에서 놓치는 작업 관련 변화를 포착하며, 공간 구조에 올바르게 의존한다는 것을 발견했다. 전체 요약 6문장 읽기 → 017 12:11 ▲ 162 · 댓글 75 LLM으로 대규모 소프트웨어 형식 검증이 현실화되다 Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. AI · 머신러닝 · LLMs are making formal software verification feasible at a much larger scale
Key Point 형식 검증이 역사적으로 수십 년의 전문 인력을 요구했으나, LLM이 이 비용을 획기적으로 낮추면서 일반 소프트웨어 개발에도 적용 가능해졌고, 향후 소프트웨어 보안 수준을 크게 변화시킬 기술이기 때문이다.
핵심 요약
Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. 개발자의 퍼지 테스트(fuzz test)를 자동으로 형식 사양으로 변환해 증명했으며, 239개 엔트리포인트에서 64MB 이하 모든 입력에 대해 크래시가 없음을 증명했다. 총 약 1억 8천만 줄의 Rocq 증명을 작성했고, 전형적인 증명은 약 60만 줄의 코드로 18,000개 RISC-V 명령어에 대한 보안 보장을 제공한다. 전체 요약 13문장 읽기 → 018 06:11 당일 +296 DeepSeek Harness 상황 창 시각화 도구 dsh-context DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. AI · 머신러닝 · bowenliang123/dsh-context · TypeScript
Key Point 에이전트 기반 AI 시스템에서 방대한 컨텍스트 윈도우를 효과적으로 관리하고, 토큰 비용을 추적하며, 성능 저하의 원인을 파악할 수 있는 심화된 시각화 도구다.
핵심 요약
DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. Context Insights 페이지는 7일 토큰·비용 차트, 활동 히트맵, 세션별 컨텍스트 프로필을 한눈에 보여주고, 기간·날짜·그룹·검색으로 필터링 가능하며 클릭으로 해당 세션으로 바로 이동한다. Context 탭은 각 세션의 컨텍스트 통계·구성·추이·이벤트·파일 작업을 대시보드로 표시하고, 요청별 토큰 이동 경로, 각 단계의 단위 토큰 가격, 모델 제시 정확한 수치를 보여준다. 전체 요약 12문장 읽기 → 019 21:11 ▲ 28 · 댓글 2 반복되는 작업을 스스로 학습하게 하는 에이전트 훈련법 Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. AI · 머신러닝 · DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
Key Point 장시간 작업을 하는 AI 에이전트의 비효율을 근본적으로 줄일 수 있는 훈련 기법으로, 추가 라벨링 없이 에이전트 자신의 경험으로부터 학습하는 방식을 제시한다.
핵심 요약
Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. DeLoop는 이런 루프를 줄이기 위한 자기지도 학습 방법으로, 에이전트 자신의 실행 기록에서 감독 신호를 얻는다. 같은 작업 실행 내에서 반복된 액션을 부정 사례, 그 이후 처음 나오는 다른 액션을 긍정 사례로 삼아 직접 선호도 최적화로 학습한다. 전체 요약 6문장 읽기 → 020 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 021 03:11 ▲ 242 · 댓글 27 DuckDB 2.0 LTS 출시, 클라이언트-서버와 비동기 I/O 지원 DuckDB 2.0.0 LTS '시나몬 틸'을 발표했으며, 1.5 이후 약 20,000개 커밋으로 개발된 최대 규모 기능 릴리스다. 오픈소스 · 도구 · DuckDB 2.0.0 LTS “Cinnamon Teal”
Key Point 클라이언트-서버 지원, 비동기 I/O, AI 에이전트 모드는 DuckDB 사용 환경을 크게 확장하고, 트리거와 확장 저장소는 엔터프라이즈 채택 장벽을 낮춘다.
핵심 요약
DuckDB 2.0.0 LTS '시나몬 틸'을 발표했으며, 1.5 이후 약 20,000개 커밋으로 개발된 최대 규모 기능 릴리스다. Quack 프로토콜을 완성해 전통적인 클라이언트-서버 구조를 지원하고, 새로운 CONNECT 문으로 원격 데이터베이스에 한 번에 연결할 수 있다. 비동기 I/O를 도입해 Parquet과 CSV 파일 읽기 시 여러 요청을 병렬로 처리해 S3 같은 객체 스토리지에서의 쿼리 속도를 크게 향상시킨다. 전체 요약 13문장 읽기 → 022 00:11 ▲ 22 · 댓글 4 장시간 작업용 LLM 에이전트, 실행 상태를 메모리처럼 재사용 장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. AI · 머신러닝 · FlowState: Execution State as Memory for Long-Horizon LLM Agents
Key Point 장시간 작업에서 LLM 에이전트의 맥락 길이 문제를 해결하는 새 방식이 기존 방법 대비 성능과 효율성 모두에서 실질적 개선을 보여주기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. FlowState는 실행 상태를 메모리로 취급해 요청 간에 유지하고 재방문할 수 있으며, 의미론적으로 타입된 상태 노드·관계·도구 관찰 참조를 보존해 필요 시에만 접근하도록 분리한다. Incremental State Update(ISU)는 실행 루프 내에서 새 입력과 피드백에 따라 현재 상태를 유지하고, Progressive State Access(PSA)는 추론 중 필요에 따라 과거 상태와 근거를 점진적으로 공개한다. 전체 요약 5문장 읽기 → 023 00:11 ▲ 138 · 댓글 75 C#이 WebAssembly에서 Rust 꺾고 최소 용량 달성 NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 웹 · 프론트엔드 · C# now beats Rust on WASM size
Key Point WebAssembly 배포 시 C#이 Rust보다 더 작은 바이너리를 생성할 수 있으며, 기존 Blazor의 256배 크기 문제를 획기적으로 개선한다.
핵심 요약
NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 같은 작업(42 출력)을 기준으로 NetWasm은 47,895바이트, Rust 1.95.0 크기 최적화 프로필은 53,635바이트로, NetWasm이 10.7% 더 작고 Brotli-11 압축 후 19.5% 더 작다. 두 결과 모두 WASI Preview 2 Component 형태의 독립형 바이너리이며 각 도구의 표준 빌드 방식을 사용하며, NetWasm 수치는 정확한 가비지 컬렉터를 포함한다. 전체 요약 13문장 읽기 → 024 21:11 당일 +215 DeepSeek Harness를 휴대폰에서 제어하는 DSH Pocket 전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 오픈소스 · 도구 · shaobeichen/dsh-pocket · JavaScript
Key Point DeepSeek Harness 사용자가 외출 중에도 전자 기기의 agent 작업을 실시간으로 모니터링하고 제어할 수 있는 표준 솔루션이 등장했으므로, 개발자 생산성 도구 사용자라면 즉시 설치 가치가 있다.
핵심 요약
전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 로컬 네트워크 모드는 설정 페이지에서 바로 사용 가능하며, 장치 IP를 자동 감지하고 WSL 환경에서 Windows 물리 네트워크 카드 IP를 자동으로 선택한다. 공인망 접근은 cloudflared 터널을 통해 작동하며, Cloudflare Tunnel Token과 도메인명을 설정해 고정된 공인 주소를 사용할 수 있는 '명명된 터널' 옵션을 제공한다. 전체 요약 12문장 읽기 → 025 21:11 ▲ 100 · 댓글 58 네브래스카의 핫도그 대포, 30년간 2만 발을 쏘다 1996년 마크 루드는 필라델피아 필리즈에서 사용하던 핫도그 런처를 보고, 자신이 일하는 페어버리 미트의 제품 홍보에 활용할 수 있겠다는 생각을 했다. 기타 · 'Der Viener Schlinger': The meat cannon that launched 20k hot dogs
Key Point 네브래스카 대학의 30년 전통 핫도그 대포가 공학 개선과 안전 논쟁을 거쳐 2만 발을 발사한 미국 스포츠 문화의 특이한 사례를 보여준다.
핵심 요약
1996년 마크 루드는 필라델피아 필리즈에서 사용하던 핫도그 런처를 보고, 자신이 일하는 페어버리 미트의 제품 홍보에 활용할 수 있겠다는 생각을 했다. 1997년 네브래스카 허스커스 풋볼 홈경기에 '더 비너 슐링거'라는 이름으로 첫 선을 보인 이 장치는 CO2 탱크와 압축 가스 원리로 동작하며, 초기에는 시속 70마일 거리 150피트까지 핫도그를 발사할 수 있었다. 운영을 맡은 콘래드 굿은 전역 후 2015년까지 18시즌 동안 매 경기마다 25개씩 발사했고, 이후 팀 엘리커가 후임자로 들어섰다. 전체 요약 12문장 읽기 → 026 21:11 ▲ 378 · 댓글 408 1.5°C 목표는 불가능...2°C 억제 후 역전 추진 UN 환경계획(UNEP)의 2026 배출격차보고서는 파리협정의 1.5°C 목표가 이제 달성 불가능하며, 1.5°C 초과는 피할 수 없다고 선언했다. 기타 · The 1.5°C goal of the Paris Agreement is no longer viable
Key Point 기후 목표의 현실적 실패를 인정하고 대안 전략으로 전환하는 만큼, 앞으로의 감축 목표와 필요한 기술·정책 변화를 파악하는 것이 중요하다.
핵심 요약
UN 환경계획(UNEP)의 2026 배출격차보고서는 파리협정의 1.5°C 목표가 이제 달성 불가능하며, 1.5°C 초과는 피할 수 없다고 선언했다. 새로운 전략은 지구 온난화를 2°C 이하로 제한한 뒤 21세기 말까지 1.5°C로 되돌리는 것이다. 2035년까지 5~8% 감축이라는 현재 정부 공약(NDC)은 필요한 18% 감축에 한참 못 미치며, 2040년까지는 69% 감축이 필요하다. 전체 요약 8문장 읽기 → 027 18:11 ▲ 25 · 댓글 2 LLM 활용해 3D 부품 조립 성능 대폭 향상 3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. AI · 머신러닝 · LLM2R: From Large Language Models to 3D Reassemblers
Key Point 대규모 부품을 가진 3D 조립 작업에서 기존 방식의 확장성 문제를 LLM 기반 접근으로 근본적으로 해결하고, 복잡한 기하학적 추론을 단일 forward pass로 처리할 수 있는 새로운 가능성을 제시한다.
핵심 요약
3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. 기존 방식은 부품 쌍의 관계에 의존하거나 반복 생성-검증을 사용해 많은 부품을 가진 물체에서 확장성이 떨어진다. LLM2R은 부품 조립을 sequence modeling 문제로 재정의하며 사전학습된 decoder-only LLM을 활용한다. 전체 요약 10문장 읽기 → 028 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 029 12:11 ▲ 227 · 댓글 3 멀티모달 GUI 에이전트의 주의력 집중 방식 FocusGUI 스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. AI · 머신러닝 · Focused Omni-Modal GUI Agents
Key Point 멀티모달 정보를 처리하는 GUI 자동화 에이전트가 불필요한 정보로 인한 오류를 줄이고 성능을 대폭 향상시키는 새로운 방식을 제시하고 있다.
핵심 요약
스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. 각 단계마다 실제로 필요한 정보는 다르므로, 단계별로 적응적이고 행동 충분하며 비방해적인 '집중된 인식'을 요구한다. FocusGUI는 경량 어댑터로서 현재 의사 결정에 필요한 멀티모달 채널을 동적으로 우선순위화하고, 가장 관련성 높은 정보를 압축된 잠재 표현으로 변환한다. 전체 요약 7문장 읽기 → 030 03:11 ▲ 119 · 댓글 81 NixOS가 자유로움을 주다—9줄로 FreshRSS 배포 저자는 FreshRSS(RSS 피드 애그리게이터)를 NixOS 서버에 9줄의 Nix 코드로 배포했다. 인프라 · 데브옵스 · NixOS is making me less afraid
Key Point NixOS의 선언적 설정 방식이 자가 호스팅 서비스 배포 및 유지의 복잡성을 획기적으로 낮추는 방법을 보여준다.
핵심 요약
저자는 FreshRSS(RSS 피드 애그리게이터)를 NixOS 서버에 9줄의 Nix 코드로 배포했다. 기존에는 RSS 피드를 스마트폰에만 로컬로 저장했는데, 화면이 작고 읽음/안 읽음 상태가 단말 전환 시 손실되는 문제가 있었다. 서버 기반 피드 애그리게이터를 원했으나 별도 프로젝트 유지 부담이 커서 미루고 있었다. 전체 요약 9문장 읽기 → 031 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 032 09:11 ▲ 156 · 댓글 69 RTX Spark 노트북에 Arch Linux 깔아 ARM 성능 검증했다 마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. 하드웨어 · 시스템 · Putting Linux on my RTX Spark laptop because I don't have a Microsoft account
Key Point Windows 의존성 없이 ARM 노트북의 전체 성능(CPU·메모리·GPU 추론)을 Linux에서 동일하게 재현할 수 있음을 구체적 수치로 입증해, 폐쇄형 OS에 갇히지 않고 오픈 모델을 로컬에서 실행하려는 개발자에게 실질적 대안을 제시한다.
핵심 요약
마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. Arch Linux 패키지 유지보수자인 저자가 NVIDIA 커널 작업, ACPI 오버라이드, 펌웨어 추출을 통해 부팅 가능한 설정을 구성했으며, 키보드·오디오·디스플레이(3840×2400, 120Hz) 지원을 추가했다. CPU 성능 테스트에서 Linux 7-Zip 26.04는 Windows와 단일 스레드에서 거의 동등(±1%)하고, 20스레드에서는 압축 5%, 압축 해제 2.7% 더 빠른 결과를 기록했다. 전체 요약 8문장 읽기 → 033 18:11 ▲ 27 · 댓글 2 논문을 포스터로 변환하는 AI 벤치마크 RAP 공개 논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. AI · 머신러닝 · RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
Key Point 시각적 코딩 벤치마크의 공백을 채우고, 객관적 평가와 인간 설계 재활용을 동시에 가능하게 하는 대규모 구조화된 데이터셋이 공개되었다.
핵심 요약
논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. RAP는 2022~2026년 머신러닝 학회 25K개 이상의 논문-포스터 쌍을 수집하고, 3단계 콘텐츠 분류체계로 주석했으며, 150개 테스트 논문 벤치마크를 별도로 포함한다. 기존 벤치마크와 달리 완전 자동화된 역렌더링 파이프라인으로 각 포스터를 재작성 가능한 HTML/CSS 마크업으로 변환하여, 논문-포스터-마크업 삼중쌍으로 검증할 수 있다. 전체 요약 8문장 읽기 → 034 12:11 ▲ 101 · 댓글 3 장기 작업 AI, 히스토리 대신 객체로 문맥 정리 장기 작업을 수행하는 AI 에이전트는 누적된 진전을 기록하는 긴 상호작용 히스토리를 반복해서 처리해야 한다는 문제가 있다. AI · 머신러닝 · Pack Light, CarryOn: Building Object-Oriented Context for Long-Horizon Agents
Key Point 컨텍스트 윈도우 제약이 있는 LLM 기반 에이전트에서 긴 작업 수행 시 토큰 사용량을 절반 이상 줄이면서 오히려 성능을 높이는 새로운 접근법이다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 누적된 진전을 기록하는 긴 상호작용 히스토리를 반복해서 처리해야 한다는 문제가 있다. CarryOn은 히스토리 대신 재사용 가능한 작업 객체를 중심으로 문맥을 조직하는 객체 지향 문맥 런타임이다. 기존 방식의 압축된 히스토리나 재구성된 진전 기록 대신, 재사용 가능한 작업 객체, 보완 실행 문맥, 최근 상호작용 로그로 문맥을 구성한다. 전체 요약 5문장 읽기 → 035 09:11 ▲ 198 · 댓글 23 Mermaid 다이어그램을 CSS로 꾸미는 가벼운 SVG 렌더러 공개 Pele는 Mermaid 다이어그램을 SVG로 렌더링하는 가벼운 오픈소스 라이브러리다. 오픈소스 · 도구 · Pele – Mermaid diagrams as themeable SVG
Key Point Mermaid의 성능 문제(느린 렌더링, 큰 번들)를 해결하면서도 CSS 기반의 쉬운 커스터마이징을 제공하는 경량 대안이 필요한 개발자들에게 선택지를 제공한다.
핵심 요약
Pele는 Mermaid 다이어그램을 SVG로 렌더링하는 가벼운 오픈소스 라이브러리다. Mermaid 문법으로 작성한 다이어그램을 Pele에 전달하면 SVG 형태로 변환된다. CSS 변수를 이용해 배경색, 글자색, 선 색상 등을 자유롭게 설정할 수 있으며, 다시 렌더링하지 않고도 색상 변경이 적용된다. 전체 요약 7문장 읽기 → 036 21:11 당일 +148 Rust 기반 에이전트 워크스페이스 OpenBitFun 1.0 공개 Rust로 작성한 고성능 에이전트 런타임과 데스크톱 앱을 결합한 OpenBitFun이 1.0 버전을 출시했다. AI · 머신러닝 · GCWing/OpenBitFun · Rust
Key Point Rust 기반의 고성능 에이전트 런타임으로 만든 멀티디바이스 워크스페이스가 나왔으며, 기존 AI 도구와 달리 소프트웨어 개발을 넘어 일반 업무를 지원하는 확장 가능한 플랫폼을 제시한다.
핵심 요약
Rust로 작성한 고성능 에이전트 런타임과 데스크톱 앱을 결합한 OpenBitFun이 1.0 버전을 출시했다. Minimal, Standard, Ultimate, Creative 네 가지 Agent Harness 모드로 빠른 협업부터 복잡한 작업까지 지원한다. 데스크톱, 모바일, 브라우저 간 원활한 연동으로 한 기기에서 시작한 작업을 다른 기기에서 이어갈 수 있다. 전체 요약 10문장 읽기 → 037 16:56 당일 +211 중국 초등학교 전과목 무료 학습 플랫폼 오픈소스 중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 오픈소스 · 도구 · wuwangzhang1216/ChinaTextbookStudyFree · Swift
Key Point 교육 자원 불균형 해소를 목표로 무료 학습 플랫폼을 완전 공개하는 사례로, 중국 교육 기술 생태와 게임화 학습 경험 설계를 한눈에 볼 수 있다.
핵심 요약
중국 소학 1~6학년 전과목 통합 학습 플랫폼 '聪聪学堂'을 MIT 라이선스로 오픈소스 공개했다. 수학(인교판), 국어(통편판), 영어(인교판 PEP), 과학(교과판) 44권 교재, 2,166개 단원, 6,545도 연습 문제를 수록했다. AI 생성 단원 소테스트, 지식 설명, 279편 원본 교과서 음성 낭독(TTS), 284편 레벨별 이야기 + 이해 문제를 제공한다. 전체 요약 10문장 읽기 → 038 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 039 06:11 ▲ 105 · 댓글 38 고급 조리대의 정체는 3000년 역사의 자기였다 비싼 인덕션 쿡탑 구매 후 조리 표면이 별도 구매 대상임을 알게 된 저자가, 그 표면 재료인 'Dekton'이 무엇인지 궁금해하며 출발한 글이다. 하드웨어 · 시스템 · What on Earth Is Dekton?
Key Point 자기는 3000년 전 기술이면서 동시에 최첨단 재료과학의 중심에 있으며, 조리대부터 인공 뼈까지 현대 생활 전반을 지탱하는 재료임을 보여준다.
핵심 요약
비싼 인덕션 쿡탑 구매 후 조리 표면이 별도 구매 대상임을 알게 된 저자가, 그 표면 재료인 'Dekton'이 무엇인지 궁금해하며 출발한 글이다. Dekton은 스페인 회사 Cosentino가 2013년 발명한 인공재료로 열·압력·긁힘·깨짐·얼룩에 강하지만, 본질적으로는 자기(porcelain)의 현대판이다. 자기는 3000년 전 중국에서 처음 만들어진 가장 오래된 고기술 중 하나인 동시에, 현대 재료과학의 최전선에 있는 신기술이다. 전체 요약 13문장 읽기 → 040 06:11 ▲ 147 · 댓글 117 JPEG XL vs AVIF, 웹 이미지 형식 비교 분석 모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 웹 · 프론트엔드 · JPEG XL vs. AVIF for web use-cases
Key Point 최근 모든 주요 브라우저에서 JPEG XL을 지원하기 시작하면서 개발자들이 AVIF와 JPEG XL 중 어떤 형식을 선택할지 판단해야 하는데, 이 글은 실제 벤치마크 데이터로 두 형식의 장단점을 명확히 제시한다.
핵심 요약
모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 손실 있는 사진의 경우 AVIF가 거의 항상 JPEG XL보다 작은 파일을 생성하는데, 기본 설정에서 JPEG XL은 AVIF보다 15~25% 크고 최대 노력 설정에서는 6~20% 크다. 스크린샷과 일러스트레이션에서는 AVIF가 JPEG XL보다 훨씬 우수하며, 기본 설정에서 30~90% 더 작은 파일을 생성한다. 전체 요약 12문장 읽기 → 041 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 042 03:11 ▲ 111 · 댓글 52 LLM이 스타크래프트 봇 작성 대회, GPT-6 Astra 압승 StarSkirmish는 LLM이 1시간 내에 스타크래프트 브루드워용 프로토스 봇을 C++로 작성하는 벤치마크로, 작성된 봇을 인간이 작성한 경쟁용 봇과 평가한다. AI · 머신러닝 · Show HN: Gemini 4 Argon plays StarCraft
Key Point LLM의 장시간 추론 능력과 실전 문제 해결 과정을 직접 관찰할 수 있는 벤치마크로, 기존 공개 평가와 다른 상관관계를 드러낸다.
핵심 요약
StarSkirmish는 LLM이 1시간 내에 스타크래프트 브루드워용 프로토스 봇을 C++로 작성하는 벤치마크로, 작성된 봇을 인간이 작성한 경쟁용 봇과 평가한다. v0.2는 OpenAI, Anthropic, Google, Meta의 최신 모델을 각 회사의 공식 CLI 환경에서 1시간 실행해 승률로 평가하며, GPT-6 Astra가 평균 승률 기준 최고점을 기록했다. GPT-6 Astra를 제외한 상위권 모델들(GPT-6.1 Sol, Gemini 4 Argon, Claude Opus 5.5, Claude Fable 5.1)은 37~39점으로 거의 동점이다. 전체 요약 13문장 읽기 → 043 21:11 당일 +338 자연어로 안드로이드 테스트 자동화를 가능하게 하는 구글 ARTEMIS 구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. AI · 머신러닝 · google/artemis · Python
Key Point AI 코딩 어시스턴트가 실제 안드로이드 기기를 자동으로 제어하고 테스트하는 방식이 크게 바뀔 수 있기 때문이다.
핵심 요약
구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. Antigravity, Codex, Claude Code 등 AI 코딩 어시스턴트와 seamless하게 통합되며, AndroidWorld 벤치마크에서 99% 이상의 성공률을 달성한다. 접근성 계층과 OCR, 시각 모델을 결합하여 캐시, Compose, Flutter 인터페이스 같은 커스텀 UI도 정확히 찾는다. 전체 요약 12문장 읽기 → 044 15:11 ▲ 54 · 댓글 2 여러 세션 걸친 강화학습 에이전트 최적화 방법 제안 기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. AI · 머신러닝 · Mosaic: Multi-Session Agentic Reinforcement Learning
Key Point LLM 에이전트가 실제로 여러 번의 상호작용 세션으로 나뉠 때 학습 방식을 바꿔야 하는 실질적 문제를 해결하는 방법을 제시했다.
핵심 요약
기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. 다중세션 에이전트 강화학습(Multi-Session Agentic RL) 설정을 제안해 임의 개수의 세션을 하나의 궤적 내에서 지원한다. 기존 방식은 궤적 수준 이점을 모든 세션에 일괄 분배하지만, 각 세션의 기여도를 구분하지 못하고 세션 할당을 지도하지 못한다. 전체 요약 6문장 읽기 → 045 15:11 ▲ 52 · 댓글 2 전자상거래 상품 메인 이미지를 자동 생성하는 AI 프레임워크 공개 알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. AI · 머신러닝 · CommerceGen-Studio: An End-to-End Framework for Commercial-Grade Main-Image Generation
Key Point 전자상거래 플랫폼의 핵심인 상품 이미지를 수초 만에 대규모로 자동 생성하는 상용 AI 시스템의 구조와 한계가 명확히 공개됨으로써, 실제 프로덕션 환경에서 생성형 AI를 어떻게 설계하고 최적화하는지를 이해할 수 있다.
핵심 요약
알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. 세 단계 파이프라인으로 구성된다: (1) PERL-Agent가 상품 메타데이터를 VLM과 LLM이 반복적으로 평가하며 판매 포인트 텍스트로 압축, (2) Layout Thinker Optimization이 생성된 이미지와 캡션 품질을 최적화, (3) SKU-DiT가 배경 없는 상품 이미지, 상표 이미지, 구조화된 레이아웃을 조건으로 최종 이미지 생성. SKU-DiT는 Reinforce-Distill-Reinforce 점진적 훈련 기법으로 학습되어 상품 피델리티, 상표 무결성, 글자 수준의 정확도를 동시에 유지한다. 전체 요약 7문장 읽기 → 046 15:11 ▲ 40 · 댓글 4 스트리밍 영상을 사람처럼 이해하는 AI 시스템 DeltaStreamer 스트리밍 영상 이해를 위해 인간의 관찰·기억·조사 방식에서 영감을 얻은 에이전트 프레임워크 DeltaStreamer를 제안한다. AI · 머신러닝 · DeltaStreamer: Towards Human-Like Agentic Streaming Video Understanding
Key Point 스트리밍 영상에서 미래 질문에 대비해 필요한 증거를 체계적으로 보존하고 선택적으로 복구하는 새로운 접근법이 실제 성능 개선으로 입증되었다.
핵심 요약
스트리밍 영상 이해를 위해 인간의 관찰·기억·조사 방식에서 영감을 얻은 에이전트 프레임워크 DeltaStreamer를 제안한다. 스트리밍 영상 이해의 핵심 문제는 미래 쿼리가 어떤 정보를 요구할지 알기 전에 충분한 증거를 보존해야 한다는 것이다. 기존 방식들은 영상 히스토리 압축 과정에서 이벤트 전환을 불분명하게 만들고 관련 세부 정보를 생략하며, 손실된 시각적 증거를 복구할 수 없다. 전체 요약 8문장 읽기 → 048 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 049 21:11 당일 +100 만화 자동 번역 도구 Koharu, Rust로 완전 로컬 실행 Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 오픈소스 · 도구 · koharu-rs/koharu · Rust
Key Point 완전 로컬 실행 만화 번역 자동화 도구로, 프라이버시 우려 없이 복잡한 시각 처리와 자연어 처리를 통합하는 오픈소스 솔루션을 원하는 사용자에게 선택지가 생겼다.
핵심 요약
Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 객체 검출, OCR, 인페인팅, LLM을 조합해 만화 번역 프로세스를 자동화하며, 래스터 이미지·압축 아카이브·PDF를 모두 지원한다. 텍스트 영역과 말풍선, 정리 영역을 감지·분할하고 대사·캡션·일반 텍스트에 대한 다중모드 OCR을 수행한다. 전체 요약 10문장 읽기 → 050 12:11 ▲ 64 · 댓글 1 루프형 MoE 모델, 비대칭 연산 배분으로 효율 19% 개선 루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. AI · 머신러닝 · LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
Key Point 파라미터 효율성을 중시하는 개발팀이 더 작은 모델로 더 나은 성능을 달성할 수 있는 구조적 개선 방안을 얻을 수 있기 때문입니다.
핵심 요약
루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. 연구진이 공유 블록을 두 번 적용하는 모델에서 각 방문별로 별도의 잔차 계수를 학습한 결과, 첫 번째 방문에서 더 작은 스케일이 나타났다. 첫 번째 방문의 스케일을 줄이면 성능이 유지되거나 개선되지만, 두 번째 방문을 같은 정도로 줄이면 성능이 떨어진다. 전체 요약 8문장 읽기 → 051 00:11 ▲ 13 · 댓글 2 긴 영상도 고정 메모리로 처리하는 프레임 압축 기법 비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. AI · 머신러닝 · Elephant in the Fridge: Constant-Memory Frame Packing for Long Video Understanding
Key Point 장영상 이해가 VLM의 메모리 병목이 되는 시점에 학습 없이 적용 가능한 고정 메모리 솔루션이 나왔고, 기존 모델 대비 10% 이상 성능 향상을 보였다.
핵심 요약
비전-언어 모델(VLM)에서 긴 영상을 처리할 때 프레임당 하나의 토큰을 사용하면 메모리가 영상 길이에 비례해 증가하는 근본적 문제가 발생한다. 기존의 토큰 감소나 핵심 프레임 선택 방식도 O(n) 증가 추세를 해결하지 못한다. FramePack-U는 학습 없이 임의로 긴 영상을 고정 크기의 시각 표현으로 압축하는 훈련-자유 프레임 패킹 프레임워크다. 전체 요약 9문장 읽기 → 052 00:11 ▲ 45 · 댓글 2 극한 압축으로 확산 모델 가속화하는 APEX 등장 확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. AI · 머신러닝 · APEX: Asynchronous Prefix Denoising for Extreme Compression
Key Point 확산 모델의 토큰 수를 획기적으로 줄이면서도 생성 품질을 유지할 수 있는 방법으로, 추론 속도와 비용에 민감한 생성형 AI 서비스 개발에 직접 영향을 미친다.
핵심 요약
확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. APEX는 계층적 레이턴시 공간과 채널 그룹별 비동기 디노이징을 결합한 새로운 방식이다. 오토인코더가 채널 프리픽스를 구조에서 세부사항 순서로 정렬하고, 공유된 단일 디노이저가 토큰을 추가하지 않고 엇갈린 시간에 생성한다. 전체 요약 6문장 읽기 → 053 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 054 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 055 18:11 ▲ 110 · 댓글 17 소리의 과학을 인터랙티브하게 배우는 가이드 소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 기타 · Sound – Bartosz Ciechanowski (2022)
Key Point 소리가 어떻게 생성·전파되고 인지되는지 물리적 원리를 인터랙티브 시뮬레이션으로 직관적으로 이해할 수 있어, 음향 공학이나 오디오 처리를 배우는 개발자의 기초 학습 자료가 될 수 있다.
핵심 요약
소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 진동하는 물체가 공기를 압축·팽창시키면 압력 파동이 생성되고, 이것이 귀에 도달할 때 소리로 인지된다. 진동판의 움직임 크기(진폭)는 음량을, 진동 빈도(주파수)는 음높이를 결정한다. 전체 요약 8문장 읽기 → 056 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
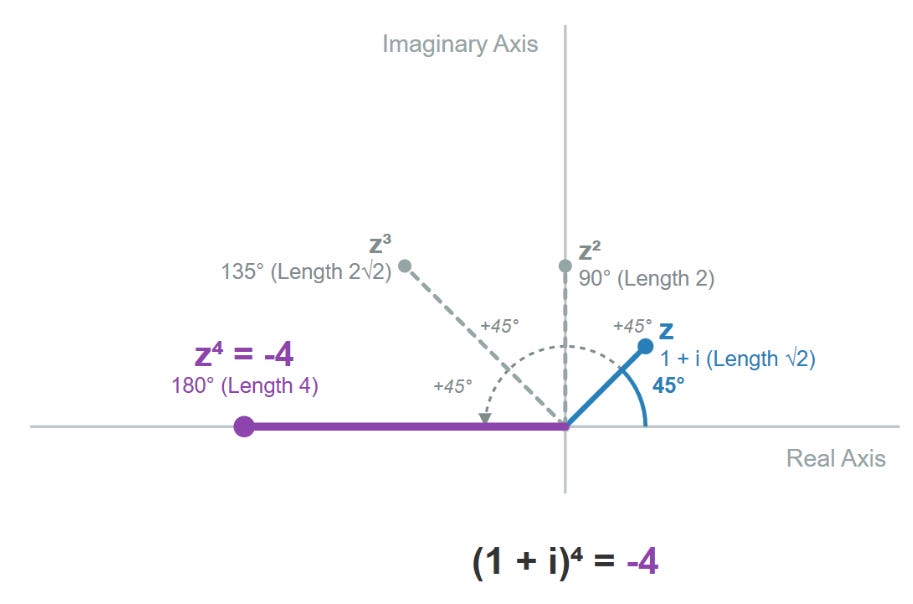
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 057 06:11 ▲ 103 · 댓글 30 키보드로 연주하는 완전한 가상 기타, Guitoro Guitoro는 브라우저에서 무료로 즐길 수 있는 가상 기타 연주 애플리케이션으로, 컴퓨터 키보드, 터치스크린, 손가락 스와이프 등 다양한 방식으로 연주할 수 있다. 기타 · Show HN: Guitoro, a virtual guitar you strum with your keyboard
Key Point 실제 악기 녹음과 정확한 손 움직임 표시를 통해 비디오 강의보다 뛰어난 학습 효과를 제공하면서 도 다운로드나 회원가입 없이 모든 기능을 무료로 이용할 수 있다.
핵심 요약
Guitoro는 브라우저에서 무료로 즐길 수 있는 가상 기타 연주 애플리케이션으로, 컴퓨터 키보드, 터치스크린, 손가락 스와이프 등 다양한 방식으로 연주할 수 있다. 스틸 스트링 어쿠스틱, 클래식 기타, 일렉트릭, 4현 베이스 4가지 악기를 지원하며, 모든 음성은 실제 악기 녹음본을 사용한다. 왼손으로 코드를 잡고 오른손으로 스트럼하는 방식으로 실제 기타처럼 연주하며, 키보드 자판의 물리적 위치와 일치하게 설계되었다. 전체 요약 12문장 읽기 → 058 03:11 ▲ 103 · 댓글 71 Anthropic이 Git을 대체할 소스 제어 시스템 'Scion' 개발·공개 Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. 인프라 · 데브옵스 · Redesigning Source Control at Anthropic
Key Point 에이전트 기반 소프트웨어 개발이 기존 개발 인프라의 한계를 드러내는 현상을 보여주는 사례이며, 다른 조직도 수개월 내 유사한 병목을 마주할 가능성이 있어 Git 및 CI/CD 설계 방식을 재검토할 시점을 제시한다.
핵심 요약
Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. Git은 완전한 오프라인 저장소 설계로 기존에는 우수하지만, Anthropic의 모노레포는 메인 브랜치 히스토리만 100GB, 압축 복사본 25GB 이상이며 일일 2,500만 체크아웃으로 기존 방식(600PB/일 트래픽)이 불가능했다. Scion은 에이전트(AI)가 항상 온라인이라는 가정에서 출발해, 클라이언트가 완전한 저장소 복사본을 유지하지 않고 서버에서 필요한 데이터를 요청하는 클라이언트-서버 비대칭 구조를 채택했다. 전체 요약 12문장 읽기 → 059 06:11 ▲ 195 · 댓글 52 WiFi 7 라우터를 320Msps 소프트웨어 무선 수신기로 개조 Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. 하드웨어 · 시스템 · Turn a WiFi 7 Router into a 320Msps Software Defined Radio Receiver
Key Point WiFi 라우터의 고성능 라디오 칩셋을 역분석하여 MediaTek 독점 펌웨어 없이 완전 독립적인 소프트웨어 정의 라디오로 구현한 사례로, 임베디드 역분석·펌웨어 개발·고속 데이터 스트리밍의 기술적 성과를 보여준다.
핵심 요약
Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. Airoha AN7581 SoC가 데이터를 처리하며, Linux 호스트에서 실시간 스펙트럼과 폭포도를 브라우저로 표시하고 라디오 제어를 함께 제공한다. 전체 2.4GHz 대역을 320Msps로 실시간 캡처 가능하며 필터링 롤오프를 보정한 후 매초 100개 스펙트럼을 262,144포인트 FFT로 생성한다. 전체 요약 11문장 읽기 → 060 03:11 ▲ 102 · 댓글 46 Google 개발자 문서 사이트에서 발견한 9만 달러 RCE 취약점 Google 개발자 문서 사이트의 OAuth2 플로우를 조사하던 중 1,200바이트 규모의 Flask 세션 쿠키를 발견했고, 이는 기대보다 훨씬 컸다. 보안 · I Found a $90k Remote Code Execution Vulnerability in Google
Key Point Flask 세션 서명 키가 쿠키 페이로드에 평문으로 노출되고 pickle 역직렬화가 비즈니스 로직에 포함된 구조로, 여러 Google 서비스에 걸쳐 원격 코드 실행이 가능했던 심각한 취약점이다.
핵심 요약
Google 개발자 문서 사이트의 OAuth2 플로우를 조사하던 중 1,200바이트 규모의 Flask 세션 쿠키를 발견했고, 이는 기대보다 훨씬 컸다. 쿠키는 zlib 압축된 JSON으로 인코딩되었으며, 내용이 암호화되지 않아 pickle 직렬화된 OAuth2WebServerFlow 객체와 Google의 OAuth client_id, client_secret을 평문으로 담고 있었다. client_secret이 Flask의 쿠키 서명 키로도 사용되고 있었으며, hmac과 sha1을 이용해 재계산하면 서명이 바이트 단위로 일치했다. 전체 요약 9문장 읽기 → 061 21:12 당일 +176 장문 코딩 세션을 수개월 지속하는 컨텍스트 압축 플러그인 billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. AI · 머신러닝 · ranxianglei/billion-context · TypeScript
Key Point 각 토큰당 과금하는 API 환경에서 컨텍스트 윈도우를 초과하면 세션이 저하되거나 끝나는데, 이 도구로 며칠~수개월 단위 장문 세션을 하나의 윈도우로 계속 실행할 수 있다.
핵심 요약
billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. 모든 AI 코딩 에이전트 클라이언트와 모델 API 사이에 위치하면서 acp-kernel 압축으로 스트림을 재작성해 모델이 직접 언제 무엇을 압축할지 결정한다. 컨텍스트 관리 도구 4가지를 주입한다: compress(메시지 범위를 상세 요약으로 압축), decompress(필요 시 복원), search_context(압축된 요약과 가시 메시지 검색), acp_status(컨텍스트 사용량 및 압축 가능 범위 조회). 전체 요약 10문장 읽기 → 062 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 063 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 064 12:11 ▲ 33 · 댓글 2 확률 분포 일치로 보정 없이 확산 언어모델 양자화 확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. AI · 머신러닝 · SoloQ: Calibration-Free Quantization for Diffusion Language Models
Key Point 확산 기반 언어모델의 배포 효율성이 점점 중요해지는 상황에서, 보정 데이터 없이도 정확도를 유지하는 양자화 기법이 실무 적용 시간을 크게 단축할 수 있다.
핵심 요약
확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. 기존 양자화 방법들은 마스킹 상태와 노이징 단계마다 활성화 분포가 바뀌어 보정 데이터가 필수였다. SoloQ는 가중치와 활성화를 정규화된 회전 기저로 매핑해 예측 가능한 주변 분포를 만들고, 이를 통해 데이터 독립적 양자화를 실현한다. 전체 요약 8문장 읽기 → 065 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 066 15:11 ▲ 38 · 댓글 5 장문맥 에이전트의 이력 압축, 소프트 메모리 토큰으로 해결 장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. AI · 머신러닝 · REMORY: Learning Residual Memory for Context Compaction
Key Point LLM 기반 장시간 에이전트의 컨텍스트 제약을 해결하는 새로운 접근법으로, 입력 토큰을 극적으로 줄이면서 의사결정 품질을 유지하는 방법을 제시한다.
핵심 요약
장시간 작업하는 에이전트는 유한한 컨텍스트 윈도우 내에서 계속 작동하기 위해 이력을 압축해야 하는데, 텍스트 요약만으로는 모든 의사결정을 지원하기 어렵다. REMORY는 요약을 보완하는 제한된 길이의 소프트 메모리 토큰 시퀀스를 생성하는 신경 메모리 네트워크로, 전체 이력이 있을 때 LLM이 생성할 결과를 시뮬레이션하도록 학습된다. 이 토큰들은 요약을 기반으로 조건화되며 요약 뒤에 추가되어 시퀀스 차원의 잔차 연결 형태를 만든다. 전체 요약 6문장 읽기 → 067 12:11 ▲ 12 · 댓글 2 성장하는 신경망, 학습 데이터를 직접 저장했다 딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. AI · 머신러닝 · Retrieval-Centric Deep Learning in Growing Nonparametric Neural Networks
Key Point 매개변수 크기를 고정하지 않고 데이터를 직접 저장하는 방식이 기존 신경망 설계와 어떻게 다르며, 실제 성능상 이점이 있는지 확인할 수 있는 새로운 학습 패러다임입니다.
핵심 요약
딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. 기존 선형 어텐션(LA) 이론을 확장해 RBF와 소프트맥스 커널 같은 고급 커널을 사용할 경우 기울기 기반 최적화가 자명하지 않은 문제를 발견했다. 함수형 기울기(functional gradient) 기반 학습 규칙을 개발하여 커널화된 어텐션 계층의 원칙적인 최적화 방법을 제시했다. 전체 요약 5문장 읽기 → 068 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 069 09:11 ▲ 114 · 댓글 51 아이디어는 여전히 넘쳐난다, 겁쟁이들만 고갈됐다고 말한다 저자는 '아이디어가 점점 더 찾기 어려워진다'는 주장에 강하게 반박한다. 이 믿음은 선택적 편향으로, 과거 아이디어도 당시엔 뻔해 보였고 새 아이디어를 생각하는 것은 항상 어렵게 느껴진다. 기타 · Ideas aren't getting harder to find (2022)
Key Point 과학이 정말 아이디어 고갈의 위기에 있는지, 아니면 학계의 구조적 문제가 혁신을 막고 있는지 구분해야 할 시점.
핵심 요약
저자는 '아이디어가 점점 더 찾기 어려워진다'는 주장에 강하게 반박한다. 이 믿음은 선택적 편향으로, 과거 아이디어도 당시엔 뻔해 보였고 새 아이디어를 생각하는 것은 항상 어렵게 느껴진다. 역사를 보면 과학이 여러 번 '거의 끝나가고 있다'고 평가받았으나 틀렸다. 1890년대 물리학은 완성 단계라고 했고, 1873년 외과학도 한계에 달했다고 했으며, 1956년 인공지능 도미니언 프로젝트는 여름 한 철에 기본 문제를 풀 수 있다고 생각했다. 지식은 광산에서 채굴하는 것처럼 고갈되지 않는다. 새 발견은 추가 발견을 열어주고, 과거 발견은 압축·단순화되어 현재 과학자들이 더 빠르게 진전할 수 있다. 전체 요약 13문장 읽기 → 070 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 071 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 072 12:11 새 버전 Tauri 2.12.2 출시, 앱 재시작 및 메뉴 버그 수정 macOS에서 process::restart와 AppHandle::restart가 LaunchServices(open -n)를 통해 앱 번들을 재실행하도록 개선되어, 새 인스턴스가 기존 프로세스의 stdio와 프로세스 그룹을 상속받지 않아 종료된 터미널에서 출력할 때의 크래시 문제 해결(인자 전달은 유지). 웹 · 프론트엔드 · tauri-apps/tauri@tauri-v2.12.2
Key Point macOS에서 앱 재시작 시 발생하던 크래시와 메뉴 기능 버그가 수정되어 데스크톱 앱 개발자에게 영향을 미칩니다.
핵심 요약
macOS에서 process::restart와 AppHandle::restart가 LaunchServices(open -n)를 통해 앱 번들을 재실행하도록 개선되어, 새 인스턴스가 기존 프로세스의 stdio와 프로세스 그룹을 상속받지 않아 종료된 터미널에서 출력할 때의 크래시 문제 해결(인자 전달은 유지). once 이벤트 리스너가 제거되기 전에 여러 이벤트를 받을 때 발생하던 패닉 버그 수정. Menu.new()에서 MenuItemOptions의 action을 직접 지정할 수 있도록 메뉴 생성 방식 복구(Menu 팝업 시 콜백 함수 정상 작동). 전체 요약 5문장 읽기 → 073 12:11 ▲ 29 · 댓글 2 생성 시점의 활성화에 맞춘 LLM 가지치기로 디코딩 가속 LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. AI · 머신러닝 · SparseDecoding: Decoding-Aware Pruning for Accurate and Efficient LLM Inference
Key Point 디코딩 단계의 실제 토큰 생성 환경과 가지치기 과정의 불일치를 해결하면서 SpMV 연산에 최적화된 커널까지 제공해, LLM 추론 속도 개선에 직접적으로 적용 가능한 실무적 해법을 제시한다.
핵심 요약
LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. 기존 방법들은 자연 텍스트에서 계산한 Hessian으로 모델을 가지치기하지만, 실제 디코딩 중에는 모델이 자체 생성 토큰을 처리하면서 분포 차이(distribution shift)가 발생한다. 이로 인해 생성 시 활성화 분포가 가지치기 시 사용된 분포에서 벗어나 모델 성능이 저하되는 문제가 있다. 전체 요약 7문장 읽기 → 074 03:11 ▲ 10 · 댓글 2 텍스트-이미지 생성 모델에 에이전트 지식 직접 조각내기 텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. AI · 머신러닝 · Internalizing Agent Experience into Diffusion Model Weights via On-Policy Context Distillation
Key Point 이미지 생성 품질을 높이는 에이전트 능력을 모델 자체에 영구적으로 내재시켜 일반 사용자도 원본 쿼리만으로 개선된 이미지를 받을 수 있게 하는 새로운 접근 방식이다.
핵심 요약
텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. 논문은 Diffusion On-Policy Context Distillation(D-OPCD)를 제안하는데, 에이전트가 개선한 프롬프트를 특권 정보로 삼아 에이전트의 능력을 확산 모델 가중치로 직접 압축하는 방식이다. Auto Skill Evolver(ASE)라는 텍스트-이미지 에이전트를 사용해 D-OPCD를 실험한 결과, 원본 쿼리만으로 생성했을 때 평균 점수가 60.52에서 65.09로 상승했다(4개 벤치마크 기준). 전체 요약 5문장 읽기 → 075 18:30 ▲ 13 · 댓글 2 조 매개변수 모델도 3분 안에 동기화, NeMo-DCR 논문 발표 에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. AI · 머신러닝 · NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Key Point 조 개 매개변수 모델의 정책 리핏 시간을 87분에서 2~3분으로 단축하는 기술로, 대규모 에이전트형 강화학습의 실제 운영 가능성을 크게 높인다.
핵심 요약
에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. 매개변수 수정(refit) 시 BF16 학습에서 단계당 약 1%의 가중치만 변한다는 측정을 기반으로, NeMo-DCR은 변경값만 전송하면서 비트 단위로 정확히 일치하는 결과를 보장한다. 학습 샤드에서의 변경을 고정 아핀 매핑으로 체크포인트의 정규 좌표계로 투영하고, 잔여 변환으로 나머지를 처리하며, 수신 런타임의 기본 로더가 모든 변경을 저장소에 배치한다. 전체 요약 6문장 읽기 → 076 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 077 18:30 ▲ 16 · 댓글 2 모바일 기기에서 3D 가우시안 스플래팅 실시간 렌더링 가능하게 Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. AI · 머신러닝 · Mobile-4DGS: Unified Static-Dynamic Real-time Mobile Gaussian Splatting
Key Point 모바일 기기에서 고품질 3D/4D 렌더링이 가능해지면, 스마트폰 AR 애플리케이션과 엣지 컴퓨팅 기반 3D 콘텐츠 처리 방식이 크게 바뀔 수 있다.
핵심 요약
Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. Monte Carlo Specular Energy Aggregator를 도입해 고차 복사 잔차를 1차 구면 조화함수(SH)로 압축하고, Attribute-Conditioned SH Enhancement 모듈로 미리 계산한 오프셋을 적용한다. Multi-View Alpha-Based Densification and Pruning 전략으로 다중 시점 일관성을 유지하면서 중복 프리미티브를 제거한다. 전체 요약 7문장 읽기 → 078 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 079 18:30 ▲ 106 · 댓글 2 선택적 정밀도로 선형 어텐션 상태 압축하는 STEPQuant Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. AI · 머신러닝 · STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 080 18:30 ▲ 548 · 댓글 362 Chrome 155부터 JPEG XL 지원, Rust로 안전성 강화 Chrome 155부터 JPEG XL(.jxl) 이미지 포맷의 디코딩을 지원한다. 웹 · 프론트엔드 · Shipping JPEG XL in Chrome
Key Point 메모리 안전성과 성능을 모두 확보한 새 이미지 포맷이 Chrome에 정식 탑재됨으로써, 웹 개발자는 JPEG 대비 더 나은 압축률로 고화질 이미지를 제공할 수 있게 되었다.
핵심 요약
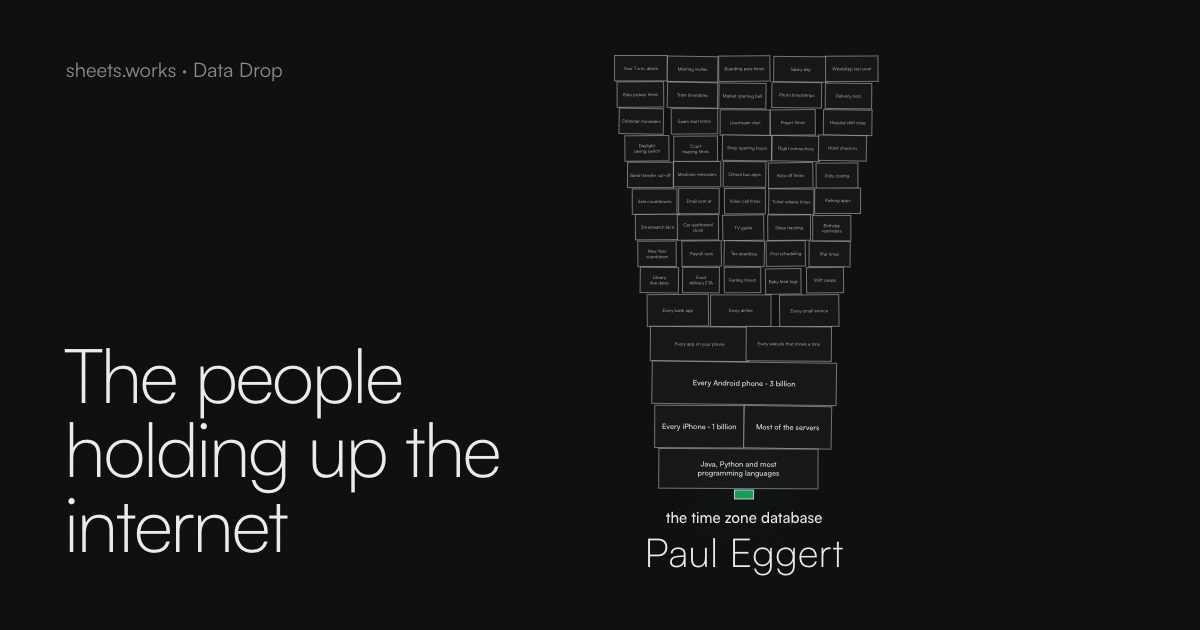
Chrome 155부터 JPEG XL(.jxl) 이미지 포맷의 디코딩을 지원한다. JPEG XL은 차세대 이미지 포맷으로 JPEG 대비 30~50% 더 나은 압축률, 무손실 압축, 내장 HDR 지원, 무손실 JPEG 변환 등을 제공한다. 고화질·무손실 압축이나 사진 이미지, 세밀한 점진적 디코딩이 필요한 경우에 유용하며, 개발자는 최적의 결과를 위해 AVIF와 JPEG XL을 모두 시도해볼 것을 권장한다. 전체 요약 10문장 읽기 → 081 18:30 ▲ 118 · 댓글 50 몇십 명이 인터넷 기반을 떠받치고 있다 안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 오픈소스 · 도구 · The people holding up the internet
Key Point 인터넷을 구성하는 핵심 소프트웨어 대부분이 1~2명의 무보수 개발자에 의존하고 있으며, 일부는 멘탈 헬스 문제나 자금 부족으로 위험에 처해 있다.
핵심 요약
안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 시간대 데이터 파일은 UCLA 교수 Paul Eggert가 2012년부터 운영하며 지난 1년간 251개 변경 중 218개를 혼자 담당했다. 리눅스 서버와 iPhone에 탑재된 압축 도구 xz는 핀란드의 Lasse Collin이 운영하다가, 2024년 악의적 기여자 Jia Tan이 몰래 백도어를 삽입한 사건이 발생했다. 전체 요약 14문장 읽기 → 082 18:30 ▲ 872 · 댓글 418 Anthropic, 저비용 소형 모델 Claude Haiku 5.5 공개 Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. AI · 머신러닝 · Claude Haiku 5.5
Key Point 소형 모델이 대폭 저렴해지면서 이전에는 비용상 불가능했던 요약, 분류, 에이전트 작업이 대규모로 가능해진다.
핵심 요약
Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. Haiku 5.5는 요약·데이터 압축·데이터베이스 쿼리·분류 등 반복적인 고용량 작업을 위해 설계되었으며, Opus 5.5 및 Sonnet 5.5와 함께 하위 에이전트로도 사용 가능하다. Haiku 4.5 대비 평균 75% 저렴하며, 특히 10만 토큰 이하 요청(전체 요청의 90%)에 대해 90% 저렴해졌다. 전체 요약 13문장 읽기 → 083 18:33 ▲ 14 · 댓글 2 LLM 강화학습의 메모리 병목을 저랭크 그래디언트로 풀다 강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. AI · 머신러닝 · LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches
Key Point LLM 강화학습 훈련의 메모리 효율을 45% 이상 개선해 더 큰 모델과 리소스 제약 환경에서의 RL 훈련을 실용적으로 만든다.
핵심 요약
강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. LoGRA는 유용한 학습 신호를 저랭크 그래디언트 스케치로 압축해 메모리 사용량을 줄이는 RL 후훈련 기법이다. 이 컴팩트한 표현은 모델 업데이트와 효율적인 정책 동기화 모두를 지원한다. 전체 요약 7문장 읽기 → 084 18:33 당일 +199 DeepSeek의 GPU GEMM 커널 라이브러리 오픈소스 공개 DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. AI · 머신러닝 · deepseek-ai/DeepGEMM · Cuda
Key Point LLM 추론·학습 성능을 좌우하는 GEMM 커널을 DeepSeek이 직접 최적화한 오픈소스 공개로, 고속 LLM 인프라 구축 시 활용할 수 있는 기반 도구가 확보된다.
핵심 요약
DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. CUTLASS와 CuTe의 개념을 참고하되 무거운 템플릿 의존성을 피하고, 런타임 JIT 컴파일(DeepJIT)로 설치 시 CUDA 컴파일을 요구하지 않는다. 각 행렬 크기에 따라 전문가 튜닝 라이브러리 수준 이상의 성능을 제공하며, H800에서 최대 1550 TFLOPS를 달성한다. 전체 요약 11문장 읽기 → 085 18:35 ▲ 19 · 댓글 2 다중 매체 검색 결과를 선택적으로 압축하는 CANOPY 멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. AI · 머신러닝 · CANOPY: Adaptive-Granularity Evidence Compression for Multimodal RAG
Key Point 멀티모달 검색에서 압축 과정의 세분화 수준을 동적으로 조절함으로써 토큰 사용을 줄이면서도 답변 정확도를 지킬 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
멀티모달 RAG는 텍스트, 표, 이미지, 비디오 등 다양한 매체를 검색하는데, 각 항목에서 얼마나 많은 맥락을 유지할지 결정하기 어려운 문제가 있다. 기존 압축 방식은 매체별로 다르게 동작하며, 이질적 항목 간에 적응형 세분화로 영역을 선택하는 공통 방식이 부족했다. CANOPY는 검색 결과를 계층 구조로 표현하고, 질문에 대해 학습된 인코더로 각 영역의 점수를 매긴 뒤, 부모 상대 정제(parent-relative refinement)로 다양한 세분화 수준의 여러 영역을 선택한다. 전체 요약 7문장 읽기 → 086 18:35 ▲ 11 · 댓글 2 긴 영상 이해하는 비전-언어 모델, 메모리 효율을 10%로 줄이다 비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. AI · 머신러닝 · KeyRec: Bounded Visual Memory for Streaming and Long-Video Understanding
Key Point 비전-언어 모델의 장시간 영상 처리 비용을 10%로 줄이면서 성능을 유지하는 방식으로, 실시간 스트리밍과 긴 영상 분석 작업의 실용성을 크게 높인다.
핵심 요약
비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. 기존의 훈련 없는 토큰 선택 방식은 정보성 있는 토큰만 남기지만, 사건의 일관된 증거를 잃고 최근 세부 관찰과 장기 히스토리를 구분하지 못한다. KeyRec은 제한된 시각 메모리를 구성하는 훈련 없는 프레임워크로, 최근 관찰은 시각 캐시에 세밀하게 보존하고 과거 증거는 구조화된 사건 은행으로 조직한다. 전체 요약 8문장 읽기 → 087 18:35 ▲ 11 · 댓글 2 에이전트 간 통신 75% 압축, 캐시 공유 방식 제안 다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. AI · 머신러닝 · Receiver-Conditioned Latent Communication gives 94% CacheBack
Key Point KV 캐시 직접 전송으로 다중 에이전트 시스템의 성능을 높이되, 메모리 증폭 문제를 receiver conditioning으로 대폭 해결할 수 있는 실용적 방법을 제시한다.
핵심 요약
다중 에이전트 시스템에서 에이전트 간 KV 캐시를 직접 전송하는 방식이 텍스트 통신보다 정확도와 지연시간이 우수하지만, 전체 캐시 크기가 각 에이전트 처리 컨텍스트와 에이전트 수에 따라 선형으로 증가해 GPU 메모리와 컨텍스트 윈도우를 초과하는 문제가 발생한다. Receiver-Conditioned Latent Communication이라는 아이디어는 수신 에이전트가 자신의 정보 필요사항을 기술해 송신 에이전트에게 전달하면, 송신 에이전트가 이를 바탕으로 KV 캐시를 필터링·압축해서 보내는 방식이다. CacheBack은 송신 에이전트의 어텐션 가중치를 기반으로 receiver conditioning을 구현한 훈련 없는 방식이다. 전체 요약 5문장 읽기 → 088 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 089 09:11 ▲ 10 · 댓글 1 3D 구조를 살린 옥트리 기반 언어모델 OctLLM 기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. AI · 머신러닝 · Octrees as an Explicit 3D Language
Key Point 3D 데이터의 공간 구조를 손상시키지 않으면서도 기존 언어모델의 능력을 보존하는 멀티모달 LLM 설계 방식이 기존 기법들보다 우수한 성능을 달성했기 때문에 3D AI 모델 개발에 관심 있는 연구자와 실무자에게 참고할 만한 접근법을 제시한다.
핵심 요약
기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. OctLLM은 3D 데이터를 옥트리 점유 토큰의 명시적 3D 시퀀스로 입력받으면서도, 끝에서 두 번째 수준의 노드를 무작위로 비우고 자손을 생략해 형태를 보존한 Sparse Octree(S-Octree)로 단축해 위치 인식 마스크 모델링과 3D 이해를 지원한다. 3D 모달리티를 추가할 때 전체 미세조정이나 LoRA 대신, 메시 토큰을 블록의 일부에서 독립적인 학습 가능 브랜치로 라우팅하면서 텍스트와 이미지 토큰은 고정된 비전-언어 경로를 유지하고, 두 스트림이 공유 자기주의를 통해 상호작용하도록 설계했다. 전체 요약 4문장 읽기 → 090 06:11 ▲ 26 · 댓글 2 3차원 텐서 상태로 장문맥 처리하는 선형 어텐션 RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. AI · 머신러닝 · Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
Key Point 선형 어텐션의 메모리 효율성을 유지하면서 상태 차원을 3차원으로 확장하는 기술적 혁신으로, 장문맥 시퀀스 모델링에서 성능과 효율성의 균형을 새로 정의한다.
핵심 요약
RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. 기존 선형 어텐션은 키·벨류 벡터의 외적으로 행렬 크기 상태를 만들었으나, 새로운 방법은 키·두 번째 키·벨류의 3중 외적으로 3차원 텐서 상태를 작성한다. 두 개의 쿼리로 텐서의 두 키 축을 수축(contraction)해 읽어내며, E차원의 두 번째 키로 상태 크기를 E배 늘리면서 파라미터 프로젝션은 단 2개만 추가한다. 전체 요약 5문장 읽기 → 091 21:11 당일 +105 리눅스·윈도우 일괄 재설치 스크립트 오픈소스 VPS 운영체제를 한 줄의 명령으로 재설치하는 오픈소스 스크립트로, 리눅스 20개 배포판과 Windows Vista~11을 지원한다. 오픈소스 · 도구 · bin456789/reinstall · Shell
Key Point 저사양 VPS에서 OS를 완전히 교체해야 할 때 복잡한 수동 작업을 자동화하는 도구로, 클라우드 환경별 드라이버 자동 설치와 IP 자동 구성이 핵심 가치다.
핵심 요약
VPS 운영체제를 한 줄의 명령으로 재설치하는 오픈소스 스크립트로, 리눅스 20개 배포판과 Windows Vista~11을 지원한다. 리눅스 간 재설치, 리눅스에서 윈도우로, 윈도우에서 리눅스로 등 모든 방향의 OS 전환이 가능하며, 최소 256MB 메모리와 1GB 디스크로도 설치할 수 있다. Alpine, Debian, Ubuntu, RHEL, CentOS, Arch, NixOS 등 다양한 배포판과 Windows 시리즈(Server 2008~2025 포함)를 지원한다. 전체 요약 11문장 읽기 → 092 15:11 ▲ 113 · 댓글 17 40년 된 고전 게임에서 메모리 손상 버그 발견 인포콤의 1983년 어드벤처 게임 '인피델'에서 와일드 포인터 메모리 손상 버그가 발견되었다. 오픈소스 · 도구 · Infidel goes wild
Key Point 40년 전 게임에 숨어있던 메모리 손상 버그가 최근에 발견된 것은 게임 개발 초창기 컴파일러 결함과 테스트 범위의 한계를 보여주는 흥미로운 사례다.
핵심 요약
인포콤의 1983년 어드벤처 게임 '인피델'에서 와일드 포인터 메모리 손상 버그가 발견되었다. 버그는 DESERT-TO-TABLE 루틴에서 발생한다. 기본값으로 사용되는 DESERT-TABLE 배열이 전역변수인데도 ZIL 컴파일러는 이를 상수로 취급했다. 결과적으로 배열 주소 11129 대신 메모리 주소 30부터 덮어쓰기가 발생했다. 전체 요약 10문장 읽기 → 093 00:11 ▲ 166 · 댓글 69 125억 개 파라미터 모델을 RTX 4090으로 초당 100토큰 속도로 실행 Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. AI · 머신러닝 · Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
Key Point 소비자용 그래픽카드만으로 클라우드 서버 수준의 대규모 언어모델을 로컬에서 무료로 실행 가능해졌기 때문에, 개인 개발자와 중소 회사의 AI 접근 장벽이 크게 낮아진다.
핵심 요약
Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. RTX 5070(12GB)과 Ryzen 5 7600 조합에서 Q2_0 압축 모델 기준으로 초당 94토큰의 답변 생성 속도(32KB 문서 읽기 초당 2,650토큰)를 달성한다. RTX 3090(24GB) 같은 더 많은 VRAM을 가진 카드는 초당 100~140토큰 속도까지 낼 수 있다. 전체 요약 12문장 읽기 → 094 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 095 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 096 03:11 당일 +336 AI 에이전트의 메모리를 영구 보존하는 claude-mem Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. AI · 머신러닝 · thedotmack/claude-mem · TypeScript
Key Point 세션이 끝나도 AI 에이전트가 이전 작업 맥락을 자동으로 기억하게 해주는 기술로, 장기 프로젝트에서 에이전트의 연속성을 유지하는 방식이 어떻게 구현되는지 보여준다.
핵심 요약
Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. 5개의 생명주기 훅(SessionStart, UserPromptSubmit, PostToolUse, Stop, SessionEnd)과 스마트 설치 기능으로 작동하며, Bun 기반 워커 서비스가 로컬 HTTP API와 웹 뷰어 UI를 제공한다. SQLite 데이터베이스에 세션과 관찰 내용을 저장하고, Chroma 벡터 데이터베이스를 통해 하이브리드 의미론적 검색과 키워드 검색을 지원하는 mem-search 기능으로 프로젝트 히스토리를 자연어로 쿼리할 수 있다. 전체 요약 10문장 읽기 → 097 15:11 ▲ 82 · 댓글 3 장기 작업 수행하는 AI 에이전트, 명시적 신념 상태로 더 정확해진다 LLM 기반 에이전트가 복잡한 작업을 수행할 때 상호작용 이력을 단순히 메모리에 저장하는 것만으로는 현재 세계 상태를 일관되게 이해하기 어렵다. AI · 머신러닝 · Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States
Key Point LLM 에이전트의 장기 작업 수행 능력을 크게 향상시키는 새로운 접근법으로, 기존 메모리 기반 방식의 한계를 구체적으로 해결하고 실제 성능 개선을 입증했습니다.
핵심 요약
LLM 기반 에이전트가 복잡한 작업을 수행할 때 상호작용 이력을 단순히 메모리에 저장하는 것만으로는 현재 세계 상태를 일관되게 이해하기 어렵다. 새로운 프레임워크 PoS는 추론 과정에서 명시적 신념 상태(explicit belief states)를 구성하고 지속적으로 유지한다. 각 신념은 현재 세계 상태 추정치와 해결되지 않은 작업 요구사항을 결합하여, 에이전트가 여전히 학습해야 할 것과 달성해야 할 것을 명확히 한다. 전체 요약 8문장 읽기 → 098 12:11 새 버전 uv 0.12.22 출시, 파이썬 5개 버전 추가 CPython 3.10.22, 3.11.17, 3.12.15, 3.13.16, 3.14.8을 새로 지원한다. 오픈소스 · 도구 · astral-sh/uv@0.12.22
Key Point 파이썬 3.14까지 지원하는 것은 최신 파이썬 버전으로의 빠른 업그레이드가 가능해진다는 뜻이며, lockfile과 오프라인 모드 개선으로 의존성 관리가 더 견고해진다.
핵심 요약
CPython 3.10.22, 3.11.17, 3.12.15, 3.13.16, 3.14.8을 새로 지원한다. 휠 플랫폼 태그에서 대문자 릴리스 접미사를 인정하도록 개선했다. 워크스페이스 멤버의 기본 그룹과 의존성 그룹 파이썬 요구사항을 lockfile에 기록하는 기능을 추가했다. 전체 요약 9문장 읽기 → 100 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 →