쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
18건 · "레이턴시"조건 지우기 ×
001 21:11 당일 +260 로컬 AI 추론을 위한 고성능 엔진 Uzu 오픈소스화 Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. AI · 머신러닝 · trymirai/uzu · Rust
Key Point 로컬에서 AI 추론을 수행하려는 개발자들이 클라우드 비용과 레이턴시를 피하면서 데이터 프라이버시까지 보호할 수 있는 프로덕션급 도구가 생겼다.
핵심 요약
Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. 데이터 프라이버시를 완전히 보장하고 추론 비용이 발생하지 않으며, Metal·WebGPU·CPU 백엔드를 지원한다. Python, Swift, TypeScript, Rust 등 4개 언어에 바인딩을 제공하고, 모델 다운로드부터 추론까지 자동으로 처리한다. 전체 요약 9문장 읽기 → 002 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 003 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 004 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 006 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 007 00:11 ▲ 45 · 댓글 2 극한 압축으로 확산 모델 가속화하는 APEX 등장 확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. AI · 머신러닝 · APEX: Asynchronous Prefix Denoising for Extreme Compression
Key Point 확산 모델의 토큰 수를 획기적으로 줄이면서도 생성 품질을 유지할 수 있는 방법으로, 추론 속도와 비용에 민감한 생성형 AI 서비스 개발에 직접 영향을 미친다.
핵심 요약
확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. APEX는 계층적 레이턴시 공간과 채널 그룹별 비동기 디노이징을 결합한 새로운 방식이다. 오토인코더가 채널 프리픽스를 구조에서 세부사항 순서로 정렬하고, 공유된 단일 디노이저가 토큰을 추가하지 않고 엇갈린 시간에 생성한다. 전체 요약 6문장 읽기 → 008 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 009 12:11 ▲ 100 · 댓글 64 이더넷 기반 오디오 인터페이스 eth68, 3.6ms 초저지연 달성 eth68은 STM32H7 마이크로컨트롤러 펌웨어로 구동되는 리눅스용 이더넷 오디오 인터페이스로, netJACK1 마스터 엔드포인트를 에뮬레이트한다. 하드웨어 · 시스템 · ETH-68: Ethernet Audio Interface for Linux
Key Point 전용 오디오 카드 수준의 초저지연(3.6ms)을 이더넷과 일반 하드웨어로 구현했으며, 오픈소스로 공개되어 리눅스 기반 음악 제작 워크플로우에서 비용 대비 성능의 새로운 기준을 제시한다.
핵심 요약
eth68은 STM32H7 마이크로컨트롤러 펌웨어로 구동되는 리눅스용 이더넷 오디오 인터페이스로, netJACK1 마스터 엔드포인트를 에뮬레이트한다. JACK 서버를 netone 백엔드로 실행하거나 PipeWire의 pw-eth68 클라이언트로 직접 연결하여 사용할 수 있다. 48kHz 64샘플 버퍼에서 3.620ms의 왕복 오디오 레이턴시를 달성하며, 96kHz에서 RME HDSPe AIO Pro PCIe 카드보다 0.33ms 낮다. 전체 요약 12문장 읽기 → 010 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 011 18:30 ▲ 872 · 댓글 418 Anthropic, 저비용 소형 모델 Claude Haiku 5.5 공개 Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. AI · 머신러닝 · Claude Haiku 5.5
Key Point 소형 모델이 대폭 저렴해지면서 이전에는 비용상 불가능했던 요약, 분류, 에이전트 작업이 대규모로 가능해진다.
핵심 요약
Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. Haiku 5.5는 요약·데이터 압축·데이터베이스 쿼리·분류 등 반복적인 고용량 작업을 위해 설계되었으며, Opus 5.5 및 Sonnet 5.5와 함께 하위 에이전트로도 사용 가능하다. Haiku 4.5 대비 평균 75% 저렴하며, 특히 10만 토큰 이하 요청(전체 요청의 90%)에 대해 90% 저렴해졌다. 전체 요약 13문장 읽기 → 012 09:11 ▲ 12 · 댓글 2 고해상도 이미지 처리 위한 효율적인 토큰 순환 모델 GTR Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. AI · 머신러닝 · GTR: Gated Token Recurrence for Efficient Dense Prediction
Key Point 이차 복잡도로 인한 고해상도 이미지 처리의 계산 병목을 해결하는 새로운 아키텍처로, 4배 빠른 처리 속도와 엣지 장비 배포 가능성을 제시한다.
핵심 요약
Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. GTR(Gated Token Recurrence)은 소프트맥스 없는 순환 비전 백본으로 게이팅 선형 어텐션, 교대 공간 스캔 방향, 공간 강화된 SwiGLU 블록을 결합했다. GTR은 최종 레이어 패치-토큰 정렬로만 증류되며 마스킹된 토큰 예측이나 중간 레이어 감독은 사용하지 않는다. 전체 요약 8문장 읽기 → 013 21:11 당일 +377 웹 데이터 수집 API 'Firecrawl', AI 에이전트용 스킬과 MCP로 확장 웹 검색, 스크래핑, 상호작용을 통합한 데이터 API로, 마크다운과 구조화된 JSON 형태로 AI 에이전트가 사용할 수 있는 형식으로 데이터를 제공한다. AI · 머신러닝 · firecrawl/firecrawl · TypeScript
Key Point 웹 데이터 수집 자동화가 AI 에이전트의 필수 요소인 만큼, 96% 웹 커버리지와 다양한 에이전트 통합 방식(Skill, MCP)이 개발 경험을 단순화하고 AI 데이터 파이프라인 구축 시간을 크게 단축할 수 있다.
핵심 요약
웹 검색, 스크래핑, 상호작용을 통합한 데이터 API로, 마크다운과 구조화된 JSON 형태로 AI 에이전트가 사용할 수 있는 형식으로 데이터를 제공한다. 96%의 웹 커버리지를 지원하며 JavaScript 렌더링이 필요한 페이지도 처리하고, P95 레이턴시는 3.4초로 실시간 에이전트 구동에 최적화했다. 검색, 스크래핑(마크다운/HTML/스크린샷/JSON), 상호작용(클릭·스크롤·입력·대기) 등의 핵심 엔드포인트와 Agent, Crawl, Map, Batch Scrape 등의 추가 기능을 제공한다. 전체 요약 9문장 읽기 → 014 21:11 당일 +101 AI 에이전트용 메모리 인프라 Mem0, 토큰 효율성 47% 향상 Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. AI · 머신러닝 · mem0ai/mem0 · Python
Key Point AI 에이전트가 사용자 정보를 효과적으로 기억하고 활용하는 것이 LLM 기반 서비스의 핵심인데, 이 업데이트는 토큰 비용을 유지하면서 성능을 30% 이상 끌어올렸기 때문에 생산 환경 배포를 고민하는 팀이 참고할 만하다.
핵심 요약
Mem0는 AI 에이전트와 애플리케이션을 위한 지속적인 메모리 계층을 제공하는 오픈소스 프로젝트로, 사용자 선호도와 세션·에이전트 상태를 학습해 개인화된 상호작용을 가능하게 한다. 2026년 4월 업데이트된 새로운 메모리 알고리즘은 LoCoMo에서 71.4점에서 92.5점으로, LongMemEval에서 67.8점에서 94.4점으로 성능을 향상시켰다. 단일 LLM 호출로 동작하는 ADD-only 추출 방식을 도입해 메모리를 누적시키면서도 6.7~6.9K 토큰으로 낮은 레이턴시(0.88~1.09초)를 유지한다. 전체 요약 11문장 읽기 → 015 18:10 ▲ 116 · 댓글 84 OpenAI, LLM으로 자체 칩 설계…20개월만에 완성 OpenAI가 자체 AI 가속기칩 '할라페뇨'를 공개했으며, 엔비디아 GB300 대비 지연시간 3.6배 단축하고 전력 소비는 덜한다. 하드웨어 · 시스템 · How OpenAI Used Its Own LLMs to Design Its Jalapeño Chip
Key Point LLM이 칩 설계 자동화를 어떻게 실현하는지, 그리고 이것이 기존 수작업 기반의 칩 개발 일정을 얼마나 단축시킬 수 있는지 보여주는 사례이기 때문입니다.
핵심 요약
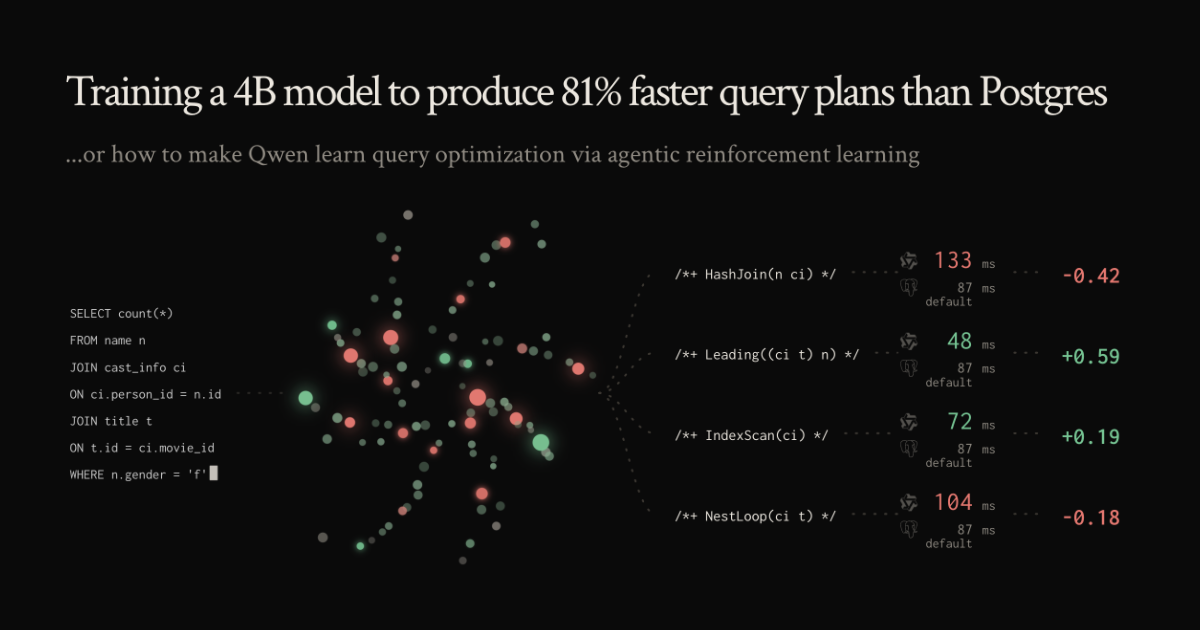
OpenAI가 자체 AI 가속기칩 '할라페뇨'를 공개했으며, 엔비디아 GB300 대비 지연시간 3.6배 단축하고 전력 소비는 덜한다. 할라페뇨는 13.4 페타플롭의 4비트 연산과 초당 15.4테라바이트의 메모리 접근 속도를 제공한다. 첫 아키텍처부터 실리콘 제조까지 20개월, RTL 코드부터 생산 단계까지 9개월이 걸렸다. 전체 요약 6문장 읽기 → 016 06:10 ▲ 183 · 댓글 27 4B 모델로 PostgreSQL 쿼리 플랜 81% 성능 개선 연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. AI · 머신러닝 · Training a 4B model to produce 81% faster query plans than Postgres
Key Point 쿼리 최적화라는 매우 어려운 데이터베이스 문제를 작은 규모의 LLM으로 해결 가능함을 실증함으로써, AI를 데이터베이스 성능 개선에 실무적으로 적용할 수 있는 방법을 제시한다.
핵심 요약
연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. 113개의 조인 중심 쿼리에서 44.7% 레이턴시 감소를 달성했으며, 초기에 99개 쿼리를 실행할 수 없던 모델이 성공적으로 작동하게 되었다. 쿼리 최적화는 조인 순서 결정이 NP-하드 문제로 알려져 있을 정도로 어려우나, 실행 시간이라는 단일 목표로 LLM 학습을 최적화할 수 있음을 보여준다. 전체 요약 4문장 읽기 → 017 03:10 ▲ 141 · 댓글 83 일상의 작은 개발 팁이 생산성을 좌우한다 엔지니어링 생산성은 언어 기능, 디버깅 기법, 명령어 같은 작은 지식들의 누적에서 나온다. 오픈소스 · 도구 · Small Programming Tricks
Key Point 개발자가 알아두면 즉시 일을 더 효율적으로 만드는 도구와 기법들이 어떤 것인지 구체적으로 알 수 있고, 팀 내 지식 공유 문화를 만드는 방법까지 배울 수 있습니다.
핵심 요약
엔지니어링 생산성은 언어 기능, 디버깅 기법, 명령어 같은 작은 지식들의 누적에서 나온다. ctrl+r 대신 fzf로 퍼지 검색하기, SQL SELECT WITHOUT FROM, git log -S로 특정 문자열 추가/삭제한 커밋 찾기 등 실무에 유용한 팁들을 소개한다. 배열의 flatMap, Object.entries 같은 모던 JS 기능, NodeJS의 https.Agent로 연결 재사용해 레이턴시 개선하기, ripgrep으로 grep 대체하기 등도 포함한다. 전체 요약 5문장 읽기 → 018 08:25 당일 +259 AI 에이전트용 초경량 샌드박스 CubeSandbox 오픈소스 공개 텐센트클라우드가 AI 에이전트 실행을 위한 CubeSandbox를 오픈소스로 공개했다. 인프라 · 데브옵스 · TencentCloud/CubeSandbox · Go
Key Point AI 에이전트 개발자나 신뢰할 수 있는 코드 실행 환경이 필요한 팀이라면, 하드웨어 격리와 극저 레이턴시를 동시에 갖춘 오픈소스 솔루션으로 기존 클라우드 서비스 비용을 절감하고 자체 인프라에서 운영할 수 있다.
핵심 요약
텐센트클라우드가 AI 에이전트 실행을 위한 CubeSandbox를 오픈소스로 공개했다. RustVMM과 KVM 기반으로 60ms 이내에 하드웨어 격리 샌드박스를 생성하며 메모리 오버헤드는 5MB 미만이다. E2B SDK와 호환되어 환경변수 한 줄만 바꾸면 E2B 클라우드에서 마이그레이션할 수 있다. 전체 요약 6문장 읽기 →