001 09:11 ▲ 110 · 댓글 29 LLM의 내부 상태 지도: 수천 개 대화의 벡터 풍경 Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. AI · 머신러닝 · What thousands of conversations look like inside a language model
Key Point LLM이 대화를 처리할 때 내부 벡터 공간에서 어떤 구조를 형성하는지, 다국어와 코드가 어떻게 배치되는지 구체적으로 보여줌으로써 모델의 표현 방식과 한계를 이해할 수 있다.
핵심 요약
Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. 100개 주제에 걸친 영어·중국어·독일어·크로아티아어 문답 900개와 Python 코딩 예제 90개를 처리해 각 토큰 위치의 2,048차원 벡터를 기록하고 3차원 공간으로 투영했다. 각 토큰은 임베딩 테이블에서 시작 벡터를 받아 모델의 레이어들이 문맥에 따라 변환하는데, 최종 토큰 상태들을 연결한 선은 각 대화의 경로를 나타낸다. 전체 요약 11문장 읽기 → 002 06:11 ▲ 127 · 댓글 31 구글의 멀티에이전트 AI, 수십 년 묵은 수학 문제를 증명하다 구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. AI · 머신러닝 · Advancing science and engineering with Antigravity's /teamwork
Key Point 구글이 멀티에이전트 AI로 정보이론, 양자 알고리즘, 형식 수학 등 수십 년 묵은 미해결 문제들을 순차적으로 증명·발견했으며, 이 도구를 모든 연구자에게 공개하면서 AI-인간 협업 연구의 새로운 패러다임을 제시했다.
핵심 요약
구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. Gemini 4 Argon, Carbon, Hydrogen 모델과 /teamwork을 함께 사용해 정보이론, 형식 검증, 분자 구조 발견, 커널 최적화 등에서 혁신을 이뤘다. /teamwork의 설계는 언어 모델의 두 가지 한계를 해결한다: 첫째 병렬 탐색과 검증자(Lean 4 증명 체커, 테스트 스위트 등)를 짝지어 생성의 불확실성을 극복하고, 둘째 각 에이전트에 필요한 도구와 파일만 전달해 장기 작업에서 맥락 손실을 방지한다. 전체 요약 14문장 읽기 → 004 18:11 ▲ 16 · 댓글 4 코드가 세상을 짜면, 영상 모델은 렌더링만 하는 게 될까? 멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. AI · 머신러닝 · WorldDraft: If Code Builds the World, Can Video Models Just Render It?
Key Point 코드 기반 3D 월드와 AI 영상 생성의 분업 구조에서 영상 모델의 한계와 개선 방법을 체계적으로 실측했기 때문에, 멀티모달 AI 시스템 설계자들이 알아야 할 핵심 발견이다.
핵심 요약
멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. 신뢰할 수 있는 생성 렌더러에 필요한 두 가지 기준을 정의한다: (i) 월드 보존 - 지정된 4D 운동과 카메라 경로 유지, (ii) 시각 실현 - 텍스트로 지정된 속성을 시간에 따라 일관되게 유지. WorldDraft 벤치마크를 제안하는데, 6개 동적 카테고리에 걸친 48개 실행 가능한 4D 월드 패밀리에서 432개의 엄격하게 쌍을 이룬 테스트 케이스로 구성된다. 전체 요약 9문장 읽기 → 005 18:11 ▲ 30 · 댓글 4 로봇 학습 위한 대규모 환경·행동 데이터셋 'Ropedia Xperience 2' 공개 GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. AI · 머신러닝 · Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors
Key Point 대규모 언어 모델의 스케일링 법칙처럼, 로봇 AI가 어떤 데이터 규모에서 성능이 향상되는지를 연구하기 위한 첫 번째 표준 데이터셋이 제시됐다.
핵심 요약
GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. 로봇 AI의 능력이 환경과 행동 데이터 규모에 어떻게 비례하는지 규명하려면, 어떤 데이터를 모을지, 어떻게 지속적으로 생산·재활용할지 먼저 정해야 한다. Ropedia Xperience 2는 1,589개의 미터급 3D 스캔과 74개 작업의 1인칭 영상 4,230개(총 131시간)를 담은 데이터셋이다. 전체 요약 5문장 읽기 → 006 18:11 ▲ 24 · 댓글 3 3D 기하 재구성 없이 23배 빠른 신규 시점 렌더링 디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. AI · 머신러닝 · TTB: Test-time Baking for Efficient Rendering of Decoder-only View Synthesis Models
Key Point 3D 재구성 없이도 신규 시점을 실시간으로 생성할 수 있는 방식의 등장으로, VR·게임·영상 제작 등 뷰 합성이 필요한 분야의 효율성 문제를 근본적으로 바꿀 수 있다.
핵심 요약
디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. 새로운 방법인 TTB(Test-Time Baking)는 교차 뷰 어텐션에서 전역 장면 정보를 경량 MLP에 학습하여 빠르고 고품질의 신규 시점 디코딩을 가능하게 한다. 첫 번째 핵심은 TTT의 빠른 가중치 MLP를 입출력 쌍에서 교차 뷰 어텐션 매핑을 명시적으로 학습하도록 재목적화하여, TTT와 동일한 렌더링 효율을 유지하면서 현저히 높은 품질을 제공한다. 전체 요약 5문장 읽기 → 007 15:11 ▲ 171 · 댓글 40 개인 컴퓨터에서 돌리는 1450억 파라미터 모델 Edge0-145B 공개 Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. AI · 머신러닝 · Edge0-145B: Frontier AI Capabilities on Your Own Computer
Key Point 개인 컴퓨터에서 클라우드 모델 수준의 복잡한 작업(코딩, 3D 모델링, 비디오 제작)을 요금 없이 수행 가능해지면서, 온디바이스 AI의 실용성이 크게 높아졌다.
핵심 요약
Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. 호환 가능한 노트북에서 피크 메모리 29GB, 토큰 생성 속도 80+tokens/s로 동작하며 기존 대규모 모델 대비 약 40% 메모리로 동등한 성능을 낸다. Edge0-145B는 DeepSWE 1.1에서 64.6점(Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4), Terminal-Bench 2.1에서 86.52점(Qwen 83.3, DeepSeek 82.7)으로 코딩·추론·명령 이행 능력이 클라우드 모델 수준이다. 전체 요약 11문장 읽기 → 008 06:11 ▲ 356 · 댓글 236 구글, 일상 업무용 AI 모델 '지미니 4 하이드로젠' 공개 구글이 Gemini 4 Hydrogen을 발표했으며, 이는 속도와 효율성이 필요한 일상 코딩 및 에이전트 작업에 최적화된 모델이다. AI · 머신러닝 · Gemini 4 Hydrogen
Key Point 일상 개발 업무에서 빠른 실행과 효율성이 필요한 개발자와 기업이 기존보다 훨씬 빠르고 저렴하게 이용할 수 있는 AI 모델이 출시되었다.
핵심 요약
구글이 Gemini 4 Hydrogen을 발표했으며, 이는 속도와 효율성이 필요한 일상 코딩 및 에이전트 작업에 최적화된 모델이다. Hydrogen은 Artificial Analysis Intelligence Index에서 Argon을 상회하면서(51 vs 50, xhigh 설정 시 54) 동시에 같은 클래스 모델보다 빠르게 완료한다. 가격은 1백만 토큰 컨텍스트 윈도우 전체에서 입력 토큰당 $1.50, 출력 토큰당 $7.50으로 고정되어 있다. 전체 요약 15문장 읽기 → 009 18:11 ▲ 14 · 댓글 5 GTA V를 AI 훈련장으로: 게임 과제로 강화학습 평가 AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. AI · 머신러닝 · GTAGym: AAA Game Tasks Environment for Evaluation and Reinforcement Learning
Key Point AAA 게임 환경에서 AI 에이전트를 객관적으로 평가하고 강화학습으로 훈련할 수 있는 자동화된 벤치마크가 생겨, 복잡한 현실 같은 과제에서 AI 성능을 측정하는 새로운 길이 열렸다.
핵심 요약
AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. 연구진은 GTA V 작업 평가 및 강화학습을 위한 환경 및 프레임워크인 GTAGym을 개발했다. GTAGym의 평가 벤치마크인 GTAVBench는 GTA V 메인 스토리 미션에서 추출한 9개 작업 계열의 103개 온라인 과제와 GTA V 이미지 기반 47개 사격·저격 과제를 포함한다. 전체 요약 8문장 읽기 → 010 15:10 ▲ 117 · 댓글 29 컴퓨터 그래픽의 상징, 유타 티팟의 50년 진화 유타 티팟은 컴퓨터 그래픽 역사의 상징으로, 베지에 곡면을 이용한 초기 3D 모델이다. 하드웨어 · 시스템 · The Utah Teapot
Key Point 초기 Bézier 곡면 기반 3D 모델의 역사적 진화 과정과 기술적 개선 방식을 정확히 이해하고 싶은 그래픽스 관심층, 그리고 산업 표준의 출발점과 그 개선 궤적을 배우려는 개발자들이 참고할 수 있는 자료다.
핵심 요약
유타 티팟은 컴퓨터 그래픽 역사의 상징으로, 베지에 곡면을 이용한 초기 3D 모델이다. 1975년 마틴 뉴엘이 박사학위 논문 작성 중 실제 주전자(멜리타)를 참고해 28개의 3차 베지에 곡면으로 모델링했다. 1976년 짐 블린이 모델을 3/4로 축소해 지금의 친숙한 형태가 되었고, SIGGRAPH 1976에서 발표되어 그래픽 커뮤니티의 표준이 됐다. 전체 요약 9문장 읽기 → 011 03:11 ▲ 123 · 댓글 55 콜 오브 듀티: 블랙 옵스 2, ARM64 맥에서 네이티브 플레이 32비트 x86 윈도우 게임을 Remill로 LLVM IR로 변환한 뒤 독자적 최적화 패스를 거쳐 ARM64 네이티브 코드로 정적 재컴파일, 윈도우 API 런타임과 Metal 기반 Direct3D 11을 구현해 macOS에서 실행하는 프로젝트. 하드웨어 · 시스템 · Show HN: Black Ops II statically recompiled to native ARM64 macOS
Key Point Mac Silicon에서 공식 지원 없이 네이티브 게임을 실행할 수 있는 새로운 방식이 등장했고, 복사 방지도 우회하지 않으면서 처음부터 끝까지 최적화한 사례를 보여줌.
핵심 요약
32비트 x86 윈도우 게임을 Remill로 LLVM IR로 변환한 뒤 독자적 최적화 패스를 거쳐 ARM64 네이티브 코드로 정적 재컴파일, 윈도우 API 런타임과 Metal 기반 Direct3D 11을 구현해 macOS에서 실행하는 프로젝트. 사용자의 Steam 게임 복사본을 자신의 Mac에서 앱으로 변환; 약 150,000개 함수를 번역하고 복사 방지는 Unicorn 기반 x86 인터프리터에서만 실행. Apple M1에서 캠페인 51~60fps, 좀비 57~60fps, 봇과의 멀티플레이 53~60fps 달성; 변환에 약 1시간 45분 소요, 캠페인은 45분 후 바로 플레이 가능. 전체 요약 11문장 읽기 → 012 15:11 ▲ 26 · 댓글 2 로봇 손가락 조작, 앞선 시각 감각으로 성공률 11% 높였다 정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. AI · 머신러닝 · DexForesight: Grounding Dexterous Policies with Implicit Spatial Foresight
Key Point 로봇이 손가락 관절의 복잡한 움직임을 미리 예측하는 방식이 기존 대비 단순화되면서, 실제 환경에서 정교한 조작 작업의 성공률이 크게 올랐다.
핵심 요약
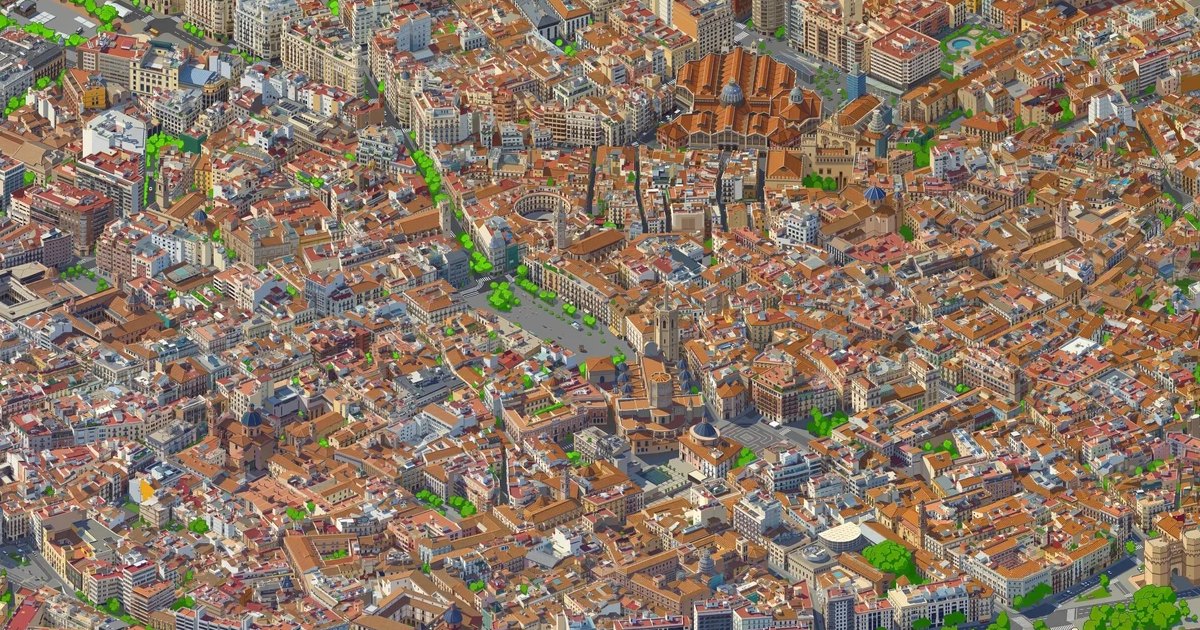
정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. DexForesight는 세계 모델을 정책의 잠재 공간에 주입해 공간 예측을 암묵적으로 학습하는 프레임워크다. 오프라인 장면 깊이 정보, 손 기하학, 시연 궤적으로부터 행동 조건부 세계 모델을 학습한다. 전체 요약 8문장 읽기 → 013 06:11 ▲ 138 · 댓글 35 스페인 발렌시아를 심시티 스타일로 재현한 등각 픽셀맵 발렌시아 전체 지자체를 심시티와 같은 등각 뷰의 픽셀아트 지도로 표현했으며, 모든 건물은 실제 건물을 위에서 같은 각도로 그린 것이다. 웹 · 프론트엔드 · Show HN: Valencia, Spain in Sim City/Isometric View
Key Point 실제 도시 데이터를 AI 이미지 모델로 처리해 레트로 게임 스타일의 맵으로 변환하는 기술이 웹에서 실제로 어떻게 구현되는지 보여주는 창의적인 사례다.
핵심 요약
발렌시아 전체 지자체를 심시티와 같은 등각 뷰의 픽셀아트 지도로 표현했으며, 모든 건물은 실제 건물을 위에서 같은 각도로 그린 것이다. 우에르타 농경지부터 알부페라 호수까지 거의 전역을 커버했으며, 3D 이미지 데이터가 없는 소규모 우에르타 지역만 제외했다. 3D 도시 데이터를 고정된 등각 카메라로 렌더링한 후, 훈련된 이미지 모델이 픽셀아트 스타일로 타일 단위로 재칠하는 방식이다. 전체 요약 5문장 읽기 → 014 03:11 ▲ 231 · 댓글 32 Blender 5.3, 가우시안 스플래팅 네이티브 지원 추가 Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. AI · 머신러닝 · Blender 5.3 released with Gaussian Splat support
Key Point 사진·영상에서 3D 장면을 재구성하는 가우시안 스플래팅이 3D 제작 파이프라인에 표준으로 통합되면서 Blender 사용자들이 AI 생성 모델이나 포토그래메트리 결과물을 직접 작업할 수 있게 된다.
핵심 요약
Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. PLY, SPZ, glTF 파일에서 가우시안 스플래팅을 포인트 클라우드로 임포트한 후 Geometry Nodes로 처리하고, EEVEE, Cycles, Workbench에서 렌더링할 수 있다. 스플래팅은 scale, rotation, radiance 등의 특수 속성으로 저장되며, 기본적으로 이미시브 셰이더로 렌더링되지만 Diffuse BSDF로 교체해 릿팅 처리도 가능하다. 전체 요약 12문장 읽기 → 015 03:11 ▲ 215 · 댓글 114 구글, 최강 프론티어 모델 'Gemini 4 Carbon' 공개 Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. AI · 머신러닝 · Gemini 4 Carbon is now available
Key Point 사이버보안·과학·엔지니어링 분야의 최고 성능과 동일한 Argon 가격으로 제공되며, /swarm 기능으로 멀티에이전트 협업 방식이 표준화되기 시작했다.
핵심 요약
Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. Gemini 4 Argon 이후 나온 Carbon은 사이버보안, 장기 에이전트 워크플로우, 소프트웨어 엔지니어링, 과학적 추론에서 최강 성능을 제공한다. CursorBench 4.0, Perplexity의 WANDR, Zapier의 AutomationBench에서 1위를 차지했으며, 다음 최고 모델 대비 비용은 2배 이상 낮다. 전체 요약 16문장 읽기 → 016 21:11 당일 +170 AI로 게임을 만드는 원맨 스튜디오, OhMyGame 오픈소스 공개 OhMyGame은 AI 에이전트가 게임 제작의 전 과정을 주도하는 오픈소스 게임 개발 플랫폼이다. AI · 머신러닝 · WhiteTowerAI/ohmygame · TypeScript
Key Point 게임 개발의 진입장벽을 AI와 통합 도구로 낮추는 새로운 접근법이며, 개인 개발자도 한 명의 스튜디오처럼 완전한 게임을 만들고 멀티플랫폼으로 배포·수익화할 수 있게 한다.
핵심 요약
OhMyGame은 AI 에이전트가 게임 제작의 전 과정을 주도하는 오픈소스 게임 개발 플랫폼이다. 사용자가 게임 아이디어를 설명하면 에이전트가 설계 문서를 작성하고, 2D·3D 아트, 비디오, 코드를 생성하며, 게임을 빌드하고 직접 플레이하며 검증한다. 캔버스 기반 UI에서 설계 문서, 개념 아트, 3D 모델, 비디오가 한 보드 위에 함께 놓여 있고, 각 요소가 서로 참조될 수 있다. 전체 요약 12문장 읽기 → 017 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 018 12:11 ▲ 26 · 댓글 2 3D 생성 AI 에이전트 평가 벤치마크 공개 코딩 에이전트는 시각 정보와 프로그램 실행을 결합해 3D 콘텐츠 자동 생성을 가능하게 한다. AI · 머신러닝 · Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
Key Point 3D 생성 AI 에이전트의 객체·장면·월드 수준별 능력과 한계가 정량적으로 규명되어, 앞으로의 개발 방향을 구체적으로 가늠할 수 있다.
핵심 요약
코딩 에이전트는 시각 정보와 프로그램 실행을 결합해 3D 콘텐츠 자동 생성을 가능하게 한다. 이미지와 지시문을 편집 가능한 프로그램으로 변환해 재구성, 생성, 편집을 하나의 워크플로우에 통합한다. 기존 벤치마크들은 과제 범위와 평가 방식이 제각각이어서 에이전트의 능력을 객체·장면·인터랙티브 수준별로 파악하기 어려웠다. 전체 요약 10문장 읽기 → 019 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 020 21:11 당일 +121 영상을 3D 가우시안 스플래팅으로 한 클릭 변환 비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 오픈소스 · 도구 · ooolabdev/ooosplat · Rust
Key Point 영상·사진 기반 3D 모델 생성을 로컬 머신에서 완전 자동화하는 오픈소스 도구로, 클라우드 의존 없이 개인정보 보호와 온프레미스 처리를 실현해 3D 콘텐츠 제작 워크플로우 변화를 가져올 수 있음.
핵심 요약
비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 입력 소재·프로젝트 폴더·품질 레벨을 선택하면 FFmpeg, COLMAP, Brush를 자동으로 실행해 최종 PLY 파일을 생성하고 바로 미리보기, 편집, 내보내기 가능. Windows 11 x64, Apple Silicon macOS 15+, Ubuntu 24.04 LTS x86_64를 지원하며, 번들된 FFmpeg·FFprobe·COLMAP·Brush를 사용해 별도 설치 불필요. 전체 요약 14문장 읽기 → 021 21:11 ▲ 21 · 댓글 3 코드로 영상 생성 제어하는 AI 에이전트 등장 Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. AI · 머신러닝 · Video-Coder: Reinforcing Agentic Coding for Video Generation
Key Point 정밀한 공간 구조와 제어 가능한 영상 생성이라는 영상 AI의 오래된 문제를 코드 기반 에이전트로 풀어내는 새로운 패러다임이기 때문이다.
핵심 요약
Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. 논문은 6천 개 샘플의 감독학습용 데이터셋(Video-Coder-SFT-6k)과 2천 개 샘플의 강화학습용 데이터셋(Video-Coder-RL-2k)을 새로 구축했다. 코드 실행·3D 렌더링·실행 피드백을 통합한 Video-Coder Harness 환경을 개발하여 에이전트 훈련과 추론에 사용한다. 전체 요약 6문장 읽기 → 022 18:11 ▲ 70 · 댓글 2 3D 가우시안 스플래팅, 장면 규모 차이 극복하다 기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. AI · 머신러닝 · SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 023 15:12 ▲ 112 · 댓글 61 웹 브라우저만으로 충분하다, 제작 비용은 점점 싸진다 작가 폴 포드는 웹 기반 오피스 스위트 '틸리틀오피스'를 런칭했고, 수십만 명의 방문자를 끌어 제품 헌트 상위 10위에 올랐다. 웹 · 프론트엔드 · The Web Is More Than Enough, by Paul Ford
Key Point 개인 개발자가 웹 브라우저만으로 게임, 오피스 스위트 같은 고도한 애플리케이션을 $0에 가까운 비용으로 만들 수 있게 되면서, 기술 경제의 구조 자체가 변하고 있는 전환점을 설명한다.
핵심 요약
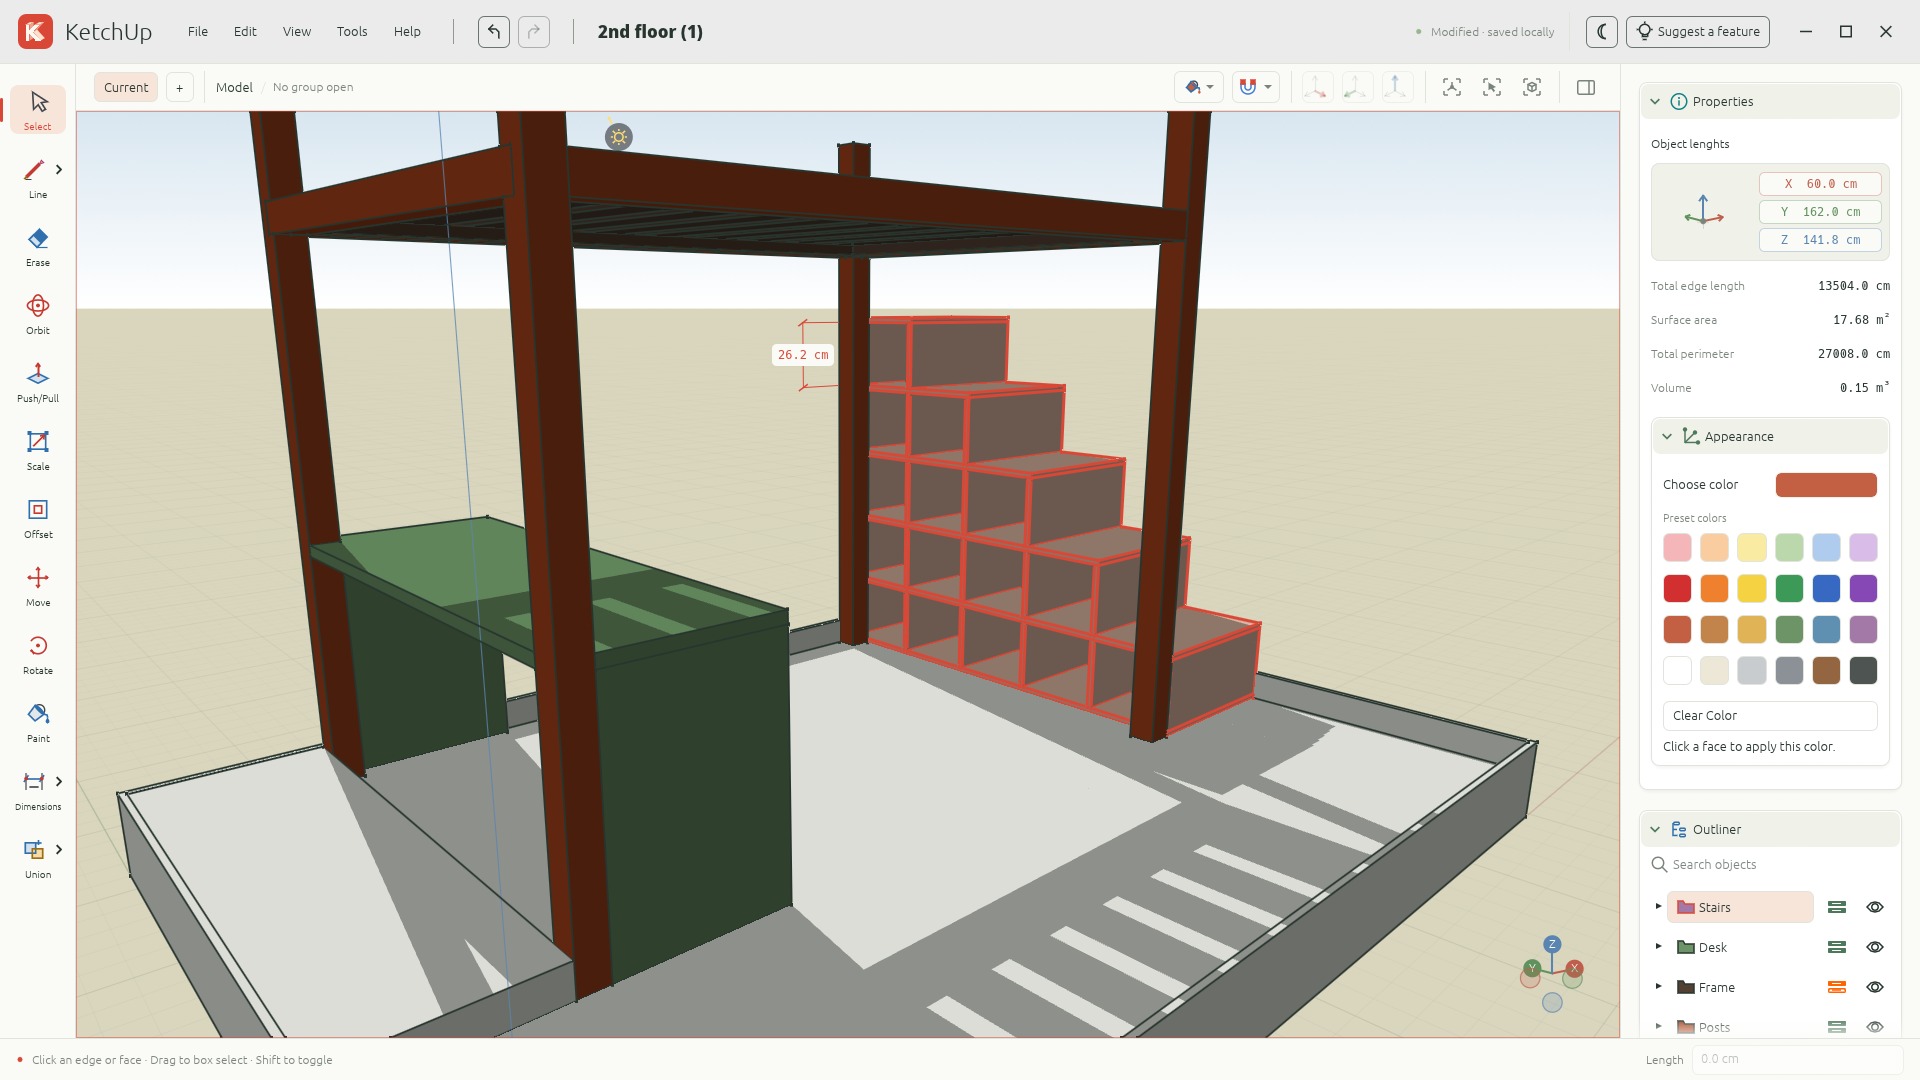
작가 폴 포드는 웹 기반 오피스 스위트 '틸리틀오피스'를 런칭했고, 수십만 명의 방문자를 끌어 제품 헌트 상위 10위에 올랐다. 웹 브라우저는 강력한 애플리케이션 개발 플랫폼이며, 그 접근성 비용이 날마다 떨어지고 있다. 포드는 긴 뉴스레터 쓰는 데 드는 노력의 2배 정도만 투자해 웹 기반 오피스 스위트를 만들었고, 클라우드플레어 호스팅 비용은 $0에 가깝다. 전체 요약 10문장 읽기 → 024 12:11 ▲ 256 · 댓글 73 Rust와 WebGPU로 만든 오픈소스 3D 모델링 도구 KetchUp 목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. 오픈소스 · 도구 · KetchUp – Open-source SketchUp alternative built with Rust and WebGPU
Key Point SketchUp의 비싼 라이선스 비용을 피하려는 목공인과 가구 제작자들이 선택할 수 있는 완전히 무료이고 오픈소스인 대안이 나왔다.
핵심 요약
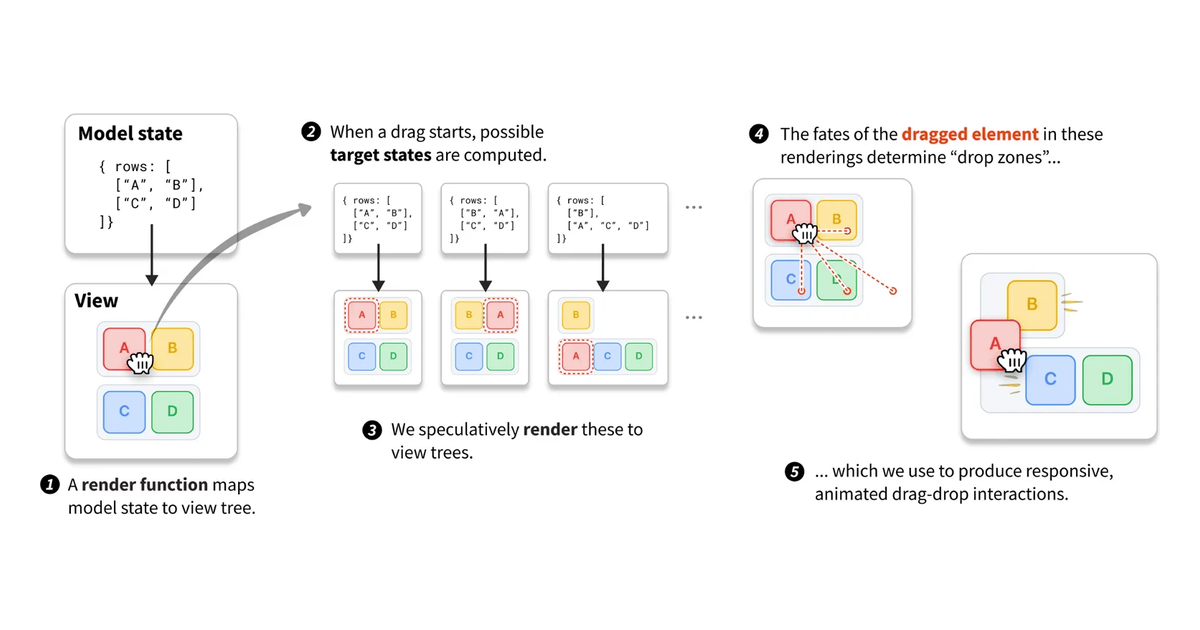
목공과 가구 설계를 위한 무료 오픈소스 3D 모델링 앱 KetchUp이 공개되었다. Windows, macOS, Linux 데스크톱 앱 또는 웹 브라우저에서 실행되며, Rust와 WebGPU로 구축되었다. 직사각형·원·자유형 스케치로 시작해 Push/Pull로 깊이를 주고, 이동·복제·스케일링·칠하기로 모델을 만들 수 있다. 전체 요약 9문장 읽기 → 025 06:11 ▲ 133 · 댓글 8 모델 상태만 지정하면 드래그 상호작용을 자동 생성 Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 웹 · 프론트엔드 · Declarative Dragging
Key Point 인터페이스 제작자가 코드를 거의 짜지 않고도 고품질의 드래그 상호작용을 구현할 수 있는 새로운 패러다임을 제시하므로, 교육 도구, 게임, 수학 탐구 환경 등 다양한 분야에서 상호작용 설계의 진입장벽을 낮춘다.
핵심 요약
Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 기존 드래그 상호작용은 기하학, 피드백, 애니메이션을 다루는 복잡한 코드가 필요했으나, 이 방식은 요소를 드래그했을 때 도달할 수 있는 미래 상태만 지정하면 된다. 시스템이 이러한 상태들을 추론적으로 렌더링해 실제 위치를 파악한 후, 가능한 모든 상태를 결합해 매끄러운 드래그-드롭 상호작용을 자동 생성한다. 전체 요약 10문장 읽기 → 026 18:15 스타 1,163 LLM이 만드는 3D 모델, sand3d로 코드처럼 쓴다 sand3d는 Python 라이브러리로, 3D 객체를 짧은 프로그램으로 작성할 수 있도록 설계되었으며 Blender의 bpy를 기반으로 한다. AI · 머신러닝 · Sandflow-ai/sand3d · HTML
Key Point 3D 모델 생성을 LLM이 직접 다루려면 토큰 효율이 결정적인데, sand3d는 기존 도구 대비 2~6배 짧은 코드로 표현해 프롬프트 예산 내에서 복잡한 객체를 만들 수 있게 한다.
핵심 요약
sand3d는 Python 라이브러리로, 3D 객체를 짧은 프로그램으로 작성할 수 있도록 설계되었으며 Blender의 bpy를 기반으로 한다. 한 부품당 Blender Python, CadQuery, FeatureScript 대비 2~6배 적은 토큰으로 표현되므로 LLM 프롬프트에 맞춘다. 전체 API가 약 3,600 토큰으로 압축되어 시스템 프롬프트에 통째로 들어갈 수 있다. 전체 요약 10문장 읽기 → 027 18:15 스타 1,120 이미지 한 장으로 3D 장면을 만드는 웹 스튜디오 이미지 기반 3D 장면 생성 시스템으로, 참고 이미지와 텍스트 프롬프트를 입력하면 카메라 궤적을 따라 미리보기·재생·추적 가능한 3D 장면을 생성한다. 웹 · 프론트엔드 · deepopen-com/deepopen-3d-webs · Python
Key Point 단일 이미지에서 공간 탐색이 가능한 3D 장면을 브라우저에서 바로 생성·편집할 수 있는 완전한 스튜디오를 갖춘 도구로, 제품 개념화부터 3D 자산 제작까지 워크플로우를 단순화한다.
핵심 요약
이미지 기반 3D 장면 생성 시스템으로, 참고 이미지와 텍스트 프롬프트를 입력하면 카메라 궤적을 따라 미리보기·재생·추적 가능한 3D 장면을 생성한다. 확산 모델(SD1.5, Blazing Drive V11m, Realistic Vision V5.1, Cartoon Pixar V5)과 카메라 궤적(Look Around, Overhead Orbit, Spin in Place 360), 렌더링 궤적(Push In and Out, Classic Orbit, Subtle Sway)을 선택하여 한 번에 생성할 수 있다. 깊이 추정(ZoeDepth)과 3D 가우시안 스플래팅을 거쳐 색상·깊이 애니메이션과 가우시안 포인트 클라우드를 생성하고, PLY 형식으로 다운로드하거나 브라우저에서 직접 미리볼 수 있다. 전체 요약 10문장 읽기 → 028 18:15 스타 1,578 한 서버에서 돌리는 AI 라이브 진행자 오픈소스 한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. AI · 머신러닝 · jacke-pp/open-yoki · JavaScript
Key Point AI 라이브 진행자를 자신의 진행자·음성으로 구축하려는 크리에이터나 스트리머에게 완전한 오픈소스 시스템을 제공하며, 웹3·AI 커뮤니티에서 진행자 자동화 기술의 실제 구현 사례를 보여준다.
핵심 요약
한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. 유저 음성을 복제한 성우와 실시간 디지털 아바타로 출연하며, 시청자 댓글을 읽고 답하고, 단골 시청자를 기억하고, 일기를 쓰고, 자동으로 포스팅하고, 정해진 일정에 방송을 시작·종료한다. 바이낸스 광장(또는 RTMP를 받는 모든 플랫폼)과 자체 웹 직방에 동시 송출되며, 헤드리스 Chrome이 16:9 화면(아바타·자막·시세 패널·선물·팔로우 감사·음악·음향 효과)을 생성하고 ffmpeg로 RTMP 푸시한다. 전체 요약 13문장 읽기 → 029 18:15 스타 1,413 AI 그림 그리기용 포즈·의상·얼굴 참고 도서관 AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. AI · 머신러닝 · HRuiCcc/RuiC-PoseAtlas · JavaScript
Key Point AI 그림 그리기·3D 모델링·일러스트·만화 창작자들이 포즈·의상·얼굴을 체계적으로 참고하고 조합할 수 있는 완전 무료 참고 라이브러리가 등장했습니다.
핵심 요약
AI 생성 인체 포즈 288조 × 5시점 1,439장과 무인 의상 1,407벌, AI 생성 얼굴 1,499장을 모은 정적 웹사이트를 공개했습니다. 포즈 도감은 정면·사선·측면·부감·앙감 다섯 방향 참고화를 한 세트로 묶어 제시하고, 화살표 키로 각도와 포즈 간 이동이 가능합니다. 의상 도감은 춘·하·추·동·내의·파티·수영복·섹시 8개 계절 분류와 색상·소재·실루엣 등 86개 삼국어 태그로 구성하여, 무인 의상을 기존 캐릭터에 직접 겹칠 수 있습니다. 전체 요약 10문장 읽기 → 030 18:15 스타 1,817 Claude가 영화 같은 랜딩페이지를 자동으로 만드는 스킬 공개 MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. 웹 · 프론트엔드 · Motionsites-AI/claude-skill · Python
Key Point AI 웹빌더가 늘어나는 가운데, 실제로 심사위원 상 수준의 사이트를 만드는 체계적 방법을 Claude에 내장했다는 점이 의미 있다. 디자인 규칙과 미디어 라이브러리, 자동 QA까지 갖춰진 방식은 단순 생성 도구와 다른 수준의 결과를 기대하게 한다.
핵심 요약
MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. AI가 흔히 만드는 평범한 사이트를 피하기 위해 명확한 설계 계획, 실제 영상 자료, 결과물 검증을 자동화한다. 스킬에 포함된 40개 예제 프롬프트는 MotionSites에서 가장 인기 있는 디자인들이며, Claude가 유사한 2~3개를 참고해 디테일을 맞춘다. 전체 요약 12문장 읽기 → 031 18:15 스타 1,676 고교 과학 실험을 3D로 배운다…'동강 랩' 50개 수업 무료 공개 물리·화학·생물·지리 고등학교 과학 주제를 다루는 인터랙티브 3D 수업 50개를 무료로 제공하는 동강 랩이 GitHub에 공개되었다. 오픈소스 · 도구 · smithjohn78390/tongjiang-lab · HTML
Key Point 고등학교 과학 실험실 환경을 3D로 완벽히 재현해 학생들이 위험하거나 복잡한 실험을 가상으로 체험할 수 있으며, 오프라인 작동과 교육 표준 연계로 학교 현장에 즉시 적용 가능하다.
핵심 요약
물리·화학·생물·지리 고등학교 과학 주제를 다루는 인터랙티브 3D 수업 50개를 무료로 제공하는 동강 랩이 GitHub에 공개되었다. 각 수업은 약 1MB 용량의 단독 HTML 파일로, 더블클릭하면 오프라인에서도 작동하며 프로젝터나 스마트보드에 연결할 수 있다. 3D 환경 내에서 실시간 제어 콘솔, 안내 질문, 교사가 따를 수 있는 단계별 진행 경로를 제공한다. 전체 요약 12문장 읽기 → 032 18:15 스타 2,306 Claude로 유튜브 쇼츠 만드는 무료 스킬 공개 Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 웹 · 프론트엔드 · mromidev/claude-animated-shorts · TypeScript
Key Point 직접 PC에서 고품질 애니메이션 쇼츠를 만들 수 있는 완전한 파이프라인과 학습 자료를 무료로 받을 수 있어, 창작자들이 외부 AI 동영상 생성 서비스에 의존하지 않고도 같은 수준의 결과물을 만들 수 있게 되었다.
핵심 요약
Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 55~70초 세로형 영상으로, 2D 캐릭터가 3D 세계에서 움직이는 구조다. three.js와 Remotion을 써서 자신의 PC에서 렌더링하며, AI 영상 생성 도구는 쓰지 않는다. 전체 요약 9문장 읽기 → 033 18:15 스타 2,588 Claude로 기계를 3D 시뮬레이터로 만들어 분해할 수 있는 도구 Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. AI · 머신러닝 · elvarofficial/teardown · JavaScript
Key Point Claude로 기계의 작동 원리를 3D 시뮬레이터로 즉시 만들 수 있는 방식이 등장해, 복잡한 엔지니어링 개념을 직관적으로 이해하고 공유하는 방법이 바뀔 수 있다.
핵심 요약
Claude Code 스킬 'teardown'은 자연어 설명으로 임의의 기계를 오프라인 HTML 페이지 3D 시뮬레이터로 변환한다. 기계는 화면 중앙에 표시되고, 주변 패널에서 실시간 수치를 읽을 수 있으며, 버튼으로 작동 부품을 분해할 수 있다. 아무도 조작하지 않으면 페이지가 자동으로 기계를 둘러본다. 전체 요약 10문장 읽기 → 034 18:15 스타 5,947 244개 픽셀 아트 이펙트 라이브러리, Claude Code 스킬로 직접 만들기 pixelfx는 불, 폭발, 마법, 날씨, UI, 픽업 등 244개의 픽셀 아트 이펙트와 애니메이션을 담은 라이브러리다. 웹 · 프론트엔드 · patch-gg/pixelfx · JavaScript
Key Point 게임 개발자라면 직접 이펙트를 만드는 노가다 없이 즉시 써먹을 244개 효과를 얻고, AI 스킬로 원하는 연출을 직접 생성할 수 있는 실용적 도구다.
핵심 요약
pixelfx는 불, 폭발, 마법, 날씨, UI, 픽업 등 244개의 픽셀 아트 이펙트와 애니메이션을 담은 라이브러리다. 모든 이펙트는 작은 코드 조각이며, 브라우저에서 재생·색칠·미러링하거나 게임 엔진으로 내보낼 수 있다. 캐릭터가 등장하는 61개 이펙트와 12개 무브는 '액팅' 시스템으로 작동한다: 캐릭터가 준비 동작을 한 후 공격을 날리고, 대상이 충격을 받으며, 회복 동작까지 연결된다. 전체 요약 12문장 읽기 → 035 18:15 스타 3,847 비디오 제작 방식을 자동 분석하는 오픈소스 도구 'rea-video' 영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. AI · 머신러닝 · JuneYaooo/rea-video · Python
Key Point 비디오 콘텐츠 제작의 주요 성분(실사/AI/코드)을 정확히 판별할 수 있으면, 제작 기법 학습 비용을 대폭 낮추고 비슷한 스타일의 콘텐츠를 빠르게 만들 수 있다.
핵심 요약
영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. 카메라 위치·조명 설정·색보정·렌즈 정보 등 촬영 기법, AI 영상의 역엔지니어링 프롬프트와 배치 전략, 3D/애니메이션의 렌더링 여부, 코드 기반 UI/타이포그래피의 타이밍, 화면 녹화 범위를 각각 구분해 보고한다. 자막·이모티콘·편집점·음성(인간/AI)·음악(BPM 포함)·효음의 위치와 지속 시간도 추출하며, SRT/ASS 자막 형식으로 내보낼 수 있다. 전체 요약 9문장 읽기 → 036 18:15 스타 21,465 웹사이트·앱·게임 보고 AI가 자동 재구성, Rust 기반 Craft Anything 공개 Craft Anything은 웹사이트·데스크톱 앱·모바일 앱·게임을 분석해 동일한 소프트웨어를 AI가 처음부터 다시 만드는 순수 Rust 기반 역공학 엔진이다. AI · 머신러닝 · storytold/craft-anything · Rust
Key Point 보는 것만으로 어떤 소프트웨어든 분석한 뒤 AI가 자동으로 재구현하는 경험이 소프트웨어 학습·프로토타이핑 방식을 근본적으로 바꿀 수 있기 때문이다.
핵심 요약
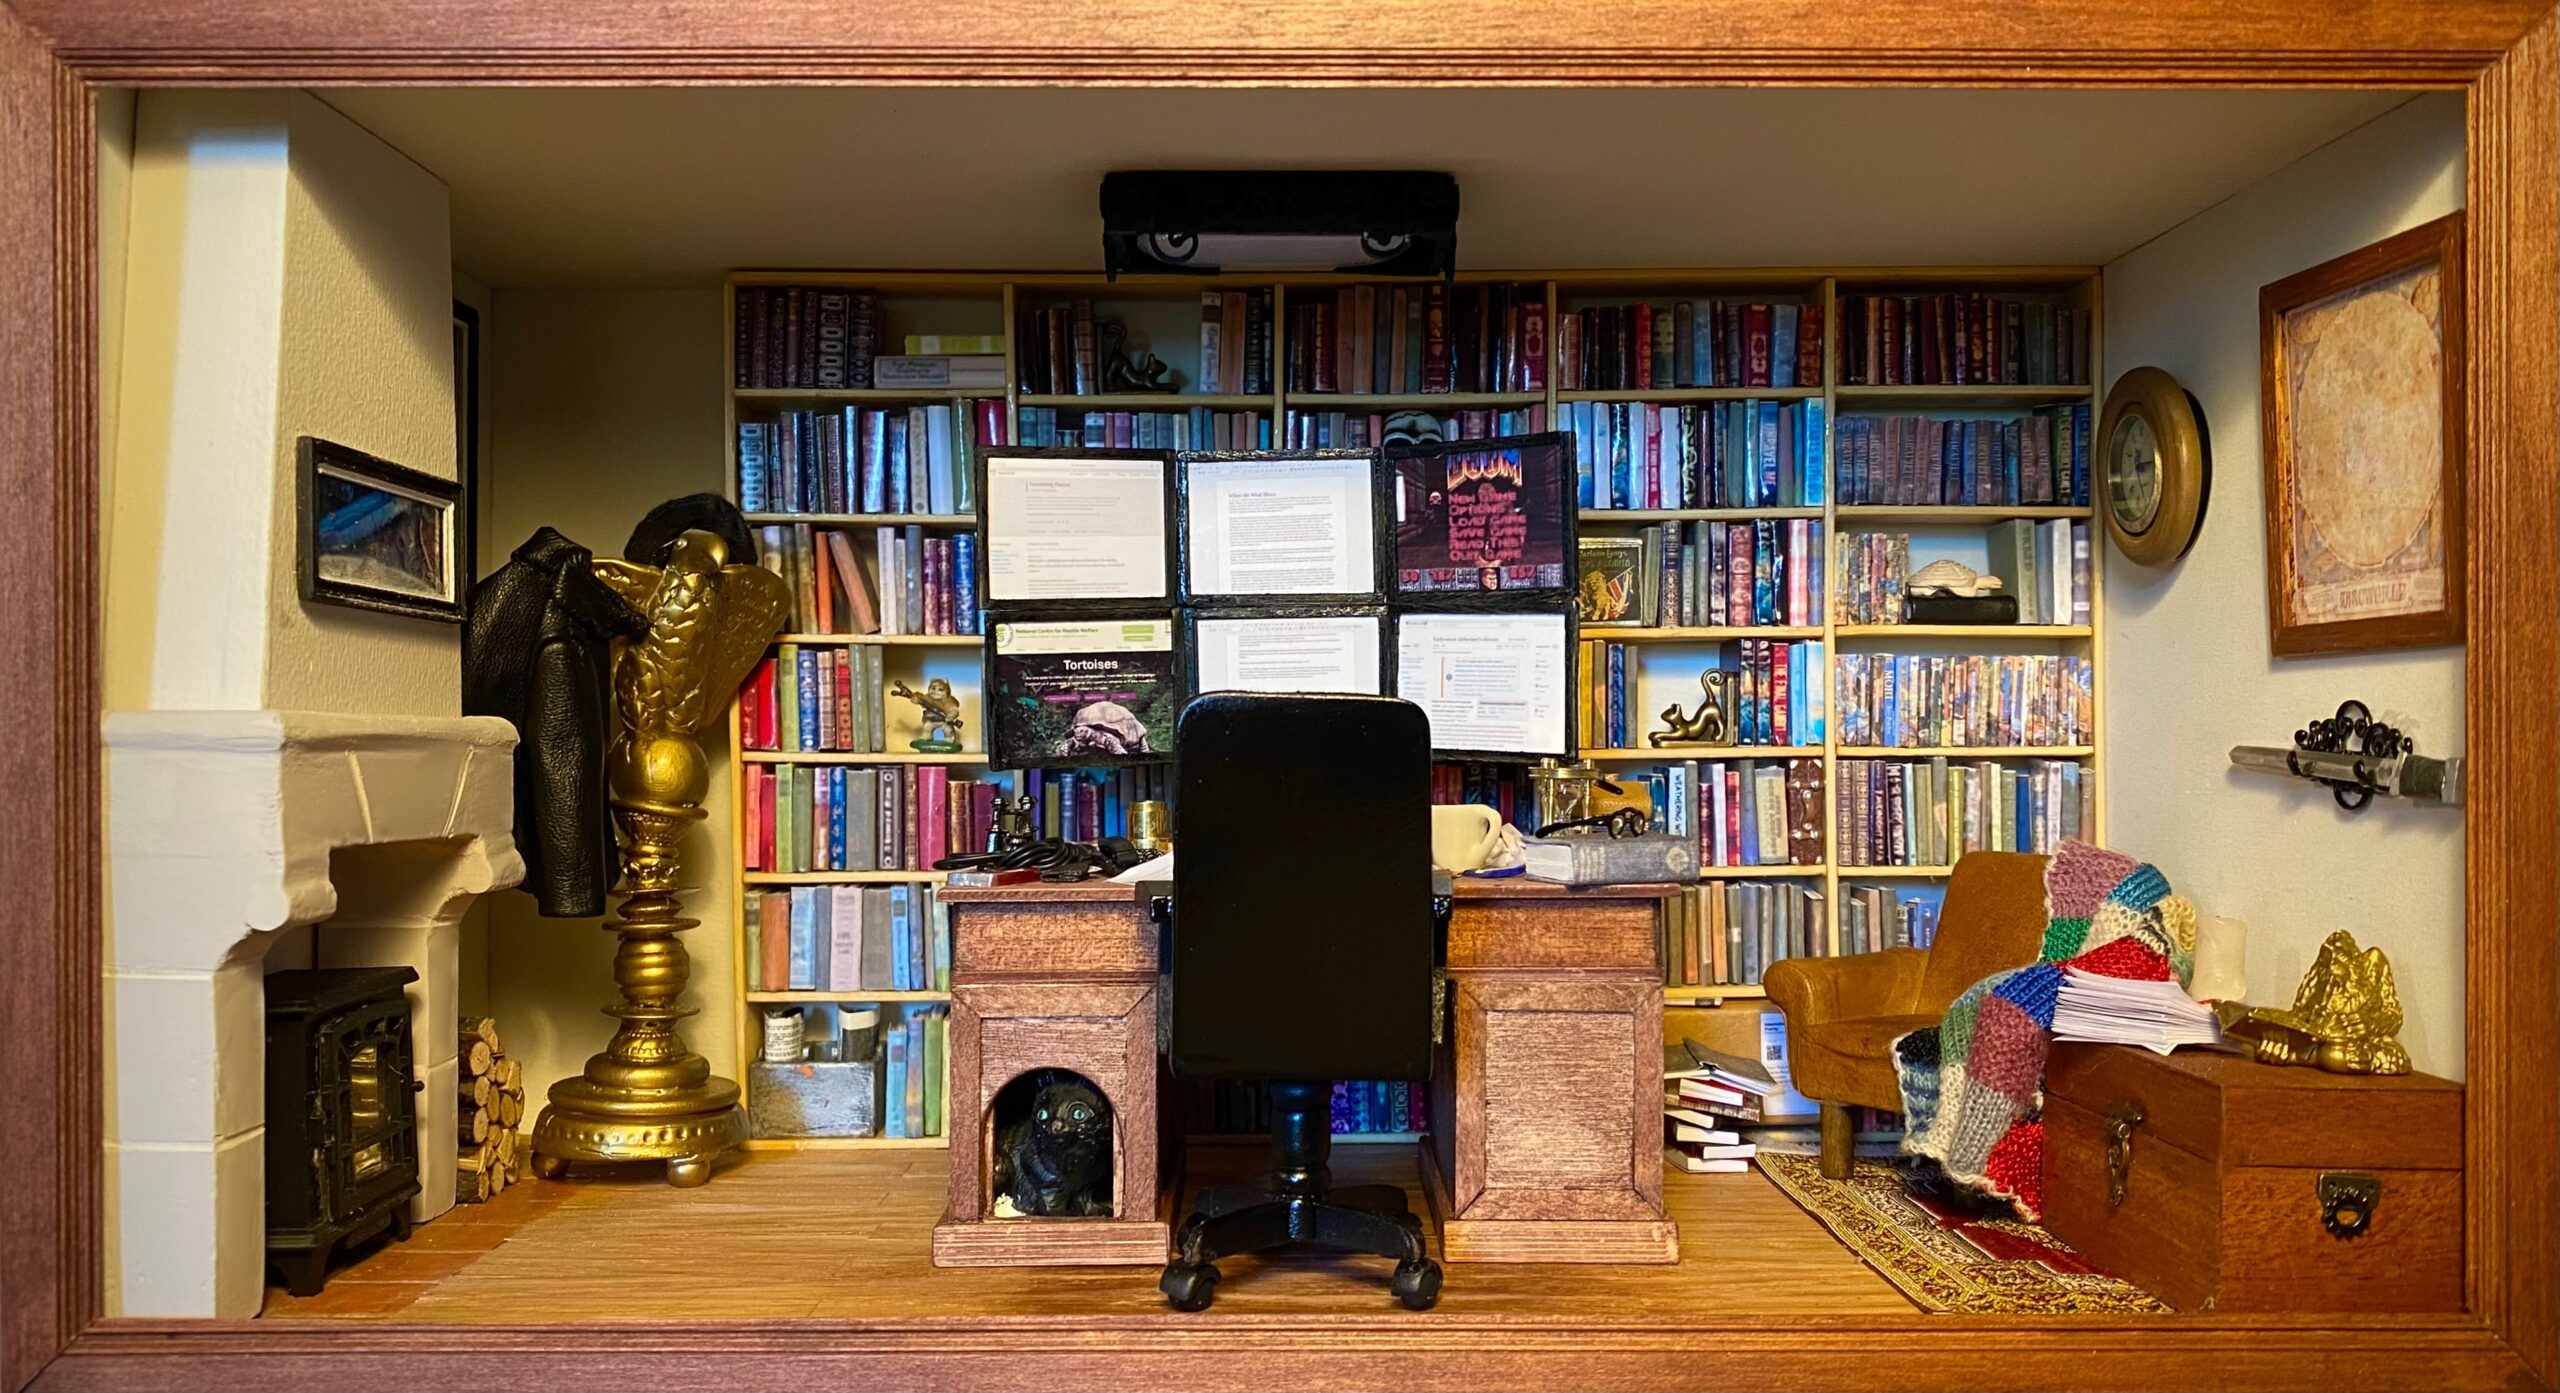
Craft Anything은 웹사이트·데스크톱 앱·모바일 앱·게임을 분석해 동일한 소프트웨어를 AI가 처음부터 다시 만드는 순수 Rust 기반 역공학 엔진이다. 대상을 지정하고 원하는 결과를 설명하면 네 단계(Study → Build → Check → Ready)를 거쳐 원본을 검사하고, 코딩 에이전트가 새 프로젝트를 생성한 뒤 원본과 비교해 정제한다. Simple 모드는 'what do you want to make'에 답하면 프로젝트 페이스 하나에서 네 단계를 진행하는 방식이고, Advanced 모드는 검사 도구·함수·의사코드·역어셈블리·16진수·콜 그래프 등 전체 워크벤치를 제공한다. 전체 요약 13문장 읽기 → 037 12:11 ▲ 111 · 댓글 31 테리 프래칫의 서재, 미니어처로 재현하다 덴마크 미니어처 제작자가 영국 판타지 작가 테리 프래칫의 서재를 1:12 축소 모형으로 재현했다. 기타 · Terry Pratchett's Study
Key Point 손으로 가죽 재킷을 바느질하고 원본 150쪽을 축소 인쇄해 담는 등, 거의 한두 달간의 압도적인 수공예 정성이 한 책 작가에게 쏟아진 사례로, 팬심의 극단을 보여준다.
핵심 요약
덴마크 미니어처 제작자가 영국 판타지 작가 테리 프래칫의 서재를 1:12 축소 모형으로 재현했다. 1.5개월간 제작한 이 프로젝트는 온라인에서 찾은 사진과 '더 커닝 아티피서' 버나드 피어슨의 조언을 바탕으로 완성됐다. 책장에는 모든 디스크월드 시리즈와 기타 프래칫 저작을 개별 제작한 책들로 채웠으며, 원본 표지를 모두 고증했다. 전체 요약 10문장 읽기 → 038 06:11 ▲ 10 · 댓글 2 불완전한 3D 포인트 클라우드에서 완전한 장면 메시 복원 이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. AI · 머신러닝 · AnchorComplete: Recovering Complete Scene Meshes from Partial Point Clouds
Key Point 3D 재구성의 오래된 문제인 보이지 않는 영역의 기하학 복원 문제를 신경망 기반으로 해결하는 새로운 방법이 나왔으며, 소수 뷰 환경에서의 성능 개선이 3D 스캔·VR·로봇 비전 등 다양한 응용에 영향을 줄 수 있다.
핵심 요약
이미지 기반 3D 재구성 방식은 주로 보이는 표면만 복원해 큰 구멍이 있는 불완전한 포인트 클라우드를 생성한다. 이를 해결하기 위해 AnchorComplete라는 프레임워크를 제안하는데, 불완전한 포인트 클라우드에서 완전한 장면 메시를 복원하면서 관찰된 기하학을 보존한다. TRELLIS.2를 기반으로 구축되었으며, 부분 포인트 조건화(global scene tokens와 local spatial evidence를 결합해 입력에 생성을 고정)와 메트릭 스케일 coarse-to-fine 생성(고정 크기 윈도우 내에서 기하학을 점진적으로 개선하면서 전역 구조 일관성 유지)을 결합한다. 전체 요약 4문장 읽기 → 039 09:11 ▲ 15 · 댓글 2 가우시안 아바타의 흐릿함·왜곡을 확산 모델로 보정 단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. AI · 머신러닝 · EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
Key Point 카메라 한 대로 촬영한 비디오나 이미지로 3D 아바타를 만들 때 피할 수 없던 흐릿함과 왜곡을 AI로 자동 보정할 수 있게 되면, 메타버스와 실시간 통신 같은 응용에서 아바타 품질을 크게 높일 수 있다.
핵심 요약
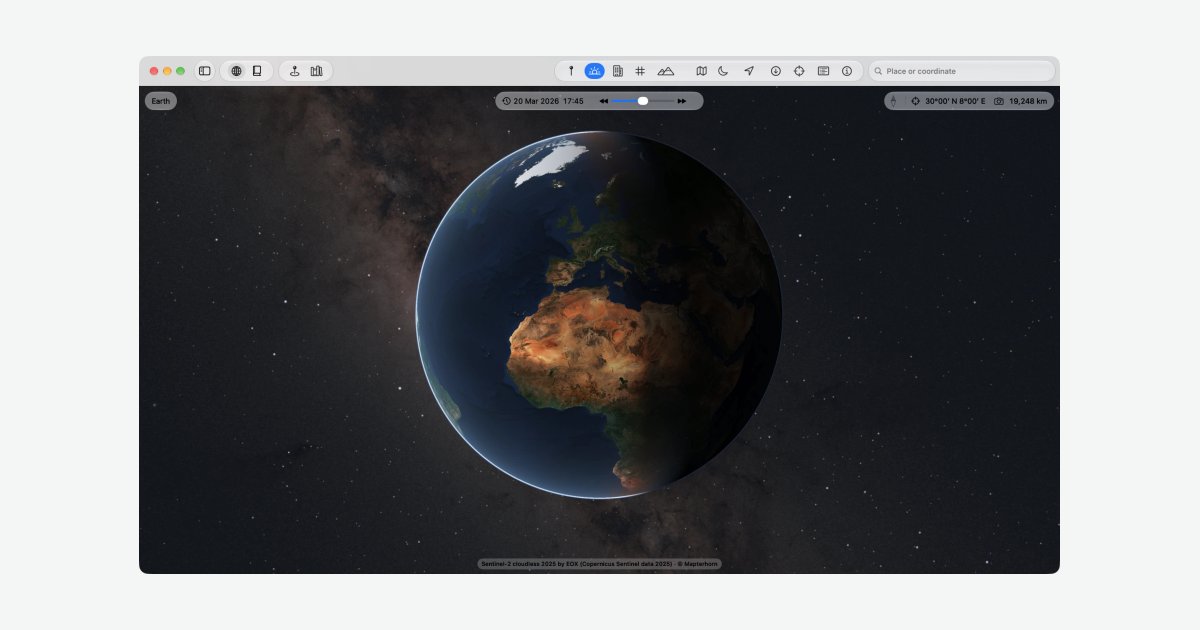
단일 이미지나 비디오로 만든 3D 아바타는 기하학과 질감이 불충분해 흐릿함, 늘어남, 시간적 불안정성 같은 결함이 생기는 문제를 다루는 논문이다. EDGAR는 조건부 확산 프레임워크로, 신원 정보를 유지하면서 가우시안 아바타의 결함을 고쳐주도록 설계했다. 학습을 위해 EDGAR-SET이라는 하이브리드 데이터셋을 만들었는데, 실제 촬영 샘플과 합성 렌더링 샘플을 섞어 열악한 가우시안 아바타 렌더링을 바닥 참값과 참조 이미지와 짝지었다. 전체 요약 8문장 읽기 → 040 21:12 ▲ 109 · 댓글 30 Mac 전용 Google Earth 대안, Kugelblitz 1.0 공개 Kugelblitz는 macOS 27 이상, Apple silicon 탑재 Mac용 무료 3D 지구 지도 앱이다. 오픈소스 · 도구 · Kugelblitz – Mac-Native Google Earth Alternative
Key Point 무료 오픈 데이터로 구축된 Mac 전용 지구 지도 앱으로, Google Earth에 비해 폐쇄적이지 않으면서 M1 Mac에서도 부드러운 성능을 제공한다.
핵심 요약
Kugelblitz는 macOS 27 이상, Apple silicon 탑재 Mac용 무료 3D 지구 지도 앱이다. OpenStreetMap과 오픈 지오데이터를 무료로 사용하며, 계정 가입이 필요 없다. imagery, 도로 지도, 지형도를 3D 지형 위에 겹쳐 표시하고, 건물까지 3D로 렌더링한다. 전체 요약 12문장 읽기 → 041 18:11 ▲ 92 · 댓글 3 로봇 조작을 위한 공간-언어-행동 통합 모델 SLA 공개 로봇 조작에는 의미 이해와 3차원 공간의 정밀한 제어가 필요하지만, 기존 시각-언어-행동(VLA) 모델들은 2D 사전학습에서 나온 시각 표현을 쓰고 공간 감각은 과제별 적응 단계에서만 학습한다. AI · 머신러닝 · SLA: Scaling Spatial-Language-Action Model via Continual Pre-training
Key Point 로봇이 현실의 다양한 상황에서 물체를 다루도록 하려면 시각과 행동뿐 아니라 공간 감각까지 기초 모델 단계에서 학습해야 하는데, SLA는 이를 실제 로봇 데이터 규모의 연속 학습으로 처음 해결한 접근이다.
핵심 요약
로봇 조작에는 의미 이해와 3차원 공간의 정밀한 제어가 필요하지만, 기존 시각-언어-행동(VLA) 모델들은 2D 사전학습에서 나온 시각 표현을 쓰고 공간 감각은 과제별 적응 단계에서만 학습한다. 공간 이해를 전이 가능한 기초 모델 능력으로 발전시키기 위해 연구팀은 SLA(Spatial-Language-Action Model)를 개발했으며, 지속적 사전학습 중 암묵적 공간 정렬을 확장하고 후속 작업 단계에서도 유지한다. SLA는 사전학습된 pi05 정책에서 시작하여 행동 예측과 중간 시각 임베딩 및 고정된 3D 인지 모델의 공간 표현 간 정렬을 공동으로 최적화한다. 전체 요약 8문장 읽기 → 042 15:10 ▲ 106 · 댓글 1 로봇 계획 25배 빠르게, 비전 모델의 구조 활용한 VFlash 로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. AI · 머신러닝 · VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
Key Point 로봇의 시각 계획 생성 속도를 획기적으로 높이면서도 정확도까지 향상시키는 기법으로, 물리 AI 시스템의 실시간 제어 가능성을 크게 높인다.
핵심 요약
로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. 기존 자동회귀 모델은 이런 시각 원시요소를 토큰 하나씩 생성하기 때문에 예측이 복잡할수록 비용이 급증한다. VFlash는 Flash Primitive Decoding 기법으로 시각 원시요소의 구조를 활용, 경량 드래프터가 전체 원시요소를 한 번의 순전파로 예측한다. 전체 요약 8문장 읽기 → 043 15:10 ▲ 18 · 댓글 2 추론 속도 7배 끌어올리는 비동기 투기형 디코딩 D3D 기존 타겟 조건 확산 드래프터는 각 블록 생성 후 타겟 모델의 숨겨진 상태를 기다려야 해 드래프팅과 검증이 순차 실행되며 속도 향상이 제한된다. AI · 머신러닝 · D3D: Decoupled Diffusion Drafting for Asynchronous Speculative Decoding
Key Point LLM 추론 병목 해결과 실시간 AI 서비스 성능 향상에 직결되는 새로운 분산 처리 기법으로, 기존 투기형 디코딩 방식의 근본적인 대기 문제를 제거했습니다.
핵심 요약
기존 타겟 조건 확산 드래프터는 각 블록 생성 후 타겟 모델의 숨겨진 상태를 기다려야 해 드래프팅과 검증이 순차 실행되며 속도 향상이 제한된다. D3D는 타겟 모델의 숨겨진 상태 없이 독립적으로 작동하는 확산 드래프터로, 블록 단위 노이징 제거와 보조 자기회귀 감독을 결합해 장기 수용 프리픽스를 달성한다. 이러한 독립성으로 D3D는 검증 중 후속 블록을 병렬로 드래프팅할 수 있어 비동기 투기형 디코딩을 가능하게 한다. 전체 요약 6문장 읽기 → 044 12:54 ▲ 103 · 댓글 35 AI 에이전트와 팀이 함께 편집하는 코드 기반 영상 편집기 키노 공개 Y Combinator S23 투자사 키노는 AI 에이전트와 팀원이 협업하는 영상 편집 플랫폼으로, 자산 보관, 리치 에디터, 리뷰 링크를 한 곳에 통합했다. AI · 머신러닝 · Launch HN: Kino AI (YC S23) – AI media manager and video editor
Key Point LLM이 에이전트로 작동하는 새로운 워크플로우에서 영상 제작 전 과정을 코드 기반으로 통합하는 도구가 등장했으며, 기존 영상 편집 방식의 기본 구조를 바꾸는 시도를 보여준다.
핵심 요약
Y Combinator S23 투자사 키노는 AI 에이전트와 팀원이 협업하는 영상 편집 플랫폼으로, 자산 보관, 리치 에디터, 리뷰 링크를 한 곳에 통합했다. Claude 등 LLM이 같은 타임라인에서 리뷰 노트와 영상 파일을 공유하며 작업할 수 있으며, 모든 편집·모션 그래픽·팀원 댓글을 코드로 표현하는 방식을 채택했다. Remotion 기반 코드 우선 접근으로 React 기반의 위지위그 에디터를 구축했으며, 사용자는 자연스럽게 단어나 코드로 편집 지시를 내릴 수 있다. 전체 요약 12문장 읽기 → 045 12:54 ▲ 101 · 댓글 44 혼합 전문가 모델 인클링 2 스몰 공개 싱킹머신즈(Thinking Machines)가 594B 파라미터(활성 17B)의 혼합 전문가 모델 인클링 2 스몰을 발표했으며, 이미지 입력과 가변 계산 노력을 지원한다. AI · 머신러닝 · Inkling 2 Small
Key Point 오픈 가중치 공개가 임박한 최신 혼합 전문자 모델로 코딩·추론·금융 작업에서 경쟁 모델을 앞서며, 자율 학습으로 모델 개선을 입증했기 때문이다.
핵심 요약
싱킹머신즈(Thinking Machines)가 594B 파라미터(활성 17B)의 혼합 전문가 모델 인클링 2 스몰을 발표했으며, 이미지 입력과 가변 계산 노력을 지원한다. 인공 분석 인텔리전스 인덱스에서 31점을 기록해 이전 세대 모델 대비 에이전트 코딩, 비전, 지식 작업, 추론 영역에서 성능이 향상됐다. 모델은 현재 틴커(Tinker)를 통해 폐쇄 가중치로 제공되며, 외부 안전 테스트와 레드팀 완료 후 다음 주 Apache 2.0 라이선스로 전체 가중치를 공개할 예정이다. 전체 요약 12문장 읽기 → 046 03:11 ▲ 101 · 댓글 82 빅데이터 수집하고도 맞춤화 실패, 기술 기업들의 아이러니 기술 기업들이 사용자 데이터를 광범위하게 수집하고 있다는 것은 이미 알려진 사실이지만, 현실은 그 데이터가 제대로 활용되지 못하고 있다. 기타 · I wish tech companies knew more about me
Key Point 기업이 수집한 엄청난 규모의 데이터가 실제로는 얼마나 부실하게 활용되는지 구체적인 사례로 폭로한 글로, 개인정보 수집 정당화 근거인 '맞춤화 서비스'의 현실을 드러낸다.
핵심 요약
기술 기업들이 사용자 데이터를 광범위하게 수집하고 있다는 것은 이미 알려진 사실이지만, 현실은 그 데이터가 제대로 활용되지 못하고 있다. 구매한 제품과 같은 상품만 반복해서 보여주거나, 이미 구매 완료한 물품의 광고를 노출하는 등 명백히 부적절한 추천이 이루어진다. Spotify와 YouTube Music에서 수년간 보컬 전자음악을 모두 스킵했지만 알고리즘은 이 패턴을 인식하지 못한다. 전체 요약 10문장 읽기 → 047 15:11 ▲ 18 · 댓글 3 반복 최적화하는 3D 구조 재구성 모델 'Solv3R' 공개 기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. AI · 머신러닝 · Solv3R: 3D Looped Transformer as a Multi-view Solver
Key Point 카메라 포즈 추정과 3D 기하 재구성을 점진적으로 개선하는 방식을 학습 가능한 솔버로 통합해, 새로운 이미지 추가나 기존 결과 정제가 자유로워졌다.
핵심 요약
기존 3D 재구성 모델은 단일 순회로 전체 기하 정보를 예측하거나 프레임을 순차적으로 처리하는 방식으로 작동하지만, 새로운 뷰를 추가하거나 기존 추정값을 정제하기 어려웠다. Solv3R은 반복 루프 구조로 현재 상태에서부터 계속 3D 기하를 풀어나가는 루프 변환기(looped transformer)이며, 이미 정제된 뷰와 새로 추가된 뷰를 함께 업데이트할 수 있다. 업데이트 연산자가 반복 횟수와 독립적으로 작동하므로, 각 뷰가 얼마나 정확한지와 관계없이 동일하게 처리된다. 전체 요약 6문장 읽기 → 048 12:11 ▲ 116 · 댓글 15 10년 추적 끝에 DOS 윙커맨더 협력 플레이 구현 저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 오픈소스 · 도구 · Show HN: After a decade of reversing, I got co-op working in DOS Wing Commander
Key Point 메모리 리버싱, 함수 훅킹, 네트워킹 프로토콜 설계를 10년간 반복해 고전 게임을 협력 플레이로 개조한 해킹의 전 과정을 담아 저수준 게임 개조와 에뮬레이터 조작의 실제 사례를 보여준다.
핵심 요약
저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 2015년 10월 DOSBox에서 게임의 모든 메모리가 640KB 안에 들어간다는 점을 발견하고, 플레이어와 윙맨의 X·Y·Z 좌표를 메모리 덤프로 찾기 시작했다. 정지 상태에서 메모리 스냅샷을 두 번 떠서 변하지 않는 배경 데이터를 제거한 뒤, 이동 시 변하는 값들을 비교해 413바이트 중 132바이트로 좌표 위치를 좁혀냈다. 전체 요약 15문장 읽기 → 049 03:11 ▲ 144 · 댓글 28 킴(Kimi) K3.1 Pro 오픈 가중치 공개 쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. AI · 머신러닝 · Kimi K3.1 Pro model weights are out
Key Point 중국 AI 스타트업이 공개한 초대형 멀티모달 모델의 가중치가 외부에 공개되어 오픈소스 커뮤니티에서 자유롭게 실험·파인튜닝할 수 있게 됐고, OpenAI·Anthropic 모델들과의 벤치마크 비교를 통해 오픈 모델의 현재 수준을 파악할 수 있다.
핵심 요약
쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. 100만 토큰 컨텍스트 윈도우를 지원하며, 코딩·3D 생성·금융 조사·사실 정확도·에이전트 기능 등에서 큰 개선을 이뤄냈다. 총 파라미터 2.8T, 활성화 파라미터 104B, 93개 레이어, 전문가 896개(토큰당 16개 활성화)의 Mixture-of-Experts 아키텍처를 사용한다. 전체 요약 10문장 읽기 → 050 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 051 09:11 ▲ 102 · 댓글 53 Lisp 기반 CAD 도구, Antimony 공개 Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 오픈소스 · 도구 · Antimony: CAD Software Evolved from Lisp Machines and Not Drafting Tables (2015)
Key Point 그래프 기반의 노드 프로그래밍 방식으로 CAD 작업을 재정의하고, 스크립트로 모든 설계 요소를 제어할 수 있는 새로운 패러다임을 제시한다.
핵심 요약
Antimony는 전통적인 제도판이 아닌 Lisp 머신 철학에서 출발한 CAD 소프트웨어로, 그래프 기반의 노드 시스템으로 설계된다. 각 노드는 Python 3.x 스크립트로 정의되며 입출력 포트를 통해 연결되고, 변경사항이 자동으로 하위 노드에 전파된다. 기하학 엔진은 불 연산(합집합·교집합·차집합)에 최적화된 함수형 표현을 사용하여 형상을 비트맵으로 렌더링한다. 전체 요약 11문장 읽기 → 052 21:11 ▲ 38 · 댓글 1 360도 파노라마도 구성미 판단해 프레이밍하는 AI 기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. AI · 머신러닝 · PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
Key Point 360도 파노라마 이미지의 최적 프레이밍을 자동으로 결정하고 설명해주는 AI 방법이 필요한 3D 콘텐츠 제작과 가상 현실 분야에서 실용적 활용이 가능해진다.
핵심 요약
기존 사진 자르기 기법은 이미 있는 이미지에서 어디를 자를지만 결정하지만, 360도 파노라마는 먼저 어느 방향을 봐야 할지 찾아야 한다. PhotoGuider는 측정 후 프레이밍 방식으로 구성미 기반 방향 선택과 최종 프레이밍을 모두 해결하는 첫 방법이다. Subject, Composition, Aesthetics, Integrity 네 가지 포토그래픽 토큰으로 구성미를 인식하는 특징을 추출하고, 기초 및 태스크 특화 비전 모델을 사용한다. 전체 요약 7문장 읽기 → 053 03:11 ▲ 100 · 댓글 29 웹GL 2 기반 3D 라이브러리 phoria2 공개 phoria2는 웹 기반 3D 렌더링을 위한 JavaScript 라이브러리로, 차트·대시보드·제품 뷰어 등을 WebGL 2 렌더러 위에서 구현할 수 있다. 웹 · 프론트엔드 · Show HN: I rebuilt my old canvas 3D library as a small WebGL 2 library – phoria2
Key Point 2013년 이후 유휴상태던 캔버스 기반 3D 라이브러리를 현대적인 WebGL 2로 재구성한 것으로, 가벼우면서도 완성도 높은 웹 3D 렌더링 도구를 찾는 개발자와 에이전트에게 선택지가 될 수 있다.
핵심 요약
phoria2는 웹 기반 3D 렌더링을 위한 JavaScript 라이브러리로, 차트·대시보드·제품 뷰어 등을 WebGL 2 렌더러 위에서 구현할 수 있다. PBR 머터리얼, 인스턴싱, 포인트, 라인, 라벨, 피킹, 섀도우, 파티클, glTF 모델 등 3D 콘텐츠 제작에 필요한 기능을 포함한다. 의존성이 없는 순수 ES 모듈로 작성되었으며, 화면 변경이 있을 때만 렌더링하는 경량 설계이다. 전체 요약 6문장 읽기 → 054 00:11 ▲ 101 · 댓글 39 3D 열 투명 망토로 물체를 열화상카메라에서 숨긴다 미국 일리노이 대학교 어베인-샤컌 캠퍼스 연구팀이 물체를 열화상카메라에서 숨길 수 있는 3차원 열 투명 망토를 개발하고 테스트했다. 하드웨어 · 시스템 · New 3D thermal invisibility cloak makes objects disappear from infrared cameras
Key Point 기존 2차원 열 망토의 한계를 극복한 3차원 전방향 열 투명화 기술이 최초로 실제 구현되어, 전자제품 냉각과 열 감지 회피 등 광범위한 응용이 가능해졌다.
핵심 요약
미국 일리노이 대학교 어베인-샤컌 캠퍼스 연구팀이 물체를 열화상카메라에서 숨길 수 있는 3차원 열 투명 망토를 개발하고 테스트했다. 기존 열 망토는 2차원이거나 열이 특정 방향에서만 올 때 작동했으나, 새 디자인은 모든 방향의 열을 물체 주위로 유도해 어떤 각도에서도 적외선상에서 물체가 보이지 않게 한다. 연구팀은 변환 열역학의 기본 원리를 재검토해 세 방향으로 독립적으로 조정 가능한 격자 구조 신소재를 개발했다. 전체 요약 11문장 읽기 → 055 21:11 당일 +115 3D 스캔을 CAD처럼 측정하는 브라우저 도구 공개 CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 하드웨어 · 시스템 · CNCKitchen/ScanRuler · TypeScript
Key Point 정밀 제조, 품질 검사, 역설계가 필요한 엔지니어에게 설계 도구 구매 비용을 줄이고 브라우저만으로 스캔 검수를 자동화할 기회를 제공한다.
핵심 요약
CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 3D 스캔 파일(STL, PLY, OBJ, 3MF, STEP)을 불러와 구, 원통, 원뿔, 평면 등을 피팅하고 치수를 측정할 수 있다. 모든 파일과 처리가 브라우저에서만 진행되며, 컴퓨터 밖으로 나가지 않는다(AI 에이전트 연결 시 제외). 전체 요약 12문장 읽기 → 056 21:11 ▲ 26 · 댓글 9 단일 영상의 3D 추적, '궤적 수리'로 개선하다 단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. AI · 머신러닝 · ReLift: Dense 3D Tracking as Lifted Trajectory Repair
Key Point 기존 2D 추적과 3D 기하 정보를 활용해 3D 추적 정확도를 높이는 새로운 접근법으로, 앞으로 나올 추적기나 기하 모델 개선의 이득을 자동으로 누릴 수 있는 구조입니다.
핵심 요약
단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. 기존 2D 추적기와 3D 기하학 모델만으로도 폐색 부분을 단순 보간한 '들어올린 궤적'이 전용 3D 추적기 수준의 성능을 낸다. 하지만 이 방식은 대응과 깊이 오차를 상속받으며, 폐색 영역에서 깊이값이 가려진 물체에서 나오는 문제가 있다. 전체 요약 7문장 읽기 → 057 21:11 당일 +120 아날로그 사진 필름 시뮬레이션을 물리 기반으로 구현 스펙트럼 데이터를 기반으로 한 아날로그 필름 렌더링 시뮬레이션을 Python으로 구현한 오픈소스 프로젝트인 spektrafilm을 GitHub에 공개했다. 오픈소스 · 도구 · andreavolpato/spektrafilm · Python
Key Point 필름 시뮬레이션을 광학·화학 원리로부터 재구성한 방식이 기존 '필름 룩' 필터와 근본적으로 다르며, 컬러 그레이딩·VFX·사진 소프트웨어 개발자들에게 실측 기반의 참조 구현을 제공한다.
핵심 요약
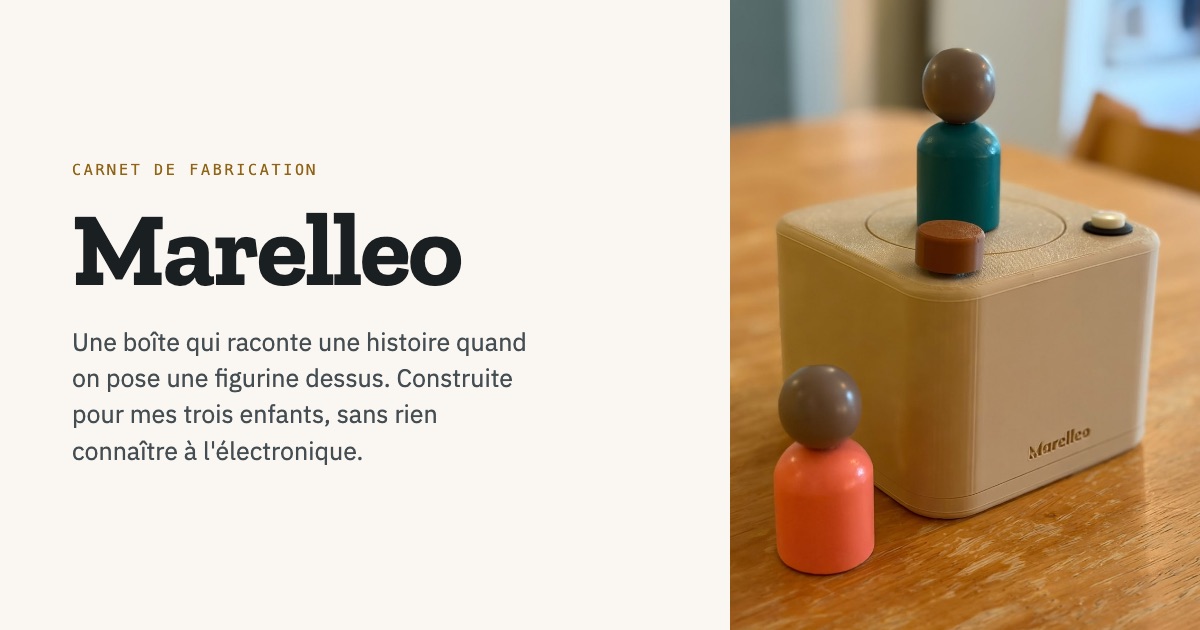
스펙트럼 데이터를 기반으로 한 아날로그 필름 렌더링 시뮬레이션을 Python으로 구현한 오픈소스 프로젝트인 spektrafilm을 GitHub에 공개했다. 카메라 RAW 파일에서 시작해 가상의 네거티브를 거쳐 인화지와 스캔 파이프라인을 통과하도록 모델링했으며, 제조사 데이터시트에서 추출한 스펙트럼 감도와 밀도 곡선을 활용한다. 필름 유제에 함유된 커플러(couplers) 화학물질이 노출된 부분을 중심으로 인접 레이어의 색 간섭을 줄이고 채도를 높이는 효과를 구현했다. 전체 요약 8문장 읽기 → 058 00:11 ▲ 127 · 댓글 36 톤박스 대신 직접 만든 오픈소스 이야기 상자, ESP32로 톤박스처럼 피규어를 올리면 이야기가 나오는 상자를 ESP32와 RFID로 만들었다. 하드웨어 · 시스템 · Show HN: Marelleo, an open-source story box I built for my kids using ESP32
Key Point 오픈소스 하드웨어 프로젝트의 전체 개발 과정을 보여주는데, 초보자가 전자회로 설계부터 PCB 제조, 펌웨어 업데이트까지 실제로 마주치는 문제들과 해결책을 구체적으로 기록했다.
핵심 요약
톤박스처럼 피규어를 올리면 이야기가 나오는 상자를 ESP32와 RFID로 만들었다. 구독 모델 대신 자신의 음성 녹음, 팟캐스트, 라디오 스트림 등 모든 콘텐츠를 직접 관리하도록 설계했다. 안전을 위해 브레드보드 대신 완전한 PCB로 설계했고, 처음 설계했음에도 불구하고 재작업 없이 완벽하게 작동했다. 전체 요약 11문장 읽기 → 059 00:11 ▲ 103 · 댓글 101 구글, Android XR 기반 유선 XR 안경 'XREAL AURA' 출시 구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. AI · 머신러닝 · The first wired XR glasses powered by Android XR
Key Point Android XR을 탑재한 첫 유선 XR 안경으로, 가벼운 설계·강력한 AI 지원·다양한 앱과 게임·업무용 유선 미러링 기능을 갖춘 모바일 XR 기기 시장의 새로운 옵션이 출시된 것이다.
핵심 요약
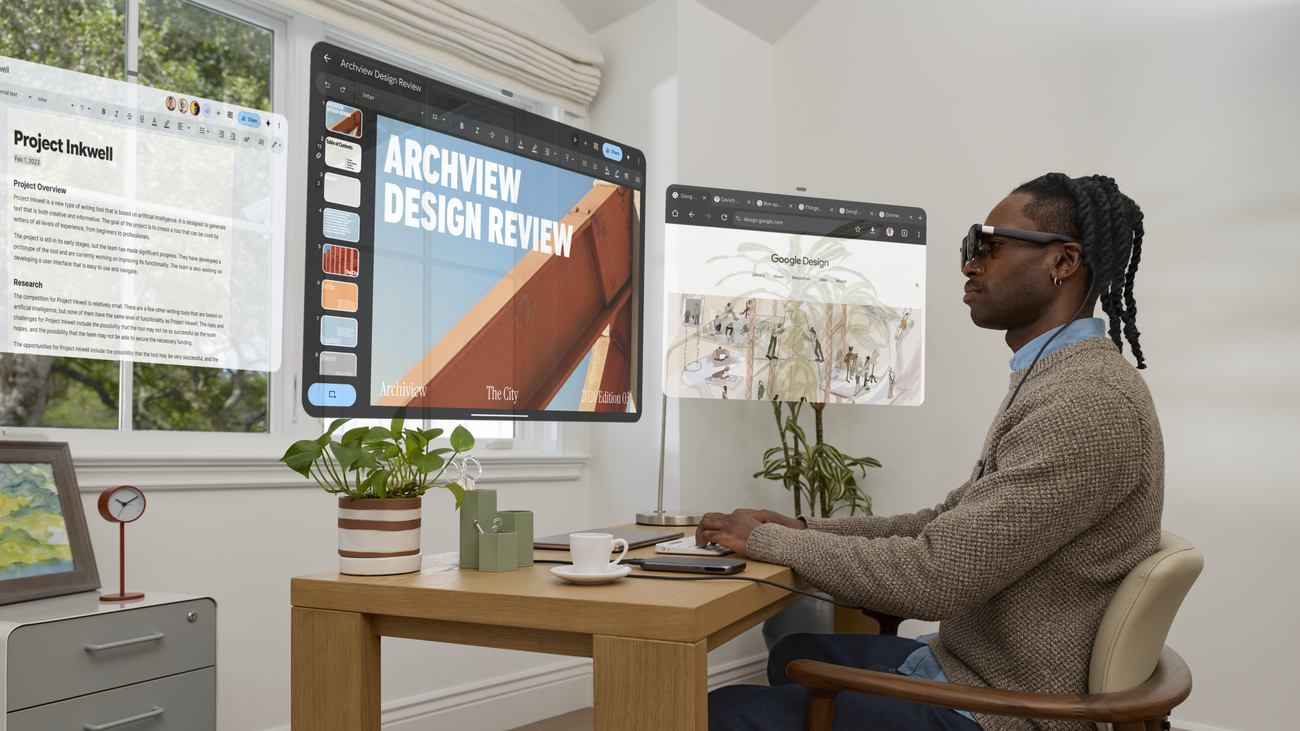
구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. 투명 렌즈로 실제 세계를 보면서 70도 시야각으로 공간 콘텐츠를 투영하며, 95g 미만의 가벼운 무게는 케이블로 연결된 별도 컴퓨트 퍽에 Snapdragon Reality Elite 칩과 배터리를 실어 구현한다. Gemini가 사용자의 행동과 화면을 이해해 자연스러운 대화로 도움을 주며, Google Play의 150개 이상 XR 전용 앱을 포함한 수백만 개 앱을 실행할 수 있다. 전체 요약 13문장 읽기 → 060 21:11 당일 +100 Godot 4용 고성능 지형 편집 시스템 Terrain3D 공개 C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 하드웨어 · 시스템 · TokisanGames/Terrain3D · C++
Key Point Godot 엔진으로 대규모 야외 지형 게임을 만드는 개발자가 고성능 지형 시스템을 바로 도입할 수 있게 되었으며, 다양한 3D 도구와의 호환성이 워크플로우를 단순화한다.
핵심 요약
C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 64x64m부터 65.5x65.5km(약 4,295km²)까지 가변 크기의 연속되지 않은 지역들을 지원하며, 최대 32개 텍스처와 10단계 LOD(레벨 오브 디테일)을 제공한다. 식생 인스턴싱, 음영 임포스터, 지형 조각, 구멍 뚫기, 텍스처 칠하기, 색상 및 습도 칠하기 등의 편집 기능을 포함한다. 전체 요약 5문장 읽기 → 061 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 062 18:11 ▲ 40 · 댓글 5 실시간 무한 세계 생성, 3D 가우시안 메모리로 해결 사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. AI · 머신러닝 · L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
Key Point 3D 메모리를 VAE 인코딩 없이 직접 활용하고 메모리 사용량을 크기에 따라 최적화해 실시간 무한 세계 생성이 실제로 가능해진 기술이다.
핵심 요약
사용자 행동에 따라 시각 콘텐츠를 생성하는 인터랙티브 월드 모델에서 장기간 탐색 시 공간 일관성을 유지하기가 어려운 상황을 다룬다. 기존 방식은 시간적 맥락이나 명시적 3D 메모리에 의존하지만 생성 스트림 길이에 따라 메모리가 증가해 확장성이 떨어진다. 또한 명시적 3D 메모리는 RGB 렌더링을 다시 인코딩해 잠재 비디오 생성기를 조건화하므로 실시간 생성이 불가능하다. 전체 요약 9문장 읽기 → 063 18:11 ▲ 23 · 댓글 2 단일 이미지에서 애니메이션 가능한 스타일 헤어 생성 게임과 아바타의 캐릭터 머리카락은 아티스트가 배치한 리본 모양의 헤어 카드로 구성되며, 스프링 본으로 애니메이션된다. AI · 머신러닝 · HairDeck: Animation-Ready Stylized Hair Cards from a Single Image
Key Point 게임 캐릭터와 아바타의 머리카락을 제작하는 과정에서 기존 방식보다 정확하고 빠르게 애니메이션 가능한 자산을 생성할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
게임과 아바타의 캐릭터 머리카락은 아티스트가 배치한 리본 모양의 헤어 카드로 구성되며, 스프링 본으로 애니메이션된다. 기존 이미지 기반 방법들은 사실적인 머리카락이나 단일 메시만 생성했고, CHARM은 유일한 스타일 헤어 카드 생성기이지만 제어점을 자동회귀로 긴 수열로 디코딩했다. 헤어 카드 스타일이 아티스트 정의 요소의 순서 없는 집합이라는 점에 착안하여 HairDeck을 제안한다. 전체 요약 7문장 읽기 → 064 15:11 ▲ 103 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 065 12:11 ▲ 135 · 댓글 90 포밍랩스, $699 수지 3D 프린터 'Form Studio 1' 출시 포밍랩스(Formlabs)가 저가 전문급 수지 3D 프린터 'Form Studio 1'을 Founders Edition으로 출시했다. 하드웨어 · 시스템 · Formlabs Studio 1 $699 Resin Printer
Key Point 전문가급 기능을 갖춘 수지 프린터가 $699라는 진입 가격에 처음 출시되어, 소규모 제조업체, 디자이너, 창작자들의 접근성이 크게 낮아진다.
핵심 요약
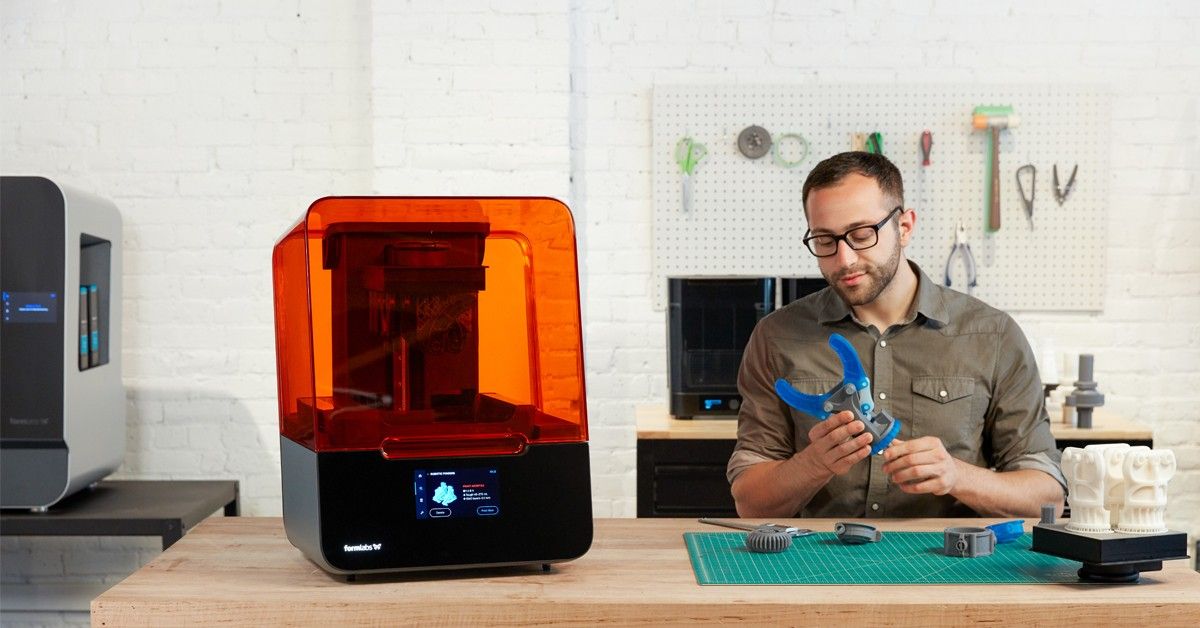
포밍랩스(Formlabs)가 저가 전문급 수지 3D 프린터 'Form Studio 1'을 Founders Edition으로 출시했다. 마스크드 스테레오리소그래피(MSLA) 기술을 사용하며, 대부분의 부품을 2시간 이내에 인쇄할 수 있다. 빌드 볼륨은 20.0 x 12.5 x 23.5 cm(5.9리터)이며, 개방형 플랫폼으로 포밍랩스의 9가지 소재 또는 써드파티 재료를 사용할 수 있다. 전체 요약 11문장 읽기 → 066 03:11 ▲ 232 · 댓글 78 중세 석상 건축, CNC 기술로 되살리다 고딕 건축의 정교한 석조 세부 작업을 CNC 기계가 자동화하면서 수개월 걸리던 조각이 며칠 안에 완성되고 있다. 하드웨어 · 시스템 · CNC Stone Carving
Key Point 중세 건축 미학의 정교함을 현대 기술로 다시 구현할 수 있게 되었으며, 컴퓨터 세대가 전통 기술의 고급 수준으로 진입하는 새로운 경로가 열렸다.
핵심 요약
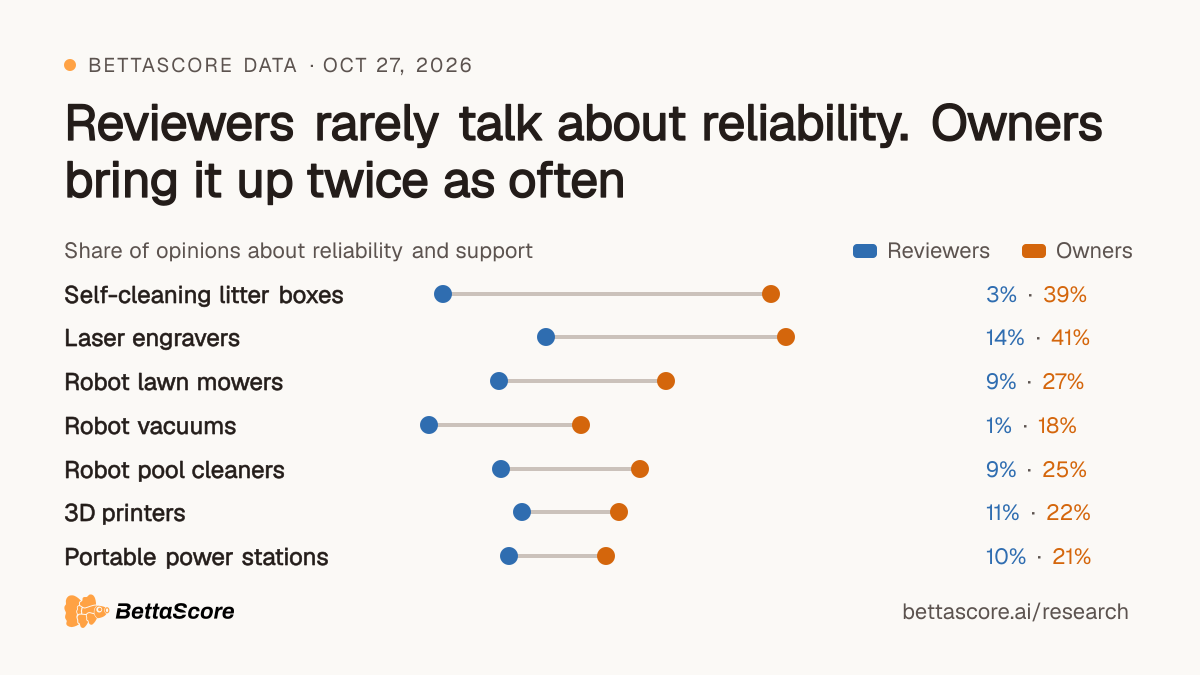
고딕 건축의 정교한 석조 세부 작업을 CNC 기계가 자동화하면서 수개월 걸리던 조각이 며칠 안에 완성되고 있다. CNC는 '컴퓨터 수치 제어' 방식으로 XYZ 좌표를 통해 기계 움직임을 제어하며, 다이아몬드 팁 블레이드로 석재를 깎아낸다. 석상 조각용 CNC는 보통 5개 축을 가져 좌우·상하·전후 이동과 2가지 방향 회전이 가능하며, 6번째 축으로 선반을 더하기도 한다. 전체 요약 11문장 읽기 → 067 15:11 ▲ 102 · 댓글 80 리뷰어는 신뢰성을 외면하고 실사용자는 두 배로 강조한다 BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 기타 · Reviewers rarely talk about reliability. Owners bring it up twice as often
Key Point 실사용자만 드러내는 신뢰성 문제를 리뷰어는 놓치고 있으며, 같은 제품도 시간이 지날수록 실제 가치와 다른 평가를 받는다는 점이 구매 결정에 큰 영향을 미친다.
핵심 요약
BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 리뷰어는 신뢰성과 내구성, 지원에 관해 전체 의견의 7.8%만 언급한 반면, 실제 사용자는 17.0%로 두 배 이상 자주 다뤘다. 13개 카테고리에서 사용자가 신뢰성을 더 많이 언급했으며, 로봇청소기(리뷰어 1% vs 사용자 18%), 자동 묘사함(3% vs 39%), 레이저 각인기(14% vs 41%)의 격차가 특히 크다. 전체 요약 12문장 읽기 → 068 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 069 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 070 12:11 ▲ 100 · 댓글 71 전설의 초고속 여객선, 세계 최대 인공어초로 침몰 1951년 건조된 SS United States는 1952년 처녀항해에서 대서양 횡단 속도 기록(3일 10시간 40분)을 세우며 Blue Riband를 획득했고, 영국의 RMS Queen Mary 기록을 10시간 2분 단축했다. 기타 · SS United States to be sunk as largest artificial reef
Key Point 선박 분야 역사에 남을 초대형 프로젝트가 11월에 실행되는 시점에, 세계 기록 보유 여객선을 인공어초로 침몰시키기 위한 준비 상황과 예상 영향을 파악할 수 있습니다.
핵심 요약
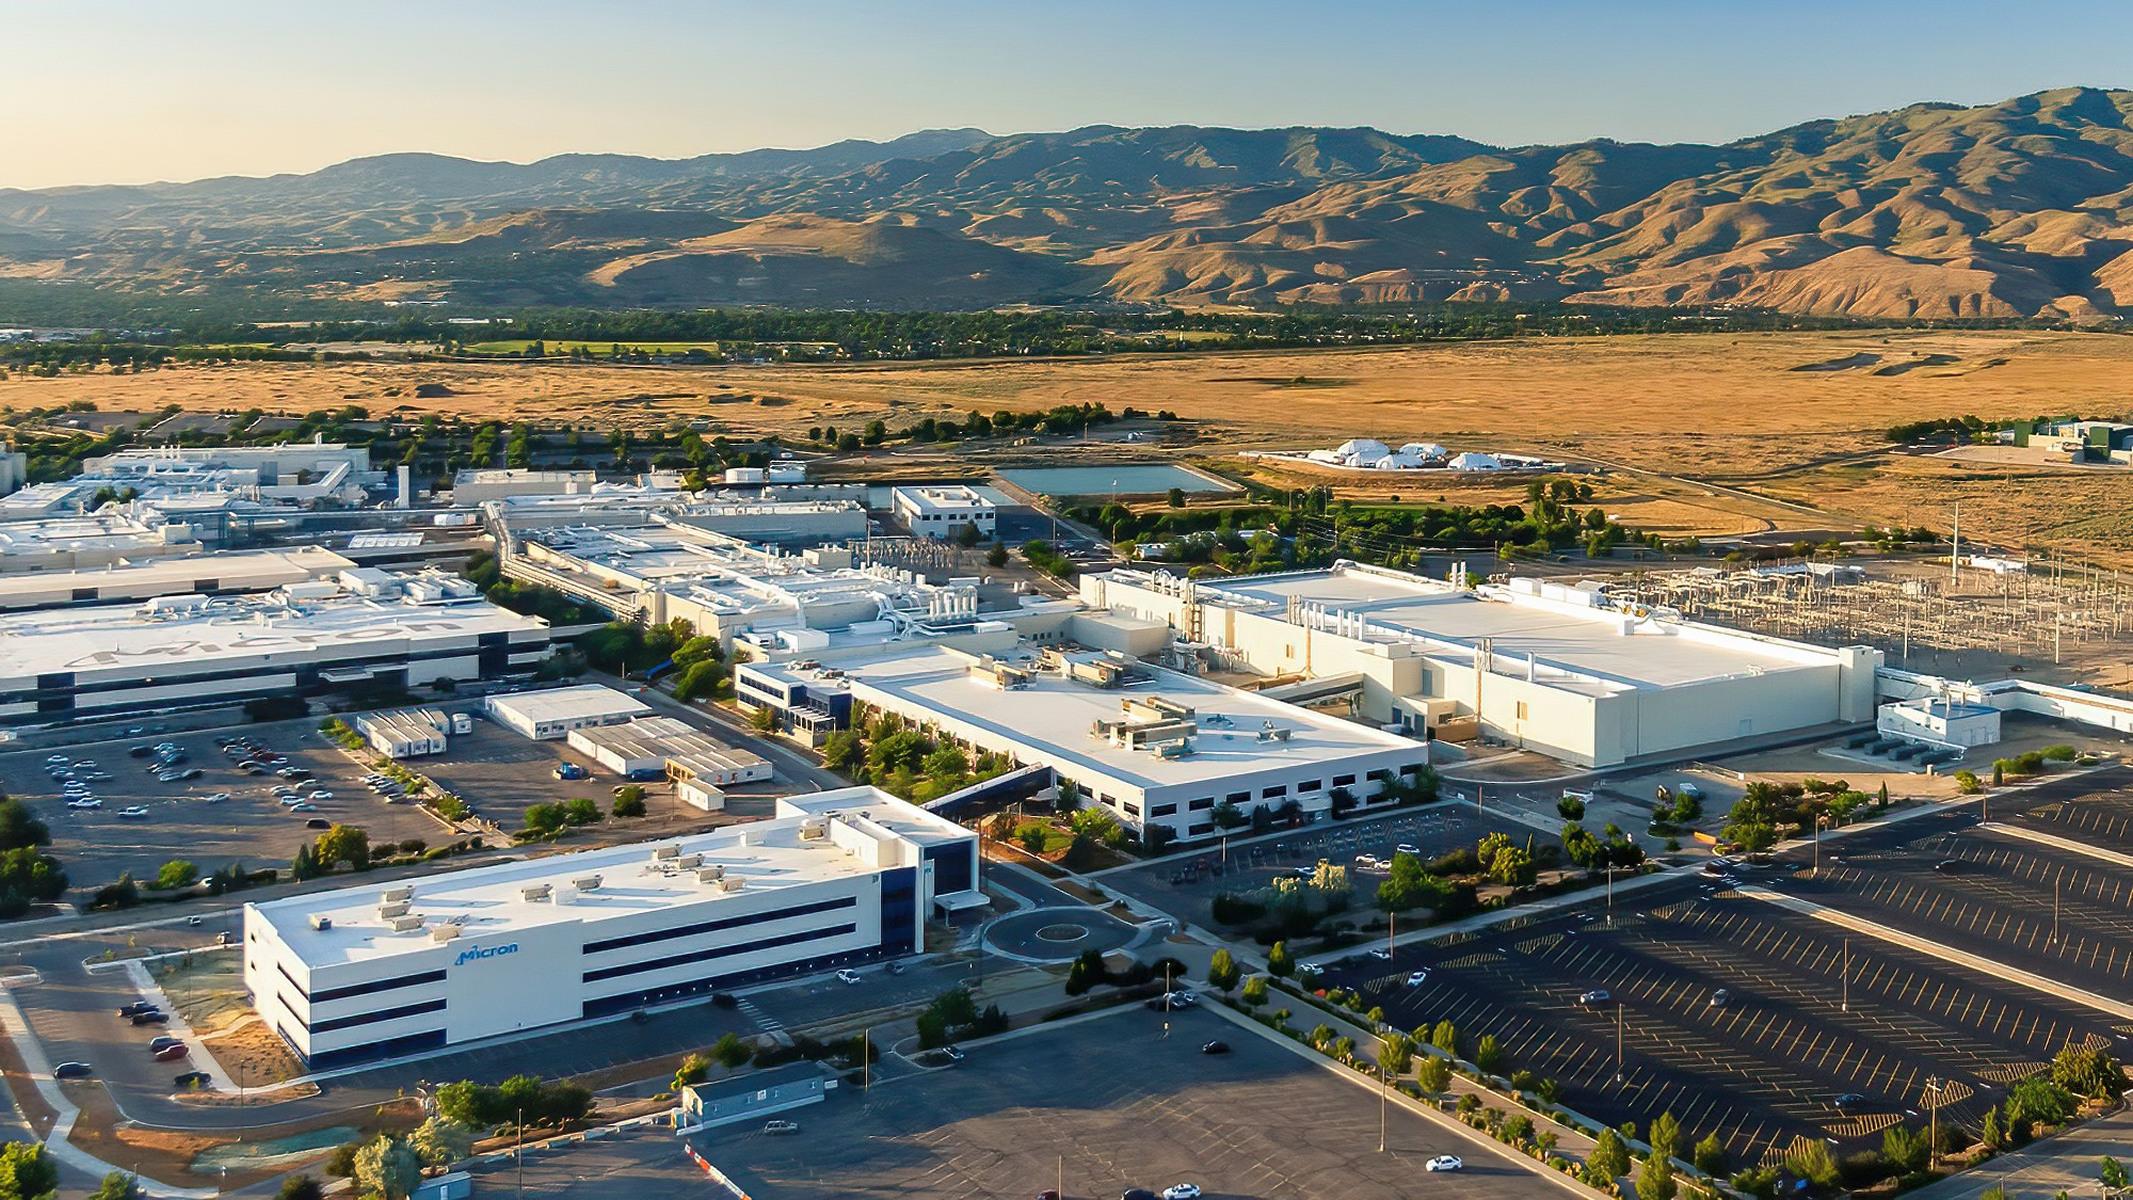
1951년 건조된 SS United States는 1952년 처녀항해에서 대서양 횡단 속도 기록(3일 10시간 40분)을 세우며 Blue Riband를 획득했고, 영국의 RMS Queen Mary 기록을 10시간 2분 단축했다. 1969년 운영비 증가로 항해를 멈춘 후 40년 이상 Philadelphia 부두에 방치되었으나, 2011년 SS United States Conservancy에 매수되어 고급 워터프론트 개발 계획이 추진됐다. 2024년 9월 부두 임차료 분쟁으로 퇴출 명령을 받은 후 2025년 2월 Philadelphia를 떠나 3월 Alabama Mobile에 도착했고, 침몰 준비를 위한 대규모 해체·정제 작업이 진행 중이다. 전체 요약 11문장 읽기 → 071 06:11 ▲ 114 · 댓글 17 마이크론이 4F² DRAM 포기, 3D 메모리로 방향 선회 마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. 하드웨어 · 시스템 · Why Micron Is Suddenly Ditching 4F² DRAM as Rivals Double Down
Key Point 경쟁업체들이 4F² DRAM에 투자할 때 마이크론만 반대 방향으로 가는 이유와, DRAM 미세화의 물리적 한계가 어디까지인지 이해할 수 있다.
핵심 요약
마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. DRAM 밀도는 셀 면적보다 커패시터 간격에 의해 결정되는데, 6F²에서 4F²로 축소해도 밀도 개선 효과가 미미하면서 비용과 복잡도만 급증한다. 마이크론은 1δ(델타) 고밀도 메모리 양산에 박차를 가하고 있으며, 1ε(엡실론)에서는 첨단 웨이퍼 본딩 기술을 적용한다. 전체 요약 8문장 읽기 → 072 00:11 ▲ 11 · 댓글 2 단일 이미지에서 3D 장면 재구성, 객체 기반 접근법으로 품질 향상 단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. AI · 머신러닝 · Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
Key Point 3D 장면 재구성 품질을 높이는 새로운 구성 방식의 등장으로, 컴퓨터 비전 모델 설계 방향을 보여주는 선례입니다.
핵심 요약
단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. 연구팀은 Easy-3Dfy라는 구성 기반 워크플로우를 제안했으며, 이는 객체 생성과 장면 배치 추정을 분리해 각 모델의 강점을 활용한다. 특화된 3D 객체 생성기는 상세한 객체 기하학을, 3D 기초 모델은 강력한 공간 이해를 각각 담당하도록 설계했다. 전체 요약 6문장 읽기 → 073 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 074 21:11 ▲ 139 · 댓글 102 로블록스가 145GB 모델 무단 다운로드, 성인 콘텐츠 포함 로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. AI · 머신러닝 · Roblox downloaded 145GB models from us (including adult content) without asking
Key Point 대형 AI 기업이 무단으로 수집한 데이터가 AI 학습에 어떻게 악용되는지, 그리고 개인과 대기업을 차별하는 저작권 집행의 불평등 문제를 구체적 사례로 보여주기 때문입니다.
핵심 요약
로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. 크롤러는 'trellis2-data-sourcing/1.0'이라는 사용자 에이전트를 사용해 34시간에 걸쳐 18,926개 프로젝트의 메인 페이지를 읽었고, robots.txt를 무시하고 약관 위반 및 저작권 침해를 범했다. 다운로드 대상의 62.6%인 345개 프로젝트가 성인 콘텐츠였으며, 이 중 423개는 비상업적 이용만 가능한 라이선스였다. 전체 요약 13문장 읽기 → 075 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 076 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 078 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 080 18:11 ▲ 114 · 댓글 56 N64 레이싱 게임 F-Zero X을 닌텐도 3DS로 이식 완료 F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 하드웨어 · 시스템 · F-Zero X on Nintendo 3DS
Key Point AI 에이전트 147개를 동원해 N64 게임을 3DS로 이식한 대규모 자동화 개발 프로젝트의 전체 과정과 최적화 기법, 비용 투명성을 공개한 사례로, 현대 AI 보조 개발의 스케일과 효율성을 보여준다.
핵심 요약
F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 첫 번째 단계(8월 11일~9월 3일)에서 New 3DS에서 3D 스테레오스코픽으로 60fps 달성했으며, 한 명의 디렉터와 147개 이상의 AI 에이전트가 참여했다. 두 번째 단계(9월 7일~10월 19일)에서 Old 3DS 지원, 네이티브 렌더러, N64 64DD 익스팬션 킷 기능을 추가했다. 전체 요약 13문장 읽기 → 081 18:11 ▲ 142 · 댓글 41 모든 키가 분리되는 블루투스 모듈식 키보드 오픈소스 공개 Keybytes는 각 키가 독립적인 1u PCB 모듈로 구성되고 자유롭게 배치할 수 있는 모듈식 키보드 프로젝트다. 하드웨어 · 시스템 · Show HN: A Truly Modular Keyboard
Key Point 각 키가 완전히 분리된 마이크로컨트롤러 모듈 구조로 진정한 의미의 모듈화를 구현했으며, 블루투스와 배터리 충전까지 한 PCB에서 해결한 하드웨어 설계 접근이 주목할 만합니다.
핵심 요약
Keybytes는 각 키가 독립적인 1u PCB 모듈로 구성되고 자유롭게 배치할 수 있는 모듈식 키보드 프로젝트다. 키 모듈(Keybit)은 Cherry MX 스위치와 CH32V003 RISC-V 마이크로컨트롤러를 탑재하며, 네 면에 포고 핀으로 전원과 I2C를 연결해 다른 키나 메인 보드와 통신한다. 메인 보드(Keyword)는 STM32WB55RGV6 칩으로 블루투스와 USB를 지원하며, 2MB QSPI 플래시(W25Q16JV)에 키 펌웨어를 저장한다. 전체 요약 8문장 읽기 → 082 18:11 ▲ 120 · 댓글 79 애플 폴딩폰, 분해 테스트 공개 애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 하드웨어 · 시스템 · iPhone Duo Teardown
Key Point 폴딩폰이 초기 수리성 평가를 받는 것은 드문데, 애플의 첫 번째 폴딩 시도가 실제로 어떤 구조를 가졌는지, 그리고 왜 초기 불량이 발생했는지를 기술 증거로 밝혀낸 정밀한 분석이다. 특히 999달러의 수리비 책정 이유를 엔지니어링 관점에서 이해할 수 있다.
핵심 요약
애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 듀오의 내부 디스플레이는 나노텍스처 코팅으로 주름을 숨긴다. 미세한 돌기가 빛을 산란시켜 반사를 부드럽게 하는데, 코팅을 제거하면 주름이 다른 폴딩폰보다 더 잘 보인다. 일부 서브픽셀이 타원형이며 방향이 다르게 배치되어 있다. 애플 특허에 따르면 이는 기하학적 디더링으로 회절 아티팩트를 줄이는 기술이다. 전체 요약 12문장 읽기 → 083 12:11 ▲ 106 · 댓글 43 디즈니 애니메이션의 제작 과정, 차근차근 파헤치다 애니메이션 영화는 평균 90분이며 수십 개의 시퀀스(1~7분)로 구성되고, 각 시퀀스는 여러 샷(0~30초)으로 이루어지며, 초당 24프레임으로 렌더링된다. 기타 · What goes into making an animated film?
Key Point 애니메이션 영화의 복잡한 제작 과정을 개발부터 포스트 프로덕션까지 체계적으로 이해할 수 있으며, 각 단계의 구체적 규모(프레임 수, 시간)와 부서 간 협력 방식을 알 수 있다.
핵심 요약
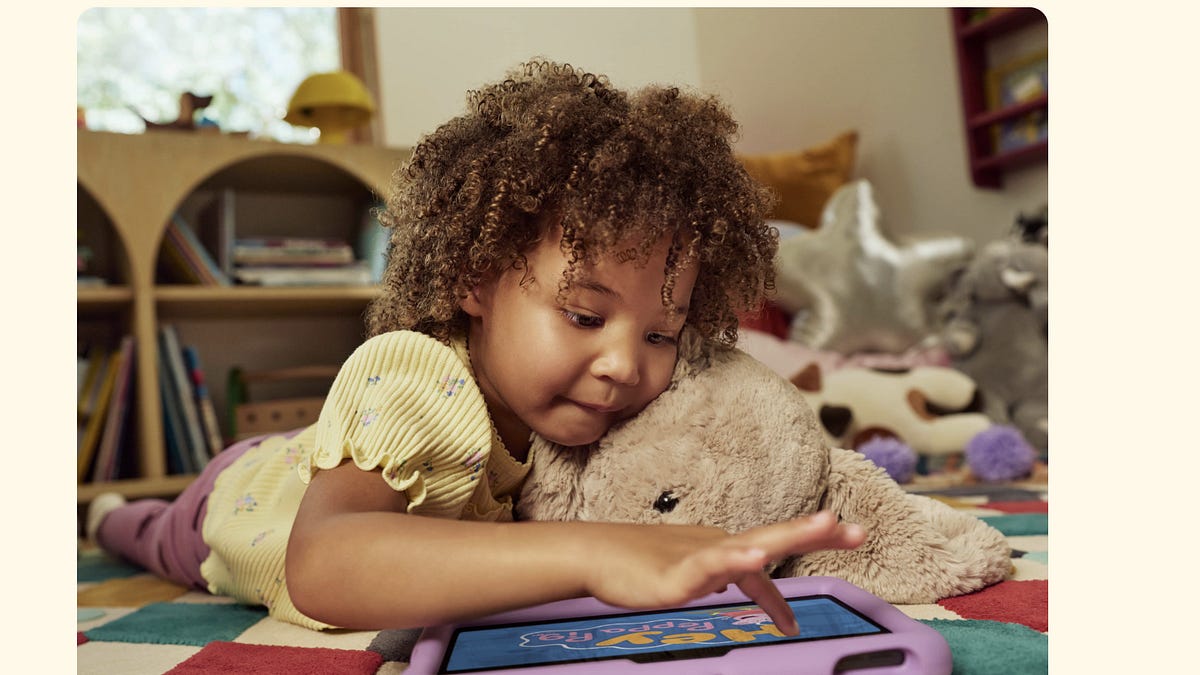
애니메이션 영화는 평균 90분이며 수십 개의 시퀀스(1~7분)로 구성되고, 각 시퀀스는 여러 샷(0~30초)으로 이루어지며, 초당 24프레임으로 렌더링된다. 스테레오 3D의 경우 좌안과 우안을 위해 프레임이 2배가 되어, 주토피아 2는 총 288,710개 프레임을 렌더링했다. 완성까지 평균 3~5년이 소요되며, 개발 단계부터 시작해 스토리 개발, 캐스팅, 자산 생성이 이루어진다. 전체 요약 7문장 읽기 → 084 12:11 ▲ 109 · 댓글 163 아마존의 영유아용 태블릿, 발달 문제 우려 속 출시 아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 스타트업 · 비즈니스 · Amazon's "digital pacifier" for toddlers
Key Point 영유아 발달을 위해 의도적으로 피해야 할 활동을 상품으로 만들어 마케팅하는 기업의 실태와 그 영향을 보여주며, 부모들이 선택할 때 고려해야 할 과학적 근거들을 제시합니다.
핵심 요약
아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 미시간 대학 소아과 의사 제니 래드스키 교수는 태블릿이 아이의 "항상 곁의 친구" 역할을 해 행동 관리와 진정 용으로 활용되는 것이 문제라며, 동봉된 손잡이가 일상적 휴대를 의도한 설계라고 지적했다. 제너레이티브 AI 기능(이미지 생성, 이야기 만들기)을 포함한 아마존의 '창의적' 마케팅은 아이들의 독립적 사고력을 해칠 수 있다고 우려했다. 전체 요약 12문장 읽기 → 085 18:11 ▲ 106 · 댓글 7 작은 프로그램과 언어가 지닌 매력 작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 오픈소스 · 도구 · Small Programs and Languages
Key Point 작은 프로그램과 언어의 구현이 단순한 취미를 넘어 프로그래밍의 본질적 복잡도를 증명하는 의미 있는 작업이며, 개발자의 이해와 통제 욕구를 충족하는 설계 원칙을 제시한다.
핵심 요약
작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 역사적 사례들이 작은 구현의 가능성을 보여준다. philippe Brochard의 46바이트 Forth, Arthur Whitney가 한 오후에 작성한 122줄 J 언어 인터프리터, 90KB 부팅 가능 이미지의 kOS 운영체제 등이 그 예다. 코드 골프와 최소화는 재미만이 아니라 의미 있는 작업이다. 콜모고로프 복잡도 관점에서, 작은 구현들은 프로그램의 최소 복잡도를 드러낸다. 전체 요약 13문장 읽기 → 086 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 087 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 088 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 089 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 090 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 091 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 092 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 093 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 094 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 095 15:11 ▲ 106 · 댓글 27 ZFS 내부 구조를 보여주는 인터랙티브 박물관 공개 ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. 인프라 · 데브옵스 · Show HN: Uberblok – an interactive museum of ZFS internals
Key Point ZFS 파일 시스템의 내부 동작 원리를 인터랙티브하게 학습할 수 있는 독창적인 학습 도구로, 인프라 엔지니어와 저수준 시스템 관심층이 ZFS의 데이터 안정성 메커니즘을 깊이 있게 이해할 수 있게 한다.
핵심 요약
ZFS 파일 시스템의 핵심인 'uberblock'을 설명하는 인터랙티브 박물관 사이트가 공개되었다. Uberblock은 크래시 후 시스템이 현재의 일관된 상태를 찾을 수 있게 해주는 작은 레코드로, 트랜잭션 그룹 번호와 루트 블록 포인터를 담는다. 디스크의 각 라벨에는 128 KiB 링 버퍼에 uberblock들이 저장되며, 새로운 uberblock은 이전 것을 덮어쓰지 않고 순환 구조로 저장된다. 전체 요약 8문장 읽기 → 096 15:11 ▲ 112 · 댓글 12 느리게 움직이며 제대로 고치기 저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 스타트업 · 비즈니스 · Move Slow and Fix Things (2024)
Key Point 창업의 의무화, VC 자금의 필수성, 지수적 성장 추구라는 기존 규범에 정면 도전하며, 지속 가능한 소규모 사업이 실질적 선택지임을 구체적으로 설명합니다.
핵심 요약
저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 지난 15년간 오픈소스 기여와 부트스트랩 사업으로 얻은 경험을 통해 지속 가능한 성장, 견고한 솔루션, 장기적 사고방식의 가치를 깨달았다. Uber, Facebook, Google 같은 유니콘 기업들은 사용자 추적, 과도한 자원 소비, 경쟁사 소송 등으로 정상 유지를 위해 수단을 가리지 않는다고 비판한다. 전체 요약 13문장 읽기 → 097 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 098 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 099 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 100 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 →